
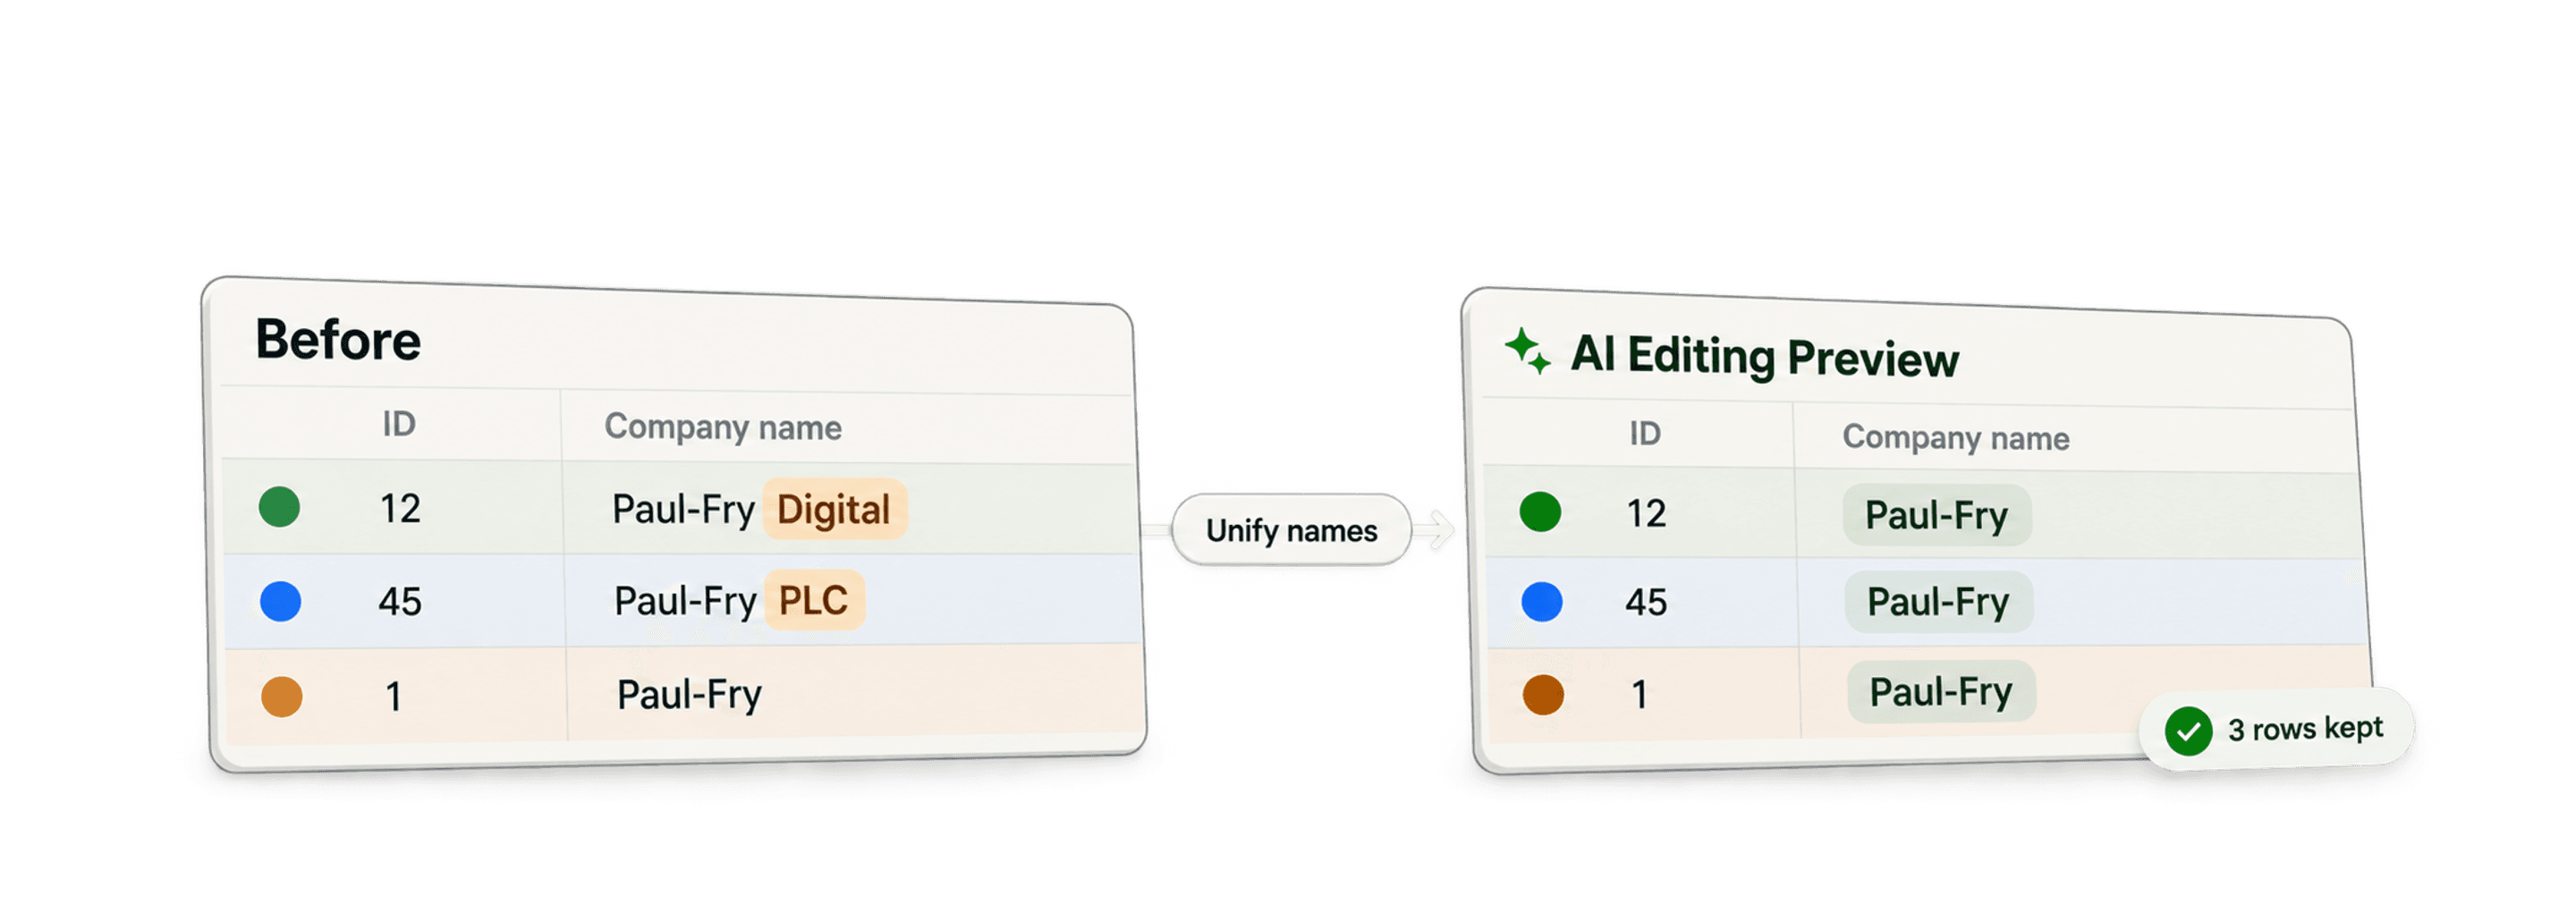
행을 병합하지 않고 필드 값을 통일하려면, 동일한 엔터티에 해당하는 레코드를 찾고 대상 필드에 사용할 값 하나를 선택한 다음 그룹 전체에 복사하면 됩니다. Datablist에서는 Duplicates Finder의 Custom with AI를 사용하고, 모든 레코드를 그대로 유지하라고 명확히 지시하세요.
회사명을 표준화하기 전에는 웹사이트처럼 신뢰할 수 있는 식별자를 기준으로 회사 레코드를 그룹화하는 것이 좋습니다. 이름이 비슷하다는 이유만으로 두 회사가 동일한 기업이라고 단정할 수는 없습니다. 행을 분리해 두면 각 레코드의 ID와 소스 정보를 보존할 수 있지만, 잘못 그룹화하면 엉뚱한 회사명이 복사될 수 있습니다.
이 가이드에서는 개별 레코드를 그대로 유지하면서 중복 그룹의 특정 필드 값을 정규화하는 방법을 알아봅니다.
데이터 정규화란?
여기서 데이터 정규화란 데이터를 일관된 형식으로 맞추는 작업을 뜻합니다. 중복 데이터에서는 특정 필드의 값이 서로 다르게 입력된 경우가 많습니다. 예를 들면 다음과 같습니다.
- 회사명: "Tech Solutions Inc.", "Tech Solutions, LLC", "Tech Solutions"
- 직책: "Software Engineer", "Software Dev.", "Eng., Software"
- 주소: "123 Main St", "123 Main Street", "123 main st"
- 국가: "대한민국", "한국", "Korea"
정규화의 목표는 "Tech Solutions"나 "대한민국"처럼 하나의 표준값을 선택해 중복으로 식별된 모든 레코드의 해당 필드에 적용하는 것입니다.
중복 레코드를 서로 분리된 상태로 유지하더라도 데이터가 깔끔해지고, 분석하기 쉬워지며, 필터링과 리포팅의 신뢰도도 높아집니다. 이는 데이터 클리닝의 핵심 단계입니다.
Duplicates Finder의 AI Processing 소개
Datablist의 Duplicates Finder는 유사한 레코드를 식별하는 강력한 도구입니다. 중복 데이터를 자동 또는 수동으로 병합하는 다양한 옵션을 제공하며, AI Processing 모드를 사용하면 더욱 유연하게 처리할 수 있습니다.
미리 정의된 병합 규칙을 따르는 대신, AI Processing에서는 자연어 프롬프트로 원하는 로직을 직접 정할 수 있습니다. AI에 중복 레코드를 어떻게 처리할지 정확히 지시할 수 있으며, 다음과 같은 작업이 가능합니다.
- 특정 기준에 따라 마스터 레코드 선택하기(예: 가장 최근에 업데이트된 레코드)
- 일부 필드는 병합하고 나머지는 분리된 상태로 유지하기
- 병합 과정에서 계산 수행하기(예: 값 합산)
- 👉 이 가이드의 핵심: 레코드를 병합하지 않고 모든 중복 레코드의 특정 필드를 하나의 정규화된 값으로 업데이트하기
스크립트가 필요했던 복잡한 데이터 처리 작업을 AI와의 간단한 대화로 해결할 수 있습니다.
중복 데이터 정규화 방법: 단계별 가이드
AI Processing을 사용해 중복 레코드의 특정 필드(예: 회사명)를 정규화하는 과정을 단계별로 살펴보겠습니다.
1단계: 데이터 준비
먼저 데이터를 Datablist에 불러와야 합니다.
- Collection 생성: 사이드바의 '+' 버튼을 클릭해 새 Collection을 만듭니다.
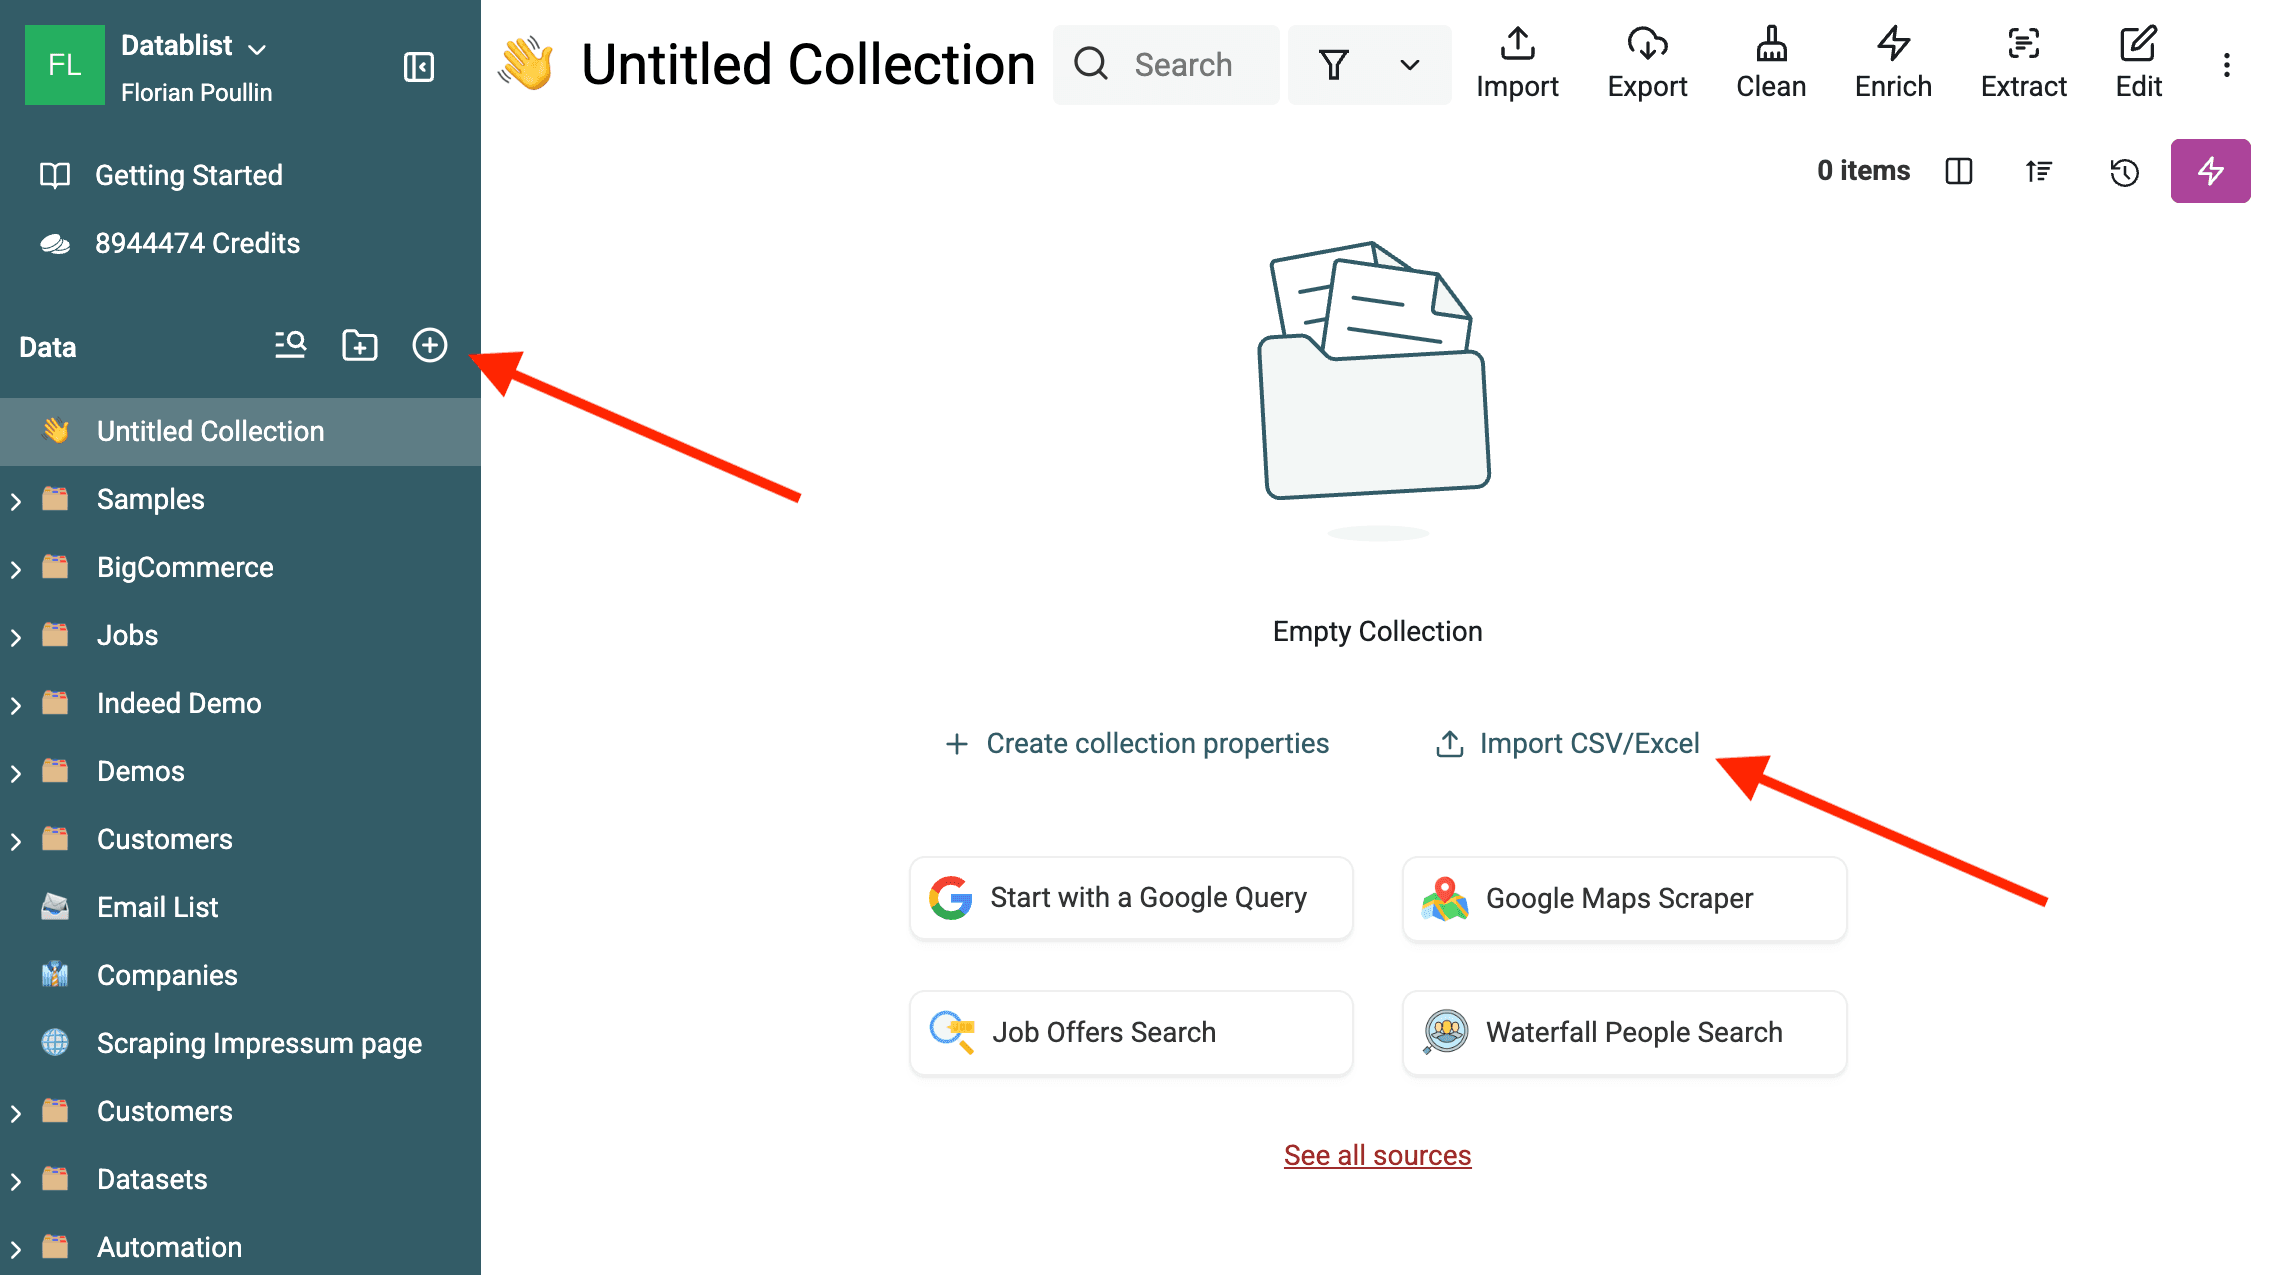
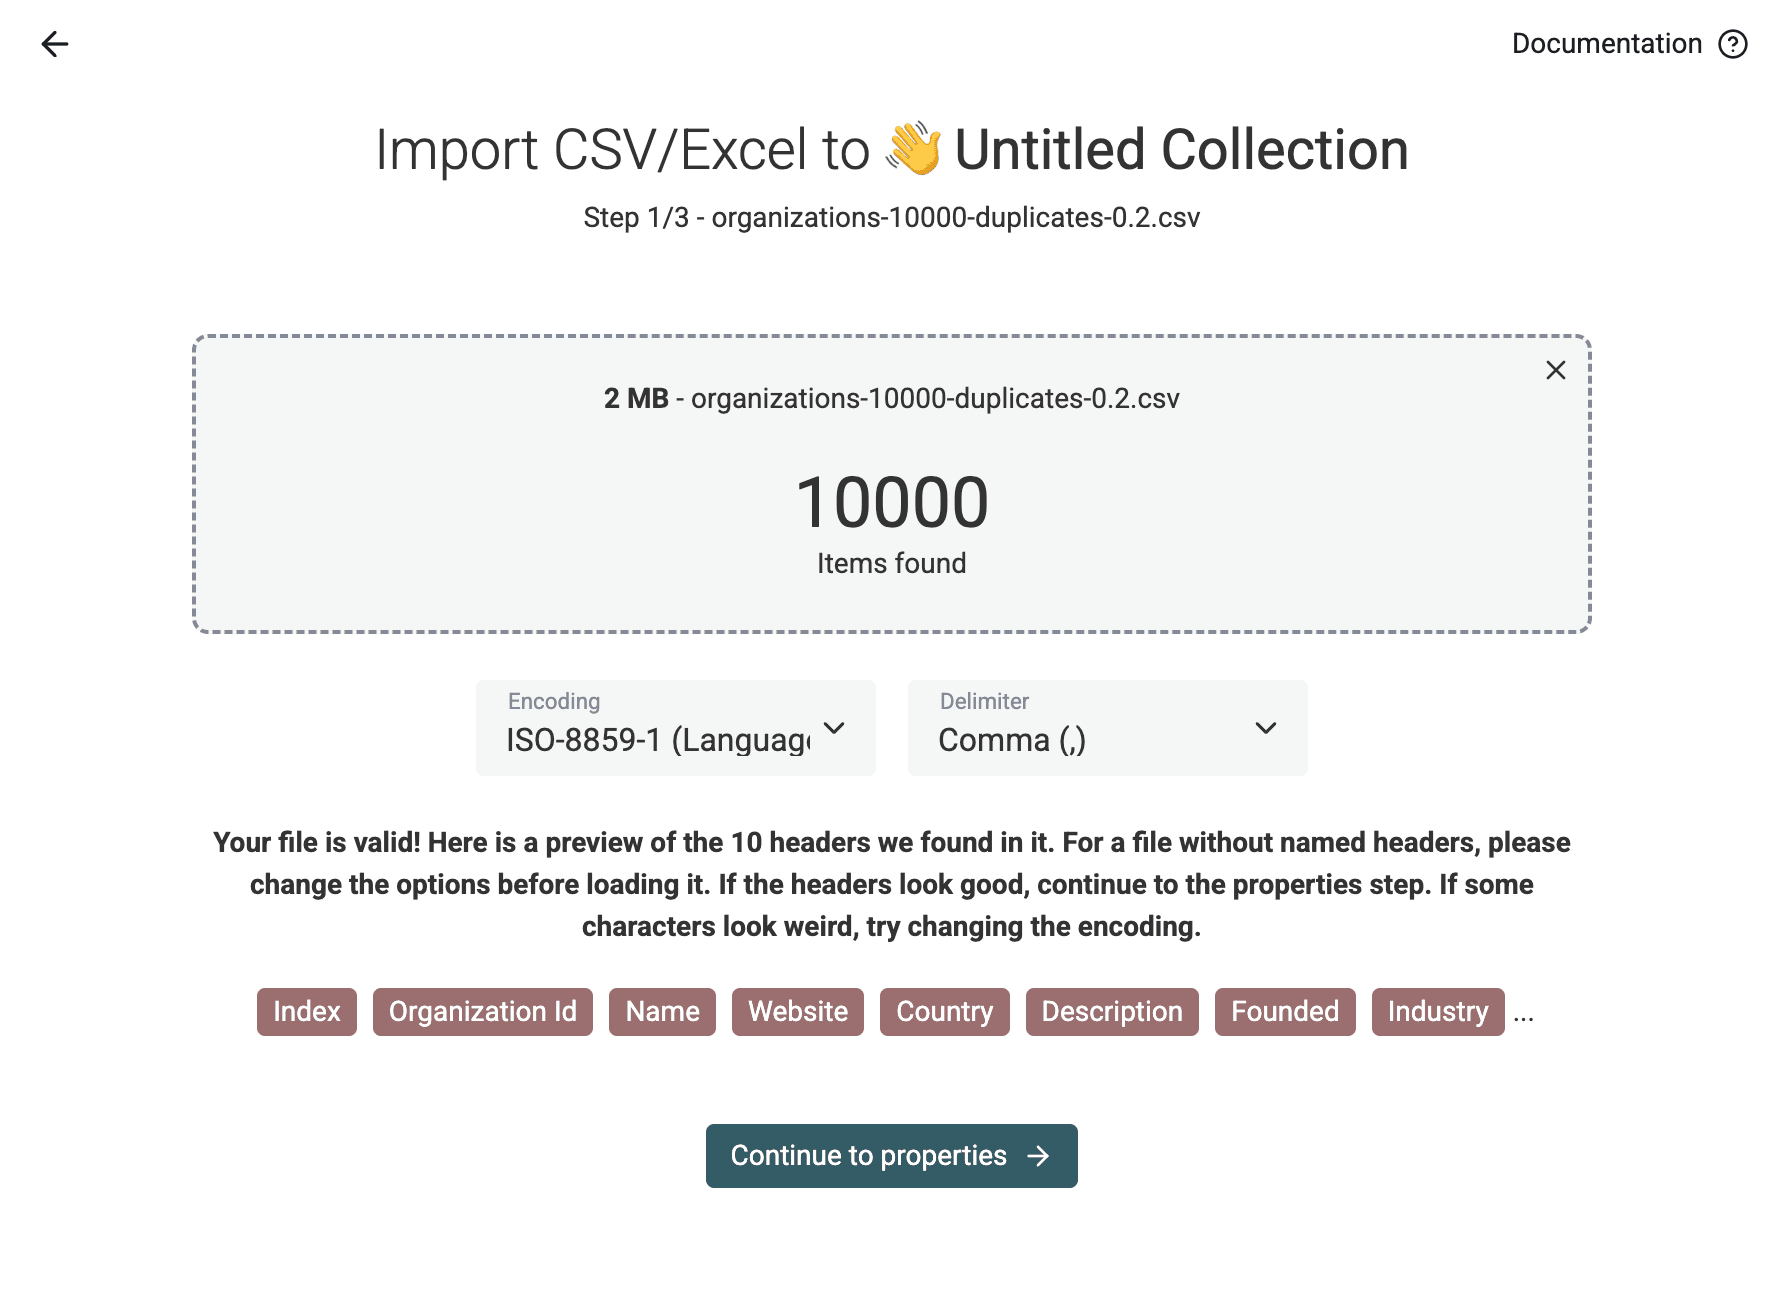
- 데이터 가져오기: CSV 또는 Excel 파일에서 데이터를 가져옵니다. 데이터가 여러 파일에 나뉘어 있다면 모두 같은 Collection으로 가져오세요. Datablist가 열을 속성에 매핑하는 과정을 안내합니다. 정규화할 필드(예: 회사명)와 중복 식별에 사용할 필드(예: 이메일, 웹사이트)가 올바르게 가져와졌는지 확인하세요.
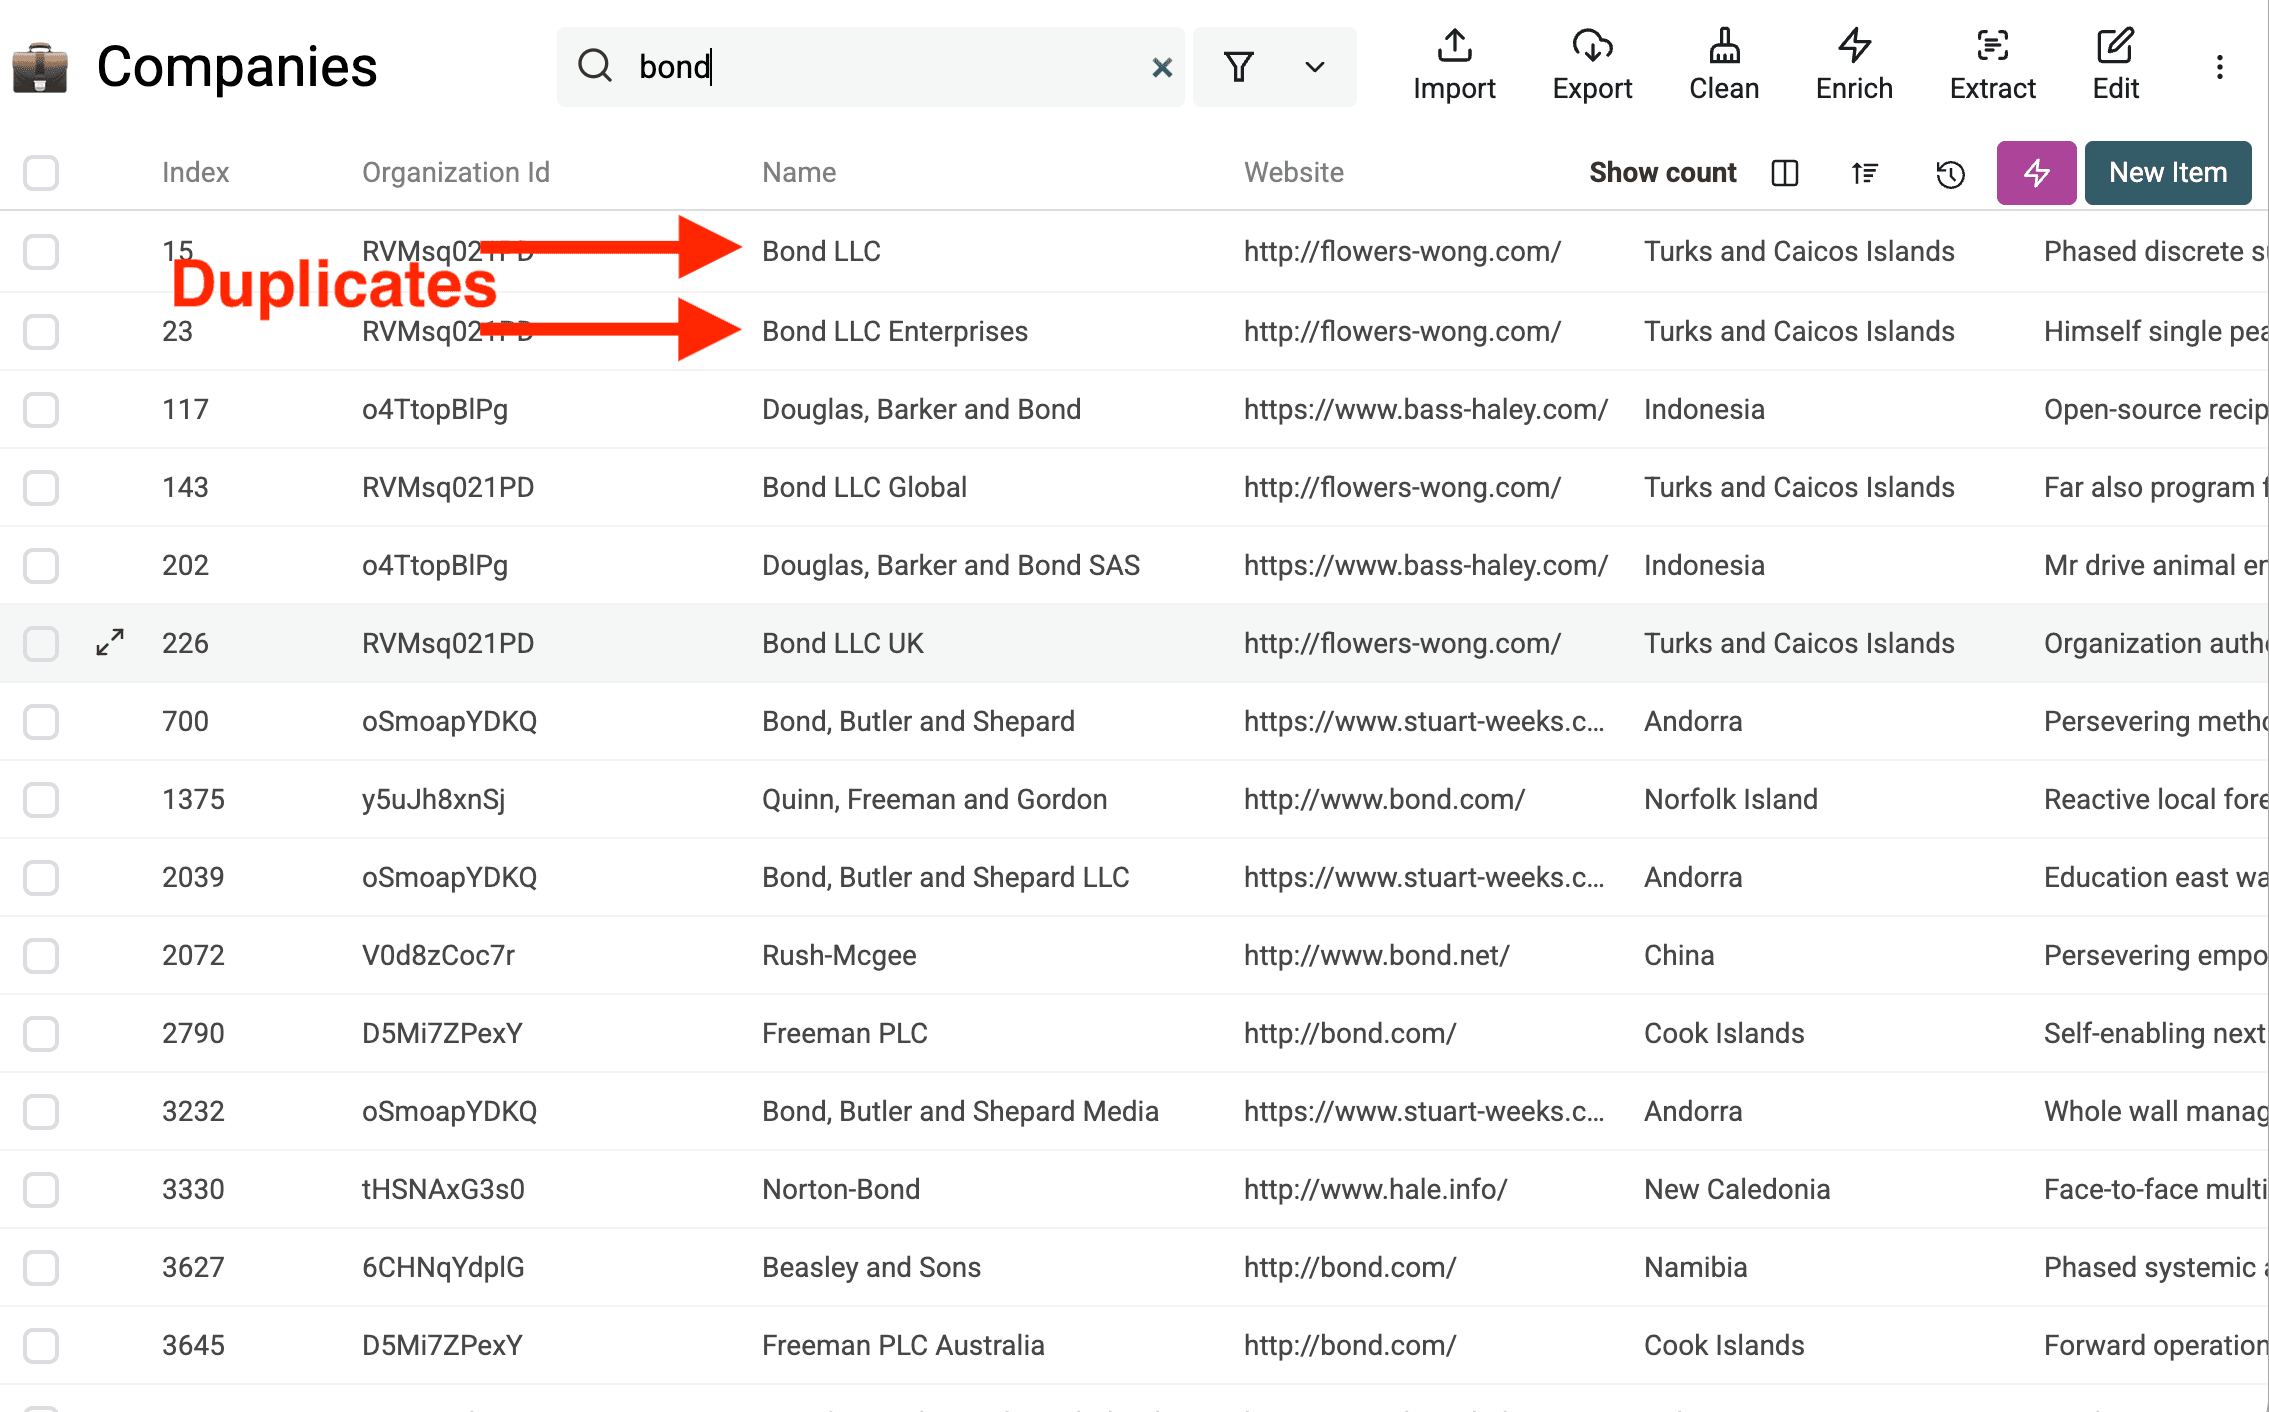
샘플 데이터에서도 정규화가 필요한 중복 회사명을 확인할 수 있습니다.
2단계: 중복 레코드 찾기
이제 중복 레코드를 식별합니다.
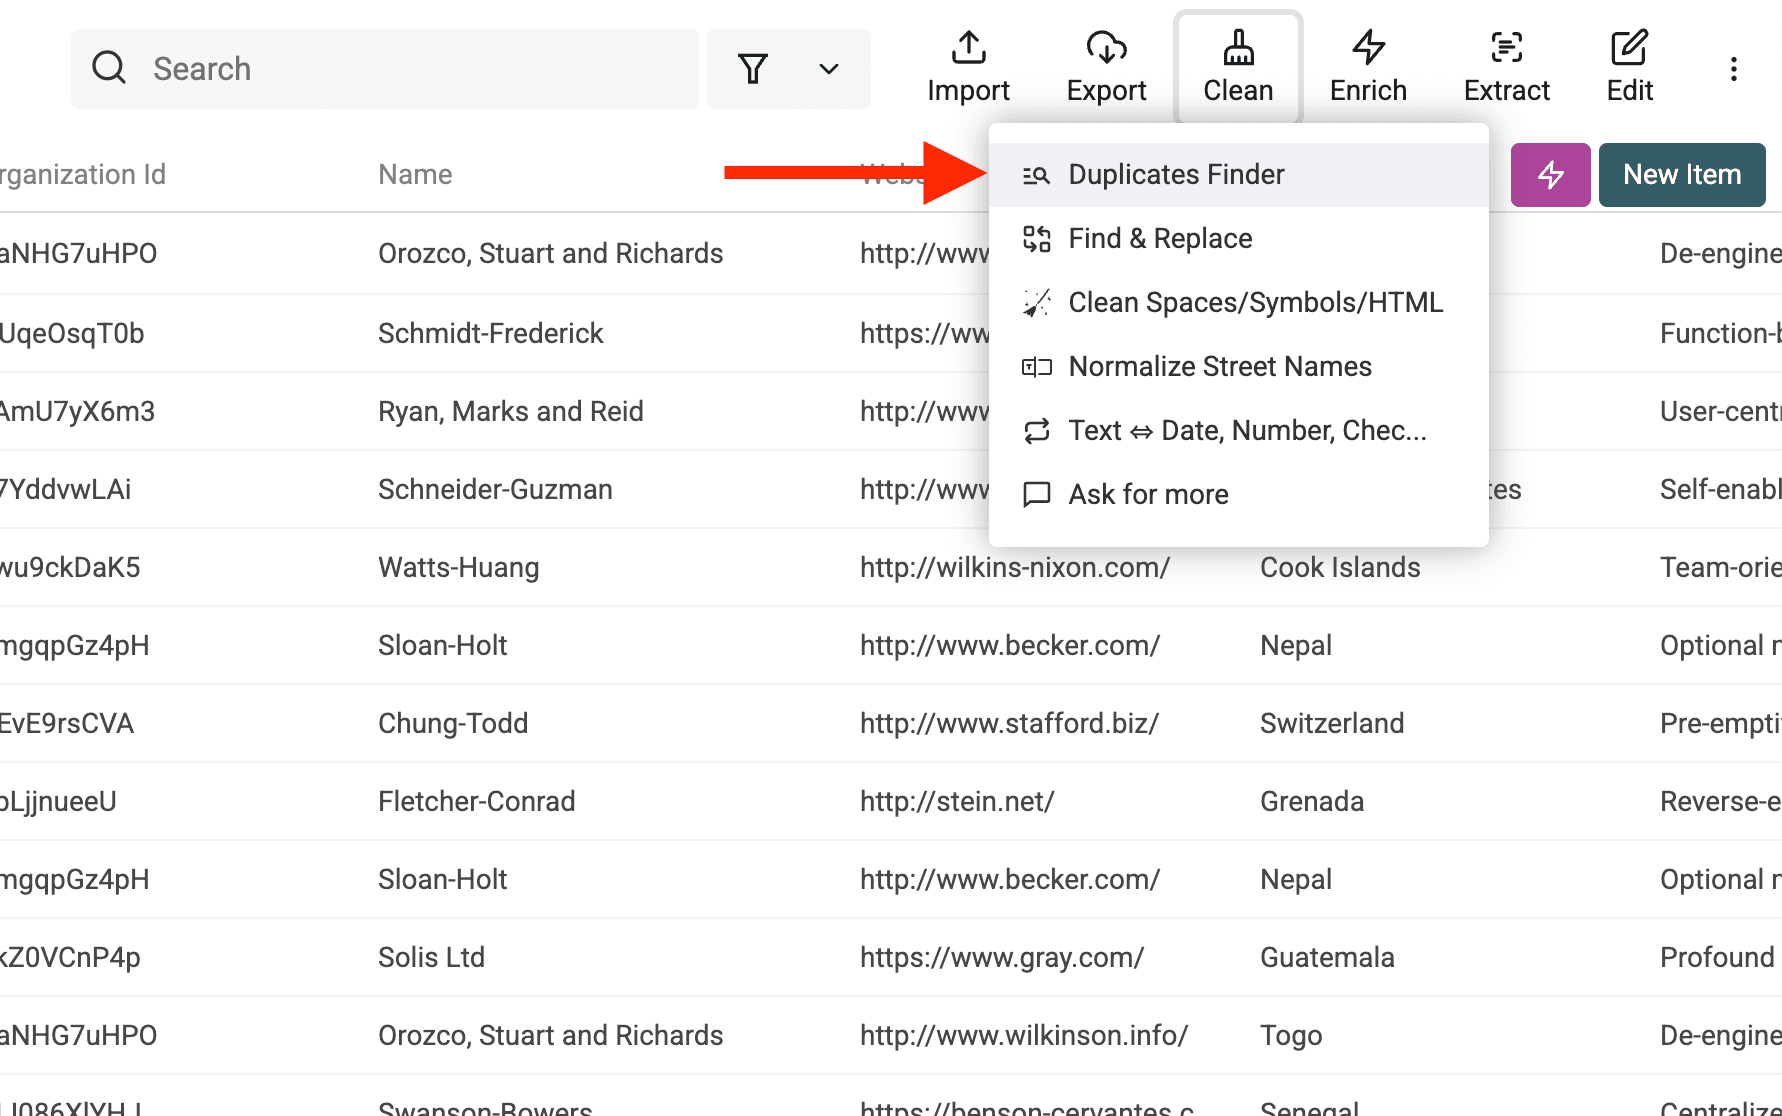
2.a. Duplicates Finder 열기
Clean > Merge duplicates를 엽니다.
2.b 중복 식별자 선택
중복 레코드를 고유하게 식별할 속성을 하나 이상 선택합니다.
공통 웹사이트나 회사 ID가 있다면 이를 사용하세요. 회사명만 있다면 회사명 매칭 가이드를 참고하고, 정규화하기 전에 각 그룹을 직접 검토하세요. 이름이 비슷하거나 법인 표기만 다르더라도 서로 다른 기업일 수 있습니다.
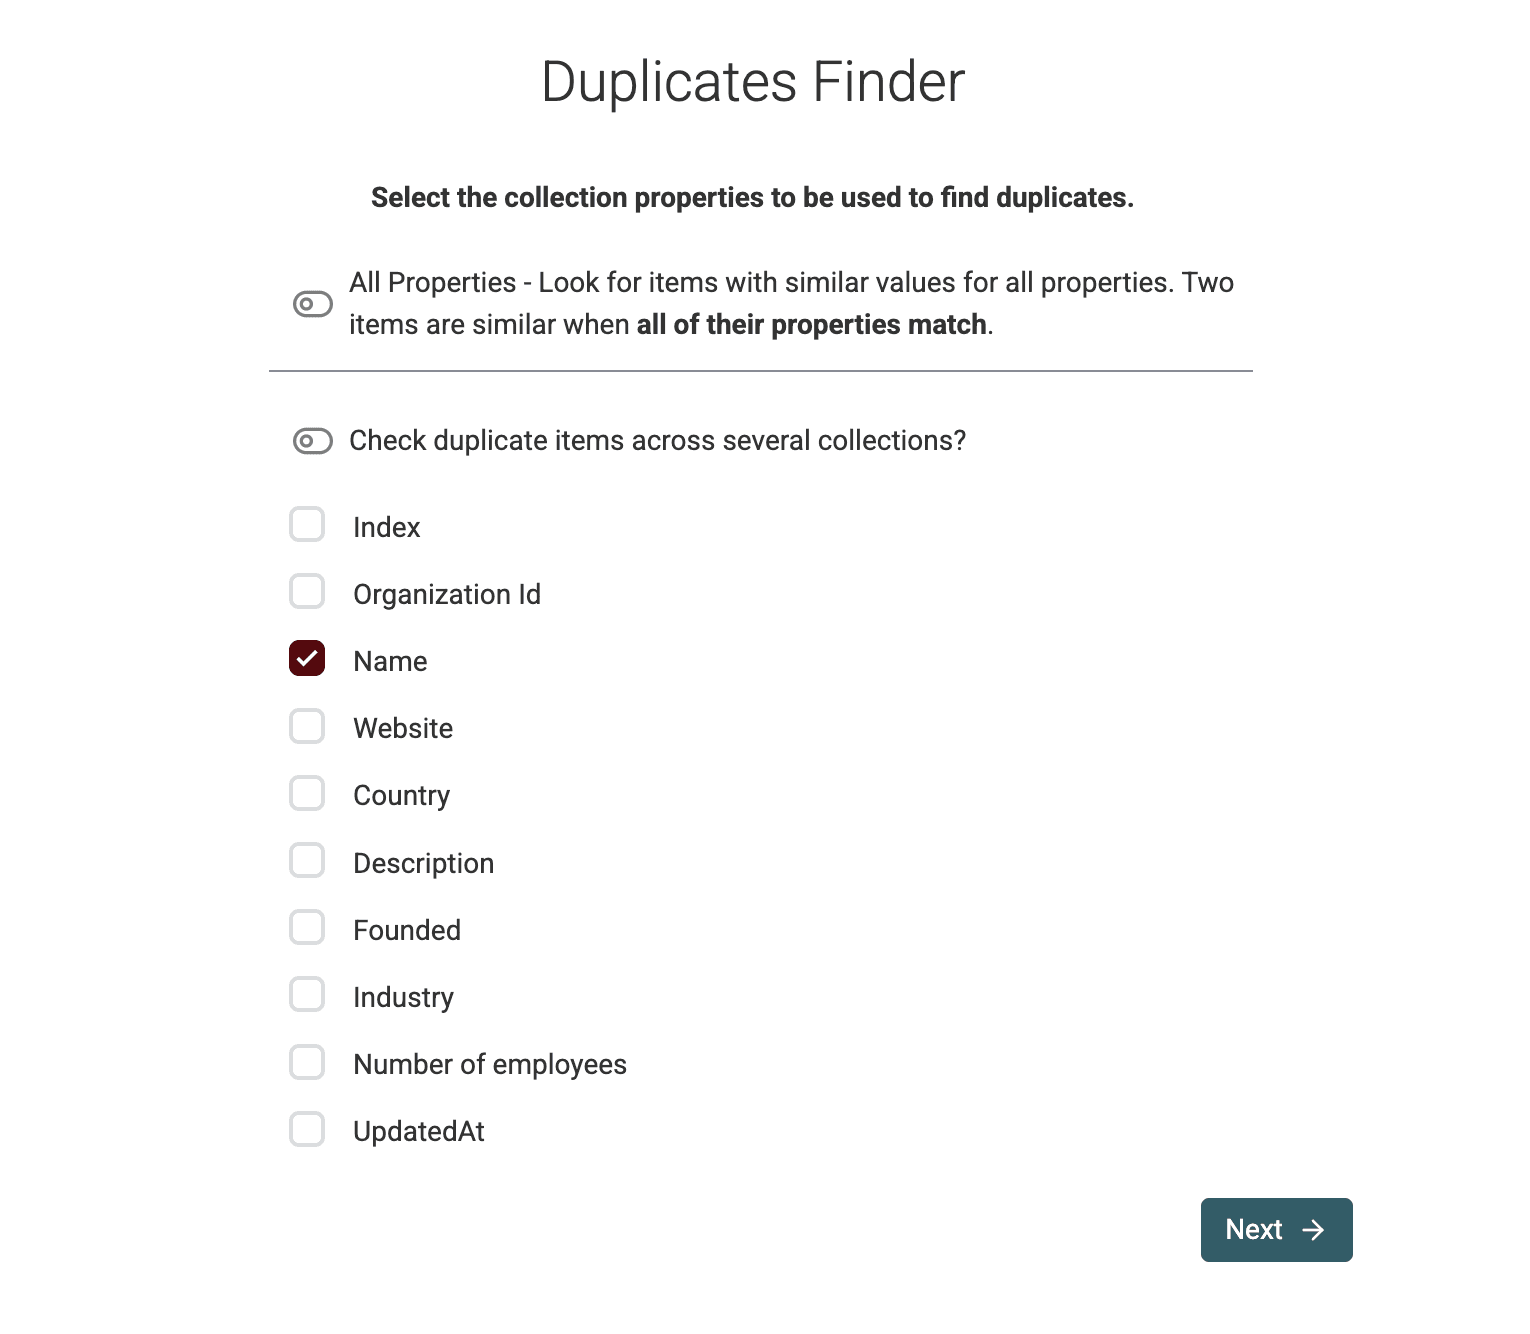
회사 데이터에는
Website URL또는LinkedIn Company Page URL도 사용할 수 있습니다.연락처 데이터에는 주로
Phone Number를 사용합니다.
2.c 매칭 알고리즘 설정
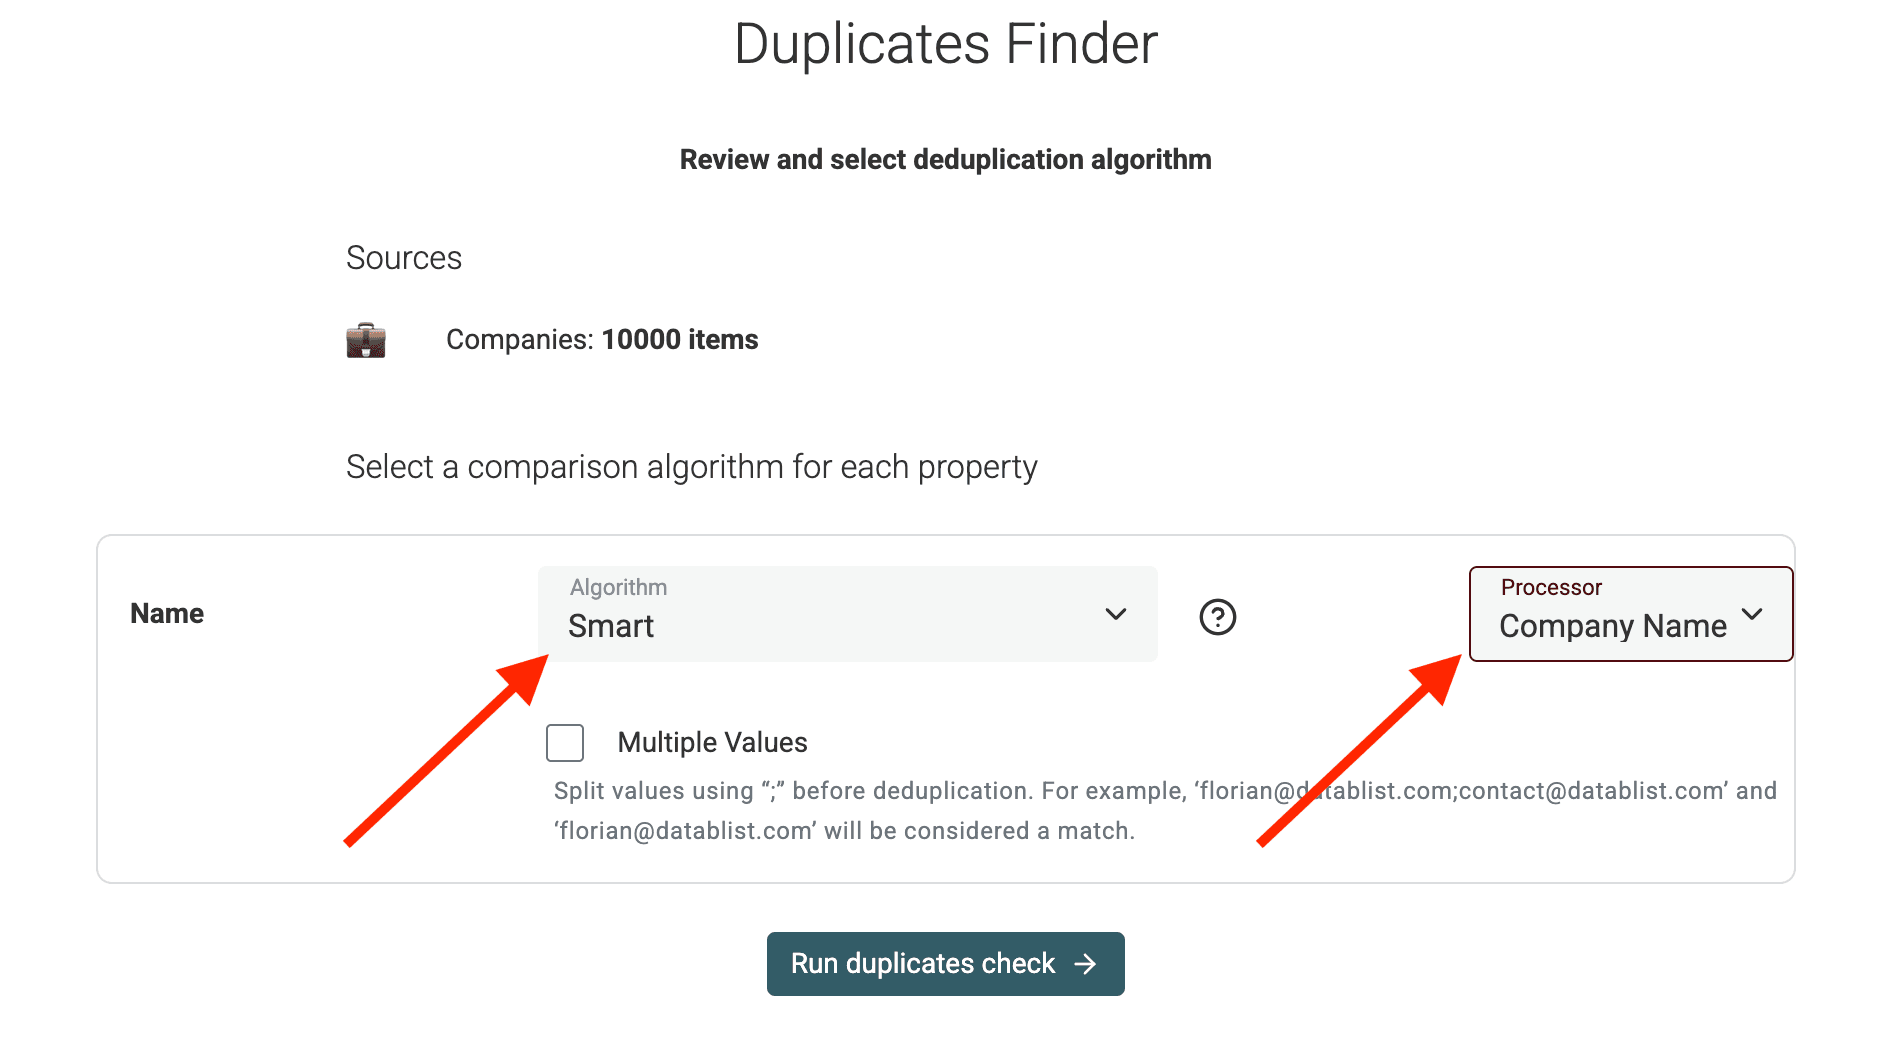
다음 단계에서 매칭 알고리즘을 선택합니다.
URL이나 이메일에는 사소한 차이를 처리할 수 있는 'Smart'가 적합한 경우가 많습니다. 'Exact'는 더 엄격하게 일치 여부를 판단합니다. 이름에는 음성 또는 퍼지 매칭을 사용할 수도 있습니다.
중복 식별에 사용하는 필드에 맞는 Processor를 선택하세요. 웹사이트 식별자에는 Url, 이메일 식별자에는 Email을 사용합니다. 회사명 변형을 매칭할 때는 Company Name을 선택하세요.
Processor는 값의 비교 방식만 바꾸며, 저장된 셀을 수정하지 않습니다. 여기서는 Website URL을 기준으로 그룹화하고, 이후 AI 단계에서 Company Name을 정규화할 수 있습니다. 매칭에 사용할 식별자와 업데이트할 필드는 서로 다른 역할을 합니다.
2.c 중복 검사 실행
Run duplicates check를 클릭합니다.
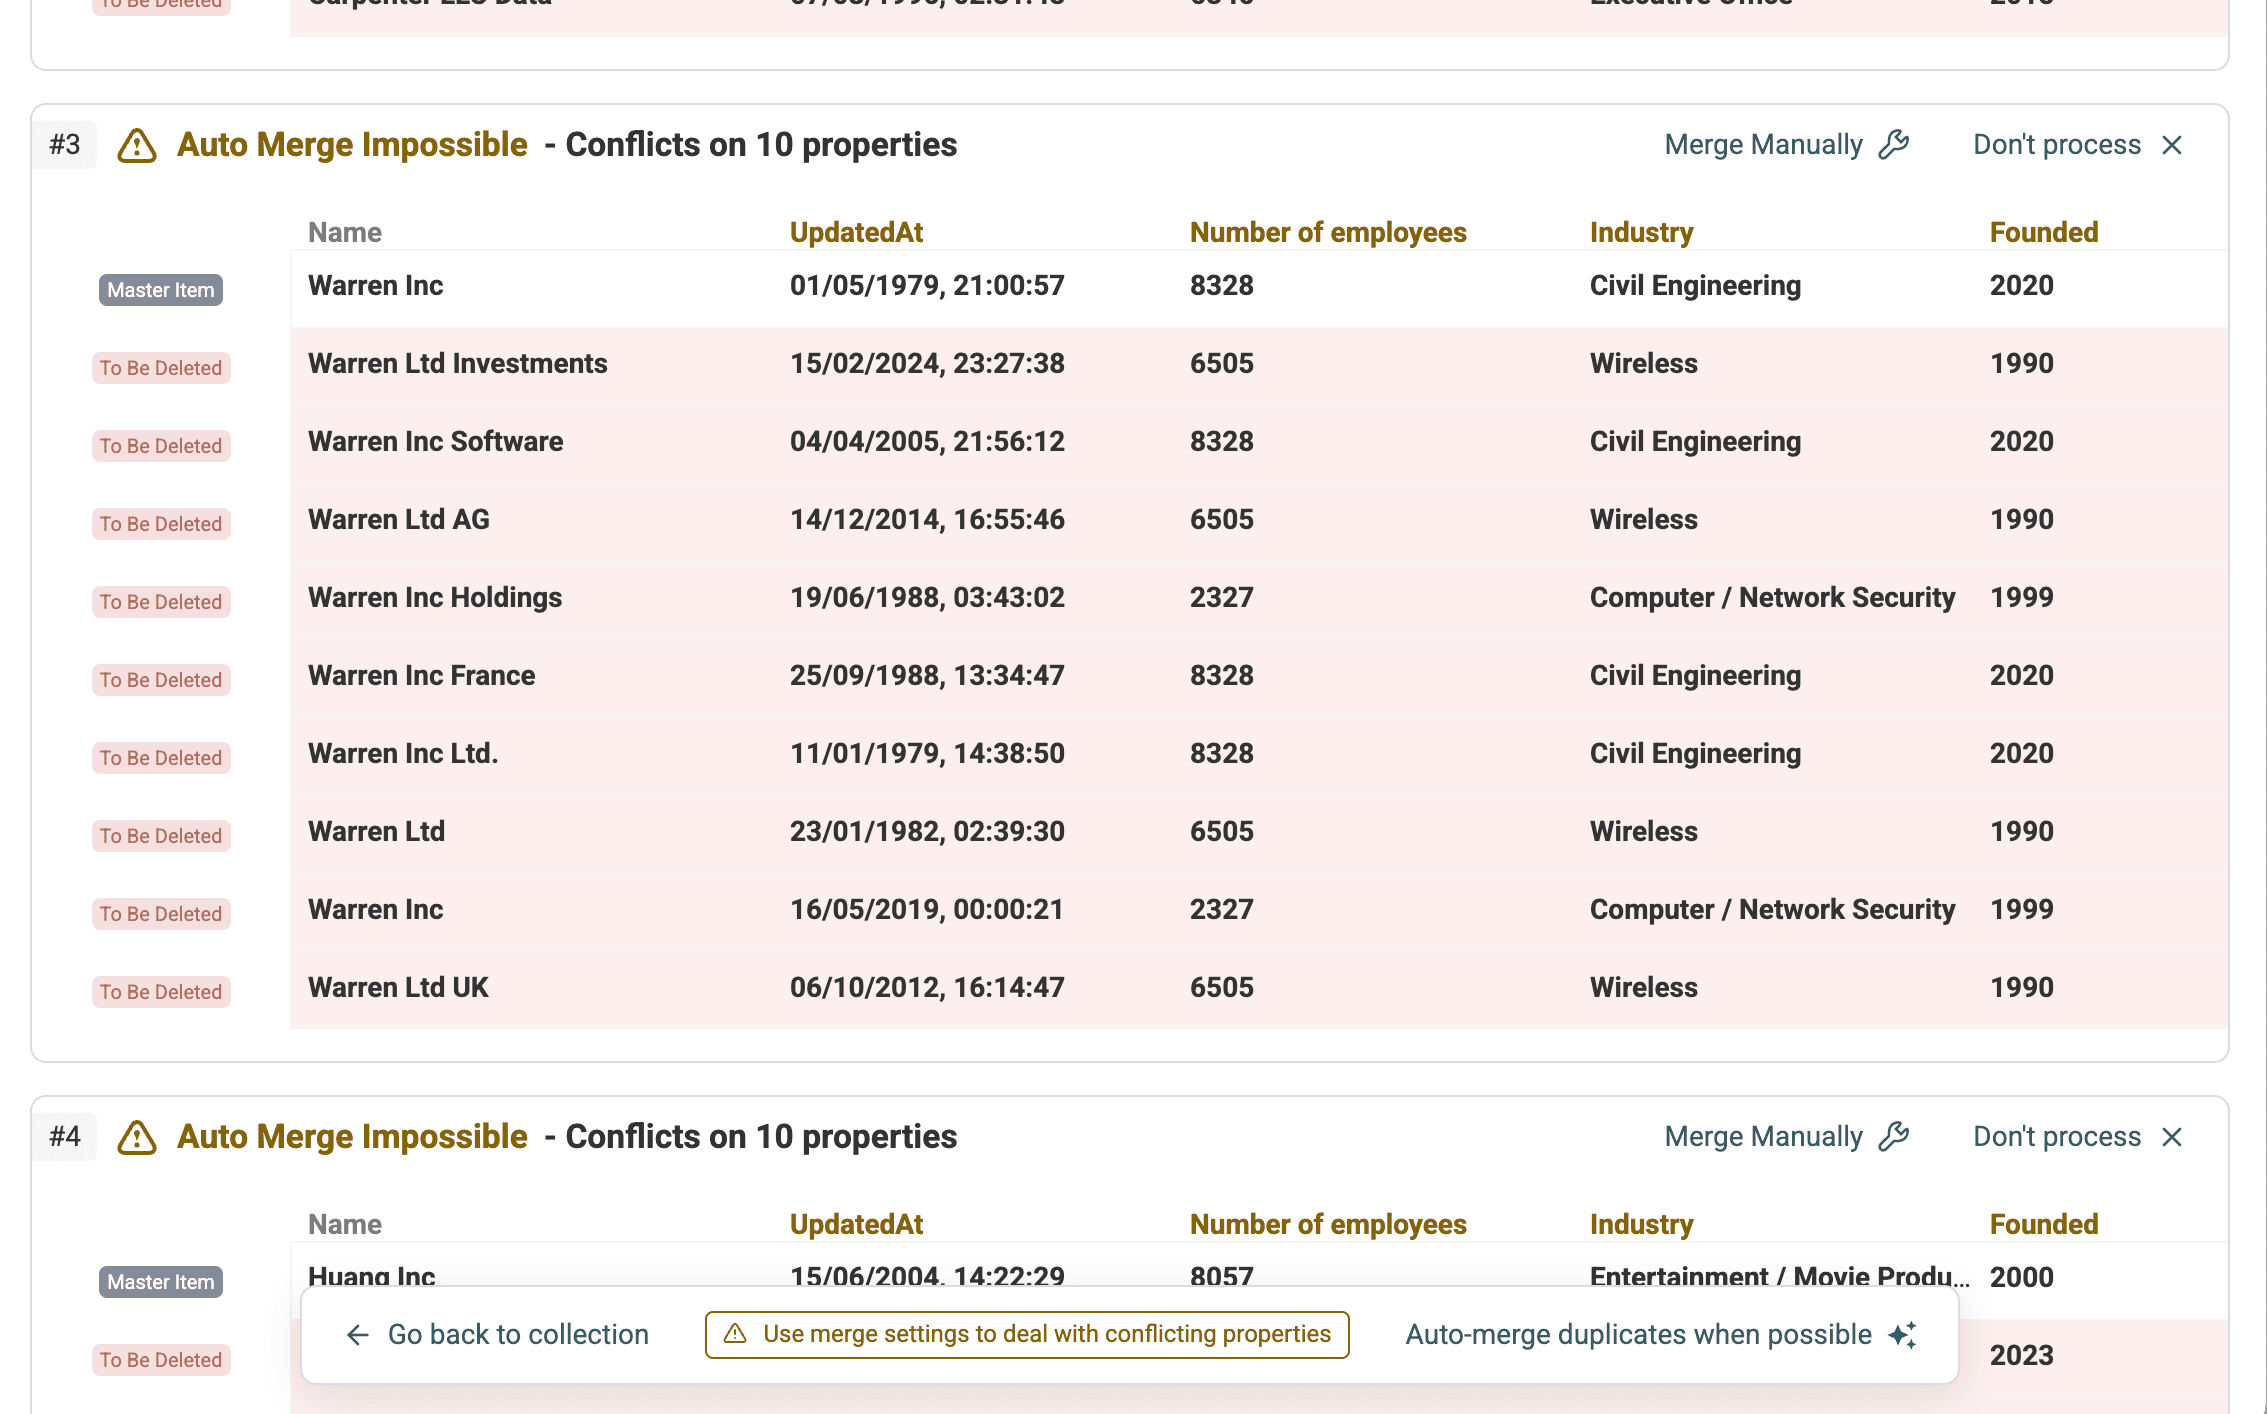
Datablist가 데이터를 분석한 후 중복 가능성이 있는 레코드를 그룹별로 표시합니다.
3단계: AI Processing 모드 선택
중복 검사 결과 페이지에서 Custom with AI를 선택합니다. 아래의 이전 스크린샷에는 과거 명칭인 AI Editing이 표시되어 있습니다. 이 모드는 사용자의 지시와 소량의 샘플 데이터를 바탕으로 스크립트를 생성한 뒤 변경 내용을 미리 보여줍니다.
4단계: 정규화 프롬프트 작성
이 단계에서 AI가 수행할 작업을 지시합니다. 다음 내용을 포함해야 합니다.
- 각 중복 그룹에서 대상 속성의 최빈값을 식별합니다.
- 해당 그룹의 모든 레코드에서 지정된 속성을 이 최빈값으로 업데이트합니다.
- 어떤 레코드도 삭제하지 말라고 명확히 지시합니다.
다음은 /Company Name 속성을 정규화하는 프롬프트 예시입니다.
각 중복 그룹에서 비어 있지 않은 /CompanyName 값을 정확한 텍스트 일치를 기준으로 집계하세요. 어떤 값 하나가 다른 모든 값보다 더 많이 나타나면, CompanyName이 비어 있는 레코드를 포함해 해당 그룹의 모든 레코드에 그 값을 /CompanyName으로 복사하세요.
모든 값이 비어 있거나 최빈값이 두 개 이상이면 해당 그룹을 변경하지 말고 건너뛰세요. 값이 이미 모두 동일한 그룹도 건너뛰세요. 다른 모든 속성을 그대로 유지하고, 레코드를 병합하거나 삭제하지 마세요.
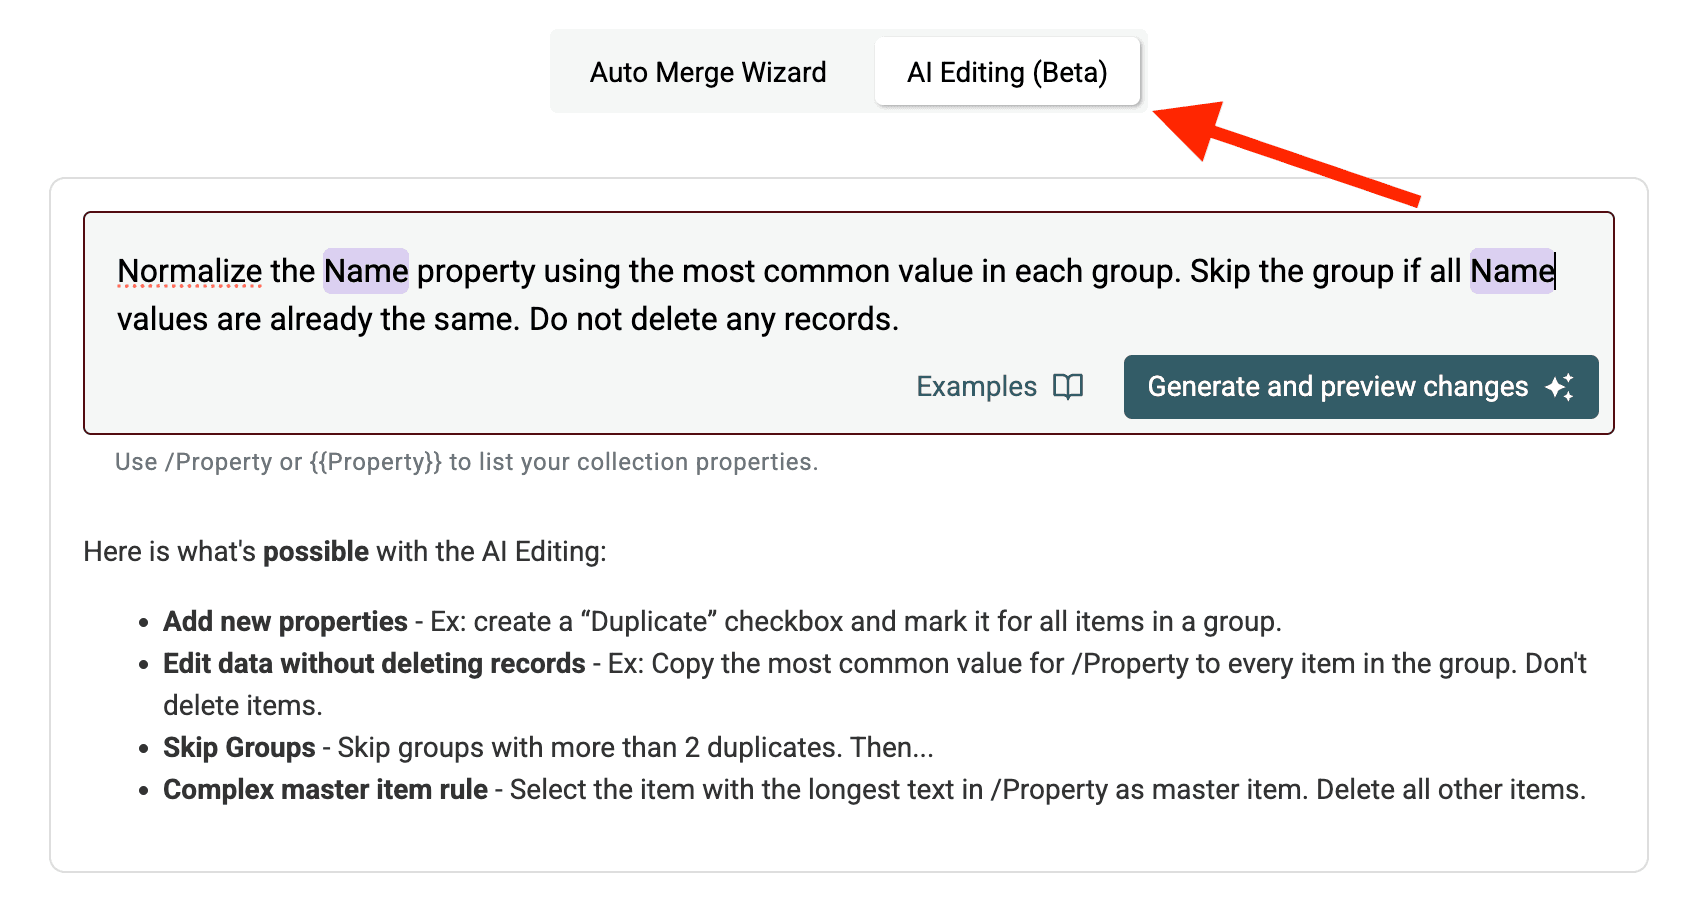
프롬프트 분석:
Normalize the /CompanyName property...: 대상 필드를 지정합니다. 열을 참조할 때는/PropertyName또는{{PropertyName}}형식을 사용하세요....count the non-empty values using exact text matches.: 표준값을 선택하는 기준을 정의합니다. 빈 값은 최빈값이 될 수 없으며, 최빈값이 여러 개인 그룹은 검토할 수 있도록 그대로 둡니다. "가장 긴 값", "가장 짧은 값" 같은 다른 기준을 사용하거나 다른 필드를 참조할 수도 있습니다(예: "가장 최근/UpdatedAt날짜가 있는 레코드의 값을 사용").Skip the group if all /CompanyName values are already the same.: 불필요한 처리를 줄이기 위한 지시입니다.Do not delete any records.: 필드만 업데이트하고 레코드가 병합되거나 삭제되지 않도록 하는 핵심 지시입니다.
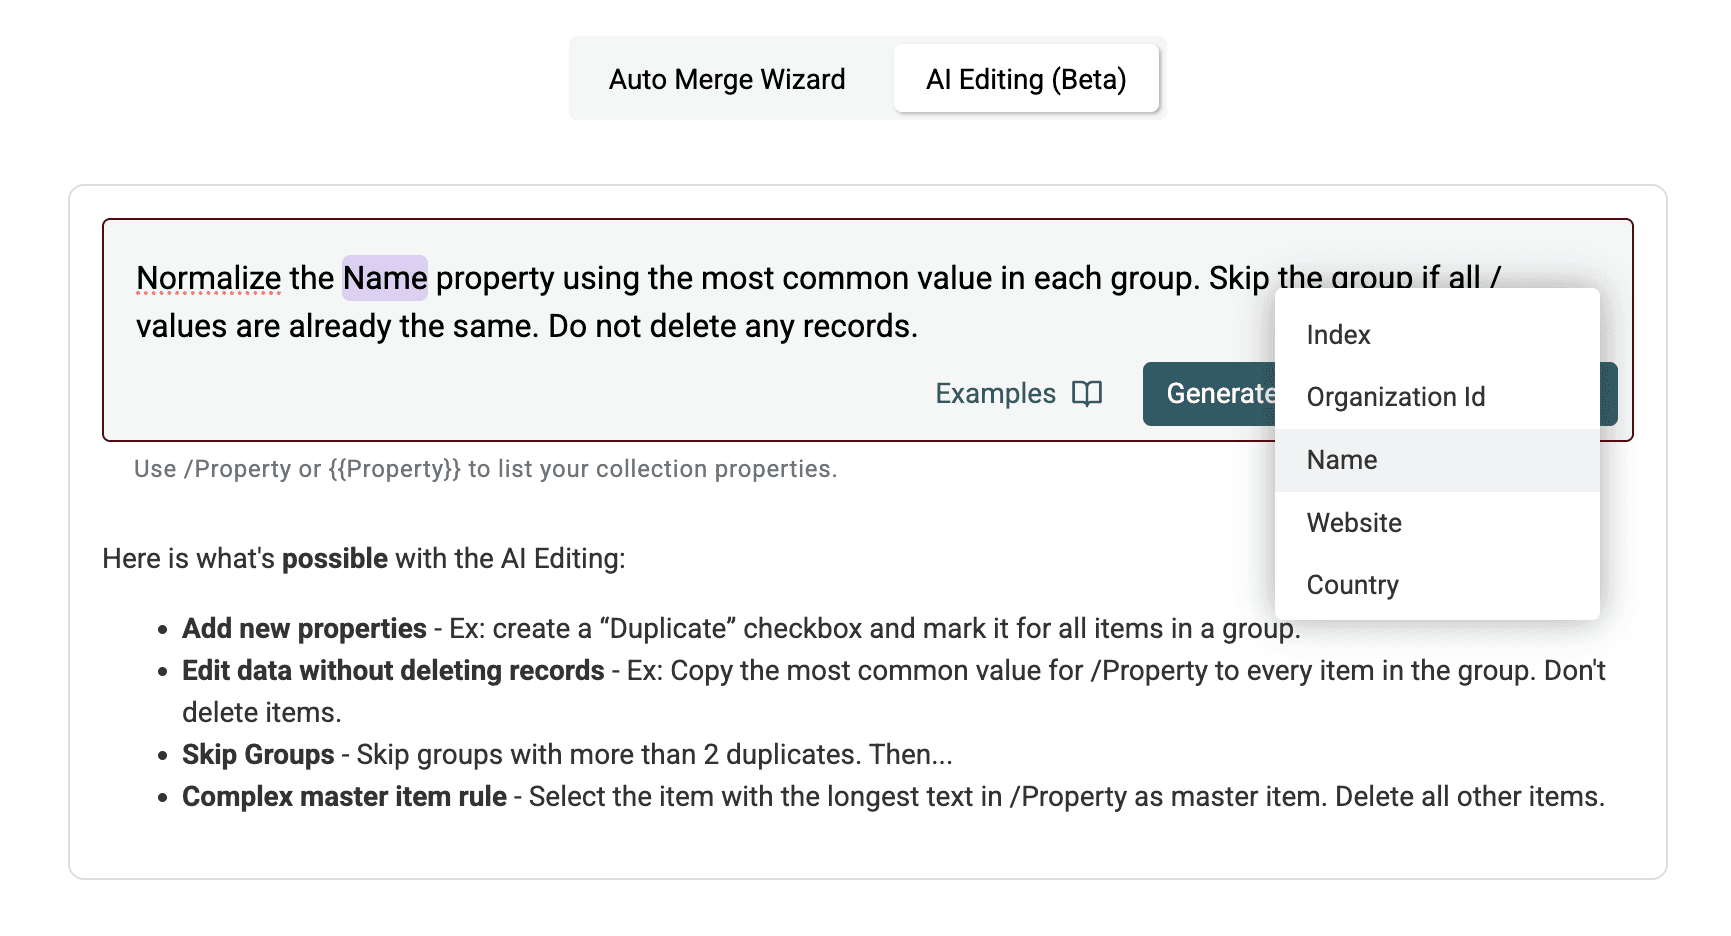
5단계: 스크립트 생성 및 미리보기
Generate and preview changes를 클릭합니다. Datablist의 AI가 프롬프트를 해석하고 작업을 수행할 스크립트를 생성합니다.
스크립트를 직접 작성하거나 수정할 필요는 없습니다.
- Script Explanation: 스크립트가 수행할 작업을 알기 쉬운 언어로 요약합니다. 의도한 내용과 일치하는지 확인하세요.
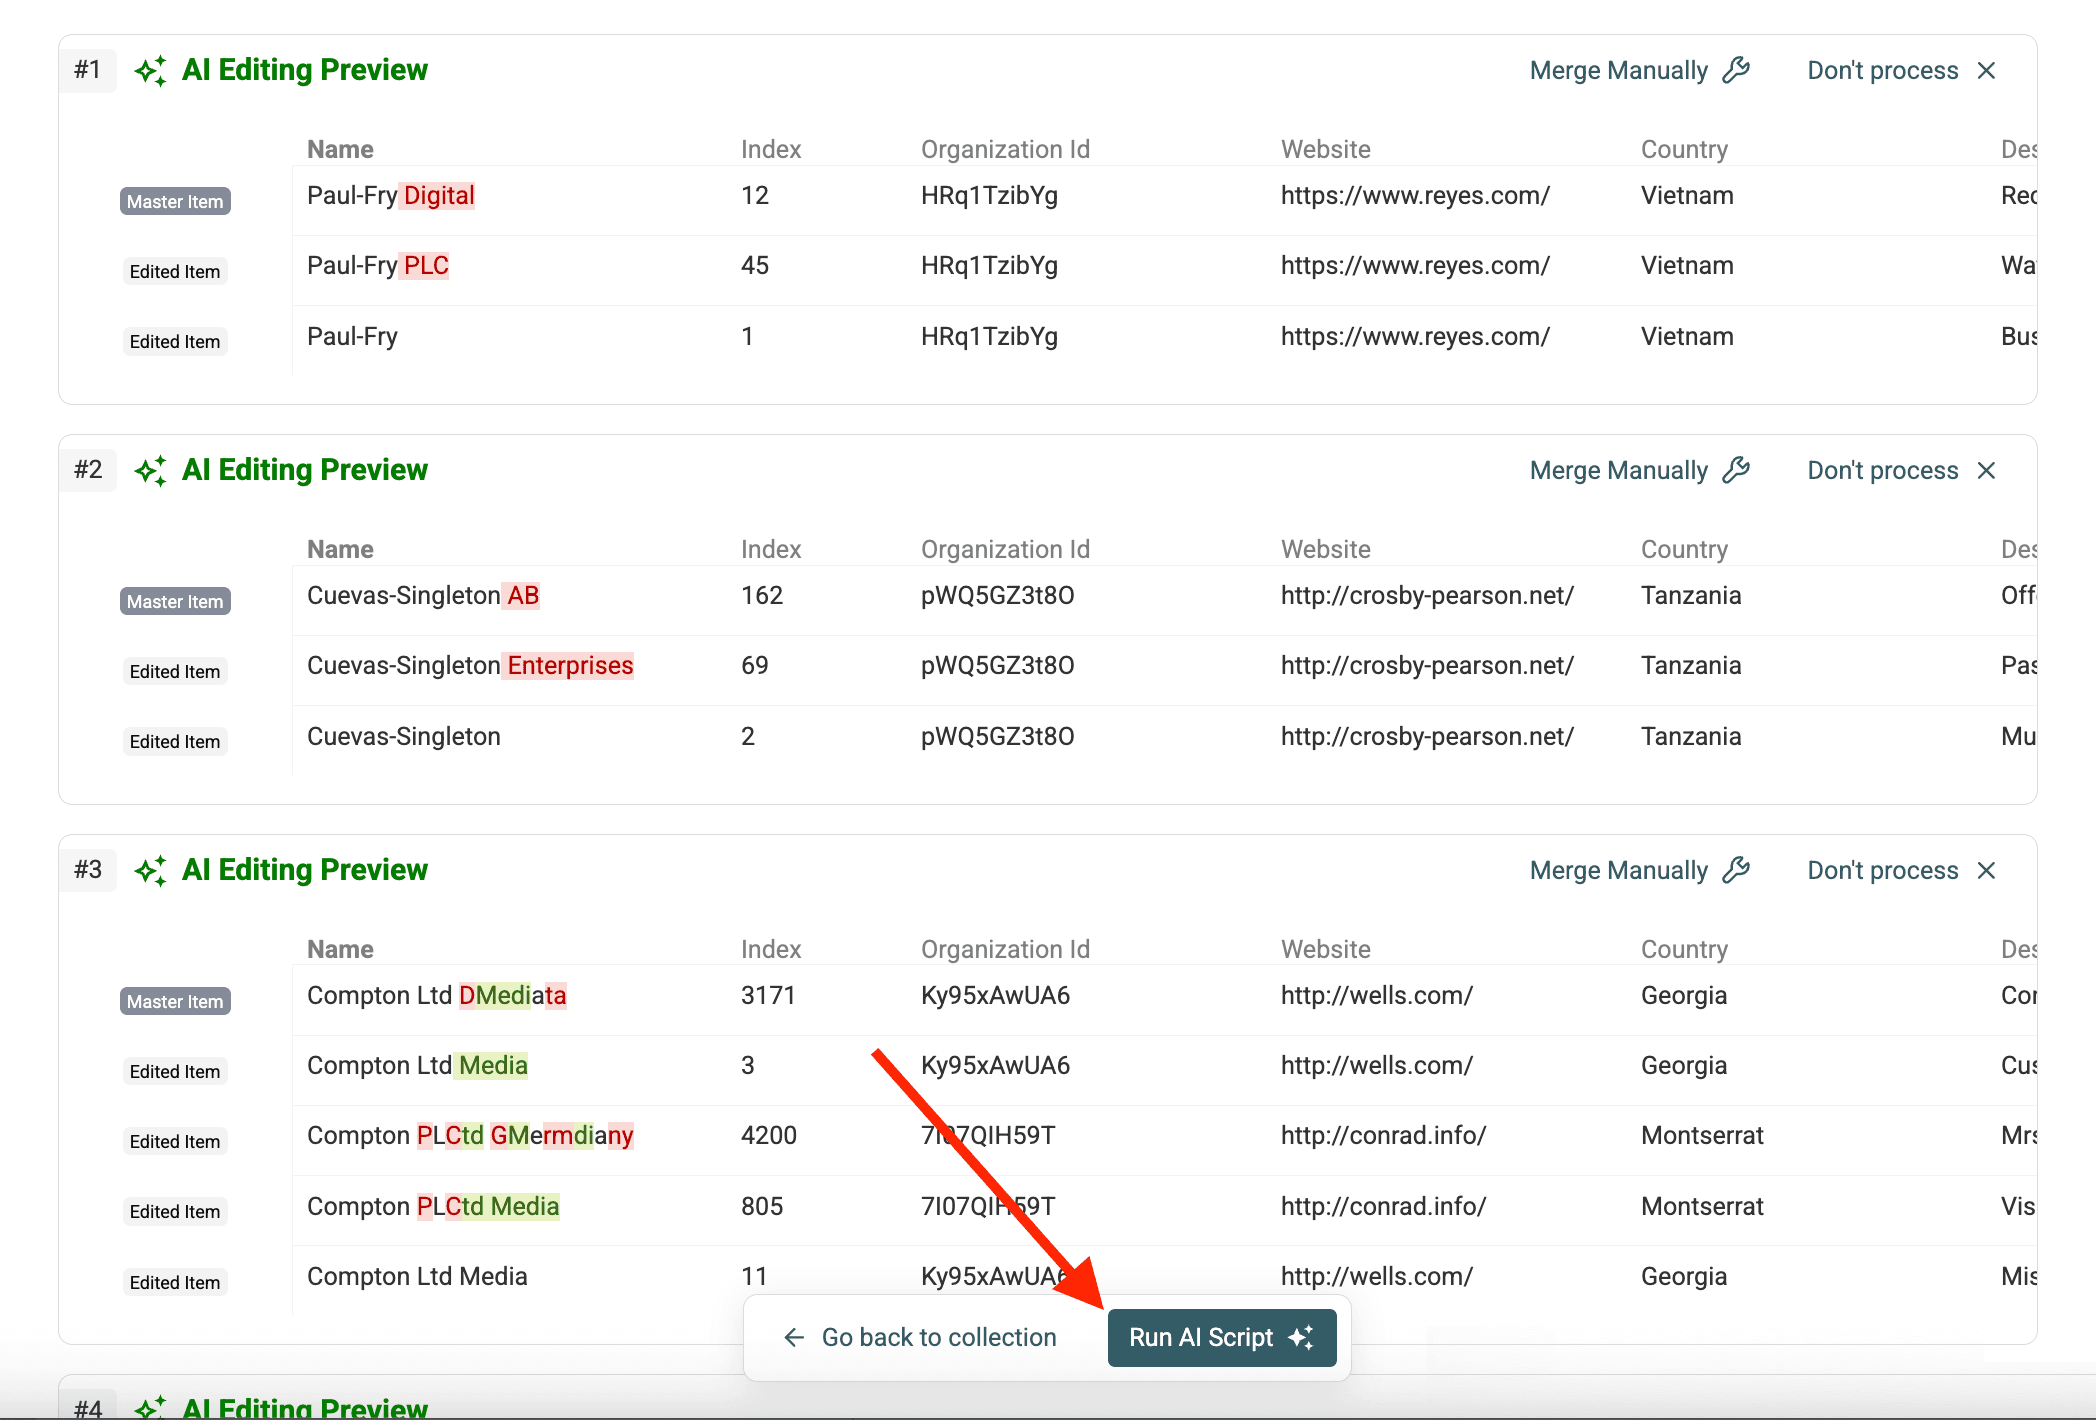
- Result Preview: 실제 변경 사항이 적용되기 전에, 샘플 중복 그룹이 스크립트로 인해 정확히 어떻게 수정되는지 표로 보여줍니다. 미리보기에서 대상 필드(예:
/Company Name)가 샘플 중복 레코드 전체에 의도한 정규화 값으로 표시되는지 확인하세요.
예를 들어 Acme Ltd, Acme Ltd, Acme Limited가 포함된 그룹은 세 개의 행을 유지하되 모든 값이 Acme Ltd가 되어야 합니다. 반면 Acme Ltd 하나와 Acme Limited 하나가 있는 그룹은 어느 값도 더 자주 등장하지 않으므로 변경되지 않아야 합니다. 이는 미리보기 검토를 위한 예시일 뿐, 실제 측정 결과는 아닙니다.
값과 행 개수를 모두 확인하세요. 명확한 최빈값이 있을 때만 빈 값이 채워지는지, 최빈값이 여러 개인 그룹은 변경되지 않는지, 소스 ID와 관련 없는 속성이 그대로 보존되는지 확인합니다.
6단계: 스크립트 실행
설명과 미리보기가 올바르다면 Run AI rules를 클릭합니다. Datablist가 식별된 모든 중복 그룹에 생성된 스크립트를 실행합니다.
7단계: 변경 사항 검토
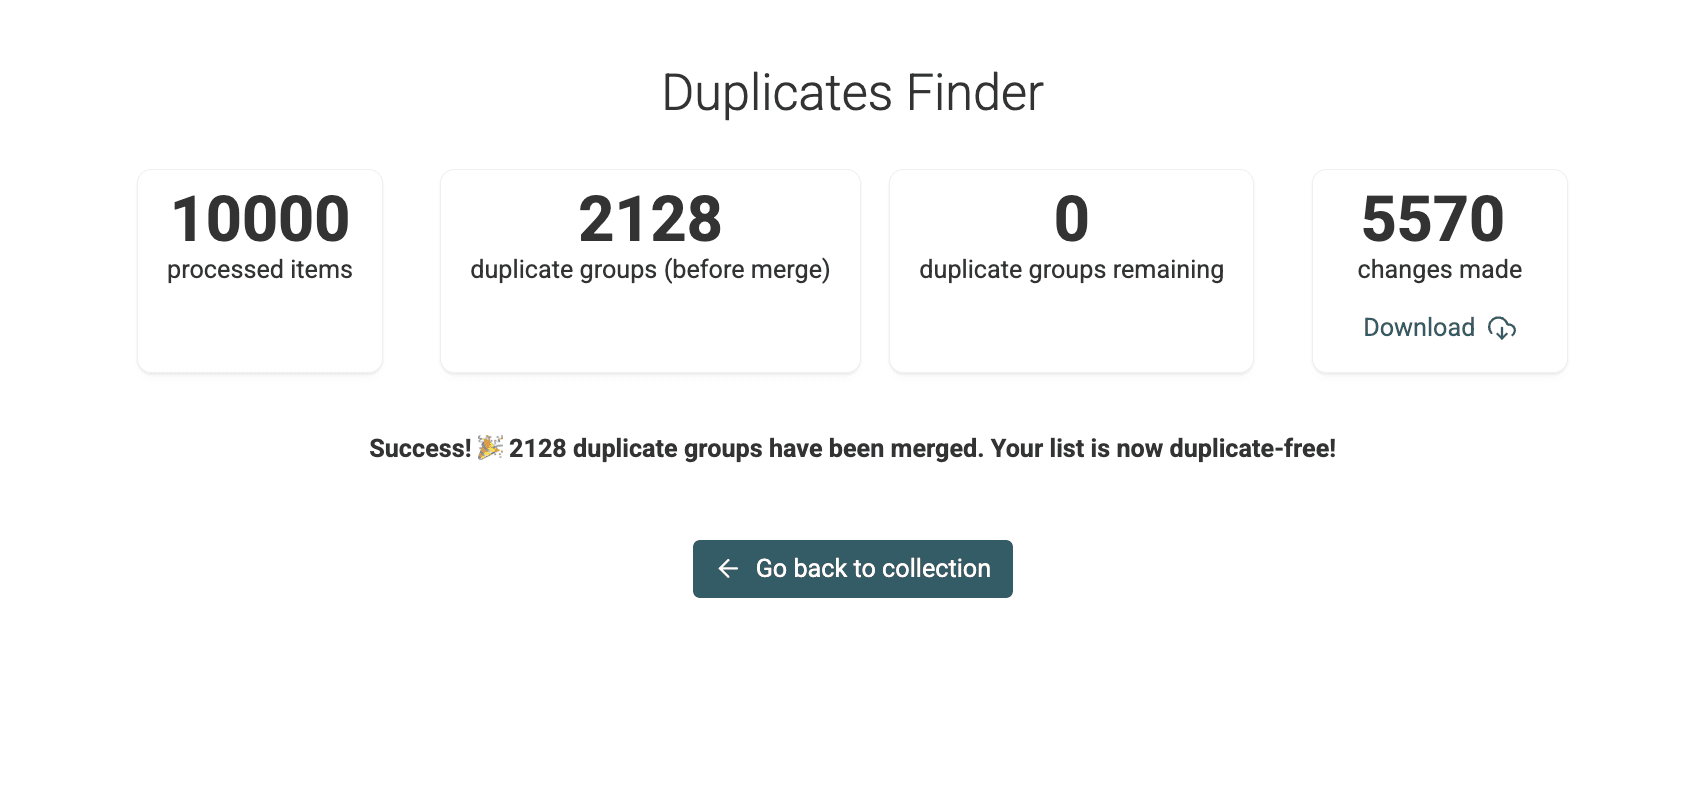
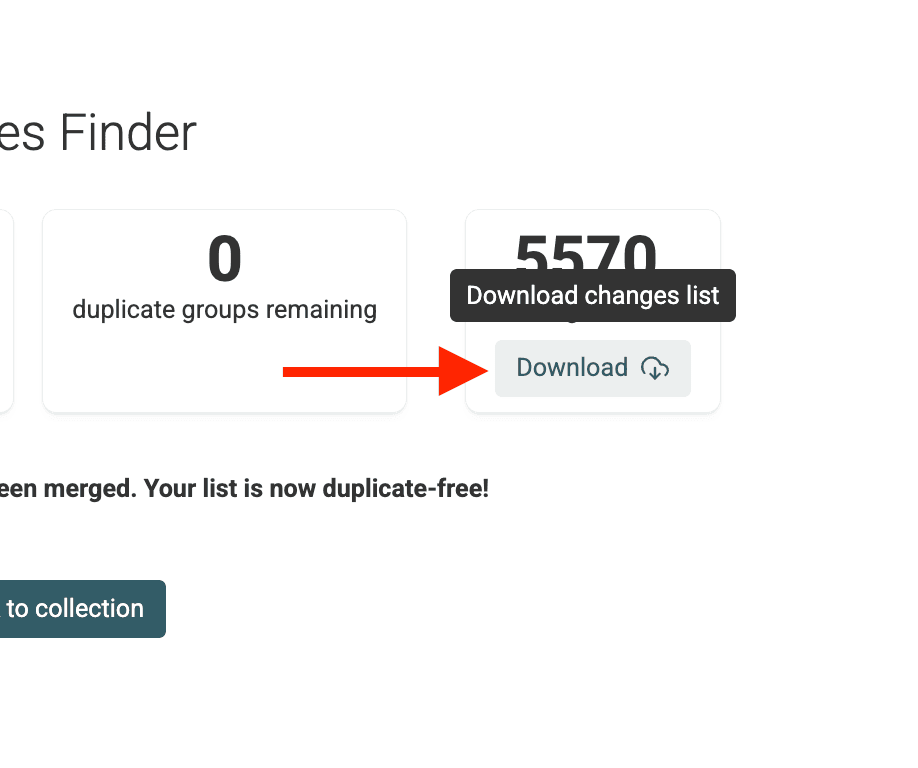
스크립트 실행이 완료되면 Datablist에서 요약 정보와 다운로드 가능한 Changes List를 제공합니다.
외부 시스템에 변경 사항을 다시 적용해야 할 때 유용합니다(예: CRM Lead 수정).
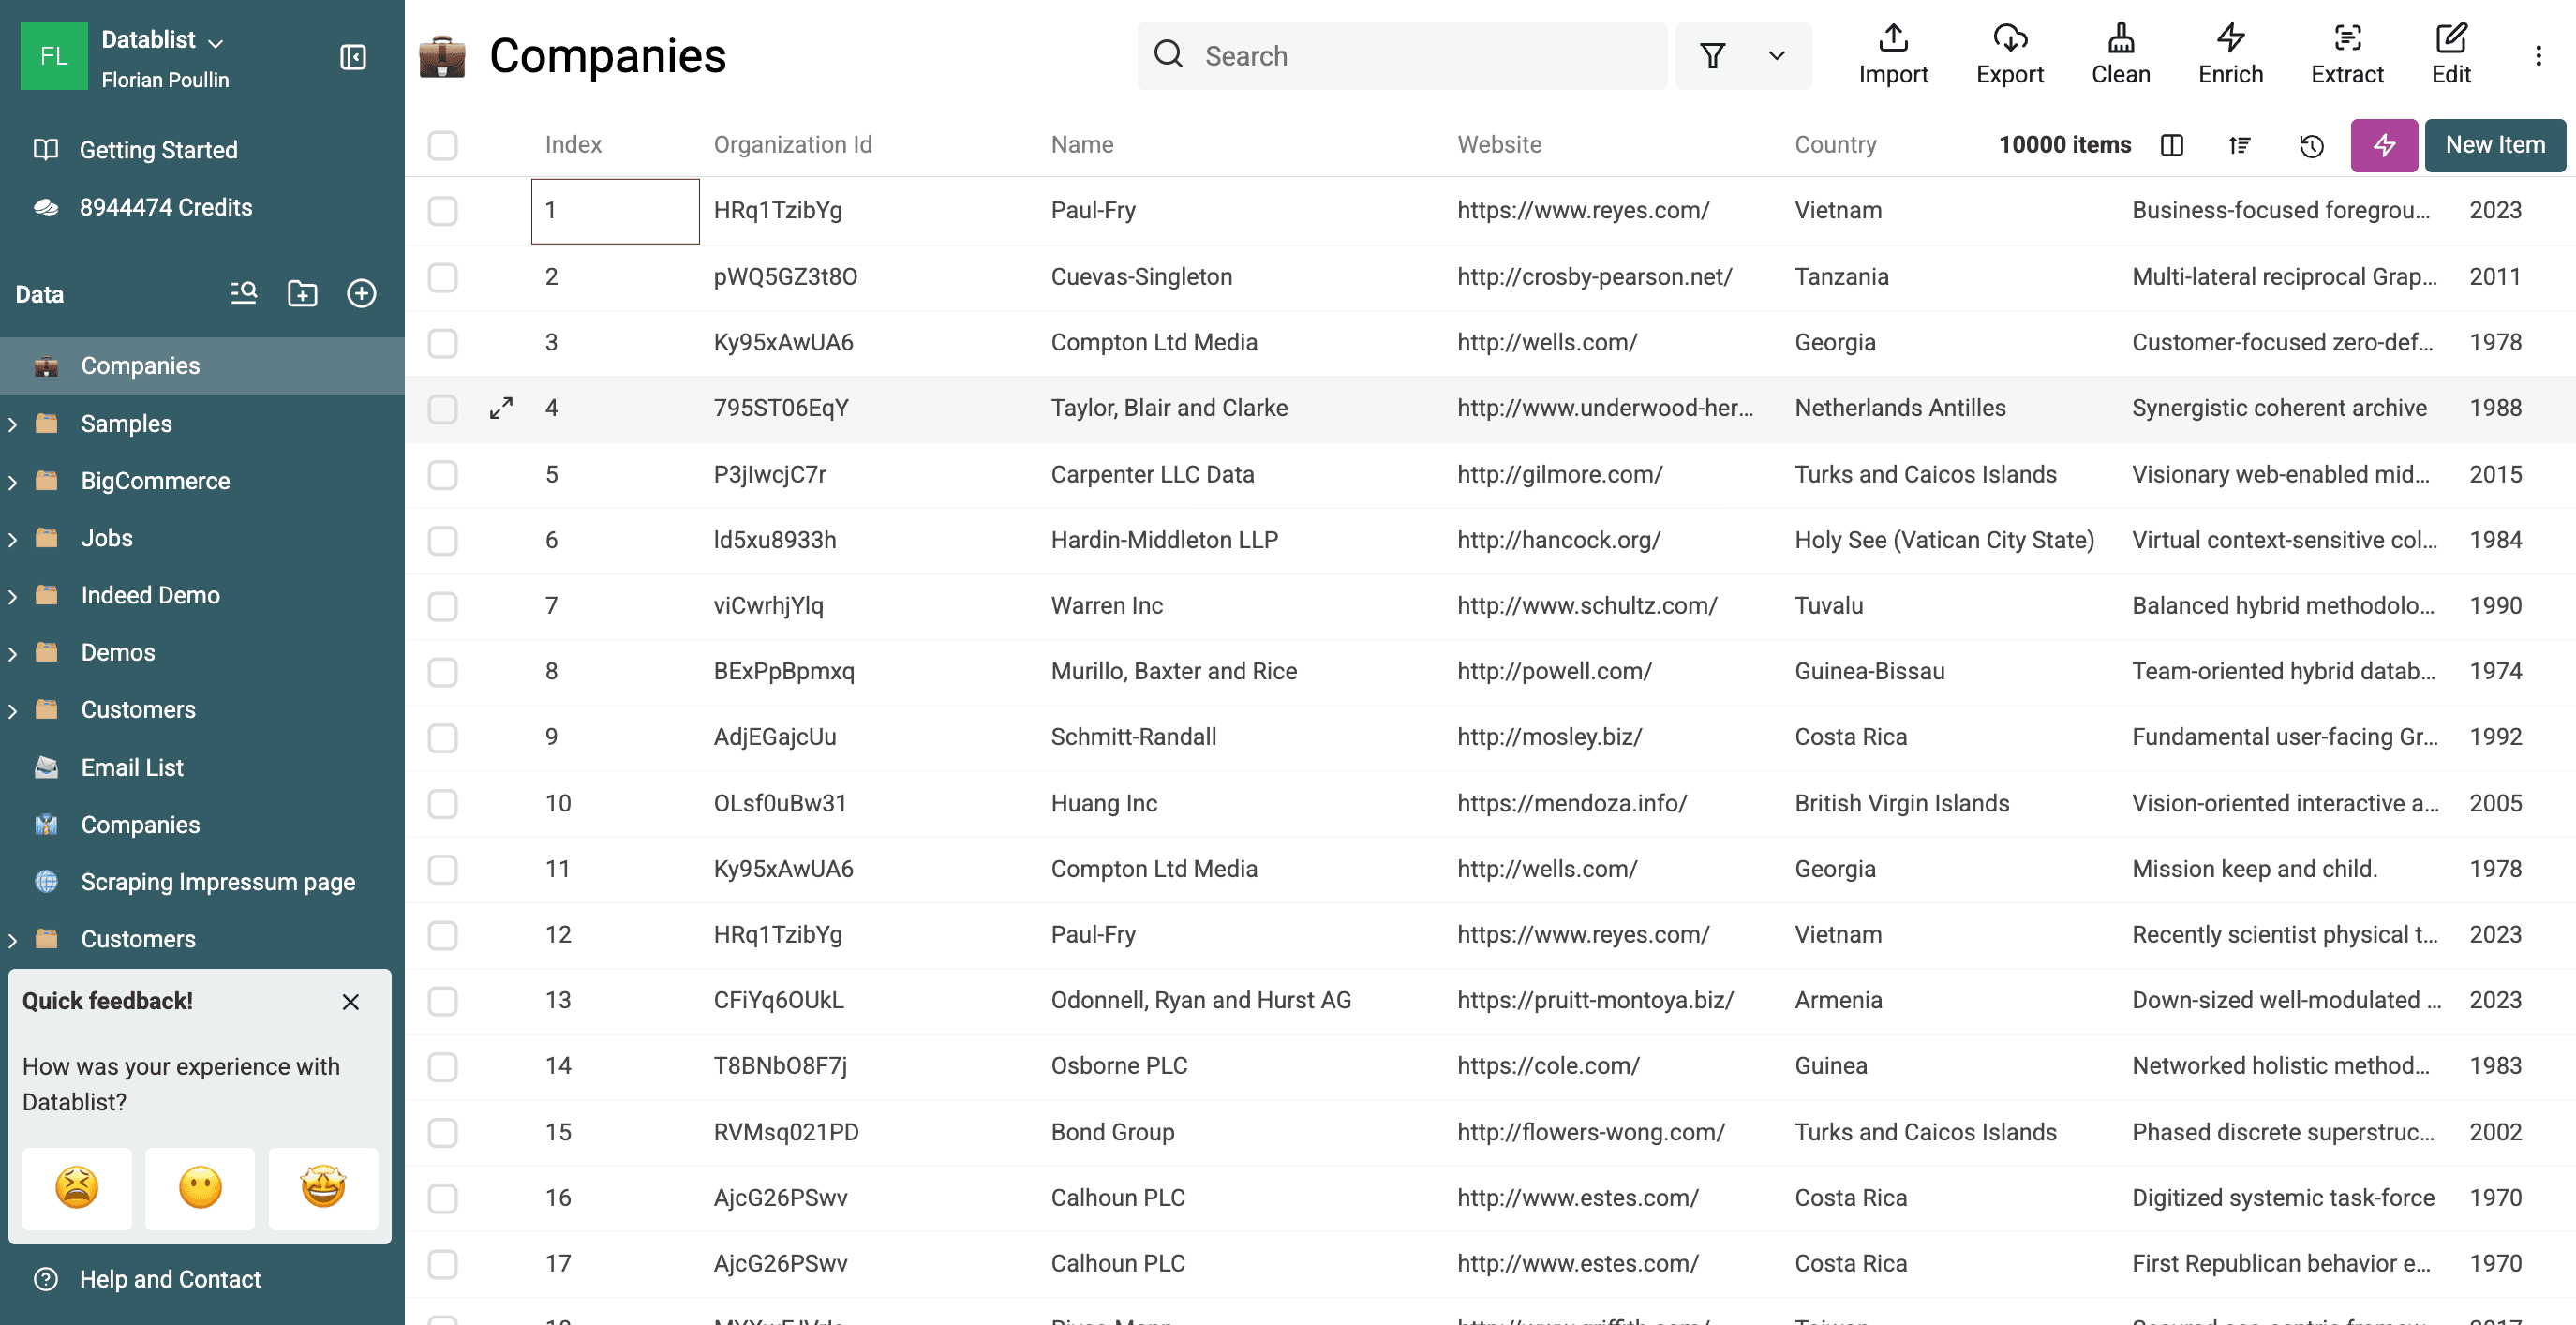
메인 Collection 화면으로 돌아갑니다. 이제 중복 그룹 내 레코드는 서로 분리된 상태로 유지되면서 대상 필드(예: /CompanyName)의 값이 일관되게 정리된 것을 확인할 수 있습니다.
이제 중복 레코드를 병합하지 않고 필드를 성공적으로 정규화했습니다! 🚀
병합 없이 데이터를 정규화하는 활용 사례
전체 병합 대신 특정 필드만 정규화하는 방식은 언제 유용할까요?
- 회사명 또는 연락처 이름 표준화: 최종 병합 전략을 결정하기 전에 중복 레코드에 있는 "Example Ltd", "Example Limited" 또는 "Jon Doe", "Jonathan Doe" 같은 변형을 정리합니다.
- 직책 정리: 일관된 리포팅과 분석을 위해 "VP Marketing", "Vice President Marketing", "Marketing VP" 같은 직책을 하나로 통일합니다.
- 지역 정보 정규화: 중복 주소 레코드에서 국가명("대한민국", "한국")이나 지역 표기("서울시", "서울특별시")를 일관되게 맞춥니다.
- CRM 가져오기 및 업데이트 준비: 중복 데이터를 임시로 유지하더라도, 엄격한 유효성 검사 규칙이 있는 CRM으로 가져오기 전에 주요 필드를 표준화합니다.
- 데이터 감사: 감사나 이력 추적을 위해 원본 중복 레코드를 보존하면서, 주요 식별자를 표준화해 분석을 쉽게 만듭니다.
- 단계적 데이터 클리닝: 전체 병합이나 삭제를 결정하기 전에, 더 큰 데이터 클리닝 워크플로의 일부로 필드를 하나씩 정규화합니다.
중복 레코드를 병합하지 않고 정규화하는 이유
- 레코드의 세부 정보 보존: 개별 중복 레코드를 그대로 유지합니다. 각 레코드의 출처, 특정 상호작용 또는 이력 데이터를 추적해야 할 때 필요할 수 있습니다.
- 불확실한 중복 데이터 처리: 중복 레코드가 완벽하게 일치하지 않을 때 유용합니다. 주요 필드를 정규화하면 다른 데이터가 서로 다른 레코드를 잘못 병합할 위험 없이 일관성을 확보할 수 있습니다.
- 단계적 접근: 데이터 클리닝 과정을 더 세밀하게 관리할 수 있습니다. 먼저 정규화한 뒤 검토를 거쳐 병합이나 삭제 여부를 결정하세요.
- 간편한 작업: 하나의 필드만 일관되게 만드는 데 집중하므로, 중복 레코드의 나머지 데이터에는 영향을 주지 않습니다.
마무리
검증된 그룹부터 시작해 값 선택 규칙을 정의하고 미리보기를 확인하세요. 실행 후에는 행 개수가 그대로인지 확인하고, 최빈값이 여러 개라 건너뛴 그룹도 검토해야 합니다. 그러면 각 소스 레코드를 분리된 상태로 유지하면서 일관된 이름을 내보낼 수 있습니다.
FAQ
-
AI Processing은 Datablist 요금제에 포함되어 있나요? 정규화 스크립트 생성과 실행을 포함한 AI Processing은 Datablist 유료 요금제에서 사용할 수 있습니다. 자세한 내용은 요금제 페이지를 확인하세요.
-
하나의 프롬프트로 여러 필드를 정규화할 수 있나요? 네. 여러 필드를 동시에 정규화하도록 프롬프트를 작성할 수 있습니다. 예: "각 그룹의 최빈값을 사용해 /Company Name 속성을 정규화하세요. 각 그룹의 최빈값을 사용해 /Country 속성을 정규화하세요. 어떤 레코드도 삭제하지 마세요."
-
AI가 프롬프트를 잘못 이해하면 어떻게 하나요? 스크립트를 실행하기 전에 항상 스크립트 설명과 미리보기 결과를 꼼꼼히 확인하세요. 미리보기가 의도와 다르다면 프롬프트를 더 명확하고 구체적으로 수정한 뒤 스크립트를 다시 생성하세요.
-
AI 스크립트로 변경한 내용을 되돌릴 수 있나요? 스크립트를 실행하면 변경 사항이 데이터에 바로 적용됩니다. Datablist는 세션 내에서 최근 작업을 되돌릴 수 있는 undo 기능을 제공하지만, 이처럼 중요한 데이터 변환을 실행하기 전에는 Collection을 복제해 두는 것이 가장 안전합니다. 필요할 때 이전 상태로 되돌릴 수 있기 때문입니다.
-
기본 "Combine conflicting properties" 병합 옵션과 무엇이 다른가요? 기본 "Combine" 옵션은 중복 레코드를 하나의 마스터 레코드로 병합하고, 서로 충돌하는 텍스트 값을 단일 필드에 이어 붙입니다. 반면 AI Processing에 적절한 프롬프트를 입력하면 모든 중복 레코드의 필드를 선택한 하나의 값으로 업데이트하면서도 각 레코드를 분리된 상태로 유지할 수 있습니다. 별도로 지시하지 않는 한 레코드를 병합하거나 값을 이어 붙이지 않습니다.