
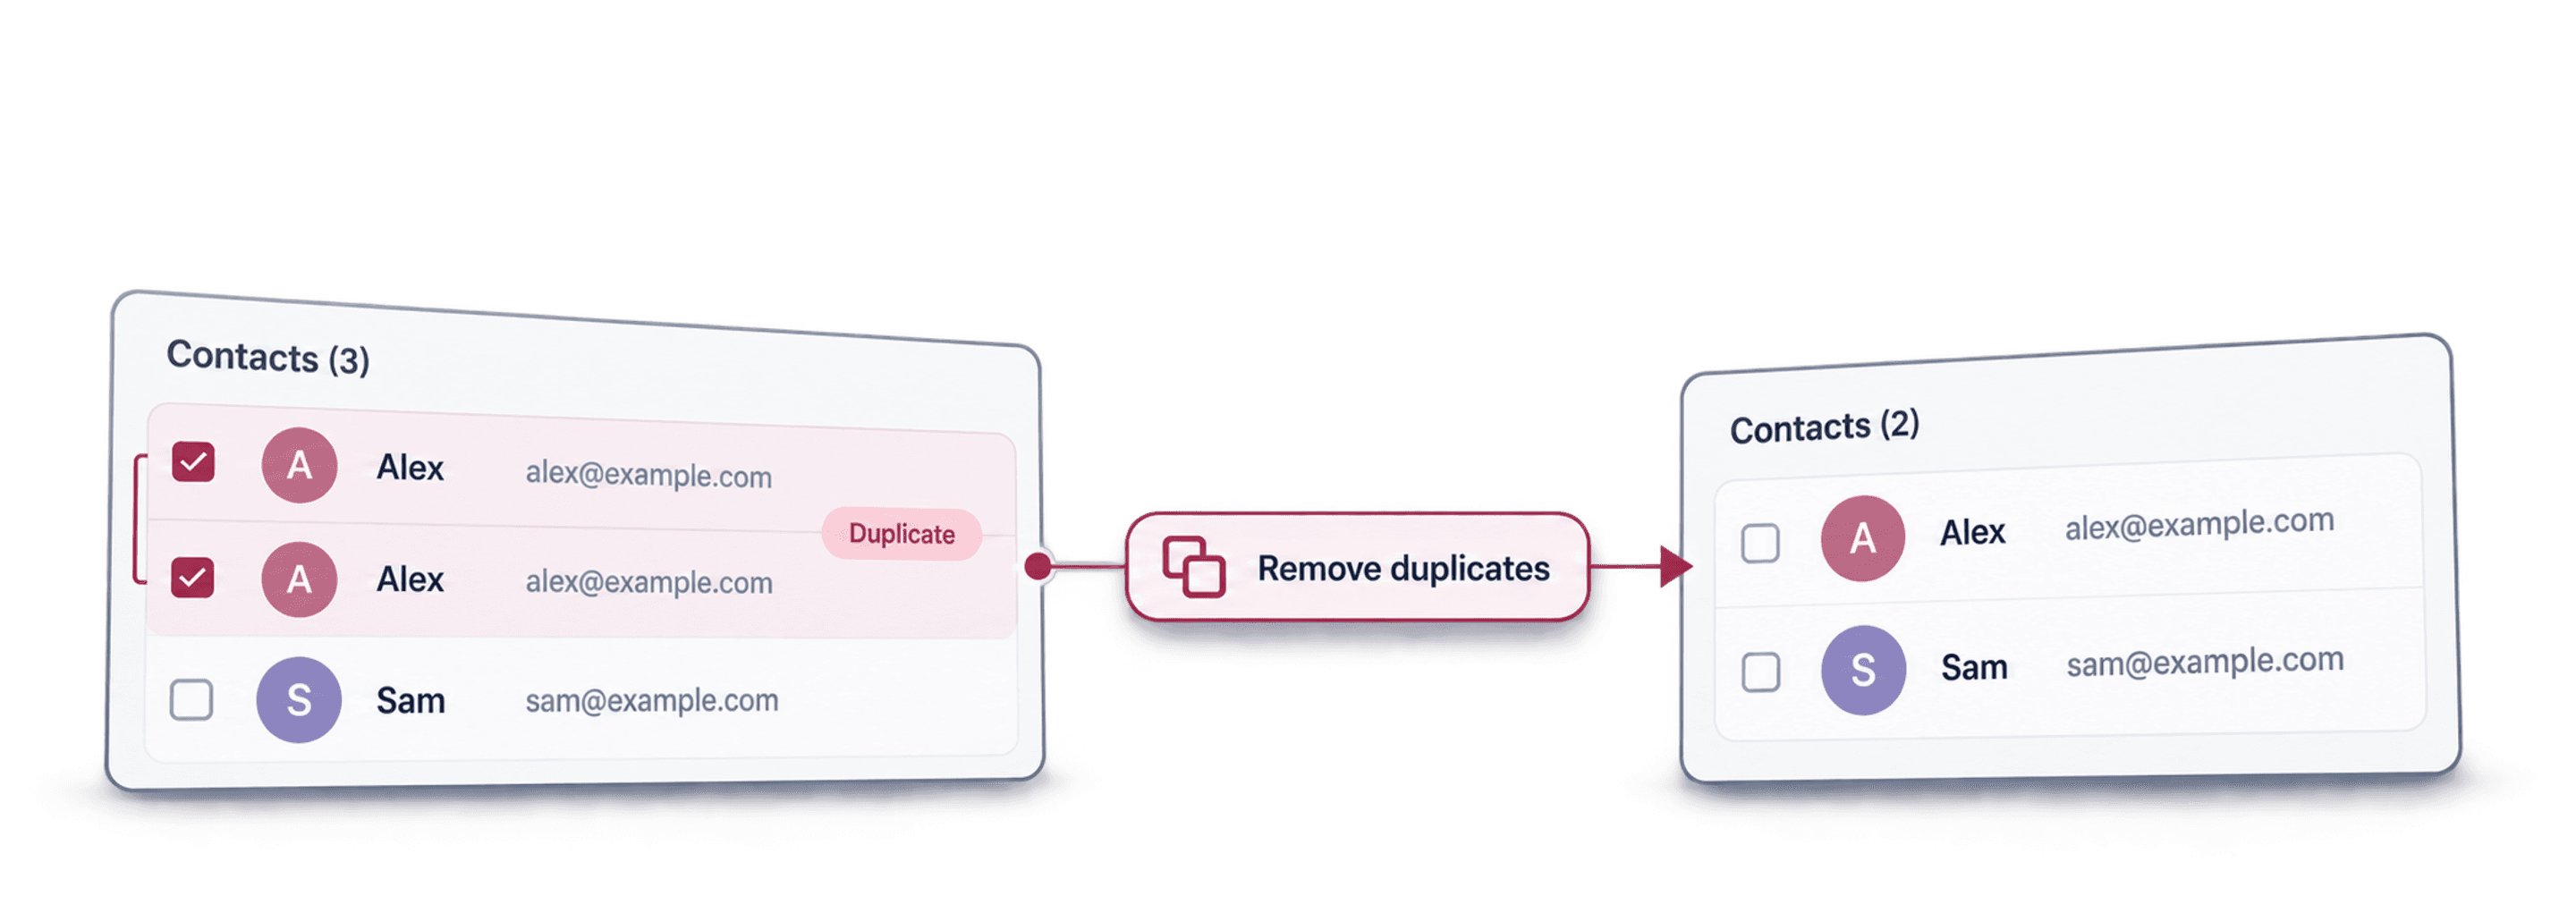
För att deduplicera en lista online börjar du med att välja det fält som identifierar en person, ett företag eller en produkt. Kör först en strikt matchning, granska de föreslagna dubblettgrupperna och slå sedan ihop användbara värden eller ta bort rader som inte tillför något. Då går rensningen snabbt utan att varje snarlikt värde behandlas som en säker matchning.
I Datablist gör du allt i ett och samma arbetsflöde i webbläsaren. Importera en CSV- eller Excel-fil, välj egenskaperna som ska matchas, jämför raderna, granska resultatet och exportera den rensade listan. Dubblettkontrollen är skrivskyddad tills du startar en Remove-, Merge- eller anpassad bearbetningsåtgärd.
I den här guiden använder vi ett nedladdningsbart exempel med 1 000 rader som innehåller exakta kopior, e-postalias, variationer av företagsnamn, olika URL-format, enklare skillnader i telefonnummerformat, stavfel, motstridiga värden och poster som kompletterar varandra.
🔑 Den säkra regeln för deduplicering
Matcha med hjälp av den minsta tillförlitliga identifieraren, men använd hela raden för att avgöra vad som ska behållas.
Deduplicera en enkel lista med värden
Om listan innehåller ett värde per rad sparar du den som en CSV-fil med en kolumn och en rubrik som Email, Domain eller Value. Importera den till Datablist och kör Clean > Remove duplicates på kolumnen med Exact. Granska grupperna, välj posten som ska behållas, bearbeta dubblettraderna och exportera sedan de återstående värdena.
En exempellista med alpha.example, beta.example och alpha.example ska till exempel innehålla ett alpha-värde och ett beta-värde efter att den upprepade raden har tagits bort. Det här är ett illustrativt exempel på input och output, inte ytterligare en mätning från det nedladdningsbara exemplet.
Jag skulle använda den här metoden för en lista med identifierare. Om filen innehåller flera kolumner behöver du i stället hantera dubblettposter: när en rad tas bort försvinner även radens övriga värden. Använd arbetsflödet för sammanslagning nedan om en upprepad e-postadress har ett användbart telefonnummer eller en anteckning på en annan rad.
Håll tomma identifierare separerade. I standardjämförelsen för valda egenskaper skapar en tom textidentifierare ingen matchning. Om du behöver radera tomma rader bör du göra det uttryckligen i ett separat rensningssteg, i stället för att förvänta dig att dedupliceringen ska avgöra vad raderna representerar.
Välj vad som gör en post unik
Börja inte med matchningsalgoritmen. Börja med att definiera entiteten.
Kontakter, företag, produkter och transaktioner behöver olika identifierare:
| Lista | Starka identifierare att börja med | Användbar andra matchning |
|---|---|---|
| Kontakter | E-post, telefonnummer, LinkedIn URL | Fullständigt namn plus företag |
| Företag | Webbdomän, företags-ID | Normaliserat företagsnamn |
| Produkter | SKU, EAN, GTIN, produkt-URL | Produktnamn plus varumärke |
| CRM-leads | E-post, telefonnummer, CRM-ID | Namn plus företagsdomän |
| Beställningar | Order-ID | Kund-ID plus orderdatum |
En enda matchning hittar sällan alla dubbletter. En kontakt kan ha samma e-postadress på två rader, medan en annan har bytt e-postadress men behållit samma telefonnummer. Kör separata matchningar för olika identifierare i stället för att skapa en regel som omfattar alla egenskaper.
Till exempel:
- Matcha kontakter efter e-postadress.
- Bearbeta de granskade grupperna.
- Normalisera telefonnumren och kör sedan en Exact-kontroll på den rensade egenskapen.
- Kör en försiktig fuzzy-kontroll på fullständigt namn plus företag.
Välj regeln för tomma värden innan du lägger till fält i samma kontroll. Med Value required kan en identifierare som saknas utesluta en relevant kandidat.
Med Match on empty value får egenskaper som är tomma i båda posterna 100 % och kan höja genomsnittet: en matchande e-postadress plus ett efternamn som saknas ger 87,5 %. Om du lägger till tre egenskaper som är tomma i båda posterna stiger resultatet till 95 %. Läs exemplet på poängsättning av tomma värden innan du utgår från att fler kolumner ger starkare bevis.
Använd de särskilda guiderna när identifieraren behöver en egen normalisering:
- Deduplicera e-postadresser och alias
- Matcha dubbla företagsnamn
- Deduplicera ett fält med flera värden
- Normalisera lokala och internationella telefonnummer
Ladda ned exempellistan med 1 000 rader
Ladda ned CSV-filen för dedupliceringsdemot. Den innehåller 1 000 rader som representerar 800 avsiktligt utformade entiteter.
Filen innehåller flera typer av testfall:
| Utformat testfall | Dubblettgrupper | Matchning |
|---|---|---|
| Exakta kopior av hela rader | 5 | All Properties med Exact |
| E-postalias och omslutna adresser | 100 | Email med Smart och Email-processorn |
| Variationer av företag och URL | 50 | Company Name- eller URL-bearbetning |
| Enklare amerikanska skillnader i telefonnummerformat | 25 | Phone med Smart, endast formatering |
| Kontrollerade stavfel i namn | 15 | Jaro-Winkler eller Levenshtein |
| Fonetiska variationer av förnamn | 5 | Metaphone |
| Poster utan avsiktligt skapad dubblett | 600 | Ska förbli separata |
Det här är facit för de avsiktligt skapade testfallen, inte ett löfte om att varje fuzzy-tröskel ger samma resultat. Avståndsbaserad matchning kan ta med fler kandidater när tröskeln är låg. Granska grupperna innan du bearbetar dem.
Här är tre par från filen:
| Användningsfall | Första lagrade värdet | Andra lagrade värdet |
|---|---|---|
| E-postalias | felix.patel.605@company-0605.example | felix.patel.605+newsletter@company-0605.example |
| Företag och URL | Redwood 0727, Inc.https://www.redwood-0727.example/ | Redwood 0727 Group LLChttp://redwood-0727.example/about?utm_source=event |
| Enkel telefonnummerformatering | +1 (202) 555-0768 | 1 202 555 0768 |
Raderna skiljer sig även åt i fält som befattning, ägare, status, omsättning, källa, taggar och anteckningar. Dessa konflikter gör filen användbar för att testa regler för huvudposter och vilka fältvärden som ska överleva en sammanslagning.
Importera listan till Datablist
Öppna Datablist och importera CSV- eller Excel-filen till en collection. En collection fungerar som ett strukturerat kalkylblad: raderna är objekt och kolumnerna är egenskaper.
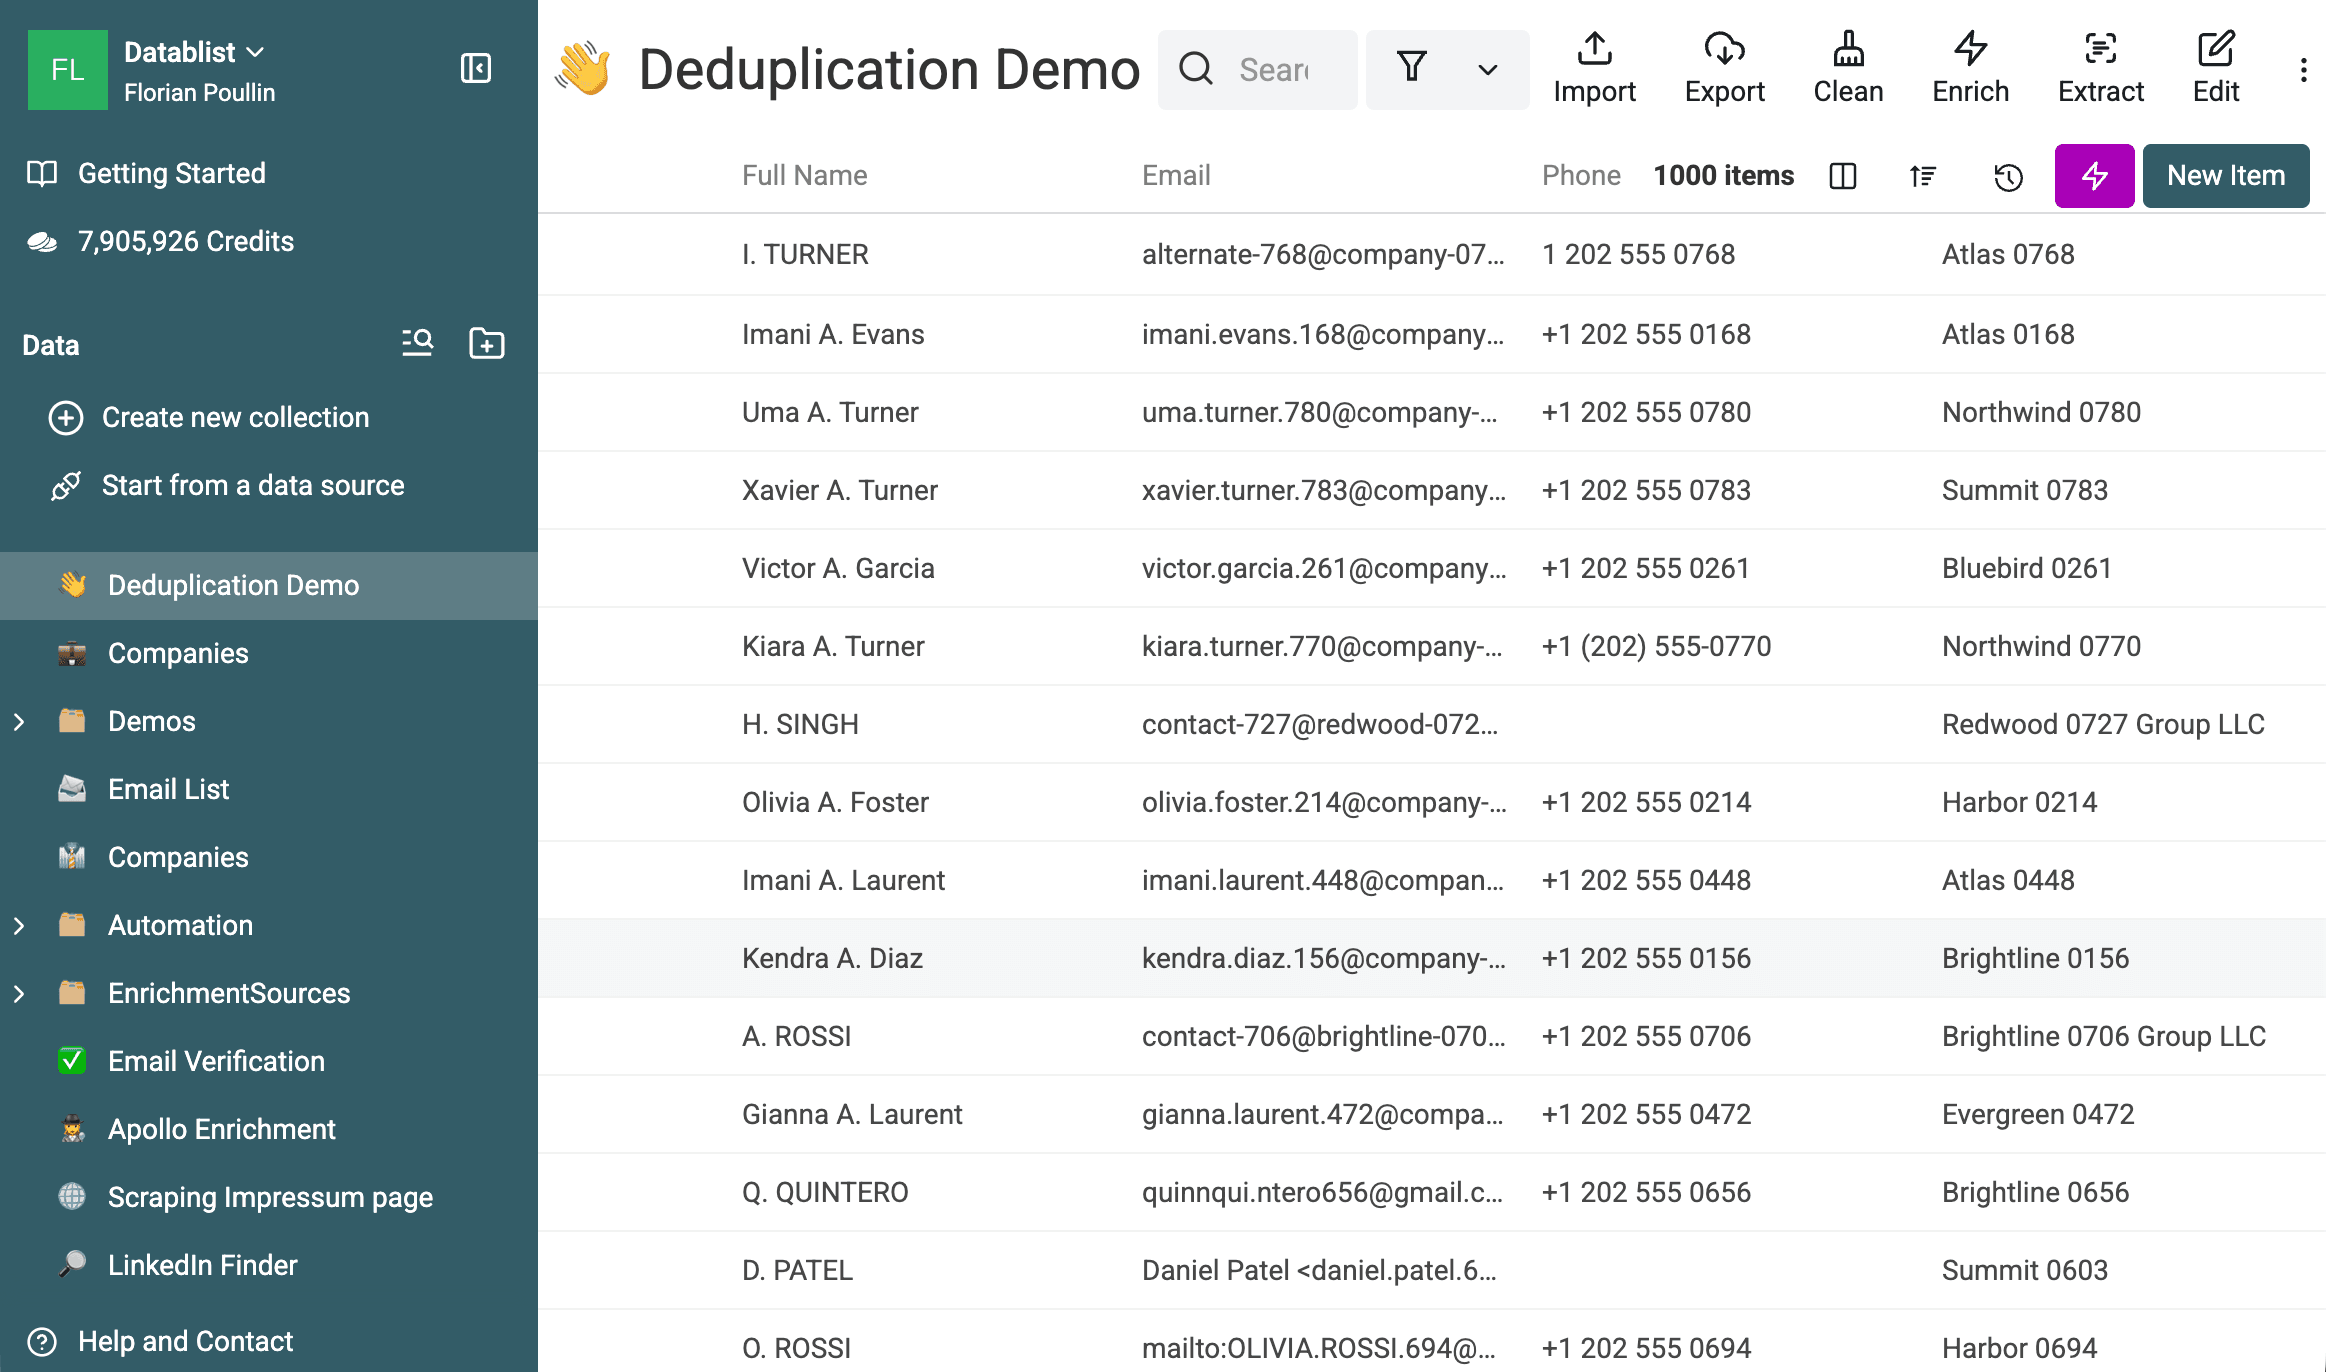
Kontrollera de identifierade egenskapstyperna under importen:
- Kolumner med e-postadresser ska använda typen Email.
- Webbplatskolumner ska använda URL.
- Telefonkolumner ska använda Phone.
- Kolumner med omsättning eller antal ska använda Number.
- Aktivitets- och skapandedatum ska använda DateTime.
Behåll kolumnerna för ID, källa, ägare, anteckningar och status i collectionen. De hjälper dig att välja rätt post och kontrollera vad som bevaras vid sammanslagningen.
Kör Exact-, Smart- och fuzzy-matchning
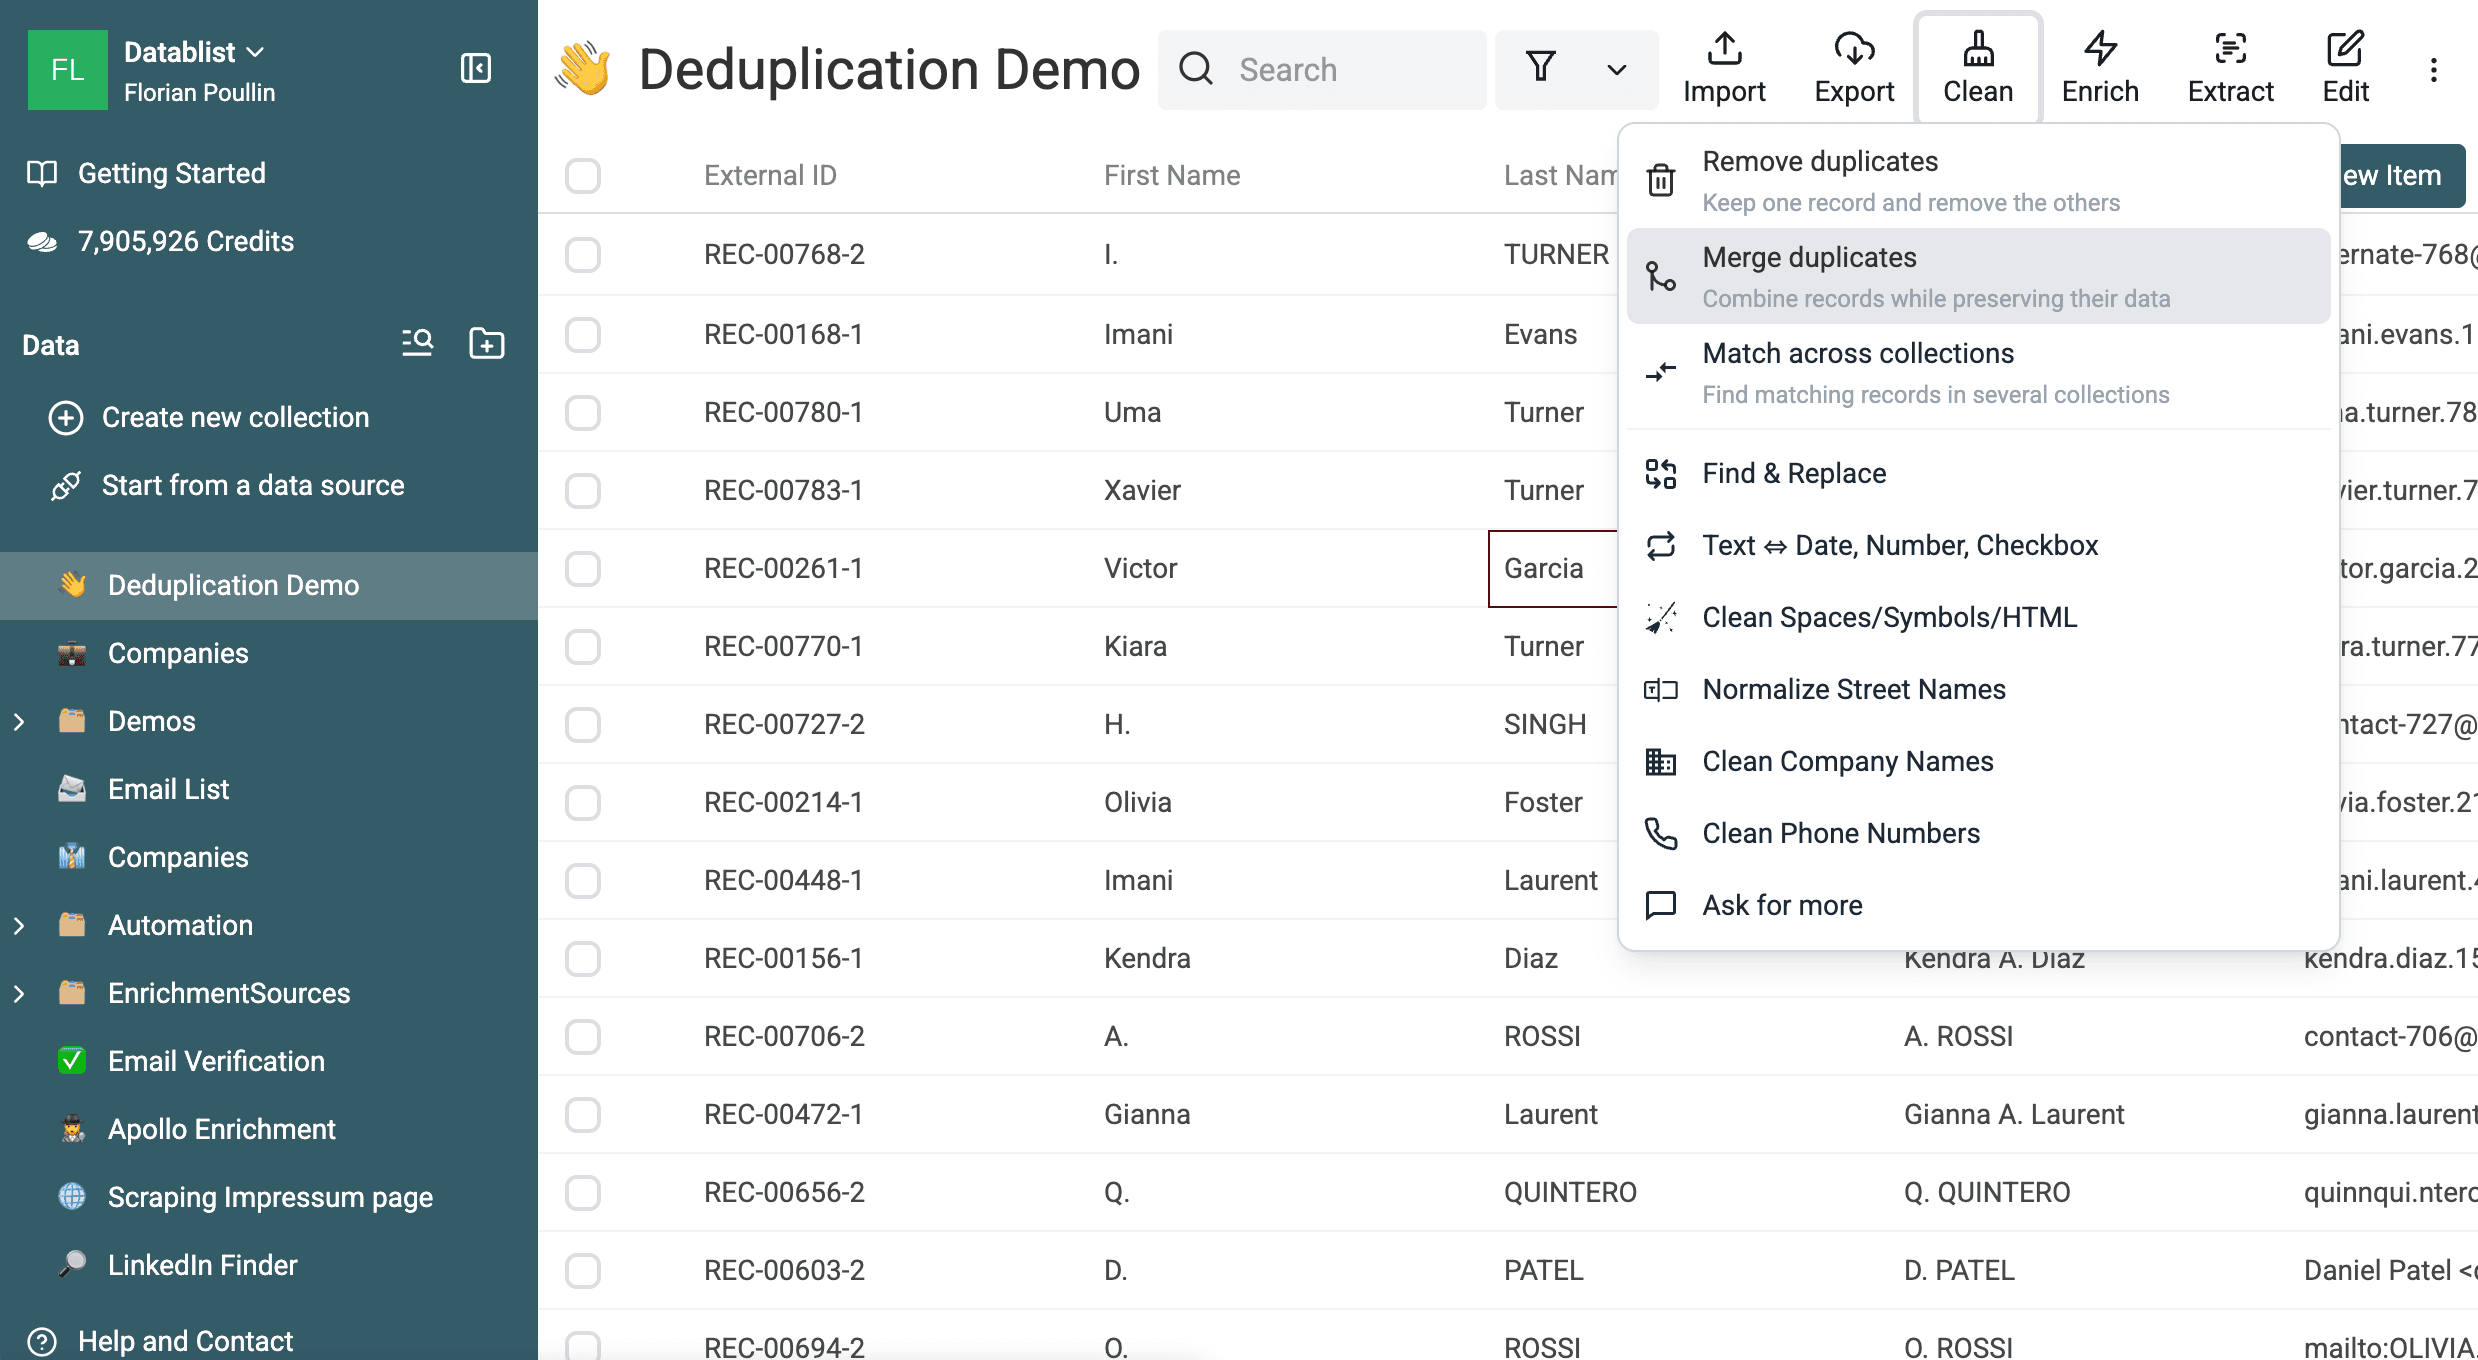
Öppna Clean och välj den åtgärd som passar ditt mål:
- Remove duplicates när de sekundära raderna kan tas bort.
- Merge duplicates när raderna innehåller information som är värd att bevara.
- Match across collections när posterna finns i separata collections.
De två första åtgärderna använder samma detekteringsmotor. De öppnar resultatarbetsytan med olika bearbetningslägen valda.
Börja med Exact-matchning
Använd All Properties med Exact för att hitta rader som har kopierats två gånger utan ändringar. Använd Selected Properties när ett fält, till exempel ett externt ID, måste vara identiskt.
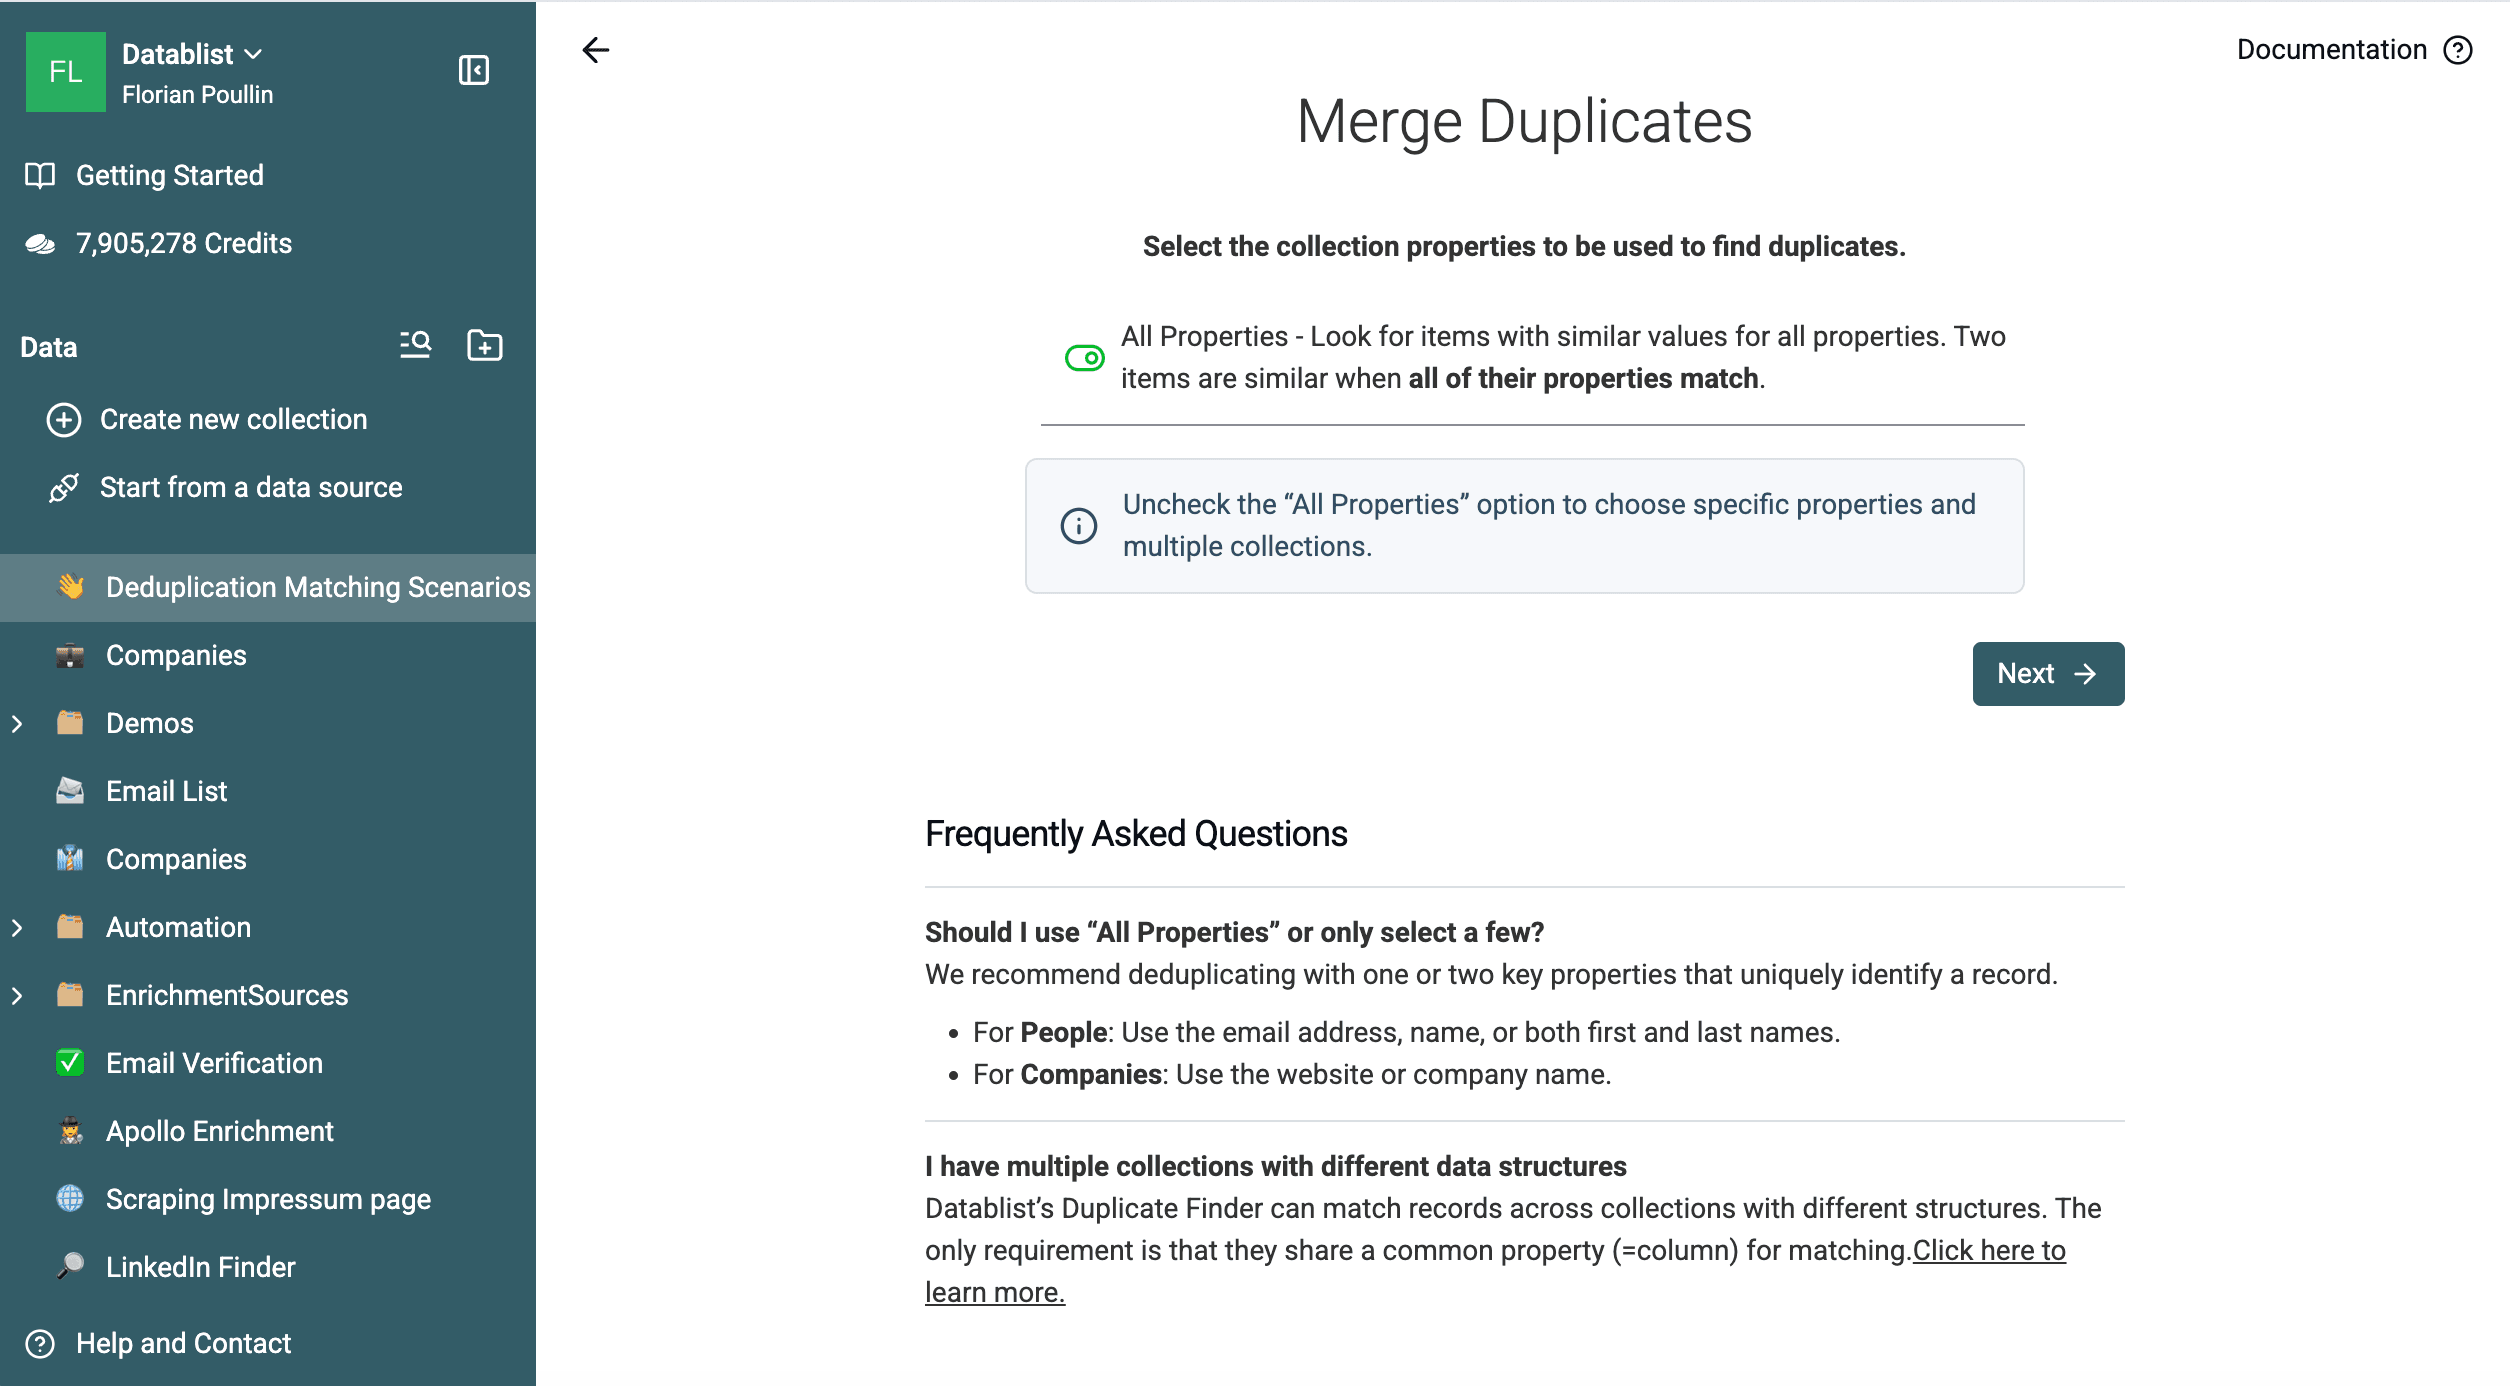
I exemplet med 1 000 rader ger den här matchningen fem dubblettgrupper. Varje grupp innehåller två rader med samma värden i alla egenskaper.
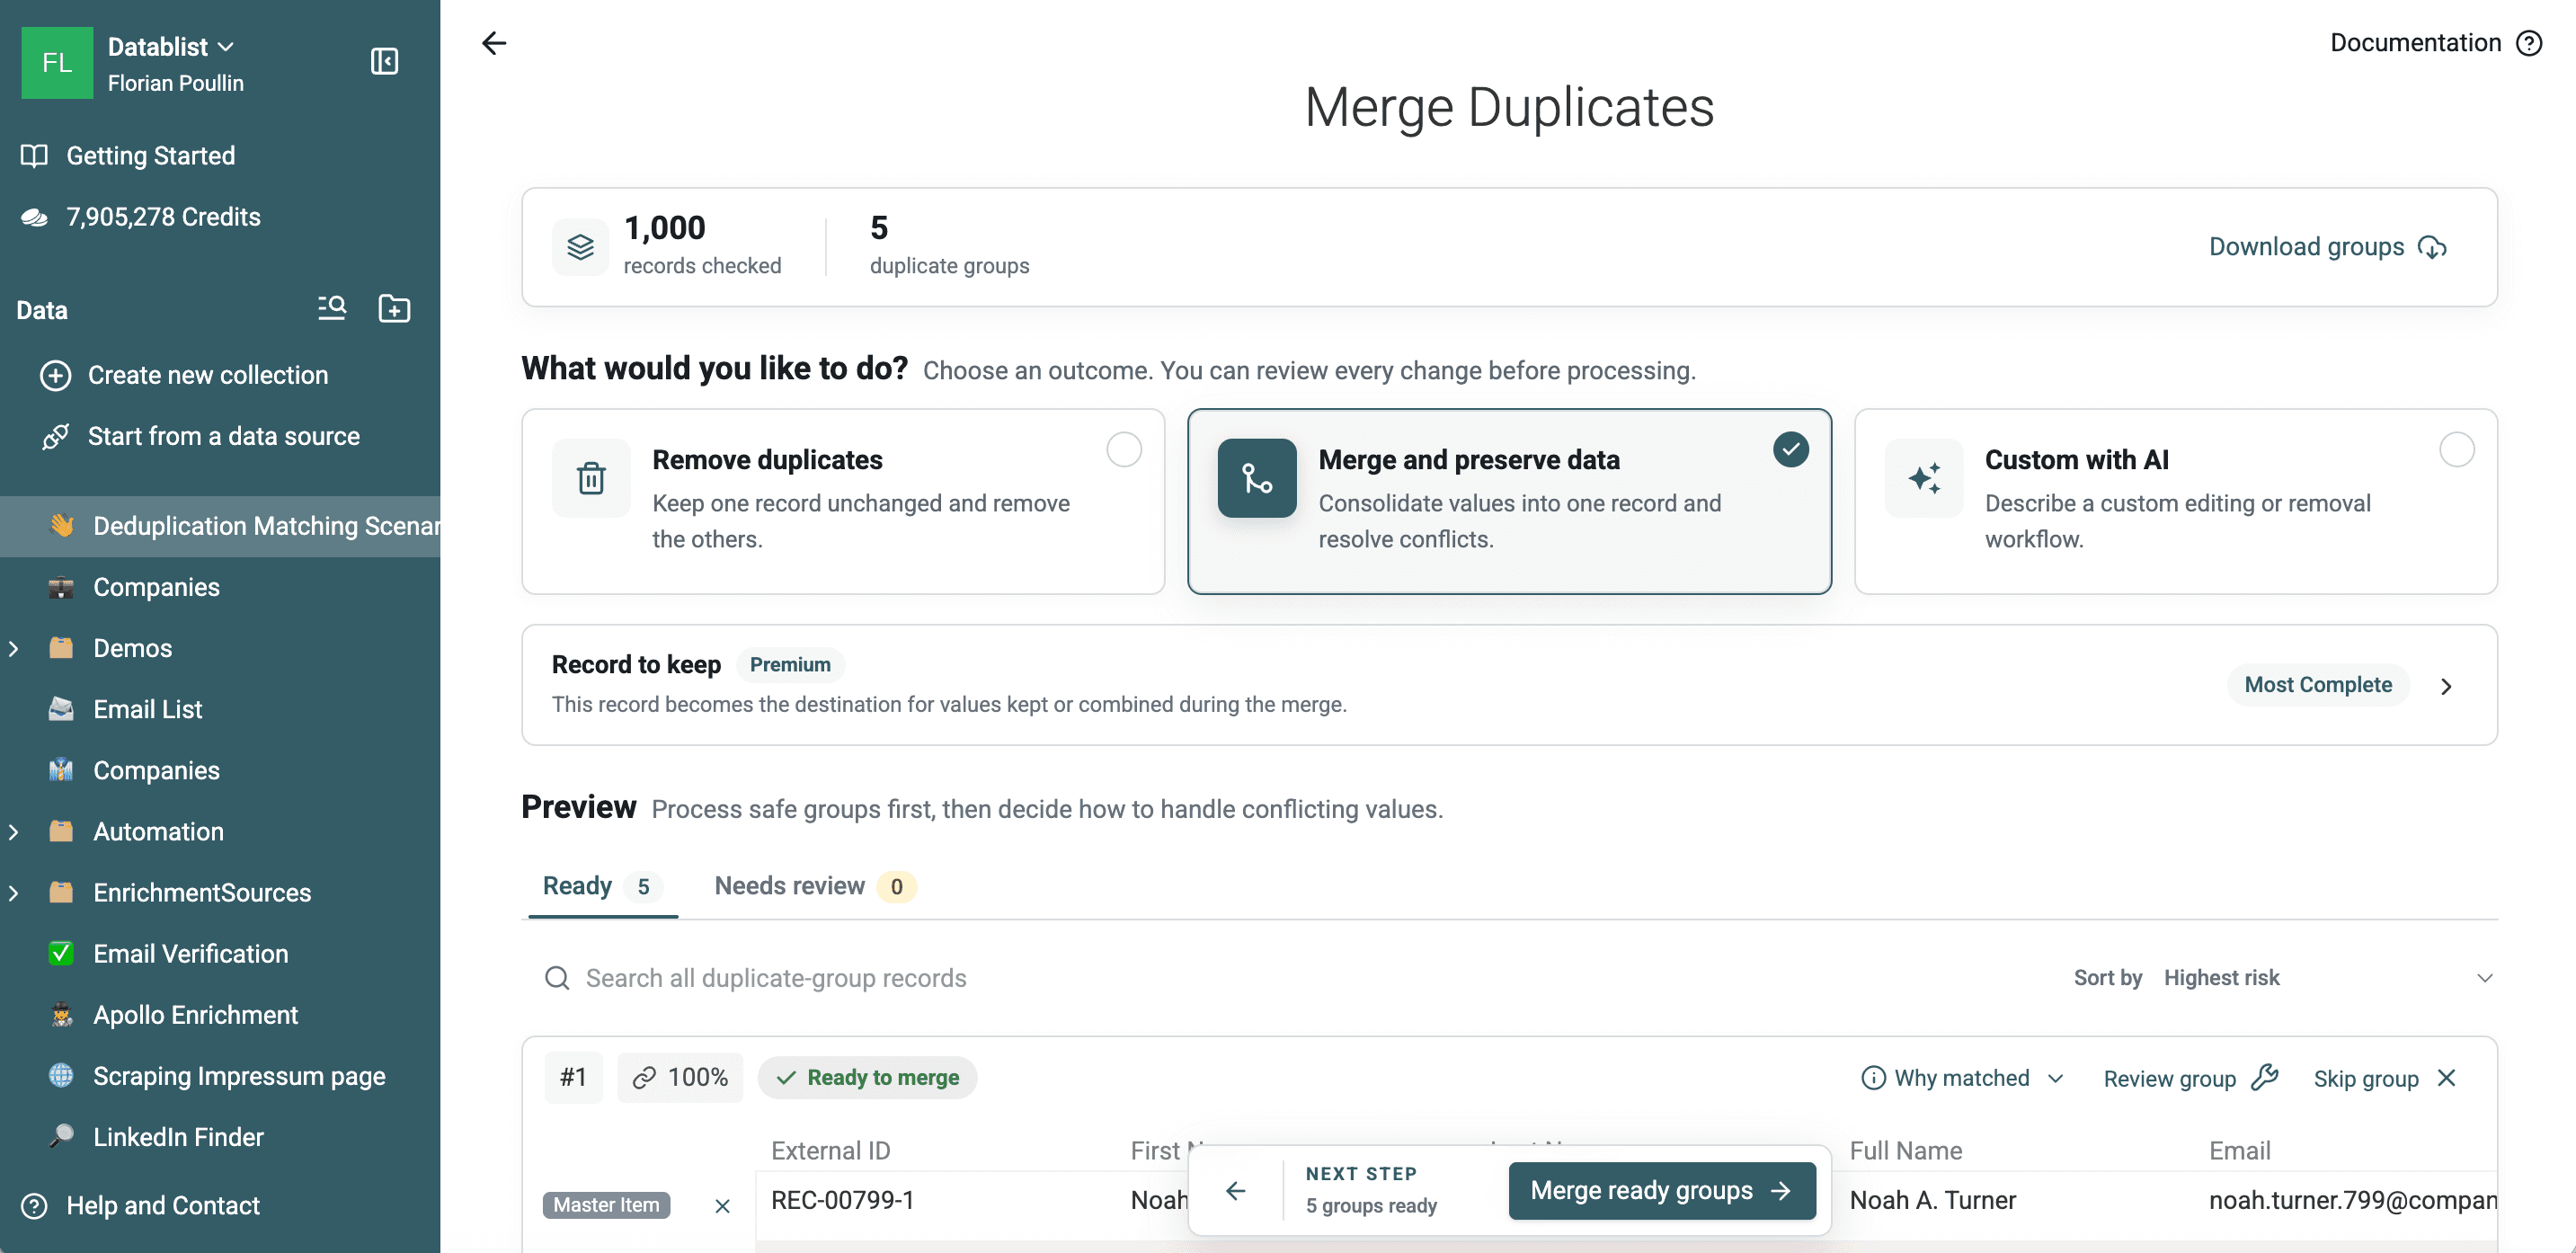
Exact är det säkraste första steget eftersom varje matchning som behålls uppfyller en strikt jämförelse. Metoden hittar inte Acme Inc. och Acme, ett formaterat telefonnummer eller ett e-postalias när de lagrade värdena skiljer sig åt.
Besökare utan konto kan köra en Exact-kontroll efter dubbletter. Med ett kostnadsfritt konto får du tillgång till Smart-jämförelse och de övriga funktionerna i Free-planen.
Använd Smart-matchning för affärsdata
Smart-matchning standardiserar värden inför jämförelsen utan att skriva om de lagrade cellerna. Välj en processor som passar egenskapen:
- Email hanterar versaler och gemener, omgivande blanksteg, plus-alias, punkter i Gmail-adresser,
googlemail.com, adresser med visningsnamn ochmailto:-värden. - URL kan ignorera protokoll och avslutande snedstreck, med valfria inställningar för subdomäner, sökvägar och query-parametrar.
- Phone ignorerar formateringstecken. Den validerar inte nummer, använder ingen Country-egenskap och härleder inte en landskod som saknas.
- Company Name tar bort vanliga juridiska, affärsmässiga och geografiska termer.
- Text ignorerar accenter, mellanslag, skiljetecken, symboler, skiftläge och ordföljd.
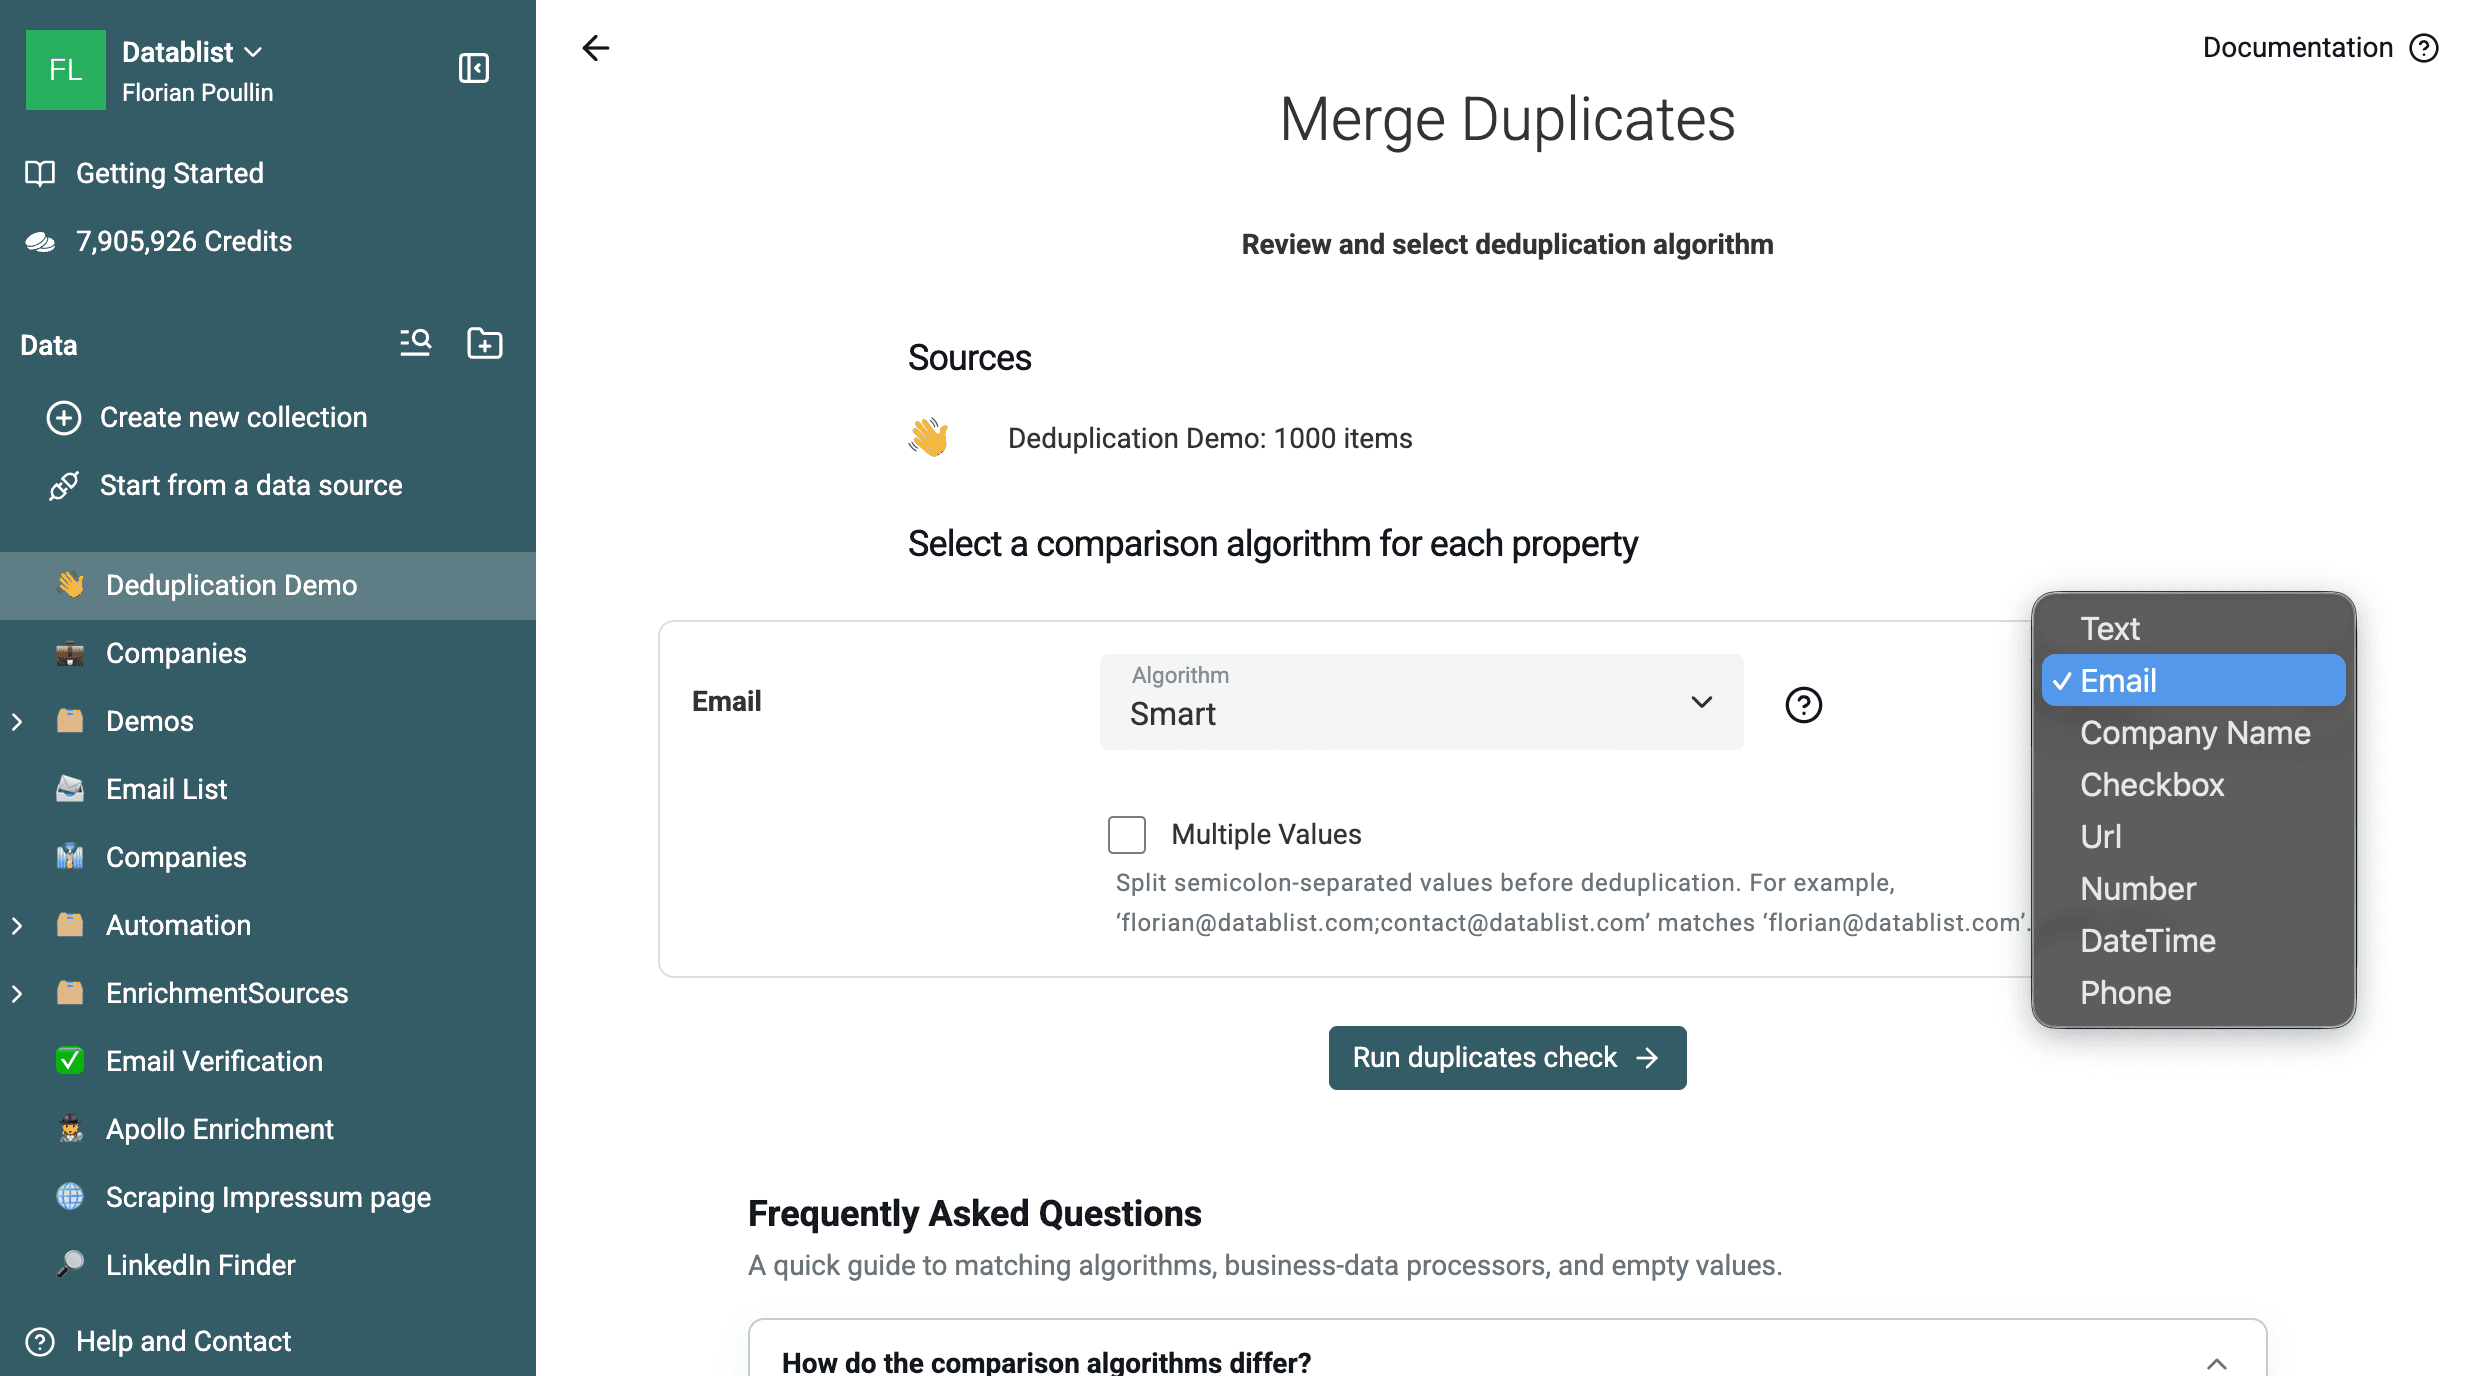
Company Name-processorn, matchning av flera värden och avancerade algoritmer kräver en betalplan. Exact och Smart är tillgängliga för matchning inom en enda collection i Free-planen, men Smart kräver ett kostnadsfritt konto.
Aktivera Multiple Values när en cell innehåller flera semikolonseparerade identifierare. Datablist jämför varje del och matchar egenskapen när minst ett par stämmer överens. En cell med primary@example.com;shared@example.com kan till exempel matcha en annan cell som innehåller shared@example.com.
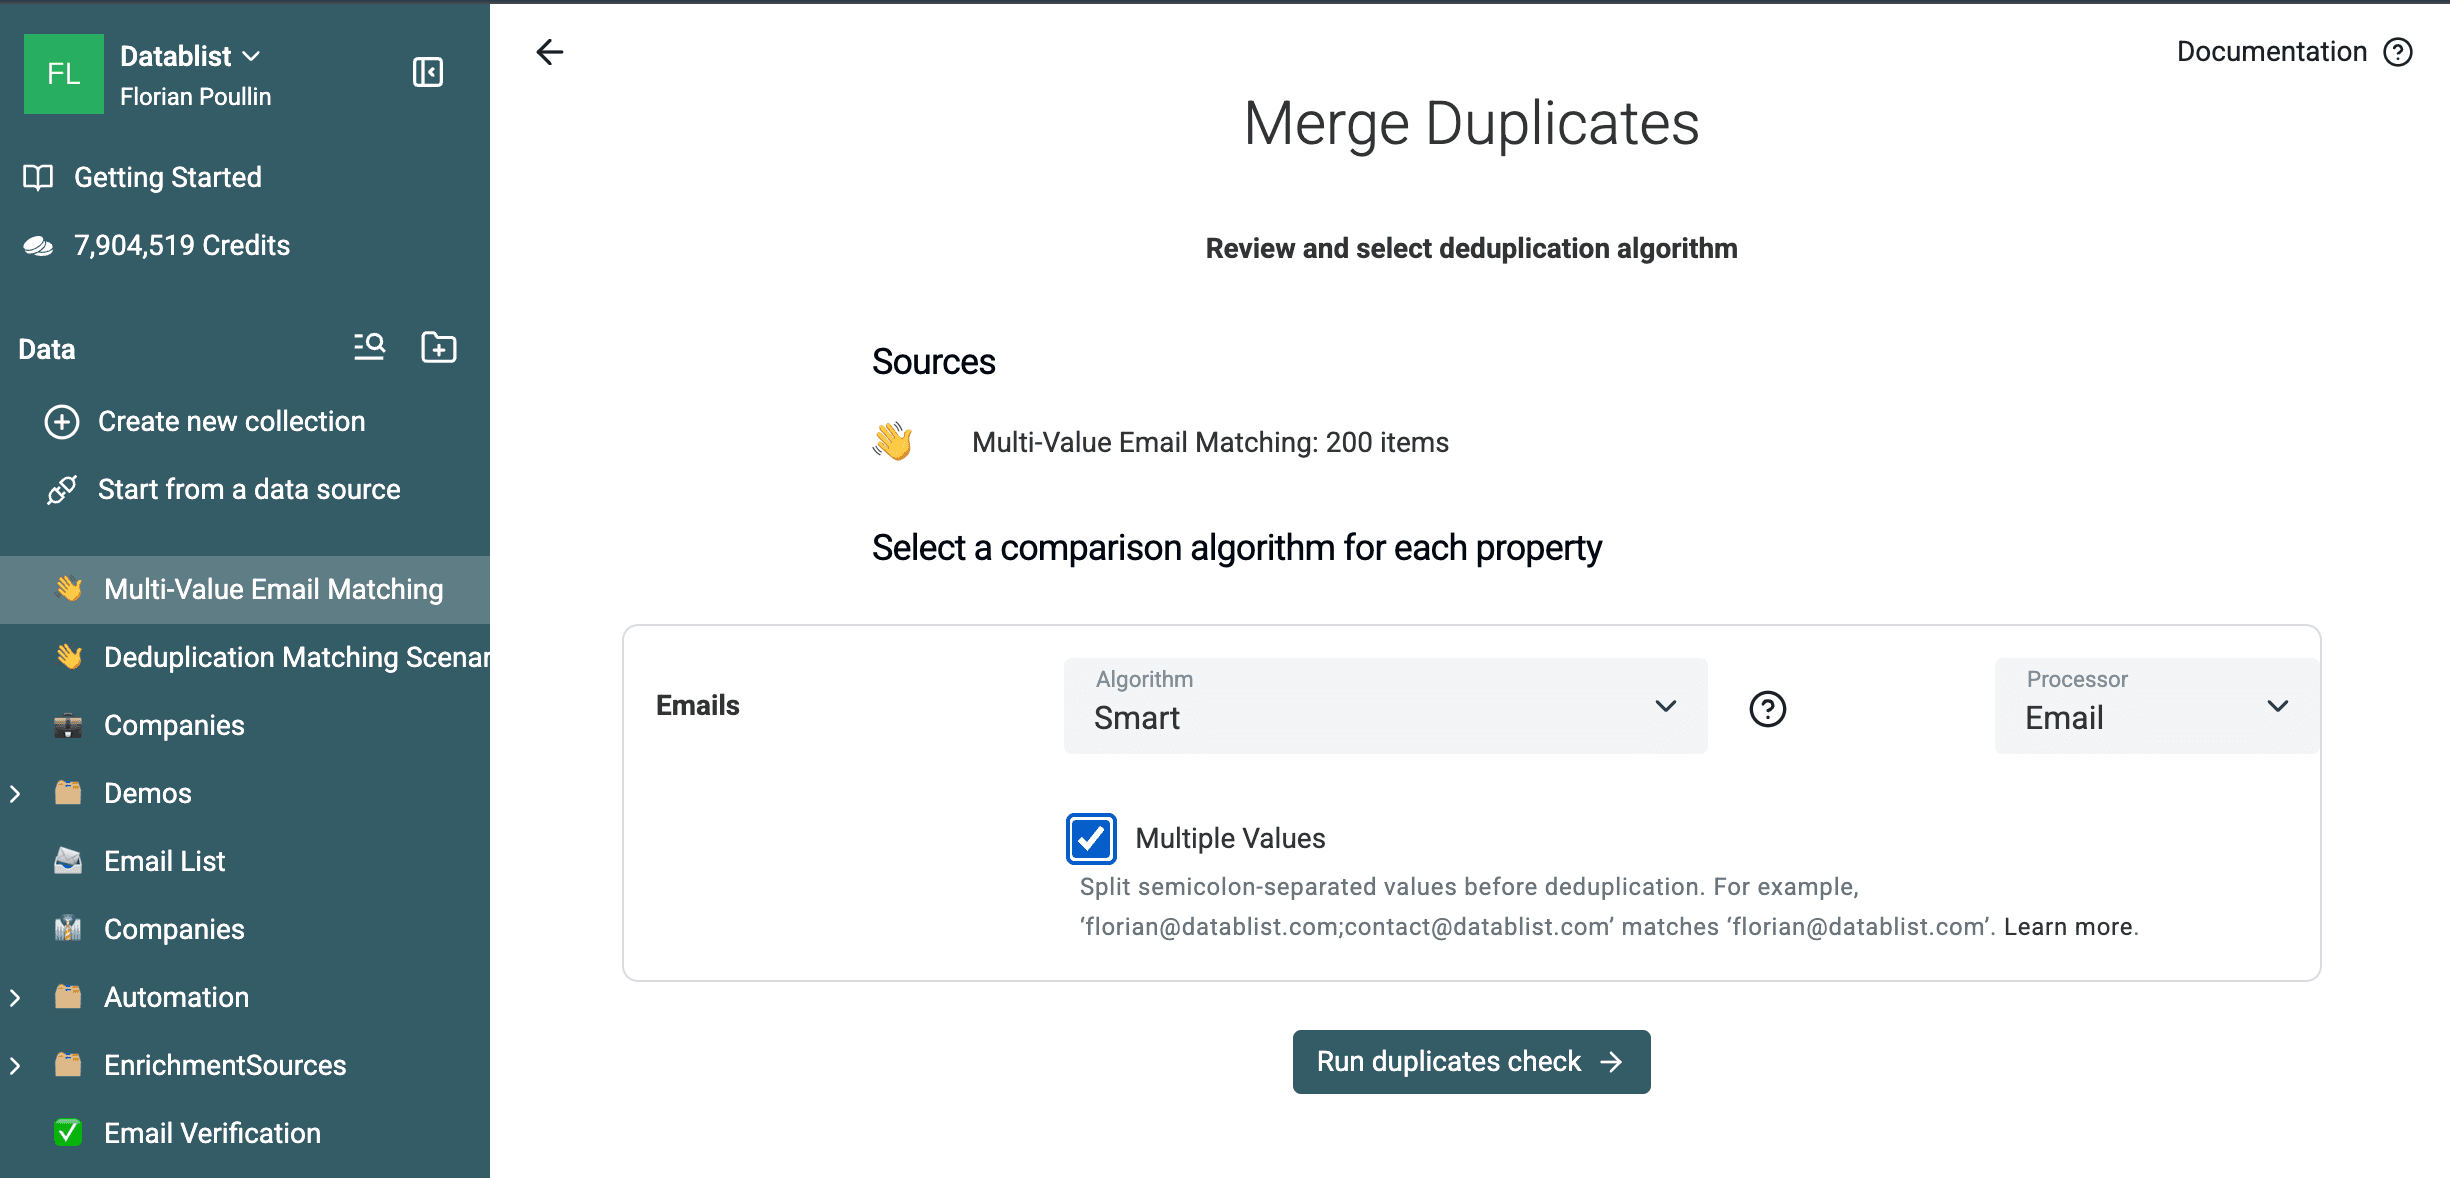
I det särskilda exemplet med 200 rader gav den här konfigurationen 60 grupper med två rader vardera. En kontroll mot facit hittade samtliga 60 avsiktligt skapade par och uteslöt alla 80 kontrollposter. Följ arbetsflödet för deduplicering av fält med flera värden för att få exempelfilen, resultatfilen i CSV-format och besluten för sammanslagning.
Den här e-postmatchningen gav 105 grupper med två rader: 100 avsiktligt skapade par för e-postnormalisering och de fem exakta kopiorna, som också delar samma e-postadress.
Normalisera telefonnummer före matchning
Smart Phone-processorn är användbar i ett begränsat fall: värden med samma siffror men olika mellanslag, parenteser, bindestreck eller symboler. Den kan matcha (415) 555-0123 med 4155550123.
Den kan inte avgöra att ett lokalt och ett internationellt nummer är samma nummer. Till exempel behöver 06 12 34 50 08 och +33 6 12 34 50 08 landsinformation innan de kan jämföras.
Använd Phone Number Cleaner före telefonbaserad deduplicering:
- Mappa den obehandlade egenskapen
Phone. - För en lista med ett enda land väljer du landet under Local Phone Countries. För en lista med flera länder aktiverar du Define country per item och mappar egenskapen
Country. - Skriv enrichment-resultatet till
Clean Phone Numberutan att skriva över det ursprungliga värdet. - Granska misslyckade eller tomma resultat. De ska inte ingå i telefonbaserad matchning.
- Kör Duplicates Finder på
Clean Phone Numbermed Exact.
Ladda ned det särskilda telefonexemplet med 200 rader. Det innehåller 50 par med lokala och internationella nummer från USA, Frankrike, Storbritannien, Tyskland och Spanien samt 100 kontrollposter som inte ska matcha. Validering med produktionslogiken i Phone Number Cleaner gav ett normaliserat telefonnummer för samtliga 200 rader. De 50 avsiktligt skapade paren resulterar i 50 gemensamma internationella värden, medan kontrollposterna förblir unika.
Det här förbehandlingssteget validerar även telefonnumrets format. Behåll de ursprungliga egenskaperna Phone och Country bredvid det rensade resultatet så att du kan granska varje post före sammanslagningen. Läs vad normalisering av telefonnummer innebär för att förstå landskodernas och de internationella värdenas betydelse.
Kör en separat matchning på Website för företagsposter. Välj Smart med URL-processorn. Aktivera bara Ignore Subdomain, Ignore Path och Ignore Query Params när dessa URL-delar inte ska identifiera olika företag eller platser.
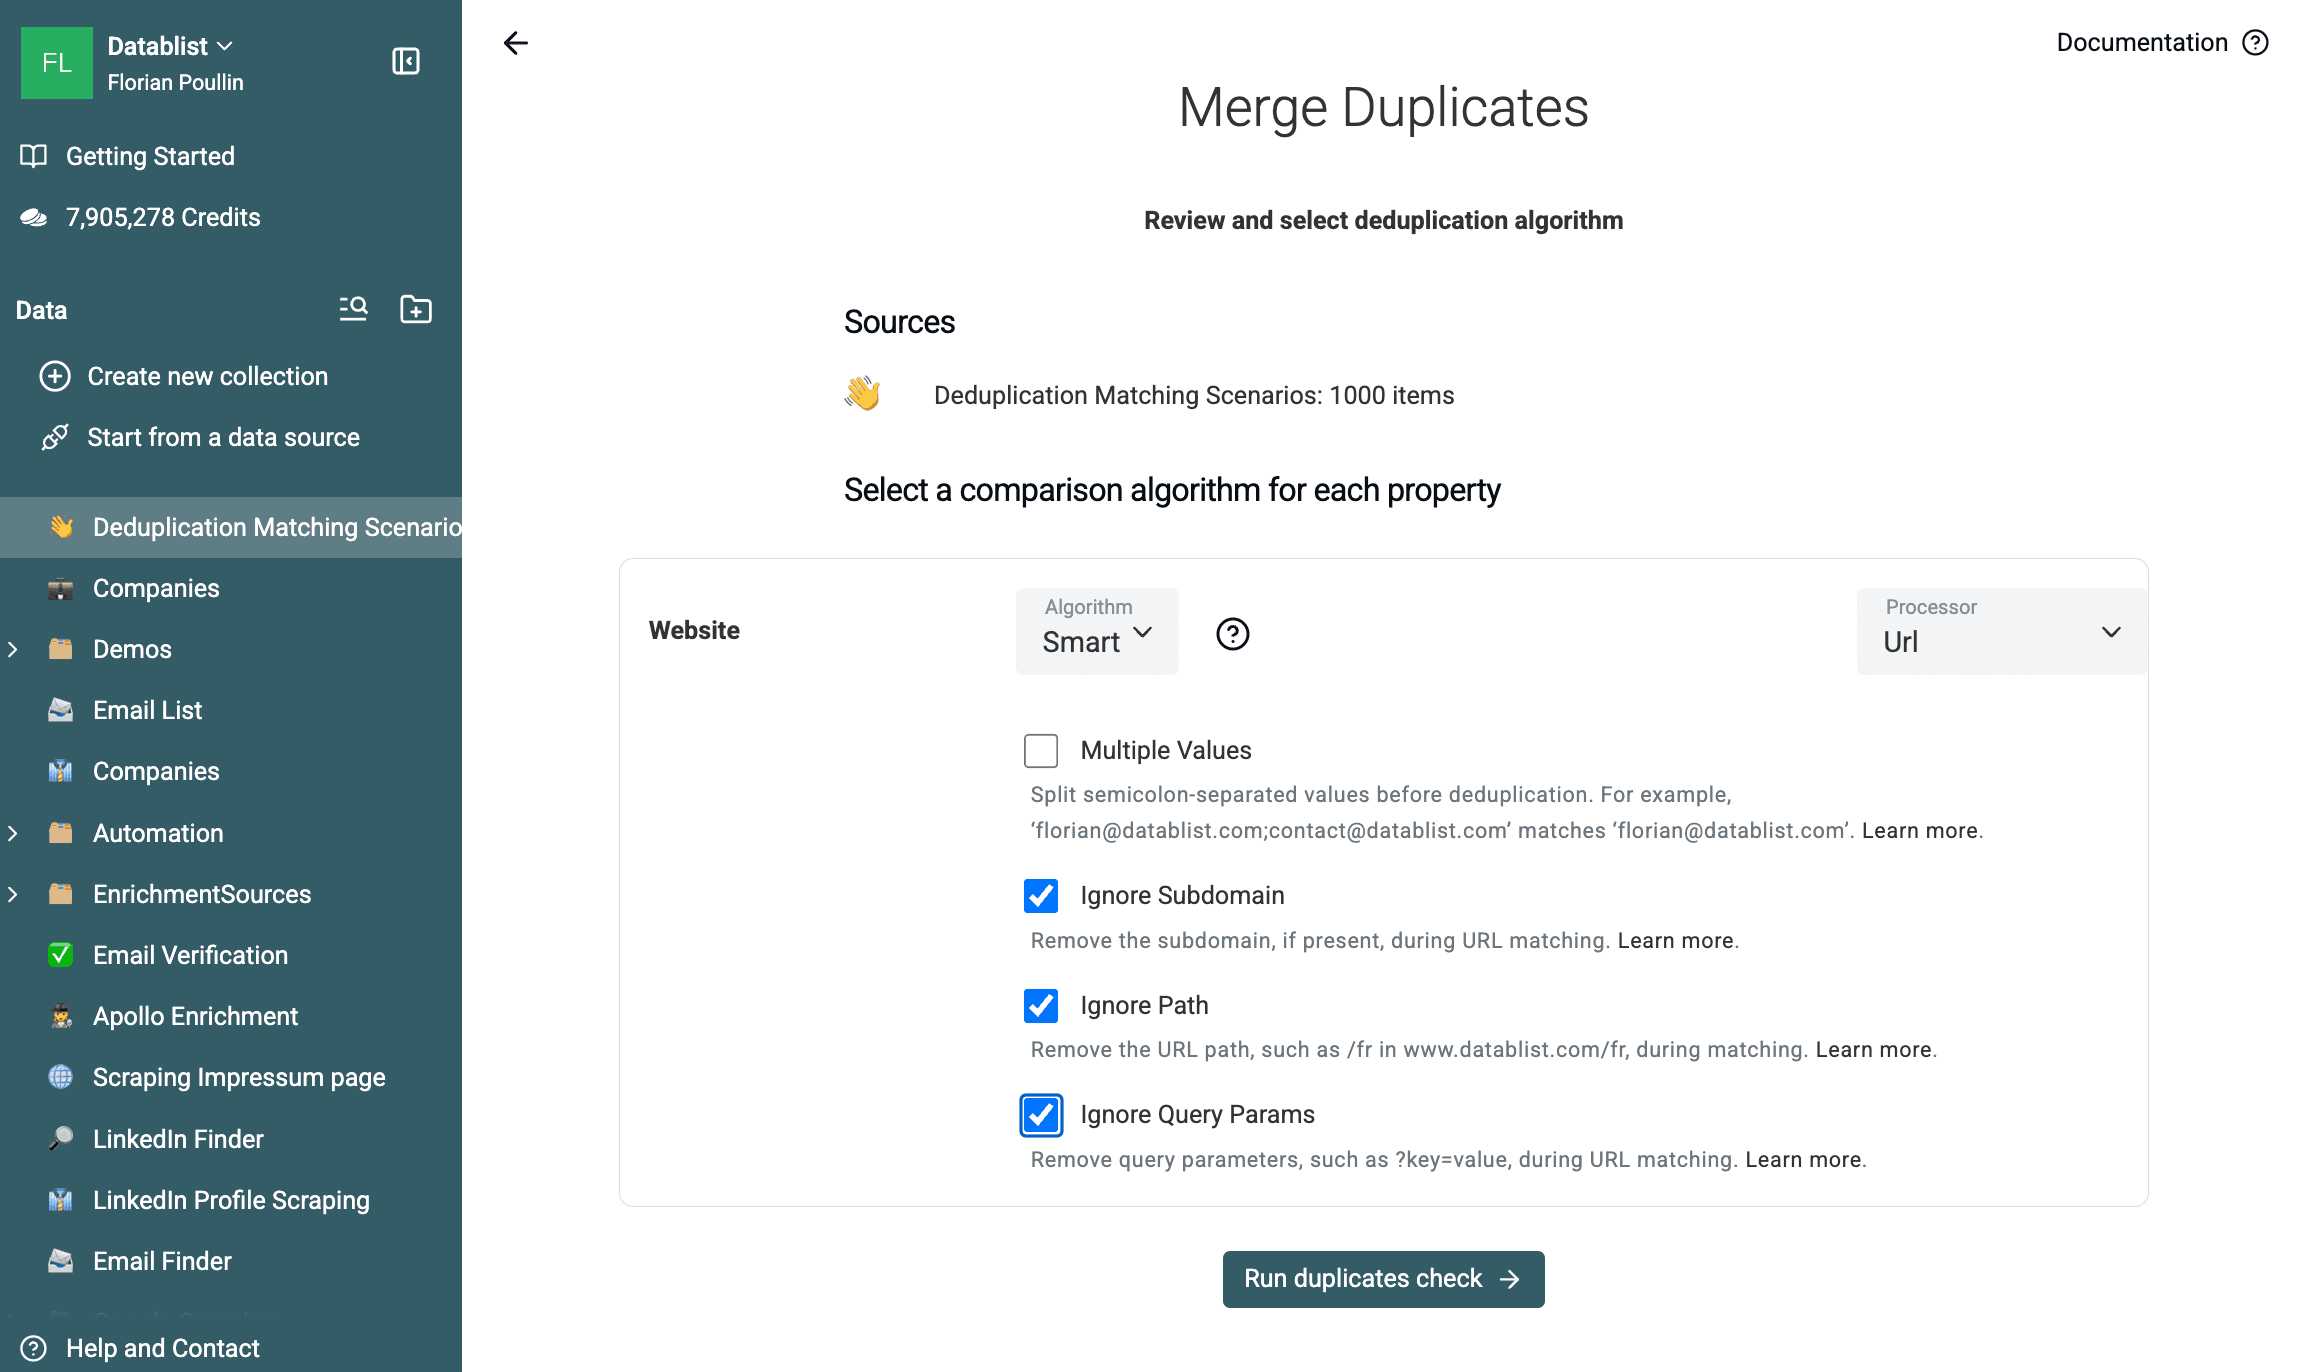
I samma exempel med 1 000 rader gav konfigurationen 200 grupper med två rader. Femtio par innehåller avsiktligt skapade URL-variationer, medan 150 par redan har en identisk webbplats. I det här testet ledde varje exporterat par till samma normaliserade värdnamn.
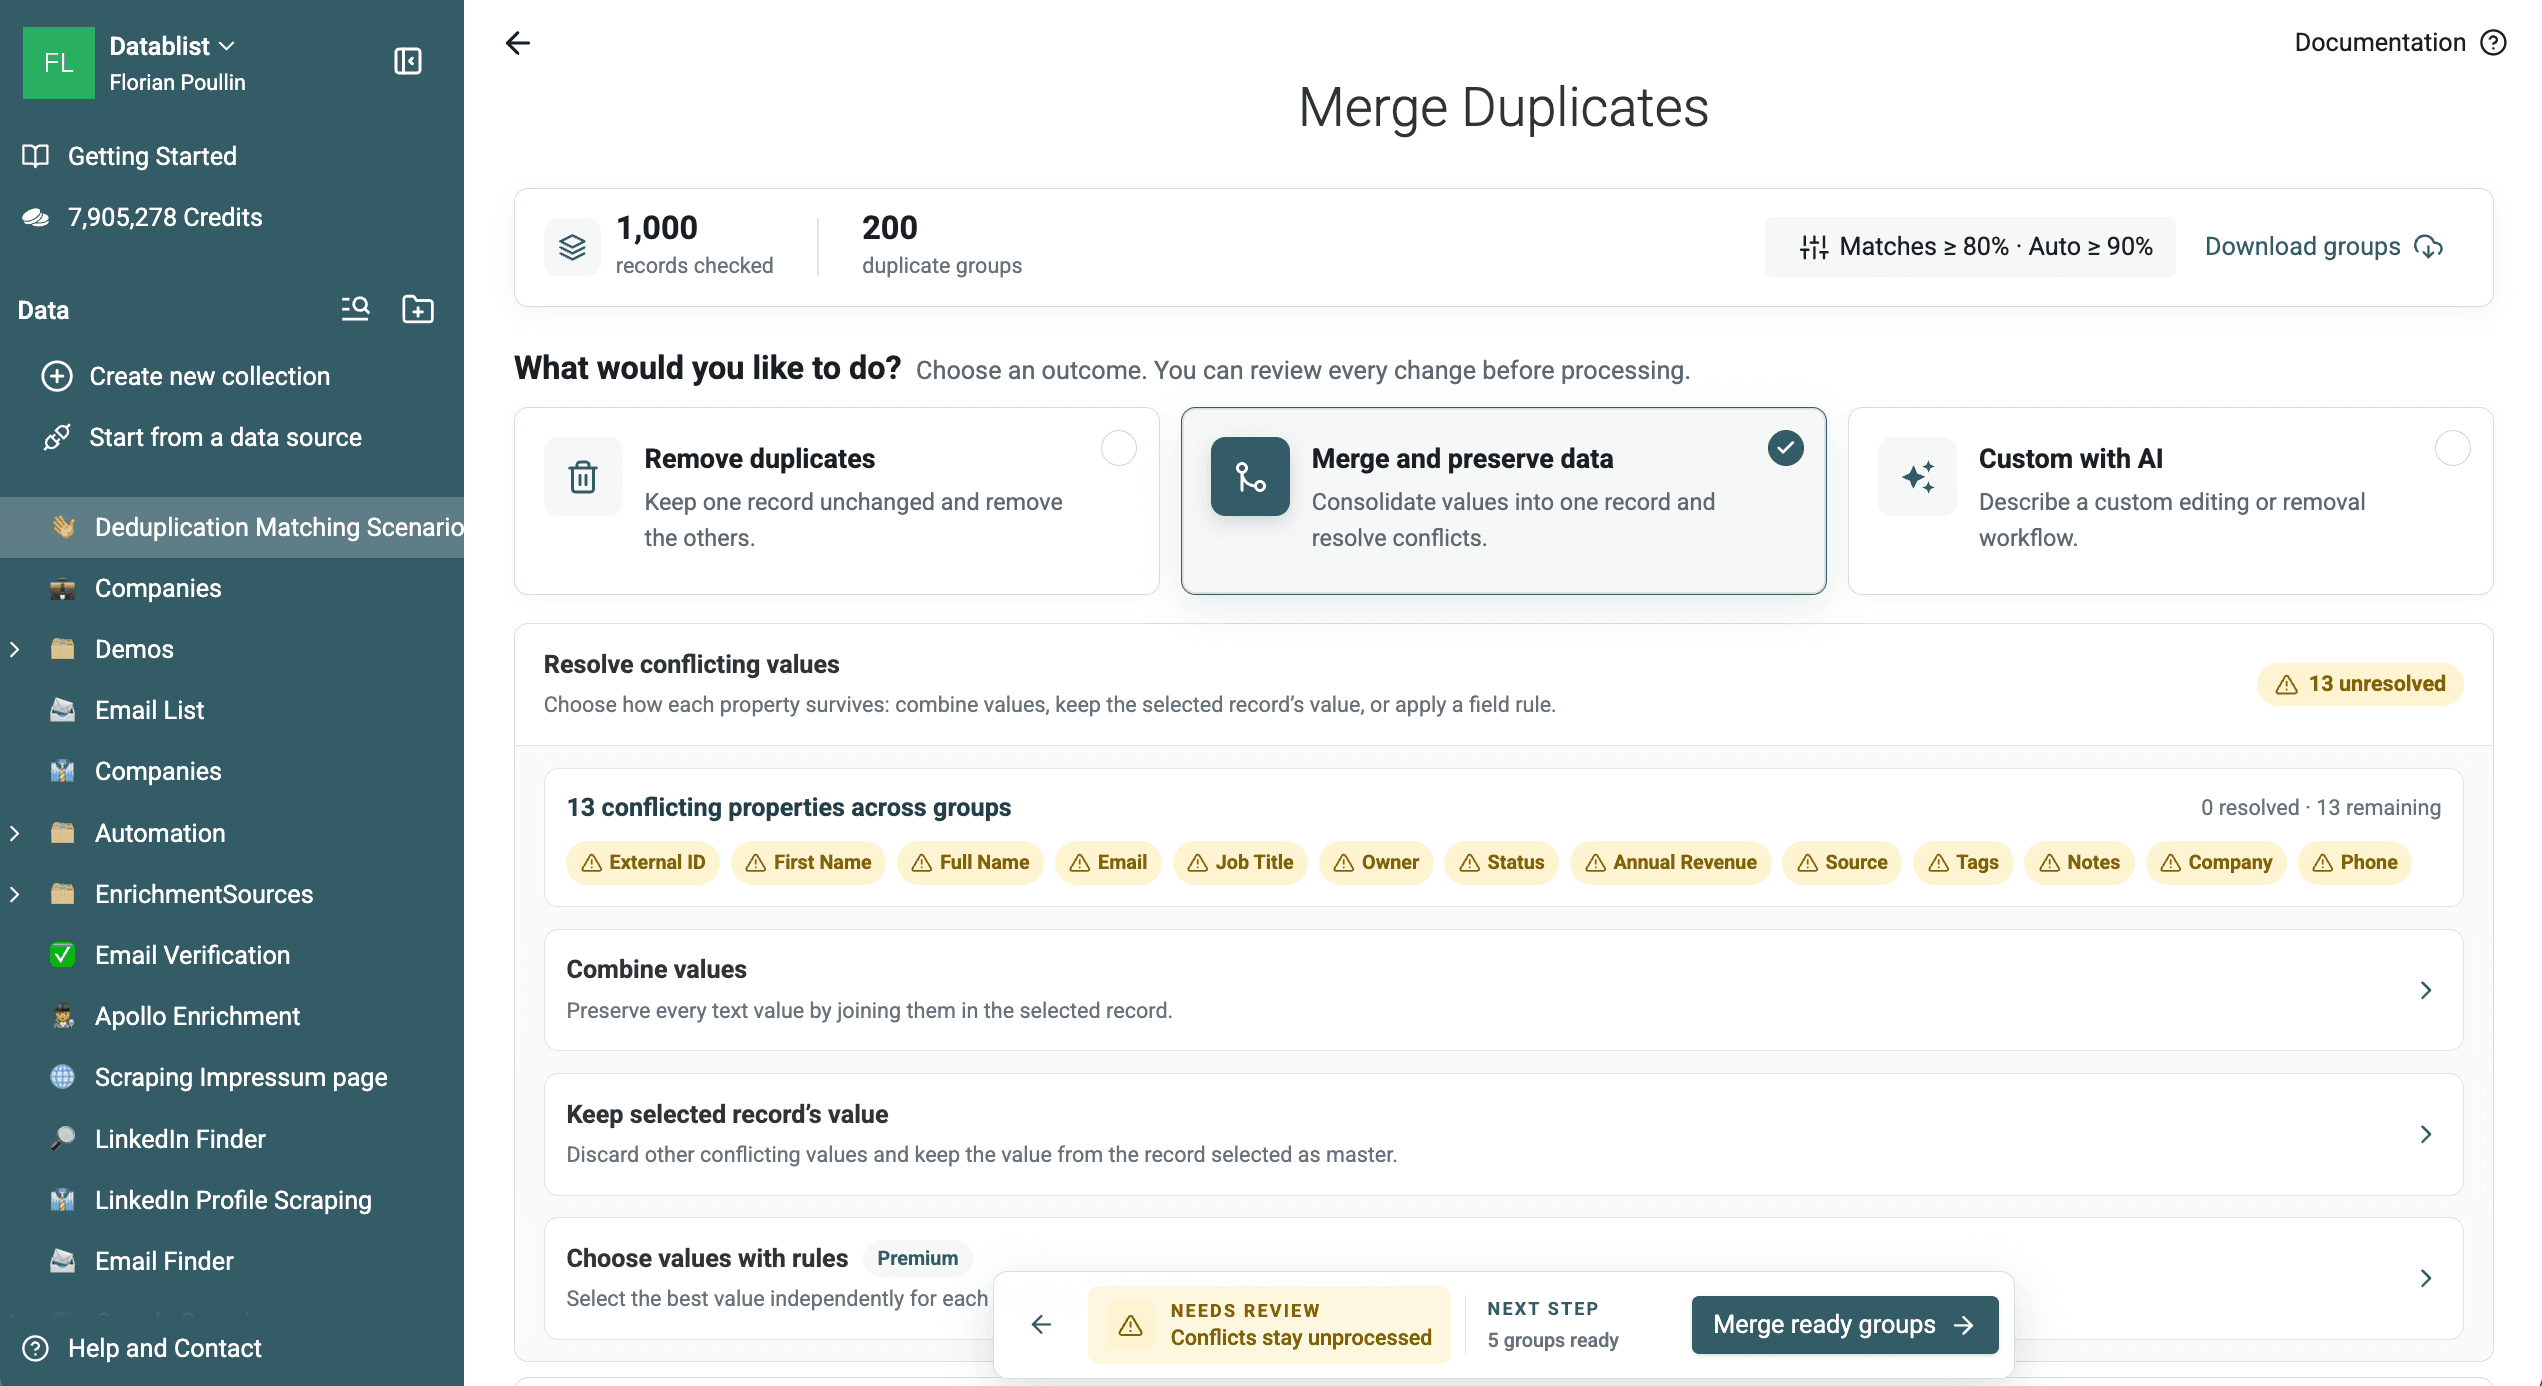
Ladda ned de 200 dubblettgrupperna för Website eller läs arbetsflödet för företagsdeduplicering för en matchningsstrategi som börjar med domänen.
Använd fuzzy- eller fonetisk matchning för granskning
Metaphone jämför hur text låter. Jaro-Winkler och Levenshtein beräknar ett likhetsvärde, vilket hjälper dig att hitta stavningsskillnader som Uma Turner och Uman Turner.
Fuzzy-matchningar är kandidater, inte bekräftade dubbletter. Börja med en hög tröskel, granska de svagaste grupperna och sänk bara resultattröskeln om precisionen fortfarande är tillräcklig.
För en uppmätt fuzzy-matchning väljer du Full Name, Distance med Levenshtein, behåller Text-processorn och ställer in tröskeln på 90 %.
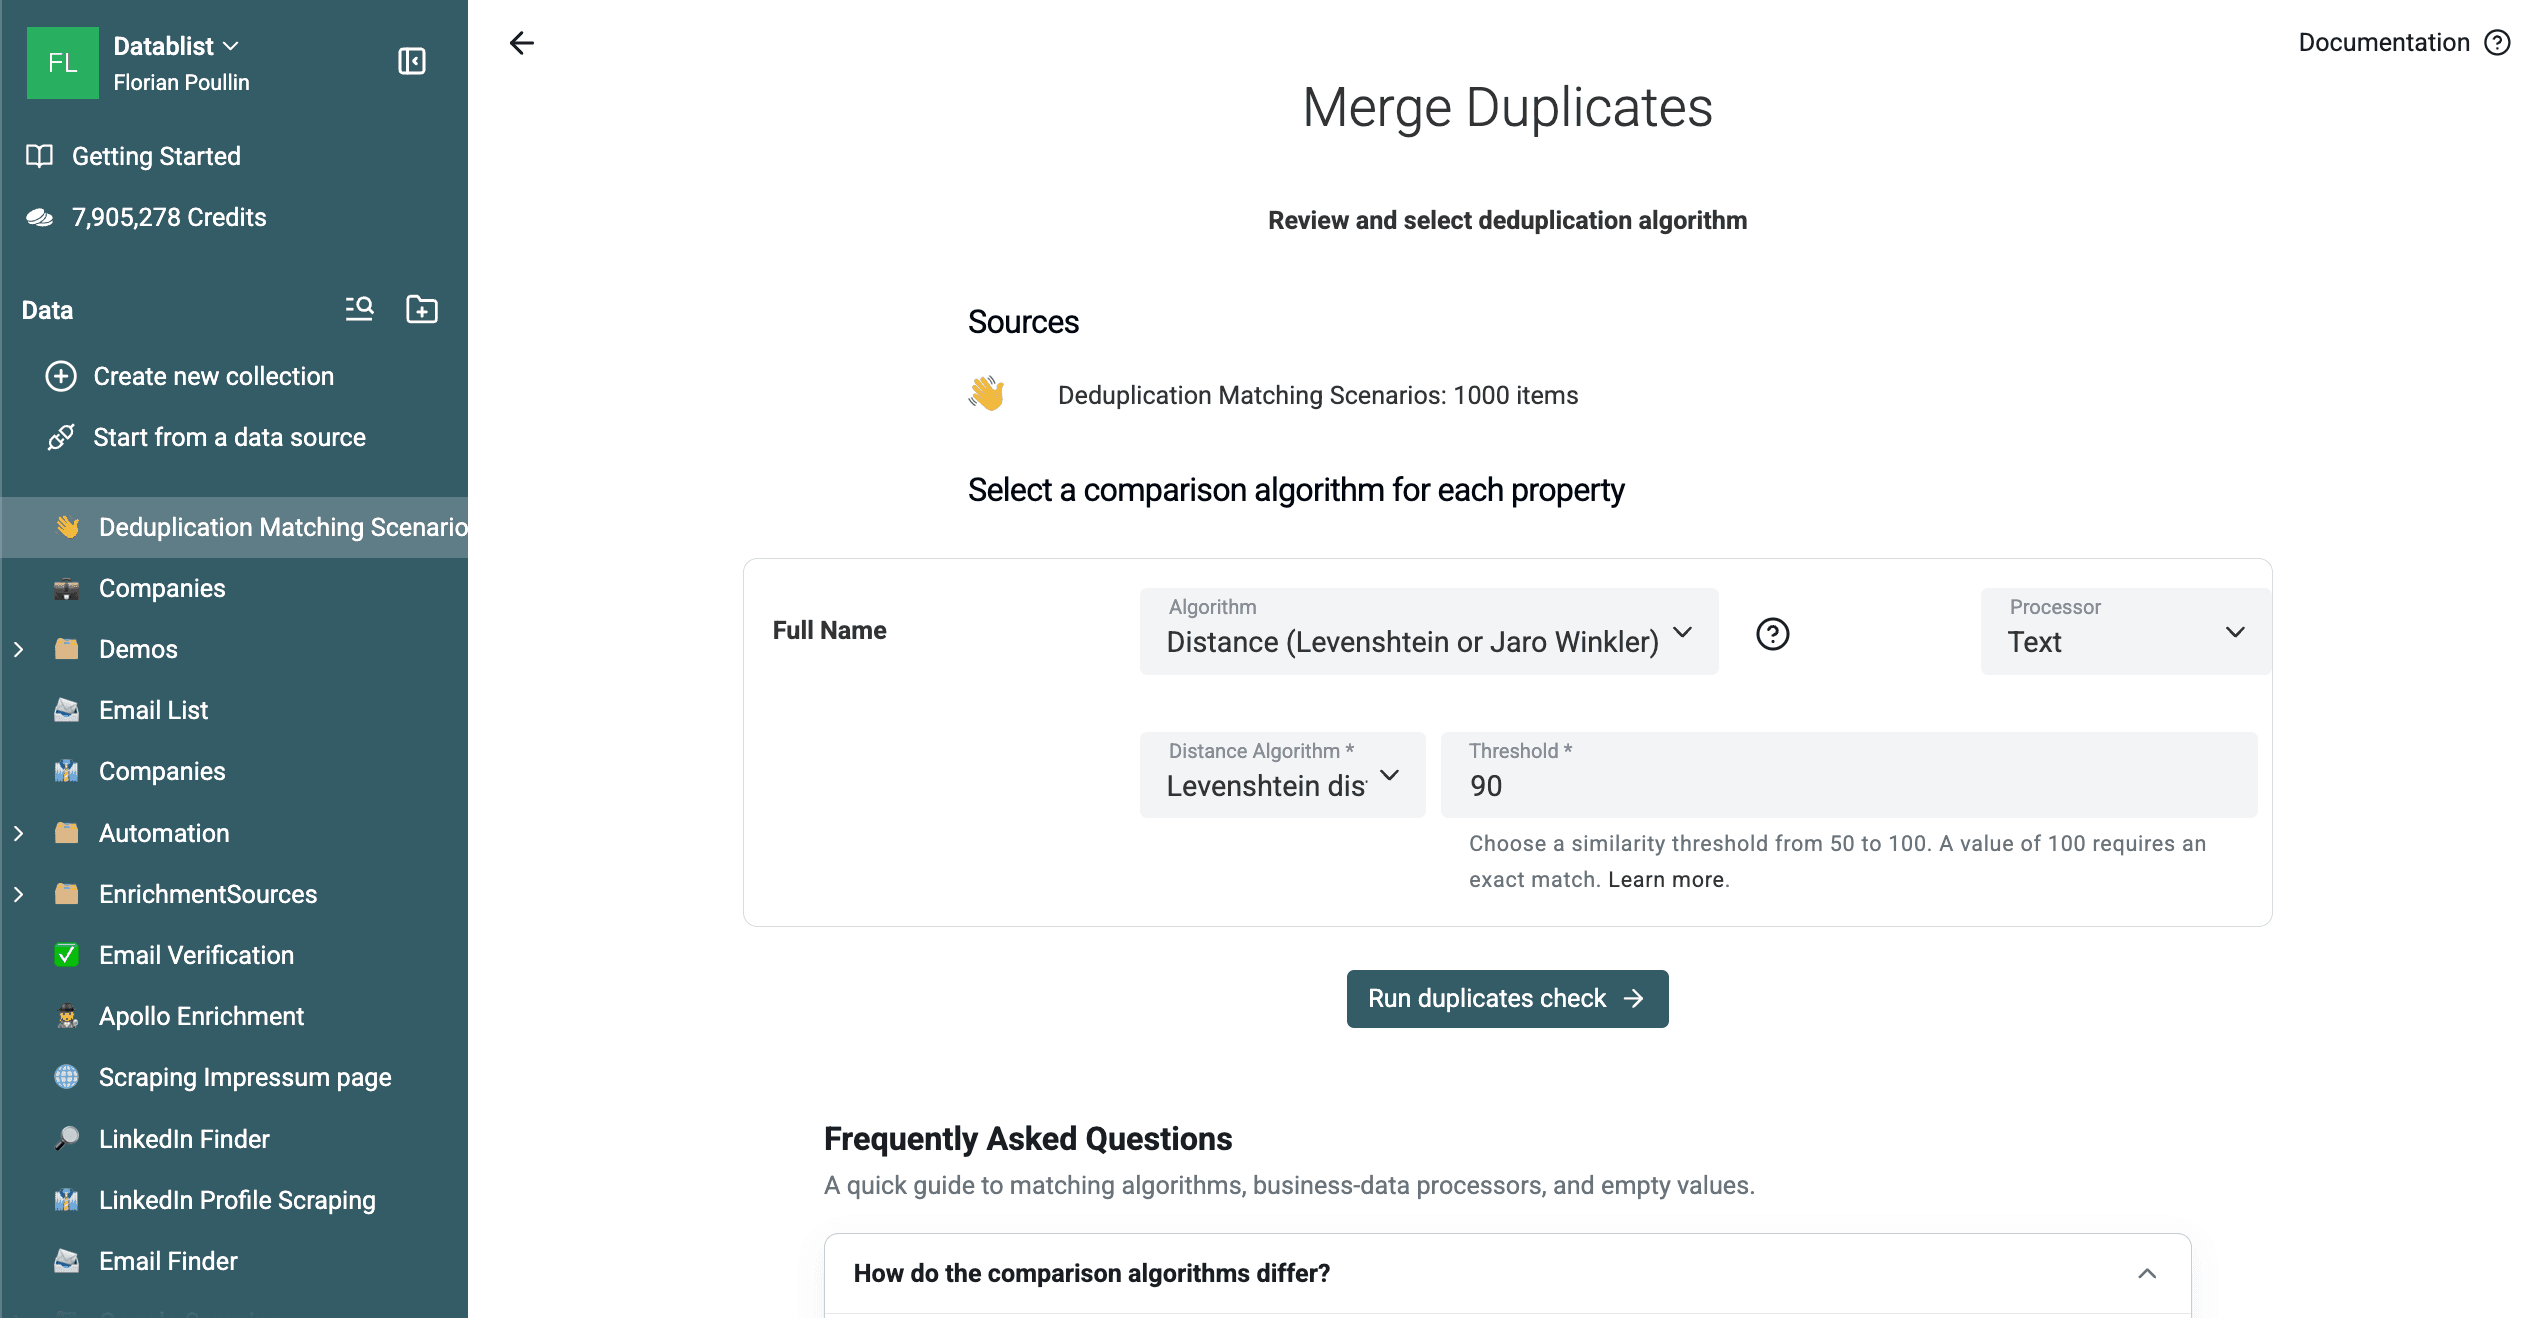
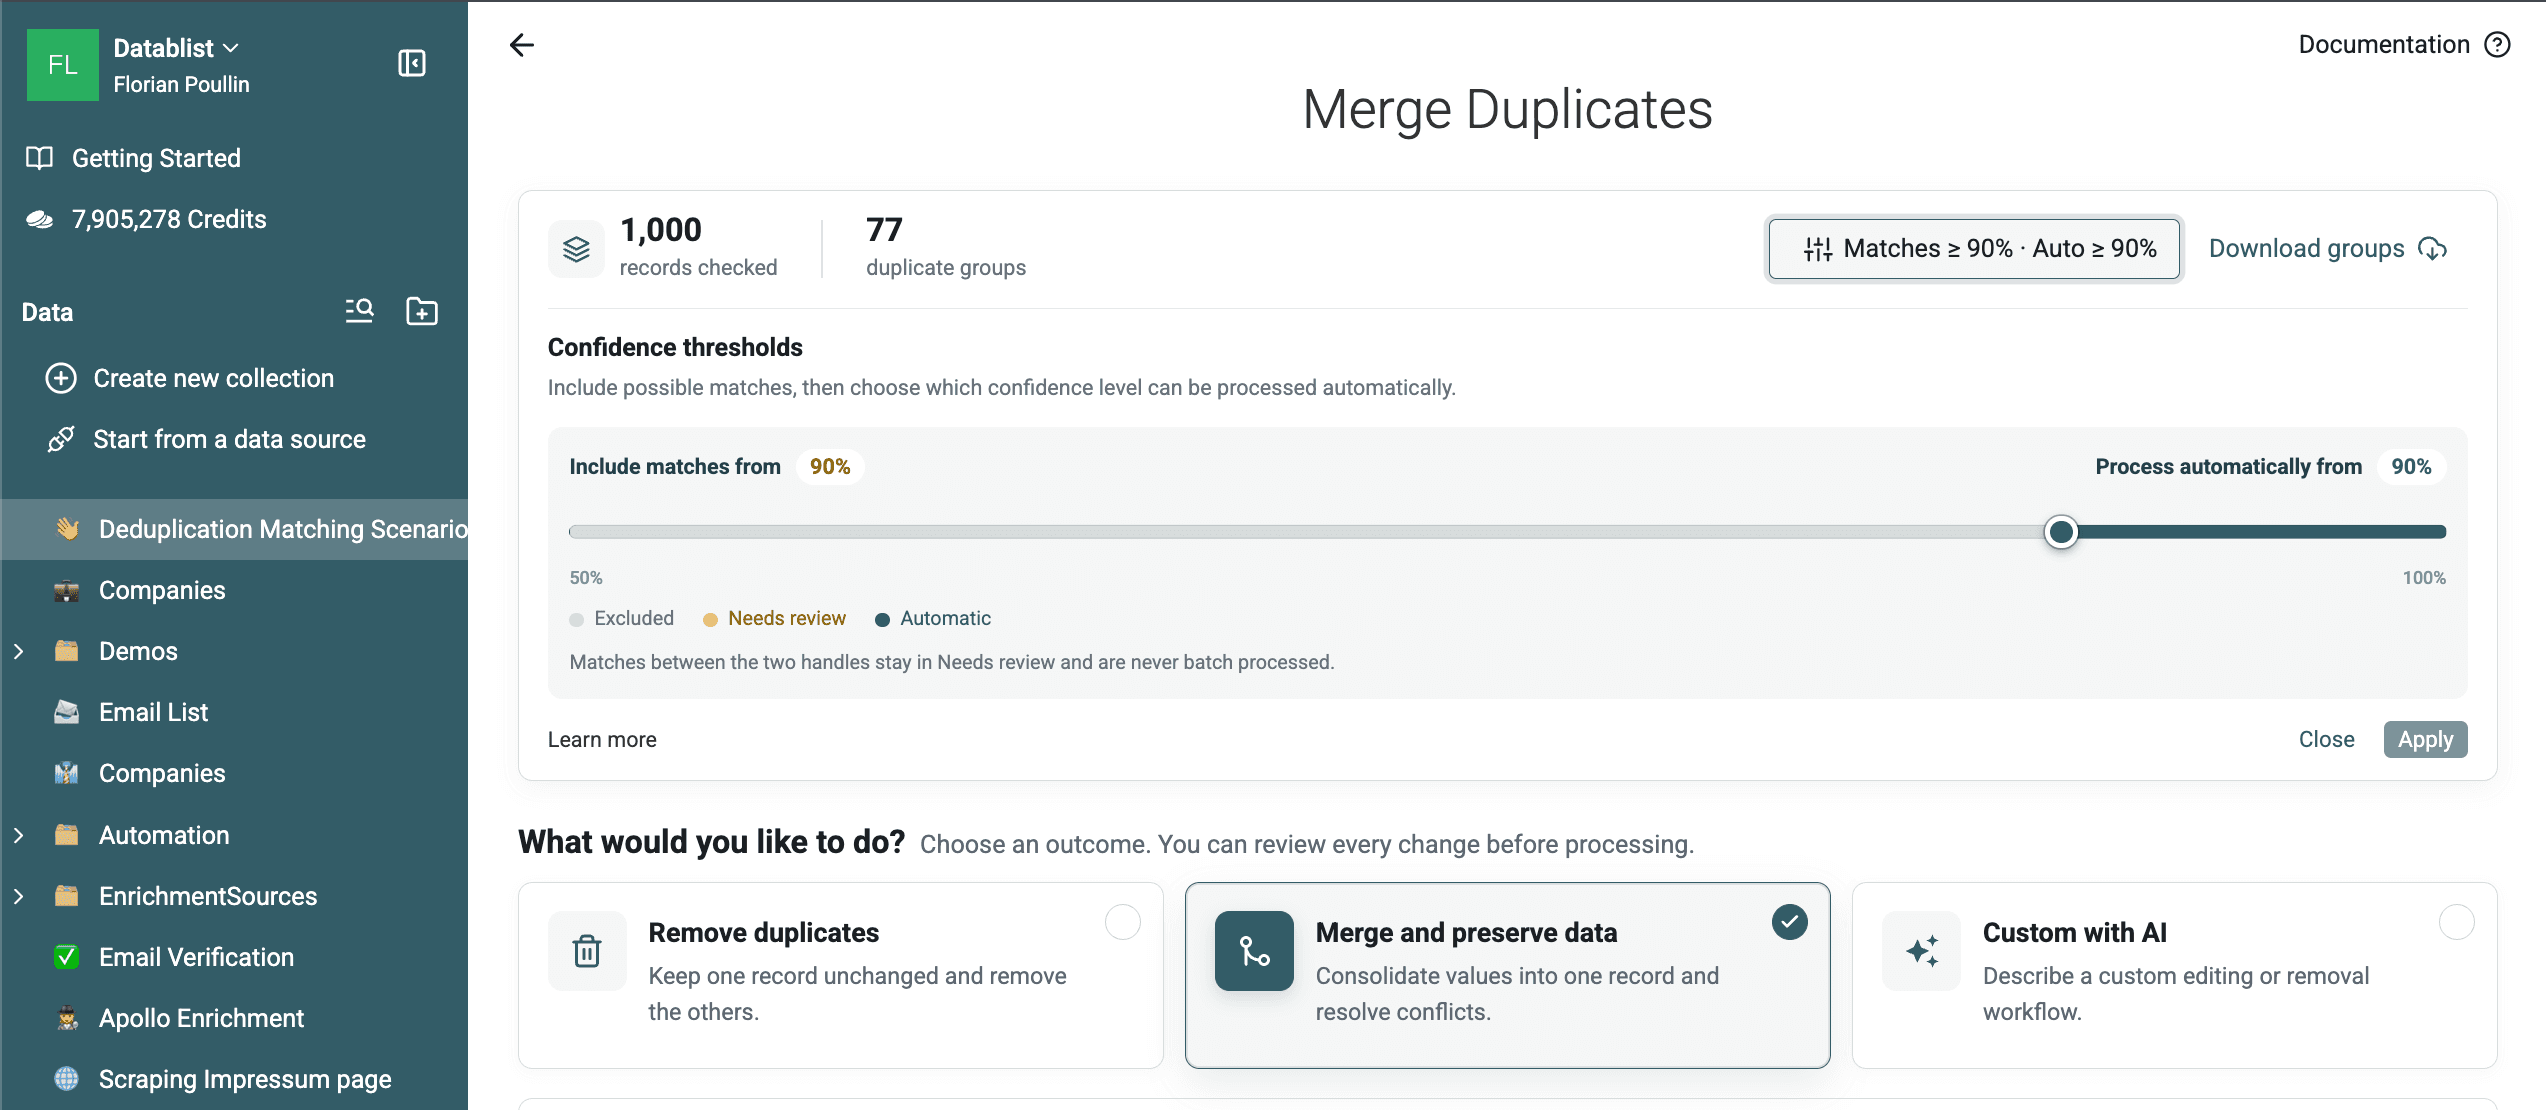
Kontrollen gav 77 grupper med två rader från exemplet med 1 000 rader. Valideringen mot facit hittade 21 grupper som kopplar samman samma avsiktligt skapade entitet och 56 grupper som länkar olika entiteter. De flesta falska positiva resultaten var förkortade namn som G. Rossi, där enbart Full Name-värdet inte kan skilja två personer åt.
Matchningen hittar avsiktliga stavningsvariationer som Uma A. Turner och Uman A. Turner, men visar också varför fuzzy-matchningar som enbart bygger på namn måste granskas.
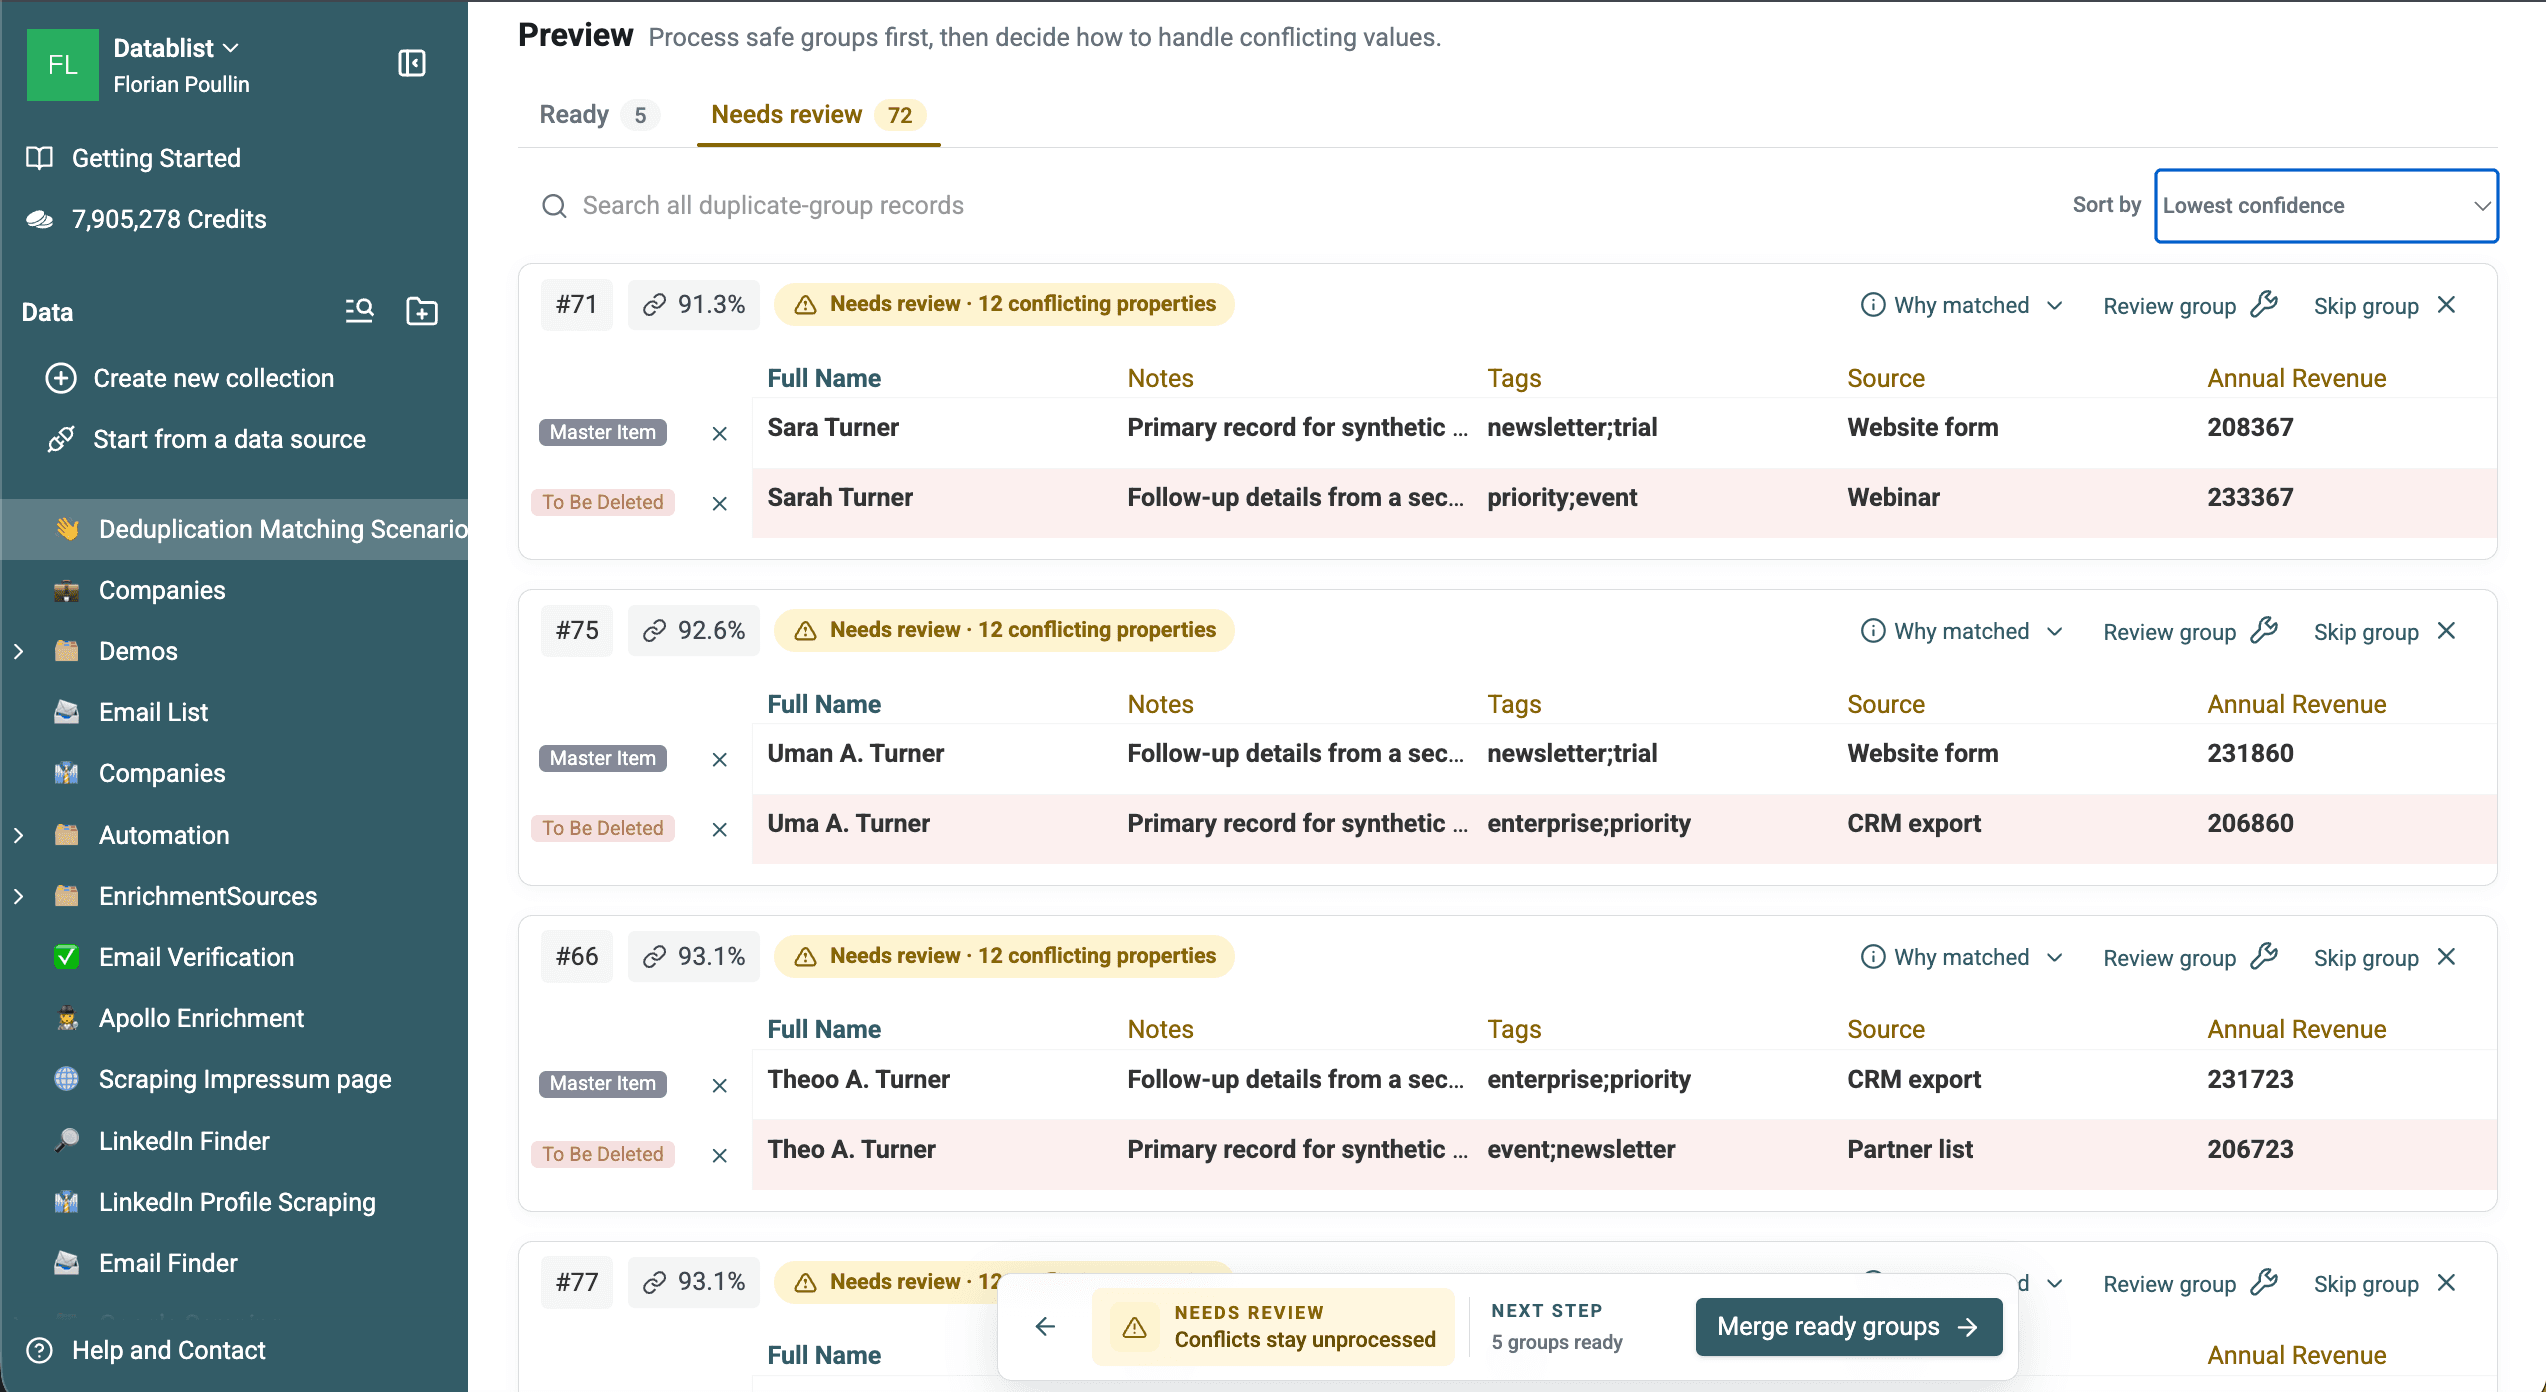
Ladda ned de 77 exporterade Levenshtein-grupperna för att granska både relevanta matchningar och falska positiva resultat.
För fonetisk matchning väljer du Full Name och Metaphone samt behåller Text-processorn.
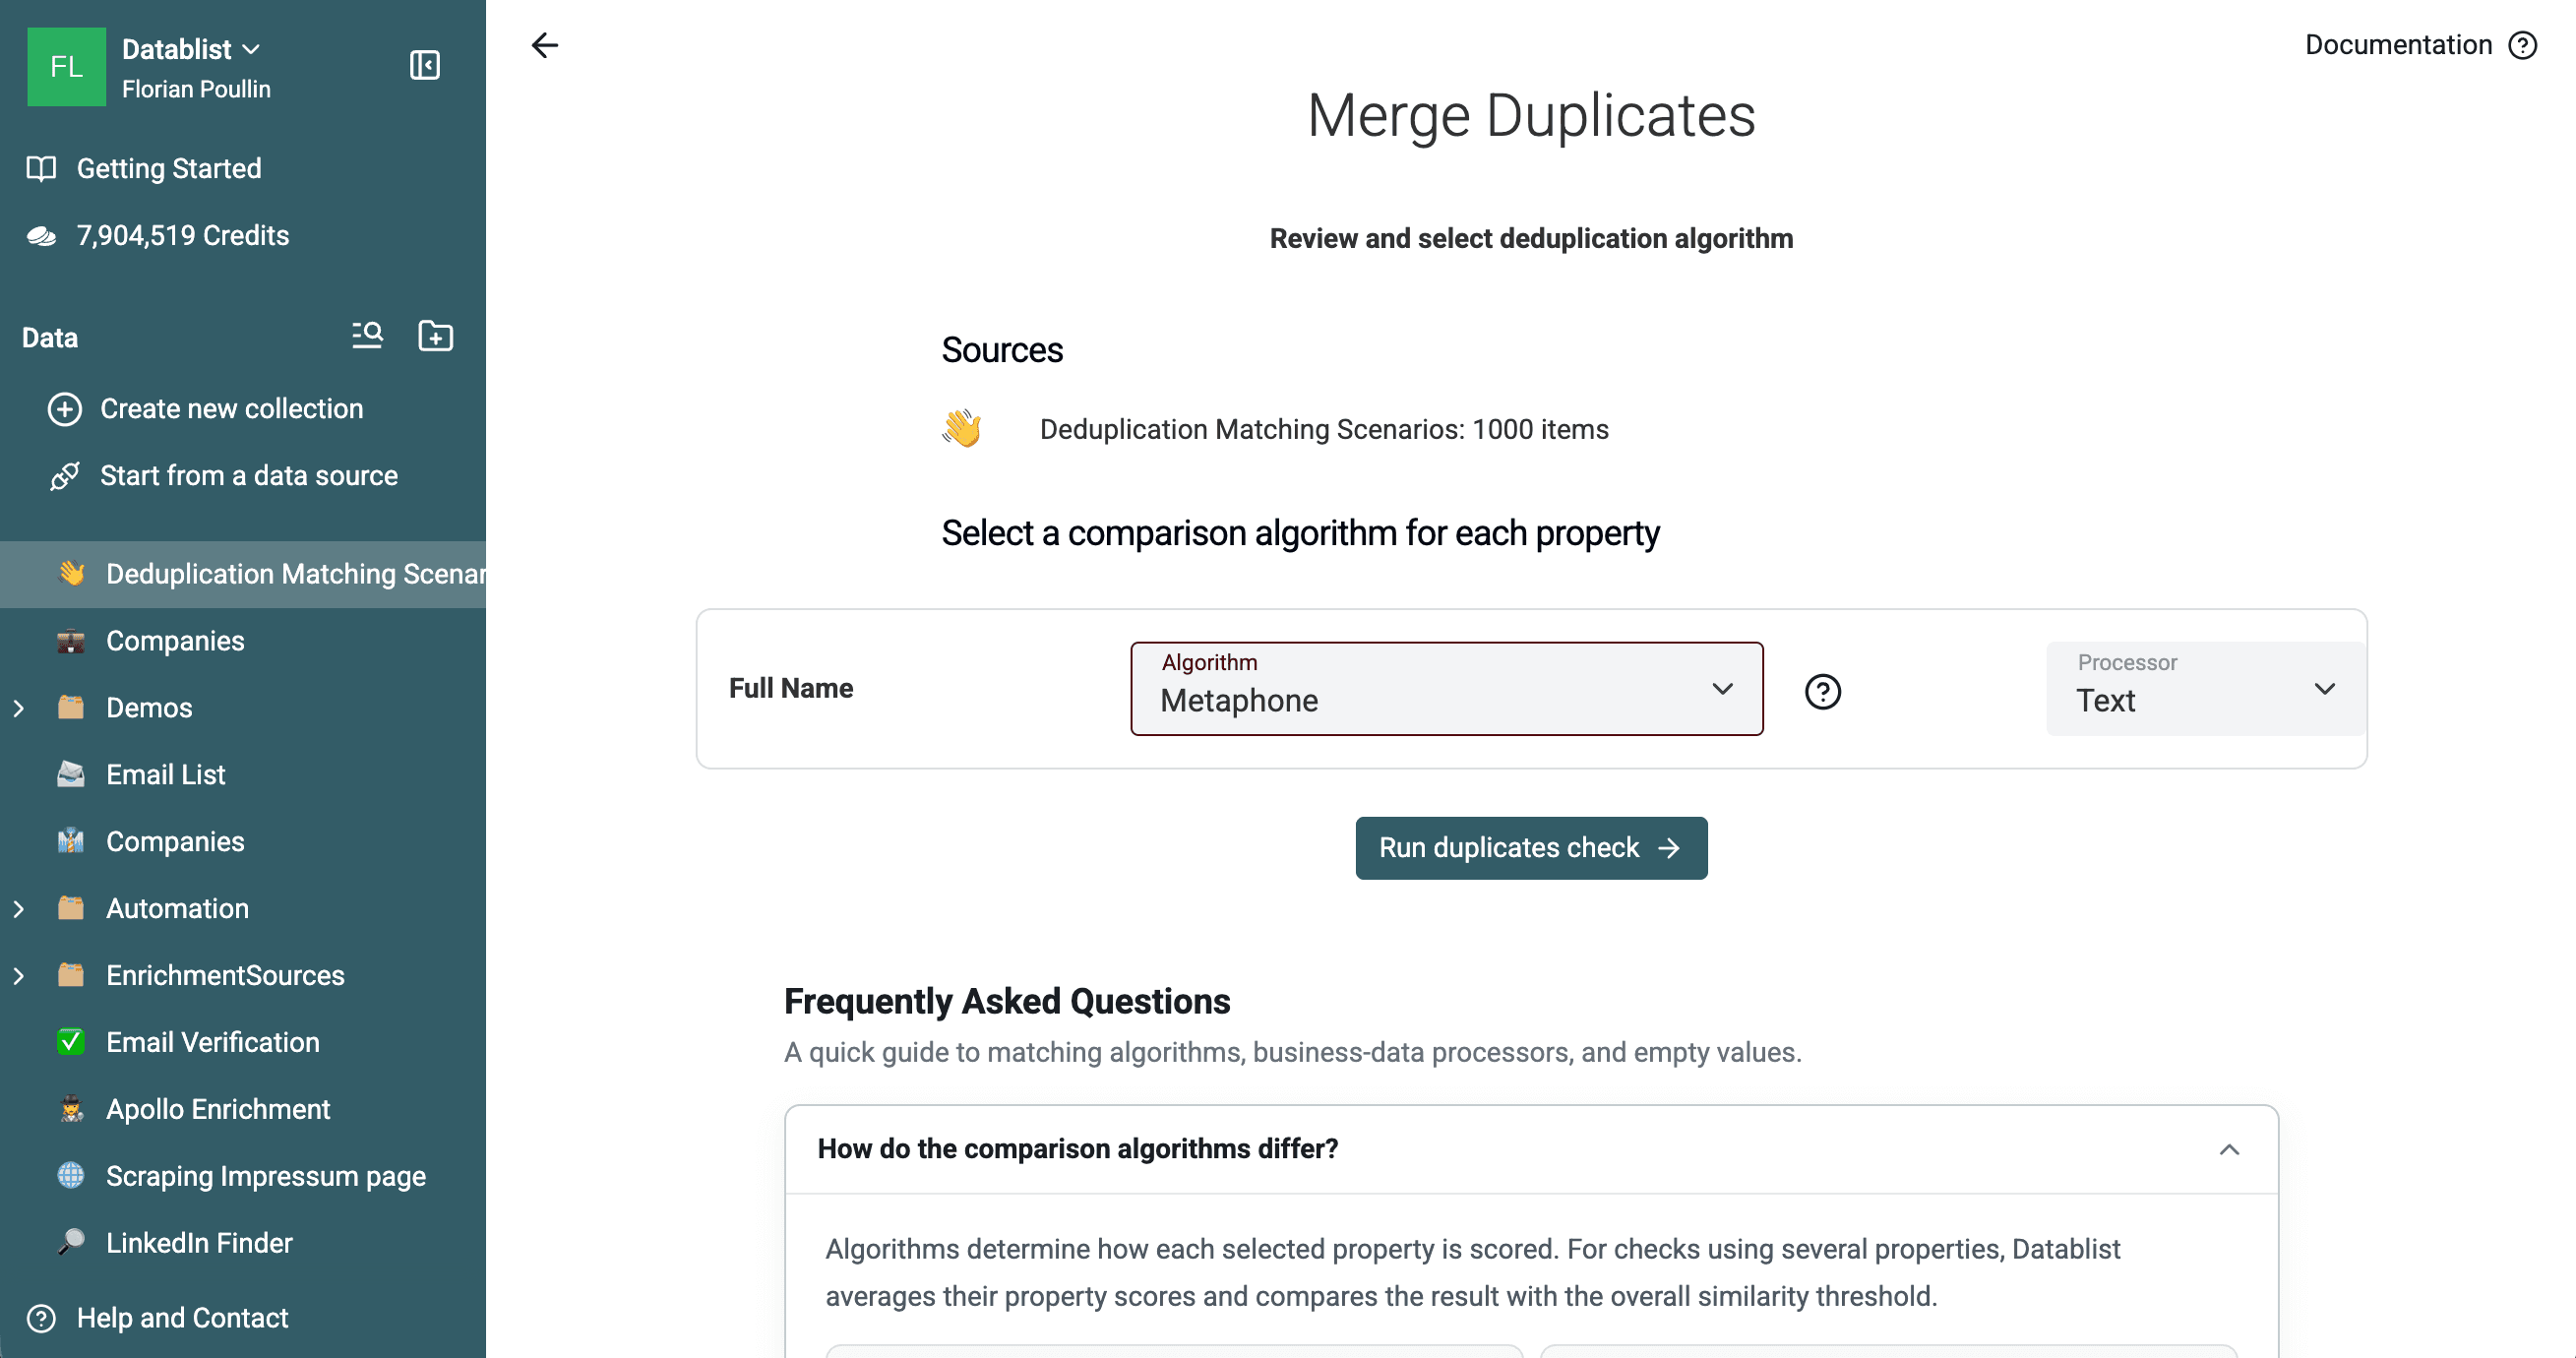
Den här matchningen visade 69 grupper: 5 Ready och 64 Needs review. De exporterade grupperna innehåller 188 rader. Validering mot de kända entiteterna i exemplet hittade 19 rena grupper med samma entitet och 50 grupper som blandar olika personer. Grupperna innehåller mellan två och sju rader.
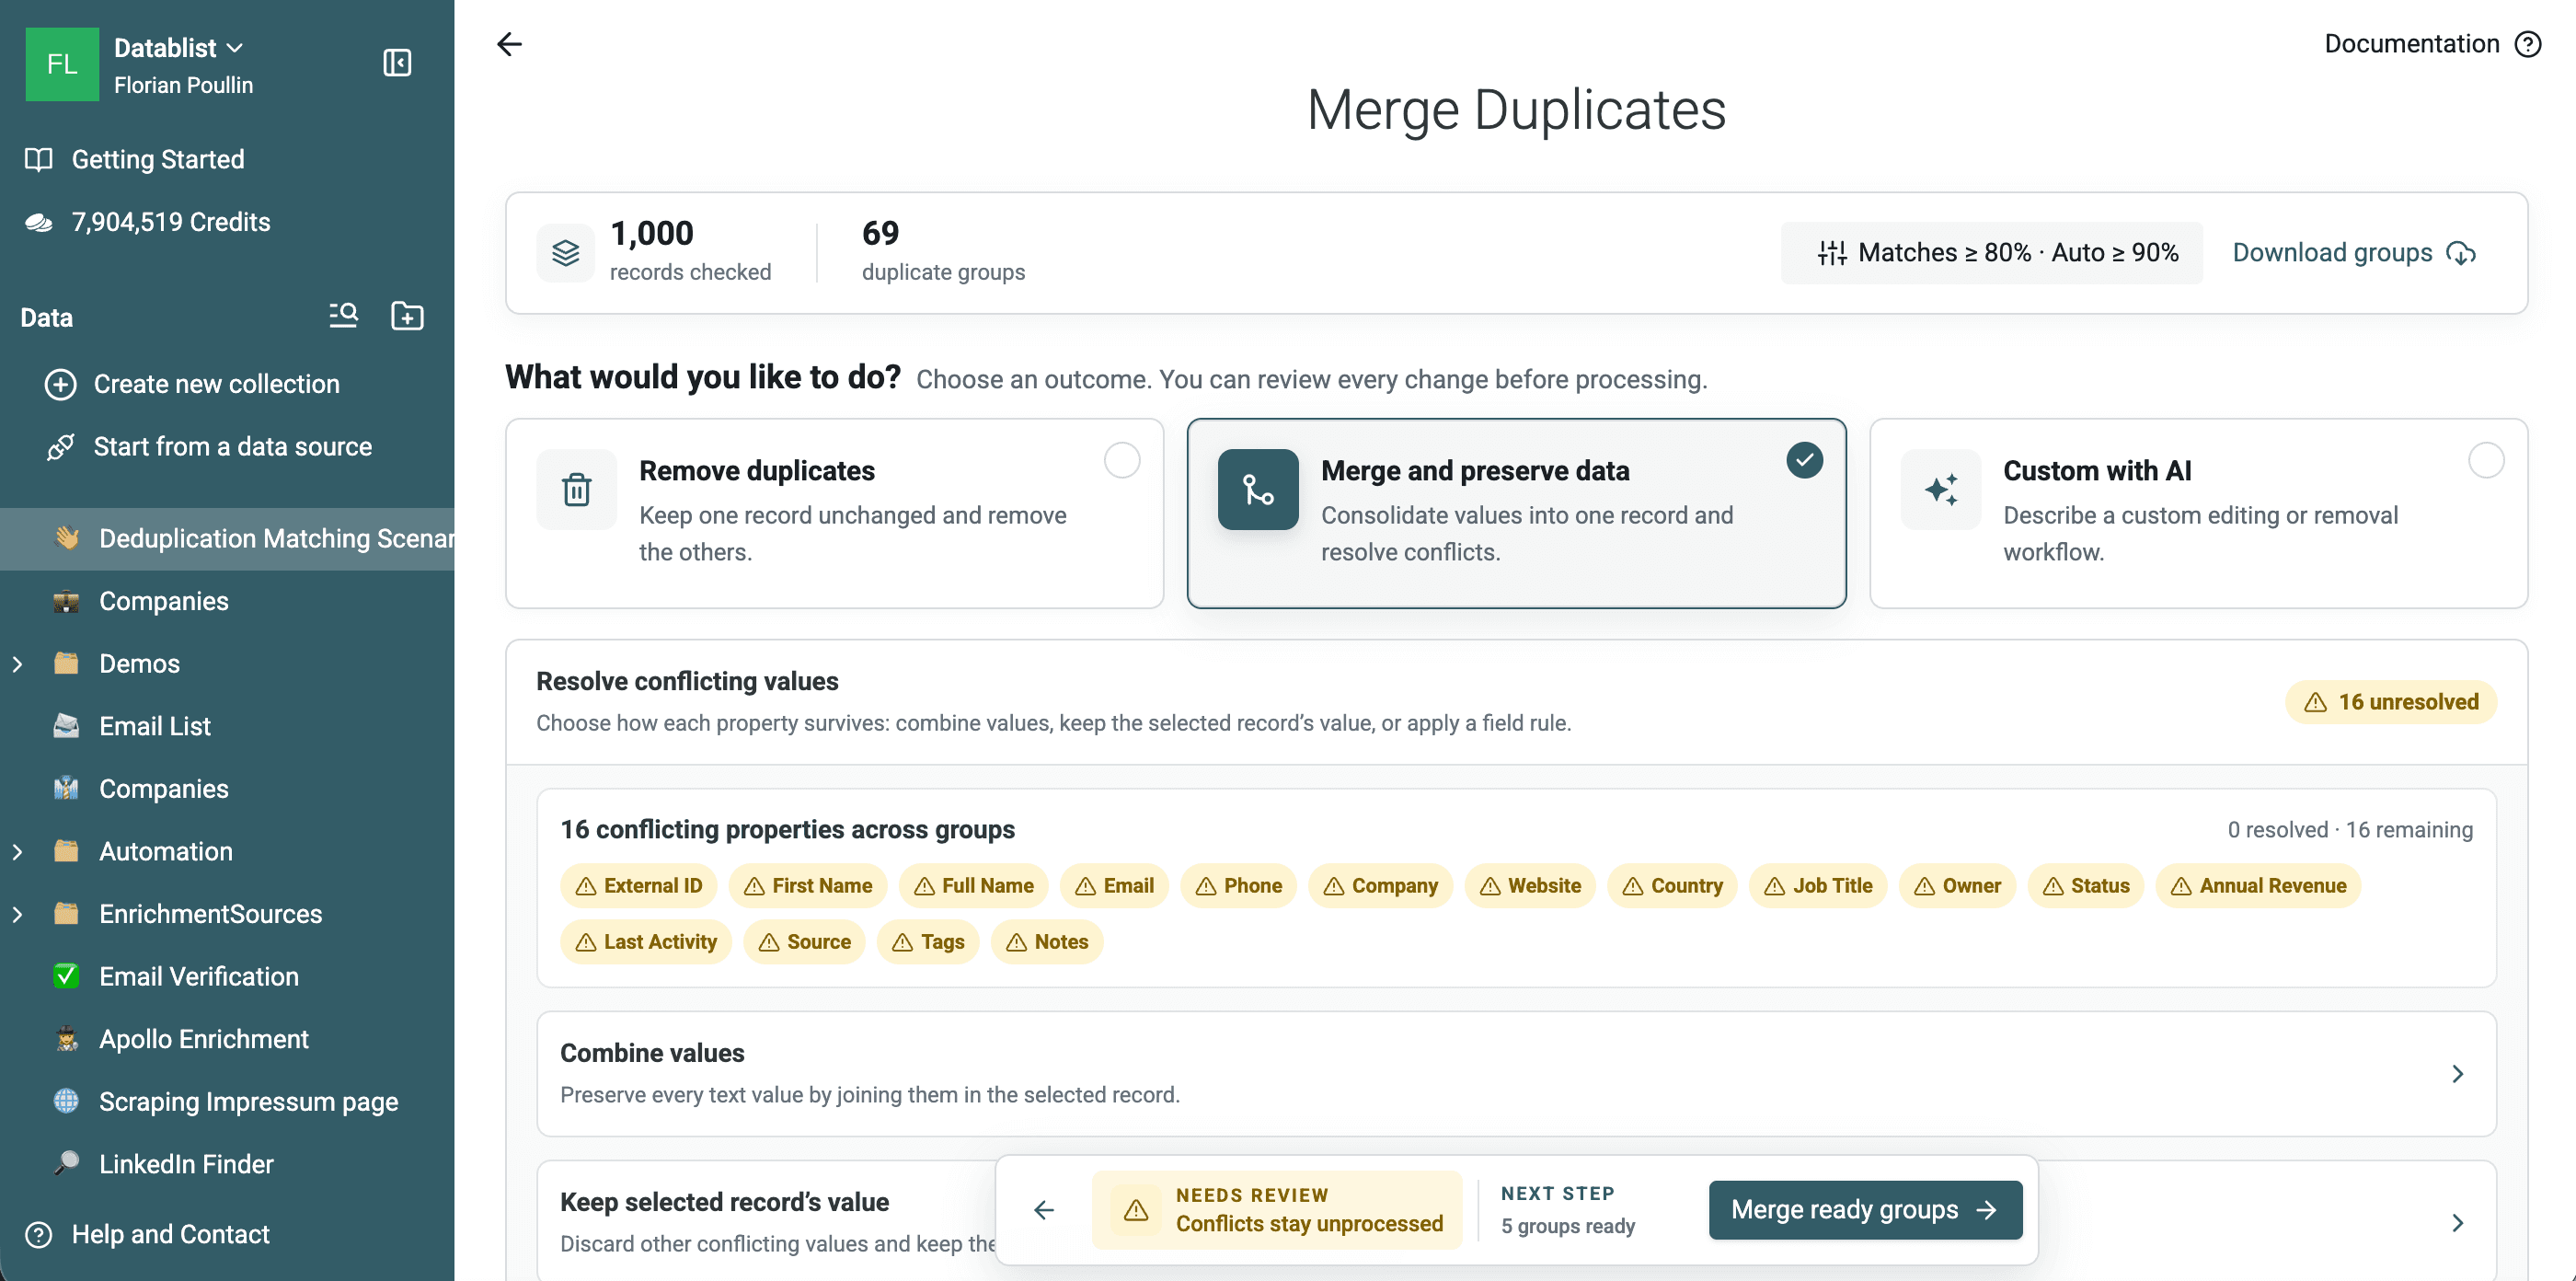
Why matched bekräftar egenskapen Full Name, algoritmen Metaphone, Text-processorn och gruppens poäng. Använd informationen för att granska jämförelsen, inte som ersättning för en identitetskontroll.
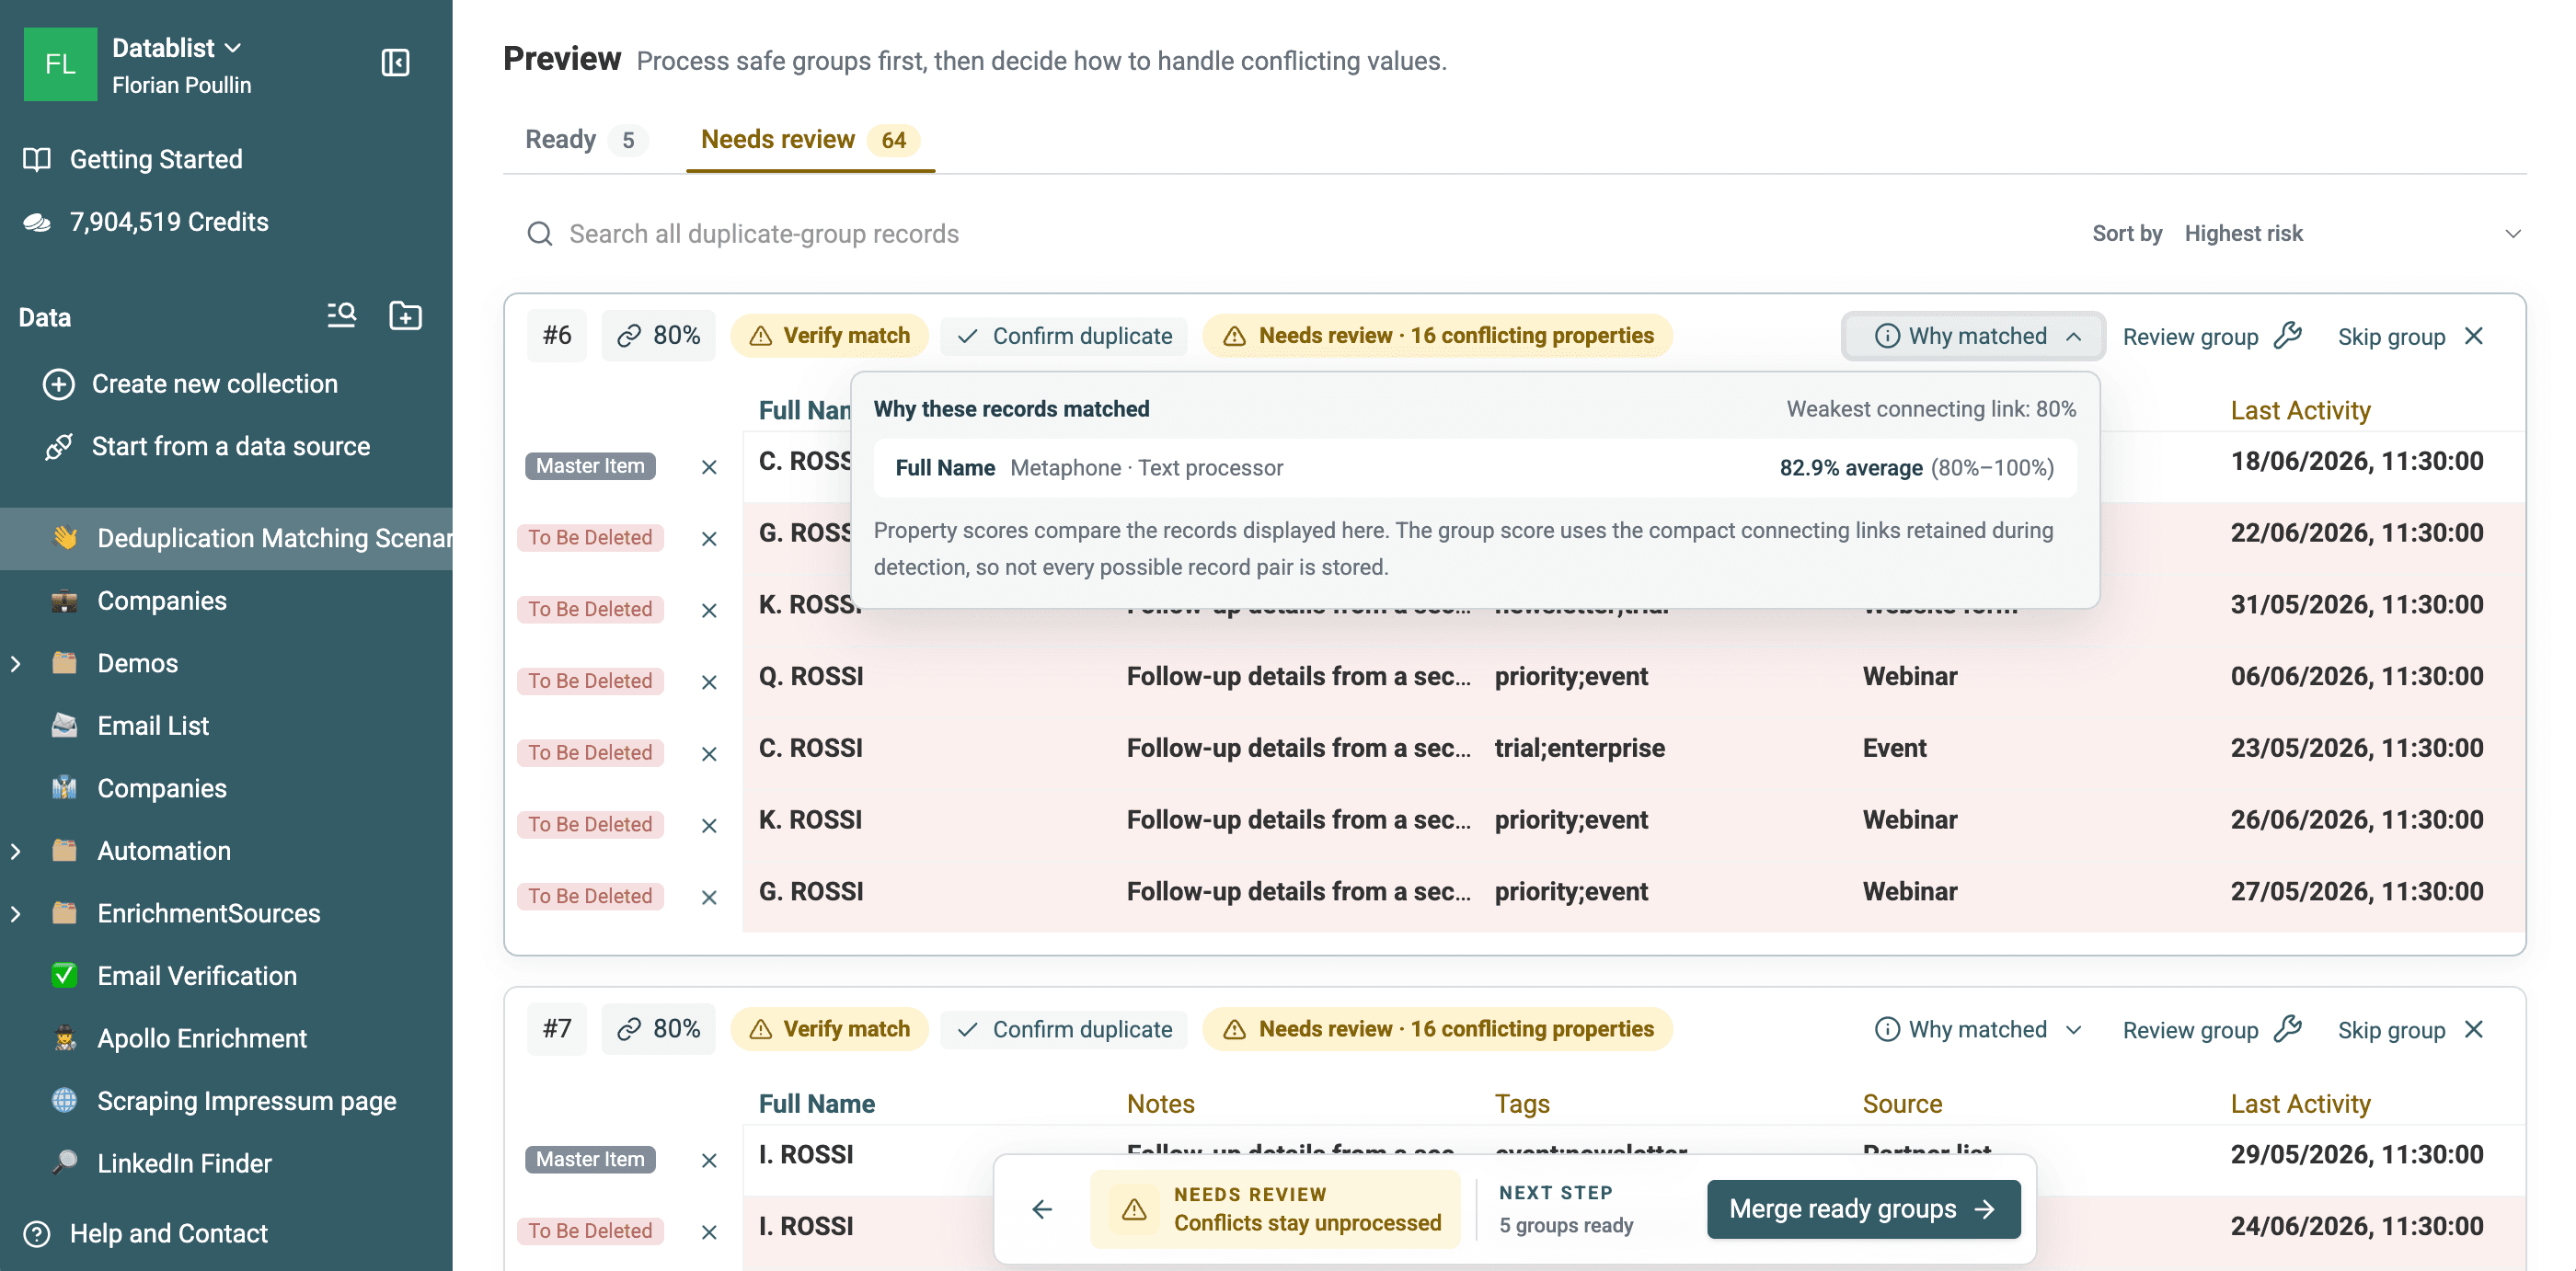
Ladda ned de 69 exporterade Metaphone-grupperna för att granska användbara fonetiska matchningar och falska positiva resultat. De större grupperna med falska positiva resultat kombinerar ofta initialer med ett vanligt efternamn, till exempel flera förkortade Rossi-namn. Deras fonetiska koder överlappar, men enbart namnen ger inte tillräckliga identitetsbevis för en automatisk sammanslagning.
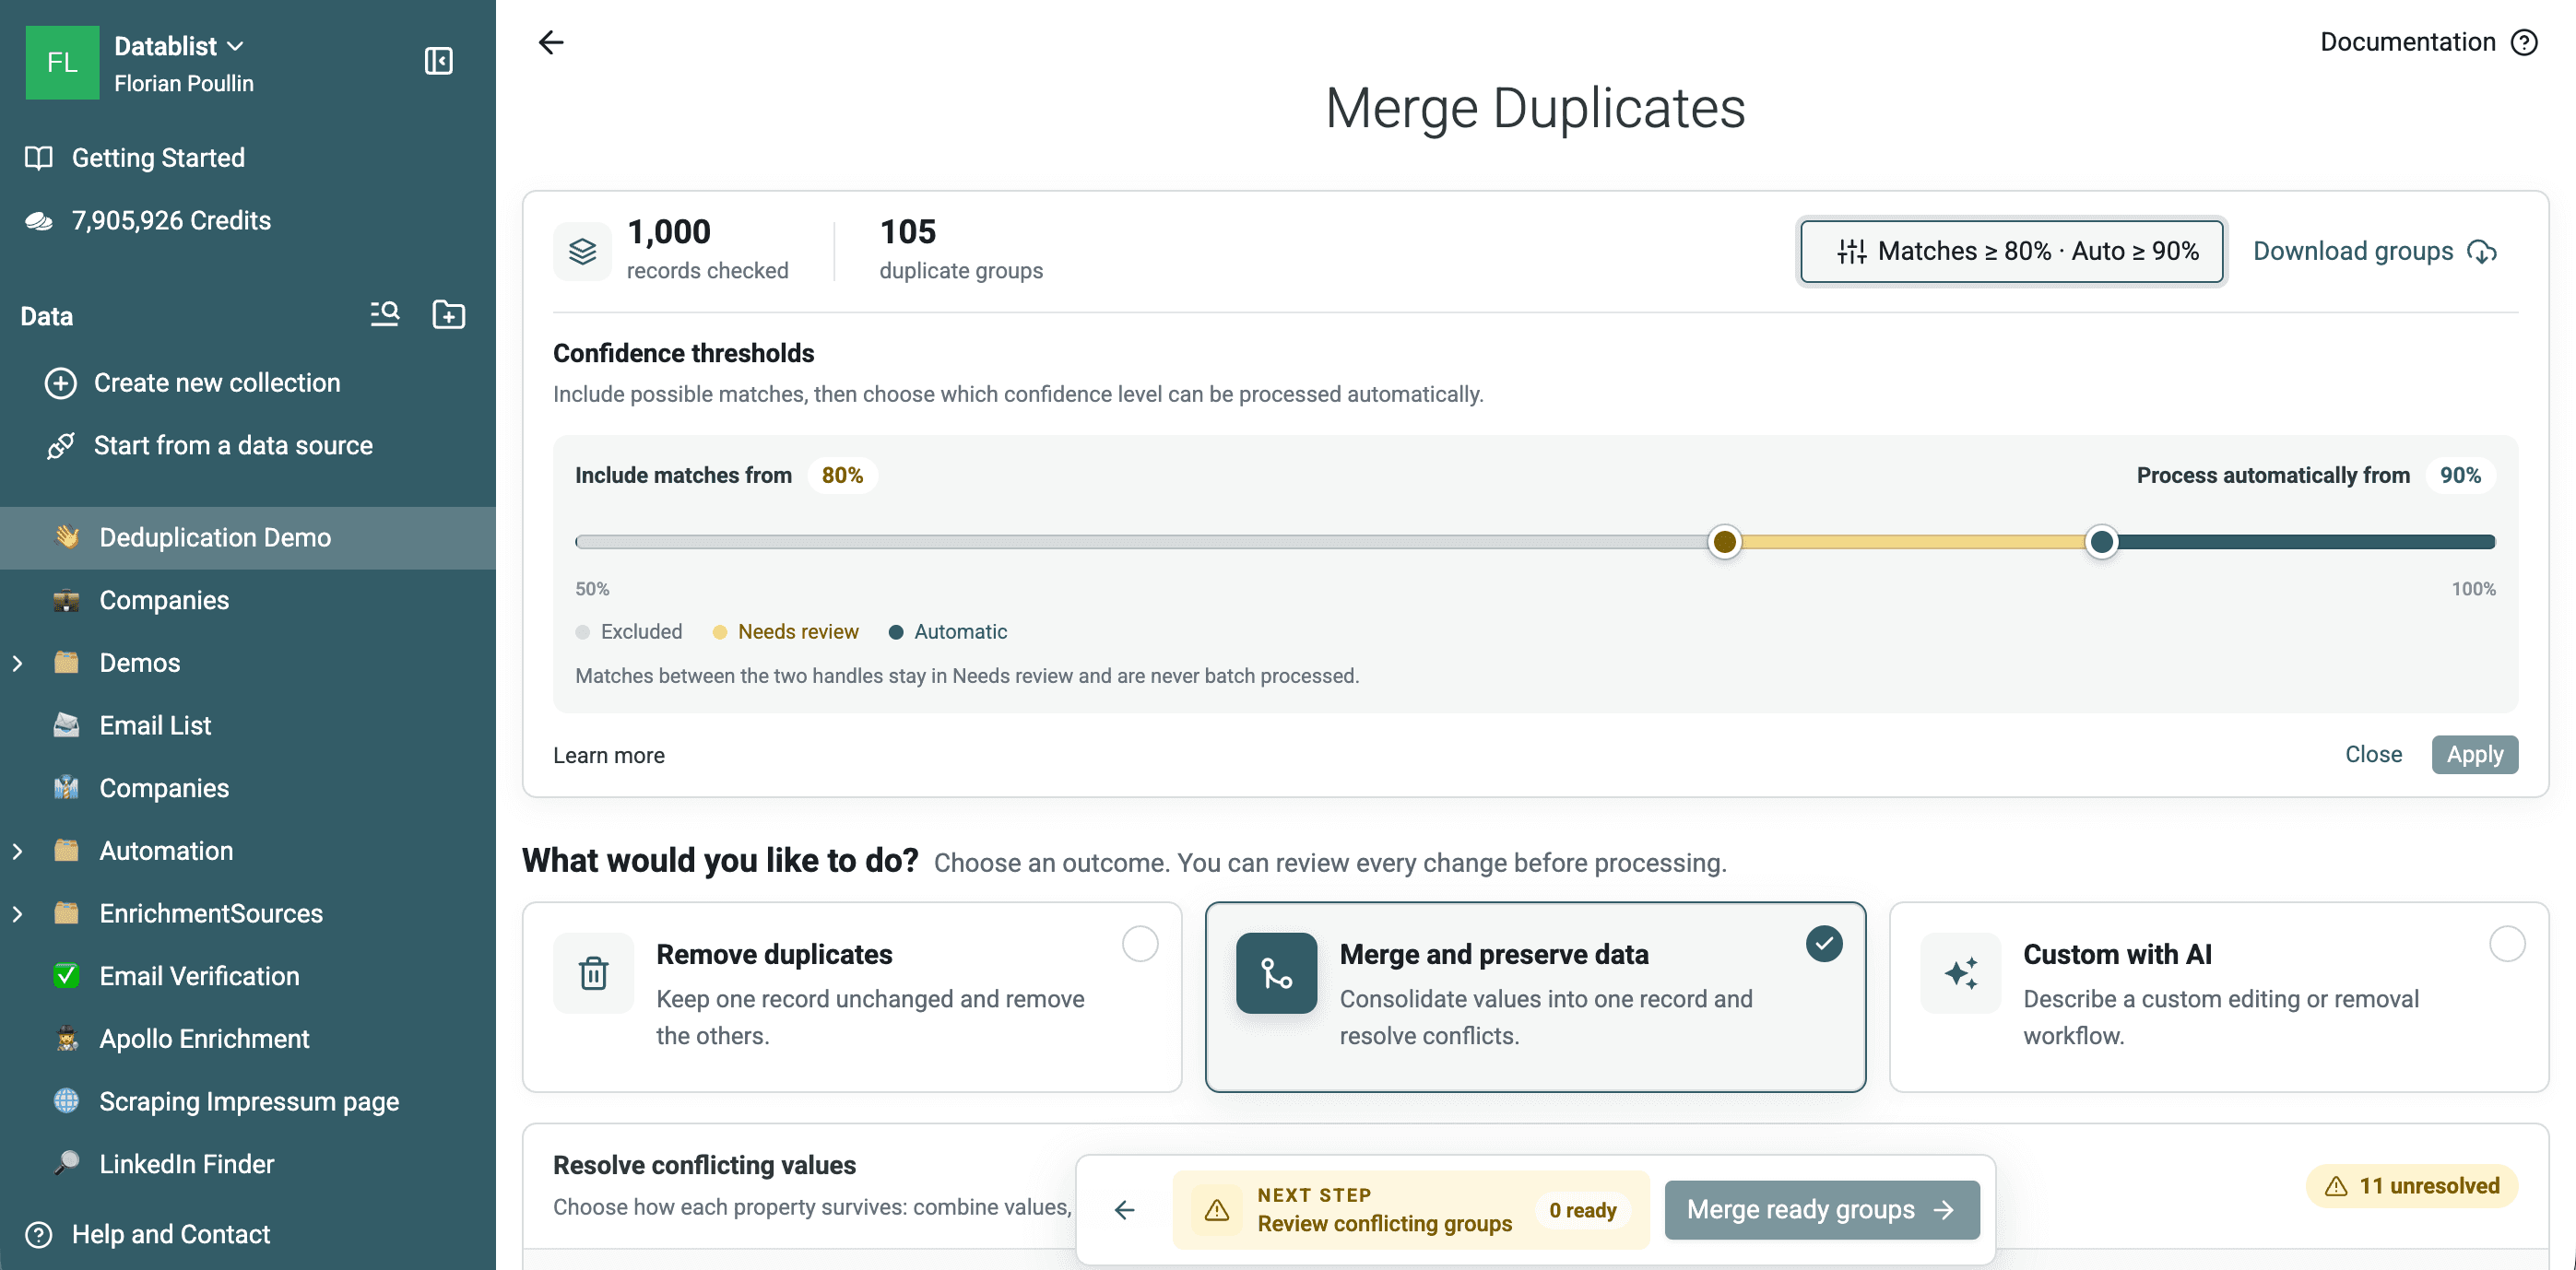
Resultatsidan har två reglage:
- Include matches from avgör vilka grupper som visas.
- Process automatically from behåller grupper med lägre säkerhet i Needs review och utesluter dem från batchbearbetning.
Den här uppdelningen gör att du kan granska en bred uppsättning kandidater utan att tillämpa samma automatiseringsregel på alla.
Granska dubblettgrupperna
Resultatarbetsytan delar upp dubblettgrupperna i Ready och Needs review.
- Ready-grupper har ett konkret bearbetningsresultat och uppfyller den automatiska säkerhetströskeln.
- Needs review-grupper har lägre säkerhet, olösta sammanslagningskonflikter, en regel för postval som inte gav någon träff eller en anpassad regel som hoppade över dem.
Kontrollera följande för varje osäker grupp:
- Representerar alla rader samma person, företag eller produkt?
- Vilken identifierare skapade matchningen?
- Finns det värden som kompletterar varandra?
- Vilken källa är mest tillförlitlig?
- Skulle du förlora ett telefonnummer, ID, en status, ett datum eller en anteckning om du tog bort en rad?
- Är gruppen sammanlänkad genom en svag tredje post?
Använd Why matched för att granska matchningsegenskaper, algoritmer, processorer och poängintervall. Vid fuzzy-kontroller motsvarar gruppens likhet den svagaste bevarade koppling som krävs för att hålla ihop gruppen.
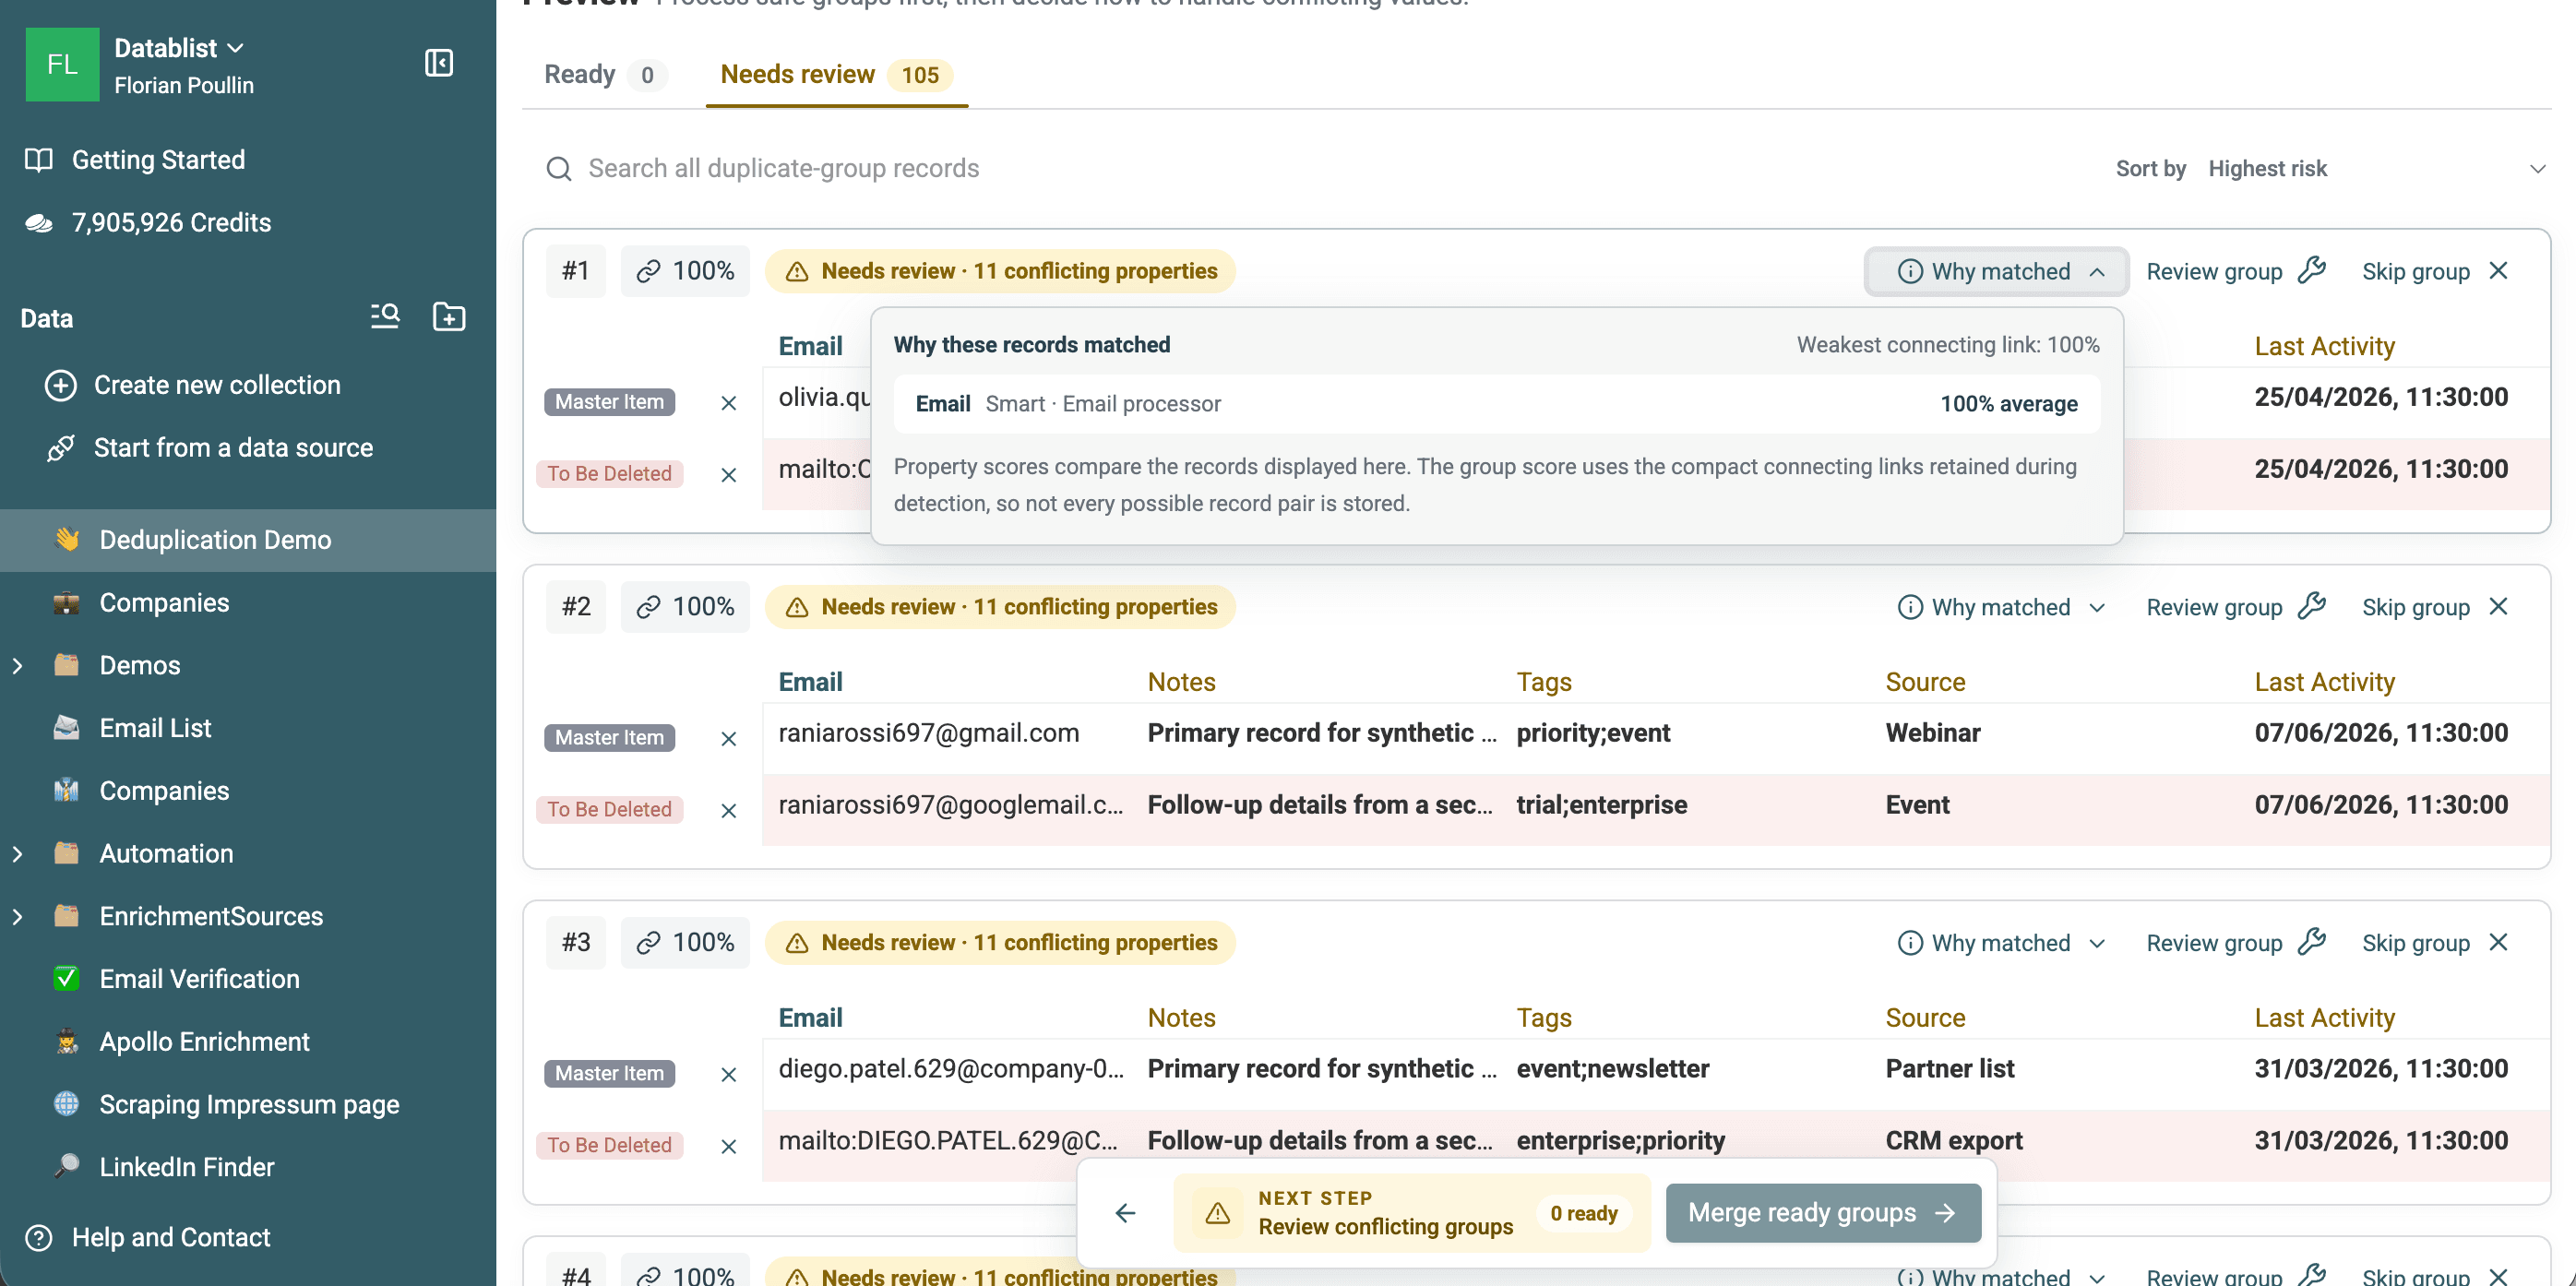
Du kan också:
- Bekräfta en matchning med låg säkerhet.
- Ta bort en post från en grupp utan att radera den.
- Hoppa över gruppen.
- Öppna och redigera en post.
- Granska gruppen i Merging Assistant.
- Söka bland alla återstående grupper och sortera de mest riskfyllda kandidaterna först.
⚠️ Bearbeta inte en fuzzy-grupp enbart utifrån procentsatsen
Liknande namn kan tillhöra olika personer. Granska identifierarna och de omgivande fälten innan du bekräftar gruppen.
Kontrollera delade och saknade identifierare före sammanslagning
En gemensam inkorg som info@company.example kan tillhöra flera kontakter. Två personer med den adressen kan matcha på Email och ändå vara olika personer. På samma sätt kan en företagsdomän identifiera ett företag men förekomma i många medarbetarposter.
Jag skulle undanta sådana grupper från automatisk sammanslagning på personnivå tills en annan identifierare stöder matchningen. Om målet i stället är en rad per företag kan den gemensamma domänen vara precis den grupperingsnyckel du behöver. Definiera entiteten innan du tolkar resultatet.
Regeln för tomma värden påverkar också jämförelser av valda egenskaper. Vid en kontroll av flera egenskaper med en annan jämförelse än Exact erbjuder den avancerade inställningen Empty Value Rule alternativen Value required (default) och Match on empty value. Standardalternativet kräver att textidentifieraren finns. Om du tillåter matchning av tomma värden blir kravet mindre strikt. Använd bara det alternativet när de övriga matchningsfälten ger tillräckliga identitetsbevis. Två e-postadresser som saknas är inget bevis på att två personer är samma person.
Två rader med tom Email och olika Full Name-värden ska till exempel inte slås ihop enbart för att minska antalet rader. En rad utan e-postadress kan fortfarande innehålla en kontakt som du behöver behålla eller enrich:a senare.
Ta bort, slå ihop eller använd egna regler
Att hitta och att hantera dubbletter är två separata beslut. Välj bearbetningsläge efter att du har granskat vad de sekundära raderna innehåller.
Ta bort dubbletter när en rad är huvudpost
Remove duplicates behåller en vald post oförändrad och raderar de övriga raderna i varje Ready-grupp.
Använd funktionen för kopierade rader, tillfälliga importer eller poster vars sekundära värden kan tas bort. Förhandsgranskningen varnar när posterna som ska raderas innehåller ytterligare eller motstridig information. Dessa värden kopieras inte till den post som behålls.
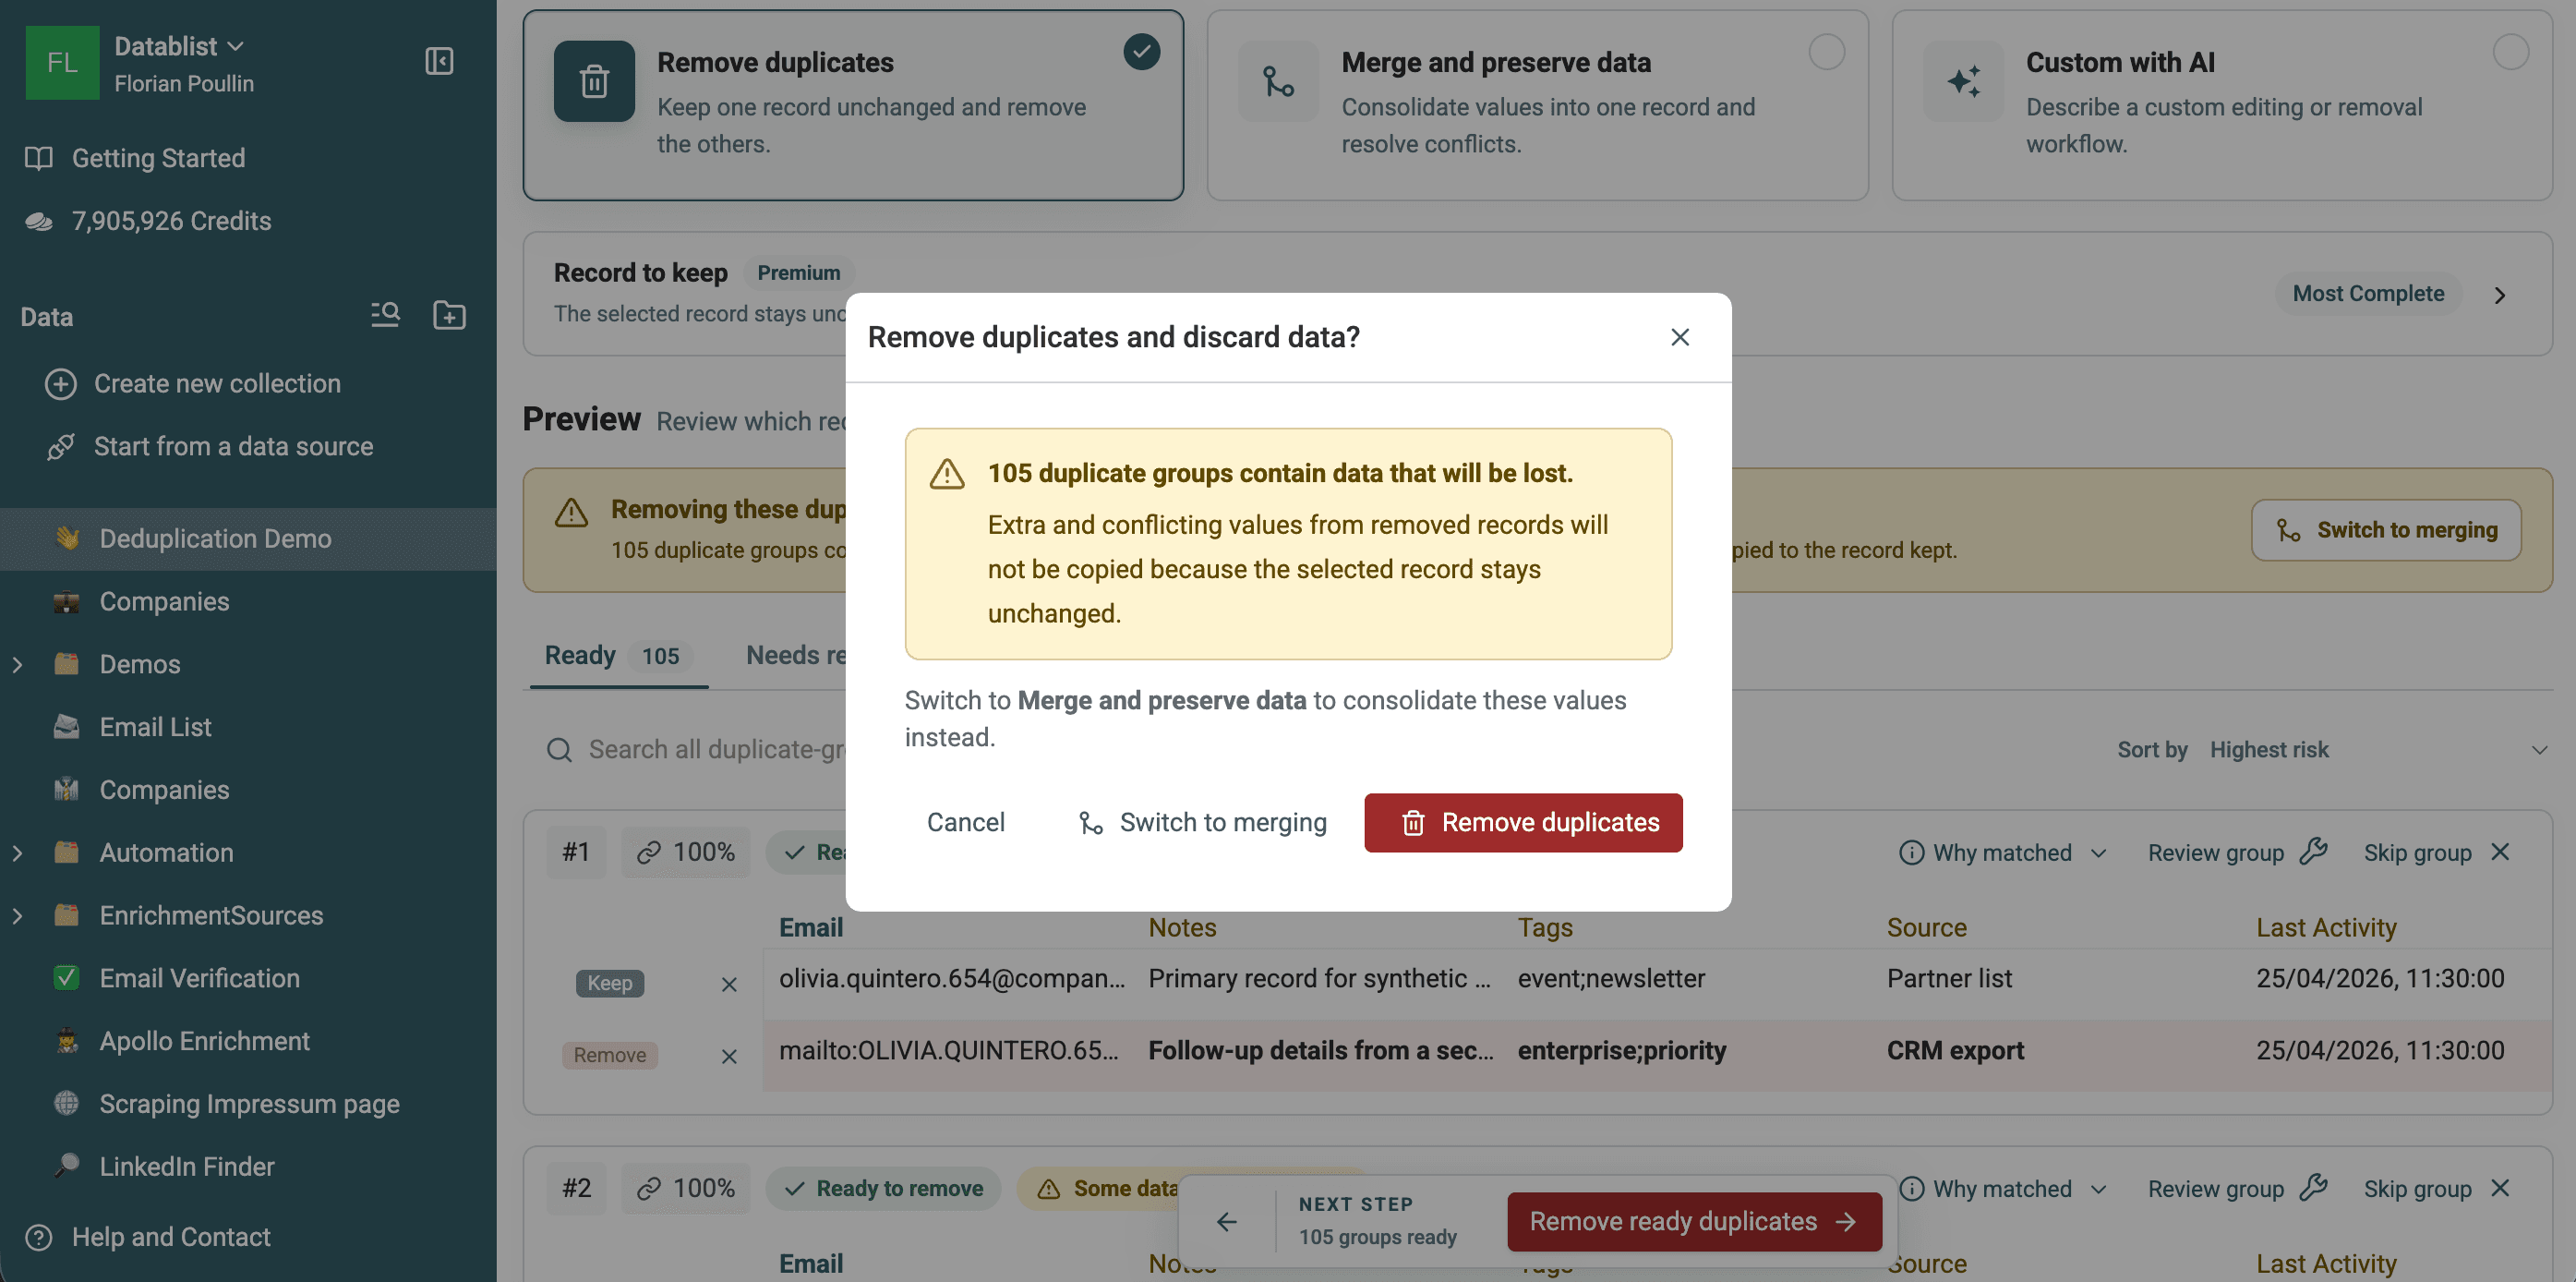
Slå ihop rader som innehåller användbar data
Merge and preserve data fyller i tomma egenskaper i den valda posten, löser konfigurerade konflikter och raderar sedan de sekundära raderna.
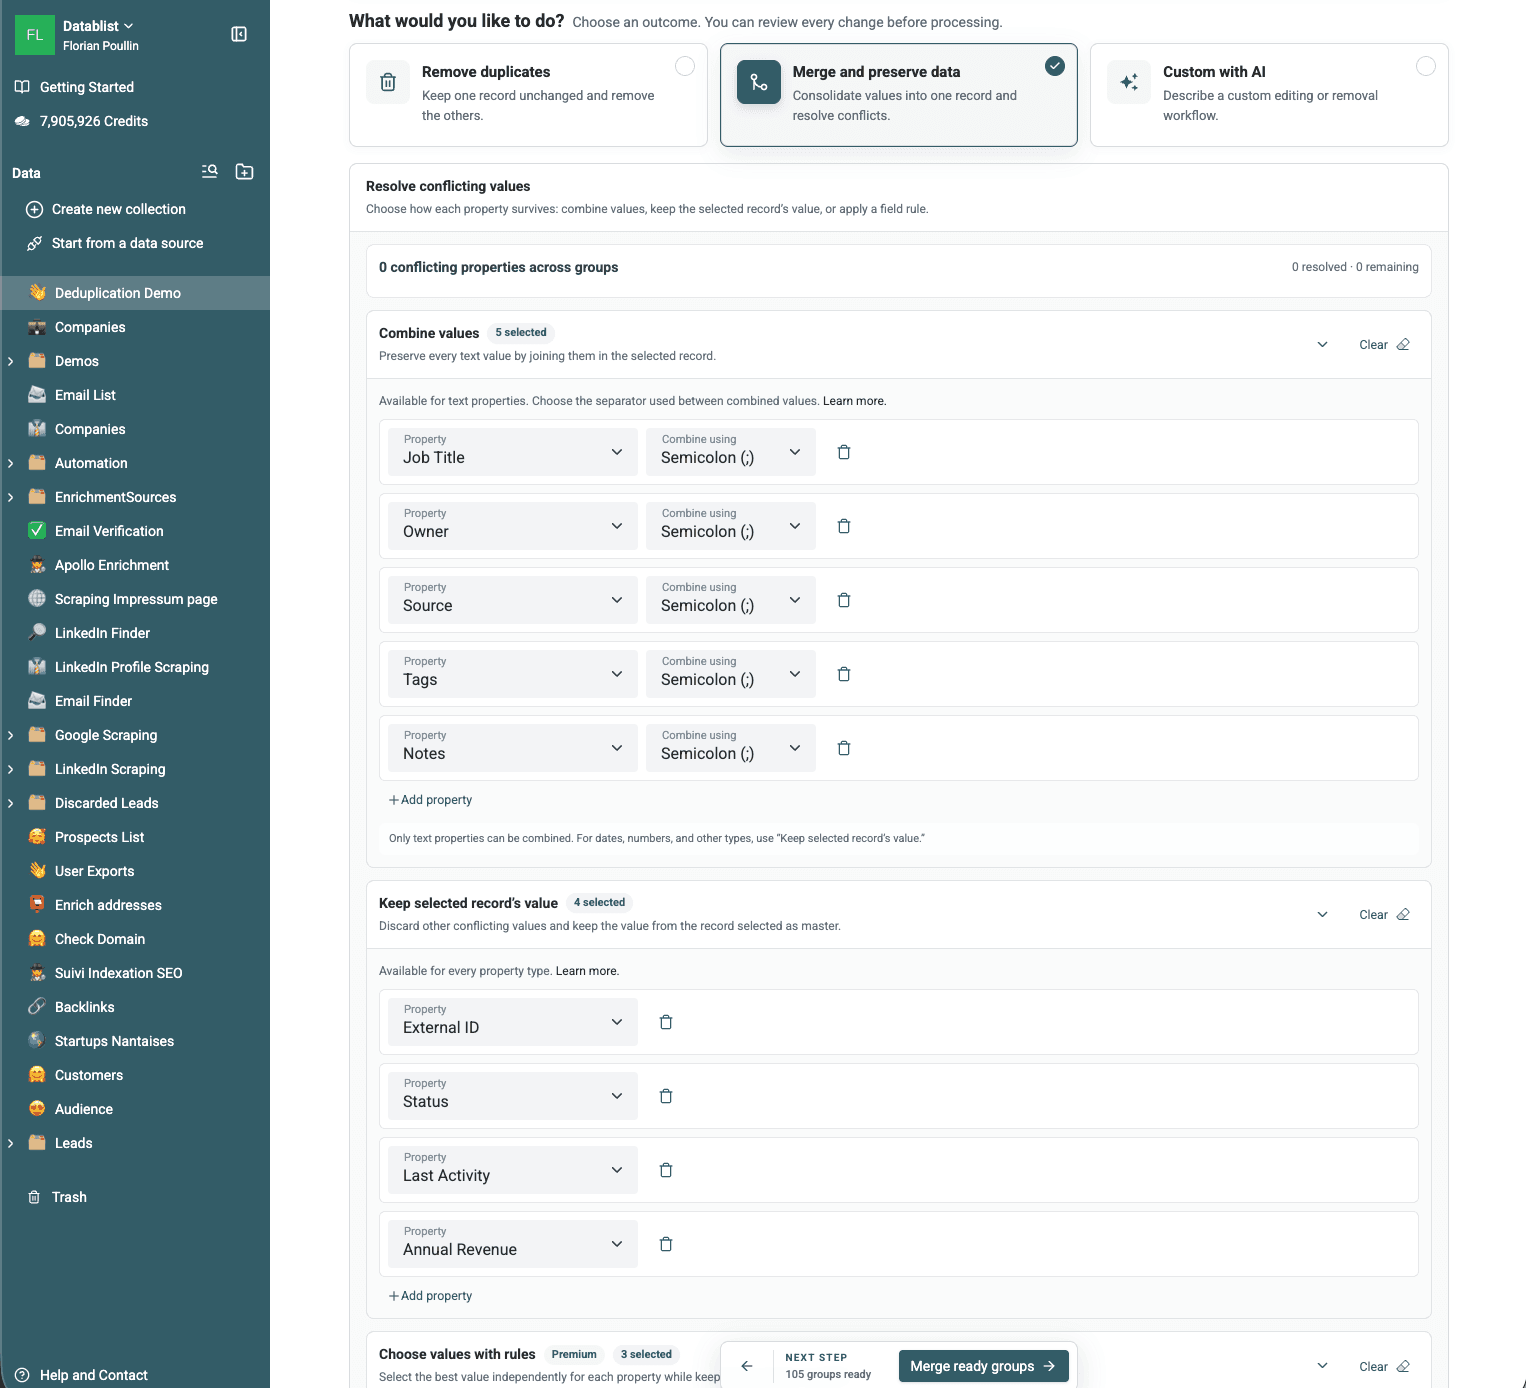
Börja med regeln Record to keep. Most Complete är standardalternativet. Med betalplaner kan du välja regler utifrån skapandetid, uppdateringstid, högsta eller lägsta egenskapsvärde eller ett obligatoriskt egenskapsvärde.
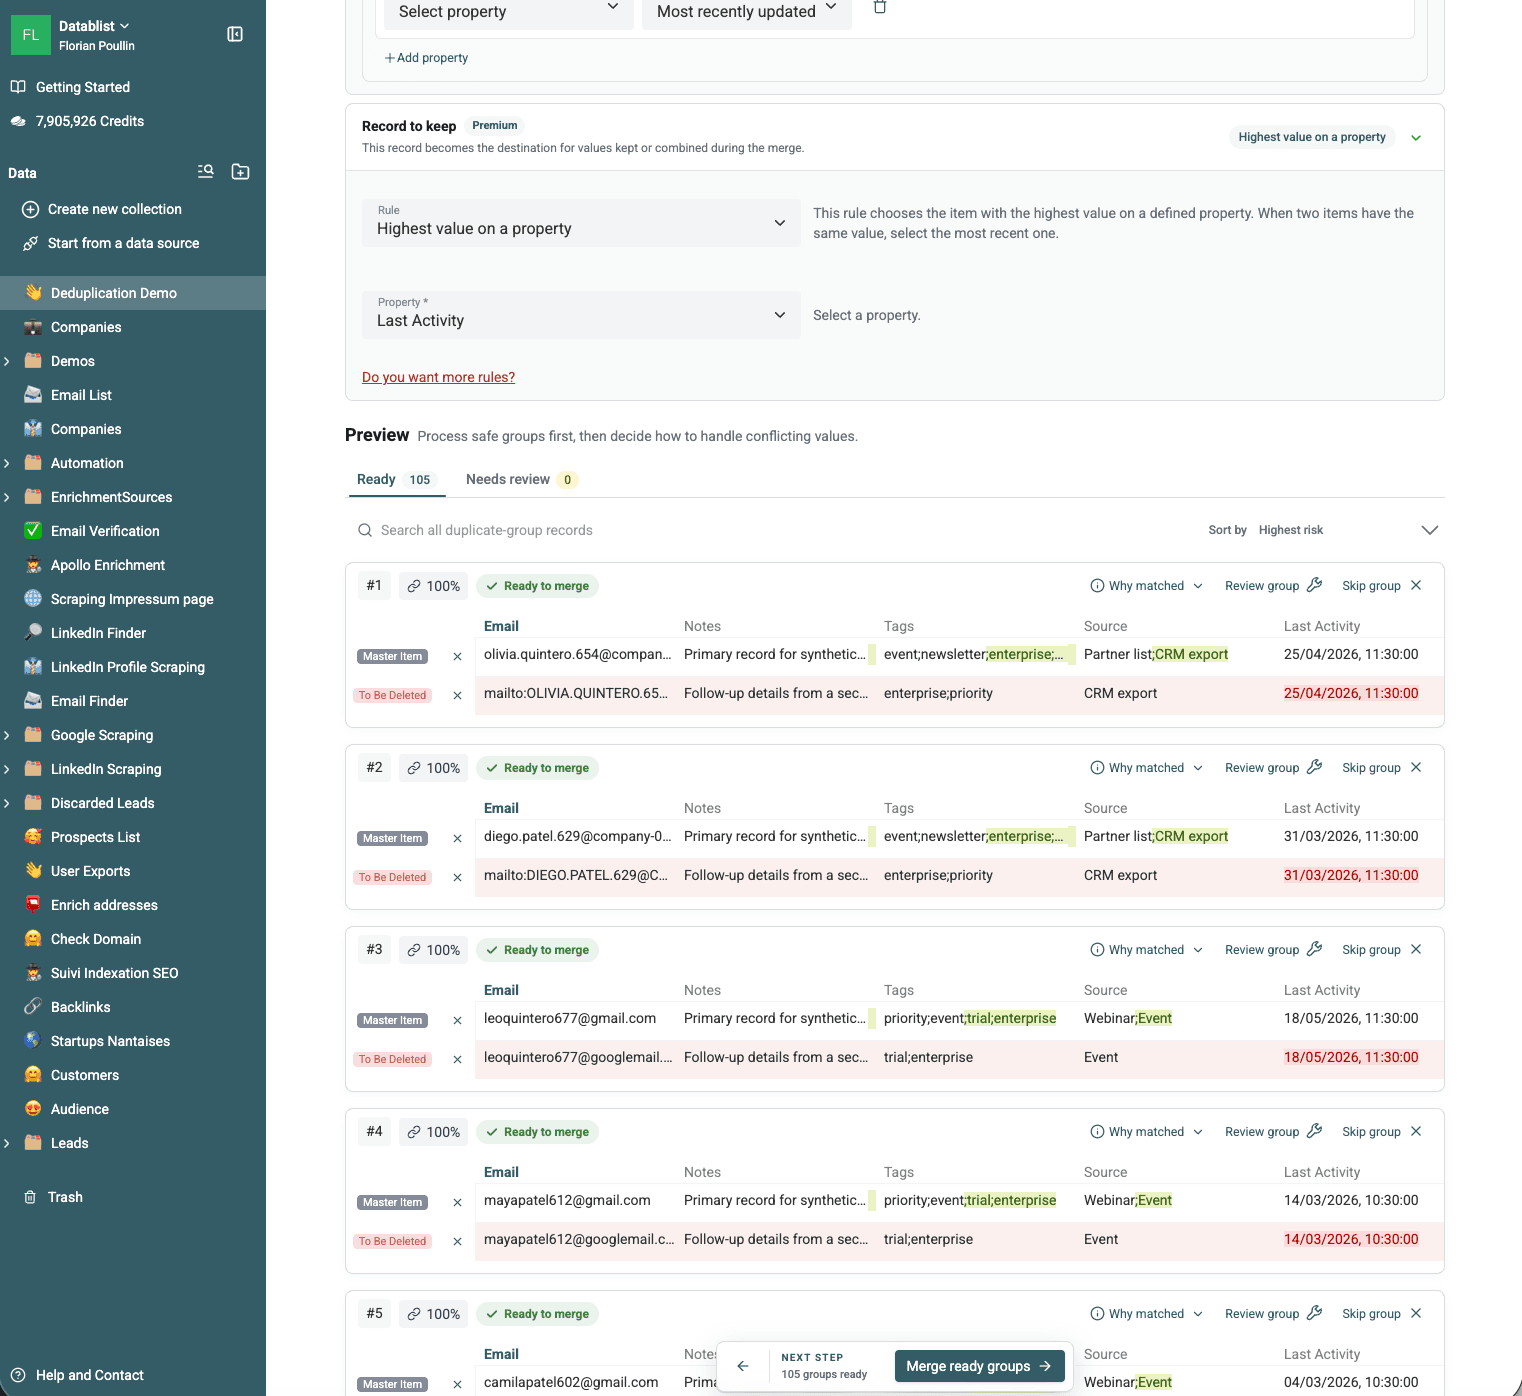
Bestäm sedan hur varje motstridig egenskap ska bevaras:
- Kombinera unika textvärden med en avgränsare.
- Behåll värdet från den valda posten.
- Med betalplaner kan du välja värden oberoende av huvudposten, med regler som senaste, äldsta, längsta, kortaste, högsta, lägsta eller vanligaste.
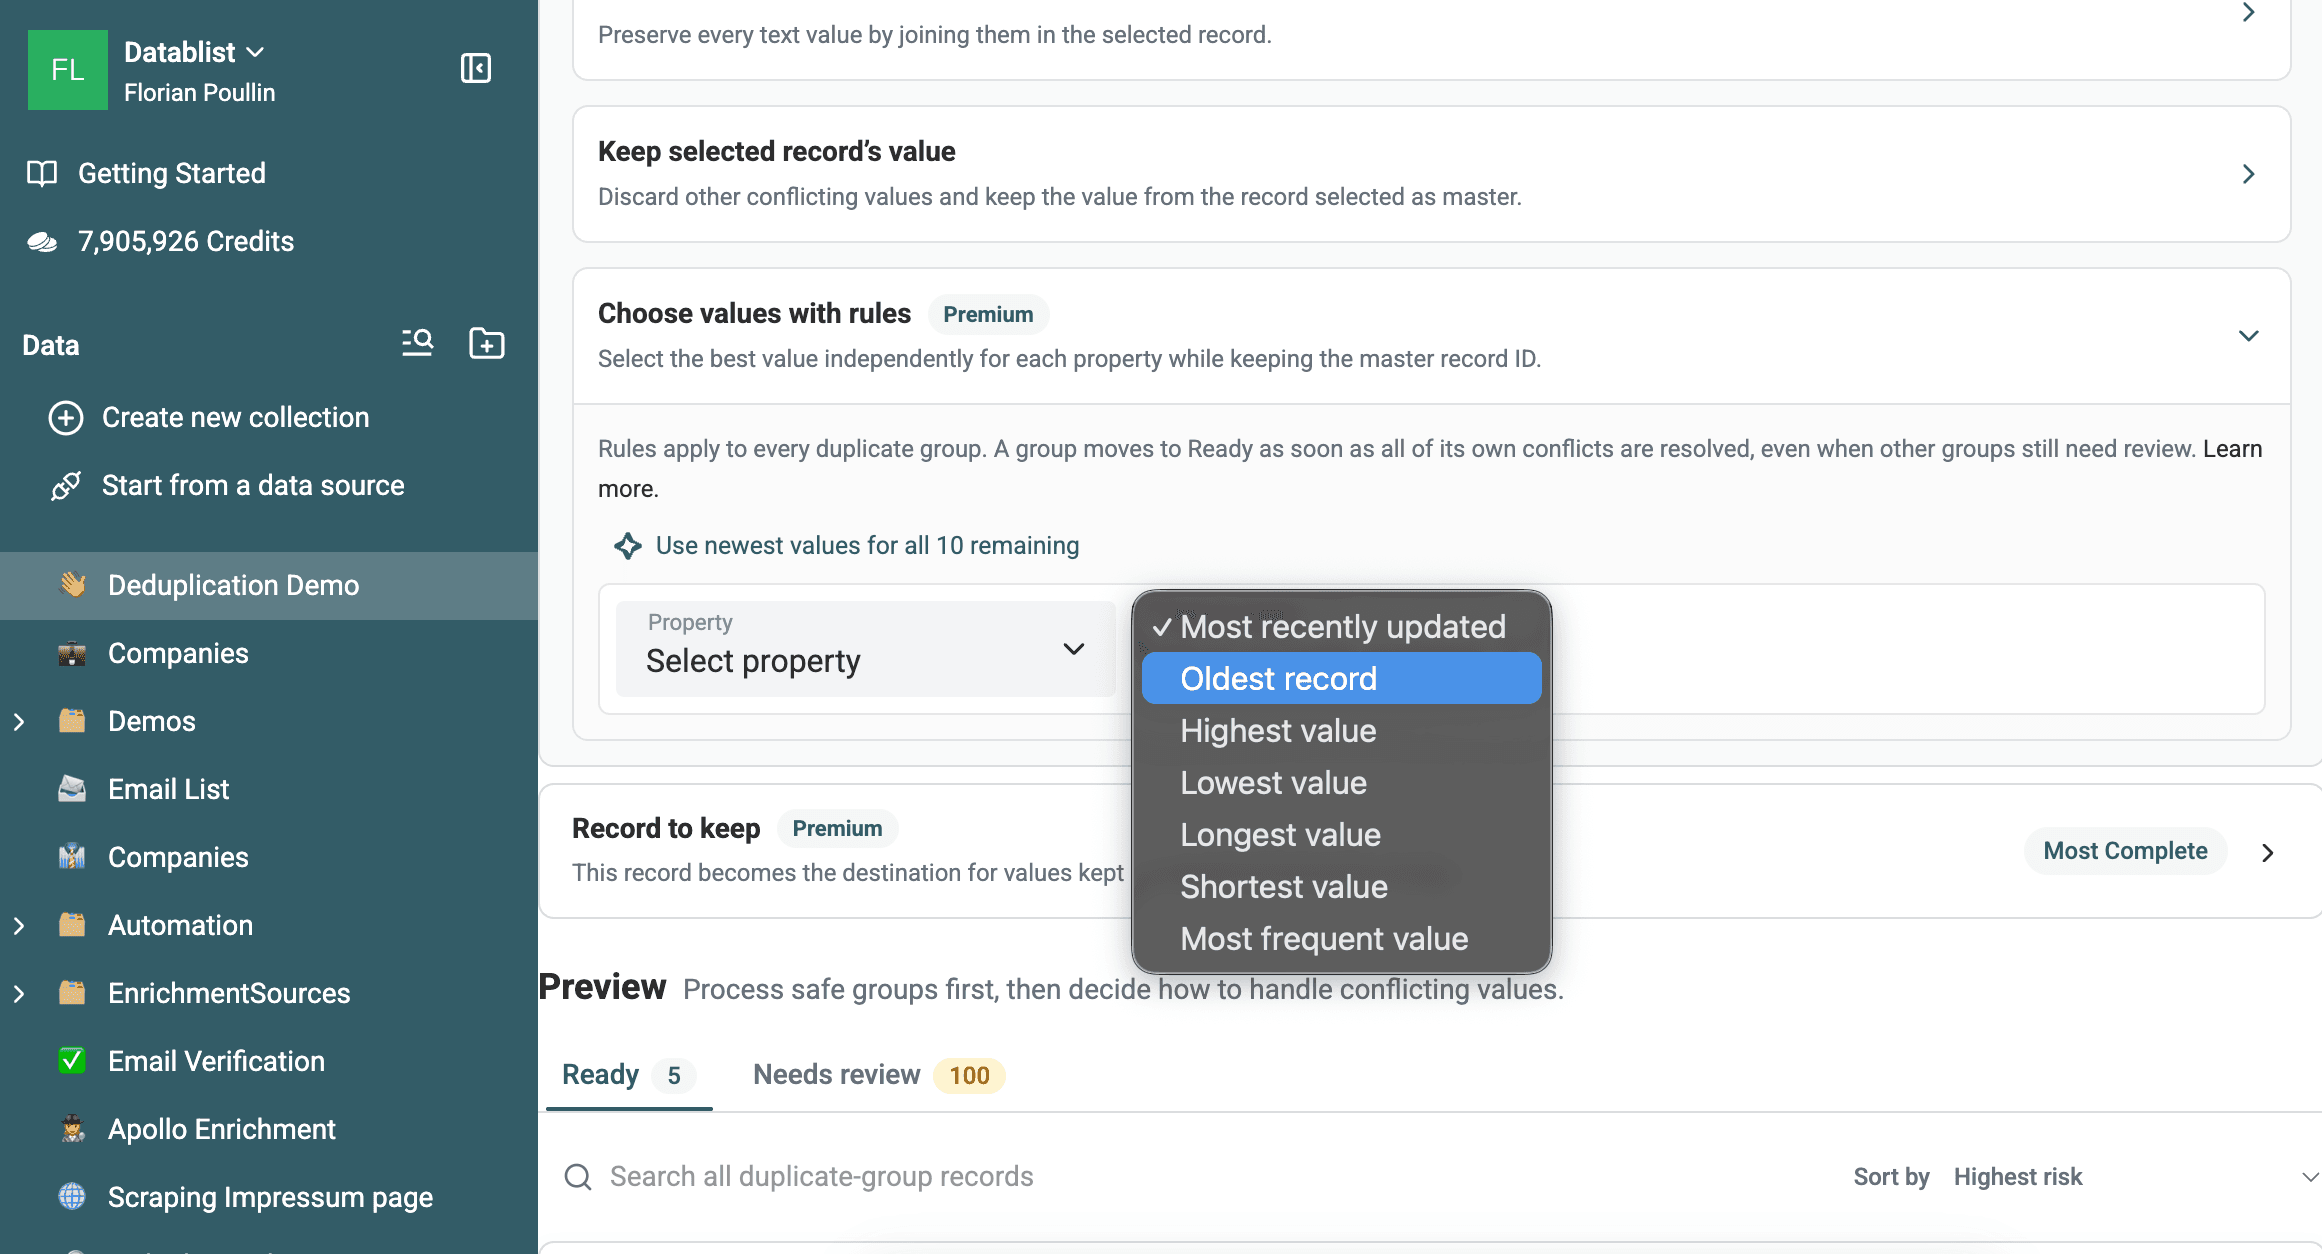
Använd regler på fältnivå när ingen enskild rad har det bästa värdet för varje egenskap. Du kan behålla den valda postens ID och samtidigt hämta en nyare befattning, ett längre företagsnamn och den vanligaste statusen från andra rader.
Uppdatera förhandsgranskningen när du ändrar tröskeln, arbetsflödet, gruppmedlemskapet, konfliktinställningarna eller regeln för val av post.
Använd Custom with AI för gruppspecifika regler
Custom with AI skapar ett arbetsflöde för gruppbearbetning utifrån en instruktion i klartext. Funktionen kan välja en post, kopiera eller normalisera värden, lägga till en statusegenskap, beräkna en gruppsumma, radera sekundära rader eller hoppa över grupper som inte uppfyller ett villkor.
Till exempel:
Behåll posten vars Source är CRM export. Kopiera Job Title från den senaste posten, kombinera unika Notes med radbrytningar, lägg till kryssrutan Duplicate Reviewed och radera sedan de sekundära posterna.
Referera till egenskaper i collectionen med /Property eller {{Property}}. Generera och förhandsgranska arbetsflödet innan du kör det. Custom with AI är tillgängligt för inloggade användare med en betalplan.
För enskilda undantag öppnar du Review group och använder Merging Assistant i stället för att göra batchregeln mer komplicerad.
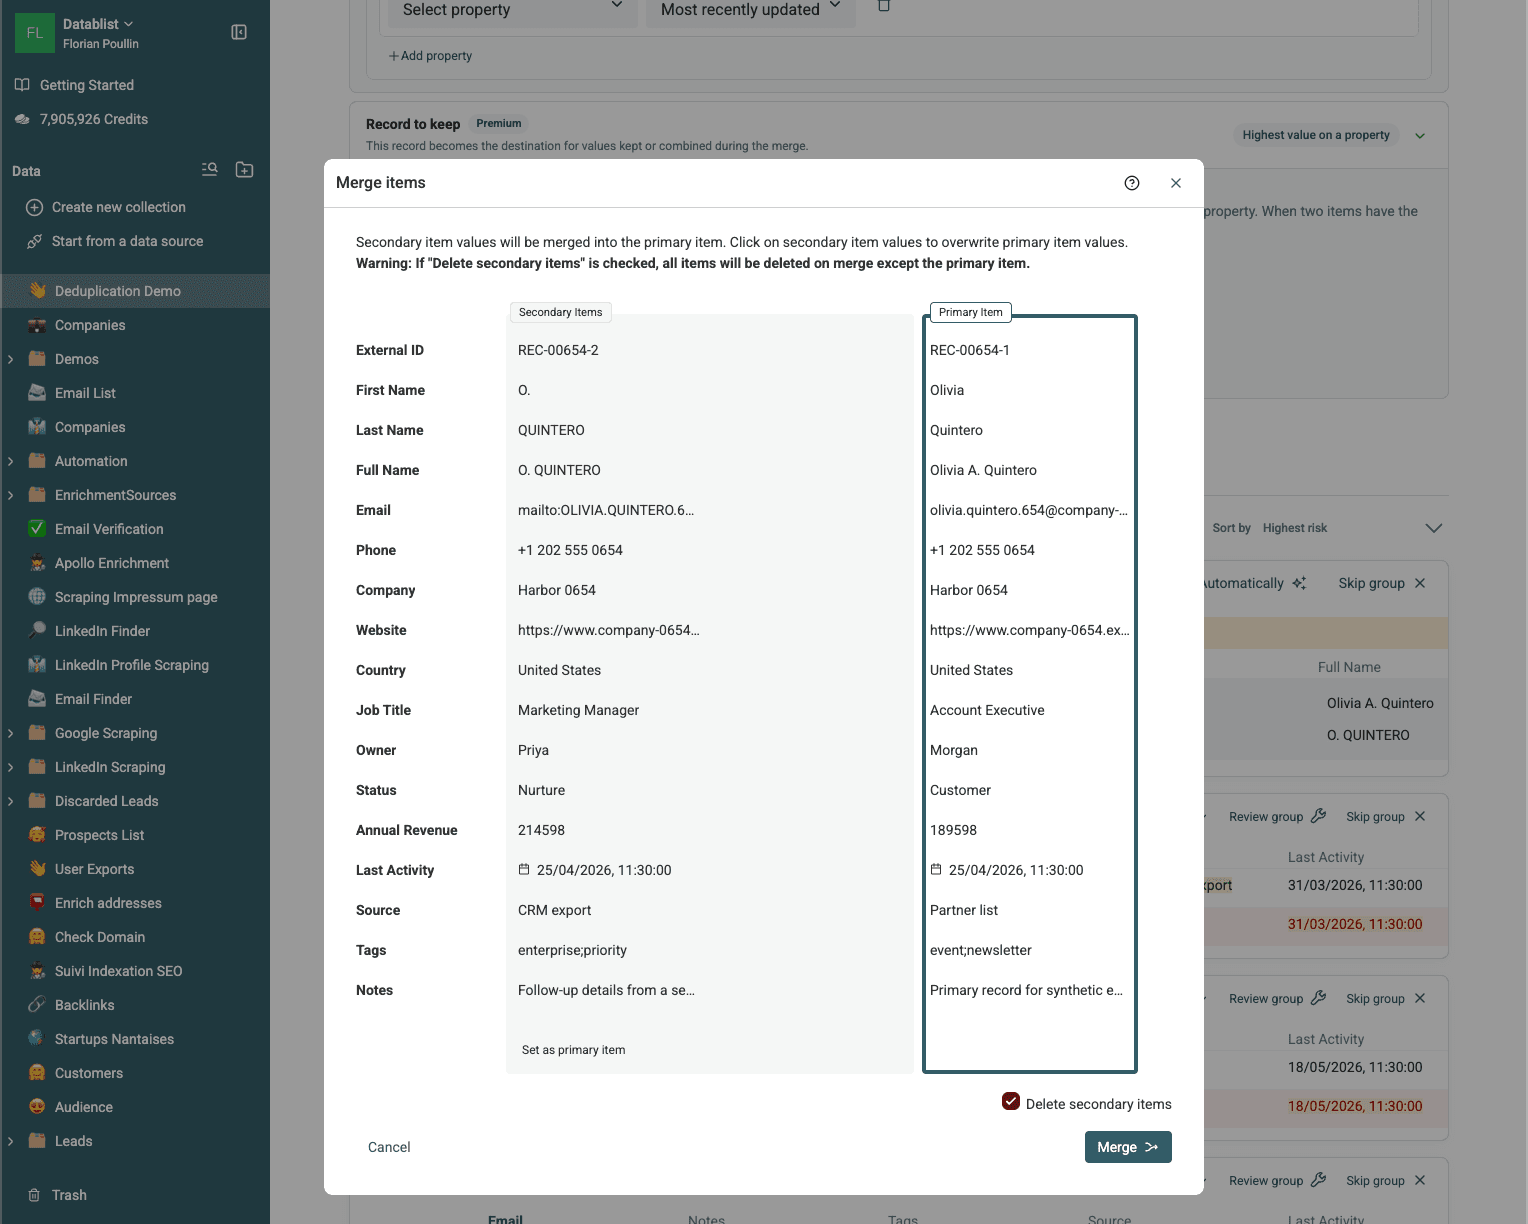
Validera och exportera den rensade listan
Kontrollera följande innan du bearbetar Ready-grupper:
- Förhandsgranskningen återspeglar de aktuella inställningarna.
- Grupper med låg säkerhet och delade identifierare har granskats.
- Den valda posten har det ID som du behöver bevara.
- Unika värden för telefonnummer, källa, anteckning och status bevaras.
- Fält som bara får innehålla ett värde sammanfogas inte.
- Det visade antalet Ready-grupper motsvarar omfattningen du vill bearbeta.
Stäm av antalet rader efter bearbetningen:
Ursprungligt antal rader - raderade sekundära rader = slutligt antal rader
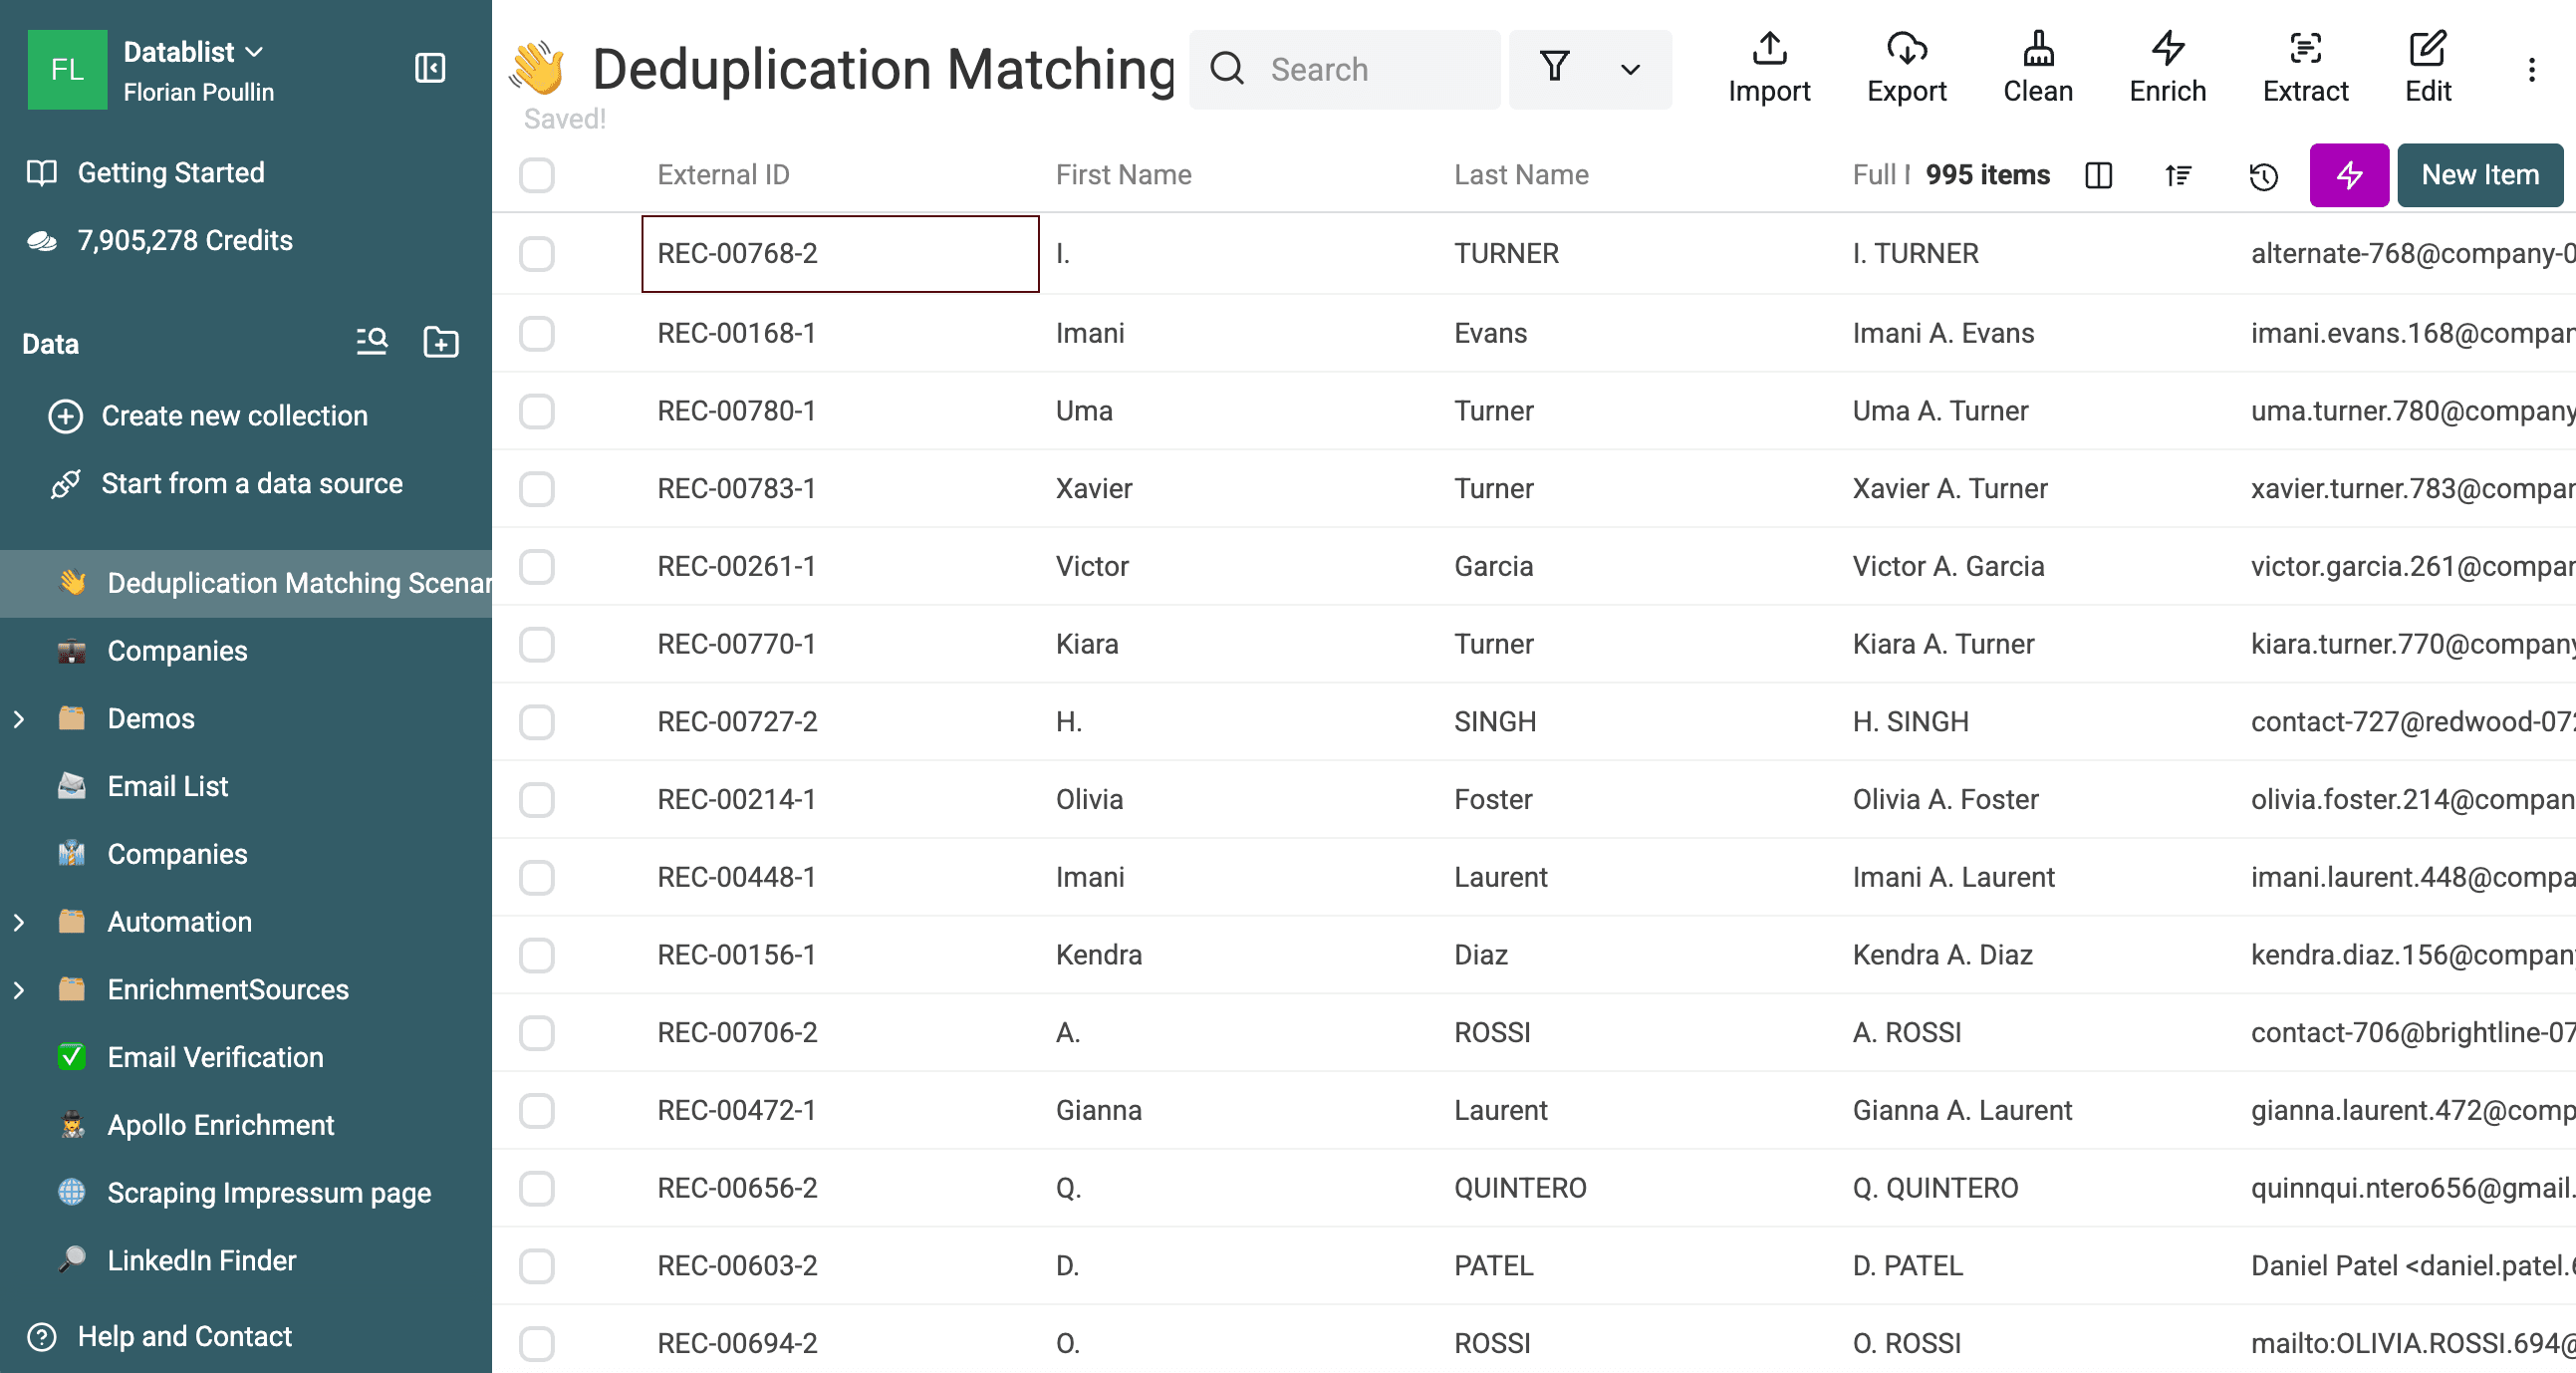
För Exact-matchningen i den här guiden slog Datablist ihop fem grupper med två rader. Collectionen gick därför från 1 000 till 995 objekt.
Ladda ned dubblettgrupperna före bearbetningen om du behöver en extern granskningsfil. Betalplanerna inkluderar användbara ID:n för dubblettgrupper och en ändringslogg efter bearbetningen. Ändringsloggen registrerar borttagna och uppdaterade Datablist-ID:n tillsammans med föregående värden och målvärden.
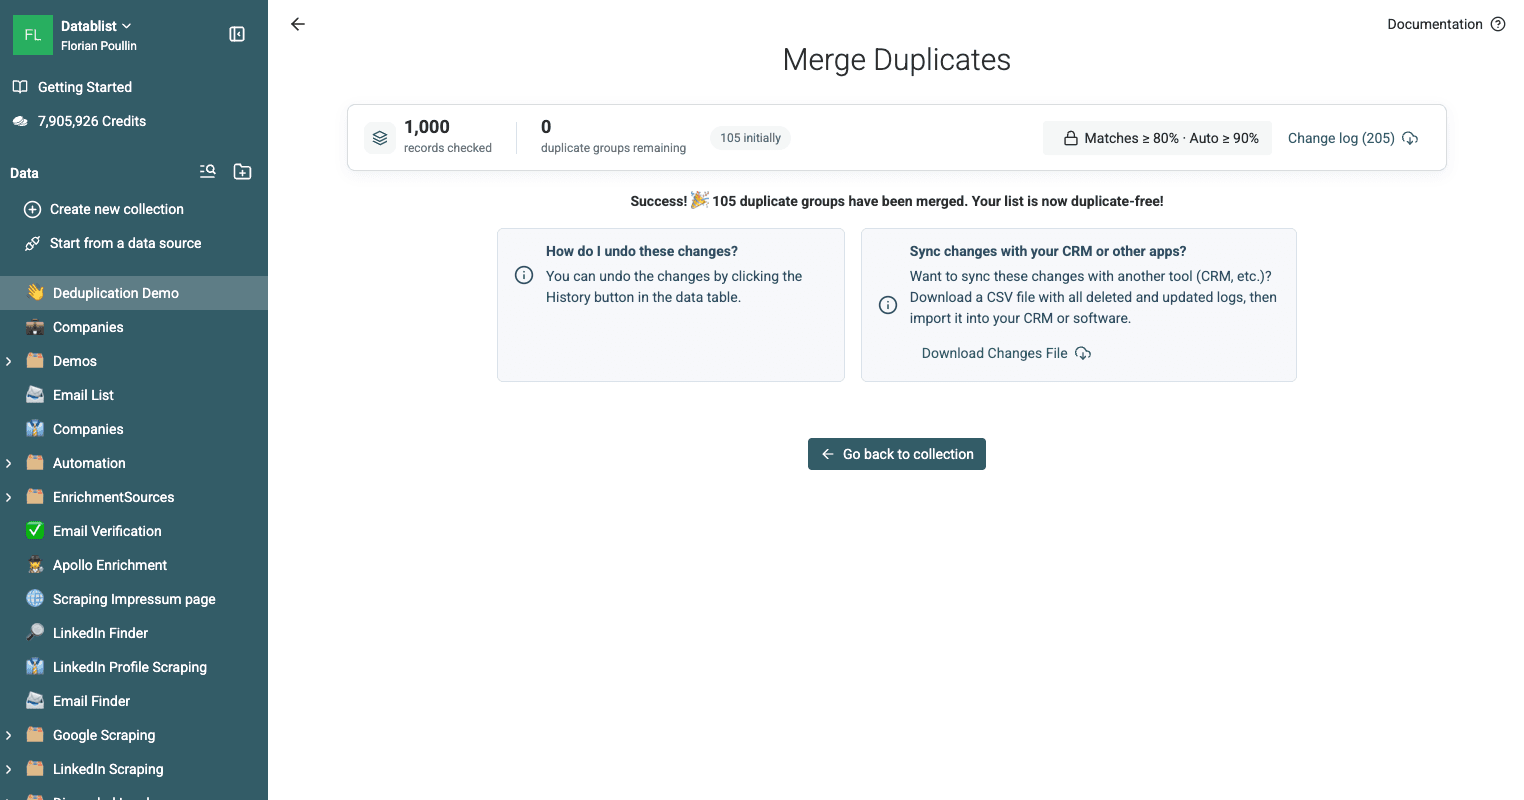
Automatiska borttagningar och sammanslagningar visas också i collectionens History, där du kan ångra dem.
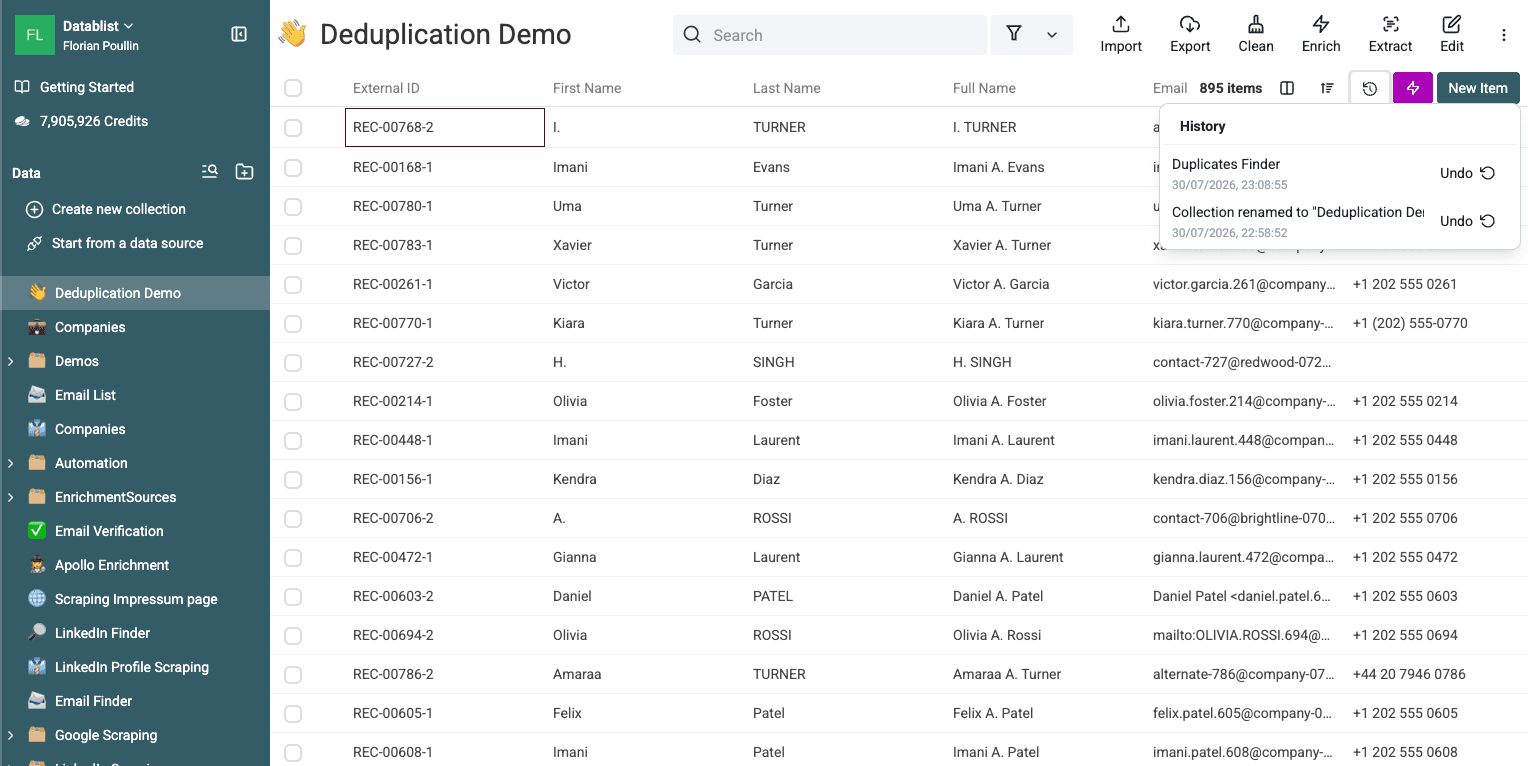
Gå tillbaka till collectionen och öppna Export för att ladda ned den rensade CSV- eller Excel-filen.
Deduplicera flera listor
Använd matchning mellan collections när en ny lead-lista ska jämföras med en CRM-export. Behandla CRM-systemet som referenslista och ta bort matchande poster från den inkommande listan före importen.
Ladda ned CRM-demofilen och demofilen med eventdeltagare för att testa arbetsflödet. Filerna har olika kolumnrubriker och innehåller 100 avsiktligt skapade överlappande e-postadresser. Varje fil börjar med 250 rader.
Importera varje fil till en egen collection och öppna sedan Clean > Match across collections. Lägg till båda collections och mappa motsvarande egenskaper, till exempel Email mot Attendee Email.
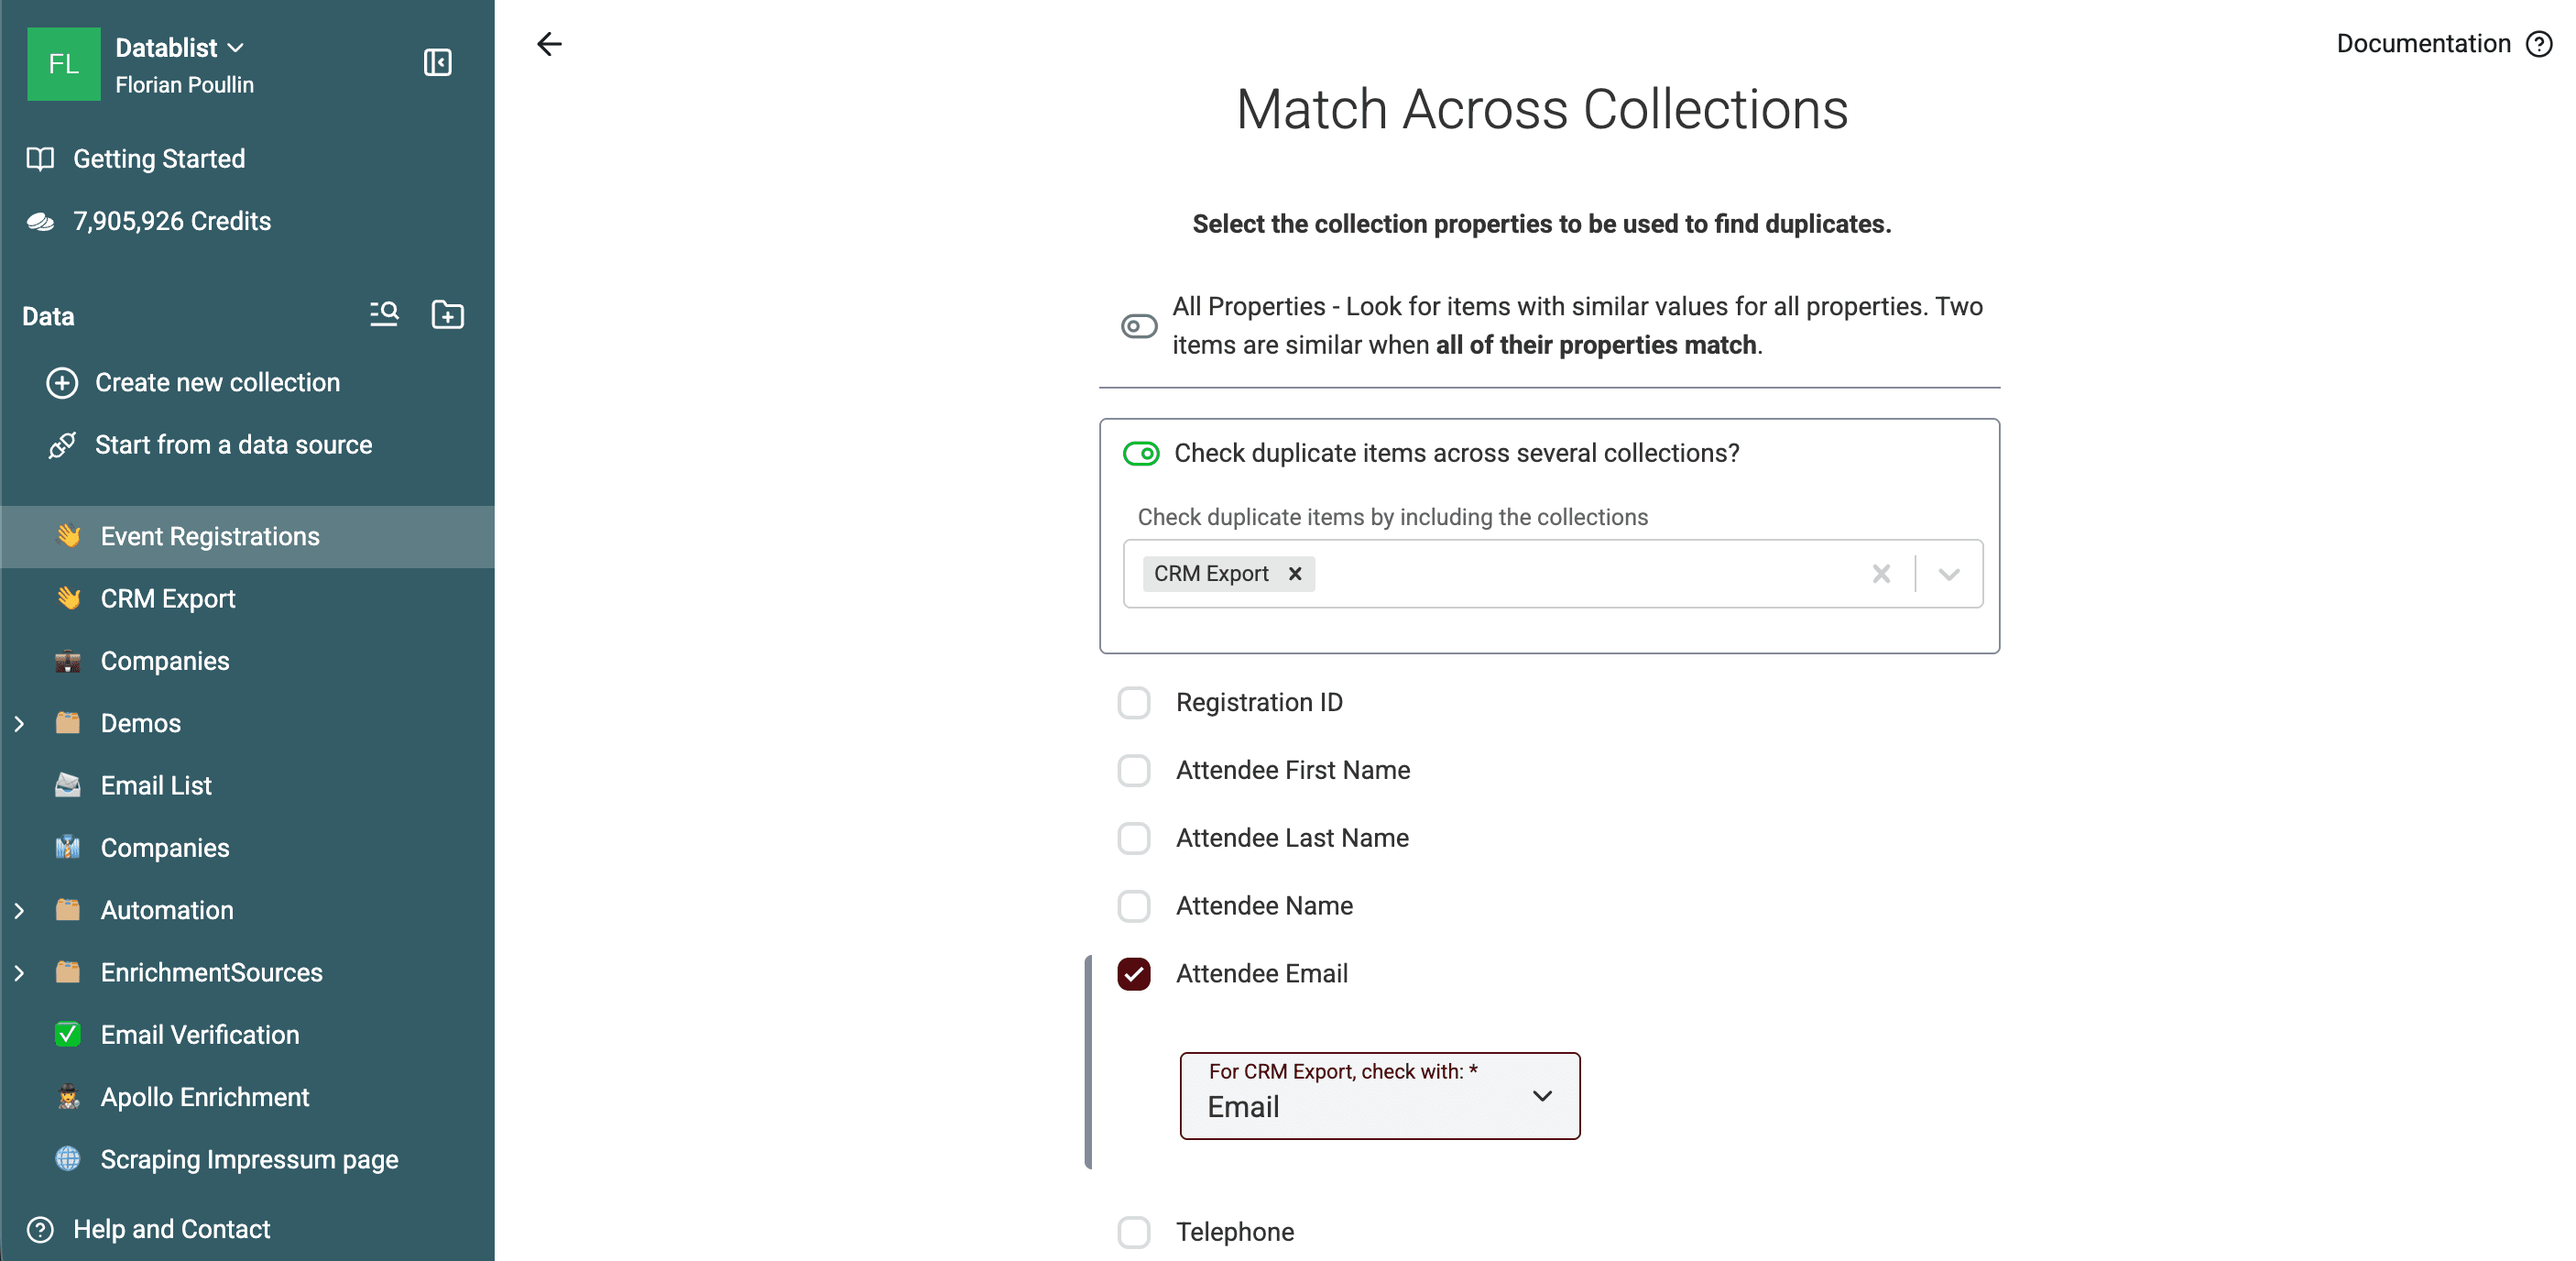
I det här testet gav Smart-matchning med Email-processorn 100 grupper mellan collections från 500 kontrollerade poster. Välj Event Registrations under Remove duplicate items from collection {X} för att lämna CRM-systemet oförändrat och ta bort dess matchningar från eventlistan.
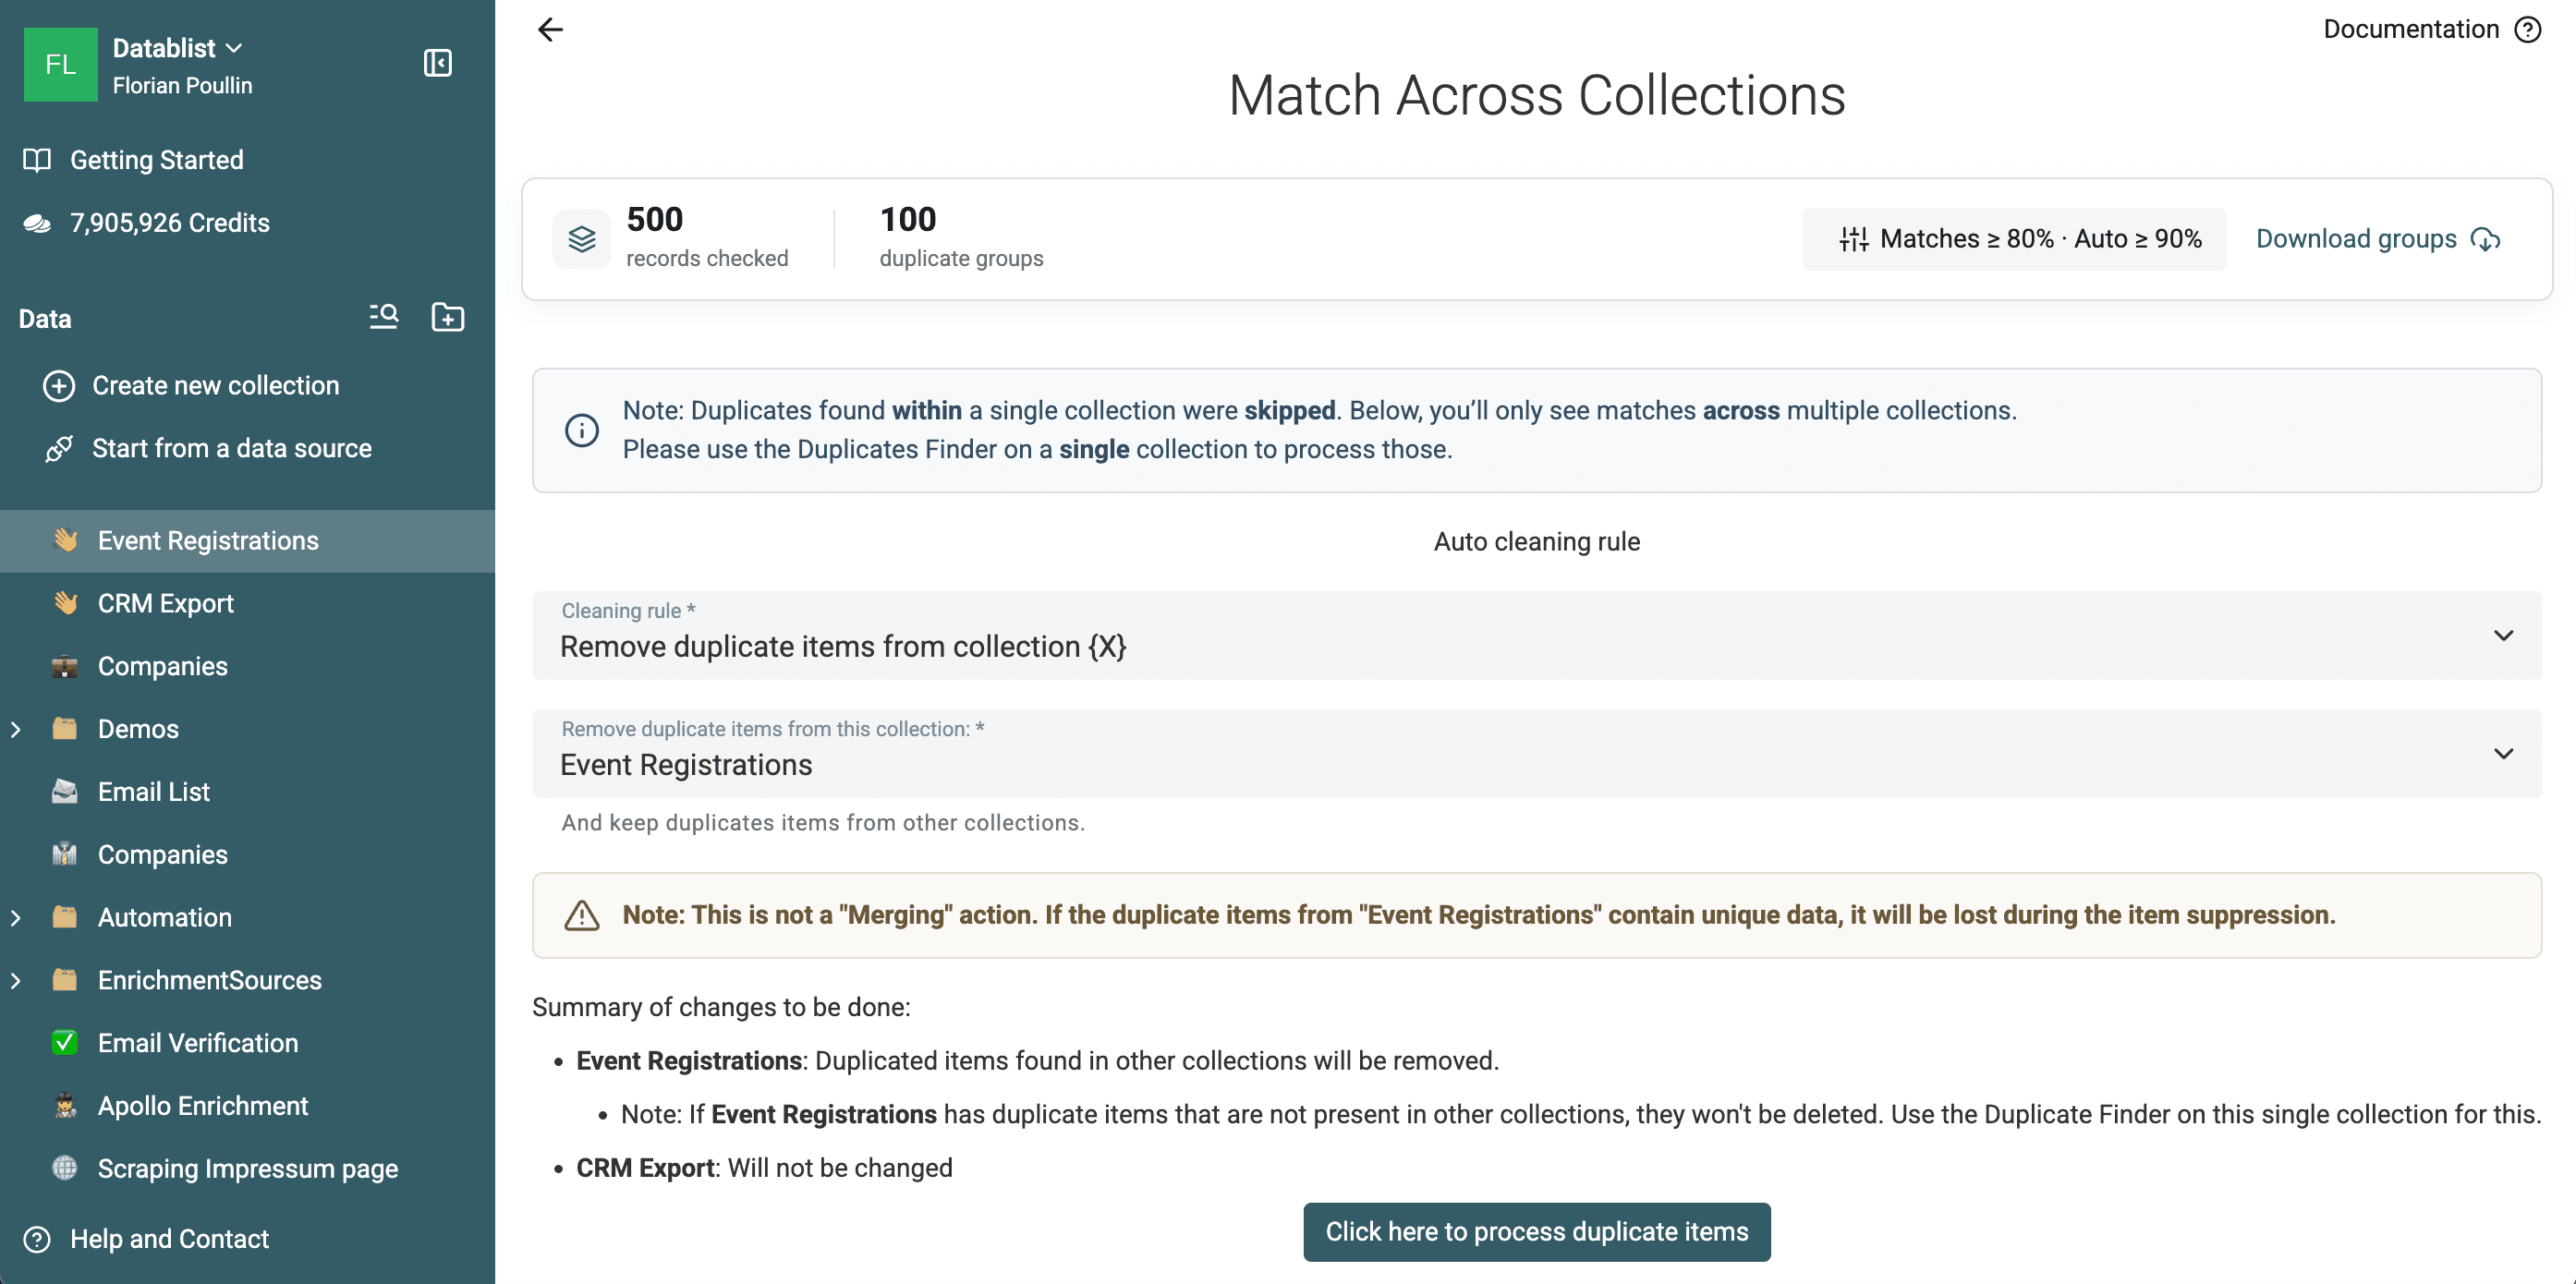
Automatisk rensning mellan collections tar bort rader. Den slår inte ihop unika eventvärden med CRM-systemet. Exportera eller granska grupperna först om de inkommande posterna innehåller information som du behöver bevara.
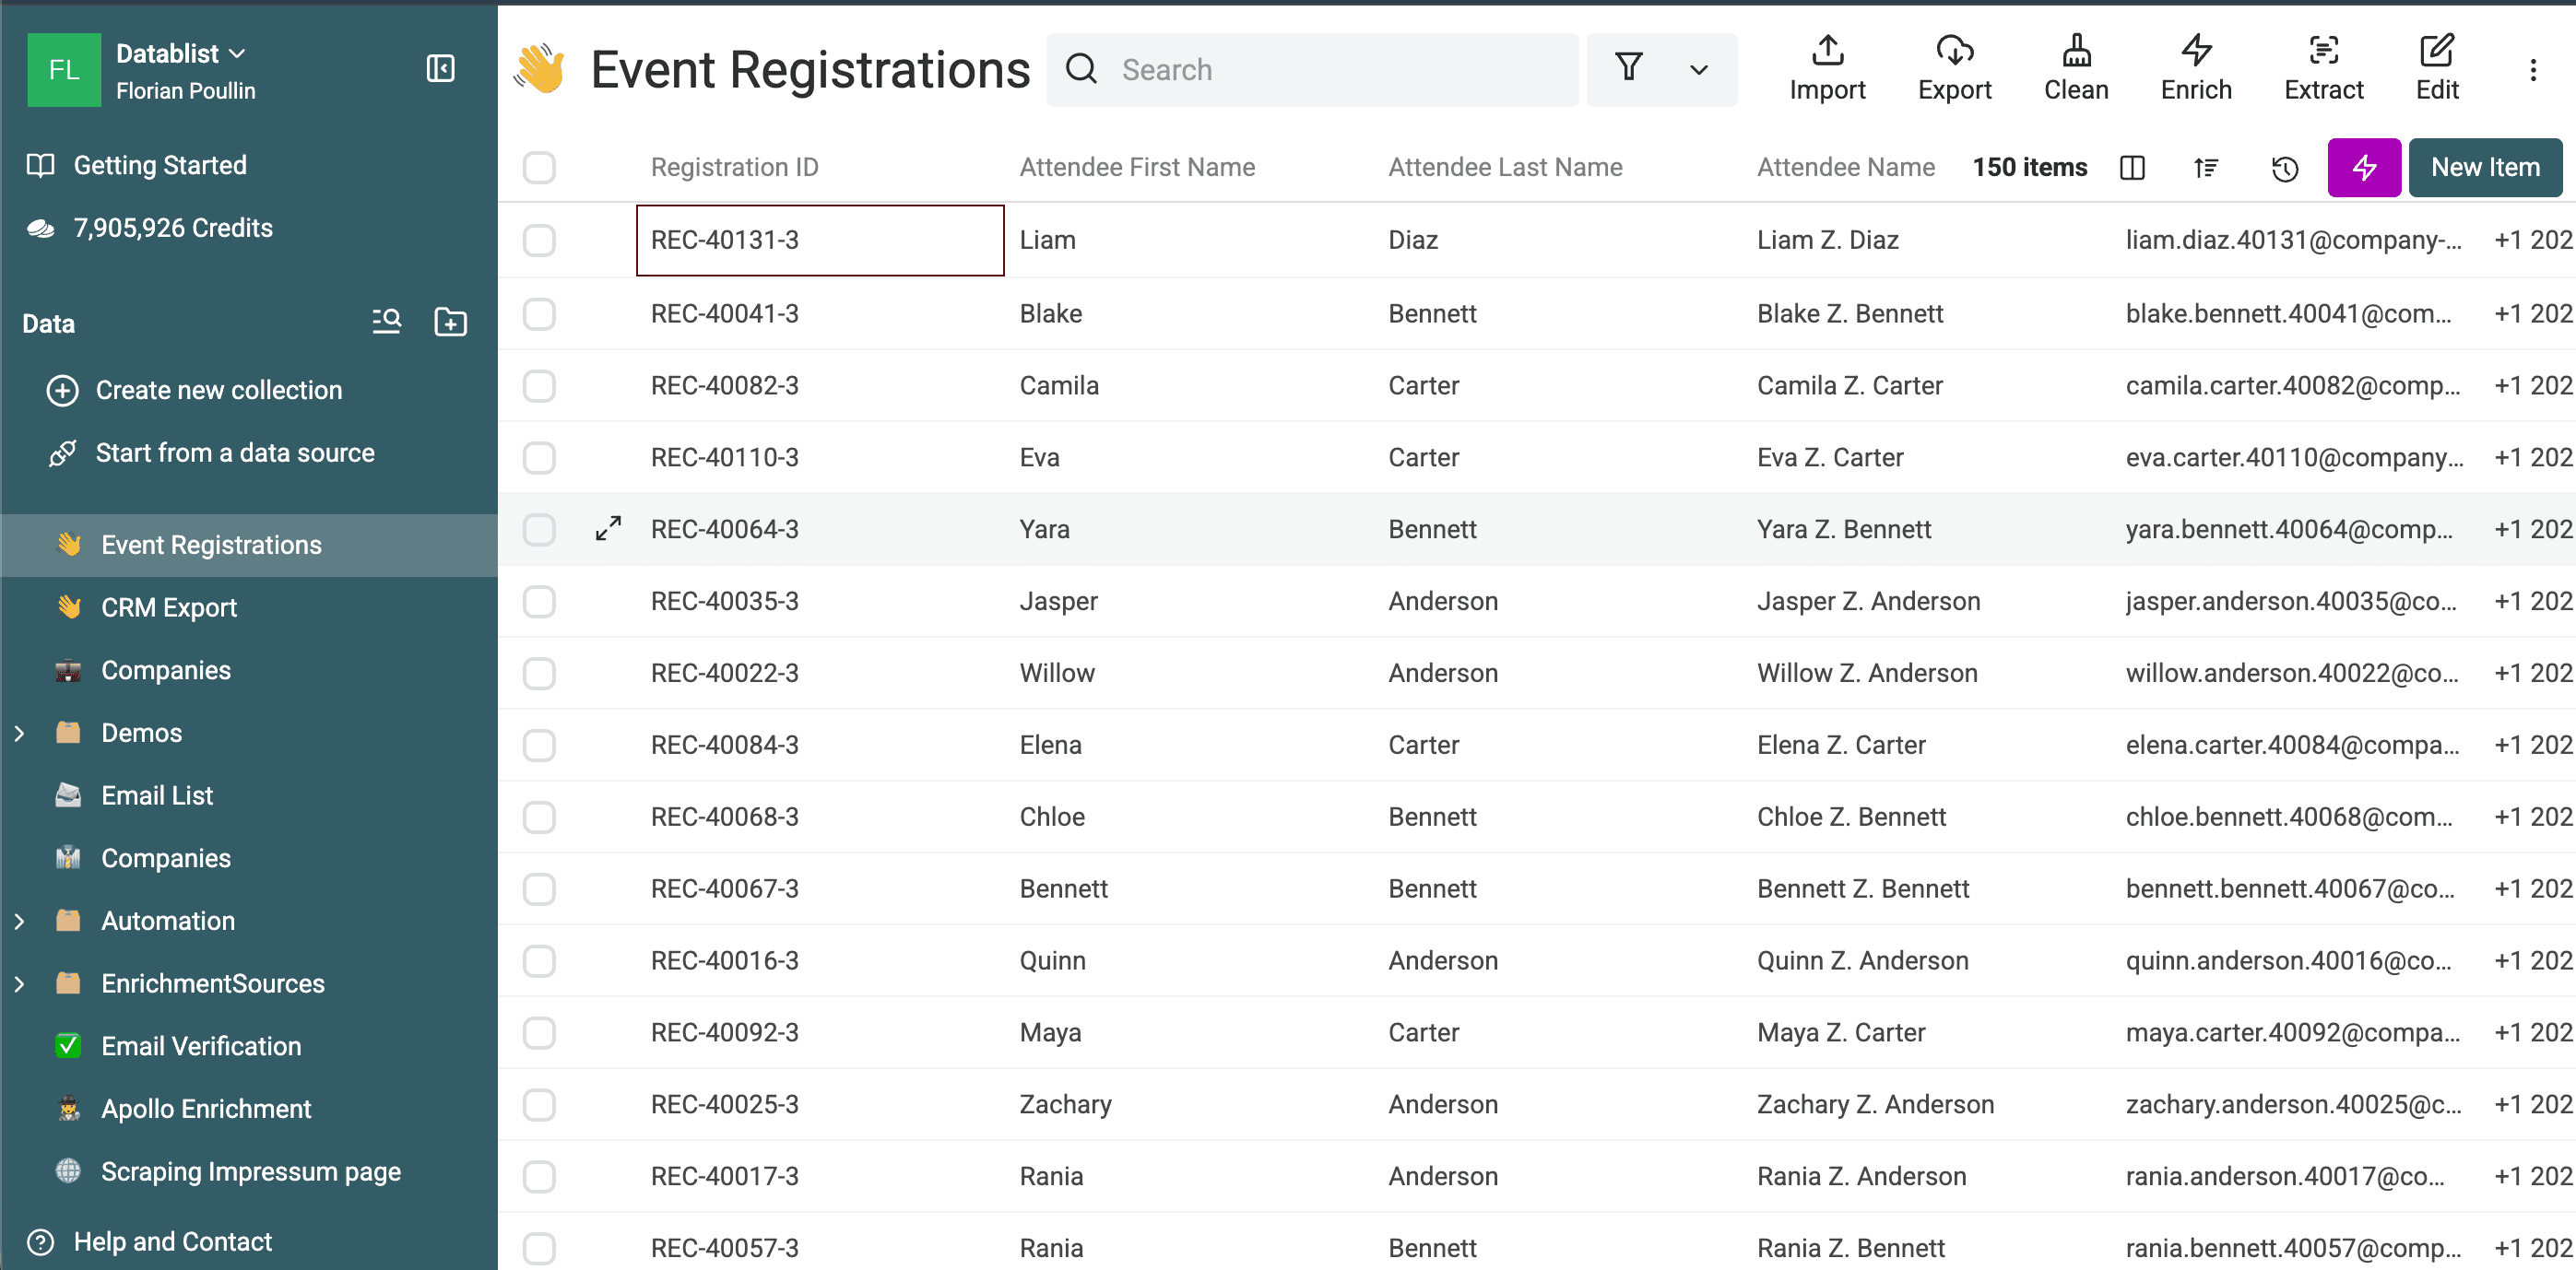
Efter bearbetningen av de 100 överlappningarna innehåller Event Registrations 150 helt nya kontakter.
Matchning mellan collections är en Premium-funktion. Läs den detaljerade guiden om hur du deduplicerar flera CSV- eller Excel-filer för information om mappning av collections och bearbetningsalternativ.
FAQ
Kan jag deduplicera en lista gratis online?
Ja. Besökare utan konto kan köra en Exact-kontroll. Ett kostnadsfritt konto ger tillgång till Smart-matchning och de andra funktionerna för en enda collection i Free-planen. Fuzzy- och fonetiska algoritmer, avancerade processorer, matchning mellan collections, konfigurerbara regler för vilka värden som ska bevaras samt Custom with AI kräver en betalplan.
Ska jag ta bort eller slå ihop dubblettrader?
Ta bort rader när en post är huvudpost och de andra inte innehåller något du behöver. Slå ihop dem när de sekundära raderna innehåller användbara värden. Förhandsgranskningen i Remove varnar när data skulle gå förlorad.
Kan Datablist hitta dubbletter med stavfel?
Ja. Jaro-Winkler och Levenshtein jämför textlikhet, medan Metaphone jämför hur text låter. Dessa avancerade algoritmer kräver en betalplan och matchningarna bör granskas.
Kan jag slå ihop dubblettrader utan dataförlust?
Datablist kan fylla i tomma fält, kombinera textvärden, behålla den valda postens värde eller tillämpa regler på fältnivå för vilka värden som ska bevaras. Granska förhandsvisningen eftersom värden som du väljer bort inte kommer att finnas i den sammanslagna posten.
Hur stor kan listan vara?
Free-planen stöder upp till 1 miljon objekt per collection i webbläsarens lagring. Betalplanerna stöder importer med upp till 2 miljoner objekt per collection. Stora lokala åtgärder är fortfarande beroende av webbläsaren och enheten.
Kan jag granska dubbletter utan att ändra listan?
Ja. Detekteringen är skrivskyddad. Du kan granska grupper, justera trösklar, använda Why matched, söka och sortera resultaten samt ladda ned dubblettrader innan du startar en bearbetningsåtgärd.
Alla inställningar och begränsningar finns i den fullständiga dokumentationen för Duplicate Finder.