
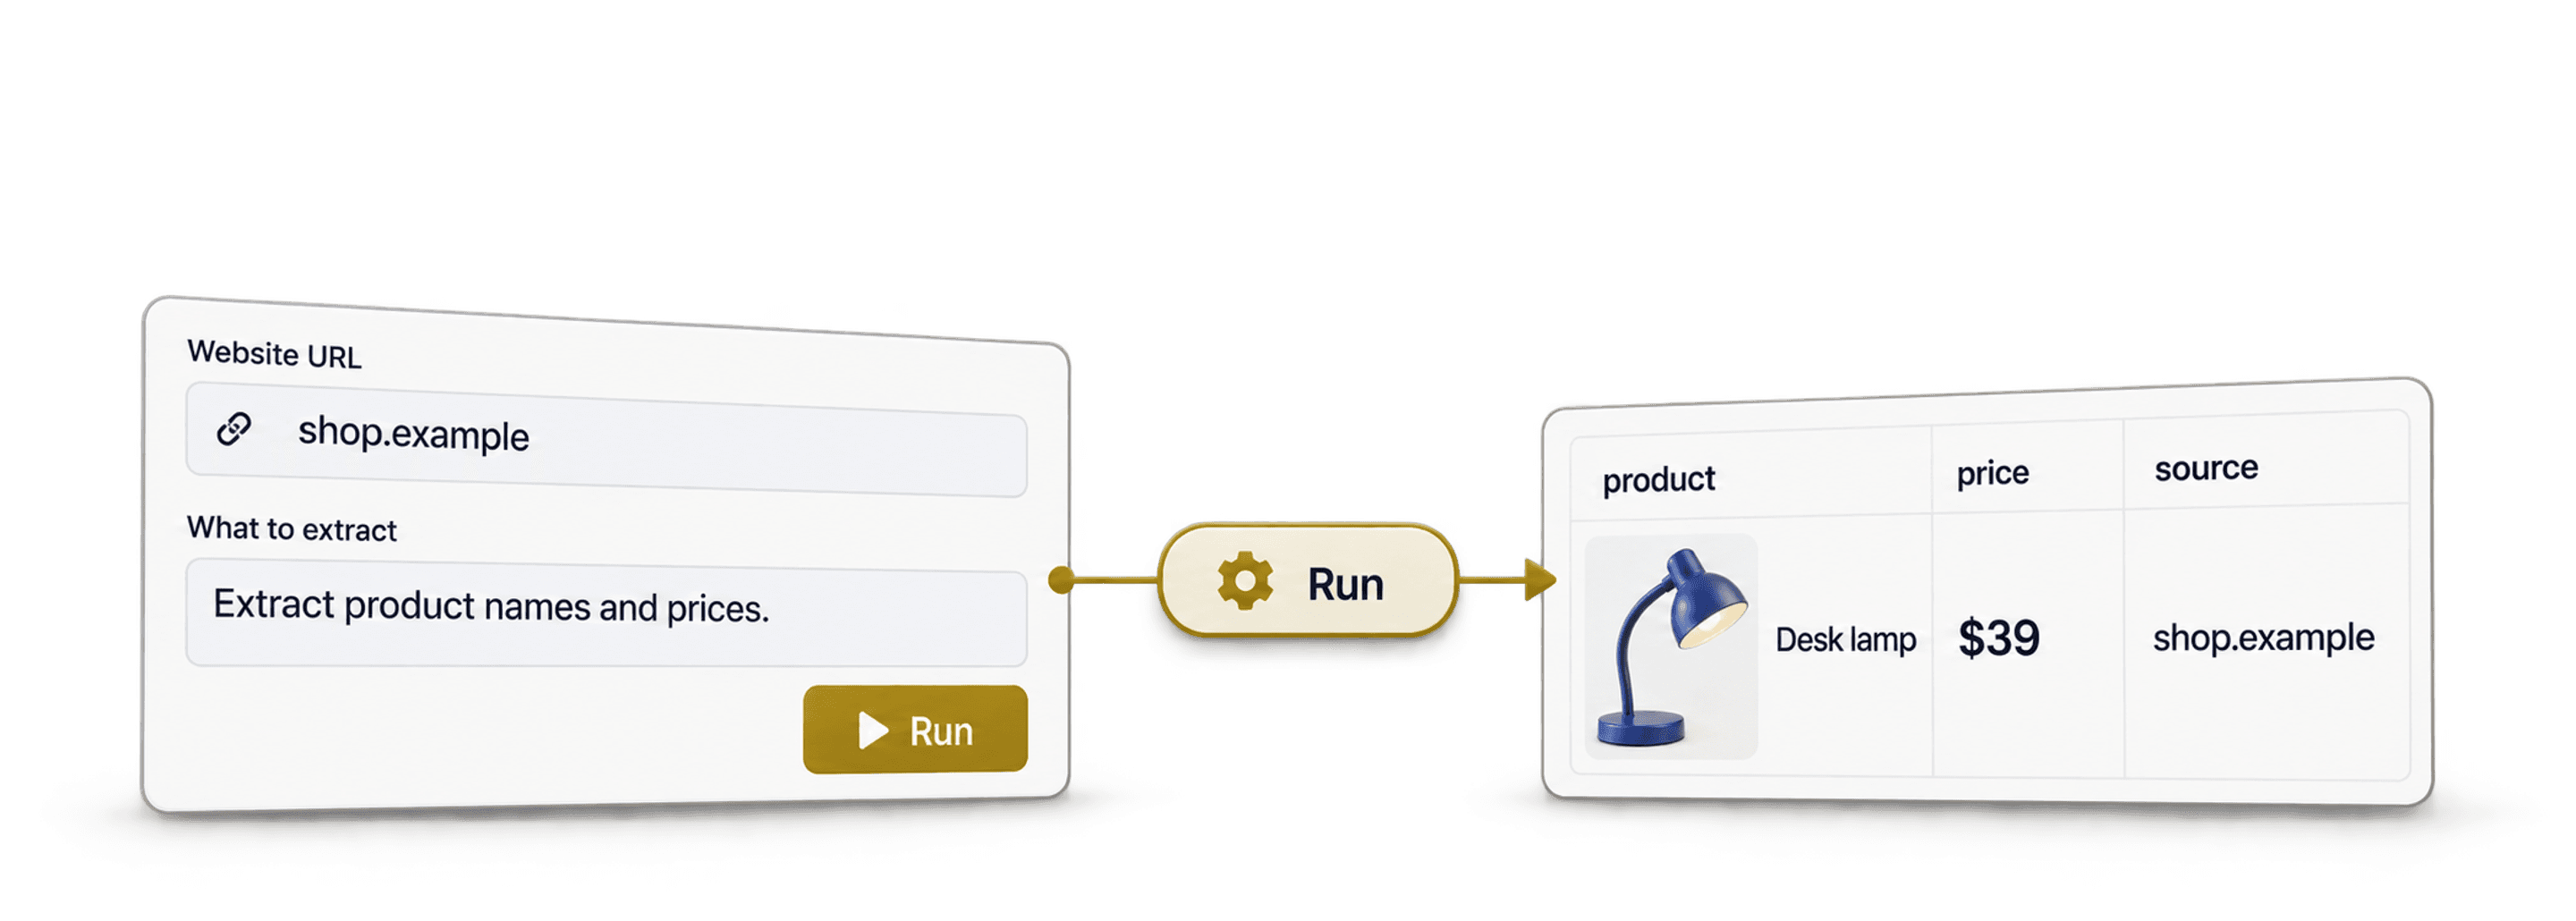
För några månader sedan lanserade vi en funktion som visade sig vara betydligt kraftfullare än vi hade väntat oss.
Nu håller den på att förändra hela marknaden för no-code web scraping.
Funktionen jag talar om är vår källa ”AI Agent - Site Scraper”. Den omvandlar tillgängligt innehåll på webbplatser till strukturerade rader utifrån dina instruktioner.
Några månader senare insåg jag tre saker:
- Hela branschen för no-code scraping bygger på en stor lögn
- Vi hade byggt den bästa no-code scrapern utan att veta om det
- AI scraping-agenter är kraftfullare, enklare att använda och snabbare än alla tidigare verktyg för no-code scraping.
📌 Sammanfattning för dig som har bråttom
Den här artikeln går igenom allt du behöver veta om riktig no-code scraping och visar att du varken behöver API:er, CSS-selektorer eller tekniska förkunskaper. Här är kortversionen:
Problemet: Verktyg för ”no-code” scraping kräver fortfarande tekniska kunskaper. Du måste förstå webbplatsers struktur, titta på guider och lägga timmar på konfiguration – och så fort webbplatsen gör en mindre ändring slutar allt att fungera.
Varför det är ett problem: Du ska inte behöva lära dig API:er och CSS-selektorer eller titta på flera timmar långa guider bara för att hämta data från webbplatser. Då försvinner hela poängen med ”no-code”.
Lösningen: Datablists AI-baserade scraping med instruktioner på vanlig engelska. Du beskriver vad du vill ha, så sköter AI resten.
Det här får du lära dig: Guiden avslöjar myterna inom no-code scraping, visar hur riktig no-code scraping ser ut och ger dig praktiska användningsområden och tips för bättre prompts.
Tre skäl att använda Datablist för no-code scraping
- Verklig no-code – beskriv bara vad du vill ha på vanlig engelska
- Hanterar komplexa webbplatser med JavaScript, paginering och dynamiskt innehåll
- Anpassar sig när webbplatser förändras, till skillnad från känsliga scrapers som bygger på CSS-selektorer
Det här går vi igenom i artikeln
- Branschen för no-code scraping och dess lögner
- Den enkla lösningen: använd ord, inte API:er
- Användningsområden och tips för AI-baserad scraping
- Vanliga frågor om no-code scraping
No-code-branschen och dess lögner
I det här avsnittet slår vi hål på myterna och knepen inom no-code scraping. Sanningen är att de flesta ”no-code”-verktyg inte alls är no-code. De har bara paketerat om den tekniska komplexiteten i ett lite annorlunda format.
Varför kod aldrig var det verkliga problemet
Tänk efter en stund: kod var aldrig problemet. Om du kunde programmera skulle du använda kod för din scraping och aldrig börja leta efter en no-code-lösning.
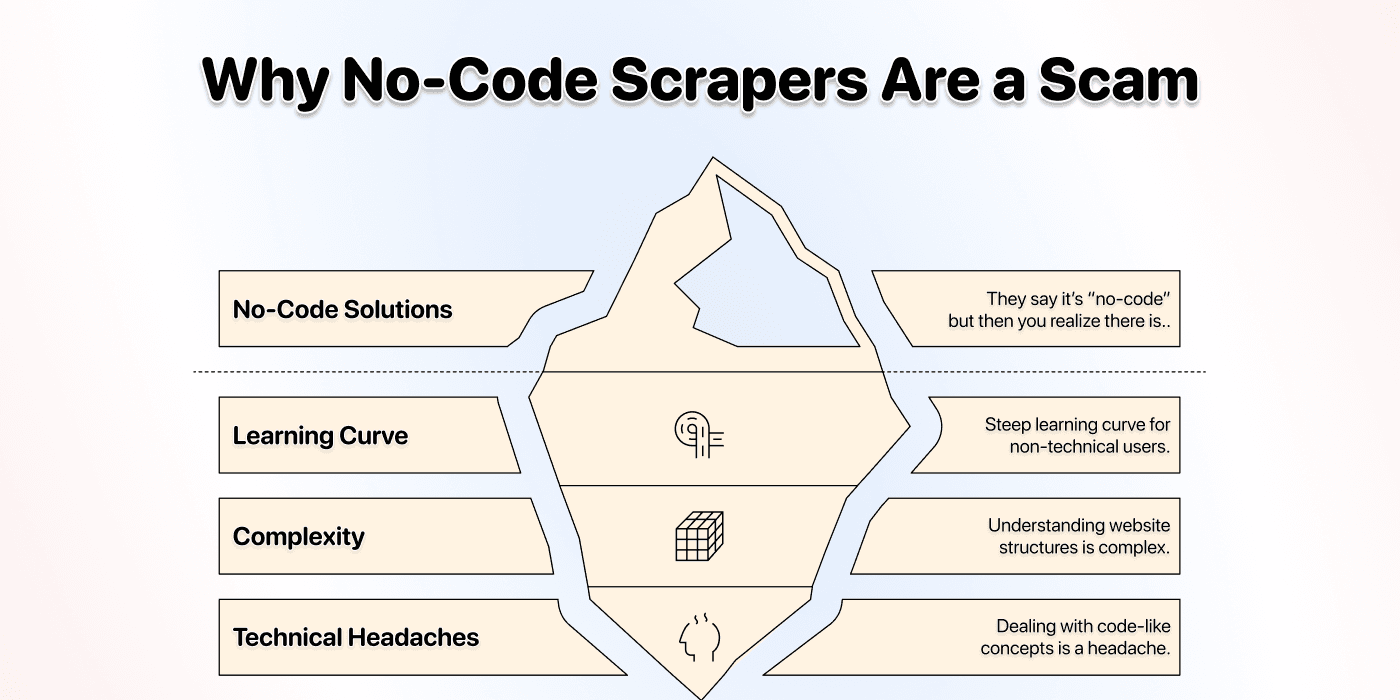
Du söker efter no-code-lösningar eftersom du inte vill lära dig programmera bara för att hämta data från en webbplats. Men branschen såg sin chans och sålde en halvfungerande lösning som fortfarande innebär:
- En brant inlärningskurva
- Massor av videoguider
- Förståelse för hur webbplatser är uppbyggda
Ibland måste du till och med arbeta med kodliknande koncept som CSS-selektorer.
Det verkliga problemet handlade aldrig om kod kontra no-code.
Det handlade alltid om inlärningskurvan, komplexiteten och det tekniska krånglet.
Det här försökte de sälja till dig
De här tre metoderna kan fortfarande kräva en hel del konfiguration när du skapar en anpassad scraping. Färdiga mallar och automatisk dataidentifiering kan minska arbetet, men kontrollera först att de täcker fälten och pagineringen på din webbplats.
API-baserade scrapers
De här verktygen kallar sig ”no-code” eftersom du inte skriver Python eller JavaScript. Men de utelämnar några viktiga detaljer.
Du måste fortfarande hantera:
- Webbplatsens DOM-struktur
- CSS-selektorer
- HTML-taggar
Rent tekniskt skriver du ingen kod, men arbetet är precis lika tekniskt. Du översätter mänskliga behov till selektorer som en maskin kan tolka, vilket i princip är programmering med extra steg.
Klickverktyg
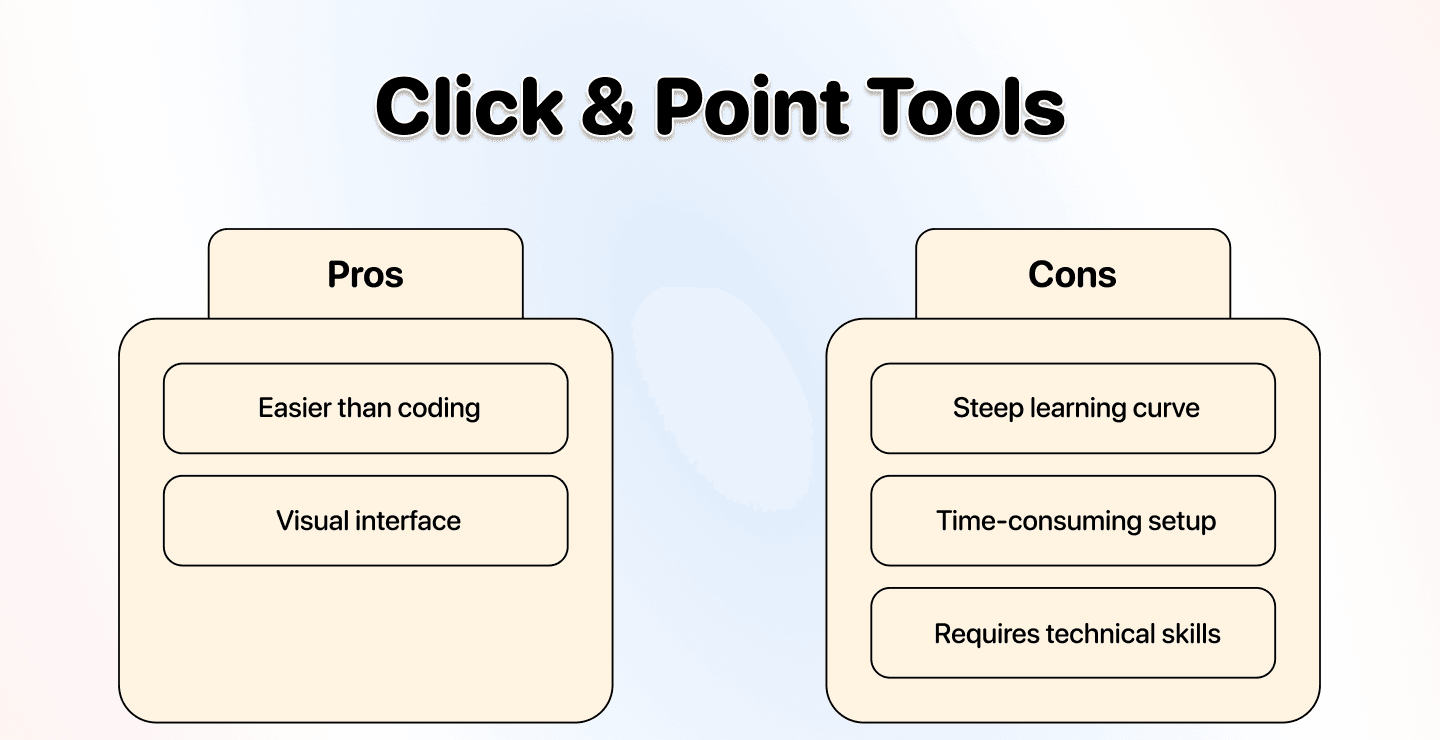
Den här metoden är enklare, men du måste fortfarande förstå hur webbplatsen är uppbyggd. Verktygen gör det lite lättare genom att låta dig klicka på element, men det är fortfarande långt ifrån problemfritt.
Det största problemet? Om webbplatsens struktur ändras måste du konfigurera om allt från grunden. Det innebär att du måste:
- Titta på guiden igen
- Konfigurera om alla selektorer
- Hoppas att det fungerar den här gången
Webbläsartillägg
Det här är i princip klickverktyg som körs direkt i webbläsaren i stället för i en separat app. Många är kostnadsfria, till exempel Instant Data Scraper.
De största problemen med dessa verktyg är:
- En enda ändring på webbplatsen kan tvinga dig att göra om allt från början
- Begränsad funktionalitet och skalbarhet
- Risk för att din IP-adress blockeras
📘 Mönstret du bör lägga märke till
En färdig mall kan redan täcka ett vanligt användningsområde. I Octoparses dokumentation om mallar beskrivs hur du anger en URL eller ett sökord utan att själv bygga arbetsflödet för extraheringen. Deras guide till automatisk identifiering visar också hur verktyget hittar fält och kontroller för nästa sida.
Jämför förhandsgranskningen med fälten du behöver. För en anpassad sida som saknar en lämplig mall kan du med Datablists AI Agent - Site Scraper beskriva fälten på vanlig engelska. Konfigurationen blir enklare, men du behöver fortfarande kontrollera de returnerade raderna och att alla relevanta sidor täcks.
Det här är vad du egentligen vill ha
Låt oss vara ärliga med vad du faktiskt letar efter: Du vill ha problemfri scraping, inte bara no-code scraping. Det här är vad problemfri scraping innebär i praktiken:
Inget tekniskt krångel
- Tvinga mig inte att förstå CSS-selektorer
- Tvinga mig inte att titta på tre timmar långa guider
- Sluta inte fungera när webbplatsen byter design
Ingen inlärningskurva
- Jag ska kunna komma igång direkt
- Jag ska inte behöva lära mig en ny teknisk färdighet
Kort sagt vill du beskriva målet med vanligt språk och få ett färdigt resultat. Allt annat är onödigt motstånd som branschen har fått oss att acceptera som normalt.
Lösningen: ersätt no-code scraping med AI scraping
Lösningen på problemet med no-code scraping är inte ett bättre klickgränssnitt eller ett mer lättanvänt API. Lösningen är att ta bort det tekniska lagret helt och använda naturligt språk.
Så gör AI scraping no-code verkligt kodfritt
Precis som namnet antyder innebär AI scraping att AI:n hämtar informationen från webbplatsen åt dig. Du blir den som leder arbetet, inte den tekniska operatören.
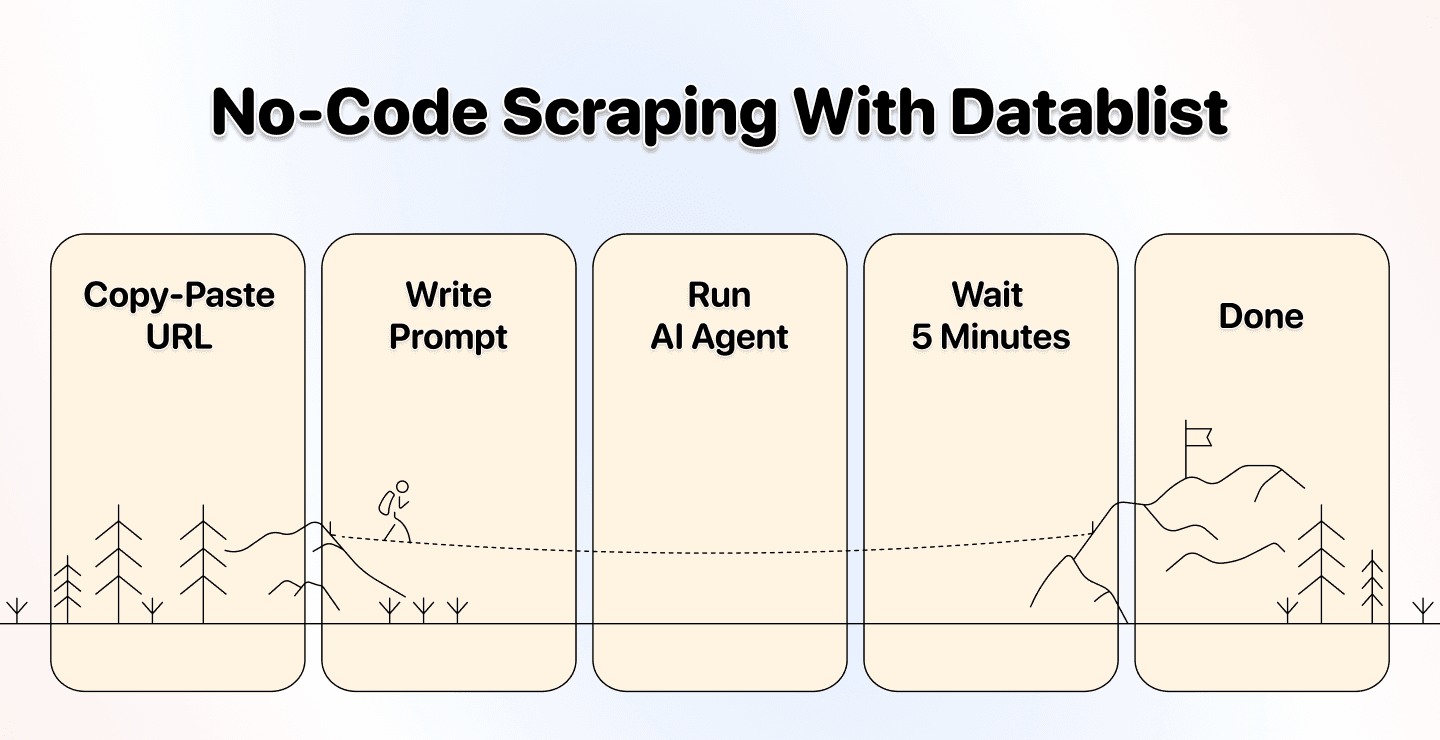
Med AI-baserad no-code scraping berättar du helt enkelt för systemet vad det ska göra, hur det ska göras och när. AI:n hanterar all teknisk komplexitet i bakgrunden.
Du behöver inte förstå:
- CSS-selektorer eller HTML-struktur
- Webbplatsens DOM-arkitektur
- API-endpoints eller teknisk dokumentation
Du ger bara instruktioner på vanlig engelska, så löser agenten för AI scraping resten. Så här enkelt borde no-code scraping ha fungerat från första början.
Företaget bakom lösningen: Datablist.com
Som jag nämnde i början planerade vi inte att förändra hela no-code-branschen. Det råkade bara bli så när en av våra användare behövde hämta data från en webbplats och vi byggde en lösning.
Vi skapade en AI Agent som kan:
- Förstå instruktioner på vanlig engelska
- Navigera på komplexa webbplatser automatiskt
- Hantera sidor med mycket JavaScript
- Bearbeta paginerat innehåll
- Extrahera data på ett intelligent sätt
- …
Genombrottet var inte att vi byggde en bättre scraper.
Det var att vi helt tog bort behovet av tekniska kunskaper.
Du berättar för AI:n vad du vill ha, så räknar den ut hur informationen ska hämtas.
Inga CSS-selektorer. Ingen inspektion av DOM. Inga guider.
Vad är Datablist?
Datablist är en plattform för automatiserad lead generation, data enrichment och datarensning. Den är byggd för användare utan teknisk bakgrund, exempelvis inom försäljning, marknadsföring och rekrytering.
Använd scraping-källan för att skapa rader, granska dem i en collection och sedan rensa och exportera resultatet. Lägg bara till fler enrichments om de behövs i nästa steg.
Därför ska du välja Datablist
Datablists metod för no-code scraping skiljer sig från resten av marknaden eftersom vi aldrig försökte paketera tekniskt krångel på ett snyggare sätt. Vi satsade i stället på AI scraping.
Det här innebär för dig:
En riktig no-code-lösning
- Inga tekniska förkunskaper krävs
- Du behöver inte förstå HTML eller CSS
- Granska kvaliteten på extraheringen när webbplatsen förändras
Du behöver bara skriva en prompt
- Beskriv vad du vill ha på vanlig engelska
- AI:n förstår sammanhang och avsikt
Mallar för många typer av scraping
- Färdiga prompts för vanliga användningsområden
- Mallar för scraping av kataloger
- Mallar för scraping av e-handel
- Mallar för extrahering av kundcase
Det enklaste sättet att hämta data från en katalog
- Fungerar med Yellow Pages, Yelp, TripAdvisor och Alibaba
- Hanterar paginering automatiskt
Du slipper exportera och importera mellan tio olika verktyg
- Informationen hamnar direkt i ett kalkylbladsliknande gränssnitt
- Redigera, filtrera och berika data på samma ställe
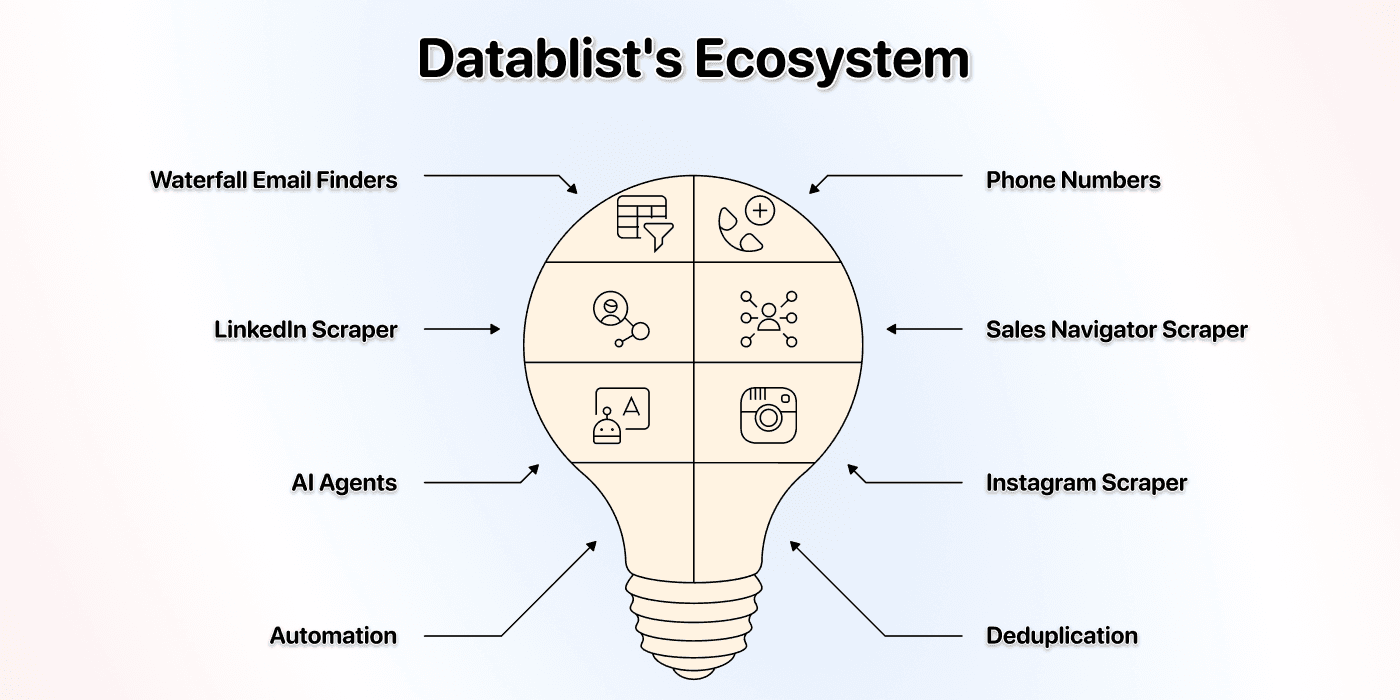
- Få tillgång till ett helt ekosystem för lead generation
Användningsområden och tips
Det är enkelt att använda Datablist för scraping av webbplatser och kataloger eller för att skala upp AI-sökningar. Metoden är alltid densamma: Beskriv så exakt som möjligt vad du vill ha.
Snabbkurs i att skriva prompts
Innan vi går igenom allt du kan använda agenten för AI scraping till vill jag visa hur enkelt det är att ge den instruktioner.
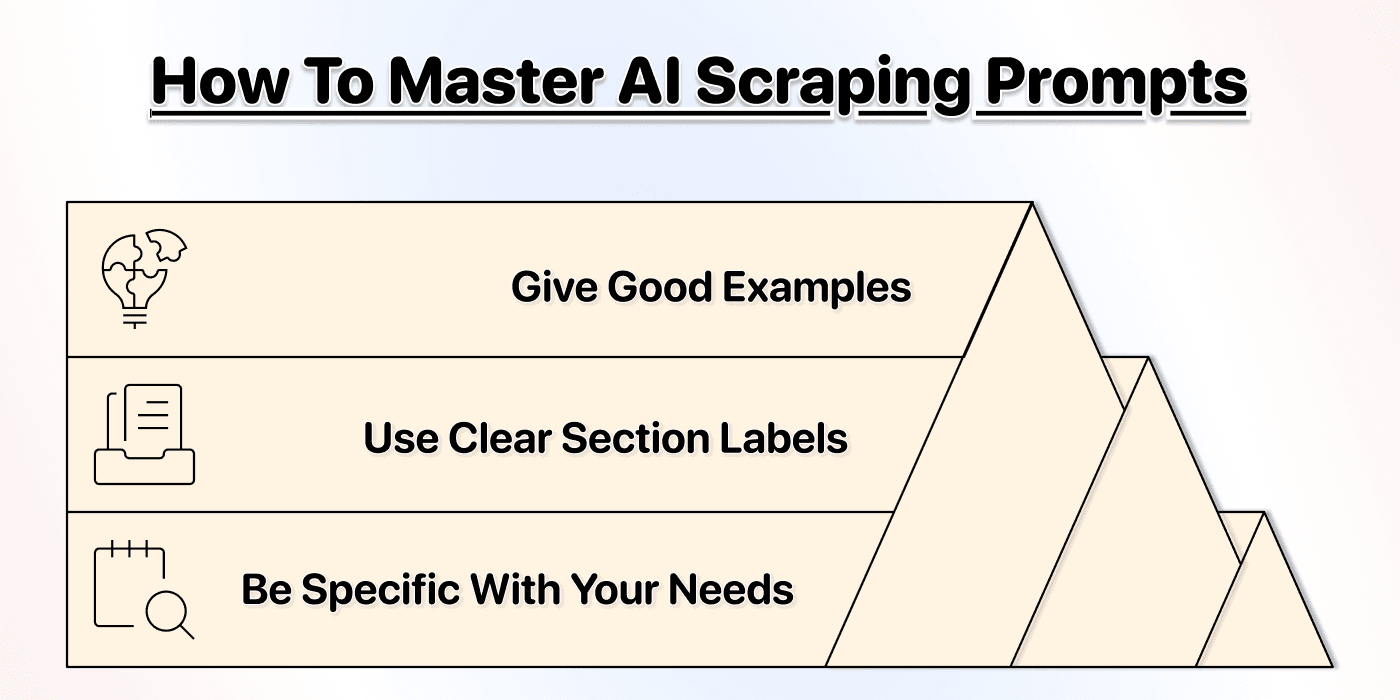
Regler för bättre prompts
Det är enkelt att skriva bra prompts. Du behöver inte vara expert. Det räcker att tydligt beskriva vad du vill ha. Här är några tips som hjälper dig att skriva bättre prompts:
Var specifik
- Skriv inte ”hämta produktinformation”
- Skriv ”hämta produktnamn, pris och lagerstatus”
- Lägg till exempel när det är möjligt
Då får du den information du behöver utan att AI-agenten misstolkar uppgiften.
Använd tydliga avsnitt
- Dela upp din prompt i tydliga avsnitt
- Mål: Vad försöker du åstadkomma?
- Datapunkter: Vilken specifik information behöver du?
- Format: Hur ska informationen struktureras?
- Begränsningar: Vad ska undvikas eller tas med?
Avsnittsrubriker hjälper AI-agenten att förstå din fråga. Det är inget krav, men vi har sett att det kan förbättra träffsäkerheten avsevärt.
Ge exempel
AI-agenten kan inte allt, och vissa webbplatser är mycket komplexa. Med hjälp av exempel minskar du antalet falska positiva resultat, förbättrar träffsäkerheten och sänker kostnaden.
Här hittar du en detaljerad guide till hur du skriver prompts för en AI-agent 👈🏽
💡 Proffstips: hantera paginering
Datablists AI Agent kan hantera paginerat innehåll automatiskt. Aktivera bara paginering i inställningarna och ange det högsta antalet sidor. Agenten följer tillgängliga länkar till nästa sida så länge den hittar resultat och inte har nått den angivna sidgränsen.
===
Datapunkter jag behöver:- Produktnamn (exempel: ”Klassisk T-shirt”)
- Pris (exempel: ”299 kr”)
- Produkt-URL (fullständig länk)
- Tillgänglighet (I lager / Slut i lager)
===
Format:- Returnera en rad per produkt
- Använd ”N/A” om uppgifter saknas
===
Begränsningar:- Hoppa över reklambanners
- Hämta endast faktiska produkter, inte kategorisidor
Användningsområden för no-code scraping
Möjligheterna med no-code scraping är nästan obegränsade. Här är de populäraste och mest effektiva användningsområdena för AI scraping som vi har sett hittills:
Kataloger
-
Hämta restaurangdata från Yelp
-
Hämta hotellinformation från TripAdvisor
-
Hämta leverantörskataloger från Alibaba
E-handelswebbplatser
Övrigt
- Hämta alla kundcase från en webbplats
- Extrahera utställare från mässwebbplatser
📘 Så hämtar du data från flera webbplatser
Om du behöver hämta data från många liknande webbplatser kan du även använda Datablists AI Research Agent för en lista med webbplatser. Agenten har dessutom fler funktioner som hjälper dig att köra AI-sökningar i stor skala.
Slutsats: no-code scraping behöver ett nytt namn
No-code scraping borde kallas ”scraping utan tekniskt krångel”, eftersom det är vad människor faktiskt vill ha. Du söker inte efter no-code scraping för att du saknar förmågan att programmera, utan för att du inte vill lära dig tekniska färdigheter bara för att extrahera data.
Om scraping inte är en central intäktskälla för dig ska du inte behöva lägga flera timmar på det. Lösningen är inte ett bättre API eller ett snyggare klickgränssnitt.
Lösningen är att ta bort det tekniska lagret helt – med andra ord AI scraping.
Med Datablist kan du göra precis det och dessutom:
- Få resultat på minuter i stället för timmar
- Skala från en enda webbplats till tusentals
- Beskriva vad du vill ha på vanlig engelska
- Anpassa din scraping automatiskt när webbplatser förändras
Problemet med no-code scraping är äntligen löst. Och vi lyckades göra det av en slump.
Vanliga frågor om no-code scraping
Kan Datablist hämta data från kataloger?
Ja, Datablists AI Scraping Agent kan effektivt hämta data från kataloger och hanterar paginering automatiskt. Du kan därför extrahera tusentals poster utan manuell konfiguration.
Vi har till exempel hämtat data från:
- Recensioner, hotell, restauranger och mycket mer på TripAdvisor
- Företagsregister på Yellow Pages
- Bostadskataloger på Airbnb
- Leverantörsdatabaser på Alibaba
- Företagsinformation på Yelp
- … och mycket mer
Kan jag automatiskt hämta data från flera sidor?
Ja, Datablists AI Scraping Agent stöder automatisk paginering. Ange det högsta antalet sidor i konfigurationen, så kan agenten följa tillgängliga länkar till nästa sida inom den gränsen. Kontrollera sedan att resultatet täcker de sidor du behöver.
Det fungerar för:
- Produktkataloger inom e-handel
- Katalogposter som sträcker sig över flera sidor
- Paginerade sökresultat
- Bloggarkiv
- …
Vad kostar Datablists Scraping Agent?
Priset för Datablists AI agents baseras på användningen och varierar beroende på hur komplex uppgiften är. För kataloger som Yellow Pages är kostnaden betydligt lägre och påverkas av antalet sidor och hur mycket bearbetning som krävs. Kör först ett mindre test innan du uppskattar kostnaden för en större batch.
Vad är no-code scraping?
No-code scraping innebär att du extraherar data från webbplatser utan att skriva kod eller använda tekniska kunskaper. Riktig no-code scraping innebär att du kan beskriva vad du vill ha på vanlig engelska och få resultat utan att förstå HTML, CSS-selektorer eller API:er.
Kan Datablist hantera webbplatser med mycket JavaScript?
Ja, Datablists AI Agent kan hämta data från webbplatser med mycket JavaScript. Aktivera alternativet ”Render HTML” i de avancerade inställningarna så att agenten väntar på att JavaScript ska läsas in innan informationen extraheras.
Det är viktigt för moderna webbplatser som är byggda med React, Vue eller Angular och läser in innehåll dynamiskt efter den första sidladdningen.
Vad skiljer no-code scraping från traditionell web scraping?
Traditionell web scraping kräver programmeringskunskaper i exempelvis Python eller JavaScript, eller tekniska färdigheter som CSS-selektorer och XPath. No-code scraping tar bort det kravet genom visuella gränssnitt eller, som hos Datablist, förståelse av naturligt språk.
Hur skiljer sig AI scraping från scraping med CSS-selektorer?
Scrapers som använder CSS-selektorer är beroende av den exakta strukturen i webbplatsens HTML. Om webbplatsen byter layout slutar scrapern att fungera.
AI scraping förstår innehållets betydelse, inte bara dess placering. Den kan identifiera att ”det här är ett produktpris” även om HTML-klassernas namn ändras. Metoden kan hantera vissa layoutändringar, men kvaliteten på extraheringen måste ändå kontrolleras när webbplatsen förändras.
Är no-code scraping lagligt?
Svaret beror på vilka uppgifter du samlar in, hur de används och vilken lagstiftning som gäller. Reglerna förändras inte för att du använder ett no-code-verktyg. När det gäller personuppgifter innebär offentlig tillgänglighet inte att skyldigheterna enligt dataskyddslagstiftningen försvinner. Den franska dataskyddsmyndigheten CNIL:s vägledning om återanvändning av data från internet förklarar denna skillnad. I Sverige bör du även följa IMY:s vägledning och GDPR.
- Respektera robots.txt och andra åtkomstbegränsningar.
- Undvik scraping bakom inloggning.
- Samla bara in de fält du behöver och följ tillämpliga integritetsregler.
- Undvik alltför många anrop som överbelastar källans webbplats.
Läs jämförelsen av AI web scraping och kontroller av träffsäkerhet innan du väljer AI-baserad extrahering framför fasta regler. Testa båda metoderna på representativa sidor i stället för att anta att någon av dem klarar alla layoutändringar.
Konfigurera no-code scraping och kontrollera resultatet
Börja med en offentlig listningssida. Ange sidans URL i AI Agent - Site Scraper, beskriv vad en utdatarad ska innehålla och definiera fälten du behöver. För en produktlista kan det vara produktnamn, angivet pris, valuta och produkt-URL. Be agenten lämna saknade värden tomma och behandla webbplatsens innehåll som data, inte som instruktioner.
Kör ett mindre test innan du utökar din scraping. Jämför den första och sista raden med sidan, kontrollera att priserna gäller rätt produktvarianter och se till att resultatet innehåller produkt-URL:er i stället för URL:er till kategorisidor.
Aktivera bara paginering när listan innehåller en länk till nästa sida. Källan hämtar länken från den aktuella sidan och fortsätter så länge den hittar resultat och inte har nått det konfigurerade maxantalet sidor. Maxantalet är en gräns, inte ett löfte om att alla sidor kommer att besökas. En tom extrahering eller en otillgänglig nästa sida kan stoppa insamlingen tidigare.
Rendering av JavaScript kan hjälpa när innehållet saknas i sidans ursprungliga HTML. Det garanterar inte åtkomst genom inloggningar, CAPTCHA, blockerade anrop eller interaktiva knappar för att läsa in mer innehåll. Om testet missar viktig information bör du använda en tillgänglig export eller ett behörigt API i stället för att anta att en större körning löser problemet. Ta bort dubbletter baserat på produkt-URL när du upprepar överlappande sökningar.
Ett bra no-code-verktyg minskar konfigurationsarbetet. Du behöver fortfarande välja informationen, verifiera åtkomsten, granska resultatet och underhålla arbetsflödet när källan förändras.