
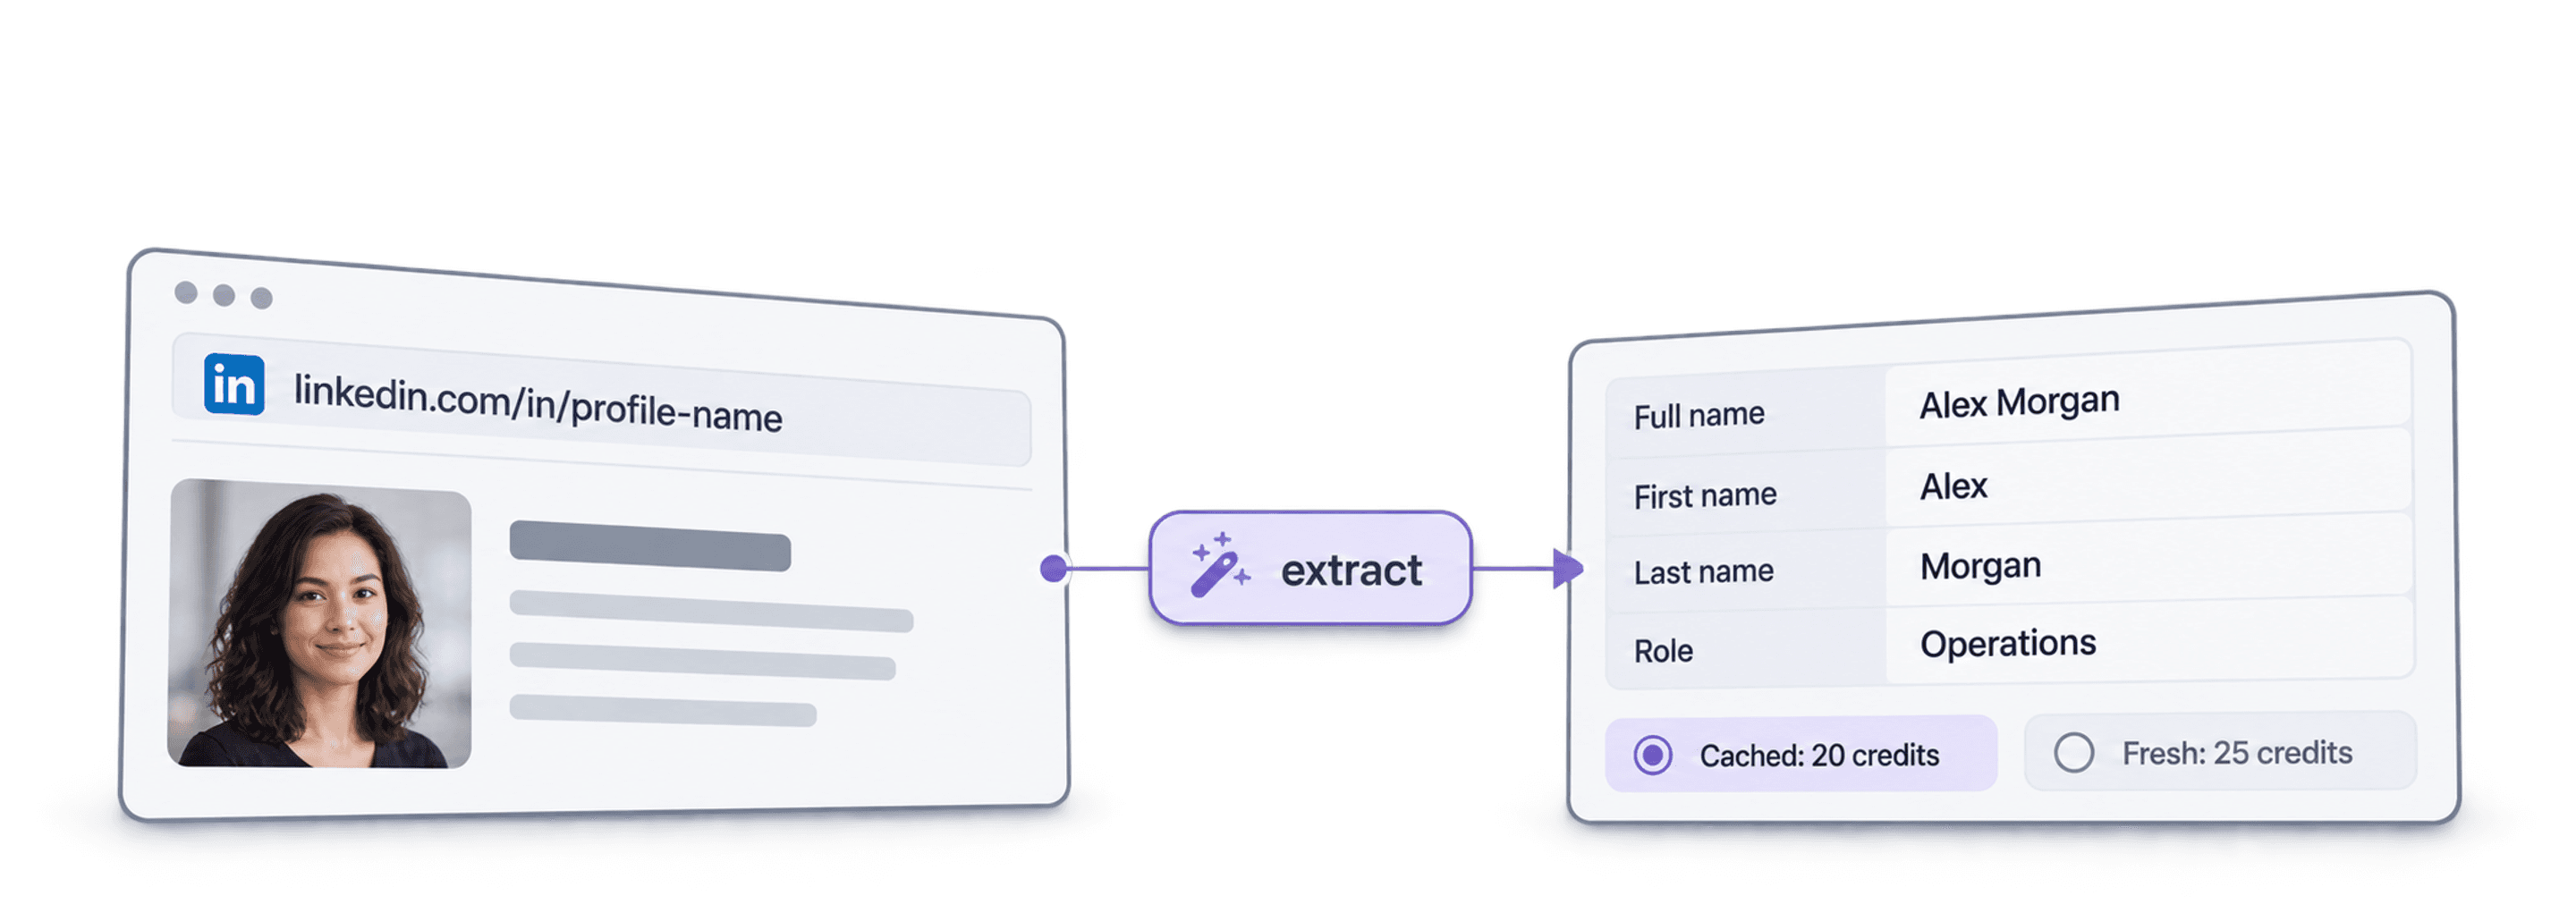
要从 LinkedIn 个人资料 URL 中提取某人的完整姓名,请将 URL 导入 Datablist collection,运行 LinkedIn Profile Scraper,再把 Full Name、First Name 和 Last Name 输出映射到对应列。不要把 /in/ 后面的文本当作已核实的姓名:个人资料 slug 可能是缩写,也可能已经更改,甚至与页面显示的姓名无关。请核对返回的个人资料;如果没有姓名,就保留空白。
这一工作流还会返回可获取的职位、地点和教育经历等信息。使用这项 enrichment 时,Datablist 不会要求你连接 LinkedIn 账号,因此无需分享登录信息,也不会自动操作你自己的登录会话。不过,这并不保证任何特定账号或平台结果。
如果只需查询一份个人资料,可以使用免费的 LinkedIn Profile Scraper。粘贴个人资料 URL,查看可获取的姓名、headline 和工作经历字段,然后复制结果,或下载为 CSV 或 JSON。需要批量处理个人资料时,请使用下方工作流。
📌 时间紧?先看这里
输入: 一列标准 LinkedIn 个人资料 URL 或 Sales Navigator Lead URL。
输出: 在能够获取时返回完整姓名、名字和姓氏,以及你选择的其他个人资料字段。
核查: 将姓名与返回的个人资料 URL 对照,并在使用名单前检查空值或异常值。
Credits: 每份实时抓取的个人资料消耗 25 credits;如果存在缓存且启用了缓存选项,则消耗 20 credits。
姓名字段来自 enrichment 结果,而不是通过拆分 URL slug 得出。
本指南将介绍哪些内容
什么是 Datablist?
Datablist 是一个用于Lead Generation工作流的平台。你可以上传个人资料 URL 列表,运行 LinkedIn Profile Scraper,并将返回的字段映射到 collection 中。
你可以把它理解为一个 Data Enrichment 中心:上传 CSV 或 Excel 文件后,即可对其中的数据运行多种 enrichment。你不必在多个工具之间来回切换,也无需搭建复杂的集成。所有操作都能在一个平台内完成。
该 scraper 不需要你的 LinkedIn 登录凭据。使用返回的信息时,请先进行核查,并遵守适用的平台规则和隐私法规。
为什么需要登录的抓取工具会带来账号风险
一些 LinkedIn 数据抓取工具会要求用户登录,或自动操作已登录的浏览器会话。这样一来,工具就能访问你的账号,也可能让账号受到平台限制。
使用需要登录的工具前,请确认它是否会:
- 保存你的登录凭据或 session cookies
- 通过你的账号发送请求
- 自动执行违反平台规则的操作
Datablist 的个人资料 enrichment 不需要登录 LinkedIn。你无需为此工作流分享登录凭据,但这并不意味着风险绝对为零。
如何从 LinkedIn 个人资料 URL 中提取信息
下面进入 LinkedIn 个人资料抓取的实际操作。你将了解可以提取哪些数据、完整的分步流程,以及具体的费用构成。
可以获取哪些数据
LinkedIn Profile Scraper 可以返回丰富的数据字段。以下是按类别整理的可获取信息:
| 类别 | 数据字段 |
|---|---|
| 基本信息 | 名字、姓氏、完整姓名、Headline、个人简介 |
| 地点 | 城市、州/省、国家、国家名称 |
| 当前/上一份工作 | 职位、公司名称、开始日期、结束日期、职位描述、地点 |
| 公司信息 | 公司主页 URL、公司网站、行业、员工人数范围 |
| 工作经历 | 最多 9 段过往工作经历(合计最多 10 段) |
| 教育经历 | 学校、学位、专业、开始/结束日期(最多 5 条) |
| 其他 | 语言、联系人数量、LinkedIn 个人资料 URL(标准化) |
💡 兼容 Sales Navigator
Datablist 同时支持标准 LinkedIn URL 和 Sales Navigator URL。输入 Sales Navigator URL 后,scraper 还会返回标准化的公开 LinkedIn 个人资料 URL。
抓取 LinkedIn 个人资料:分步教程
下面介绍如何设置并运行 LinkedIn Profile Scraper。
第 1 步:注册并上传数据
- 前往 datablist.com 注册 Datablist
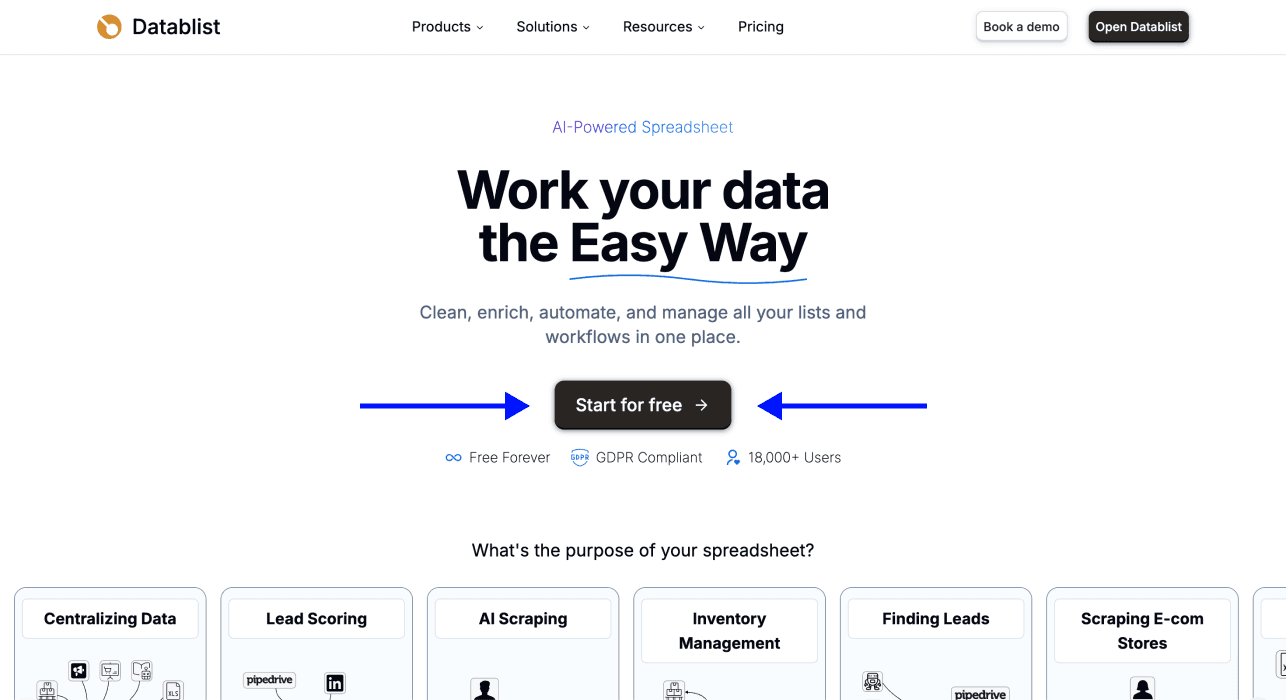
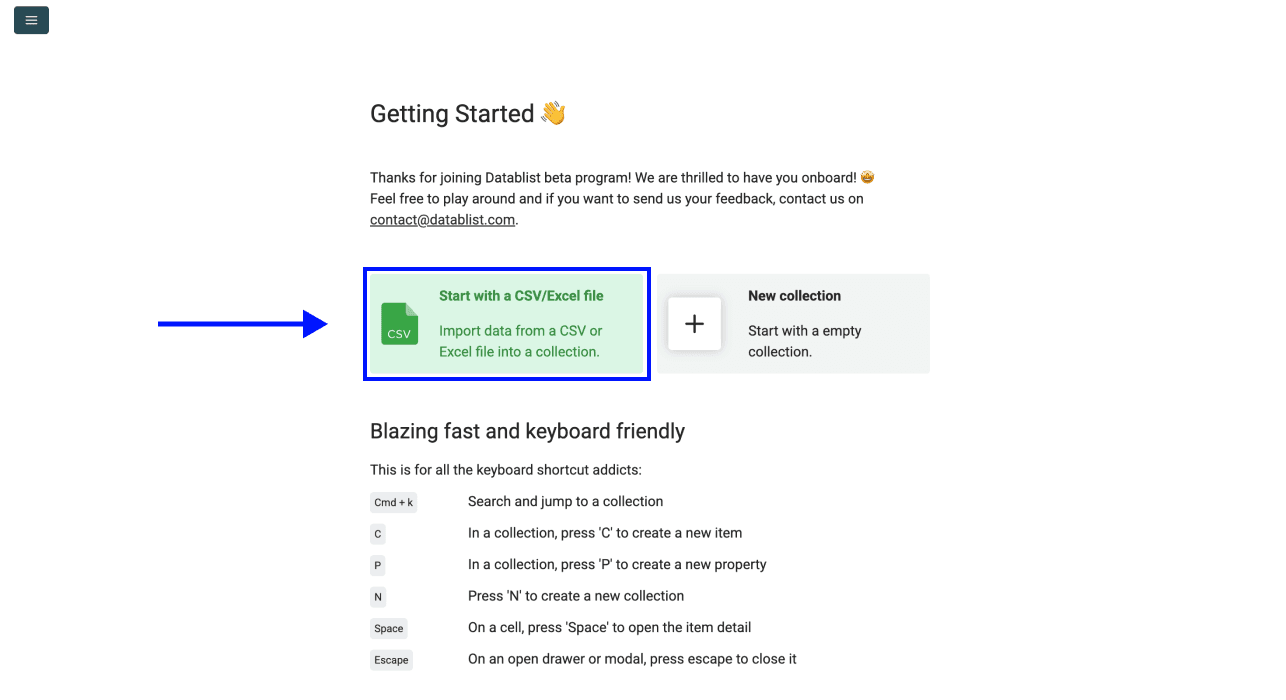
- 点击 Upload,上传包含 LinkedIn 个人资料 URL 的 CSV 或 Excel 文件
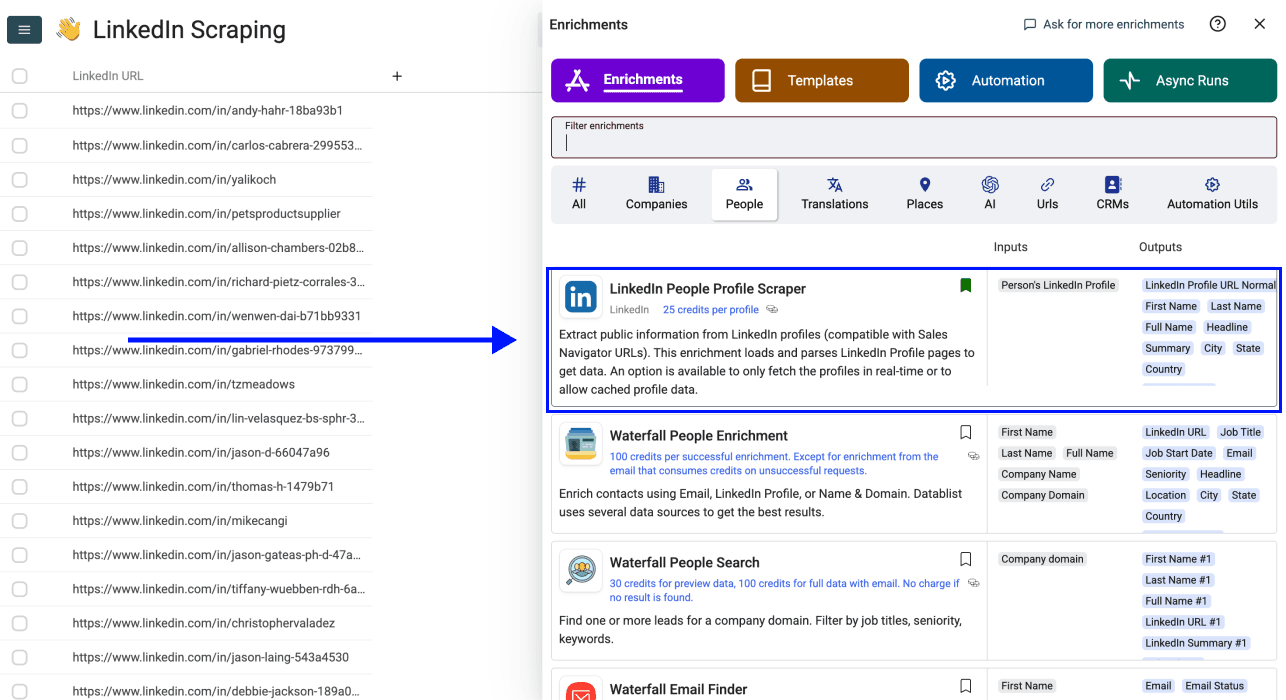
第 2 步:找到 Enrichment
- 点击顶部菜单中的 Enrich
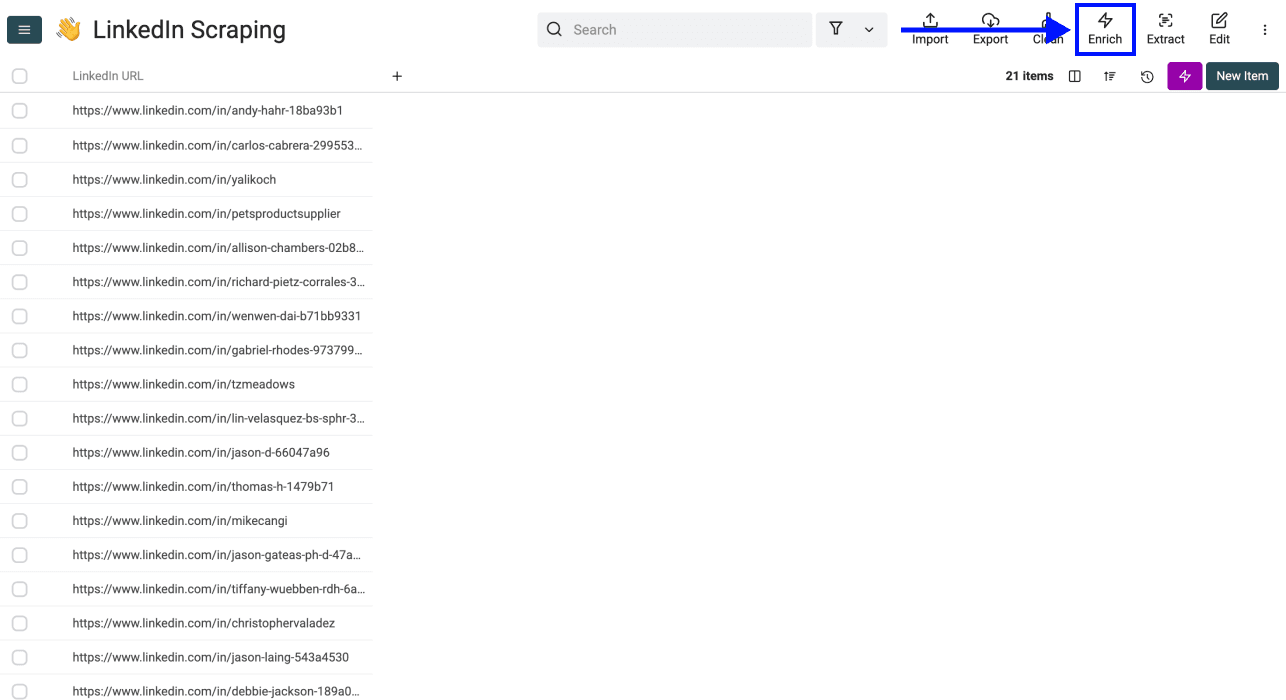
- 进入 People 分区,选择 LinkedIn Profile Scraper
第 3 步:设置 Enrichment
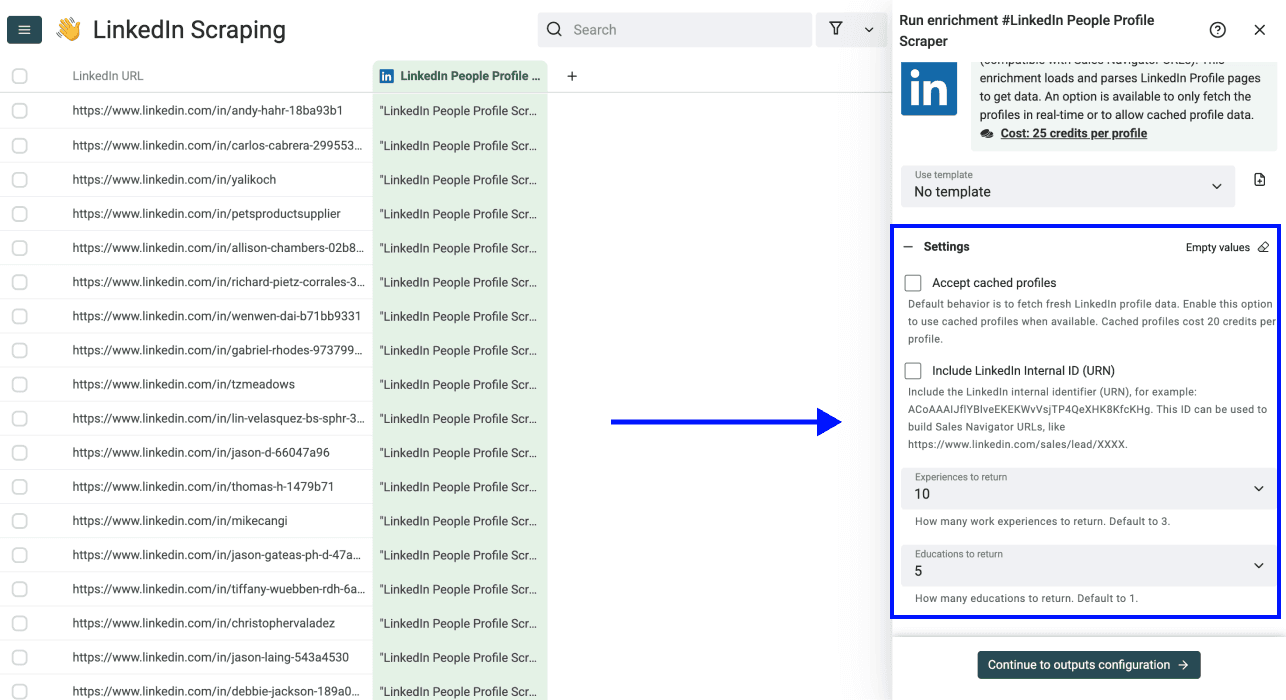
选择 LinkedIn Profile Scraper 后,页面会打开一个设置抽屉。你将看到以下选项:
- Accept Cached Profiles (if available): 默认情况下,工具会抓取最新的 LinkedIn 个人资料数据。启用此选项后,如果存在缓存资料,系统会优先使用。每份缓存资料消耗 20 credits,而不是 25 credits。
- Include LinkedIn Internal ID (URN): 返回 LinkedIn 内部标识符,例如 ACoAAAIJflYBlveEKEKWvVsjTP4QeXHK8KfcKHg。该字段可用于构建 Sales Navigator URL。
- Experiences to return: 选择要抓取的工作经历数量,可选 3、5 或 10 条。
- Educations to return: 选择要抓取的教育经历数量,可选 1、3 或 5 条。
第 4 步:配置输入字段
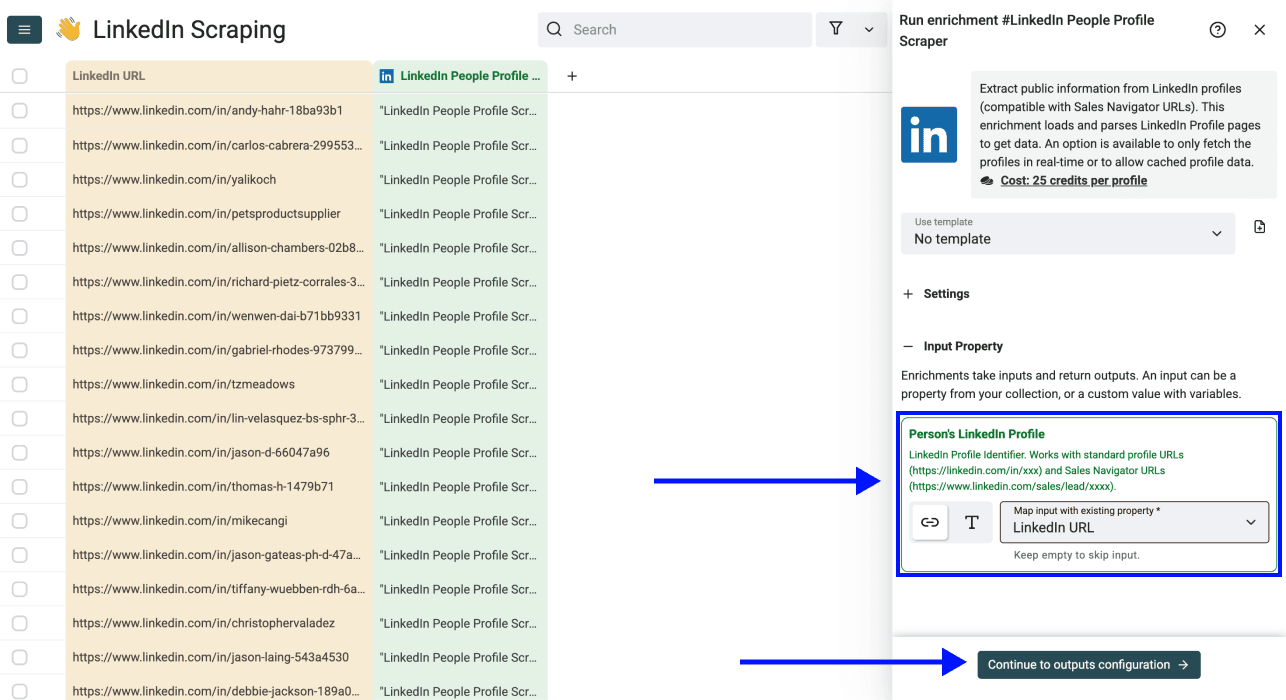
完成设置后,向下滚动,将包含 LinkedIn 个人资料 URL 的列映射为 Input Property。
准备好后,点击 Continue to Outputs Configuration。
第 5 步:选择输出字段
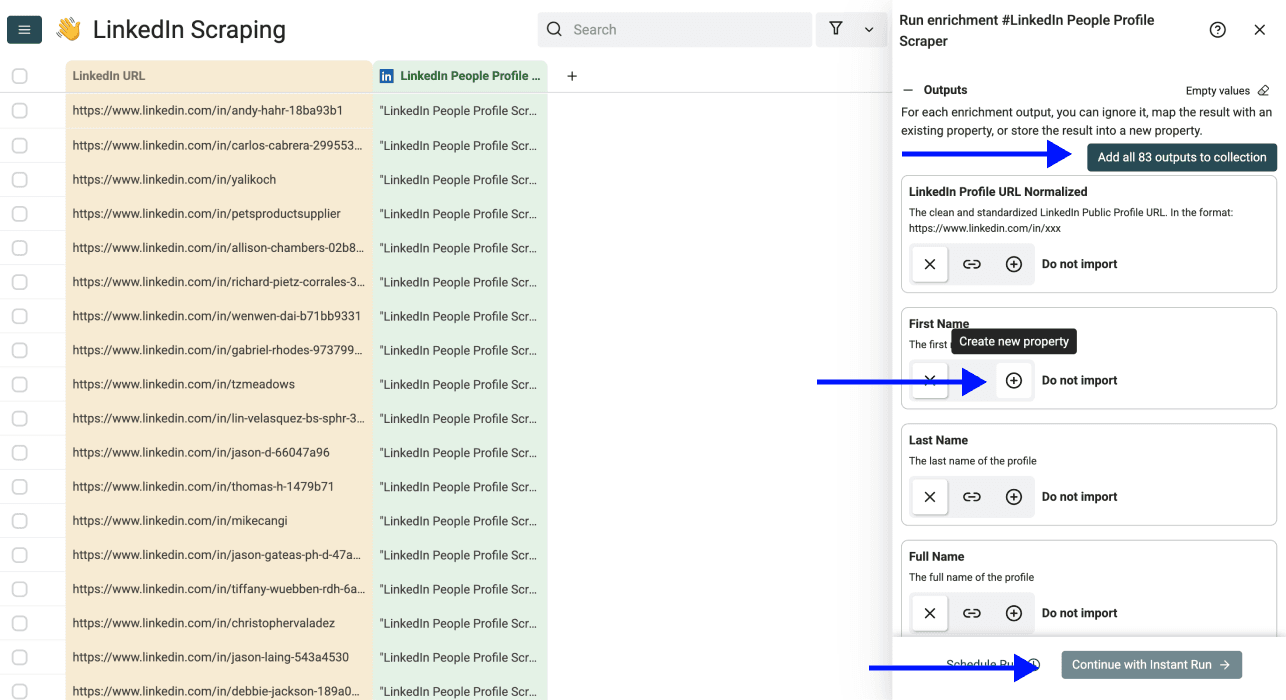
配置提取结果的保存位置。如果需要提取姓名,请将 Full Name、First Name 和 Last Name 映射到现有列,或创建新列。请保留输入 URL 列,以便将每条结果与原始个人资料进行比对。
点击 ⊕ 图标,将输出字段添加到 collection。你也可以使用快捷操作,一键添加所有列。
然后点击 Continue with Instant Run 继续。
第 6 步:运行 Enrichment
现在可以选择运行方式:
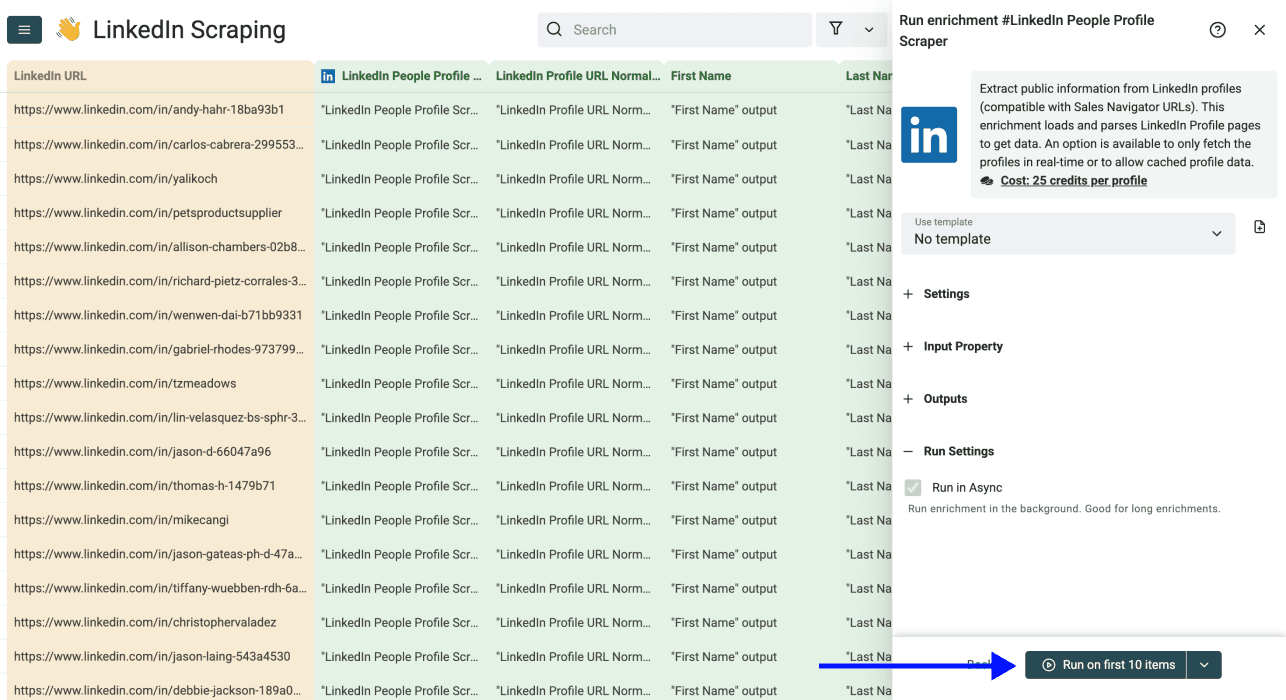
- Run on first 10 items: 先测试,再决定是否批量运行
- Run on first 100 items: 验证更大的样本
- Run on all view items: 处理当前视图中的全部数据
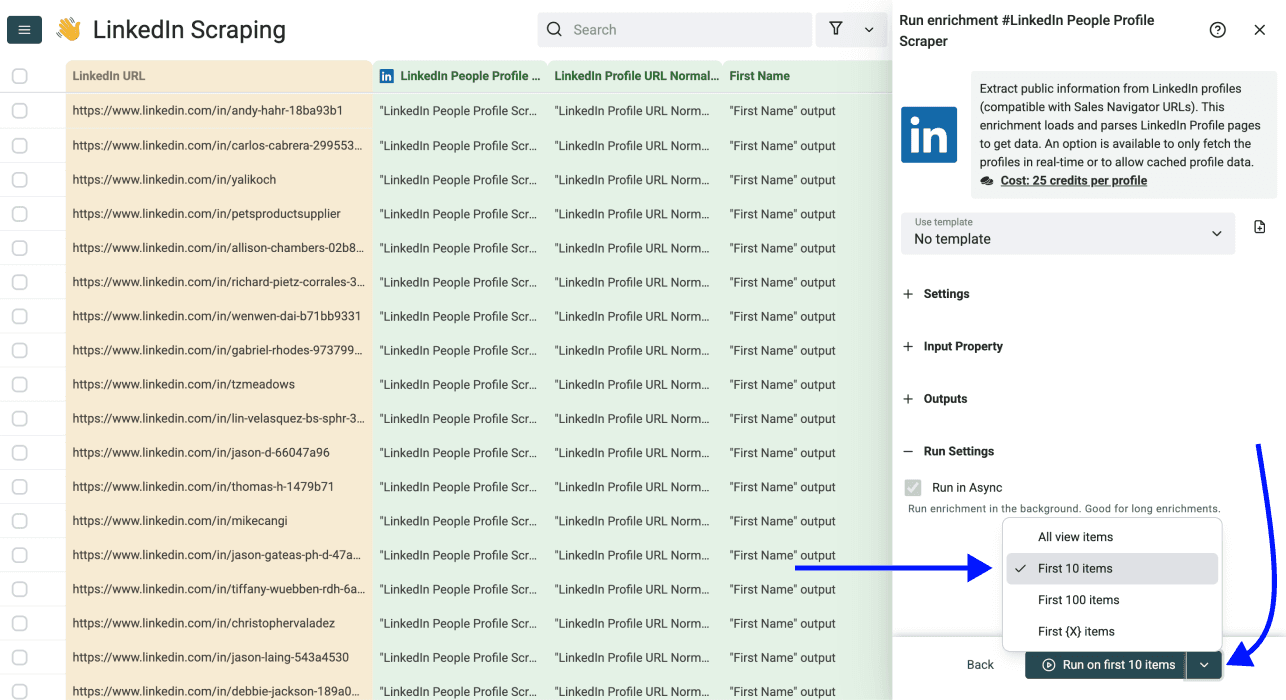
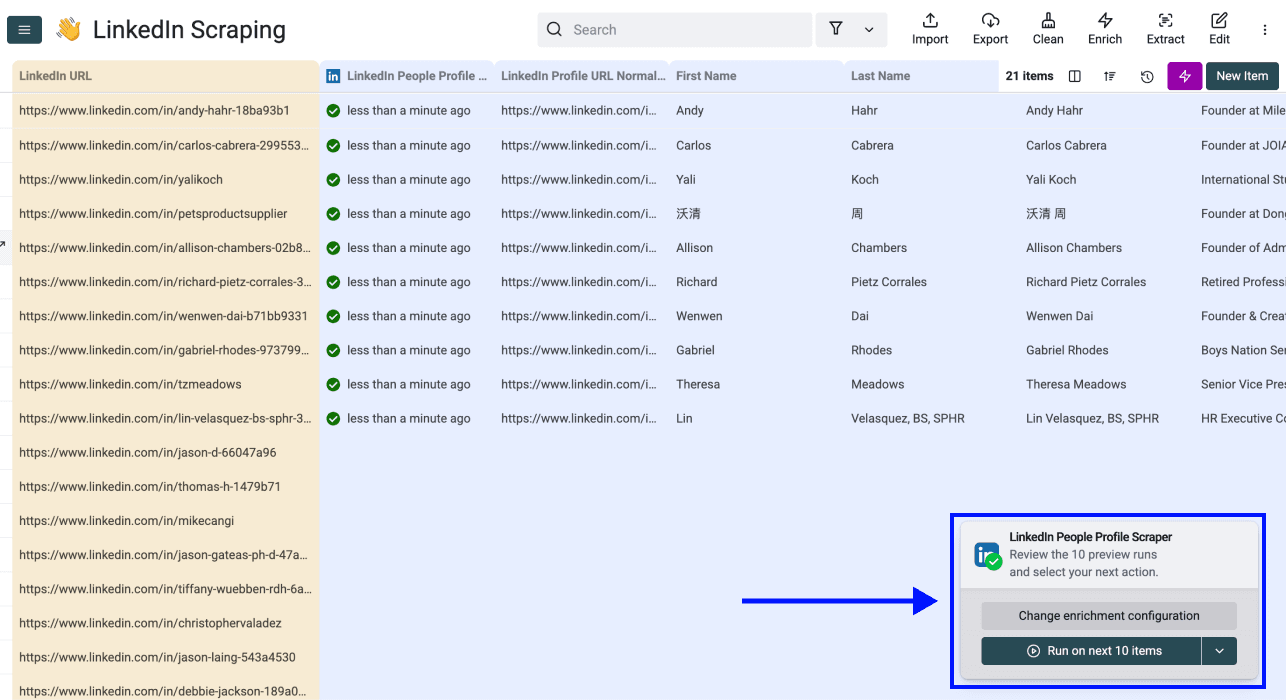
点击 Run on first 10 items,系统会自动填充抓取到的数据。
继续批量处理前,请先检查第一批结果。如果个人资料不可用,或数据提供方返回的信息不完整,姓名字段可能为空;此时不要根据 URL slug 推断姓名。
费用明细
Datablist 的 enrichment 采用 credits 计费。抓取 LinkedIn 个人资料的费用如下:
- 实时个人资料数据: 每份个人资料 25 credits
- 缓存个人资料数据: 每份个人资料 20 credits(存在缓存时)
不同套餐包含的 credits 数量不同:Starter 套餐每月包含 5,000 credits,Growth 套餐包含 20,000 credits。以下美元加购示例来自当前套餐目录;购买前请在应用内确认最新价格。
| 加购价格 | Credits | 个人资料数量(实时数据,每份 25 credits) | 每份资料成本 |
|---|---|---|---|
| $20 | 20,000 | 800 份 | $0.025 |
| $55 | 60,000 | 2,400 份 | $0.023 |
| $165 | 200,000 | 8,000 份 | $0.021 |
| $700 | 1,000,000 | 40,000 份 | $0.018 |
📘 需要订阅套餐
批量运行前,请在 Datablist 中检查当前套餐和 credits 余额。按每条实时抓取成功结果 25 credits 计算,100 份成功获取的个人资料会消耗 2,500 credits;如果有缓存结果,费用可能更低。
核查提取的个人资料数据
完成测试运行后,请选取若干条记录,将完整姓名、个人资料 URL 和当前职位与源资料进行比对。姓名为空的行需要单独检查。/in/ slug 只是标识符,不能作为可靠的姓名来源。使用这项 enrichment 时,Datablist 不需要你的 LinkedIn 登录信息。
但 Datablist 不只是一款 scraper,而是一个完整的 Lead Generation 和 Data Enrichment 生态系统。抓取 LinkedIn 个人资料后,你还可以使用以下工具继续构建 Lead List:
- Waterfall Email Finder: 通过 LinkedIn 个人资料查找邮箱地址
- Phone Number Finder: 为 Lead 补充直拨电话号码
- Job Board Scraper: 一次抓取 19 个招聘网站的职位信息
- LinkedIn Sales Navigator Scraper: 轻松抓取 Sales Navigator 搜索结果
- AI Research Agent: 在电子表格中运行 ChatGPT 搜索,为每一行获取相关答案
将经过核查的姓名和个人资料信息,作为下一步工作流的起点。
常见问题(FAQ)
能从 LinkedIn 个人资料 URL 中提取完整姓名吗?
可以。将 URL 作为 LinkedIn Profile Scraper 的输入,并映射其 Full Name、First Name 和 Last Name 输出即可。不要拆分 /in/ 后面的 URL slug 来猜测姓名,因为它可能是自定义的,也可能已经过时,而且部分个人资料可能不会返回姓名。使用前,请将每个返回的姓名与对应的个人资料 URL 进行核对。
抓取 LinkedIn 个人资料需要多少费用?
每份实时个人资料数据消耗 25 credits,缓存资料消耗 20 credits。以下是一些计算示例:
- 100 份实时个人资料: 2,500 credits
- 1,000 份实时个人资料: 25,000 credits
- 10,000 份实时个人资料: 250,000 credits
以上是成功获取实时结果时的 credits 预估。实际需要加购多少 credits,取决于你的现有余额以及其中是否包含缓存结果。
Datablist 的 LinkedIn Profile Scraper 会连接我的 LinkedIn 账号吗?
这项 enrichment 不需要登录 LinkedIn。因此,在此工作流中,你无需向 Datablist 分享登录凭据;但这并不能保证 LinkedIn 会如何将平台规则应用于任何账号。
Datablist 的 LinkedIn Profile Scraper 包含邮箱吗?
这里介绍的 Profile Scraper 不会在个人资料数据中返回邮箱地址。如果你需要 Email Enrichment,可以另行运行 Waterfall Email Finder。
Datablist 的 LinkedIn Profile Scraper 有速率限制吗?
处理能力和数据提供方的可用性可能会发生变化。建议先测试一小批数据,检查运行状态和 credits 余额;确认结果符合需求后,再增加个人资料数量。
Datablist 的 LinkedIn Profile Scraper 会返回哪些数据?
你可以获取全面的个人资料数据,包括姓名、Headline、个人简介、地点、当前工作信息、工作经历(最多 10 个职位)、教育经历(最多 5 条)、语言和联系人数量。完整字段请参阅上方表格。
抓取 1,000 份 LinkedIn 个人资料需要多长时间?
处理 1,000 份个人资料没有可靠的固定时长。请先运行一个小样本,再根据实际完成时间规划更大的批次;数据提供方的响应速度和无法获取的个人资料都会影响结果。
Datablist 的 LinkedIn Profile Scraper 支持 Sales Navigator URL 吗?
支持。Datablist 的 LinkedIn Profile Scraper 同时接受标准 LinkedIn 个人资料 URL(linkedin.com/in/xxx)和 Sales Navigator URL(linkedin.com/sales/lead/xxx)。输入 Sales Navigator URL 后,工具还会返回标准化的公开个人资料 URL。
批量抓取 LinkedIn 个人资料的最佳方法是什么?
上传一列个人资料 URL,选择 LinkedIn Profile Scraper,映射姓名和其他所需输出,再运行一小批样本。检查空值或匹配错误的结果后,再处理完整名单。
提取候选人资料需要登录 LinkedIn 吗?
LinkedIn Profile Scraper 不需要你的 LinkedIn 登录凭据,因此运行这项 enrichment 时,不会自动操作你自己的已登录会话。请遵守平台规则以及适用的数据使用义务;任何工具都无法承诺账号永远不会受到限制。