
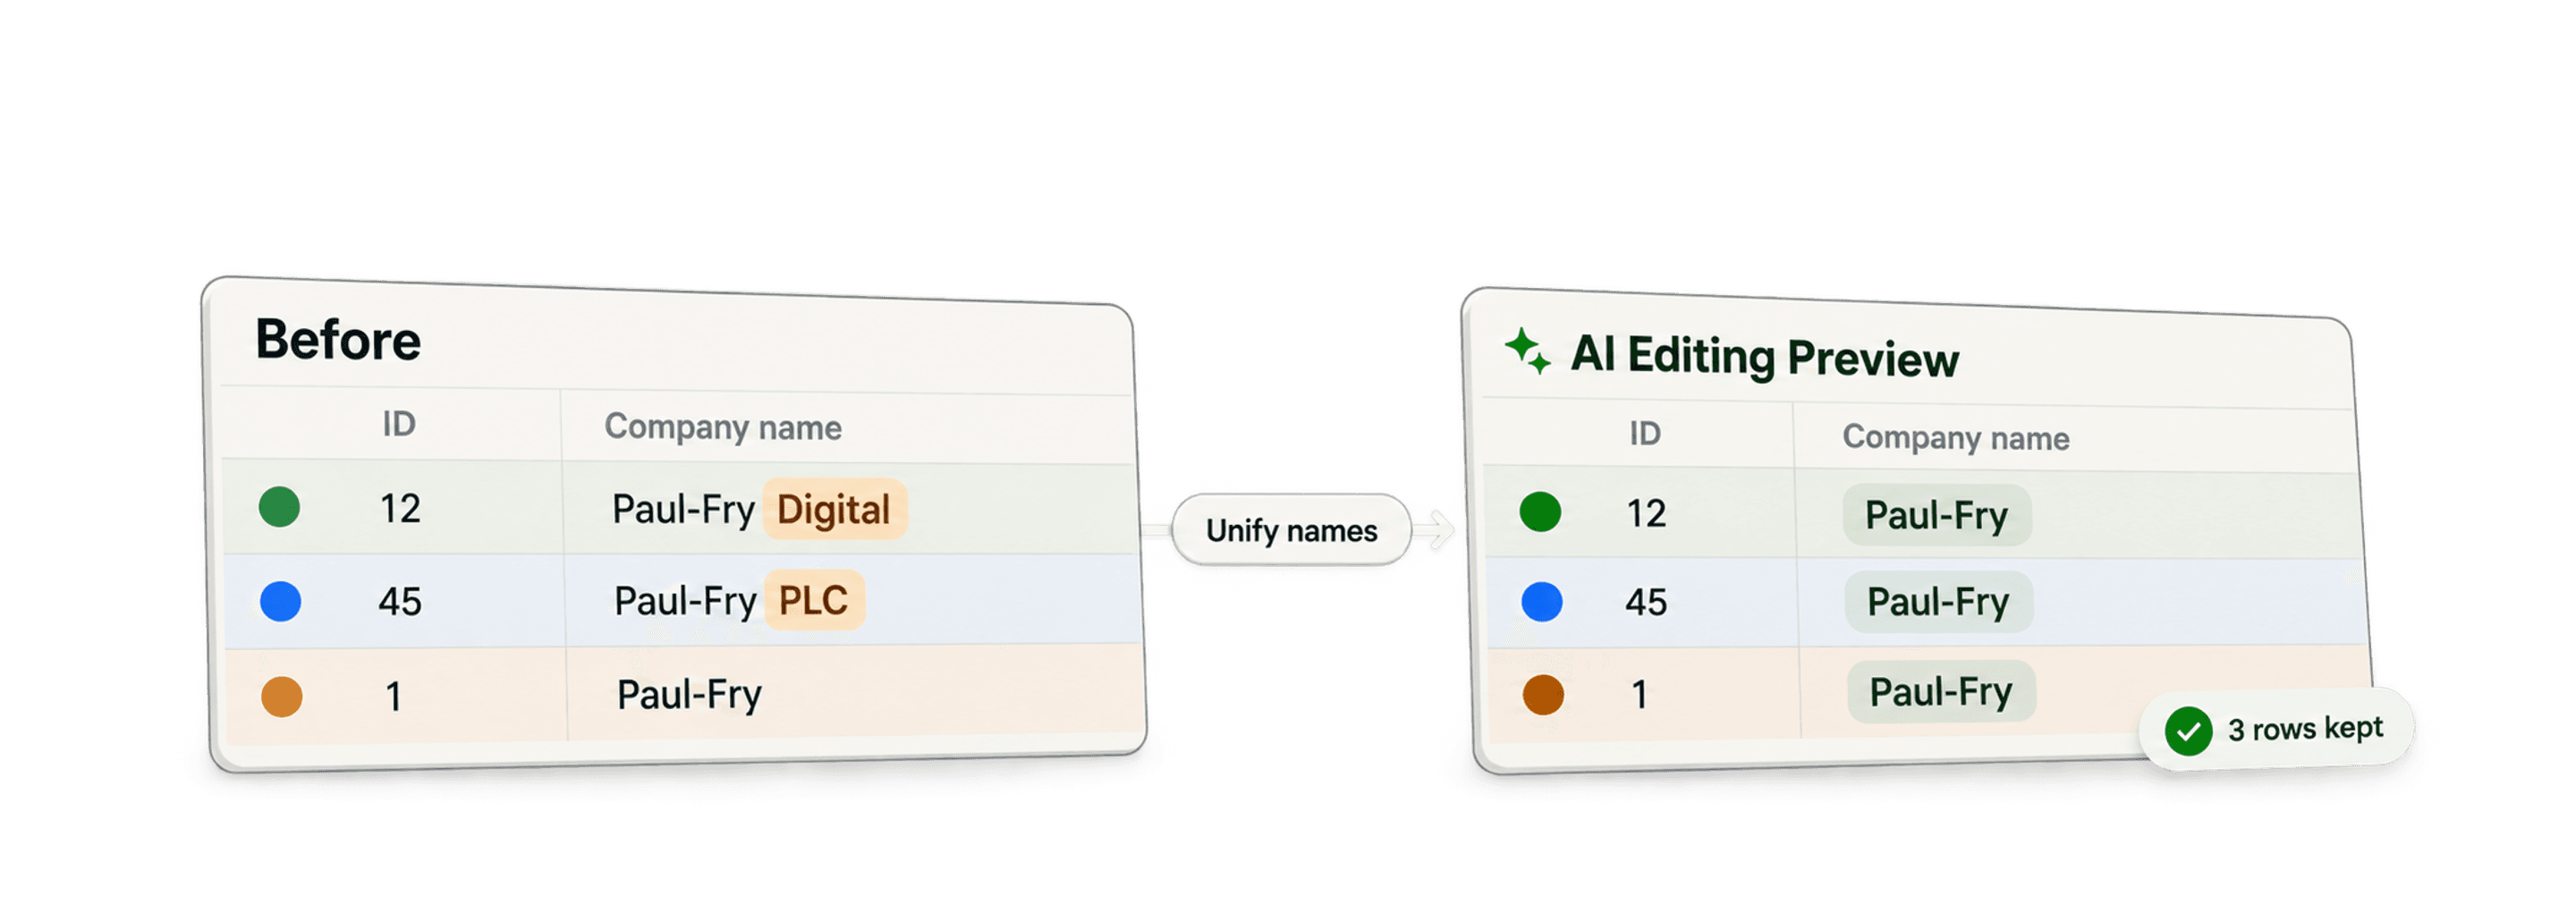
要在不合并行的情况下统一字段值,先找出属于同一实体的记录,为目标字段选定一个值,再将它复制到该组的所有记录中。在 Datablist 中,可以使用 Duplicates Finder 里的 Custom with AI,并在指令中明确要求保留每条记录。
在统一公司名称之前,我建议先使用网站等可靠标识符对公司记录进行分组。仅凭名称相似,并不能证明两家公司属于同一企业。保持各行独立可以保留其 ID 和来源信息,但如果分组有误,错误的名称仍可能被复制到组内记录中。
本指南将介绍如何统一重复记录组中的特定字段值,同时保留每条独立记录:
什么是数据标准化?
在本文语境中,数据标准化是指让数据采用一致的格式。处理重复数据时,某些字段经常会出现不一致。例如:
- 公司名称:“Tech Solutions Inc.”、“Tech Solutions, LLC”、“Tech Solutions”
- 职位名称:“Software Engineer”、“Software Dev.”、“Eng., Software”
- 地址:“123 Main St”、“123 Main Street”、“123 main st”
- 国家:“中国”、“中华人民共和国”、“CN”
标准化的目标是选出一个标准值(例如“Tech Solutions”或“中国”),并将其应用到所有被识别为重复项的记录对应字段中。
即使这些重复记录仍然彼此独立,这样处理也能让数据更整洁、更容易分析,并提高筛选和报表的可靠性。它是数据清洗中的关键一步。
Duplicates Finder 中的 AI Processing
Datablist 的 Duplicates Finder 本身就是一款强大的相似记录识别工具。除了提供完善的自动或手动合并重复项功能外,AI Processing 模式还能带来更高的灵活性。
你不必使用预设的合并规则,而是可以通过自然语言 Prompt 自行定义处理逻辑,准确告诉 AI 应如何处理重复项,包括:
- 根据特定条件选择主记录,例如最近更新的记录。
- 合并指定字段,同时让其他字段保持独立。
- 在合并过程中执行计算,例如对数值求和。
- 👉 也是本指南最重要的用途:在不合并记录的前提下,将所有重复项中的指定字段更新为同一个标准值。
原本需要编写脚本才能完成的数据处理,现在只需用自然语言向 AI 说明需求即可。
如何逐步统一重复数据中的字段值
下面以公司名称为例,介绍如何使用 AI Processing 统一重复记录中的字段值。
第 1 步:准备数据
首先,需要将数据导入 Datablist。
- **创建 Collection:**点击侧边栏中的“+”按钮,新建一个 Collection。
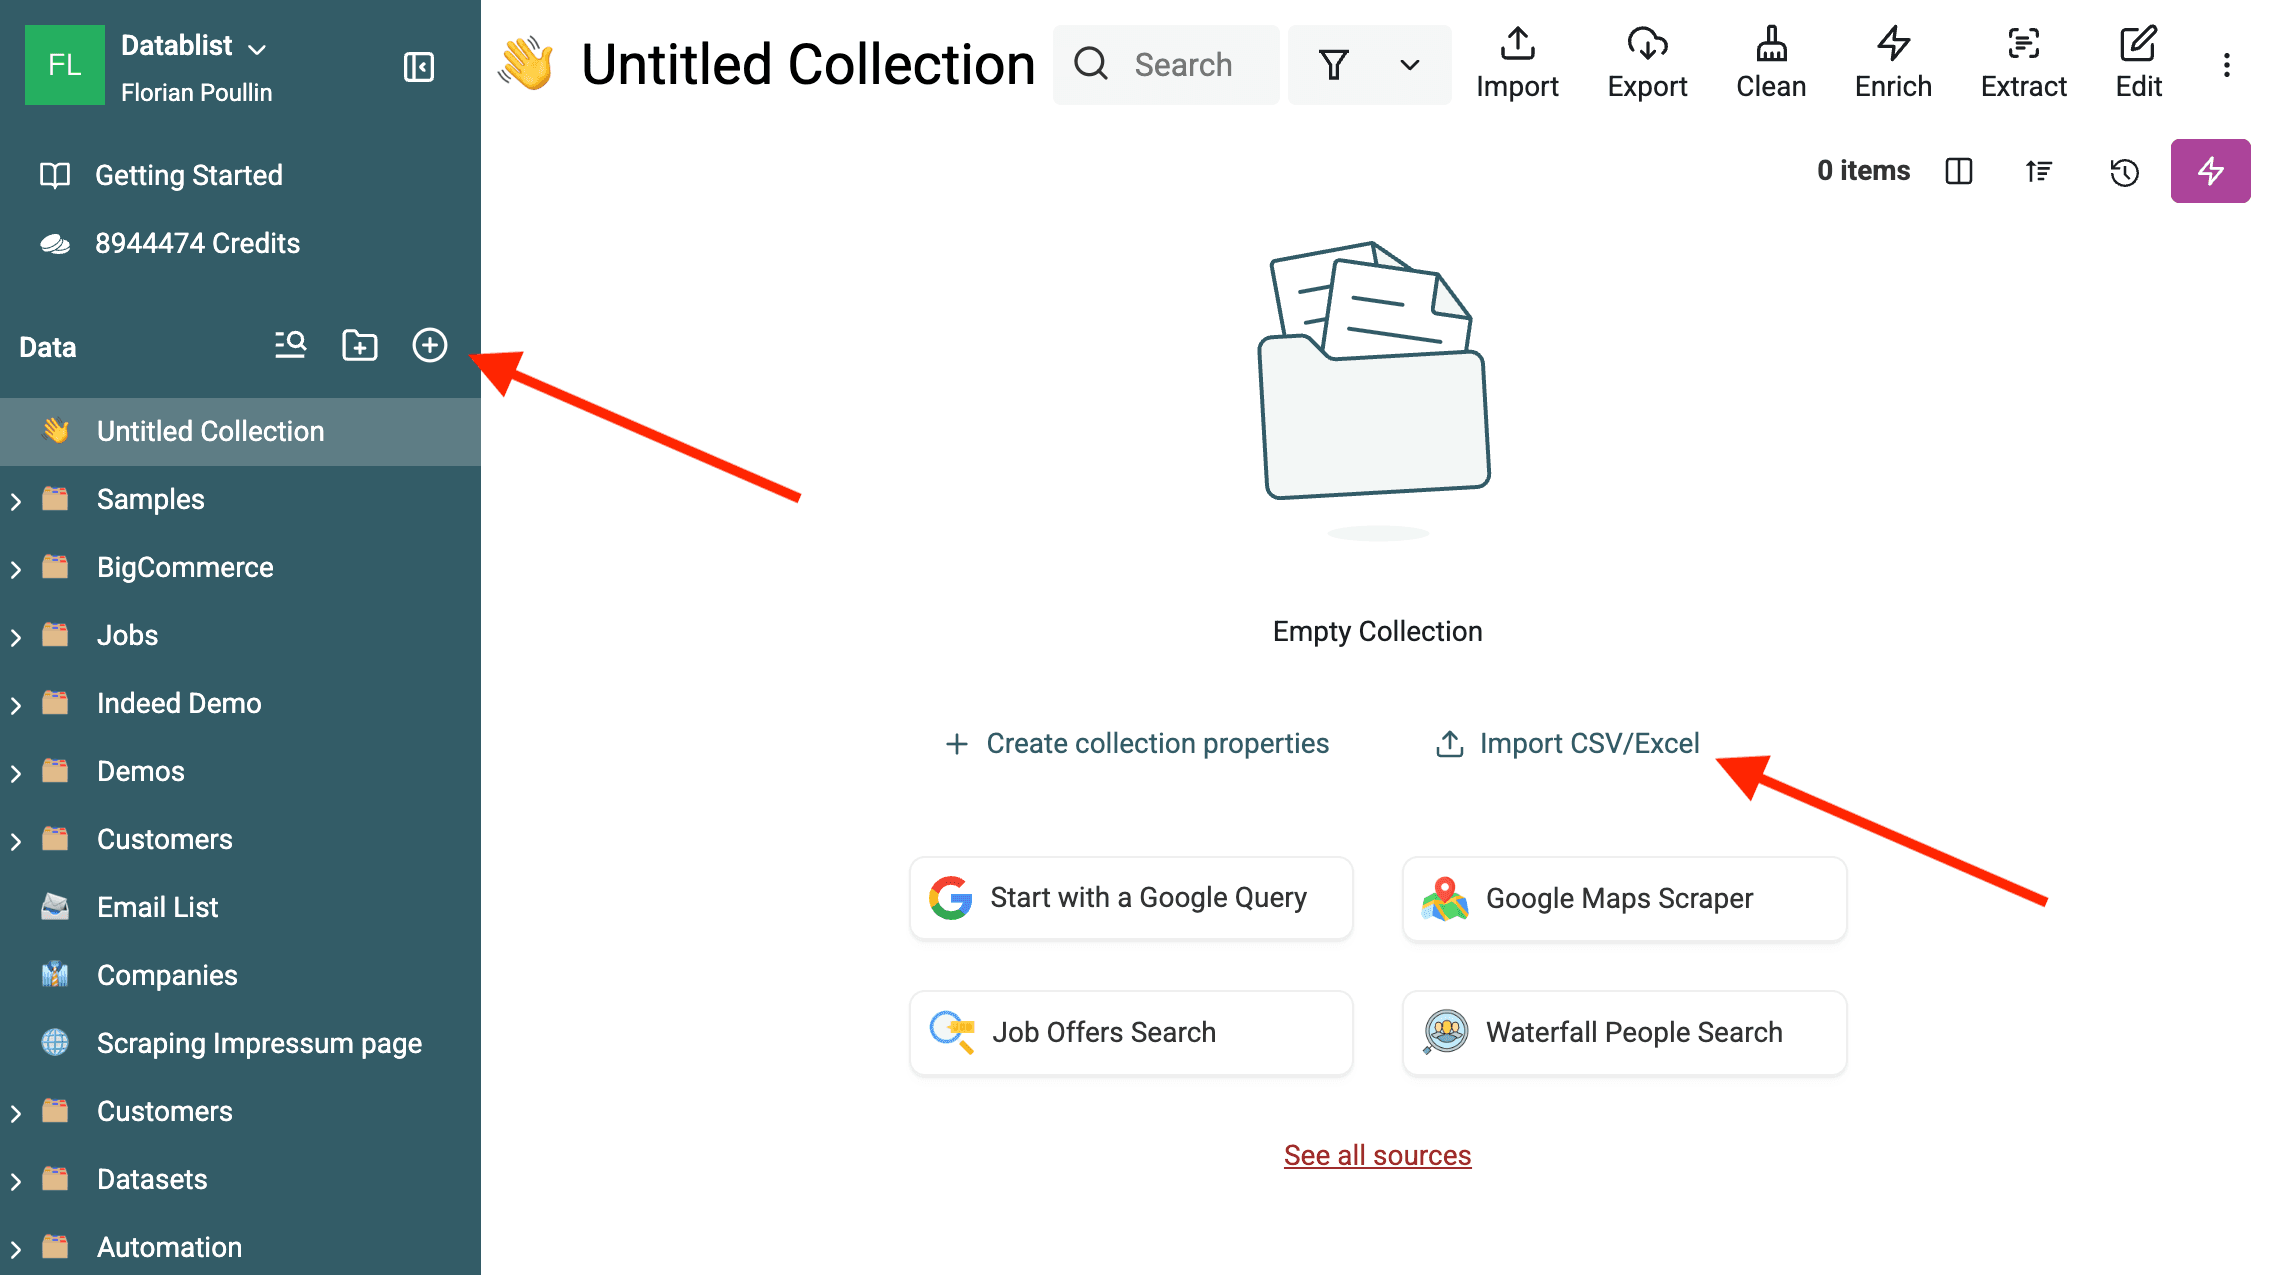
- **导入数据:**从 CSV 或 Excel 文件导入数据。如果数据来自多个文件,请将它们导入同一个 Collection。Datablist 会引导你把各列映射到相应的 Property。请确保要标准化的字段(如 Company Name)以及用于识别重复项的字段(如 Email、Website)均已正确导入。
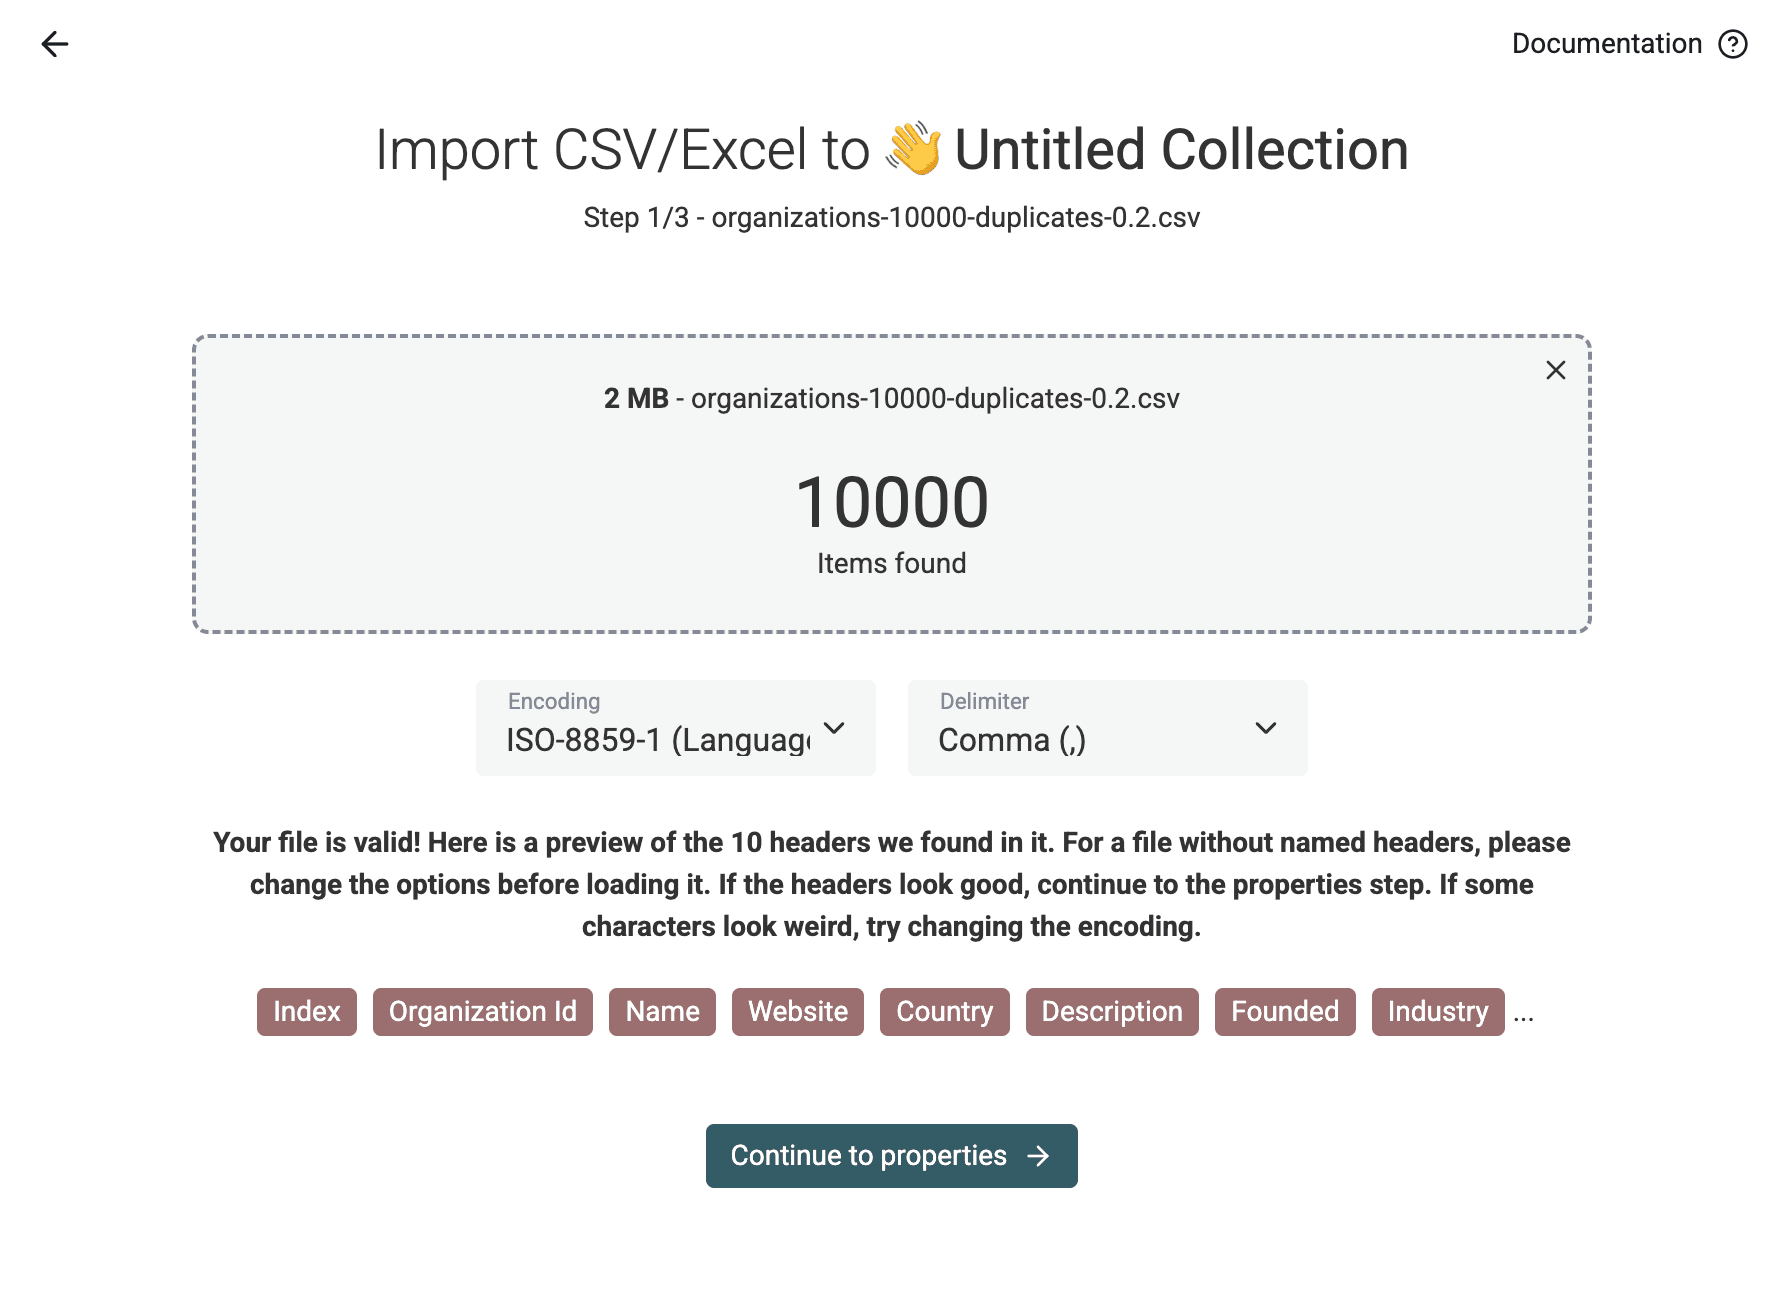
在这份示例数据中,已经可以看到一些需要统一的重复公司名称。
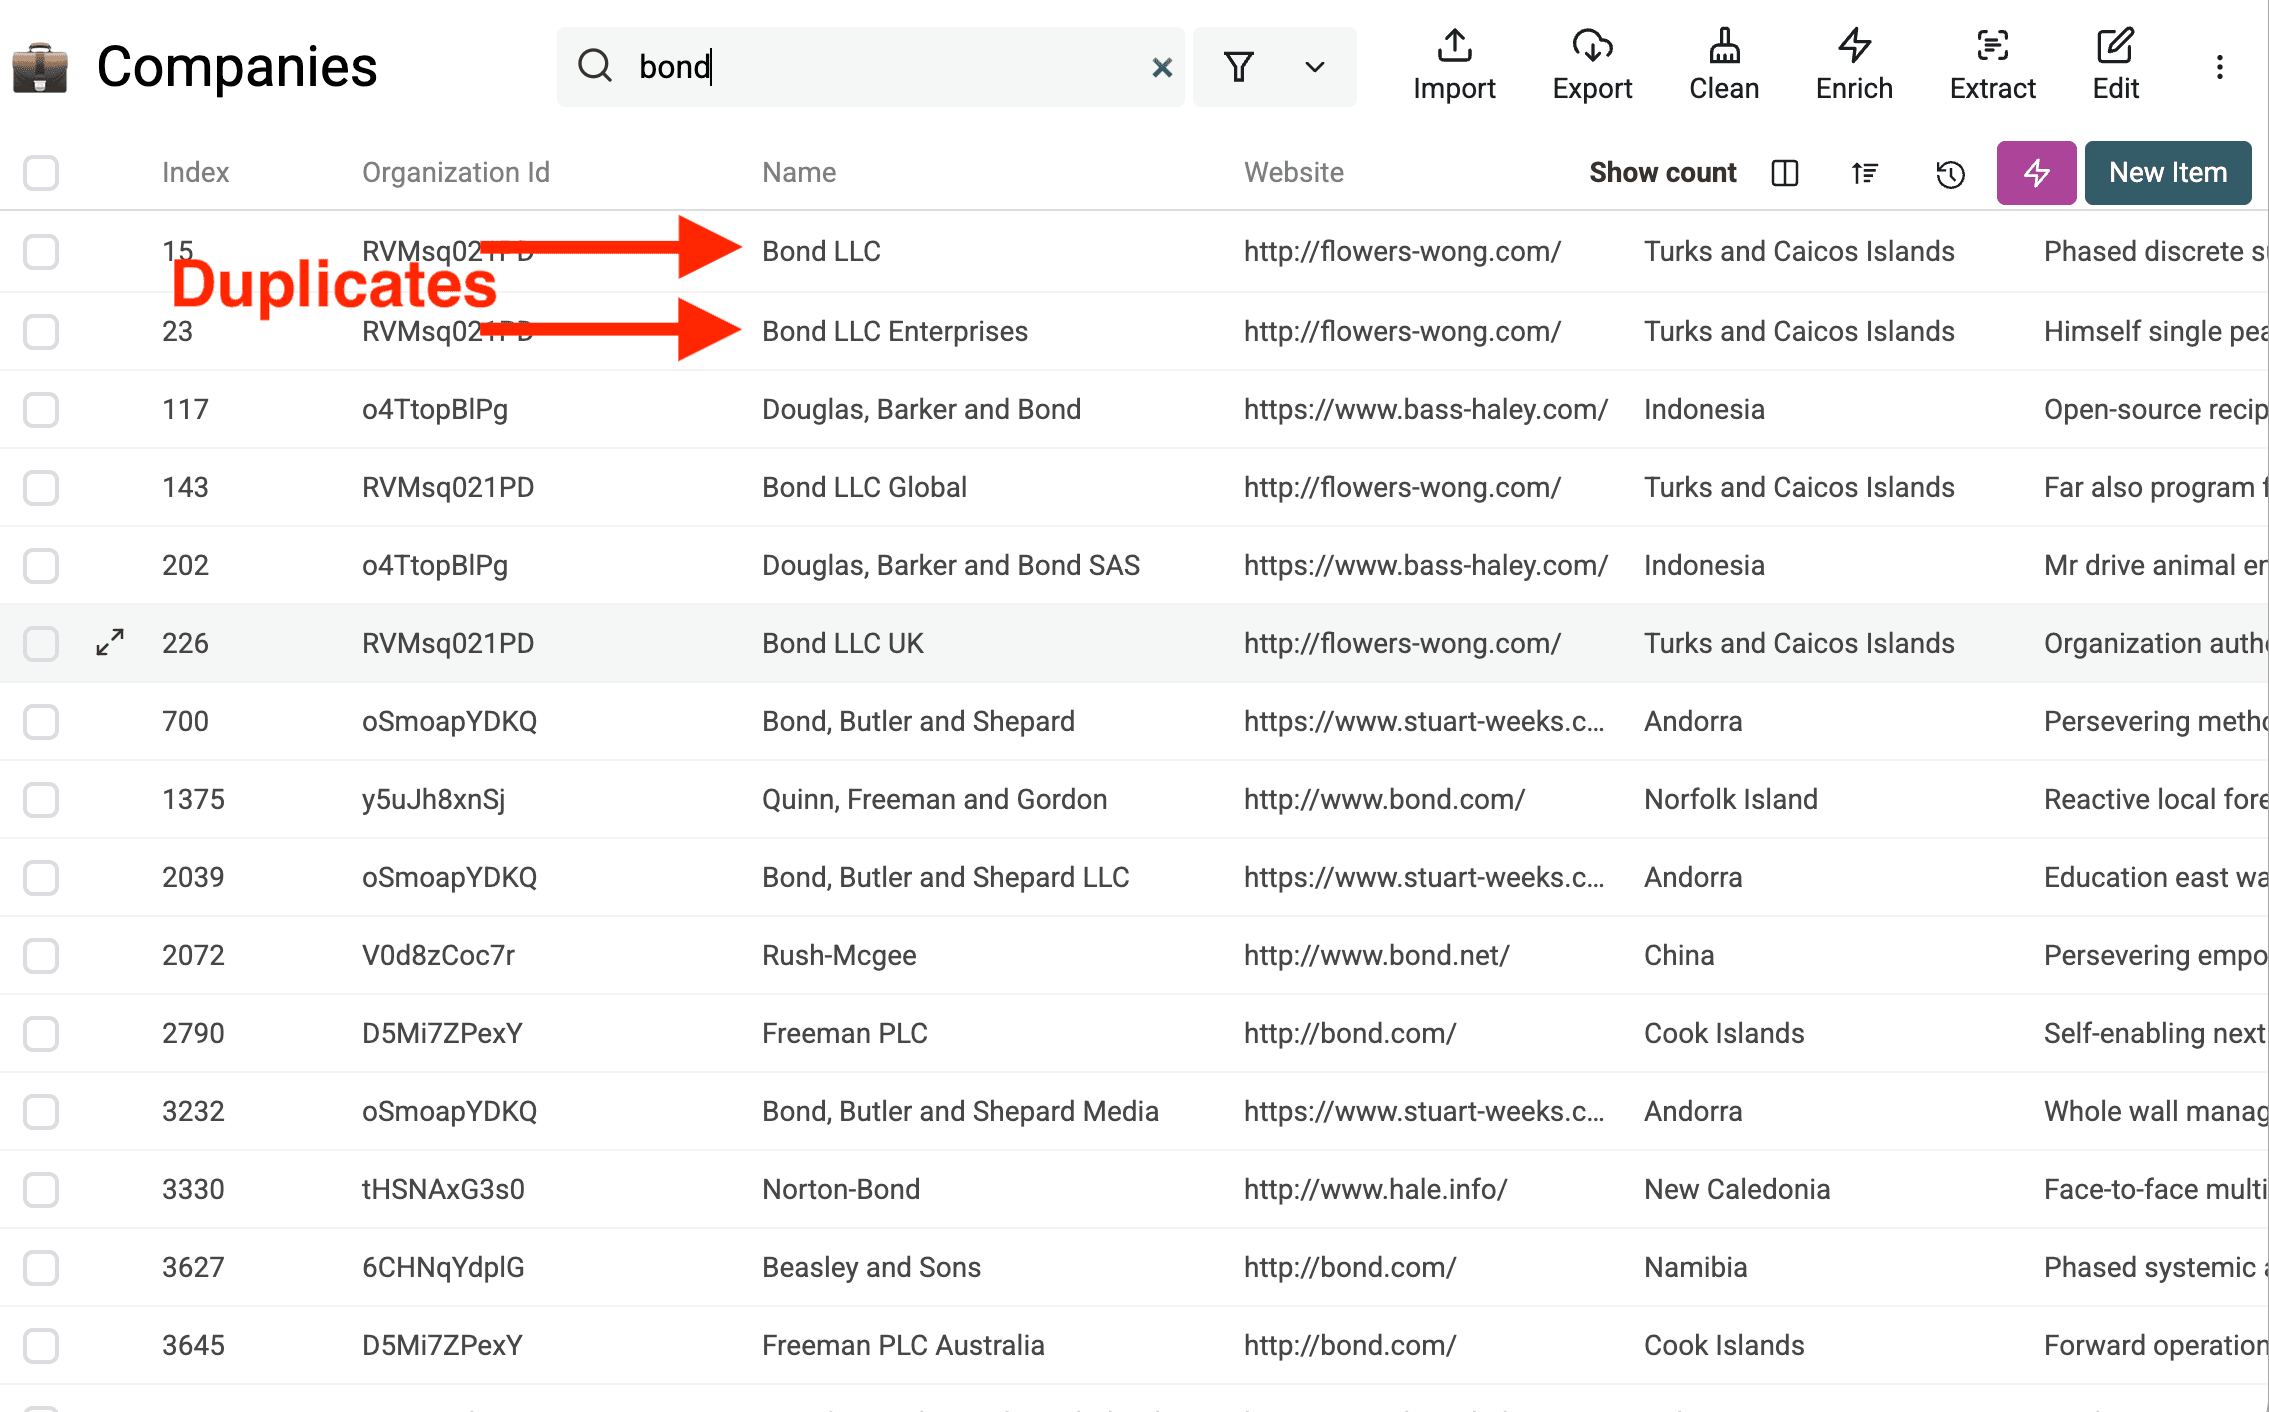
第 2 步:查找重复项
接下来,识别重复记录。
2.a 打开 Duplicates Finder
打开 Clean > Merge duplicates。
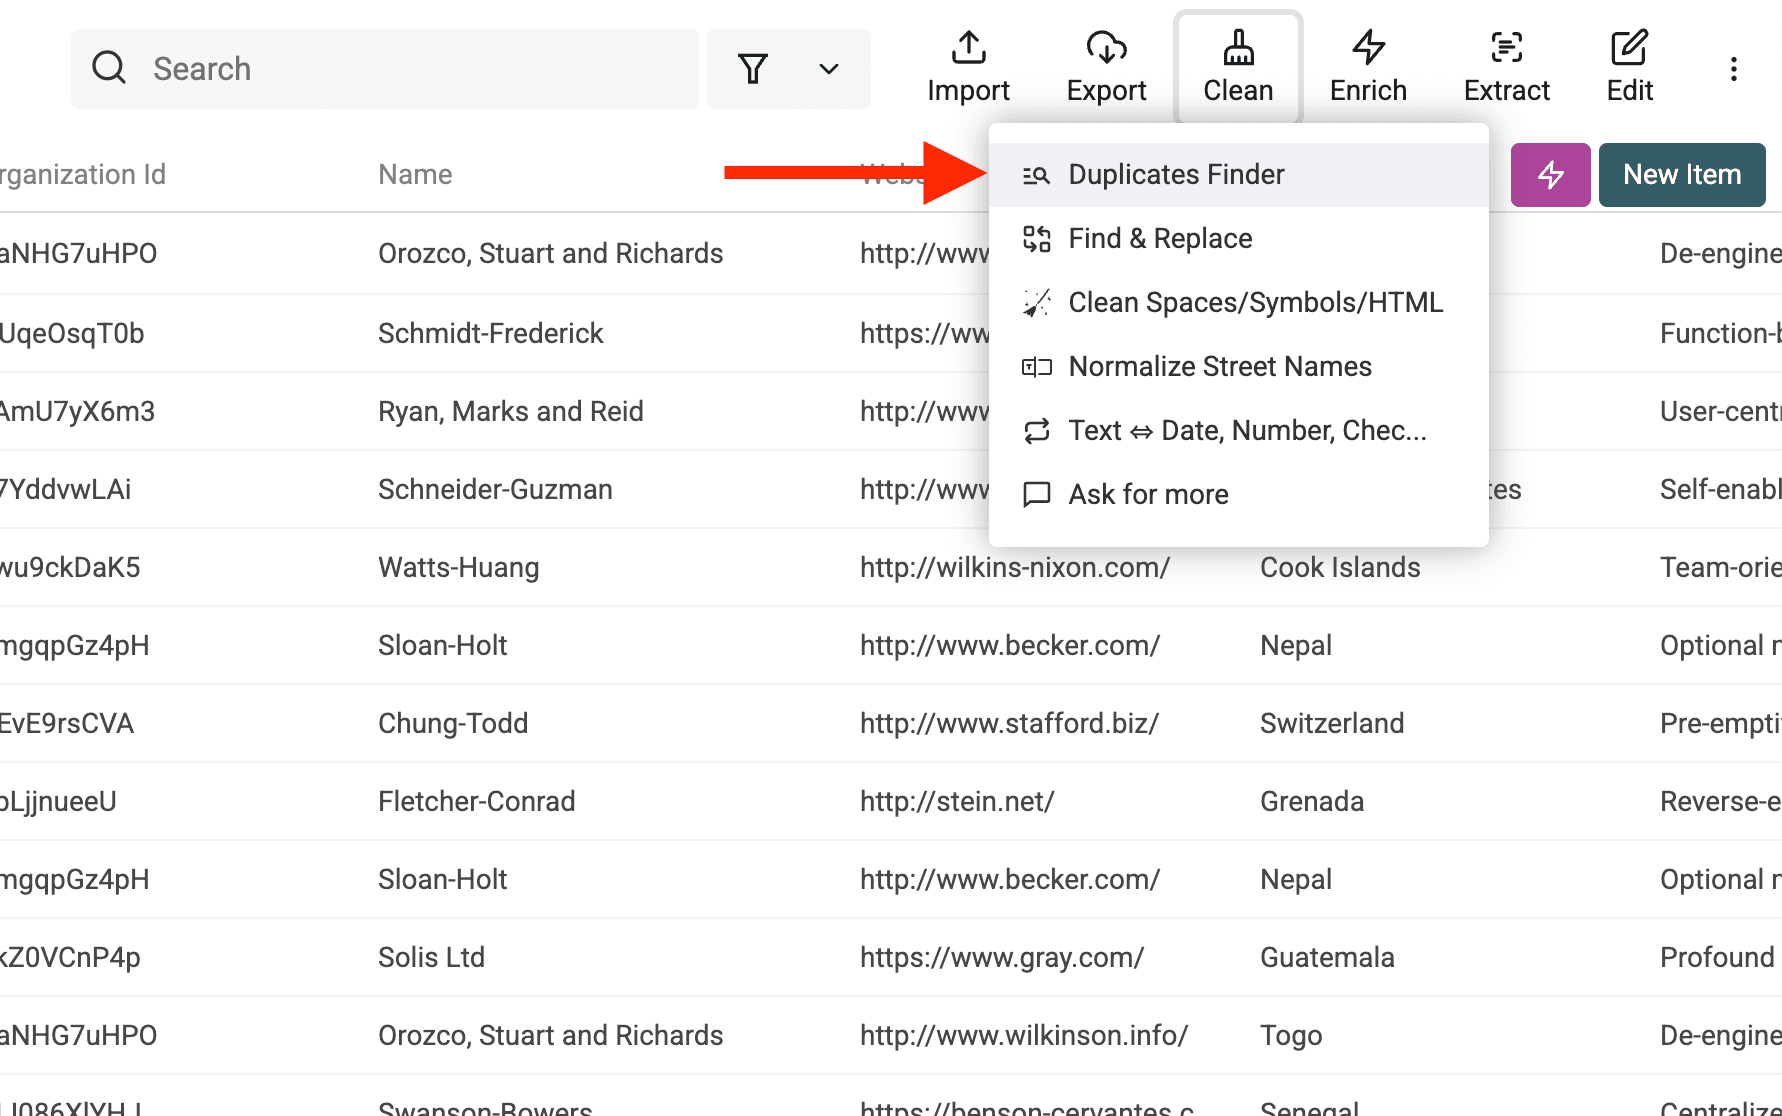
2.b 选择去重标识符
选择能够唯一识别重复项的 Property,可以选择一个或多个。
如果有共享的网站或公司 ID,请优先使用。如果手头只有公司名称,请参考公司名称匹配指南,并在标准化之前逐组检查。名称相似或法律实体后缀不同的公司,也可能是彼此独立的企业。
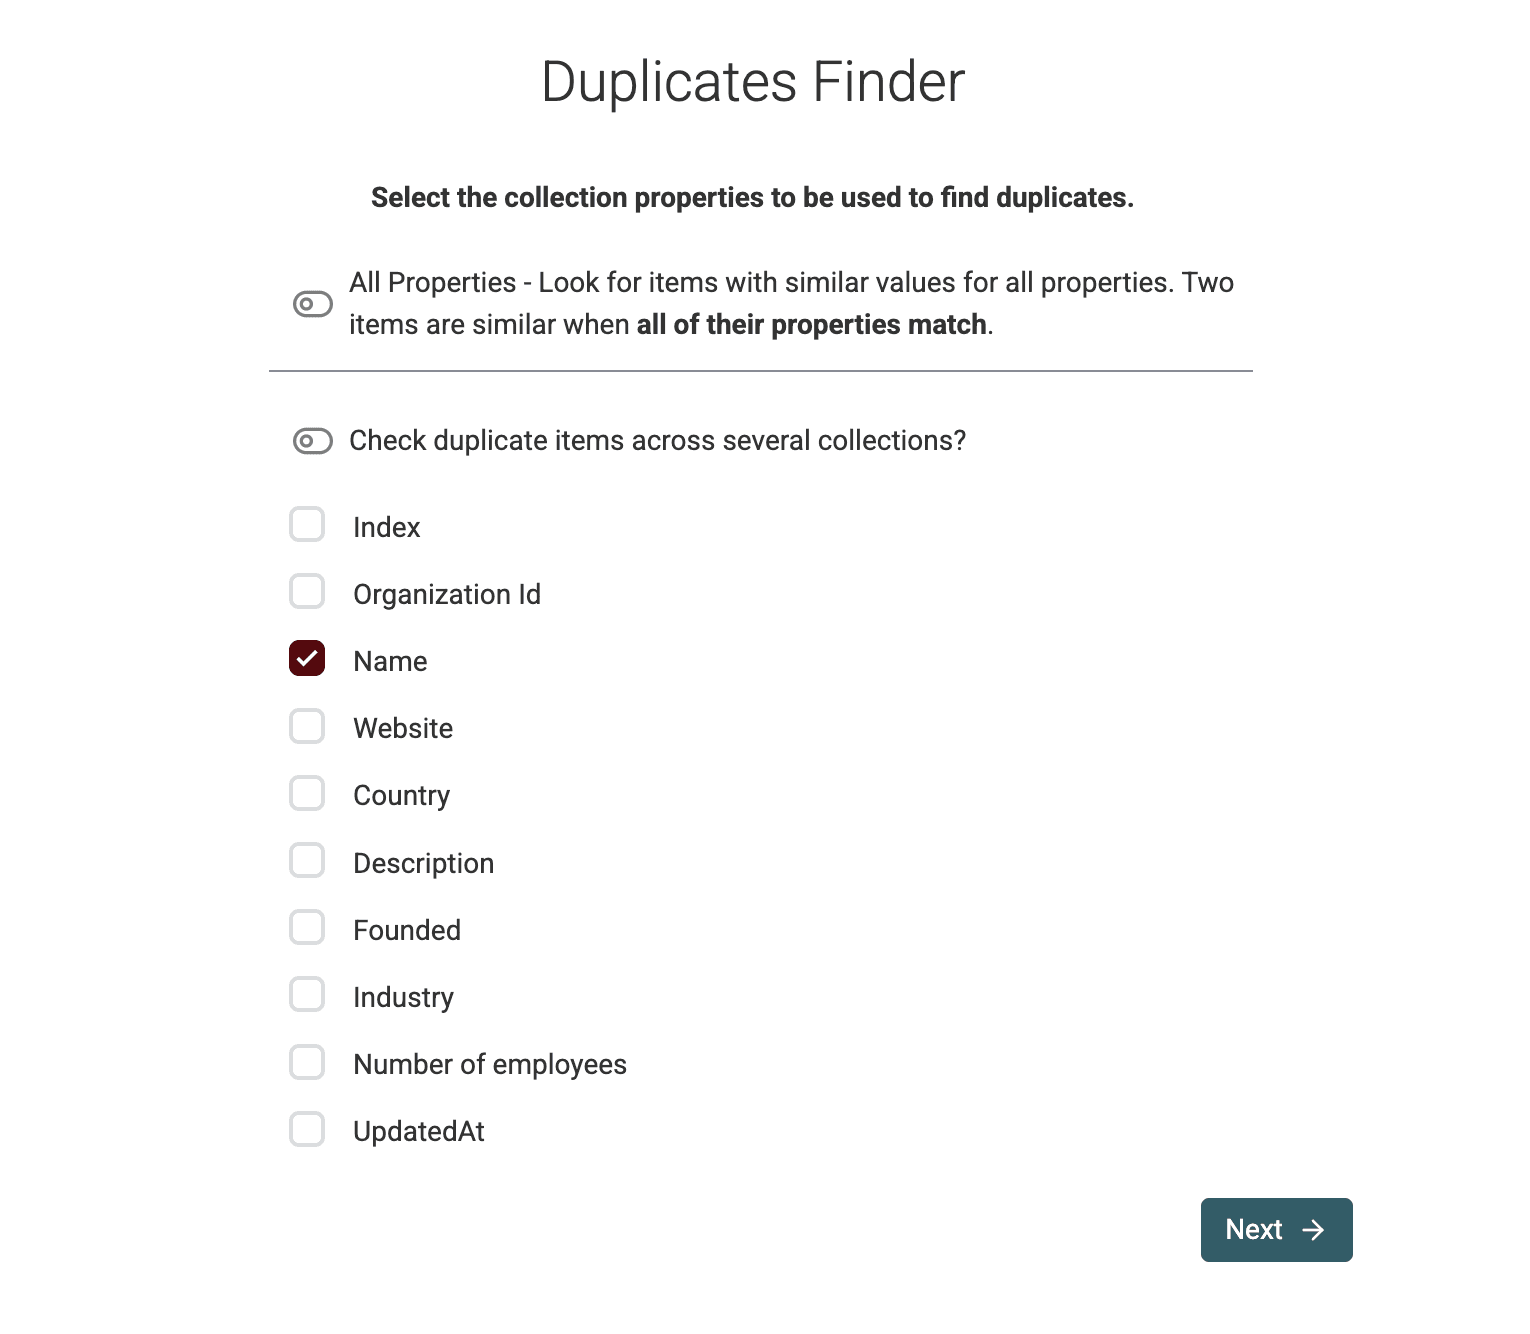
对于公司,也可以使用
Website URL或LinkedIn Company Page URL。对于联系人,常用选项包括
Phone Number。
2.c 配置匹配算法
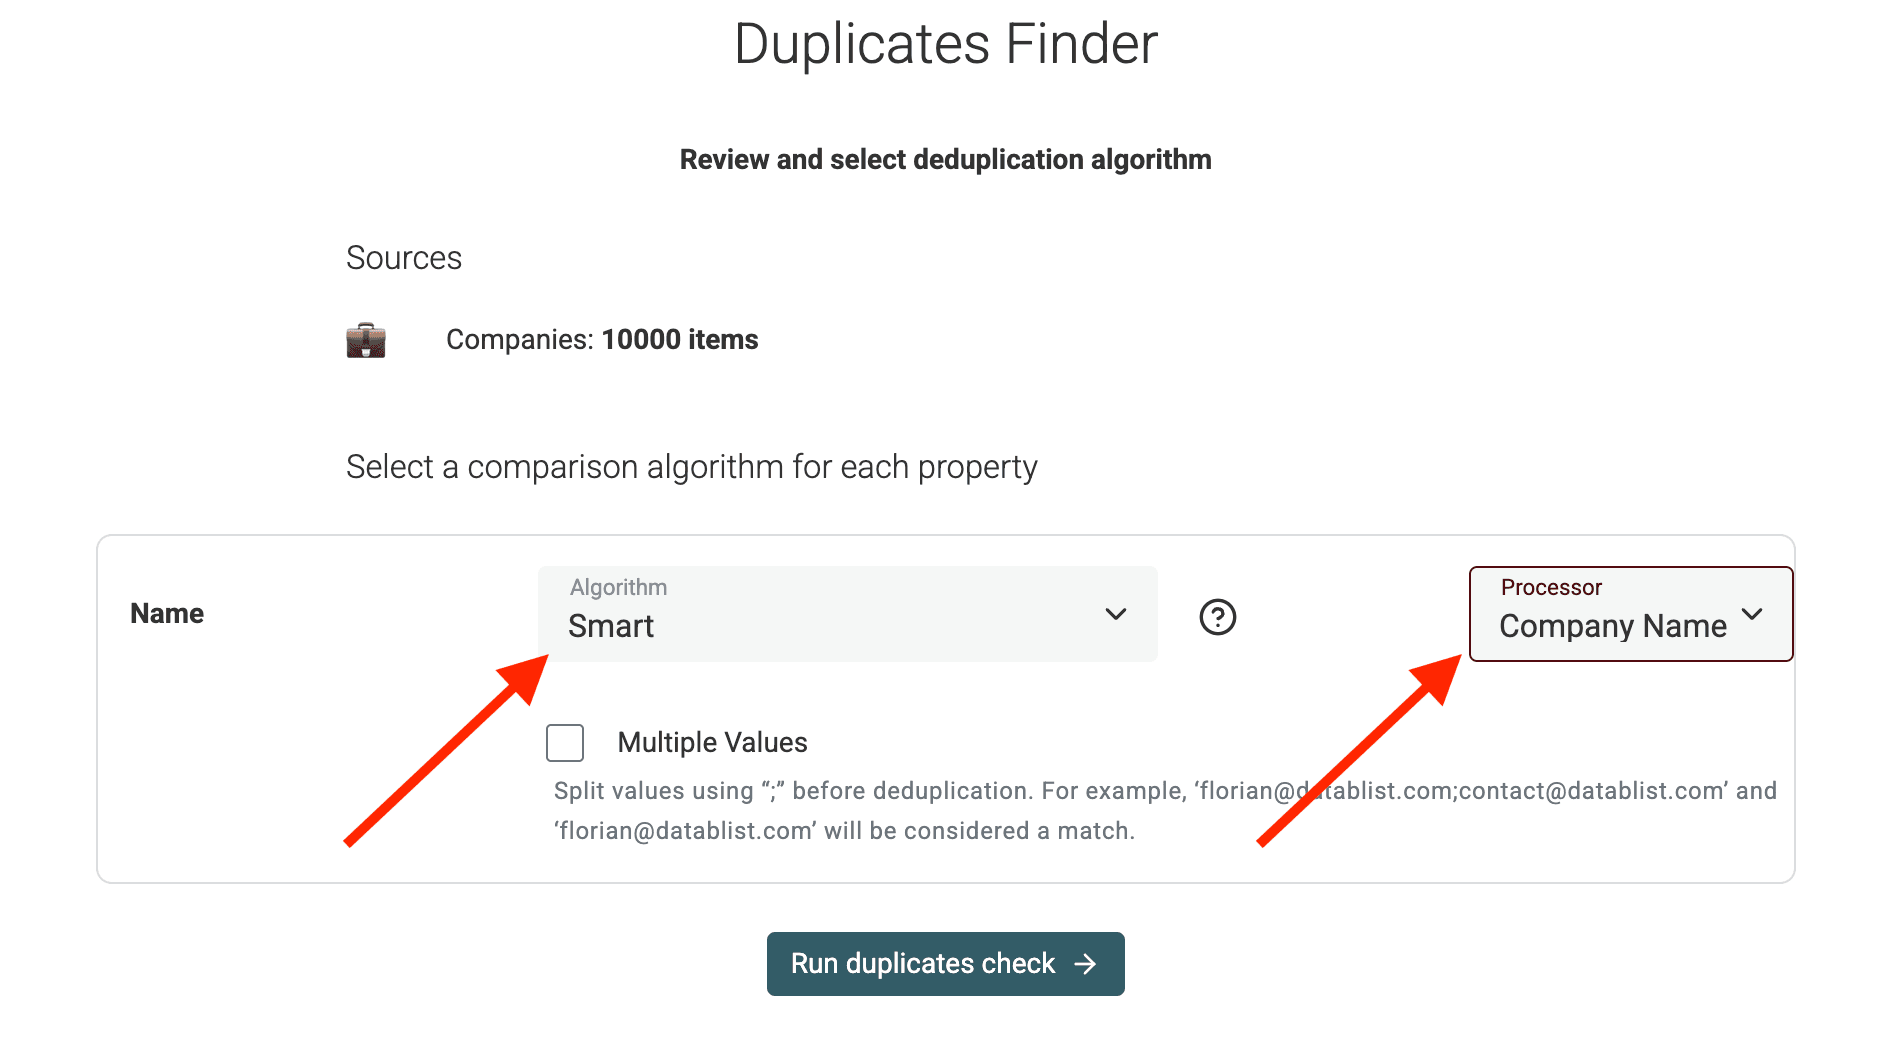
下一步,选择匹配算法。
“Smart”通常适合 URL 或 Email,能够处理细微差异;“Exact”则更严格。匹配名称时,还可以使用语音或模糊匹配。
为用于识别重复项的字段选择合适的 Processor。网站标识符使用 Url,邮箱标识符使用 Email。匹配公司名称变体时,请选择 Company Name。
Processor 只会改变值的比较方式,不会编辑已存储的单元格。你可以在这里按 Website URL 分组,再在后续 AI 步骤中统一 Company Name。匹配标识符与需要更新的字段承担的是不同作用。
2.c 运行重复项检查
点击 Run duplicates check。
Datablist 会分析数据,并展示可能的重复记录组。
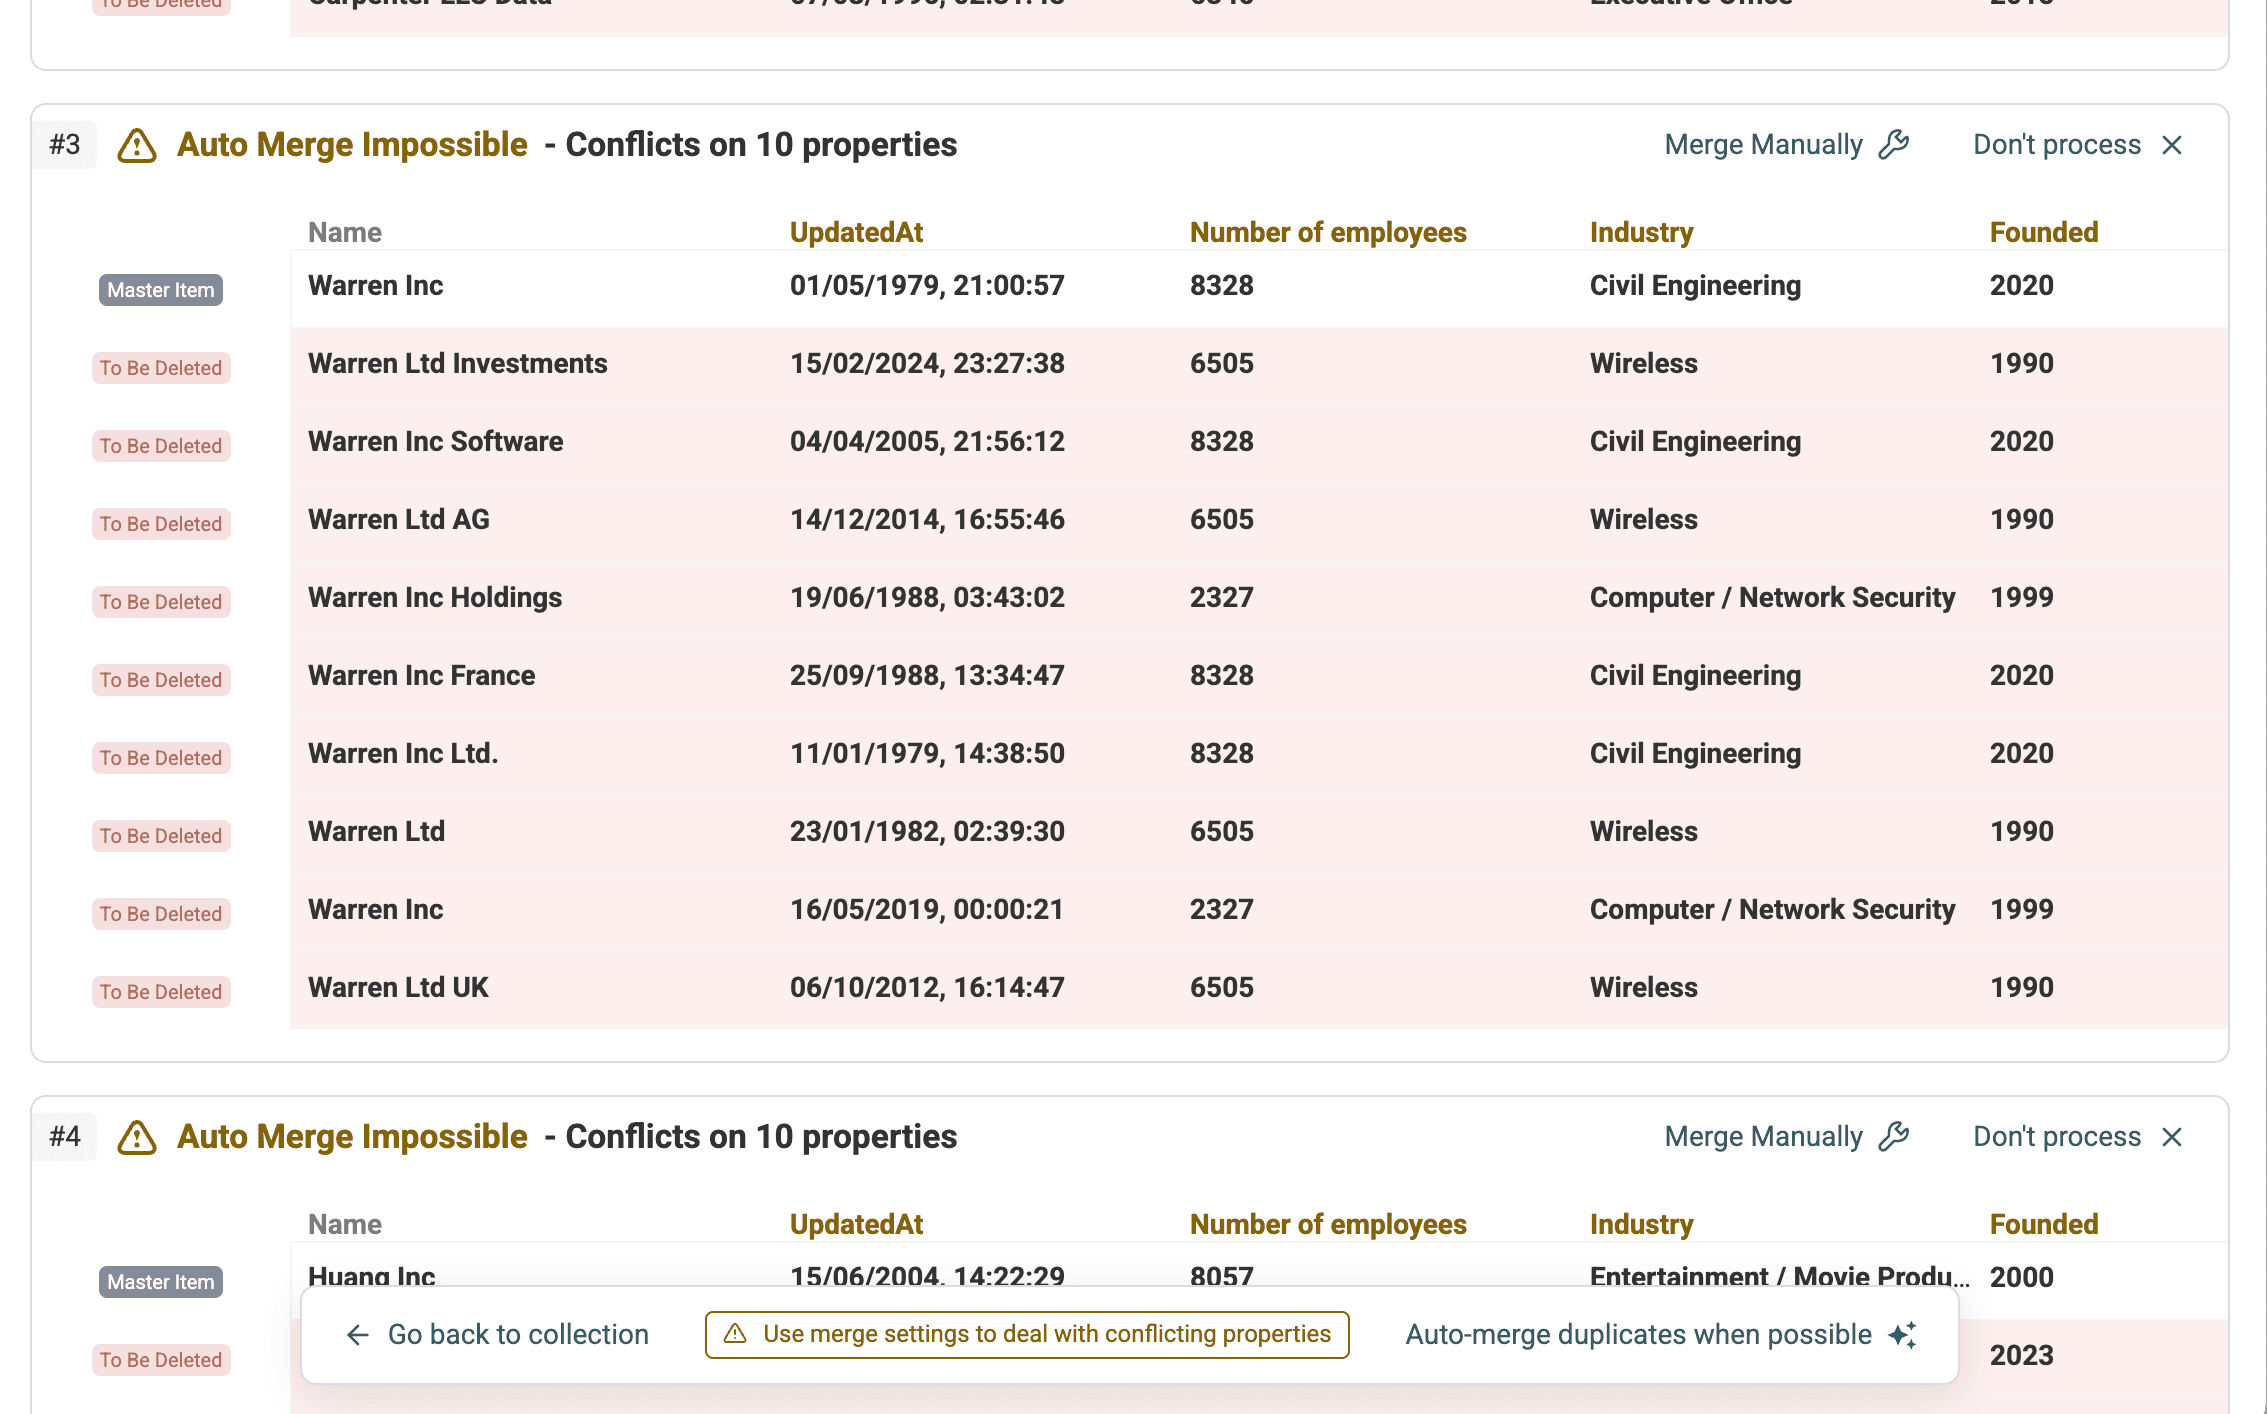
第 3 步:选择 AI Processing 模式
在重复项结果页面选择 Custom with AI。下方较早的截图仍显示旧名称 AI Editing。该模式会根据你的指令和少量记录样本生成脚本,然后预览脚本将进行的更改。
第 4 步:编写标准化 Prompt
现在需要告诉 AI 具体要做什么。指令应要求它:
- 找出每个重复记录组中目标 Property 出现次数最多的值。
- 将该组中的所有记录更新为这个常用值,但只修改指定 Property。
- 明确说明不得删除任何记录。
以下 Prompt 示例用于统一 /Company Name Property:
对于每个重复记录组,使用精确文本匹配统计非空的 /CompanyName 值。如果某个值的出现次数高于其他所有值,请将其复制到该组每条记录的 /CompanyName 中,包括 CompanyName 为空的记录。
如果所有值均为空,或者有两个及以上的值并列出现次数最多,请跳过该组,不做任何更改。值已经完全相同的组也应跳过。保留其他所有 Property,不要合并或删除任何记录。
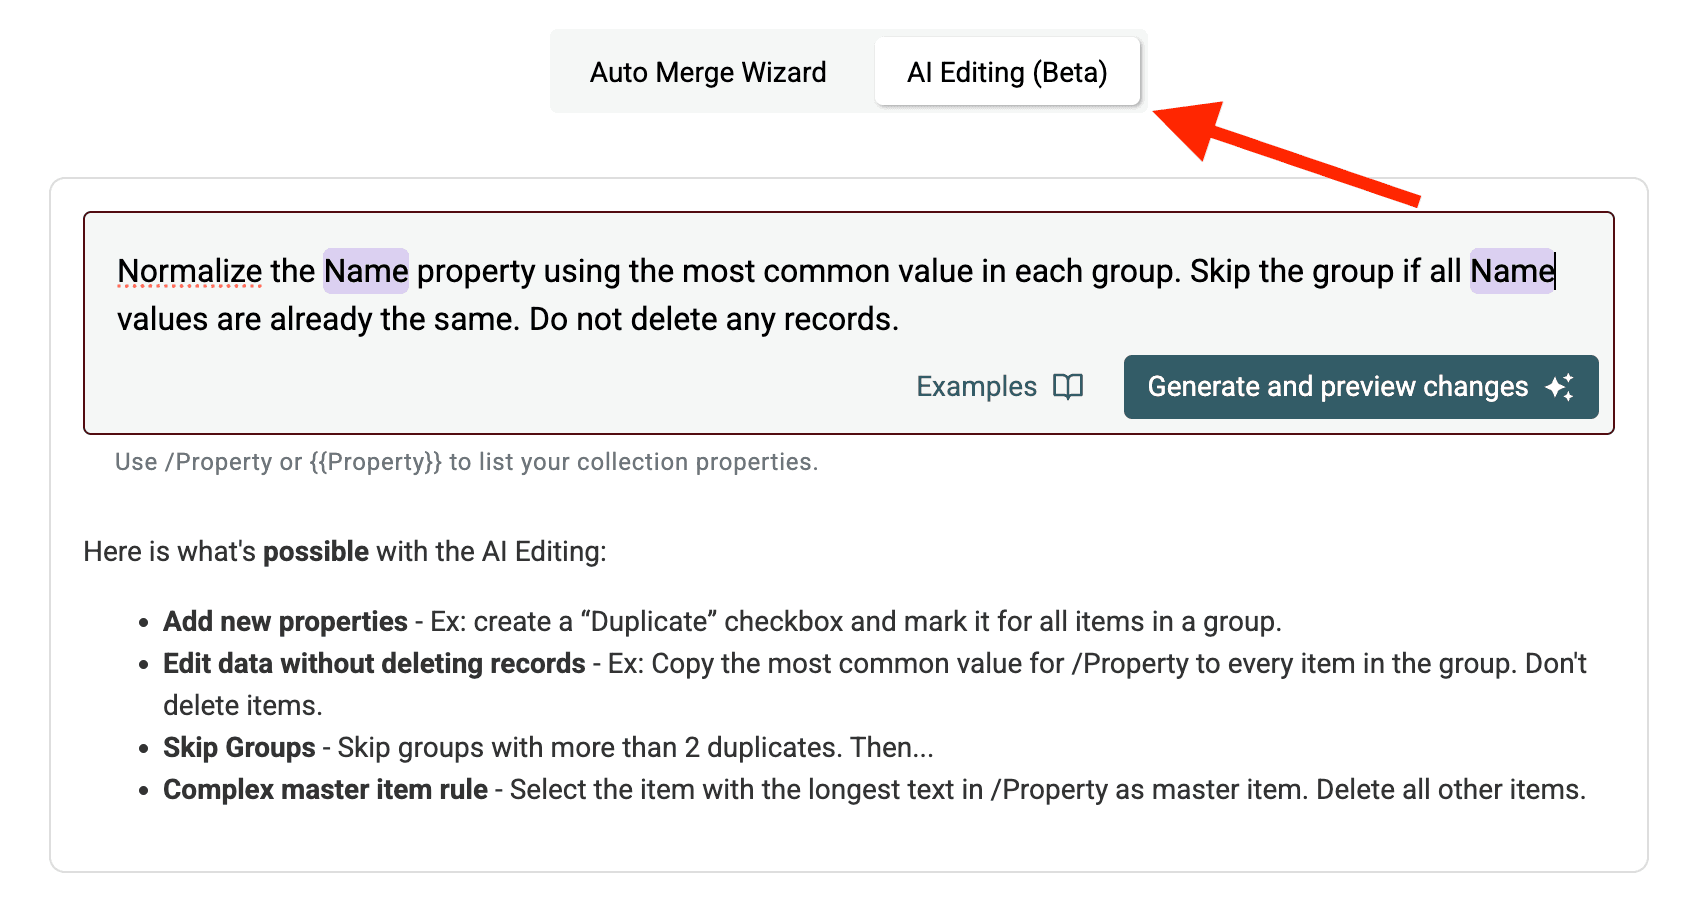
Prompt 解析:
统一 /CompanyName Property……:指定目标字段。使用/PropertyName或{{PropertyName}}引用数据列。……使用精确文本匹配统计非空值。:定义标准值的选择方式。空值不能成为结果;如果出现并列,则保留该组供人工检查。你也可以采用其他标准,例如“最长值”“最短值”,或引用另一字段,例如“使用 /UpdatedAt 日期最新记录中的值”。如果所有 /CompanyName 值已经相同,则跳过该组。:避免不必要处理,提高效率。不要删除任何记录。:这条指令至关重要,可确保系统只更新字段,不会合并或移除记录。
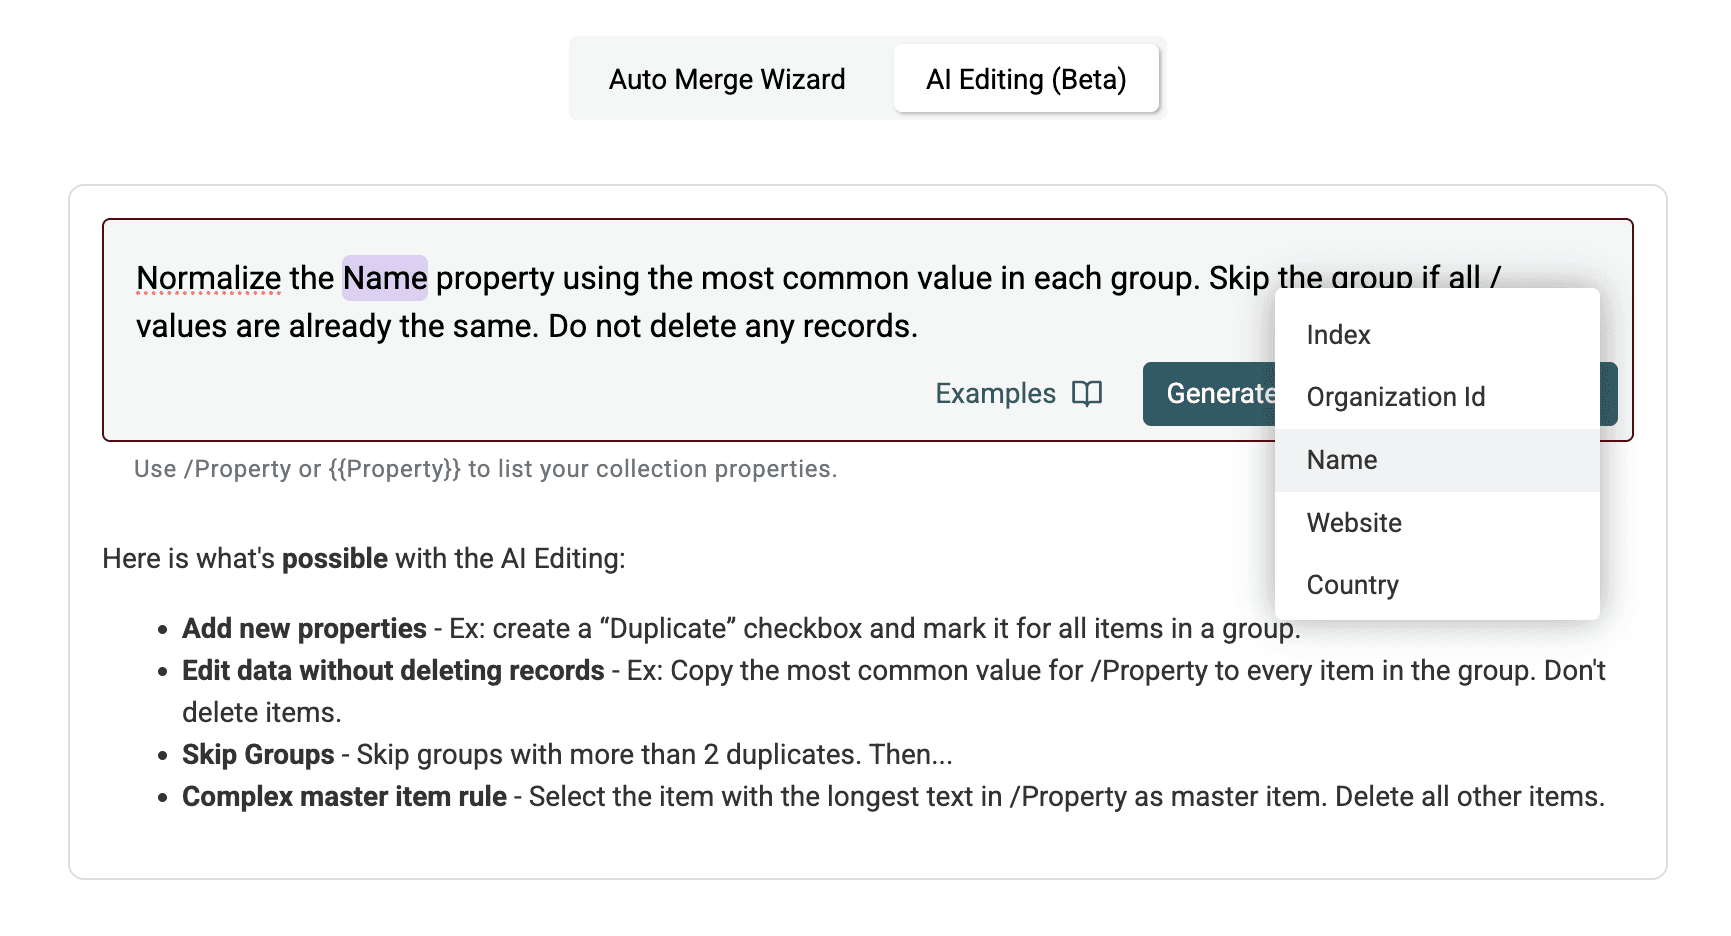
第 5 步:生成并预览脚本
点击 Generate and preview changes。Datablist AI 会解析 Prompt,并生成用于执行操作的脚本。
无需担心,你不需要亲自编写或编辑任何脚本。
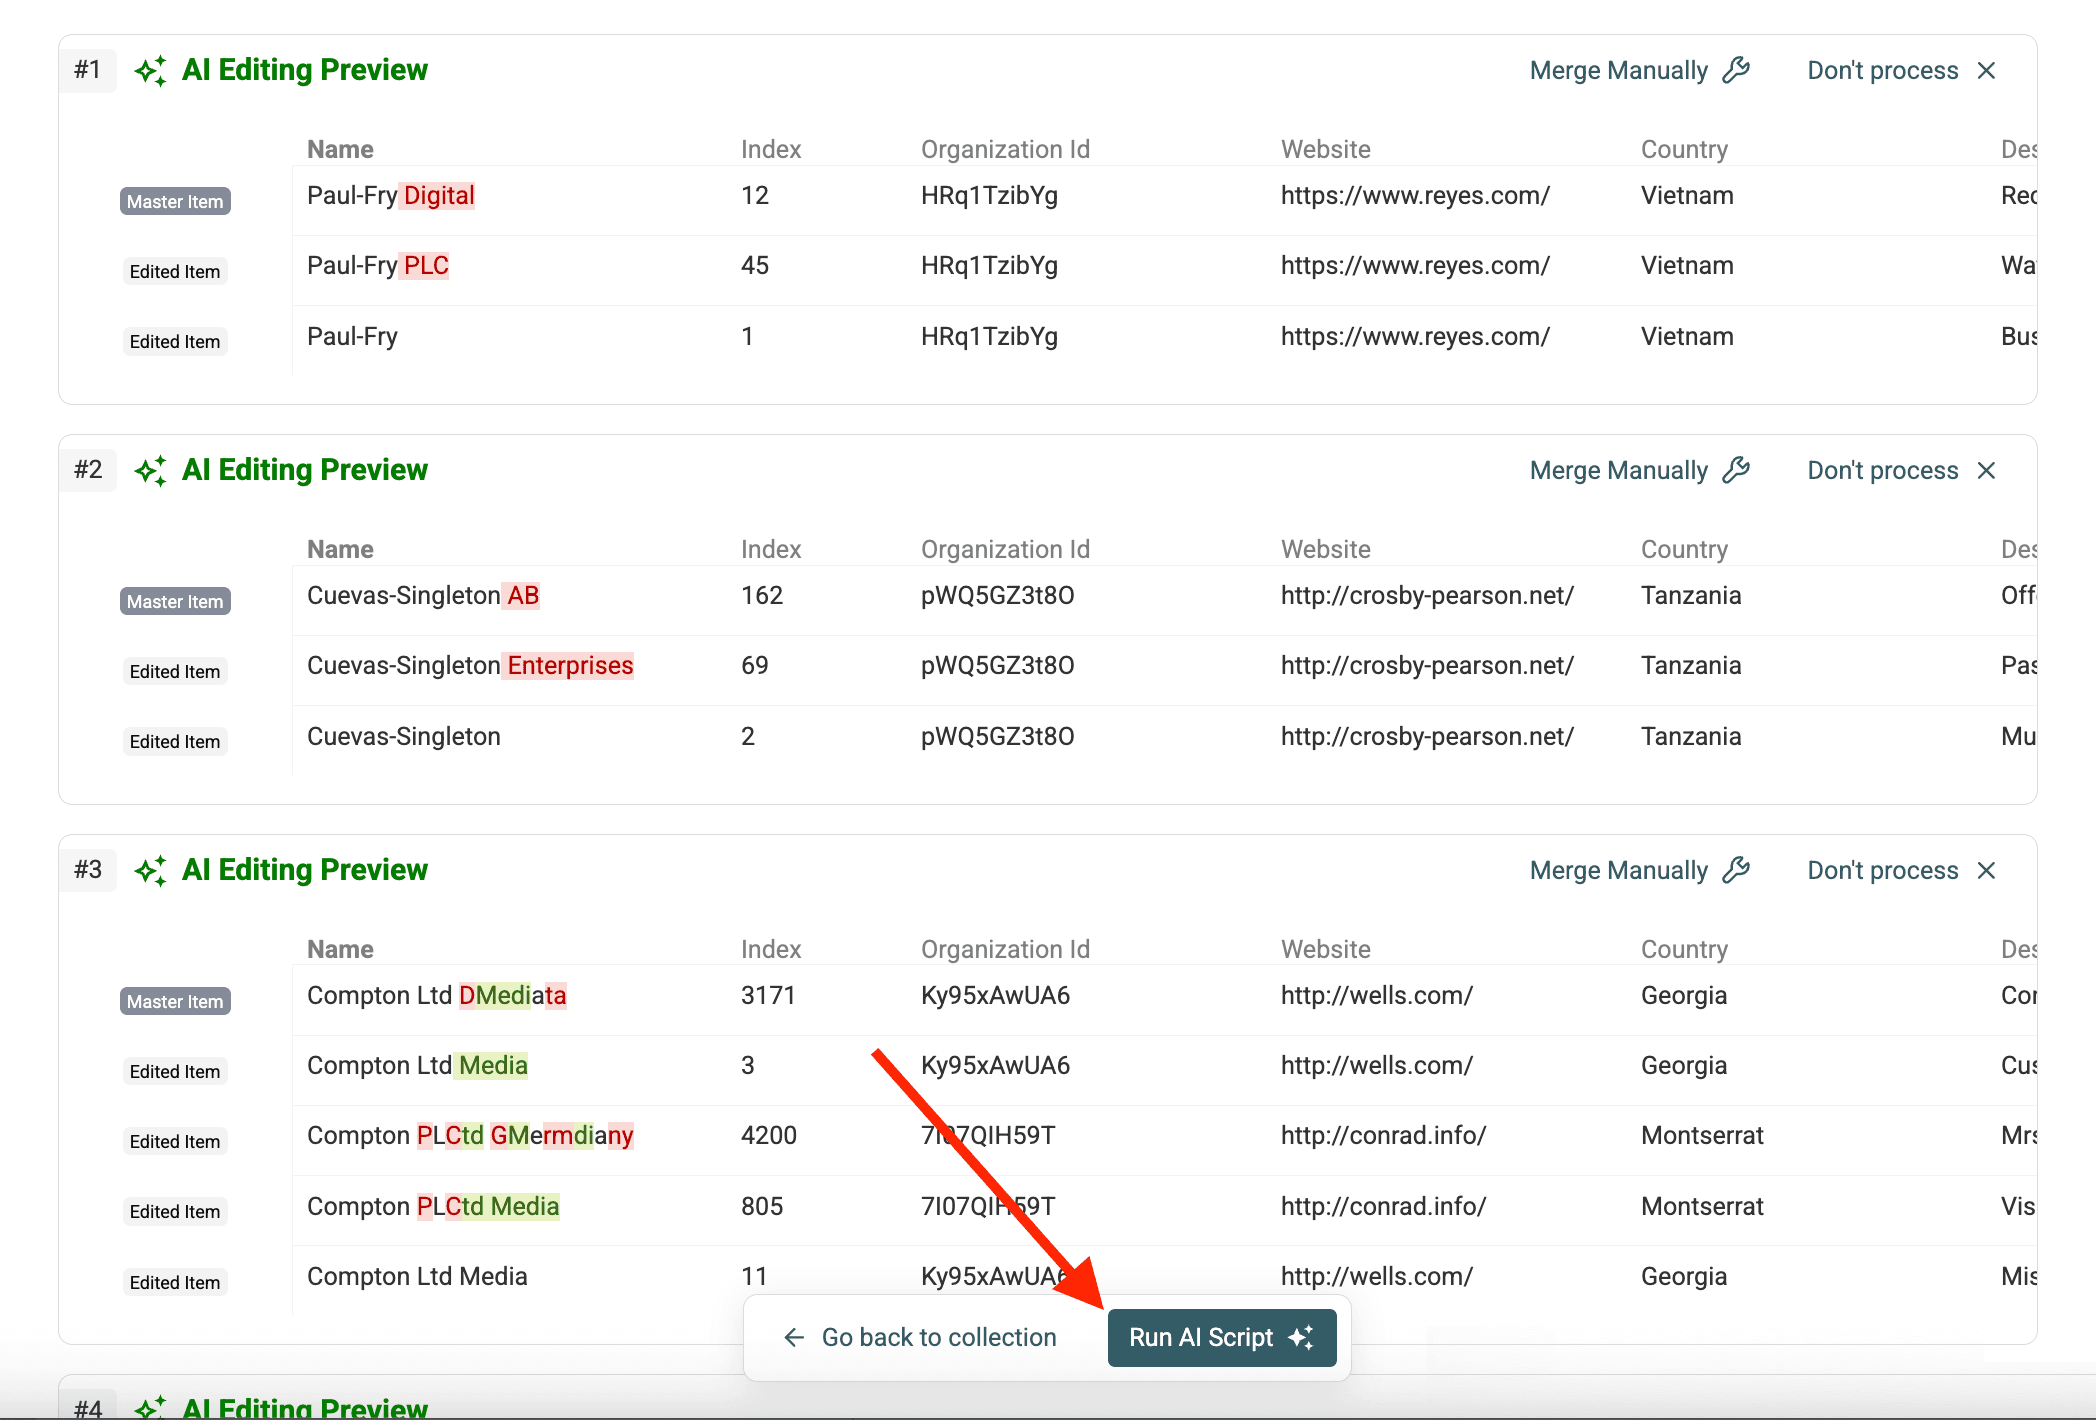
- **Script Explanation:**用简单易懂的语言说明脚本会执行哪些操作。请确认说明符合你的预期。
- **Result Preview:**在应用任何更改之前,通过表格准确展示脚本将如何修改部分重复记录组。检查预览中的目标字段(如
/Company Name),确认示例重复项均会被更新为预期的标准值。
例如,一个包含 Acme Ltd、Acme Ltd 和 Acme Limited 的组应保留三行,并将所有值统一为 Acme Ltd。如果某组只包含一个 Acme Ltd 和一个 Acme Limited,由于没有出现次数更多的值,该组应保持不变。这些只是用于检查预览结果的示例,并非实际测量结果。
**既要检查字段值,也要检查行数。**确认只有在存在明确胜出值时才填充空值;并列的组保持不变;来源 ID 和无关 Property 均得到保留。
第 6 步:运行脚本
如果脚本说明和预览结果均符合预期,请点击 Run AI rules。Datablist 会对所有已识别的重复记录组执行生成的脚本。
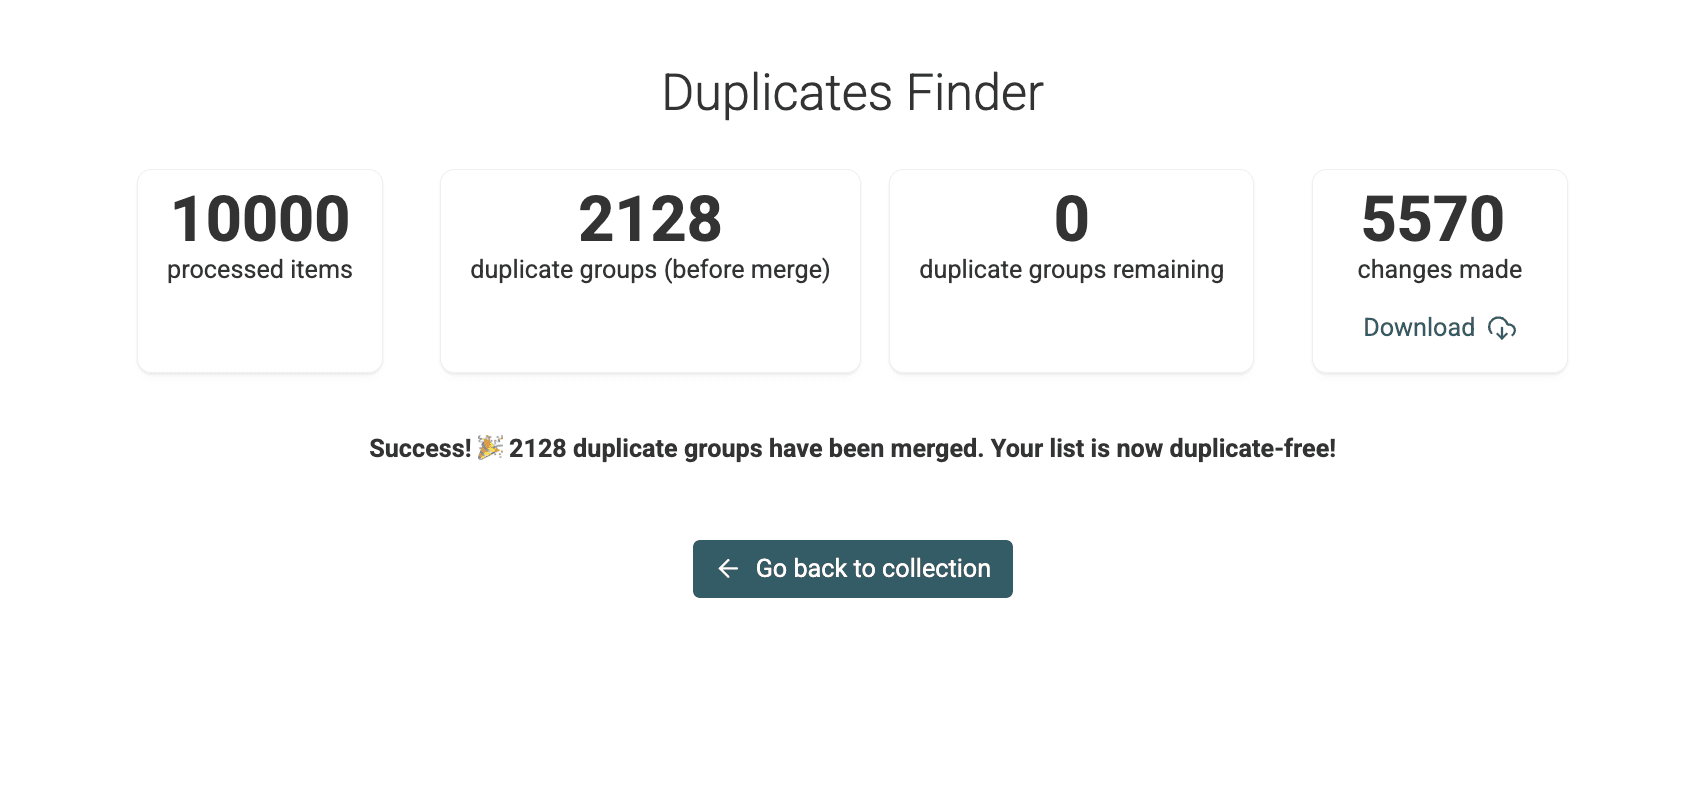
第 7 步:检查更改
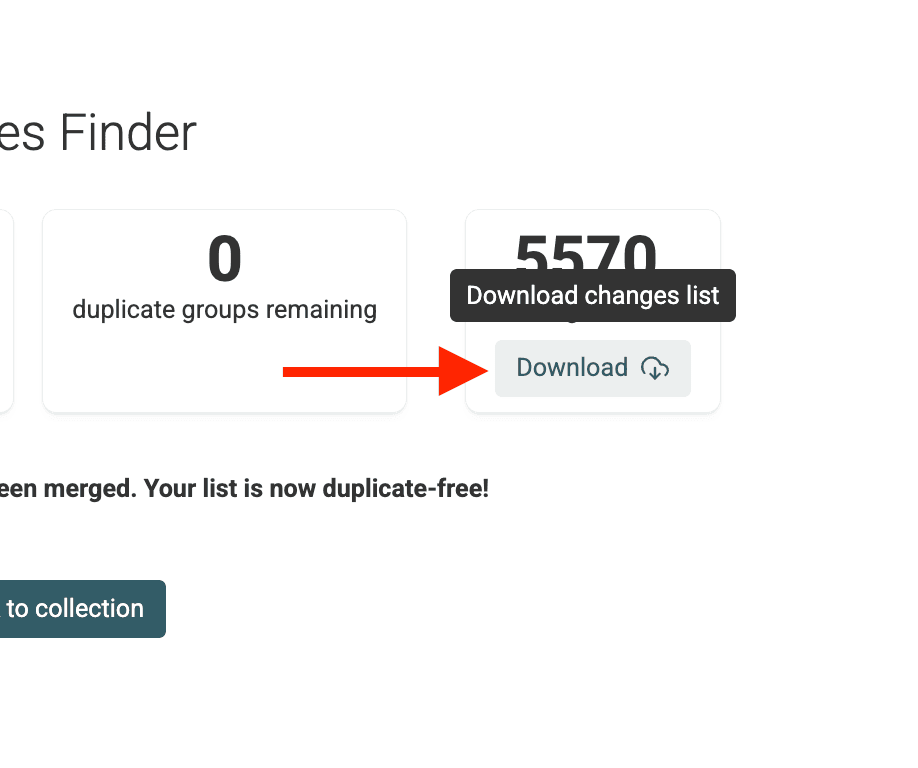
脚本运行完毕后,Datablist 会提供执行摘要以及可下载的 Changes List。
当你需要在外部系统中重放这些更改时,这份列表会很有用,例如编辑 CRM Lead等场景。
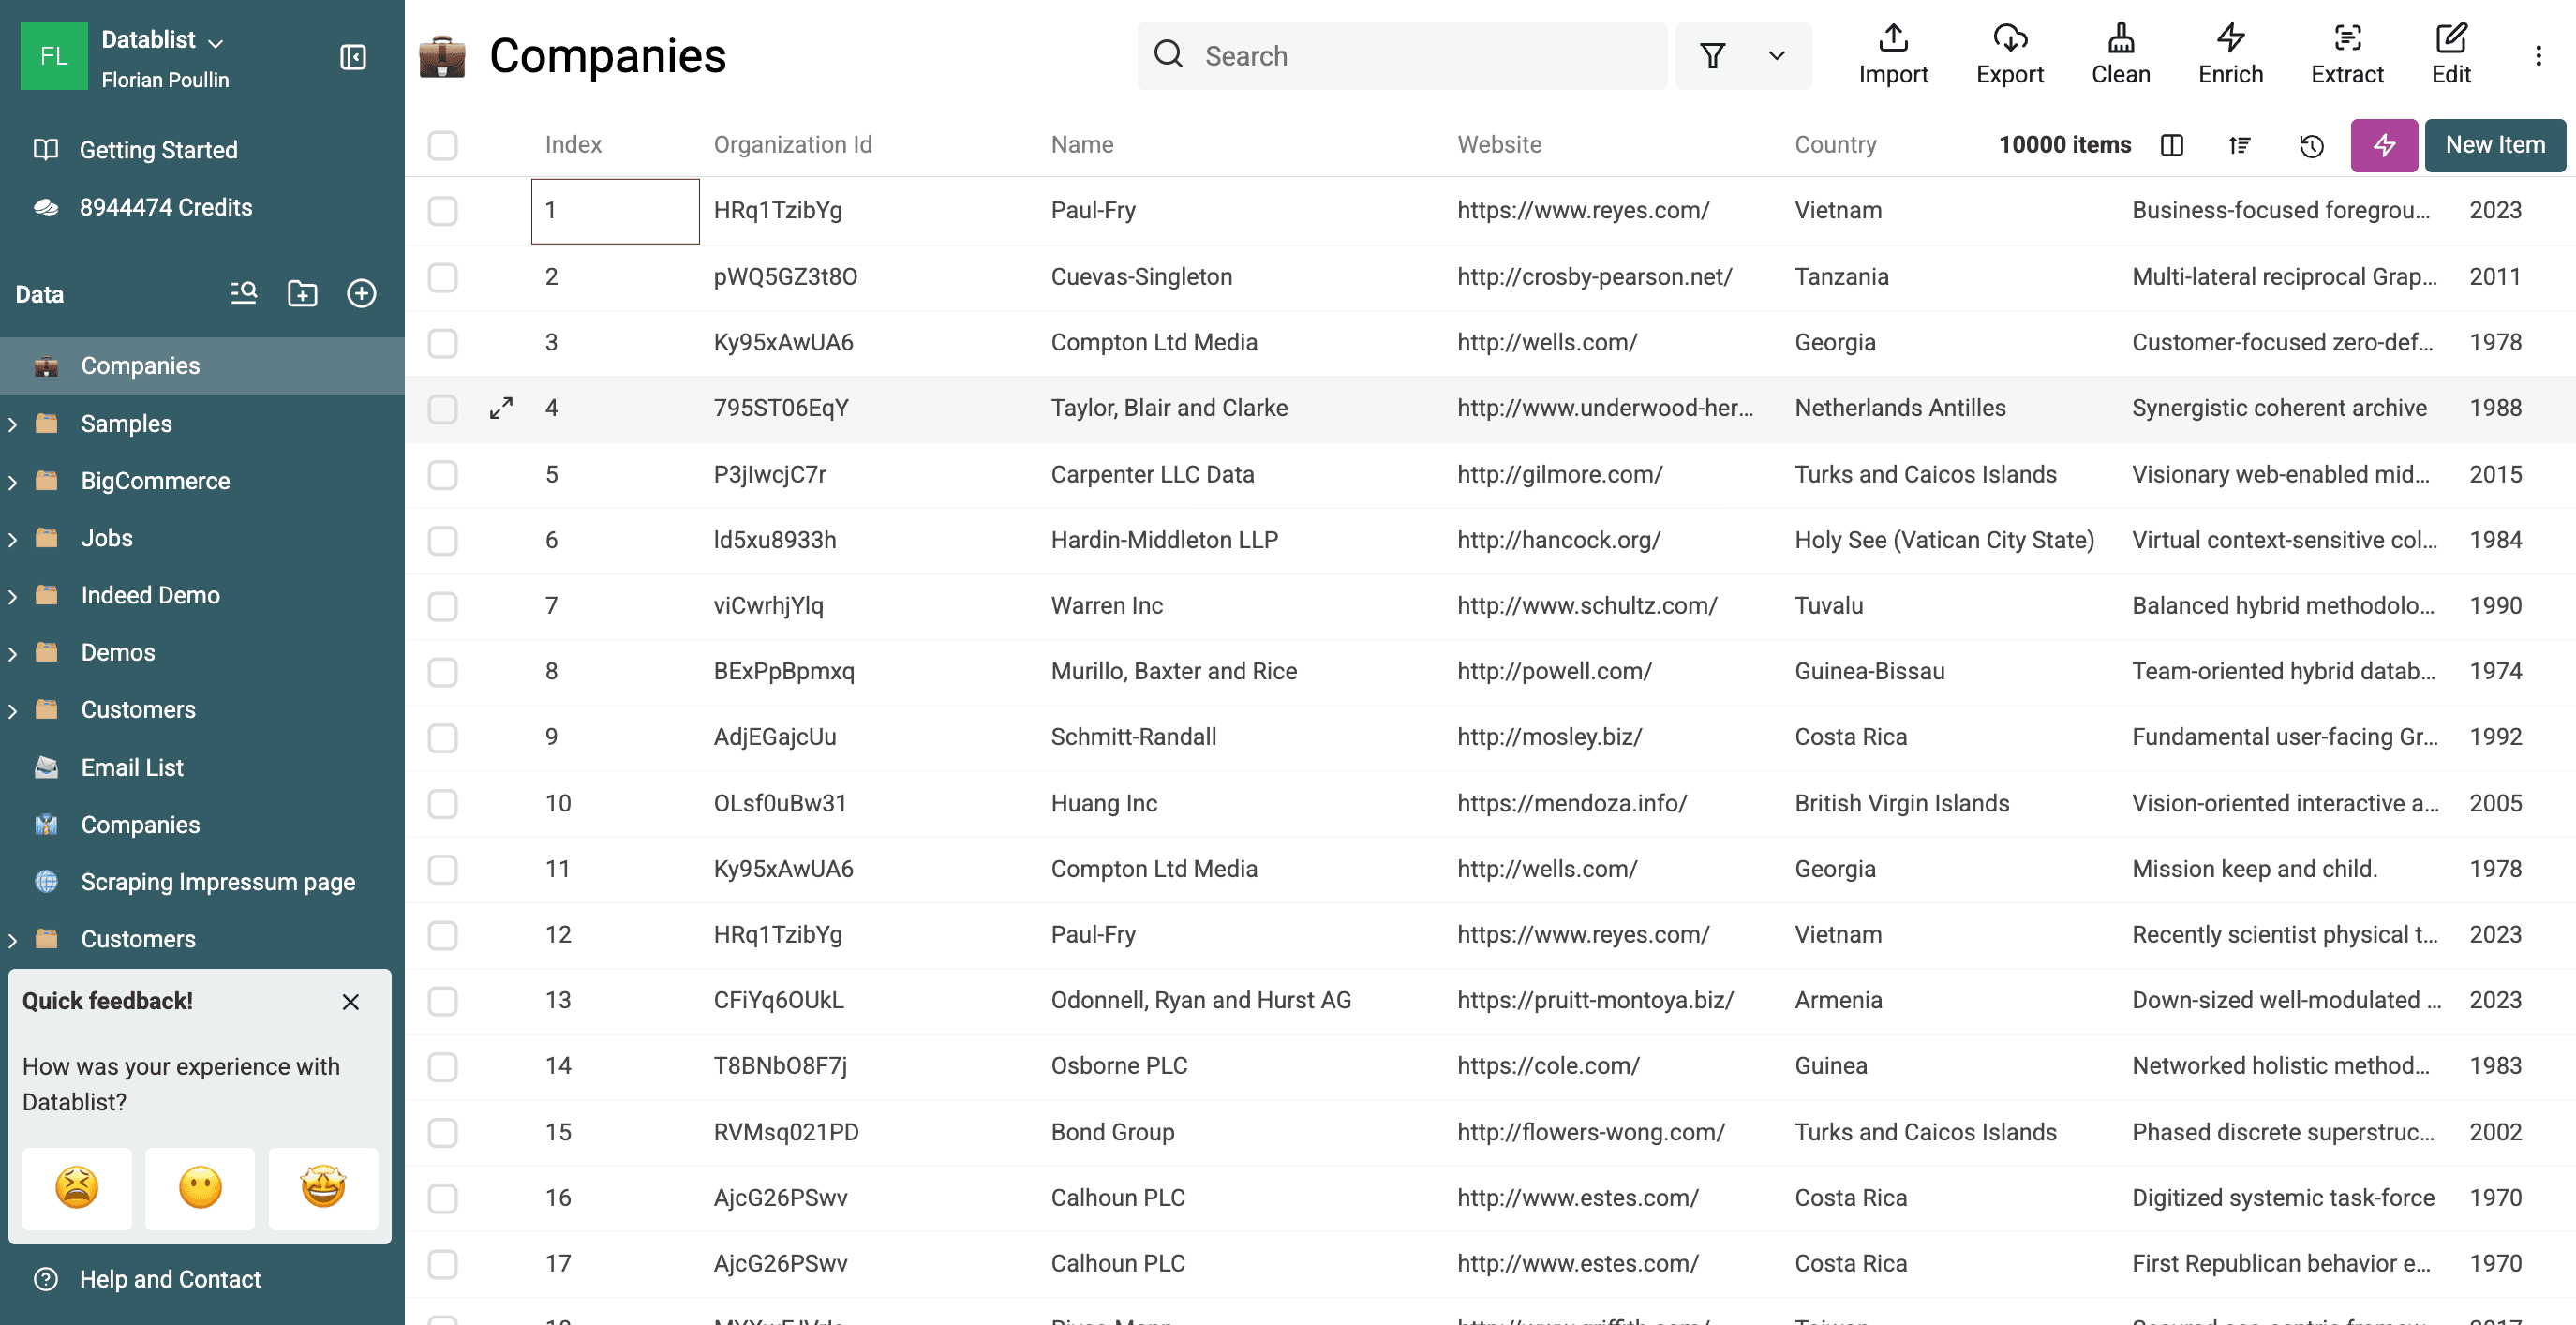
返回主 Collection 视图。此时可以看到,重复记录组中的目标字段(如 /CompanyName)已经统一,而各条记录仍保持独立。
现在,你已经成功在不合并重复项的情况下统一了字段值!🚀
不合并记录的数据标准化场景
哪些情况下适合统一字段,而不是直接完整合并记录?
- **统一公司或联系人名称:**在确定最终合并策略之前,先清理重复项中的名称变体,例如“Example Ltd”“Example Limited”,或者“Jon Doe”“Jonathan Doe”。
- **清理职位名称:**将“VP Marketing”“Vice President Marketing”“Marketing VP”等职位统一,方便生成一致的报表或开展分析。
- **统一地区信息:**让重复地址记录中的国家名称(如“CN”“中国”)或省市简称保持一致。
- **为 CRM 导入或更新做准备:**即使暂时保留重复项,也可以先统一关键字段,再将数据导入具有严格校验规则的 CRM。
- **数据审计:**保留原始重复记录以便审计或追踪历史,同时统一关键标识符,让分析更简单。
- **渐进式清洗:**在决定完整合并或删除之前,将逐个字段的标准化纳入更全面的数据清洗流程。
为什么选择标准化而不是合并?
- **保留记录粒度:**完整保留每条重复记录,便于追踪数据来源、特定互动或各记录关联的历史信息。
- **应对不确定性:**适用于无法完全确认是否重复的记录。统一关键字段可以提升一致性,同时避免因其他数据点不同而错误合并记录。
- **分阶段处理:**让数据清洗过程更可控。先统一字段,再进行检查,之后决定是否合并或删除。
- **操作简单:**这是一项范围明确的操作。你只需统一一个字段,不会影响重复记录中的其他数据。
总结
先从经过验证的重复记录组开始,定义值的选择规则并仔细检查预览。运行脚本后,确认总行数没有变化,并检查因值并列而被跳过的组。之后,你就能导出名称一致的数据,同时保留每条独立的来源记录。
FAQ
-
我的 Datablist 套餐是否包含 AI Processing? AI Processing 包括生成和运行标准化脚本,目前在 Datablist 的付费套餐中提供。详情请查看我们的价格页面。
-
可以通过一个 Prompt 同时统一多个字段吗? 可以。你可以编写一个 Prompt,同时统一多个字段。例如:“使用每组中最常见的值统一 /Company Name Property;使用每组中最常见的值统一 /Country Property;不要删除任何记录。”
-
如果 AI 误解了我的 Prompt,应该怎么办? 运行脚本之前,务必仔细检查脚本说明和预览结果。如果预览不正确,请进一步明确 Prompt,补充更具体的规则,然后重新生成脚本。
-
可以撤销 AI 脚本所做的更改吗? 脚本运行后,更改会直接应用。Datablist 提供 Undo 功能,可撤销当前 Session 内的近期操作。不过,在执行这类重要的数据转换之前,最佳做法仍是先克隆 Collection,以便在需要时恢复数据。
-
这与标准的“Combine conflicting properties”合并选项有何不同? 标准的“Combine”选项会将重复记录合并成一条主记录,并把存在冲突的文本值拼接到同一个字段中。使用正确 Prompt 的 AI Processing 则会把所有重复记录中的字段更新为同一个选定值,同时让每条记录保持独立。除非 Prompt 明确要求,否则它既不会合并记录,也不会拼接字段值。