
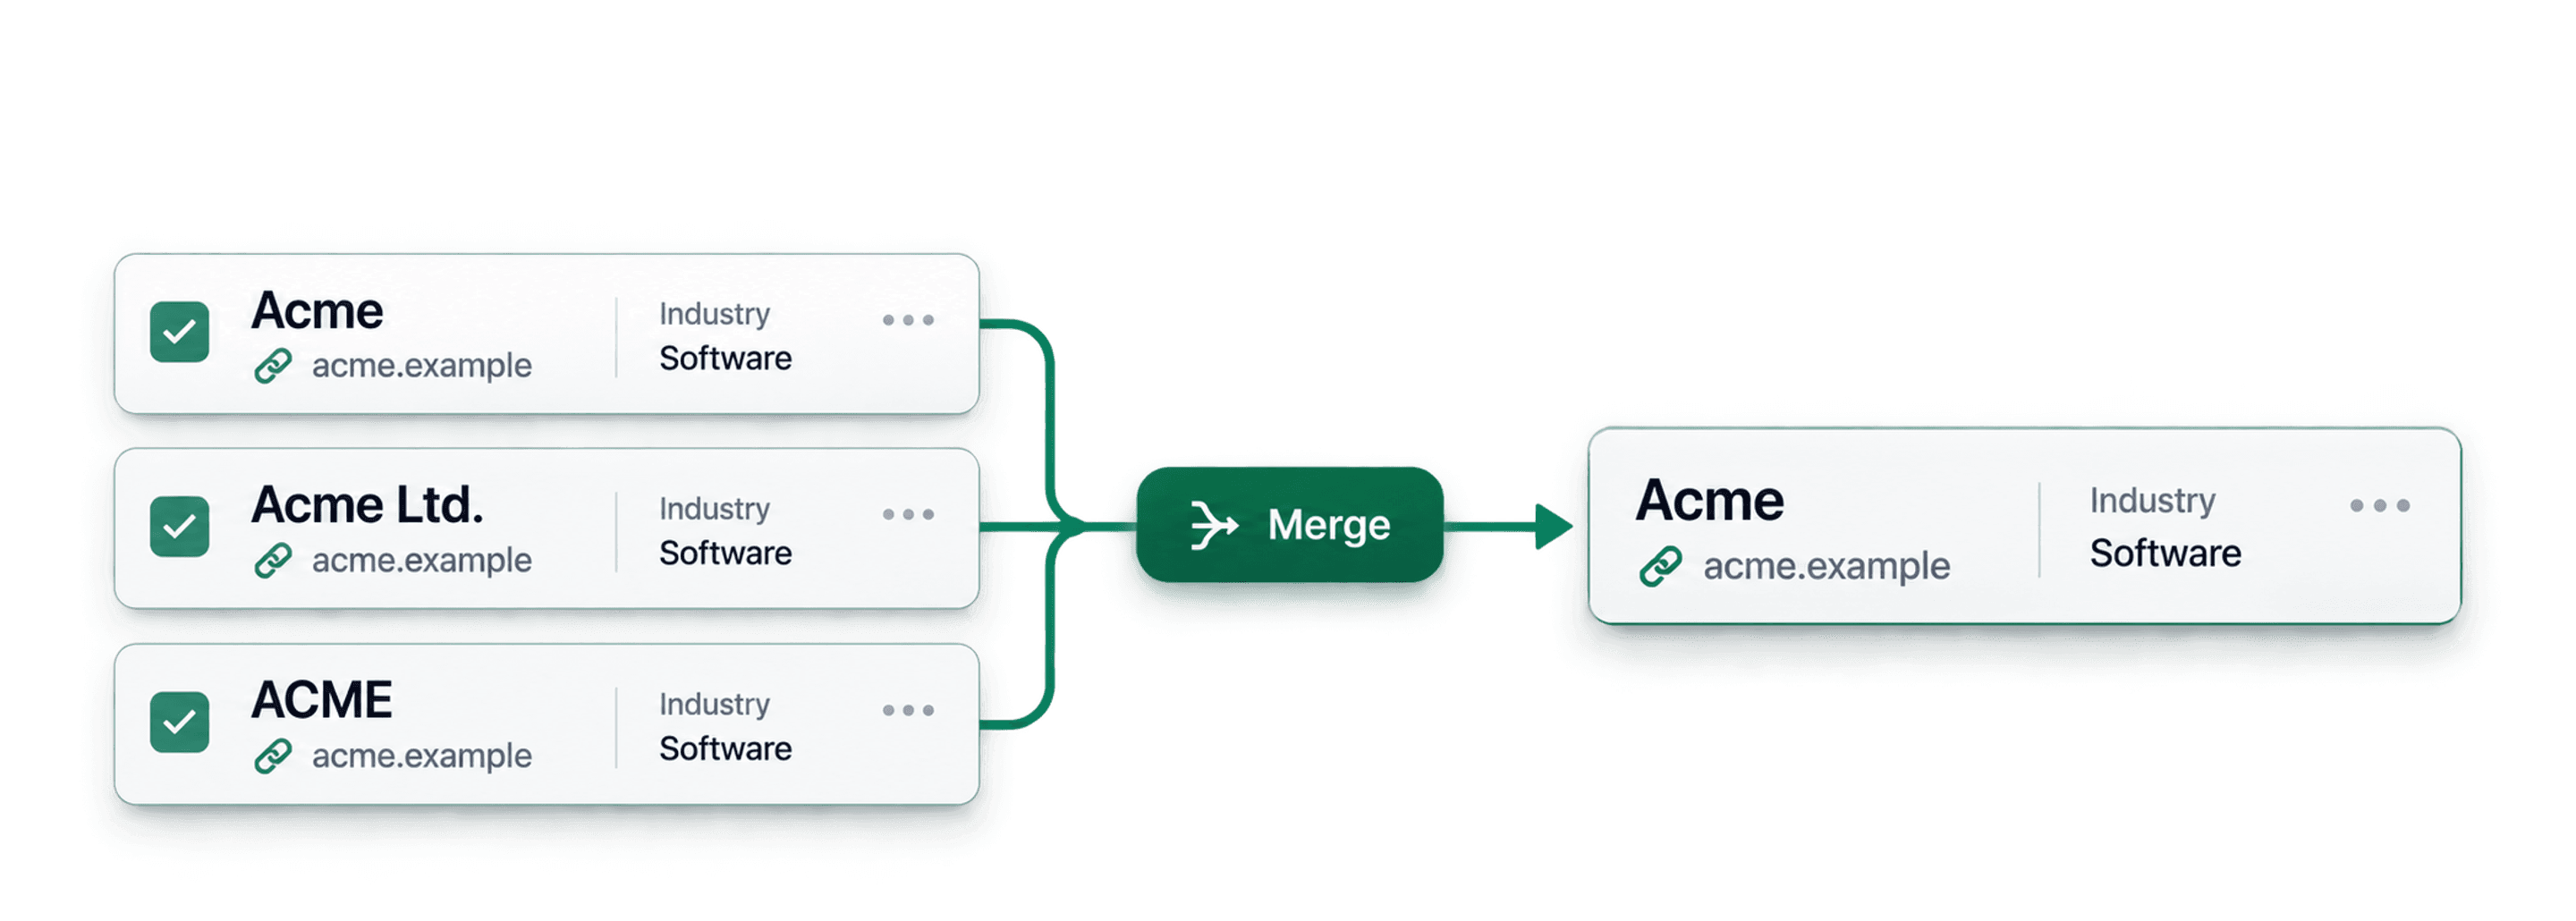
Um doppelte Firmennamen zu finden, vergleichst Du zuerst eine stabile Domain. Bei Datensätzen ohne zuverlässige Website nutzt Du anschließend den Abgleich normalisierter Firmennamen. Prüfe die vorgeschlagenen Gruppen vor dem Zusammenführen, da zwei Unternehmen denselben kurzen oder allgemeinen Namen haben können.
Dieser Guide zeigt Dir, wie Du:
- Deine Liste mit Firmennamen importierst
- Übereinstimmende Websites und Firmennamen findest
- Doppelte Firmendatensätze zusammenführst
Best Practices zur Dublettenbereinigung von Firmenlisten
Nutze den zuverlässigsten verfügbaren Identifikator. Eine normalisierte Website oder Domain eignet sich für den ersten Durchlauf besser als ein Name, da verschiedene Unternehmen Namen wie Acme Services tragen können. Speichere den ursprünglichen Firmennamen, die Website und die CRM-Datensatz-ID in separaten Eigenschaften. So kannst Du jeden Treffer prüfen und den bereinigten Datensatz seiner Quelle zuordnen.
Führe den Namensabgleich in einem zweiten Durchlauf aus. Der Company Name Processor entfernt vor dem Vergleich gängige Begriffe für Rechtsformen, Regionen und Geschäftstätigkeiten. Dadurch lassen sich Cedar Group LLC und Cedar zusammenbringen – allerdings können so auch zwei unabhängige Unternehmen ähnlich wirken. Vergleiche bei Datensätzen ohne Domain ein weiteres Feld wie Land, Stadt oder Adresse, bevor Du sie zusammenführst. Eine 100%ige Namensübereinstimmung ist kein Beweis dafür, dass es sich um dasselbe Unternehmen handelt.
Wenn eine Gruppe unterschiedliche Telefonnummern, zuständige Personen oder Notizen enthält, prüfe Why matched und entscheide, welche Werte Du behalten möchtest. Exportiere die Dublettengruppen zuerst, falls Du einen Audit-Trail benötigst. Führe Datensätze erst zusammen, wenn Du nachvollziehbar erklären kannst, warum sie dasselbe Unternehmen betreffen.
Wenn Du für einige Datensätze eine separate Spalte mit bereinigten Namen brauchst, nutze vor dem Import den kostenlosen Company Name Cleaner. Behalte die Originalnamen neben den Ergebnissen. Die Bereinigung erleichtert den Vergleich, entscheidet aber nicht, welche Unternehmen zusammengeführt werden sollten.
Schritt 1: Liste mit Firmennamen importieren
Importiere zunächst Deine Firmenliste in Datablist. Behalte eine Domain- oder Website-Spalte bei, sofern vorhanden. Eine Domain ist in der Regel ein zuverlässigerer Identifikator als nur der Firmenname.
Um den unten gemessenen Workflow nachzuvollziehen, kannst Du das Deduplication-Testset mit 1.000 Zeilen herunterladen. Es enthält 800 gezielt erstellte Entitäten, darunter 50 Paare mit Varianten bei Firmennamen und Websites.
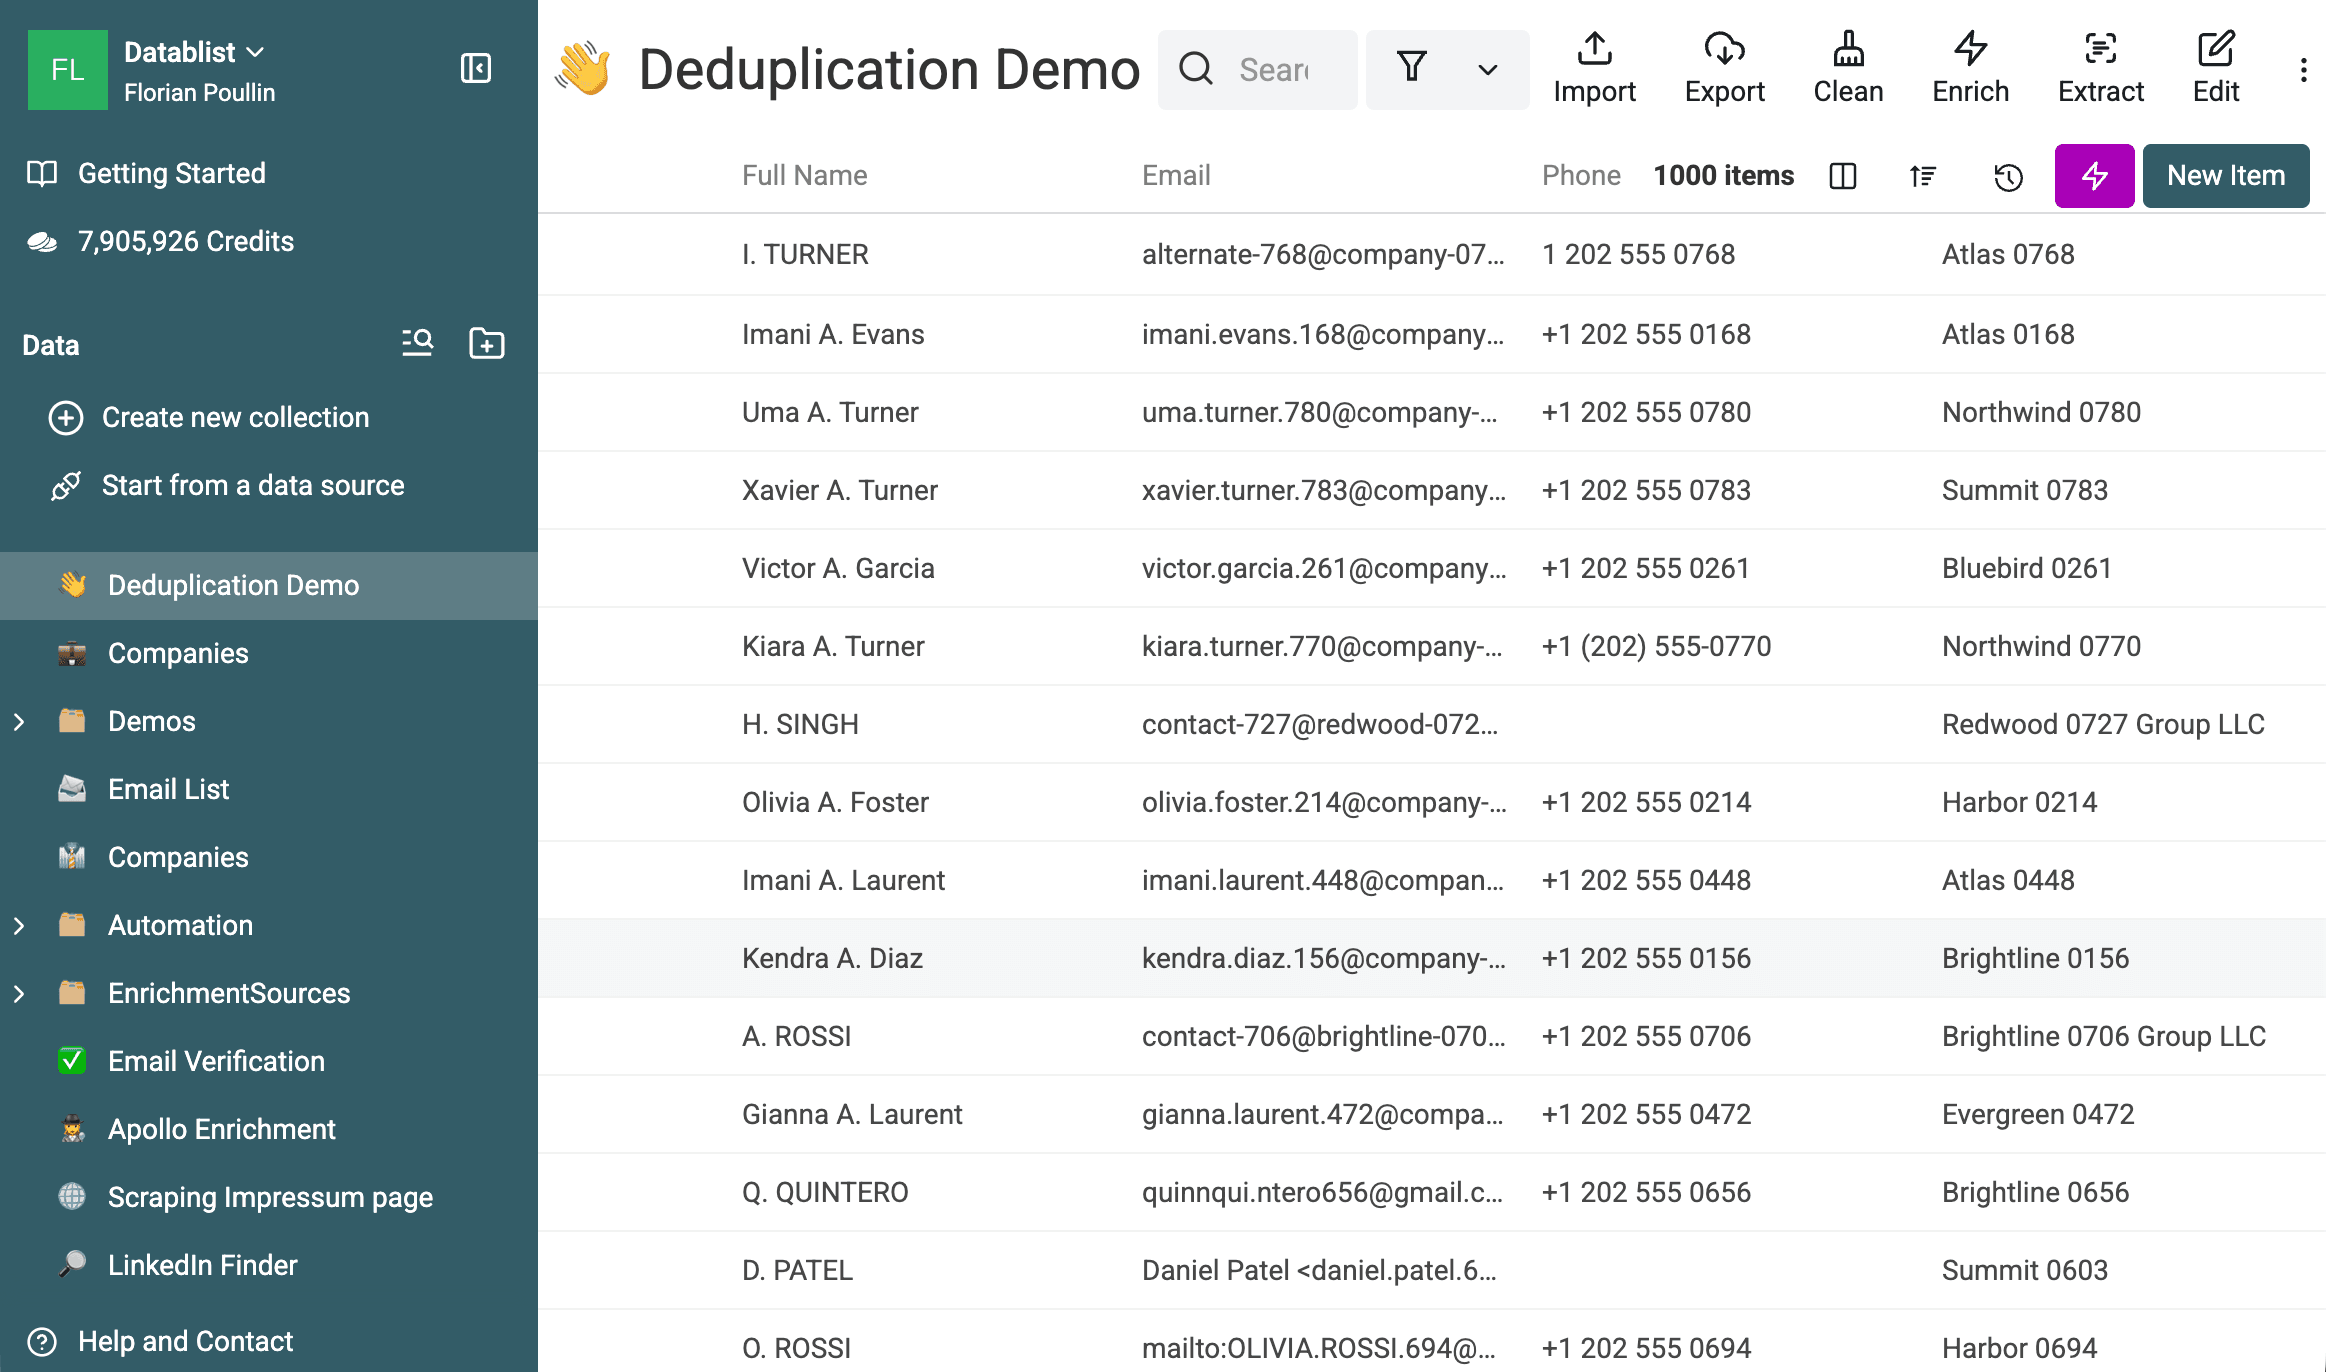
Prüfe die importierten Eigenschaften und lege Website gegebenenfalls als URL fest. Die Eigenschaft Company kann auf Text eingestellt bleiben.
Schritt 2: Dubletten mit Algorithmen erkennen
Öffne Clean > Merge duplicates, um übereinstimmende Firmendatensätze zu erkennen.
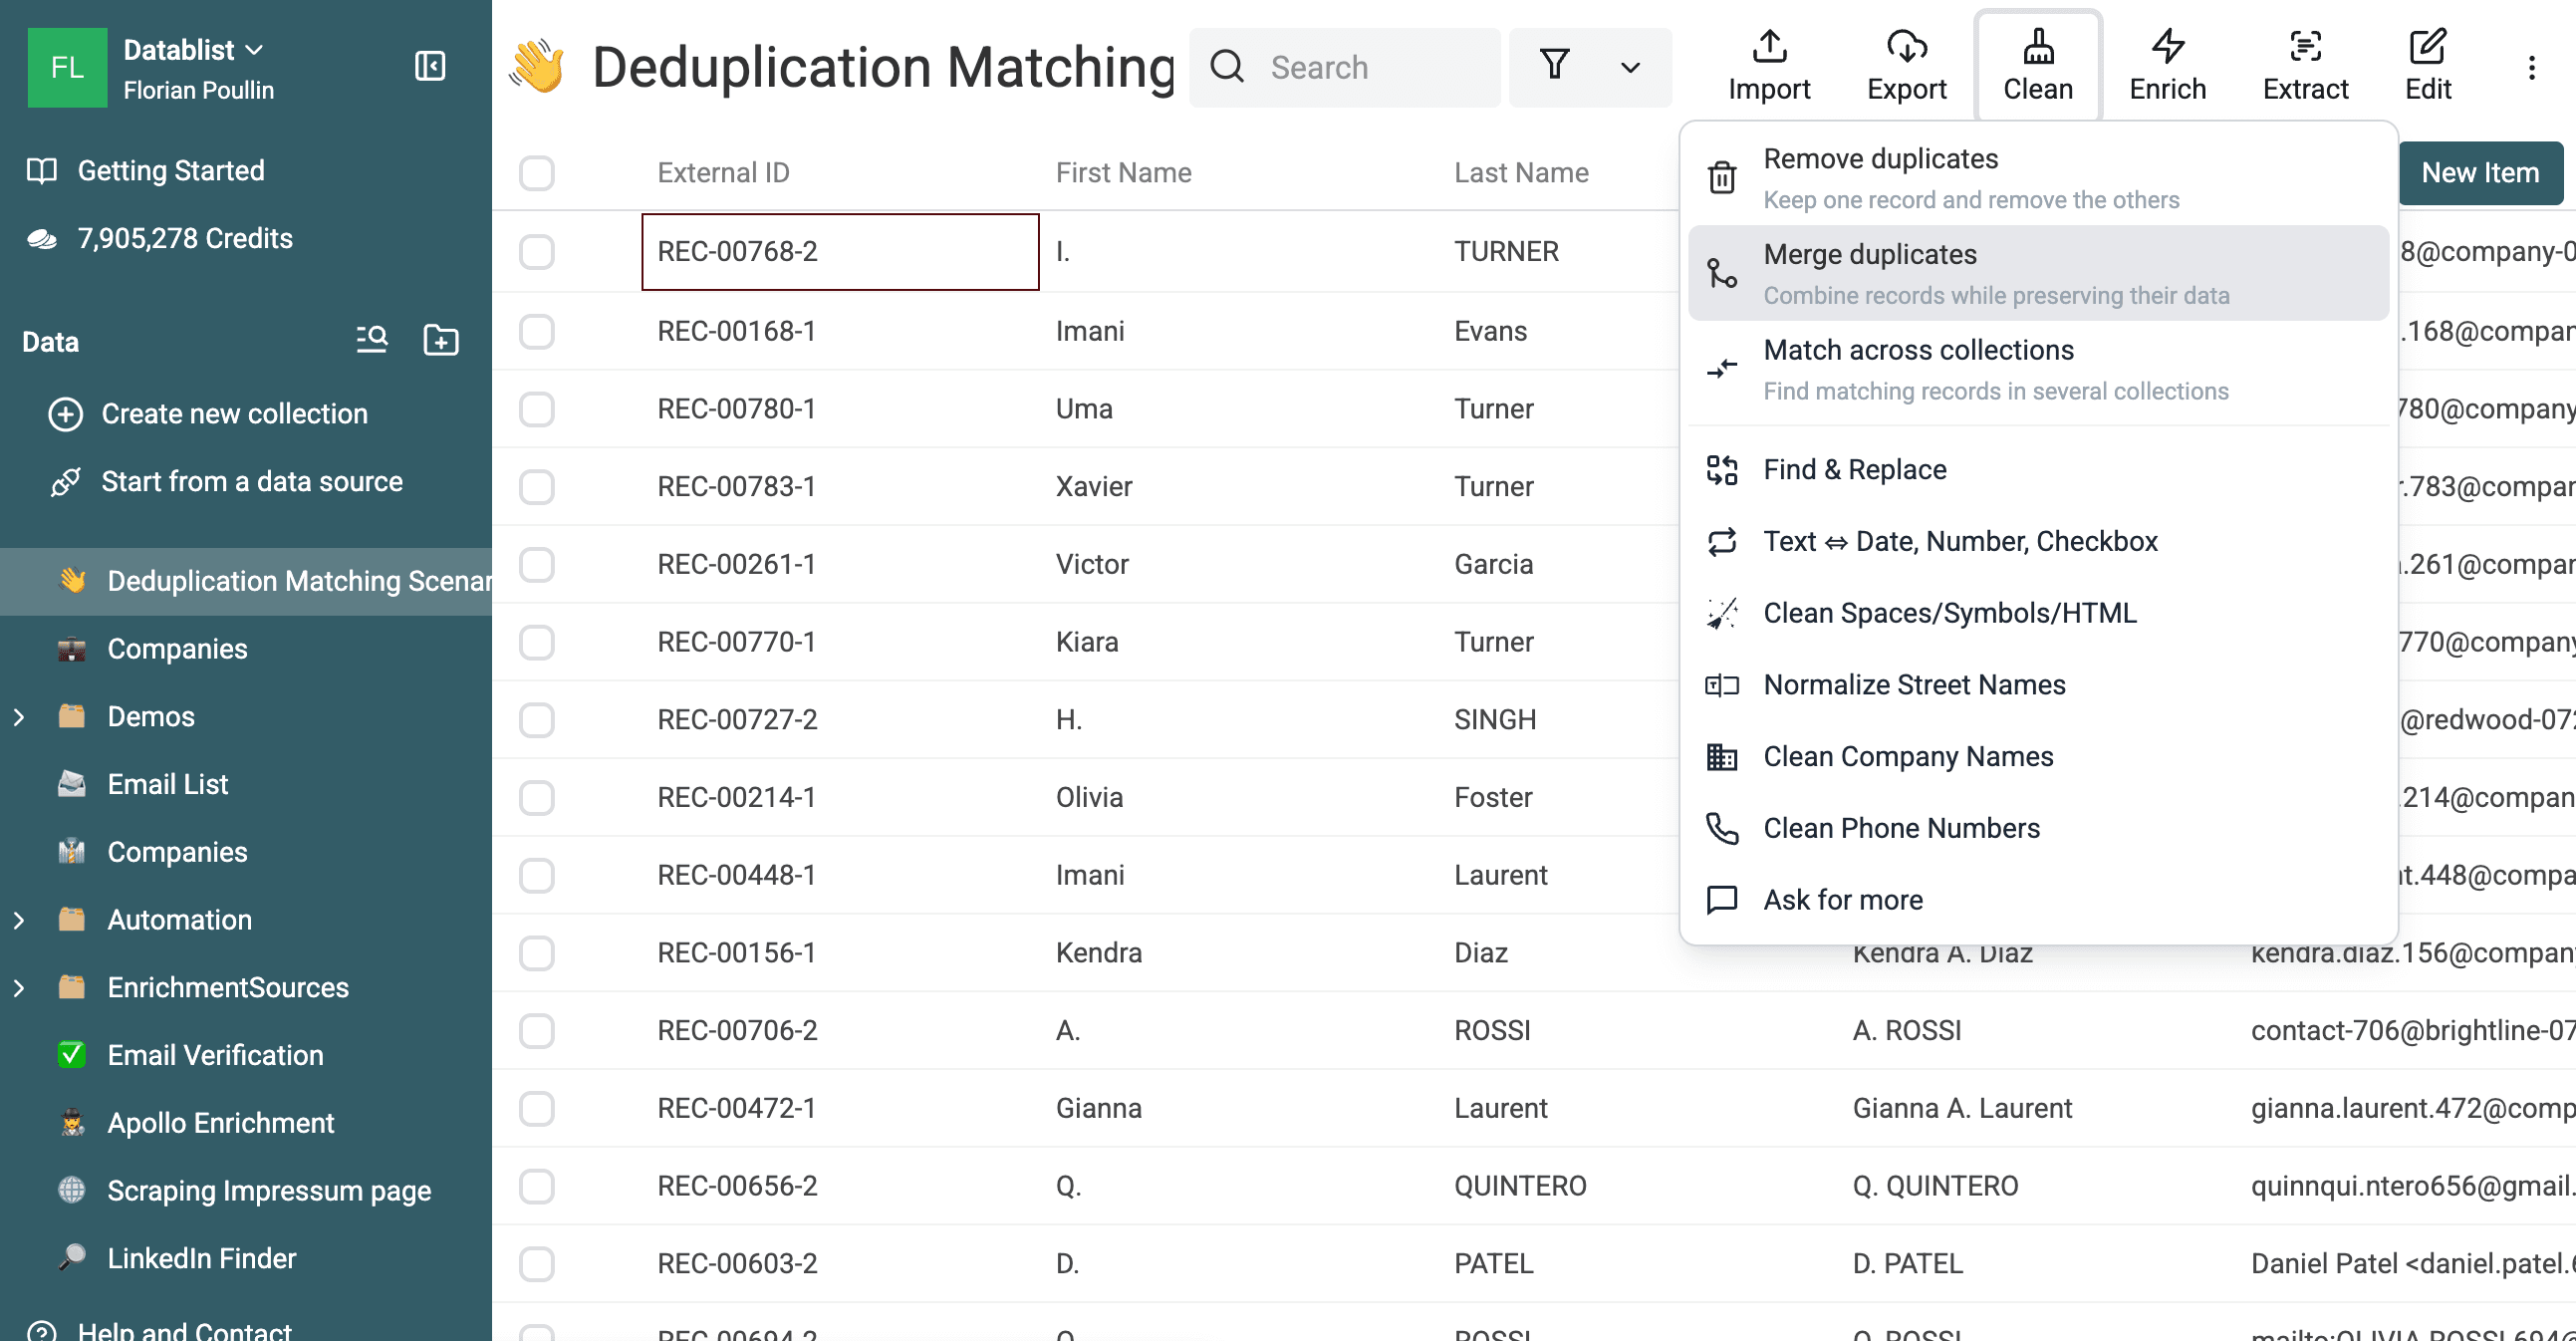
Wenn Deine Liste Websites enthält, gleiche diese zuerst ab. Führe danach einen separaten Durchlauf für Firmennamen bei Zeilen ohne zuverlässige Website oder Domain aus.
Firmenwebsites abgleichen
Deaktiviere All Properties und wähle nur Website aus.
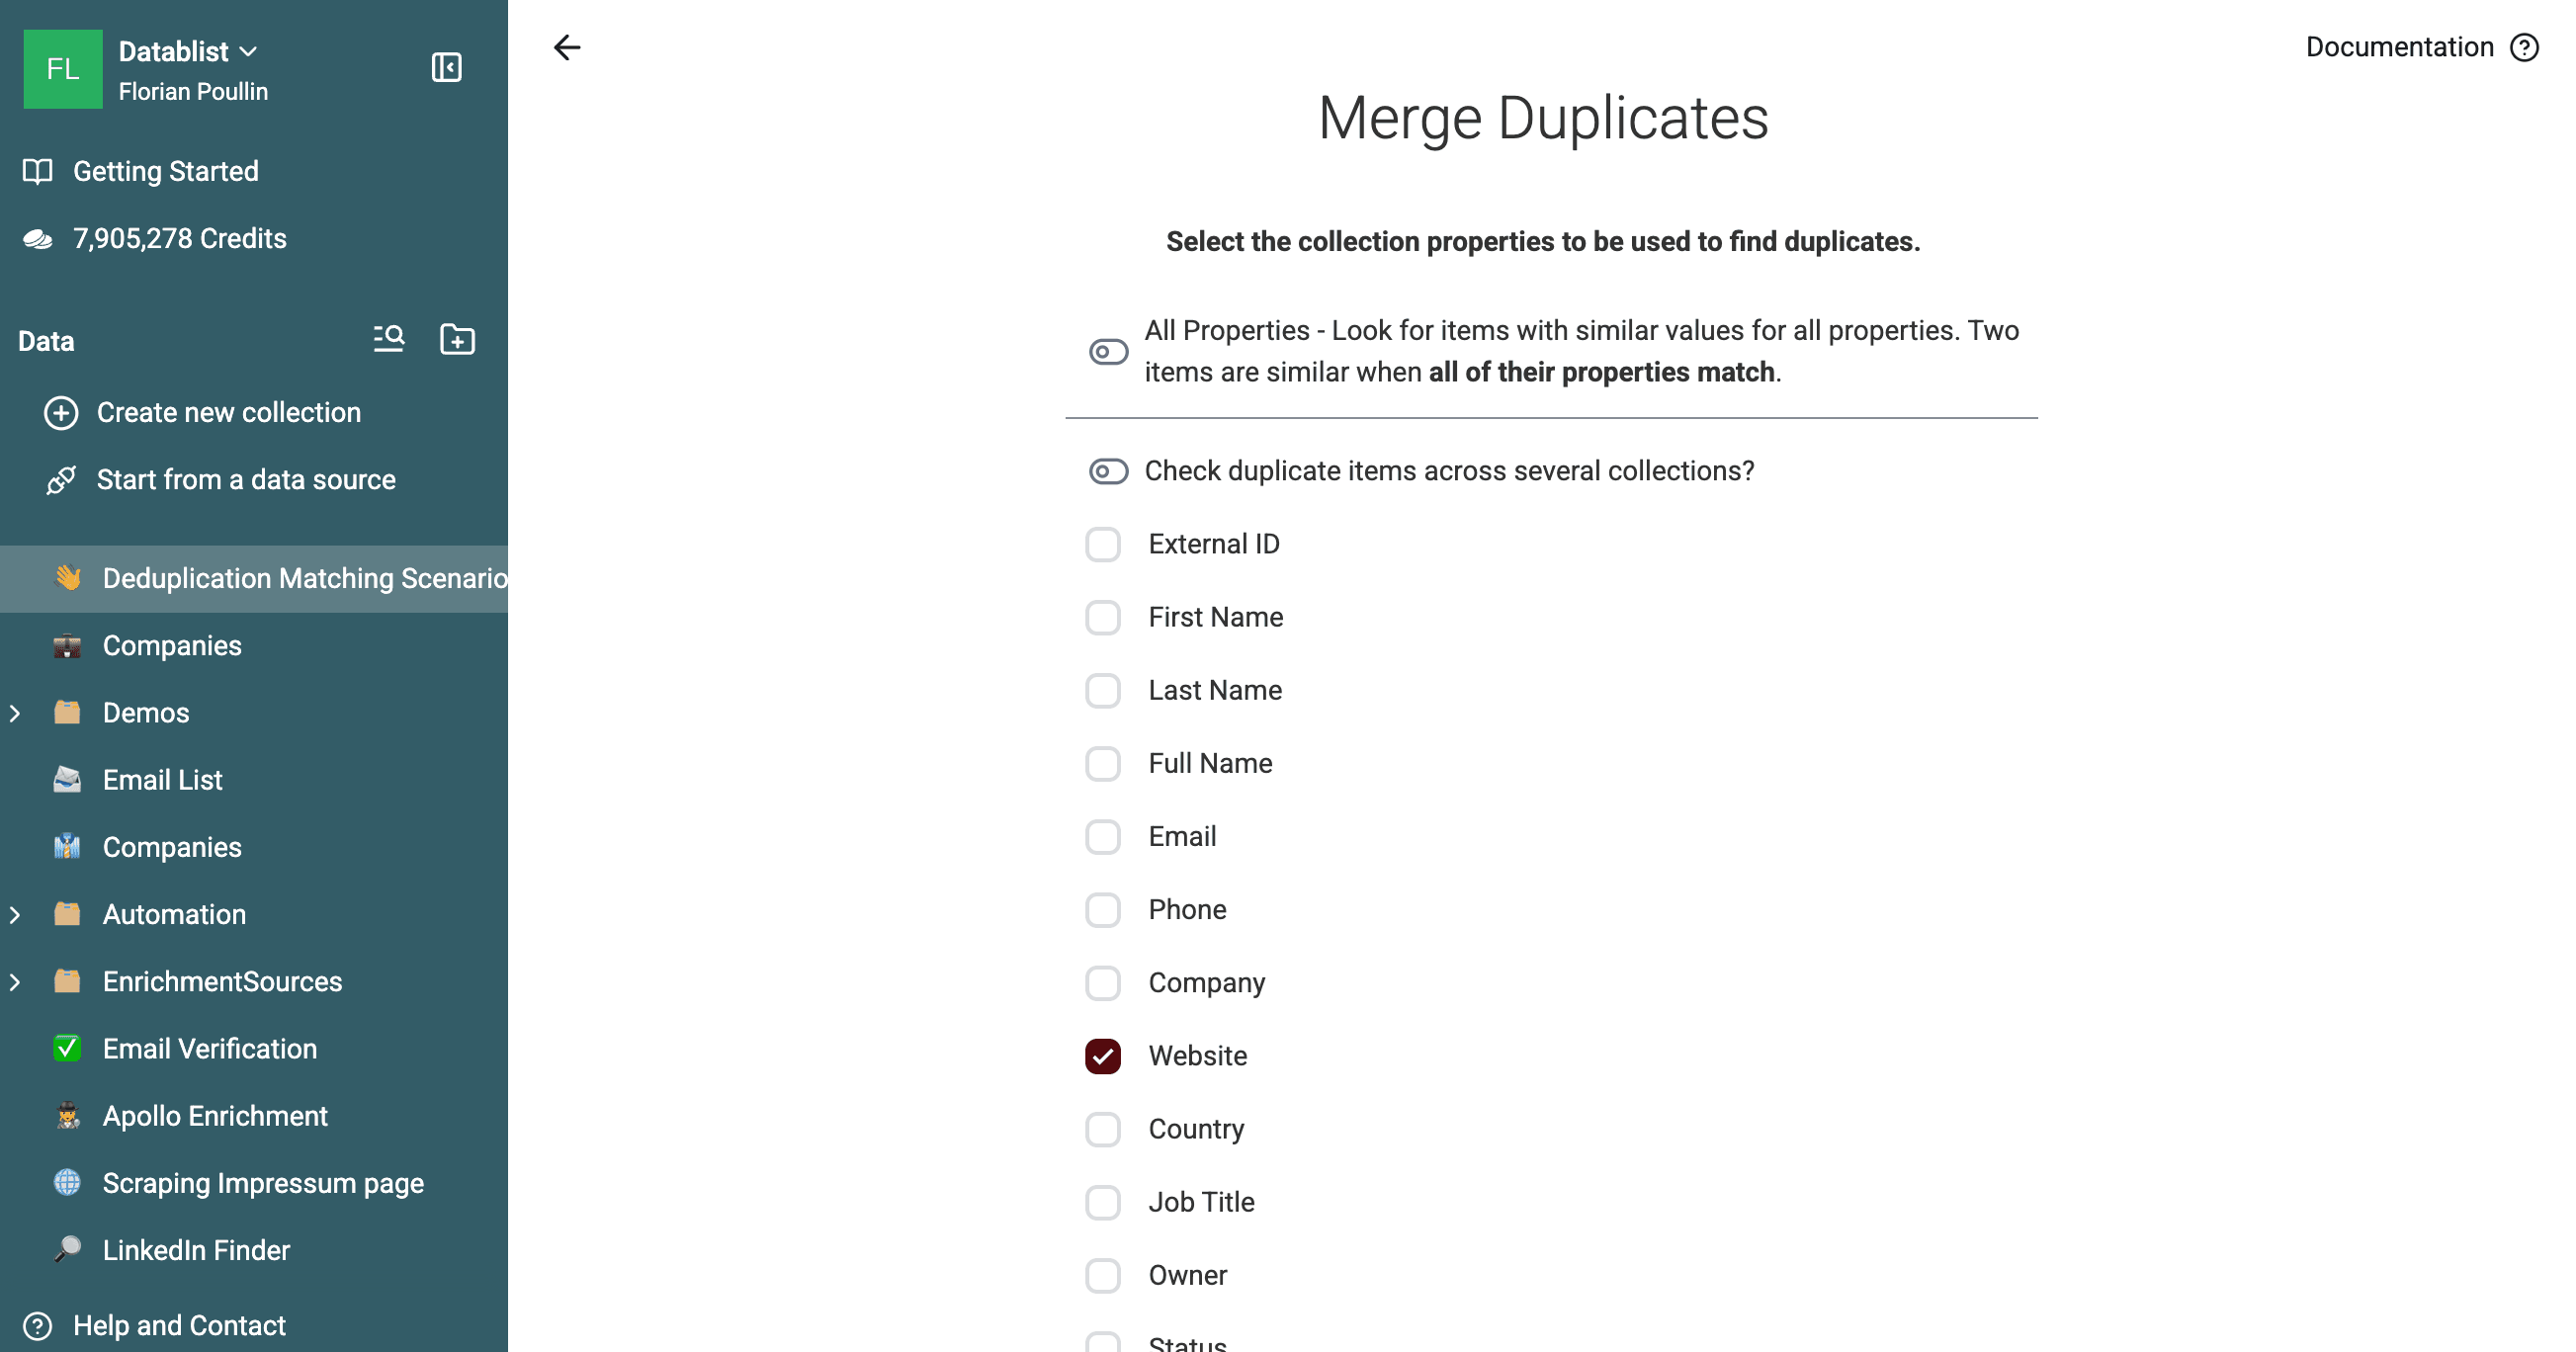
Wähle Smart mit dem URL Processor. Der Processor ignoriert Unterschiede beim Protokoll und abschließende Schrägstriche. Aktiviere die folgenden optionalen Einstellungen, wenn sie zu Deinen Daten passen:
- Ignore Subdomain behandelt Subdomains wie dieselbe registrierte Domain.
- Ignore Path vergleicht die Domain ohne Seitenpfade.
- Ignore Query Params entfernt Tracking- und andere Abfrageparameter vor dem Vergleich.
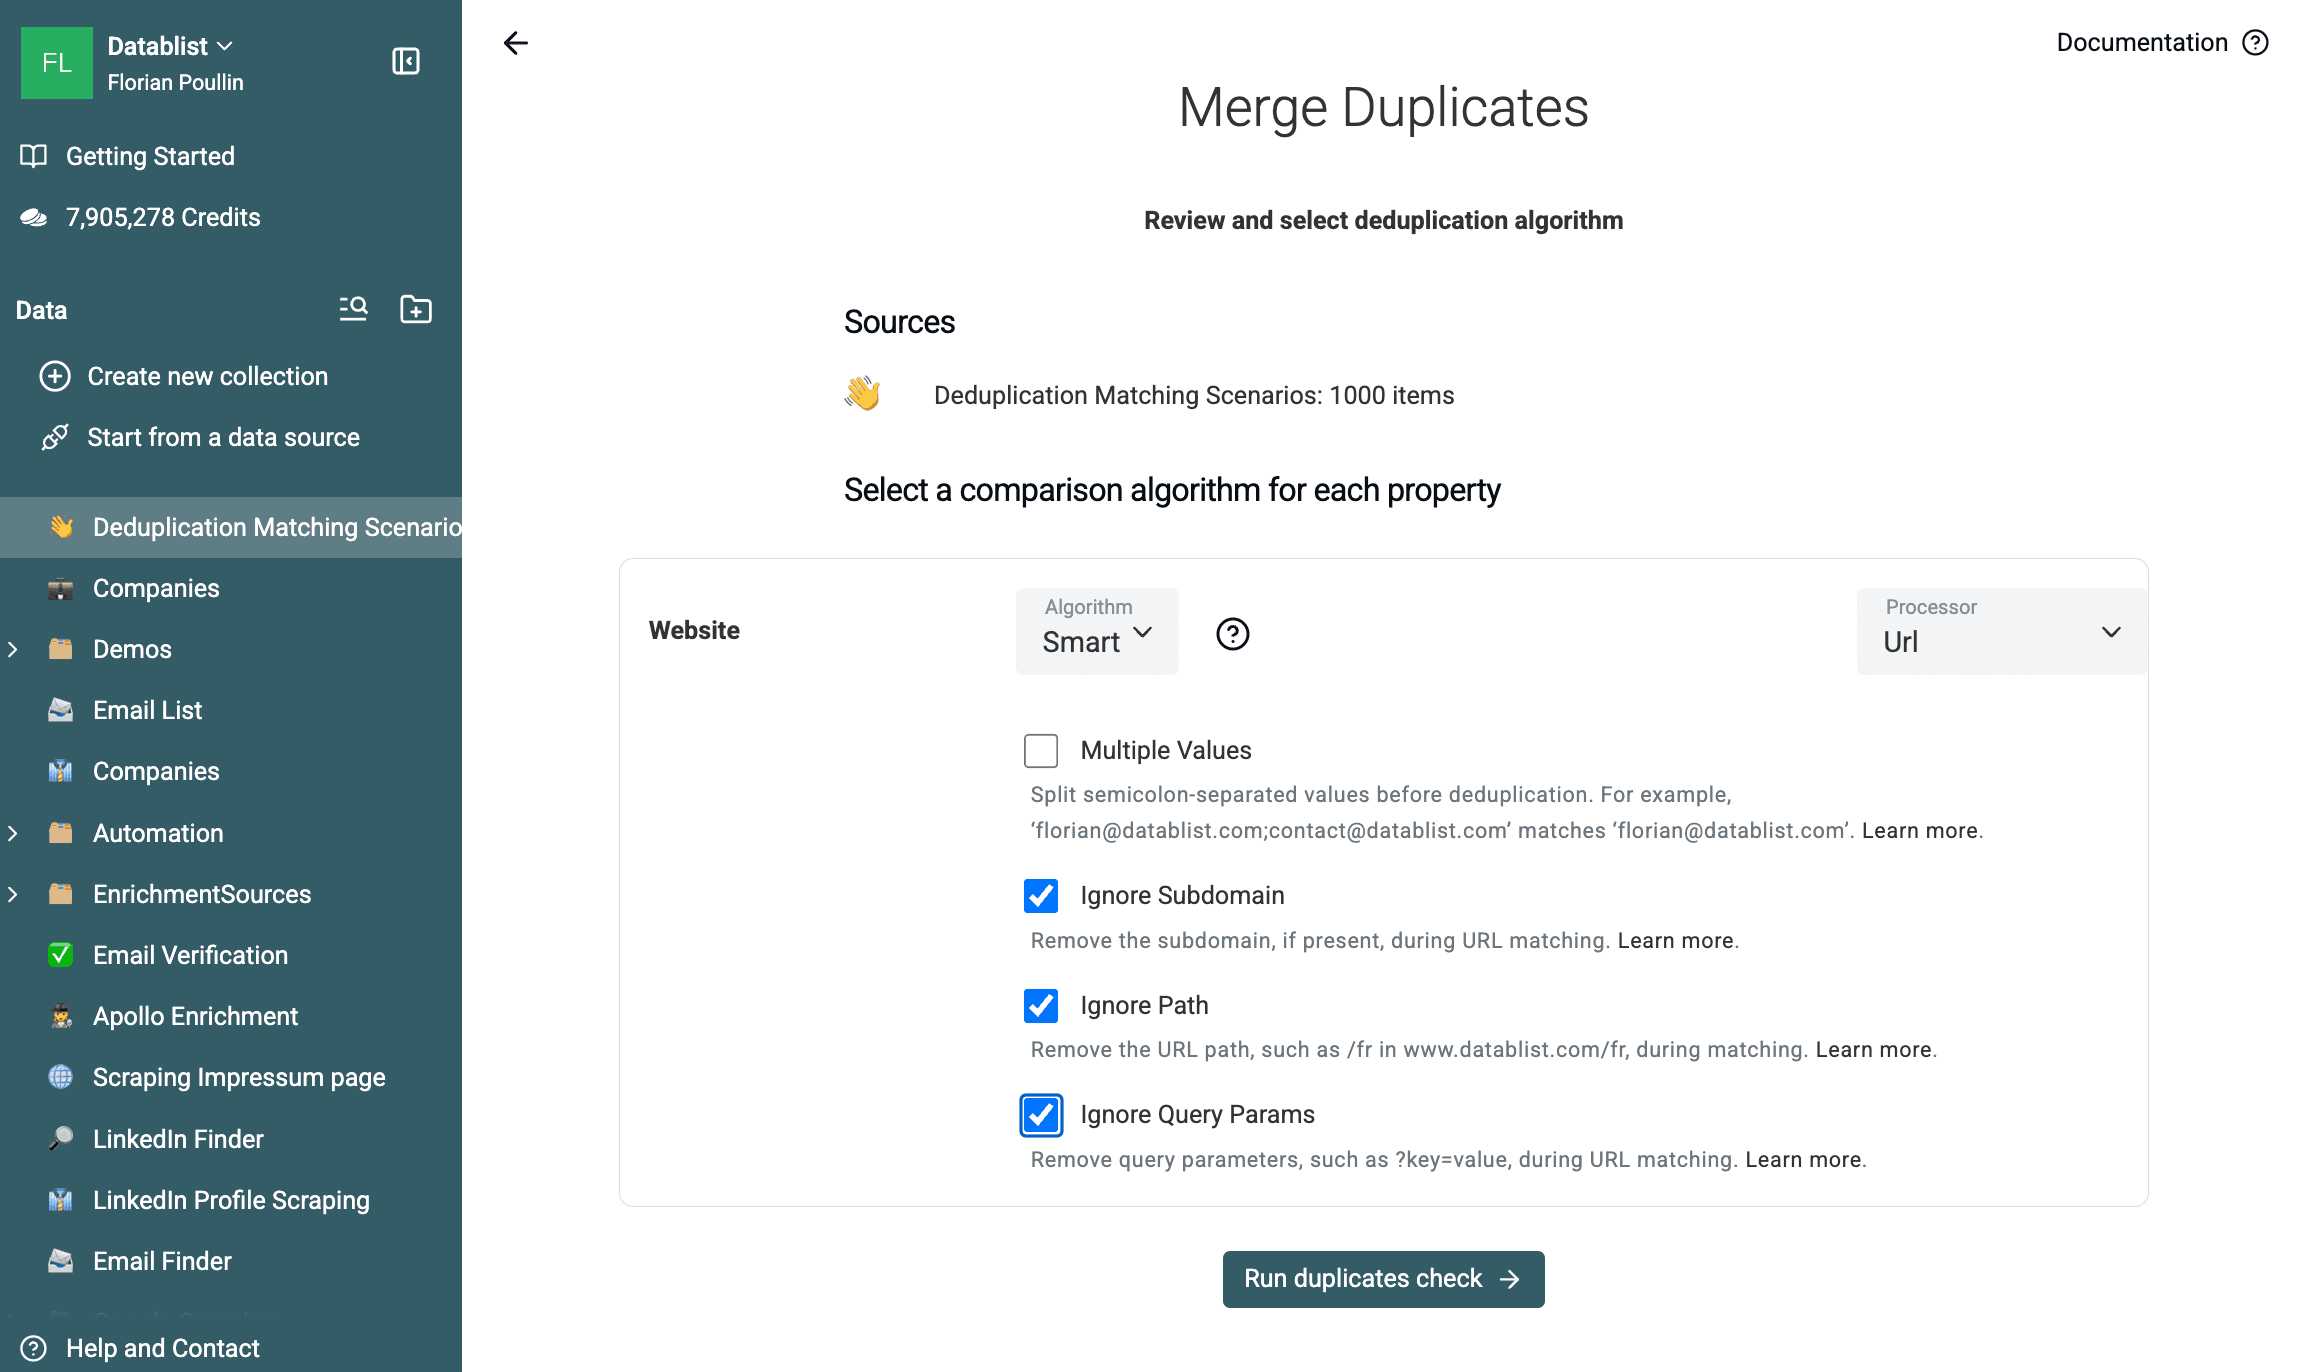
Nutze diese Optionen mit Bedacht. Zwei Subdomains oder Pfade können für unterschiedliche Accounts, Niederlassungen, Produkte oder Standorte stehen. Behalte sie bei, wenn diese Unterschiede wichtig sind.
Der Website-Durchlauf ergab im Testset mit 1.000 Zeilen 200 Gruppen mit jeweils zwei Datensätzen. 50 Paare enthalten gezielt erstellte URL-Varianten, während 150 Paare bereits denselben Website-Wert haben. Bei der Validierung der exportierten Gruppen wurde keine Übereinstimmung zwischen unterschiedlichen Entitäten gefunden.
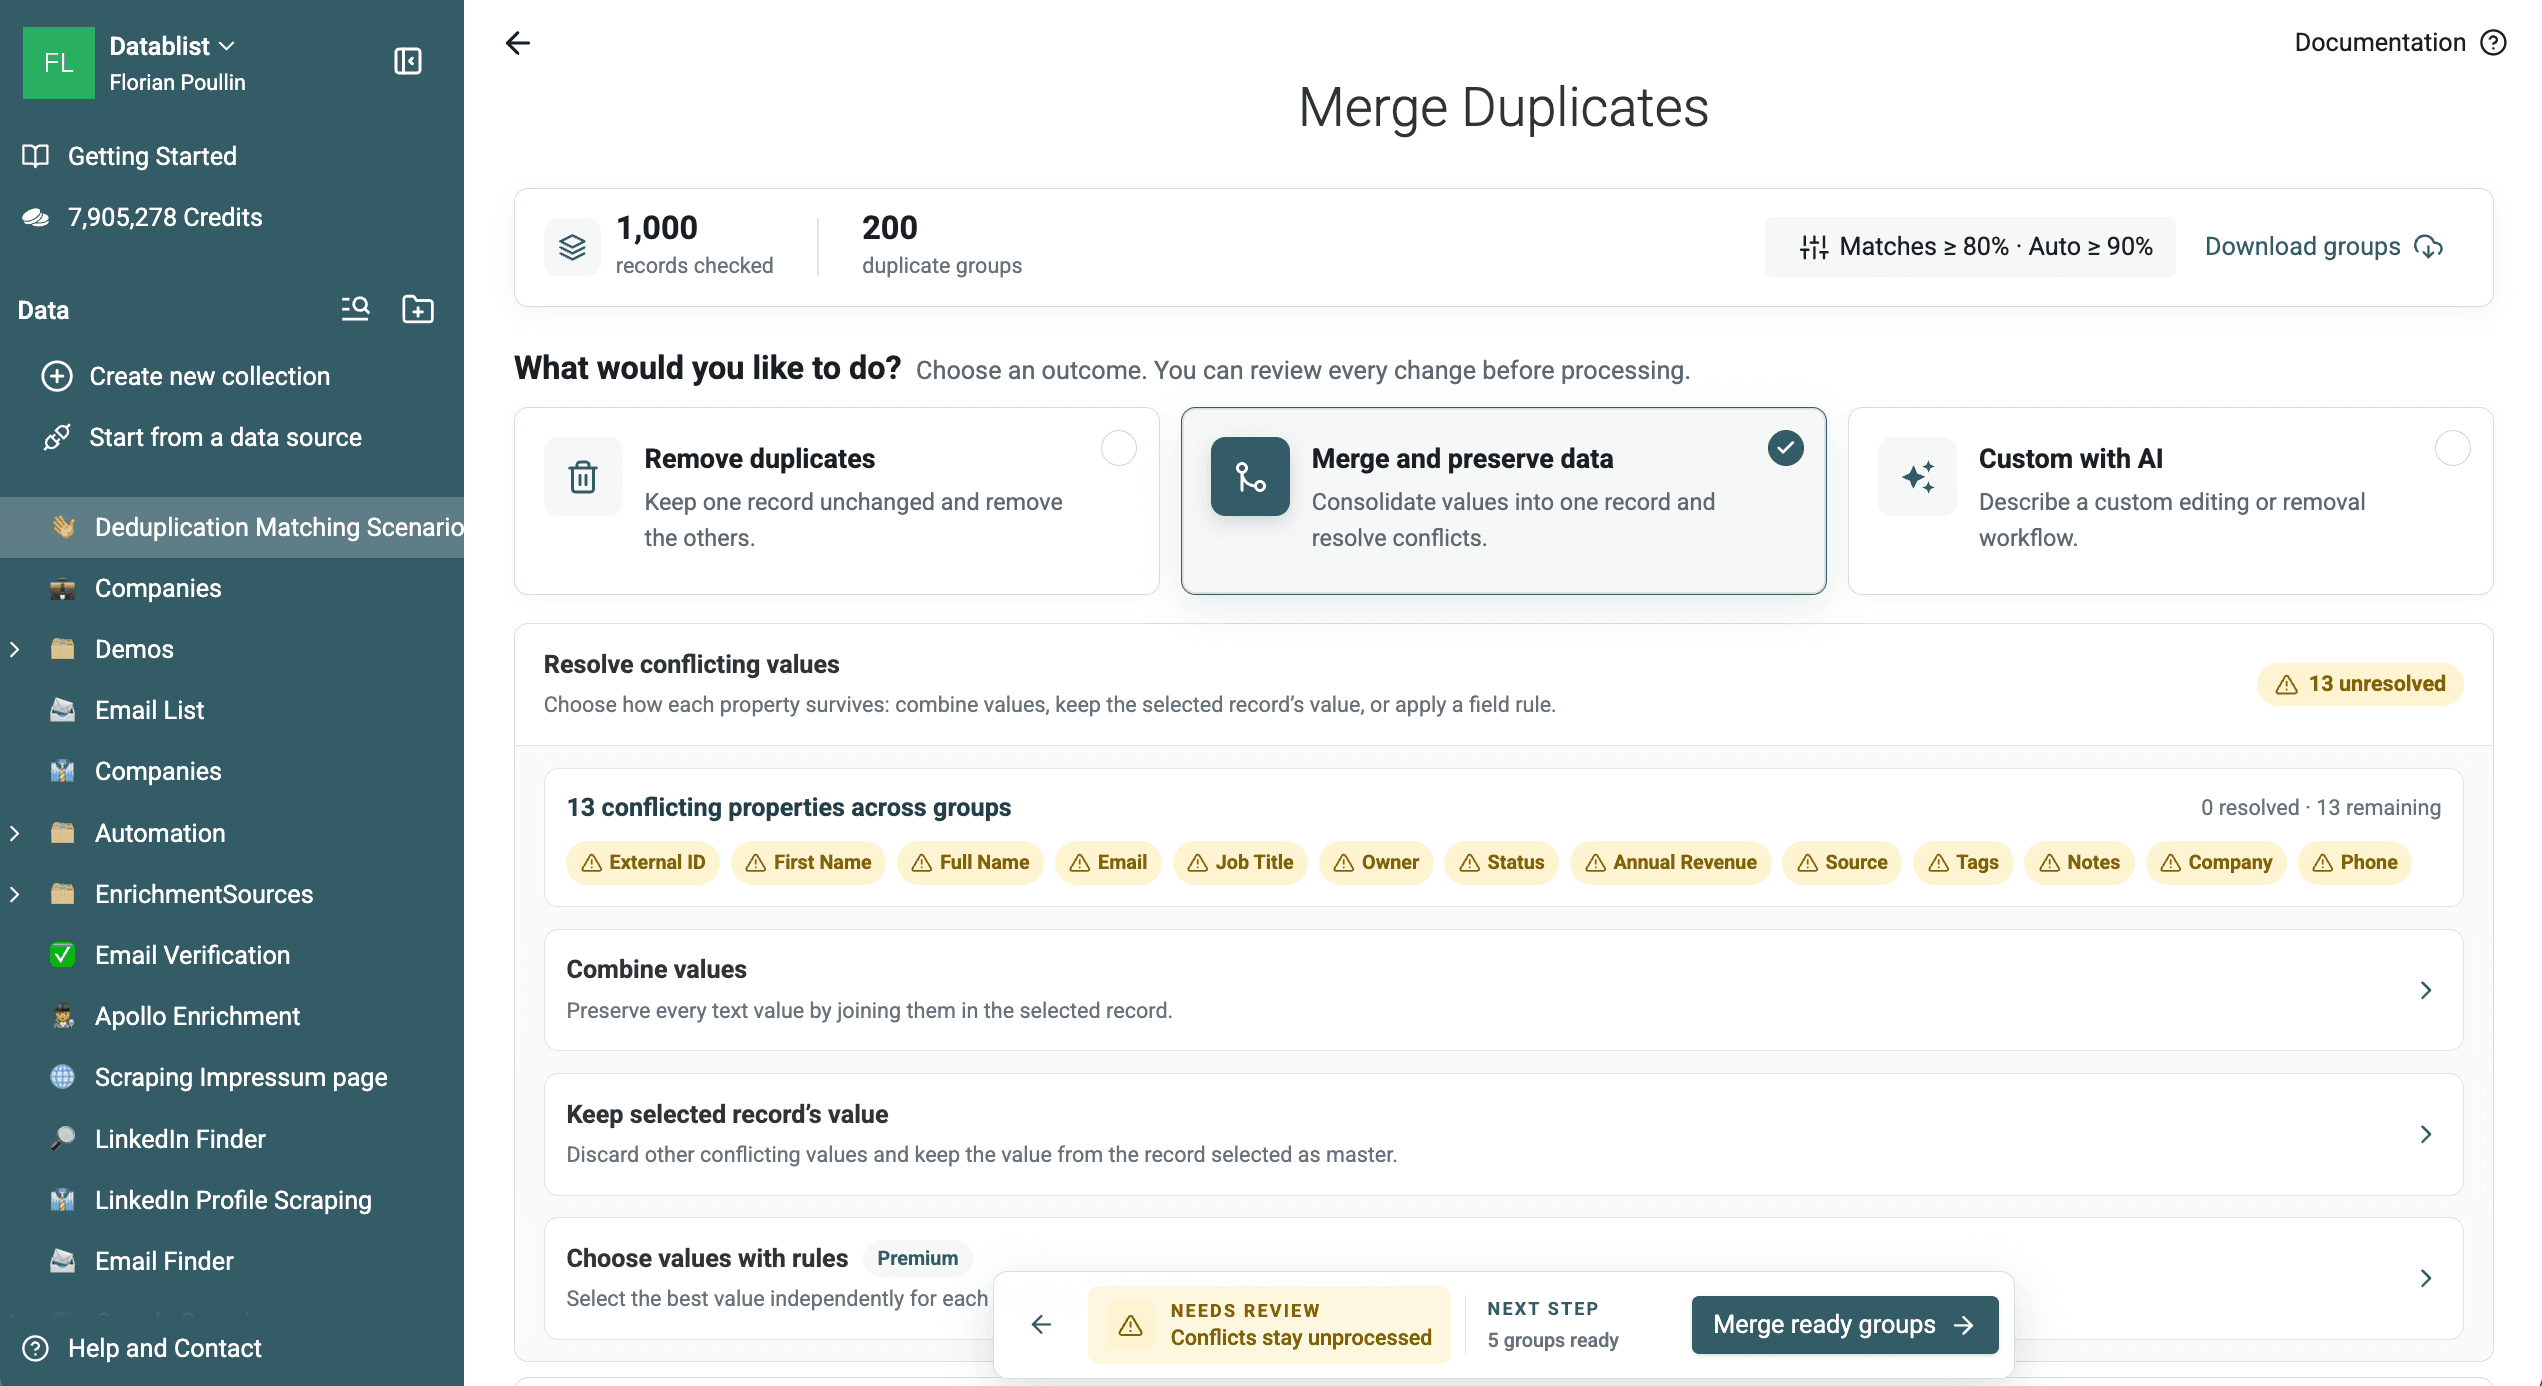
Öffne Why matched, bevor Du eine Gruppe verarbeitest. Dort siehst Du die Website-Eigenschaft, den Smart-Algorithmus, den URL Processor, die aktivierten URL-Optionen und den Match Score.
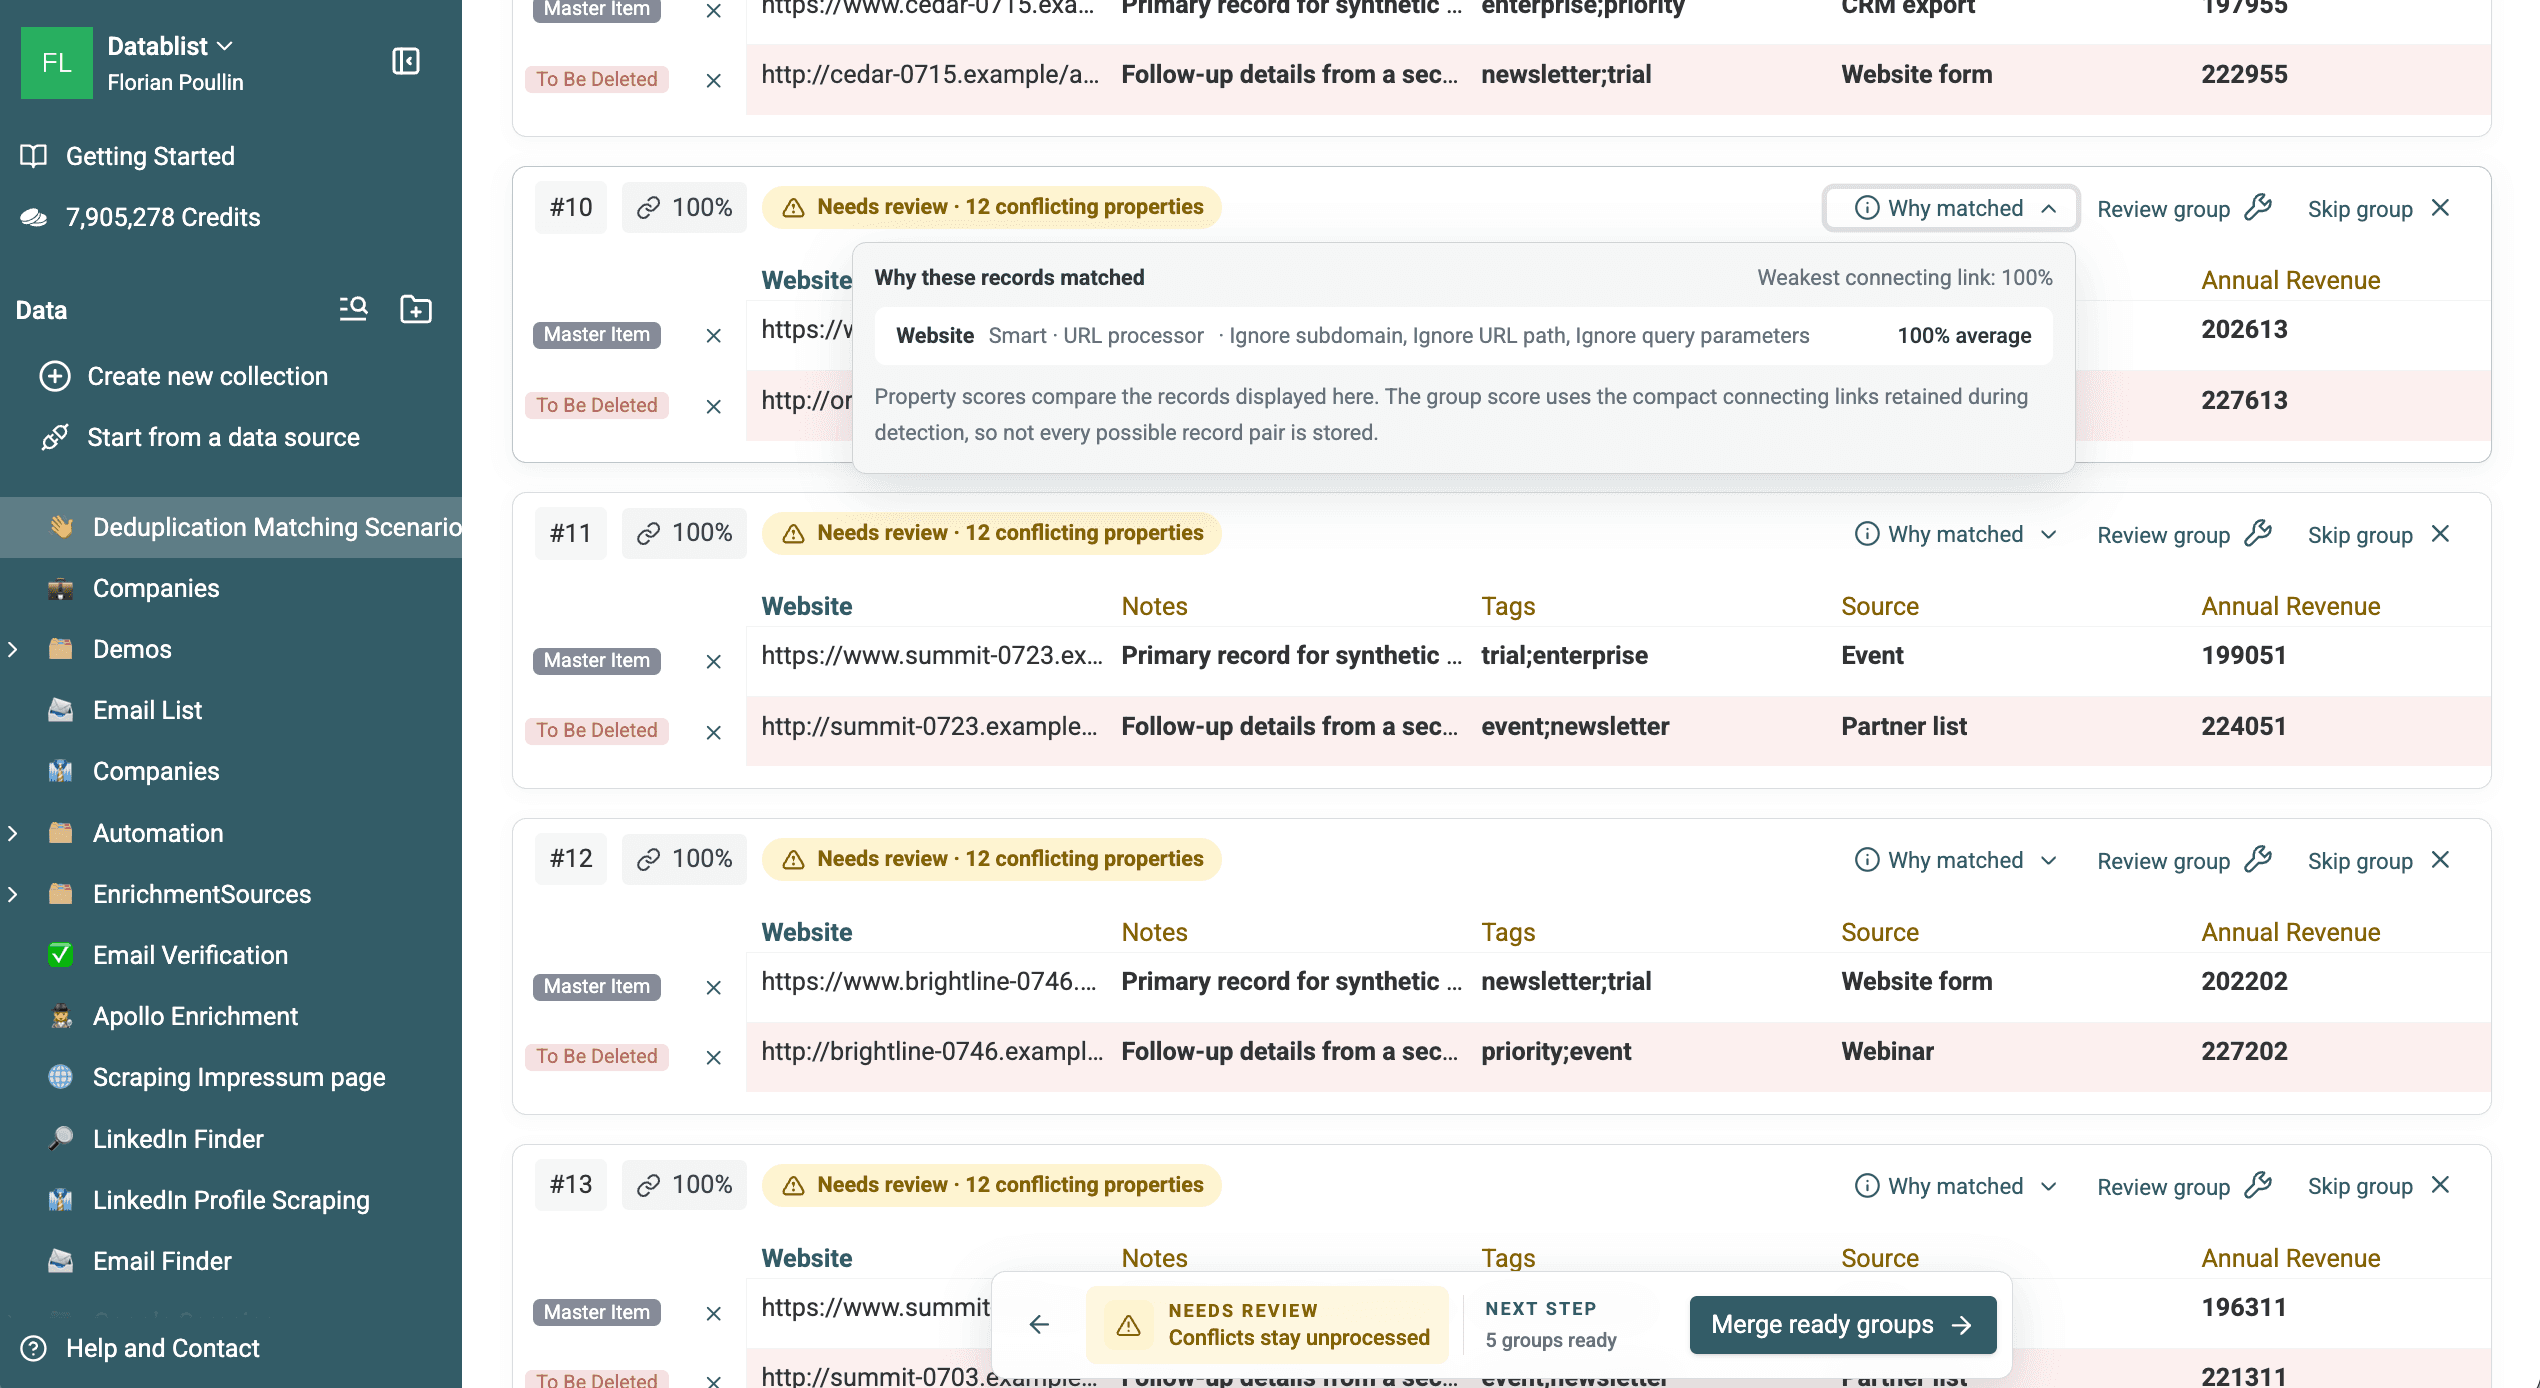
Lade die 200 Website-Dublettengruppen herunter, um die übereinstimmenden Zeilen zu prüfen.
Normalisierte Firmennamen abgleichen
Wähle für einen zweiten Durchlauf Company aus.
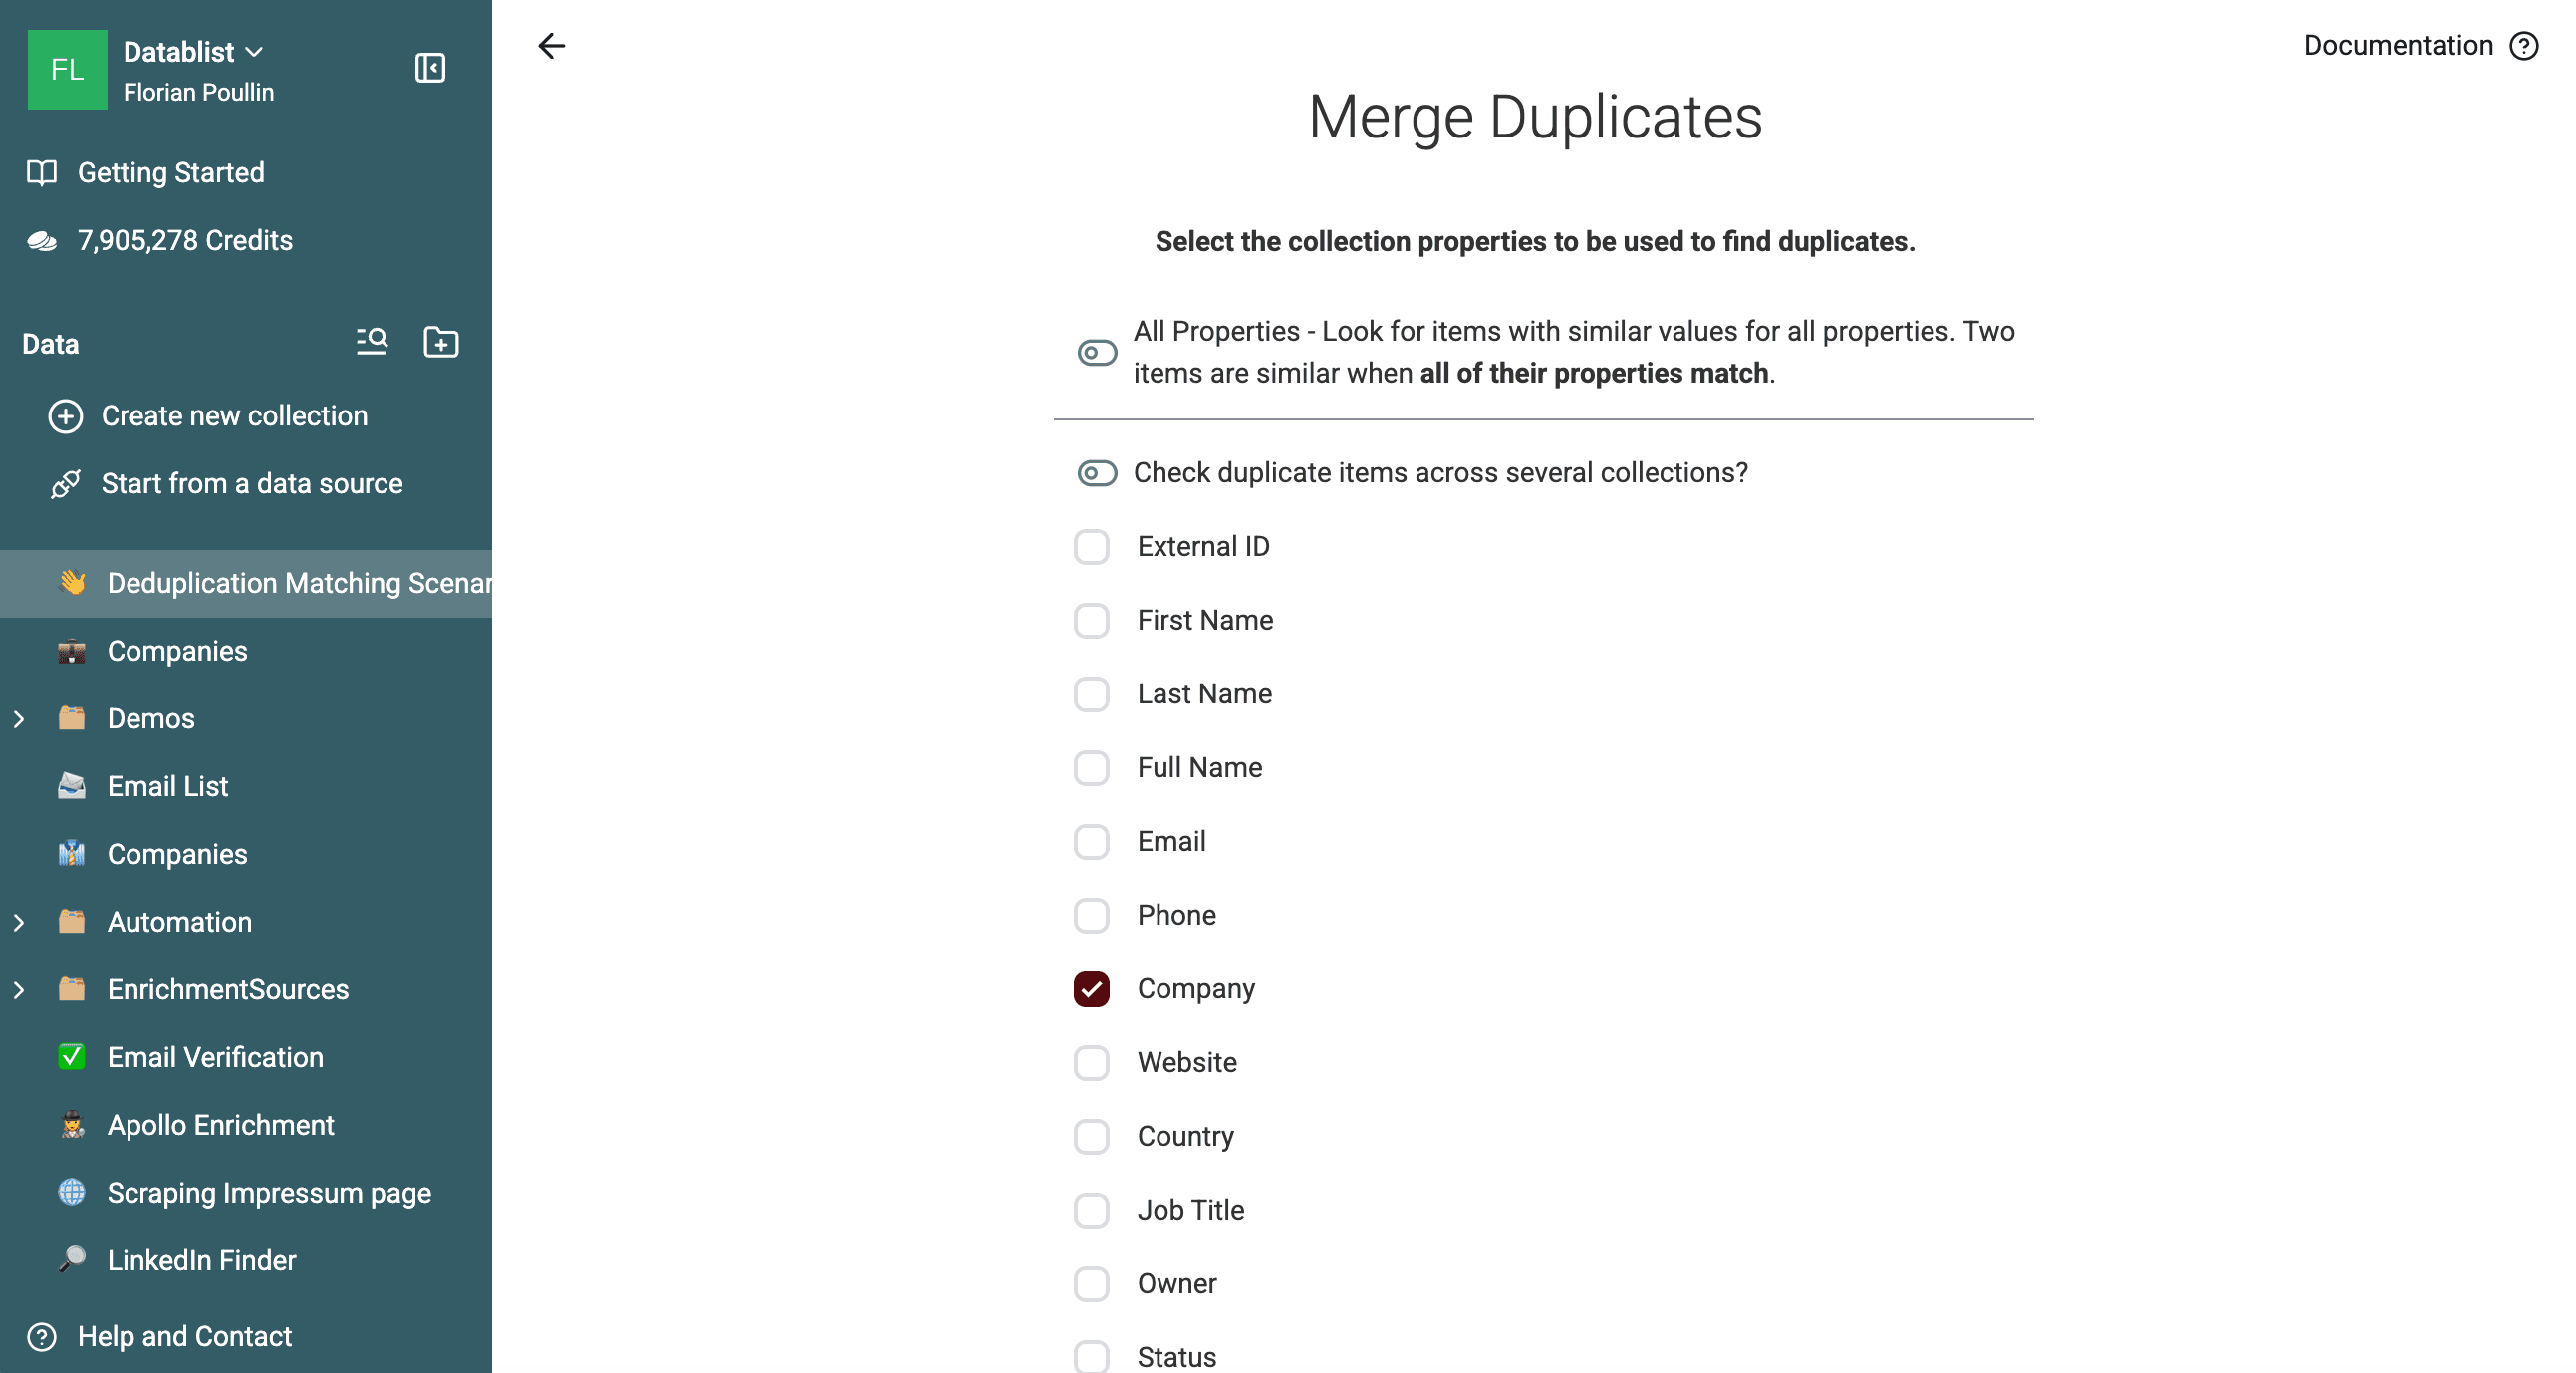
Wähle die Vergleichsmethode:
- Nutze Smart mit dem Company Name Processor, um gängige Firmenbegriffe vor dem Vergleich zu entfernen.
- Nutze Jaro-Winkler oder Levenshtein für unterschiedliche Schreibweisen. Beginne mit einem hohen Schwellenwert und belasse Gruppen mit geringerer Konfidenz in Needs review.
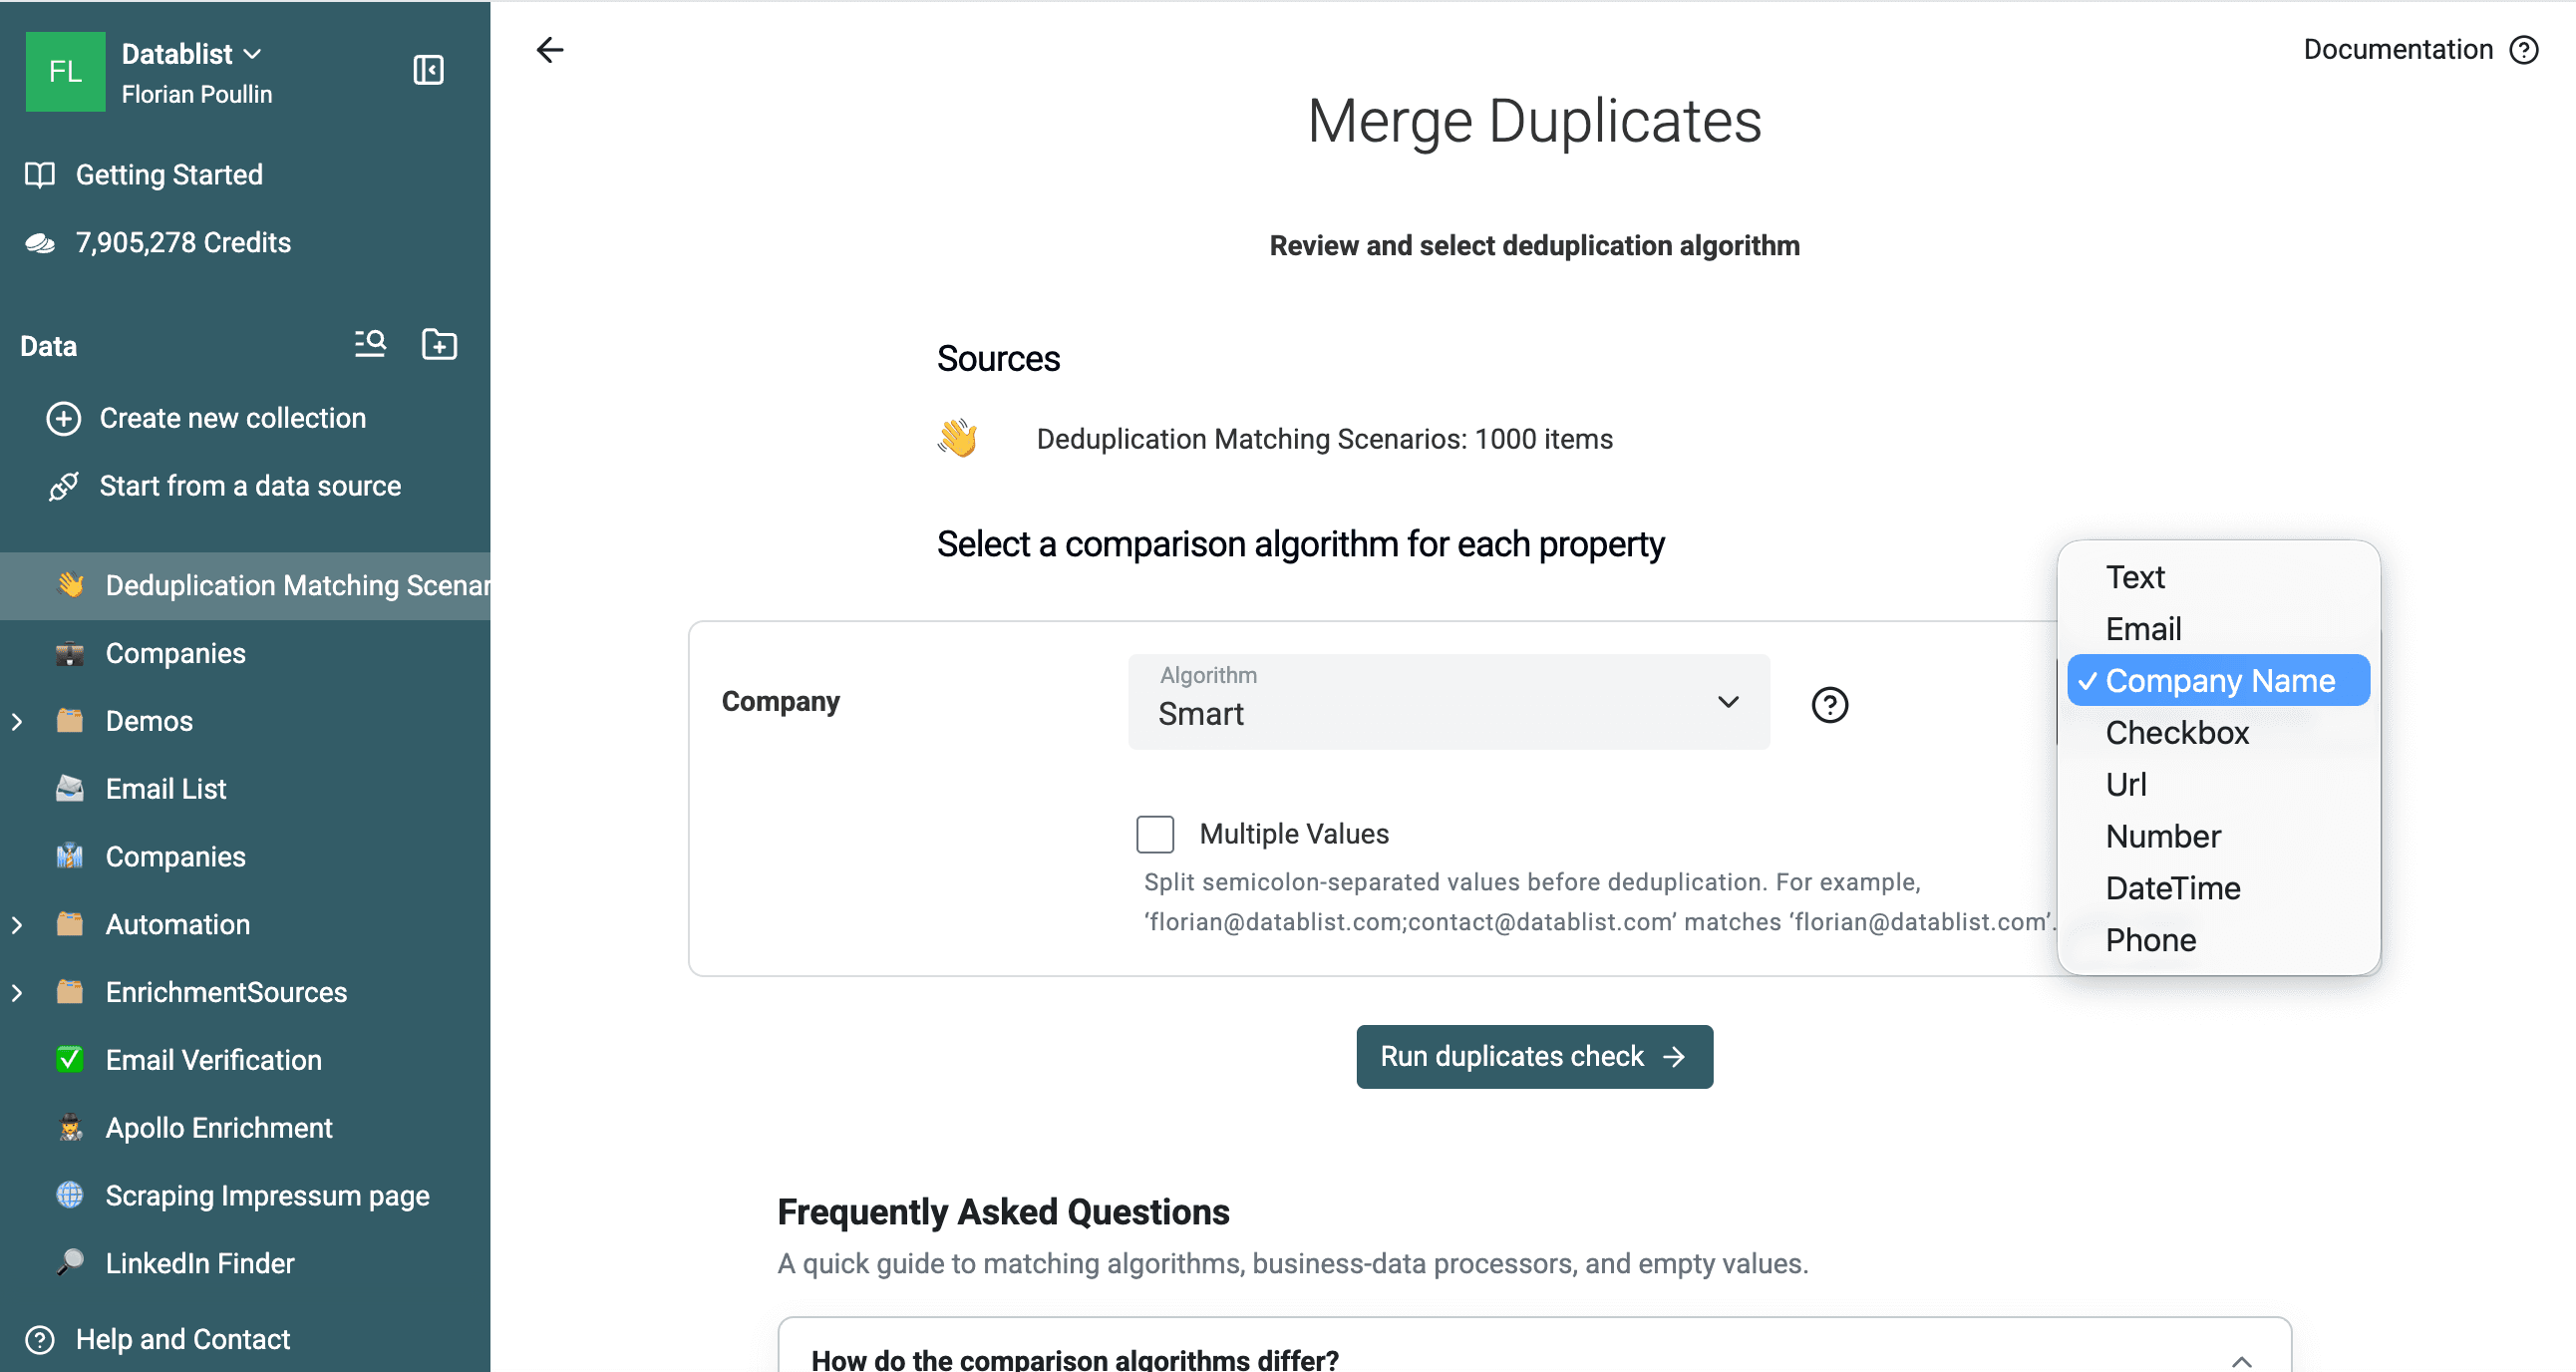
Starte die Dublettenprüfung, um übereinstimmende Datensätze zu erkennen.
So funktioniert der Company Name Processor
Der Company Name Processor ist ein spezielles Tool, das Firmennamen vor der Dublettenerkennung normalisiert. Das ist wichtig, weil Firmennamen in Deinen Daten häufig in verschiedenen Varianten vorkommen.
Was er macht:
- Entfernt Rechtsformzusätze: LLC, Inc., Ltd. usw.
- Ignoriert geografische Begriffe: Europe, USA, UK usw.
- Entfernt allgemeine Geschäftsbegriffe: Partners, Group, Technologies usw.
Beispiel:
| Originalname | Normalisierter Name |
|---|---|
| Apple Inc. | Apple |
| Apple USA LLC | Apple |
| Apple Technologies | Apple |
| Microsoft Corporation | Microsoft |
| Microsoft Ltd. UK | Microsoft |
Diese Werte können als übereinstimmende Kandidaten erkannt werden. Der Company Name Processor ist ein kostenpflichtiges Feature. Vor dem Zusammenführen musst Du trotzdem sicherstellen, dass die Gruppe tatsächlich dasselbe Unternehmen abbildet.
Messergebnis für das Testset mit 1.000 Zeilen
Der Company-Name-Durchlauf ergab bei 1.000 geprüften Datensätzen 200 Gruppen mit jeweils zwei Zeilen:
- 50 Paare enthalten gezielt erstellte Varianten von Firmennamen wie
Cedar 0715, Inc.undCedar 0715 Group LLC. - 150 weitere gezielt erstellte Dublettenpaare haben bereits einen identischen Company-Wert.
Alle 200 Gruppen wurden in diesem Test den richtigen synthetischen Entitäten zugeordnet. Keine Gruppe kombiniert Datensätze aus unterschiedlichen Entitäten. Dieses Ergebnis gilt für das generierte Testset und ist keine allgemeine Genauigkeitsgarantie.
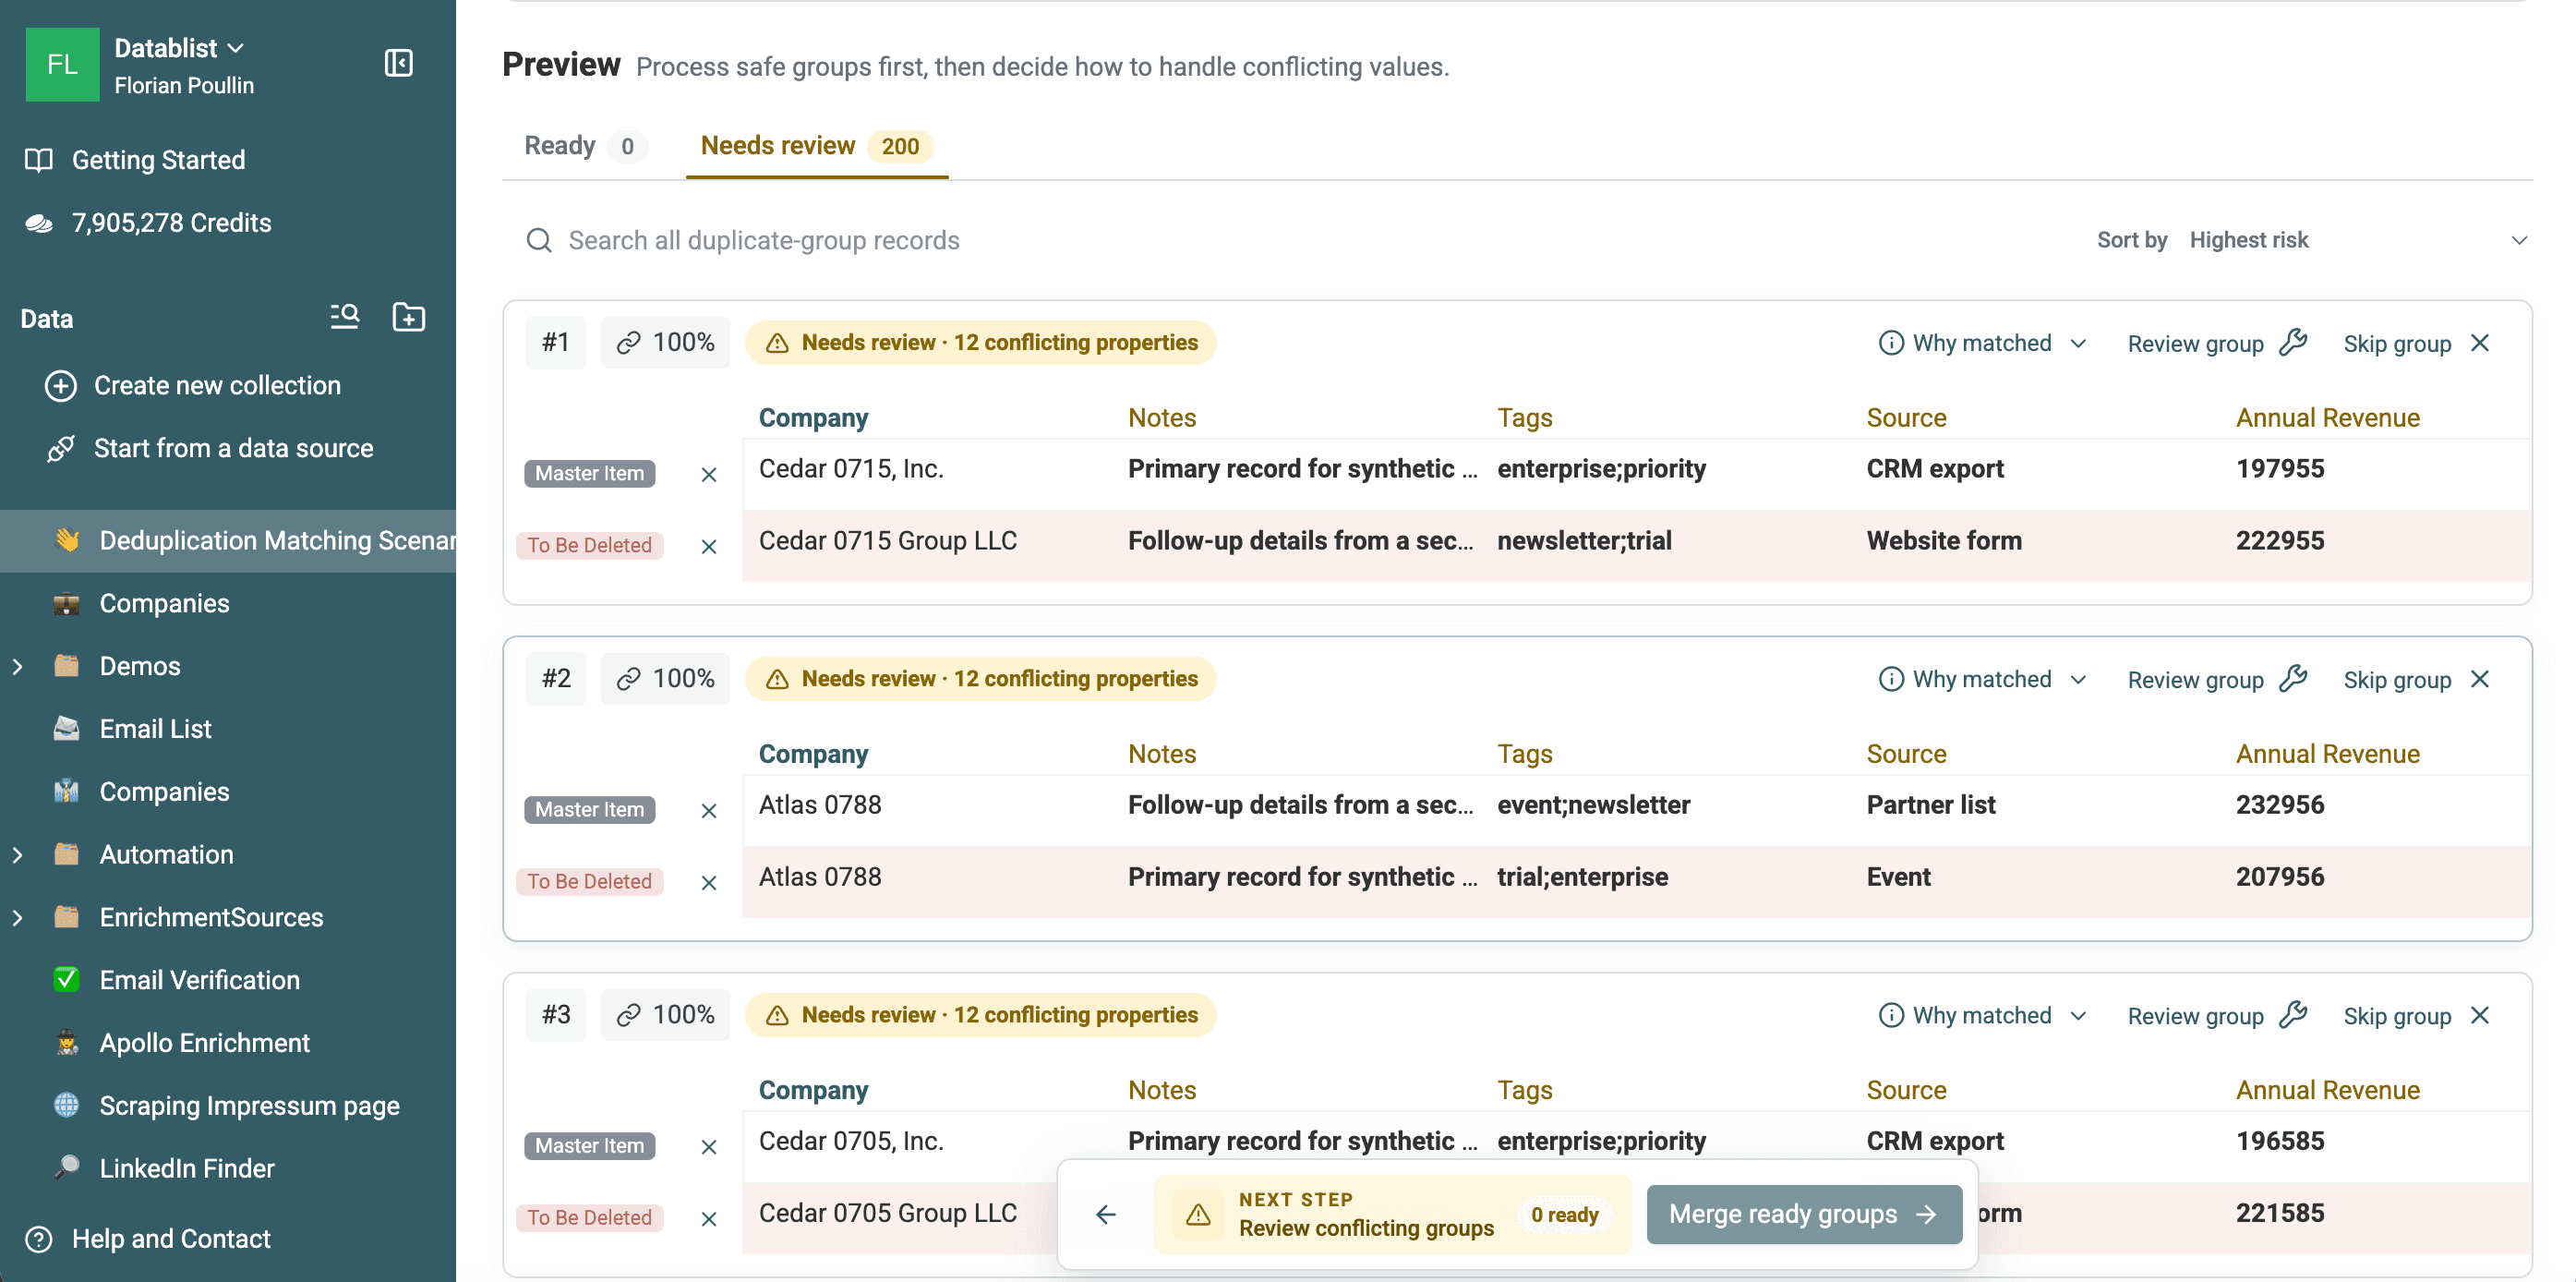
Die Gruppen haben einen Match Score von 100 %. Sie erscheinen in Needs review, weil andere Eigenschaften voneinander abweichen – nicht, weil der Abgleich der Firmennamen eine geringe Konfidenz hat.
Öffne Why matched, um die für eine Gruppe verwendete Eigenschaft, den Algorithmus, den Processor und den Score zu prüfen.
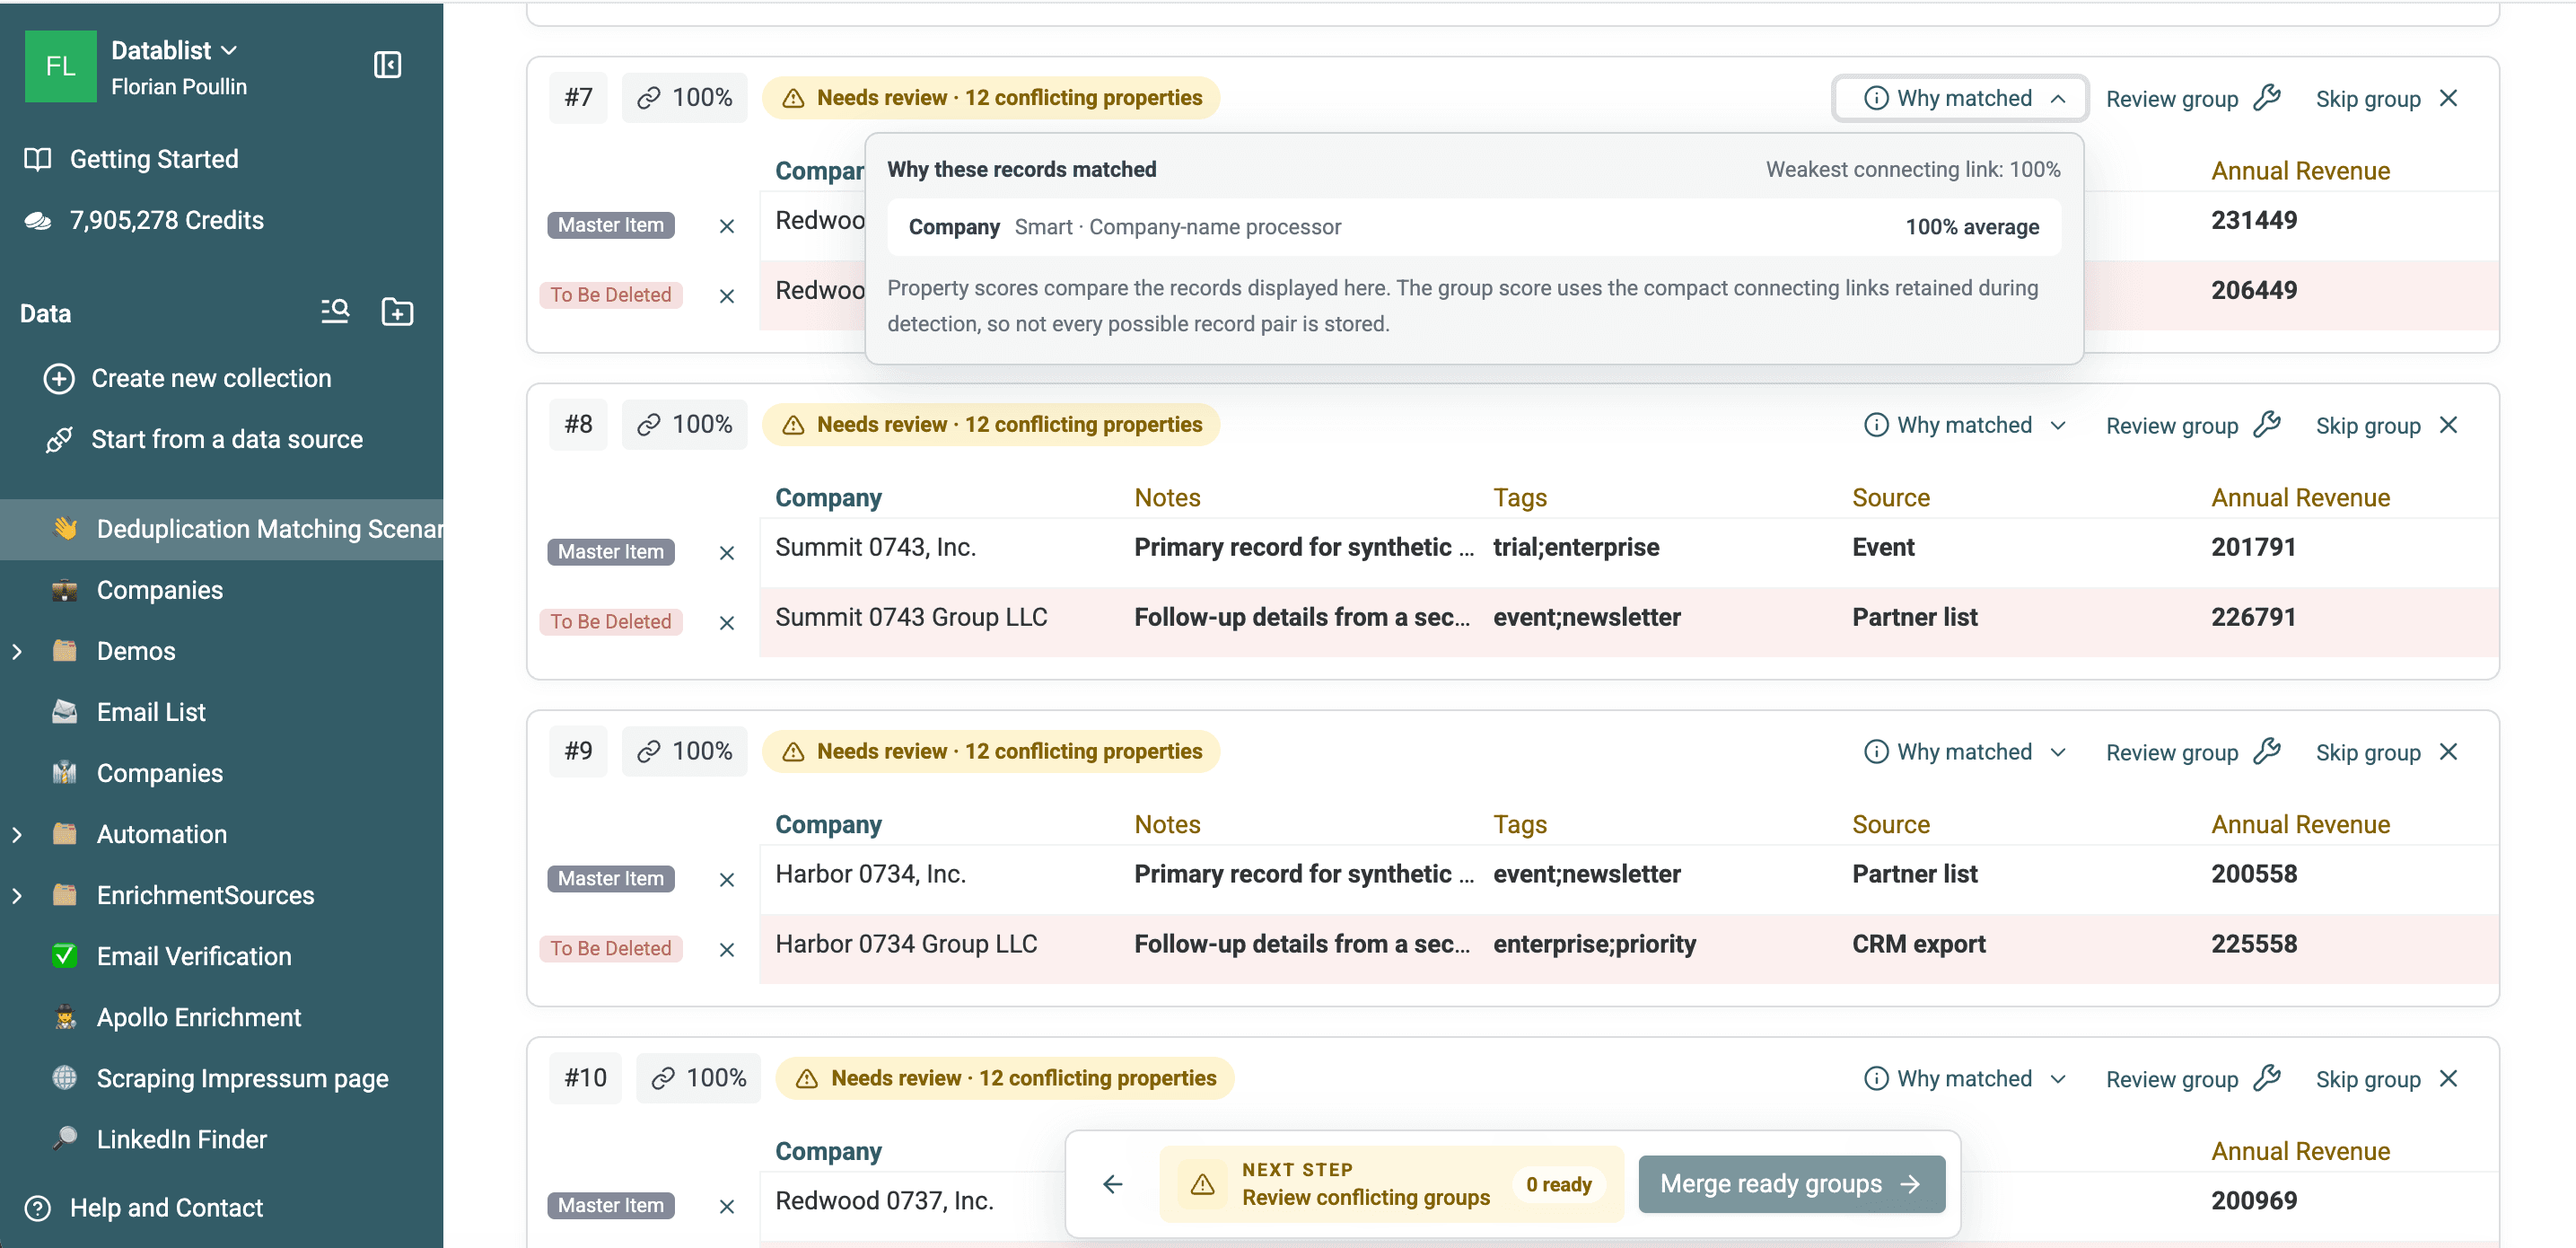
Lade die 200 exportierten Dublettengruppen herunter, um die übereinstimmenden Zeilen und DuplicateGroupId-Werte zu prüfen.
Schritt 3: Doppelte Firmendatensätze zusammenführen
Wenn Du nur eine Liste der Treffer brauchst, nutze Download groups und beende den Vorgang vor der Verarbeitung. Fahre fort, wenn Du die Datensätze in Datablist konsolidieren möchtest.
Konflikte lösen
Eine widersprüchliche Eigenschaft bedeutet, dass dasselbe Feld in den erkannten Dubletten unterschiedliche Werte enthält.
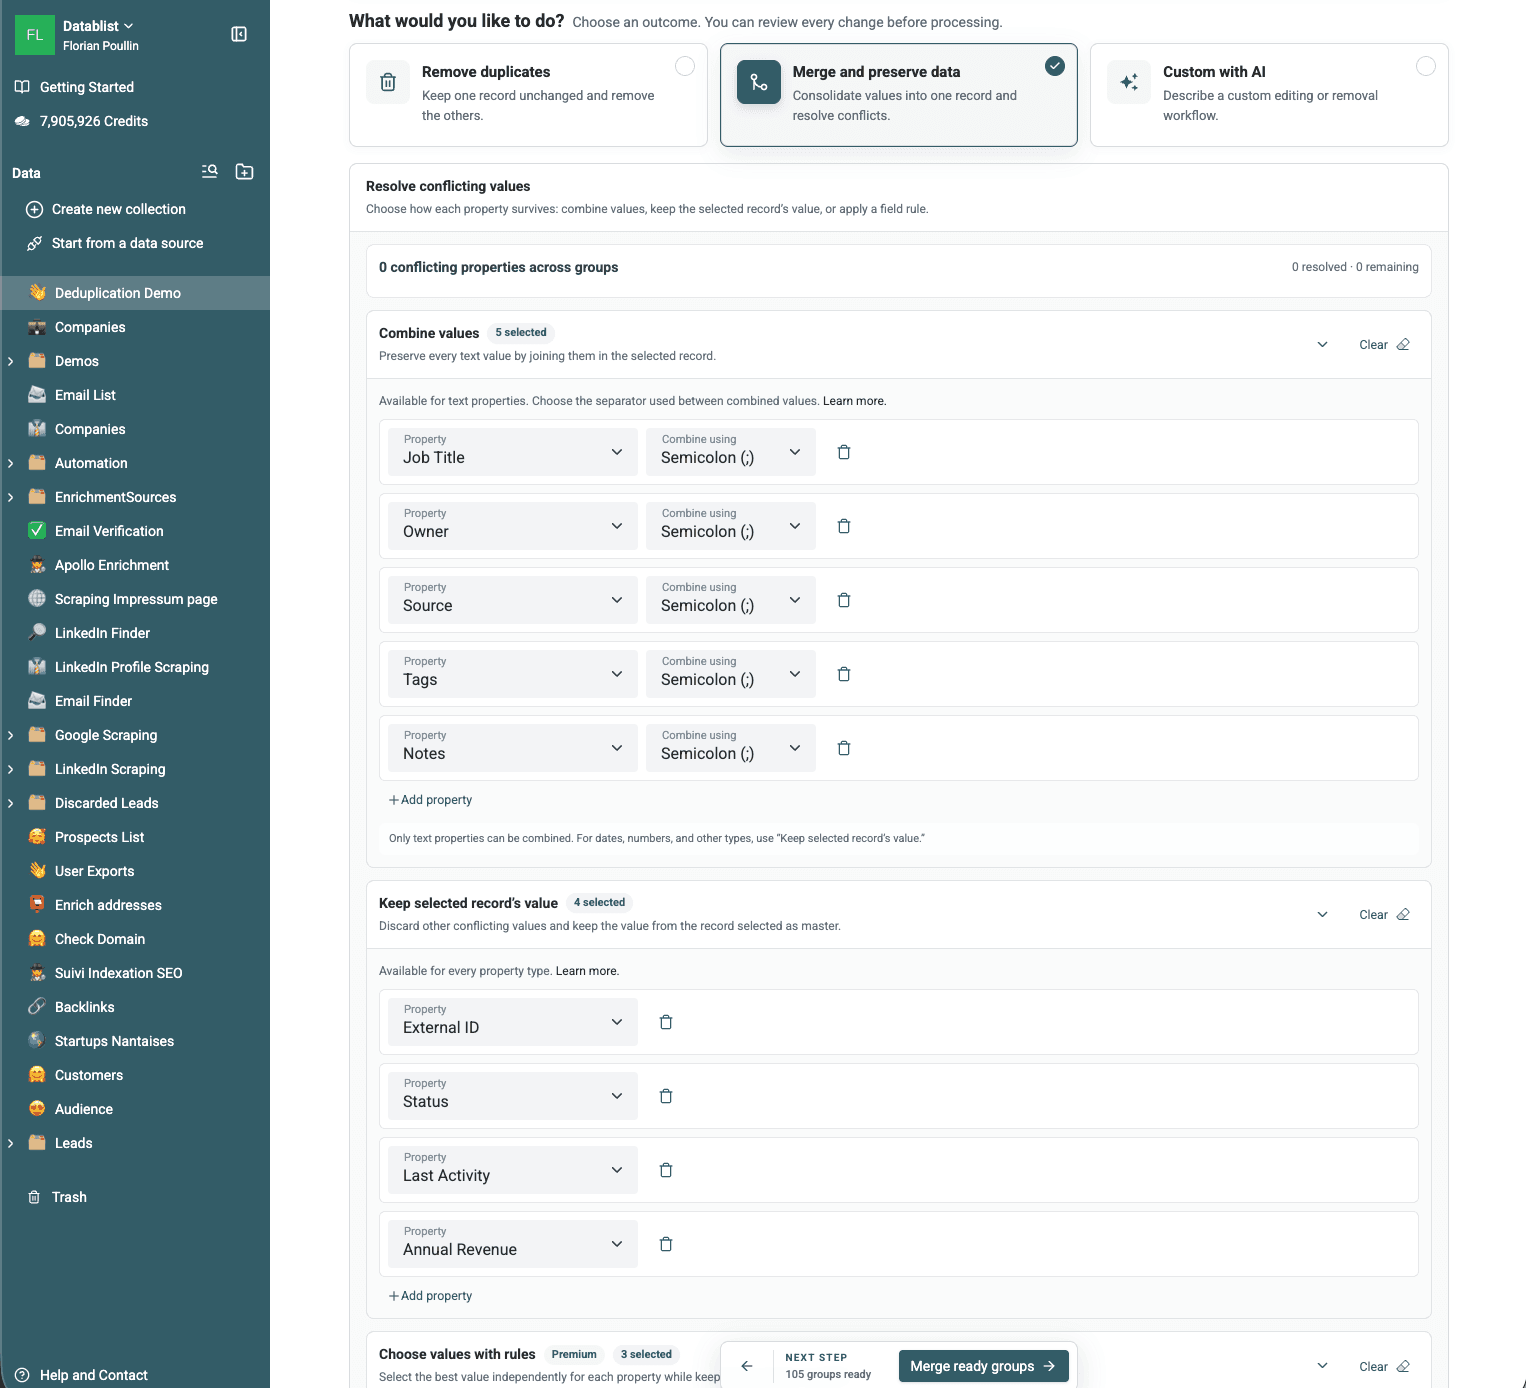
Wenn doppelte Datensätze in einzelnen Feldern unterschiedliche Werte haben, musst Du festlegen, wie sie zusammengeführt werden.
Wähle für jede widersprüchliche Eigenschaft eine Regel:
- Combine behält unterschiedliche Textwerte bei und trennt sie durch ein Trennzeichen.
- Keep the selected record's value verwirft die anderen Werte.
- Mit Field-Survivorship-Regeln kannst Du in kostenpflichtigen Tarifen den neuesten, ältesten, längsten, kürzesten, höchsten, niedrigsten oder häufigsten Wert auswählen.
Nutze die Schnellwahl, um dieselbe Regel auf mehrere widersprüchliche Eigenschaften anzuwenden. Passe anschließend bei Bedarf einzelne Felder an.
Master Record auswählen
Ein Datensatz wird zum Ziel und behält seine Datablist-ID.
Du kannst ihn anhand folgender Kriterien auswählen:
- Most Complete: Behält den Datensatz mit den meisten ausgefüllten Eigenschaften.
- Last Updated: Behält den zuletzt geänderten Datensatz.
- First Created: Behält den ältesten Datensatz.
- Highest Value oder Lowest Value: Vergleicht eine ausgewählte Eigenschaft.
- Matching Value: Behält den Datensatz, der einen festgelegten Eigenschaftswert enthält.
Nachdem Du die Merge-Regeln und die Auswahl des Master Records konfiguriert hast, aktualisierst Du die Vorschau. So siehst Du das Ergebnis des Zusammenführens, bevor Du die Änderungen übernimmst.
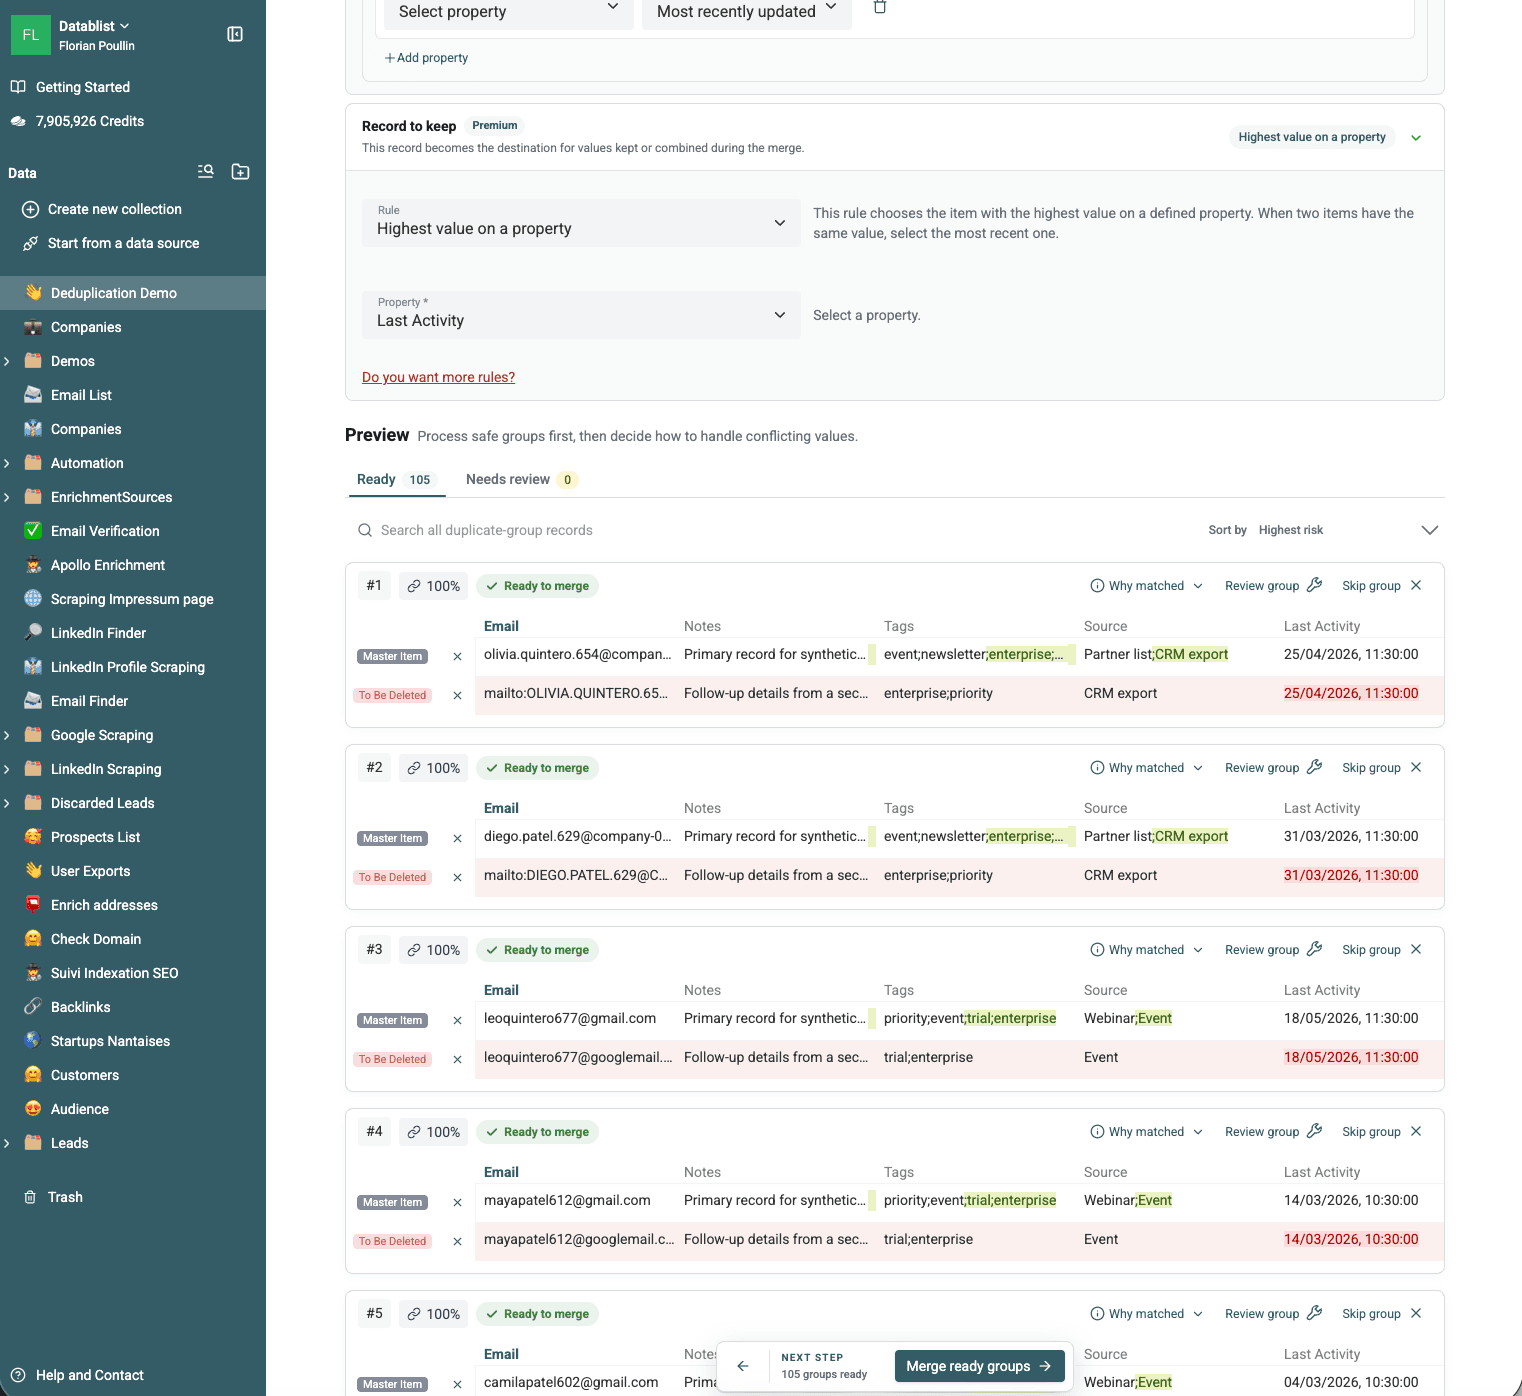
Die Vorschau zeigt für jede Dublettengruppe, welche Werte gelöscht oder kombiniert werden und welcher Datensatz als Master Record vorgesehen ist.
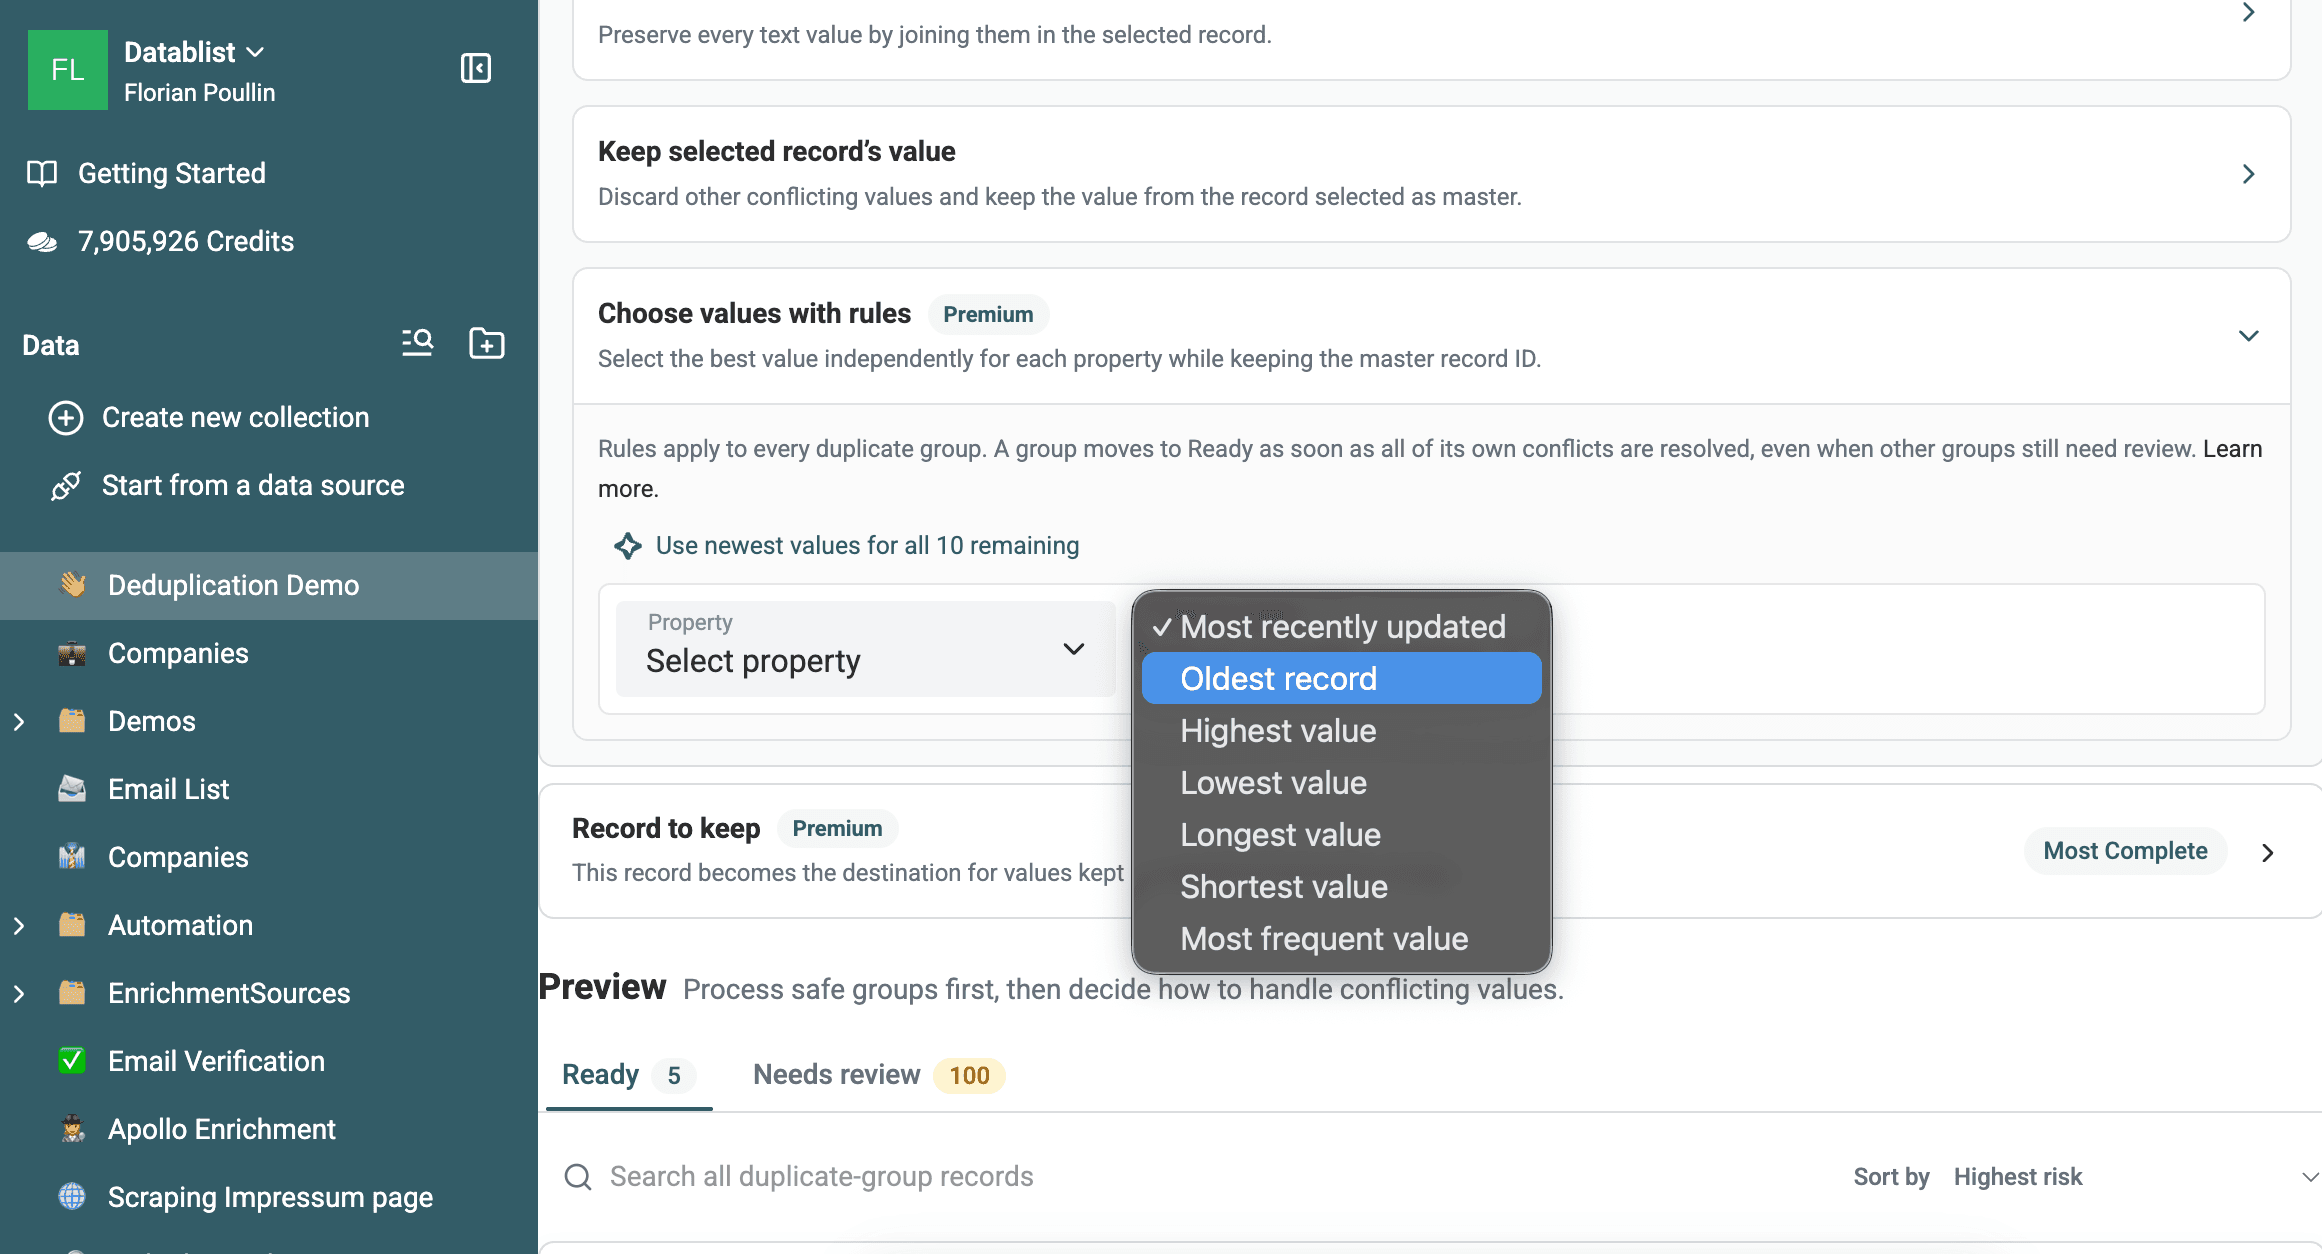
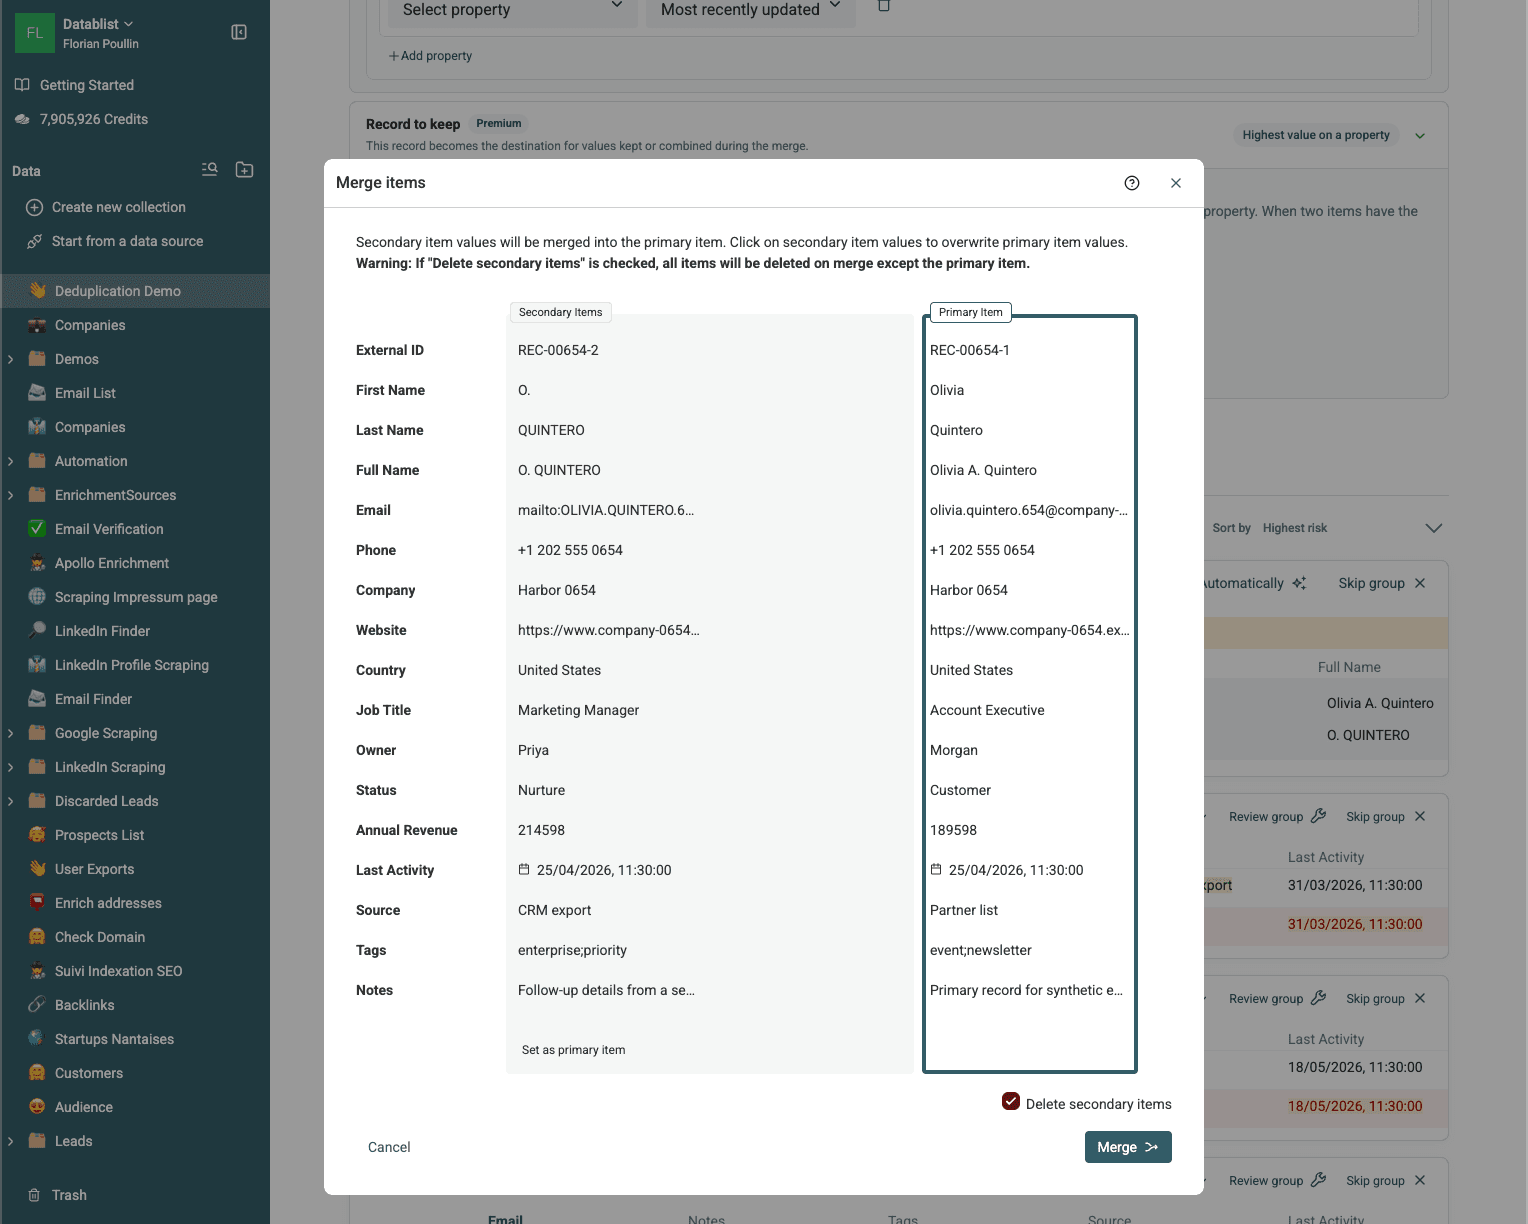
Öffne bei Ausnahmen Review group und wähle die Werte manuell aus.
Verarbeite die Gruppen unter Ready. Gruppen, die weiterhin als Needs review markiert sind, bleiben unverändert.
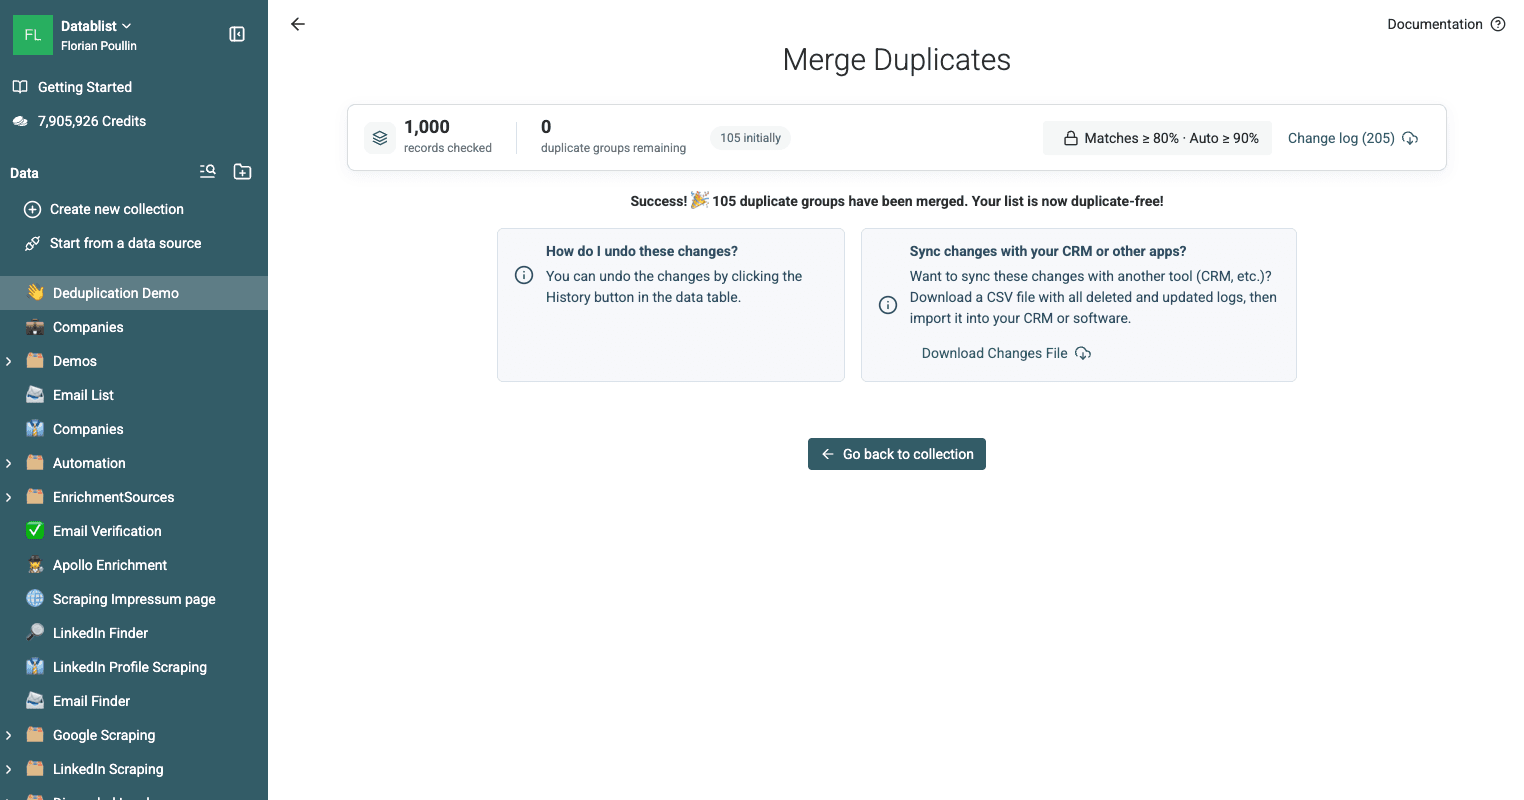
Nutze nach dem Zusammenführen Export im Header der Collection, um die bereinigte Liste als CSV- oder Excel-Datei herunterzuladen. Das nach der Verarbeitung erstellte Änderungsprotokoll dokumentiert gelöschte und aktualisierte IDs, falls Du einen Audit-Trail benötigst.
Alle Einstellungen für Abgleich, Prüfung und Zusammenführung findest Du in der Duplicate Finder Dokumentation.