
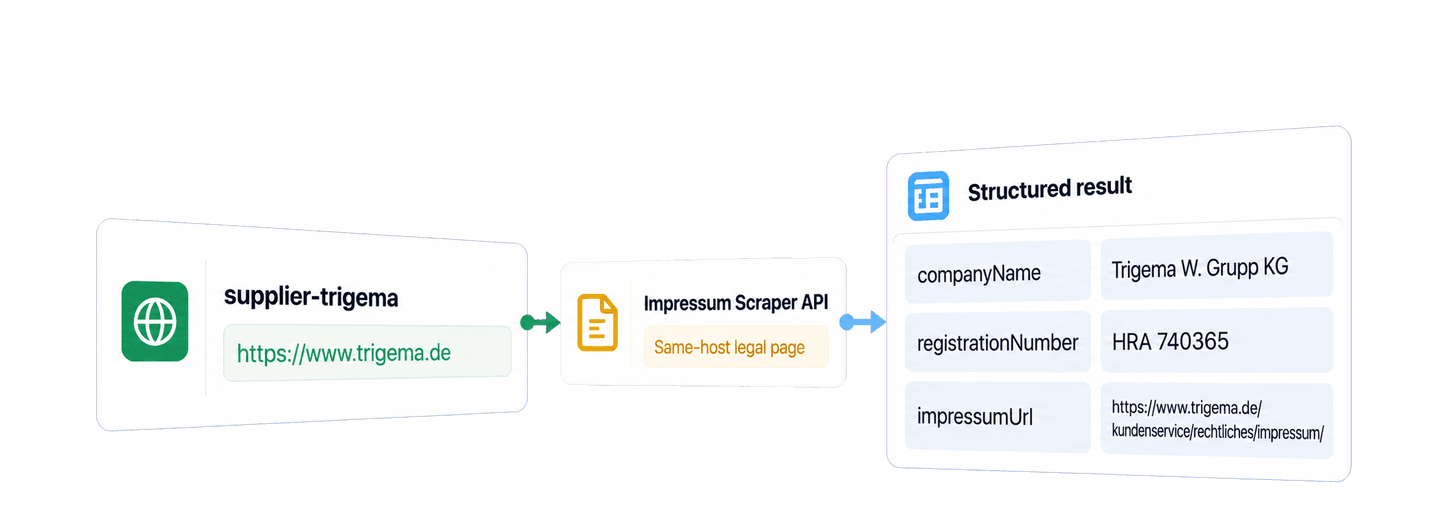
Um Impressum-Daten mit Python auszulesen, ohne einen eigenen Crawler zu entwickeln, nutzt Du die Impressum Scraper API von Datablist zusammen mit der Requests Library. Du übergibst die URLs der Unternehmenswebsites, die API findet das jeweilige Impressum und extrahiert daraus strukturierte Unternehmens- und Kontaktdaten.
Für dieses Beispiel verwende ich zwei etablierte deutsche Marken: den Bekleidungshersteller Trigema und die Outdoor-Marke VAUDE. Ein kleines, direkt ausführbares Python-Beispiel führt die Abfrage durch und speichert die extrahierten Angaben sowie die Quell-URL des Impressums im jeweiligen Lieferantendatensatz.
📌 Kurzfassung für Eilige
Mit der Impressum Scraper API von Datablist verwandelst Du deutsche Unternehmenswebsites in strukturierte Firmen- und Kontaktdaten. Das Python-Beispiel übermittelt zwei Websites, wartet auf die Verarbeitung im Hintergrund, ruft alle Ergebnisseiten ab und speichert die gefundene Impressums-URL im jeweiligen Datensatz.
- Input: URLs deutscher Unternehmenswebsites.
- Output: Unternehmens- und Kontaktdaten plus Link zum Quell-Impressum.
💡 Du bevorzugst eine No-Code-Lösung? Mit dem Impressum Scraper von Datablist extrahierst Du diese Unternehmensdaten ganz ohne Code.
API-Key und Python-Umgebung einrichten
Erstelle ein Datablist-Konto und anschließend einen Personal API Key. Der Zugriff auf die REST API ist im Growth-Plan verfügbar. So sieht ein API-Key beispielsweise aus:
auth0|exampleuser:exampleaccount:EXAMPLE_TOKEN_NOT_VALID:1Exportiere Deinen eigenen Key als DATABLIST_API_KEY:
export DATABLIST_API_KEY="your-personal-api-key"Für dieses Python-Beispiel verwende ich das Package requests. Erstelle eine Datei namens scrape_impressum.py und installiere das Package:
python -m pip install requestsJede übermittelte Website kostet 10 Credits. Das folgende Beispiel mit zwei Websites verbraucht 20 Credits, wenn beide Inputs verarbeitet werden.
Funktion scrape_impressums() erstellen
Füge dieses vollständige Skript in scrape_impressum.py ein:
import json
import os
import time
import uuid
import requests
def scrape_impressums(suppliers, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": supplier["id"],
"data": {"websiteUrl": supplier["website_url"]},
}
for supplier in suppliers
]
payload = {
"enrichmentId": "impressum-scraper",
"uniqueId": str(uuid.uuid4()),
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
suppliers = [
{
"id": "supplier-trigema",
"label": "Trigema",
"website_url": "https://www.trigema.de",
},
{
"id": "supplier-vaude",
"label": "VAUDE",
"website_url": "https://www.vaude.com",
},
]
impressum_results = scrape_impressums(suppliers, api_key)
for result in impressum_results:
print(json.dumps(result, ensure_ascii=False))Führe das vollständige Skript mit folgendem Befehl aus:
python scrape_impressum.pyDie Funktion durchläuft die API in drei Schritten. Sie übermittelt die Website-Inputs, wartet auf den Abschluss des Tasks und ruft danach alle Ergebnisseiten ab.
Website-Inputs übermitteln
Das Skript wandelt jeden Lieferanten in einen API-Input wie diesen um:
inputs = [
{
"inputId": supplier["id"],
"data": {"websiteUrl": supplier["website_url"]},
}
for supplier in suppliers
]inputId ist Deine eigene stabile Kennung. data.websiteUrl enthält die Unternehmenswebsite, die der Scraper untersuchen soll. Verwende die eigene Website des Unternehmens und kein Verzeichnis oder Social-Media-Profil. Im Payload wird das öffentliche Enrichment impressum-scraper ausgewählt. Das Objekt settings bleibt leer, weil diese API keine öffentlichen Einstellungen erfordert.
Der POST-Request erstellt einen Task, der im Hintergrund ausgeführt wird. Datablist nimmt den Request an und gibt ein Task-Objekt zurück, dessen @id diesen Durchlauf identifiziert. Mit dieser ID erstellt die Funktion die URLs für Status und Ergebnisse.
Eine gekürzte Antwort beim Erstellen des Tasks sieht so aus:
{
  "@id": "task-id",
  "enrichmentId": "impressum-scraper",
  "status": "queued",
  "links": {
    "self": "https://api.datablist.com/v1/enrichments/tasks/task-id",
    "results": "https://api.datablist.com/v1/enrichments/tasks/task-id/results"
  }
}
queued bedeutet, dass der Request angenommen wurde – nicht, dass das Ergebnis bereits vorliegt. Das Skript übernimmt die zurückgegebene @id in die nächsten beiden Schritte. Du musst die Task-URLs also nicht manuell kopieren. Vor dem Auslesen jeder Antwort ruft es außerdem raise_for_status() auf. Dadurch stoppt ein Authentifizierungs- oder Validierungsfehler direkt beim fehlgeschlagenen HTTP-Request, statt fälschlich als abgeschlossene Abfrage behandelt zu werden.
Auf den Hintergrund-Task warten
Datablist verarbeitet den Task im Hintergrund. Das Beispiel prüft den Status alle drei Sekunden, bis er completed, failed oder stopped erreicht. Requests ist eine blockierende Python Library. Dein lokales Skript wartet deshalb während dieser Aufrufe, obwohl der API-Task selbst im Hintergrund läuft.
Endet der Task mit failed oder stopped, löst die Funktion einen Fehler aus, der die Task-ID und den finalen Status enthält. Bewahre diese ID für die Analyse des bestehenden Tasks auf, statt dieselbe kostenpflichtige Verarbeitung sofort erneut zu starten.
Alle Ergebnisseiten abrufen
Sobald der Task abgeschlossen ist, ruft das Skript bis zu 100 Ergebnisse gleichzeitig ab. Die Paginierungsregel ist einfach: Rufe die nächste Seite ab, bis nextCursor den Wert null hat. Enthält der Cursor einen Wert, sendet das Skript ihn mit dem nächsten Request.
Verknüpfe die zurückgegebenen Datensätze in Deiner Anwendung nicht anhand ihrer Listenposition. Die Ergebnisse können in einer anderen Reihenfolge als die übermittelten Inputs eintreffen. Verwende inputId als Join-Key.
So findet die API eine Impressumsseite
Die Startseite ist der Ausgangspunkt, nicht die Seite, von der die API die Daten extrahiert. Der Impressum Scraper untersucht mithilfe von AI die internen Links des angegebenen Hosts und erkennt ein Impressum oder eine entsprechende Rechts- beziehungsweise Kontaktseite. Das ist wichtig, weil der Link beispielsweise Rechtliches, Kontakt oder Legal heißen kann, statt direkt unter /impressum erreichbar zu sein.
Findet die AI keinen passenden internen Link, probiert der Scraper die üblichen Pfade /impressum und /imprint auf demselben Host aus. Sobald er eine Quellseite erreicht, extrahiert die AI Angaben zum rechtlichen Unternehmen, zur Adresse, zu Kontaktdaten, Registrierung und Umsatzsteuer sowie die Quelldaten in ein Ergebnis. Der Scraper verwendet weder eine Suchmaschine noch wechselt er zu einem externen Verzeichnis.
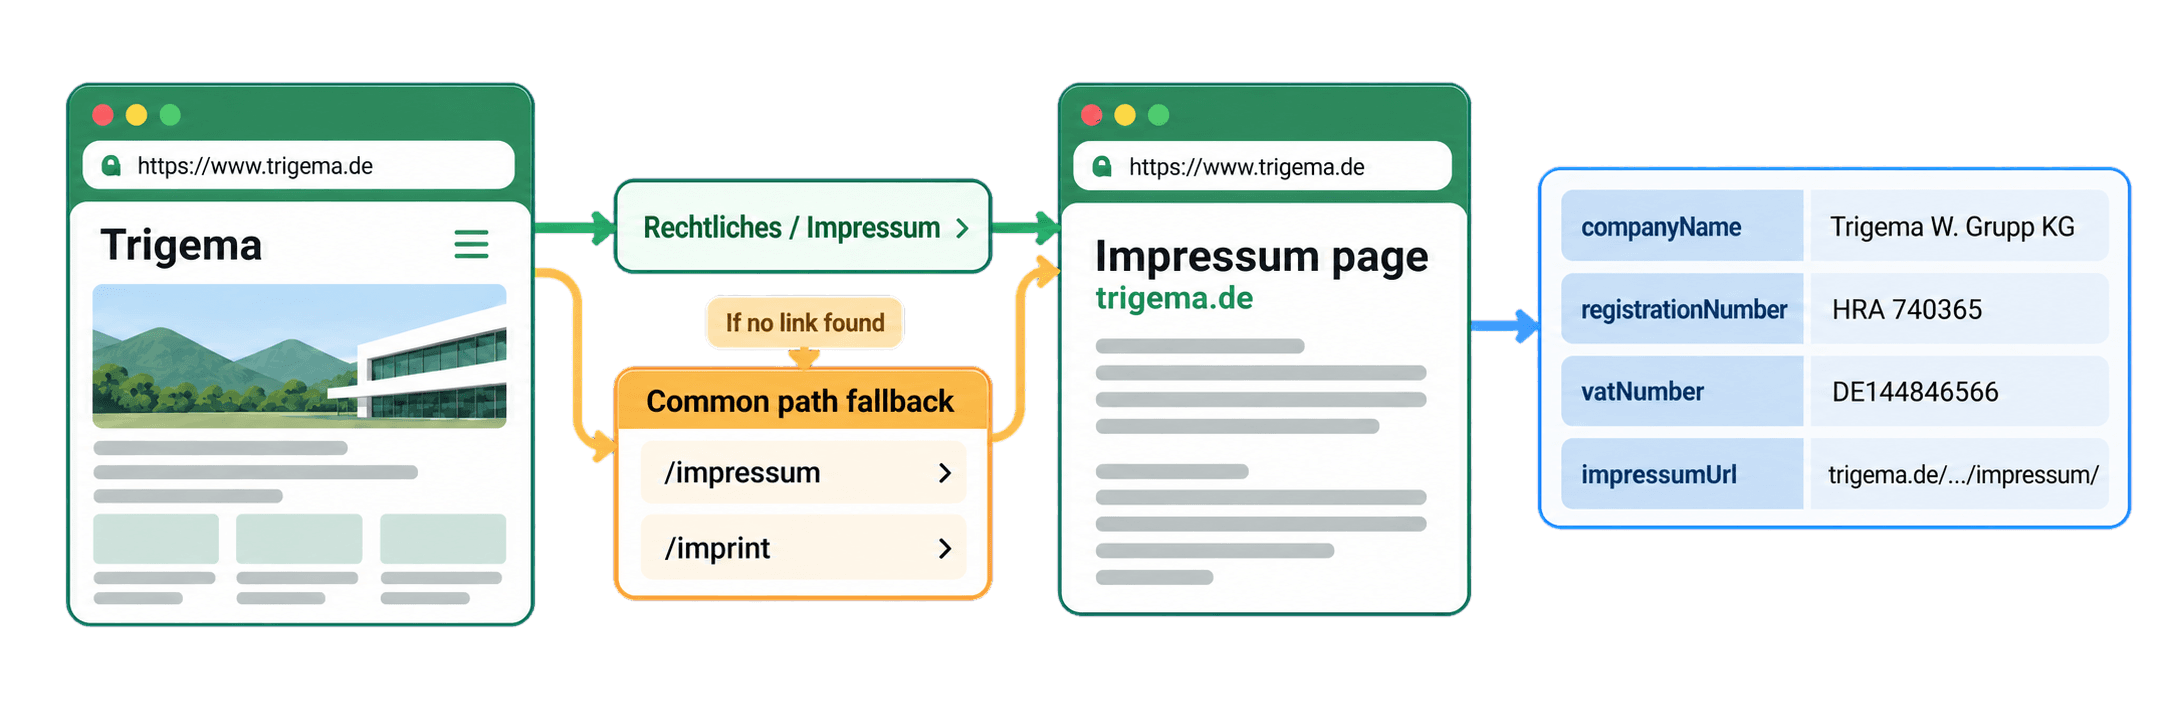
Die beiden Ergebnisse zeigen die unterschiedlichen Pfade in der Praxis. Für Trigema wurde /kundenservice/rechtliches/impressum/ zurückgegeben, für VAUDE dagegen /de/de/impressum.html. Speichere impressumUrl zusammen mit jedem Ergebnis, denn das Feld dokumentiert die genaue Quellseite der extrahierten Angaben.
Ergebnisse von Trigema und VAUDE auswerten
Hier siehst Du einen kompakten Auszug aus den beiden Beispielergebnissen.
📘 Beispiel-E-Mail-Adressen: Die E-Mail-Adressen sind unten mit
**maskiert. Die API gibt die vollständigen Adressen zurück.
[
  {
    "inputId": "supplier-trigema",
    "status": "success",
    "outputs": {
      "firstName": "Wolfgang",
      "lastName": "Grupp",
      "companyName": "Trigema W. Grupp KG",
      "postalAddress": "Josef-Mayer-Str. 31-35, D-72393 Burladingen",
      "emailAddress": "b**@trigema.de",
      "registrationNumber": "HRA 740365",
      "vatNumber": "DE144846566",
      "impressumUrl": "https://www.trigema.de/kundenservice/rechtliches/impressum/",
      "agentConfidenceScore": 90
    },
    "creditsUsed": "10",
    "error": null
  },
  {
    "inputId": "supplier-vaude",
    "status": "success",
    "outputs": {
      "firstName": "Antje",
      "lastName": "von Dewitz",
      "companyName": "VAUDE Sport GmbH & Co. KG",
      "postalAddress": "Vaude Straße 2, 88069 Tettnang",
      "emailAddress": "s**@service.vaude.com",
      "registrationNumber": "HRA 631071",
      "vatNumber": "DE203894755",
      "impressumUrl": "https://www.vaude.com/de/de/impressum.html",
      "agentConfidenceScore": 95
    },
    "creditsUsed": "10",
    "error": null
  }
]
Beginnen wir mit den Namen. Trigema ist die Lieferantenbezeichnung im Python-Input, während Trigema W. Grupp KG der aus dem Impressum extrahierte rechtliche Unternehmensname ist. Bei VAUDE gibt es dieselbe Unterscheidung: Der Input-Name lautet VAUDE, das zurückgegebene Unternehmen heißt VAUDE Sport GmbH & Co. KG. Wenn Du beide Werte speicherst, bleibt der in Deinem Team geläufige Name erhalten und wird gleichzeitig um die auf der Unternehmenswebsite angegebene juristische Person ergänzt. Das ist besonders hilfreich, wenn Du einen Lieferantendatensatz mit einer Rechnung, einem Vertrag oder einem anderen Unternehmensdatensatz vergleichst, in dem möglicherweise der längere rechtliche Name steht.
Die zurückgegebenen Felder beantworten unterschiedliche Fragen Deiner Recherche:
firstNameundlastNameenthalten den Namen der Geschäftsführung oder der Gründerperson, sofern er auf der Seite gefunden wurde. In diesem Beispiel sind das Wolfgang Grupp und Antje von Dewitz.postalAddressenthält die von der rechtlichen Seite extrahierte Geschäftsadresse. Die Felder für E-Mail und Telefon liefern die dort veröffentlichten Kontaktdaten.registrationNumberundvatNumberübernehmen die auf der Seite angegebenen Kennungen. Bei Trigema sind dasHRA 740365undDE144846566, bei VAUDEHRA 631071undDE203894755. So erhältst Du konkrete Werte, die Du mit den bereits in Deinen Lieferantendaten gespeicherten Kennungen vergleichen kannst.impressumUrlbezeichnet die für die Extraktion verwendete Seite. Dieses Feld ist von der übermittelten Startseite getrennt: Die eine URL dokumentiert das Unternehmen, mit dem Du begonnen hast, die andere die Quelle der rechtlichen Unternehmensdaten.
Beide Datensätze haben den Wert status: success und jeweils 10 Credits verbraucht. Der agentConfidenceScore ist ein Signal zwischen 0 und 100, mit dem Du die manuelle Prüfung priorisieren kannst. Er ist keine prozentuale Genauigkeitsangabe. Output-Felder können weiterhin leer bleiben, wenn ein Wert auf der Seite fehlt oder nicht extrahiert werden konnte. Bewahre daher den Status des Eintrags auf und öffne die zurückgegebene Impressums-URL, wenn eine Angabe für Deinen nächsten Schritt relevant ist.
Der dokumentierte Output kann außerdem Geschlecht, Telefonnummer und weitere Kontaktdaten enthalten. Das aktuelle Schema findest Du in der Dokumentation zur Impressum Scraper API.
Output in Lieferantendatensätze umwandeln
Der direkte API-Aufruf funktioniert bereits. Jetzt ordnen wir ihn in eine Lieferantenrecherche ein. Bei der Lieferantensuche oder beim Onboarding erhältst Du möglicherweise eine stabile ID, den von Deinem Team verwendeten Kurznamen und eine Startseite. Das Impressum-Ergebnis ergänzt das rechtliche Unternehmen hinter der Website, dessen veröffentlichte Kennungen und Kontaktdaten sowie die Seite, auf der diese Angaben gefunden wurden.
Das folgende Snippet indexiert die Ergebnisse anhand der inputId und erstellt lokale Datensätze für die Unternehmensrecherche. Füge es im vollständigen Skript direkt nach dem Aufruf von scrape_impressums() ein:
results_by_id = {
result["inputId"]: result for result in impressum_results
}
company_research = []
for supplier in suppliers:
result = results_by_id[supplier["id"]]
company_research.append(
{
"supplier_id": supplier["id"],
"supplier_label": supplier["label"],
"website_url": supplier["website_url"],
"status": result["status"],
"outputs": result.get("outputs", {}),
"credits_used": result["creditsUsed"],
"error": result.get("error"),
}
)
print(json.dumps(company_research, indent=2, ensure_ascii=False))Beim Trigema-Datensatz bleiben supplier-trigema, der Anzeigename Trigema und https://www.trigema.de erhalten. Das verschachtelte Objekt outputs ergänzt Trigema W. Grupp KG, die Adresse und Kennungen, den zurückgegebenen Namen Wolfgang Grupp sowie die URL des Quell-Impressums. Der VAUDE-Datensatz bildet dieselbe Kette ab: vom Namen VAUDE und der Startseite bis zu VAUDE Sport GmbH & Co. KG und der zugehörigen Quellseite. Damit kannst Du Datensätze nach dem rechtlichen Unternehmen vergleichen oder gruppieren, ohne die ursprüngliche Lieferantenidentität zu verlieren, die die Recherche ausgelöst hat.
Der Datensatz speichert die zurückgegebenen Angaben, den erfolgreichen API-Status, den Verbrauch von 10 Credits und den öffentlichen Fehlerwert zusammen mit Lieferanten-ID, Bezeichnung und Website.
Die entscheidende Regel beim Zusammenführen ist der Dictionary-Lookup über die Lieferanten-ID. So wird das richtige Ergebnis auch dann zugeordnet, wenn die API VAUDE vor Trigema zurückgibt. Das Snippet übernimmt außerdem nicht erfolgreiche Einzelergebnisse in company_research, da es nicht nach Status filtert. Ein Eintrag mit no_result oder error bleibt mitsamt ID und Fehler für Deine Prüfliste erhalten, statt einfach zu verschwinden.
Dieser Code bereitet lokale Recherchedatensätze vor. Du kannst die Liste serialisieren oder an Deinen eigenen nachgelagerten Code übergeben, ohne einen weiteren API-Aufruf auszuführen.
Kosten der API berechnen
Der Impressum Scraper kostet pauschal 10 Credits pro übermittelter Website. Die beiden Beispiel-Websites haben insgesamt 20 Credits verbraucht. Bei demselben Tarif benötigen 1.000 Websites 10.000 Credits.
Der Growth-Plan bietet Zugriff auf die REST API und enthält Subscription Credits. Bei Bedarf kannst Du mit optionalen Top-ups weitere Credits hinzufügen. Planzugriff, enthaltene Credits und zusätzliche Credit-Käufe sind separate Kostenbestandteile. Prüfe daher die aktuellen Datablist-Preise, bevor Du einen größeren Durchlauf planst.
Häufige Probleme ohne doppelte Kosten lösen
Das Skript stoppt vor dem ersten Request
Fehlt DATABLIST_API_KEY, löst das Skript den Fehler Set DATABLIST_API_KEY before running this script. aus. Exportiere die Variable im selben Terminal und führe die Datei erneut aus:
export DATABLIST_API_KEY="your-personal-api-key"
python scrape_impressum.pyDie API lehnt den Request ab
response.raise_for_status() stoppt bei einem HTTP-Fehler. Prüfe, ob Du einen gültigen Personal API Key angegeben hast und Dein Konto Zugriff auf die REST API besitzt. Dieser Fall unterscheidet sich von einer fehlenden Variable: Ein ungültiger Wert erreicht die API und erhält eine HTTP-Antwort.
Der Task schlägt fehl oder stoppt
Der ausgelöste Fehler enthält die Task-ID und den Status. Prüfe diesen bestehenden Task, seine Ergebnisse und die Credit-Felder, bevor Du einen neuen Task erstellst. Auch ein fehlgeschlagener oder gestoppter Task kann Ergebnisse und einen Credit-Verbrauch enthalten. Wenn Du ihn sofort wiederholst, zahlst Du möglicherweise doppelt für dieselbe Verarbeitung.
Ein Ergebnis ist unvollständig
Ein abgeschlossener Task kann Einzelergebnisse mit no_result, error oder unvollständigen Outputs enthalten. Bewahre inputId, status, die gegebenenfalls vorhandene impressumUrl und den öffentlichen error des Datensatzes auf. Prüfe anschließend, ob der Input wirklich die eigene Startseite oder Root-Domain des Unternehmens ist, und sieh Dir die Website an, bevor Du eine erneute Abfrage startest.
Die Task-Dokumentation erklärt Statuswerte, Ergebnispaginierung, Task-Verlauf, Limits und Aufbewahrungsfristen ausführlicher.
Nächste Schritte
Du hast jetzt eine direkt ausführbare Python-Requests-Integration, die deutsche Unternehmenswebsites übermittelt, auf den Task des Impressum Scrapers wartet, alle Ergebnisseiten abruft und strukturierte Unternehmensdaten samt Quell-URLs in lokalen Datensätzen für die Lieferantenrecherche speichert.
Ersetze die beiden Beispiel-Lieferanten durch Deine eigenen stabilen IDs und Website-URLs. Prüfe danach jede zurückgegebene impressumUrl, bevor Du die extrahierten Felder in nachgelagerten Prozessen verwendest. Du kannst das gepflegte synchrone Requests-Beispiel herunterladen oder zum asynchronen HTTPX-Beispiel im Repository wechseln, wenn Du nicht blockierende parallele Verarbeitung benötigst.