
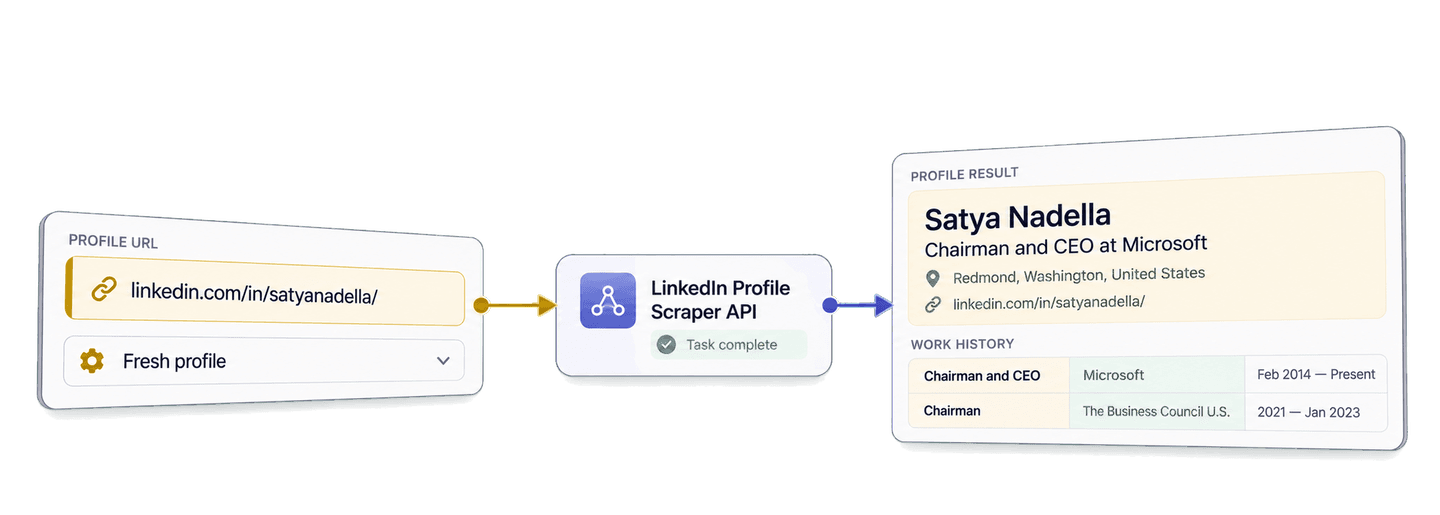
Vous pouvez scraper des profils LinkedIn en Python en envoyant des URL de profils publics connues à la LinkedIn Profile Scraper API de Datablist avec la bibliothèque Requests. L’API renvoie des données structurées sur l’identité, la localisation, le parcours professionnel, la formation et l’entreprise. Vous pouvez ainsi constituer des listes de leads et personnaliser votre outreach grâce à des informations pertinentes sur leurs postes et leurs entreprises.
Ce guide utilise l’URL du profil public de Satya Nadella comme exemple concis. Vous allez exécuter une tâche complète de scraping de profil, interpréter les informations renvoyées sur son poste chez Microsoft et ses expériences datées, puis associer le résultat au lead source avant de préparer votre outreach.
🔑 Résumé pour les plus pressés : envoyez à Datablist des URL connues de profils LinkedIn personnels et récupérez les données disponibles sur le profil, la localisation, le parcours professionnel, la formation et l’entreprise sous forme de JSON structuré. L’exemple Python ci-dessous conserve ces informations avec chaque lead source afin de qualifier votre liste et de préparer un outreach plus pertinent.
- Entrée : URL connues de profils LinkedIn personnels.
- Sortie : données de profil structurées, associées à chaque contact source.
💡 Vous préférez une solution no-code ? Utilisez le LinkedIn Profile Scraper de Datablist pour extraire les informations de profils à partir d’URL connues, sans écrire de code.
Configurer l’API Datablist et Python
L’accès à la REST API de Datablist est inclus dans le plan Growth. La récupération des profils consomme également des crédits d’enrichissement, dont le détail figure dans la section consacrée aux coûts.
Créez une Personal API Key depuis la page API de votre compte Datablist. Voici le format d’une Personal API Key :
auth0|exampleuser:exampleaccount:EXAMPLE_TOKEN_NOT_VALID:1Le script lit votre clé depuis la variable d’environnement DATABLIST_API_KEY et l’envoie dans le header X-API-Key.
Pour cet exemple Python, j’utilise le package requests. Les commandes de configuration suivantes sont destinées à un shell macOS ou Linux. Créez un dossier de projet, ouvrez-le dans votre terminal, puis exécutez :
python -m venv .venv
source .venv/bin/activate
python -m pip install requestsCréez ensuite un fichier nommé scrape_linkedin_profiles.py, puis exportez votre clé :
export DATABLIST_API_KEY="your-personal-api-key"Scraper un profil LinkedIn complet en Python
Dans ce tutoriel, l’enregistrement source contient un identifiant de contact stable et une URL de profil connue :
{
  "contact_id": "contact-satya-nadella",
  "profile_url": "https://www.linkedin.com/in/satyanadella/"
}
Le script transmet contact_id comme inputId à l’API. Les résultats ne sont pas nécessairement renvoyés dans le même ordre que les entrées. Cet identifiant permet donc d’associer de façon fiable chaque résultat à son contact source.
Collez le script complet suivant dans scrape_linkedin_profiles.py :
import json
import os
import time
import uuid
import requests
def scrape_profiles(source_contacts, api_key):
"""Submit one task, wait for completion, and return every result page."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": contact["contact_id"],
"data": {"profileUrl": contact["profile_url"]},
}
for contact in source_contacts
]
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "linkedin-profile-scraper",
"uniqueId": unique_id,
"settings": {
"experiencesNb": "5",
"educationsNb": "3",
"acceptCachedProfiles": False,
"includeUrn": False,
"includePictures": False,
},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
print(f"Task ID: {task_id}")
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
source_contacts = [
{
"contact_id": "contact-satya-nadella",
"profile_url": "https://www.linkedin.com/in/satyanadella/",
}
]
profile_results = scrape_profiles(source_contacts, api_key)
print(json.dumps(profile_results, indent=2))Exécutez-le avec :
python scrape_linkedin_profiles.pyLes settings demandent cinq expériences professionnelles et trois formations. L’API attend ces nombres sous forme de chaînes de caractères. acceptCachedProfiles: false demande une nouvelle récupération, tandis que les options relatives aux images et aux identifiants internes restent désactivées, car ce workflow repose sur des champs texte et URL durables.
Utilisez une URL publique standard de profil /in/ ou une URL de lead Sales Navigator pour chaque entrée. Le nom d’une personne, une page de recherche LinkedIn et une page d’entreprise correspondent à d’autres usages et ne constituent pas des entrées valides pour ce scraper. Si votre source contient des liens Sales Navigator, le champ profileUrl renvoyé peut contenir l’URL publique normalisée du profil. Pour une liste plus importante, attribuez à chaque inputId une valeur unique et stable au lieu de la déduire de la position de la ligne.
Les nombres d’éléments d’historique déterminent combien de champs professionnels et de formation, numérotés et à plat, l’API peut renvoyer. Ils ne modifient pas le tarif en crédits par profil. Demandez suffisamment d’historique pour prendre votre décision, mais évitez de sélectionner dix expériences si vous ne comptez examiner que les derniers postes.
À quoi servent les trois appels API
La requête POST envoie les settings sélectionnés et les profils à traiter. Datablist prend en charge le travail sous la forme d’une tâche en arrière-plan et renvoie son @id. Le script affiche à la fois le uniqueId généré et l’identifiant de la tâche renvoyé, afin que vous puissiez consulter celle-ci ultérieurement.
Le premier appel GET vérifie le statut de la tâche toutes les trois secondes. Le client Python reste bloqué pendant l’attente, mais la tâche API continue de s’exécuter en arrière-plan. La boucle s’arrête lorsque le statut devient completed, failed ou stopped.
Le second appel GET récupère les résultats par pages de 100 enregistrements maximum. Lorsque nextCursor contient une valeur, le script charge la page suivante. Il s’arrête lorsque nextCursor vaut null.
Lire les résultats et régler la récupération
L’URL transmise détermine le profil récupéré par le scraper. Datablist accepte les URL publiques de profils personnels et les URL de leads Sales Navigator, normalise au besoin l’URL du profil et organise les données publiques disponibles dans des champs à plat consacrés au profil, aux expériences, à la formation et à l’entreprise.
La nouvelle récupération utilisée dans ce guide s’est terminée correctement et a consommé 25 crédits. Voici le résultat complet :
{
  "inputId": "contact-satya-nadella",
  "status": "success",
  "outputs": {
    "profileUrl": "https://www.linkedin.com/in/satyanadella/",
    "fullName": "Satya Nadella",
    "firstName": "Satya",
    "lastName": "Nadella",
    "linkedInHeadline": "Chairman and CEO at Microsoft",
    "linkedInSummary": "As chairman and CEO of Microsoft, I define my mission and that of my company as empowering every person and every organization on the planet to achieve more.",
    "linkedInProfilePicture": "https://media.licdn.com/dms/image/v2/C5603AQHHUuOSlRVA1w/profile-displayphoto-shrink_800_800/profile-displayphoto-shrink_800_800/0/1579726625483?e=1794441600&v=beta&t=I1sL---bTuvjxqb1vdbNsNy-fAsLCpBj3-WtJjOGbOc",
    "linkedInInternalIdentifier": "ACoAAAEkwwAB9KEc2TrQgOLEQ-vzRyZeCDyc6DQ",
    "linkedInLocation": "Redmond, Washington, United States",
    "linkedInCity": "Redmond",
    "linkedInState": "Washington",
    "linkedInCountryName": "United States",
    "linkedInCountryCode": "US",
    "linkedInLanguages": "",
    "linkedInConnections": 832,
    "linkedInlastExpTitle": "Chairman and CEO",
    "linkedInlastExpCompany": "Microsoft",
    "linkedInlastExpEmploymentType": null,
    "linkedInlastExpLocation": "Greater Seattle Area",
    "linkedInlastExpStartsAt": "2014-02-01",
    "linkedInlastExpEndsAt": null,
    "linkedInlastExpDescription": null,
    "linkedInlastExpCompanyWebsite": "https://news.microsoft.com/",
    "linkedInlastExpCompanyPage": "https://www.linkedin.com/company/microsoft/",
    "linkedInlastExpCompanyIndustry": "Software Development",
    "linkedInlastExpCompanyRange": "10001+",
    "linkedInlastExpCompanyDescription": "Every company has a mission. What's ours? To empower every person and every organization to achieve more. We believe technology can and should be a force for good and that meaningful innovation contributes to a brighter world in the future and today. Our culture doesn’t just encourage curiosity; it embraces it. Each day we make progress together by showing up as our authentic selves. We show up with a learn-it-all mentality. We show up cheering on others, knowing their success doesn't diminish our own. We show up every day open to learning our own biases, changing our behavior, and inviting in differences. Because impact matters. \n\nMicrosoft operates in 190 countries and is made up of approximately 228,000 passionate employees worldwide.",
    "linkedInlastExpCompanyLogo": "https://media.licdn.com/dms/image/v2/D560BAQH32RJQCl3dDQ/company-logo_200_200/B56ZYQ0mrGGoAM-/0/1744038948046/microsoft_logo?e=1793836800&v=beta&t=4wXD40LQU4IfLY4DiEvT2bwvjUoPQPGgi5_T-vPsbQ8",
    "linkedIn2ExpTitle": "Chairman",
    "linkedIn2ExpCompanyName": "The Business Council U.S.",
    "linkedIn2ExpEmploymentType": null,
    "linkedIn2ExpStartsAt": "2021-01-01",
    "linkedIn2ExpEndsAt": "2023-01-01",
    "linkedIn2ExpDescription": null,
    "linkedIn2ExpLogo": "https://media.licdn.com/dms/image/v2/C4D0BAQGcnaZNpjMvrw/company-logo_200_200/company-logo_200_200/0/1630557702704/the_business_council_us_logo?e=1793836800&v=beta&t=Ejb0D8lV5sMTFwcz_-FKdfQvIvq-mKx_Nl8vRMib53k",
    "linkedIn3ExpTitle": "Member Board Of Trustees",
    "linkedIn3ExpCompanyName": "University of Chicago",
    "linkedIn3ExpEmploymentType": null,
    "linkedIn3ExpStartsAt": "2018-01-01",
    "linkedIn3ExpEndsAt": null,
    "linkedIn3ExpDescription": null,
    "linkedIn3ExpLogo": "https://media.licdn.com/dms/image/v2/D4E0BAQGDP-PXY3u8dw/company-logo_200_200/B4EaENqZTQGoAM-/0/1791230580227/uchicago_logo?e=1793836800&v=beta&t=NJGoETr0tY868Z2pvlyXeh939iXwW0WbSFwRctabEVU",
    "linkedIn4ExpTitle": "Board Member",
    "linkedIn4ExpCompanyName": "Starbucks",
    "linkedIn4ExpEmploymentType": null,
    "linkedIn4ExpStartsAt": "2017-01-01",
    "linkedIn4ExpEndsAt": "2024-01-01",
    "linkedIn4ExpDescription": null,
    "linkedIn4ExpLogo": "https://media.licdn.com/dms/image/v2/C4D0BAQEQxk9y2rk7Hw/company-logo_200_200/company-logo_200_200/0/1631316692275?e=1793836800&v=beta&t=NVjljhe0oI5KzvJHodAJjss5EdvxaOIzQQ2rAGyh_AQ",
    "linkedIn5ExpTitle": "Board Member",
    "linkedIn5ExpCompanyName": "Fred Hutch",
    "linkedIn5ExpEmploymentType": null,
    "linkedIn5ExpStartsAt": "2016-01-01",
    "linkedIn5ExpEndsAt": "2022-01-01",
    "linkedIn5ExpDescription": null,
    "linkedIn5ExpLogo": "https://media.licdn.com/dms/image/v2/D4D0BAQGF4eOou62nvQ/company-logo_200_200/company-logo_200_200/0/1664795263764/fredhutch_logo?e=1793836800&v=beta&t=dJWSO-KkuBPd6I6aRYBoIcQVzcSEmGLwqYy-VMFXJQc",
    "linkedInlastEduSchool": "The University of Chicago Booth School of Business",
    "linkedInlastEduDegree": null,
    "linkedInlastEduField": null,
    "linkedInlastEduStartsAt": "1994-01-01",
    "linkedInlastEduEndsAt": "1996-01-01",
    "linkedInlastEduPage": "https://www.linkedin.com/school/universityofchicagoboothschoolofbusiness/",
    "linkedInlastEduLogo": "https://media.licdn.com/dms/image/v2/D560BAQFZO05jhYKSkw/company-logo_200_200/company-logo_200_200/0/1692627816910/universityofchicagoboothschoolofbusiness_logo?e=2147483647&v=beta&t=BTjFA4UVU5iKIIyicg8d44rhoiuMbetNDB97BmqpwhQ",
    "linkedIn2EduSchool": "Manipal Institute of Technology",
    "linkedIn2EduDegree": "Bachelor’s Degree",
    "linkedIn2EduField": "Electrical Engineering",
    "linkedIn2EduStartsAt": null,
    "linkedIn2EduEndsAt": null,
    "linkedIn2EduPage": "https://www.linkedin.com/school/manipal-institute-of-technology/",
    "linkedIn2EduLogo": "https://media.licdn.com/dms/image/v2/D4D0BAQHodG_7cUqs6w/company-logo_200_200/B4DZ8hC8AUJQAE-/0/1782965846314/manipal_institute_of_technology_logo?e=2147483647&v=beta&t=jqJK15_r7lxUNgWdbbzdMq47aLa_PqnkDYxg4Jun4Zo",
    "linkedIn3EduSchool": "University of Wisconsin-Milwaukee",
    "linkedIn3EduDegree": "Master’s Degree",
    "linkedIn3EduField": "Computer Science",
    "linkedIn3EduStartsAt": null,
    "linkedIn3EduEndsAt": null,
    "linkedIn3EduPage": "https://www.linkedin.com/school/uwmilwaukee/",
    "linkedIn3EduLogo": "https://media.licdn.com/dms/image/v2/D4D0BAQE47QlO_LG8SQ/company-logo_200_200/company-logo_200_200/0/1729615751602/uwmilwaukee_logo?e=2147483647&v=beta&t=l-w3ttd1mZRc-_j5aCPXEzNiYJzl1iJjMGw7q8B3eRI"
  },
  "creditsUsed": "25",
  "error": null
}
Lisez ensemble l’intitulé du poste, l’employeur, la date de début et la date de fin. L’expérience chez Microsoft commence en février 2014 et ne comporte aucune date de fin. Celle au Business Council U.S. s’étend de 2021 à janvier 2023. Ces dates permettent de distinguer une expérience en cours d’une expérience terminée et montrent également que certains rôles peuvent se chevaucher.
linkedInlastExpTitle et linkedInlastExpCompany contiennent l’expérience actuelle ou la dernière expérience identifiée. Cette première expérience peut inclure des informations plus détaillées sur l’entreprise, comme sa page LinkedIn, son site web, son secteur, sa description et sa tranche d’effectifs. Les entrées numérotées ajoutent les intitulés, employeurs et dates des autres expériences. Dans cette réponse, le site de Microsoft renvoyé est https://news.microsoft.com/. Cette URL apporte à la fiche du lead une source utile sur l’entreprise, en complément de son parcours professionnel.
Les champs linkedInlastEduSchool, linkedIn2EduSchool et linkedIn3EduSchool mentionnent The University of Chicago Booth School of Business, Manipal Institute of Technology et University of Wisconsin-Milwaukee. L’entrée de Manipal comprend un Bachelor’s Degree en Electrical Engineering, tandis que celle de Wisconsin-Milwaukee indique un Master’s Degree en Computer Science. Le diplôme et le domaine d’études de Chicago ne sont pas renseignés.
Utilisez les valeurs "3", "5" ou "10" pour experiencesNb, et "1", "3" ou "5" pour educationsNb, selon la profondeur d’historique nécessaire. Lisez directement ces champs dans outputs lorsqu’ils sont utiles à vos recherches. Une valeur facultative vide ne signifie pas que l’ensemble du résultat a échoué.
Le mode fresh convient à la préparation de listes de leads lorsque vous souhaitez récupérer à nouveau les données publiques disponibles. Le mode cached peut renvoyer un profil déjà enregistré pour moins de crédits et, si aucun profil en cache n’est disponible, basculer vers une nouvelle récupération. Choisissez selon le niveau de fraîcheur souhaité et votre budget de crédits.
Préparer les fiches de leads pour l’outreach
Une fois profile_results disponible, vous pouvez rattacher chaque réponse à son contact source sans soumettre de nouvelle tâche. Le bloc suivant réutilise les variables créées par le script complet :
results_by_input_id = {
result["inputId"]: result
for result in profile_results
}
contact_research = []
for contact in source_contacts:
result = results_by_input_id[contact["contact_id"]]
contact_research.append(
{
"contact_id": contact["contact_id"],
"source_profile_url": contact["profile_url"],
"result_status": result["status"],
"profile": result.get("outputs", {}),
"credits_used": result["creditsUsed"],
"error": result.get("error"),
}
)
research_record = contact_research[0]
profile = research_record["profile"]
print("Contact:", profile.get("fullName"))
print("Headline:", profile.get("linkedInHeadline"))
print("Location:", profile.get("linkedInLocation"))
print(
"First work entry:",
profile.get("linkedInlastExpTitle"),
"at",
profile.get("linkedInlastExpCompany"),
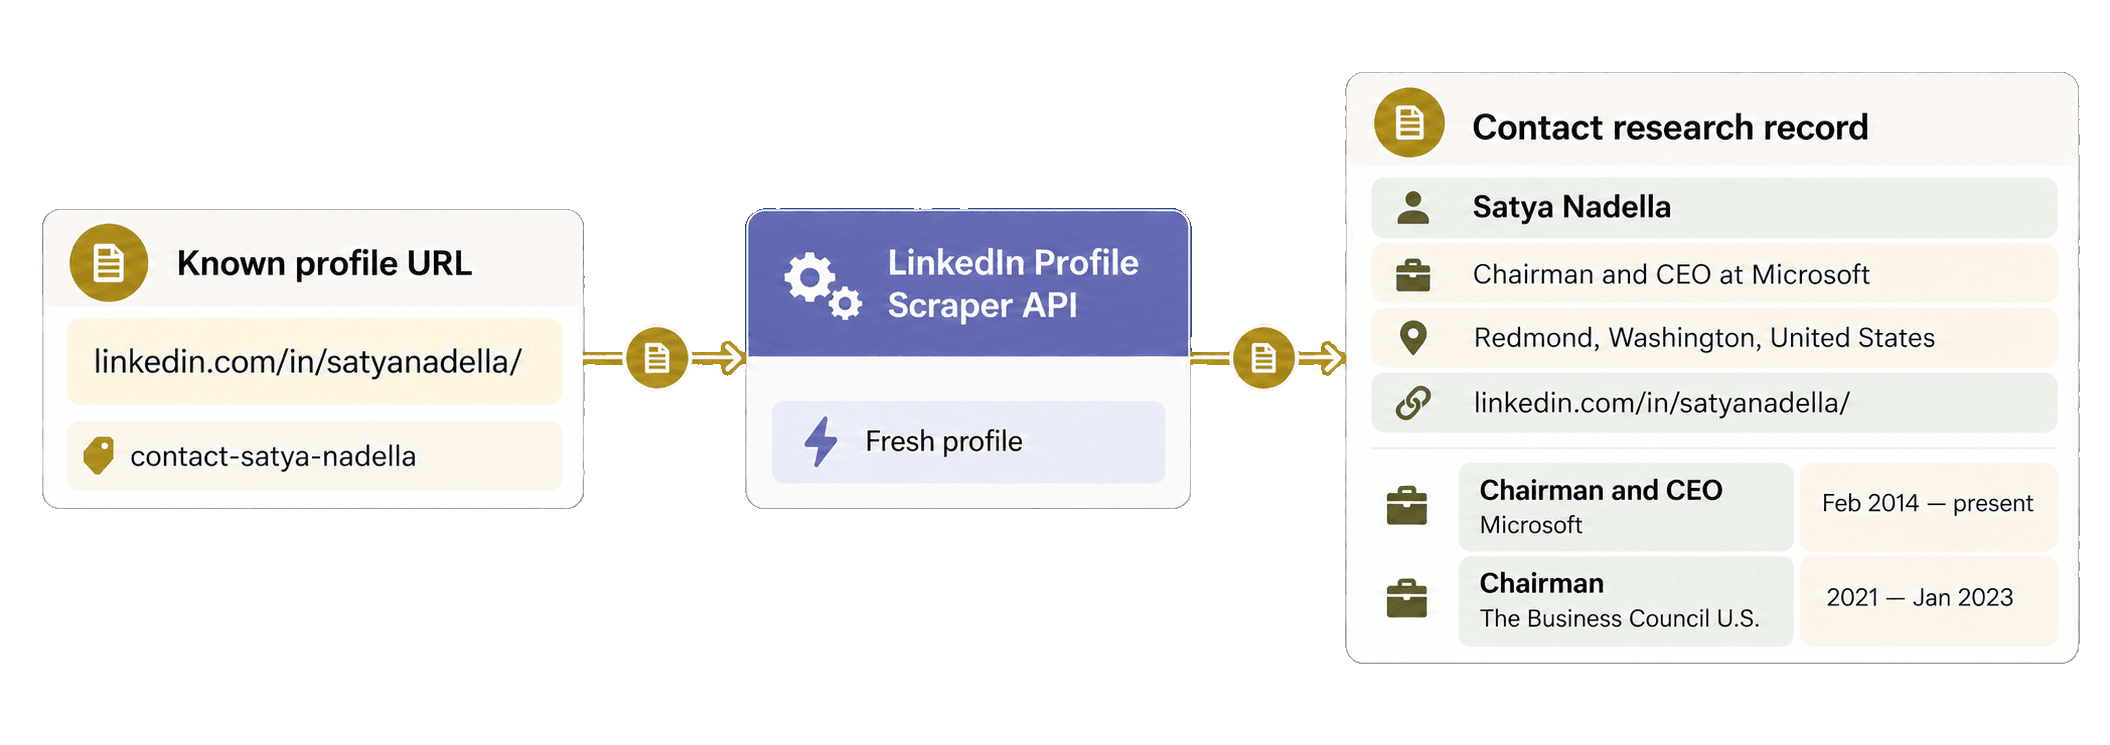
)Le dictionnaire indexé par inputId gère les réponses reçues dans un ordre différent de celui des entrées. contact-satya-nadella reste à la fois l’identifiant source et l’identifiant API, l’URL LinkedIn connue demeure dans source_profile_url, et profile conserve l’objet outputs d’origine sans le modifier.
Cette structure conserve l’intégralité du profil renvoyé avec l’URL source, le statut API et le nombre de crédits consommés. Vous pouvez utiliser la headline, la localisation et la première expérience affichées pour qualifier le lead et enrichir votre outreach avec un contexte pertinent sur son poste ou son entreprise. Les lignes API en échec conservent leur statut et leur erreur, ce qui permet de les repérer dans la liste de leads.
Vous pouvez télécharger l’exemple Requests bloquant maintenu ou utiliser l’alternative asynchrone avec HTTPX une fois le fonctionnement bloquant bien compris.
Estimer le coût du scraping de profils LinkedIn
Une nouvelle récupération consomme 25 crédits par profil. Lorsque les profils en cache sont activés, un résultat disponible en cache consomme 20 crédits. Si le cache ne contient aucun résultat, l’API peut tout de même effectuer une nouvelle récupération à 25 crédits. L’exemple fresh de Satya Nadella a consommé 25 crédits.
Pour 1 000 profils, la récupération consomme donc 20 000 crédits si tous les profils demandés sont disponibles en cache, ou jusqu’à 25 000 crédits pour de nouvelles récupérations. L’accès à la REST API de Datablist nécessite le plan Growth. L’abonnement, les crédits inclus et les recharges facultatives constituent des éléments de coût distincts. Consultez la page des tarifs pour connaître les offres actuelles.
En prenant comme exemple de planification le tarif de recharge actuel de 20 $ US pour 20 000 crédits, les crédits consommés représentent un coût estimé de 20 $ pour 1 000 profils tous disponibles en cache, ou de 25 $ pour de nouvelles récupérations. Ces estimations n’incluent pas le coût de l’abonnement Growth.
Corriger les erreurs courantes et récupérer une tâche
DATABLIST_API_KEYest absente : le script s’arrête avant d’envoyer une requête. Exportez la variable, puis relancez le fichier.- L’API refuse la clé : vérifiez la Personal API Key et envoyez uniquement l’identifiant
X-API-Keyutilisé dans cet exemple. - L’URL du profil est absente ou incorrecte : utilisez une URL publique de profil LinkedIn personnel ou une URL de lead Sales Navigator prise en charge. Le nom d’une personne, une page de recherche ou une page d’entreprise ne constitue pas une entrée de profil valide.
- Le solde de crédits est insuffisant : vérifiez votre solde, puis utilisez les crédits inclus ou ajoutez une recharge avant de créer une autre tâche.
- La tâche est
failedoustopped: examinez son erreur, les résultats disponibles et les crédits consommés avant de décider si une nouvelle soumission payante est nécessaire. - Un résultat est incomplet,
no_resultouerror: examinez son statut et l’erreur publique, puis vérifiez l’URL et les settings. Les champs disponibles peuvent varier selon le profil, sa visibilité et la récupération.
Si la connexion est interrompue pendant le POST, utilisez le uniqueId affiché avant la soumission. Listez les tâches récentes du scraper et comparez leurs valeurs avant d’en créer une autre :
response = requests.get(
"https://api.datablist.com/v1/enrichments/tasks",
headers={"X-API-Key": api_key},
params={"enrichmentId": "linkedin-profile-scraper", "limit": 100},
)
response.raise_for_status()
printed_unique_id = "paste-the-printed-unique-id"
tasks = response.json()["tasks"]
matching_task = None
for task in tasks:
if task["uniqueId"] == printed_unique_id:
matching_task = task
break
if matching_task:
print("Task ID:", matching_task["@id"])La liste des tâches peut être filtrée par enrichmentId, mais pas par uniqueId. Suivez son nextCursor si la tâche ne figure pas sur la première page. Une fois l’identifiant de la tâche retrouvé, poursuivez avec les mêmes URL de statut et de résultats que celles utilisées par la fonction principale. La documentation de l’API des tâches explique plus en détail le cycle de vie, la pagination et le comportement en cas d’interruption.
Prochaines étapes
Vous disposez maintenant d’une fonction Python Requests réutilisable qui transforme des URL connues de profils LinkedIn en résultats structurés, ainsi que de fiches de leads associées grâce à un identifiant stable. Remplacez l’exemple par un petit ensemble d’URL vérifiées, choisissez une récupération fresh ou cached selon vos besoins de fraîcheur et votre budget de crédits, puis exploitez les données sur les postes et les entreprises pour qualifier vos leads ou personnaliser votre outreach.
Si vous devez encore trouver les URL des profils à partir de noms et d’un mot-clé lié à une entreprise ou à un établissement, consultez le guide dédié pour trouver des profils LinkedIn en Python avec une API avant d’utiliser ce scraper.