
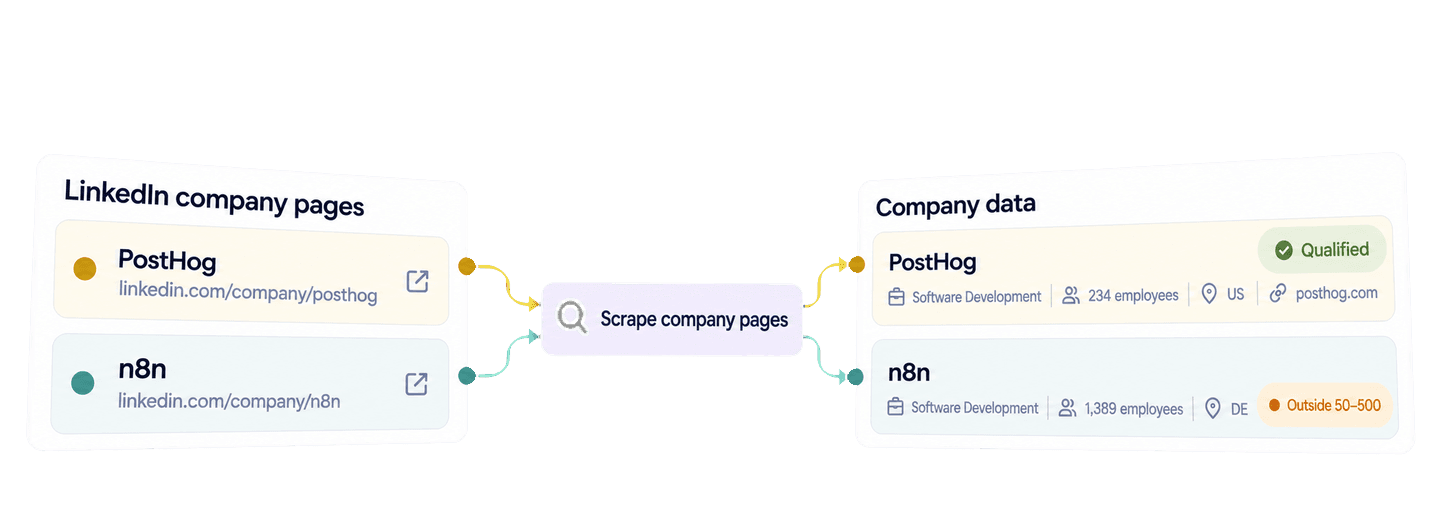
Vous pouvez scraper les données d’entreprises LinkedIn avec Python en envoyant une liste d’URL de pages d’entreprise à l’API de Datablist via la bibliothèque Requests. L’API renvoie des fiches d’entreprise structurées avec, lorsqu’elles figurent sur la page publique, des champs tels que le secteur d’activité, le nombre d’employés, le siège social, le site web et la description.
Dans ce guide, j’utilise une seule fonction Python facile à lire pour récupérer les fiches de n8n, PostHog, Back Market et Datablist. Je réutilise ensuite ces résultats pour qualifier les comptes d’entreprises technologiques comptant entre 50 et 500 employés et basées aux États-Unis ou en Allemagne. Chaque fiche qualifiée conserve son site web et sa description afin d’approfondir la recherche commerciale.
🔑 Résumé pour les plus pressés
Datablist transforme des URL vérifiées de pages d’entreprise LinkedIn en fiches structurées, prêtes à intégrer votre workflow de recherche commerciale. L’exemple Python ci-dessous récupère toutes les pages de résultats, puis applique un filtre de qualification local sans effectuer un second appel API.
- Entrée : URL de pages d’entreprise LinkedIn.
- Sortie : informations disponibles sur les entreprises et décision de qualification locale, avec l’URL d’origine et toutes les données de l’entreprise regroupées.
💡 Vous préférez une solution no-code ? Utilisez le LinkedIn Company Page Scraper de Datablist pour extraire les données d’entreprise à partir d’URL de pages LinkedIn connues, sans écrire de code.
Configurer Python et votre clé API Datablist
Pour cet exemple Python, j’utilise le package requests. L’API REST de Datablist est accessible avec le plan Growth, et chaque recherche de page d’entreprise consomme des crédits d’enrichissement.
Créez une Personal API Key depuis la page API de votre compte Datablist.
Créez un fichier nommé scrape_linkedin_companies.py, puis préparez un environnement virtuel et installez Requests :
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
export DATABLIST_API_KEY="your-api-key"Le script lit la clé depuis DATABLIST_API_KEY et l’envoie dans le header X-API-Key.
Scraper des pages d’entreprise LinkedIn avec Python
La liste source ci-dessous regroupe des entreprises de secteurs, de tailles et de pays différents. Chaque account_id devient l’inputId de l’API. Les résultats n’étant pas associés selon leur position dans la réponse, cet identifiant stable permet de relier chaque résultat à la bonne URL source.
Collez ce script complet dans scrape_linkedin_companies.py :
import json
import os
import time
import uuid
import requests
accounts = [
{
"account_id": "account-n8n",
"linkedin_company_url": "https://www.linkedin.com/company/n8n/",
},
{
"account_id": "account-posthog",
"linkedin_company_url": "https://www.linkedin.com/company/posthog/",
},
{
"account_id": "account-back-market",
"linkedin_company_url": "https://www.linkedin.com/company/back-market/",
},
{
"account_id": "account-datablist",
"linkedin_company_url": "https://www.linkedin.com/company/datablist/",
},
]
def scrape_companies(accounts, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": account["account_id"],
"data": {"companyLinkedInUrl": account["linkedin_company_url"]},
}
for account in accounts
]
unique_id = str(uuid.uuid4())
print(f"Request ID: {unique_id}")
payload = {
"enrichmentId": "linkedin-company-enrichment",
"uniqueId": unique_id,
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
print(f"Task ID: {task_id}")
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
company_results = scrape_companies(accounts, api_key)
print(json.dumps(company_results, indent=2, ensure_ascii=False))Exécutez-le avec :
python scrape_linkedin_companies.pyLes principales valeurs à modifier sont les fiches de accounts. Conservez un account_id stable et unique pour chacune d’elles, puis remplacez linkedin_company_url par l’URL vérifiée d’une page d’entreprise LinkedIn. La fonction convertit ces fiches au format inputs de l’API et transmet l’URL de l’entreprise dans companyLinkedInUrl. settings reste vide, car cet enrichissement ne propose aucun réglage public.
La requête POST crée une tâche d’enrichissement en arrière-plan. L’API répond avec le statut 202 Accepted et un identifiant de tâche, tandis que le client Requests interroge régulièrement l’URL de statut. Ce code Python bloquant est pratique pour un petit script, mais la tâche reste exécutée de manière asynchrone côté Datablist.
La première requête GET vérifie la tâche elle-même. Celle-ci peut se terminer avec le statut completed, failed ou stopped. Le script ne poursuit son exécution qu’après un statut completed. Dans les autres cas, il lève une erreur contenant l’identifiant de la tâche et l’erreur renvoyée par l’API. Conservez cet identifiant pendant votre diagnostic : même une tâche échouée ou interrompue peut avoir produit des résultats et consommé des crédits à vérifier.
Une fois la tâche terminée, la dernière boucle récupère les pages de résultats par lots de 100. Elle charge la page suivante jusqu’à ce que nextCursor soit égal à null. Chaque résultat conserve l’inputId fourni. La boucle de qualification peut donc associer correctement les résultats, même si l’ordre de la réponse diffère de celui des entrées.
Lire les résultats et comprendre la méthode de recherche
L’URL LinkedIn identifie directement l’entreprise. Datablist normalise cette URL d’organisation et récupère les données publiques disponibles sur sa page, au lieu de rechercher puis de noter plusieurs entreprises potentielles. Pour une URL d’entreprise nommée, le processus part de la page publique et peut compléter les champs manquants grâce à des sources de fallback gérées, tout en conservant les données pertinentes déjà trouvées.
Cette distinction est importante pour interpréter le résultat. Les champs facultatifs dépendent des informations accessibles publiquement. Une adresse de siège social égale à null ou une spécialité absente ne signifie pas que toute la recherche a échoué.
Voici la page de résultats complète renvoyée pour les quatre URL :
{
  "taskId": "69516a973dc34481920f41ade748e917",
  "results": [
    {
      "inputId": "account-n8n",
      "status": "success",
      "outputs": {
        "companyName": "n8n",
        "companyHQPostalCode": "10115",
        "companyDescription": "n8n is a workflow automation platform that uniquely combines AI capabilities with business process automation. The platform enables connection to any app or API while maintaining the flexibility of code with the speed of no-code.\n\nReleased under a fair-code license, n8n can be self-hosted and is supported by a vibrant community of developers and builders. Users can start simple and layer complexity as needed - utilizing the visual builder for quick wins, and adding custom Javascript or Python code where more control is required, enabling the connection of anything to everything.\n\nn8n is privately held, with funding from Sequoia, Felicis Ventures, Firstminute Capital, Harpoon Ventures, and others. Individual investors include Eventbrite's Kevin Hartz and Supercell's IIkka Paananen. n8n was founded in 2019 and is headquartered in Berlin.",
        "companyTagline": "Flexible AI workflow automation for technical teams.",
        "companyIndustry": "Software Development",
        "companySpecialities": "AI, SOAR, Workflow Automation, and AI agents",
        "companyWebsite": "https://n8n.io",
        "companyHQCity": "Berlin",
        "linkedInCompanyId": "28491094",
        "companyType": "Privately Held",
        "companyHQCountry": "DE",
        "companySize": 1389,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D4D0BAQEgEphZqatXwA/company-logo_200_200/B4DaFY.Sa2JcAE-/0/1792494086070/n8n_logo?e=2147483647&v=beta&t=NTL4C6f5QAd_o9nXd15PO8pOMSSEoms_tJdDHEo6eLk",
        "companyHQAddress": "Novalisstraße 10",
        "companyFoundedYear": 2019,
        "companyFollowerCount": 442229
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-posthog",
      "status": "success",
      "outputs": {
        "companyName": "PostHog",
        "companyHQPostalCode": null,
        "companyDescription": "At PostHog, we're working to increase the number of successful products in the world.\n\nUntil now, tools for building products have been fragmented. Product analytics, heatmaps, session recording, web analytics, feature flags, and A/B testing are all helpful, but no one wants to buy, send data to, and integrate multiple products.\n\nPostHog offers these tools (and more) in an integrated, open source platform which can be hosted in either the US or EU. Both versions are SOC2 certified, GDPR-ready, and HIPAA compliant. \n\nWe started PostHog during Y Combinator's W20 cohort and had the most successful B2B software launch on Hacker News since 2012 - with a product that was just 4 weeks old.\n\nWith over 100,000 users, we're default alive, growing 97% through word of mouth, and we are in the top 0.01% most popular repos on GitHub.",
        "companyTagline": "Your product's context layer. Get started with npx @posthog/wizard",
        "companyIndustry": "Software Development",
        "companySpecialities": "analytics, open source, product analytics, product, data, engineering, self-driving product, session replay, context warehouse, AI, product context, and error tracking",
        "companyWebsite": "https://posthog.com/",
        "companyHQCity": "San Francisco",
        "linkedInCompanyId": "37415928",
        "companyType": "Privately Held",
        "companyHQCountry": "US",
        "companySize": 234,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D560BAQGQUyE_CXUxIw/company-logo_200_200/B56aCMWEgaJAAE-/0/1789060991251/posthog_logo?e=2147483647&v=beta&t=WfTGRSqp5UfYL33sBXx3tZ1zmFUECfUPf7JtEGPAvbA",
        "companyHQAddress": null,
        "companyFoundedYear": 2020,
        "companyFollowerCount": 59696
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-back-market",
      "status": "success",
      "outputs": {
        "companyName": "Back Market",
        "companyHQPostalCode": null,
        "companyDescription": "The world is waking up to what fast tech costs. Back Market is where the revolution shops. \nWe make refurbished tech the smart, confident choice by building trust in quality, repair and circularity. New is not always better. Smarter is.\n\nAs a certified B Corp, our mission is to create a world that does more with what we already have by prolonging the lifespan of electronic devices through circularity and repair. We have grown by double digits year over year and now serve 18 million customers across 17 markets, avoiding more than 2 million tons of CO2 emissions*\n*Back Market calculation based on ADEME 2022 methodology.\n\nFounded in Paris in 2014 by Thibaud Hug de Larauze, Quentin Le Brouster and Vianney Vaute, Back Market is a leading global marketplace where people can buy professionally refurbished technology or trade in their devices.\n\nAre you ready to join us?",
        "companyTagline": "Where the world shops refurbished tech.",
        "companyIndustry": "Internet Marketplace Platforms",
        "companySpecialities": "refurbished tech, marketplace, sustainability, circularity, Right to Repair, sustainable solutions, refurbished marketplace, circular economy, and sustainable alternatives",
        "companyWebsite": "http://www.backmarket.com",
        "companyHQCity": "Paris",
        "linkedInCompanyId": "4793443",
        "companyType": "Privately Held",
        "companyHQCountry": "FR",
        "companySize": 1054,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D4E0BAQHRv6UClt5D2g/company-logo_200_200/B4EZnoUG3tKgAI-/0/1760539209613/back_market_logo?e=2147483647&v=beta&t=Pywpeu1Qs3h0Cl8kgvYurmBfXbImm5QIIc-aQog1MqM",
        "companyHQAddress": null,
        "companyFoundedYear": 2014,
        "companyFollowerCount": 101878
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-datablist",
      "status": "success",
      "outputs": {
        "companyName": "Datablist",
        "companyHQPostalCode": null,
        "companyDescription": "When people hear \"data,\" they think of something complicated. We will change this.\n\nDatablist is an AI-powered spreadsheet that helps you: get, manipulate, or clean data and create workflows that run automatically while you focus on what matters most.\n\nIf you want to separate Datablist.com into its main parts, you can say we have:\n\n- Deduplicating, grouping, and labeling data\n- Cleaning and editing data\n- Managing data and automated workflows\n- 50+ B2B data sources and scrapers\n- 3 AI agents:\n    - Editing assistant\n    - AI Research agent\n    - Deduplication assistant\n\nThe top 3 reasons why companies choose Datablist.com are:\n\n1. Simplicity: you don't need to have technical knowledge or experience with formulas to get everything out of it.\n2. Flexibility that allows you to do (almost) everything with your data and AI while keeping everything under your control.\n3. Scalability that no other solution can match. Up to 2 million rows—forget Excel.\n\nGo on try it for free!\n\nhttps://www.Datablist.com",
        "companyTagline": "Let your tasks become workflows: automated workflows.",
        "companyIndustry": "Information Technology & Services",
        "companyWebsite": "https://www.datablist.com",
        "companyHQCity": "Paris",
        "linkedInCompanyId": "69842428",
        "companyType": "Privately Held",
        "companyHQCountry": "FR",
        "companySize": 3,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/C4E0BAQFNFlMb8KEPRQ/company-logo_200_200/company-logo_200_200/0/1630622803412?e=2147483647&v=beta&t=UVkk7BOerChiWgS9Y06zOpT08SlK4kpAWGDYiVvUEVU",
        "companyFollowerCount": 134,
        "companyFoundedYear": 2020,
        "companyHQAddress": null
      },
      "creditsUsed": "25",
      "error": null
    }
  ],
  "nextCursor": null
}
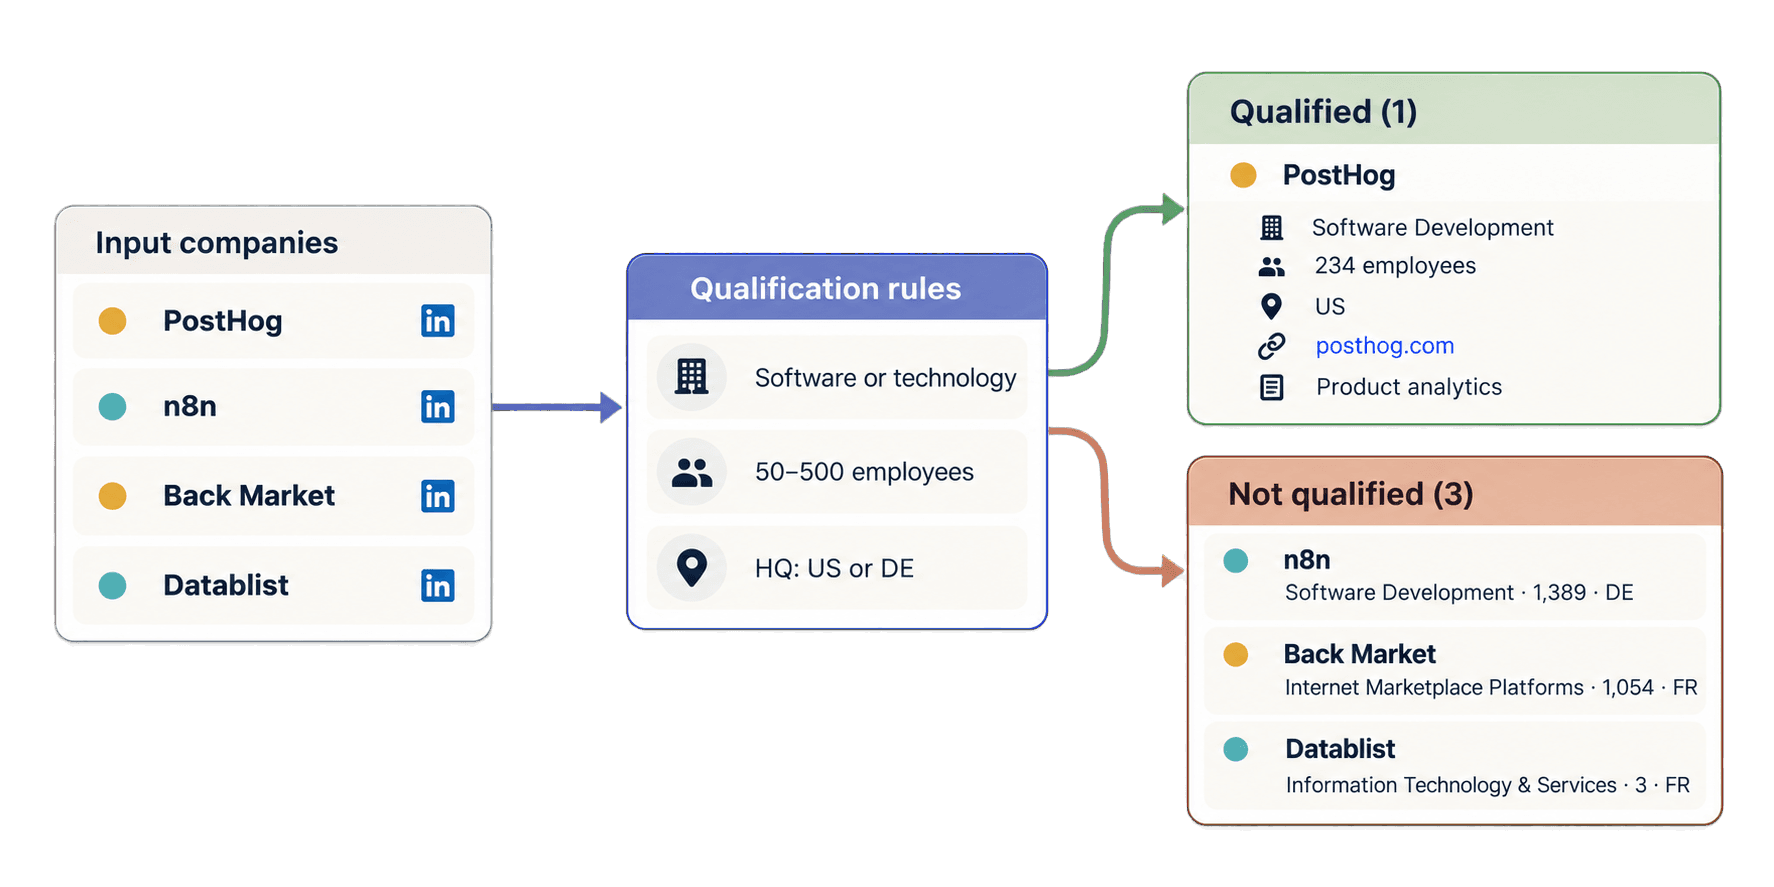
Les quatre lignes ont été traitées avec succès et ont consommé 25 crédits chacune. Pour PostHog, l’API a renvoyé Software Development, 234 employés, un siège aux États-Unis, ainsi que le site web et la description de l’entreprise. n8n est également une entreprise de logiciels située dans l’un des pays ciblés, mais son effectif renvoyé s’élève à 1 389 personnes. Back Market compte 1 054 employés, est basé en France et appartient au secteur Internet Marketplace Platforms. Datablist compte 3 employés, est basé en France et relève du secteur Information Technology & Services.
L’objet complet est utile, car la recherche sur un compte s’arrête rarement à un seul champ. Vous pouvez qualifier une entreprise selon son secteur, son effectif et son pays, tout en conservant le site web et la description exacts renvoyés pour l’étape de recherche suivante.
Dans cette réponse, companySize correspond au nombre d’employés renvoyé et non à une tranche d’effectif LinkedIn. companyHQCountry désigne le pays du siège social, et non tous les pays dans lesquels l’entreprise exerce ses activités. Ces nuances sont importantes lorsque vous adaptez les filtres d’effectif et de pays à votre profil client idéal.
Tous les champs facultatifs ne sont pas indispensables à la qualification. Une adresse ou une spécialité manquante peut rester vide si le secteur, le nombre d’employés et le pays du siège sont disponibles. Conservez companyWebsite tel qu’il est renvoyé au lieu de supposer que l’API le transforme en domaine nu. La description aide les équipes commerciales à comprendre l’offre de l’entreprise et à préparer une recherche propre à chaque compte avant la prise de contact. Lors de la vérification ou du stockage de la fiche, conservez les champs status, creditsUsed et error du résultat avec les données de l’entreprise.
Qualifier des comptes pour la prospection commerciale
Imaginons que vous cibliez des entreprises de logiciels ou de technologie comptant entre 50 et 500 employés et dont le siège se trouve aux États-Unis ou en Allemagne. Ajoutez la boucle suivante sous le script complet. Elle réutilise company_results et ne soumet donc aucune nouvelle tâche :
accounts_by_id = {account["account_id"]: account for account in accounts}
qualified_accounts = []
other_accounts = []
for result in company_results:
account = accounts_by_id.get(result["inputId"])
qualification = "needs_review"
if result["status"] == "success":
outputs = result["outputs"]
industry = outputs.get("companyIndustry")
company_size = outputs.get("companySize")
country = outputs.get("companyHQCountry")
if industry and isinstance(company_size, (int, float)) and country:
industry_matches = any(
keyword in industry.lower()
for keyword in ("software", "technology")
)
size_matches = 50 <= company_size <= 500
country_matches = country in {"US", "DE"}
if industry_matches and size_matches and country_matches:
qualification = "qualified"
else:
qualification = "not_qualified"
source_url = None
if account is not None:
source_url = account["linkedin_company_url"]
reviewed_account = dict(result)
reviewed_account["sourceLinkedInUrl"] = source_url
reviewed_account["qualification"] = qualification
if qualification == "qualified":
qualified_accounts.append(reviewed_account)
else:
other_accounts.append(reviewed_account)
print(json.dumps(qualified_accounts, indent=2, ensure_ascii=False))PostHog est bien réassocié à account-posthog, même si l’API renvoie les lignes dans un ordre différent. L’entreprise est qualifiée, car Software Development, 234 employés et US satisfont les trois critères. La boucle copie le résultat d’origine avec tous ses outputs, le site web https://posthog.com/, la description, creditsUsed et error. Elle ajoute uniquement l’URL source et le statut de qualification local.
n8n est réassocié à account-n8n, mais n’est pas qualifié, car ses 1 389 employés dépassent la limite supérieure. Back Market ne répond ni au critère de secteur, ni à celui de taille, ni à celui de pays. Datablist se situe sous la tranche d’effectif et hors des pays sélectionnés. Les futures lignes incomplètes ou en échec recevront le statut needs_review au lieu d’être supprimées silencieusement.
Vous pouvez télécharger l’exemple synchrone avec Requests, maintenu à jour, ou utiliser l’alternative asynchrone avec HTTPX du dépôt si votre application nécessite du code non bloquant.
Estimer les crédits du scraping d’entreprises LinkedIn
Une page d’entreprise LinkedIn standard avec un nom utilise 25 crédits. Une URL d’entreprise avec un identifiant numérique peut consommer 75 crédits si le dernier fallback est nécessaire, mais toutes les URL numériques ne coûtent pas systématiquement 75 crédits. Les recherches infructueuses ou sans correspondance peuvent également consommer des crédits. Utilisez donc le total de la tâche et la valeur creditsUsed de chaque résultat comme référence de la consommation réelle.
Les quatre URL nommées de ce guide ont consommé 100 crédits au total. Au tarif standard, 1 000 pages d’entreprise utilisent 25 000 crédits. Si vos entrées contiennent beaucoup d’identifiants numériques, prévoyez une marge pour les traitements susceptibles de coûter 75 crédits.
L’accès à l’API REST nécessite le plan Growth. L’abonnement mensuel comprend 20 000 crédits, et les crédits supplémentaires s’achètent séparément. Au tarif de base actuel de 20 $ US pour 20 000 crédits supplémentaires, un crédit coûte 0,001 $. À ce tarif, 25 000 crédits représentent 25 $. Consultez les tarifs Datablist pour connaître les offres et packs de crédits en vigueur.
Résoudre les problèmes d’entrée, de tâche et de résultat
DATABLIST_API_KEYest manquante : le script s’arrête avant d’envoyer une requête. Exportez la variable, puis relancez le fichier.- L’API refuse la clé : vérifiez votre Personal API Key et conservez-la dans le header
X-API-Keyutilisé par l’exemple. - L’URL source est invalide : remplacez tout profil personnel, site sans rapport, valeur vide ou URL mal formée par une URL publique prise en charge : page d’entreprise, d’établissement scolaire ou Showcase LinkedIn, identifiant numérique ou URL d’entreprise Sales Navigator.
- Le solde de crédits est insuffisant : vérifiez votre solde, puis utilisez les crédits inclus ou achetez des crédits supplémentaires avant de créer une nouvelle tâche.
- La tâche a le statut
failedoustopped: examinez son erreur, les résultats existants et les crédits consommés avant de décider s’il faut soumettre une autre tâche payante. - Un résultat est incomplet ou porte le statut
no_resultouerror: conservez son URL source, son statut, ses crédits et son erreur pour vérification. Avant de le soumettre à nouveau, vérifiez que l’entrée correspond bien à une page d’entreprise publique, sans chercher à deviner pourquoi les données n’étaient pas disponibles.
Si vous perdez la réponse de création, utilisez l’identifiant de requête affiché par le script avant la requête POST. Commencez par lister les tâches, puis recherchez cette valeur dans uniqueId :
curl "https://api.datablist.com/v1/enrichments/tasks?limit=100" \
-H "X-API-Key: $DATABLIST_API_KEY"Le champ @id de la tâche correspondante est son identifiant. Utilisez-le pour continuer à vérifier /v1/enrichments/tasks/{taskId} ou récupérer /v1/enrichments/tasks/{taskId}/results, au lieu de créer automatiquement une nouvelle tâche. Une requête peut contenir jusqu’à 10 000 entrées et 10 Mio. Consultez la documentation sur les tâches pour connaître la durée de conservation et les autres détails du cycle de vie.
Prochaines étapes
Vous disposez maintenant d’une fonction Python Requests réutilisable qui transforme une liste d’URL de pages d’entreprise LinkedIn en fiches structurées, ainsi que d’une boucle de qualification locale qui conserve l’intégralité des données renvoyées par l’API pour votre recherche commerciale.
Remplacez les quatre exemples par une petite liste de comptes vérifiés, conservez des identifiants stables et adaptez les critères de secteur, d’effectif et de pays à votre profil client idéal. Si votre point de départ est une liste de personnes plutôt que d’entreprises, consultez le guide de l’API de scraping de profils LinkedIn. Si vous ne disposez que des noms d’entreprise, commencez par trouver leurs sites web avec Python.