
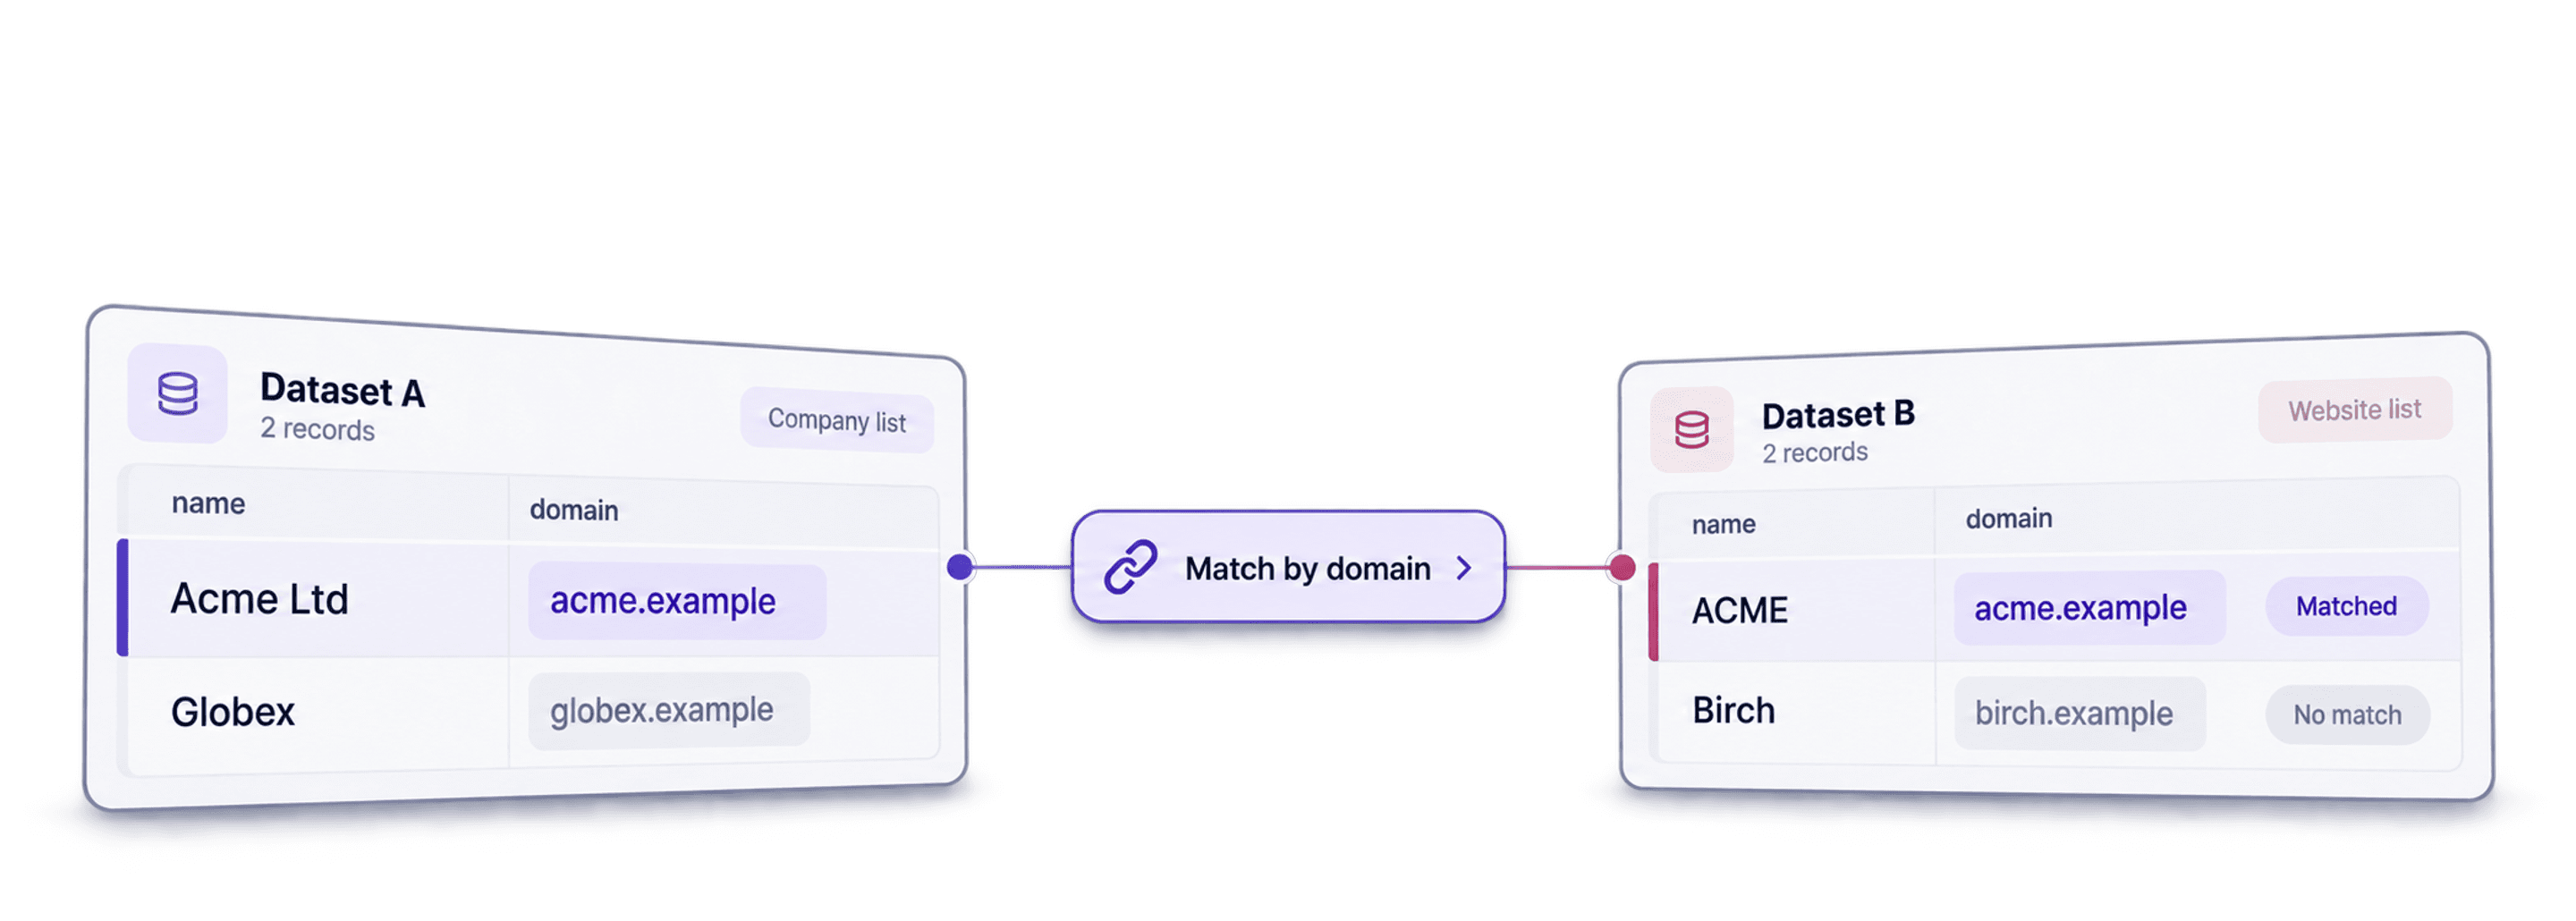
2つのリストに、同じ人物や企業がわずかに異なる名前で登録されている可能性がある場合は、データ照合ツールが役立ちます。Datablistでは、リストをcollectionにインポートし、比較するカラムをマッピングして照合アルゴリズムを選択した後、候補グループを確認してからマージまたはエクスポートできます。まずはメールアドレスや企業ドメインなど、一意性の高い識別子を使いましょう。安定した識別子がない場合に限り、名前のfuzzy matchingを使い、必ず2つ目のフィールドと照らし合わせて結果をご確認ください。
たとえば、一方のLeadリストにacme.comのAcme Ltd、もう一方に同じドメインのACMEが含まれているとします。この場合、名前が似ているという理由だけでなく、ドメインの一致を根拠にレコードを関連付ける方が確実です。DatablistのDuplicates Finderは、1つのcollection内でも、複数のcollection間でもレコードを比較し、確認用のグループとして表示できます。高度な音声照合とfuzzy matchingアルゴリズムは有料プランでご利用いただけます。
この記事で解説するデータ照合のポイントは次のとおりです。
マージする前に一致結果をご確認ください。 特に短い名前や略称では、よく似た名前が別の人物や企業を指している場合があります。
Step 1:データセットを読み込む
最初に、データセットをDatablistへ読み込みます。Datablistは、リスト管理に使えるオンラインツールです。CSVファイルの表示・編集に加え、Excelファイルにも対応しています。Leadリストの管理、顧客データのクレンジング、スクレイピングデータのクレンジングに最適です。
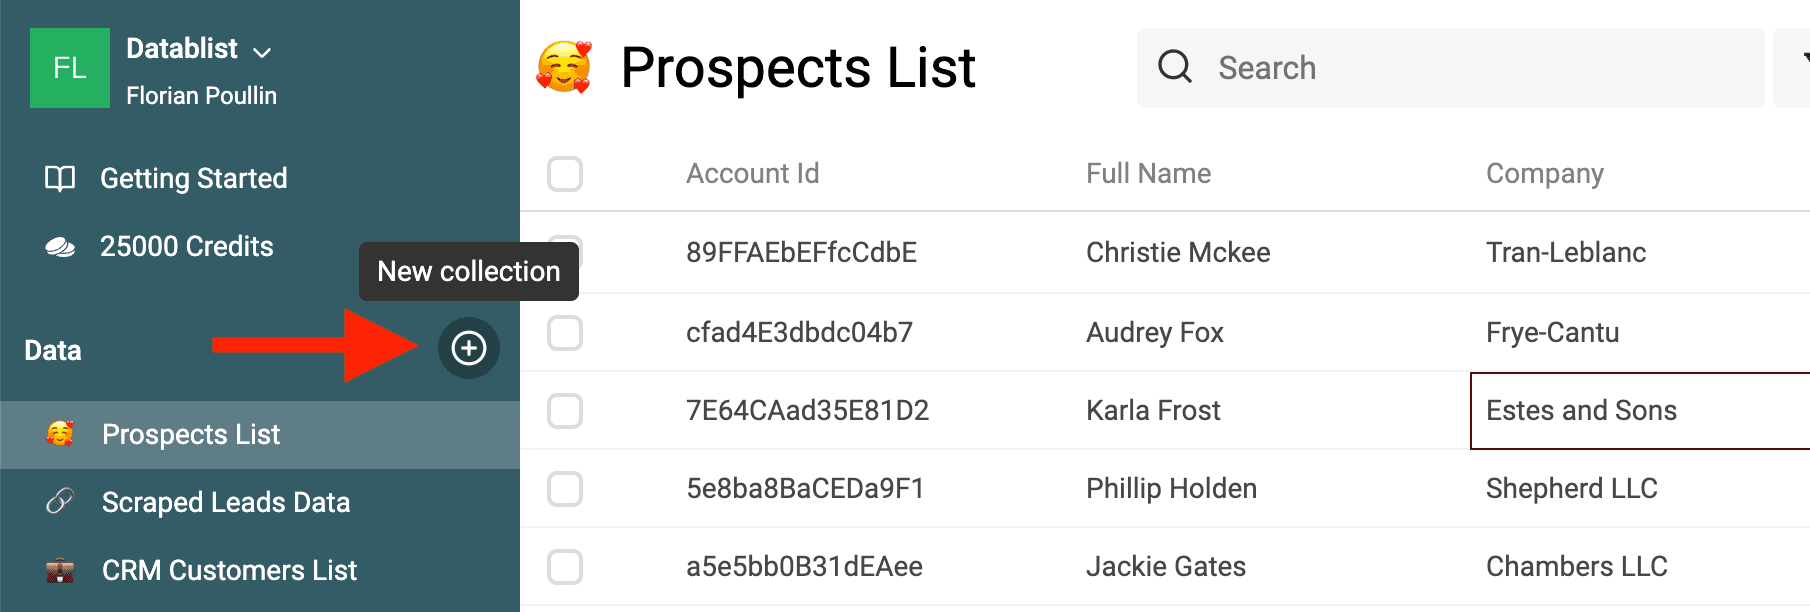
まず、最初のデータセットを読み込むためのcollectionを作成します。
次に、Importボタンをクリックします。
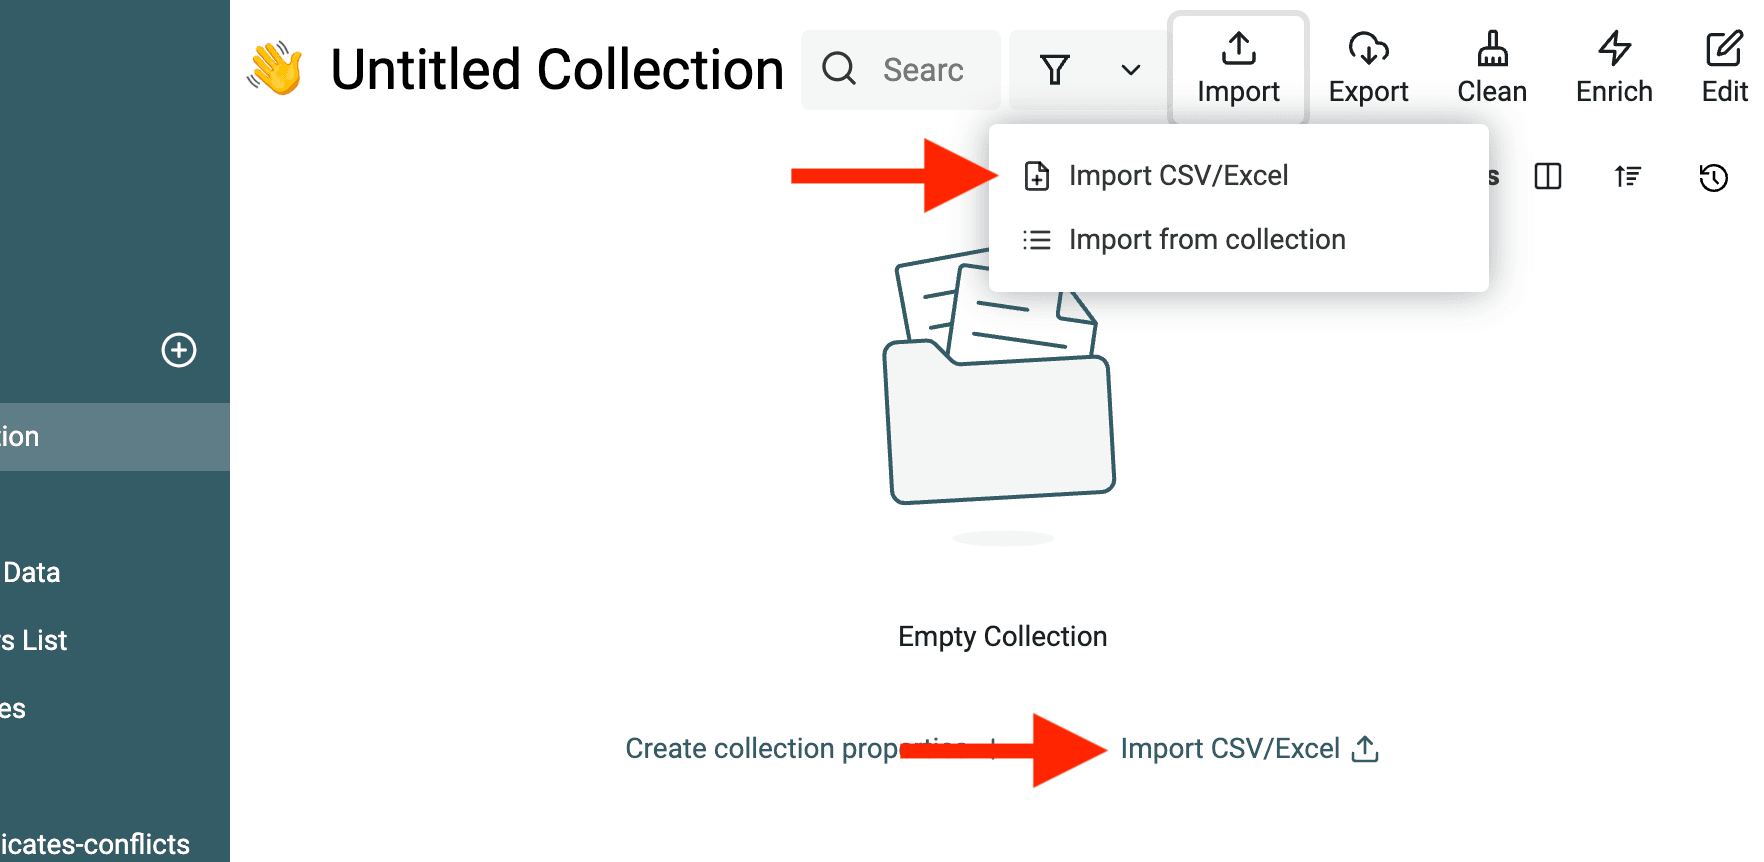
最初のデータセットをインポートした後は、次のいずれかを選べます。
- 共通のデータ構造を持つ別のデータセットを、同じcollectionへインポートする。
- 異なるデータ構造を持つデータセットを、新しいcollectionへインポートする。
DatablistのDuplicates Finderは、1つのcollection内にある一致レコードだけでなく、異なるデータ構造を持つ複数のcollection間でも一致レコードを検出できます。
Step 2:必要に応じてデータをクレンジングする
次のステップはData Cleansingです。データクレンジングは、正確で信頼できるデータ照合を行ううえで欠かせない準備作業です。汚れたデータや未整理のデータは、誤った一致や信頼性の低い結果につながります。つまり、データクレンジングがデータ照合の成功を左右します。
人物名や企業名に不要な文字列が含まれていても、情報としての価値はありません。それどころか、重複排除アルゴリズムが重複を検出できなくなる原因になります。
Datablistには、次のデータクレンジングツールが標準で用意されています。
- 記号と句読点を削除 - スクレイピングしたテキストには、顔文字やASCII記号、句読点を含む名前が混在する場合があります。Datablistの照合アルゴリズムはデータ照合時にこれらを無視しますが、重複排除処理での自動マージを妨げる可能性があります。
- 余分なスペースを削除 - 単語間にスペースが1つ多いだけでも、2つの文字列は別の値として扱われます。Datablistの照合アルゴリズムは前処理で余分なスペースを除去しますが、これらのスペースは重複排除処理の自動マージを妨げることがあります。
- テキストからメールアドレスやURLなどを抽出 - メールアドレス、URL、メンション、タグなどを含む非構造化テキストがある場合は、Data Extractorで該当要素を抽出し、データを構造化できます。照合対象が構造化されていれば、データ照合も容易になります。
- HTMLタグを削除 - HTMLタグを含む文字列をプレーンテキストへ変換できます。これにより、HTMLタグを含むスクレイピングリストも、ほかのデータセットと照合できます。
- テキストをDateTime、Number、Booleanなどに変換 - Datablistは、DateTime、Number、Booleanなどのネイティブ形式に対応しています。生のテキストを適切な形式へ変換することは、データクレンジングの重要な工程です。最新の日付を持つレコードを選ぶ場合など、値の比較によってマスターレコードを決める高度なマージルールでは、ネイティブのDateTimeやNumberが欠かせません。
- 大文字・小文字を変換して表記を統一 - 大文字・小文字の変換はシンプルですが、必要な処理です。Datablistには複数の変換アルゴリズムが組み込まれています。
- プロパティを分割または結合 - 複数の値を持つデータの処理に適した機能です。カンマ、セミコロン、スペースで区切られた複数のメールアドレスが1つのプロパティに入っている場合、DatablistのSplit Propertyツールで、メールアドレスごとにプロパティを分けられます。
- 空の値を削除または置換 - Datablistのフィルタリング機能を使って、空の値や空行を絞り込めます。
詳しい使用例と手順は、データクレンジングガイドをご覧ください。
人物名を正規化する
人物データセットの処理は、Data Deduplicationでよく発生します。顧客、Lead、prospectのデータセットが代表例です。理想的には、人物データの照合にはメールアドレスや個人識別番号などの一意な識別子を使います。一意な識別子がない場合や、複数のデータセットをまたいで人物を照合する場合は、氏名を利用する必要があります。
氏名を事前処理して表記を統一すると、重複排除時のエラーを減らせます。
氏名から不要な文字列を削除する
氏名の表記には大きなばらつきがあります。ニックネーム、略称、別のつづり、特殊文字などが代表的です。
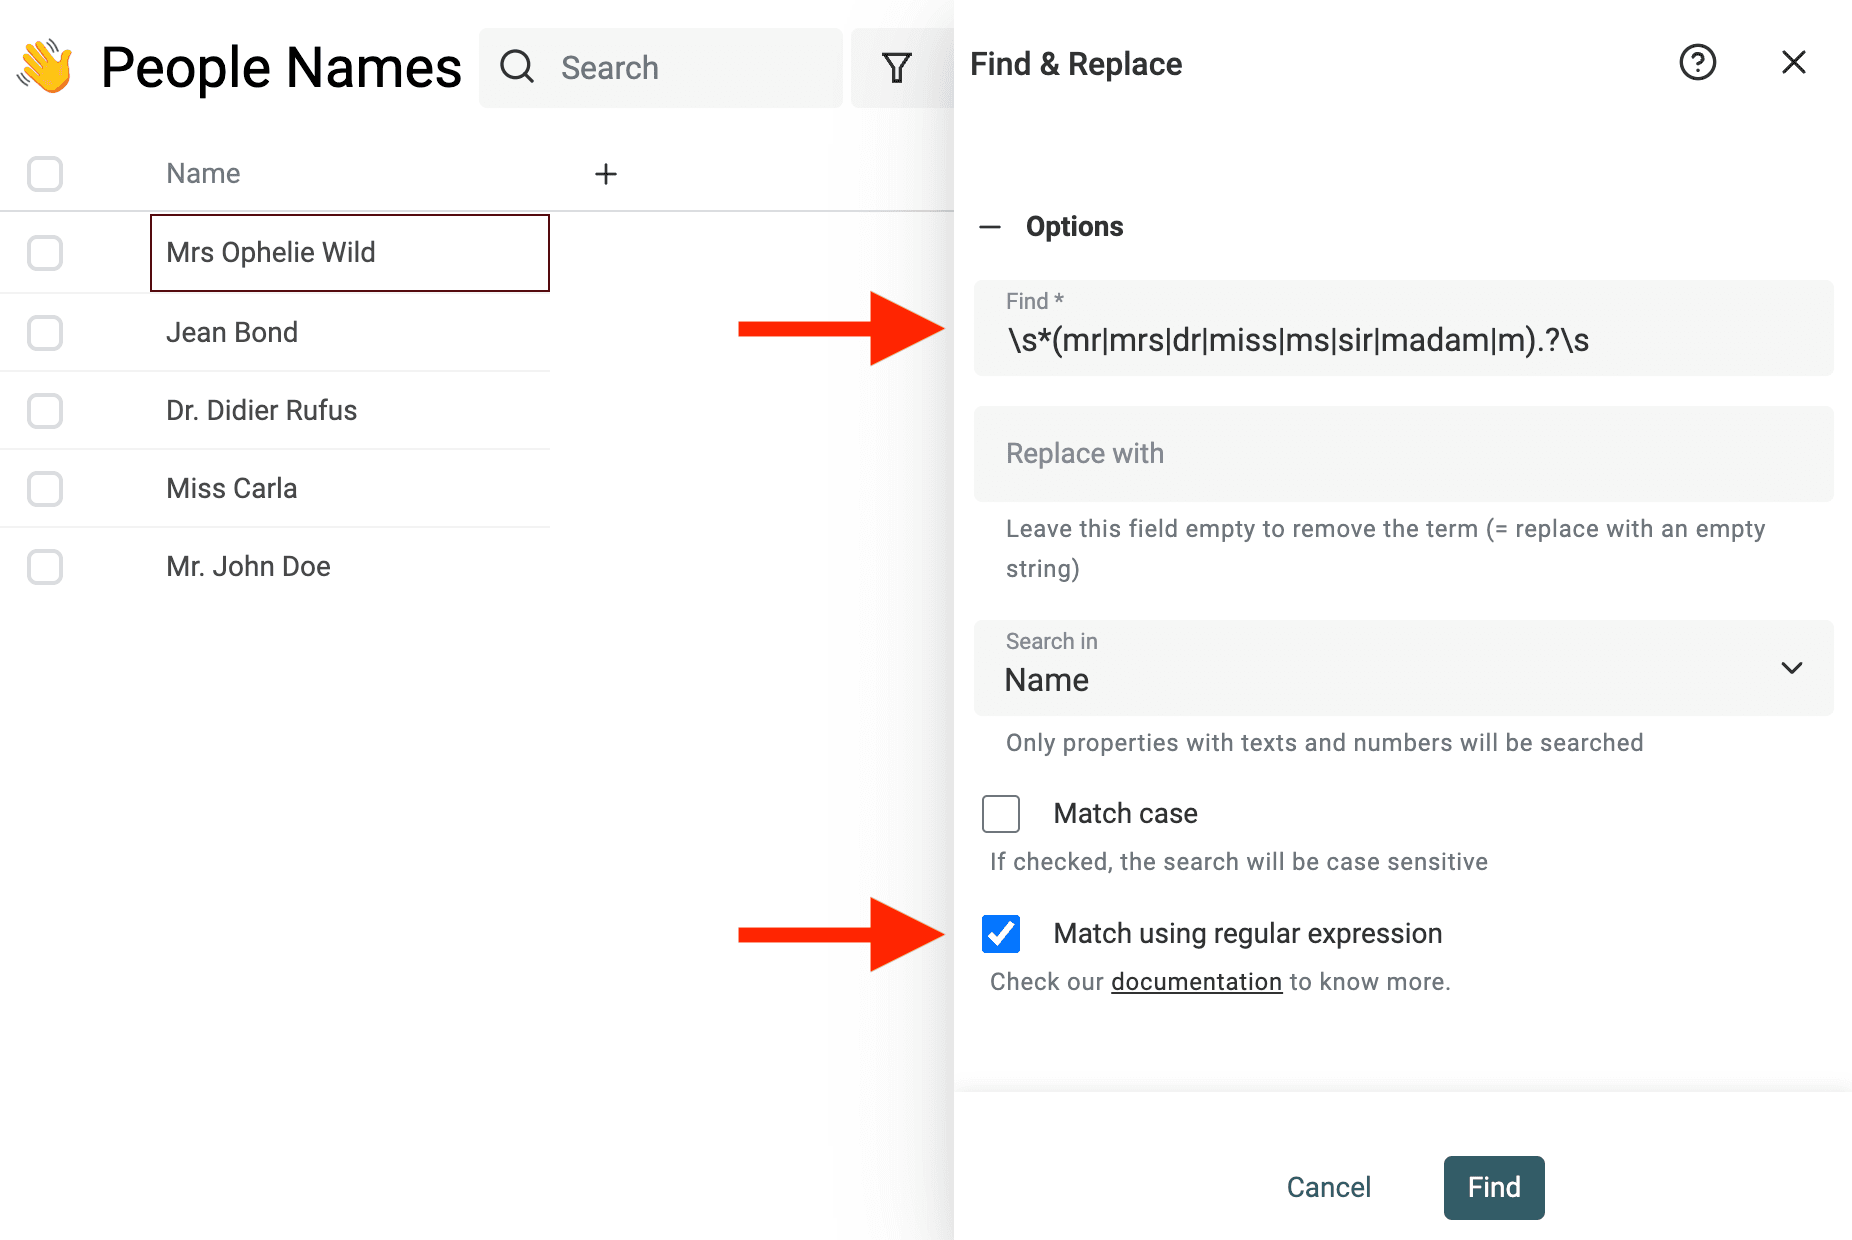
高機能なFind & Replace toolを使えば、接頭辞、接尾辞、stop words、地域情報、その他の不要な単語を削除できます。
たとえば、敬称を削除する場合は、次の正規表現を使用できます。
^\s*(mr|mrs|dr|miss|ms|sir|madam|m).?\s
置換後の文字列は空欄にします。
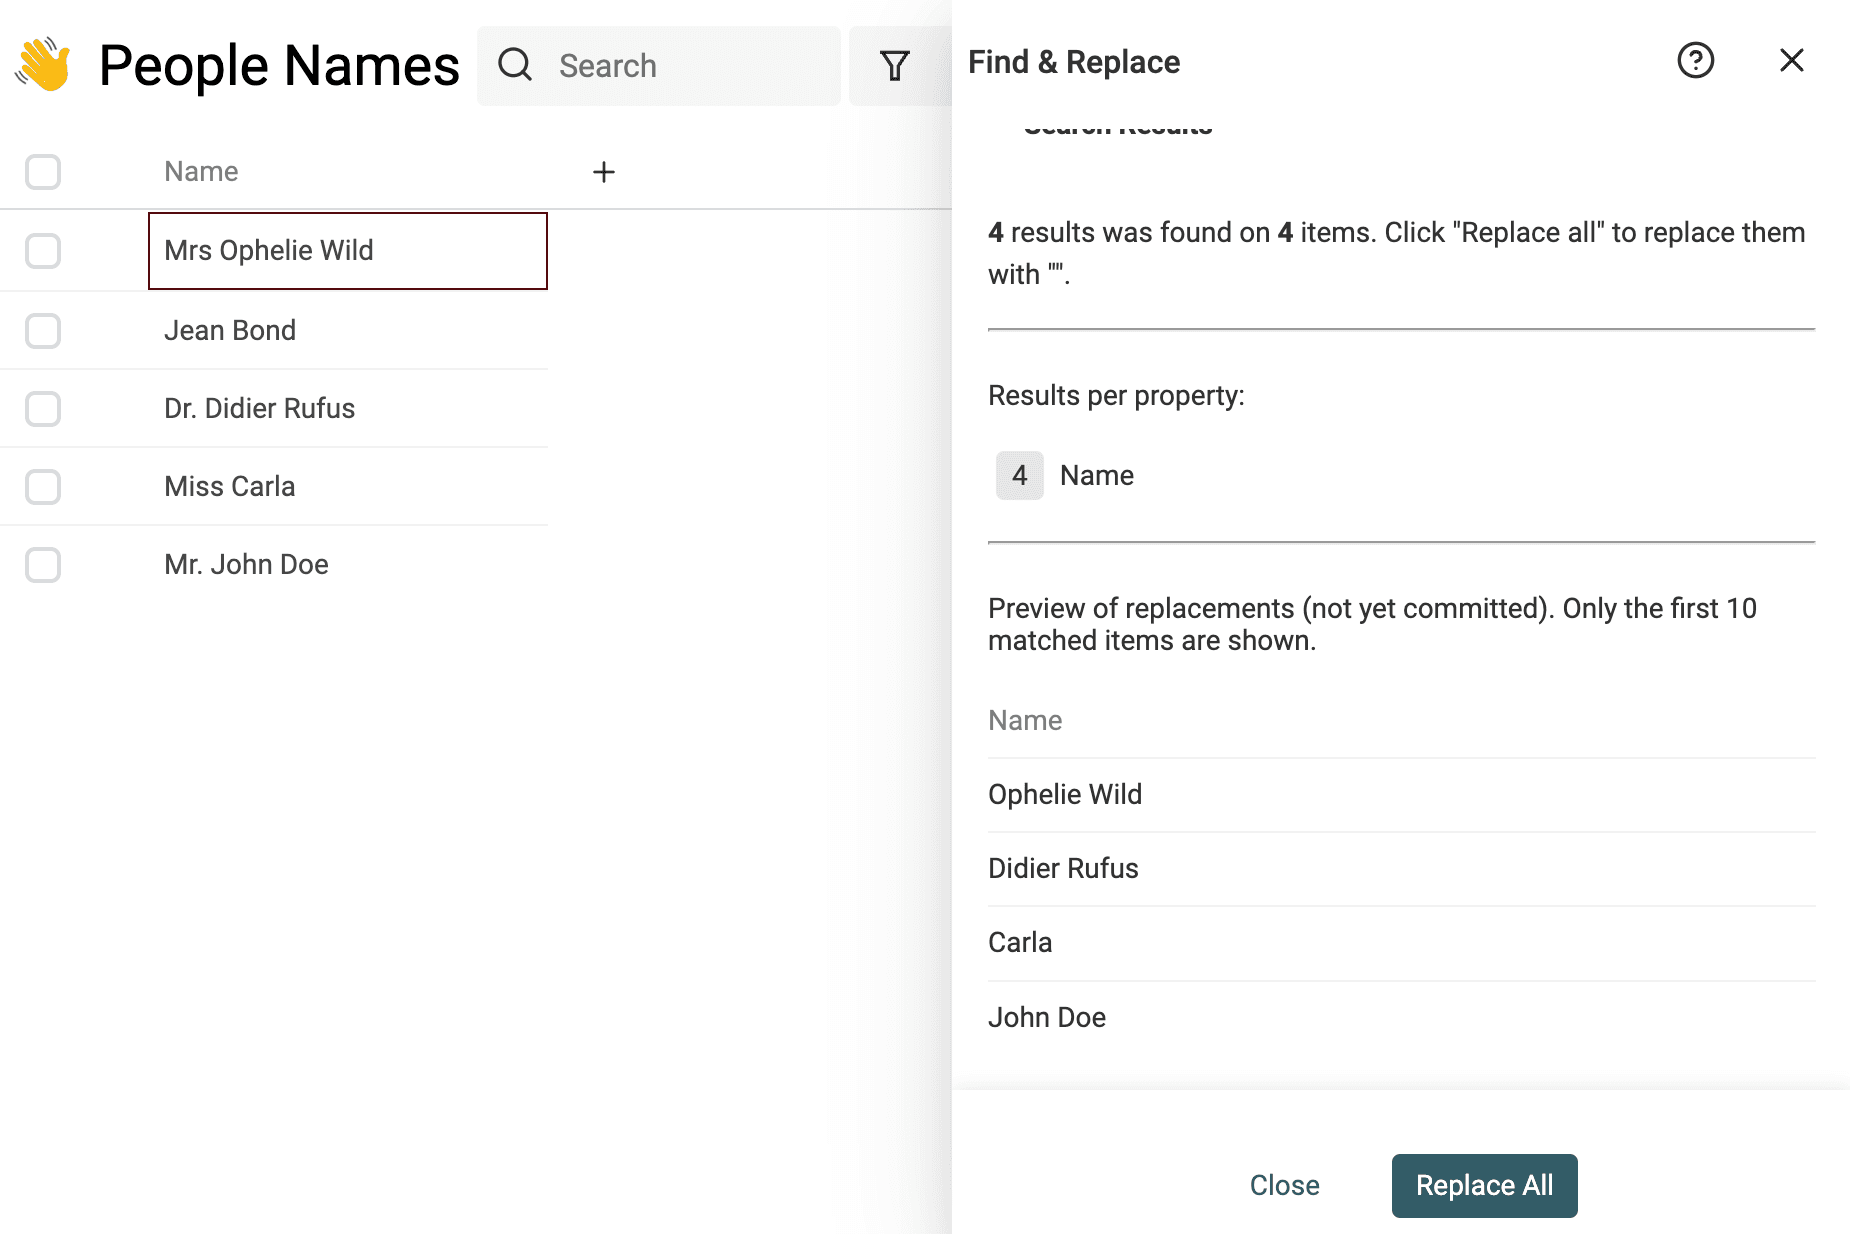
注記 正規表現に詳しくない場合は、お気軽にお問い合わせください。データクレンジングをサポートいたします。
フルネームを各要素に分割する
Datablistは単なるデータクレンジングツールではなく、データエンリッチメントにも対応しています。Lead enrichmentや、DeepLを使ったCSV翻訳などがその例です。
Name Parserは、氏名のクレンジングに適したenrichmentです。フルネームを受け取り、名、ミドルネーム、姓に分割します。さらに、その氏名で一般的な性別と国も返します。
フルネームの分割には統計データが使用されます。
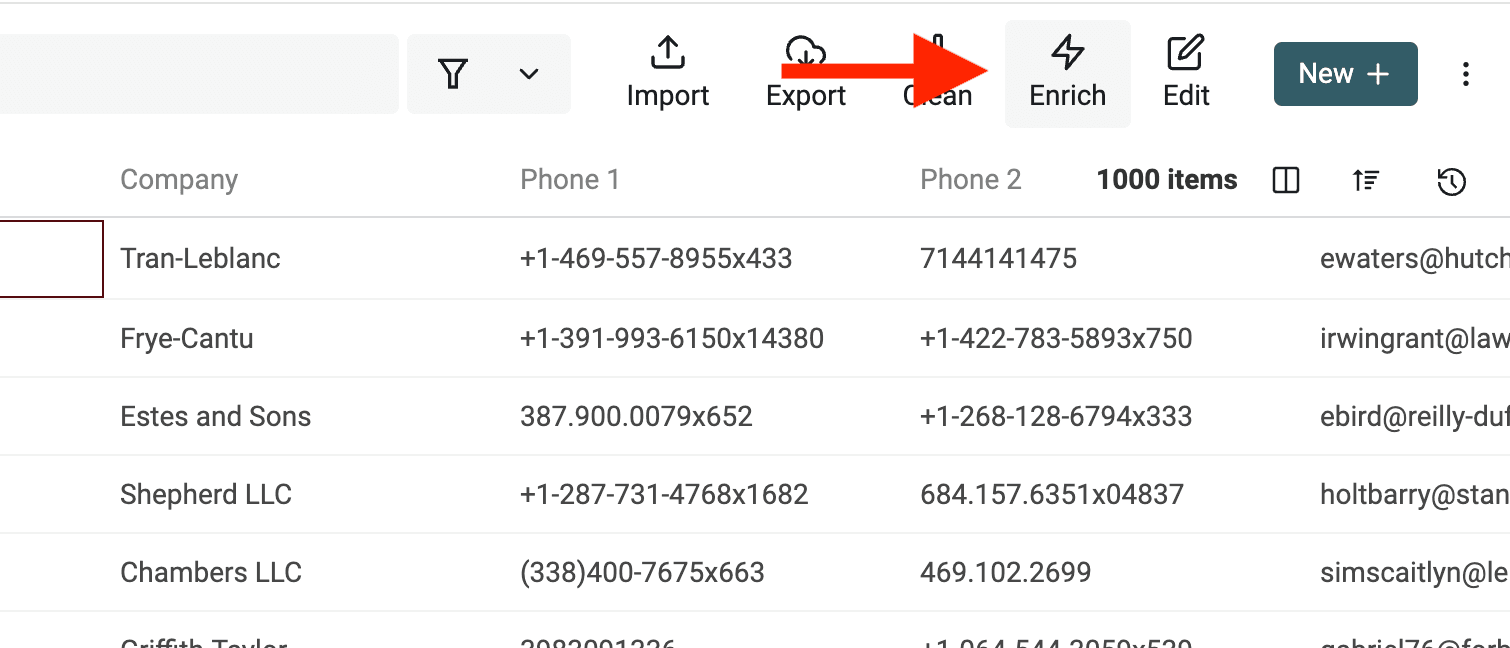
利用するには、画面上部のボタンから「Enrich Menu」を開きます。
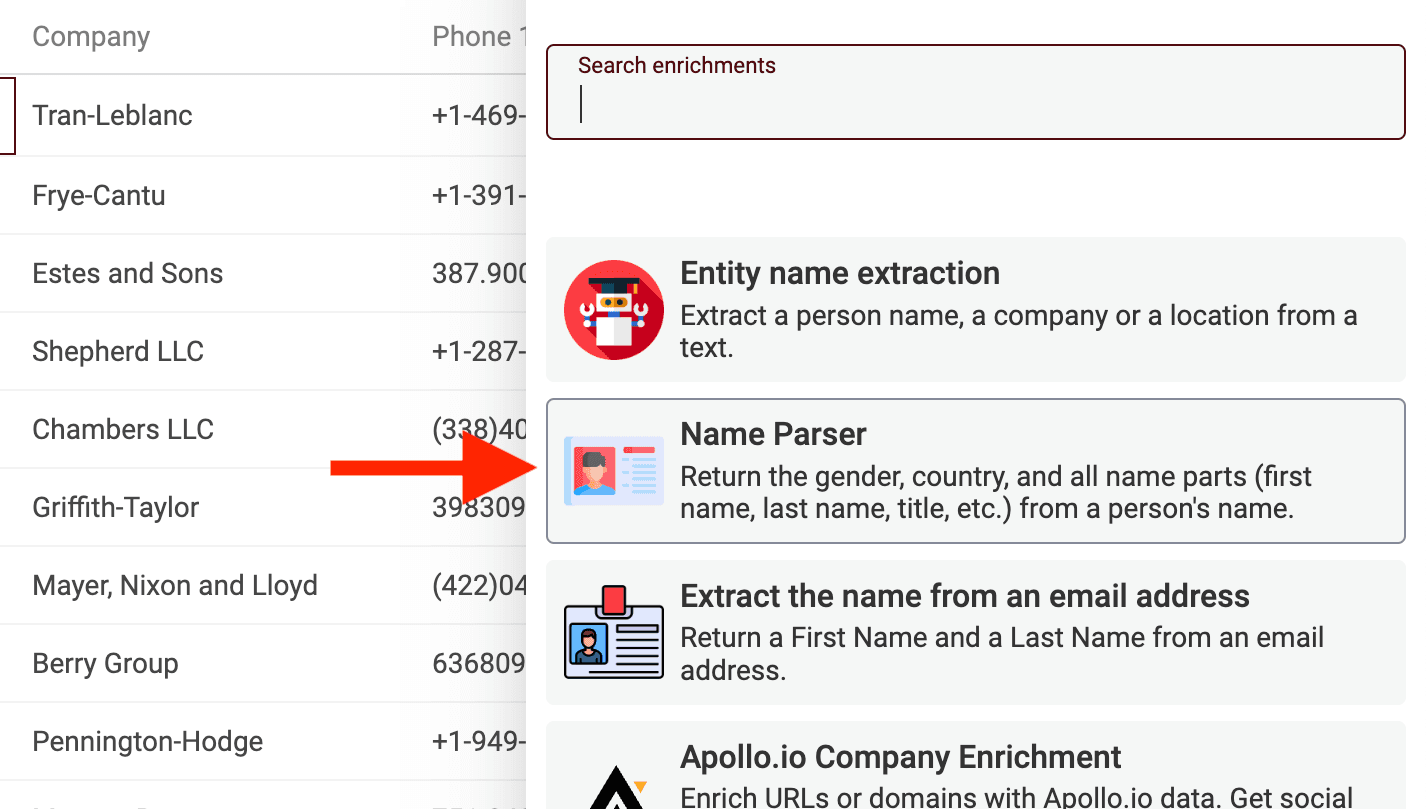
続いて「Name Parser」を選択します。
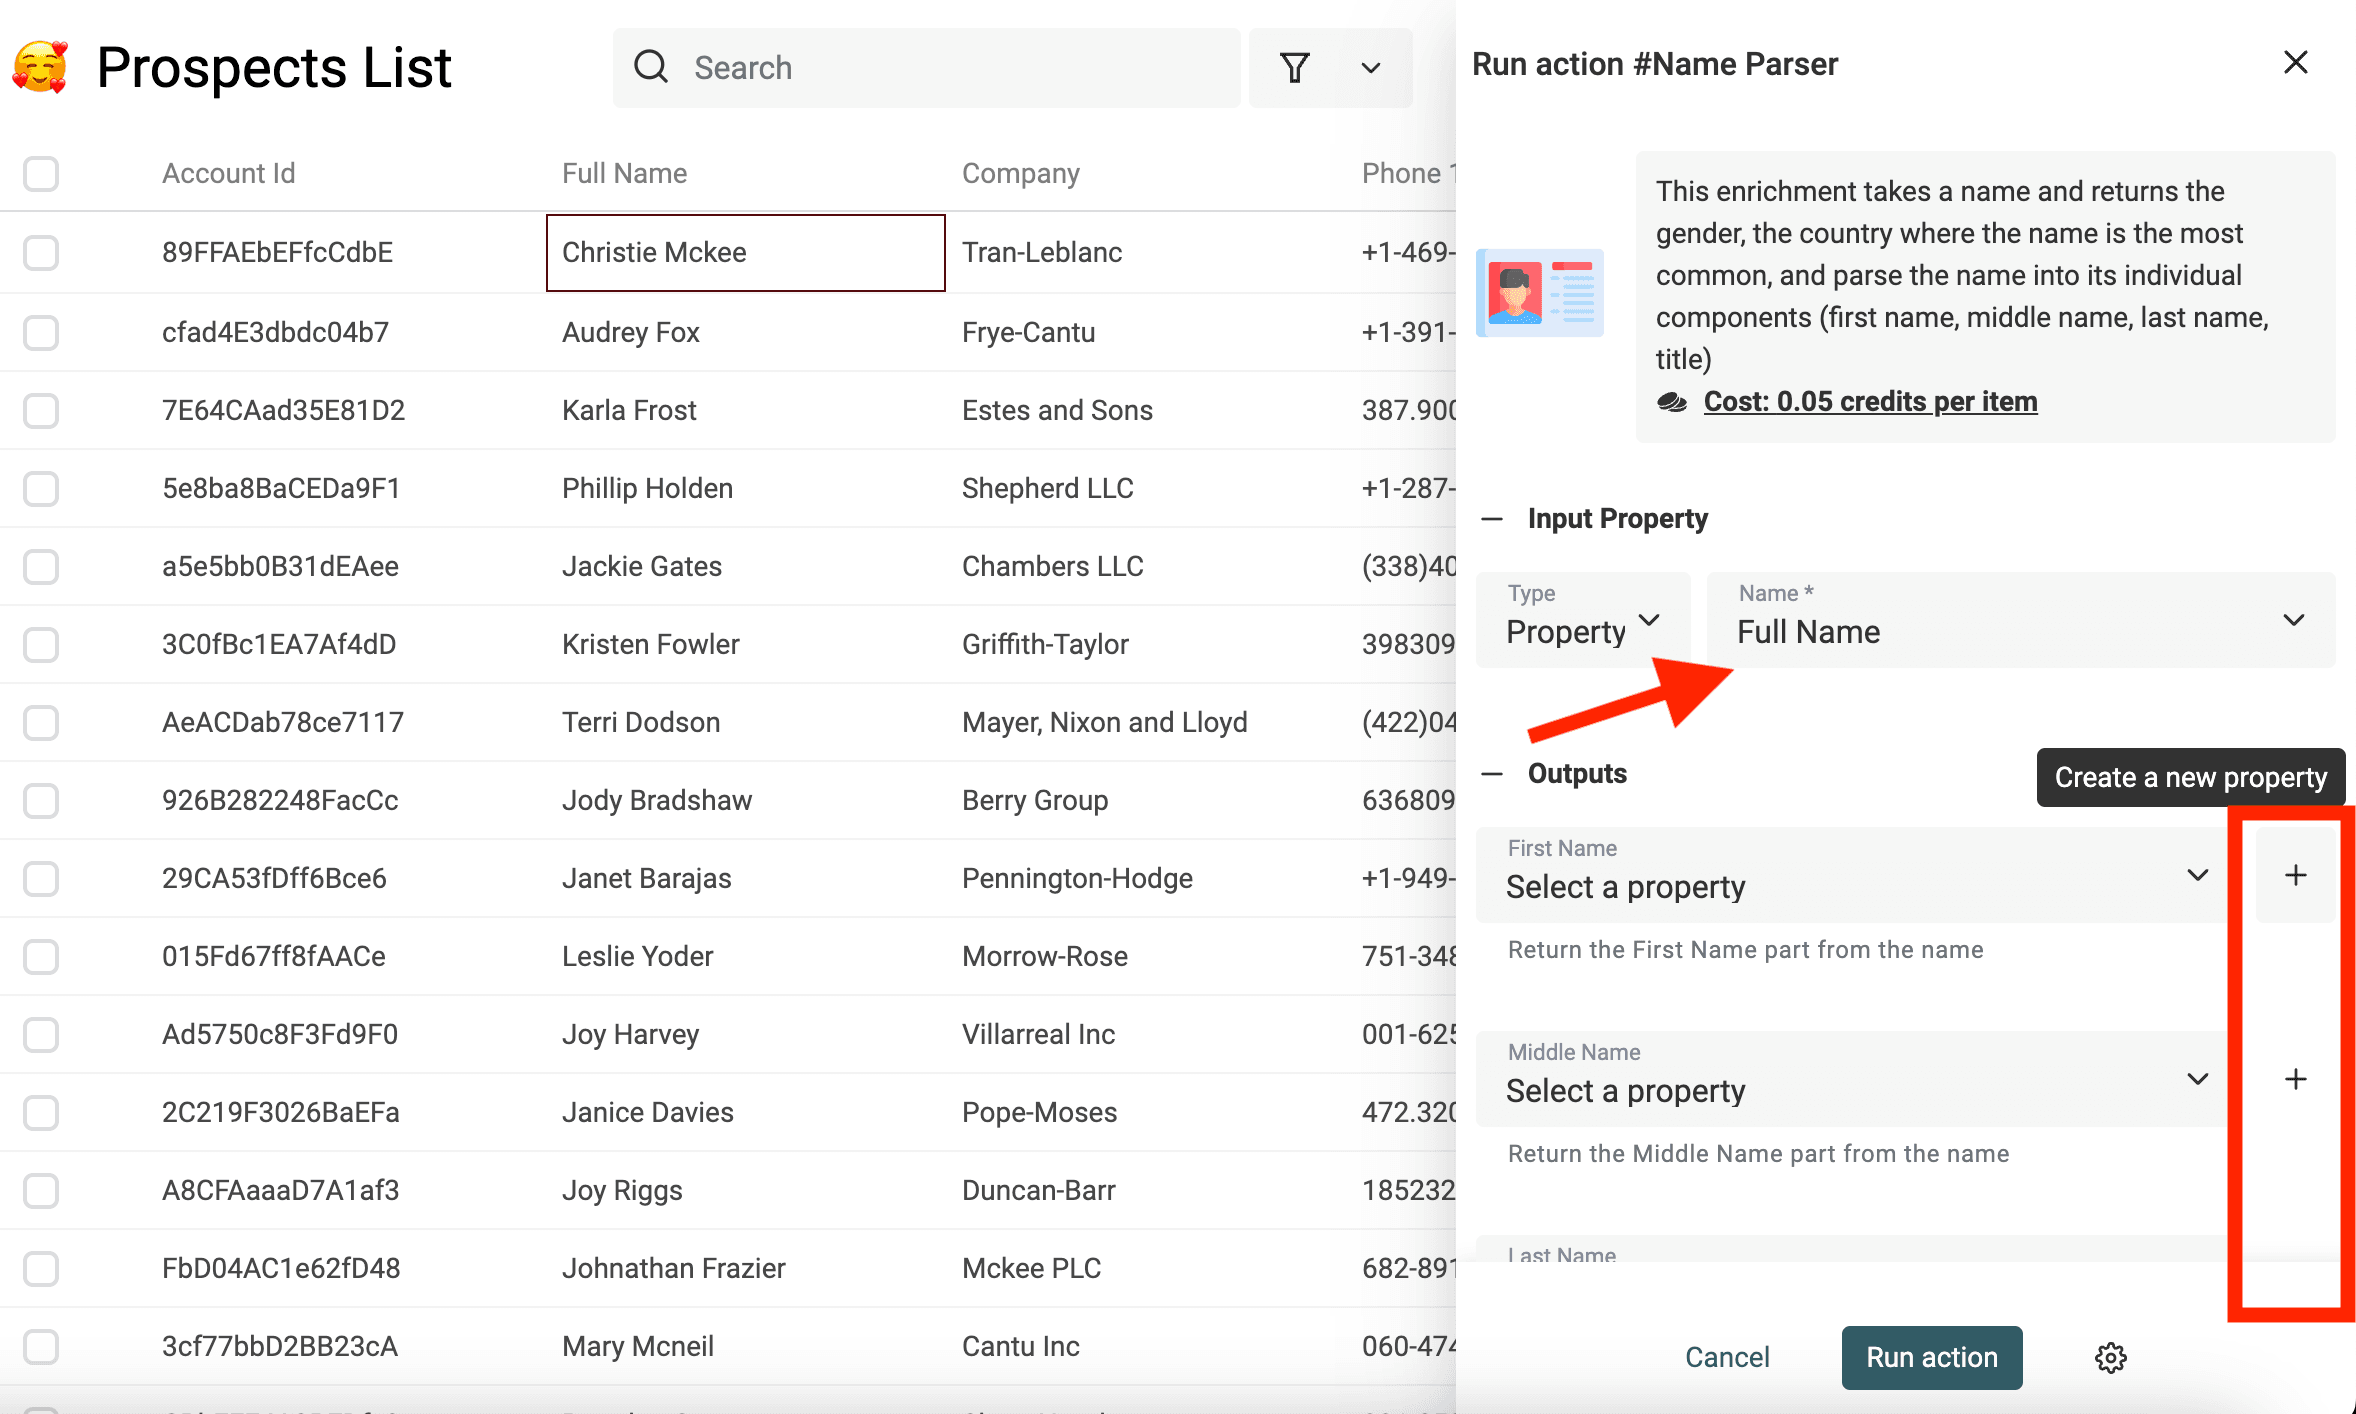
次に、氏名が入っているプロパティを選択し、解析結果を保存するプロパティをマッピングするか、新しく作成します。フルネームのプロパティは編集されず、出力先のプロパティにのみ解析結果が書き込まれます。
企業名を正規化する
企業名から不要な文字列を削除することもできます。接頭辞、接尾辞、stop words、地域情報など、正確な照合を妨げる要素が対象です。
クレンジングの一例として、「Inc.」や「GmbH」といった企業形態を示す接尾辞の削除があります。
Find & Replaceで、次の正規表現を使用します。
,?\s(llc|inc|incorporated|corporation|corp|co|gmbh|ltd).?$
置換後の文字列は空欄にします。
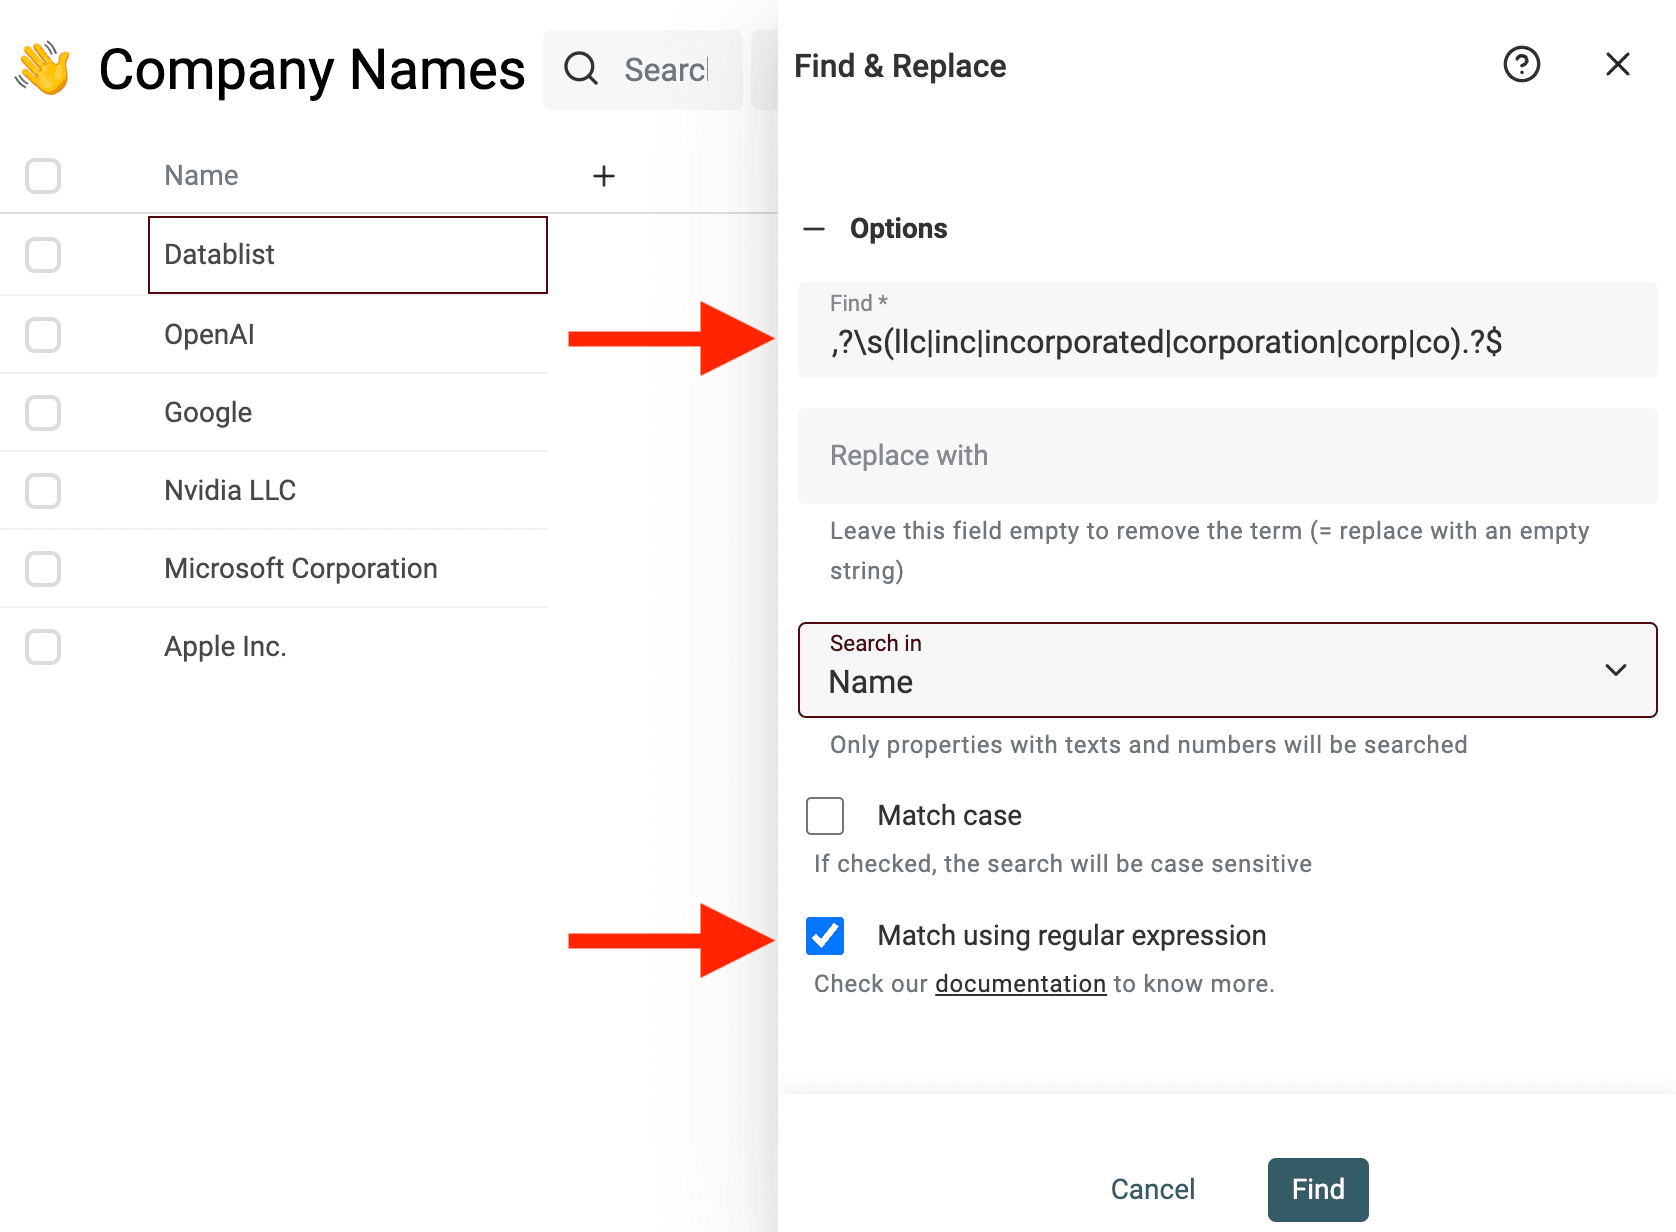
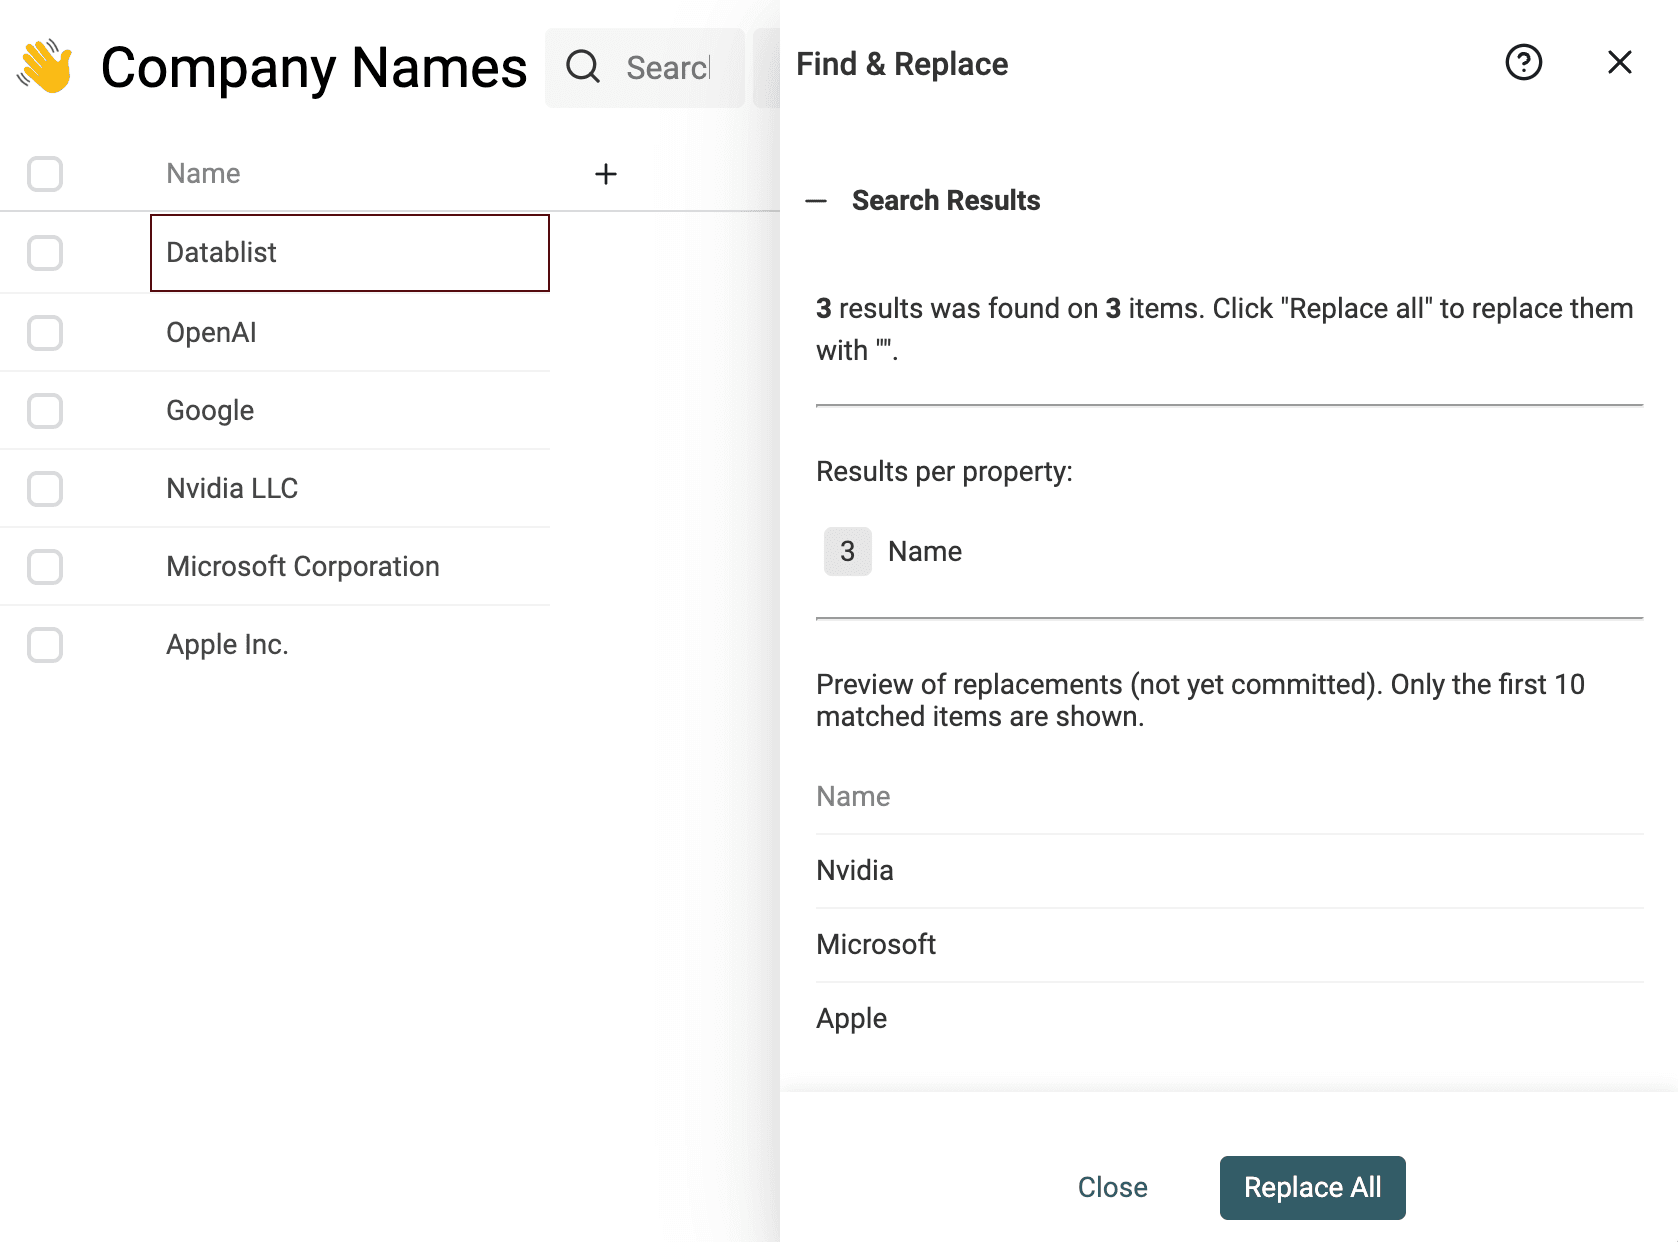
すべてのデータセットで企業名と住所を正規化し、共通の形式にそろえることが重要です。
通り名を正規化する
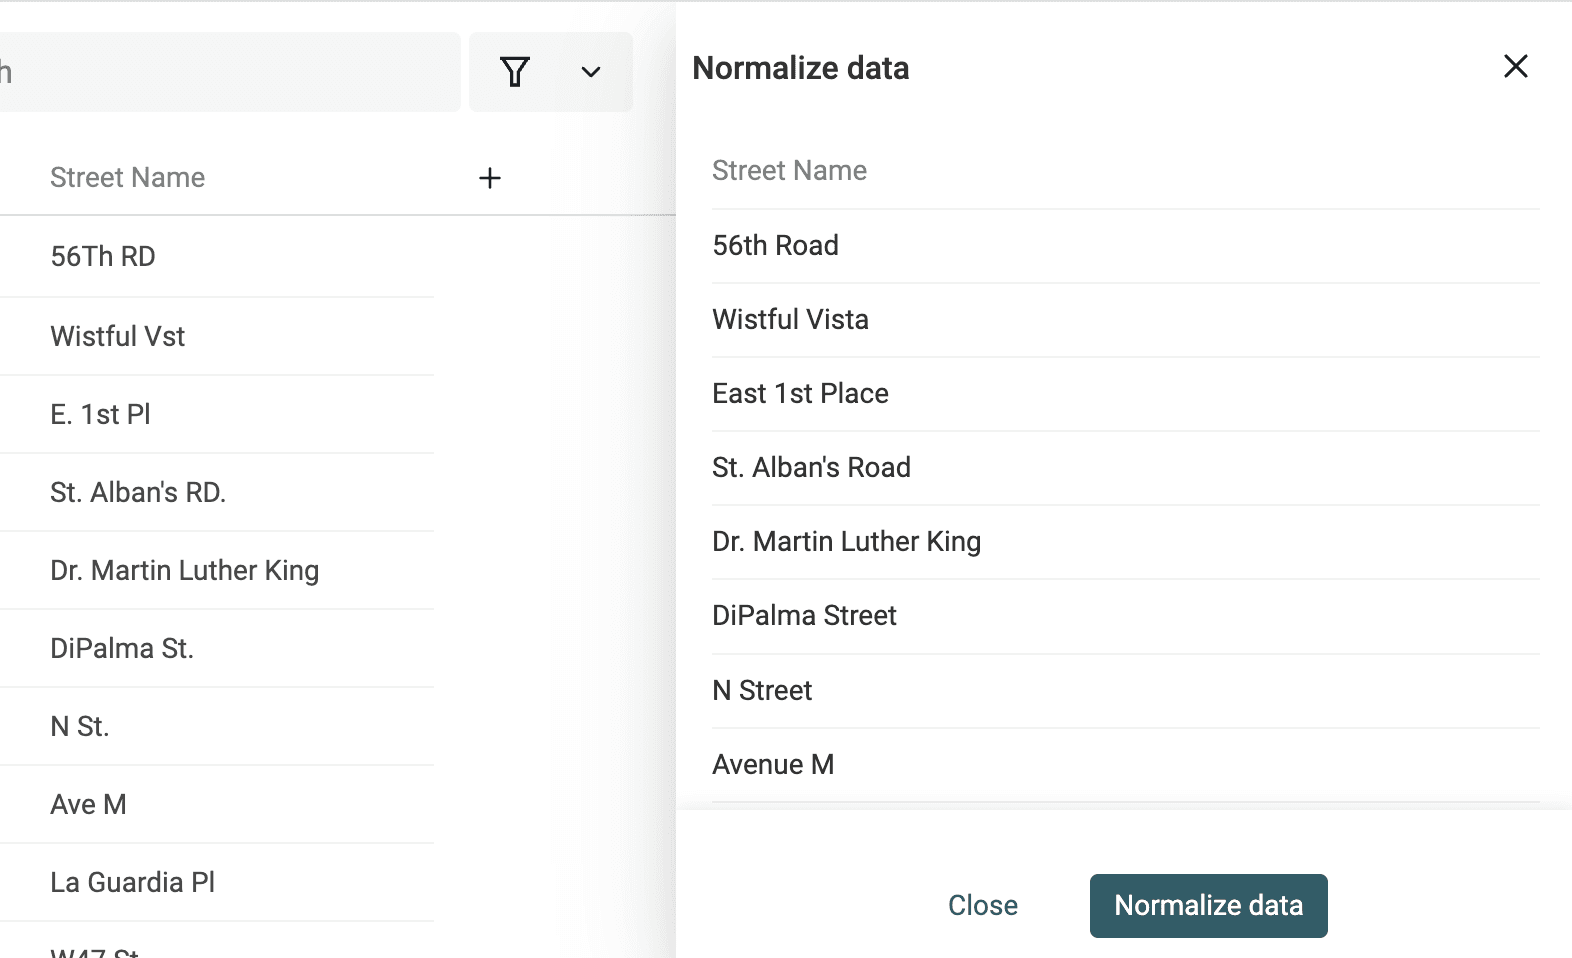
住所を使ってデータ照合を行う場合、通り名の正規化が重要です。住所には略称、方角を示す接頭辞、序数の接尾辞など、さまざまな表記があります。正規化しなければ、同じ通りが複数の異なる表記で登録され、データ照合が難しくなります。
たとえば、Main 9 St、Main 9TH St.、Main 9th Streetは同じ通り名です。Washington BlvdとWashington Boulevardも同様です。
こうした違いをfuzzyアルゴリズムだけで処理するのは効率的ではありません。Washington BlvdとWashington Boulevardでは複数の文字変更が必要となり、fuzzy matchingアルゴリズムで算出される距離も大きくなります。
通り名の表記揺れには、正規化で対応する方が効果的です。形式を統一することで、一貫性を確保できます。
Datablistは、英語圏の住所形式に対応した通り名の正規化機能を提供しています。略称や通り番号などを正規化できます。
注記
通り名の正規化は、住所が要素ごとに分割されている場合に利用できます。通り名は独立したプロパティに保存されている必要があります。 住所全体が1つの値に入っている場合は利用できません。
「Clean」メニューから「Normalize Street Names」をクリックします。
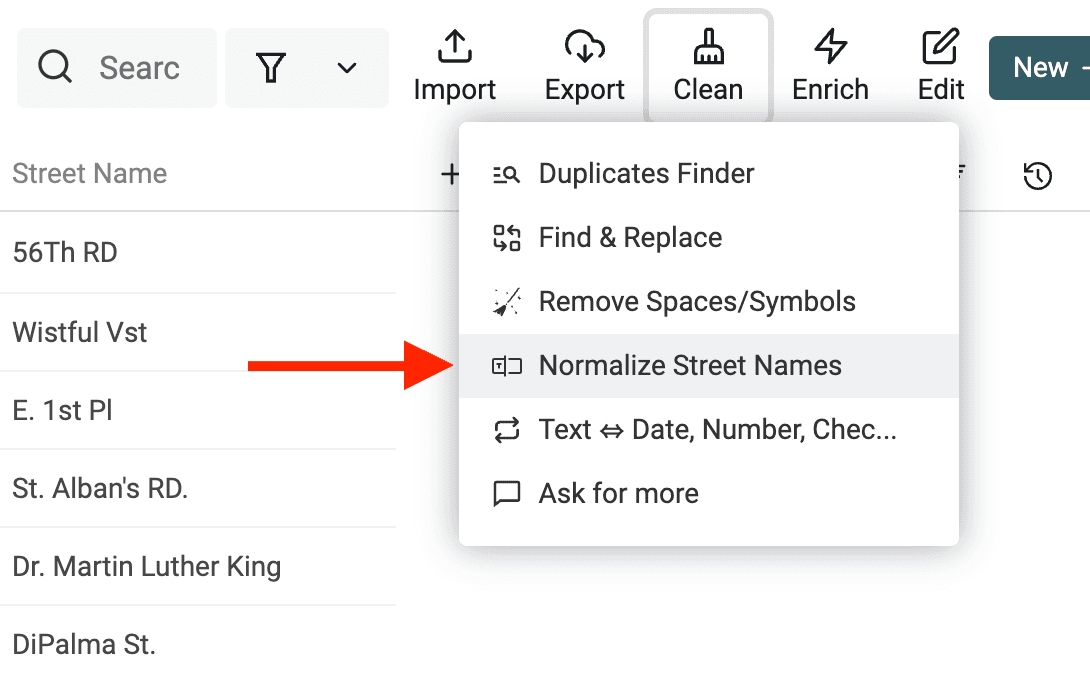
次に、通り名が入っているプロパティを選び、「Normalize english street names」を選択します。
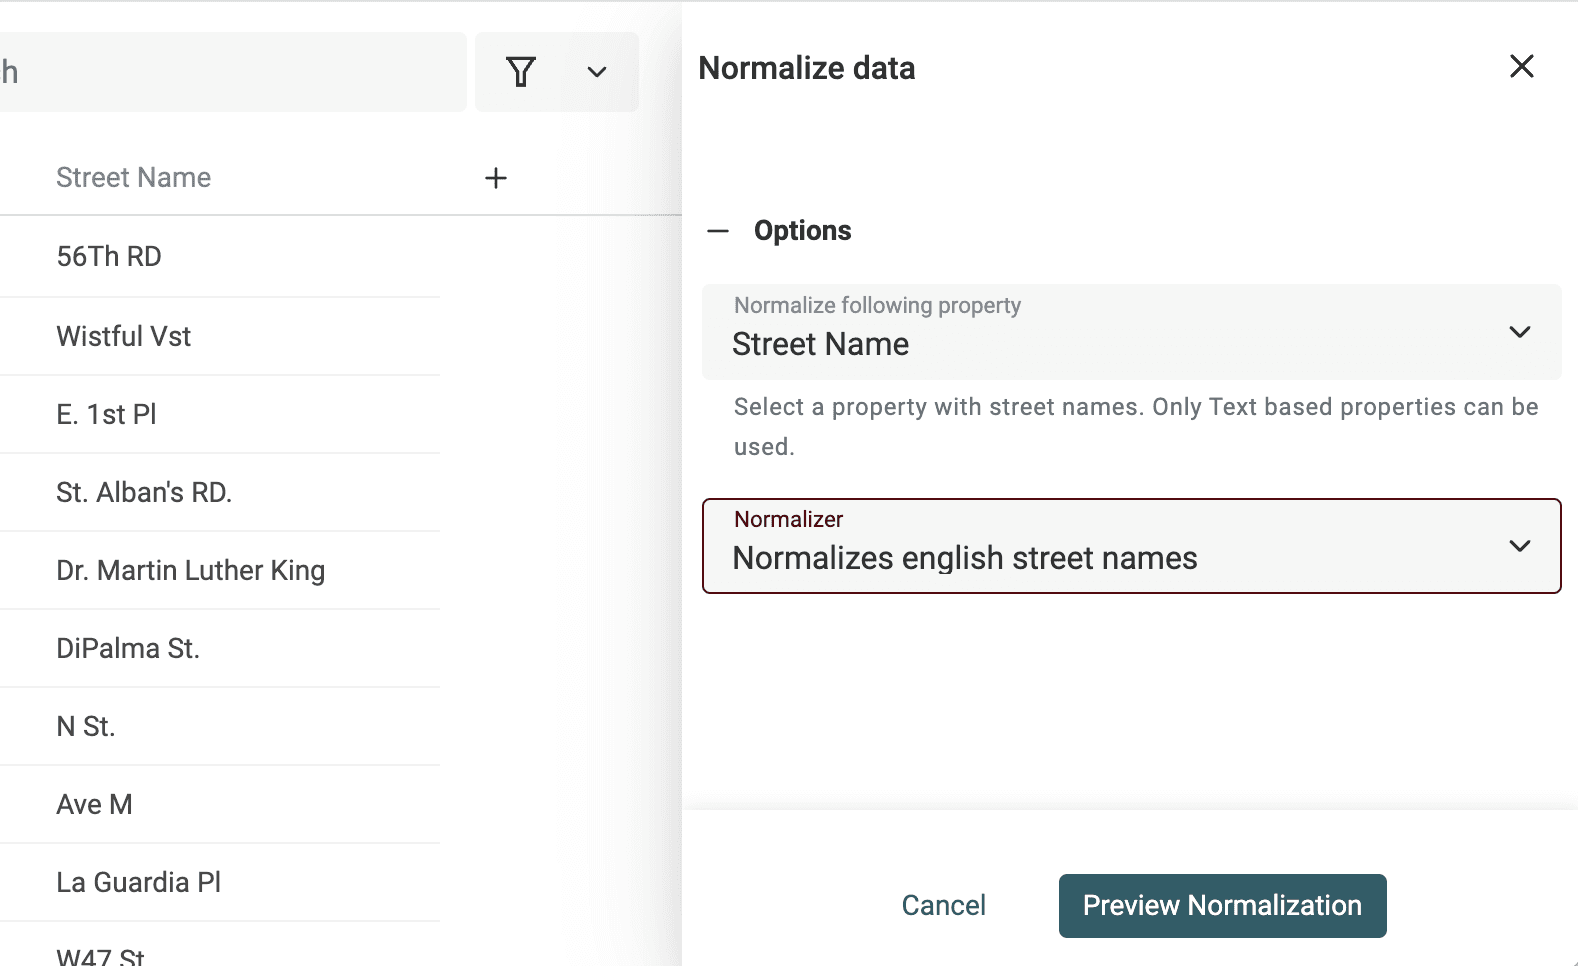
変更内容をプレビューで確認し、「Run」をクリックします。
Step 3:1つまたは複数のcollectionでレコードを照合する
データのクレンジングと正規化が完了したら、データ照合に進みます。このステップでは、類似するレコードをグループ化します。
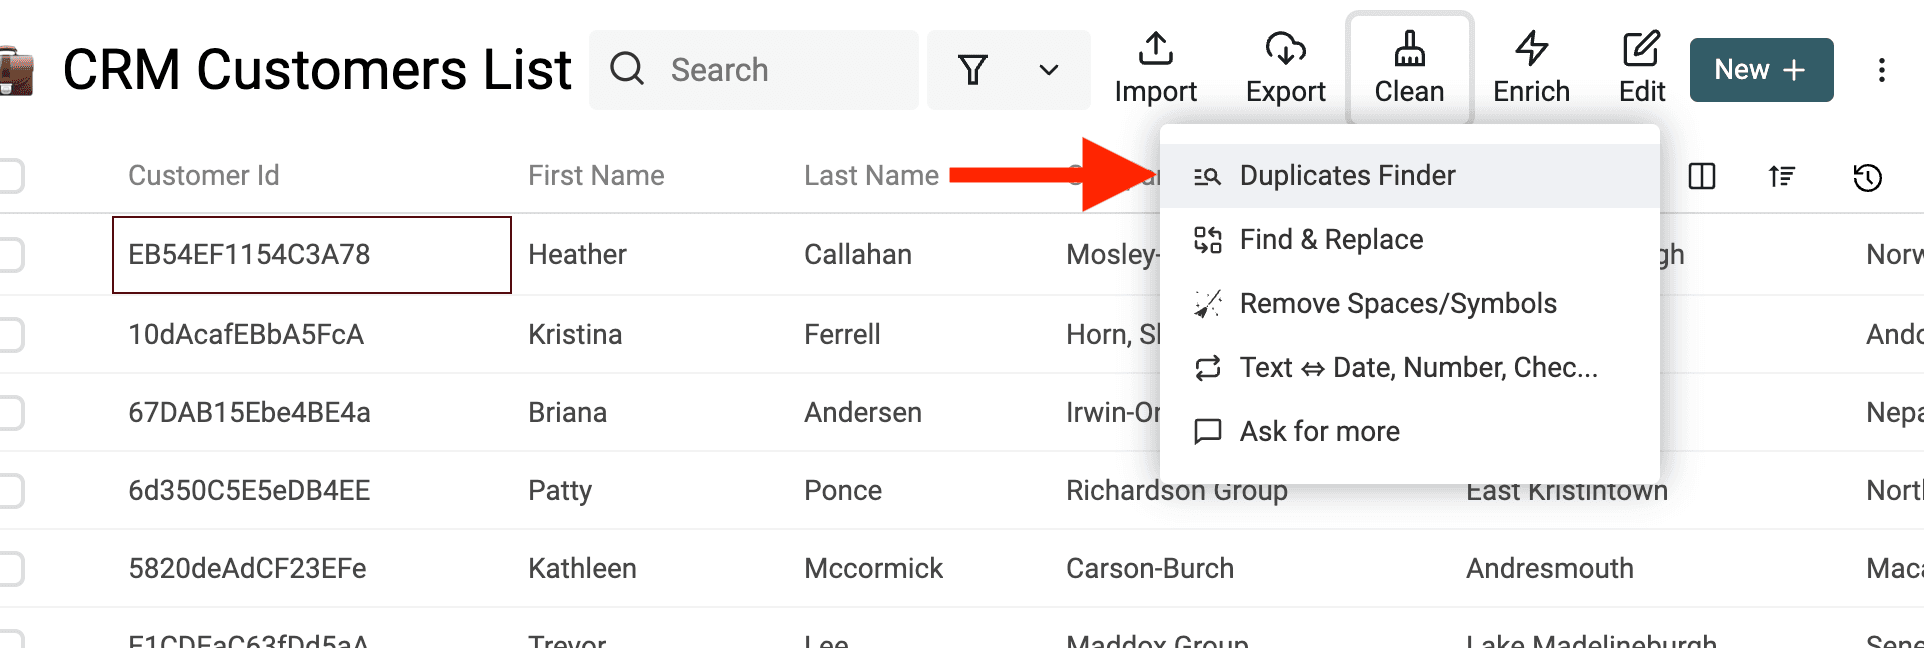
Datablistには、次の3つの開始モードがあります。
- Selected Properties:1つのcollection内で、選択したフィールドを比較します。
- All Properties:1つのcollection内で、レコード全体を比較します。
- Match across collections:複数のcollectionからプロパティをマッピングして比較します。
EmailとCompanyを含む2つのLeadファイルを照合する場合は、まずメールアドレスのプロパティをマッピングします。メールアドレスがない場合は企業名を比較し、可能であればWebサイトや所在地のフィールドも追加してください。出力されるのは照合候補のグループであり、重複が完全に解消されたリストではありません。レコードをマージする前に、いくつかのグループを開き、元の値をご確認ください。
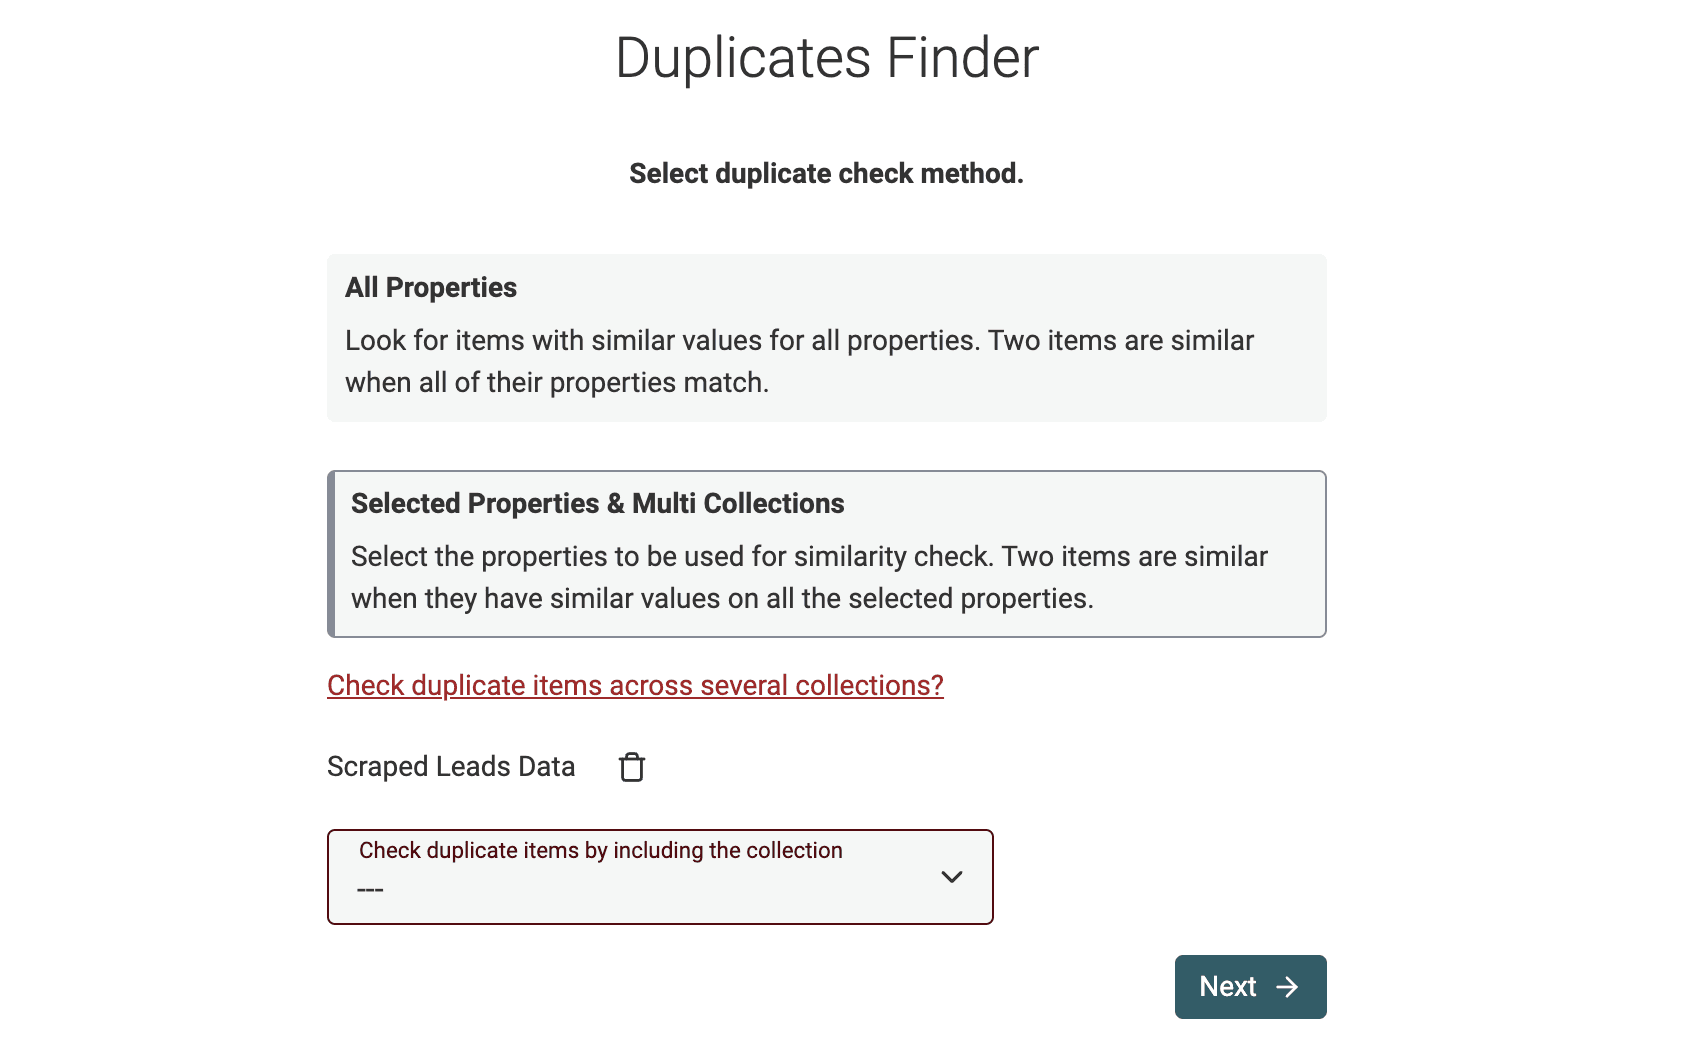
照合するプロパティを選択する
以降の手順では、Match across collectionsを使用します。
次に、データ照合で使用するプロパティを選択します。前のステップで複数のcollectionを選んだ場合は、collectionごとにマッピングするプロパティを指定します。
注記
Datablistは、プロパティ名を基に複数のcollection間で自動マッピングを試みます。
照合アルゴリズムを選択する
次のステップでは、選択したプロパティが一覧表示されます。各プロパティに使用する比較アルゴリズムを設定してください。
Datablistでは、次の照合アルゴリズムを利用できます。
-
Exact - DateTime、Number、Booleanなど、テキスト以外のプロパティに推奨されるアルゴリズムです。テキストプロパティに使用する場合は、大文字・小文字を区別するかどうかを選べます。Exactアルゴリズムでは、テキストの先頭と末尾にあるスペースが削除されます。
-
Smart - わずかな表記揺れがあるデータを照合できるよう、レコードを前処理します。異なるプロトコルのURLも照合できるほか、語順や句読点の違いにも対応します。たとえば、「John-Doe」と「Doe John」は一致します。
-
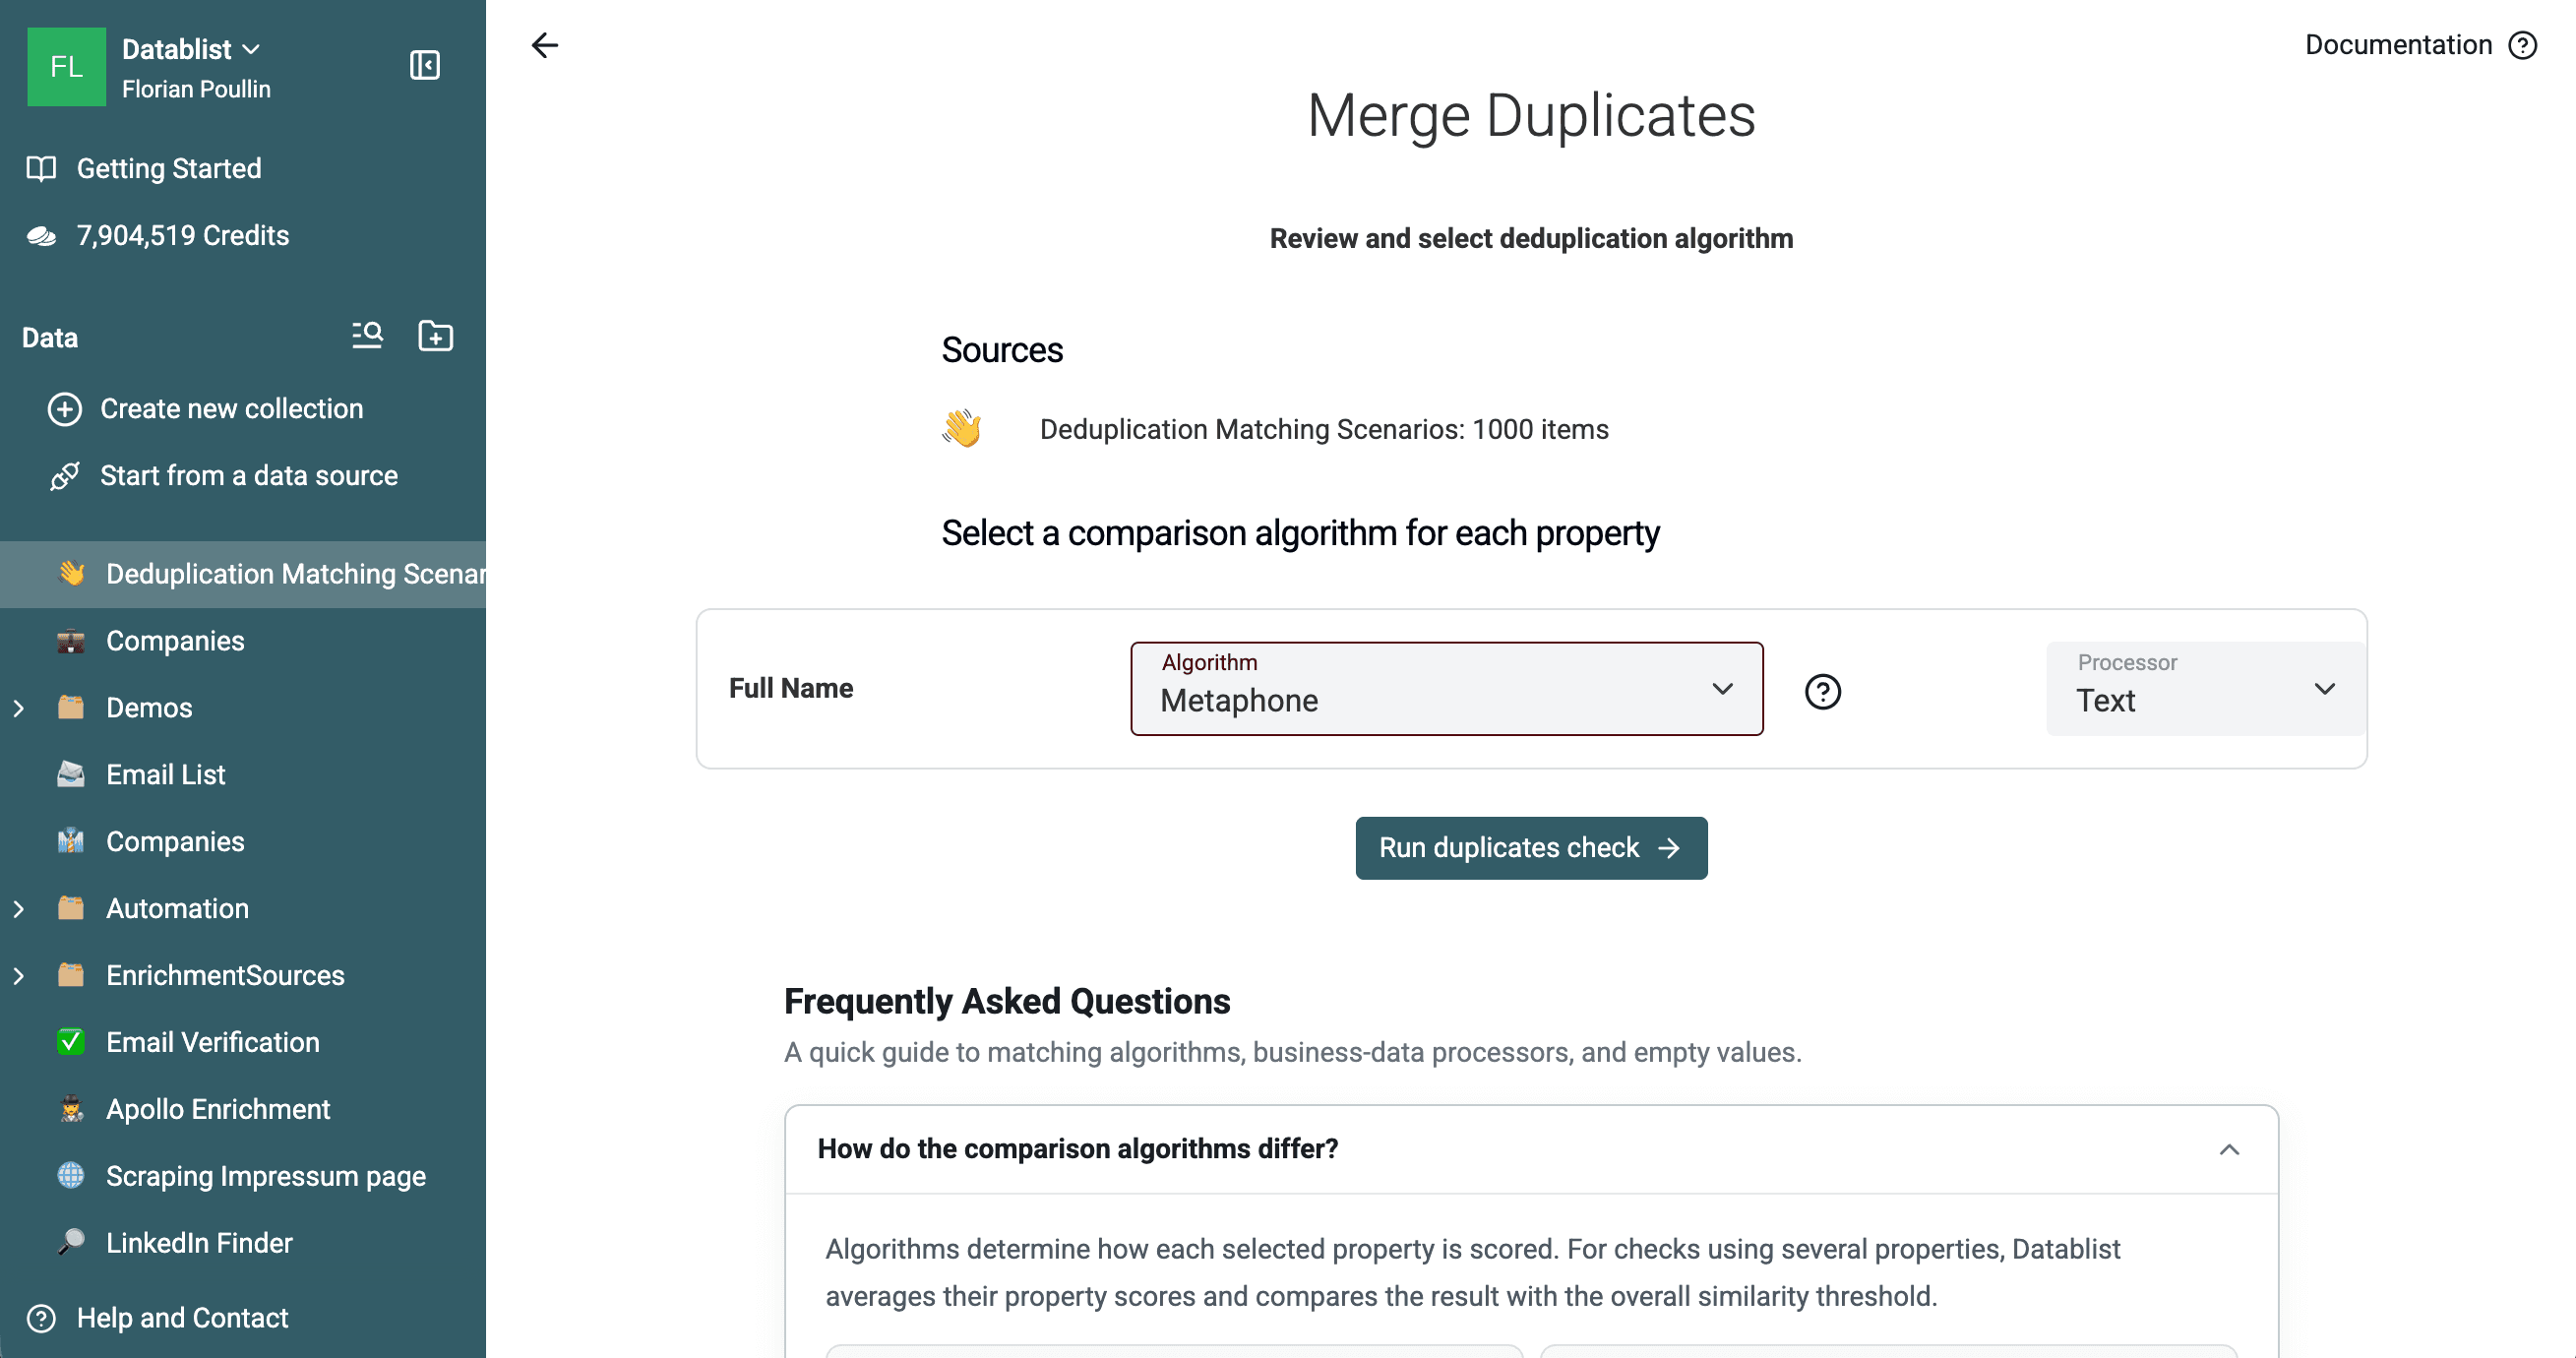
Double MetaphoneアルゴリズムによるPhonetic - Datablistは、音声照合にDouble Metaphoneアルゴリズムを採用しています。単語を発音に対応するコードへ変換し、発音が似ている2つの単語には同じDouble Metaphoneコードを付与します。
-
距離アルゴリズムによるFuzzy matching - Datablistは、Jaro-Winkler距離とLevenshtein距離を使ったfuzzy matchingにも対応しています。選択時には類似度のしきい値を設定します。しきい値を高くするほど、許容される表記差は小さくなります。
各照合アルゴリズムの詳細は、ドキュメントをご確認ください。
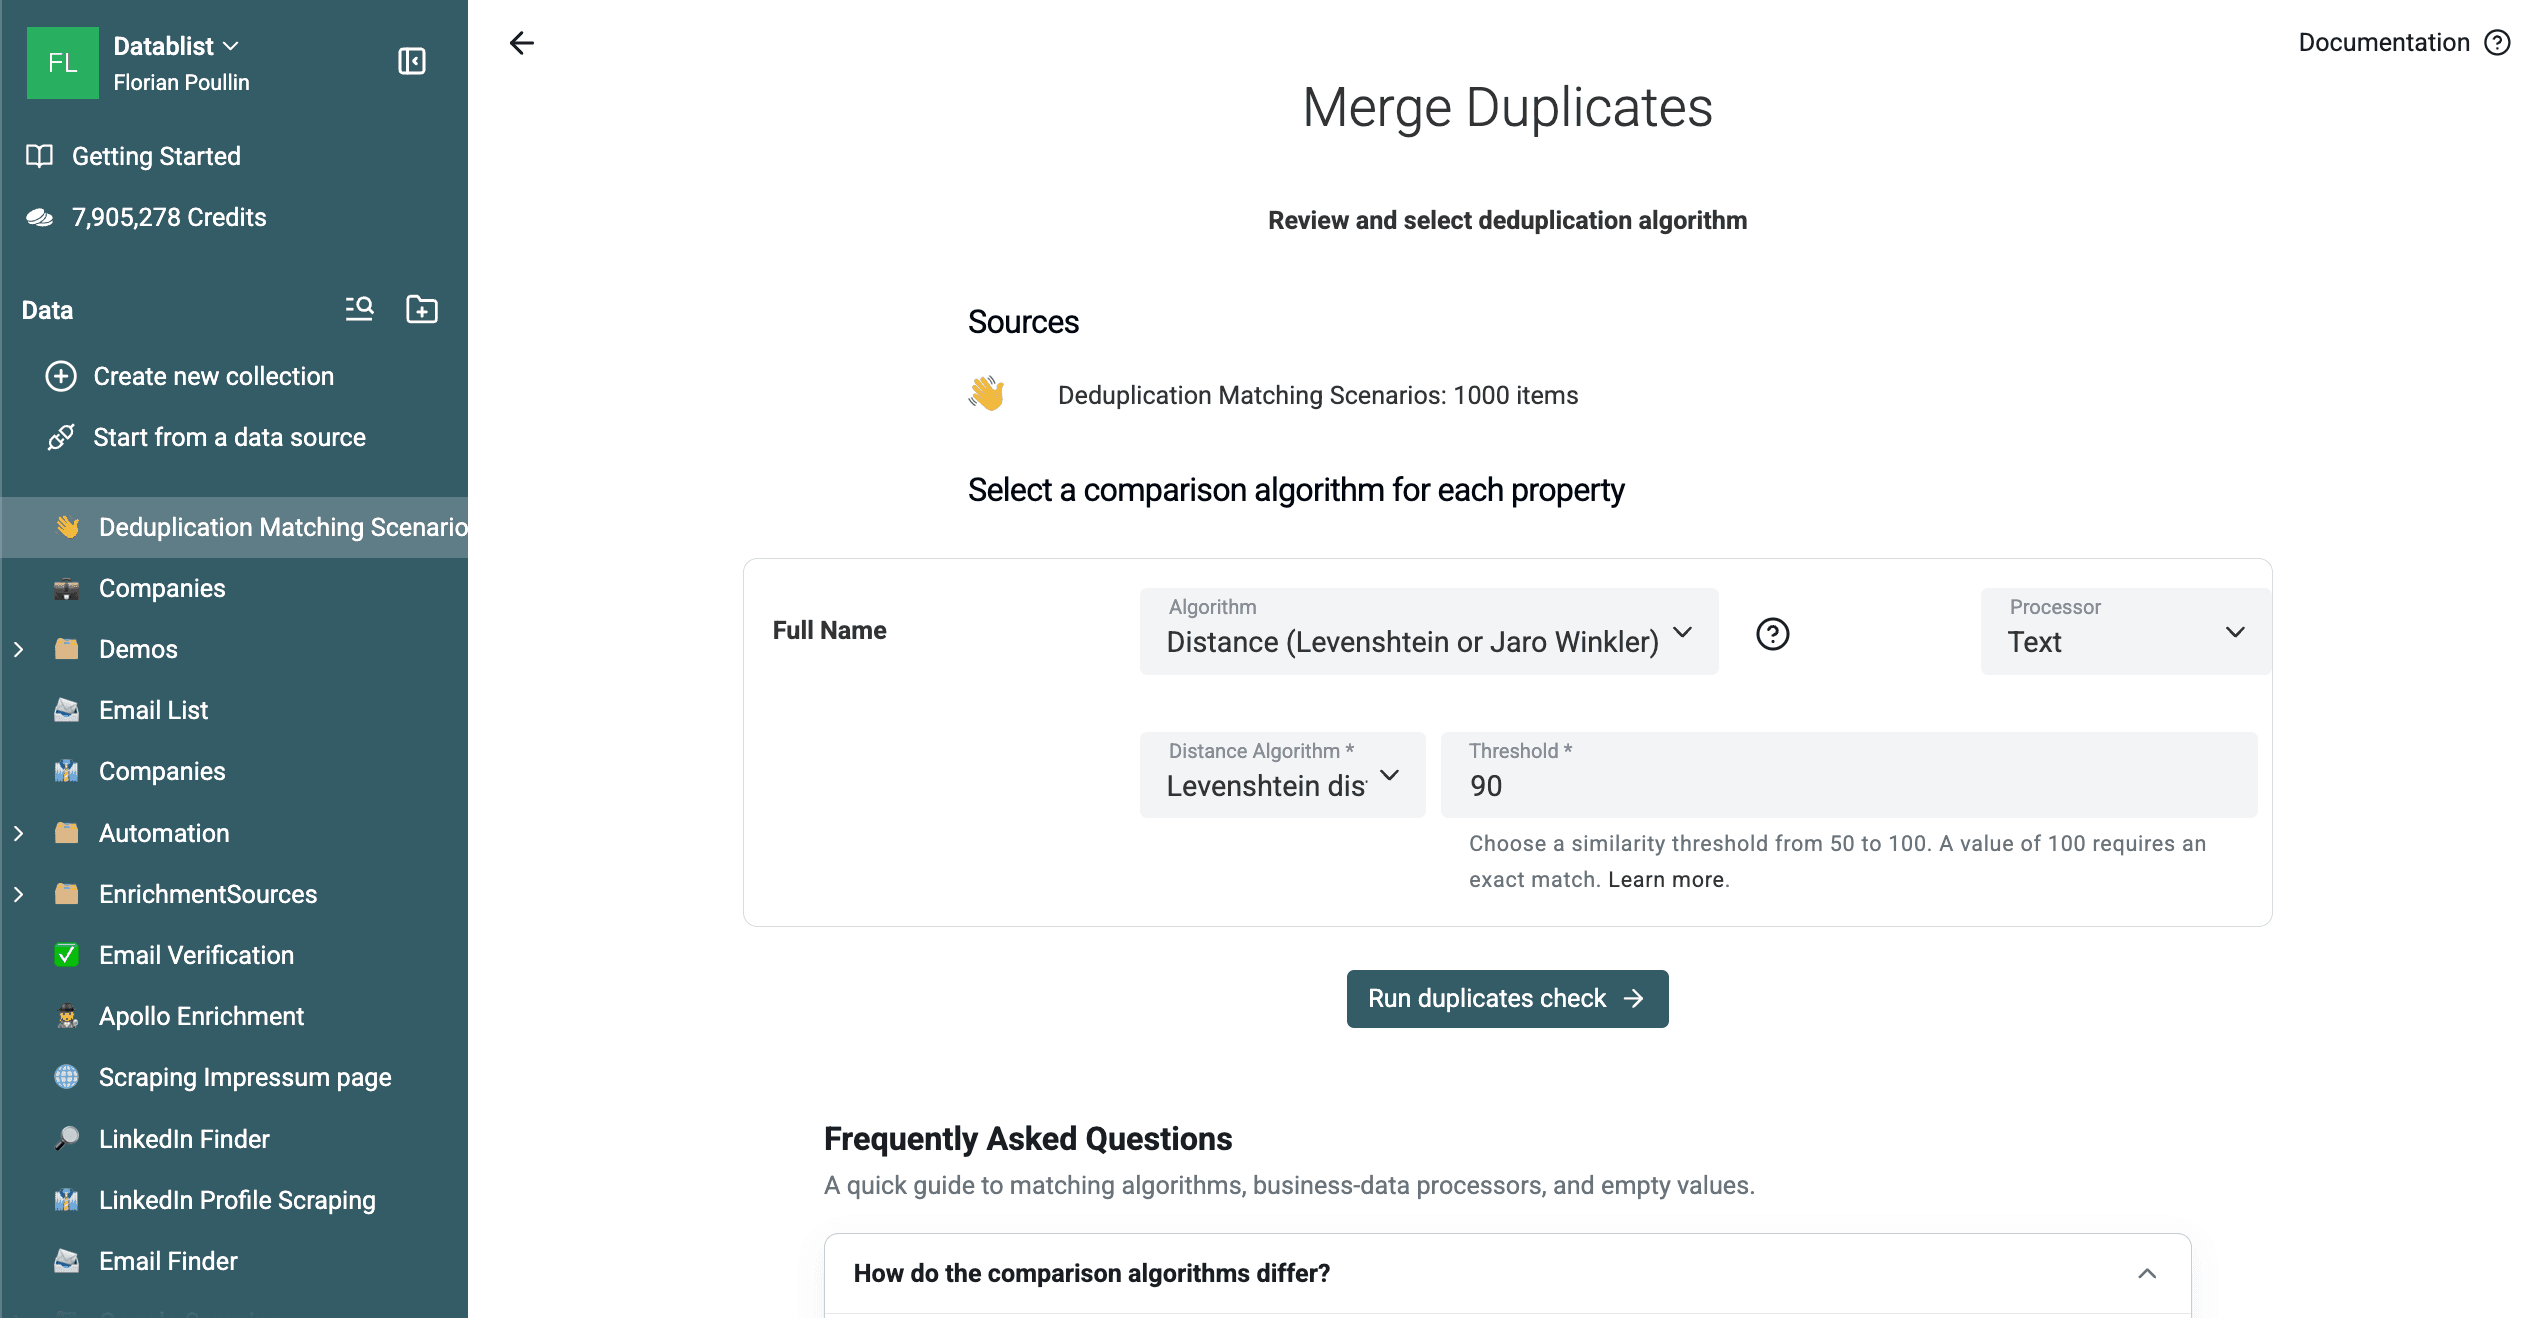
1,000行の重複排除サンプルでは、このFull Name設定により、各2行で構成される77グループが検出されました。正解データと照合したところ、同一人物として設計されたグループは21件、別人を誤って結び付けたグループは56件でした。誤検出の多くは、G. Rossiのような短く同一の略称でした。
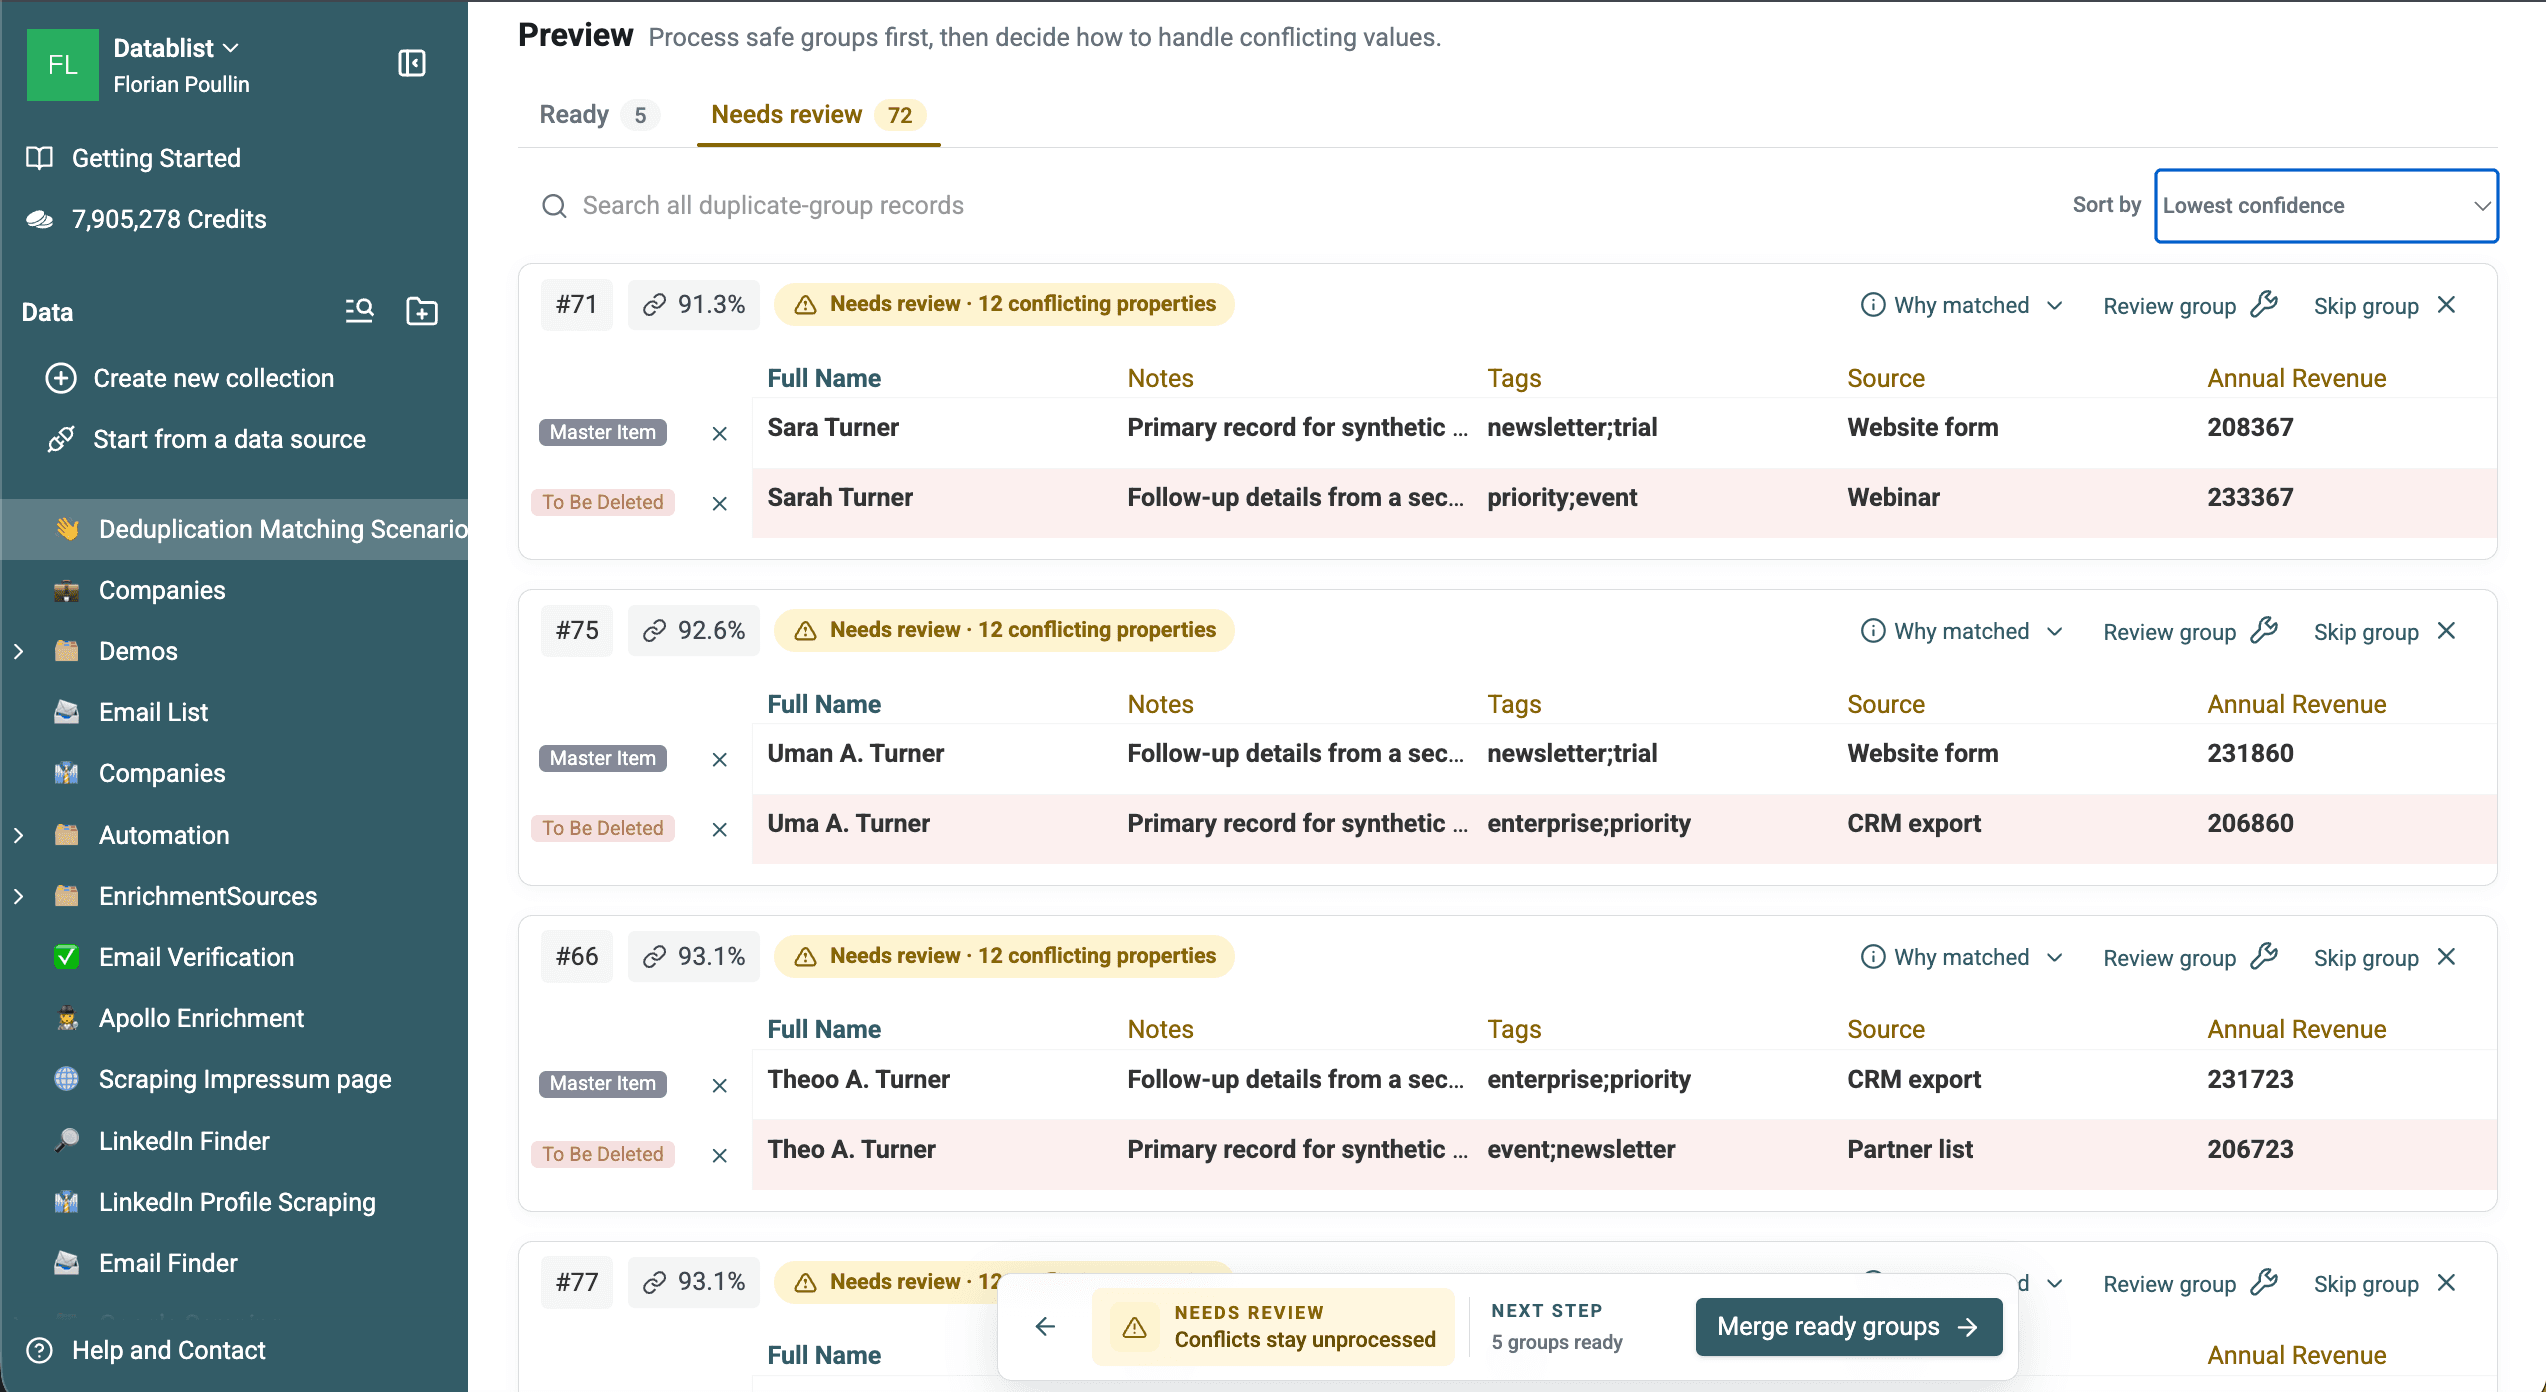
曖昧な氏名の一致を処理する前に、メールアドレス、電話番号、企業名、Webサイトなど、2つ目の識別子をご使用ください。結果を確認するには、エクスポートされた77グループをダウンロードできます。
同じサンプルで、Full NameにMetaphoneとText processorを使用した場合は、69グループ、合計188行がグループ化されました。正解データと照合したところ、同一人物のみで構成されたグループは19件、別人が混在するグループは50件でした。
結果には、同じ姓と略称を持つ人物の大きなグループも含まれていました。音声的な類似性は候補の発見には役立ちますが、2つのレコードが同一人物であることを証明するものではありません。
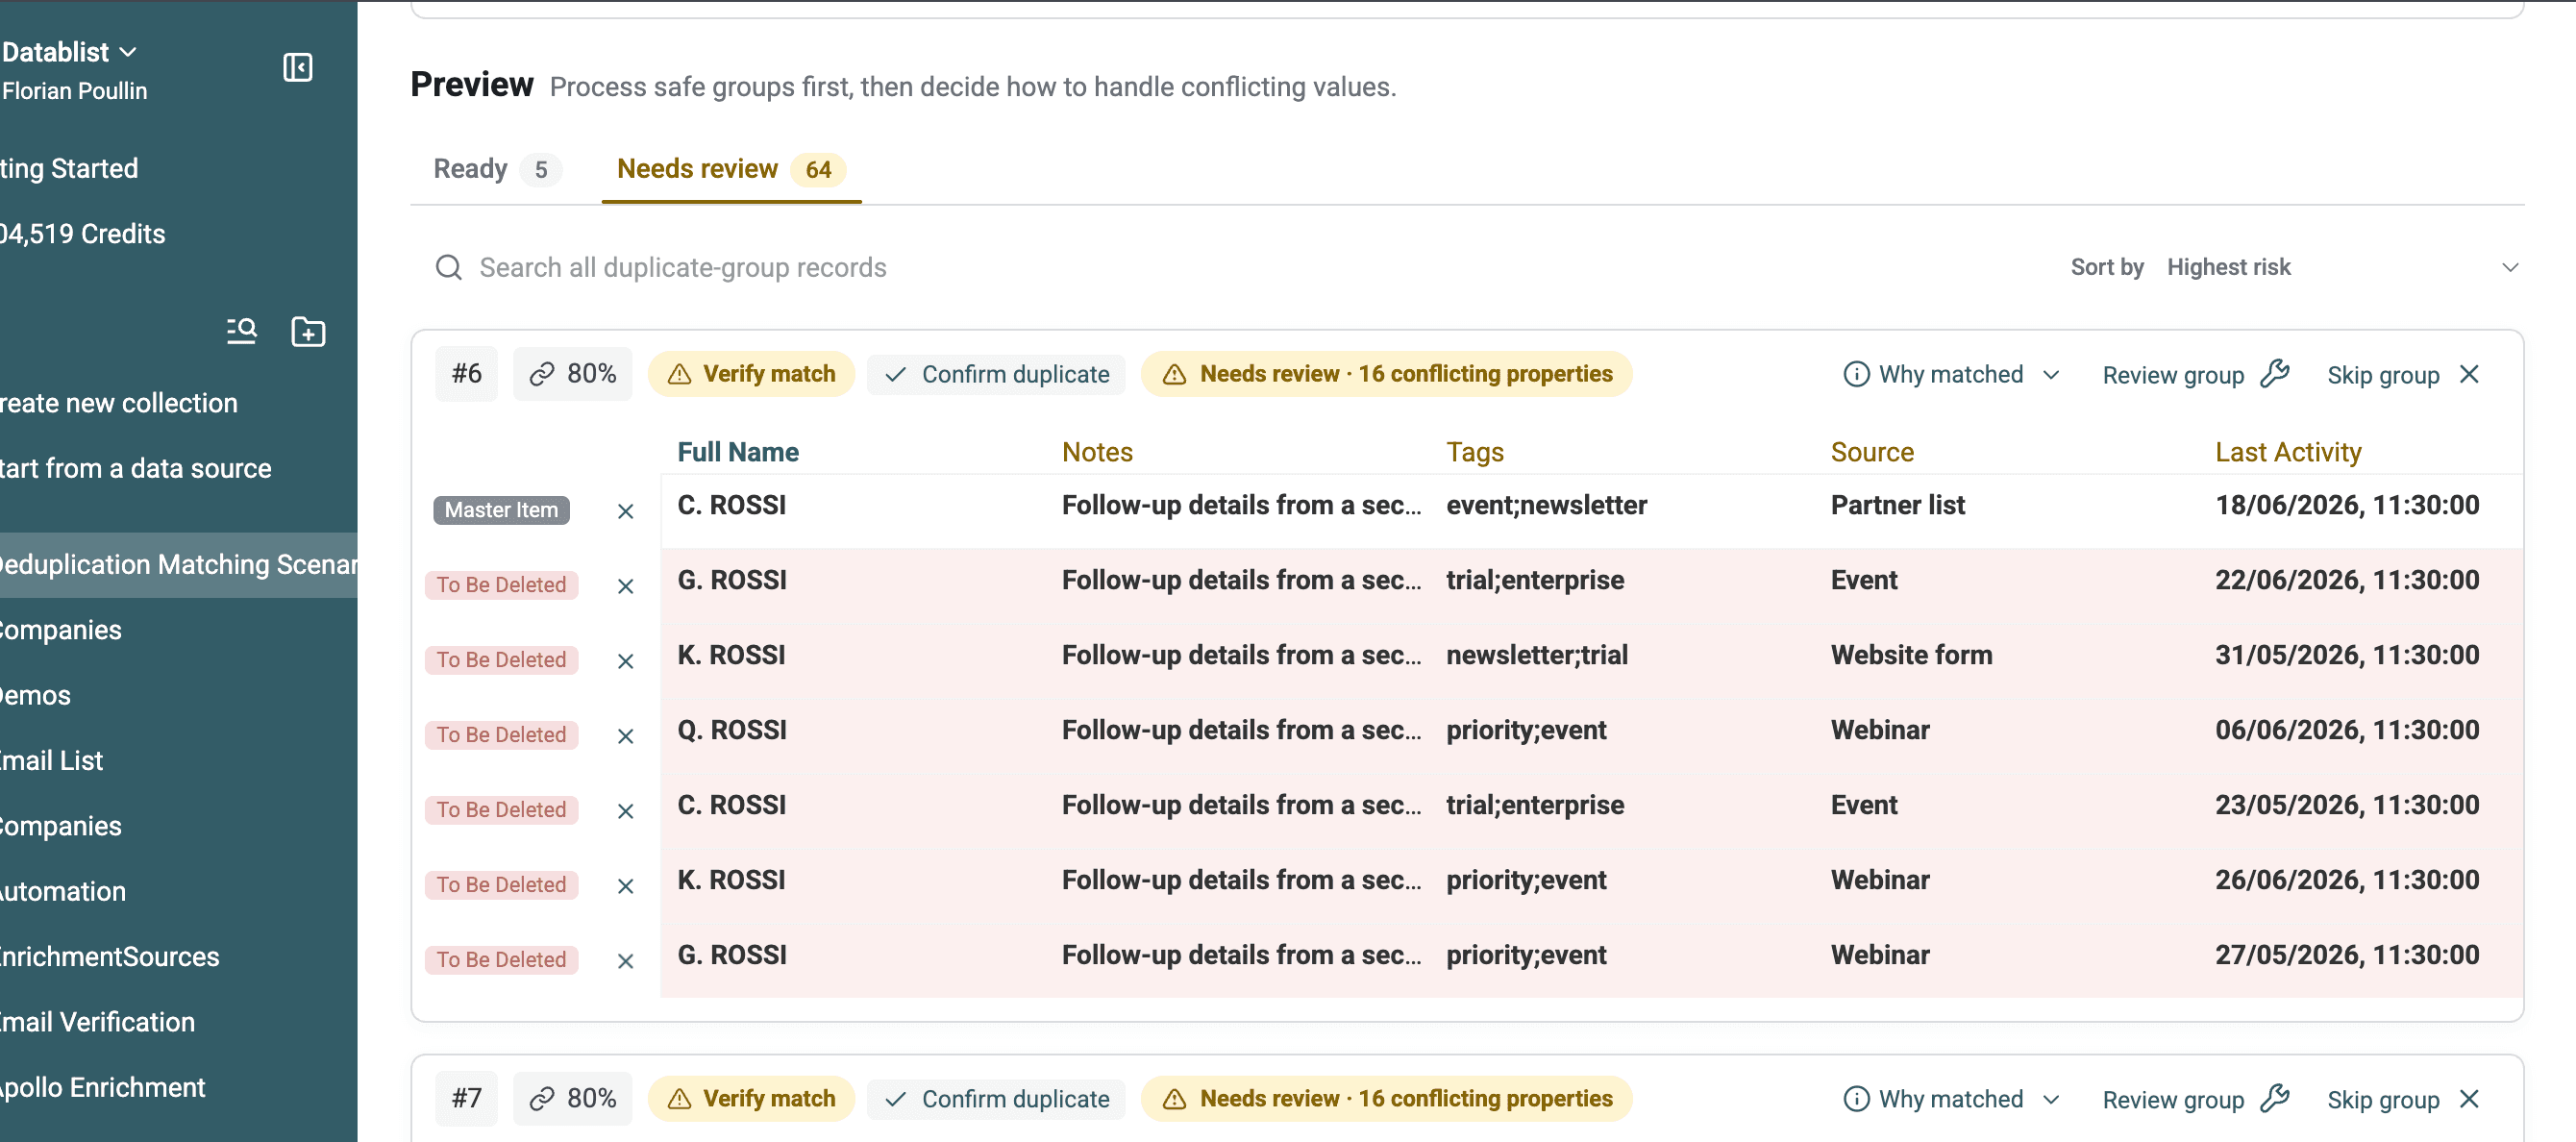
エクスポートされた69件のMetaphoneグループをダウンロードし、2~7行で構成される各グループを確認して、有効な一致と誤検出を比較できます。
注記
- Smart、Phonetic、fuzzyアルゴリズムは、テキスト系のプロパティにのみ適用できます(Email、Text、LongTextを含みます)。
- URLプロパティに対応しているのは、ExactとSmartアルゴリズムのみです。
Step 4:一致グループを削除またはマージする
DatablistのDuplicates Finderは、一致したレコードを確認用のグループとして返します。結果画面では一致した理由を確認でき、Readyのグループと確認が必要な候補が分けて表示されます。
1つのcollectionで重複を自動マージする
1つのcollectionを処理する場合は、Merge and preserve dataを選択します。Datablistが空のプロパティを補完し、設定した競合ルールとRecord to keepルールを適用します。
注記:
この機能を利用できるのは、1つのcollection内で重複排除を行う場合のみです。複数のcollectionを対象にする場合、collectionごとにデータ構造が異なる可能性があります。
データ競合がない場合の自動マージ
マージ結果が明確で、未解決の要件がない場合、DatablistはそのグループをReadyとして表示します。
処理の仕組みは次のとおりです。
- すべての重複アイテムでプロパティ値が同じ場合は、1件だけを残してほかを削除します。
- 重複アイテムの情報が相互補完できる場合は、最も多くの情報を持つアイテムをPrimary Itemとして選び、ほかのアイテムの値で空のプロパティを補完します。その後、Primary Item以外を削除します。
- 値が競合する場合はルールを設定するか、そのグループをNeeds reviewのまま残します。
データ競合を解消して自動マージする
Auto-Mergingアルゴリズムを実行すると、DatablistのDuplicates Finderが競合するプロパティを自動検出します。競合とは、同じプロパティについて2つのアイテムが異なる値を持つ状態です。マージするには、次の選択肢から処理方法を指定します。
- Combine:異なるテキスト値を、選択した区切り文字で連結します。
- Keep the selected record's value:選択したレコードの値を残し、それ以外を破棄します。
- 有料のfield survivorshipルールでは、プロパティごとに最新、最古、最長、最短、最大、最小、または最頻値を選択できます。
複数collectionのデータ照合で使えるクレンジングルール
複数のデータセットに対してDatablistのデータ照合ツールを実行する場合、自動マージ機能は利用できません。collectionごとにプロパティやデータ構造が異なる可能性があるためです。
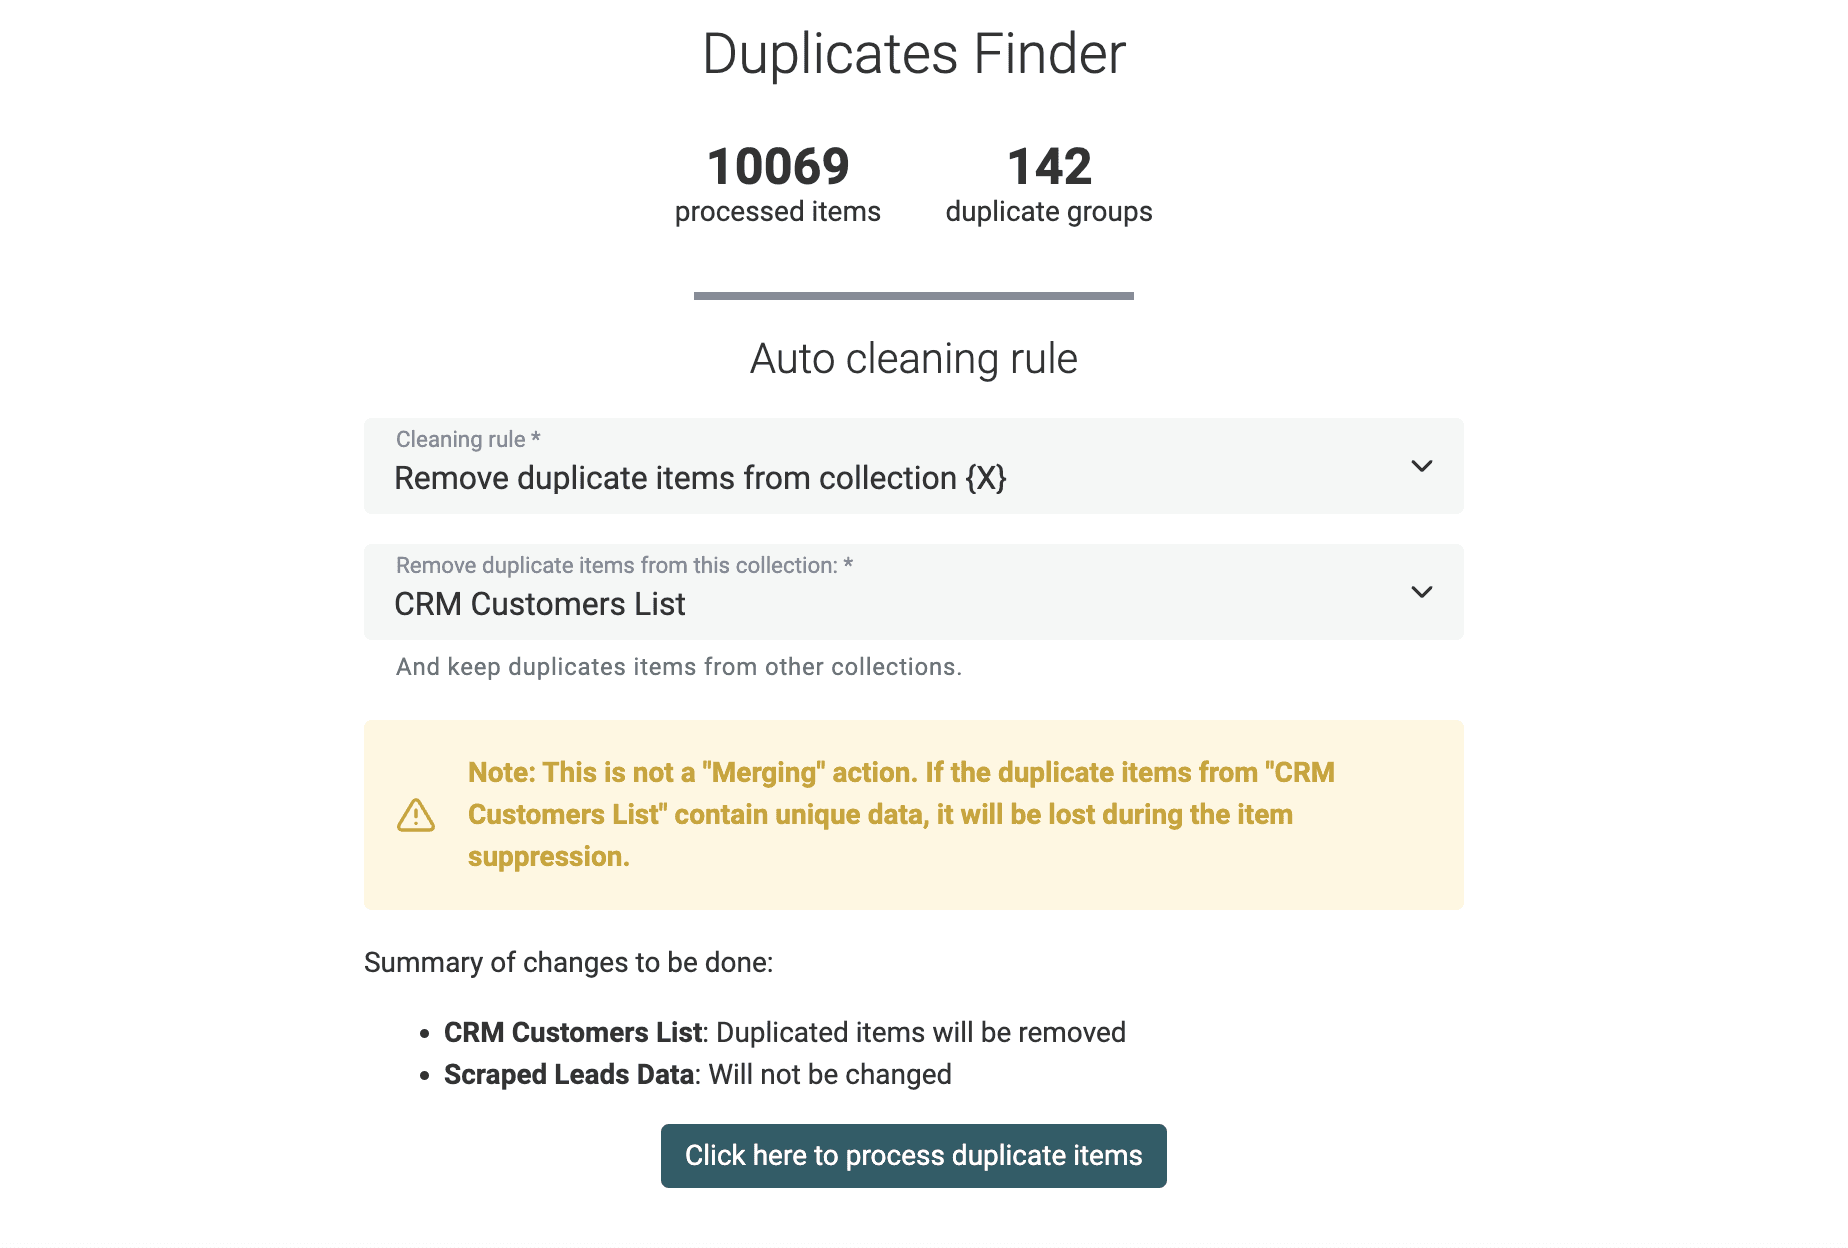
代わりに、1つのcollectionだけにアイテムを残し、それ以外のcollectionから重複アイテムを削除するクレンジング機能を利用できます。このツールを使えば、複数のデータセットをまたいでアイテムの一意性を確保できます。
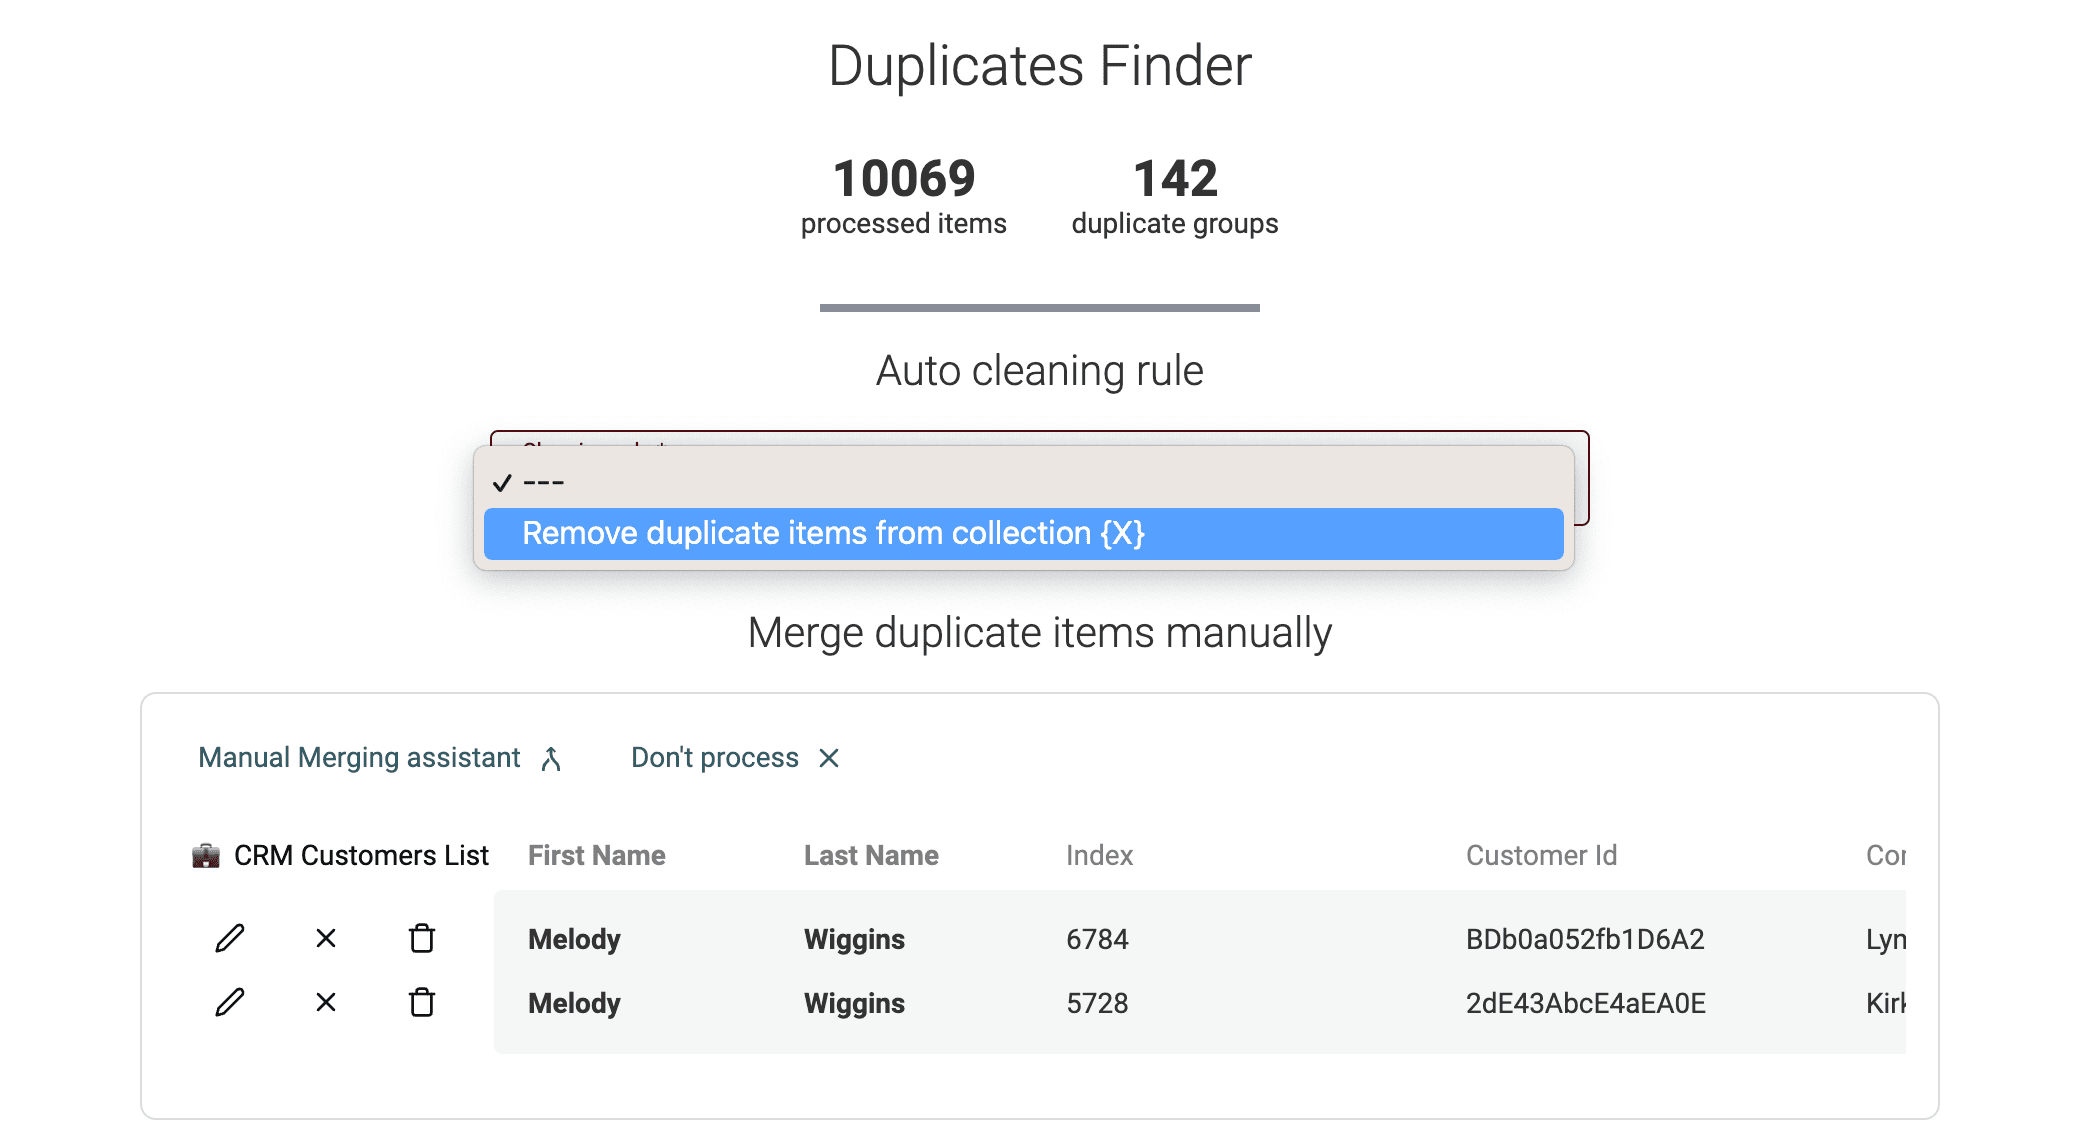
クレンジングアルゴリズムを実行する前に、変更予定の内容がプレビュー表示されます。
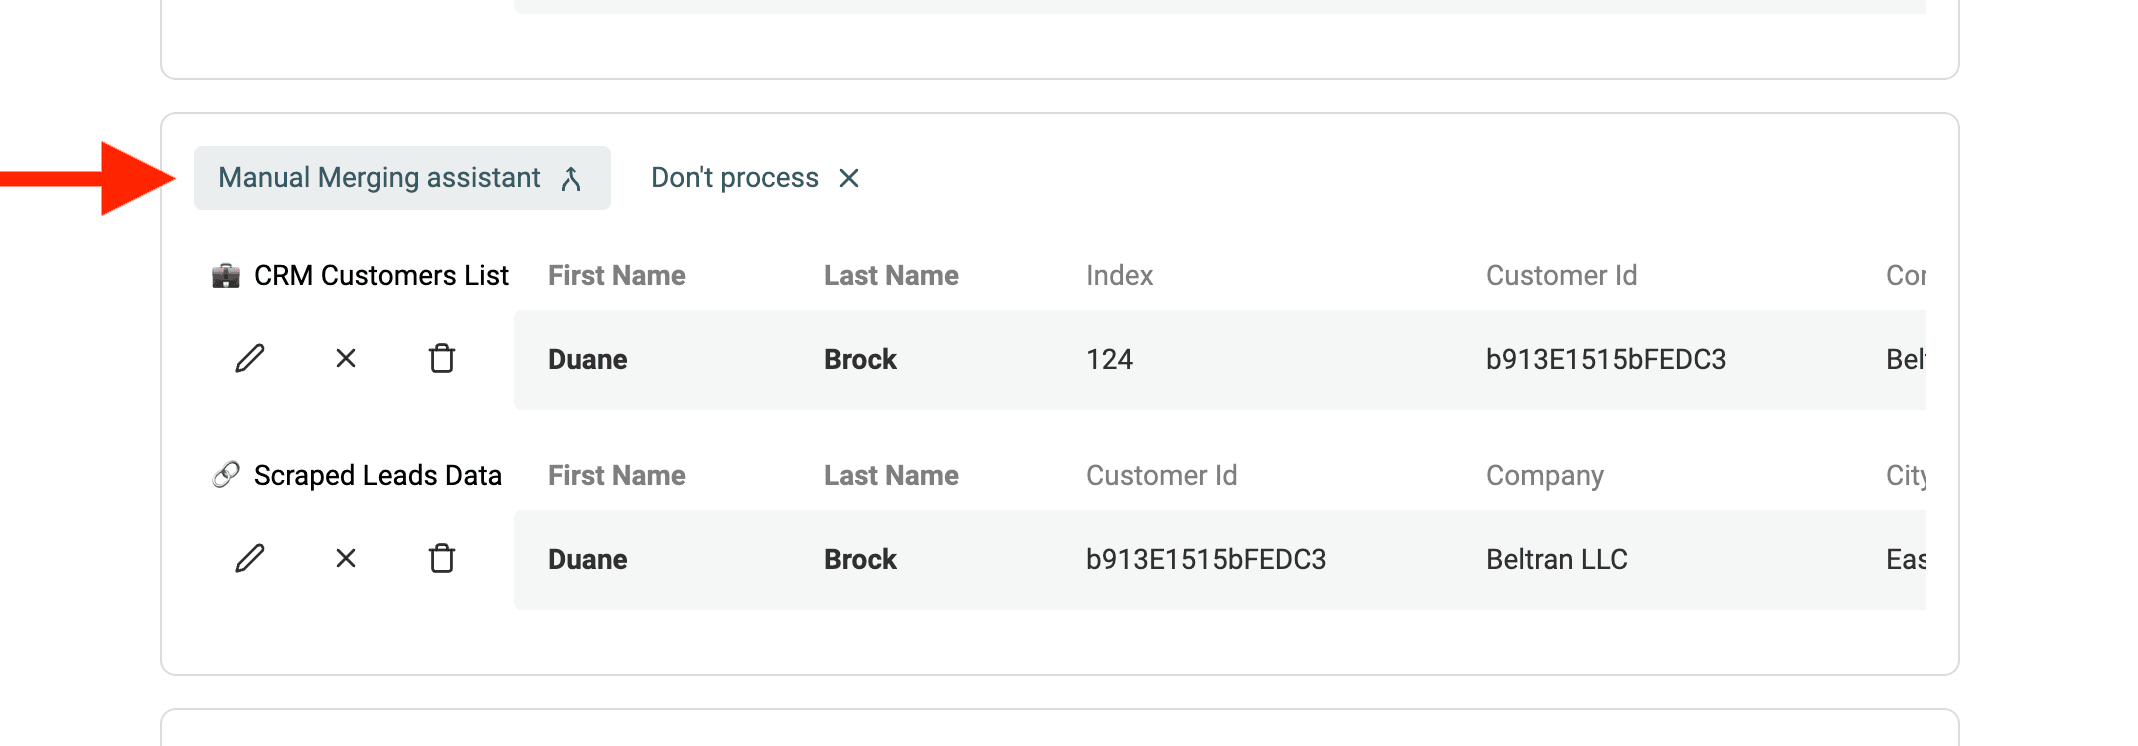
Merging Assistantで手動マージする
残った重複レコードには、手動のMerging Assistantを使用できます。
Review groupをクリックし、Manual Merging Assistantを開きます。
マージツールが開きます。右側には「Primary Item」、左側には残りの重複アイテムが「Secondary Items」として表示されます。 Datablistは、最も多くのデータを持つアイテムを「Primary Item」に選びます。
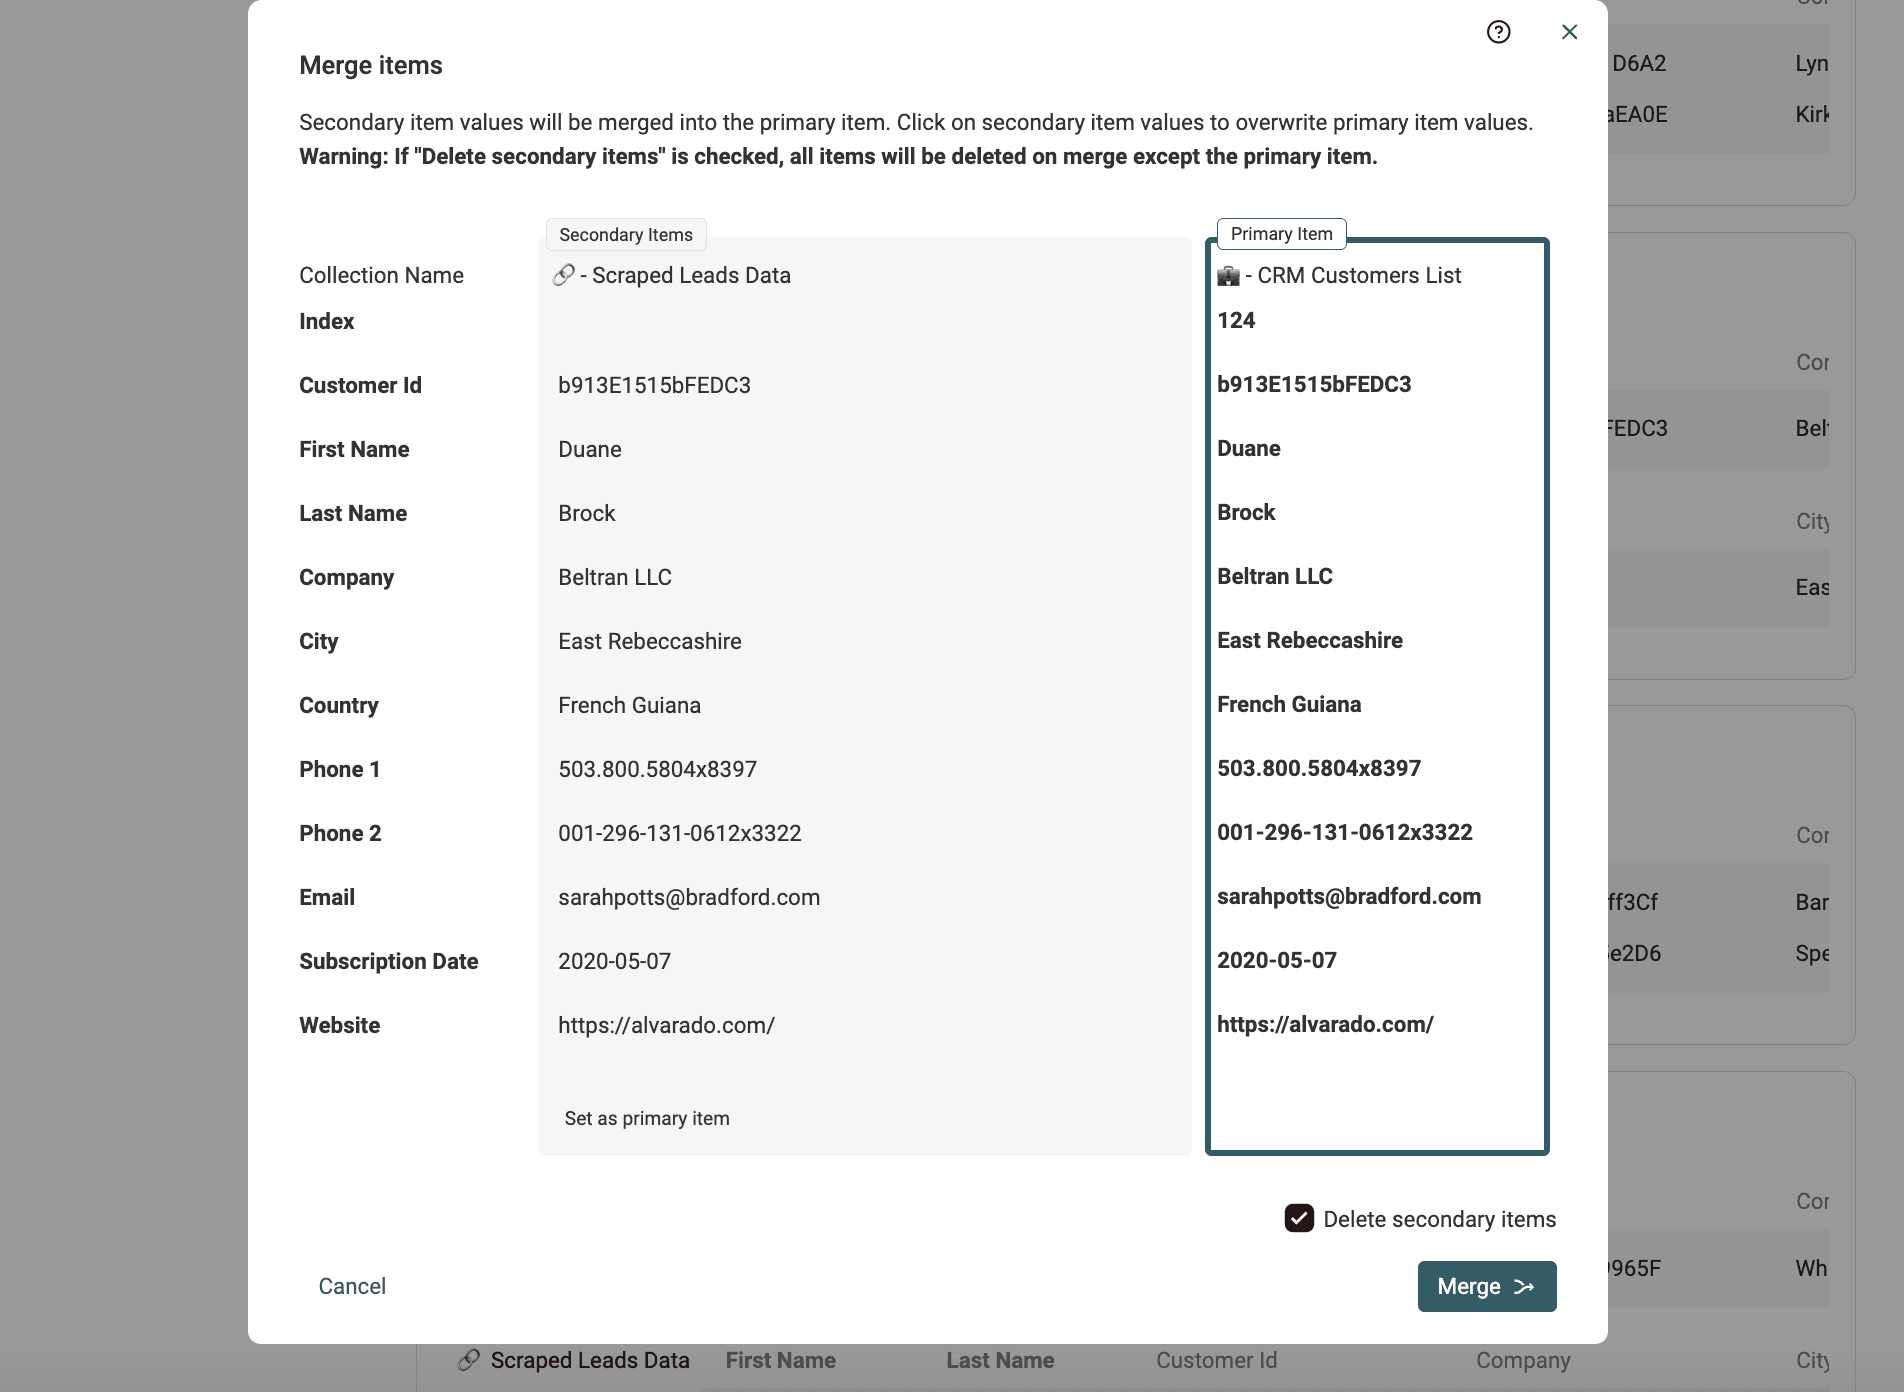
可能な場合は、Secondary Itemsのプロパティ値が自動選択され、Primary Itemへマージされます。複数の値が競合する場合は、どの値を残すか選択する必要があります。
完成した「Primary Item」に問題がなければ、Mergeボタンをクリックしてマージを確定します。Secondary Itemsはすべて削除され、統合された1件のアイテムだけが残ります。
注記 複数のcollectionで重複排除を行う場合でも、collectionのデータ構造が類似していれば、Manual Merging Assistantを利用できます(同じプロパティを持つ場合)。
重複グループをダウンロードして外部ツールでマージする
最後に、Datablistのデータ照合ツールでは、検出した重複グループをエクスポートできます。すべての重複アイテムを連続して並べたCSVまたはExcelファイルを出力できます。
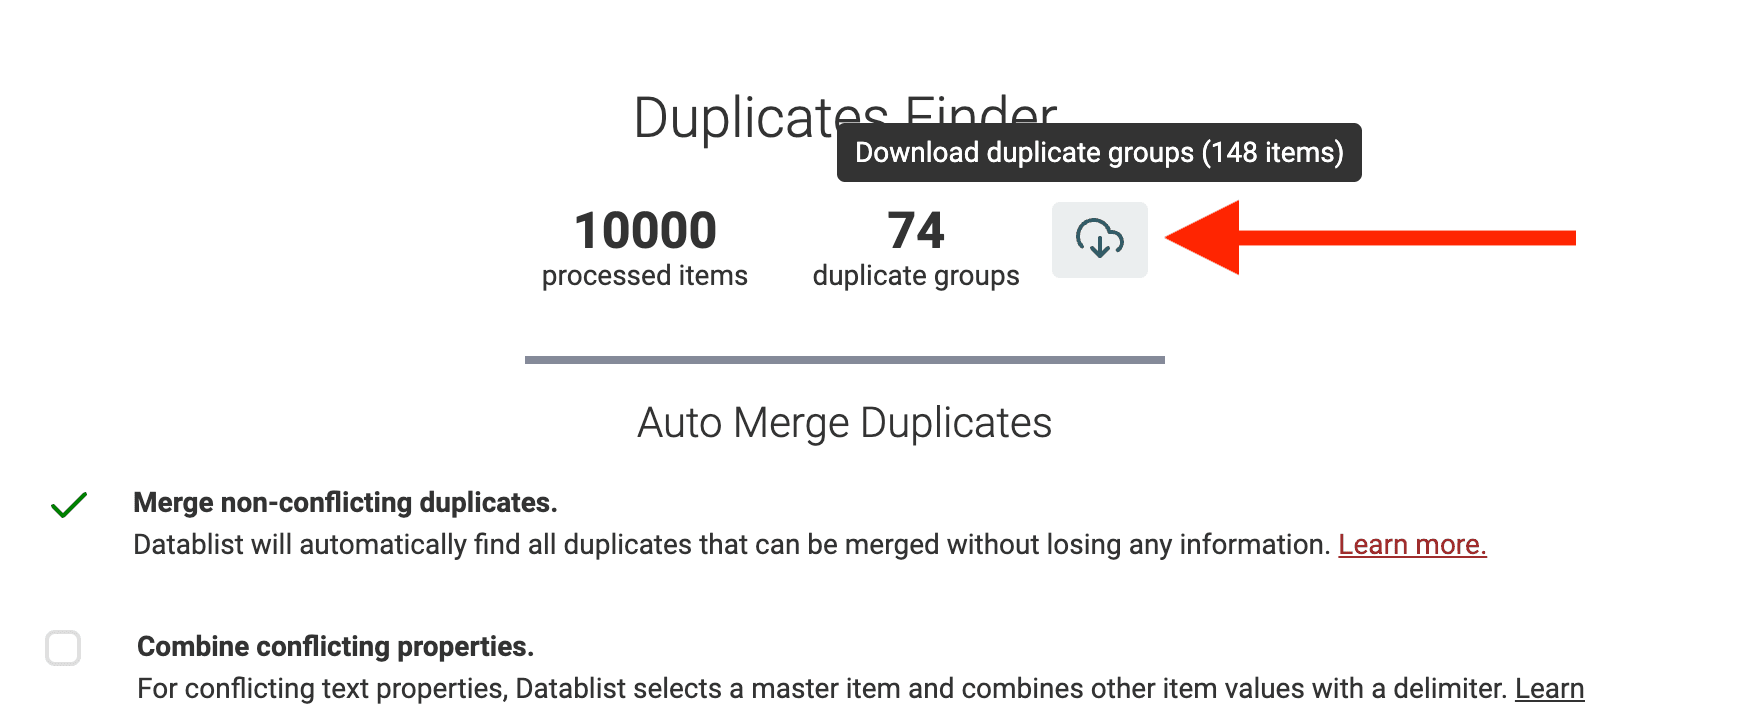
エクスポートしたファイルは、表計算ソフトなどの別ツールでレコードをクレンジングしたり、より複雑な分析を行ったりする際にご活用ください。
FAQ
データ照合とは何ですか?
データ照合とは、record linkageや重複排除とも呼ばれ、1つまたは複数のデータセットに含まれる関連レコードを特定し、結び付ける処理です。同じ実体、人物、対象を表す重複レコードや類似レコードを検出して統合し、データの品質、精度、一貫性を高めることが主な目的です。
時間の経過とともに重複レコードが追加されたデータセットのクレンジングや、類似または重複するフィールドを持つ複数のデータセットの統合に役立ちます。
データ照合では、メールアドレス、WebサイトURL、識別用の文字列や番号など、識別力の高いフィールドを使用できます。また、氏名、生年月日、企業名、所在地など、一意ではない複数の属性を組み合わせ、レコード間の類似度スコアを算出する方法もあります。
Datablistのデータ照合はどのくらい高速ですか?
Datablistのデータ照合ツールは、データセットをメモリへ読み込んで照合分析を行います。100万レコード未満のデータセットに適しており、多くのデータ照合分析は数分以内に完了します。
データ照合に専門的なスキルは必要ですか?
いいえ。Datablistは、データアナリストからマーケティング、営業担当者まで、どなたでも使えるno-codeソリューションです。
データ照合はどのような場面で使いますか?
データ照合は、金融、医療、マーケティング、顧客管理など、信頼できるデータに基づく意思決定やほかのツールとのデータ連携が必要な幅広い分野で活用されています。
不正検知、ユーザープロファイルの統合、複数ソースからのデータエンリッチメントなどにも役立ちます。
次に読むおすすめガイド
データクレンジングに関心がある方には、次のガイドもおすすめです。