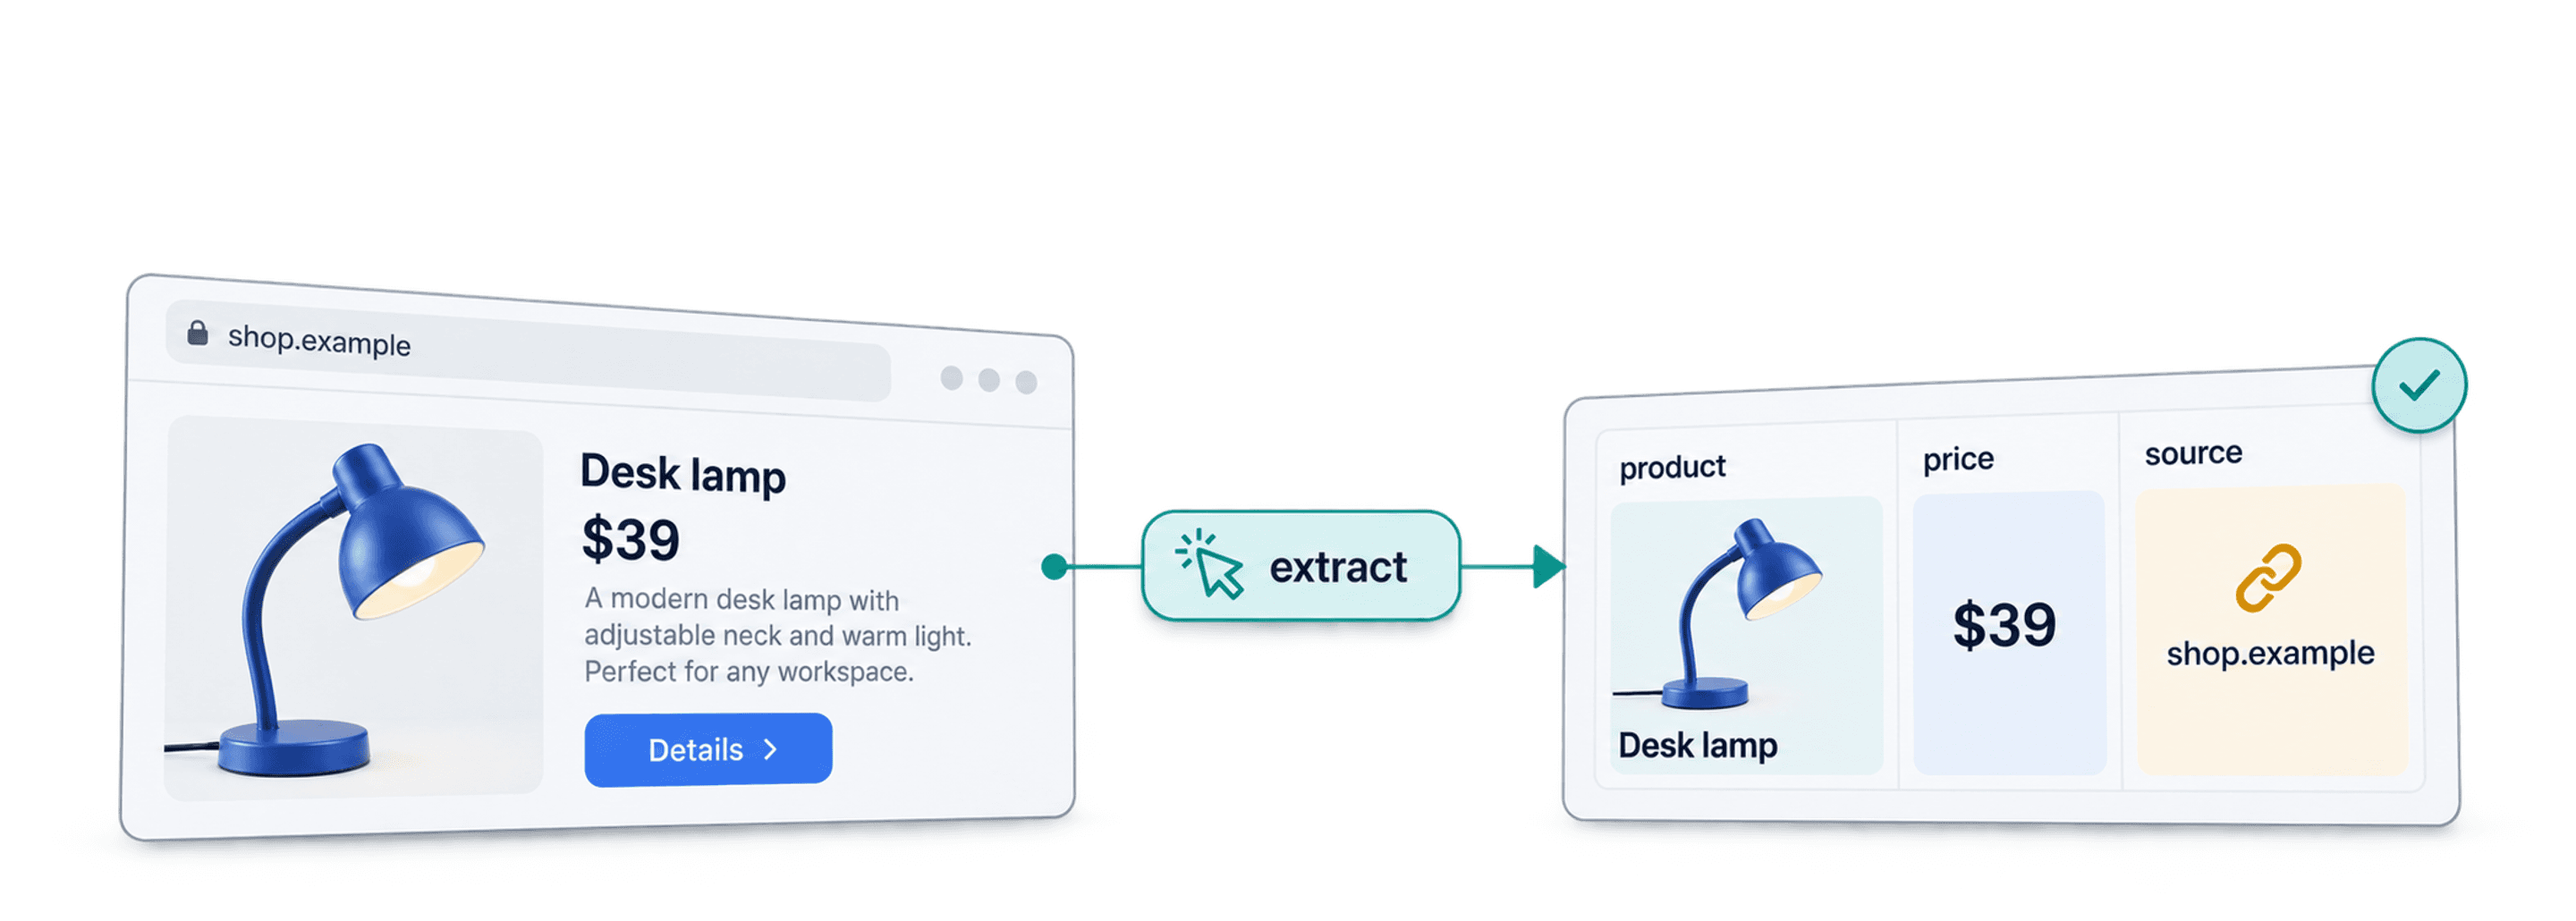
AI 웹 스크래핑은 AI 모델로 웹사이트 콘텐츠를 읽고 제품명, 가격, 출처 URL처럼 지정한 필드를 반환하는 방식입니다. 필드마다 CSS selector를 작성하는 대신 필요한 정보를 설명하고 결과를 각 열에 매핑합니다. 다만 결과 검수는 여전히 필요합니다. 모델이 필드를 누락하거나 서로 다른 페이지를 혼동하고, 출처에서 확인할 수 없는 값을 반환할 수도 있기 때문입니다.
예를 들어 Agent에 제품 페이지를 제공하고 제품명, 현재 가격, 제품 URL을 요청할 수 있습니다. 바람직한 결과는 이 세 필드가 한 행에 정리되고, 가격이 원본 페이지와 대조된 형태입니다. 페이지에 가격이 표시되지 않았다면 추측하지 말고 해당 필드를 비워 두어야 합니다. 이 가이드에서는 AI 추출과 규칙 기반 스크래핑의 차이, 상황에 맞는 워크플로 선택법, 데이터 활용 전에 확인할 항목을 설명합니다.
이 가이드에서 다루는 내용
AI 웹 스크래핑이란?
아래 용어들은 모두 넓은 의미에서 같은 접근 방식을 가리킵니다. 어떤 도구를 사용하든 접근 가능한 원본 콘텐츠와 명확한 출력 필드가 필요합니다.
AI Web Scraping, AI Scraping, AI Data Scraping
AI web scraping = AI scraping = AI data scraping
모두 AI 모델을 이용해 웹 콘텐츠에서 정보를 식별하고 구조화하는 방식을 뜻합니다. 기존 스크래퍼는 일반적으로 CSS selector나 XPath로 요소를 선택합니다. 반면 AI 추출 워크플로는 prompt나 schema를 이용해 의미를 기준으로 필드를 찾습니다. 페이지마다 레이아웃이 다를 때 유용하지만, 접근할 수 없는 페이지나 변경된 콘텐츠, 잘못된 출력까지 자동으로 해결해 주는 것은 아닙니다.
AI 스크래핑을 사용해야 하는 이유
페이지마다 같은 정보가 서로 다른 위치에 표시되거나, 비정형 텍스트를 열 단위 데이터로 변환해야 할 때 AI 추출이 유용합니다. 반대로 레이아웃이 일정하고 안정적인 페이지에서는 규칙 기반 스크래핑이 더 단순하고 저렴할 수 있습니다. 원본 데이터와 필요한 출력 형태를 기준으로 선택하세요.
코딩도 API도 필요 없는 방식
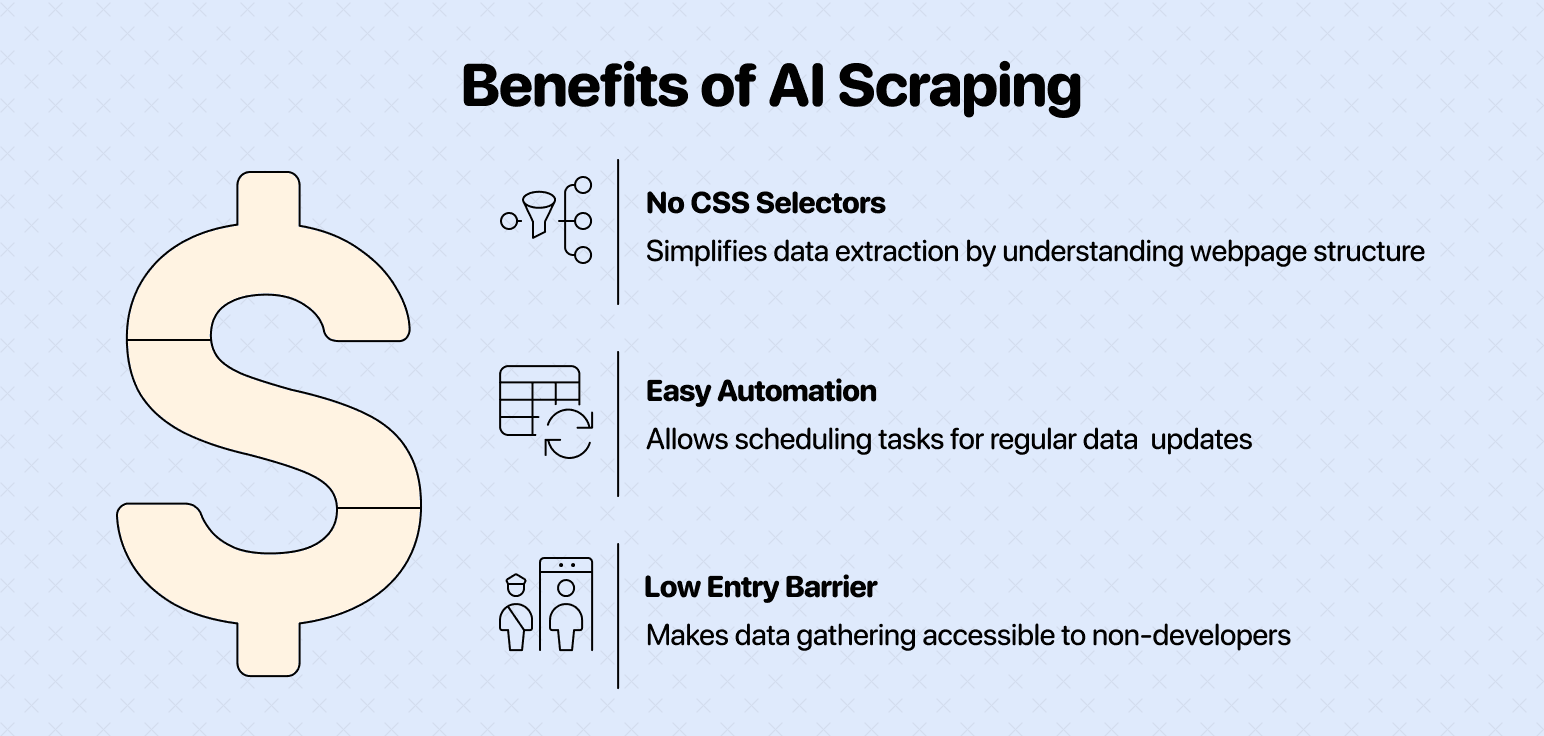
일부 AI 스크래핑 도구는 사용자 인터페이스에서 자연어 prompt를 입력하는 방식으로 작동합니다. API나 코드가 필요한 도구도 있습니다. 요청을 작성할 때는 출력할 각 필드의 이름과 페이지에 값이 없을 때의 처리 방식을 명확히 지정해야 합니다.
CSS Selector와 XPath 없이 간편하게
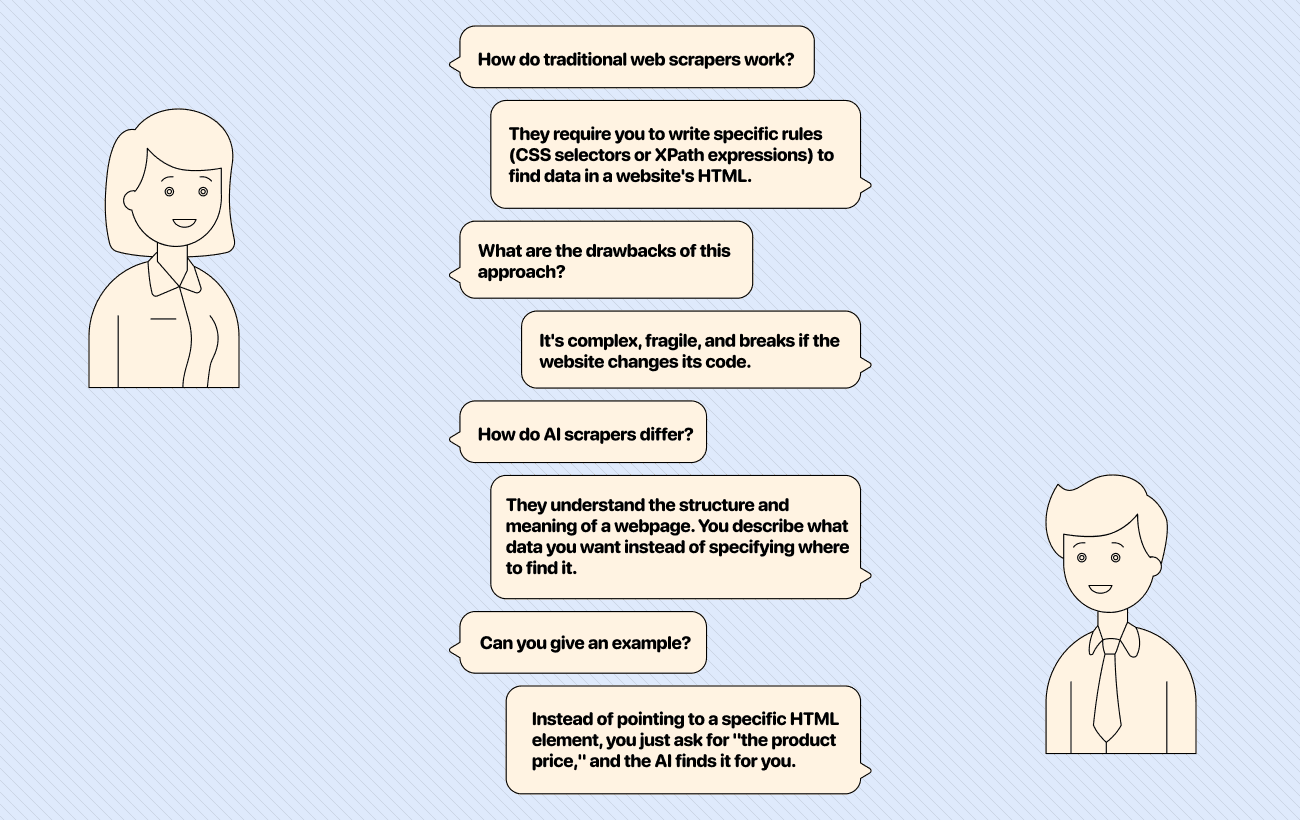
Selector 기반 스크래퍼에서는 값이 들어 있는 HTML 요소를 직접 지정합니다. AI 추출에서는 레이아웃이 서로 다른 여러 페이지에도 “현재 제품 가격”과 같은 필드를 요청할 수 있습니다. 먼저 대표 페이지 몇 개에서 두 방식을 모두 테스트해 보세요. 레이아웃 변경, 차단된 페이지, 모호한 가격 표기 때문에 prompt 수정이나 수동 검수가 필요할 수 있습니다.
간편한 자동화와 낮은 진입 장벽
URL 목록에 AI 추출 워크플로를 실행하거나, 하나의 사이트 URL에서 시작할 수 있습니다. 반복 실행하기 전에는 출력 결과 일부를 확인해 빈 필드, 잘못 연결된 값, 원본 사이트 구조의 변경 여부를 점검하세요. 자동화된 작업에도 지속적인 모니터링은 필요합니다.
AI 스크래핑 활용 사례
AI 스크래핑은 비즈니스의 거의 모든 영역에서 폭넓게 활용할 수 있습니다. 웹 데이터 수집을 자동화하면 팀은 중요한 인사이트를 더 빠르게 확보하고 효율적으로 업무를 수행할 수 있습니다.
AI Scraping으로 할 수 있는 작업은 다음과 같습니다.
- 이커머스 스토어 스크래핑
- 수천 개의 상품 페이지에서 제품명, 가격, 설명, 이미지 등의 정보를 추출할 수 있습니다.
- 경쟁사 분석, 가격 모니터링, 제품 카탈로그 구축에 유용합니다.
- 리뷰 스크래핑
- Yelp, G2, Amazon 같은 사이트의 고객 리뷰를 수집하면 시장의 전반적인 반응을 파악할 수 있습니다.
- AI로 데이터를 분석해 반복되는 주제, 제품의 문제점, 고객 만족 요인을 찾아 경쟁사 분석에 활용할 수 있습니다.
- 가격 페이지 모니터링
- Sales와 Marketing 팀은 경쟁사의 가격 및 프로모션을 자동으로 추적할 수 있습니다.
- 이를 바탕으로 동적 가격 전략을 수립하고 시장 경쟁력을 유지할 수 있습니다.
- 고객 사례 스크래핑
- Marketing 팀은 경쟁사 웹사이트에서 고객 사례를 수집해 포지셔닝과 성공 사례를 분석할 수 있습니다.
- 이 정보는 자사의 마케팅 메시지와 Sales pitch를 개선하는 데 유용합니다.
- 데이터베이스에 없는 정보 조사
- 일부 정보는 구조화된 데이터베이스에 존재하지 않습니다.
- AI scraper를 이용하면 포럼, 블로그, 전문 웹사이트에서 고유한 데이터를 수집해 시장 조사, 학술 연구, 탐사 보도 등에 활용할 수 있습니다.
💡 AI Scraping을 시작하는 실전 가이드
AI 스크래핑 방법 2가지
AI 스크래핑 도구는 작업 유형에 따라 서로 다른 접근 방식을 제공합니다. 기반 기술은 비슷하지만, 기존 데이터셋을 enrichment할지 아니면 새로운 웹사이트를 처음부터 탐색할지에 따라 적합한 방법이 달라집니다.
대표적인 두 가지 방법을 살펴보겠습니다.
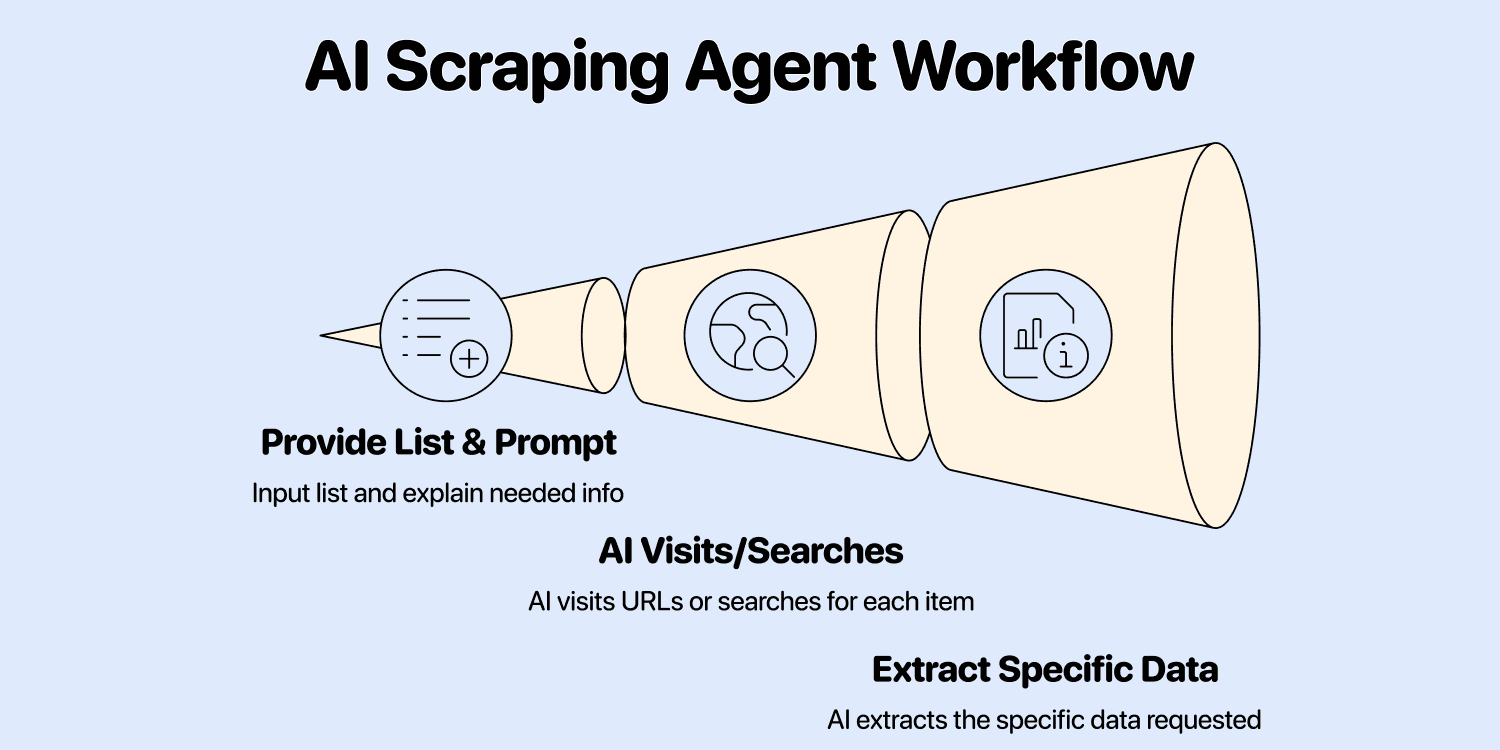
항목 목록에 AI Scraping Agent 실행하기
회사명이나 제품 URL이 정리된 spreadsheet처럼 이미 출발점이 있을 때 적합한 방법입니다. 목록과 함께 각 항목에서 추가로 필요한 정보를 설명하는 prompt를 AI Agent에 제공합니다.
그러면 AI가 각 URL을 방문하거나 항목별 검색을 수행해 요청한 데이터를 추출합니다.
- 추천 용도: 회사 목록에서 업종을 찾거나 Account 목록에서 CEO 이름을 찾는 등 기존 데이터셋을 enrichment하는 작업
- 검수 방법: 먼저 소량의 샘플로 테스트하고, 중요한 필드는 원본 페이지와 대조하세요.
URL과 Prompt로 AI Scraping Agent를 Site Scraper처럼 사용하기
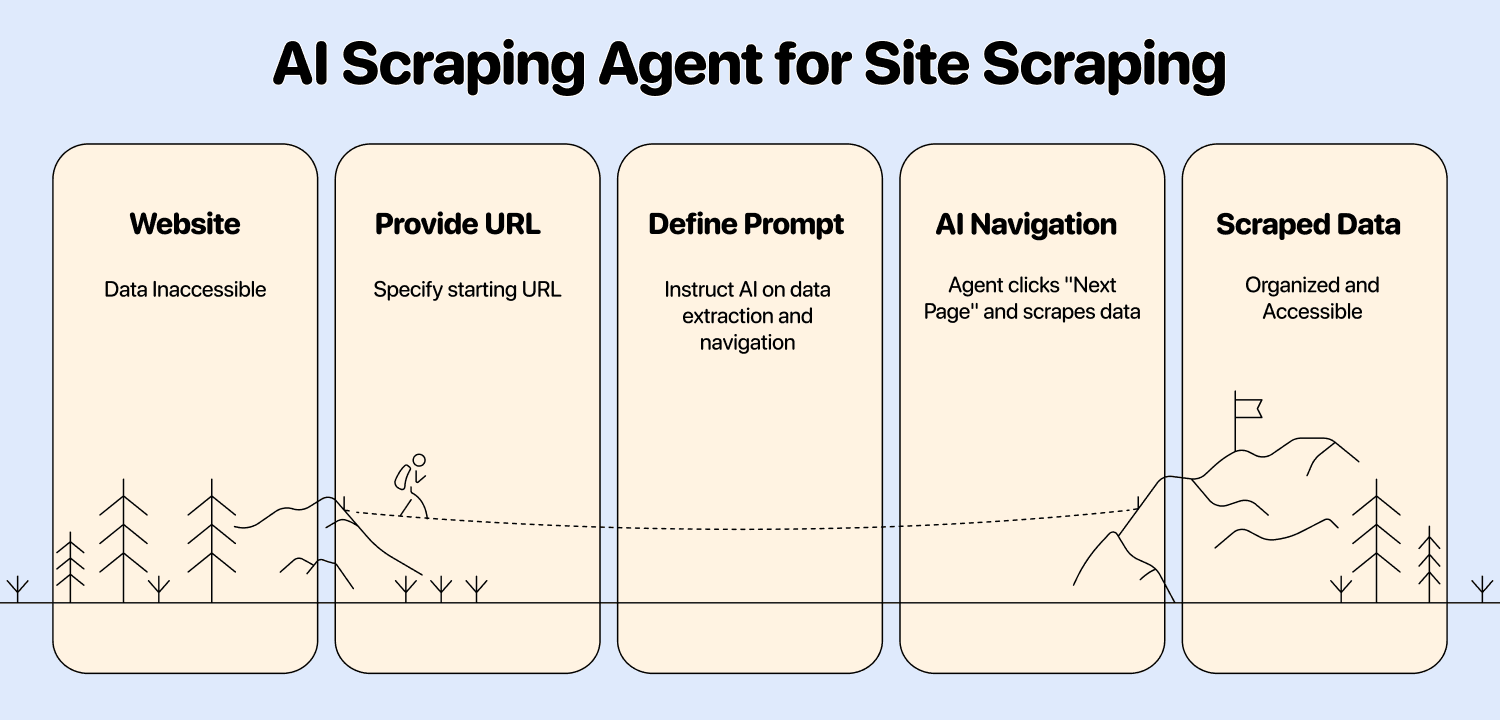
웹사이트 전체 또는 특정 영역을 탐색하고 데이터를 추출할 때 사용하는 방법입니다. 시작 URL과 함께 AI가 무엇을 찾고 사이트를 어떻게 탐색해야 하는지 설명하는 prompt를 제공합니다. 예를 들어 이커머스 사이트의 카테고리 페이지를 시작 URL로 지정할 수 있습니다.
Datablist의 website scraper에는 시작 URL과 추출할 항목을 설명하는 prompt를 입력합니다. Pagination은 선택 사항이며, 원본 사이트의 검색 결과가 여러 페이지로 나뉘어 있을 때 설정하면 됩니다.
웹사이트 스크래핑 설정 및 샘플 검수 방법에서는 출력 결과와 prompt를 대조하고, 렌더링을 테스트하며, 필드 누락과 페이지 차단을 구분하는 과정을 안내합니다.
- 추천 용도: Amazon이나 eBay 같은 사이트의 제품 목록, 블로그 게시물 또는 각종 디렉터리의 리스트 추출
- 검수 방법: 먼저 페이지 수를 제한해 실행한 뒤, 반환된 행이 의도한 페이지에서 추출됐는지 확인하고 작업 범위를 확대하세요.
AI 스크래핑 도구
AI 스크래핑 도구 시장은 빠르게 성장하고 있습니다. 적합한 제품은 사용자의 기술 수준, 예산, 구체적인 요구 사항에 따라 달라집니다. 아래에서는 세 가지 도구와 USD 기준 월간 결제 시작 가격을 비교합니다.
| 도구 | 주요 용도 | 시작 가격 | 월간 기본 제공량 |
|---|---|---|---|
| Datablist | No-code 스크래핑 및 spreadsheet enrichment | 월 $25 | 5,000 credits |
| Firecrawl | 앱을 위한 웹 데이터 및 구조화 추출 | 월 $19 | 5,000 credits |
| ScrapingBee | AI 추출 기능을 제공하는 Scraping API | 월 $19 | 75,000 API credits |
각 도구의 credit은 서로 다른 작업량을 나타냅니다. Datablist는 사용한 AI 모델과 도구에 따라 차감하고, Firecrawl은 페이지와 선택한 출력 형식을 기준으로 계산합니다. ScrapingBee는 기본 요청 비용에 AI 추출 비용을 추가합니다. 따라서 단순히 제공 credit이 가장 많다고 해서 실제 워크플로 비용이 가장 저렴한 것은 아닙니다.
Datablist - Sales, Marketing, Operations 팀을 위한 도구
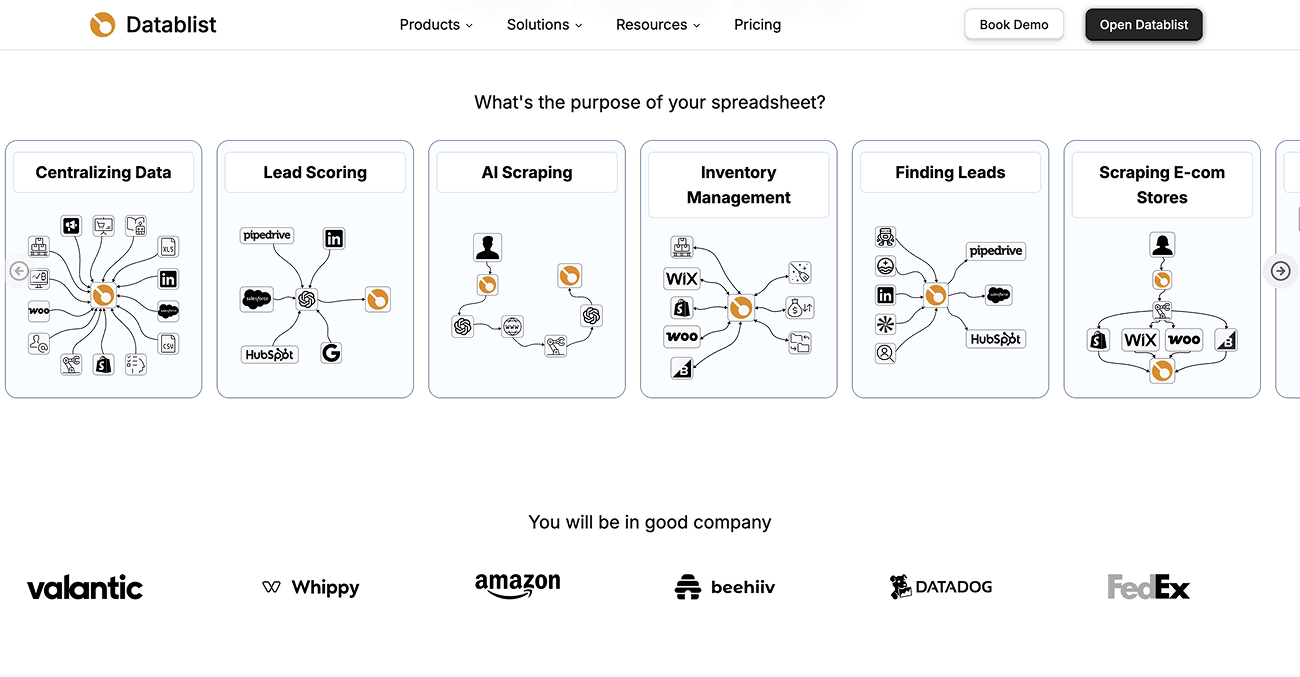
Datablist는 강력한 AI 스크래핑 기능을 사용하기 쉬운 spreadsheet 인터페이스에 통합한 데이터 자동화 플랫폼입니다. 코드 작성이나 API 설정 없이 데이터를 수집하고 enrichment해야 하는 Sales, Marketing, Operations 팀을 위해 설계되었습니다.
주요 기능:
- 자연어 Prompt: 필요한 정보를 일상적인 언어로 설명하면 AI Agent가 찾아줍니다. 코딩이나 복잡한 API 설정이 필요하지 않습니다.
- 두 가지 시작 방식: 기존 행에 AI Agent를 실행하거나, 웹사이트 URL과 prompt를 입력하고 선택적으로 pagination을 설정할 수 있습니다.
- 실행 설정: Website scraper에는 페이지 제한과 선택형 HTML rendering 설정이 있습니다. 페이지 수를 늘리기 전에 소규모로 테스트하세요.
- 구조화된 출력: 요청한 필드를 collection의 각 열에 매핑하고 행을 검수한 뒤, 필요에 따라 다른 enrichment 결과와 결합할 수 있습니다.
가격:
- Starter: 월 $25, 5,000 credits 제공. Growth는 월 $50에 20,000 credits를 제공합니다.
- AI 스크래핑 사용량은 모델, 도구, 방문한 페이지에 따라 달라집니다. HTML rendering을 활성화하면 scrape당 2 credits가 추가됩니다.
- 25,000 credits가 필요한 작업이라면 Starter와 20,000-credit top-up을 합해 $45($25 + $20)가 듭니다. 이는 페이지 수에 따른 고정 가격이 아니라 credit 예산의 예시입니다. Top-up은 활성화된 유료 plan에서 구매할 수 있으며 만료되지 않습니다.
💡 Datablist의 숨은 강점
Datablist의 AI Scraper는 단순한 scraper가 아닙니다. Google 검색, Google News 방문, API 호출, 데이터 추출, 웹사이트 pagination 등을 수행할 수 있는 AI scraping agent입니다.
Firecrawl - AI App을 위한 Web Data API
Firecrawl은 개발자를 위한 오픈 소스 Web Data API로, 웹사이트를 LLM이 바로 활용할 수 있는 데이터로 변환해 AI application 구축을 지원합니다.
주요 기능:
- 구조화 추출: URL과 JSON schema 또는 prompt를 입력해 필요한 필드를 정의할 수 있습니다. 반환된 값은 원본 페이지와 대조해야 합니다.
- LLM-Ready 출력: JSON, Markdown, screenshot 등 AI 처리에 바로 사용할 수 있는 다양한 형식으로 데이터를 제공합니다.
- Developer-First 접근 방식: Python과 Node.js용 SDK를 제공하며, 상세한 문서와 예제를 갖추고 있습니다.
가격:
- Hobby: 월 $19, 5,000 credits 제공. Standard는 월 $99에 100,000 credits를 제공합니다. 연간 결제 할인 가격이 아닌 월간 결제 기준입니다.
- 기본 페이지 scrape에는 1 credit이 필요합니다. JSON을 선택하면 4 credits가 추가되므로 JSON 추출을 적용한 페이지 한 개에 5 credits가 사용됩니다. 다른 모드를 선택하면 사용량이 달라질 수 있습니다.
ScrapingBee - 개발자를 위한 AI Scraper
ScrapingBee는 proxy와 browser 처리를 지원하는 API-first 스크래핑 도구입니다. 개발자는 코드에서 직접 호출할 수 있으며, n8n이나 Make 같은 integration을 이용해 다른 워크플로에 연결할 수도 있습니다. 요청 설정과 반환 데이터 매핑은 사용자가 직접 해야 합니다.
주요 기능:
- AI 기반 Web Scraping: AI로 데이터를 parsing하고 추출해 웹사이트 변경에 더 유연하게 대응합니다.
- API Access: 개발자가 자체 application과 워크플로에 통합할 수 있도록 설계되었습니다.
- JavaScript Rendering: JavaScript 의존도가 높은 최신 동적 웹사이트도 스크래핑할 수 있습니다.
가격:
- Hobby: 월 $19, 75,000 API credits 제공. 월 $49인 Freelance plan은 250,000 credits를 제공합니다.
- AI 추출에는 요청당 5 credits가 추가됩니다. AI 추출 비용을 더하기 전 기본 요청은 1 credit, JavaScript rendering을 사용한 요청은 5 credits입니다. Premium proxy 설정에 따라 기본 비용이 더 높아질 수 있습니다.
구조화 데이터 추출 비용은 얼마일까?
아래 예시는 페이지당 요청 한 건과 명시된 설정을 기준으로 계산했습니다. 정확하게 추출된 레코드 수가 아니라 API 사용량에 대한 비용입니다.
| 도구 및 작업 | 필요 Credits | 월간 Plan 및 비용 |
|---|---|---|
| Firecrawl: JSON 추출로 1,000페이지 처리 | 5,000 | Hobby: $19 |
| Firecrawl: JSON 추출로 10,000페이지 처리 | 50,000 | Standard: $99 |
| ScrapingBee: JavaScript rendering 없이 AI 추출 요청 10,000건 | 60,000 | Hobby: $19 |
| ScrapingBee: JavaScript rendering을 적용한 AI 추출 요청 10,000건 | 100,000 | Freelance: $49 |
ScrapingBee의 마지막 두 행은 각각 10,000 × (1 + 5), 10,000 × (5 + 5)로 계산됩니다. Rendering을 사용하면 필요한 credits가 Hobby 제공량을 초과합니다. Datablist는 먼저 소규모 작업을 실행해 사용 중인 모델, prompt, 원본 페이지의 credit 사용량을 확인한 후, 위에서 설명한 $25 Starter 제공량과 top-up 가격을 기준으로 예산을 계산하세요.
AI 스크래핑 결과 검증 방법
데이터셋을 사용하기 전에 일부 행을 원본 페이지와 대조하세요. 각 값이 올바른 항목에 연결됐는지, 단위와 통화가 그대로 유지됐는지, 원본에 없는 값이 빈칸으로 남아 있는지 확인해야 합니다. 원본 페이지에 접근할 수 없거나 결과가 불확실하다면 prompt를 수정하거나 해당 행을 직접 검토하세요. 원본 사이트가 변경된 후에도 샘플을 다시 점검해야 합니다.
AI 스크래핑 FAQ
ChatGPT로 웹 스크래핑을 할 수 있나요?
AI 모델은 사용자가 제공한 웹 콘텐츠에서 필드를 추출할 수 있습니다. 많은 URL을 대상으로 반복 실행하려면 출처 URL을 기록하고, 필드를 각 열에 매핑하며, 실패하거나 불확실한 행을 검수할 수 있는 워크플로를 사용하세요.
AI Scraping이란 무엇인가요?
AI scraping은 모델을 사용해 웹사이트 콘텐츠에서 요청한 필드를 식별하고 구조화된 결과로 반환하는 방식입니다. CSS selector를 지정하는 대신 prompt로 필드를 설명할 수 있지만, 중요한 결과는 원본과 대조해야 합니다.
웹 스크래핑은 합법인가요?
관련 규정은 웹사이트, 데이터 유형, 관할 지역에 따라 달라집니다. 특히 개인정보를 수집하거나 사용할 때는 해당 사이트의 이용약관과 적용되는 법적 요건을 먼저 확인하세요.
Data Scraping이란 무엇인가요?
Data scraping은 웹사이트나 문서 같은 출처에서 정보를 추출하는 작업을 뜻합니다. AI scraping은 AI 모델을 이용해 요청한 정보를 식별하거나 구조화합니다.
AI Scraping과 기존 웹 스크래핑의 차이는 무엇인가요?
Selector 기반 스크래핑은 페이지 HTML의 특정 요소를 대상으로 합니다. AI 추출은 prompt나 schema를 이용해 의미를 기준으로 필드를 식별합니다. 사이트가 변경되거나 페이지에 접근할 수 없으면 두 방식 모두 실패할 수 있으므로, 대표 페이지에서 결과를 비교해야 합니다.
AI Scraping을 시작하려면 어떤 기술이 필요한가요?
Datablist에서는 코드를 작성하지 않고도 URL이나 행 목록을 제공하고, 필요한 필드를 설명한 뒤, 출력 결과를 매핑할 수 있습니다. 다만 결과 중 일부는 반드시 검수해야 합니다.
AI Scraper는 레이아웃이 바뀐 웹사이트도 처리할 수 있나요?
경우에 따라 가능합니다. 레이아웃이 바뀌어도 prompt가 동일한 필드를 계속 찾을 수 있지만, 페이지 차단, 콘텐츠 누락, 모호한 label은 여전히 오류를 일으킬 수 있습니다. 원본 사이트가 변경되면 샘플을 다시 검수하세요.
출처
- [1] Datablist. Starter는 월 $25에 5,000 credits, Growth는 월 $50에 20,000 credits를 제공하며, 유료 구독자는 credit top-up을 구매할 수 있습니다.
- [2] Firecrawl. 월간 Hobby와 Standard 가격은 각각 $19와 $99이며, 기본 scraping은 페이지당 1 credit, JSON은 4 credits가 추가됩니다.
- [3] ScrapingBee. Hobby는 월 $19에 75,000 credits, Freelance는 월 $49에 250,000 credits를 제공하며, AI 추출에는 기본 요청 비용 외에 5 credits가 추가됩니다.