
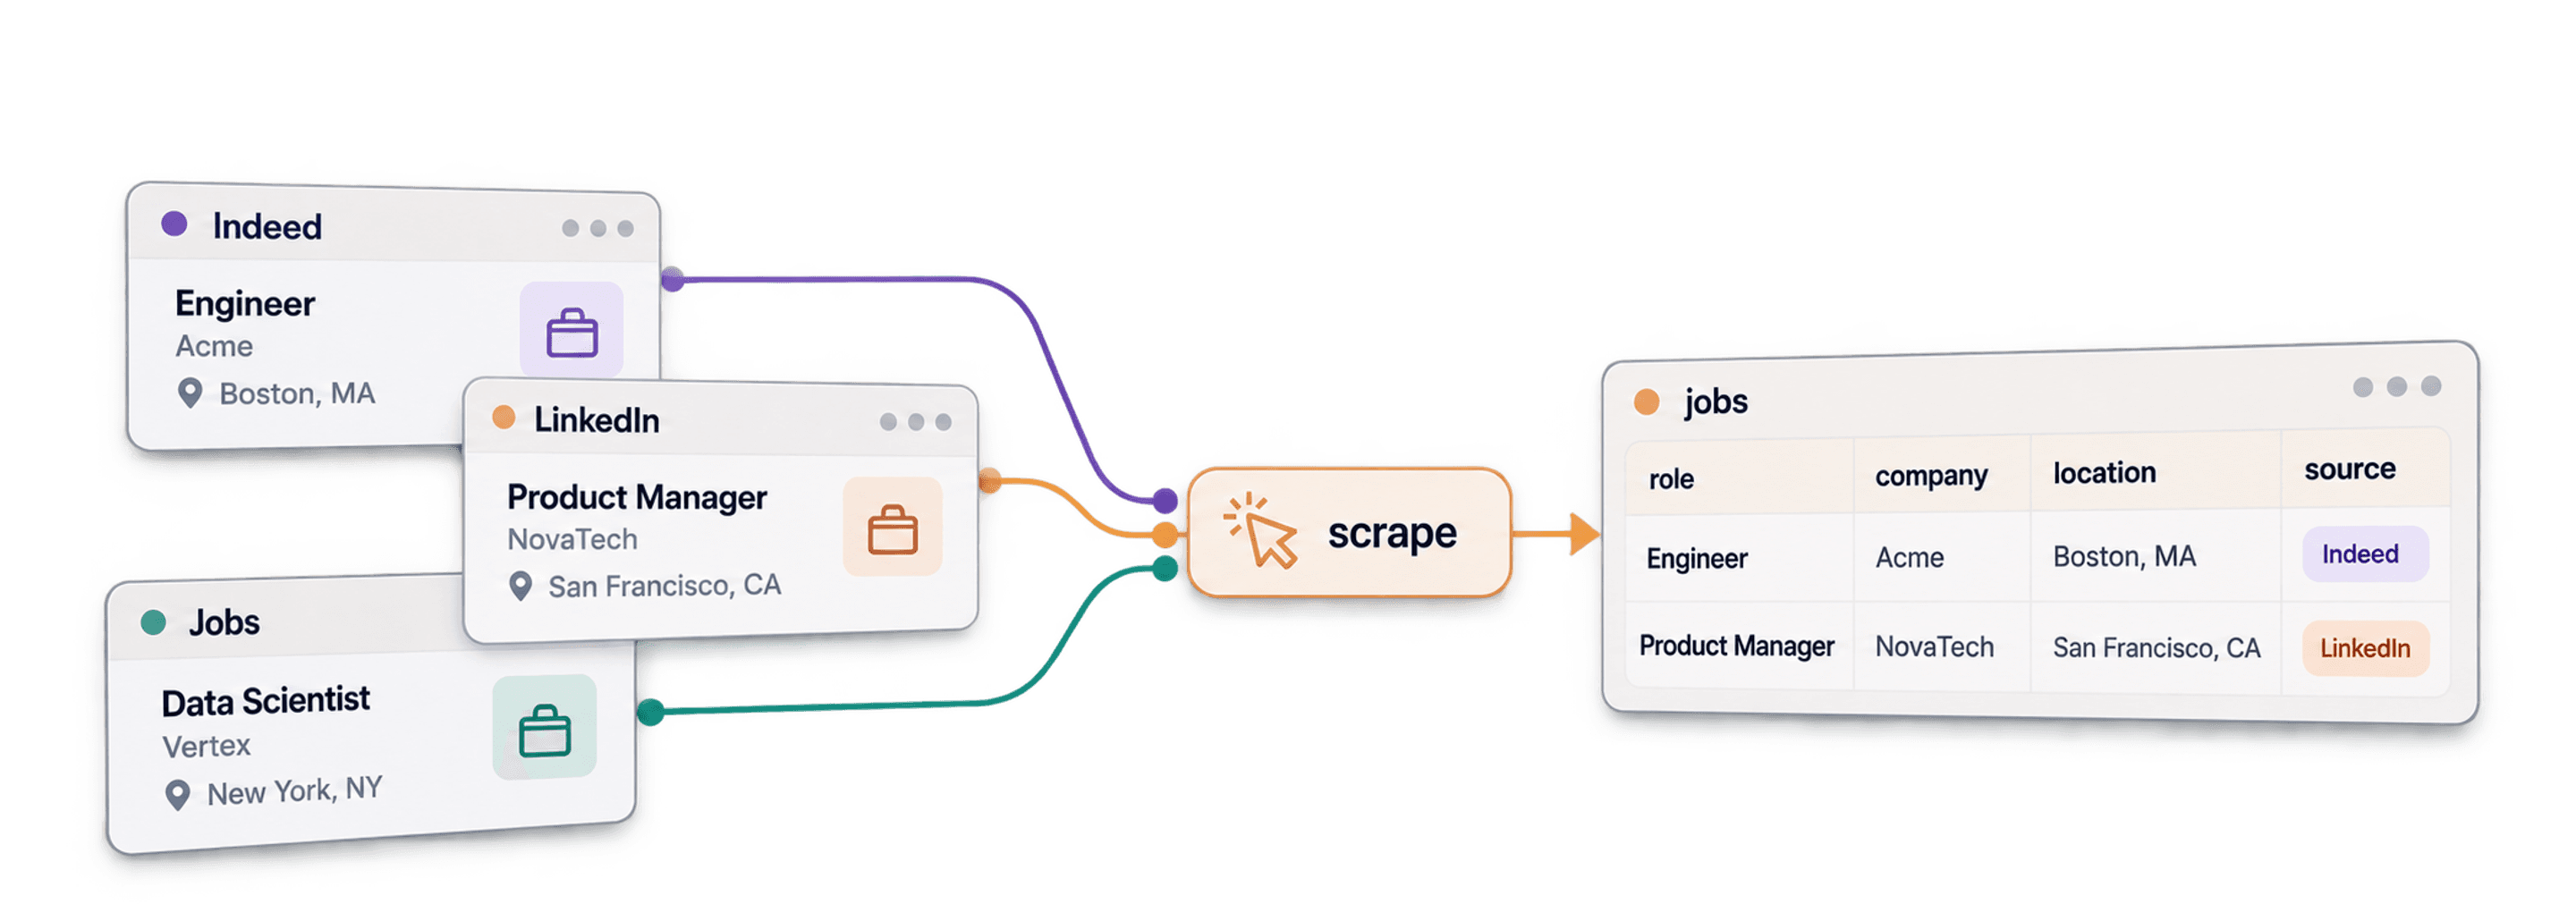
For å scrape jobbportaler med Datablist åpner du Job Postings Search, velger søkeord og land og importerer relevante stillinger til en collection. Du kan også søke etter ledige stillinger hos selskaper fra CRM-systemet ditt. Ta vare på stillings-ID, selskapets nettsted og publiseringsdato, slik at du kan sammenligne resultatene når du gjentar søket.
Jeg anbefaler å skille mellom to mål: å finne nye selskaper som ansetter, og å overvåke nye stillinger hos selskaper du allerede kjenner. Å ekskludere selskaper du har funnet tidligere, kan være nyttig for det første målet, men vil skjule nye stillinger for det andre.
Denne guiden dekker filterbaserte og selskapsbaserte søk, hvilke felter du kan hente inn, og en arbeidsflyt for gjentatte søk som sporer nye utlysninger uten å telle samme stilling to ganger.
📺 For deg som lærer best visuelt
Hvis du, som meg, heller ser en video enn å lese, kan du se videoen min om hvordan du scraper stillingsannonser fra 19 jobbportaler samtidig 👈🏽
Dette dekker artikkelen
- Metoden jeg bruker for å scrape 19 jobbportaler samtidig
- Liste over jobbportalene vi scraper
- Slik scraper du stillingsannonser – trinn for trinn
- Slik scraper du stillinger hos selskaper i CRM-systemet ditt – trinn for trinn
- Derfor bør du scrape flere jobbportaler, ikke bare én
- Slik bruker du stillingsdata i salg og markedsføring med Datablist
Metoden for å scrape 19 jobbportaler samtidig
Hvis du vil scrape 19 jobbportaler samtidig, har du to alternativer:
- Bygge en egen scraper for hver jobbportal og håndtere komplisert kode
- Bruke Datablists jobbportalscraper, som samler data fra 19 jobbportaler verden over
Datablist søker i en samlet stillingsdatabase via sin dataleverandør. Søket returnerer relevante, indekserte utlysninger. Det crawler ikke alle de oppførte jobbportalene fra bunnen av ved hvert søk. Dekningen og de tilgjengelige feltene varierer fra utlysning til utlysning, så sjekk kilde-URL-ene for stillingene du vil bruke.
💡 Hva Datablist er
Datablist er en plattform for å bygge arbeidsflyter for leadgenerering, der du kan finne, berike og rense data med over 60 ulike verktøy – fra AI Agents og Email Finders til AI-processorer, teknologiberikelse og mye mer.
I tillegg lar Datablist deg konfigurere automatiserte arbeidsflyter som kjører etter en tidsplan eller ved behov. Her er noen praktiske bruksområder Datablist-brukere setter pris på:
- Bygge leadlister
- Tilpasse e-poster med AI
- Rense og deduplisere CRM-data
- Scrape stillingsannonser fra 19 jobbportaler samtidig
- Scrape LinkedIn Sales Navigator-søk uten å risikere kontoen din
Poenget er enkelt: Hvis du trenger å hente eller rense data eller automatisere datadrevne arbeidsflyter, og løsningen må være enkel, rask og pålitelig, er Datablist et naturlig valg.
Jobbportalene Datablist scraper for deg
Datablist har noen unike fordeler sammenlignet med andre scrapere for stillingsdata. Løsningen samler data fra 19 jobbportaler samtidig, slik at du slipper å bruke timevis på å konfigurere og vedlikeholde separate scrapere.
Her er jobbportalene Datablist scraper:
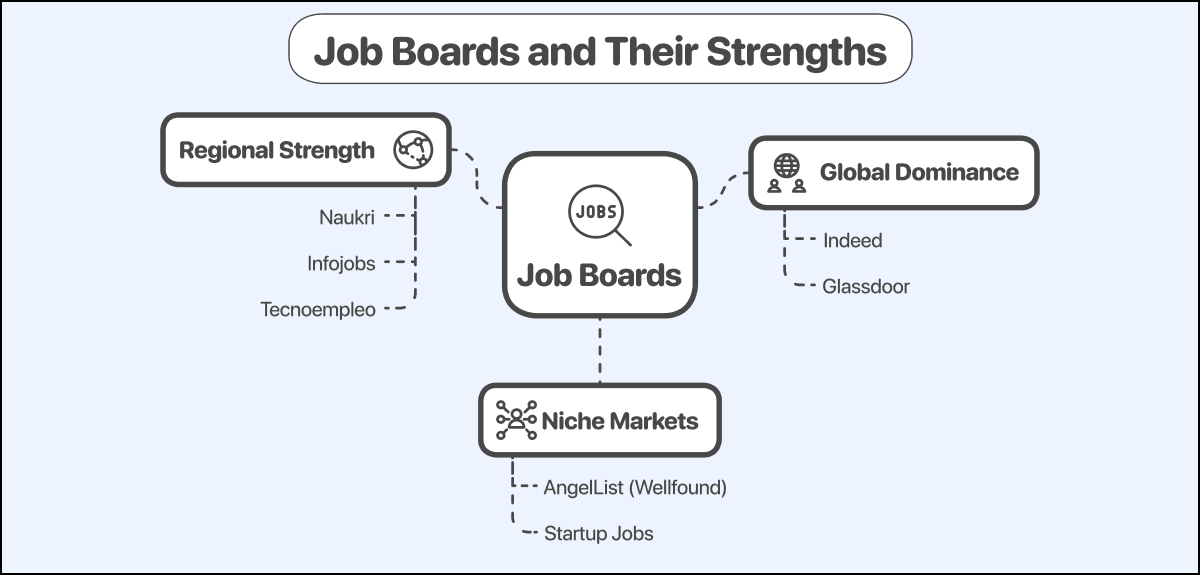
Globale jobbportaler:
- Indeed: Har en dominerende posisjon globalt og bred dekning på tvers av de fleste land og bransjer.
- Glassdoor: En global plattform med både stillingsannonser og et sterkt fokus på bedriftsomtaler
Regionale jobbportaler:
- Asia og Oseania
- Seek: Markedsleder i Australia og New Zealand
- Naukri: Markedsleder i India med millioner av stillingsannonser
- Naukri Gulf: Spesialisert på arbeidsmarkedene i Midtøsten
- JobsDB: Sterk tilstedeværelse i sørøstasiatiske land
- Jobstreet: Populær i Malaysia, Filippinene, Singapore og andre asiatiske markeder
- Europa
- Infojobs: Dominerende i Spania og deler av Latin-Amerika
- Tecnoempleo: Spansk portal med spesialisering innen teknologistillinger
- Welcome to The Jungle: Stor plattform i Frankrike som ekspanderer til flere europeiske markeder
Nisjeportaler og ATS-systemer:
- Startup-økosystemet
- AngelList (nå Wellfound): Rettet mot startup-stillinger, hovedsakelig i den amerikanske teknologisektoren
- Startup Jobs: Spesialisert på stillinger i oppstartsselskaper i tidlig fase i Nord-Amerika
- ATS-systemer (rekrutteringssystemer)
- Workable, Greenhouse, Lever, Ashby, Join, BambooHR, SimplyHired: Datablist scraper også disse systemene for å gi deg enda bredere dekning av arbeidsmarkedet
Slik scraper du flere jobbportaler samtidig
I Datablist mener vi at brukerne bør ha mest mulig kontroll over hvilke data de får, og hvordan de hentes inn.
Derfor gir vi deg to måter å scrape stillingsannonser på:
Slik scraper du flere jobbportaler med filtre
Her viser jeg deg hvordan du bruker filtrene i Datablists jobbportalaggregator til å finne stillingsannonser basert på søkeord, senioritetsnivå, sted og mer.
La oss sette i gang!
Registrer deg først hos Datablist.

Opprett en Collection.
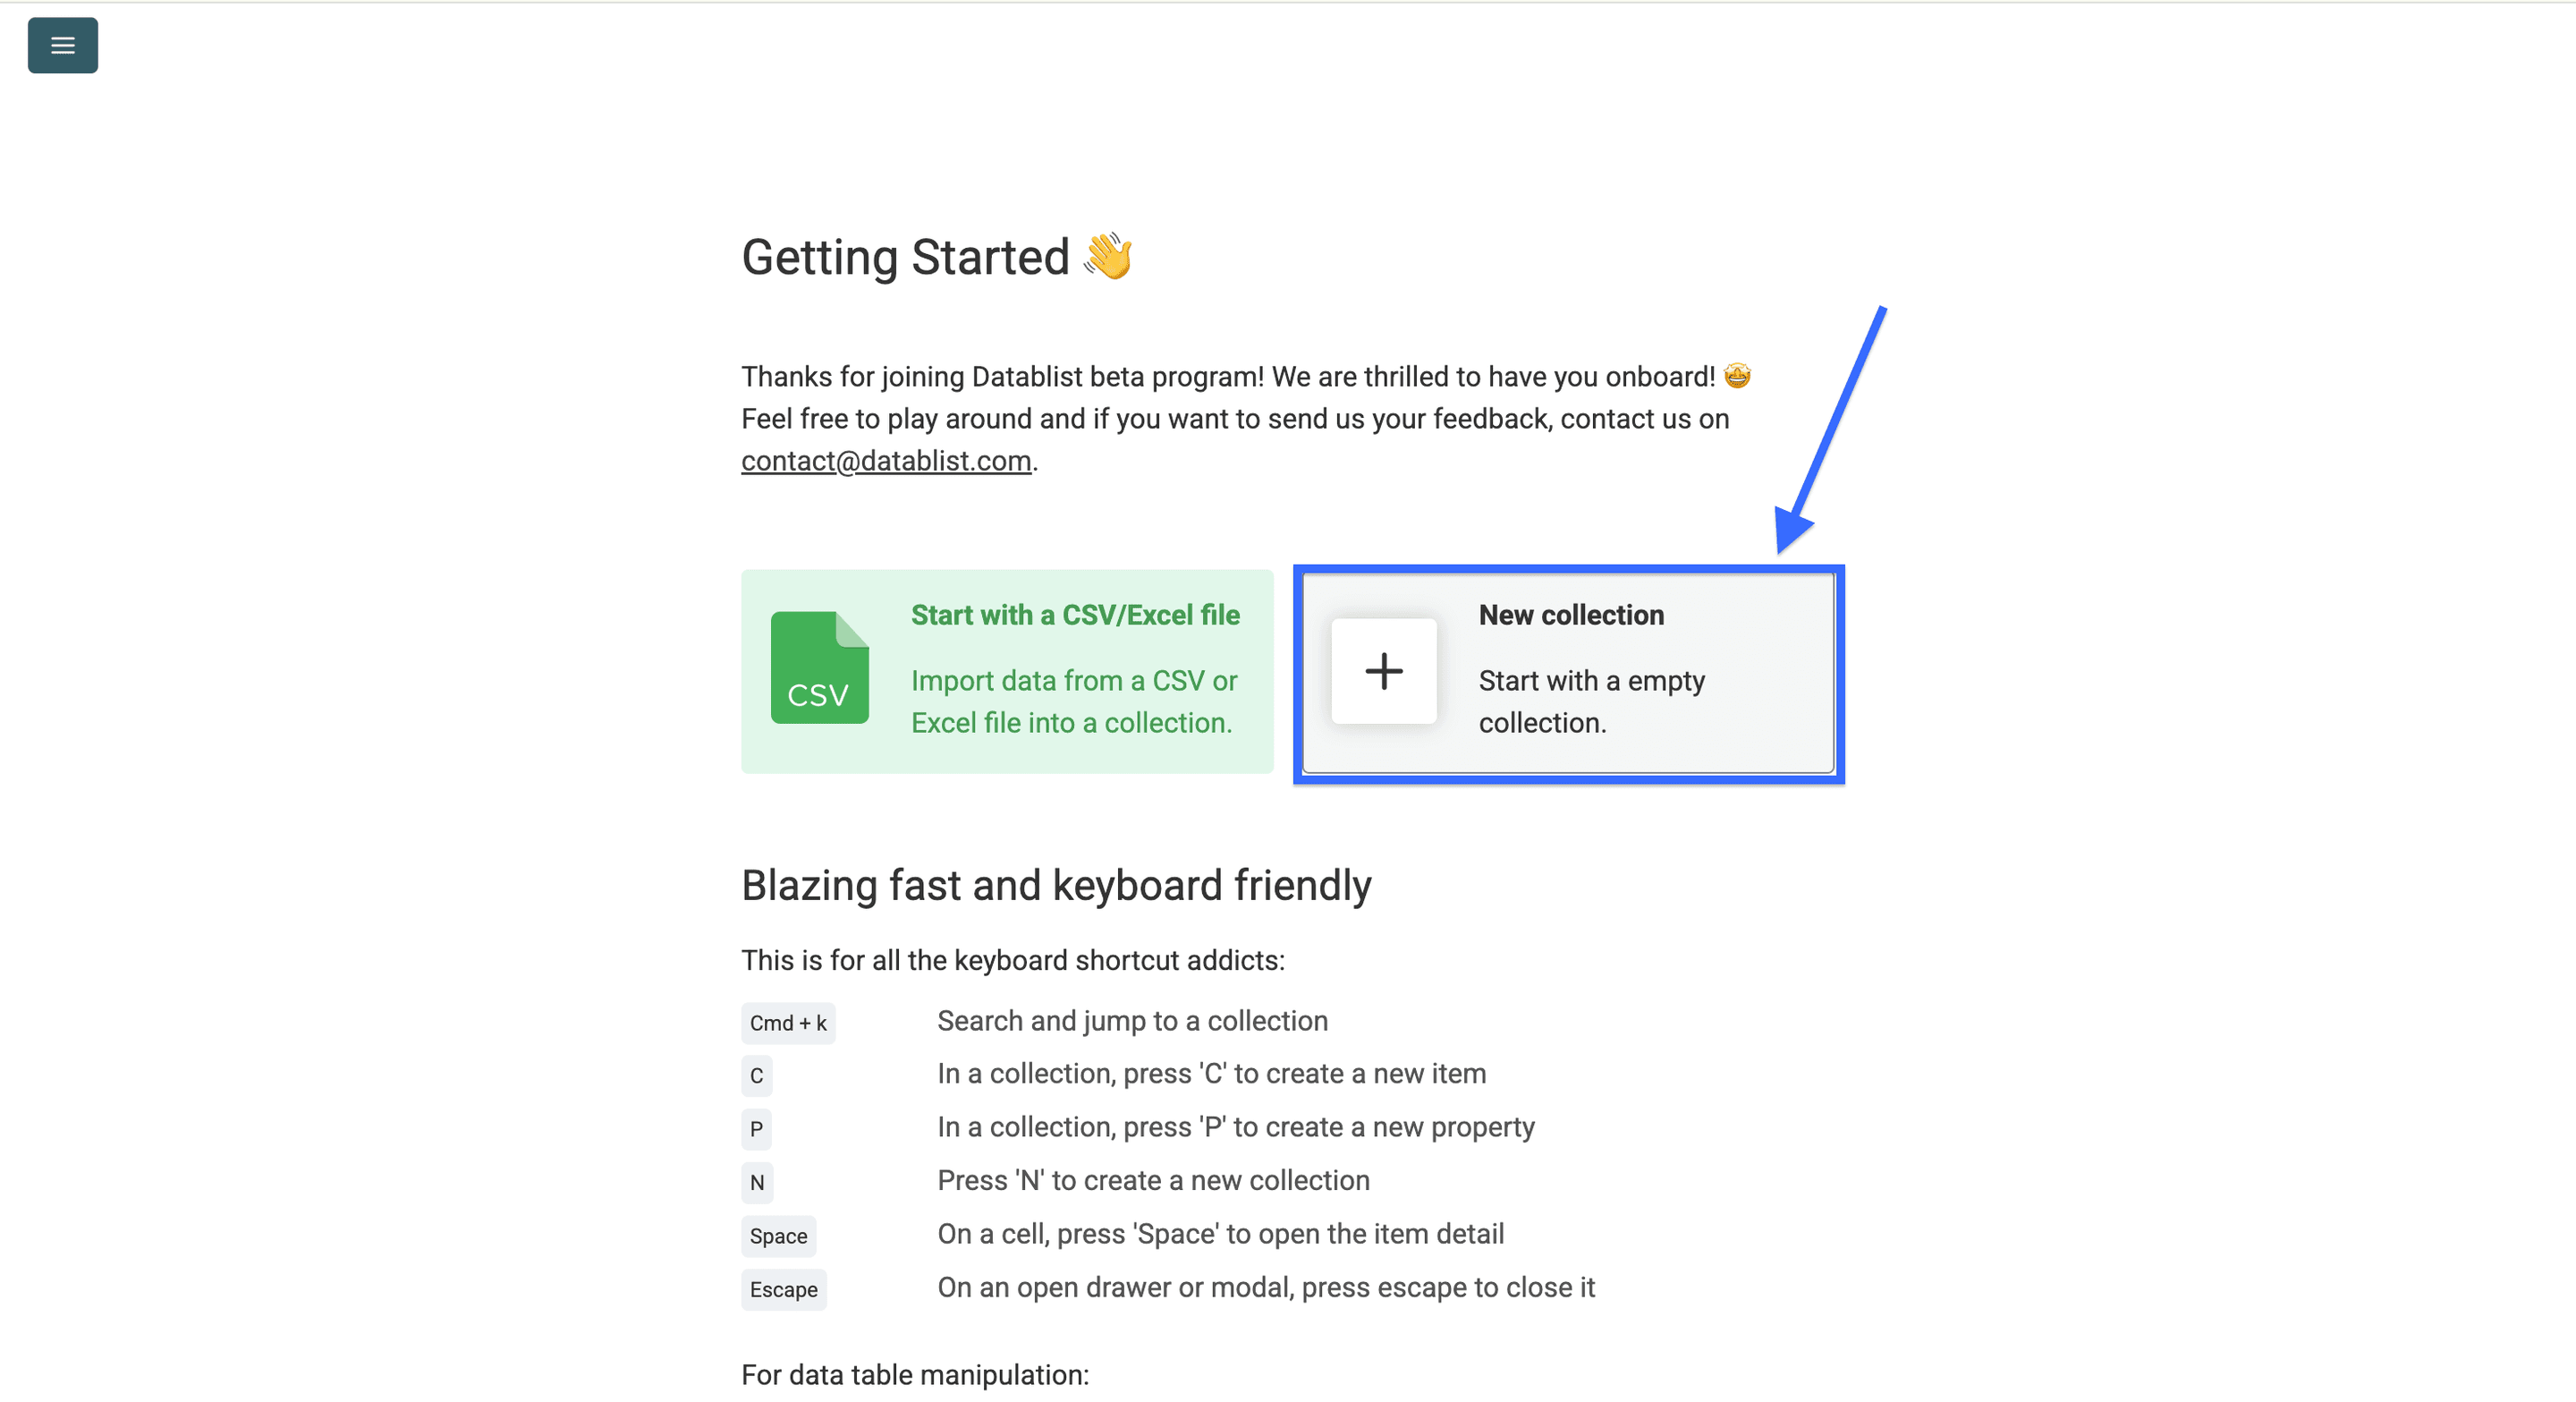
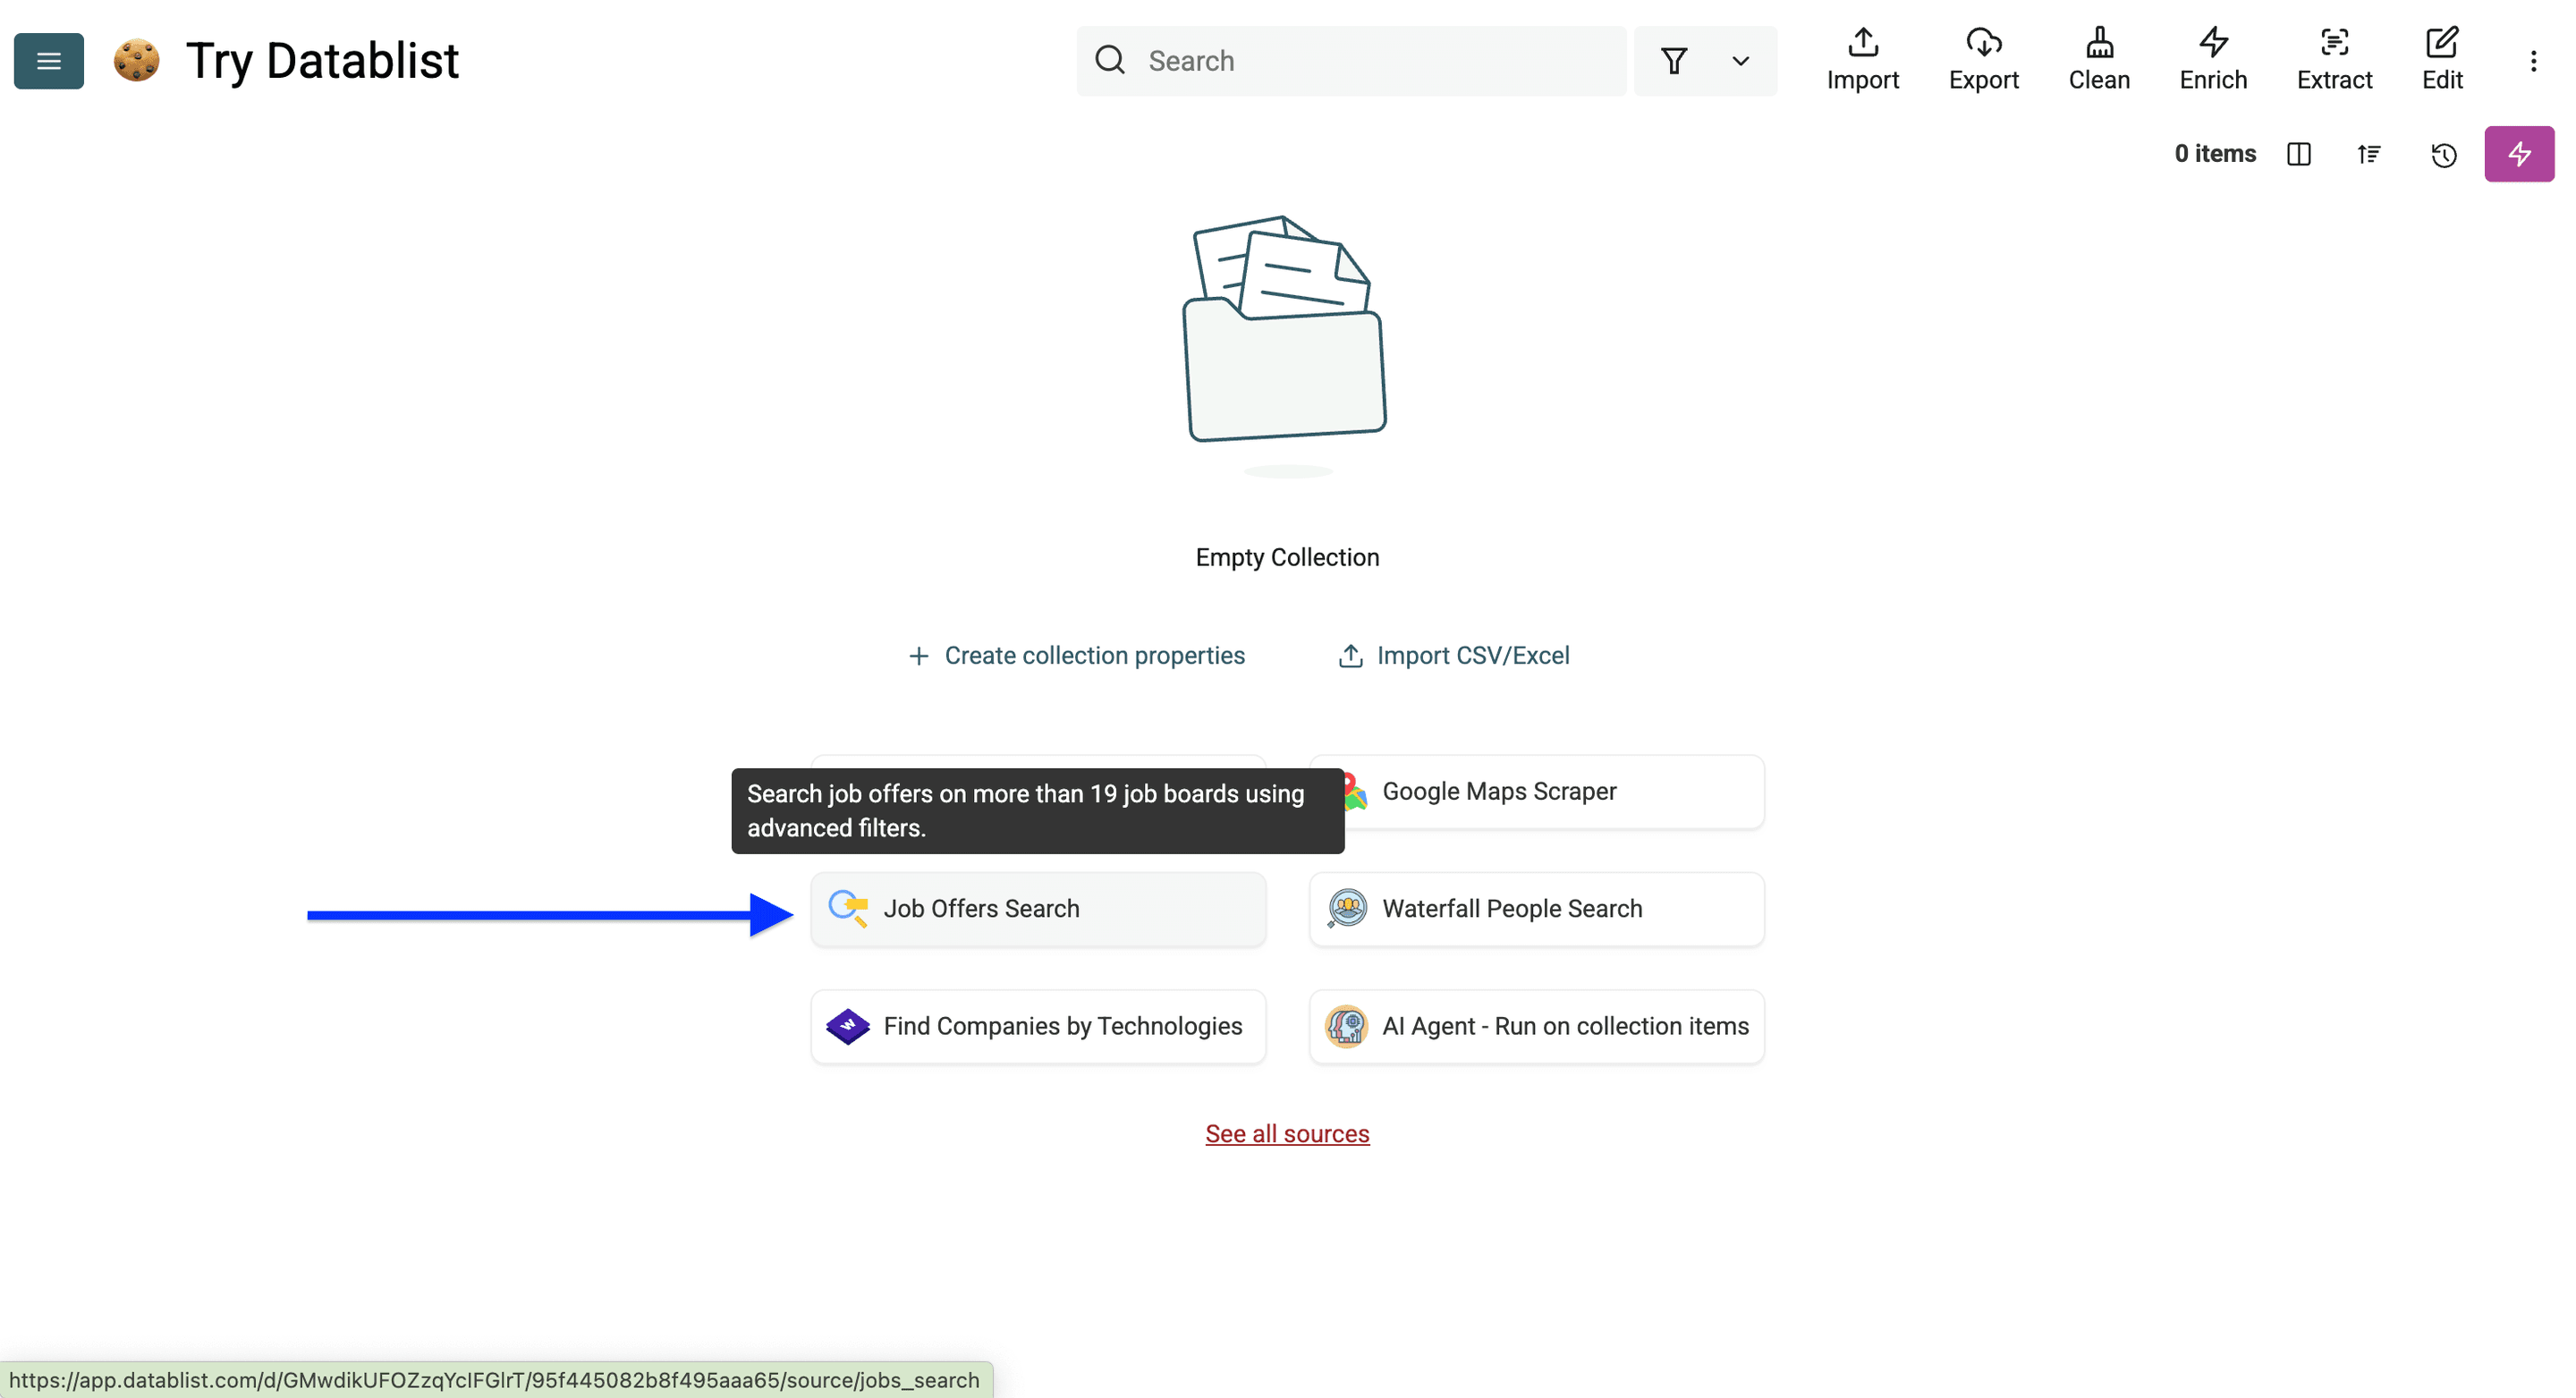
Klikk på Job Postings Search.
Konfigurer filtrene for stillingene du vil finne. Innstillingene nedenfor kan avvike fra de eldre skjermbildene.
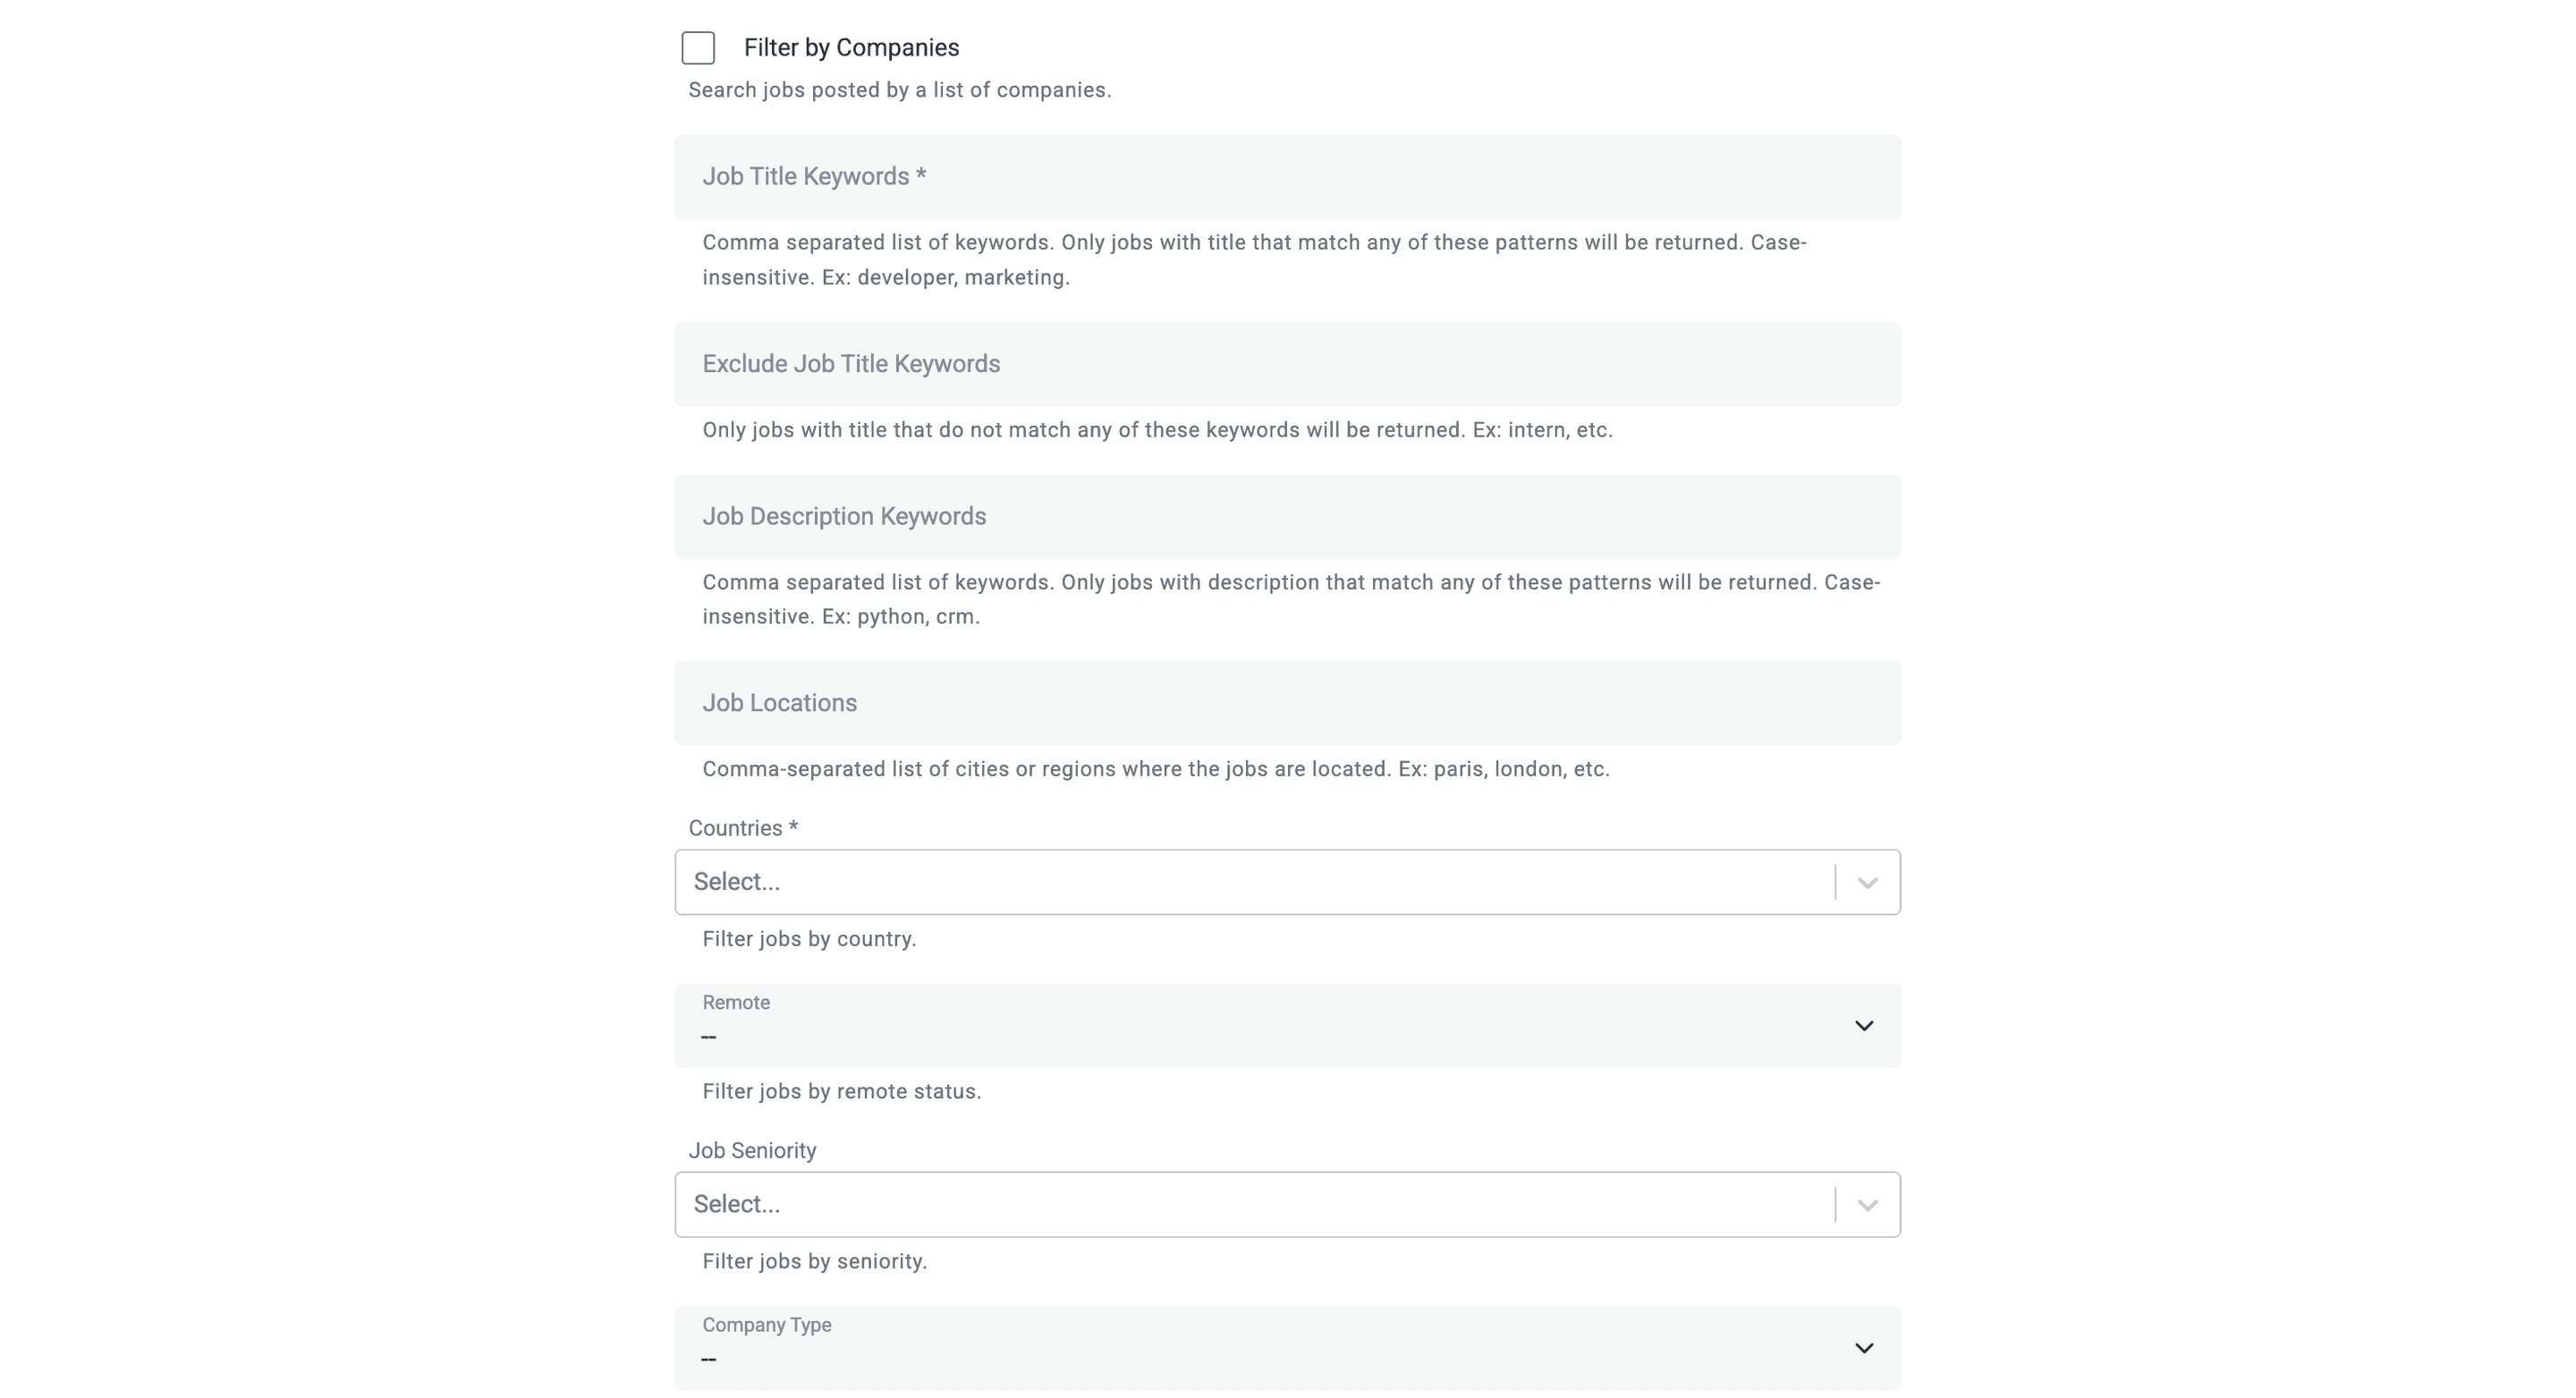
Filtre for stillinger og selskaper
Start med et avgrenset søk. Hvis du for eksempel vil finne Python-relaterte stillinger i Storbritannia, setter du Job Description Keywords til python, velger Storbritannia under Countries, lar Job Status stå på Only Open Jobs (default), velger Last 7 days under Max Age og setter Limit til 100 for det første søket.
Gå gjennom de første resultatene før du utvider søket. At Python nevnes i en stillingsbeskrivelse, betyr ikke nødvendigvis at Python-utvikling er stillingens hovedansvar.
Velg hvordan søkeord skal samsvare:
- Job Title Keywords godtar kommaseparerte fraser. En tittel gir treff på en frase når alle ordene i frasen finnes i tittelen, uavhengig av store og små bokstaver og ordenes rekkefølge.
data engineerkan for eksempel matcheSenior Data Platform Engineer. - Exclude Job Title Keywords fjerner titler som samsvarer, for eksempel stillinger som inneholder
intern. - Job Description Keywords søker som standard etter hele ord i ren tekst.
salesmatchersales manager, men ikkeSalesforce. - Use Regex for Description Matching aktiverer mønstre. I denne modusen lar Require All Description Patterns deg kreve at alle inkluderte mønstre samsvarer, i stedet for bare ett av dem. La regex være deaktivert ved et enkelt søkeordsøk.
- Exclude Job Description Keywords bruker samme samsvarsmodus som du valgte for stillingsbeskrivelsen.
Velg arbeidssted og stillingsstatus:
- Job Locations filtrerer på byer eller regioner, mens Countries filtrerer på landet der stillingen er lokalisert. Selskapets hovedkontor filtreres separat.
- Workplace Types tilbyr On-site, Hybrid og Remote. Employment Types filtrerer på heltid, deltid, kontrakt og andre ansettelsesformer.
- Job Seniority filtrerer på erfaringsnivå.
- Job Status kan returnere åpne, lukkede eller alle stillinger. Bruk åpne stillinger for å få en oppdatert liste over selskaper som ansetter.
- Only with Recruiter Info begrenser resultatene til utlysninger med informasjon om rekruttereren. Enkelte stillinger har kanskje bare deler av denne informasjonen, så sjekk feltene som returneres.
Velg selskaper og datoperiode:
- Filter Job Postings for a specific list of Companies søker etter selskaper fra en collection. Se arbeidsflyten for selskapslister.
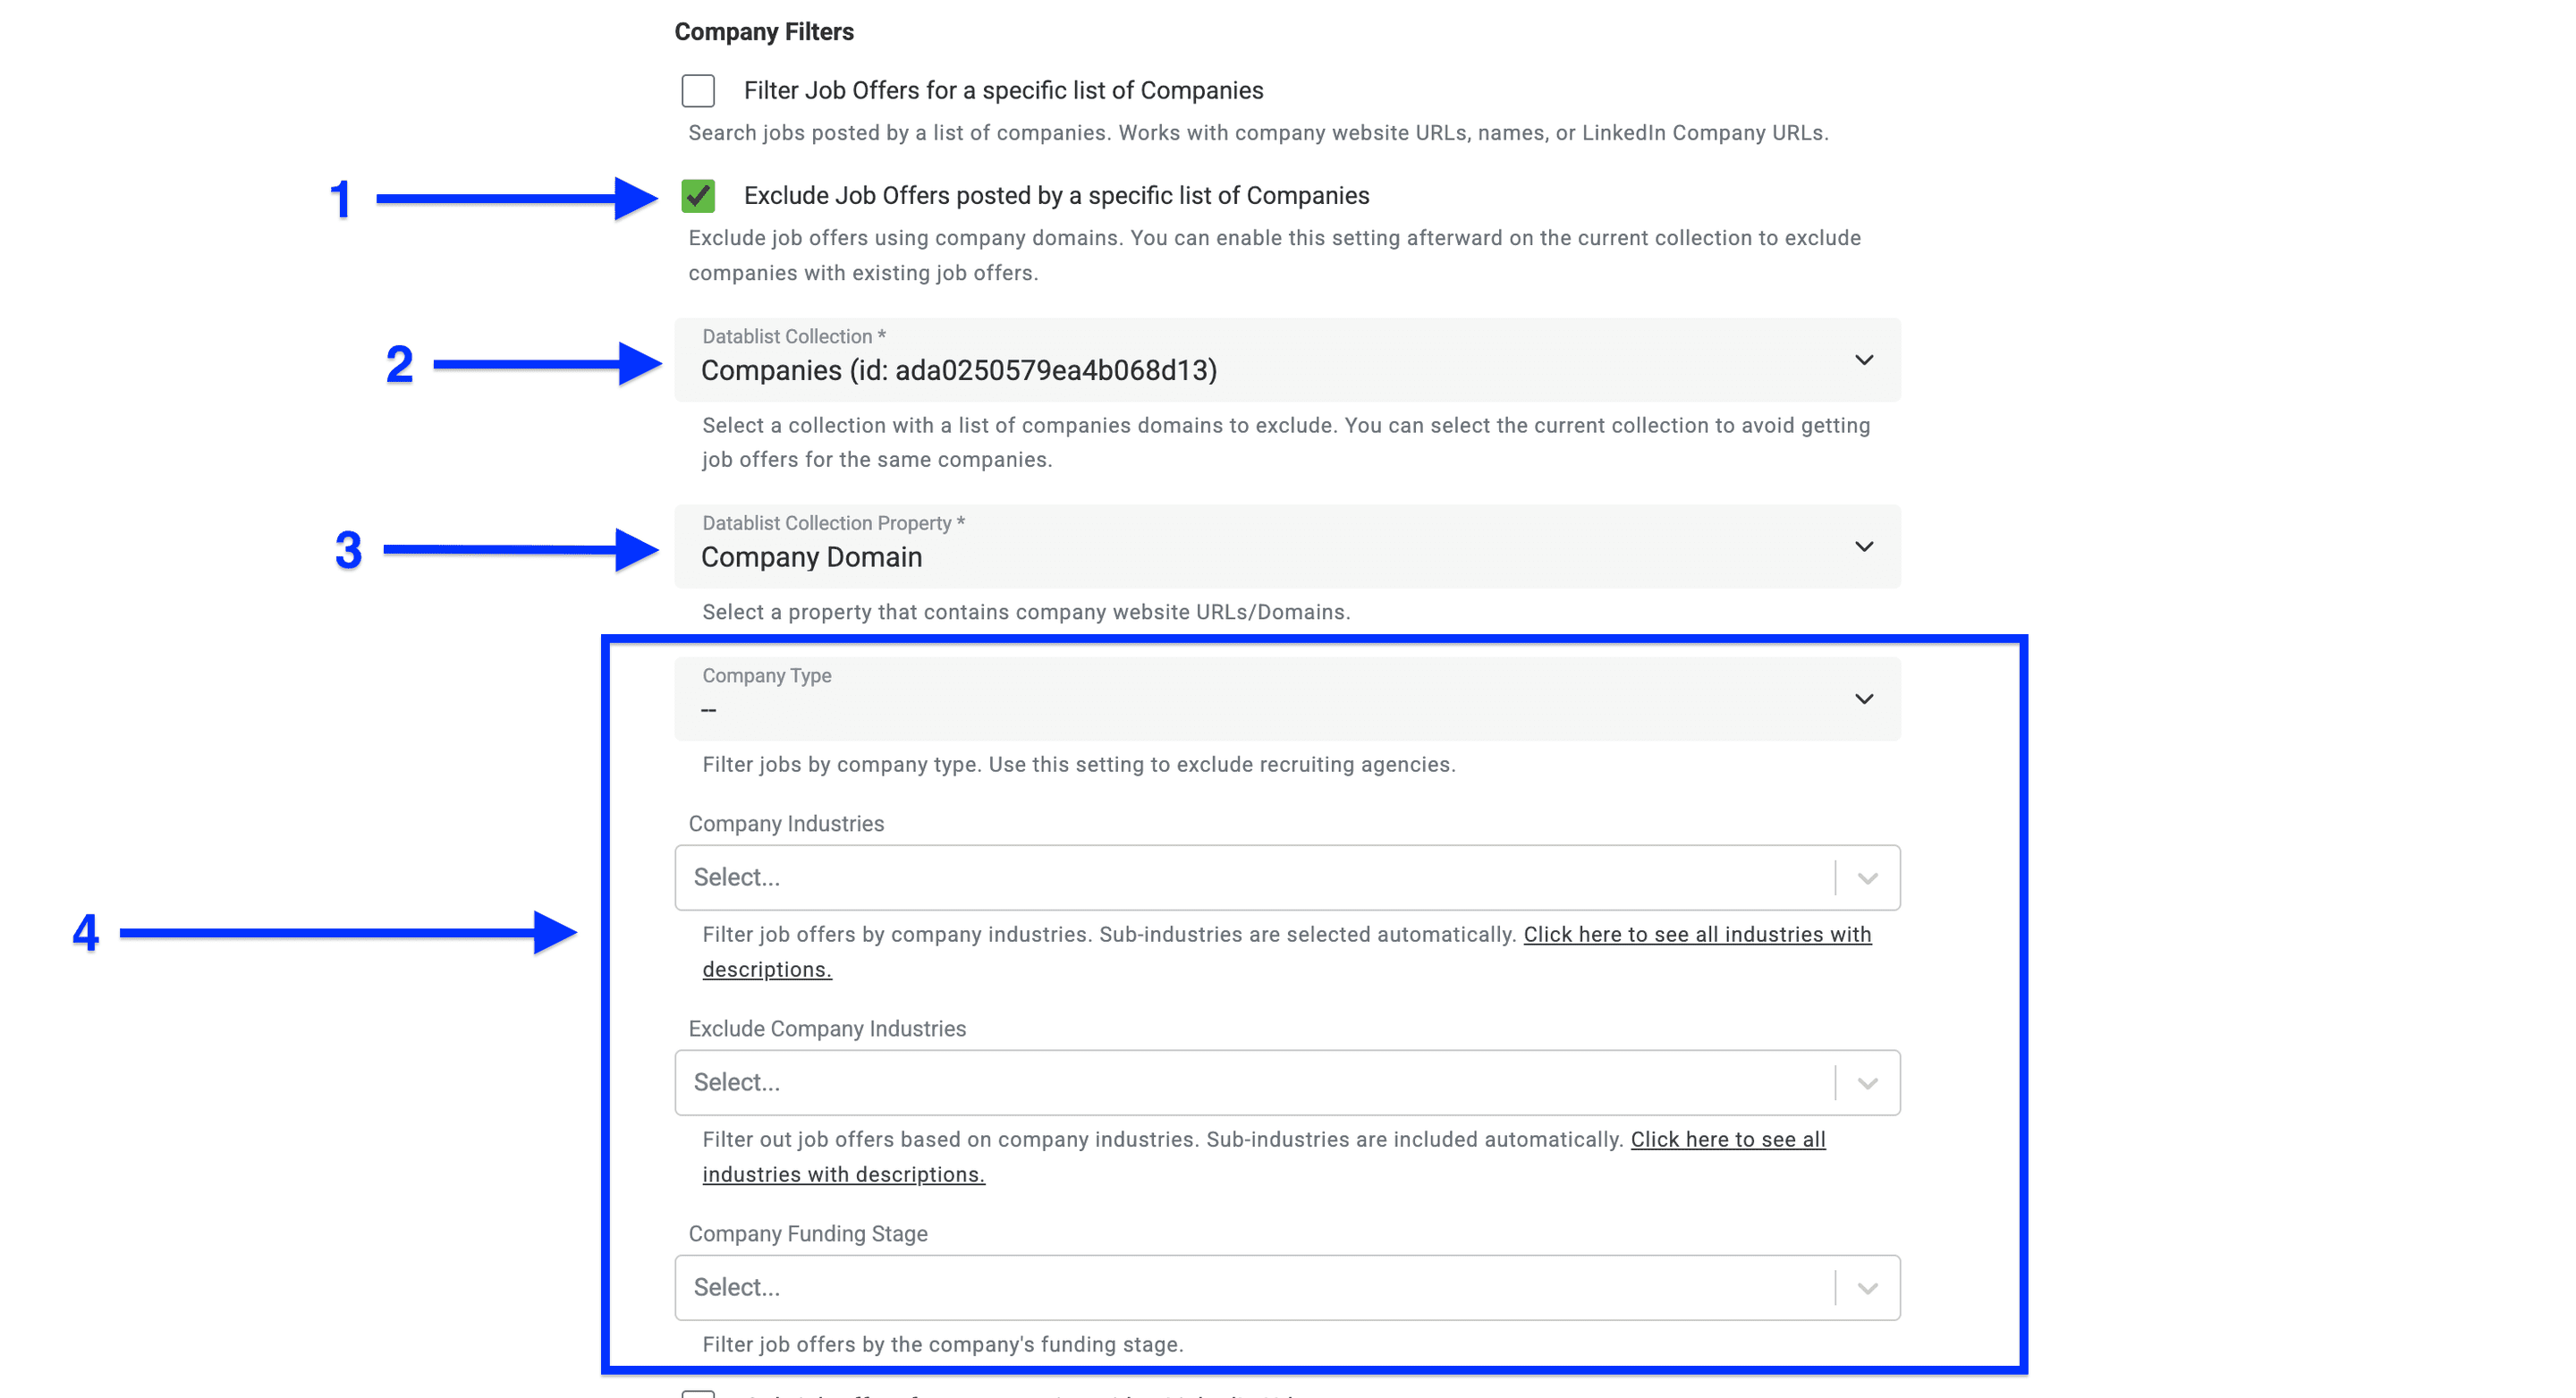
- Exclude Job Postings posted by a specific list of Companies ekskluderer alle utlysninger fra de valgte selskapsdomenene. Bruk dette for selskaper du bevisst ikke vil ha med i resultatene.
- Selskapsfiltrene omfatter Company Type, Company Industries, Company Funding Stage og hovedkontorets sted eller land.
- Max Age begrenser hvor gammel en utlysning kan være. Posted On or After og Posted On or Before angir en nøyaktig datoperiode og overstyrer Max Age når de er angitt.
- Limit begrenser antallet utlysninger som returneres. Standardverdien er 1 000, og hvert søk støtter opptil 2 000. Hvis du når grensen, bør du undersøke mer avgrensede søk i stedet for å anta at du har hentet alle relevante stillinger.
Ekskluder selskaper du ikke vil overvåke
Selskapsekskludering er nyttig når du vil fjerne aktive kunder eller selskaper utenfor målgruppen din. Det er ikke deduplisering på stillingsnivå. Hvis du ekskluderer et selskap du fant i går, ekskluderer du også en annen stilling som selskapet publiserer i morgen.
Slik bruker du en liste over selskaper som skal ekskluderes:
- Aktiver Exclude Job Postings posted by a specific list of Companies.
- Velg ekskluderingslisten under Datablist Collection.
- Koble Datablist Collection Property til kolonnen som inneholder selskapets nettsted eller domene.
Start søket etter stillingsannonser
Når du har angitt alle filtrene, klikker du på Continue.
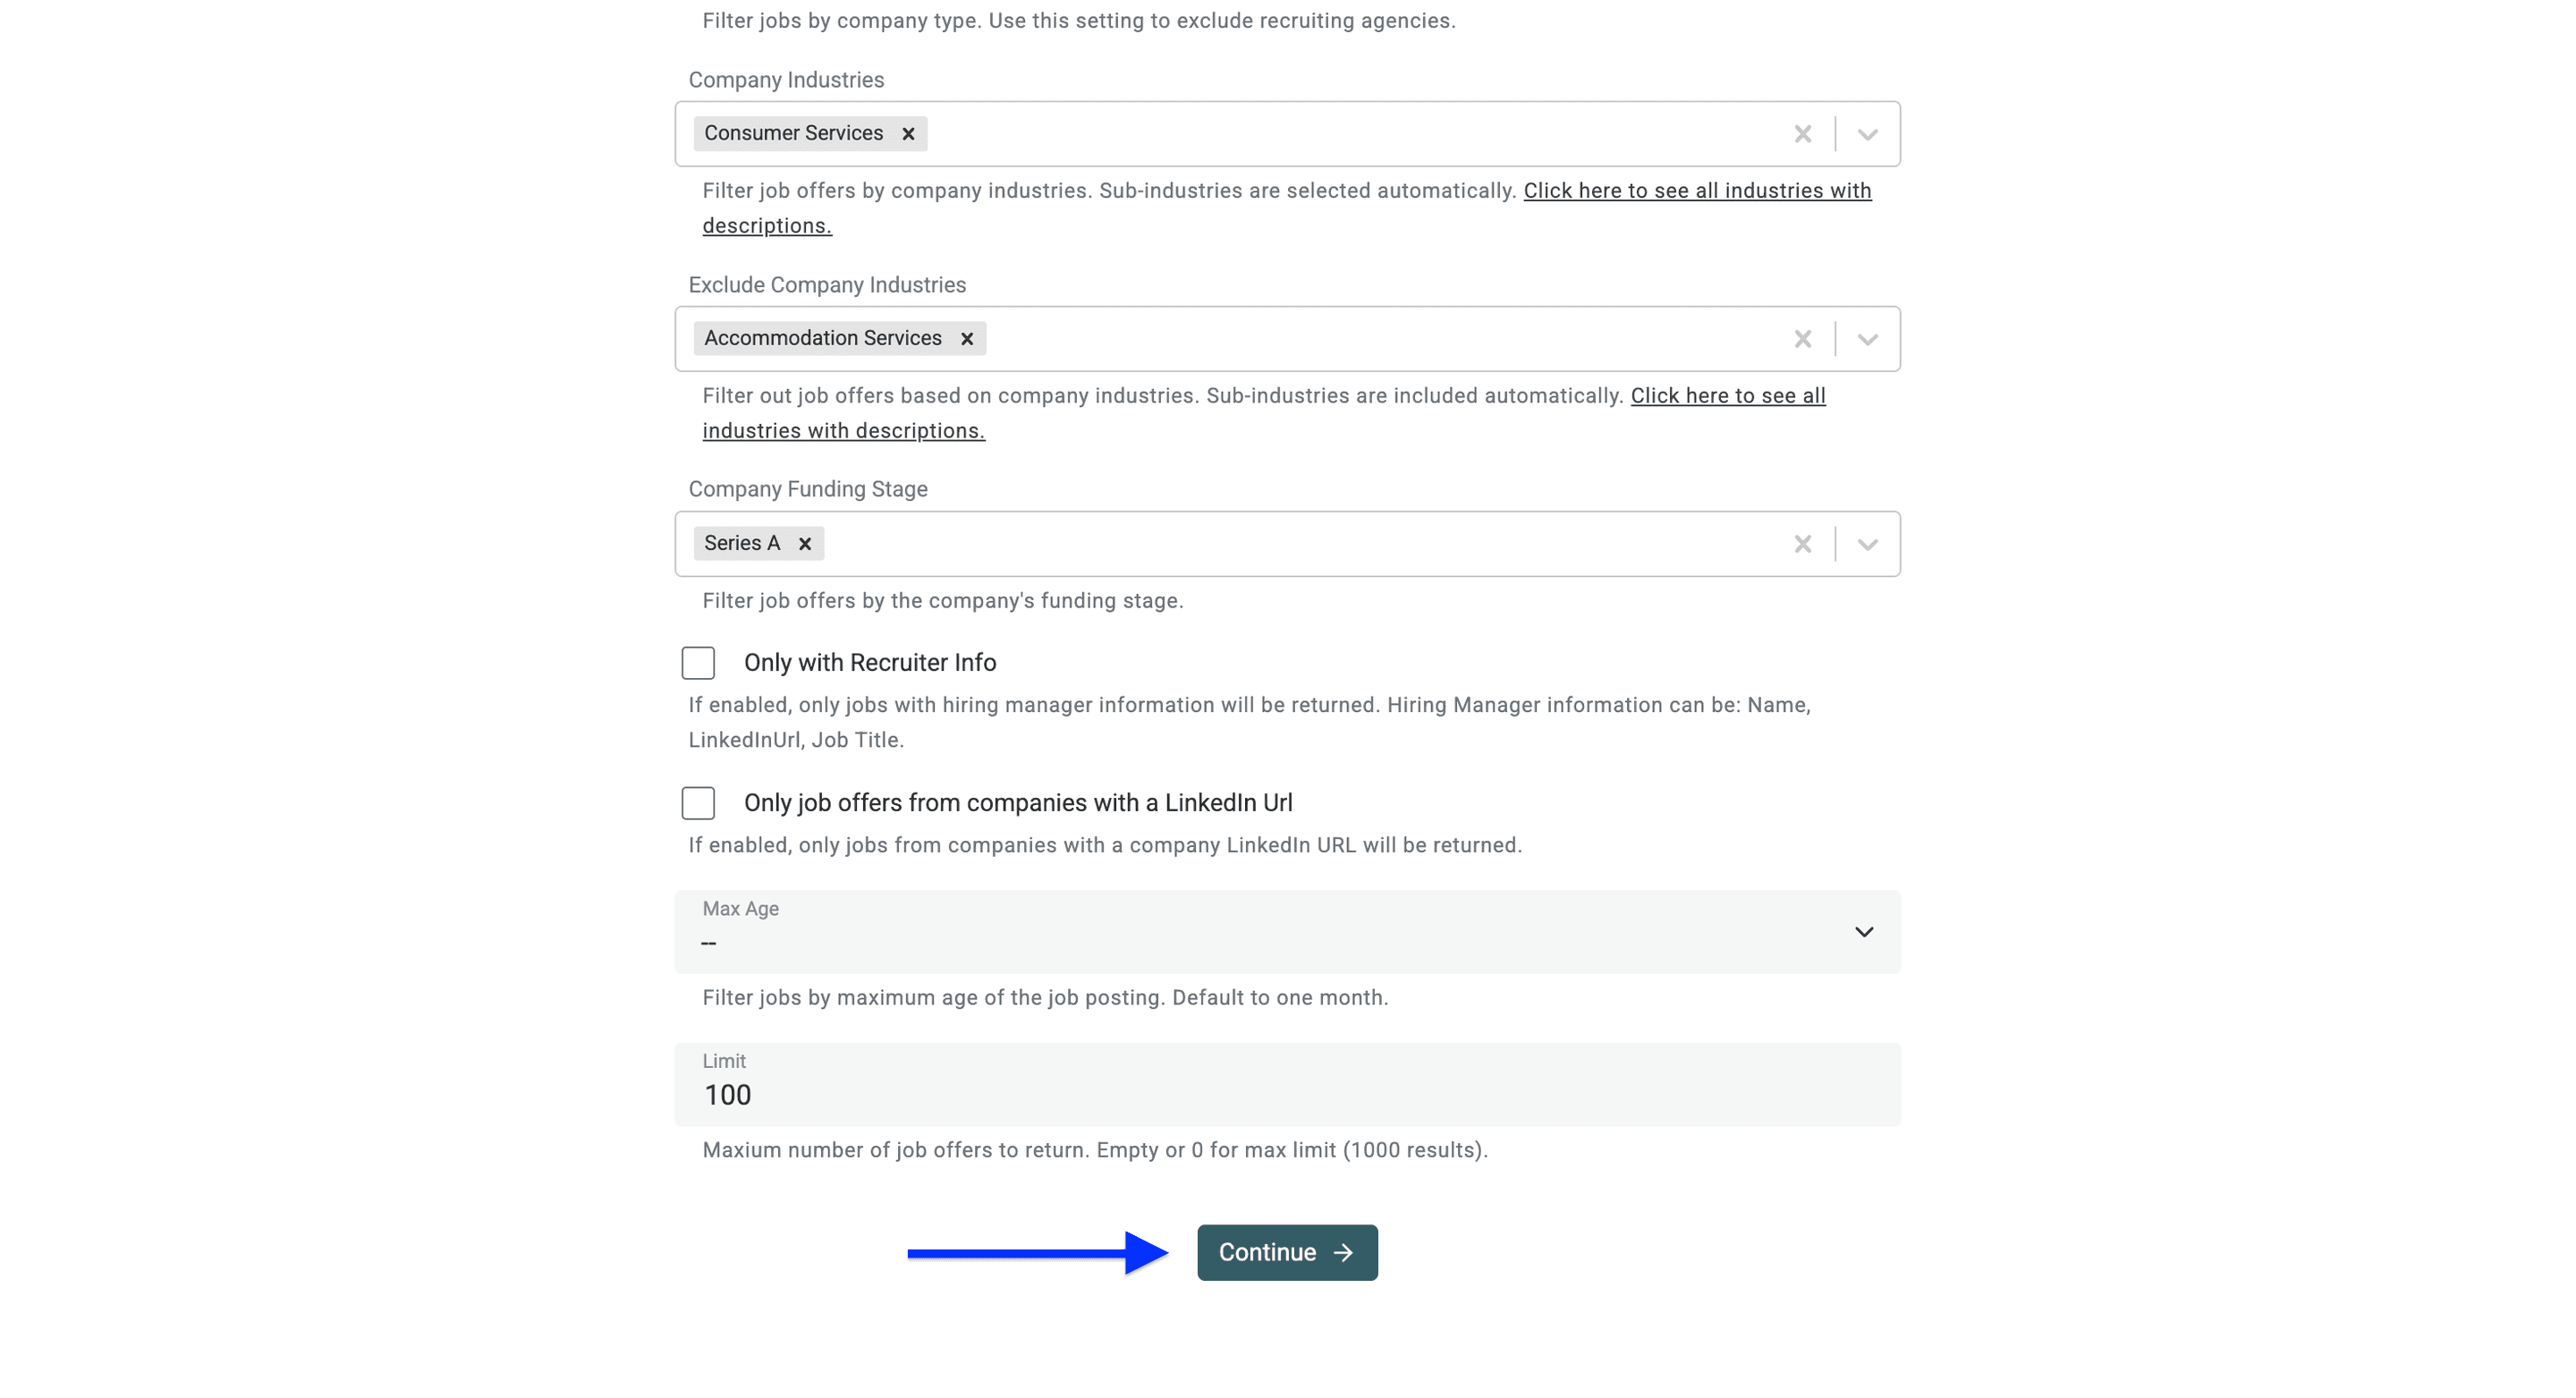
Datablist returnerer følgende datapunkter:
| Kategori | Felter |
|---|---|
| Stillingsdetaljer | Job Title, Job Description, Job Type, Job Location, Job Country, Workplace Type, Job Seniority, Salary Range |
| Firmografiske data | Company Name, Company Website, LinkedIn URL, Employee Count, Company Employee Range, Industry, Founded Year, Revenue |
| Tilleggsinformasjon | Company Description, Company City, Company Country, Company Job Postings Count, Company Recent Job Postings Count |
| Metadata for stillingen | Job Posting Id, Job Posting URL, Job Posting Source URL, Date Posted, Closed At |
| Informasjon om ansettelsesansvarlig | Hiring Manager Name, Hiring Manager Job Title, Hiring Manager LinkedIn Profile |
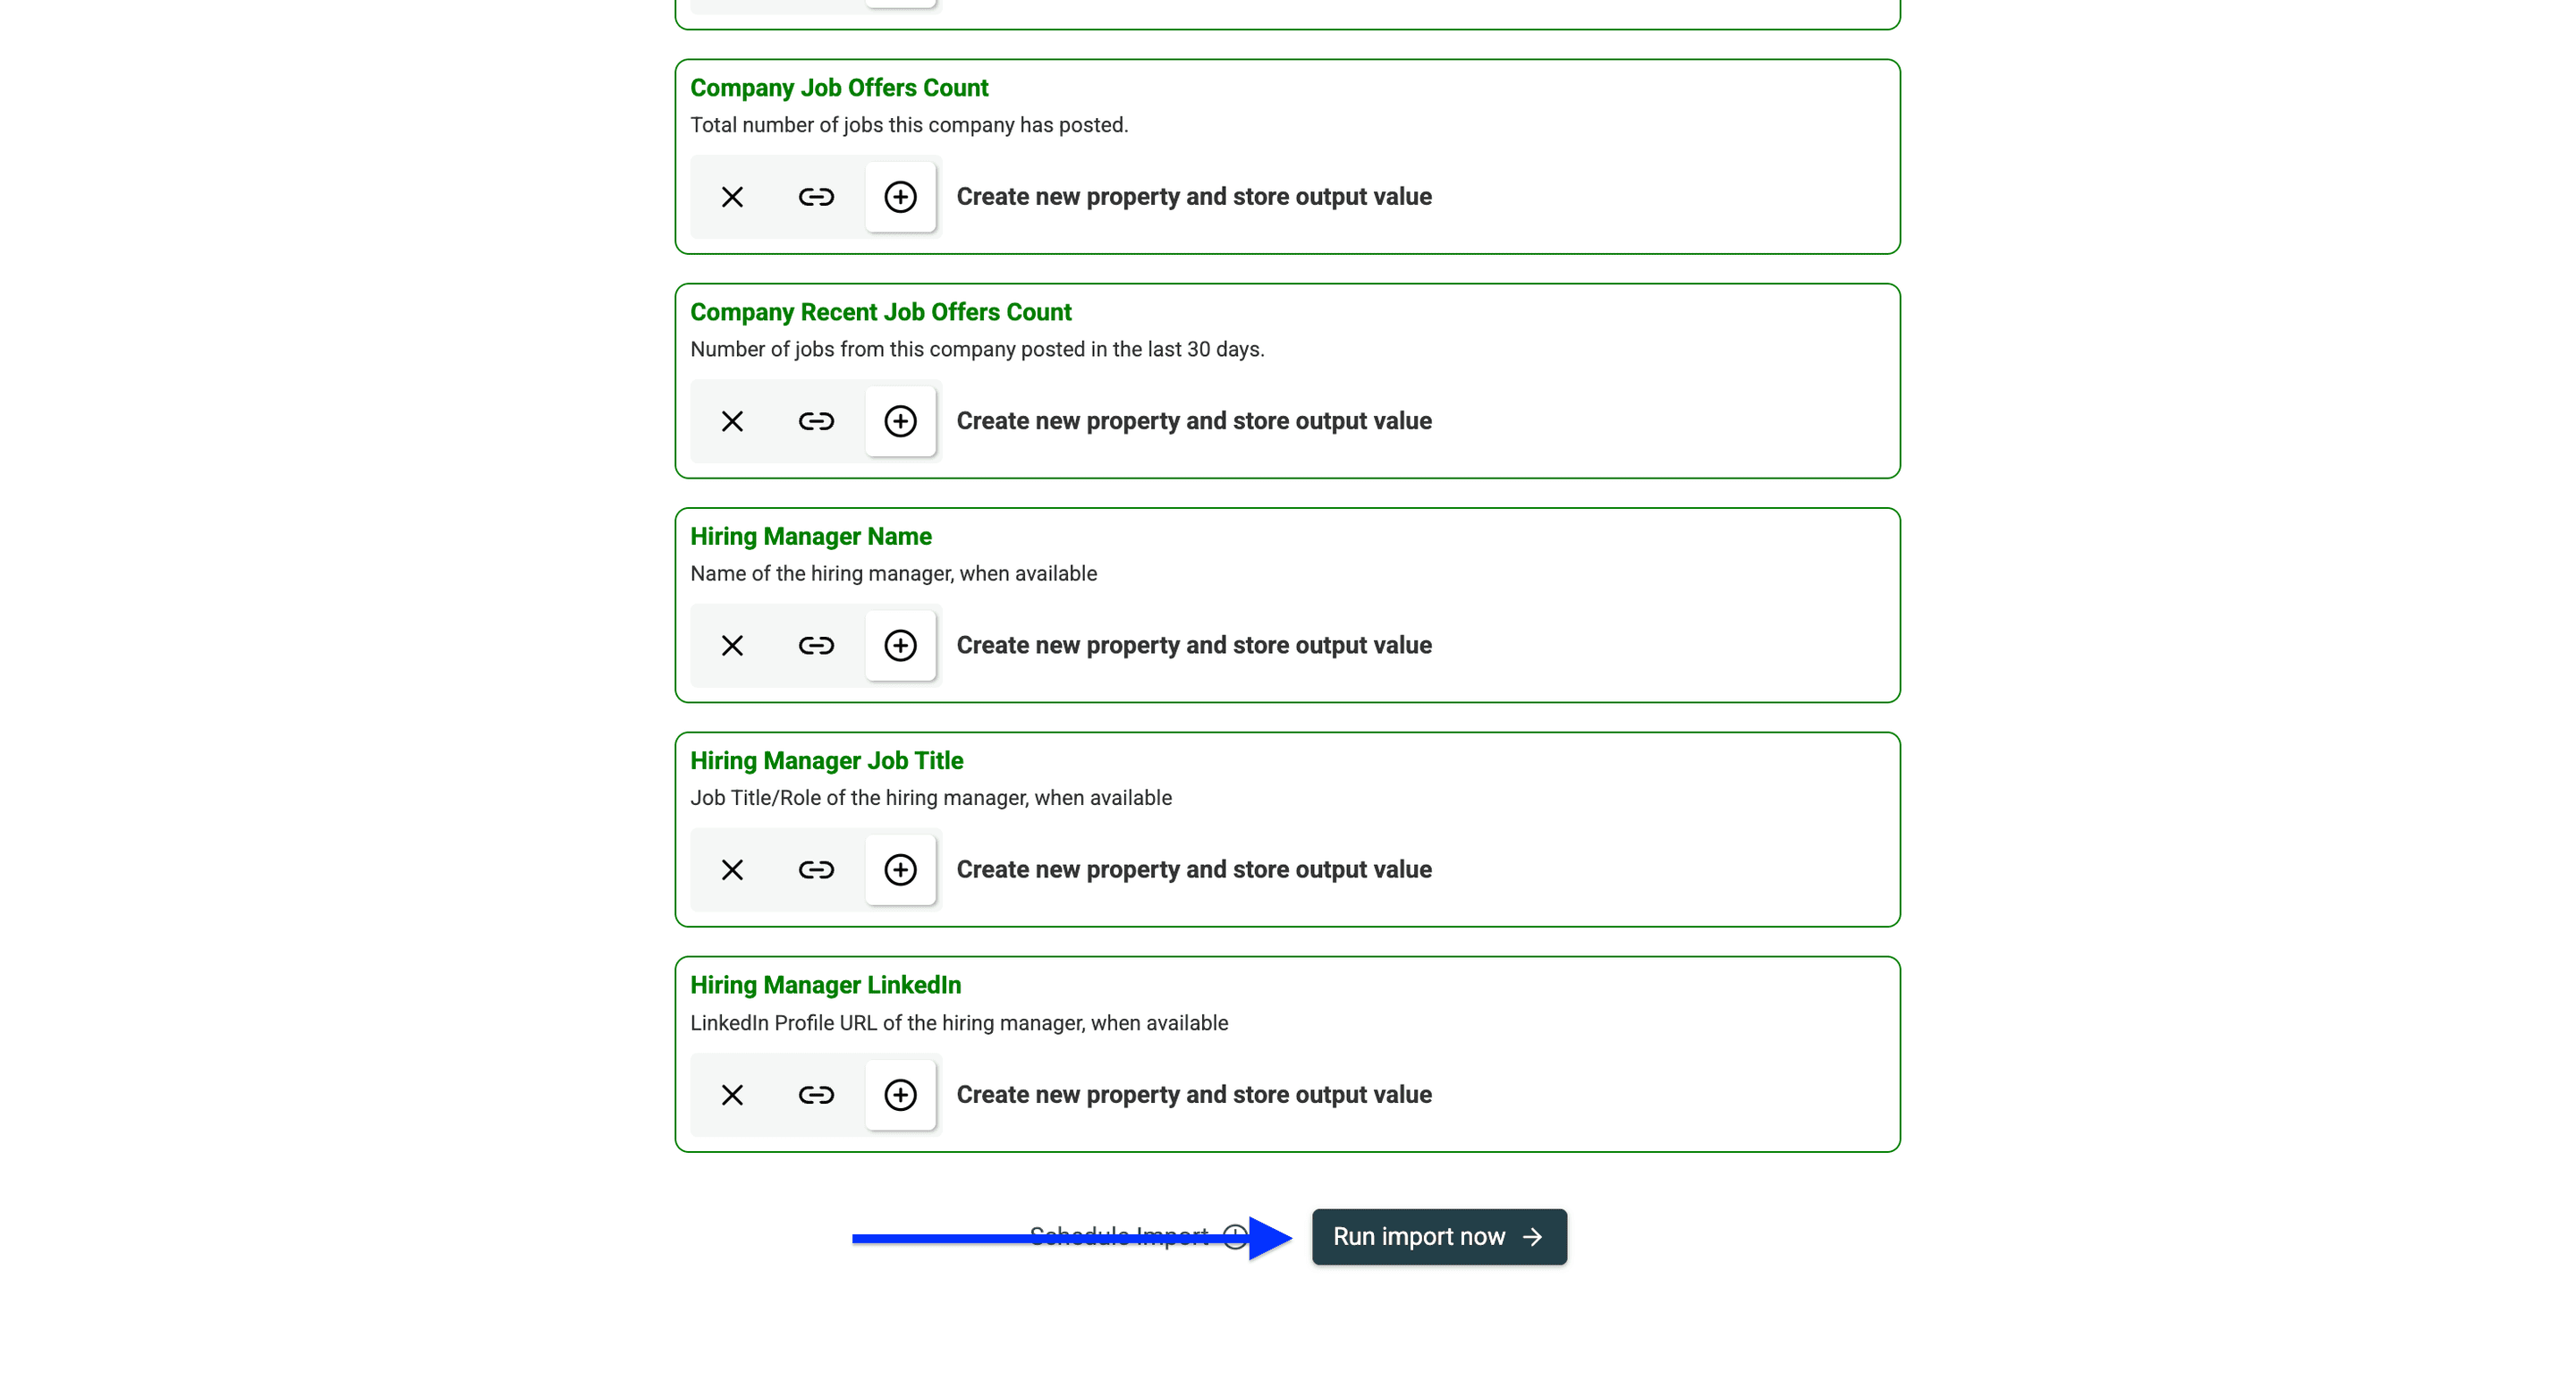
Gå til bunnen av siden og klikk på Run import now.
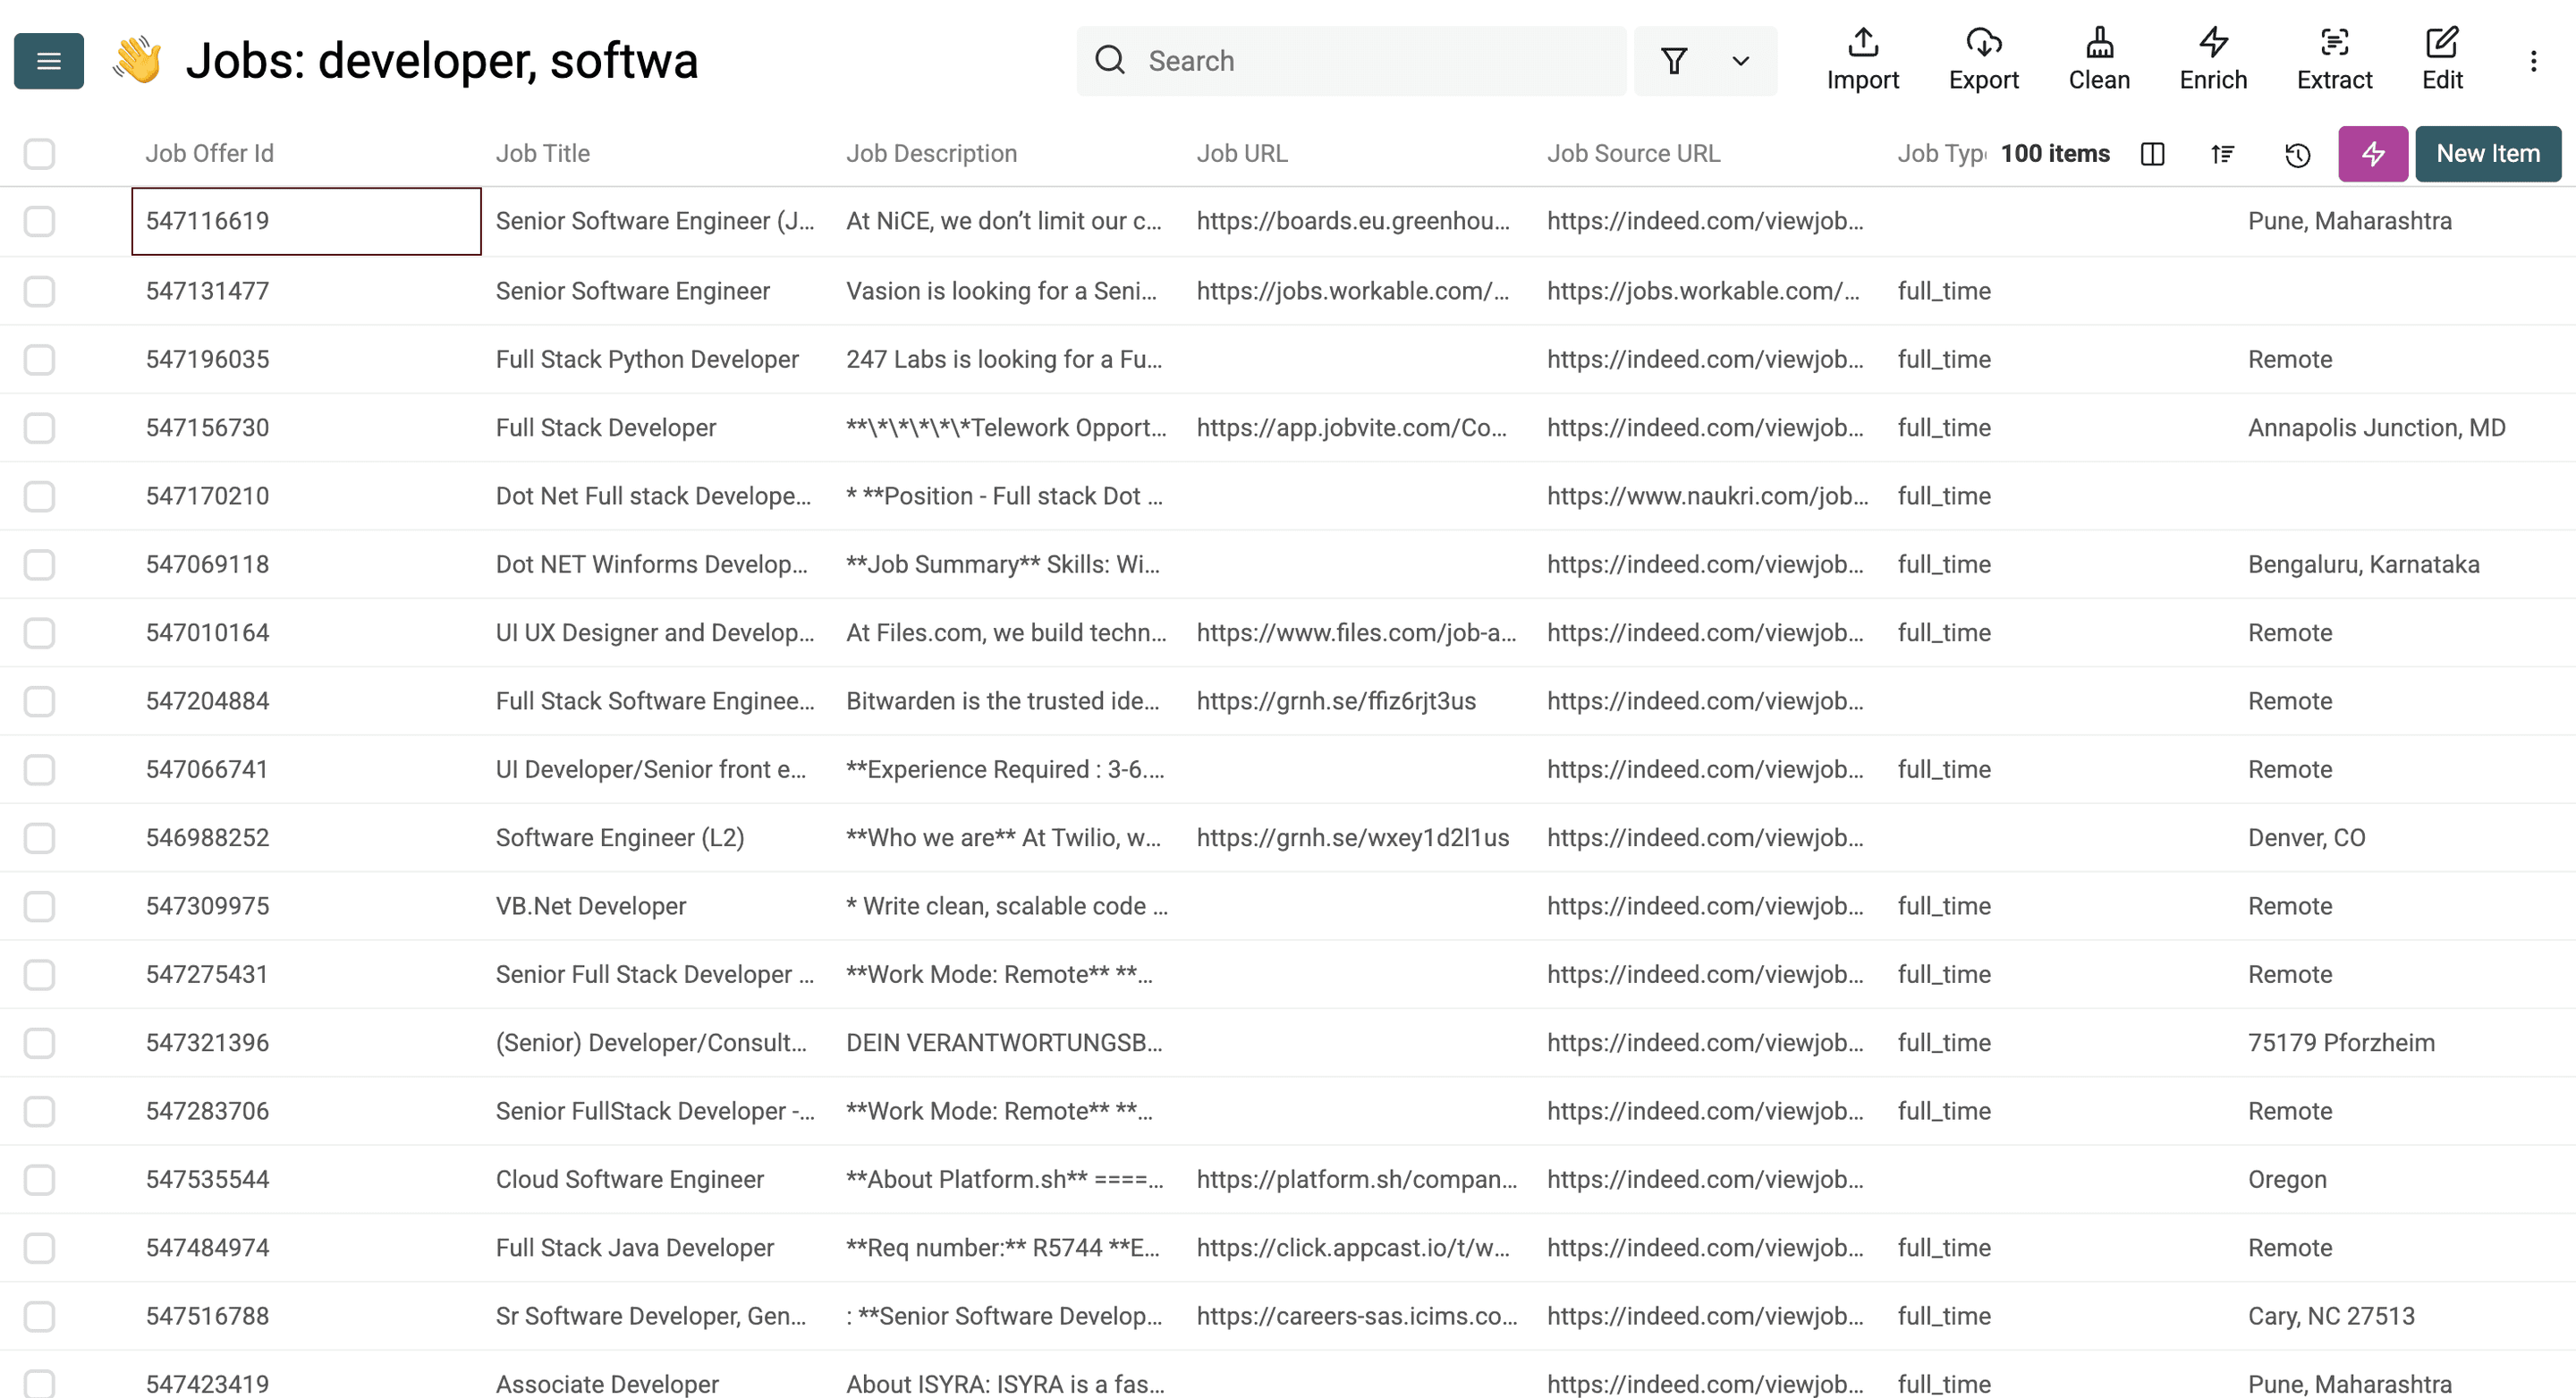
Når scrapingen er fullført, ser resultatene slik ut:
Søk etter stillinger fra en selskapsliste
Som nevnt lar dette alternativet deg scrape stillingsannonser fra selskaper du allerede har i Datablist-arbeidsområdet, CRM-systemet eller en annen database.
Du må ha selskapsnavnet, selskapets LinkedIn-URL eller nettadresse i en Datablist-collection.
Registrer deg først hos Datablist.
Import en liste over selskaper.
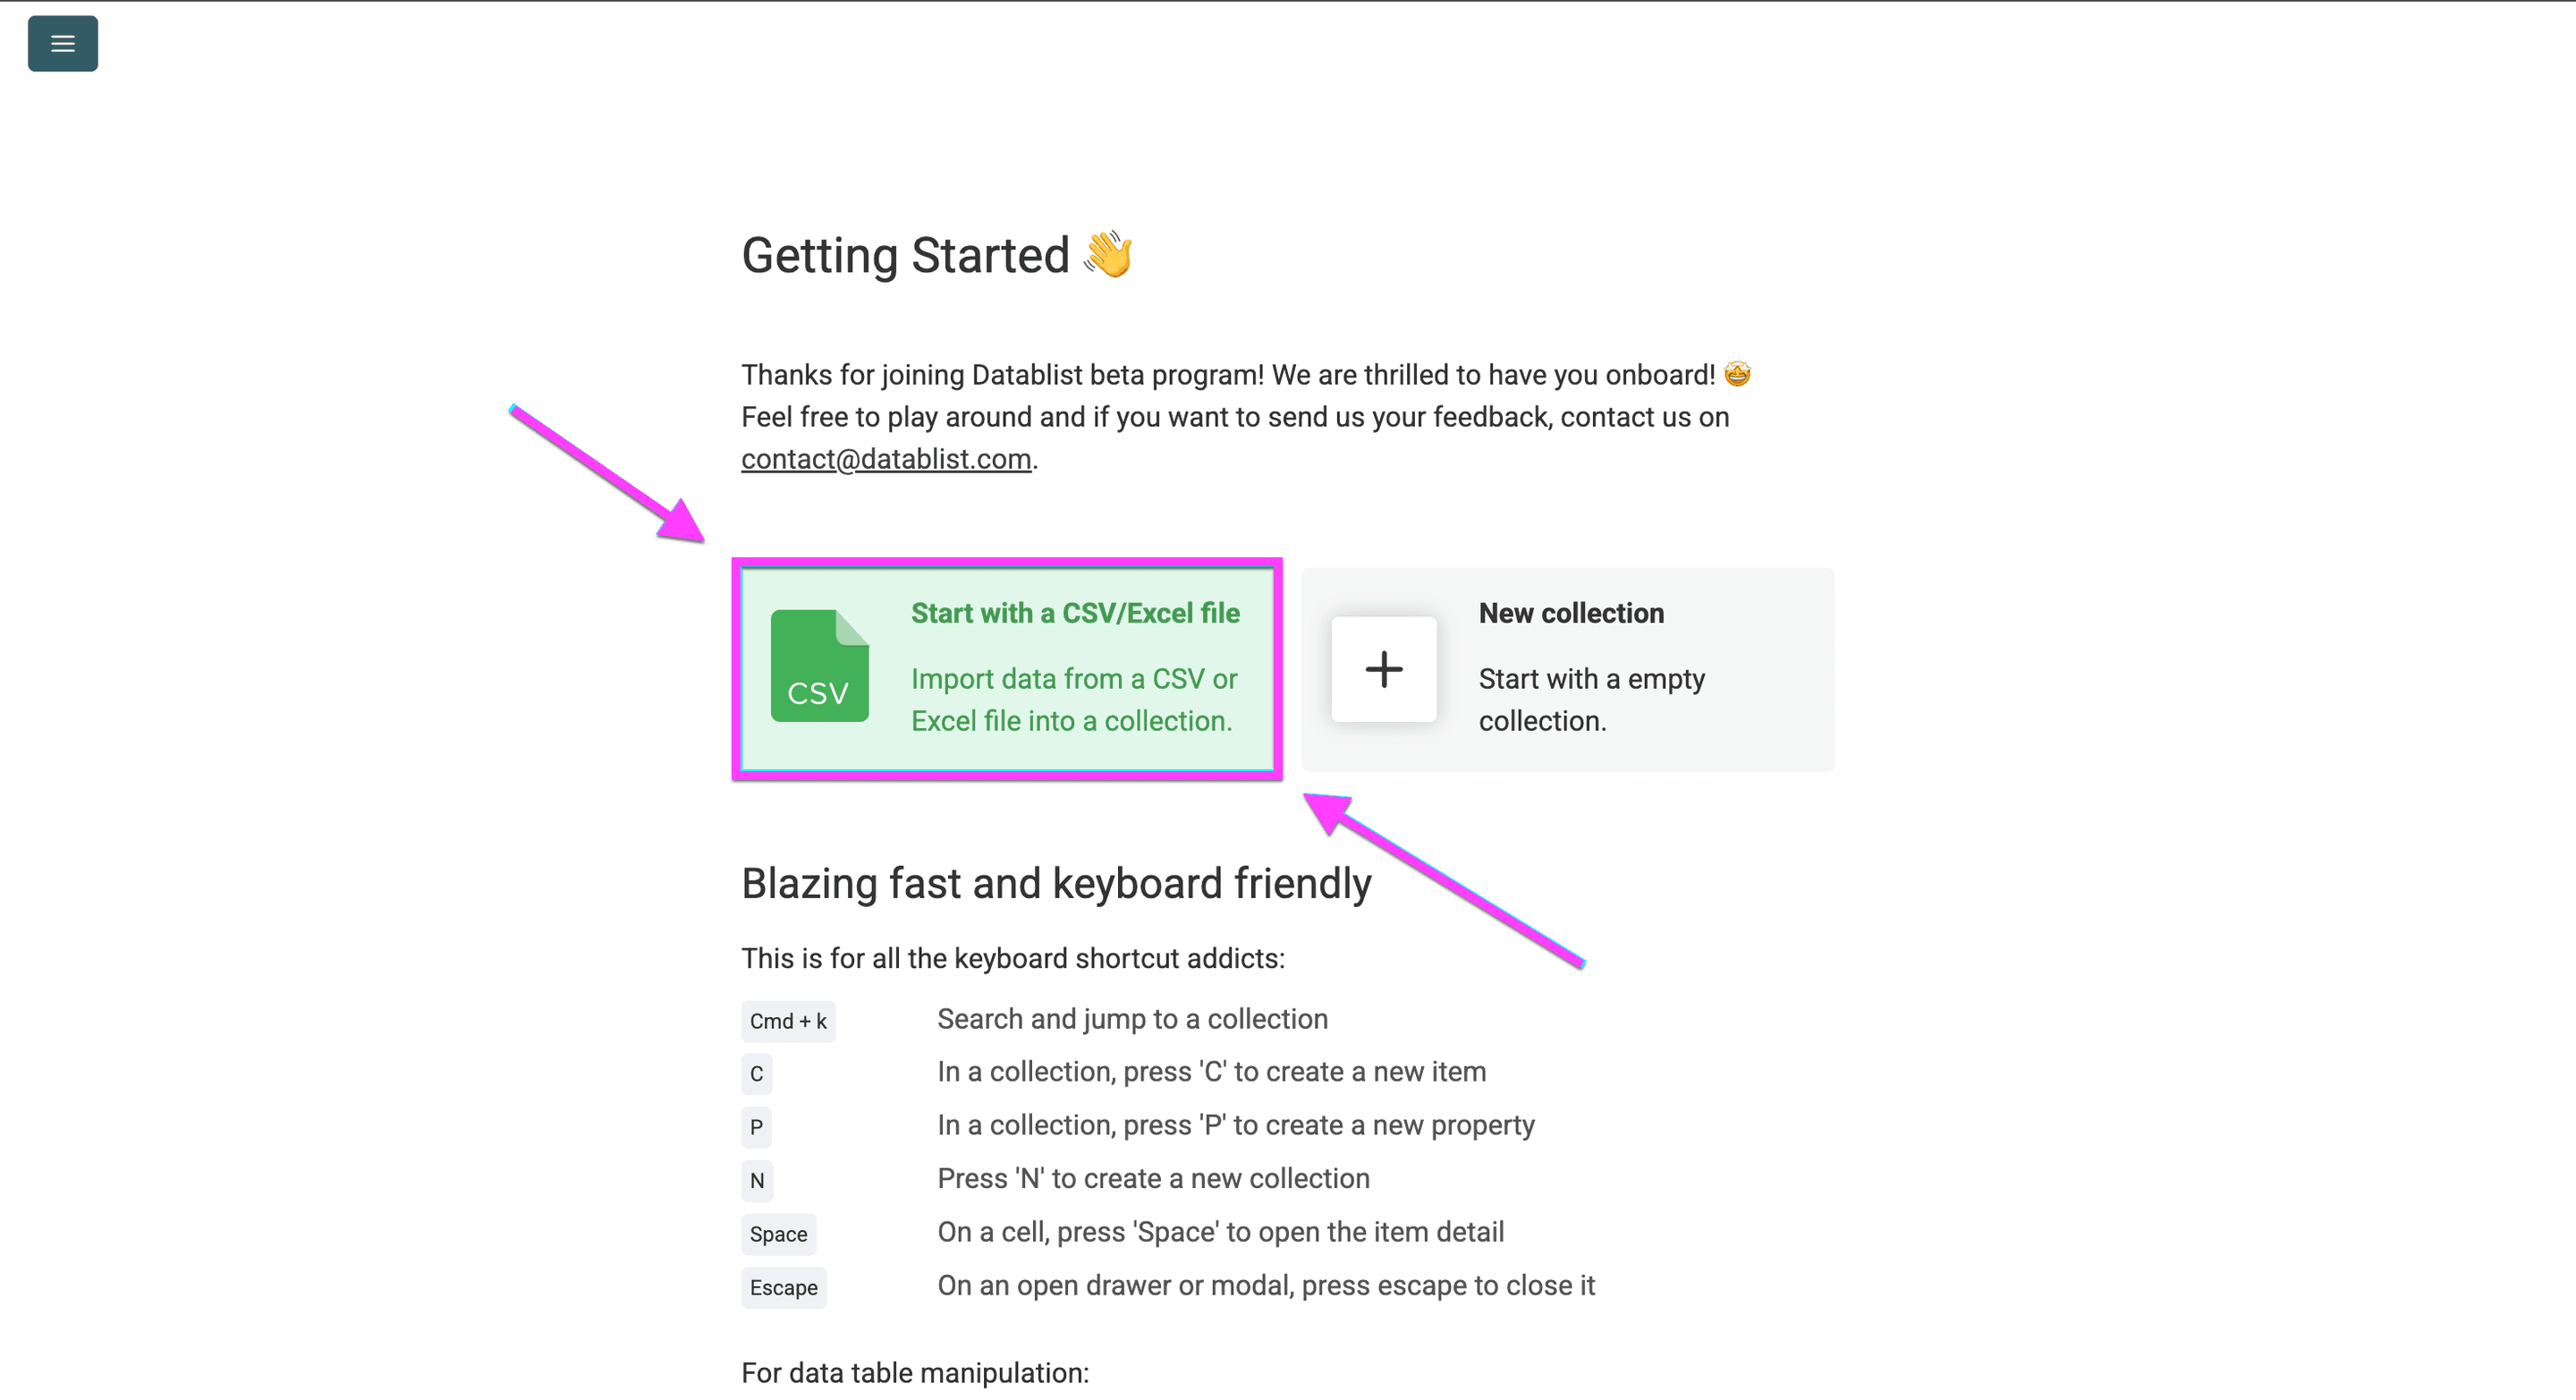
Opprett en separat Collection.
Åpne Job Postings Search.
Gjør deretter følgende:
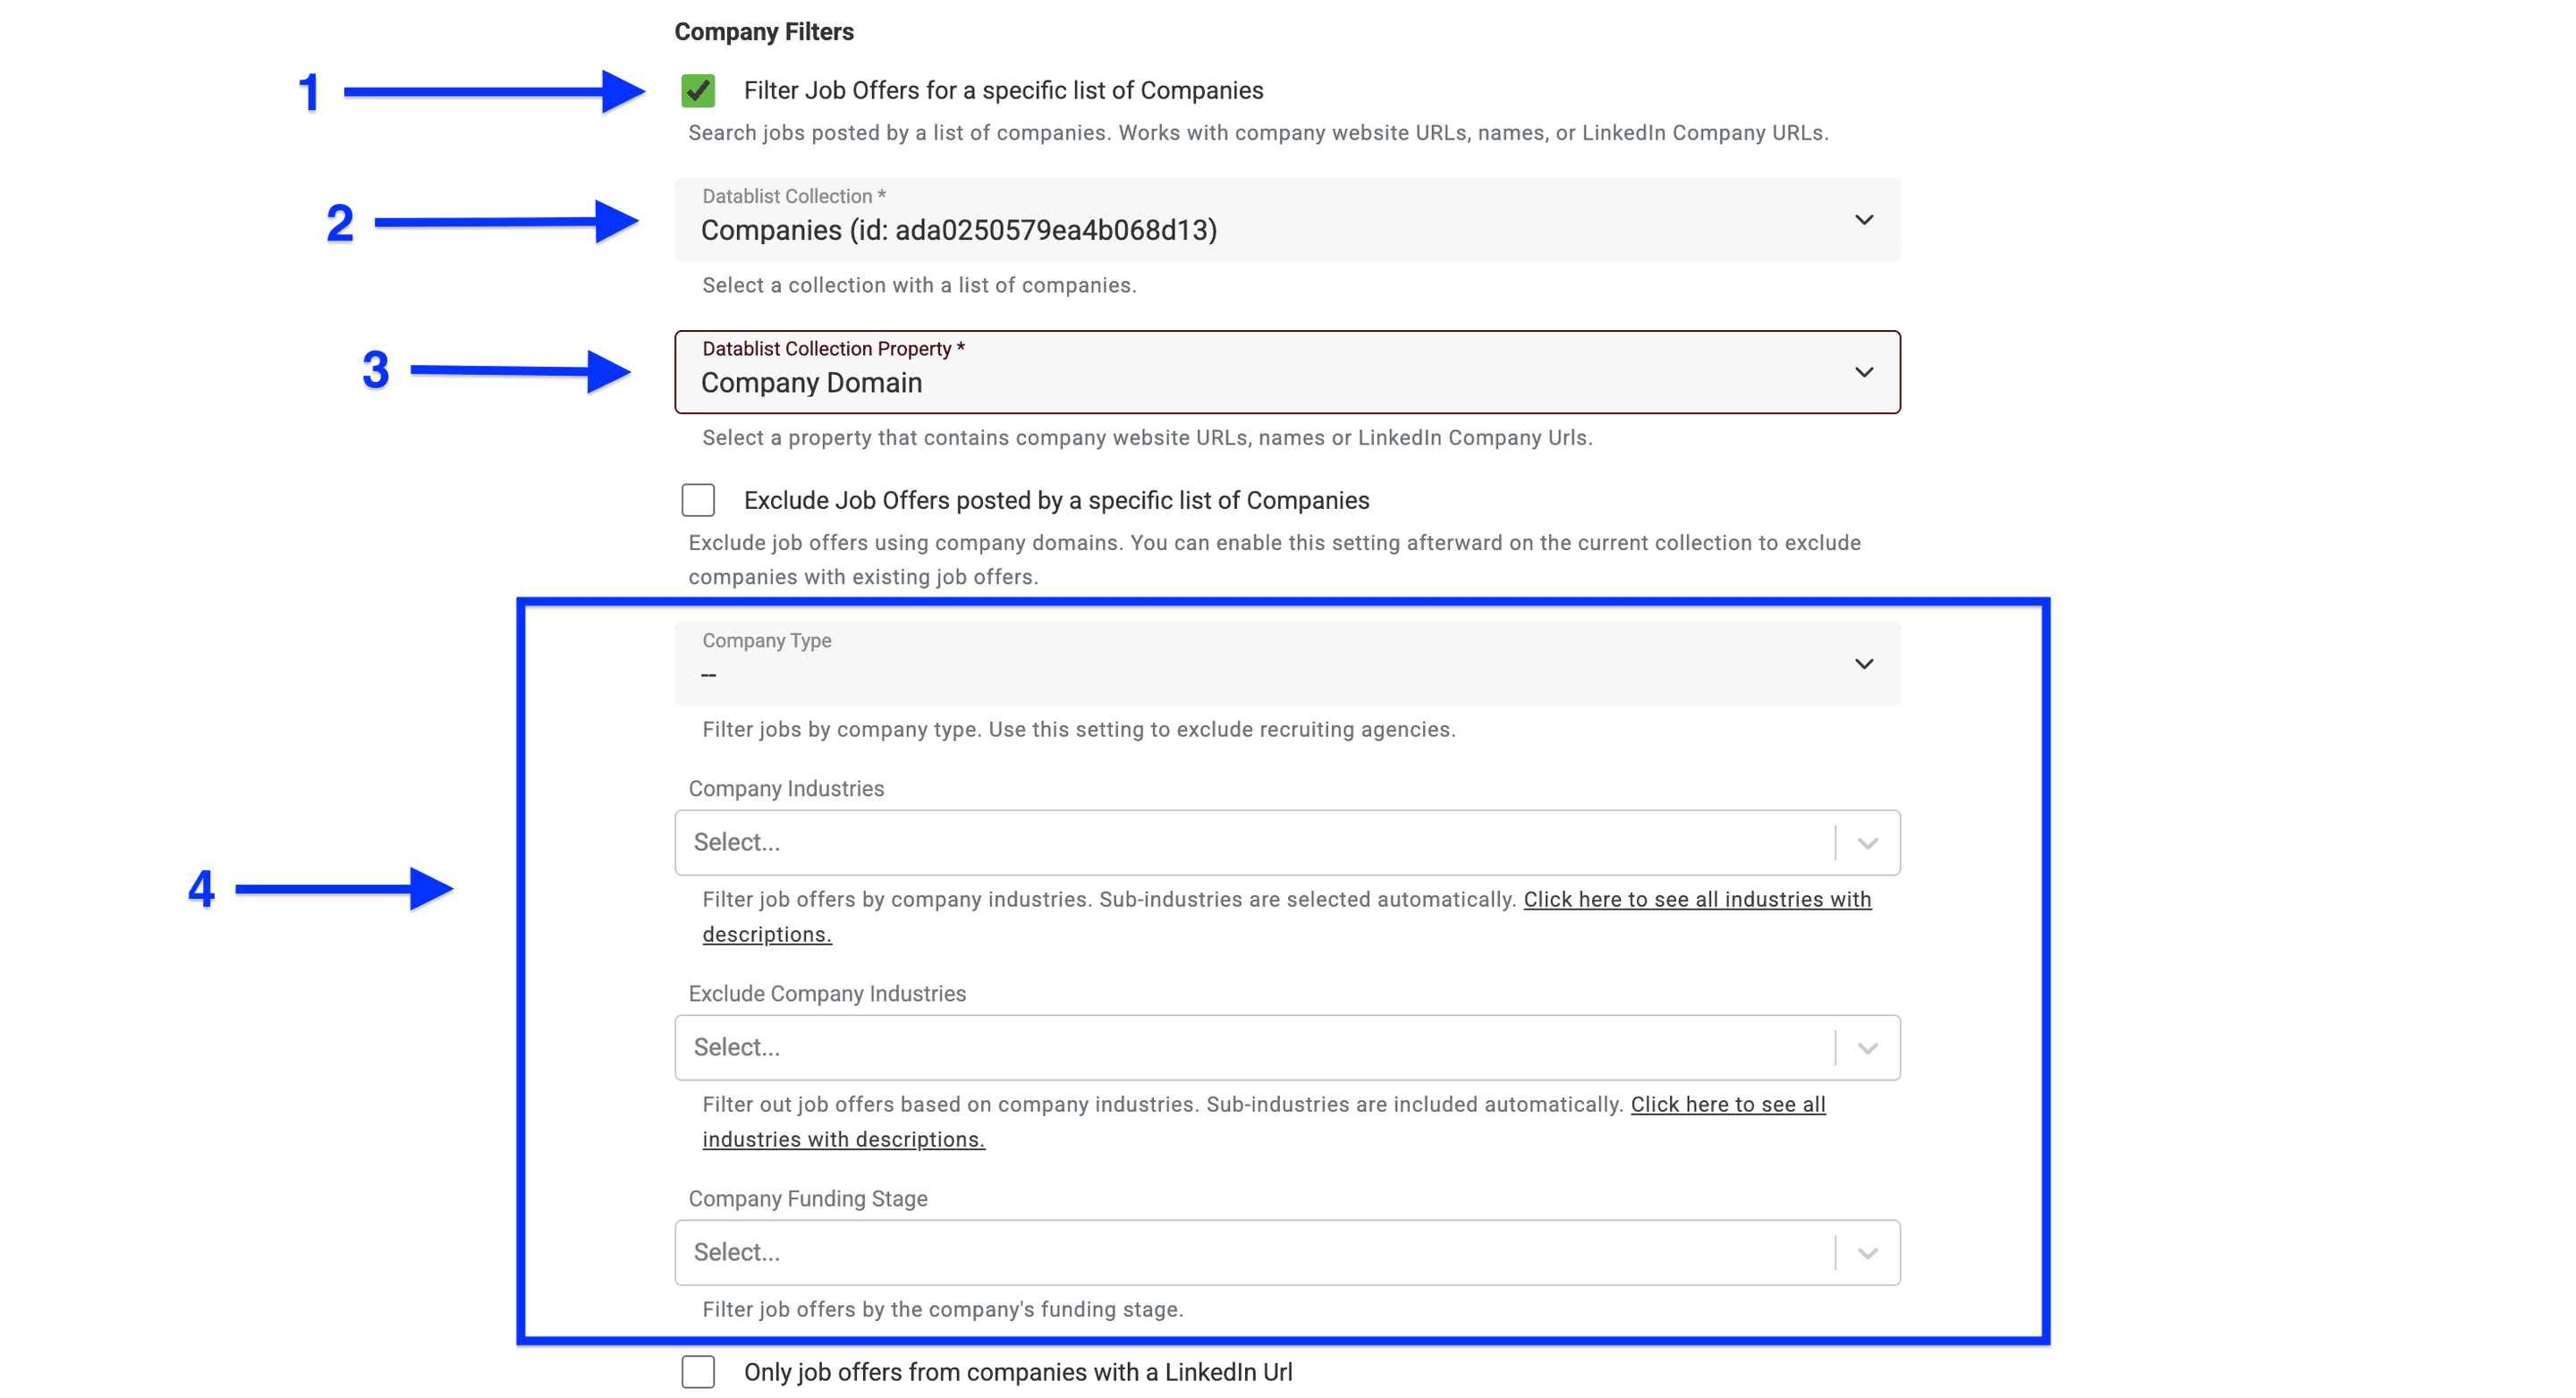
- Aktiver Filter Job Postings for a specific list of Companies.
- Velg listen du lastet opp, under Datablist Collection.
- Koble Datablist Collection Property til kolonnen med selskapets nettsted, navn eller LinkedIn-URL. Jeg anbefaler å bruke nettsteder når de er tilgjengelige, for å unngå tvetydige selskapsnavn.
- Bruk filtrene våre til å definere hvilke stillingsannonser du vil scrape. Klikk her for å se alle filtrene.
Med samme fremgangsmåte kan du også opprette en collection med nettsteder eller domener som skal ekskluderes fra stillingsresultatene.
💡 3 nyttige tips for scraping av jobbportaler
Tips 1: Ekskluder aktive kunder fra stillingssøket for å unngå pinlige situasjoner.
Tips 2: Ta med tidligere kunder i søket for å åpne dialogen med dem igjen.
Tips 3: Du kan filtrere eller ekskludere selskaper ved hjelp av nettadresser og selskapsnavn, ikke bare domener.
Når alt er konfigurert, klikker du på Continue.
Gå deretter til bunnen av siden og klikk på Run import now.
Når importen er ferdig, går du gjennom de relevante utlysningene og kilde-URL-ene deres. Søknadsfiltrene, resultatgrensen og den indekserte dekningen avgjør hvilke stillinger du mottar.
📘 Credits for stillingssøk
Hver stillingsannonse som returneres, koster 10 credits. Hvis søket for eksempel returnerer 100 utlysninger, koster det 1 000 credits. Sjekk credit-saldoen og de gjeldende abonnementene før du kjører et stort eller gjentakende søk.
Slik overvåker du nye stillinger over tid
Et gjentakende stillingssøk krever en stabil sammenligningsnøkkel og en datoperiode – ikke bare en daglig kjøring. Jeg ville startet med et daglig søk i de siste sju dagene og deretter tilpasset overlappingen til markedet ditt. Overlappingen gir forsinkede utlysninger en ny sjanse til å dukke opp, men betyr også at samme stilling kan returneres flere ganger.
- Behold
Job Posting Id,Job Posting URL,Company WebsiteogDate Postedi resultatene. - Sammenlign hver nye batch med tidligere batcher ved hjelp av
Job Posting Id. Bruk innstillingene for unike properties for å hindre dupliserte verdier, eller gå gjennom duplikatene før du slår sammen eksporter. - Behold det samme selskapet i overvåkingslisten. En annen stillings-ID fra det samme selskapet er en ny utlysning som bør vurderes, ikke et selskapsduplikat som skal forkastes.
- Registrer når du først oppdaget en utlysning i din egen sporingsfil hvis du trenger denne informasjonen.
Date Posteder publiseringsdatoen, ikke tidspunktet arbeidsflyten din oppdaget stillingen. - Undersøk manglende ID-er og tilsynelatende republiseringer basert på tittel, selskap, sted og URL. Ulike ID-er kan fortsatt beskrive lignende stillinger. Ikke slå dem sammen automatisk bare fordi tittelen er lik.
For en automatisert import på Growth velger du daglig frekvens, klokkeslett og tidssone i planleggeren for datakilden, og klikker deretter på Schedule Import. Konfigurer håndteringen av duplikater før du aktiverer tidsplanen. Du kan også gjenta søket manuelt. Deduplisering av lagrede rader gjør ikke resultatene fra dataleverandøren gratis, så ta høyde for overlapping i credit-budsjettet.
Hvis hvert av 30 daglige søk for eksempel returnerer 100 utlysninger, betaler du for 3 000 returnerte utlysninger: 30 × 100 × 10 = 30 000 credits. Selv om deduplisering bare etterlater 400 unike stillings-ID-er, koster søkene fortsatt 30 000 credits. Tallene er kun ment som eksempler. Bruk det faktiske antallet returnerte stillinger når du budsjetterer for neste måned.
Ikke anta at en stilling er besatt eller lukket bare fordi den forsvinner fra ett søk. Den kan ha falt utenfor datoperioden, filtrene eller resultatgrensen. Bruk Job Status og det returnerte feltet Closed At når du sjekker lukkede utlysninger, og kontroller viktige stillinger på kildesidene.
Derfor bør du scrape 19 jobbportaler
Har du noen gang hørt noen si: «Jeg har for mye data»? Ikke jeg heller, for data er gull. Men én ting kan vi være enige om: Ikke alle data er like mye verdt. Noe er verdifullt, mens annet er irrelevant.
Derfor er flere datakilder viktige
Når du scraper flere jobbportaler, får du flere stillingsannonser og øker dermed sjansen for å finne nyttige data. Den brede tilnærmingen sørger for at du ikke går glipp av verdifulle muligheter som ligger skjult på ulike plattformer.
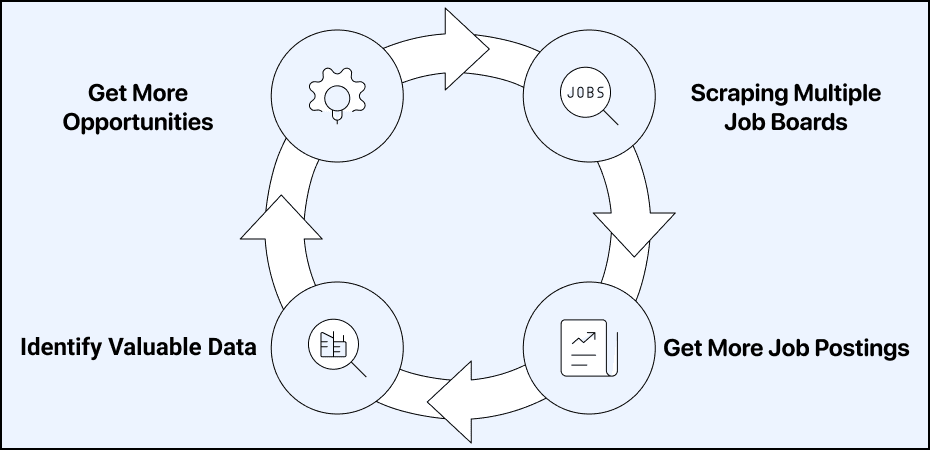
Fordeler ved å scrape flere jobbportaler
- Større datamengde
- Sammenlign utlysninger fra flere kilder
- Oppdag flere muligheter hos målselskaper
- Strategisk forretningsinnsikt
- Identifiser selskaper med et umiddelbart behov, signalisert gjennom stillingsannonser
- Prioriter target accounts ut fra hva de satser på akkurat nå
- Bruk dataene som kvalifiseringsvariabler i Cold Email-kampanjer
- Konkurransefortrinn
- Vinn oppdrag mer effektivt som rekrutterer
- Gi jobbsøkere mer helhetlig innsikt
- Oppdag ansettelsestrender før konkurrentene
- Få bedre markedsdekning enn med søk i én enkelt portal
- Kom i kontakt med potensielle kunder når de investerer i vekst
Nå som du har fått et inntrykk av hvorfor disse dataene er så nyttige, skal jeg vise deg hva du kan gjøre videre med dem.
Slik kan du bruke stillingsdata
Ja, Datablist er svært godt egnet til å scrape jobbportaler, men det utgjør ikke engang 1 % av hva plattformen kan gjøre for deg. Her er noen ideer til hvordan du kan bruke dataene fra stillingsannonsene:
- Berik selskaper med flere data
- Bruk AI Agent til å finne informasjon som ikke finnes i noen database
- Finn beslutningstakere hos target accounts
- Finn e-postadresser og telefonnumre med Waterfall Enrichment
- Bruk AI til å skrive personaliserte e-poster
- Analyser selskapets tech stack
Listen kunne fortsatt lenge. Poenget er at Datablist ikke bare er et scrapingverktøy. Ett rimelig abonnement gir deg tilgang til et helt økosystem for leadgenerering.
Konklusjon
Å scrape flere jobbportaler gir deg et konkurransefortrinn du bør utnytte så lenge du kan. Datablist gjør stillingsdata enklere tilgjengelig enn andre verktøy og lar deg også søke etter ledige stillinger hos selskaper du allerede har i CRM-systemet.
FAQ
Hvordan fungerer scraping av stillinger i denne arbeidsflyten?
Datablist søker i dataleverandørens samlede stillingsdatabase med filtrene dine og importerer deretter relevante utlysninger som rader. Dette er nyttig for å bygge strukturerte stillingslister fra flere kilder. Løsningen garanterer ikke at alle ledige stillinger fra samtlige jobbportaler blir funnet, så behold kilde-URL-ene og kontroller stillingene før du bruker dataene.
Hva betyr det å scrape stillingsannonser?
Å scrape stillingsannonser betyr å bruke automatiserte verktøy til å hente ut informasjon om ledige stillinger fra ulike nettsteder. Prosessen samler inn data som stillingstitler, beskrivelser, selskapsinformasjon, arbeidssted, lønnsnivå og mer.
Hva er det beste verktøyet for jobbscraping?
Datablist skiller seg ut som et kraftig verktøy for jobbscraping som samler stillingsannonser fra 19 jobbportaler samtidig. Det tilbyr omfattende filtrering av stillingsdetaljer, selskapsinformasjon og data om ansettelsesansvarlige. I tillegg til scraping tilbyr Datablist databerikelse, AI-drevne søk og automatisering.
Kan jeg bruke AI til å analysere stillingsannonser?
Ja. Etter at du har importert stillingene, kan du bruke AI enrichment til å klassifisere beskrivelser, identifisere relevante krav eller lage et kort sammendrag til account research. Behold den opprinnelige utlysningen og kilde-URL-en ved siden av resultatet, slik at du kan kontrollere hva modellen baserte seg på. Se guiden til AI-klassifisering for regler om etiketter og kvalitetssikring.
Hvordan bruker jeg stillingsdata i Outbound-kampanjer?
Stillingsdata gir verdifull innsikt til målrettede Outbound-kampanjer. Du kan identifisere selskaper som ansetter aktivt – et mulig vekstsignal – finne beslutningstakere, berike kontaktinformasjon og bruke AI til å skrive personaliserte meldinger basert på konkrete behov. Bekreft ansettelsessignalet før du bruker det i Outbound, og koble det til en relevant arbeidsflyt for lead scraping.
Hvilke data kan jeg hente fra jobbportaler?
Verktøy for scraping av jobbportaler, som Datablist, kan hente omfattende data. Det inkluderer stillingsdetaljer som tittel, beskrivelse, type, sted og lønn, selskapsinformasjon som navn, nettsted, LinkedIn, størrelse og bransje, informasjon om ansettelsesansvarlig som navn, tittel og LinkedIn samt metadata som publiseringsdato. Dette rike datasettet gir verdifull forretningsinnsikt.
Hvor mange jobbportaler bør jeg scrape?
Scraping av flere jobbportaler gir betydelig bedre resultater enn å basere seg på én enkelt kilde. Verktøy som Datablist kan scrape 19 jobbportaler samtidig. Det gir bred markedsdekning, flere muligheter til å identifisere potensielle kunder og bedre innsikt i ansettelsestrender før konkurrentene.