
En no-code web scraper ska omvandla de webbsidor du bryr dig om till användbara rader utan att du behöver skriva ett skript. Innan du väljer verktyg bör du testa några representativa URL:er och kontrollera att det hämtar de fält, den paginering och det utdataformat som ditt arbetsflöde kräver.
Den här rankningen använder ett annat upplägg. Ett fast 10-poängstest har tillämpats på 8 no-code-verktyg för web scraping: Datablist, Browse AI, Octoparse, Apify, Phantombuster, Outscraper, Instant Data Scraper och ParseHub.
Vårt test bygger på följande frågor: Kan verktyget scrapa vilken webbplats som helst? Kan dess AI tolka fältbeskrivningar i klartext, eller identifierar den bara tabeller automatiskt? Hjälper verktyget dig att berika resultatet, eller stannar det vid rådata? Och mycket mer …
📌 Sammanfattning för dig som har bråttom
Vårt val: Datablist är den bästa no-code scrapern för dig som vill ha maximal scrapingkraft utan kod.
Om du vill kunna scrapa alla slags webbplatser, extrahera data med instruktioner i klartext och berika resultatet direkt i samma kalkylblad är Datablist det tydligaste valet. Verktyget toppar vårt kraftfokuserade test med 9,5/10.
Två AI-agenter hjälper dig att scrapa vilken webbplats som helst. Färdiga scrapers hämtar data från LinkedIn, leads från Sales Navigator, jobbannonser, Instagram och Google Maps. Dessutom ger över 60 enrichments dig e-postadresser, telefonnummer och företagsdata utan att du behöver lämna fliken.
Också utvärderade: Browse AI, Octoparse, Phantombuster, Outscraper, Apify, Instant Data Scraper och ParseHub. För- och nackdelarna med varje verktyg beskrivs nedan.
Slutsats: Välj Datablist för störst kraft med minst friktion. Välj bara ett specialistverktyg när ditt behov är smalt.
Det här tar guiden upp
- Vad no-code scraping faktiskt innebär och vad du bör leta efter
- Testa en scraper på dina egna webbsidor
- Vårt kraftfokuserade 10-poängstest
- De 8 bästa no-code scrapers, rankade och betygsatta
- Varför rena API-verktyg och utvecklarverktyg inte rankas
- Så väljer du rätt scraper för ditt behov
- Vanliga frågor
Vad räknas som en no-code scraper?
”No-code” betyder olika saker beroende på vem som använder begreppet. För utvecklare innebär det att inga egna skript krävs. För en person utan teknisk bakgrund innebär det även att man slipper konfigurera API:er, autentiseringstokens och konfigurationsfiler.
Definitionen som många missförstår
Många definierar no-code scraping som ”scraping utan skript”. Det är en alltför snäv definition.
För en person utan teknisk bakgrund är konfigurationen av ett API fortfarande kod. Du måste skapa anrop, skicka nycklar och hantera svar. Friktionen är densamma, även om den ser annorlunda ut.
En riktig no-code scraper kräver inget av detta. Inga selektorer, skript eller API-inställningar. Du anger en webbplats, beskriver vad du vill ha och får strukturerade data tillbaka.
Vad du bör leta efter i en no-code scraper
Fem egenskaper skiljer ett verktyg du fortfarande använder nästa månad från ett du överger efter en vecka:
- Stöd för alla webbplatser: kan du ange vilken URL som helst, eller fungerar verktyget bara med mallar som stöds?
- Djup i AI-extraktionen: kan du beskriva fälten i klartext, eller identifierar verktyget bara tabeller automatiskt?
- Inbyggd enrichment: rensar och berikar verktyget informationen, eller exporterar det rådata som du måste bearbeta någon annanstans?
- Friktion vid start: är verktyget webbaserat och redo direkt, eller krävs en skrivbordsinstallation och en teknisk konsol?
- Förutsägbar prissättning: betalar du per resultat eller per körminut, där misslyckade försök kostar lika mycket som lyckade?
Du märker snabbt konsekvenserna av varje kompromiss. Begränsat stöd för olika webbplatser blockerar nischade sidor, medan bristfällig enrichment tvingar dig att koppla ihop tre olika verktyg.
📘 Det här ingår inte i rankningen
Rena API-tjänster och utvecklarverktyg (ScraperAPI, Bright Data och Zyte) behandlas i ett avslutande avsnitt men rankas inte, eftersom de inte klarar vårt krav på noll kod.
Renodlade AI-scrapers behandlas i en separat artikel. Clay utesluts eftersom det är ett verktyg för enrichment med licensierade data, inte en scraper som hämtar live-data.
Testa en no-code scraper på dina egna sidor
En verktygsrankning kan inte avgöra om just din målwebbplats kommer att fungera. Använd därför samma lilla urval med varje scraper du överväger. Du kan exempelvis välja tio offentliga produkt-URL:er från en webbutik, inklusive en produkt som saknar pris eller har en ovanlig layout. Be verktyget att returnera Produktnamn, SKU, Pris, Valuta och Produkt-URL som separata fält.
Kör urvalet och öppna sedan tre källsidor bredvid motsvarande extraherade rader. Kontrollera att priser och valutor stämmer, att saknade värden förblir tomma och att URL:en leder till rätt produkt. Om arbetet börjar på en kategorisida bör du även testa om verktyget följer pagineringen och undviker dubbletter. Exportera urvalet till CSV och kontrollera att kolumnerna fortfarande går att använda i ditt kalkylblad eller CRM.
Testet ger dig ett praktiskt beslutsunderlag: en visuell selektor kan räcka för en stabil webbplats, medan en AI-scraper passar bättre när sidornas layout varierar. För återkommande jobb bör du även kontrollera hur misslyckade sidor rapporteras och vad en omkörning kostar. Utgå inte enbart från funktionslistan när du bedömer detta.
Så poängsätter vi: det kraftfokuserade 10-poängstestet
Som tidigare nämnt definierade vi ett fast test med allt som krävs för maximal scrapingkraft utan kod. Därefter poängsatte vi åtta no-code scrapers utifrån dessa kriterier.
Varje verktyg börjar på noll. Det kan få upp till 6 poäng för ren kapacitet och ytterligare 4 bonuspoäng för låg friktion och förutsägbara kostnader. Verktyget med högst totalpoäng vinner.
Testet av scrapingkraft (6 poäng)
Kapacitet väger tyngst eftersom det är här skillnaderna mellan verktygen faktiskt märks. AI-extraktion väger allra mest.
- AI/extraktion med naturligt språk (2): beskriv fälten i klartext och låt verktyget hitta och strukturera dem. Fullständig agentbaserad extraktion ger 2 poäng. AI-hjälp eller automatisk identifiering ger 1 poäng.
- Flexibilitet för alla webbplatser (1): verktyget kan användas med valfri URL, inte bara mallar som stöds.
- Färdiga scrapers (1): bredden på utbudet av färdiga scrapers som kan köras utan att du bygger något.
- JavaScript, dynamiskt innehåll och paginering (1): hanterar moderna, skripttunga och paginerade webbplatser.
- Enrichment och automatisering (1): inbyggd datarensning eller enrichment samt schemaläggning och återkommande körningar.
Bonuspoäng för friktion och kostnad (4 poäng)
De här fyra kriterierna belönar verktyg som levererar stor kraft utan att skapa extraarbete eller göra fakturan svår att förutse.
- Friktion vid start (1): ett webbaserat verktyg som fungerar direkt slår en skrivbordsinstallation eller teknisk konsol.
- Resultat och inlärningskurva (1): rena utdata och en kort inlärningskurva slår omfattande efterbearbetning.
- Ingångspris (1): en gratisnivå eller ett lågt startpris på omkring 30 dollar per månad eller mindre som inkluderar de viktigaste scrapingfunktionerna.
- Förutsägbar prissättning (1): transparent fast pris eller pris per resultat slår användningsbaserad debitering där väntetid och nya försök kostar pengar.
De 8 bästa no-code scrapers i korthet
Här är hela rankningen innan vi går in på detaljerna. Lägg märke till hur den kraftfokuserade poängsättningen ändrar den vanliga ordningen där ”enklast verktyg vinner”:
| Verktyg | AI-extraktion | Alla sajter | Färdiga scrapers | JS/dynamiskt | Enrichment + auto | Enkelhet | Startpris (månad) | Poäng |
|---|---|---|---|---|---|---|---|---|
| Datablist | ✅ ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | 25 USD/mån | 9,5 |
| Browse AI | ✅ | ✅ | ✅ | ✅ | ⚠️ | ✅ | 48 USD/mån | 7,5 |
| Octoparse | ⚠️ | ✅ | ✅ | ✅ | ⚠️ | ⚠️ | 83 USD/mån | 7,0 |
| Phantombuster | ⚠️ | ❌ | ✅ | ✅ | ✅ | ✅ | 69 USD/mån | 6,0 |
| Outscraper | ⚠️ | ❌ | ✅ | ⚠️ | ✅ | ✅ | PAYG | 6,0 |
| Apify | ⚠️ | ✅ | ✅ | ✅ | ✅ | ❌ | 19 USD/mån | 5,5 |
| Instant Data Scraper | ⚠️ | ✅ | ❌ | ⚠️ | ❌ | ✅ | Gratis | 5,5 |
| ParseHub | ❌ | ✅ | ❌ | ✅ | ⚠️ | ❌ | Gratis/189 USD | 4,5 |
Startpriserna för betalplaner avser månadsbetalning i USD och kontrollerades den 30 oktober 2026. Browse AI erbjuder också ett årspris motsvarande 19 USD per månad, som betalas i förskott med 228 USD. Octoparses alternativ för 83 USD per månad är Standard-konfigurationen för låg användning. Ordinarie Standard kostar 119 USD per månad. Gratisnivåer och alternativ med löpande betalning finns kvar i verktygsprofilerna nedan.[10] [11]
De 8 bästa no-code scrapers, rankade och betygsatta
Rankningen går från den mest kompletta no-code scrapern till de mest specialiserade alternativen. Alla poäng, priser och funktionsuppgifter nedan bygger på tester av respektive verktyg.
Datablist: störst scrapingkraft utan kod (9,5/10)
Datablist.com är mer än en scraper. Det är ett AI-drivet kalkylblad där du kan scrapa leads, hämta webbdata, berika, rensa och ta bort dubbletter utan att lämna fliken.
Därför sticker Datablist ut som no-code scraper
Om vi återgår till definitionen av en no-code scraper – ingen kod, inget API och ingen autentisering – blir det snabbt tydligt varför Datablist vinner.
Plattformen erbjuder flera scrapingmetoder som i praktiken når alla offentliga webbplatser:
- Smart Scraper scrapar webbplatsdata snabbt
- Två AI-agenter gör grovjobbet med instruktioner i klartext när uppgiften kräver en mer riktad metod
- Över 10 andra scrapers hämtar e-postadresser, LinkedIn-data, Sales Navigator-leads, Instagram-följare, jobbannonser med mera.
Dessutom kan du skapa automatiserade arbetsflöden i Datablist och koppla ihop dem med enrichments så att informationen blir direkt användbar.
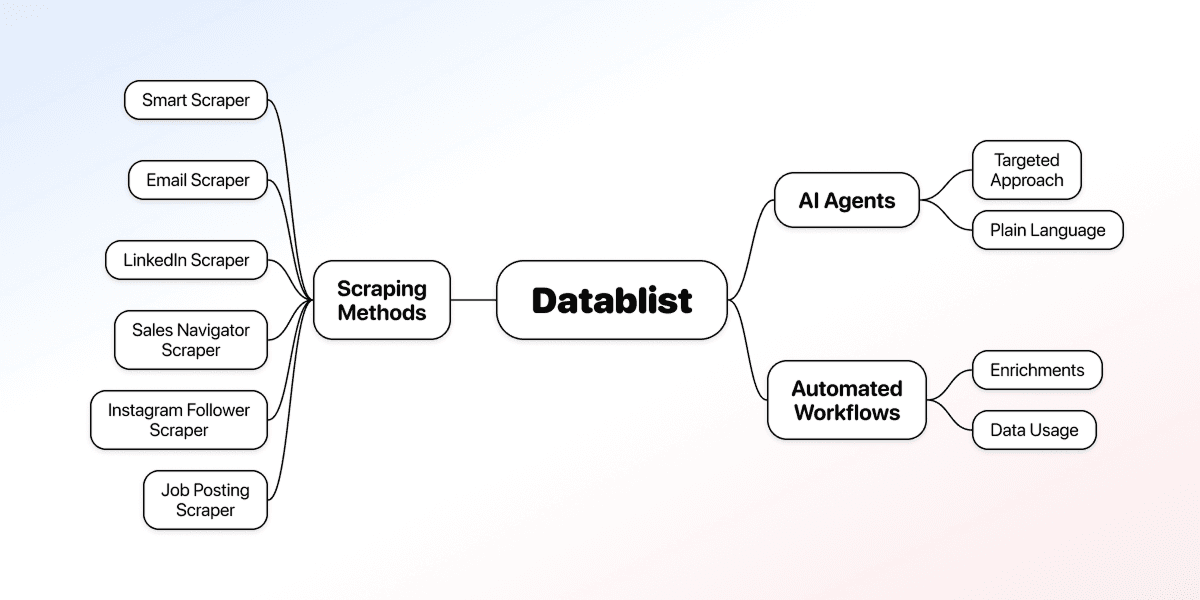
Datablists verktyg för no-code web scraping
- Smart Scraper: extraherar e-postadresser, länkar och webbplatstexter från valfri sida. Perfekt som underlag för AI-baserad kvalificering av företag
- AI Scraping Agent: hämtar en fullständig lista från en sida – exempelvis produkter från en återförsäljare, poster i en katalog eller kundcase från en webbplats – med instruktioner på vanlig engelska.
- AI Research Agent: extraherar specifika fält från en lista med webbplatser och hjälper dig att skala AI-sökningar över tusentals rader.
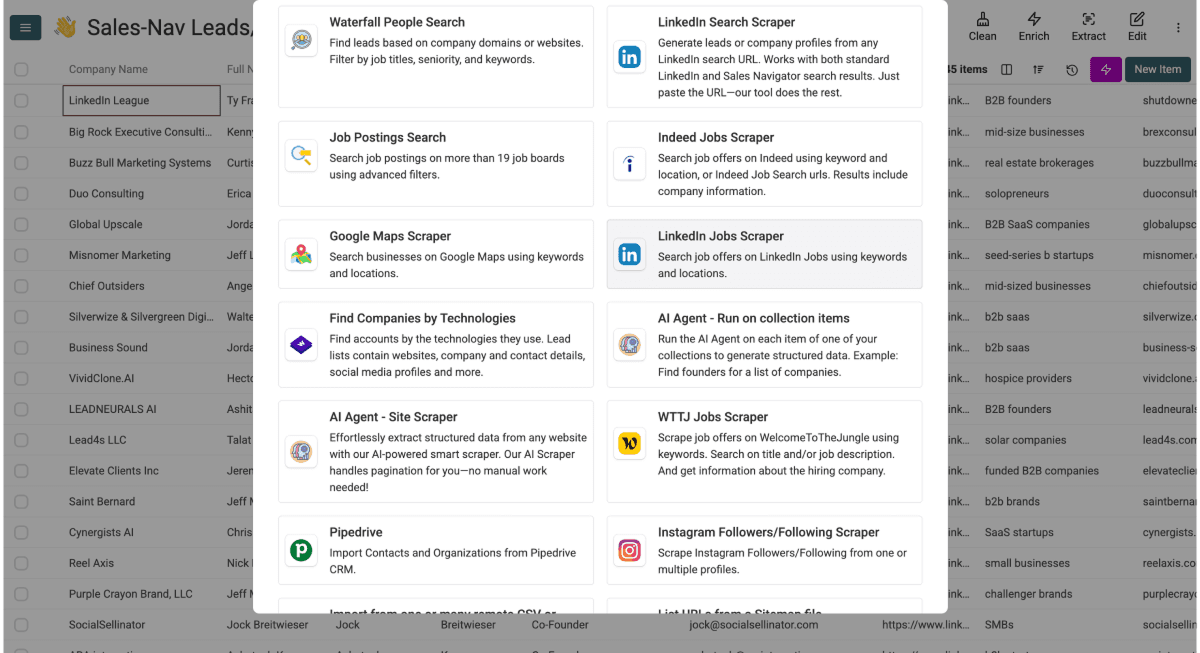
Utöver AI-agenterna erbjuder Datablist.com ett bibliotek med färdiga scrapers och enrichments för de vanligaste lead generation-jobben, utan någon konfiguration.
Datablists färdiga scrapers
De färdiga scrapers hämtar data från plattformarna som growth- och rekryteringsteam använder mest:
- Sales Navigator Scraper: exportera leads från Sales Navigator utan den vanliga risken för kontot.
- LinkedIn Jobs Scraper: hämta aktuella jobbannonser, jobbtitlar och rekryterande företag direkt från LinkedIn Jobs.
- Job Board Scraper: samla lediga tjänster från flera jobbsajter i en enda körning.
- Instagram och Google Maps: hämta sociala profiler och lokala företagslistningar för prospektering.
Datablists enrichments
Datablists enrichments omvandlar scrapade data till en komplett leadlista:
- Domain Finder: matcha företagsnamn med deras webbplatser i stor skala.
- Email and Personal Email Finder: hitta professionella eller privata e-postadresser.
- Waterfall Phone Finder: kombinera leverantörer för att hitta fler telefonnummer.
- LinkedIn Profile Finder: hitta rätt profil med enbart ett namn.
- Company and Technology Enrichment: lägg till företagsdata och identifiera en webbplats tech stack.
Sedan kommer delen som de flesta scrapers saknar: över 60 enrichments, deduplicering och datarensning samt återkommande körningar på högre abonnemangsnivåer. Du slutför hela jobbet på ett ställe i stället för att exportera informationen till tre olika verktyg.
Fördelen med Datablist: du får maximal scrapingkraft utan kod, stöd för alla webbplatser, AI-extraktion i klartext och enrichment. Dessutom finns en gratisnivå och förutsägbar prissättning per uppgift för färdiga scrapers.[1]
🆚 Datablists betyg som no-code scraper
- Poäng: 9,5/10
- Pris: Starter kostar 25 USD/mån för 5 000 credits per månad. Growth kostar 50 USD/mån för 20 000 credits. Extra credits upphör aldrig att gälla
- Åtkomstmodell: webbläsarbaserat kalkylblad samt API för dem som behöver det.
- Bäst för: dig som vill nå alla webbplatser, extrahera data med AI-instruktioner i klartext och berika informationen på ett och samma ställe
- Välj bort om: svårt att motivera om du letar efter en bra no-code scraper
Browse AI: bäst för schemalagd bevakning (7,5/10)
Browse AI kör molnbaserade peka-och-klicka-robotar som spelar in en extraktion på nästan vilken webbplats som helst och därefter bevakar förändringar enligt ett schema.
Du spelar in roboten en gång, sedan körs den automatiskt. AI-assisterad extraktion och färdiga robotar tolkar sidstrukturen väl, och du kan ange vilka fält du vill ha. Lösningen ligger dock närmare assisterad inspelning än fullständig agentbaserad extraktion.
Verktyget hanterar dynamiska sidor, scrollning och paginering. Det har även ett bibliotek med färdiga robotar och tusentals integrationer.[2] Bevakning av förändringar är dess tydligaste styrka.
Svagheten är enrichment och datarensning. Det finns inget inbyggt lager för e-postadresser, telefonnummer eller företagsdata som gör informationen användbar, och resultatet måste rensas innan det kan användas.
🆚 Browse AI:s betyg som no-code scraper
- Poäng: 7,5/10
- Pris: gratis med 50 credits/mån. Personal kostar 48 USD/mån eller 19 USD/mån vid årsbetalning (228 USD i förskott). Professional kostar från 69 USD/mån vid årsbetalning
- Åtkomstmodell: webbapp, API och integrationer
- Bäst för: schemalagd bevakning och återkommande extraktion från specifika sidor.
- Välj bort om: du behöver inbyggd enrichment eller utdata som inte kräver någon rensning
Octoparse: bästa no-code scrapern för desktop (7,0/10)
Octoparse är en visuell no-code scraper för desktop och molnet, med automatisk AI-identifiering, ett stort mallbibliotek, schemaläggning, IP-rotation och CAPTCHA-lösning.[3]
Peka-och-klicka-byggaren fungerar på praktiskt taget alla offentliga webbplatser. Automatisk AI-identifiering skannar sidan och skapar en extraktionsmall med ett klick. Det är AI-hjälp, inte extraktion med naturligt språk. Du kan inte beskriva valfria fält i löpande text.
Verktyget är starkt på JavaScript, infinite scroll, paginering, rullgardinsmenyer och formulär. Det har även ett stort mallbibliotek för populära webbplatser. Schemaläggning och parallella körningar i molnet fungerar också bra.
Octoparse har samma problem som många andra no-code-verktyg för web scraping: ingen enrichment, rådata som måste rensas och krav på en desktopinstallation samt en relativt dyr plan för att låsa upp extraktion i molnet.
🆚 Octoparses betyg som no-code scraper
- Poäng: 7,0/10
- Pris: gratisnivå endast för lokala körningar. Standard för låg användning kostar 83 USD/mån och ordinarie Standard 119 USD/mån. Årsbetalning finns också
- Åtkomstmodell: desktopapp, moln och API
- Bäst för: mallbaserad, schemalagd extraktion från kataloger, kartor och webben i stort
- Välj bort om: du vill ha ett renodlat webbläsarverktyg eller inbyggd enrichment
Phantombuster: svårt att rekommendera (6,0/10)
Phantombuster är ett bibliotek med färdiga ”Phantoms”, det vill säga fasta arbetsflöden för en begränsad lista med plattformar: LinkedIn, Instagram, Twitter, Google Maps och några andra.
Tjänsten har en katalog för specifika datakällor. Schemaläggning, sammankoppling via Flows och AI-assisterad datarensning fungerar bra så länge din källa finns på listan över plattformar som stöds.
Verktyget fungerar bra inom sin egen katalog. Går du utanför den märks tre kompromisser direkt:
- Inget stöd för valfria webbplatser: Phantombuster kör bara färdiga Phantoms, så du kan inte ange en godtycklig URL. Det finns inte heller någon extraktion med naturligt språk, utan bara ett fåtal fasta arbetsflöden.
- Risk för kontot: Phantoms får åtkomst till sociala plattformar genom anslutna sessionscookies. Det ökar risken för upptäckt, och användare har tidigare fått sina konton blockerade.
- Oförutsägbar debitering: prissättning baserad på körtid innebär att körningar som fastnar kostar lika mycket som lyckade körningar, vilket gör den verkliga kostnaden svår att prognostisera.
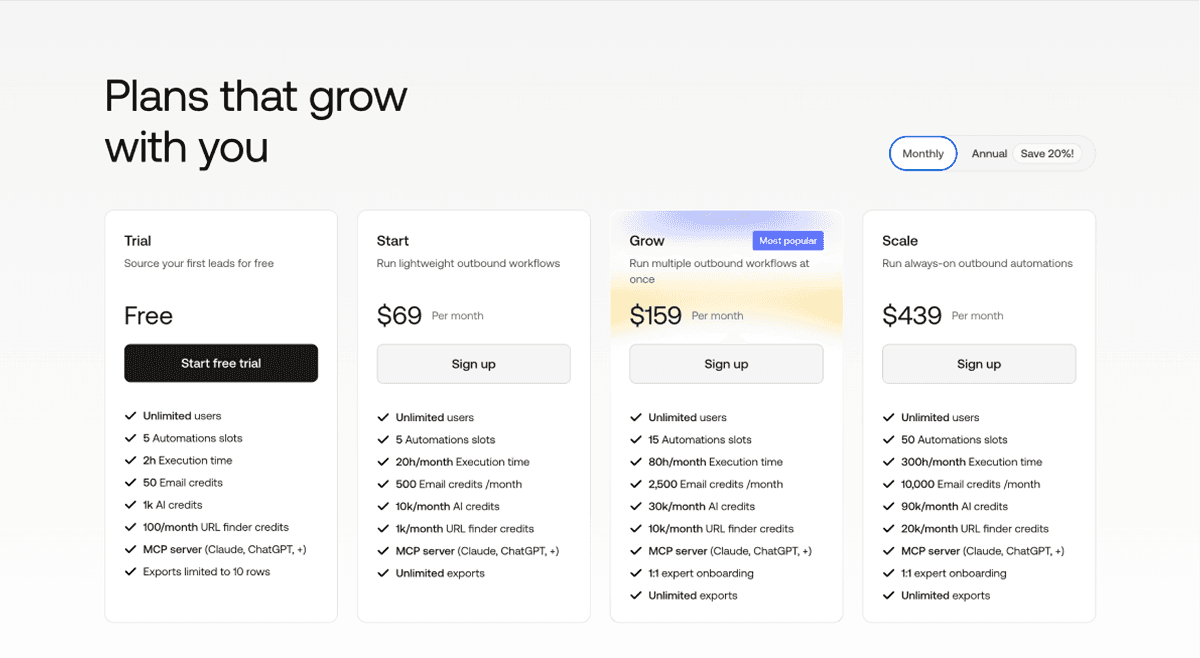
Phantombuster har en gratis provperiod, men den är bara avsedd för en snabb utvärdering. Exporter är begränsade till 10 rader och du får två timmars körtid som engångspott, utan månatlig påfyllning.[4]
🆚 Phantombusters betyg som no-code scraper
- Poäng: 6,0/10
- Pris: endast gratis provperiod (exporter begränsade till 10 rader och två timmars körtid utan påfyllning). Betalplanen Start kostar omkring 69 USD/mån eller 56 USD/mån vid årsbetalning
- Åtkomstmodell: webbapp, API och integrationer (Make, Zapier och n8n)
- Bäst för: svårt att rekommendera. Allt verktyget gör täcks av Datablist och andra alternativ till ett bättre pris och utan samma begränsningar
- Välj bort om: du behöver scrapa valfria vanliga webbplatser
Outscraper: bäst för billig Google Maps-data (6,0/10)
Outscraper är en katalog med scrapers för bland annat Google Maps, företagsdata och recensioner. Tjänsten erbjuder tillägg för enrichment, löpande betalning och ett API.[5]
Du väljer en tjänst och kör den utan installation. Tjänsten Universal AI Scraper ger AI-driven extraktion, men större delen av plattformen består av fasta, färdiga tjänster i stället för flexibel extraktion.
Täckningen är relativt bred och resultatet är rent och strukturerat. Det finns viss enrichment av kontaktuppgifter samt schemaläggning och automatisering via API. Fokus ligger dock på Google Maps.
🆚 Outscrapers betyg som no-code scraper
- Poäng: 6,0/10
- Pris: gratisnivå. Löpande betalning från omkring 3 USD per 1 000 grundposter, eller ungefär 9–14 USD med fullständiga kontaktuppgifter
- Åtkomstmodell: användargränssnitt, API och MCP-server
- Bäst för: team med mycket liten budget som bara behöver grundläggande data
- Välj bort om: du behöver scrapa en specifik, valfri webbplats
Apify: bäst för variation och skalbarhet (5,5/10)
Apify är en marknadsplats med över 43 000 färdiga Actors[6] och en komplett headless browser-motor, byggd för att scrapa praktiskt taget vad som helst i stor skala.
När det gäller ren flexibilitet slår inget annat verktyg på listan Apify. SDK:n och egna Actors når alla webbplatser, den färdiga katalogen är störst i jämförelsen och rendering av JavaScript, infinite scroll samt proxyrotation är centrala funktioner.
Problemet är kravet på noll kod. Konsolen är teknisk, anpassade lösningar kräver kod och kvaliteten samt drifttiden varierar mellan Actors som underhålls av communityn. Det finns inget eget lager för extraktion med naturligt språk.
Debiteringen beror på vilken Actor du använder. Användningsbaserade Actors kan debitera för datorkraft, proxyer och lagring, medan andra tar betalt per event eller kombinerar båda modellerna. Kontrollera priserna och utgiftsgränsen för vald Actor innan du uppskattar kostnaden per lead.[7]
🆚 Apifys betyg som no-code scraper
- Poäng: 5,5/10
- Pris: gratis med 5 USD i credits per månad. Starter kostar 19 USD/mån och inkluderar 19 USD i förbetald användning. Därefter gäller löpande betalning enligt prismodellen för vald Actor
- Åtkomstmodell: användargränssnitt för uppgifter, API och SDK (JS/Python)
- Bäst för: tekniska användare som vill ha maximal flexibilitet och störst utbud av färdiga scrapers
- Välj bort om: du vill ha verklig no-code scraping för nybörjare med förutsägbara kostnader
Instant Data Scraper: bästa gratisverktyget för engångsjobb (5,5/10)
Instant Data Scraper är ett kostnadsfritt Chrome-tillägg som använder heuristik för att identifiera tabeller på en sida och exportera dem, utan krav på konto.[8]
För en snabb extraktion är det svårslaget: ett klick, omedelbart resultat och helt gratis. Det fungerar på många list- och tabellsidor och hanterar infinite scroll samt grundläggande paginering.
När du behöver mer än grunderna tar möjligheterna snabbt slut. Det finns inget mallbibliotek, ingen schemaläggning och ingen enrichment. Verktyget har dessutom svårt för komplexa dynamiska webbplatser. Resultatet behöver vanligtvis rensas.
🆚 Instant Data Scrapers betyg som no-code scraper
- Poäng: 5,5/10
- Pris: helt gratis, utan konton eller abonnemangsnivåer
- Åtkomstmodell: endast Chrome-tillägg
- Bäst för: snabba, kostnadsfria engångsextraktioner av tabeller
- Välj bort om: du behöver återkommande jobb, enrichment eller rena strukturerade utdata.
ParseHub: svårt att rekommendera (4,5/10)
ParseHub är en visuell desktop-scraper som hanterar JavaScript, AJAX och paginering, med schemaläggning på betalplanerna.
Visuell markering fungerar på de flesta offentliga webbplatser, och verktyget hanterar rullgardinsmenyer, AJAX och paginering bra. Gratisnivån med 200 sidor per körning[9] gör det enkelt att testa verktyget med liten budget.
Nackdelarna är dock många: ingen AI eller extraktion med naturligt språk, inget riktigt mallbibliotek, ingen enrichment, ett användargränssnitt som känns hämtat från 2012 och en brant inlärningskurva.
Betalplanerna börjar på 189 USD/mån[9], vilket är mycket dyrt jämfört med övriga verktyg.
🆚 ParseHubs betyg som no-code scraper
- Poäng: 4,5/10
- Pris: gratisnivå med 200 sidor per körning. Standard kostar omkring 189 USD/mån
- Åtkomstmodell: desktopapp och API
- Bäst för: svårt att rekommendera.
- Välj bort om: du vill ha AI-extraktion eller ett modernt verktyg med låg friktion
Så väljer du rätt no-code scraper för ditt behov
Vilken no-code scraper som är bäst beror på din situation. Så här väljer du:
- En webbplats eller många? För jobb på valfria webbplatser passar Datablist, Apify eller Octoparse. För fasta datakällor passar Outscraper.
- Webben i allmänhet eller sociala plattformar? Datablist passar bäst för scraping av sociala medier och lead generation.
- Engångsjobb eller återkommande körningar? Instant Data Scraper passar för en snabb extraktion, Browse AI för schemalagd bevakning och Datablist för återkommande jobb.
- Rådata eller berikade data? Om du behöver e-postadresser, telefonnummer och företagsdata på samma ställe är Datablist det enda kompletta alternativet.
- Vilken budget har du? Instant Data Scraper och gratisnivåerna passar för kostnadsfria tester. Om du vill ha förutsägbara kostnader som kan skalas bör du prioritera plattformar med pris per resultat framför debitering per beräkningsenhet eller körtid.
Slutsats: Datablist ger mest kraft utan kod
Om du vill ha maximal scrapingkraft utan att skriva kod är Datablist.com den klara vinnaren. Det är den enda no-code scrapern som toppar vårt kraftfokuserade test med 9,5/10. Verktyget kombinerar stöd för alla webbplatser och AI-extraktion med naturligt språk med enrichment som de andra alternativen helt enkelt saknar.
För sociala medier och lead scraping är skillnaden ännu större. Du kan exportera Sales Navigator-leads utan att riskera ditt konto, scrapa jobbannonser från LinkedIn, Instagram-profiler och företagslistningar från Google Maps samt låta AI Research Agent fylla i valfria fält över tusentals rader.
Datablists enrichment för e-post, telefonnummer och företagsdata omvandlar sedan den scrapade informationen till en kontaktklar leadlista, direkt i samma kalkylblad. För bredast funktionalitet med minst friktion kommer inget annat verktyg i närheten.
Vanliga frågor om no-code scrapers
Vilken är den bästa no-code web scrapern?
Datablist hamnar först i vårt test med 9,5/10. Verktyget kombinerar scraping av valfria webbplatser, extraktion med naturligt språk via två AI-agenter samt inbyggd enrichment och datarensning. Därmed täcker det det mesta en no-code scraper behöver kunna göra.
Vilken no-code scraper passar bäst för icke-tekniska användare?
Datablist är det starkaste valet för icke-tekniska användare eftersom det fungerar som ett välbekant kalkylblad och låter dig beskriva fält i klartext. Browse AI och Octoparse är också lättanvända, men båda bygger mer på inspelning med peka-och-klicka än på AI-extraktion.
Kan en no-code scraper scrapa alla webbplatser?
Vissa kan det. Datablist, Apify, Octoparse och ParseHub kan i praktiken nå alla offentliga URL:er. Andra, som Outscraper och Phantombuster, kör bara färdiga scrapers för en fast uppsättning datakällor och kan därför inte riktas mot en valfri webbplats.
Vilket no-code scrapingverktyg har mest förutsägbart pris?
Pris per resultat och fasta priser vinner här. Datablists färdiga scrapers har ett fast pris per uppgift, medan Octoparse använder fasta abonnemang. Apify och Phantombuster förlitar sig mer på användnings- eller tidsbaserad debitering, där körningar som fastnar och nya försök fortfarande kostar pengar.
Kan en no-code web scraper extrahera data med naturligt språk?
Ja, de bästa kan det. Med Datablists AI Scraping Agent kan du beskriva önskade fält på vanlig engelska. De flesta andra verktyg erbjuder AI-hjälp eller automatisk identifiering som tolkar sidans struktur men inte kan följa fritt formulerade instruktioner.
Vilken är den billigaste no-code web scrapern?
Instant Data Scraper är gratis, medan Datablist, ParseHub och Browse AI har gratisnivåer för begränsad användning. För löpande betalt arbete börjar Datablist på 25 USD/mån med credits som även kan användas till enrichment[1]. Det är billigare än att betala separat för verktyg för scraping, datarensning och enrichment.
Vad är en no-code scraper?
En no-code scraper hämtar data från webbplatser utan skript eller API. Du använder en visuell byggare, en färdig scraper eller en AI-agent i stället för att skriva selektorer. Därmed kan vem som helst extrahera webbdata utan programmeringskunskaper.
Hur fungerar no-code-verktyg för web scraping?
Peka-och-klicka-verktyg spelar in de element du väljer, färdiga scrapers riktar in sig på kända datakällor och AI-scrapers läser sidan ungefär som en människa och returnerar de fält du beskriver – helt utan kod.
Går det att scrapa en webbplats utan kod?
Ja. No-code scrapers hanterar hela processen, från att öppna sidan till att strukturera informationen. Med en AI-scraper som Datablist klistrar du in en URL, beskriver vad du vill ha i klartext och låter verktyget extrahera och strukturera resultatet.
Klarar no-code scrapers JavaScript-tunga webbplatser?
De flesta moderna verktyg gör det. Datablist, Apify, Octoparse, Browse AI och ParseHub kan alla rendera JavaScript och hantera dynamiska, paginerade sidor. Enklare tillägg som Instant Data Scraper kan få problem med komplexa dynamiska webbplatser.
Vad skiljer en no-code scraper från en API-scraper?
En no-code scraper körs från ett användargränssnitt utan programmering. En API-scraper som ScraperAPI eller Zyte returnerar data genom kod som du själv skriver. API-verktyg är kraftfulla men klarar inte kravet på noll kod och rankas därför inte här.
Är no-code scrapers säkra på plattformar som kräver konto?
Verktyg som Datablist, som scrapar via sin egen infrastruktur, håller dina konton utanför processen. Verktyg som skickar en inloggningscookie till molnautomatisering via delade IP-adresser, som Phantombuster, medför större risk för upptäckt.
Vilken no-code scraper är bäst för sociala medier?
Datablist kan scrapa LinkedIn-data, Sales Navigator-leads, Instagram-följare och Instagram-profiler utan att ansluta dina konton på sociala medier. Verktyget scrapar även Google Maps, LinkedIn Jobs, Indeed och mycket mer.