
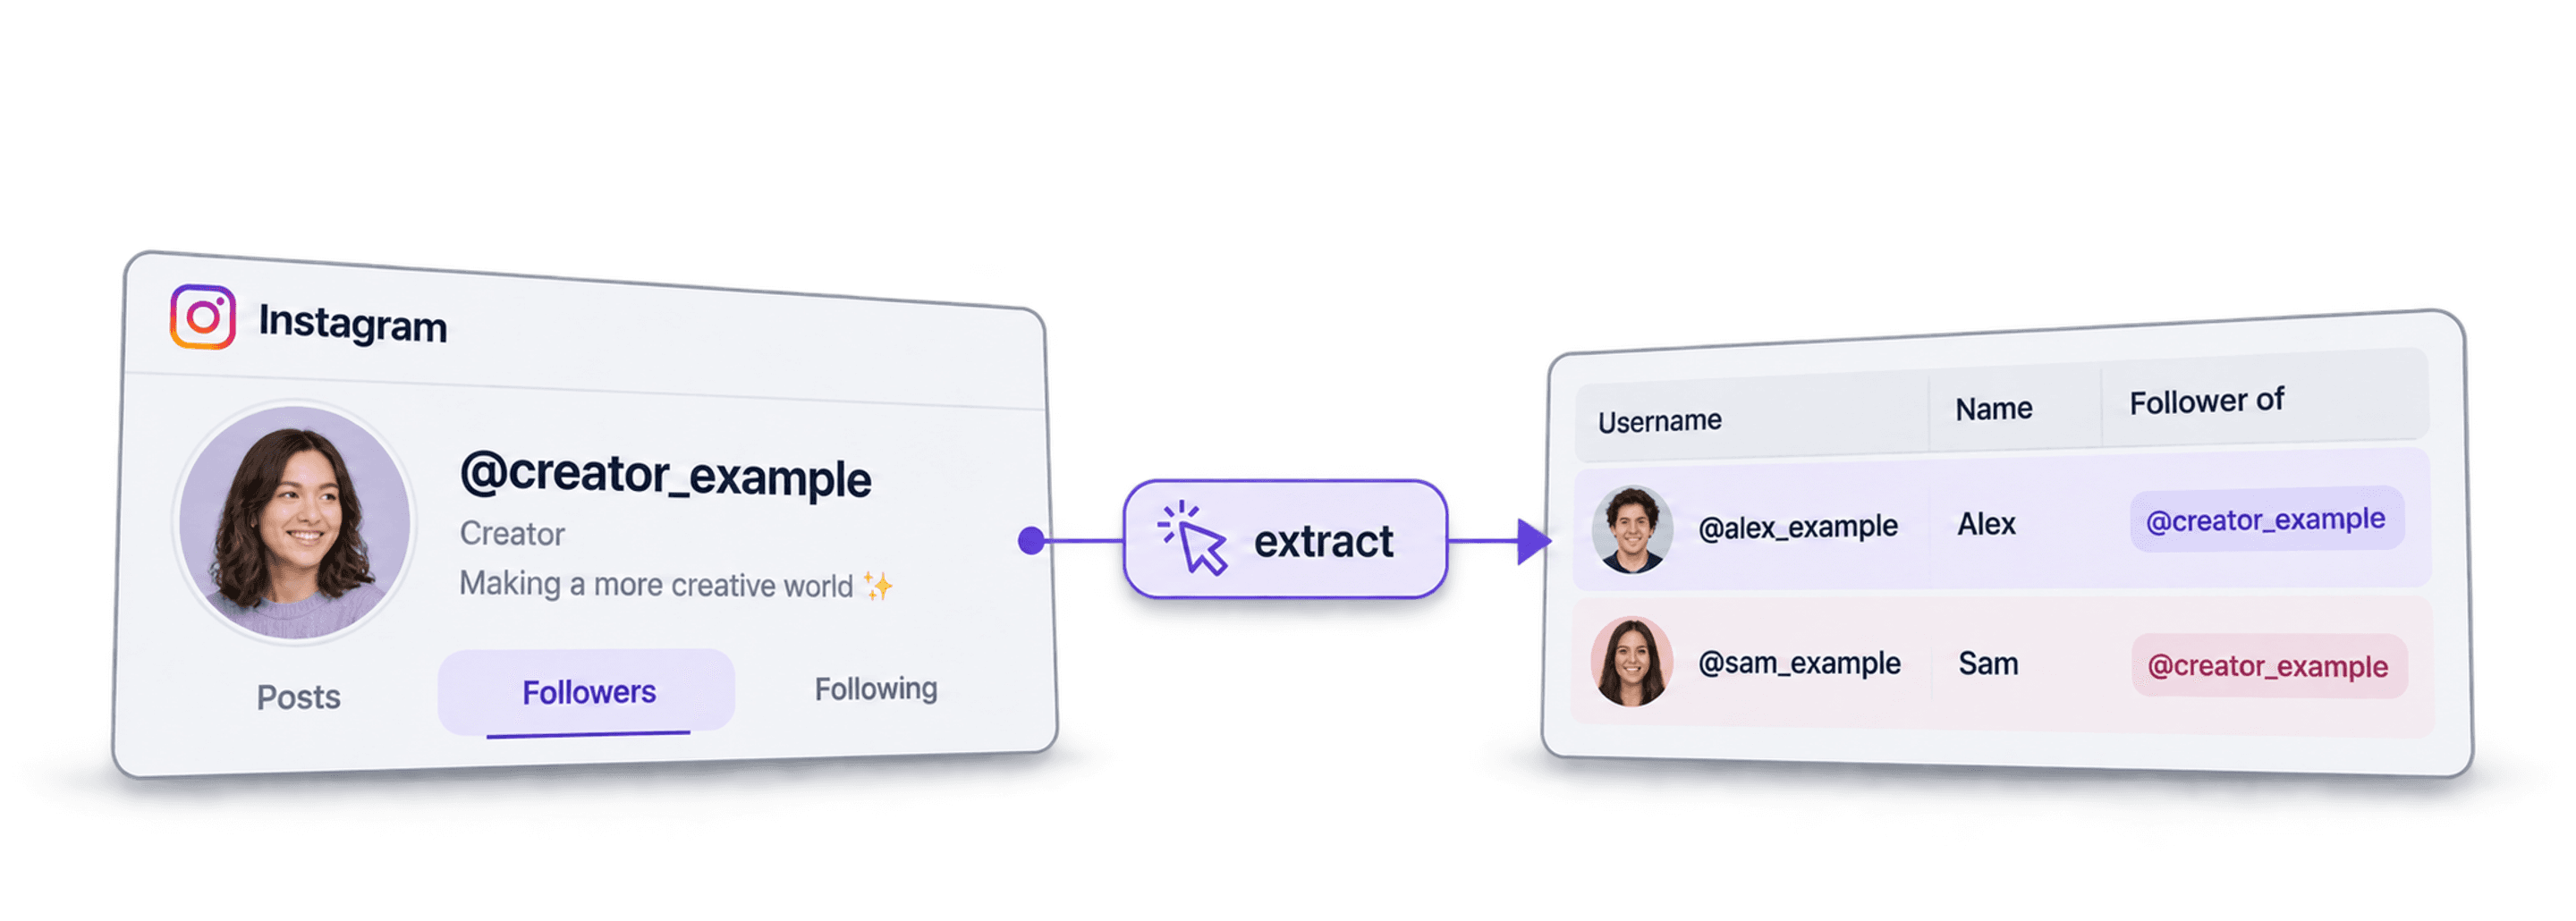
För att skrapa Instagram-följare i Datablist öppnar du källan Instagram Followers/Following Scraper, anger en offentlig profil-URL, ett användarnamn eller ett användar-ID, väljer en gräns per profil och granskar de returnerade följarraderna innan du exporterar dem.
Jag rekommenderar att börja med en profil och en låg gräns. Listan du får är en ögonblicksbild av de konton som leverantören kunde hämta – inte en garanti för att profilens fullständiga, aktuella följarlista har samlats in. Att någon följer en influencer inom en viss nisch säger inte heller något säkert om personens yrke, plats eller köpintresse.
Den här guiden går igenom källinställningar, relationsfält, granskning och deduplicering, hur du återupptar en större skrapning samt separat enrichment av profildata. Du behöver inte lämna ut dina inloggningsuppgifter till Instagram.
📌 Snabbguide
Skapa en collection, öppna See all sources och välj Instagram Followers/Following Scraper. Ange en profil per rad under Instagram Profiles, behåll Followers (default) under Scrape followers or following och ställ in Scraping Limit Per Profile. Lägg till identifierare för följare och källprofiler, kör ett test och kontrollera sedan resultatet innan du exporterar.
Vad kostar det att skrapa Instagram-följare?
Att hämta följarlistan kostar 0,01 credits per returnerad följare. Att identifiera källprofilen kan kosta ytterligare 1 credit om identifieraren inte finns i cachen. Enrichment av profildata debiteras separat.
Anta exempelvis att en källprofil returnerar exakt 1 000 följarrader:
- Följarlista: 1 000 × 0,01 = 10 credits, plus 1 för en källsökning som inte finns i cachen: 11 credits.
- Profildata för 100 utvalda följare: med deras returnerade User Id kostar standardsökningen 2 credits per profil: 200 credits. Alternativet kan returnera offentlig e-postadress och telefonnummer när dessa finns tillgängliga, men inget av fälten kan garanteras.
- Totalt: 211 credits för listan och de 100 profilsökningarna. Kostnaden för enrichment ändras om du lägger till About-data eller väljer en annan Scraping Type.
Vid månadsvis fakturering i USD kostar Starter 25 dollar och inkluderar 5 000 credits. Om hela saldot är oanvänt behövs ingen påfyllning för exemplet, och du har 4 789 credits kvar. Abonnemanget på 25 dollar är betalningen, medan 211 credits är arbetsflödets förbrukning. Credits har inget fast dollarvärde som gäller för alla abonnemang och påfyllningspaket.
Använd det returnerade User Id-värdet för profilens enrichment i det här exemplet. Ett användarnamn eller en URL kan kräva ytterligare en sökning efter identifieraren. Kontrollera antalet returnerade rader och förbrukade credits efter testet. Leverantörens sidor kan överskrida en låg begärd gräns, och en profilsökning kan förbruka credits även om inga följarrader returneras. Den angivna gränsen är därför inget exakt kostnadstak.
Vad är Datablist? En snabb överblick
Datablist är en kalkylbladsliknande arbetsyta för Lead Generation-arbetsflöden. Du kan samla in, granska, enrich och exportera rader med hjälp av olika enrichments, från AI Agents och Email Finders till AI processors, Technology enrichments och mycket mer.
I Datablist kan du dessutom skapa automatiserade arbetsflöden som körs enligt ett schema eller vid behov. Här är några praktiska användningsområden som är populära bland Datablists användare:
- Bygga Lead-listor
- Personalisera e-post med AI
- Rensa och deduplicera CRM-system
- Skrapa jobbannonser
- Skrapa Leads från Sales Navigator
Skrapa Instagram-följare billigt – steg för steg
Nu sätter vi igång. Börja med att öppna Datablist och ange vad du vill skrapa, det vill säga profilernas URL:er eller användarnamnen för de influencers vars följare du vill hämta.
Skapa först ett test och utöka sedan körningen när du har kontrollerat källprofilen och de returnerade fälten. Du behöver varken ett webbläsartillägg eller en egen API-nyckel från leverantören för det här arbetsflödet.
📘 Viktigt: privata profiler
Det går inte att hämta följarlistan för en privat profil med det här arbetsflödet. En körning kan förbruka credits för att identifiera en profil även om inga följarrader returneras. Enrichment av profildata är en separat sökning och ger inte tillgång till privata inlägg eller följarlistor.
Steg 1: Skapa ett konto på Datablist.com
Gå till Datablist.com och skapa ett konto. Följ kontoinställningen för att öppna din arbetsyta.
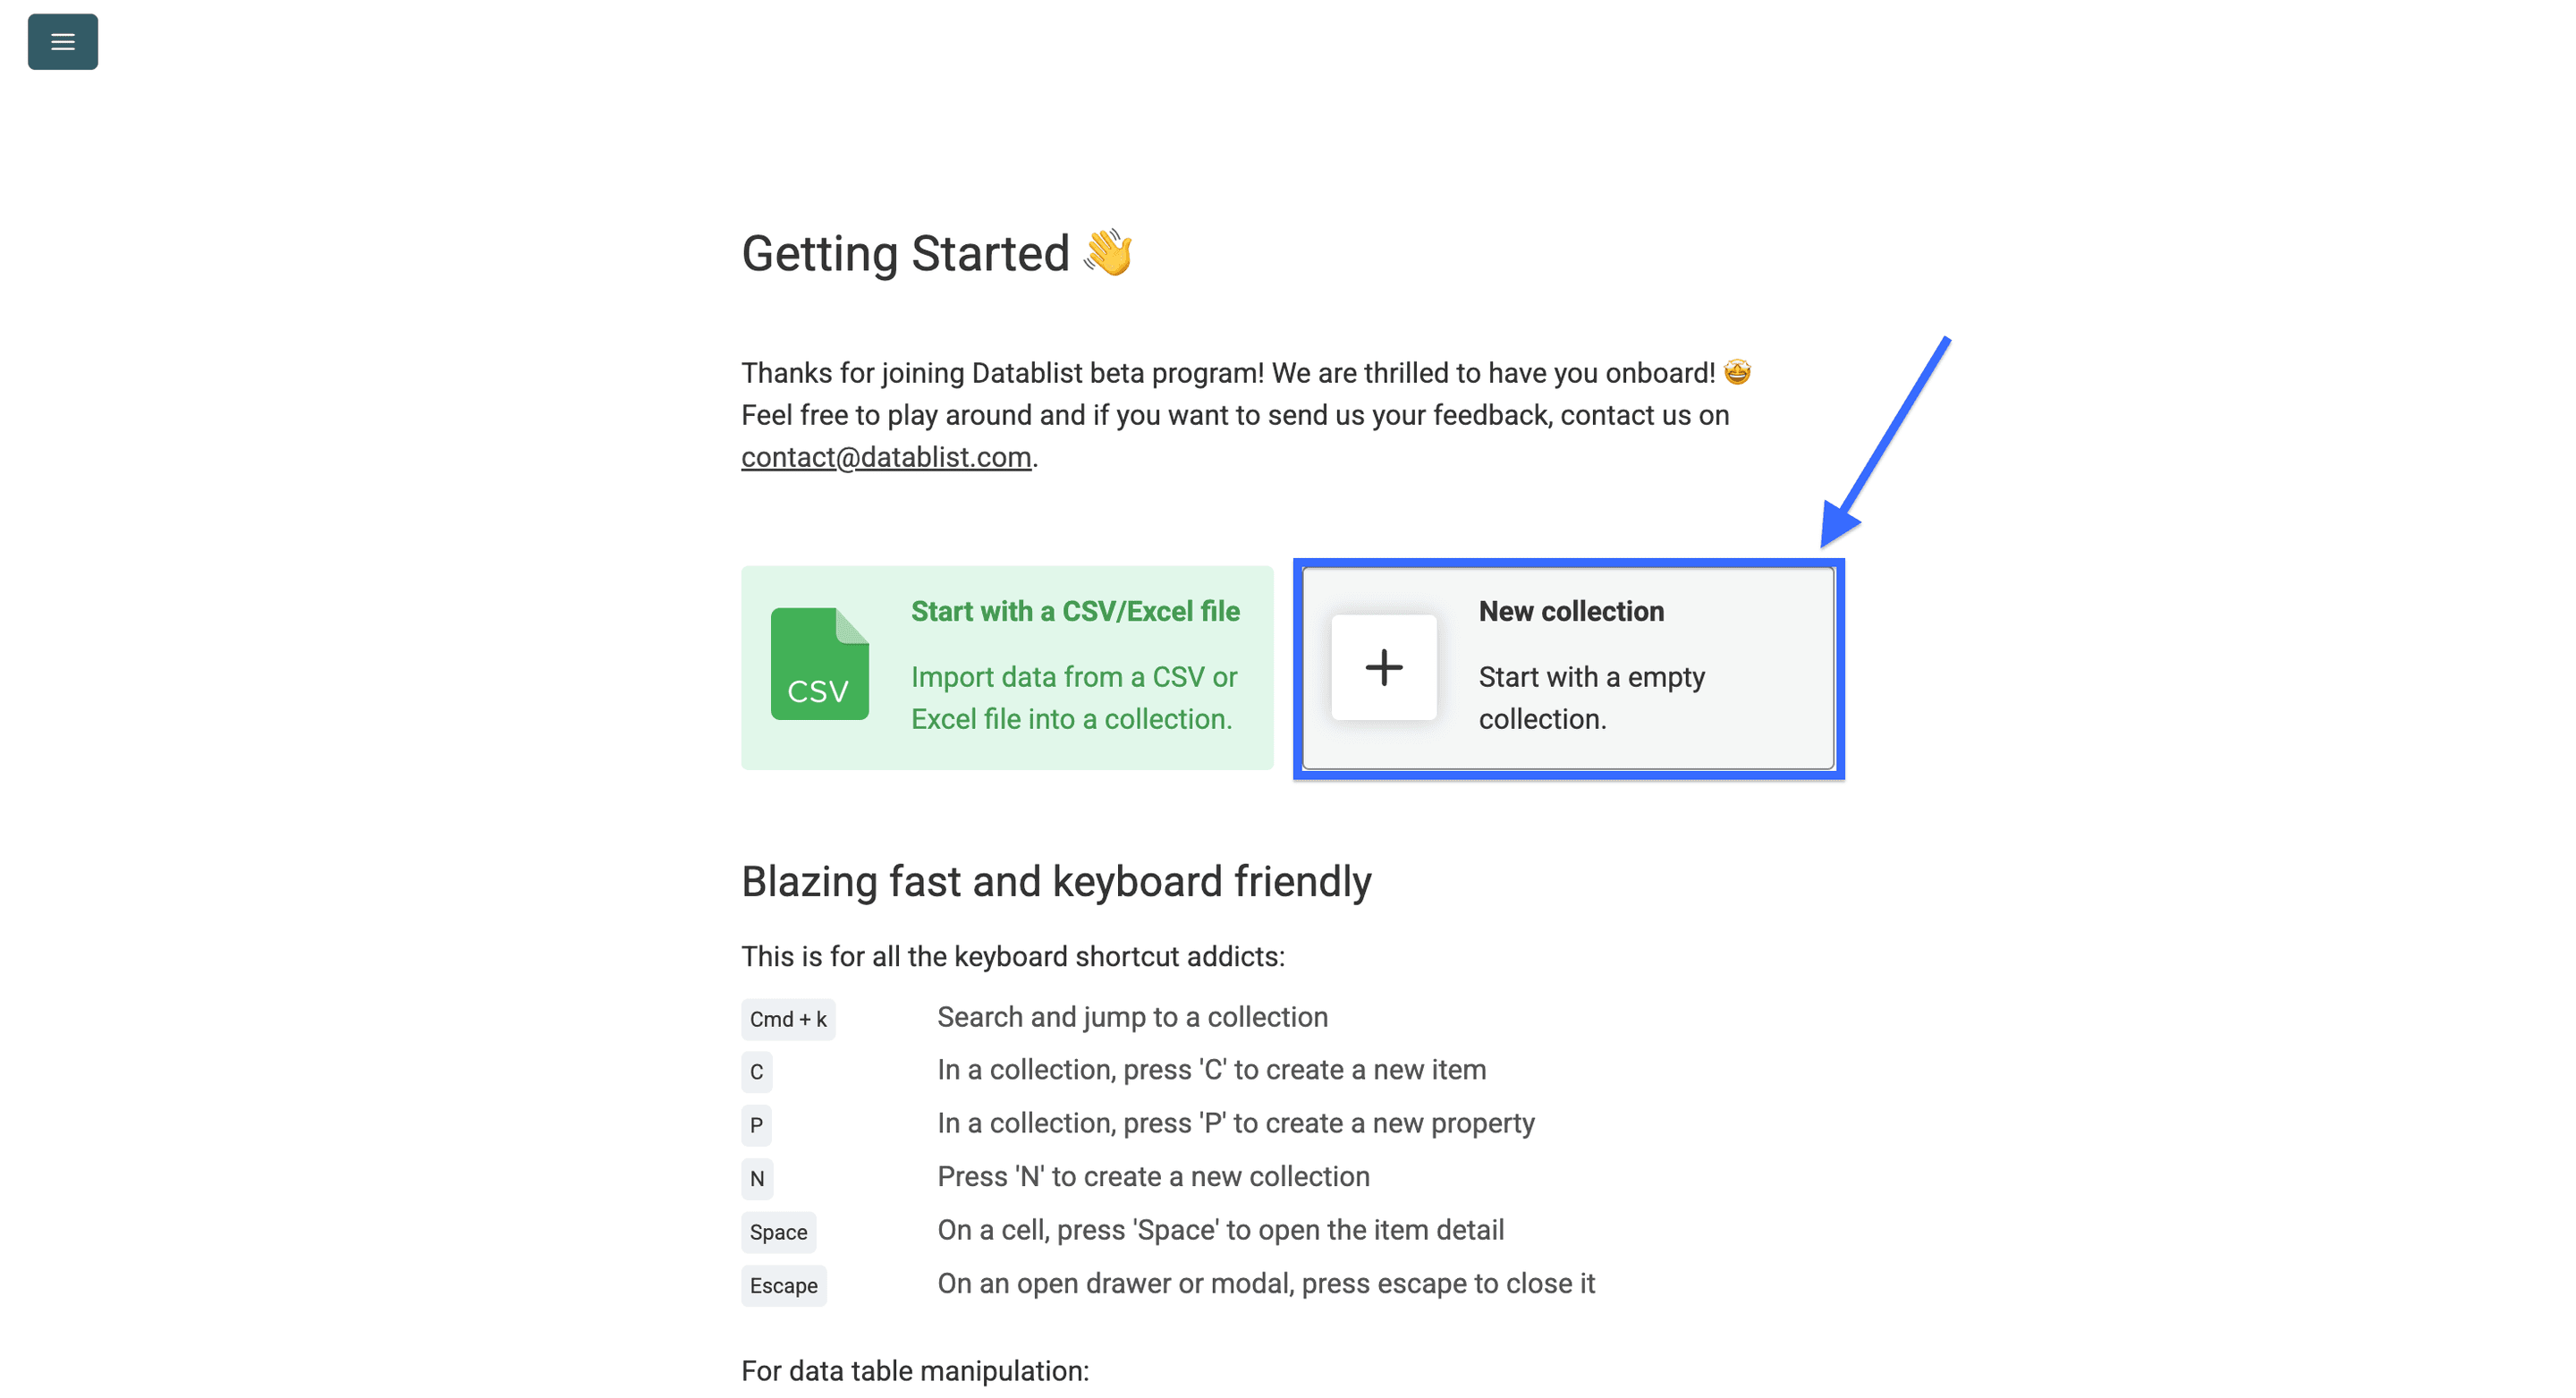
Steg 2: Skapa en ny collection
När du har loggat in klickar du på New Collection.
Steg 3: Öppna Instagram Followers/Following Scraper
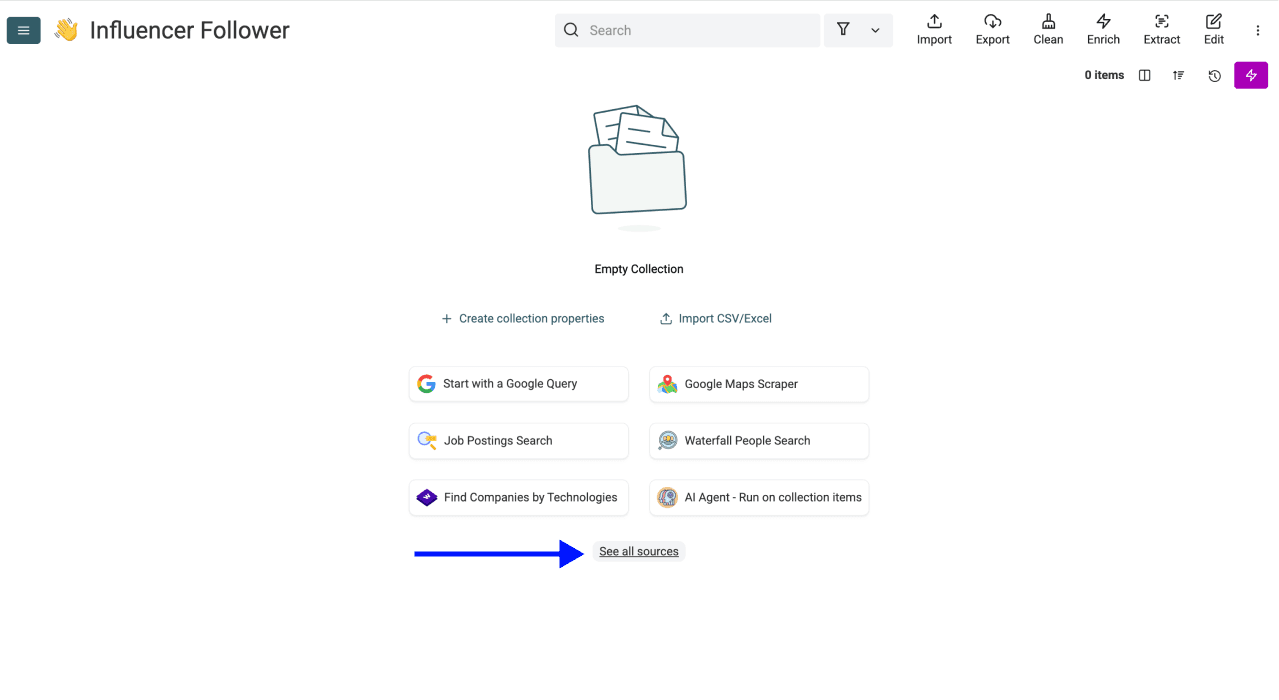
Klicka på See all sources.
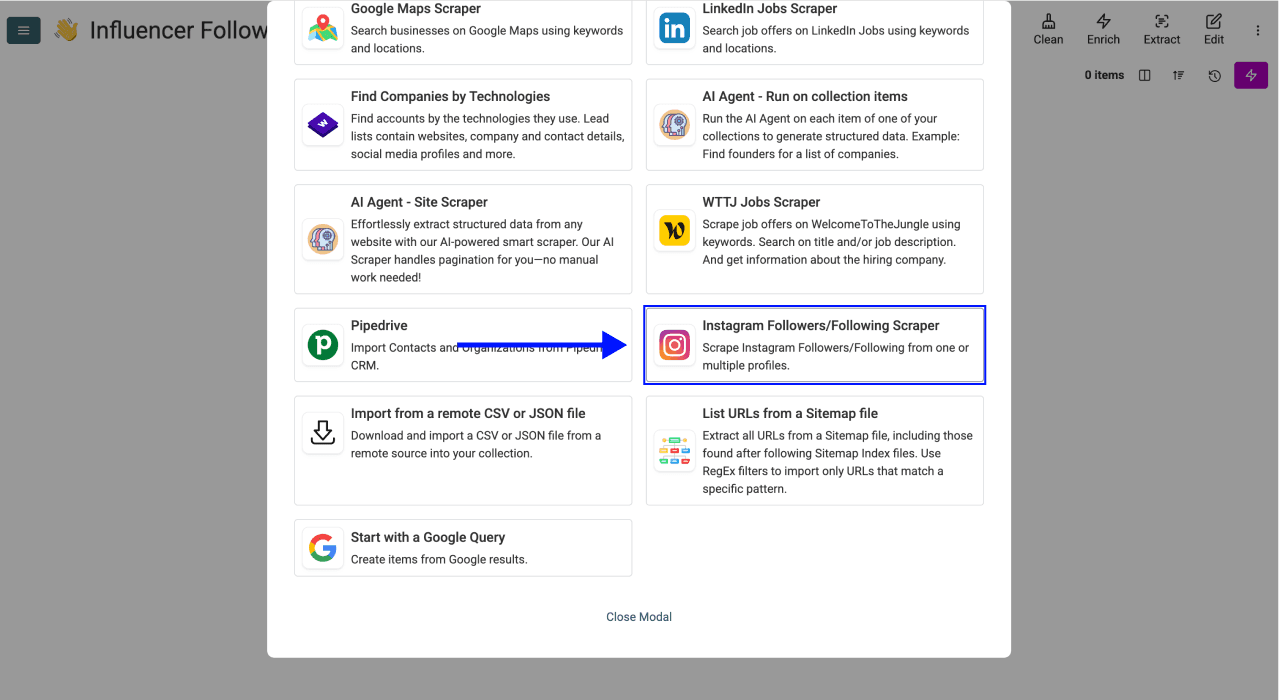
Rulla ned och välj Instagram Followers/Following Scraper i listan.
Steg 4: Konfigurera inställningarna
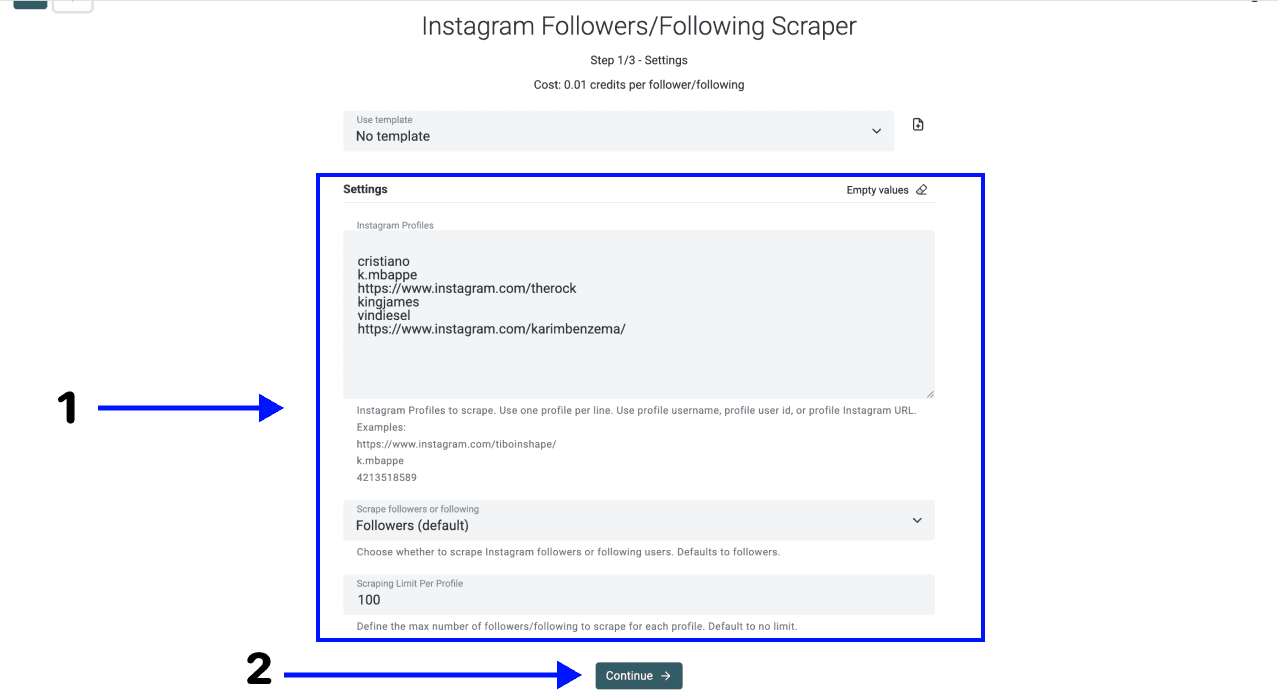
Du möts av en enkel konfigurationssida. Gör så här för att få bästa möjliga resultat:
- Under Instagram Profiles anger du en offentlig profil-URL, ett användarnamn eller ett användar-ID per rad. Kontrollera att varje identifierare leder till rätt konto.
- Under Scrape followers or following väljer du Followers (default). Välj endast Following om du vill hämta de konton som den angivna profilen följer.
- Ställ först in Scraping Limit Per Profile på ett lågt antal för testet och utöka sedan körningen. En gräns garanterar inte att listan blir fullständig.
- Klicka på Continue och konfigurera utdatakolumnerna.
Steg 5: Välj utdatakolumner
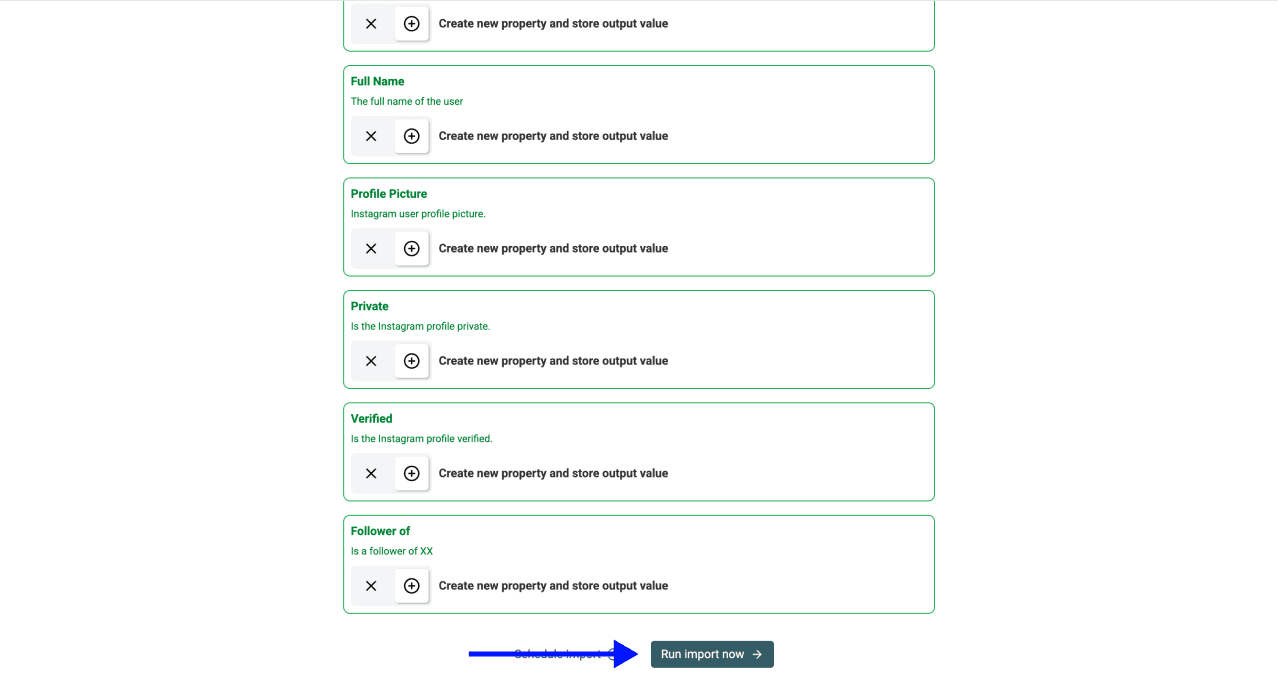
Datablist visar de tillgängliga utdatafälten. Behåll följarens User Id, User Username och User Profile URL samt fälten för källprofilen. Med dem kan du kontrollera vem varje rad avser och vilken inmatad profil som genererade den.
Klicka på ✕ vid de fält du vill ta bort och klicka sedan på Run import now.
Steg 6: Hämta resultaten
När källkörningen är klar jämför du antalet returnerade rader med den begärda gränsen och granskar körningens status. Tiden beror på leverantörens svar, sidindelningen, profilen och körningens storlek. Utgå inte från att ett lågt antal rader innebär att profilen saknar fler följare.
Obs! Resultaten innehåller även fullständiga namn. Vi har dolt dem i bilden nedan för att skydda personernas integritet.
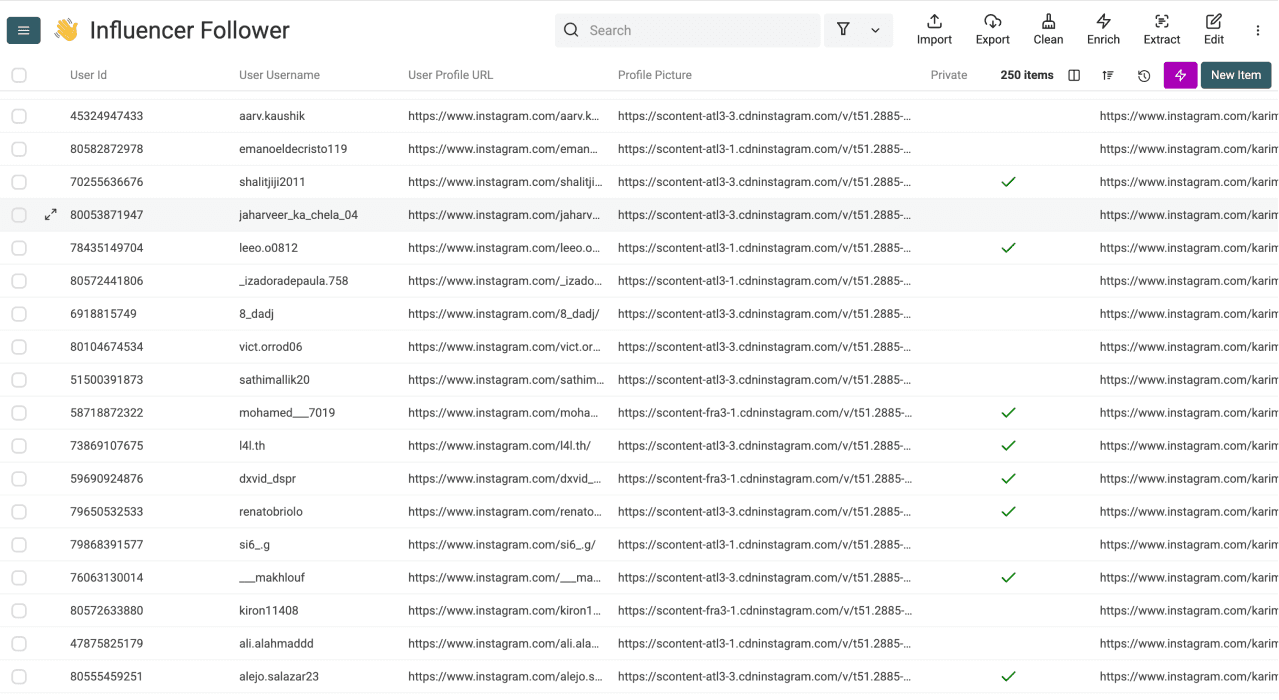
För flera inmatade profiler bör du behålla Follower of (UserId), Follower of (Username) eller Follower of (ProfileUrl). Använd dem för att filtrera relationerna efter källkonto i stället för att förlita dig på kolumnernas placering.
💡 Bra att veta: stora skrapningar
Källkörningen har egna gränser för sidindelning och antal rader. De är separata från lagringsutrymmet i din collection och molnsynkroniseringen. Om körningen stoppas medan fler resultat finns tillgängliga använder du alternativet för att återuppta den nedan. Utgå inte från att alla återstående följare ryms i samma körning.
Steg 7: Enrich följarnas profildata
Att hämta en följarlista är bara början. För att omvandla användarnamnen till användbara Leads behöver du veta vilka personerna är. Med Instagram Profile Scraper kan du enrich din lista med offentliga uppgifter som e-postadresser, biografier och engagemangsstatistik.
När du bygger Lead-listor bör profildata användas som underlag för segmenteringen. En följarrelation är inte i sig ett tillförlitligt kvalificeringskriterium.
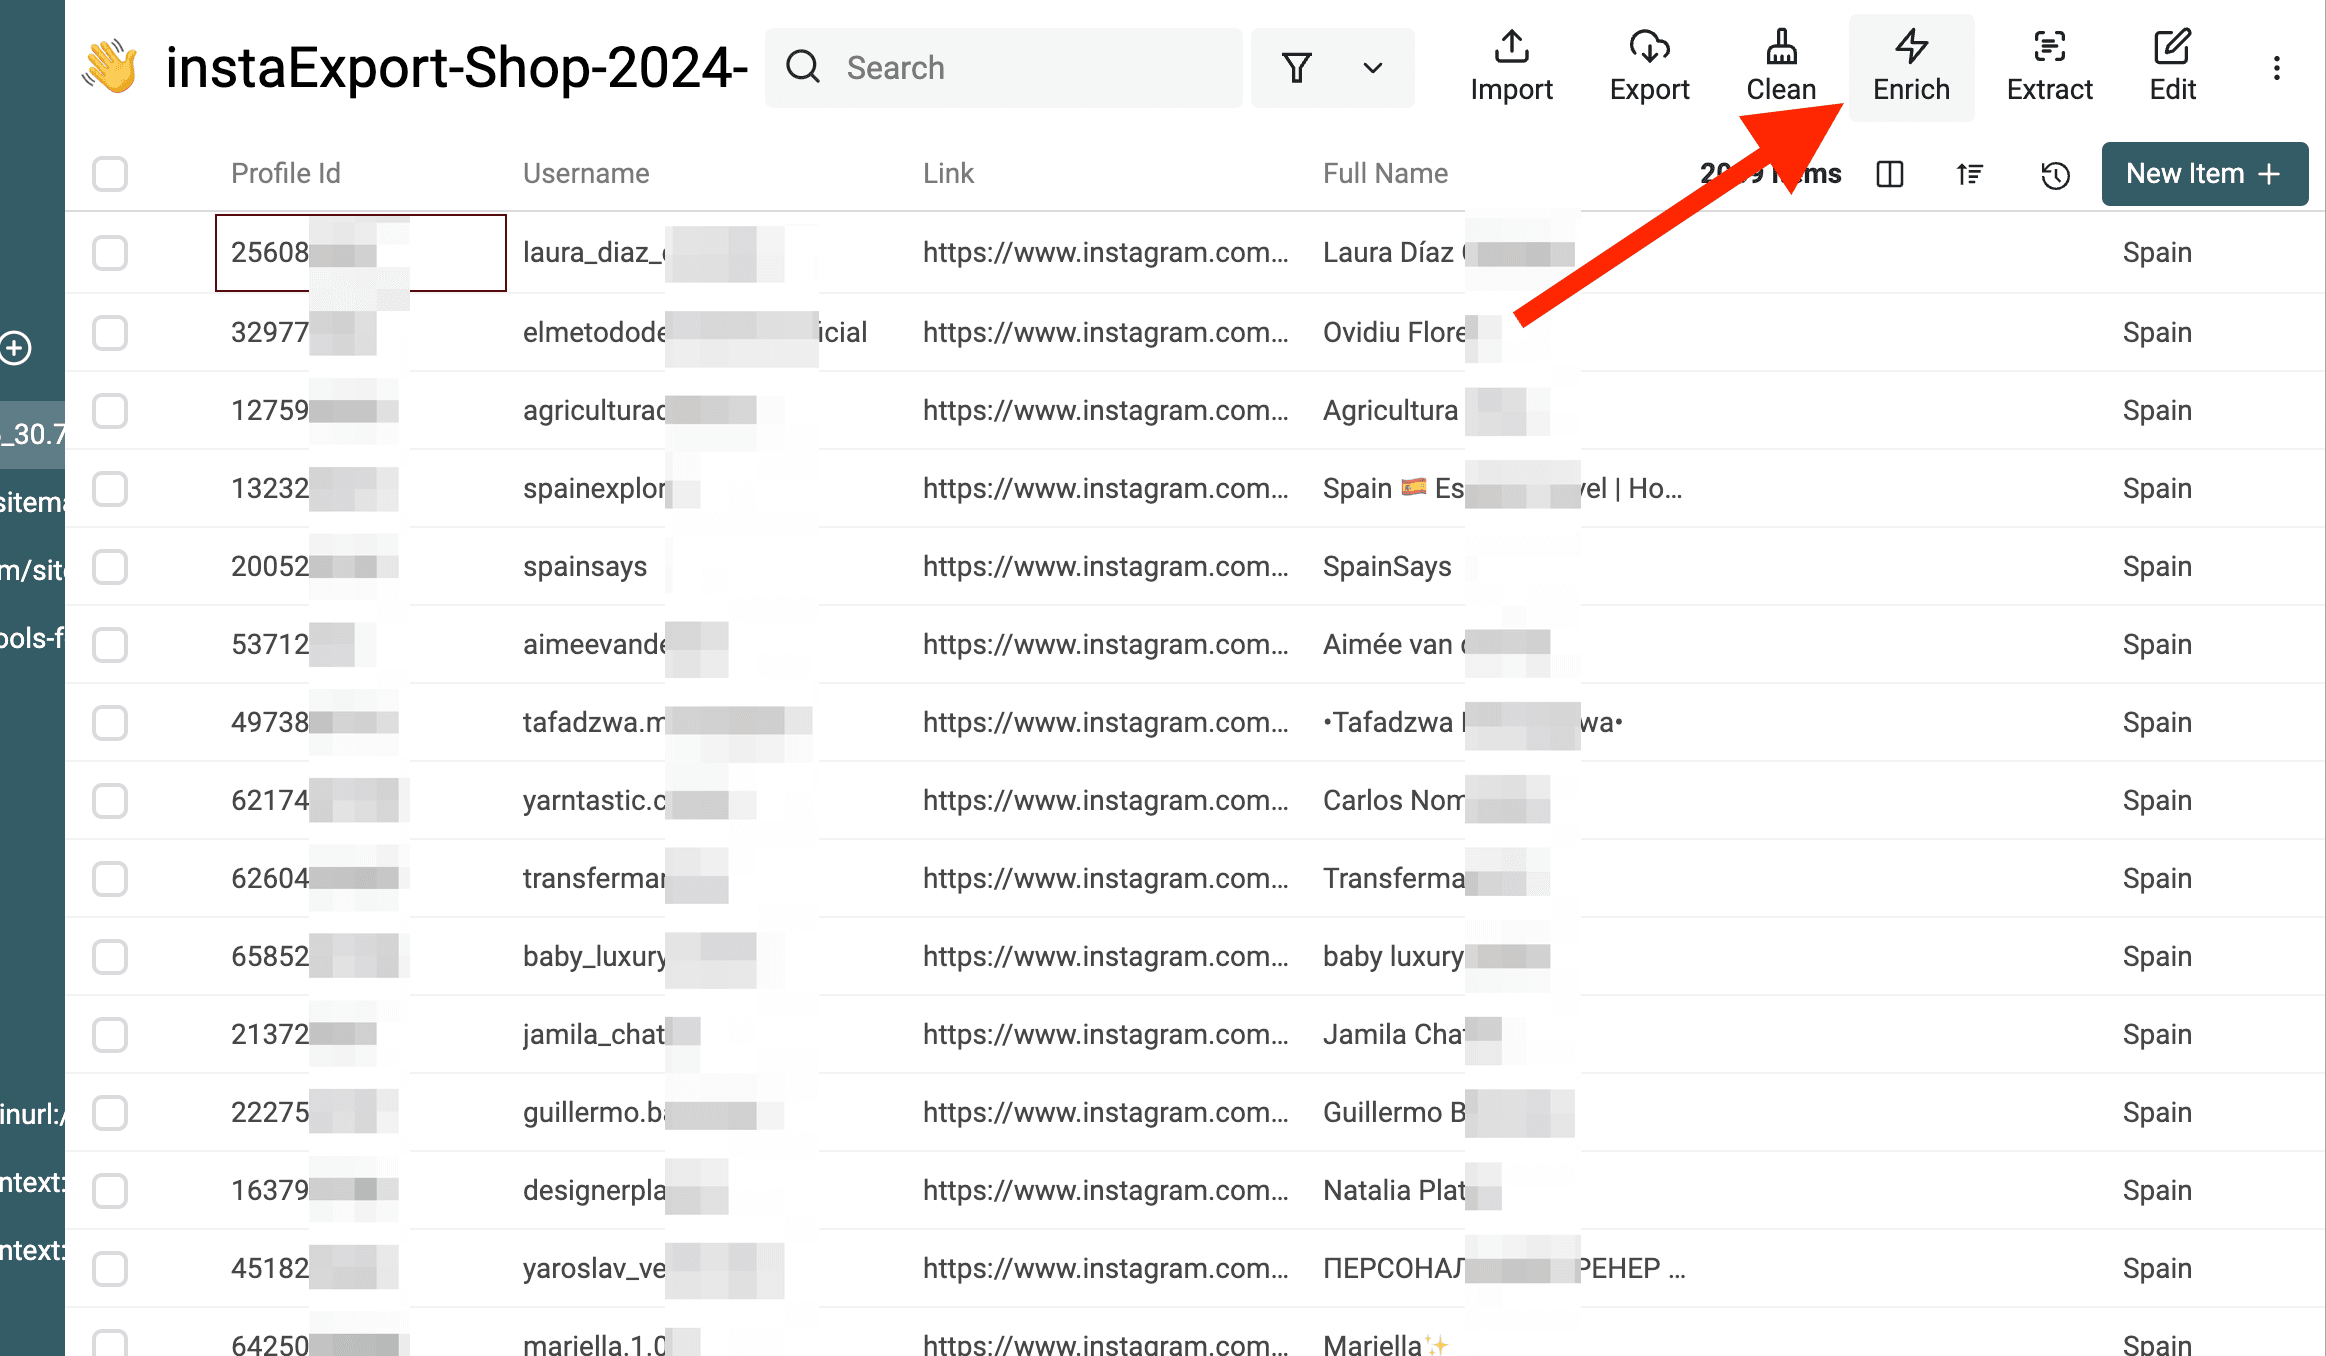
1. Öppna Enrichment-menyn Klicka på Enrich högst upp på dashboarden i den collection som innehåller de skrapade följarna.
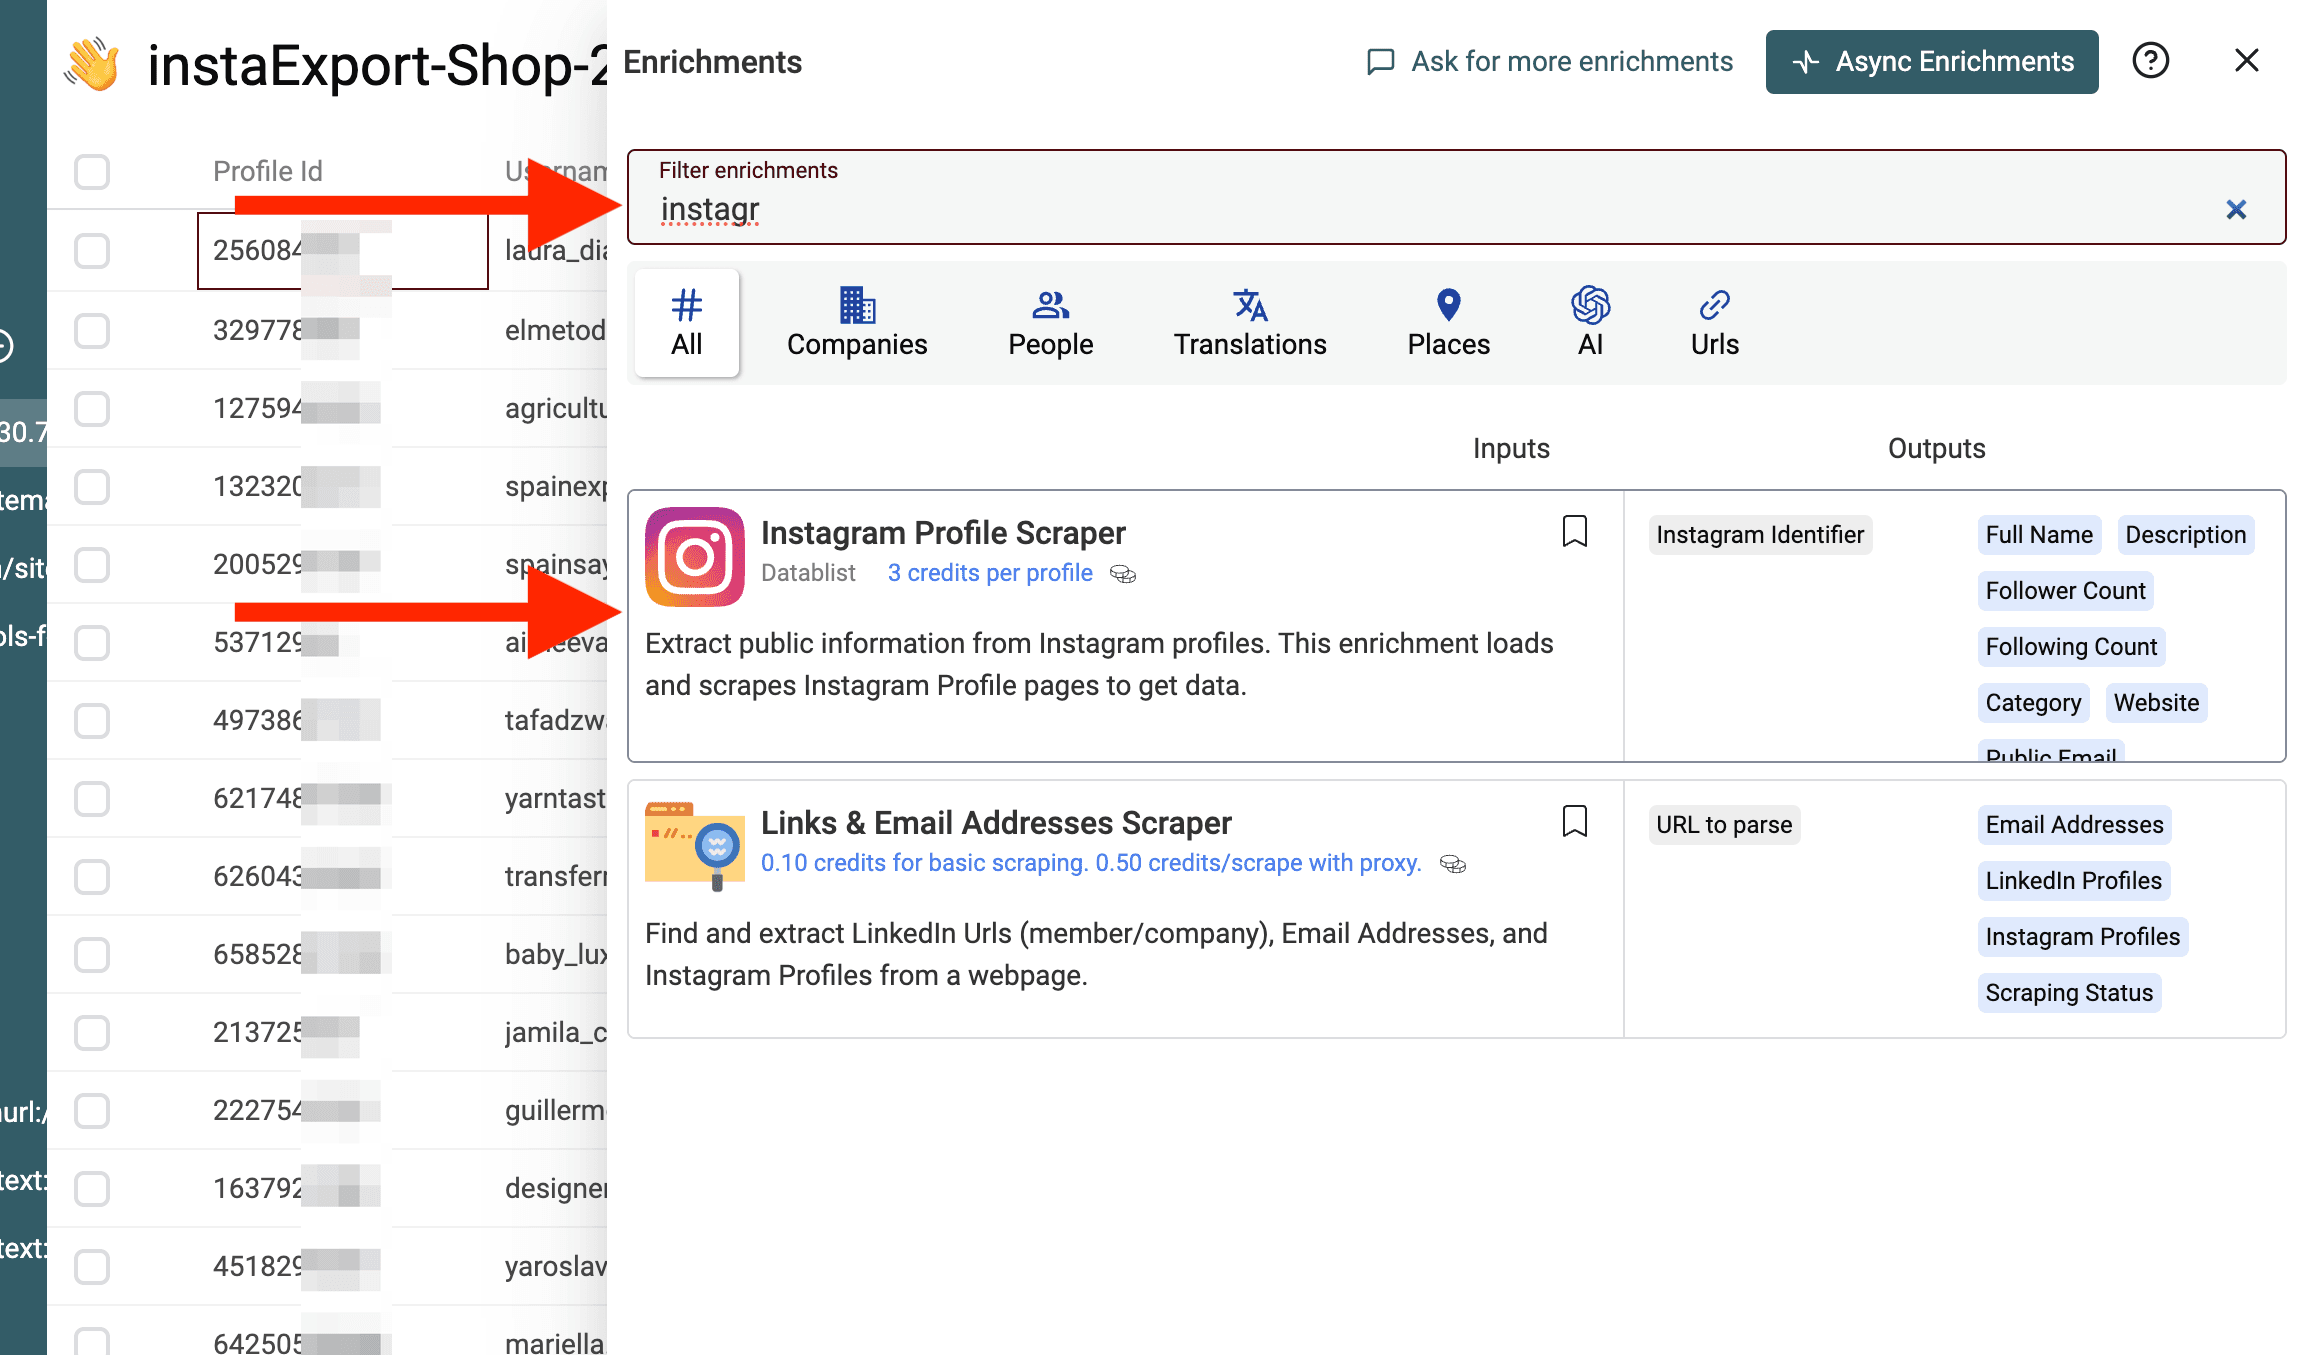
2. Välj Instagram Profile Scraper Sök efter Instagram Profile Scraper och välj den. Denna enrichment använder profilidentifierarna från källresultaten för att hämta ytterligare profilfält. Tillgängligheten beror på vald Scraping Type och vilka uppgifter leverantören kan returnera.
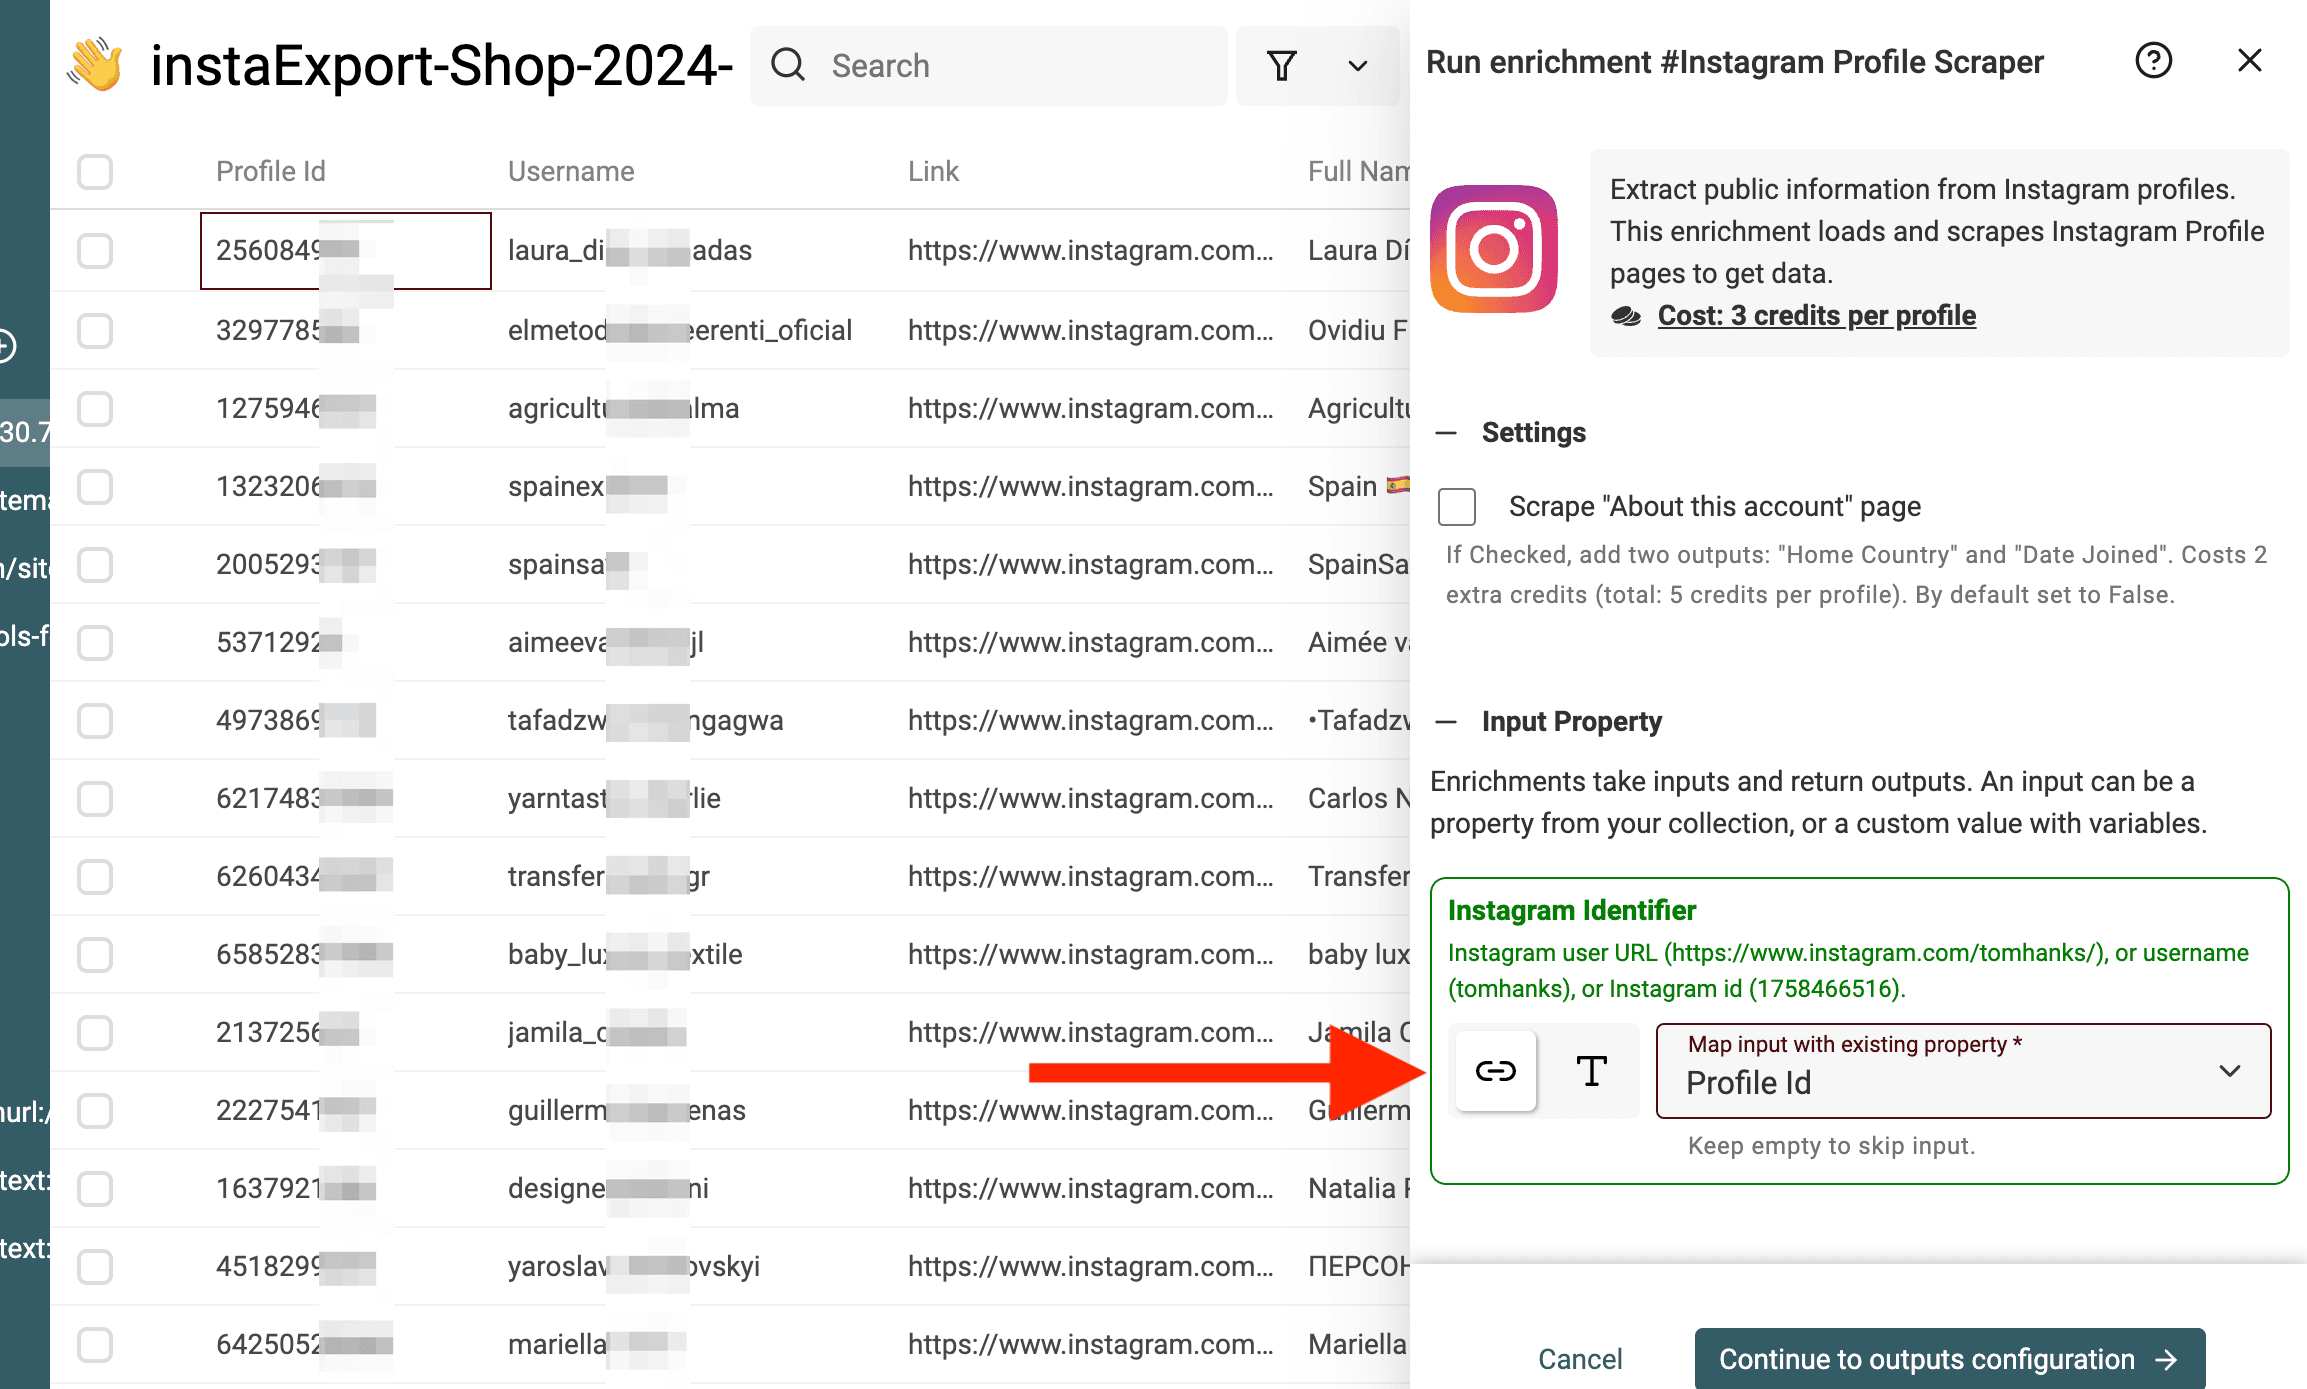
3. Mappa datakolumnerna Ange vilken kolumn som innehåller profilernas handles. Mappa kolumnen Instagram Username eller Profile URL från steg 6 till scraperns inmatningsfält.
4. Välj utdatafält Välj de datapunkter som du vill lägga till i din collection.
Mappa önskade utdatafält till nya kolumner så att följarnas ursprungliga identifierare finns kvar.
Bland utdatafälten hittar du:
- Public Email: Hämta e-postadresser direkt från företagsprofiler.
- Description: Använd fältet för att filtrera dina data efter specifika yrkesroller eller intressen.
- Follower Count: Skilj mellan mikroinfluencers och vanliga användare.
- Website: Hämta länken i profilens bio för vidare företagsresearch.
5. Kör enrichment
Välj den Scraping Type som returnerar fälten du behöver och kör sedan ett test. Alternativet som endast hämtar offentliga profildata inkluderar inte e-postadresser eller telefonnummer. Profilalternativet kan returnera en offentlig e-postadress eller ett telefonnummer om användaren har angett det, men fälten kan fortfarande vara tomma. Kontrollera de tillgängliga inställningarna och den uppskattade credit-förbrukningen innan du bearbetar resten.
Granska Enrichment Status och eventuella tomma fält när enrichment-processen är klar. En offentlig e-postadress som saknas ska lämnas tom. Det bevisar inte att personen saknar e-postadress. Du kan därefter använda Data Extractor om en e-postadress finns dold i biotexten i stället för i det officiella e-postfältet.
Granska överlappningar och återuppta en större skrapning
Håll isär två olika typer av dataset:
- Följarrelationer: en rad per kombination av följare och källprofil. En person som följer två inmatade konton kan med rätta förekomma två gånger.
- Unika profiler: en rad per User Id när du vill enrich varje person en enda gång. Spara informationen om källtillhörighet separat innan du tar bort dubbletter.
I ett förenklat exempel motsvarar User Id 101, som följer både konto A och konto B, två relationer men en profil. Om du deduplicerar enbart efter User Id förlorar du en av källrelationerna, såvida du inte först sammanställer den informationen.
Jag rekommenderar att granska saknade ID:n, upprepade kombinationer av källa och följare samt oväntat små resultat före enrichment. Välj ett representativt urval av profiler och kontrollera Description, Website och eventuella returnerade e-postfält. Klassificera inte automatiskt alla följare till ett fitnesskonto som yrkesverksamma inom fitness.
Om en tidigare körning har en sparad fortsättning öppnar du källinställningarna och använder Continue a previous scrape. Tillgängliga poster är knutna till den aktuella arbetsytan och sparas i sju dagar. Den valda posten återanvänder sin källprofil och Scraping Type, så du behöver inte ersätta dem med en ny profil.
När källan når gränsen för en collection återupptar du körningen i en annan collection på samma arbetsyta enligt anvisningarna i inställningen. Om fortsättningen inte längre är tillgänglig bör du kontrollera källkörningen innan du börjar om. En omstartad skrapning kan överlappa med en tidigare ögonblicksbild. Jämför därför identifierarna och behåll informationen om källa och collection.
Spara ett Checked At-datum för varje batch och exportera de granskade resultaten som CSV eller Excel. Ett förändrat antal följare är ingen checklista som bevisar att utdraget är fullständigt – följare kan tillkomma eller försvinna mellan sidor och körningar.
Sammanfattning
Börja med en offentlig profil och en låg gräns, behåll identifierarna för både följaren och källan och granska de returnerade relationerna innan du enrich eller exporterar dem. Använd en sparad fortsättning när en sådan finns tillgänglig för en större källkörning.
Öppna Datablist och testa samma arbetsflöde med en profil som är relevant för ditt projekt.
Vanliga frågor om att skrapa Instagram-följare
Är det lagligt att skrapa Instagram-följare?
Att uppgifter är offentligt synliga innebär inte automatiskt att du har tillåtelse att samla in eller återanvända dem med automatiserade metoder. Läs Instagrams aktuella villkor och kontrollera vilka krav som gäller för ditt användningsområde innan du samlar in följardata.
Kan jag skrapa följare från flera influencers samtidigt?
Ja. Ange en identifierare per rad under Instagram Profiles. Källan bearbetar de angivna kontona och inkluderar relationsfält för källprofilerna i de returnerade raderna. Körtid och slutförande kan variera mellan kontona.
Kan jag skrapa följare från privata Instagram-profiler?
Nej. Det här arbetsflödet kan inte hämta följarlistan från en privat profil. En sökning efter profildata är en separat enrichment och kan inte användas för att låsa upp begränsade följardata.
Hur snabbt kan jag skrapa Instagram-följare?
Det finns ingen fast slutförandetid som gäller för alla profiler. Kör ett litet test och kontrollera den faktiska tidsåtgången, antalet returnerade rader och credit-förbrukningen innan du utökar körningen.
Vad händer om jag skrapar fler än 100 000 följare?
Se källkörningens gräns och lagringsutrymmet i din collection som två separata begränsningar. En källa kan stoppas innan profilens fullständiga lista har hämtats. Använd en tillgänglig fortsättning i en annan collection när inställningen anger det och exportera varje färdig batch. Utgå inte från att importkapaciteten i din collection motsvarar källans kapacitet för datahämtning.
Vilka data får jag när jag skrapar Instagram-följare?
Du kan välja mellan flera profilfält för varje följare, bland annat:
- User Id: Instagrams interna användaridentifierare
- User Username: Följarens Instagram-handle
- User Profile URL: Direktlänk till personens Instagram-profil
- Full Name: Visningsnamnet på profilen
- Profile Picture: URL till profilbilden
- Private: Om kontot är privat eller offentligt
- Verified: Om kontot har Instagrams blå verifieringsmärke
- Follower of (UserId), Follower of (Username) och Follower of (ProfileUrl): Källkontots identifierare som används för att kontrollera relationen
Hur många Instagram-följare kan jag skrapa samtidigt?
Ställ in Scraping Limit Per Profile för källkörningen och kontrollera förloppet samt inställningarna för att fortsätta. Det faktiska resultatet beror på tillgängliga följarsidor, leverantörens svar, körningsgränser och tillgängliga credits. Importkapaciteten är ingen garanti för att en följarkälla kan returnera samma antal under en enda körning.
Behöver jag ett webbläsartillägg för att skrapa Instagram-följare?
Nej. Datablist körs helt som en webbapp. Inga tillägg, nedladdningar eller installationer behövs.
Vilket är det billigaste sättet att skrapa Instagram-följare?
Ange en låg gräns, granska den uppskattade credit-förbrukningen och kontrollera de returnerade raderna innan du kör enrichment av profildata. Jämför kostnaden per användbar och granskad profil i stället för att anta att varje returnerad följare är en kvalificerad kontakt.
Hur skrapar jag Instagram-följare utan att bli blockerad?
Datablist ber inte om dina inloggningsuppgifter eller sessionscookies från Instagram i det här arbetsflödet. Det innebär dock inte att metoden är riskfri eller att du automatiskt har tillåtelse att samla in uppgifterna. Använd tillgängliga källdata, granska plattformens krav och avbryt när den begärda listan inte är tillgänglig.
Vad är skillnaden mellan Followers och Following?
Followers är personer som följer en profil. Following är listan över konton som profilen själv följer. Den här guiden handlar specifikt om att skrapa Followers, men Datablist erbjuder båda alternativen.
Kan jag skrapa Instagram-följare från ett företagskonto?
Ja, så länge företagskontot är offentligt. Scrapern fungerar på samma sätt för personliga konton, Creator-konton och företagskonton.
Hur laddar jag ned en lista med Instagram-följare?
Skapa ett konto på Datablist, skapa en collection, välj Instagram Followers/Following Scraper, klistra in profilen och starta körningen. När den är klar exporterar du resultaten som CSV eller Excel.
Vilka verktyg kan skrapa Instagram-följare?
Det finns flera alternativ, bland annat webbläsartillägg, Python-skript och plattformar som Datablist. Jämför vilken kontoåtkomst som krävs, vilka fält som returneras, stöd för att fortsätta en körning, testets tidsåtgång och kostnaden per användbart resultat. Datablist kräver inte dina Instagram-inloggningsuppgifter för det här arbetsflödet.