
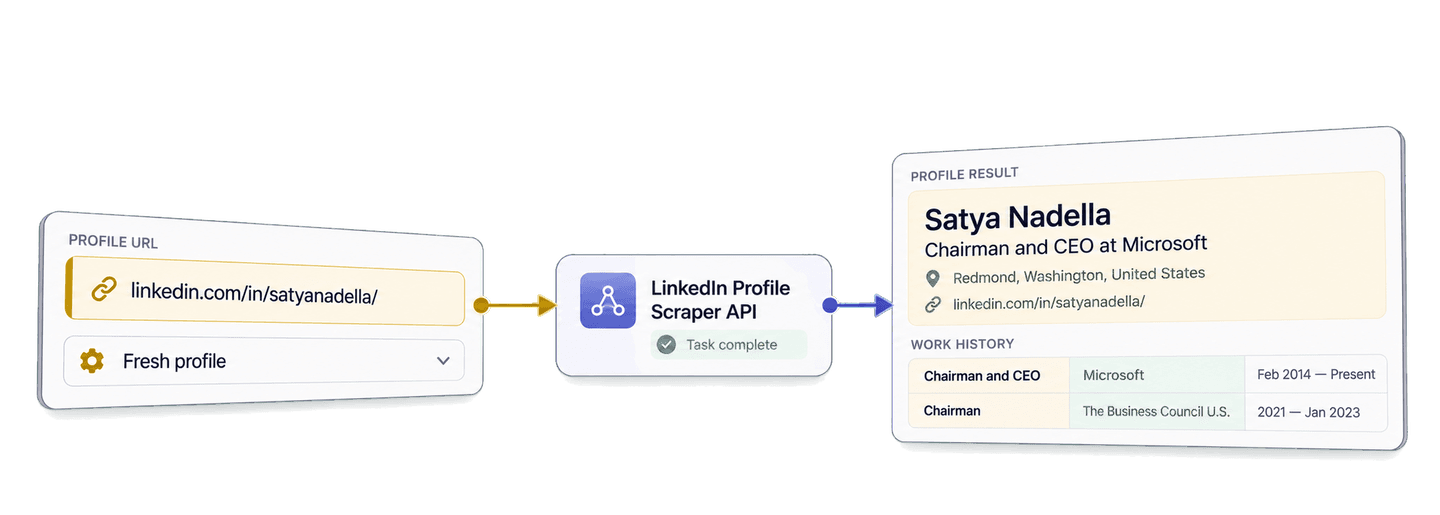
Du kannst LinkedIn-Profile mit Python scrapen, indem du bekannte öffentliche Profil-URLs über die Requests-Bibliothek an die LinkedIn Profile Scraper API von Datablist sendest. Die API liefert strukturierte Angaben zu Identität, Standort, beruflichem Werdegang, Ausbildung und Unternehmen. Damit kannst du Lead-Listen erstellen und deine Ansprache mit relevantem Kontext zur Position und zum Unternehmen personalisieren.
In diesem Guide verwenden wir die öffentliche Profil-URL von Satya Nadella als kompaktes Beispiel. Du führst einen vollständigen Scraping-Task aus, wertest seine Position bei Microsoft sowie die datierten beruflichen Stationen aus und verknüpfst das Ergebnis anschließend mit deinem ursprünglichen Lead, bevor du deinen Outreach vorbereitest.
🔑 Kurzfassung für Eilige: Sende bekannte URLs von persönlichen LinkedIn-Profilen an Datablist und erhalte verfügbare Profil-, Standort-, Berufs-, Ausbildungs- und Unternehmensdaten als strukturiertes JSON. Das Python-Beispiel unten verknüpft diese Angaben mit dem jeweiligen ursprünglichen Lead. So kannst du deine Liste qualifizieren und relevanteren Outreach vorbereiten.
- Input: Bekannte URLs von persönlichen LinkedIn-Profilen.
- Output: Strukturierte Profildaten, die beim jeweiligen Ausgangskontakt gespeichert werden.
💡 Du bevorzugst eine No-Code-Lösung? Mit dem LinkedIn Profile Scraper von Datablist kannst du Daten aus bekannten Profil-URLs extrahieren, ohne Code zu schreiben.
Datablist API und Python-Umgebung einrichten
Der Zugriff auf die Datablist REST API ist im Growth-Plan enthalten. Das Abrufen von Profilen verbraucht zusätzlich Enrichment Credits. Eine genaue Kostenübersicht findest du weiter unten.
Erstelle auf deiner Datablist API-Kontoseite einen Personal API Key. So sieht das Format eines Personal API Key aus:
auth0|exampleuser:exampleaccount:EXAMPLE_TOKEN_NOT_VALID:1Das Skript liest deinen Key aus der Umgebungsvariable DATABLIST_API_KEY und sendet ihn im Header X-API-Key.
Für dieses Python-Beispiel verwende ich das Paket requests. Die folgenden Befehle sind für eine macOS- oder Linux-Shell gedacht. Erstelle einen Projektordner, öffne ihn im Terminal und führe diese Befehle aus:
python -m venv .venv
source .venv/bin/activate
python -m pip install requestsErstelle anschließend eine Datei namens scrape_linkedin_profiles.py und exportiere deinen Key:
export DATABLIST_API_KEY="your-personal-api-key"LinkedIn-Profile vollständig mit Python scrapen
Der Quelldatensatz in diesem Beispiel enthält eine stabile Kontakt-ID und eine bekannte Profil-URL:
{
  "contact_id": "contact-satya-nadella",
  "profile_url": "https://www.linkedin.com/in/satyanadella/"
}
Das Skript sendet contact_id als inputId an die API. Die Ergebnisse müssen nicht in derselben Reihenfolge wie die Inputs zurückgegeben werden. Mit dieser ID kannst du deshalb jedes Ergebnis zuverlässig dem ursprünglichen Kontakt zuordnen.
Füge das folgende vollständige Skript in scrape_linkedin_profiles.py ein:
import json
import os
import time
import uuid
import requests
def scrape_profiles(source_contacts, api_key):
"""Submit one task, wait for completion, and return every result page."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": contact["contact_id"],
"data": {"profileUrl": contact["profile_url"]},
}
for contact in source_contacts
]
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "linkedin-profile-scraper",
"uniqueId": unique_id,
"settings": {
"experiencesNb": "5",
"educationsNb": "3",
"acceptCachedProfiles": False,
"includeUrn": False,
"includePictures": False,
},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
print(f"Task ID: {task_id}")
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
source_contacts = [
{
"contact_id": "contact-satya-nadella",
"profile_url": "https://www.linkedin.com/in/satyanadella/",
}
]
profile_results = scrape_profiles(source_contacts, api_key)
print(json.dumps(profile_results, indent=2))Führe das Skript so aus:
python scrape_linkedin_profiles.pyDie Einstellungen fordern fünf berufliche Stationen und drei Ausbildungseinträge an. Die API erwartet diese Zahlen als Strings. Mit acceptCachedProfiles: false forderst du einen aktuellen Abruf an. Die Optionen für Bilder und interne IDs bleiben deaktiviert, da dieser Workflow auf beständigen Text- und URL-Feldern basiert.
Verwende für jeden Input eine standardmäßige öffentliche /in/-Profil-URL oder eine Sales-Navigator-Lead-URL. Der Name einer Person, eine LinkedIn-Suchergebnisseite und eine Unternehmensseite stehen für andere Aufgaben und sind für diesen Scraper keine gültigen Profil-Inputs. Enthält deine Quelle Sales-Navigator-Links, kann die zurückgegebene profileUrl die normalisierte öffentliche Profil-URL sein. Bei größeren Listen sollte jede inputId eindeutig und stabil sein. Leite sie nicht von der Position der Zeile ab.
Die Anzahl der Einträge legt fest, wie viele flache, nummerierte Felder für Berufserfahrung und Ausbildung die API zurückgeben kann. Sie verändert nicht die Credit-Kosten pro Profil. Fordere genug Historie für deine Recherche an, aber wähle nicht zehn berufliche Stationen aus, wenn du ohnehin nur die letzten Positionen prüfen möchtest.
Was die drei API-Aufrufe bewirken
Der POST-Request sendet die ausgewählten Einstellungen und Profil-Inputs. Datablist nimmt den Auftrag als Background-Task an und gibt dessen @id zurück. Das Skript zeigt sowohl die generierte uniqueId als auch die zurückgegebene Task-ID an. Damit hast du alle Werte, um den Task später zu prüfen.
Der erste GET-Aufruf prüft den Task-Status alle drei Sekunden. Der Python-Client wartet währenddessen, der API-Task läuft jedoch im Hintergrund weiter. Die Schleife endet bei completed, failed oder stopped.
Der zweite GET-Aufruf ruft die Ergebnisse in Seiten mit jeweils bis zu 100 Datensätzen ab. Enthält nextCursor einen Wert, lädt das Skript die nächste Seite. Sobald nextCursor den Wert null hat, endet der Abruf.
Profilergebnis lesen und Abrufeinstellungen wählen
Die übermittelte URL bestimmt, welches Profil der Scraper abruft. Datablist akzeptiert öffentliche URLs persönlicher Profile und Sales-Navigator-Lead-URLs, normalisiert die Profil-URL bei Bedarf und überträgt die verfügbaren öffentlichen Daten in flache Profil-, Berufs-, Ausbildungs- und Unternehmensfelder.
Der in diesem Guide verwendete aktuelle Abruf wurde erfolgreich abgeschlossen und hat 25 Credits verbraucht. Hier ist das vollständige Ergebnis:
{
  "inputId": "contact-satya-nadella",
  "status": "success",
  "outputs": {
    "profileUrl": "https://www.linkedin.com/in/satyanadella/",
    "fullName": "Satya Nadella",
    "firstName": "Satya",
    "lastName": "Nadella",
    "linkedInHeadline": "Chairman and CEO at Microsoft",
    "linkedInSummary": "As chairman and CEO of Microsoft, I define my mission and that of my company as empowering every person and every organization on the planet to achieve more.",
    "linkedInProfilePicture": "https://media.licdn.com/dms/image/v2/C5603AQHHUuOSlRVA1w/profile-displayphoto-shrink_800_800/profile-displayphoto-shrink_800_800/0/1579726625483?e=1794441600&v=beta&t=I1sL---bTuvjxqb1vdbNsNy-fAsLCpBj3-WtJjOGbOc",
    "linkedInInternalIdentifier": "ACoAAAEkwwAB9KEc2TrQgOLEQ-vzRyZeCDyc6DQ",
    "linkedInLocation": "Redmond, Washington, United States",
    "linkedInCity": "Redmond",
    "linkedInState": "Washington",
    "linkedInCountryName": "United States",
    "linkedInCountryCode": "US",
    "linkedInLanguages": "",
    "linkedInConnections": 832,
    "linkedInlastExpTitle": "Chairman and CEO",
    "linkedInlastExpCompany": "Microsoft",
    "linkedInlastExpEmploymentType": null,
    "linkedInlastExpLocation": "Greater Seattle Area",
    "linkedInlastExpStartsAt": "2014-02-01",
    "linkedInlastExpEndsAt": null,
    "linkedInlastExpDescription": null,
    "linkedInlastExpCompanyWebsite": "https://news.microsoft.com/",
    "linkedInlastExpCompanyPage": "https://www.linkedin.com/company/microsoft/",
    "linkedInlastExpCompanyIndustry": "Software Development",
    "linkedInlastExpCompanyRange": "10001+",
    "linkedInlastExpCompanyDescription": "Every company has a mission. What's ours? To empower every person and every organization to achieve more. We believe technology can and should be a force for good and that meaningful innovation contributes to a brighter world in the future and today. Our culture doesn’t just encourage curiosity; it embraces it. Each day we make progress together by showing up as our authentic selves. We show up with a learn-it-all mentality. We show up cheering on others, knowing their success doesn't diminish our own. We show up every day open to learning our own biases, changing our behavior, and inviting in differences. Because impact matters. \n\nMicrosoft operates in 190 countries and is made up of approximately 228,000 passionate employees worldwide.",
    "linkedInlastExpCompanyLogo": "https://media.licdn.com/dms/image/v2/D560BAQH32RJQCl3dDQ/company-logo_200_200/B56ZYQ0mrGGoAM-/0/1744038948046/microsoft_logo?e=1793836800&v=beta&t=4wXD40LQU4IfLY4DiEvT2bwvjUoPQPGgi5_T-vPsbQ8",
    "linkedIn2ExpTitle": "Chairman",
    "linkedIn2ExpCompanyName": "The Business Council U.S.",
    "linkedIn2ExpEmploymentType": null,
    "linkedIn2ExpStartsAt": "2021-01-01",
    "linkedIn2ExpEndsAt": "2023-01-01",
    "linkedIn2ExpDescription": null,
    "linkedIn2ExpLogo": "https://media.licdn.com/dms/image/v2/C4D0BAQGcnaZNpjMvrw/company-logo_200_200/company-logo_200_200/0/1630557702704/the_business_council_us_logo?e=1793836800&v=beta&t=Ejb0D8lV5sMTFwcz_-FKdfQvIvq-mKx_Nl8vRMib53k",
    "linkedIn3ExpTitle": "Member Board Of Trustees",
    "linkedIn3ExpCompanyName": "University of Chicago",
    "linkedIn3ExpEmploymentType": null,
    "linkedIn3ExpStartsAt": "2018-01-01",
    "linkedIn3ExpEndsAt": null,
    "linkedIn3ExpDescription": null,
    "linkedIn3ExpLogo": "https://media.licdn.com/dms/image/v2/D4E0BAQGDP-PXY3u8dw/company-logo_200_200/B4EaENqZTQGoAM-/0/1791230580227/uchicago_logo?e=1793836800&v=beta&t=NJGoETr0tY868Z2pvlyXeh939iXwW0WbSFwRctabEVU",
    "linkedIn4ExpTitle": "Board Member",
    "linkedIn4ExpCompanyName": "Starbucks",
    "linkedIn4ExpEmploymentType": null,
    "linkedIn4ExpStartsAt": "2017-01-01",
    "linkedIn4ExpEndsAt": "2024-01-01",
    "linkedIn4ExpDescription": null,
    "linkedIn4ExpLogo": "https://media.licdn.com/dms/image/v2/C4D0BAQEQxk9y2rk7Hw/company-logo_200_200/company-logo_200_200/0/1631316692275?e=1793836800&v=beta&t=NVjljhe0oI5KzvJHodAJjss5EdvxaOIzQQ2rAGyh_AQ",
    "linkedIn5ExpTitle": "Board Member",
    "linkedIn5ExpCompanyName": "Fred Hutch",
    "linkedIn5ExpEmploymentType": null,
    "linkedIn5ExpStartsAt": "2016-01-01",
    "linkedIn5ExpEndsAt": "2022-01-01",
    "linkedIn5ExpDescription": null,
    "linkedIn5ExpLogo": "https://media.licdn.com/dms/image/v2/D4D0BAQGF4eOou62nvQ/company-logo_200_200/company-logo_200_200/0/1664795263764/fredhutch_logo?e=1793836800&v=beta&t=dJWSO-KkuBPd6I6aRYBoIcQVzcSEmGLwqYy-VMFXJQc",
    "linkedInlastEduSchool": "The University of Chicago Booth School of Business",
    "linkedInlastEduDegree": null,
    "linkedInlastEduField": null,
    "linkedInlastEduStartsAt": "1994-01-01",
    "linkedInlastEduEndsAt": "1996-01-01",
    "linkedInlastEduPage": "https://www.linkedin.com/school/universityofchicagoboothschoolofbusiness/",
    "linkedInlastEduLogo": "https://media.licdn.com/dms/image/v2/D560BAQFZO05jhYKSkw/company-logo_200_200/company-logo_200_200/0/1692627816910/universityofchicagoboothschoolofbusiness_logo?e=2147483647&v=beta&t=BTjFA4UVU5iKIIyicg8d44rhoiuMbetNDB97BmqpwhQ",
    "linkedIn2EduSchool": "Manipal Institute of Technology",
    "linkedIn2EduDegree": "Bachelor’s Degree",
    "linkedIn2EduField": "Electrical Engineering",
    "linkedIn2EduStartsAt": null,
    "linkedIn2EduEndsAt": null,
    "linkedIn2EduPage": "https://www.linkedin.com/school/manipal-institute-of-technology/",
    "linkedIn2EduLogo": "https://media.licdn.com/dms/image/v2/D4D0BAQHodG_7cUqs6w/company-logo_200_200/B4DZ8hC8AUJQAE-/0/1782965846314/manipal_institute_of_technology_logo?e=2147483647&v=beta&t=jqJK15_r7lxUNgWdbbzdMq47aLa_PqnkDYxg4Jun4Zo",
    "linkedIn3EduSchool": "University of Wisconsin-Milwaukee",
    "linkedIn3EduDegree": "Master’s Degree",
    "linkedIn3EduField": "Computer Science",
    "linkedIn3EduStartsAt": null,
    "linkedIn3EduEndsAt": null,
    "linkedIn3EduPage": "https://www.linkedin.com/school/uwmilwaukee/",
    "linkedIn3EduLogo": "https://media.licdn.com/dms/image/v2/D4D0BAQE47QlO_LG8SQ/company-logo_200_200/company-logo_200_200/0/1729615751602/uwmilwaukee_logo?e=2147483647&v=beta&t=l-w3ttd1mZRc-_j5aCPXEzNiYJzl1iJjMGw7q8B3eRI"
  },
  "creditsUsed": "25",
  "error": null
}
Lies Position, Arbeitgeber, Startdatum und Enddatum immer gemeinsam. Der Microsoft-Eintrag beginnt im Februar 2014 und hat kein Enddatum. Der Eintrag beim Business Council U.S. reicht von 2021 bis Januar 2023. An diesen Daten erkennst du, ob eine Position noch läuft oder bereits beendet wurde. Außerdem zeigen sie, dass sich Tätigkeiten zeitlich überschneiden können.
linkedInlastExpTitle und linkedInlastExpCompany enthalten die aktuelle oder zuletzt zugeordnete berufliche Station. Dieser erste zugeordnete Eintrag kann ausführlichere Unternehmensdaten enthalten, etwa die Unternehmensseite, Website, Branche, Beschreibung und Mitarbeiterzahl. Nummerierte Einträge ergänzen frühere Positionen, Arbeitgeber und Zeiträume. In dieser Response lautet die zurückgegebene Microsoft-Website https://news.microsoft.com/. Damit erhält der Lead-Datensatz neben dem beruflichen Werdegang der Person auch eine hilfreiche Unternehmensquelle.
Die Felder linkedInlastEduSchool, linkedIn2EduSchool und linkedIn3EduSchool nennen die The University of Chicago Booth School of Business, das Manipal Institute of Technology und die University of Wisconsin-Milwaukee. Der Manipal-Eintrag enthält einen Bachelor’s Degree in Electrical Engineering, der Wisconsin-Milwaukee-Eintrag einen Master’s Degree in Computer Science. Beim Chicago-Eintrag sind Abschluss und Fachrichtung leer.
Mit den experiencesNb-Werten "3", "5" oder "10" sowie den educationsNb-Werten "1", "3" oder "5" bestimmst du, wie viel Historie du benötigst. Lies diese Felder direkt aus outputs, wenn sie für deine Recherche relevant sind. Ein leerer optionaler Wert bedeutet nicht, dass das gesamte Ergebnis fehlgeschlagen ist.
Der aktuelle Abruf eignet sich für die Vorbereitung von Lead-Listen, wenn du die verfügbaren öffentlichen Profildaten neu laden möchtest. Im Cache-Modus kann ein vorhandenes gespeichertes Profil mit weniger Credits zurückgegeben werden. Ist kein Profil im Cache verfügbar, kann Datablist auf einen aktuellen Abruf ausweichen. Entscheide anhand der gewünschten Aktualität und deines Credit-Budgets.
Lead-Datensätze für den Outreach vorbereiten
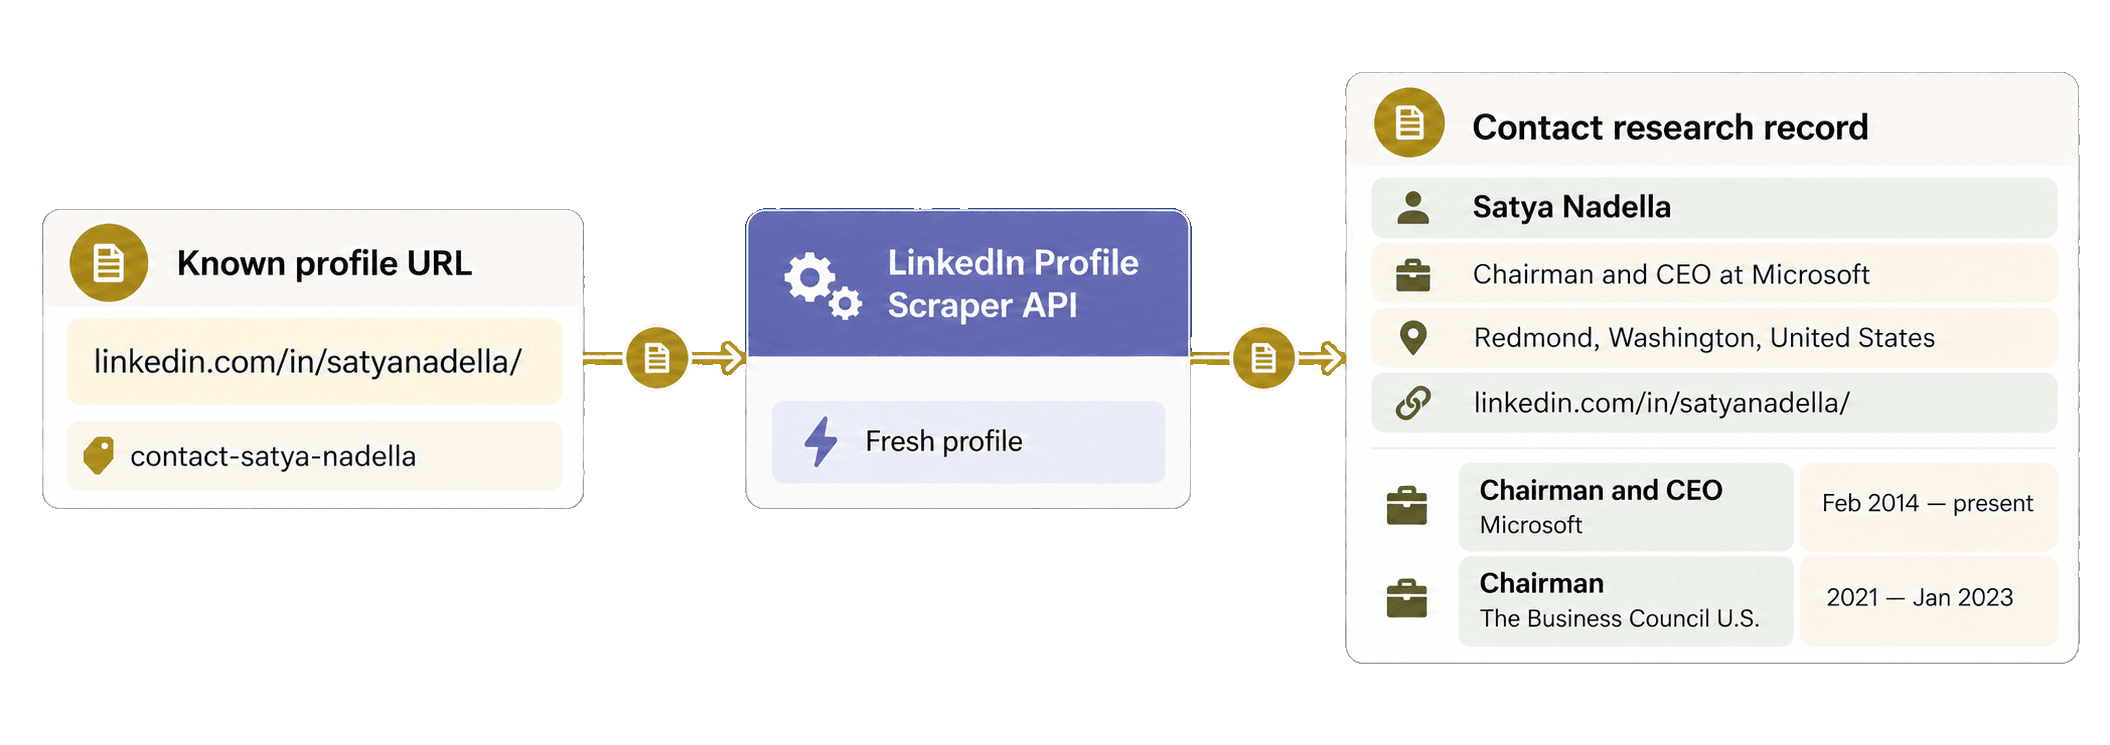
Sobald profile_results verfügbar ist, kannst du jede Response mit dem zugehörigen Ausgangskontakt verknüpfen, ohne einen weiteren Task zu übermitteln. Der folgende Block verwendet die Variablen aus dem vollständigen Skript erneut:
results_by_input_id = {
result["inputId"]: result
for result in profile_results
}
contact_research = []
for contact in source_contacts:
result = results_by_input_id[contact["contact_id"]]
contact_research.append(
{
"contact_id": contact["contact_id"],
"source_profile_url": contact["profile_url"],
"result_status": result["status"],
"profile": result.get("outputs", {}),
"credits_used": result["creditsUsed"],
"error": result.get("error"),
}
)
research_record = contact_research[0]
profile = research_record["profile"]
print("Contact:", profile.get("fullName"))
print("Headline:", profile.get("linkedInHeadline"))
print("Location:", profile.get("linkedInLocation"))
print(
"First work entry:",
profile.get("linkedInlastExpTitle"),
"at",
profile.get("linkedInlastExpCompany"),
)Das nach inputId indizierte Dictionary verarbeitet Responses auch dann korrekt, wenn sie in einer anderen Reihenfolge eintreffen. contact-satya-nadella bleibt sowohl die Quell-ID als auch die API-ID, die bekannte LinkedIn-URL bleibt in source_profile_url erhalten und profile speichert das ursprüngliche outputs-Objekt unverändert.
Dieser Wrapper hält das vollständige zurückgegebene Profil zusammen mit der Quell-URL, dem API-Status und dem Credit-Verbrauch fest. Mit der ausgegebenen Headline, dem Standort und der ersten beruflichen Station kannst du den Lead qualifizieren und deinen Outreach um relevanten Kontext zur Rolle oder zum Unternehmen ergänzen. Bei nicht erfolgreichen API-Zeilen bleiben der zurückgegebene Status und der Fehler erhalten, sodass sie weiterhin in der Lead-Liste sichtbar sind.
Du kannst das gepflegte Blocking-Beispiel mit Requests herunterladen oder die asynchrone HTTPX-Alternative verwenden, sobald dir der blockierende Ablauf klar ist.
Kosten für das Scrapen von LinkedIn-Profilen
Ein aktueller Abruf verbraucht 25 Credits pro Profil. Sind Cache-Profile aktiviert, kostet ein verfügbares Ergebnis aus dem Cache 20 Credits. Bei einem Cache Miss kann weiterhin ein aktueller Abruf für 25 Credits erfolgen. Das aktuelle Beispielprofil von Satya Nadella hat 25 Credits verbraucht.
Für 1.000 Profile werden damit 20.000 Credits benötigt, wenn jedes angeforderte Cache-Profil verfügbar ist. Bei aktuellen Abrufen können es bis zu 25.000 Credits sein. Für den Zugriff auf die Datablist REST API ist der Growth-Plan erforderlich. Das Abonnement, die enthaltenen Credits und optionale Credit Top-ups sind separate Kostenbestandteile. Die aktuellen Angebote findest du auf der Preisseite.
Nehmen wir als Planungsbeispiel das aktuelle Basis-Top-up von 20 US-Dollar für 20.000 Credits: Dann entsprechen die verbrauchten Credits bei 1.000 vollständig aus dem Cache geladenen Profilen geschätzten 20 US-Dollar. Bei einem aktuellen Abruf wären es 25 US-Dollar. Diese Schätzungen verstehen sich zuzüglich der Kosten für das Growth-Abonnement.
Häufige Fehler beheben und Tasks wiederherstellen
DATABLIST_API_KEYfehlt: Das Skript wird beendet, bevor ein Request gesendet wird. Exportiere die Variable und führe die Datei erneut aus.- Die API lehnt den Key ab: Prüfe den Personal API Key und sende ausschließlich die in diesem Beispiel verwendeten
X-API-Key-Anmeldedaten. - Die Profil-URL fehlt oder ist fehlerhaft: Verwende eine öffentliche LinkedIn-URL einer Person oder eine unterstützte Sales-Navigator-Lead-URL. Der Name einer Person, eine Suchergebnisseite oder eine Unternehmensseite ist kein gültiger Profil-Input.
- Die Credits reichen nicht aus: Prüfe deinen Kontostand und nutze anschließend enthaltene Credits oder füge ein Top-up hinzu, bevor du einen weiteren Task erstellst.
- Der Task hat den Status
failedoderstopped: Prüfe den Fehler, die verfügbaren Ergebnisse und den Credit-Verbrauch, bevor du entscheidest, ob eine weitere kostenpflichtige Übermittlung nötig ist. - Ein Ergebnis ist unvollständig oder hat den Status
no_resultbeziehungsweiseerror: Prüfe den Status und den öffentlichen Fehler. Kontrolliere anschließend die URL und die Einstellungen. Die verfügbaren Felder können je nach Profil, Sichtbarkeit und Abruf variieren.
Falls die Verbindung während des POST-Requests abbricht, verwende die vor dem Absenden ausgegebene uniqueId. Rufe die zuletzt ausgeführten Scraper-Tasks ab und vergleiche ihre Werte, bevor du einen weiteren Task erstellst:
response = requests.get(
"https://api.datablist.com/v1/enrichments/tasks",
headers={"X-API-Key": api_key},
params={"enrichmentId": "linkedin-profile-scraper", "limit": 100},
)
response.raise_for_status()
printed_unique_id = "paste-the-printed-unique-id"
tasks = response.json()["tasks"]
matching_task = None
for task in tasks:
if task["uniqueId"] == printed_unique_id:
matching_task = task
break
if matching_task:
print("Task ID:", matching_task["@id"])Die Task-Liste lässt sich nach enrichmentId filtern, aber nicht nach uniqueId. Folge ihrem nextCursor, wenn der Task nicht auf der ersten Seite erscheint. Sobald du die Task-ID hast, kannst du mit denselben Status- und Ergebnis-URLs fortfahren, die auch die Hauptfunktion verwendet. Die Dokumentation zur Task API erklärt Lifecycle, Pagination und Verhalten bei Unterbrechungen ausführlicher.
Nächste Schritte
Du hast jetzt eine wiederverwendbare Python-Requests-Funktion, die bekannte LinkedIn-Profil-URLs in strukturierte Ergebnisse umwandelt. Außerdem verfügst du über Lead-Datensätze, die anhand stabiler IDs korrekt zugeordnet werden. Ersetze das Beispiel durch eine kleine, geprüfte Auswahl von URLs. Entscheide je nach gewünschter Aktualität und Credit-Kosten zwischen einem aktuellen Abruf und Cache-Daten. Nutze anschließend den zurückgegebenen Kontext zu Position und Unternehmen, um Leads zu qualifizieren oder deinen Outreach zu personalisieren.
Falls du Profil-URLs erst anhand von Namen und einem Unternehmens- oder Hochschul-Keyword finden musst, folge zunächst dem separaten Guide zum Finden von LinkedIn-Profilen mit Python und einer API, bevor du diesen Scraper ausführst.