
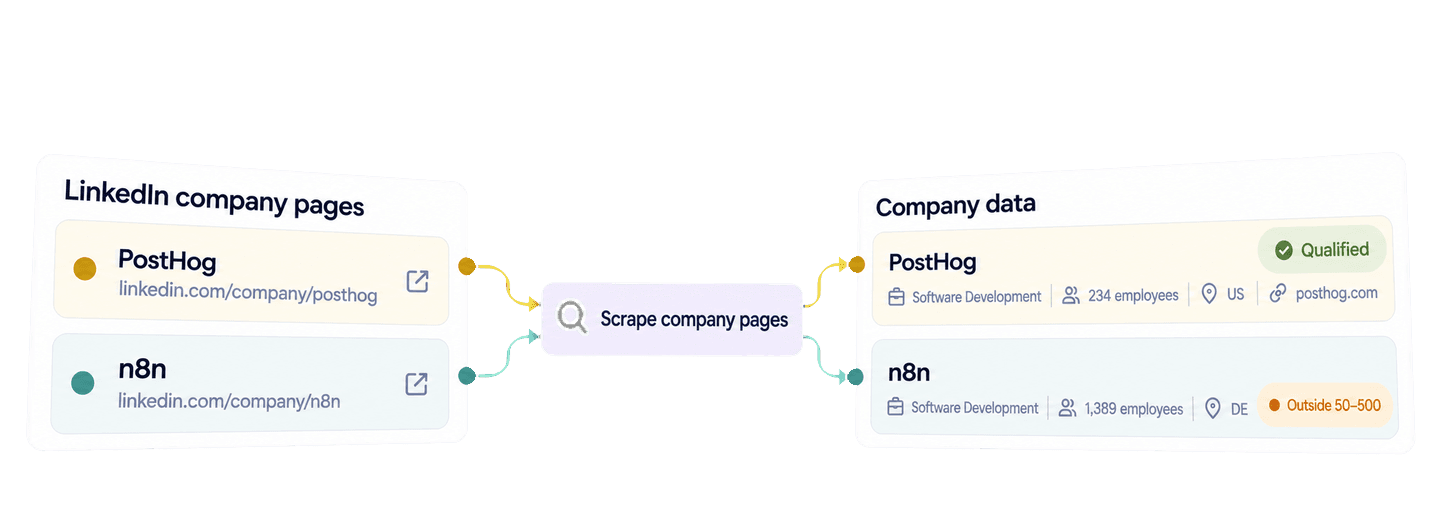
Du kannst LinkedIn-Unternehmensdaten mit Python scrapen, indem du eine Liste mit URLs von Unternehmensseiten über die Requests-Bibliothek an die API von Datablist sendest. Die API liefert strukturierte Unternehmensdatensätze mit Feldern wie Branche, Mitarbeiterzahl, Hauptsitz, Website und Beschreibung – sofern diese Angaben auf der öffentlichen Unternehmensseite verfügbar sind.
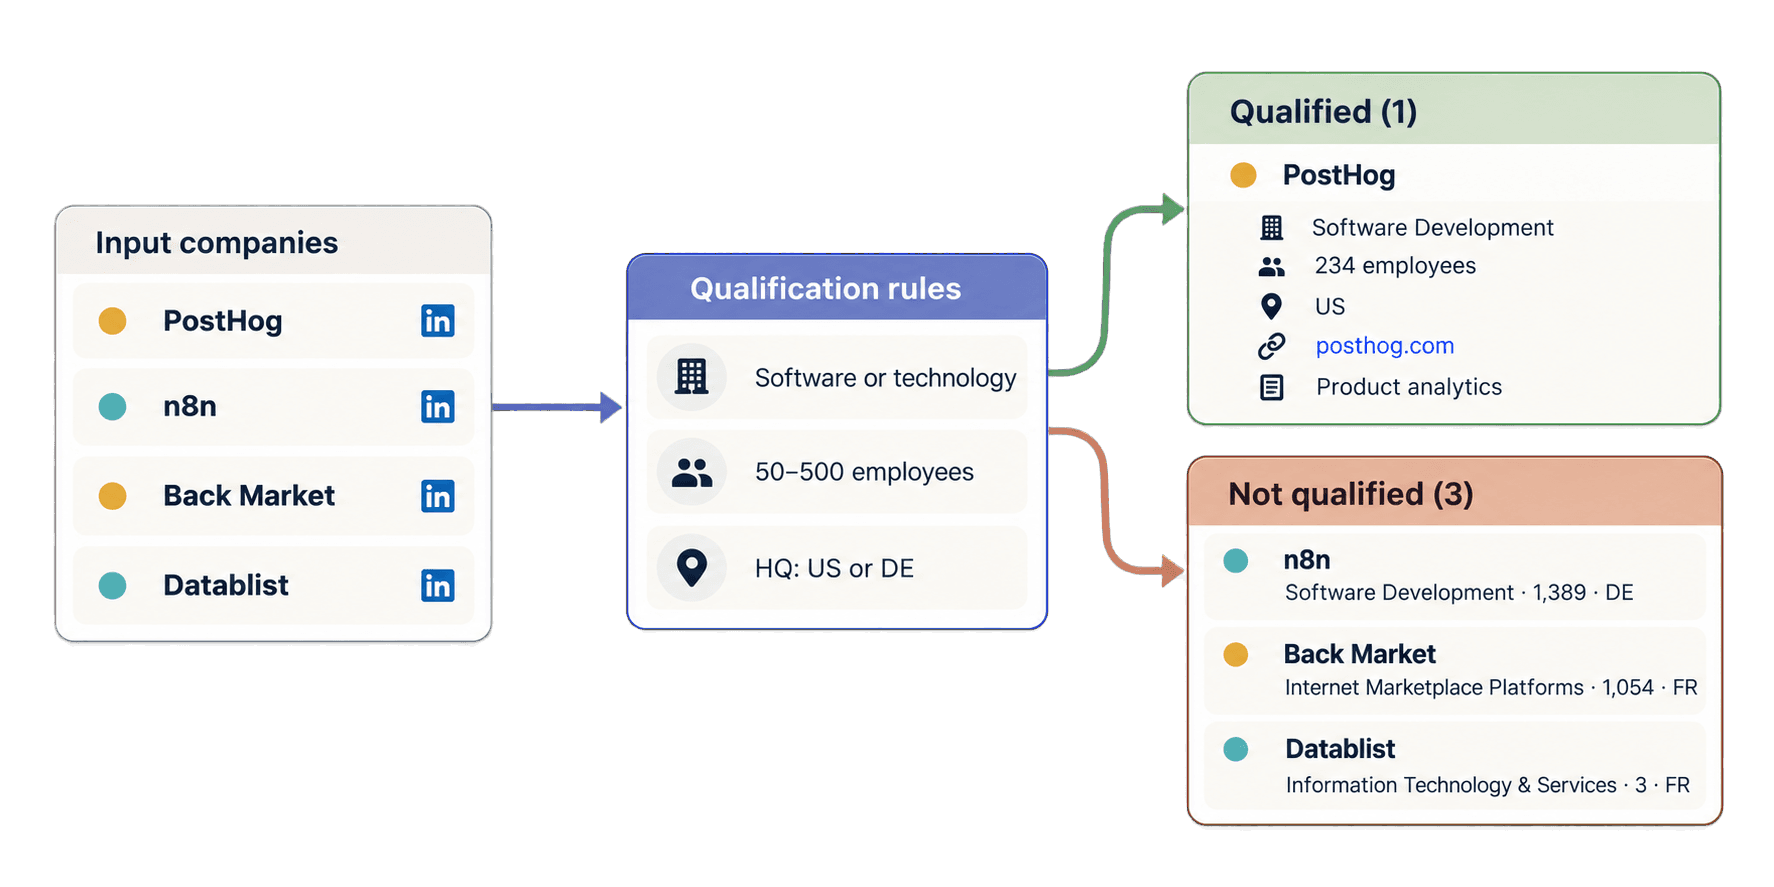
In diesem Guide verwende ich eine übersichtliche Python-Funktion, um Datensätze für n8n, PostHog, Back Market und Datablist abzurufen. Anschließend nutze ich die Ergebnisse, um Softwareunternehmen mit 50 bis 500 Mitarbeitern und Hauptsitz in den USA oder Deutschland zu qualifizieren. Website und Beschreibung bleiben im qualifizierten Datensatz erhalten und können für eine tiefergehende Sales-Recherche verwendet werden.
🔑 Kurzfassung für Eilige
Datablist verwandelt geprüfte URLs von LinkedIn-Unternehmensseiten in strukturierte Unternehmensdatensätze für deinen Sales-Research-Workflow. Das Python-Beispiel unten ruft sämtliche Ergebnisseiten ab und wendet anschließend einen lokalen Account-Filter an – ohne einen zweiten API-Aufruf.
- Input: URLs von LinkedIn-Unternehmensseiten.
- Output: Verfügbare Unternehmensdaten und eine lokale Qualifizierungsentscheidung, wobei die ursprüngliche URL und der vollständige Unternehmensdatensatz zusammenbleiben.
💡 Du bevorzugst eine No-Code-Lösung? Mit dem LinkedIn Company Page Scraper von Datablist kannst du Unternehmensdaten aus bekannten LinkedIn-Unternehmens-URLs extrahieren, ohne Code zu schreiben.
Python und Datablist API-Key einrichten
Für dieses Python-Beispiel verwende ich das Paket requests. Die REST API von Datablist ist im Growth-Plan verfügbar. Jeder Abruf einer Unternehmensseite verbraucht Enrichment Credits.
Erstelle auf deiner Datablist-API-Kontoseite einen Personal API Key.
Lege eine Datei namens scrape_linkedin_companies.py an. Richte danach eine virtuelle Umgebung ein und installiere Requests:
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
export DATABLIST_API_KEY="your-api-key"Das Skript liest den Key aus DATABLIST_API_KEY und sendet ihn im Header X-API-Key.
LinkedIn-Unternehmensseiten mit einer Python-Funktion scrapen
Die folgende Ausgangsliste enthält Unternehmen aus unterschiedlichen Branchen, mit verschiedenen Größen und Hauptsitzländern. Jede account_id wird zur inputId der API. Die Ergebnisse werden nicht anhand ihrer Position in der Response zugeordnet. Deshalb verbindet diese stabile ID jedes Ergebnis mit der richtigen Quell-URL.
Füge das vollständige Skript in scrape_linkedin_companies.py ein:
import json
import os
import time
import uuid
import requests
accounts = [
{
"account_id": "account-n8n",
"linkedin_company_url": "https://www.linkedin.com/company/n8n/",
},
{
"account_id": "account-posthog",
"linkedin_company_url": "https://www.linkedin.com/company/posthog/",
},
{
"account_id": "account-back-market",
"linkedin_company_url": "https://www.linkedin.com/company/back-market/",
},
{
"account_id": "account-datablist",
"linkedin_company_url": "https://www.linkedin.com/company/datablist/",
},
]
def scrape_companies(accounts, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": account["account_id"],
"data": {"companyLinkedInUrl": account["linkedin_company_url"]},
}
for account in accounts
]
unique_id = str(uuid.uuid4())
print(f"Request ID: {unique_id}")
payload = {
"enrichmentId": "linkedin-company-enrichment",
"uniqueId": unique_id,
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
print(f"Task ID: {task_id}")
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
company_results = scrape_companies(accounts, api_key)
print(json.dumps(company_results, indent=2, ensure_ascii=False))Führe es so aus:
python scrape_linkedin_companies.pyÄndern musst du vor allem die Datensätze in accounts. Lass jede account_id stabil und eindeutig. Ersetze anschließend linkedin_company_url durch eine geprüfte LinkedIn-Unternehmensseite. Die Funktion wandelt diese Datensätze in das inputs-Format der API um und übermittelt die Unternehmens-URL als companyLinkedInUrl. settings bleibt leer, weil dieses Enrichment keine öffentlichen Einstellungen hat.
Der POST-Request erstellt eine Enrichment-Task im Hintergrund. Die API antwortet mit 202 Accepted und einer Task-ID, während der Requests-Client durch regelmäßiges Abfragen der Status-URL wartet. Dieser blockierende Python-Code ist für ein kleines Skript praktisch. Aufseiten von Datablist läuft die Task trotzdem asynchron.
Der erste GET-Request prüft die Task selbst. Sie kann mit completed, failed oder stopped enden. Das Skript fährt nur bei completed fort. Andernfalls löst es einen Fehler aus, der die Task-ID und den Task-Fehler der API enthält. Bewahre die ID für deine Fehleranalyse auf, denn auch eine fehlgeschlagene oder gestoppte Task kann Ergebnisse und prüfbare Credit-Nutzung enthalten.
Sobald die Task abgeschlossen ist, ruft die letzte Schleife Ergebnisseiten mit einem Limit von 100 ab. Sie lädt weitere Seiten, bis nextCursor den Wert null hat. Jedes Ergebnis behält die von dir übermittelte inputId. Deshalb kann die spätere Qualifizierungsschleife Ergebnisse auch dann korrekt zuordnen, wenn ihre Reihenfolge von der Input-Reihenfolge abweicht.
Unternehmensergebnis und Abrufmethode verstehen
Die LinkedIn-URL identifiziert das Unternehmen direkt. Datablist normalisiert die Unternehmens-URL und ruft die verfügbaren öffentlichen Daten der Unternehmensseite ab, statt nach mehreren möglichen Unternehmen zu suchen und diese zu bewerten. Bei einer benannten Unternehmens-URL beginnt der Abruf auf der öffentlichen Seite. Noch fehlende Felder können über verwaltete Fallback-Quellen ergänzt werden, während bereits gefundene relevante Werte erhalten bleiben.
Dieser Unterschied ist beim Auswerten des Ergebnisses wichtig. Optionale Felder hängen davon ab, welche Angaben öffentlich verfügbar sind. Eine leere Hauptsitzadresse oder eine fehlende Spezialisierung bedeutet nicht, dass der gesamte Unternehmensabruf fehlgeschlagen ist.
Hier siehst du die vollständige Ergebnisseite für die vier URLs:
{
  "taskId": "69516a973dc34481920f41ade748e917",
  "results": [
    {
      "inputId": "account-n8n",
      "status": "success",
      "outputs": {
        "companyName": "n8n",
        "companyHQPostalCode": "10115",
        "companyDescription": "n8n is a workflow automation platform that uniquely combines AI capabilities with business process automation. The platform enables connection to any app or API while maintaining the flexibility of code with the speed of no-code.\n\nReleased under a fair-code license, n8n can be self-hosted and is supported by a vibrant community of developers and builders. Users can start simple and layer complexity as needed - utilizing the visual builder for quick wins, and adding custom Javascript or Python code where more control is required, enabling the connection of anything to everything.\n\nn8n is privately held, with funding from Sequoia, Felicis Ventures, Firstminute Capital, Harpoon Ventures, and others. Individual investors include Eventbrite's Kevin Hartz and Supercell's IIkka Paananen. n8n was founded in 2019 and is headquartered in Berlin.",
        "companyTagline": "Flexible AI workflow automation for technical teams.",
        "companyIndustry": "Software Development",
        "companySpecialities": "AI, SOAR, Workflow Automation, and AI agents",
        "companyWebsite": "https://n8n.io",
        "companyHQCity": "Berlin",
        "linkedInCompanyId": "28491094",
        "companyType": "Privately Held",
        "companyHQCountry": "DE",
        "companySize": 1389,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D4D0BAQEgEphZqatXwA/company-logo_200_200/B4DaFY.Sa2JcAE-/0/1792494086070/n8n_logo?e=2147483647&v=beta&t=NTL4C6f5QAd_o9nXd15PO8pOMSSEoms_tJdDHEo6eLk",
        "companyHQAddress": "Novalisstraße 10",
        "companyFoundedYear": 2019,
        "companyFollowerCount": 442229
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-posthog",
      "status": "success",
      "outputs": {
        "companyName": "PostHog",
        "companyHQPostalCode": null,
        "companyDescription": "At PostHog, we're working to increase the number of successful products in the world.\n\nUntil now, tools for building products have been fragmented. Product analytics, heatmaps, session recording, web analytics, feature flags, and A/B testing are all helpful, but no one wants to buy, send data to, and integrate multiple products.\n\nPostHog offers these tools (and more) in an integrated, open source platform which can be hosted in either the US or EU. Both versions are SOC2 certified, GDPR-ready, and HIPAA compliant. \n\nWe started PostHog during Y Combinator's W20 cohort and had the most successful B2B software launch on Hacker News since 2012 - with a product that was just 4 weeks old.\n\nWith over 100,000 users, we're default alive, growing 97% through word of mouth, and we are in the top 0.01% most popular repos on GitHub.",
        "companyTagline": "Your product's context layer. Get started with npx @posthog/wizard",
        "companyIndustry": "Software Development",
        "companySpecialities": "analytics, open source, product analytics, product, data, engineering, self-driving product, session replay, context warehouse, AI, product context, and error tracking",
        "companyWebsite": "https://posthog.com/",
        "companyHQCity": "San Francisco",
        "linkedInCompanyId": "37415928",
        "companyType": "Privately Held",
        "companyHQCountry": "US",
        "companySize": 234,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D560BAQGQUyE_CXUxIw/company-logo_200_200/B56aCMWEgaJAAE-/0/1789060991251/posthog_logo?e=2147483647&v=beta&t=WfTGRSqp5UfYL33sBXx3tZ1zmFUECfUPf7JtEGPAvbA",
        "companyHQAddress": null,
        "companyFoundedYear": 2020,
        "companyFollowerCount": 59696
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-back-market",
      "status": "success",
      "outputs": {
        "companyName": "Back Market",
        "companyHQPostalCode": null,
        "companyDescription": "The world is waking up to what fast tech costs. Back Market is where the revolution shops. \nWe make refurbished tech the smart, confident choice by building trust in quality, repair and circularity. New is not always better. Smarter is.\n\nAs a certified B Corp, our mission is to create a world that does more with what we already have by prolonging the lifespan of electronic devices through circularity and repair. We have grown by double digits year over year and now serve 18 million customers across 17 markets, avoiding more than 2 million tons of CO2 emissions*\n*Back Market calculation based on ADEME 2022 methodology.\n\nFounded in Paris in 2014 by Thibaud Hug de Larauze, Quentin Le Brouster and Vianney Vaute, Back Market is a leading global marketplace where people can buy professionally refurbished technology or trade in their devices.\n\nAre you ready to join us?",
        "companyTagline": "Where the world shops refurbished tech.",
        "companyIndustry": "Internet Marketplace Platforms",
        "companySpecialities": "refurbished tech, marketplace, sustainability, circularity, Right to Repair, sustainable solutions, refurbished marketplace, circular economy, and sustainable alternatives",
        "companyWebsite": "http://www.backmarket.com",
        "companyHQCity": "Paris",
        "linkedInCompanyId": "4793443",
        "companyType": "Privately Held",
        "companyHQCountry": "FR",
        "companySize": 1054,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/D4E0BAQHRv6UClt5D2g/company-logo_200_200/B4EZnoUG3tKgAI-/0/1760539209613/back_market_logo?e=2147483647&v=beta&t=Pywpeu1Qs3h0Cl8kgvYurmBfXbImm5QIIc-aQog1MqM",
        "companyHQAddress": null,
        "companyFoundedYear": 2014,
        "companyFollowerCount": 101878
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "account-datablist",
      "status": "success",
      "outputs": {
        "companyName": "Datablist",
        "companyHQPostalCode": null,
        "companyDescription": "When people hear \"data,\" they think of something complicated. We will change this.\n\nDatablist is an AI-powered spreadsheet that helps you: get, manipulate, or clean data and create workflows that run automatically while you focus on what matters most.\n\nIf you want to separate Datablist.com into its main parts, you can say we have:\n\n- Deduplicating, grouping, and labeling data\n- Cleaning and editing data\n- Managing data and automated workflows\n- 50+ B2B data sources and scrapers\n- 3 AI agents:\n    - Editing assistant\n    - AI Research agent\n    - Deduplication assistant\n\nThe top 3 reasons why companies choose Datablist.com are:\n\n1. Simplicity: you don't need to have technical knowledge or experience with formulas to get everything out of it.\n2. Flexibility that allows you to do (almost) everything with your data and AI while keeping everything under your control.\n3. Scalability that no other solution can match. Up to 2 million rows—forget Excel.\n\nGo on try it for free!\n\nhttps://www.Datablist.com",
        "companyTagline": "Let your tasks become workflows: automated workflows.",
        "companyIndustry": "Information Technology & Services",
        "companyWebsite": "https://www.datablist.com",
        "companyHQCity": "Paris",
        "linkedInCompanyId": "69842428",
        "companyType": "Privately Held",
        "companyHQCountry": "FR",
        "companySize": 3,
        "companyLogoUrl": "https://media.licdn.com/dms/image/v2/C4E0BAQFNFlMb8KEPRQ/company-logo_200_200/company-logo_200_200/0/1630622803412?e=2147483647&v=beta&t=UVkk7BOerChiWgS9Y06zOpT08SlK4kpAWGDYiVvUEVU",
        "companyFollowerCount": 134,
        "companyFoundedYear": 2020,
        "companyHQAddress": null
      },
      "creditsUsed": "25",
      "error": null
    }
  ],
  "nextCursor": null
}
Alle vier Datensätze wurden erfolgreich abgerufen und verbrauchten jeweils 25 Credits. Für PostHog wurden Software Development, 234 Mitarbeiter, ein Hauptsitz in den USA, die Website und die Beschreibung zurückgegeben. n8n ist ebenfalls ein Softwareunternehmen in einem der ausgewählten Länder, hat laut Ergebnis aber 1.389 Mitarbeiter. Für Back Market lieferte die API Internet Marketplace Platforms, 1.054 Mitarbeiter und einen Hauptsitz in Frankreich. Datablist kam mit Information Technology & Services, 3 Mitarbeitern und einem Hauptsitz in Frankreich zurück.
Das vollständige Objekt ist hilfreich, weil eine Account-Recherche selten bei einem einzigen Feld endet. Du kannst nach Branche, Mitarbeiterzahl und Land qualifizieren und gleichzeitig die exakt zurückgegebene Website und Beschreibung für den nächsten Rechercheschritt behalten.
In dieser Response steht companySize für die zurückgegebene Mitarbeiterzahl und nicht für eine LinkedIn-Größenklasse. companyHQCountry bezeichnet das Land des Hauptsitzes und nicht jedes Land, in dem das Unternehmen tätig ist. Diese Unterschiede sind wichtig, wenn du die Größen- und Länderfilter an dein Ideal Customer Profile anpasst.
Für die Qualifizierung müssen nicht alle optionalen Felder vorhanden sein. Eine fehlende Adresse oder Spezialisierung kann leer bleiben, sofern Branche, Mitarbeiterzahl und Hauptsitzland verfügbar sind. Behalte companyWebsite so bei, wie es zurückgegeben wurde, statt davon auszugehen, dass die API die URL in eine reine Domain umwandelt. Die Beschreibung hilft Sales-Researchern dabei, das Produkt des Unternehmens zu verstehen und vor dem Outreach eine accountspezifische Recherche vorzubereiten. status, creditsUsed und error auf Ergebnisebene sollten bei der Prüfung oder Speicherung neben den Unternehmensfeldern erhalten bleiben.
Accounts für die Sales-Recherche qualifizieren
Angenommen, deine Zielgruppe sind Software- oder Technologieunternehmen mit 50 bis 500 Mitarbeitern und Hauptsitz in den USA oder Deutschland. Ergänze die folgende Schleife unterhalb des vollständigen Skripts. Sie verwendet company_results erneut und erstellt daher keine weitere Task:
accounts_by_id = {account["account_id"]: account for account in accounts}
qualified_accounts = []
other_accounts = []
for result in company_results:
account = accounts_by_id.get(result["inputId"])
qualification = "needs_review"
if result["status"] == "success":
outputs = result["outputs"]
industry = outputs.get("companyIndustry")
company_size = outputs.get("companySize")
country = outputs.get("companyHQCountry")
if industry and isinstance(company_size, (int, float)) and country:
industry_matches = any(
keyword in industry.lower()
for keyword in ("software", "technology")
)
size_matches = 50 <= company_size <= 500
country_matches = country in {"US", "DE"}
if industry_matches and size_matches and country_matches:
qualification = "qualified"
else:
qualification = "not_qualified"
source_url = None
if account is not None:
source_url = account["linkedin_company_url"]
reviewed_account = dict(result)
reviewed_account["sourceLinkedInUrl"] = source_url
reviewed_account["qualification"] = qualification
if qualification == "qualified":
qualified_accounts.append(reviewed_account)
else:
other_accounts.append(reviewed_account)
print(json.dumps(qualified_accounts, indent=2, ensure_ascii=False))PostHog wird wieder account-posthog zugeordnet, selbst wenn die API die Datensätze in einer anderen Reihenfolge zurückgibt. Der Account qualifiziert sich, weil Software Development, 234 Mitarbeiter und US alle drei Prüfungen bestehen. Die Schleife kopiert das ursprüngliche Ergebnis mitsamt den vollständigen outputs, der zurückgegebenen Website https://posthog.com/, der Beschreibung, creditsUsed und error. Hinzu kommen lediglich die Quell-URL und das lokale Qualifizierungslabel.
n8n wird account-n8n zugeordnet und qualifiziert sich nicht, weil 1.389 Mitarbeiter über der Obergrenze liegen. Back Market verfehlt die ausgewählten Kriterien für Branche, Größe und Land. Datablist liegt unterhalb der Größenspanne und außerhalb der ausgewählten Länder. Künftige erfolglose oder unvollständige Datensätze erhalten needs_review, statt unbemerkt verworfen zu werden.
Du kannst das gepflegte synchrone Requests-Beispiel herunterladen oder die asynchrone HTTPX-Alternative aus dem Repository verwenden, wenn deine Anwendung nicht blockierenden Code benötigt.
Credits fürs Scrapen von LinkedIn-Unternehmen berechnen
Eine reguläre, benannte LinkedIn-Unternehmensseite kostet 25 Credits. Eine Unternehmens-URL mit numerischer ID kann 75 Credits verbrauchen, wenn der letzte Fallback benötigt wird. Das bedeutet jedoch nicht, dass jede numerische URL 75 Credits kostet. Auch fehlgeschlagene Abfragen oder Abfragen ohne Treffer können Credits verbrauchen. Nutze deshalb die Gesamtsumme der Task und den Wert creditsUsed jedes Ergebnisses als Nachweis für den tatsächlichen Verbrauch.
Die vier benannten URLs in diesem Guide haben insgesamt 100 Credits verbraucht. Zum Standardtarif benötigen 1.000 Unternehmensseiten 25.000 Credits. Enthält dein Input viele URLs mit numerischen IDs, solltest du mehr Spielraum für den möglichen 75-Credit-Abruf einplanen.
Der Zugriff auf die REST API setzt den Growth-Plan voraus. Der monatliche Plan enthält 20.000 Credits; zusätzliche Top-up Credits werden separat gekauft. Beim aktuellen Basispreis von 20 US-Dollar für 20.000 Credits kostet ein Credit 0,001 US-Dollar. Damit entsprechen 25.000 Credits einem Wert von 25 US-Dollar. Die aktuellen Pläne und Credit-Pakete findest du auf der Seite Datablist Pricing.
Häufige Input-, Task- und Ergebnisfehler beheben
DATABLIST_API_KEYfehlt: Das Skript wird beendet, bevor eine Anfrage gesendet wird. Exportiere die Variable und führe die Datei erneut aus.- Die API lehnt den Key ab: Prüfe deinen Personal API Key und übermittle ihn weiterhin im Header
X-API-Key, wie im Beispiel gezeigt. - Die Quell-URL ist ungültig: Ersetze persönliche Profile, themenfremde Websites, leere Werte oder fehlerhafte URLs durch eine unterstützte öffentliche LinkedIn-URL für ein Unternehmen, eine Bildungseinrichtung, eine Showcase Page, eine numerische Unternehmens-ID oder ein Sales-Navigator-Unternehmen.
- Die Credits reichen nicht aus: Prüfe dein Guthaben und nutze enthaltene Credits oder kaufe ein Top-up, bevor du eine weitere Task erstellst.
- Die Task hat den Status
failedoderstopped: Prüfe den Fehler, vorhandene Ergebnisse und den Credit-Verbrauch, bevor du entscheidest, ob du eine weitere kostenpflichtige Task startest. - Ein Ergebnis ist unvollständig,
no_resultodererror: Behalte Quell-URL, Status, Credits und Fehler für die Prüfung bei. Vergewissere dich vor einer erneuten Übermittlung, dass der Input eine öffentliche Unternehmensseite ist, ohne über den Grund für die fehlenden Daten zu spekulieren.
Falls die Response beim Erstellen verloren geht, verwende die Request-ID, die das Skript vor dem POST-Request ausgegeben hat. Liste zunächst die Tasks auf und suche den entsprechenden Wert in uniqueId:
curl "https://api.datablist.com/v1/enrichments/tasks?limit=100" \
-H "X-API-Key: $DATABLIST_API_KEY"Die @id der passenden Task ist die Task-ID. Verwende sie, um /v1/enrichments/tasks/{taskId} weiter abzufragen oder die Ergebnisse unter /v1/enrichments/tasks/{taskId}/results abzurufen, statt automatisch eine weitere Task zu erstellen. Eine einzelne Anfrage kann bis zu 10.000 Inputs und 10 MiB enthalten. Details zur Aufbewahrung und zu weiteren Lifecycle-Regeln findest du in der Task-Dokumentation.
Nächste Schritte
Du hast jetzt eine wiederverwendbare Python-Requests-Funktion, die eine Liste mit URLs von LinkedIn-Unternehmensseiten in strukturierte Unternehmensdatensätze umwandelt. Hinzu kommt eine lokale Qualifizierungsschleife, die den vollständigen API-Output für deine Sales-Recherche erhält.
Ersetze die vier Beispiele durch eine kleine, geprüfte Account-Liste, behalte stabile IDs bei und passe die Regeln für Branche, Mitarbeiterzahl und Land an dein Ideal Customer Profile an. Wenn du mit Personen statt Unternehmen startest, nutze den Guide zur LinkedIn Profile Scraper API. Falls du nur Unternehmensnamen hast, kannst du zunächst mit Python die passenden Unternehmenswebsites finden.