
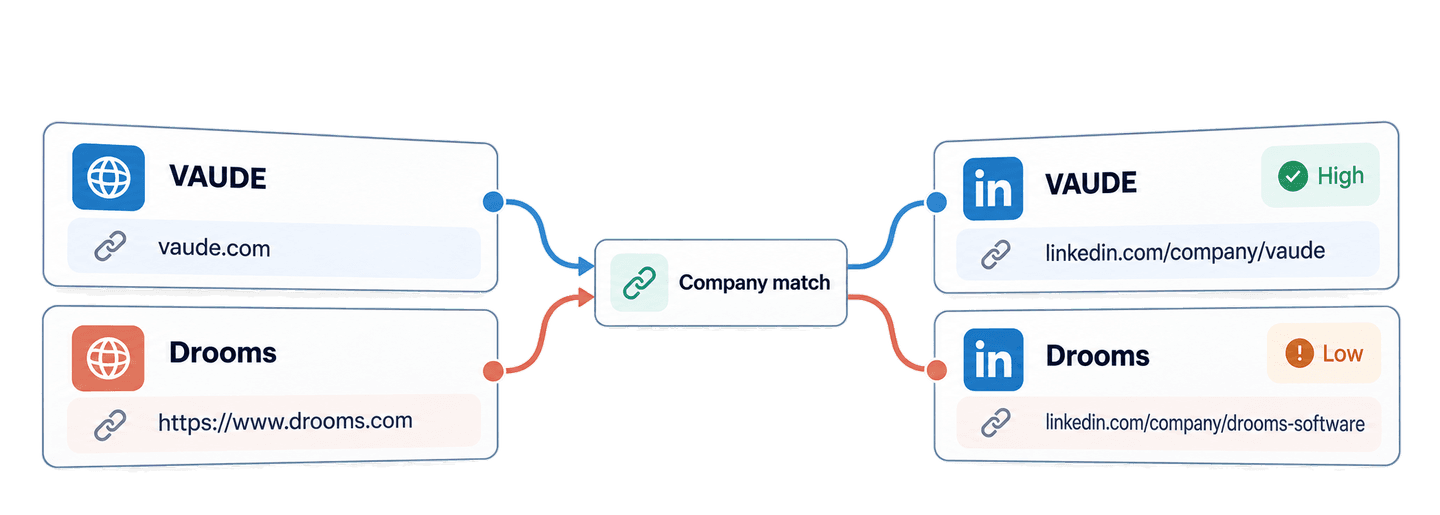
Utilisez l’API Company to LinkedIn de Datablist pour trouver la page LinkedIn d’une entreprise à partir de son site web avec Python. Vous pouvez envoyer un domaine seul ou l’URL complète d’un site, attendre la fin de la tâche de matching, puis récupérer le nom de l’entreprise, son site, l’URL de sa page LinkedIn et un indice de confiance.
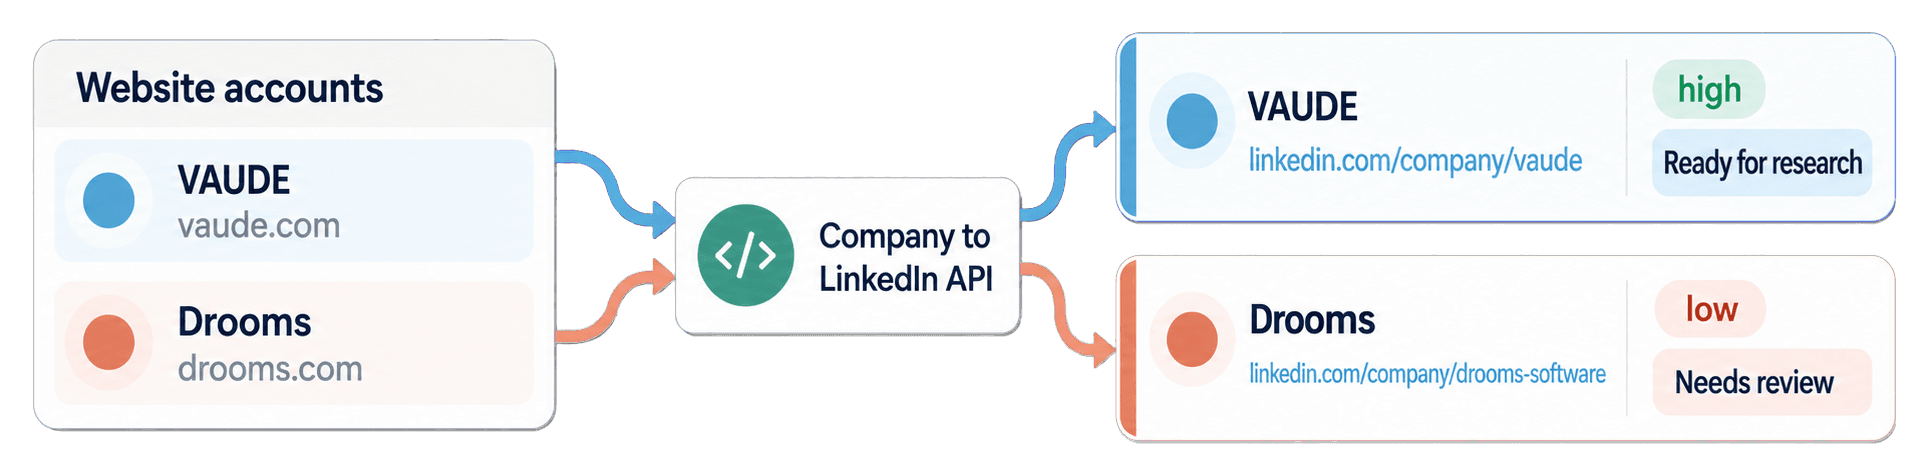
Dans ce guide, j’utilise Python et la bibliothèque Requests pour identifier les pages LinkedIn de cinq entreprises à partir de leur site. La liste comprend des éditeurs de logiciels connus, mais aussi VAUDE, une entreprise d’équipements outdoor, et Drooms, un fournisseur de data rooms virtuelles. Je transforme ensuite les résultats en deux files locales : les correspondances prêtes pour la recherche sur les entreprises et celles qui nécessitent une vérification manuelle.
🔑 L’essentiel si vous êtes pressé
Envoyez les sites web de votre liste de comptes à l’API Company to LinkedIn de Datablist. L’API renvoie les URL des pages LinkedIn d’entreprise et des indices de confiance pour vous aider à déterminer les correspondances exploitables et celles à vérifier.
- Entrée : domaines seuls et URL complètes de sites d’entreprise.
- Sortie : noms d’entreprise, sites correspondants, URL des pages LinkedIn et niveau de confiance
highoulow, répartis entre les filesReady for researchetNeeds review.
💡 Vous préférez une solution no-code ? Utilisez l’enrichissement LinkedIn Company Pages & Domain Lookup de Datablist pour faire correspondre sites d’entreprise et pages LinkedIn sans écrire de code.
Configurer Python et votre clé API Datablist
Pour cet exemple, j’utilise le package requests. L’API fonctionne en HTTP : vous pourrez donc reprendre la même séquence de requêtes dans un autre langage par la suite.
Vous avez besoin d’un compte Datablist avec un accès à la REST API, disponible avec le plan Growth. Chaque recherche réussie consomme également des crédits d’enrichissement. Le calcul précis est détaillé plus loin dans ce guide.
Créez un répertoire de travail et un fichier nommé find_linkedin_company_pages.py, puis créez un environnement virtuel et installez Requests :
mkdir company-linkedin-matcher
cd company-linkedin-matcher
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
touch find_linkedin_company_pages.pyCréez une Personal API Key depuis votre compte Datablist, puis exportez-la comme variable d’environnement :
export DATABLIST_API_KEY="your-api-key"Le script lit cette valeur et l’envoie dans le header X-API-Key.
Trouver des pages LinkedIn avec une fonction Python
L’exemple utilise ces cinq comptes sources :
account-datablist:datablist.comaccount-posthog:posthog.comaccount-n8n:https://n8n.ioaccount-vaude:vaude.comaccount-drooms:https://www.drooms.com
Chaque account_id devient l’inputId de l’API. C’est important, car les résultats ne sont pas nécessairement renvoyés dans le même ordre que les données d’entrée. Un identifiant stable permet de rattacher chaque résultat au bon compte source.
Collez le script complet suivant dans find_linkedin_company_pages.py :
import json
import os
import time
import uuid
import requests
def match_companies(accounts, api_key, matching_direction):
"""Submit one matching task, wait for it, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": account["account_id"],
"data": {"sourceUrl": account["source_url"]},
}
for account in accounts
]
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "company-to-linkedin",
"uniqueId": unique_id,
"settings": {"matchingDirection": matching_direction},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "datablist.com",
},
{
"account_id": "account-posthog",
"company_name": "PostHog",
"source_url": "posthog.com",
},
{
"account_id": "account-n8n",
"company_name": "n8n",
"source_url": "https://n8n.io",
},
{
"account_id": "account-vaude",
"company_name": "VAUDE",
"source_url": "vaude.com",
},
{
"account_id": "account-drooms",
"company_name": "Drooms",
"source_url": "https://www.drooms.com",
},
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
match_results = match_companies(
accounts, api_key, matching_direction="domain_to_linkedin"
)
print(json.dumps(match_results, indent=2))Exécutez-le avec :
python find_linkedin_company_pages.pyLa fonction effectue successivement trois types d’appels.
Tout d’abord, le POST envoie les cinq sites avec matchingDirection défini sur domain_to_linkedin. L’API répond avec le statut 202 Accepted et un ID de tâche, car le matching s’exécute en arrière-plan. Le script Requests reste toutefois simple à suivre : il attend la fin de chaque étape avant de passer à la suivante.
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]Ensuite, la requête de statut vérifie la tâche jusqu’à ce qu’elle passe à completed, failed ou stopped. La pause de trois secondes évite que le script n’envoie des requêtes de statut en continu.
Enfin, la requête de résultats récupère des pages contenant jusqu’à 100 résultats. Si nextCursor contient une valeur, la boucle l’envoie comme cursor dans la requête suivante. Elle ne s’arrête que lorsque nextCursor vaut null.
Analyser les correspondances et les résultats à vérifier
Voici la liste complète des résultats pour les cinq entrées :
[
  {
    "inputId": "account-datablist",
    "status": "success",
    "outputs": {
      "companyWebsite": "datablist.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/datablist",
      "companyName": "datablist"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-posthog",
    "status": "success",
    "outputs": {
      "companyWebsite": "posthog.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/posthog",
      "companyName": "PostHog"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-n8n",
    "status": "success",
    "outputs": {
      "companyWebsite": "n8n.io",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/n8n",
      "companyName": "n8n"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-vaude",
    "status": "success",
    "outputs": {
      "companyWebsite": "vaude.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/vaude",
      "companyName": "vaude"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-drooms",
    "status": "success",
    "outputs": {
      "companyWebsite": "drooms.com",
      "confidence": "low",
      "companyLinkedInUrl": "https://www.linkedin.com/company/drooms-software",
      "companyName": "Drooms"
    },
    "creditsUsed": "1.5",
    "error": null
  }
]
Interprétez status et confidence séparément. L’API renvoie un objet de résultat pour chaque entrée, y compris en cas d’échec. Un statut success signifie qu’elle a trouvé une page d’entreprise candidate. La valeur outputs.confidence indique si la correspondance avec le site a pu être validée. inputId relie l’objet à votre compte source, tandis que creditsUsed indique le coût de la ligne et qu’error contient une erreur structurée le cas échéant.
Conservez l’intégralité de l’objet outputs dans votre application, même si le premier écran n’affiche que l’URL LinkedIn et le niveau de confiance. companyName et companyWebsite accélèrent la vérification manuelle, notamment lorsque la casse du nom renvoyé diffère ou que l’entrée était une URL complète. Ces champs vous apportent aussi un contexte utile sans appel API supplémentaire.
Le processus de matching commence par normaliser le site soumis et par rechercher dans les bases de données d’entreprises une relation connue entre ce site et une page LinkedIn. Il compare ensuite le domaine saisi avec le site publié sur la page LinkedIn candidate. Si les domaines enregistrés correspondent, le niveau de confiance est high.
Lorsque les bases de données ne fournissent aucune URL LinkedIn, la recherche peut lancer une requête Google ciblée pour trouver des pages d’entreprise candidates. Si une page candidate ne peut pas être validée à partir d’un site publié, elle peut être renvoyée avec un niveau de confiance low. En revanche, une incompatibilité connue entre les sites n’est pas acceptée.
Considérez le niveau de confiance comme une consigne de vérification. Pour VAUDE, l’API a renvoyé https://www.linkedin.com/company/vaude avec une confiance high : la correspondance peut donc rejoindre la file de recherche. Pour Drooms, elle a renvoyé https://www.linkedin.com/company/drooms-software avec une confiance low. Ouvrez le site de Drooms et sa page LinkedIn avant de vous fier à cette relation.
Datablist, PostHog et n8n ont également obtenu des correspondances à forte confiance. Cette API établit la relation entre le site et la page d’entreprise. Si vous avez ensuite besoin de l’effectif, du secteur ou d’autres informations issues de cette page, poursuivez avec le guide de l’API LinkedIn company scraper.
Préparer une file de recherche sur les comptes
Réutilisez maintenant match_results pour créer une file locale destinée à la recherche manuelle sur les entreprises. Ce bloc ne rappelle pas l’API. Il indexe les résultats par inputId, puis parcourt la liste de comptes d’origine afin que chaque compte source reste visible, même si un résultat venait à manquer.
results_by_id = {result["inputId"]: result for result in match_results}
ready_for_research = []
needs_review = []
for account in accounts:
result = results_by_id.get(account["account_id"])
if result is not None:
outputs = result.get("outputs", {})
else:
outputs = {}
research_record = {
**account,
"companyLinkedInUrl": outputs.get("companyLinkedInUrl"),
"confidence": outputs.get("confidence"),
"api_result": result,
}
is_ready = (
result is not None
and result["status"] == "success"
and outputs.get("companyLinkedInUrl")
and outputs.get("confidence") == "high"
)
if is_ready:
ready_for_research.append(research_record)
else:
needs_review.append(research_record)
print("Ready for research:")
print(json.dumps(ready_for_research, indent=2))
print("Needs review:")
print(json.dumps(needs_review, indent=2))Le dictionnaire de résultats rend la jointure indépendante de l’ordre de réponse. account-vaude relie l’enregistrement vaude.com d’origine à la page VAUDE trouvée et rejoint ready_for_research. account-drooms conserve son URL d’entrée complète et l’intégralité du résultat API, mais rejoint needs_review, car le niveau de confiance est faible malgré le statut success.
La même logique maintient dans la file de vérification toute ligne absente, avec le statut no_result ou en erreur. Les deux listes affichées donnent à l’équipe un point de départ clair pour ses recherches manuelles sur les entreprises.
Vous pouvez également télécharger l’exemple synchrone avec Requests, maintenu à jour. Le dépôt comprend aussi un exemple asynchrone avec HTTPX pour les applications qui ont besoin de requêtes HTTP non bloquantes. La version bloquante ci-dessus reste toutefois plus facile à suivre pour une première intégration.
Retrouver un site depuis une page LinkedIn d’entreprise
La même fonction accepte les pages LinkedIn d’entreprise lorsque vous changez le sens du matching. C’est utile si votre liste source contient des URL de pages d’entreprise et que vous avez besoin des sites avant de lancer un enrichissement compatible sur les entreprises ou les emails professionnels.
linkedin_accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "https://www.linkedin.com/company/datablist",
}
]
website_results = match_companies(
linkedin_accounts,
api_key,
matching_direction="linkedin_to_domain",
)Une recherche standard à partir d’une page LinkedIn d’entreprise utilise le tarif de matching habituel. Les identifiants numériques d’entreprise et les URL d’entreprise Sales Navigator peuvent consommer 10 crédits, car ils suivent un autre processus de reverse lookup. Pour effectuer cette opération sans code, consultez le guide expliquant comment obtenir les URL de sites depuis des pages LinkedIn d’entreprise.
Estimer les crédits pour la recherche LinkedIn
Une recherche standard et réussie d’un site vers LinkedIn consomme 1,5 crédit. Les cinq correspondances présentées ont donc utilisé 7,5 crédits. Au même tarif, 1 000 correspondances réussies consomment 1 500 crédits. Les entrées invalides et les lignes sans résultat peuvent ne consommer aucun crédit : consultez la valeur creditsUsed de chaque résultat pour connaître l’utilisation réelle.
L’accès à la REST API est inclus dans le plan Growth, et l’abonnement mensuel est distinct des crédits supplémentaires. Une recharge de 20 $ vous donne 20 000 crédits, soit 0,001 $ par crédit. À raison de 1,5 crédit par correspondance réussie, 1 000 correspondances utilisent 1 500 crédits, d’une valeur de 1,50 $. Consultez les tarifs Datablist pour connaître les offres et packs actuels.
Résoudre les problèmes d’entrée, de tâche et de résultat
DATABLIST_API_KEYest absente : le script s’arrête avant d’envoyer une requête. Exportez la variable d’environnement, puis relancez la commande.- L’API refuse la clé : vérifiez que vous avez copié une Personal API Key et que la requête l’envoie uniquement dans
X-API-Key. - L’entrée n’est pas prise en charge : pour
domain_to_linkedin, utilisez un site d’entreprise ou un domaine. Dans l’autre sens, utilisez l’URL compatible d’une page d’entreprise, et non un profil personnel ou une valeur vide. - Le solde de crédits est insuffisant : vérifiez votre solde, puis utilisez les crédits inclus ou ajoutez une recharge avant de créer une nouvelle tâche.
- La tâche est
failedoustopped: examinez son statut, l’erreur, les résultats existants et les crédits consommés avant de décider de la relancer. - Un résultat présente une confiance faible, le statut
no_resultou une erreur : conservez le site source et le résultat complet dansneeds_review. Ouvrez la page candidate lorsqu’elle existe et ne supposez pas la cause d’une absence de résultat.
Si la connexion est interrompue pendant la création de la tâche, utilisez le uniqueId affiché avant le POST. Listez vos tâches et recherchez cette valeur avant d’en créer une autre :
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-to-linkedin" \
--data-urlencode "limit=100"La liste des tâches ne peut pas être filtrée par uniqueId. Examinez donc chaque tâche renvoyée et suivez nextCursor si nécessaire. Une fois la valeur correspondante trouvée, utilisez son @id avec les mêmes URL de statut et de résultats que dans le script.
Une tâche peut contenir jusqu’à 10 000 entrées. Pour connaître toutes les limites relatives aux requêtes, à la conservation des tâches et à la pagination, consultez la documentation de l’API Company to LinkedIn.
Prochaines étapes
Vous disposez maintenant d’une fonction Python Requests réutilisable qui transforme des sites d’entreprise en pages LinkedIn candidates. La file locale conserve les correspondances à forte confiance prêtes pour la recherche et laisse visibles les enregistrements incertains ou sans résultat afin de les vérifier.
Remplacez les cinq exemples par une petite liste de comptes, vérifiez chaque page candidate à faible confiance, puis utilisez les URL validées pour vos recherches manuelles sur les entreprises ou comme entrées de l’API LinkedIn company scraper. Si votre liste source contient des noms d’entreprise plutôt que des sites, commencez par le guide de l’API de recherche de sites d’entreprise.