
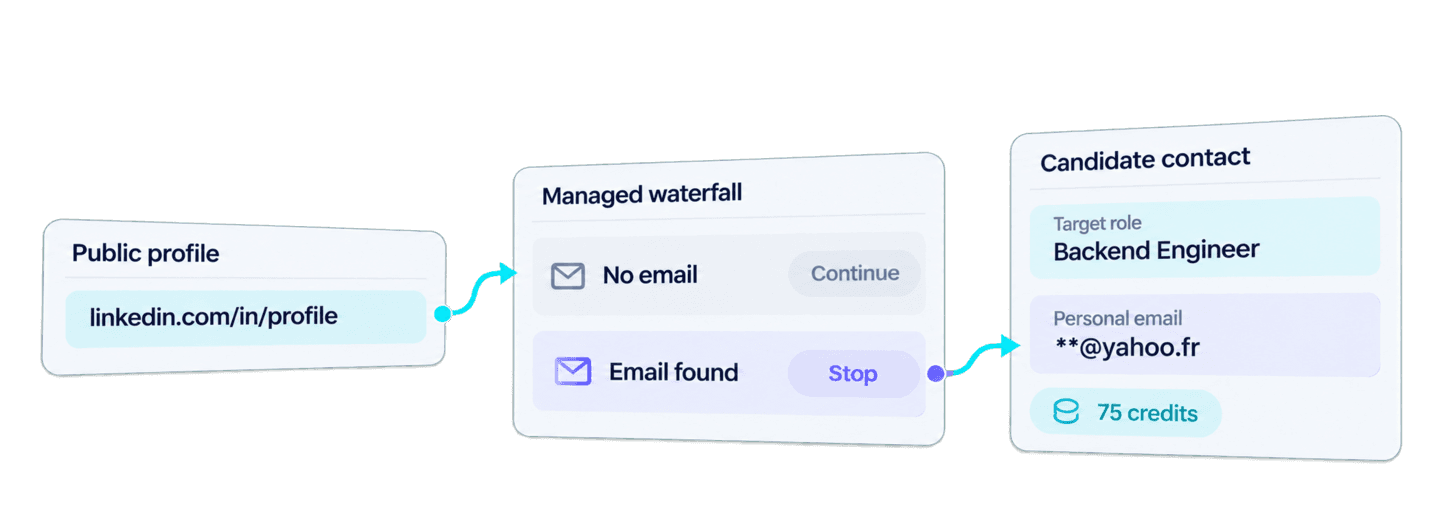
Vous pouvez trouver des adresses email personnelles à partir de LinkedIn avec Python en envoyant des URL publiques de profils linkedin.com/in/... à l’API Waterfall Personal Email Finder de Datablist. L’API interroge successivement plusieurs fournisseurs d’emails éligibles et renvoie une adresse personnelle dès que l’un d’eux trouve un résultat.
L’exemple complet avec Requests ci-dessous soumet une tâche en arrière-plan, attend qu’elle se termine, puis récupère toutes les pages de résultats. Une fois la recherche effectuée, vous réutiliserez les objets renvoyés pour préparer des fiches de contact destinées au recrutement, avec le nom de chaque candidat, son URL LinkedIn et le poste visé à côté de l’adresse trouvée.
Ce workflow recherche une adresse email personnelle indépendante de l’employeur actuel du candidat. Si vous avez plutôt besoin d’une adresse liée à son entreprise, consultez le guide dédié pour trouver un email professionnel depuis un profil LinkedIn.
🔑 L’essentiel pour aller vite
Fournissez les noms des candidats, les URL publiques de leurs profils LinkedIn et les postes visés. Le workflow Python trouve les emails personnels disponibles et associe chaque adresse aux informations de recrutement fournies au départ.
- Entrée : noms des candidats, URL publiques de profils
linkedin.com/in/...et postes visés.- Sortie : emails personnels trouvés, associés aux informations des candidats correspondants.
💡 Vous préférez une solution no-code ? Utilisez le Waterfall Personal Email Finder de Datablist pour trouver des emails personnels sans écrire de code.
Si votre source contient des noms, mais aucune URL de profil, commencez par trouver les profils LinkedIn publics avec Python, puis transmettez ces URL à cette API.
Configurer Python, Requests et votre clé API Datablist
Pour cet exemple, j’utilise Python avec le package requests. Créez un fichier nommé find_personal_emails.py, puis installez Requests :
python -m pip install requestsCréez une Personal API Key dans votre compte Datablist, puis exportez-la comme variable d’environnement :
export DATABLIST_API_KEY='your-api-key'L’accès à la REST API est disponible avec le plan Growth. Chaque email personnel trouvé consomme également des crédits, dont le calcul est détaillé plus bas dans la section consacrée aux coûts.
Trouver un email personnel avec une fonction Python
Dans ce script, la liste modifiable candidates contient une fiche de recrutement. target_role est un exemple de valeur source qui reste dans le workflow de recrutement local. Seuls candidate_id et linkedin_url sont inclus dans le payload de l’API.
import json
import os
import time
import uuid
import requests
def find_personal_emails(candidates, api_key):
"""Submit one task, wait for it to finish, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": candidate["candidate_id"],
"data": {"profileUrl": candidate["linkedin_url"]},
}
for candidate in candidates
]
unique_id = str(uuid.uuid4())
print(f"Recovery uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-personal-email-finder",
"uniqueId": unique_id,
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(f"Task {task_id} {task['status']}: {task.get('error')}")
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
candidates = [
{
"candidate_id": "candidate-florian-poullin",
"name": "Florian Poullin",
"linkedin_url": "https://www.linkedin.com/in/florianpoullin/",
"target_role": "Backend Engineer",
}
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
personal_email_results = find_personal_emails(candidates, api_key)
for result in personal_email_results:
print(json.dumps(result, indent=2))Exécutez le fichier depuis le même terminal :
python find_personal_emails.pyVous pouvez également télécharger l’exemple synchrone avec Requests, qui est régulièrement mis à jour. Le script ci-dessus reprend la même séquence — soumission, polling et pagination — tout en utilisant les identifiants de candidats issus des fiches sources.
Soumettre la recherche
La fonction transforme chaque candidat en entrée pour l’API. inputId reçoit l’identifiant stable du candidat, tandis que data.profileUrl reçoit l’URL publique de son profil LinkedIn. Une URL standard au format linkedin.com/in/... est obligatoire. Les URL Sales Navigator, les pages d’entreprise, les valeurs vides et les noms sans URL de profil ne sont pas des entrées valides pour cet enrichissement.
La requête utilise waterfall-personal-email-finder comme enrichmentId et un objet settings vide, comme indiqué dans la documentation de l’API Waterfall Personal Email Finder. Le script affiche le uniqueId généré avant la soumission. Conservez cette valeur : elle permet d’identifier une tâche existante si la connexion est interrompue après l’acceptation de la requête par l’API.
Voici le body complet de la requête pour cet exemple avec un seul profil :
{
  "enrichmentId": "waterfall-personal-email-finder",
  "uniqueId": "55001d29-4fb9-4fe2-9497-80f4b346eed7",
  "settings": {},
  "inputs": [
    {
      "inputId": "candidate-florian-poullin",
      "data": {
        "profileUrl": "https://www.linkedin.com/in/florianpoullin/"
      }
    }
  ]
}
Une soumission réussie renvoie le statut HTTP 202 Accepted, avec l’identifiant de la tâche dans @id. Le traitement se poursuit ensuite sur les serveurs de Datablist.
Attendre la fin de la tâche en arrière-plan
Le script Requests reste en attente localement pendant que le serveur exécute la tâche en arrière-plan. Il vérifie son état toutes les trois secondes et continue tant que le statut est queued ou running. Lorsque la tâche passe à completed, le script récupère les résultats. Si son statut est failed ou stopped, il lève une erreur contenant l’identifiant de la tâche et le message d’erreur disponible.
Récupérer toutes les pages de résultats
L’endpoint de résultats renvoie, pour chaque ligne, l’identifiant source, le statut, les outputs, les crédits et l’erreur. La première requête demande jusqu’à 100 résultats. Le script récupère chaque page suivante jusqu’à ce que nextCursor soit égal à null.
Les résultats de la tâche conservent l’ordre des entrées. inputId établit toujours un lien explicite entre chaque résultat et la fiche du candidat, y compris lorsque les résultats s’étendent sur plusieurs pages.
Lorsque vous adaptez cet exemple à un plus grand nombre de fiches, conservez un candidate_id stable dans le système source. Cette valeur garantit une jointure fiable lorsque la tâche comporte plusieurs pages de résultats.
Comment le waterfall trouve un email personnel
Datablist nettoie l’URL publique du profil LinkedIn transmise, puis soumet le profil non résolu aux fournisseurs d’emails personnels actuellement éligibles, l’un après l’autre. Si un fournisseur ne renvoie aucune adresse exploitable, le profil peut passer au fournisseur éligible suivant. Dès qu’un fournisseur trouve un email exploitable, la séquence s’arrête pour ce profil et l’adresse est renvoyée dans outputs.emailFound.
Datablist gère les fournisseurs éligibles : votre intégration n’a donc besoin ni de requêtes propres à chaque fournisseur, ni de code de fallback. Le résultat public indique l’email obtenu, sans présenter un ordre fixe des fournisseurs ni l’historique des tentatives.
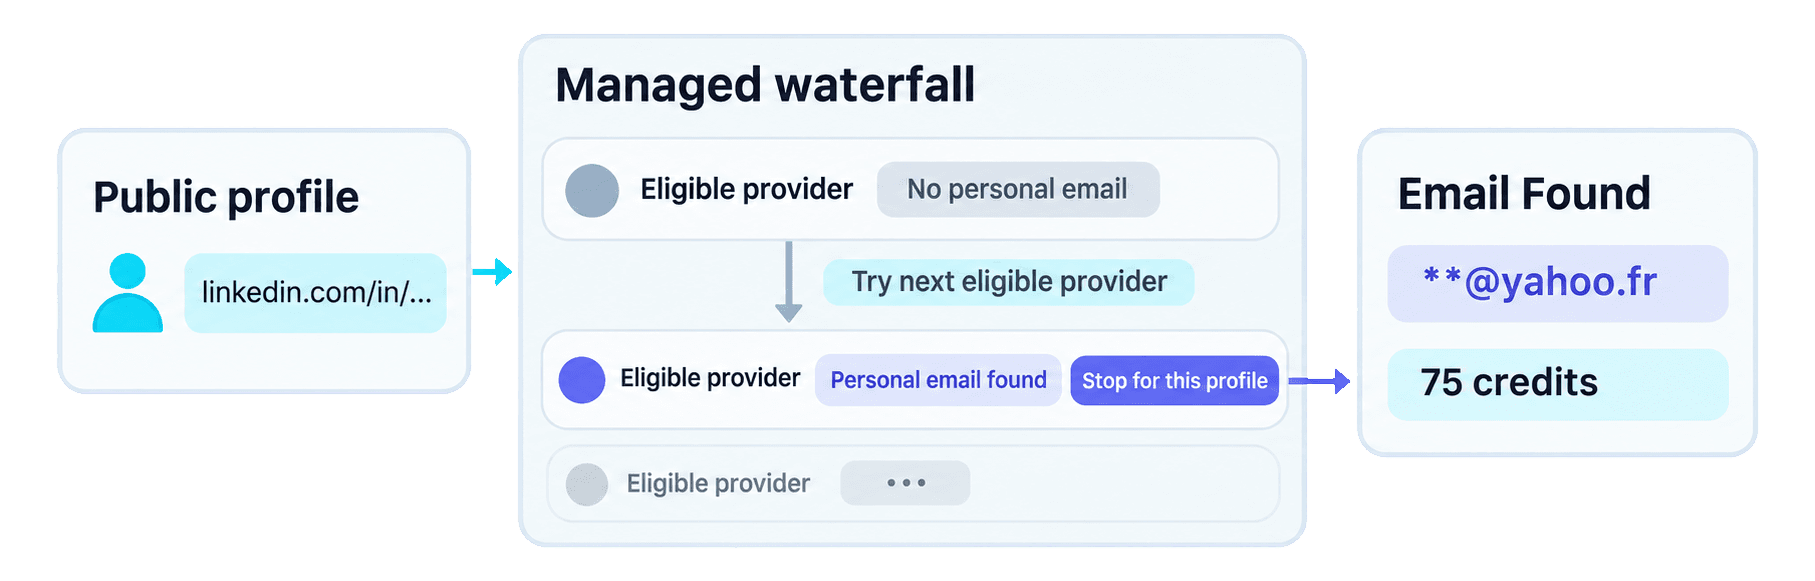
Le waterfall désigne la méthode de recherche. Le polling remplit une autre fonction : il permet au client Python d’attendre la fin de ce traitement en arrière-plan.
Pourquoi le waterfall aide les équipes de recrutement internationales
Les fournisseurs d’emails personnels s’appuient sur des jeux de données différents. Leurs performances varient donc selon les pays et les marchés. Si le premier fournisseur ne dispose d’aucun email pour un candidat, un autre fournisseur du waterfall peut en trouver un.
Les équipes qui recrutent dans plusieurs pays bénéficient ainsi d’une couverture plus large avec une seule intégration API. Datablist gère la séquence, ce qui permet de retrouver des contacts qu’une recherche auprès d’un fournisseur unique pourrait manquer, sans avoir à connecter et maintenir plusieurs API.
Lire le résultat complet
📘 Email masqué : la partie locale de l’adresse est remplacée par
**ci-dessous. Le résultat de votre API contient la valeur complète.
Voici la page de résultats complète pour le candidat fourni en entrée :
{
  "taskId": "b5de73ffaa3f4f349c125d7c85125bb4",
  "results": [
    {
      "inputId": "candidate-florian-poullin",
      "status": "success",
      "outputs": {
        "emailFound": "**@yahoo.fr"
      },
      "creditsUsed": "75",
      "error": null
    }
  ],
  "nextCursor": null
}
inputId est la clé de jointure avec la fiche source du candidat. outputs.emailFound contient son adresse personnelle. creditsUsed indique le coût de référence pour cette ligne, tandis que error: null signifie que l’API n’a renvoyé aucune erreur au niveau de la ligne. Le curseur nul confirme que cette réponse ne comporte aucune page de résultats suivante.
Considérez cette adresse comme un moyen de contact associé au profil transmis et vérifiez-la avant de l’utiliser dans le cadre d’un recrutement.
Préparer les fiches candidats pour les recruteurs
Une fois les résultats disponibles, vous pouvez préparer localement une liste à vérifier par les recruteurs, sans nouvelle requête API. Le bloc suivant réutilise les variables candidates et personal_email_results existantes :
results_by_id = {
result["inputId"]: result for result in personal_email_results
}
prepared_contacts = []
for candidate in candidates:
result = results_by_id.get(candidate["candidate_id"])
if not result or result.get("status") != "success":
continue
email_found = result.get("outputs", {}).get("emailFound")
if not email_found:
continue
prepared_contact = candidate.copy()
prepared_contact["result"] = result
prepared_contacts.append(prepared_contact)
print(json.dumps(prepared_contacts, indent=2))Pour candidate-florian-poullin, la recherche dans le dictionnaire trouve le résultat portant le même inputId. La fiche copiée conserve le nom de Florian Poullin, son URL LinkedIn et le poste cible donné en exemple, Backend Engineer. Elle ajoute ensuite l’objet complet de l’API sous result, où le recruteur peut consulter result.outputs.emailFound.
La boucle part de la liste source des candidats. À l’avenir, une absence de résultat, une erreur de ligne, un résultat manquant ou un champ emailFound vide laissera cette liste source inchangée et n’ajoutera rien à prepared_contacts.
Pour mettre en place un processus de vérification plus complet et utiliser d’autres canaux de contact, consultez le guide pour trouver l’adresse email d’un candidat en tant que recruteur.
Estimer le coût de l’API Waterfall Personal Email Finder
Chaque email personnel trouvé consomme 75 crédits. Une recherche sans résultat ne consomme aucun crédit. Pour connaître votre dépense réelle, consultez creditsUsed dans chaque résultat au lieu de multiplier le nombre total de profils transmis.
La formule de prévision est la suivante :
emails personnels trouvés × 75 crédits
Par exemple, si vous transmettez 100 profils et que 20 recherches aboutissent à un email personnel, la tâche consomme 20 × 75 = 1 500 crédits. Il s’agit d’un simple calcul prévisionnel, et non d’un taux de réussite attendu. Pour des volumes plus importants, 100 emails trouvés consomment 7 500 crédits et 1 000 emails trouvés, 75 000 crédits.
Avec le tarif de recharge de base actuel en dollars, $20 / 20,000 credits = $0.001 per credit. Un email trouvé représente donc $0.075 de crédits, et 100 emails trouvés, $7.50. Cette estimation porte sur la valeur des crédits consommés. L’abonnement Growth requis pour accéder à la REST API est facturé séparément. Consultez les tarifs Datablist pour connaître les offres et packs de crédits actuels.
Corriger les erreurs et récupérer une tâche existante
La plupart des problèmes surviennent avant la soumission, lors de la requête HTTP ou dans un résultat individuel. Identifiez l’emplacement de l’erreur pour choisir l’action adaptée :
- Variable
DATABLIST_API_KEYmanquante : le script s’arrête localement avant d’envoyer une requête. Exportez la variable d’environnement, puis relancez le fichier. - Échec de l’authentification HTTP : vérifiez la Personal API Key enregistrée dans
DATABLIST_API_KEY. La fonction l’envoie dans le headerX-API-Key. Corrigez l’identifiant avant d’effectuer une nouvelle soumission. - URL de profil non prise en charge : remplacez toute URL Sales Navigator, page d’entreprise, valeur vide ou URL incorrecte par un profil personnel public au format
linkedin.com/in/.... - Crédits insuffisants : vérifiez le solde du compte et les crédits disponibles avant de soumettre de nouvelles tâches.
- La tâche porte le statut
failedoustopped: examinez l’erreur de la tâche, les résultats disponibles et les crédits consommés avant de déterminer les éléments à relancer. - Une ligne ne contient aucun résultat ou comporte une erreur : conservez le candidat source pour vérification ou pour utiliser un autre canal de contact. Une recherche infructueuse n’indique pas pourquoi l’adresse était indisponible.
Si vous ne recevez pas la réponse POST, listez vos tâches avant d’en créer une autre. Recherchez dans la réponse le uniqueId affiché par le script, puis copiez la valeur @id de la tâche correspondante :
curl "https://api.datablist.com/v1/enrichments/tasks?enrichmentId=waterfall-personal-email-finder&limit=100" \
--header "X-API-Key: $DATABLIST_API_KEY"
TASK_ID='paste-matching-task-id'
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID" \
--header "X-API-Key: $DATABLIST_API_KEY"
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID/results" \
--header "X-API-Key: $DATABLIST_API_KEY"Si la tâche recherchée ne figure pas dans la première réponse de l’historique, suivez le curseur de pagination renvoyé et consultez la page suivante. Continuez à vérifier la tâche récupérée ou téléchargez ses résultats disponibles au lieu de créer automatiquement une nouvelle tâche payante. La documentation sur les tâches détaille leur cycle de vie, la pagination et la durée de conservation des résultats.
Prochaines étapes
Vous disposez maintenant d’une fonction Python Requests réutilisable pour traiter les URL publiques de profils LinkedIn, ainsi que d’une jointure fondée sur des identifiants stables pour associer chaque email personnel trouvé au contexte source du candidat.
Remplacez la liste d’exemple par une petite sélection de vos candidats, conservez pour chacun un identifiant stable et le poste visé, puis vérifiez chaque contact préparé avant de l’intégrer à votre processus de recrutement. Lorsque votre application aura besoin d’une exécution concurrente non bloquante, appuyez-vous sur l’exemple asynchrone avec HTTPX comme prochaine étape d’implémentation.