
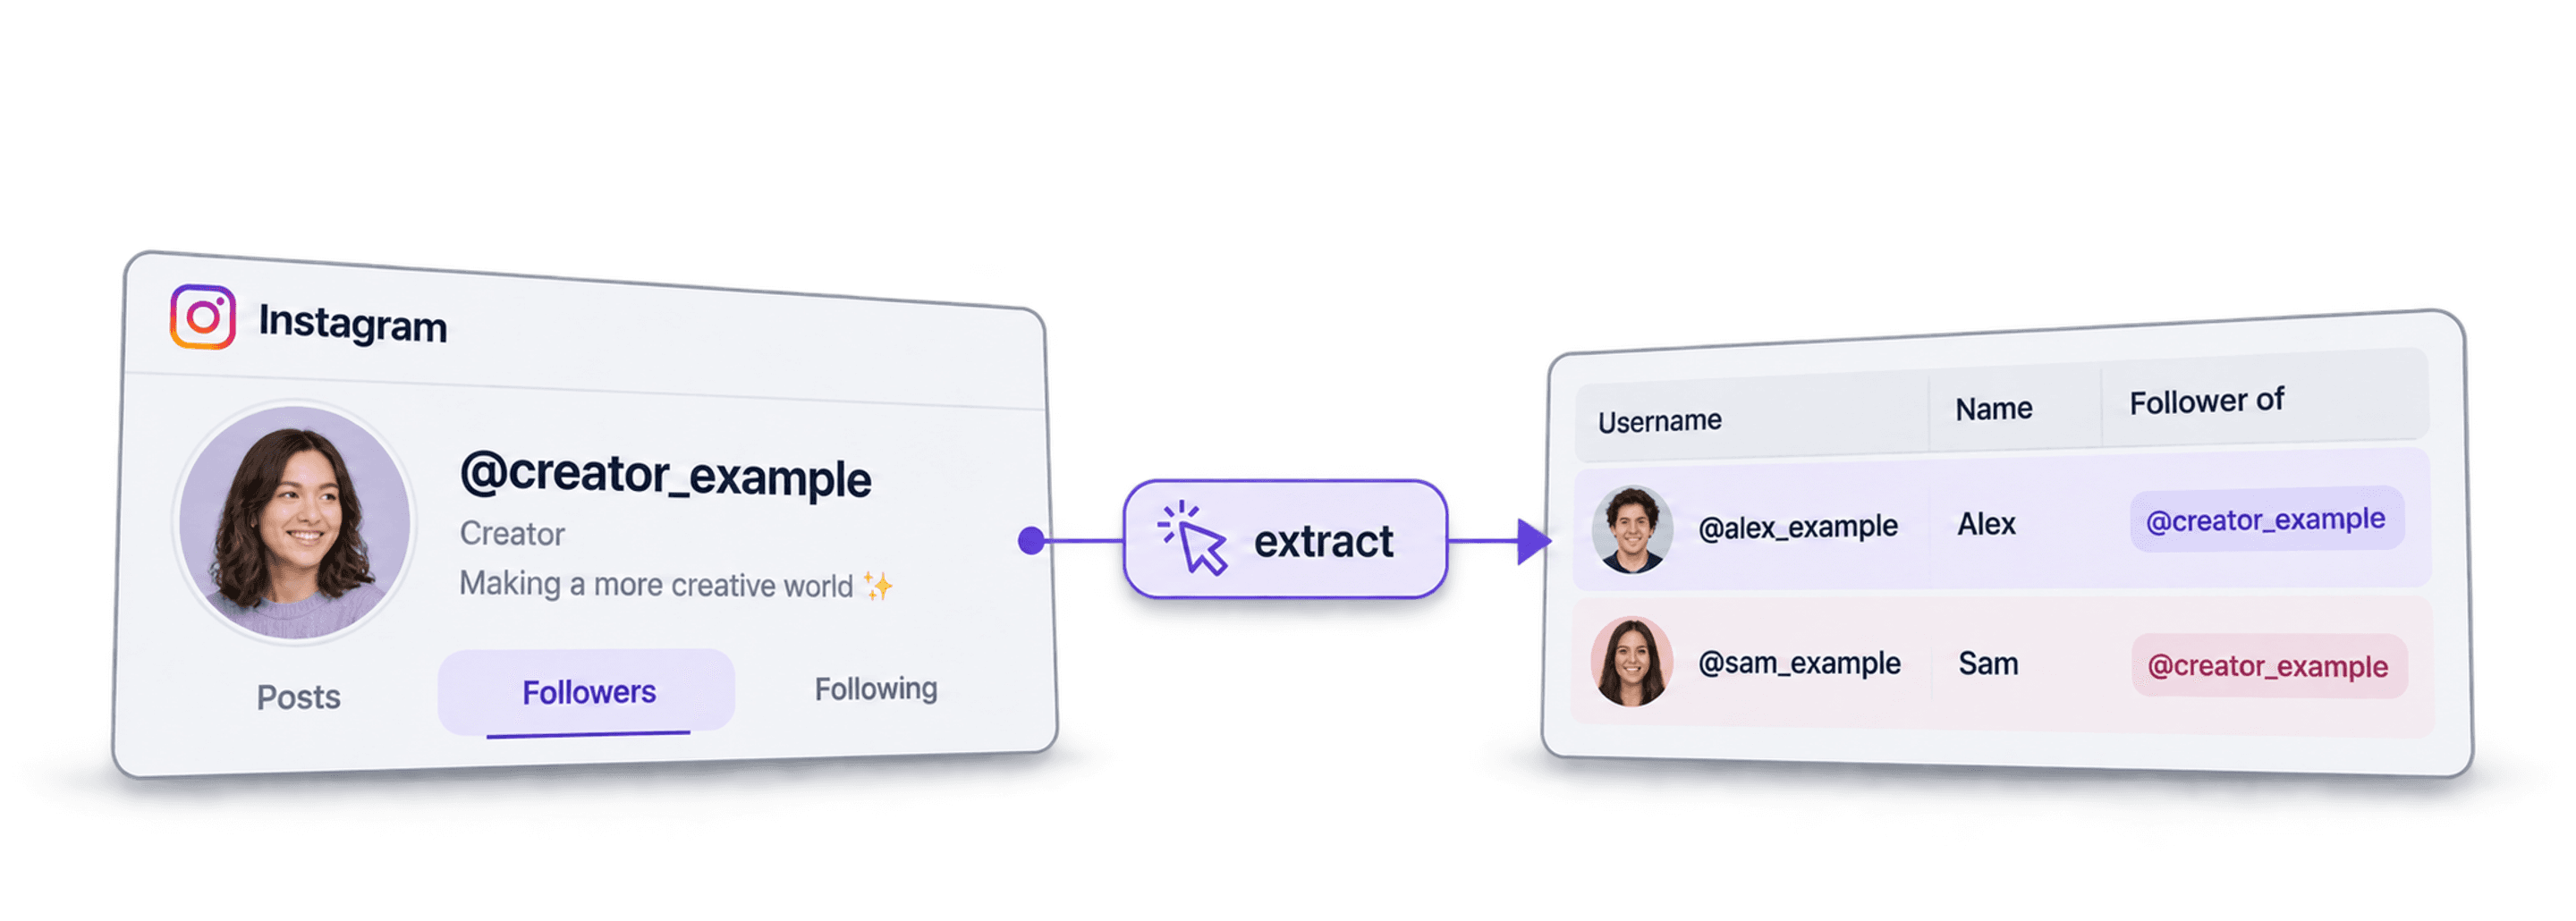
For å skrape Instagram-følgere i Datablist åpner du datakilden Instagram Followers/Following Scraper, oppgir URL-en, brukernavnet eller bruker-ID-en til en offentlig profil, velger en grense per profil og kontrollerer følgeradene før du eksporterer dem.
Jeg ville startet med én profil og en lav grense. Listen du får tilbake, er et øyeblikksbilde av kontoene leverandøren klarte å hente – ikke en garanti for at du får hele den gjeldende følgerlisten. At noen følger en influencer i en bestemt nisje, sier heller ikke nødvendigvis noe om personens yrke, bosted eller kjøpsvilje.
Denne guiden tar for seg innstillinger for datakilden, relasjonsfelter, kontroll og deduplisering, videreføring av større skrapinger og separat enrichment av profildetaljer. Du trenger ikke å oppgi innloggingsinformasjonen din til Instagram.
📌 Rask arbeidsflyt
Opprett en collection, åpne See all sources og velg Instagram Followers/Following Scraper. Skriv inn én profil per linje under Instagram Profiles, behold Followers (default) under Scrape followers or following, og angi Scraping Limit Per Profile. Legg til følgeridentifikatorer og felter for kildeprofilen, kjør en test og kontroller resultatet før eksport.
Hva koster det å skrape Instagram-følgere?
Det koster 0,01 credits per returnerte følger å hente en følgerliste. Oppslag av kildeprofilen kan koste 1 ekstra credit dersom identifikatoren ikke ligger i hurtigbufferen. Enrichment av profildetaljer belastes separat.
La oss ta et eksempel der én kildeprofil returnerer nøyaktig 1 000 følgere:
- Følgerliste: 1 000 × 0,01 = 10 credits, pluss 1 for oppslag av en kilde som ikke er hurtigbufret: 11 credits.
- Detaljer for 100 utvalgte følgere: Med de returnerte User Id-verdiene koster standardoppslaget av profiler 2 credits per profil: 200 credits. Dette alternativet kan returnere offentlig e-postadresse og telefonnummer når opplysningene er tilgjengelige, men ingen av delene er garantert.
- Totalt: 211 credits for listen og de 100 profiloppslagene. Kostnaden for enrichment endres dersom du legger til About-data eller velger en annen scraping type.
Med månedlig fakturering i USD koster Starter $25 og inkluderer 5 000 credits. Hvis hele kvoten er tilgjengelig ved start, krever dette eksemplet ingen ekstra credits og etterlater 4 789 credits. Abonnementet på $25 er beløpet du betaler, mens 211 credits er forbruket i arbeidsflyten. Credits har ikke én fast dollarverdi på tvers av abonnementer og tilleggspakker.
Bruk den returnerte User Id-verdien i dette eksemplet på profil-enrichment. Et brukernavn eller en URL kan kreve et nytt identifikatoroppslag. Kontroller antallet returnerte rader og credit-forbruket etter testen. Leverandørens sider kan overskride en lav angitt grense, og et profiloppslag kan bruke credits selv om ingen følgere returneres. Den angitte grensen er derfor ikke et nøyaktig kostnadstak.
Hva er Datablist? Kort oversikt
Datablist er et regnearkbasert arbeidsområde for lead generation. Her kan du samle inn, kontrollere, enrichere og eksportere rader ved hjelp av enrichments, blant annet AI Agents, Email Finders, AI processors og Technology enrichments.
I tillegg lar Datablist deg konfigurere automatiserte arbeidsflyter som kjøres etter en tidsplan eller ved behov. Her er noen praktiske bruksområder Datablist-brukere setter pris på:
- Bygge lead-lister
- Tilpasse e-poster med AI
- Rydde og deduplisere CRM-data
- Skrape stillingsannonser
- Skrape leads fra Sales Navigator
Slik skraper du Instagram-følgere billig – trinn for trinn
Da setter vi i gang. Først logger du inn i Datablist og konfigurerer hva du vil skrape. Det vil si at du limer inn profil-URL-ene eller brukernavnene til influencerne du ønsker å hente følgere fra.
Konfigurer først en test, og utvid deretter kjøringen når du har kontrollert kildeprofilen og de returnerte feltene. Du trenger verken en nettleserutvidelse eller din egen API-nøkkel fra leverandøren til denne arbeidsflyten.
📘 Viktig: Private profiler
Følgerlisten til en privat profil er ikke tilgjengelig gjennom denne arbeidsflyten. En kjøring kan bruke credits på å slå opp en profil selv om ingen følgere returneres. Enrichment av profildetaljer er et separat oppslag og gir ikke tilgang til private innlegg eller følgerlister.
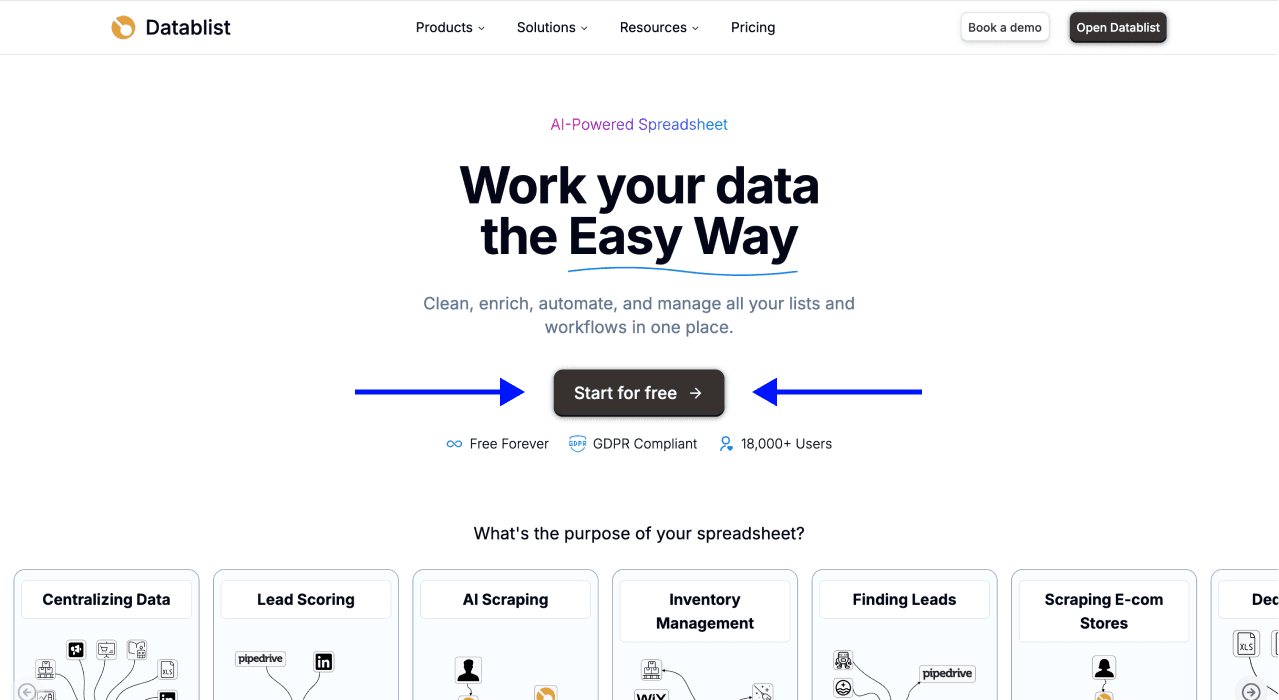
Trinn 1: Registrer deg på Datablist.com
Gå til Datablist.com, og opprett en konto. Følg registreringsprosessen for å åpne arbeidsområdet ditt.
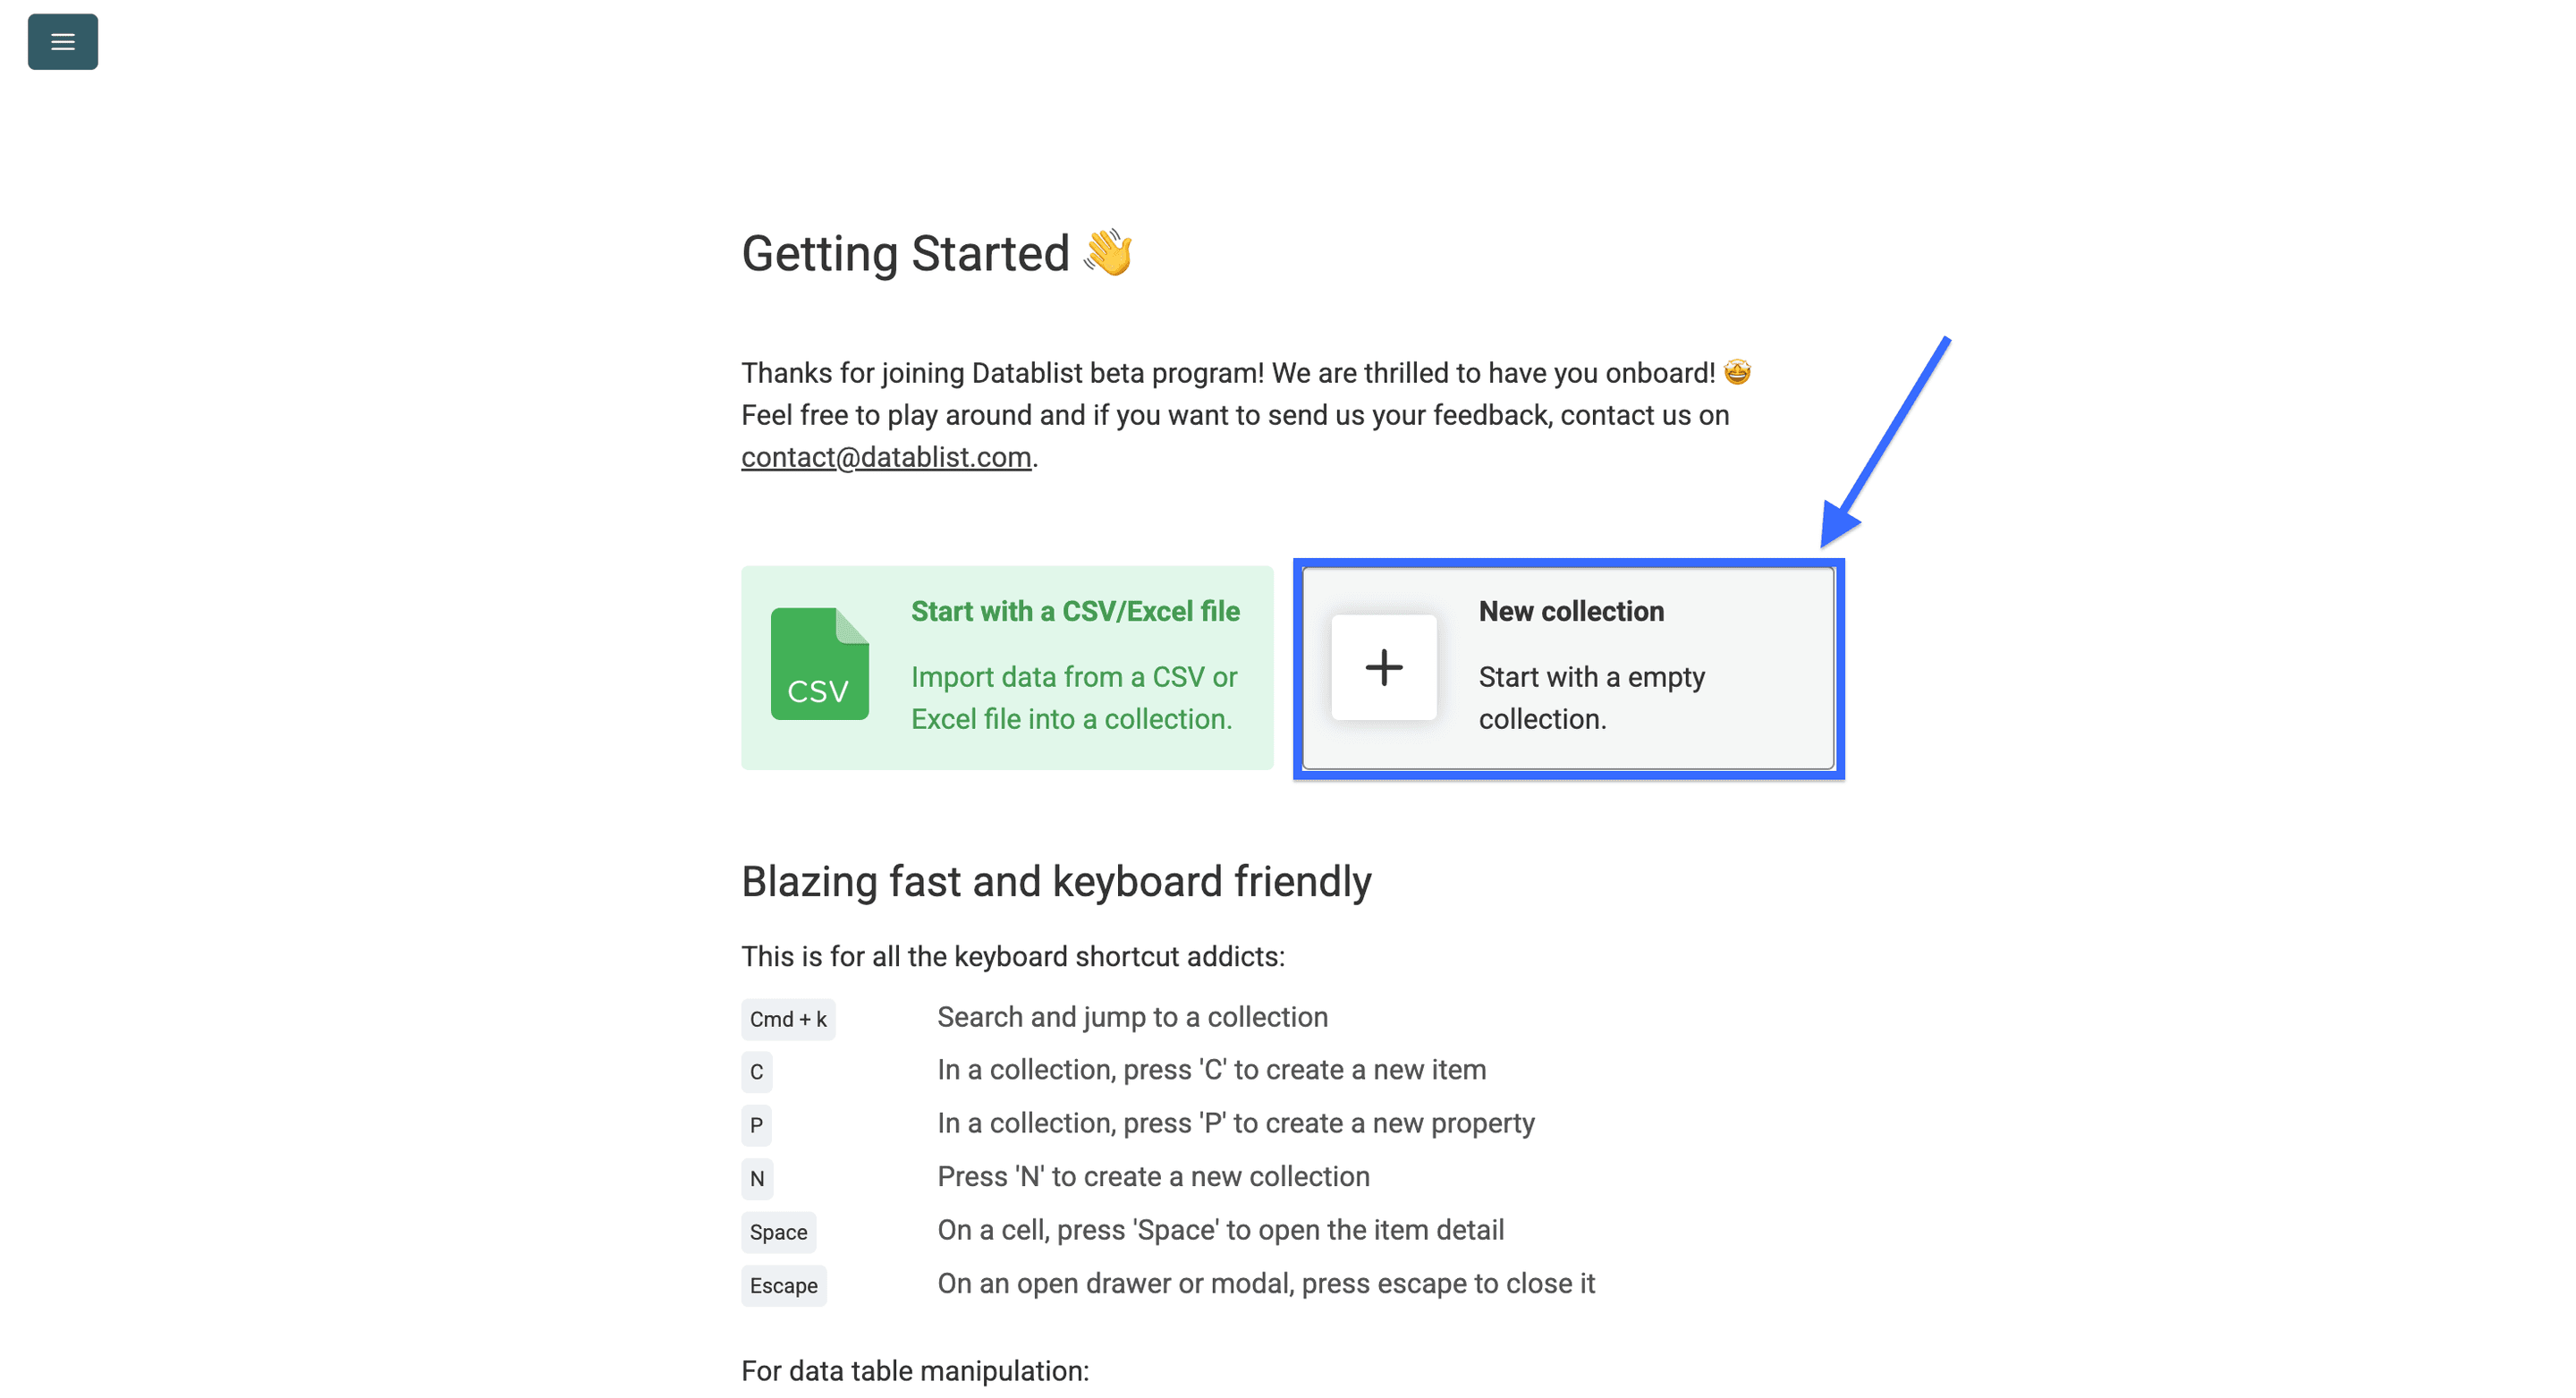
Trinn 2: Opprett en ny collection
Når du er inne, klikker du på New Collection.
Trinn 3: Åpne Instagram Followers/Following Scraper
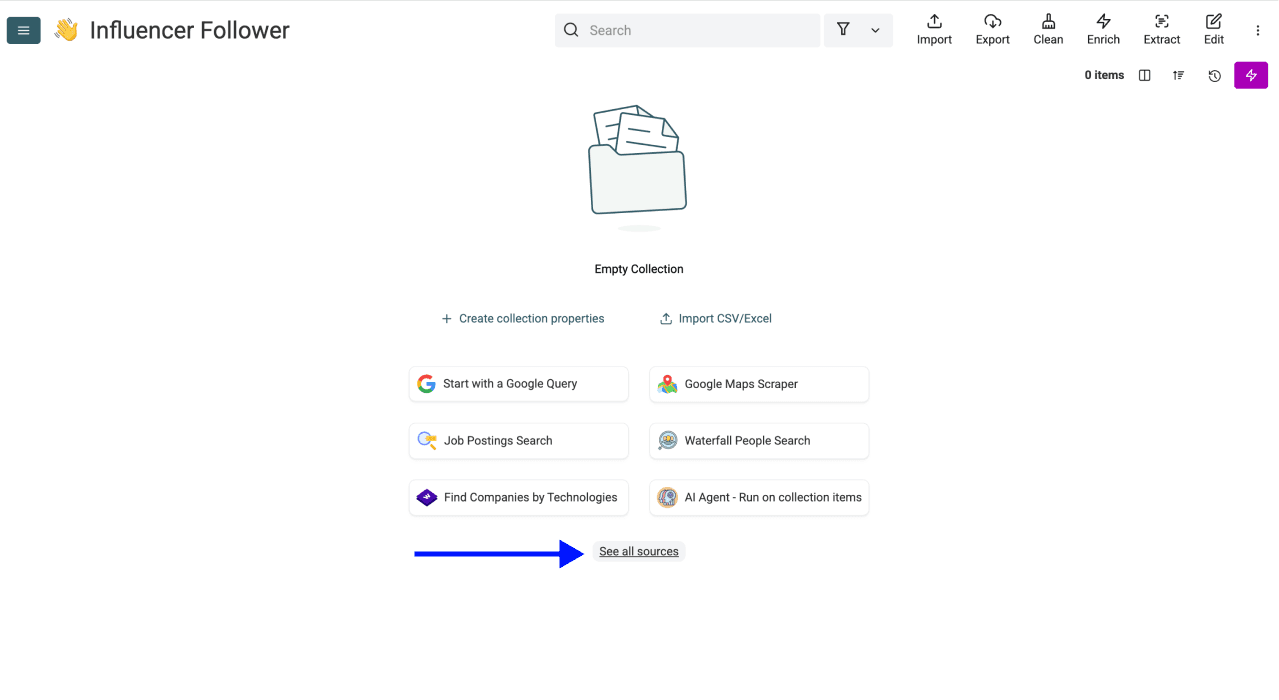
Klikk på See all sources.
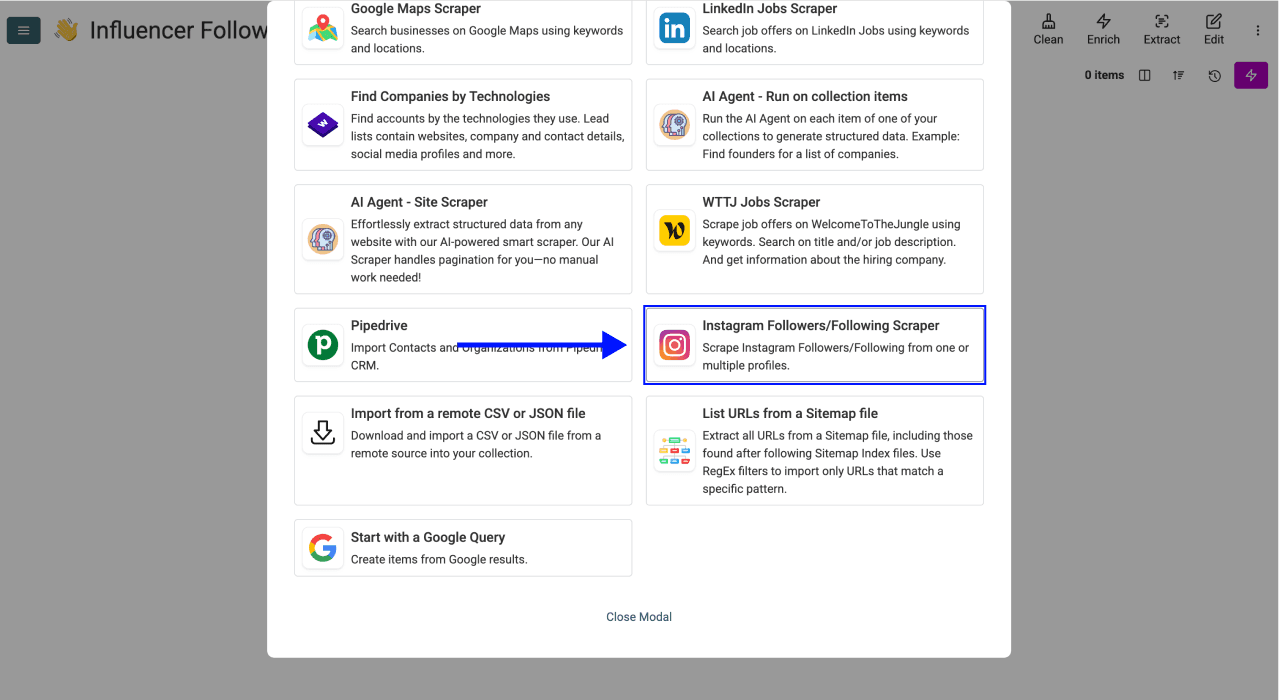
Rull ned, og velg Instagram Followers/Following Scraper fra listen.
Trinn 4: Konfigurer innstillingene
Du får opp et enkelt konfigurasjonsvindu. Slik får du best mulig resultat:
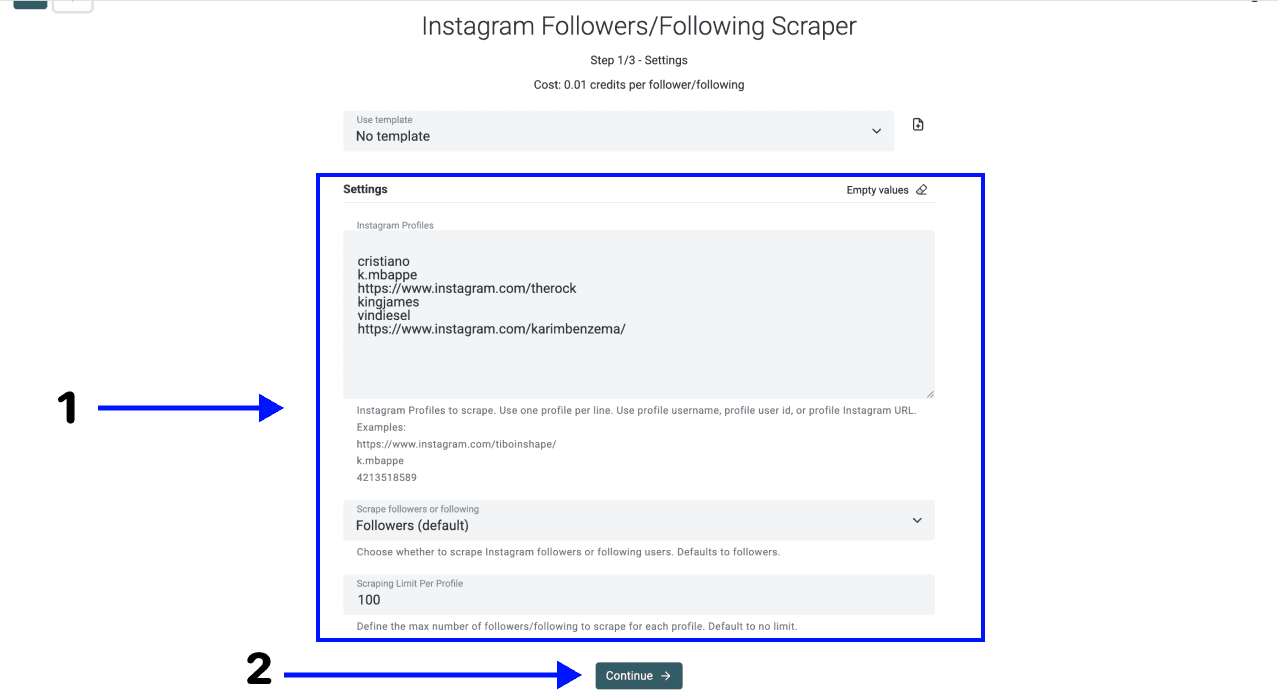
- Under Instagram Profiles skriver du inn én offentlig profil-URL, ett brukernavn eller én bruker-ID per linje. Kontroller at hver identifikator tilhører riktig konto.
- Under Scrape followers or following velger du Followers (default). Velg bare Following dersom du vil hente kontoene som den oppgitte profilen følger.
- Sett Scraping Limit Per Profile til et lavt testantall før du utvider kjøringen. En grense er ingen garanti for at listen blir komplett.
- Klikk på Continue, og konfigurer kolonnene som skal returneres.
Trinn 5: Velg feltene du vil hente
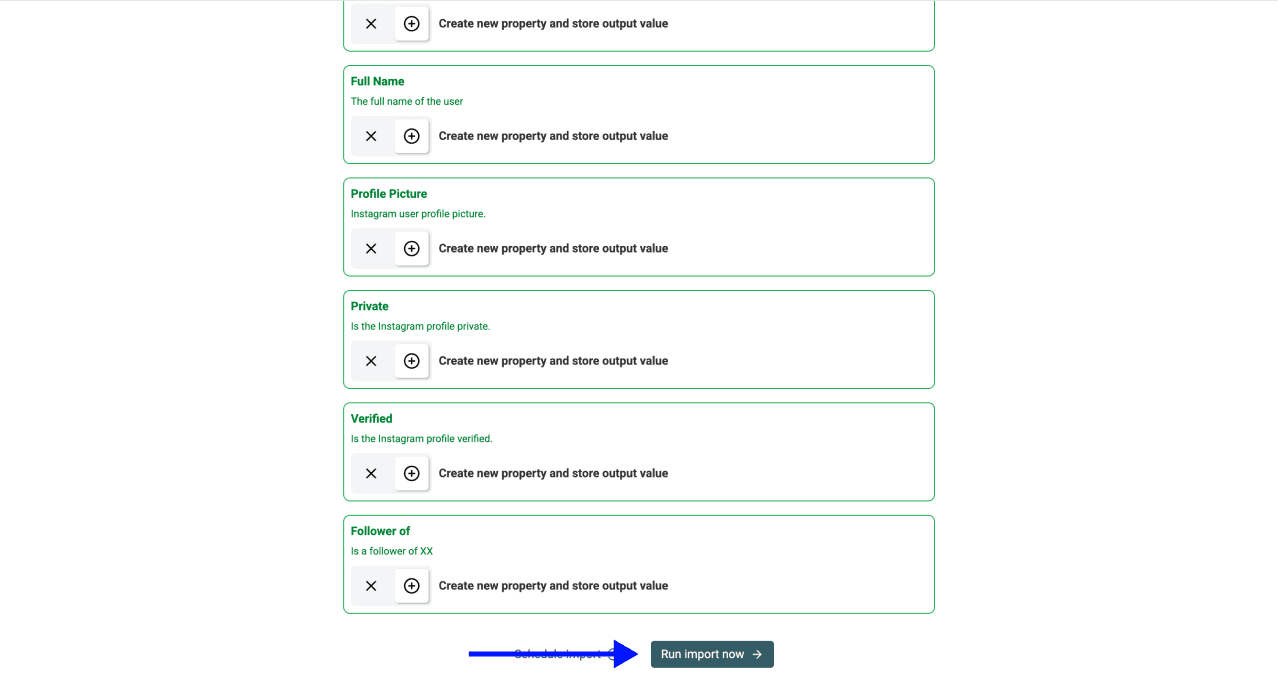
Datablist viser de tilgjengelige feltene. Behold følgerens User Id, User Username og User Profile URL samt feltene for kildeprofilen. Da kan du kontrollere hvem hver rad representerer, og hvilken profil som var utgangspunktet.
Klikk på ✕-ikonene for å fjerne feltene du ikke trenger. Klikk deretter på Run import now.
Trinn 6: Hent resultatene
Når kjøringen er ferdig, sammenligner du antallet returnerte rader med grensen du anga, og kontrollerer statusen. Tidsbruken avhenger av leverandørens responser, paginering, profilen og størrelsen på kjøringen. Ikke gå ut fra at et lavt antall rader betyr at profilen ikke har flere følgere.
Merk: Resultatene inneholder også fulle navn. Vi har skjult dem i bildet nedenfor for å ivareta personvernet.
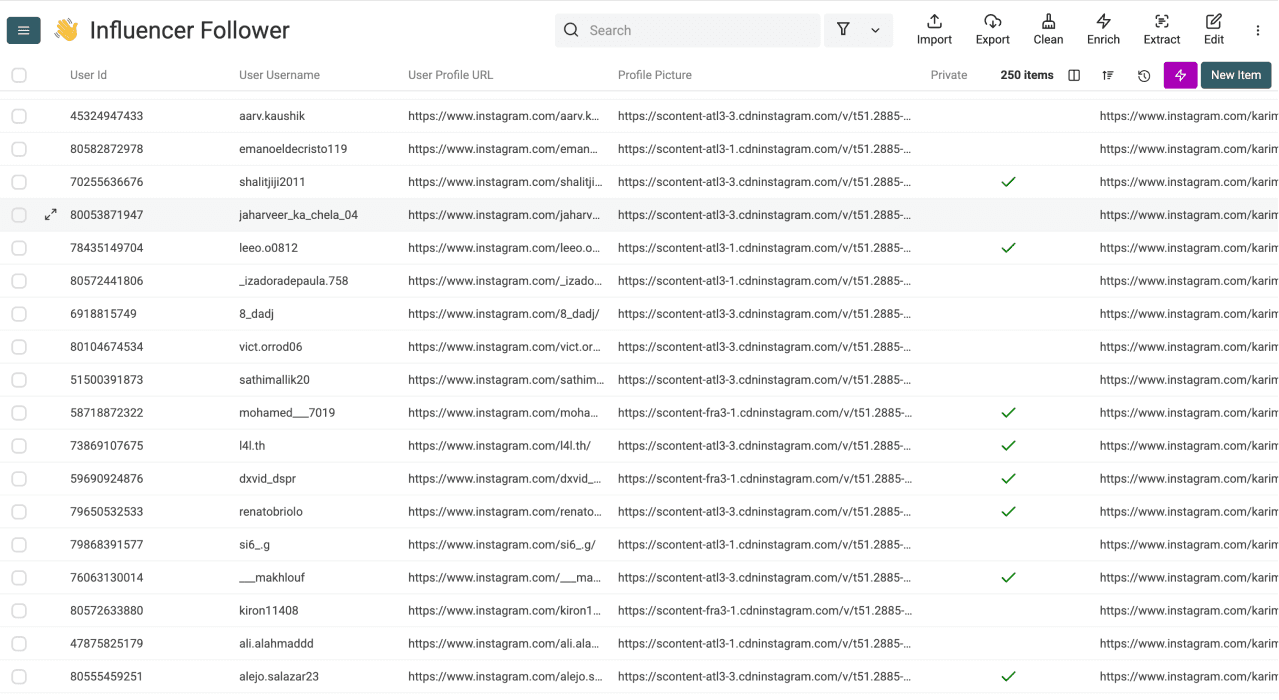
Hvis du bruker flere kildeprofiler, bør du beholde Follower of (UserId), Follower of (Username) eller Follower of (ProfileUrl). Bruk disse feltene til å filtrere relasjonene etter kildekonto i stedet for å basere deg på kolonneplasseringen.
💡 Greit å vite: Store skrapinger
Kjøringen av datakilden har egne grenser for paginering og antall rader. Disse er uavhengige av lagringsplassen i collection og synkroniseringen mot skyen. Hvis en kjøring stopper mens flere resultater er tilgjengelige, bruker du funksjonen for å fortsette nedenfor. Ikke gå ut fra at alle gjenværende følgere får plass i samme kjøring.
Trinn 7: Enrich følgerne med profildetaljer
Å hente en følgerliste er bare begynnelsen. Skal brukernavnene bli nyttige leads, må du vite hvem personene er. Med Instagram Profile Scraper kan du enrichere listen med offentlige data som e-postadresser, biografier og engasjementstall.
Når du bygger lead-lister, bør du bruke profildetaljer som grunnlag for segmenteringen. En følgerrelasjon alene er ikke et pålitelig kvalifiseringskriterium.
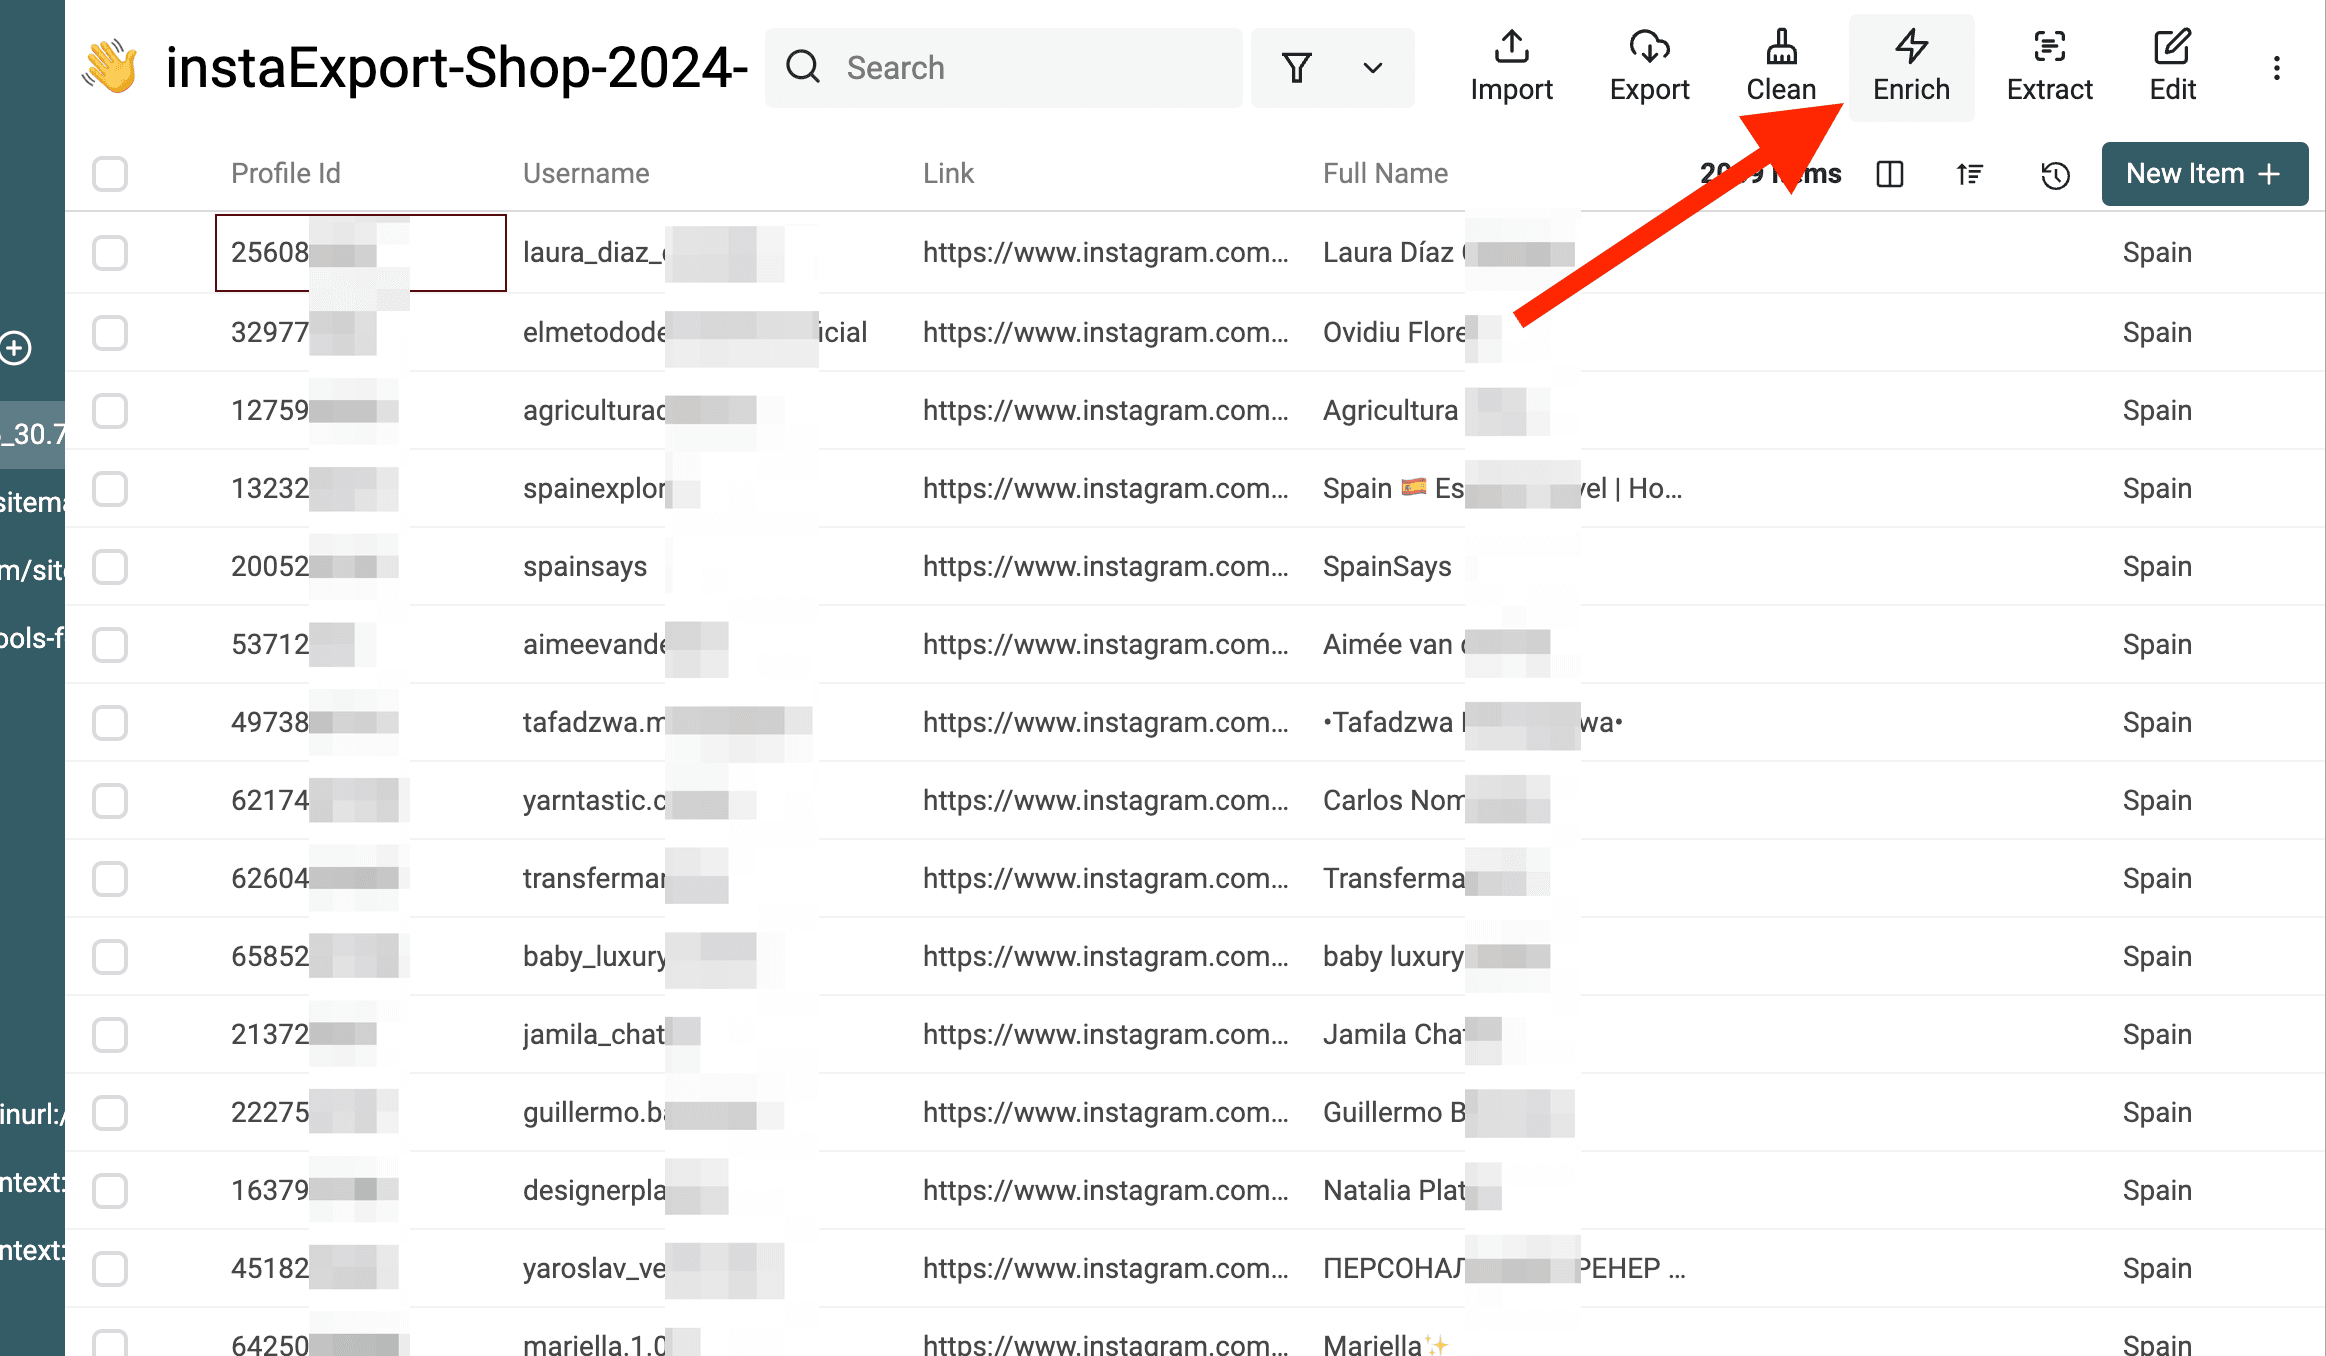
1. Åpne Enrich-menyen I collection med de skrapede følgerne klikker du på Enrich øverst i kontrollpanelet.
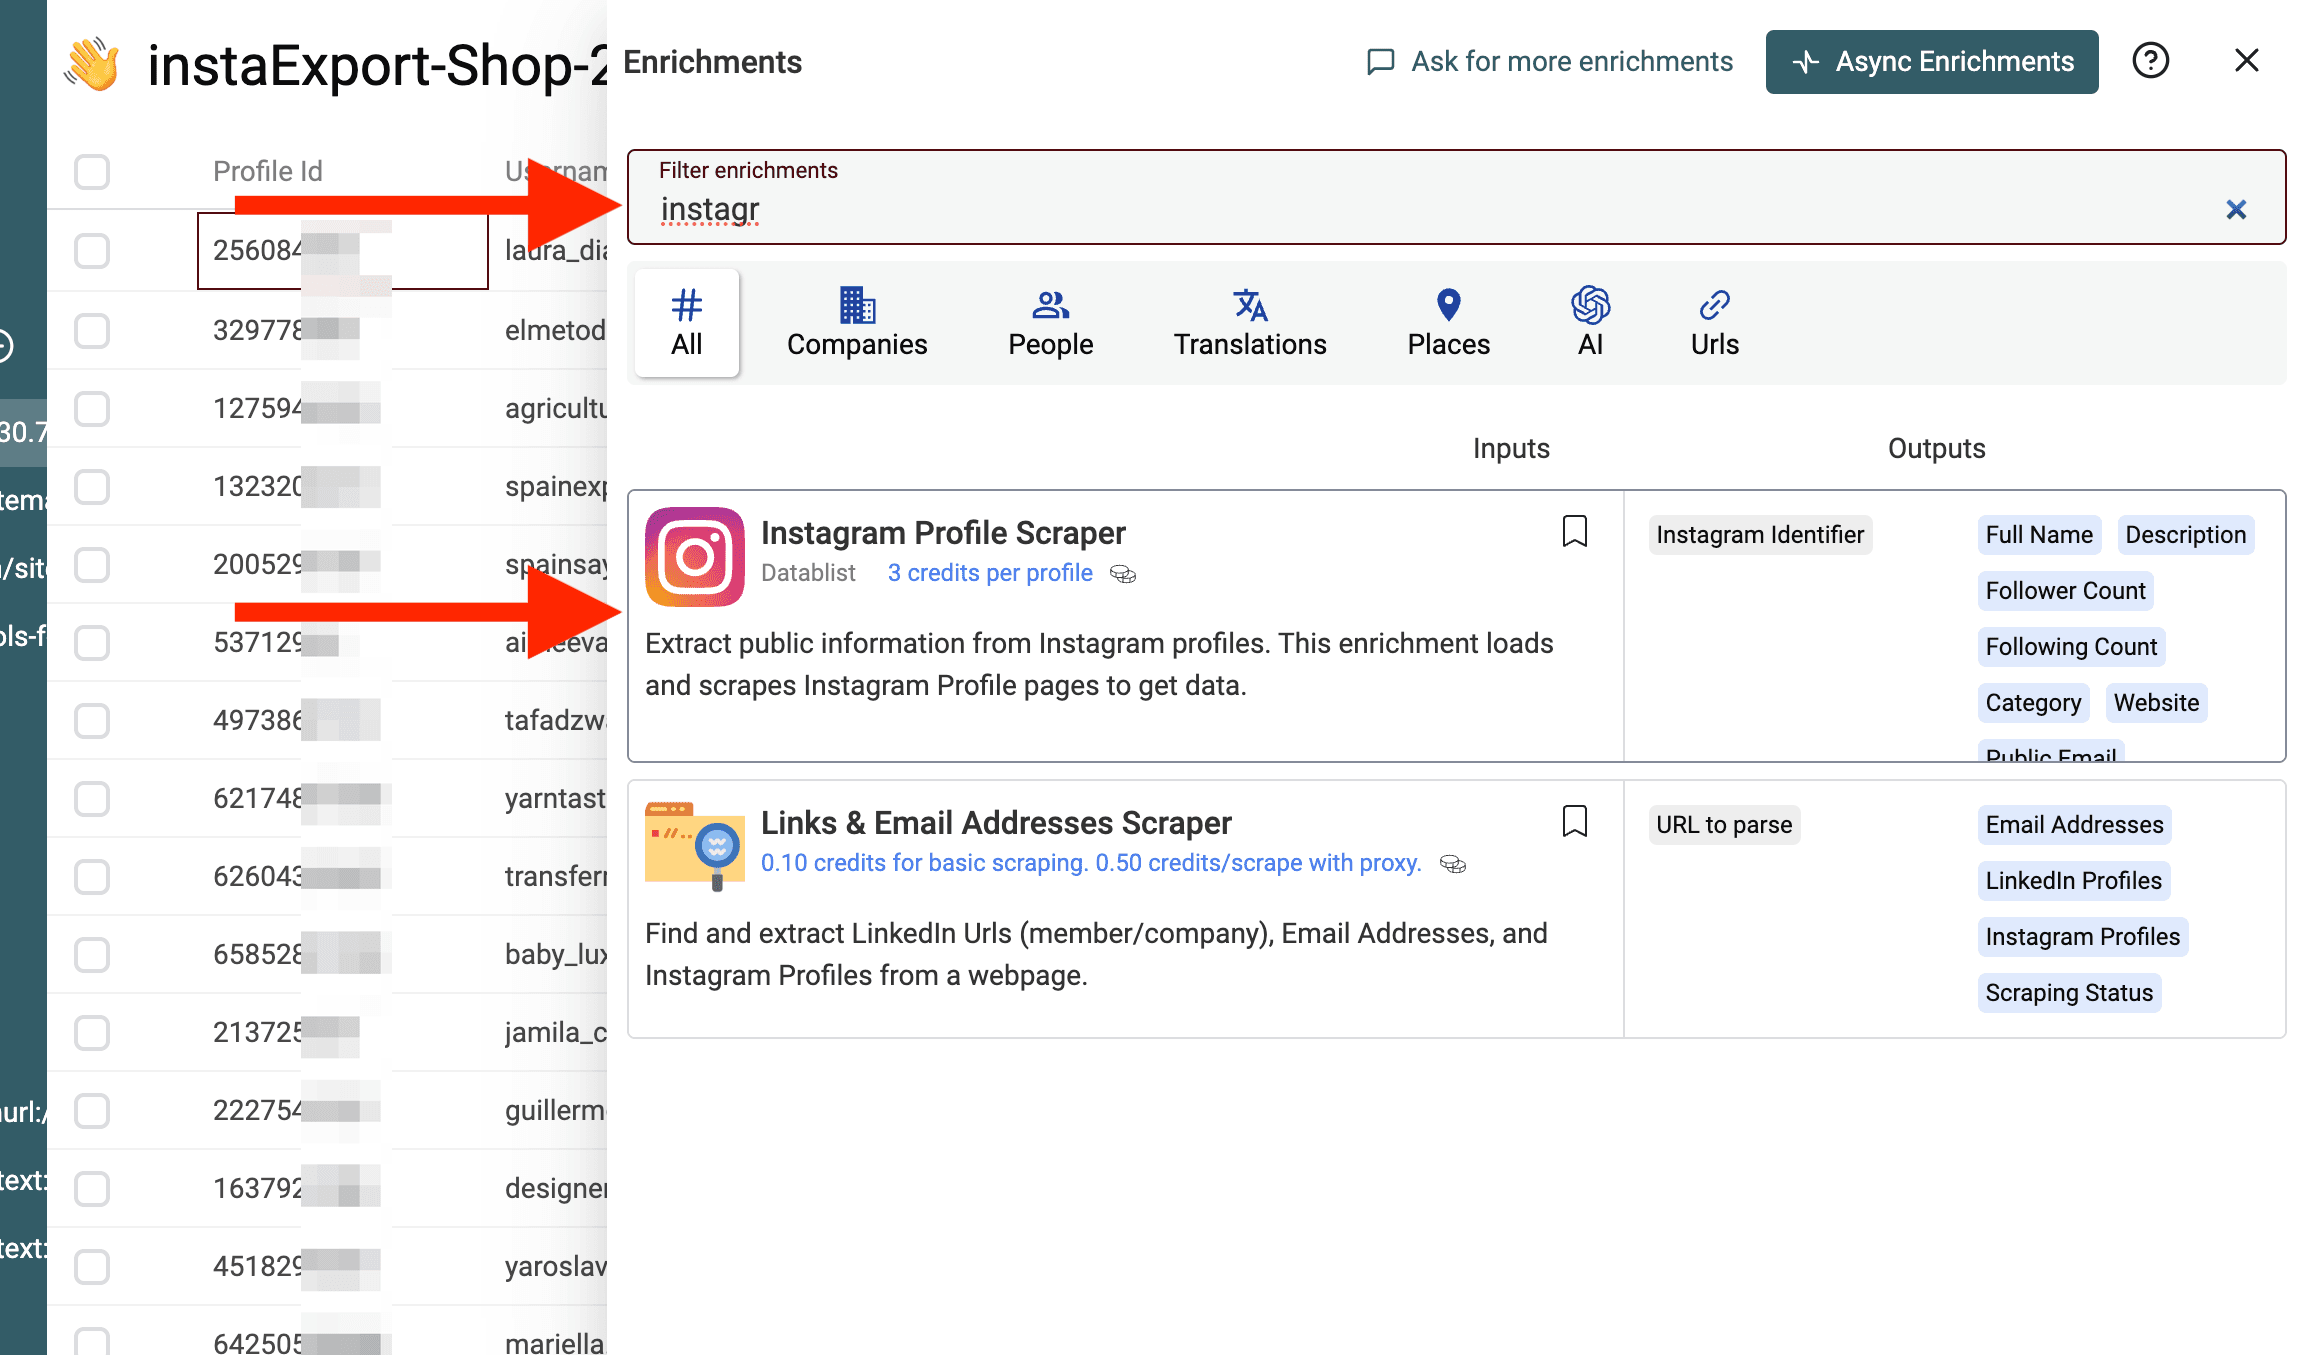
2. Velg Instagram Profile Scraper Søk etter Instagram Profile Scraper, og velg den. Denne enrichment-funksjonen bruker profilidentifikatorene fra kilderesultatene til å hente flere profilfelter. Hvilke data som er tilgjengelige, avhenger av valgt scraping type og hva leverandøren kan returnere.
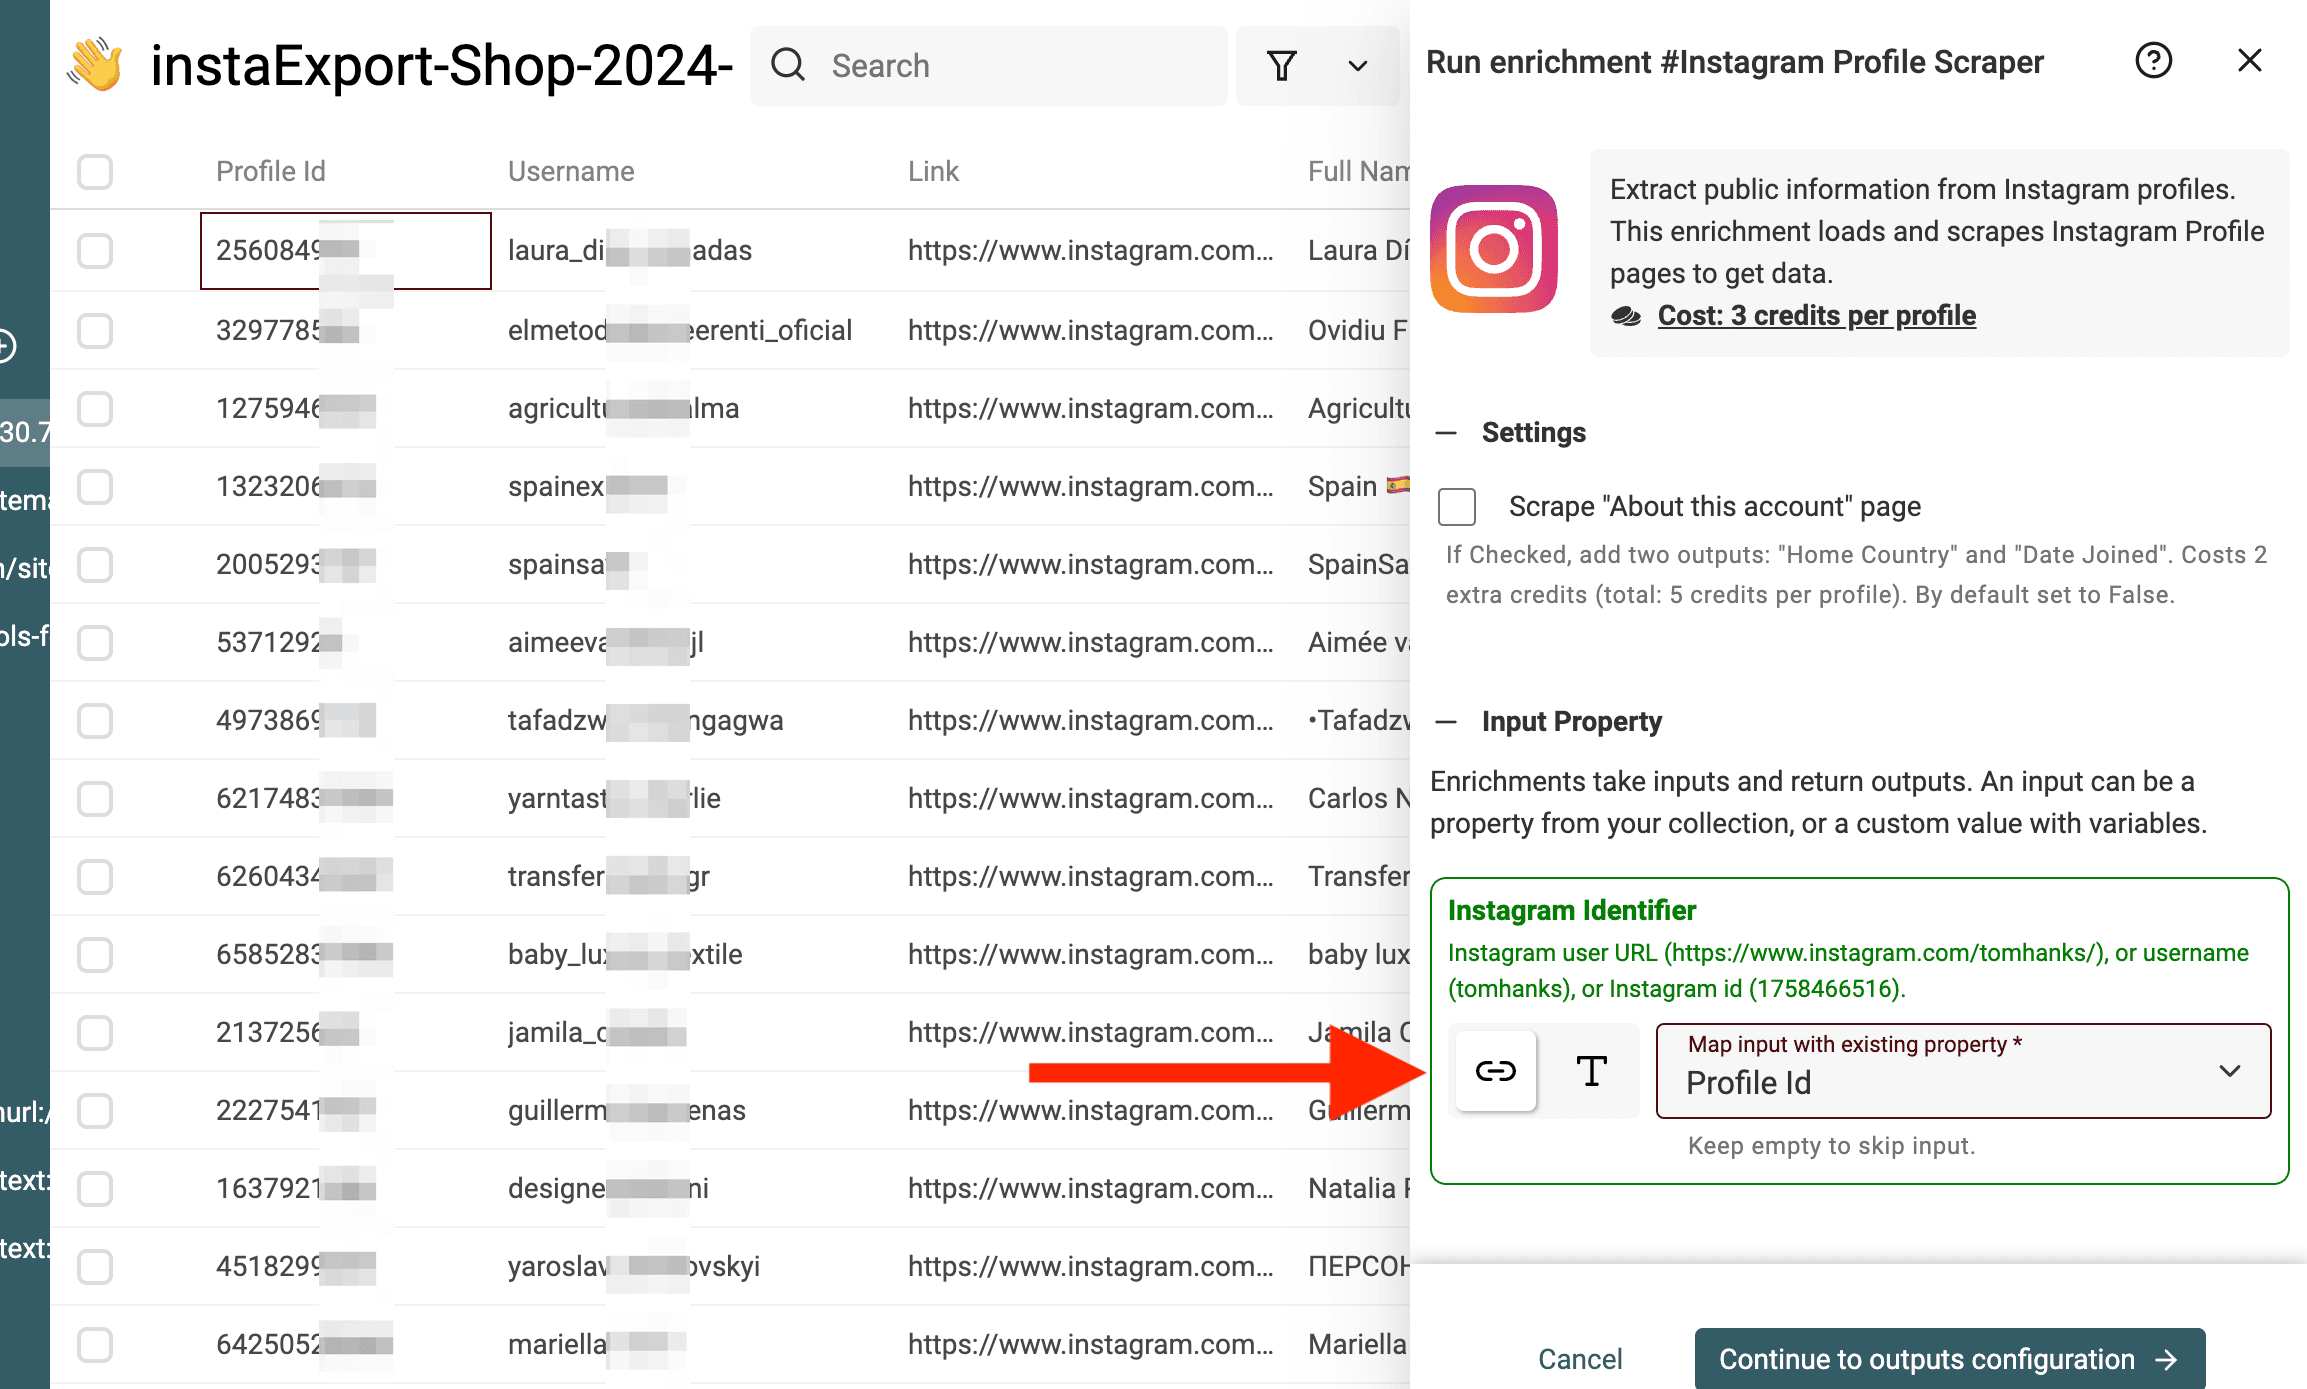
3. Koble datakolonnene Fortell Datablist hvilken kolonne som inneholder brukernavnene. Koble kolonnen Instagram Username eller Profile URL fra trinn 6 til scraperens inndatafelt.
4. Velg feltene du vil legge til Velg datapunktene du vil legge til i collection.
Koble feltene du trenger, til nye kolonner slik at de opprinnelige følgeridentifikatorene beholdes.
Du kan blant annet hente:
- Public Email: Hent e-postadresser direkte fra bedriftsprofiler.
- Description: Bruk feltet til å filtrere dataene etter bestemte stillingstitler eller interesser.
- Follower Count: Skill mellom «micro-influencere» og vanlige brukere.
- Website: Hent lenken fra biografien for videre bedriftsresearch.
5. Kjør enrichment
Velg den Scraping Type som returnerer feltene du trenger, og kjør deretter en test. Alternativet som bare henter offentlige profildata, inkluderer ikke e-post- eller telefonfelter. Profilalternativet kan returnere en offentlig e-postadresse eller et telefonnummer dersom brukeren har oppgitt dette, men feltene kan fortsatt være tomme. Kontroller de tilgjengelige innstillingene og det estimerte credit-forbruket før du behandler resten.
Når enrichment er ferdig, kontrollerer du Enrichment Status og eventuelle manglende felter. En manglende offentlig e-postadresse skal forbli tom. Det beviser ikke at personen ikke har en e-postadresse. Du kan deretter bruke Data Extractor hvis e-postadresser ligger skjult i biografiteksten i stedet for i det offisielle e-postfeltet.
Kontroller overlapp og fortsett en større skraping
Hold disse to datasettene atskilt:
- Følgerrelasjoner: Én rad per kombinasjon av følger og kildeprofil. En person som følger to av profilene du har oppgitt, kan legitimt forekomme to ganger.
- Unike profiler: Én rad per User Id når du bare vil enrichere hver person én gang. Behold informasjonen om hvilke kildeprofiler personen følger, før du fjerner duplikater.
Tenk deg for eksempel at User Id 101 følger både konto A og konto B. Det utgjør to relasjoner, men bare én profil. Hvis du dedupliserer kun etter User Id, mister du én kilderelasjon med mindre du først samler denne konteksten.
Jeg ville kontrollert manglende ID-er, gjentatte kombinasjoner av kilde og følger samt uventet få resultater før enrichment. Velg et representativt utvalg av profiler, og undersøk Description, Website og eventuelle returnerte e-postfelter. Ikke kategoriser alle som følger en treningskonto, som treningsprofesjonelle.
Hvis en tidligere kjøring har en lagret fortsettelse, åpner du innstillingene for datakilden og bruker Continue a previous scrape. Tilgjengelige oppføringer er knyttet til det gjeldende arbeidsområdet og oppbevares i sju dager. Den valgte oppføringen bruker samme kildeprofil og scraping type. Du trenger ikke å erstatte dem med nye profilopplysninger.
Når datakilden når grensen for en collection, fortsetter du i en annen collection i samme arbeidsområde som anvist i innstillingen. Hvis fortsettelsen ikke lenger er tilgjengelig, kontrollerer du kildekjøringen før du starter på nytt. En ny skraping kan overlappe med et tidligere øyeblikksbilde. Sammenlign derfor identifikatorene, og behold konteksten for kilde og collection.
Lagre en Checked At-dato sammen med hver batch, og eksporter de kontrollerte resultatene som CSV eller Excel. Et endret følgertall er ikke et bevis på at uttrekket er komplett. Følgerlisten kan endre seg mellom sider og kjøringer.
Konklusjon
Start med en offentlig profil og en lav grense, behold identifikatorene for både følgeren og kildeprofilen, og kontroller relasjonene før du enricher eller eksporterer dem. Bruk en lagret fortsettelse når den er tilgjengelig for større kjøringer.
Åpne Datablist for å prøve den samme arbeidsflyten med en profil som er relevant for prosjektet ditt.
Vanlige spørsmål om skraping av Instagram-følgere
Er det lovlig å skrape Instagram-følgere?
At data er offentlig synlige, betyr ikke automatisk at du har tillatelse til å samle dem inn eller bruke dem på nytt. Les Instagrams gjeldende vilkår og reglene som gjelder for bruksområdet ditt, før du samler inn følgerdata.
Kan jeg skrape følgere fra flere influencere samtidig?
Ja. Skriv inn én identifikator per linje under Instagram Profiles. Datakilden behandler kontoene du oppgir, og inkluderer felter som viser relasjonen til kildeprofilen sammen med de returnerte radene. Kjøretid og fullføringsgrad kan variere mellom kontoene.
Kan jeg skrape følgere fra private Instagram-profiler?
Nei. Denne arbeidsflyten gir ikke tilgang til følgerlisten til en privat profil. Oppslag av profildetaljer er en separat enrichment og kan ikke brukes til å låse opp begrensede følgerdata.
Hvor raskt kan jeg skrape Instagram-følgere?
Det finnes ingen fast behandlingstid som gjelder for alle profiler. Kjør en liten test, og kontroller faktisk tidsbruk, returnerte rader og credit-forbruk før du utvider kjøringen.
Hva skjer hvis jeg skraper mer enn 100 000 følgere?
Behandle grensen for kildekjøringen og lagringsplassen i collection som to separate begrensninger. Datakilden kan stoppe før hele følgerlisten er hentet. Bruk en tilgjengelig fortsettelse i en annen collection når du får beskjed om det, og eksporter hver fullførte batch. Ikke gå ut fra at importkapasiteten i en collection tilsvarer uttrekkskapasiteten til datakilden.
Hvilke data får jeg når jeg skraper Instagram-følgere?
Du kan velge mellom en rekke profilfelter for hver følger, blant annet:
- User Id: Instagrams interne brukeridentifikator
- User Username: Følgerens brukernavn på Instagram
- User Profile URL: Direkte lenke til Instagram-profilen
- Full Name: Visningsnavnet på profilen
- Profile Picture: URL til profilbildet
- Private: Om kontoen er privat eller offentlig
- Verified: Om kontoen har blått verifiseringsmerke
- Follower of (UserId), Follower of (Username) og Follower of (ProfileUrl): Identifikatorer for kildekontoen som brukes til å kontrollere relasjonen
Hvor mange Instagram-følgere kan jeg skrape om gangen?
Angi Scraping Limit Per Profile for kildekjøringen, og følg med på fremdriften og innstillingene for fortsettelse. De faktiske resultatene avhenger av tilgjengelige følgersider, leverandørens responser, kjøringsgrenser og tilgjengelige credits. Importkapasiteten er ingen garanti for at datakilden kan returnere like mange følgere i én kjøring.
Trenger jeg en nettleserutvidelse for å skrape Instagram-følgere?
Nei. Datablist kjører som en ren webapp. Du trenger ingen utvidelser, nedlastinger eller installasjoner.
Hva er den billigste måten å skrape Instagram-følgere på?
Angi en lav grense, kontroller det estimerte credit-forbruket og gå gjennom de returnerte radene før du kjører enrichment av profildetaljer. Sammenlign kostnaden per nyttige, kontrollerte profil i stedet for å anta at alle returnerte følgere er kvalifiserte kontakter.
Hvordan skraper jeg Instagram-følgere uten å bli utestengt?
Datablist ber ikke om innloggingsinformasjonen eller session cookies fra Instagram i denne arbeidsflyten. Det betyr ikke at metoden er risikofri, eller at du automatisk har tillatelse til å samle inn data. Bruk tilgjengelige kildedata, les nettstedets krav og stopp dersom den ønskede listen ikke er tilgjengelig.
Hva er forskjellen på å skrape Followers og Following?
Followers er personene som følger en profil. Following er listen over kontoer som profilen selv følger. Denne guiden handler spesifikt om å skrape Followers, men Datablist tilbyr begge alternativene.
Kan jeg skrape Instagram-følgere fra en bedriftskonto?
Ja, så lenge bedriftskontoen er offentlig. Scraperen fungerer på samme måte for personlige kontoer, creator-kontoer og bedriftskontoer.
Hvordan laster jeg ned en liste over Instagram-følgere?
Registrer deg i Datablist, opprett en collection, velg Instagram Followers/Following Scraper, lim inn profilen og start kjøringen. Når den er ferdig, eksporterer du resultatene som CSV eller Excel.
Hvilke verktøy kan skrape Instagram-følgere?
Det finnes flere alternativer, blant annet nettleserutvidelser, Python-skript og plattformer som Datablist. Sammenlign nødvendig kontotilgang, tilgjengelige felter, støtte for fortsettelse, testens varighet og kostnaden per nyttige resultat. Datablist krever ikke Instagram-innloggingsinformasjonen din til denne arbeidsflyten.