

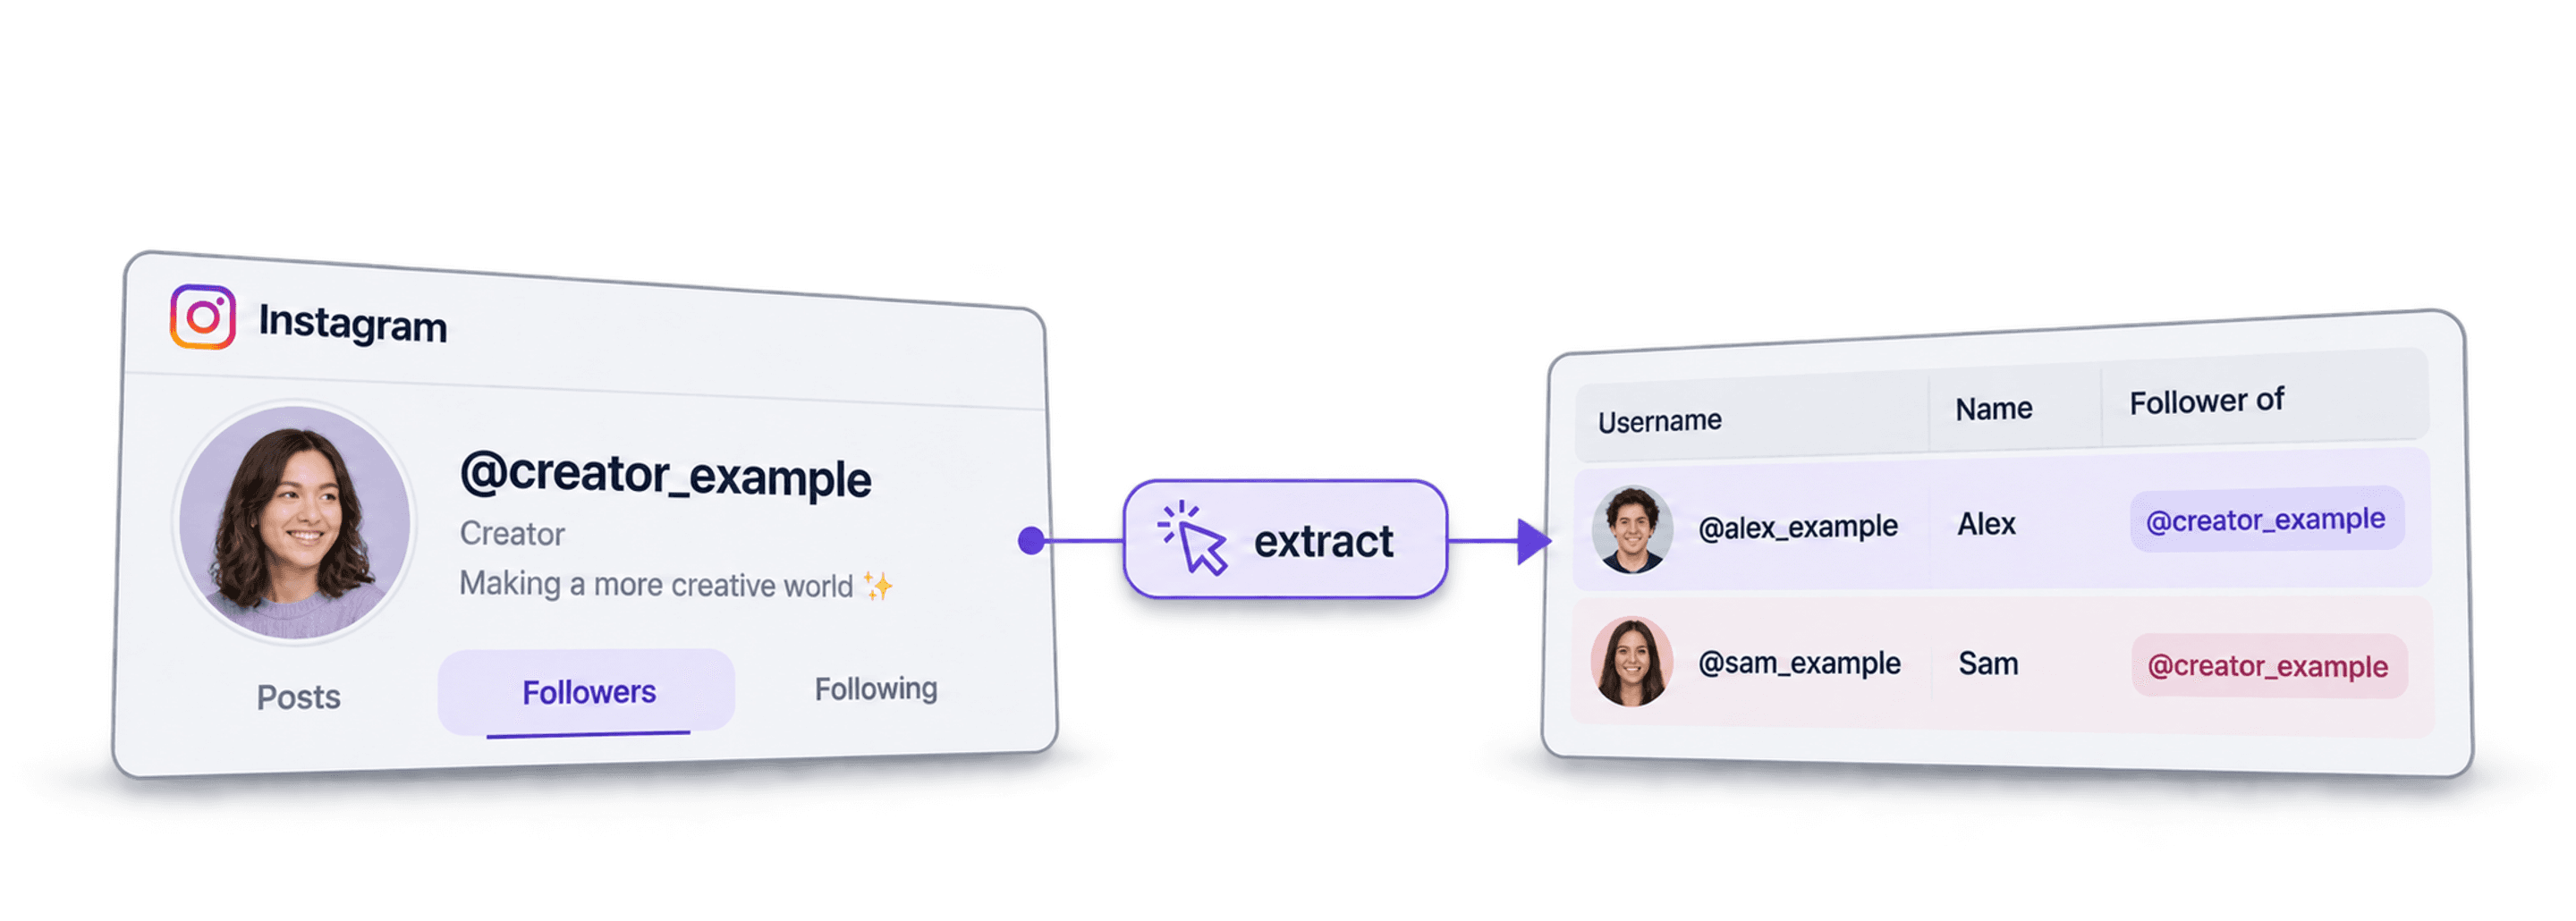
Aby scrapować obserwujących z Instagrama w Datablist, otwórz źródło Instagram Followers/Following Scraper, podaj URL publicznego profilu, nazwę użytkownika lub identyfikator użytkownika, ustaw limit dla każdego profilu, a przed eksportem sprawdź zwrócone wiersze.
Na początek warto wybrać jeden profil i niewielki limit. Zwrócona lista jest migawką kont, które dostawca zdołał pobrać — nie gwarantuje kompletności aktualnej listy obserwujących dany profil. Sam fakt obserwowania influencera z określonej niszy nie świadczy też o zawodzie, lokalizacji ani gotowości zakupowej danej osoby.
W tym poradniku omawiamy ustawienia źródła, pola określające relacje, weryfikację i deduplikację danych, wznawianie większego scrapingu oraz osobne wzbogacanie profili. Nie musisz podawać danych logowania do Instagrama.
📌 Szybki proces
Utwórz kolekcję, otwórz See all sources i wybierz Instagram Followers/Following Scraper. W sekcji Instagram Profiles wpisz po jednym profilu w każdym wierszu, pozostaw Followers (default) w polu Scrape followers or following i ustaw Scraping Limit Per Profile. Dodaj identyfikatory obserwujących oraz pola profilu źródłowego, uruchom próbkę, a następnie sprawdź i wyeksportuj wyniki.
Ile kosztuje scraping obserwujących z Instagrama?
Pobranie listy kosztuje 0,01 kredytu za każdego zwróconego obserwującego. Rozpoznanie profilu źródłowego może kosztować dodatkowy 1 kredyt, jeśli jego identyfikator nie znajduje się w pamięci podręcznej. Wzbogacanie szczegółów profilu jest rozliczane osobno.
Załóżmy, że jeden profil źródłowy zwróci dokładnie 1000 wierszy z obserwującymi:
- Lista obserwujących: 1000 × 0,01 = 10 kredytów oraz 1 kredyt za wyszukanie profilu spoza pamięci podręcznej, czyli łącznie 11 kredytów.
- Dane 100 wybranych obserwujących: przy użyciu zwróconych wartości User Id standardowe wyszukanie profilu kosztuje 2 kredyty za osobę, czyli 200 kredytów. Ta opcja może zwrócić publiczny e-mail i numer telefonu, jeśli są dostępne, ale nie gwarantuje żadnej z tych informacji.
- Łącznie: 211 kredytów za listę i 100 wyszukań profili. Dodanie danych About lub wybór innego typu scrapingu zmieni koszt wzbogacania.
Przy miesięcznych rozliczeniach w USD plan Starter kosztuje 25 USD i obejmuje 5000 kredytów. Jeśli cały ten limit jest dostępny, przykład nie wymaga dokupowania kredytów i pozostawia 4789 kredytów. Opłata 25 USD to koszt subskrypcji, natomiast 211 kredytów to wykorzystanie w ramach tego procesu. Kredyty nie mają jednej stałej wartości w dolarach — zależy ona od planu i wybranego pakietu dodatkowego.
W tym przykładzie wzbogacania profili użyj zwróconego User Id. Nazwa użytkownika lub URL mogą wymagać kolejnego wyszukania identyfikatora. Po uruchomieniu próbki sprawdź rzeczywistą liczbę wierszy oraz zużycie kredytów. Strony dostawcy mogą przekroczyć niski zadany limit, a wyszukanie profilu może zużyć kredyty nawet wtedy, gdy nie zostanie zwrócony żaden obserwujący. Zadany limit nie jest więc dokładnym limitem wydatków.
Datablist — krótki przegląd
Datablist to przestrzeń robocza przypominająca arkusz kalkulacyjny, przeznaczona do procesów lead generation. Pozwala zbierać, weryfikować, wzbogacać i eksportować wiersze za pomocą enrichments, takich jak AI Agents, Email Finders, procesory AI, Technology enrichments i wiele innych.
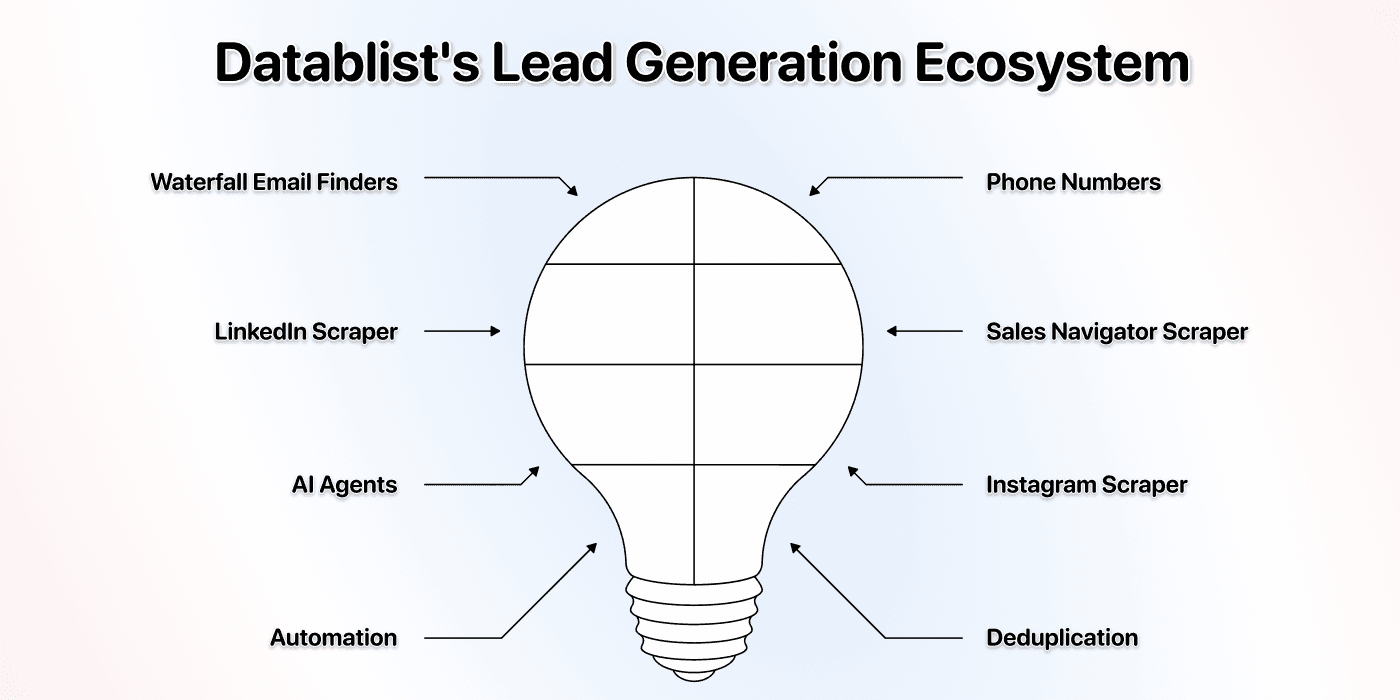
Datablist umożliwia również tworzenie automatycznych workflow uruchamianych zgodnie z harmonogramem lub na żądanie. Oto kilka praktycznych zastosowań szczególnie cenionych przez użytkowników:
- Budowanie list leadów
- Personalizacja e-maili za pomocą AI
- Czyszczenie i deduplikacja danych w CRM
- Scraping ofert pracy
- Pozyskiwanie leadów z Sales Navigatora
Jak tanio scrapować obserwujących z Instagrama krok po kroku
Przejdźmy do konkretów. Najpierw zaloguj się do Datablist i skonfiguruj dane, które chcesz pobrać, czyli wklej adresy URL profili lub nazwy użytkowników influencerów, których obserwujących chcesz pozyskać.
Najpierw skonfiguruj próbkę, a dopiero po sprawdzeniu profilu źródłowego i zwróconych pól zwiększ skalę procesu. Ten workflow nie wymaga rozszerzenia przeglądarki ani własnego klucza API dostawcy.
📘 Ważne: profile prywatne
W tym procesie lista obserwujących profil prywatny nie jest dostępna. Uruchomienie może zużyć kredyty podczas rozpoznawania profilu, nawet jeśli nie zwróci żadnych wierszy. Wzbogacanie szczegółów profilu jest osobnym wyszukiwaniem i nie zapewnia dostępu do prywatnych postów ani list obserwujących.
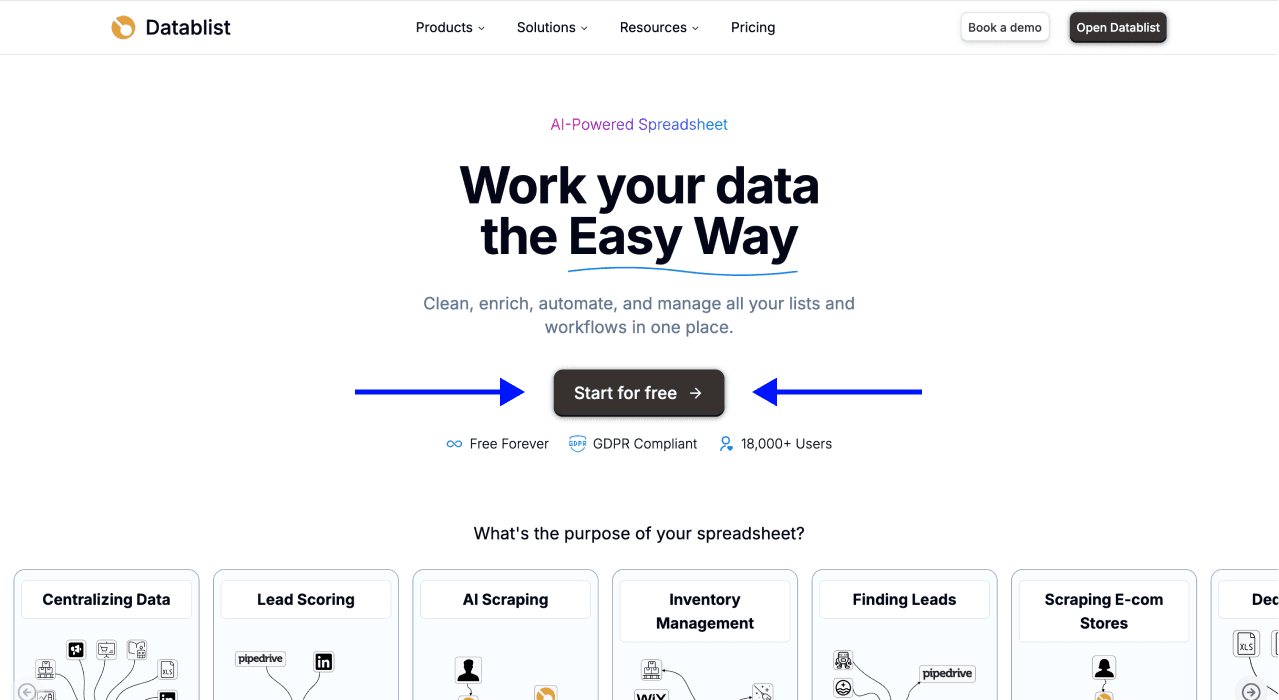
Krok 1: Załóż konto w Datablist.com
Wejdź na Datablist.com i utwórz konto. Przejdź przez konfigurację konta, aby otworzyć swoją przestrzeń roboczą.
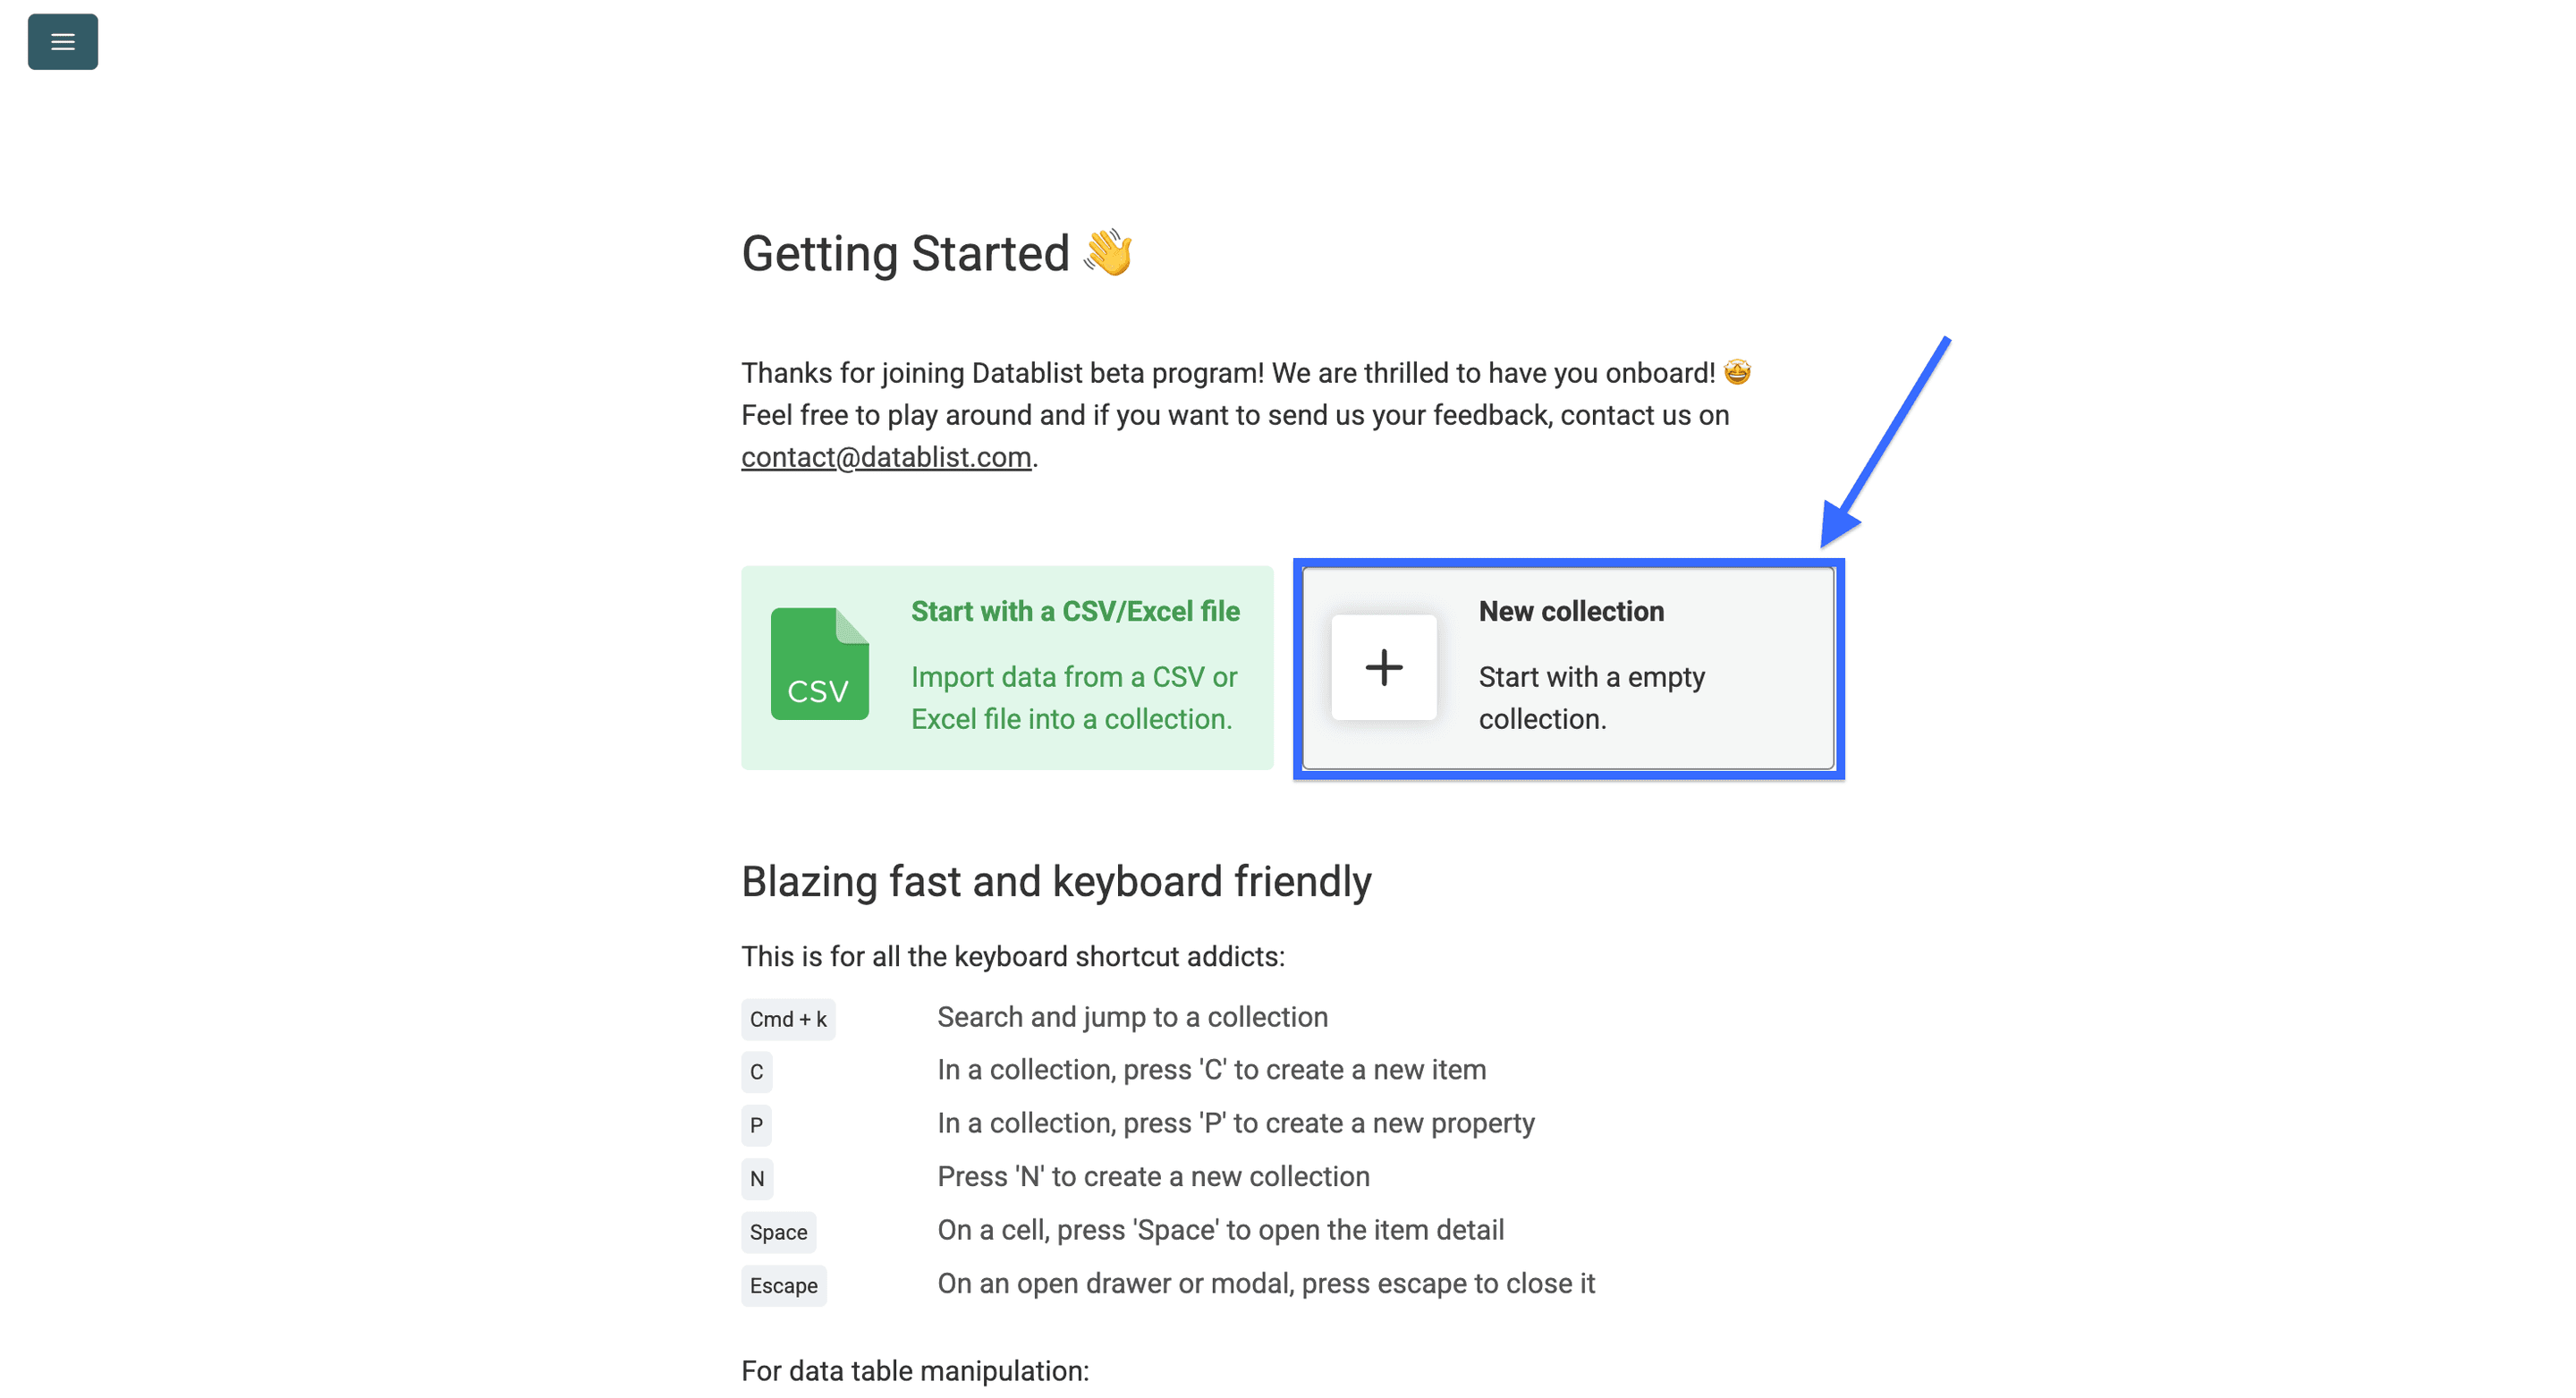
Krok 2: Utwórz nową kolekcję
Po zalogowaniu kliknij New Collection.
Krok 3: Otwórz Instagram Followers/Following Scraper
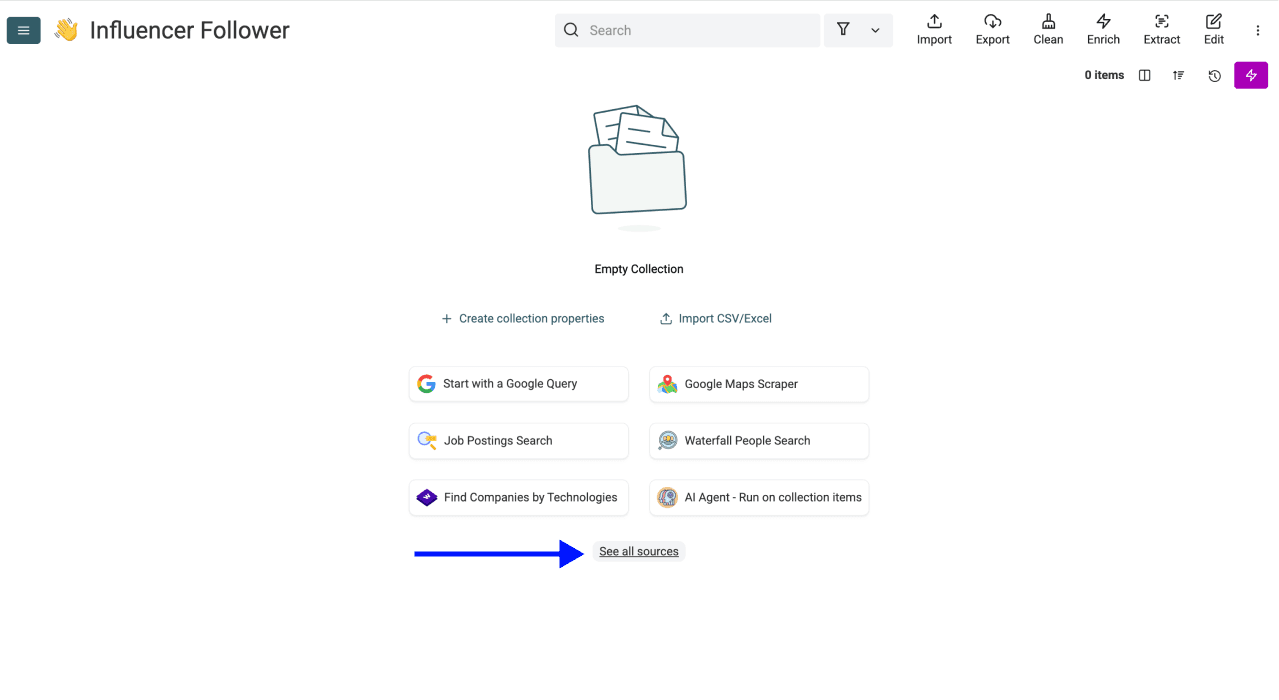
Kliknij See all sources.
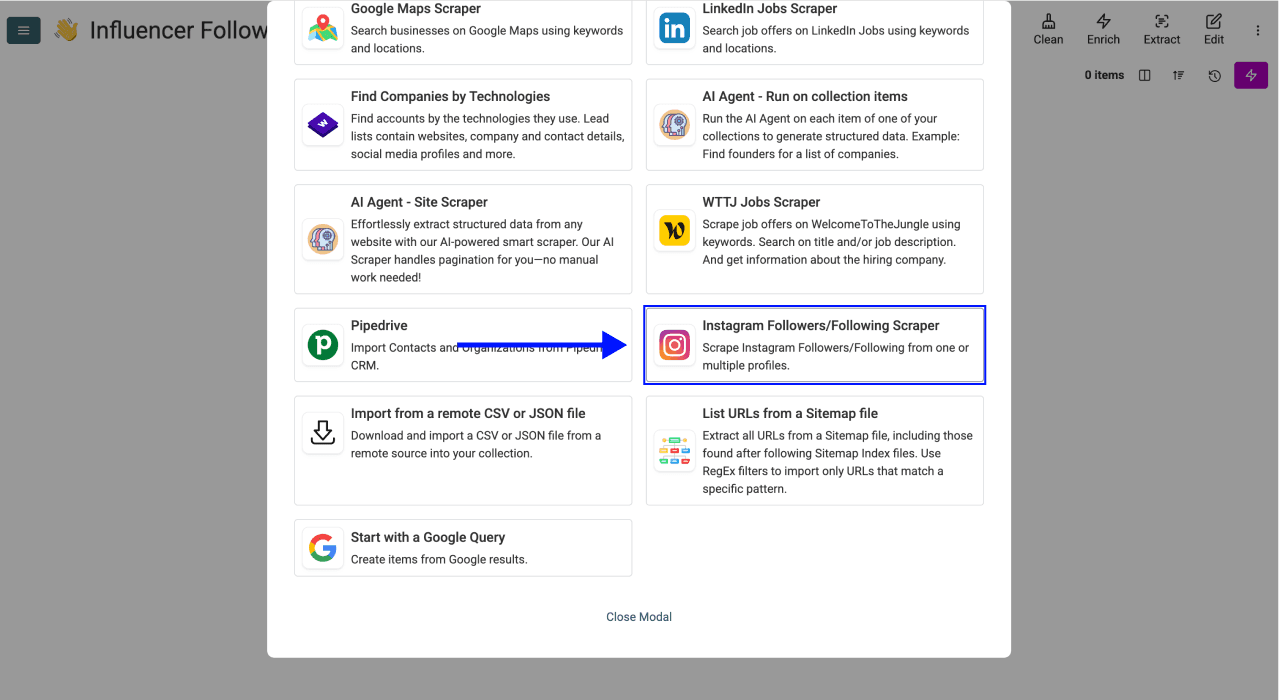
Przewiń listę w dół i wybierz Instagram Followers/Following Scraper.
Krok 4: Skonfiguruj ustawienia
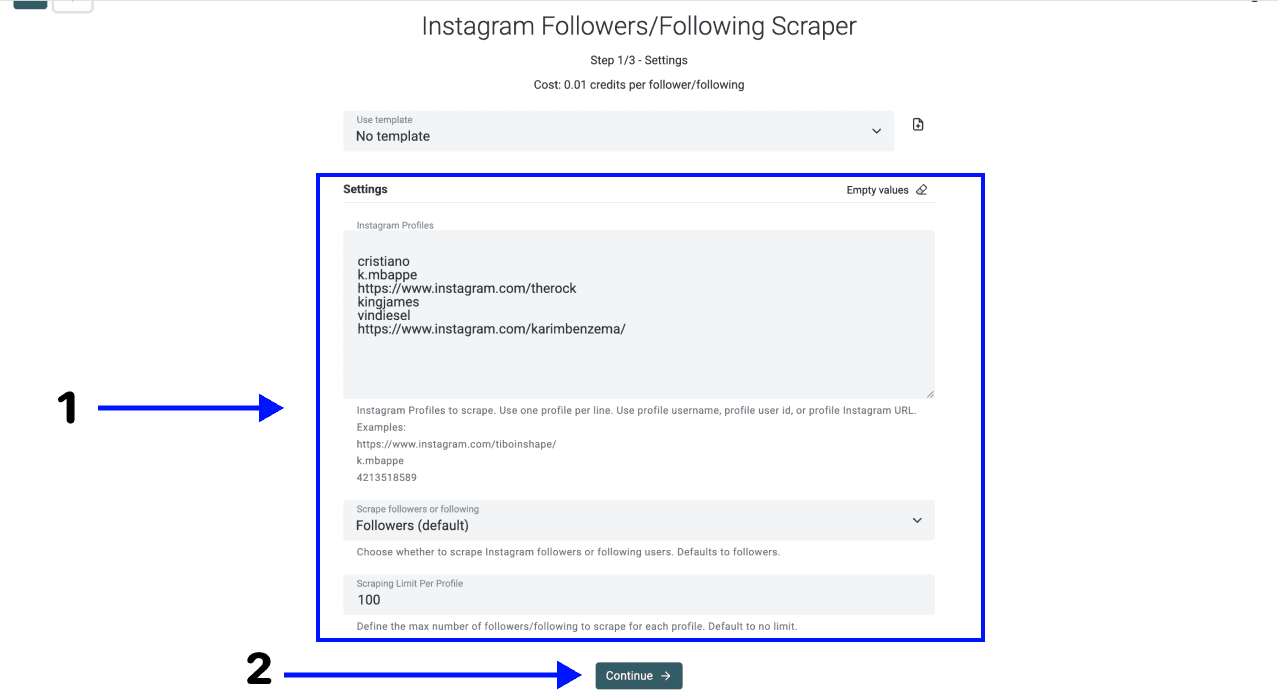
Zobaczysz prosty ekran konfiguracji. Aby uzyskać najlepsze wyniki:
- W sekcji Instagram Profiles wpisz w osobnych wierszach URL publicznego profilu, nazwę użytkownika lub user ID. Upewnij się, że każdy identyfikator prowadzi do właściwego konta.
- W polu Scrape followers or following wybierz Followers (default). Opcję Following wybierz tylko wtedy, gdy chcesz pobrać konta obserwowane przez podany profil.
- Ustaw niewielką wartość Scraping Limit Per Profile dla próbki, zanim zwiększysz skalę procesu. Limit nie gwarantuje kompletności danych.
- Kliknij Continue i skonfiguruj kolumny wynikowe.
Krok 5: Wybierz pola wynikowe
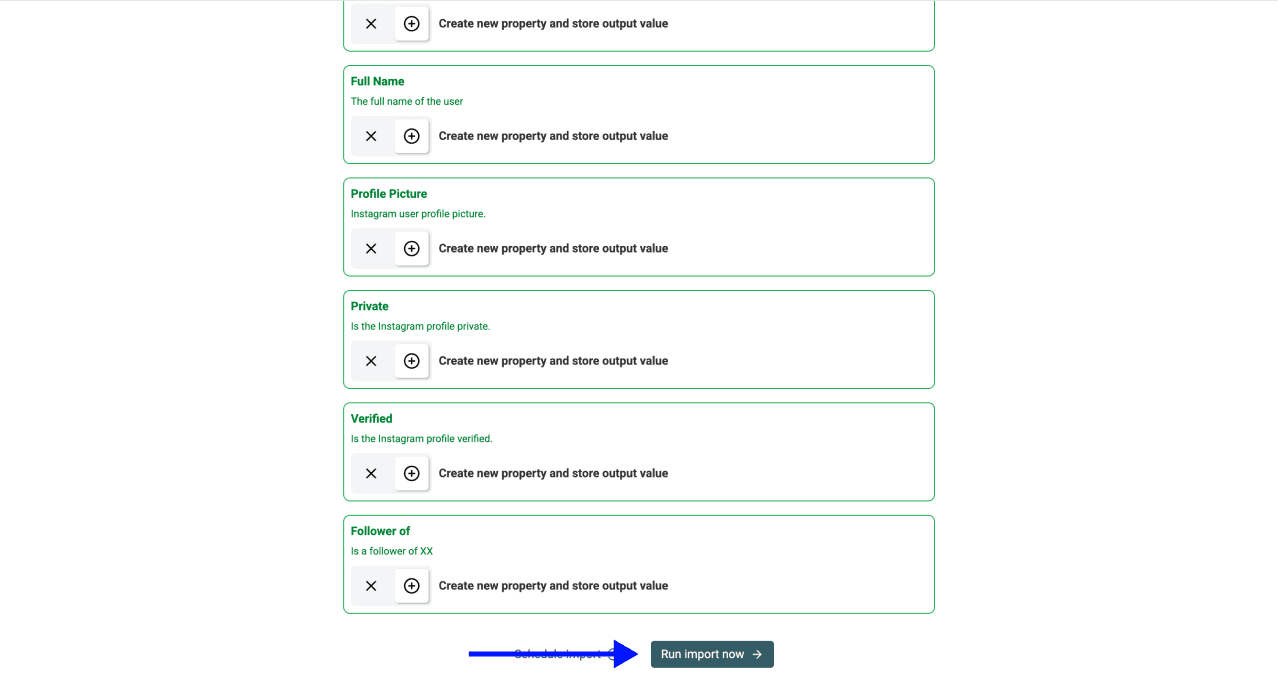
Datablist wyświetli dostępne pola wynikowe. Zachowaj User Id, User Username oraz User Profile URL obserwującego, a także pola profilu źródłowego. Dzięki nim sprawdzisz, kogo reprezentuje każdy wiersz i z którego profilu wejściowego pochodzi.
Kliknij ikony ✕, aby usunąć niepotrzebne pola, a następnie wybierz Run import now.
Krok 6: Pobierz wyniki
Po zakończeniu procesu porównaj liczbę zwróconych wierszy z zadanym limitem i sprawdź status uruchomienia. Czas zależy od odpowiedzi dostawcy, paginacji, profilu i rozmiaru zadania. Niewielka liczba wierszy nie oznacza, że profil nie ma innych obserwujących.
Uwaga: Wyniki zawierają również imiona i nazwiska. Na poniższej ilustracji zostały one ukryte, aby chronić prywatność użytkowników.
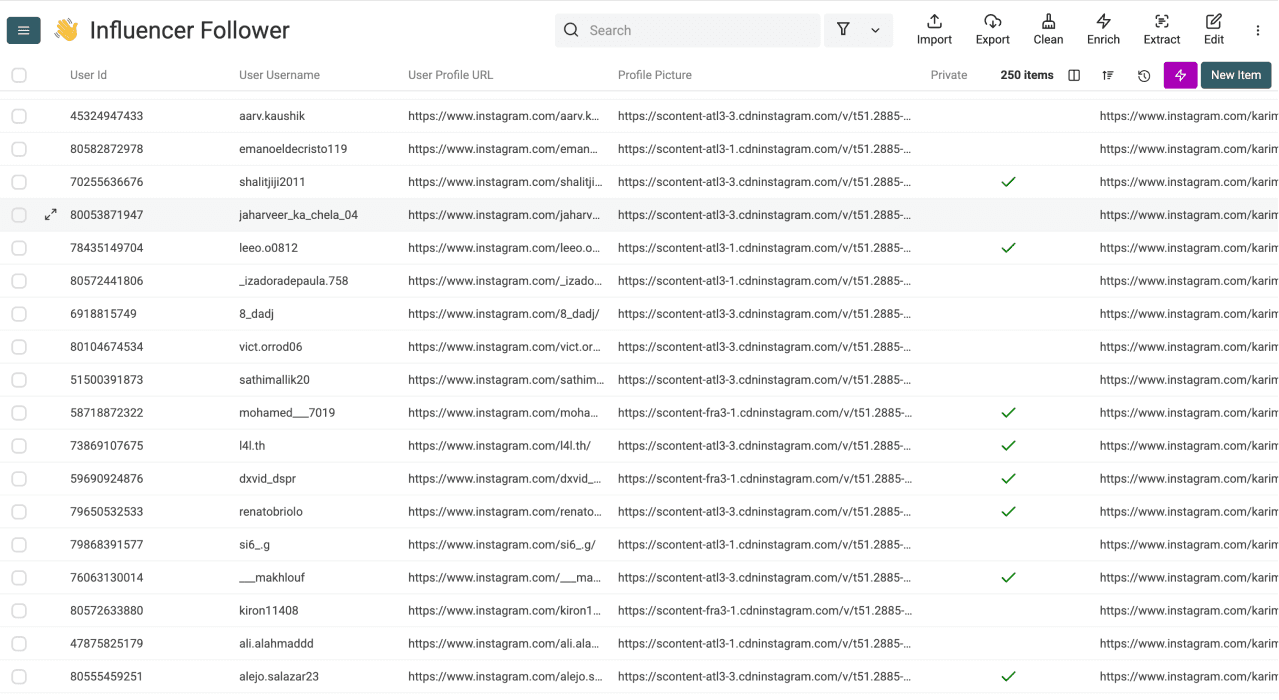
Jeśli podajesz kilka profili wejściowych, zachowaj pola Follower of (UserId), Follower of (Username) lub Follower of (ProfileUrl). Użyj ich do filtrowania relacji według konta źródłowego zamiast polegać na położeniu kolumn.
💡 Warto wiedzieć: duże scrapingi
Uruchomienie źródła ma własne limity paginacji i liczby wierszy. Są one niezależne od przestrzeni kolekcji i synchronizacji w chmurze. Jeśli proces zatrzyma się, mimo że dostępne są kolejne wyniki, użyj opisanej niżej opcji wznowienia. Nie zakładaj, że wszyscy pozostali obserwujący zmieszczą się w tym samym uruchomieniu.
Krok 7: Wzbogać profile obserwujących
Lista obserwujących to dopiero początek. Aby przekształcić nazwy użytkowników w użyteczne leady, musisz dowiedzieć się, kim są ich właściciele. Instagram Profile Scraper pozwala wzbogacić listę o publiczne dane, takie jak adresy e-mail, opisy bio i statystyki zaangażowania.
Podczas budowania listy leadów traktuj szczegóły profilu jako podstawę do przypisania osoby do segmentu. Sama relacja obserwowania nie jest wiarygodnym kryterium kwalifikacji.
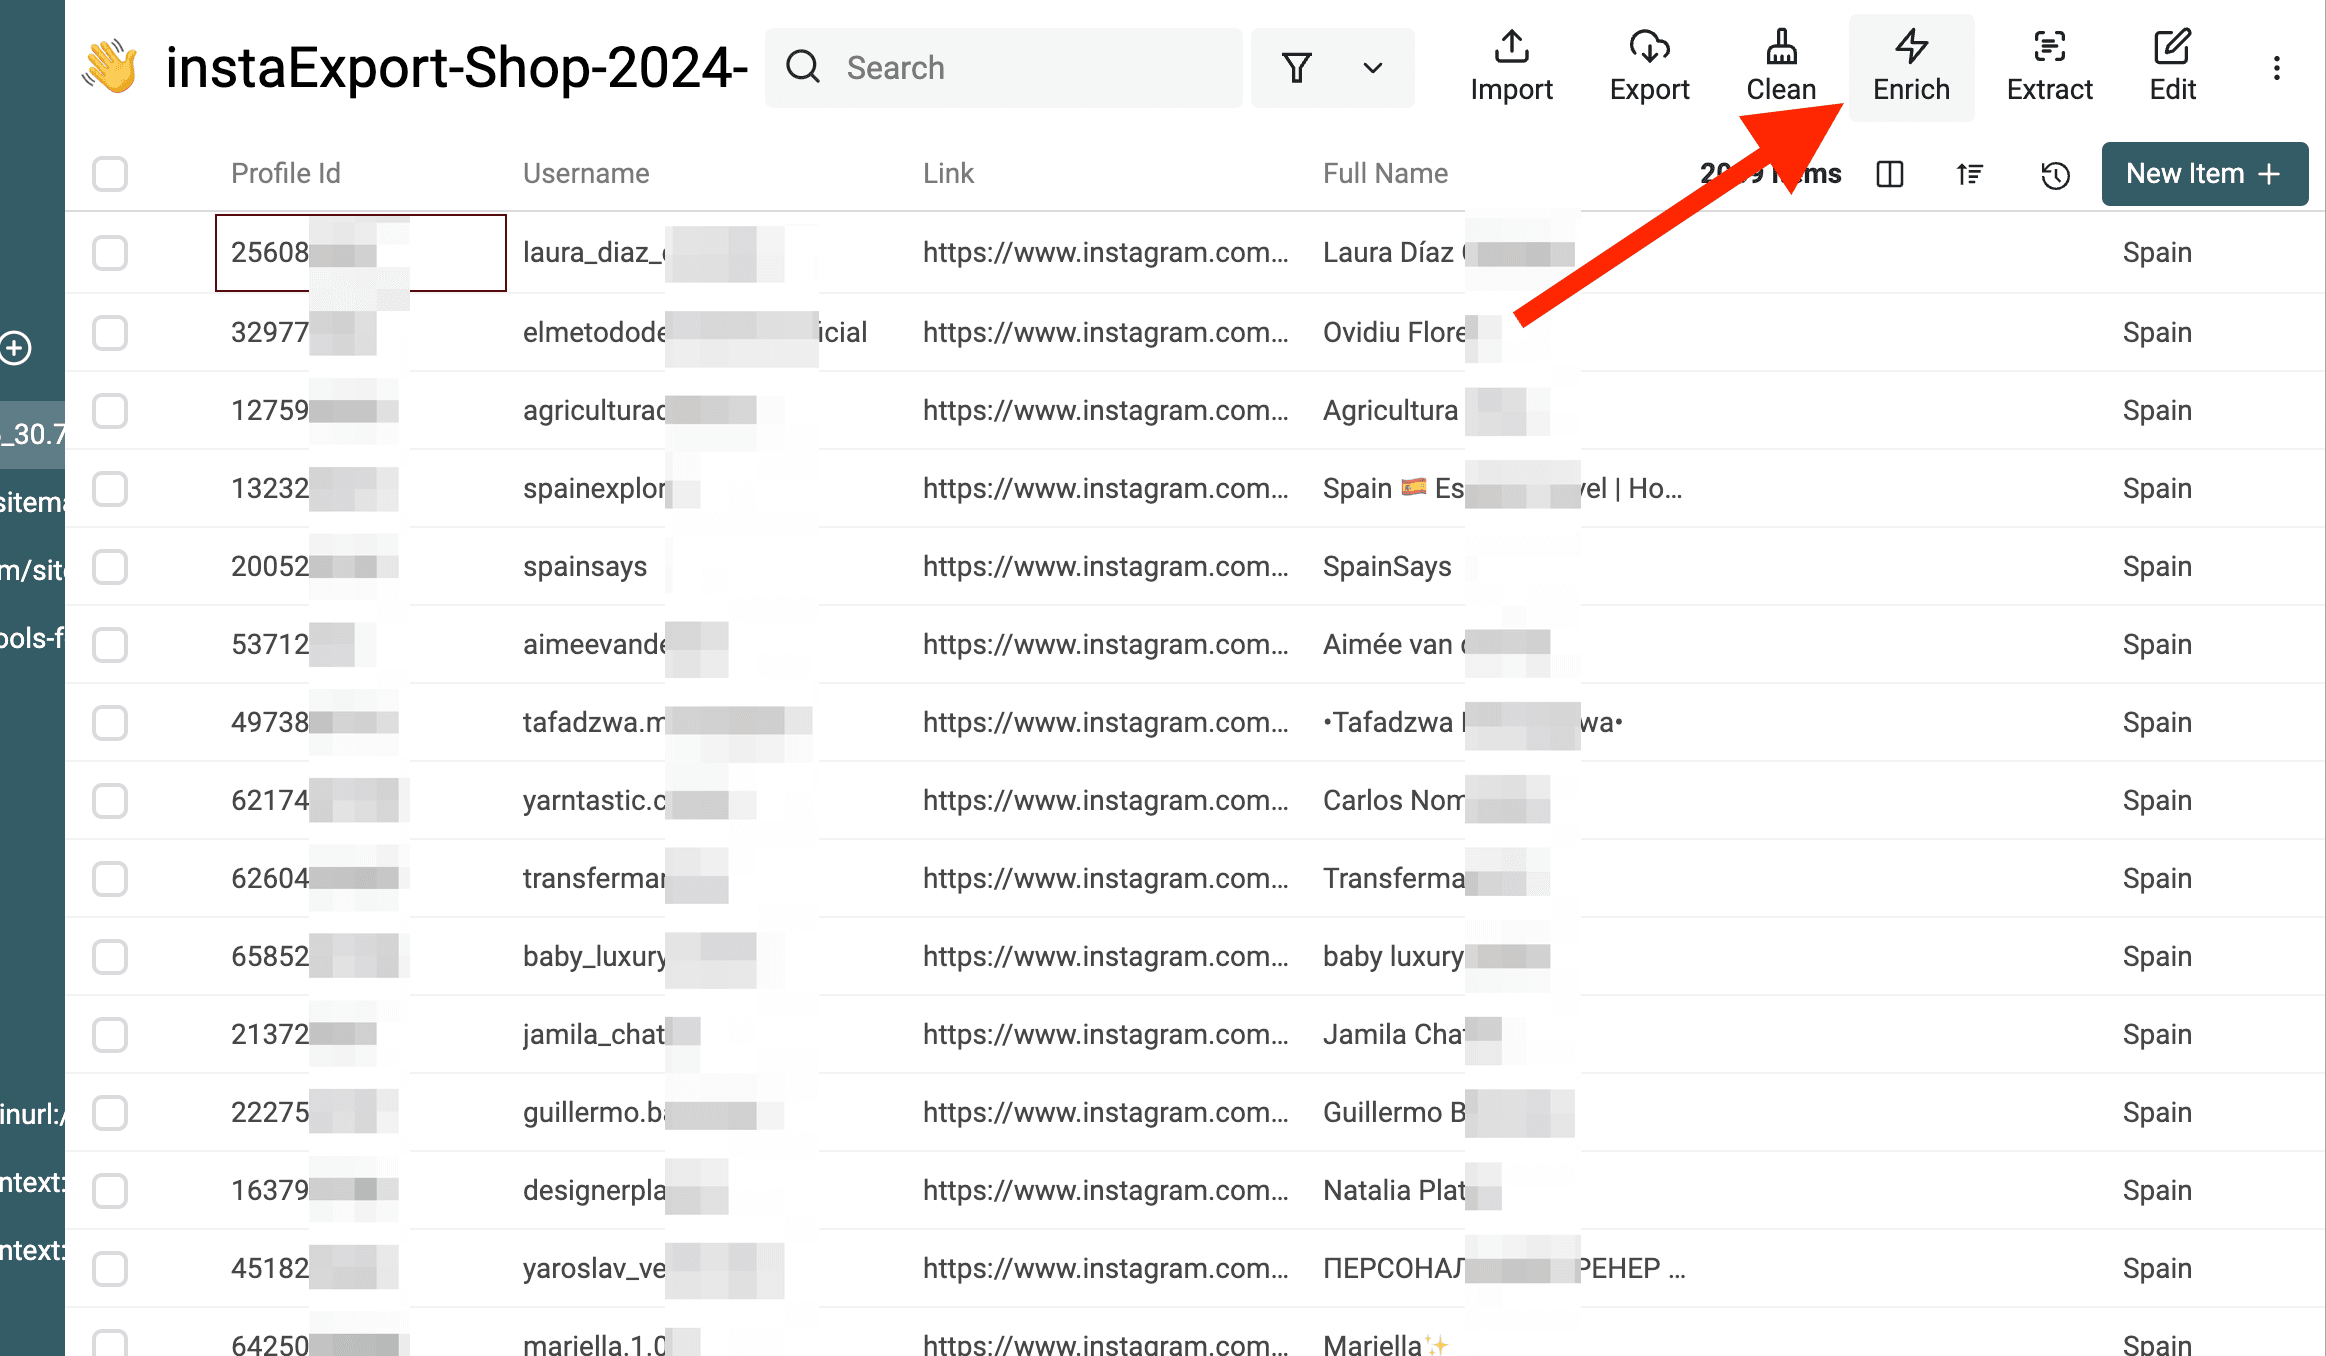
1. Otwórz menu Enrich W kolekcji zawierającej pobranych obserwujących kliknij Enrich u góry panelu.
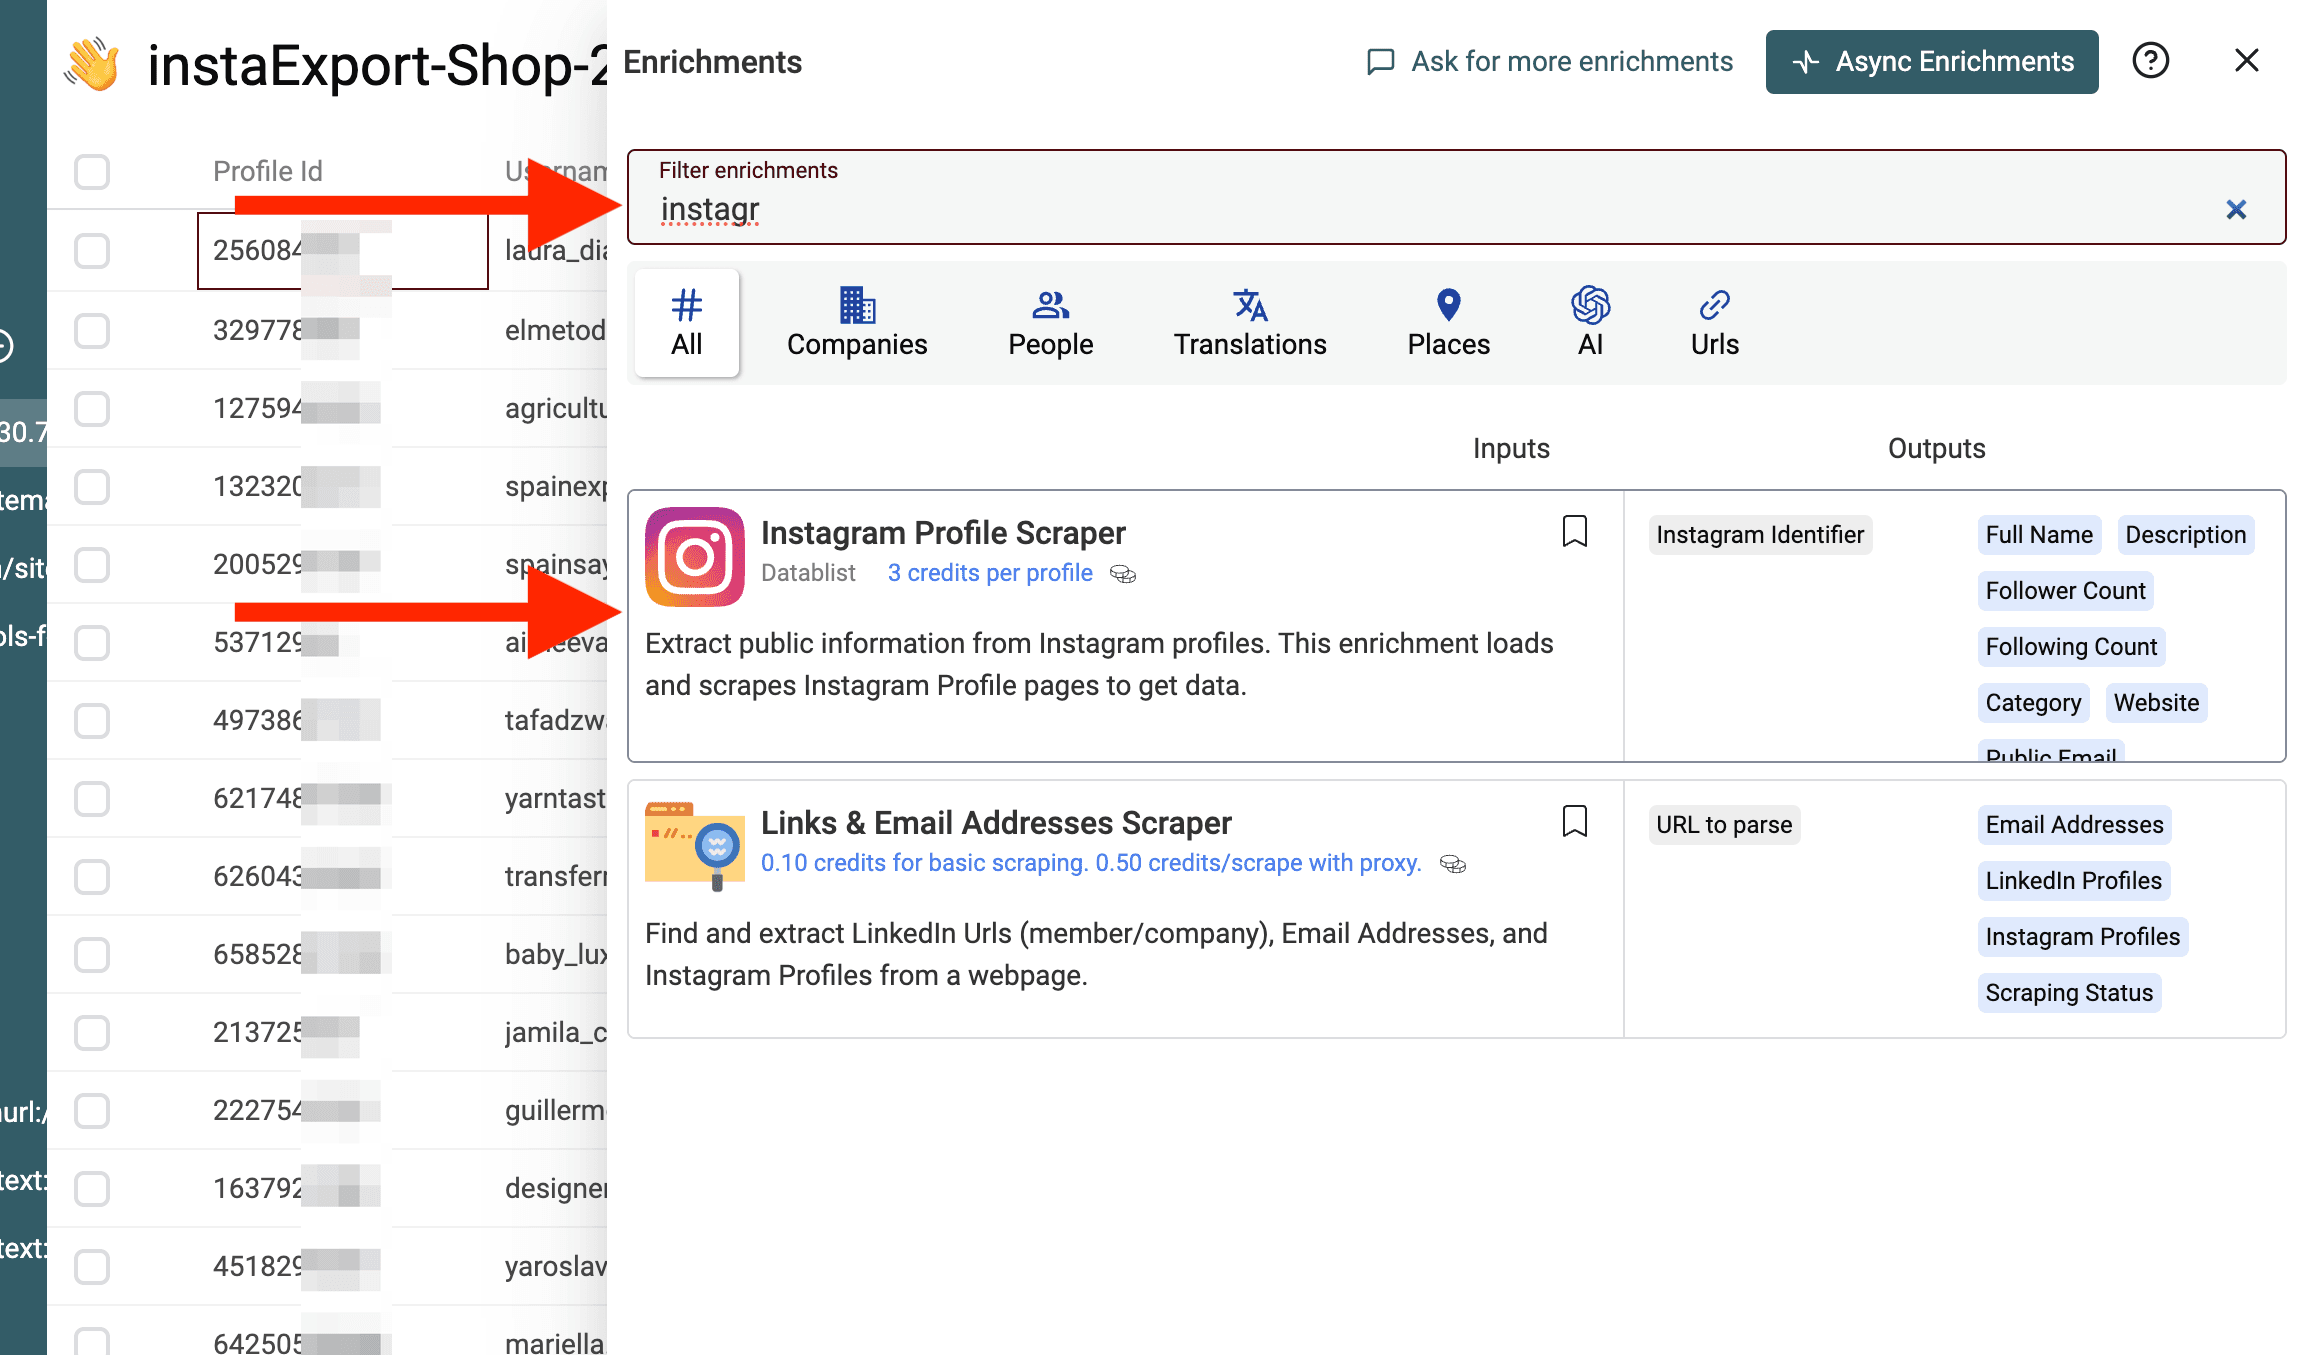
2. Wybierz Instagram Profile Scraper Wyszukaj i wybierz Instagram Profile Scraper. To enrichment wykorzystuje identyfikatory profili z wyników źródłowych, aby pobrać dodatkowe pola. Ich dostępność zależy od wybranego typu scrapingu i danych, które może zwrócić dostawca.
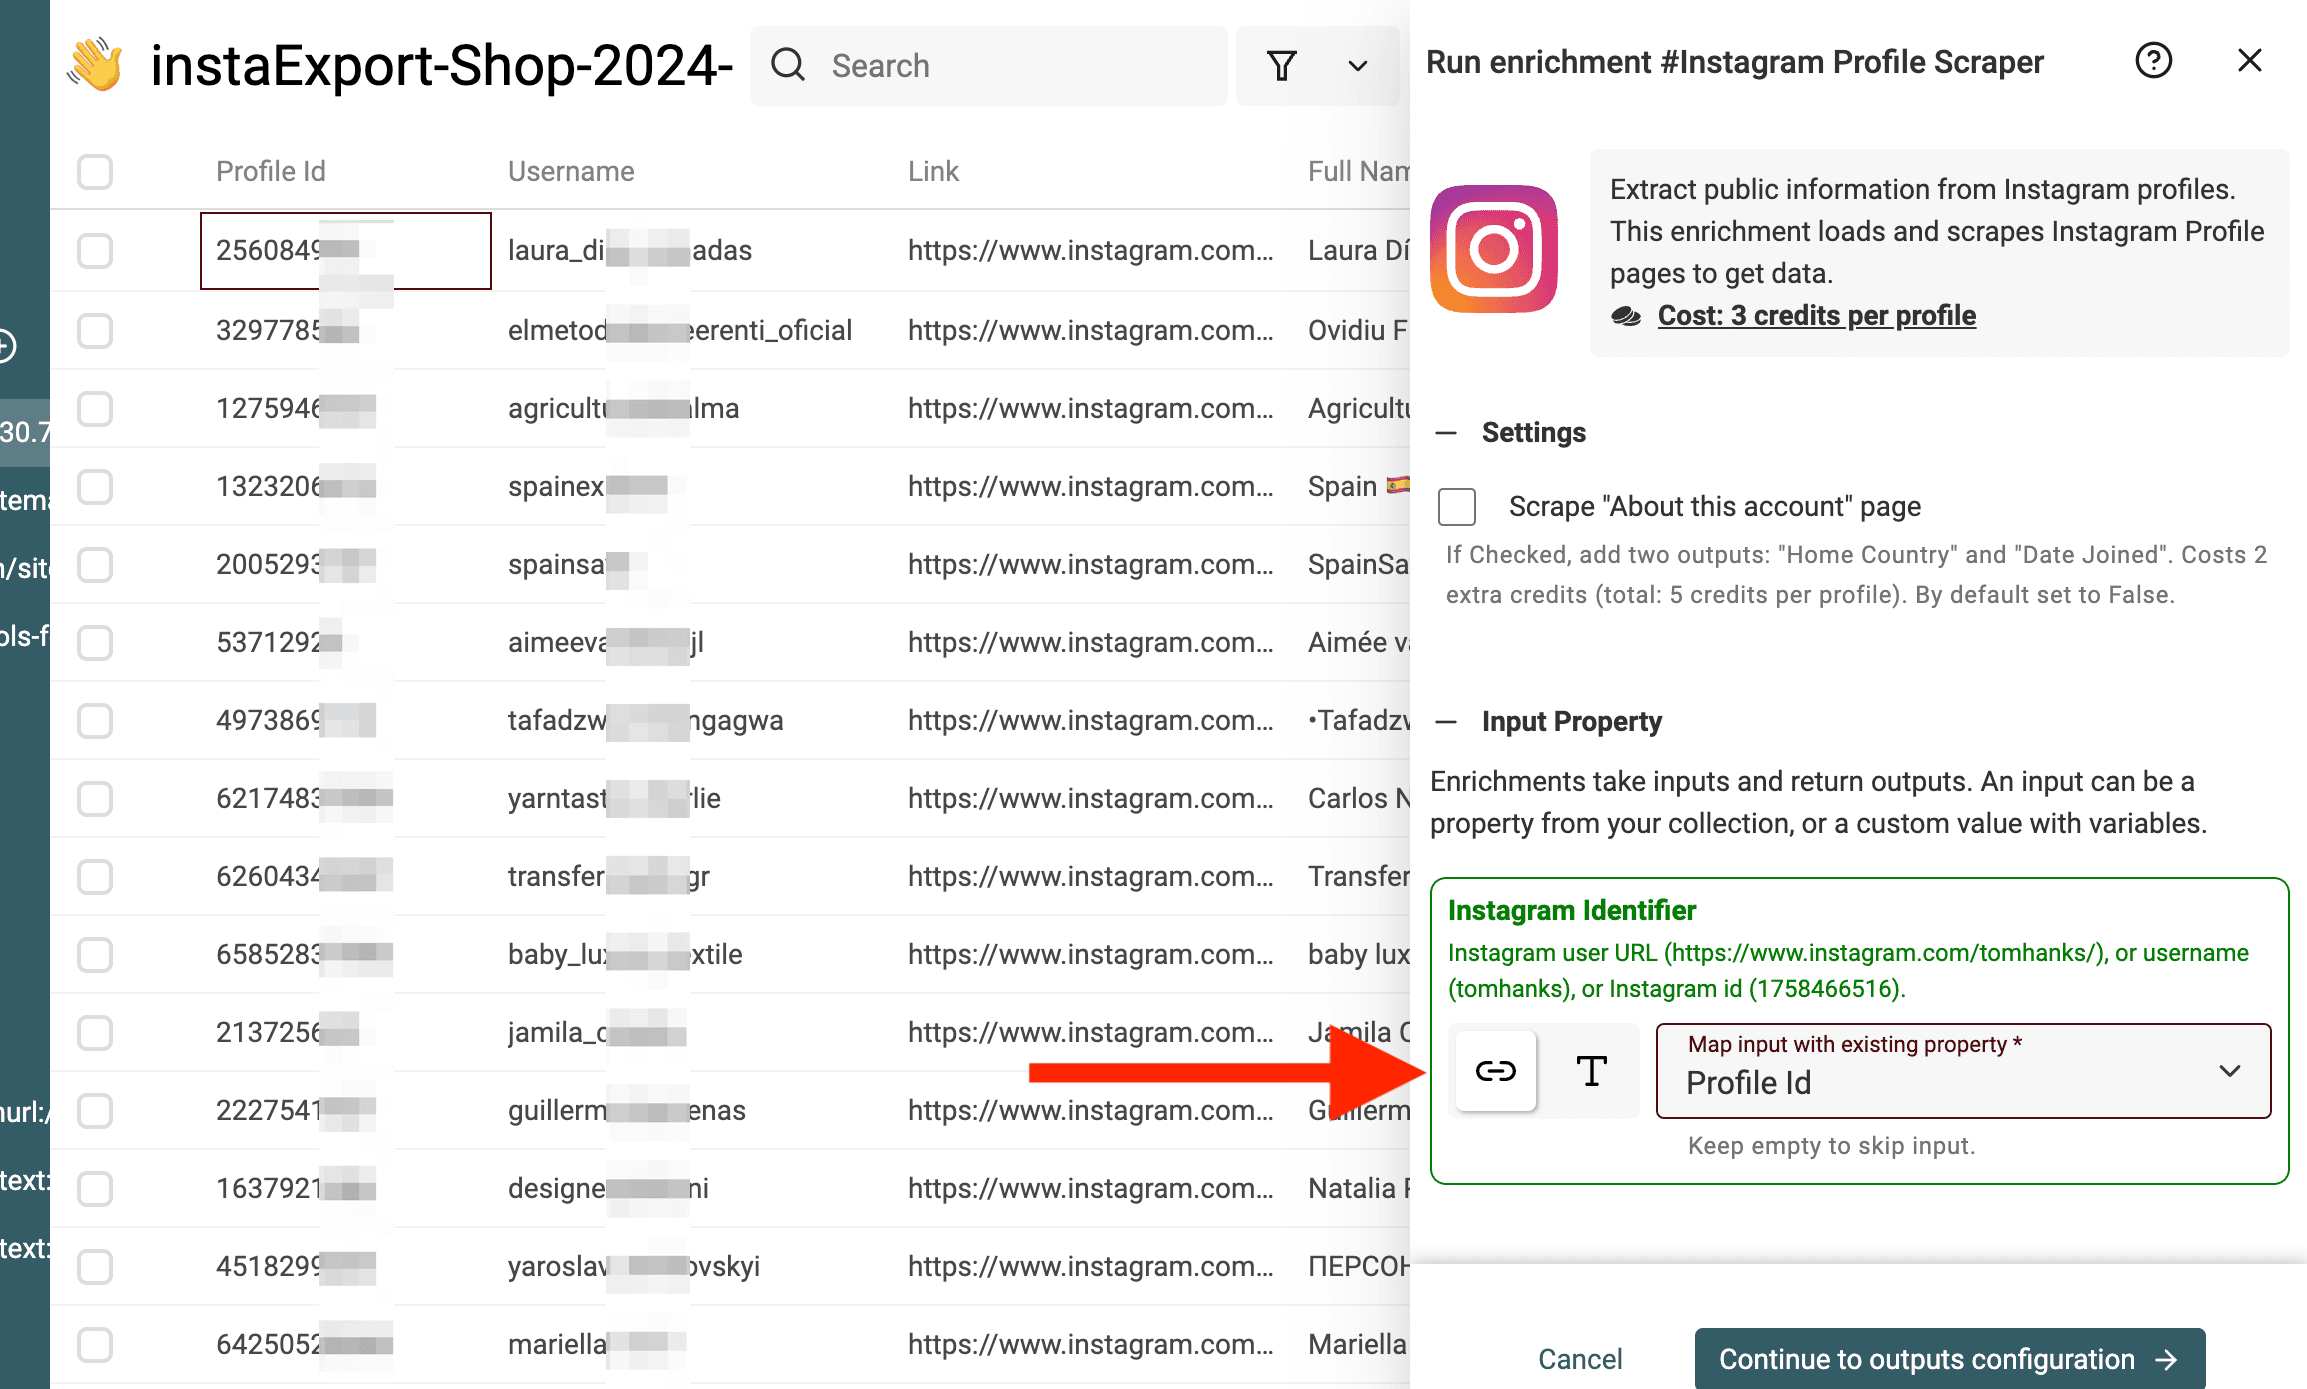
3. Zmapuj kolumny danych Wskaż Datablist kolumnę zawierającą nazwy użytkowników. Kolumnę Instagram Username lub Profile URL z kroku 6 należy przypisać do pola wejściowego scrapera.
4. Wybierz pola wynikowe Wybierz konkretne dane, które chcesz dodać do kolekcji.
Przypisz potrzebne pola wynikowe do nowych kolumn, aby zachować pierwotne identyfikatory obserwujących.
Wśród wyników znajdziesz:
- Public Email: Pozyskiwanie adresów e-mail bezpośrednio z profili firmowych.
- Description: Użyj tego pola, aby filtrować dane według stanowisk lub zainteresowań.
- Follower Count: Odfiltruj mikroinfluencerów od zwykłych użytkowników.
- Website: Pobierz link z bio, aby przeprowadzić dalszy research firmy.
5. Uruchom enrichment
Wybierz Scraping Type zwracający potrzebne pola, a następnie uruchom próbkę. Opcja ograniczona do profilu publicznego nie zawiera pól e-mail ani telefonu. Opcja profilu może zwrócić publiczny adres e-mail lub numer telefonu, jeśli użytkownik go udostępnił, ale pola te nadal mogą pozostać puste. Przed przetworzeniem reszty danych sprawdź dostępne ustawienia i szacowane zużycie kredytów.
Po zakończeniu enrichment sprawdź Enrichment Status i brakujące pola. Brak publicznego adresu e-mail powinien pozostać pustym polem — nie dowodzi, że dana osoba nie ma adresu e-mail. Jeśli adresy zostały umieszczone w tekście bio zamiast oficjalnego pola e-mail, możesz użyć Data Extractor.
Sprawdzanie duplikatów i wznawianie dużego scrapingu
Pamiętaj o rozróżnieniu dwóch zbiorów danych:
- Relacje obserwowania: jeden wiersz na każdą parę obserwujący–profil źródłowy. Osoba obserwująca dwa konta wejściowe może prawidłowo występować dwukrotnie.
- Unikalne profile: jeden wiersz na każdy User Id, jeśli chcesz wzbogacić dane każdej osoby tylko raz. Przed usunięciem powtarzających się profili zachowaj osobno informację o ich przynależności do źródeł.
W przykładowej partii User Id 101 obserwujący zarówno konto A, jak i konto B reprezentuje dwie relacje, ale jeden profil. Deduplikacja wyłącznie według User Id spowodowałaby utratę jednej relacji ze źródłem, chyba że wcześniej połączysz te informacje.
Przed enrichment warto sprawdzić brakujące identyfikatory, powtarzające się pary źródło–obserwujący oraz zaskakująco małe zbiory wyników. Wybierz reprezentatywną próbkę profili i sprawdź pola Description, Website oraz zwrócone adresy e-mail. Nie klasyfikuj automatycznie każdego obserwującego konto fitness jako specjalisty z branży fitness.
Jeśli poprzednie uruchomienie ma zapisany punkt kontynuacji, otwórz ustawienia źródła i użyj Continue a previous scrape. Dostępne pozycje są przypisane do bieżącej przestrzeni roboczej i przechowywane przez siedem dni. Wybrana pozycja ponownie wykorzysta profil źródłowy oraz typ scrapingu — nie trzeba zastępować ich nowymi danymi profilu.
Gdy źródło osiągnie limit kolekcji, zgodnie ze wskazówkami ustawienia wznów proces w innej kolekcji w tej samej przestrzeni roboczej. Jeśli kontynuacja nie jest dostępna, sprawdź wcześniejsze uruchomienie źródła, zanim rozpoczniesz proces od nowa. Ponownie uruchomiony scraping może częściowo pokrywać się z wcześniejszą migawką, dlatego porównaj identyfikatory i zachowaj kontekst źródła oraz kolekcji.
Do każdej partii dodaj datę Checked At, a następnie wyeksportuj sprawdzone wyniki jako CSV lub Excel. Zmieniająca się liczba obserwujących nie jest dowodem kompletności danych — użytkownicy mogą zacząć lub przestać obserwować profil pomiędzy kolejnymi stronami albo uruchomieniami.
Podsumowanie
Zacznij od publicznego profilu i niewielkiego limitu. Zachowaj identyfikatory obserwujących i profilu źródłowego, a przed enrichment lub eksportem sprawdź zwrócone relacje. Przy większym scrapingu skorzystaj z zapisanej kontynuacji, jeśli jest dostępna.
Otwórz Datablist i wypróbuj ten sam workflow na profilu związanym z Twoim projektem.