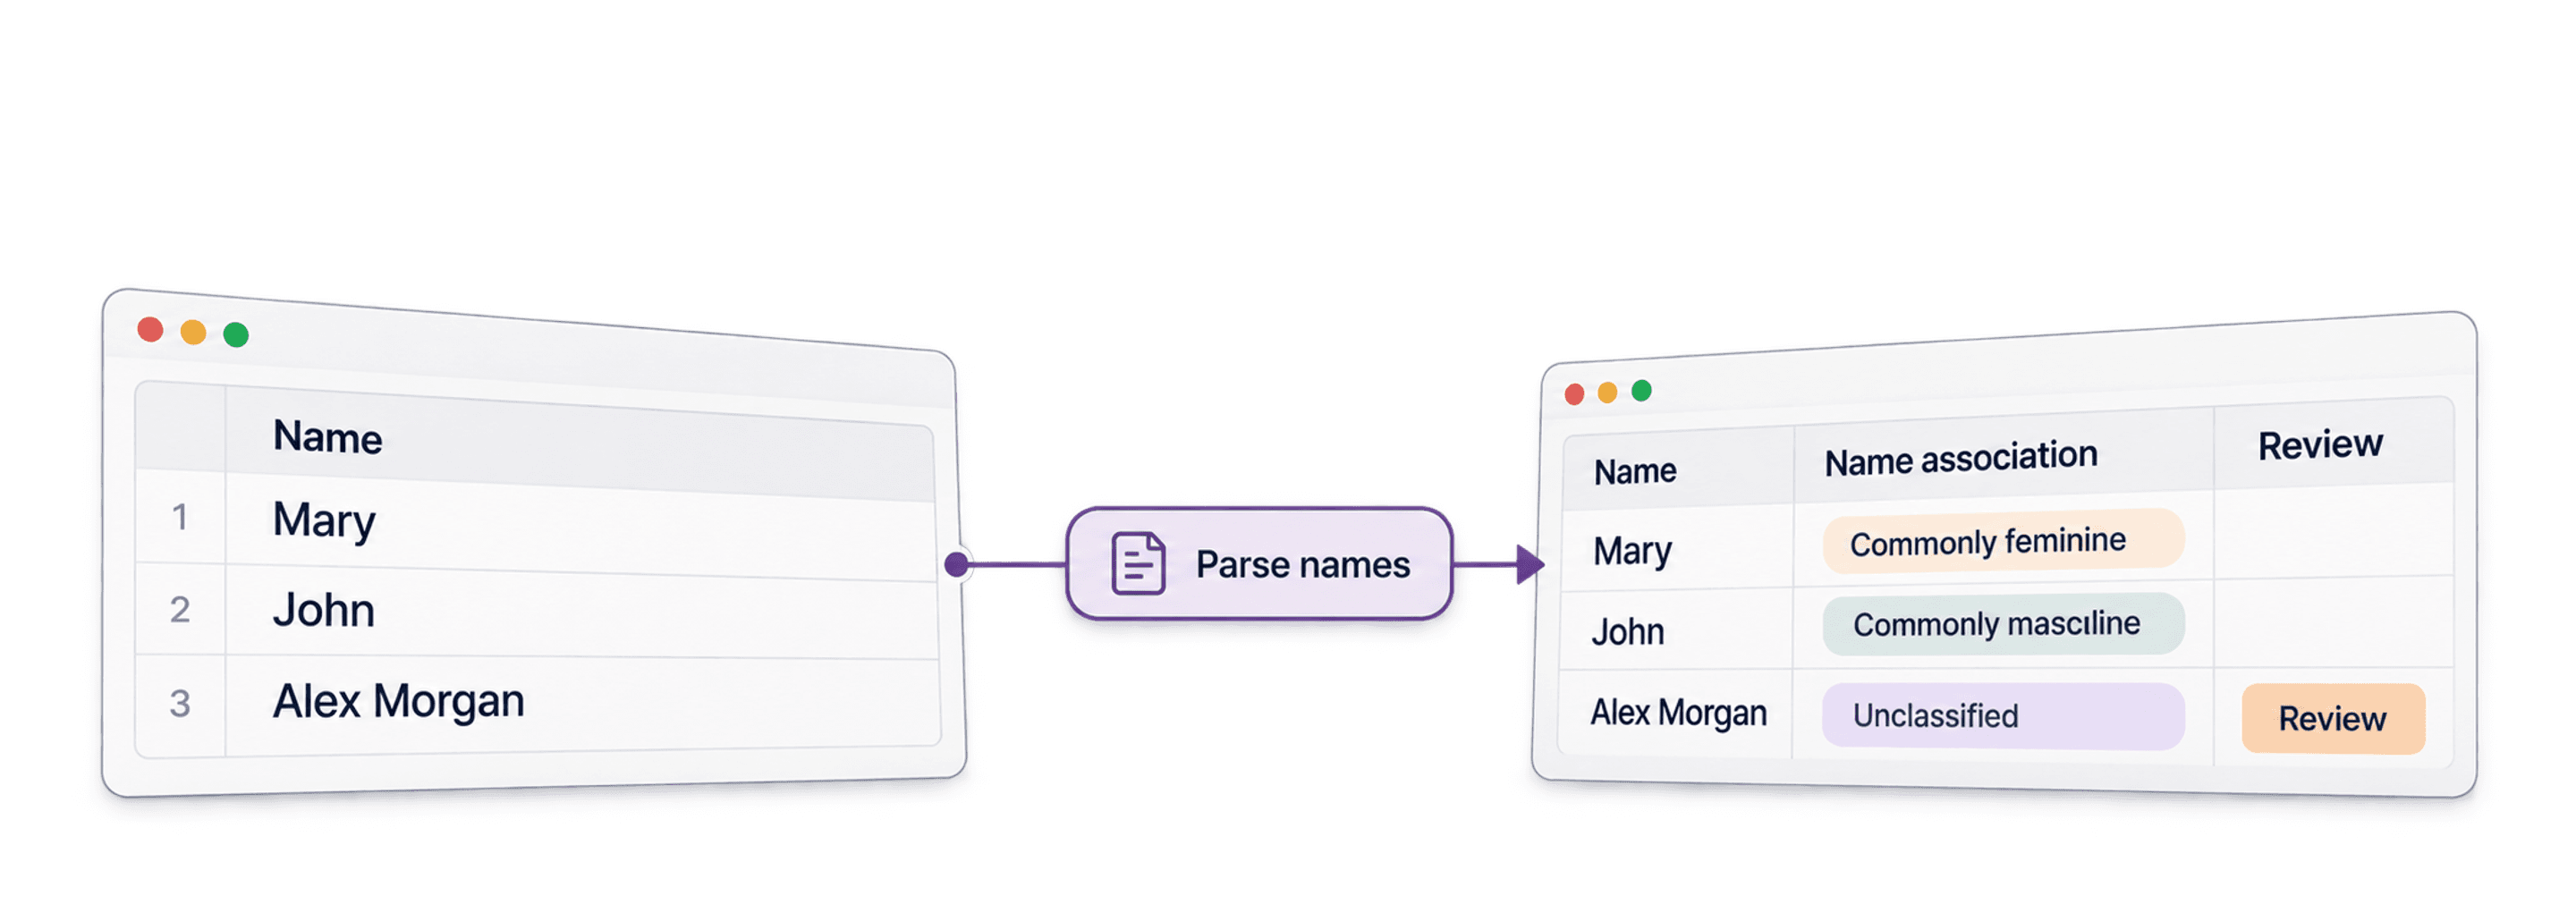
要在电子表格中根据姓名推测性别,请导入姓名列,运行 Datablist 的 Name Parser,并将其 Gender 输出映射到一个新属性。结果表示基于姓名得出的统计关联,并不代表个人的性别认同。对于含义不明确或缺失的结果,请不要分类。
例如,Name = Alex Morgan 这条记录在不同国家和文化中可能对应不同性别。请将原始姓名与结果保留在一起,以便审核。如果相关信息可用,解析器还可以返回姓名组成部分和可能关联的国家/地区。
📌 赶时间?先看摘要
本指南将介绍如何对名单运行 Name Parser,并审核其输出结果。
**输入:**CSV 或 Excel 文件中的
Name列。**输出:**可选的
Gender、姓名组成部分、Country、Country Confidence和Processed字段。为什么考虑使用 Datablist:
- 无需编写代码,即可映射源数据列和结果列。
- 处理整个名单前,可先预览一小部分样本。
- 将二元性别姓名关联视为不确定的推断,而非经过验证的个人数据。
本指南涵盖哪些内容
Datablist 是什么?快速了解
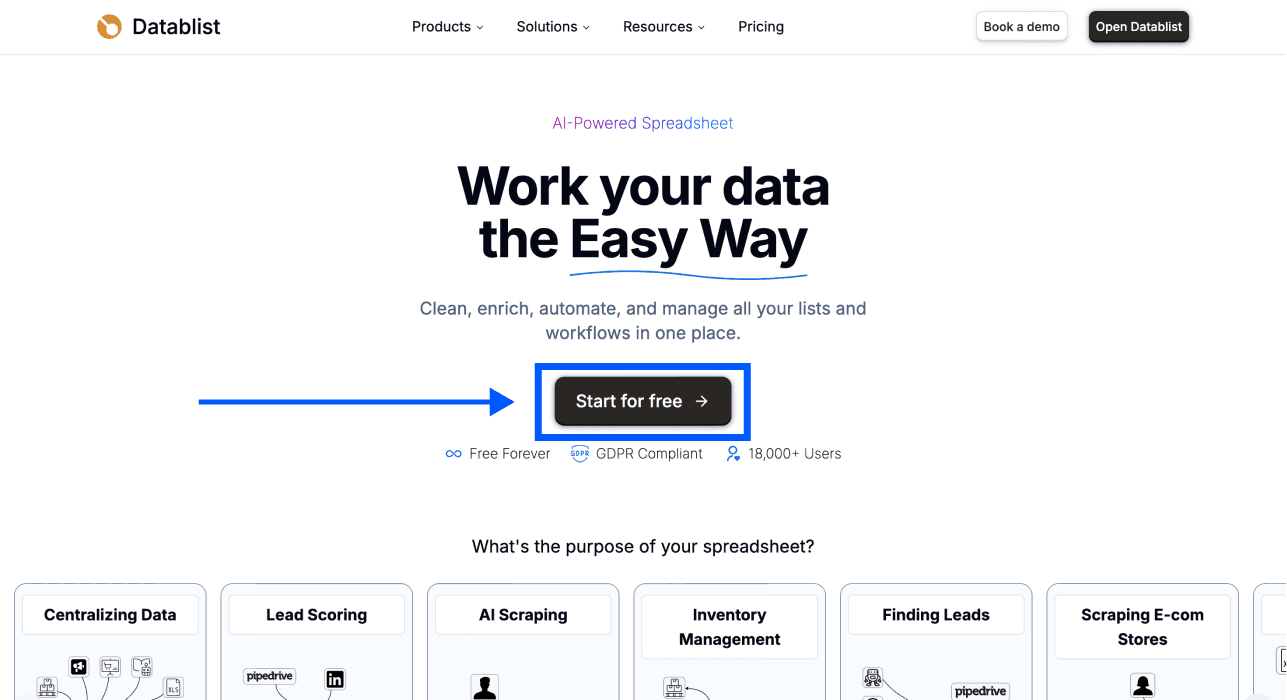
根据姓名推测性别 - Datablist 首页
Datablist 是一款由 AI 驱动的电子表格,可用于导入、清理和丰富名单数据。执行这项任务时,请将原始姓名和解析结果保存在同一个 collection 中,以便检查异常匹配,并仅导出所需字段。
性别识别工具的工作原理
在介绍具体步骤前,不妨先了解这些工具如何通过姓名推测性别。这有助于你获得更可靠的结果,并理解准确性可能因何而异。
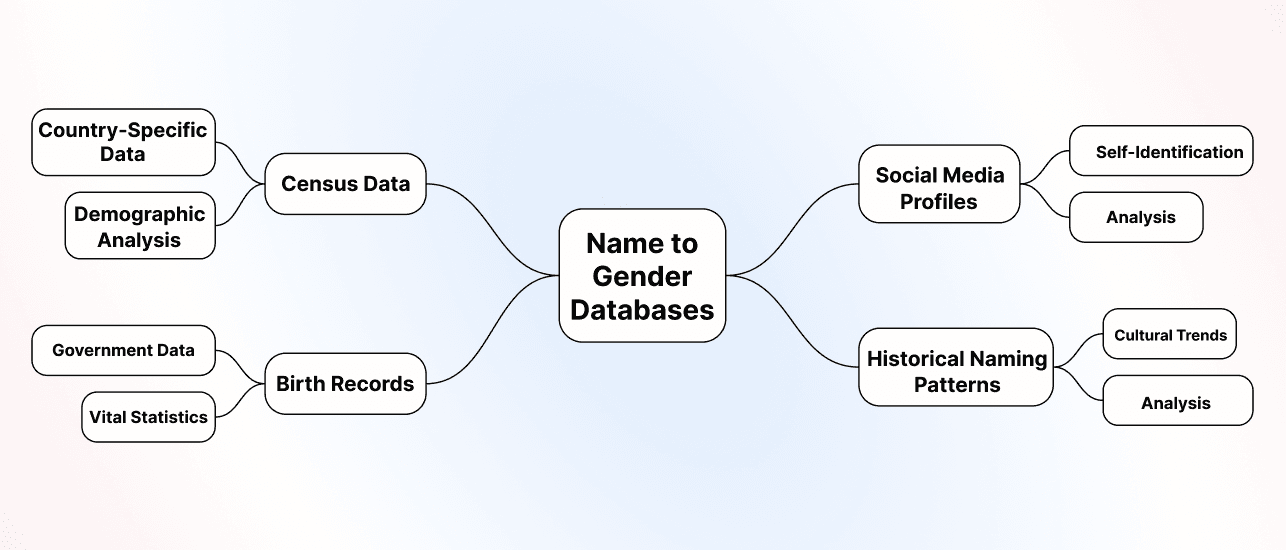
基本原理:姓名与性别数据库
Datablist 的 Name Parser 使用姓名数据集,根据解析出的姓名组成部分推断关联性别。成功识别到关联时,其 Gender 输出为 Male 或 Female;该字段也可能为空。它并不会询问本人如何认同自己的性别。另一个独立字段 Country Confidence 表示推测国家/地区的置信度,并非 Gender 字段的置信度。
为什么准确性会有差异
并非所有姓名都同样容易分类。以下因素会影响准确性:
有些姓名会被不同性别或文化群体共同使用,也可能存在姓名顺序不同、使用简称或拼写错误等情况。仅凭名字可能对应许多不同的人。如果需要称呼某人,应以对方明确表达的偏好为准,而不是使用推测得出的称谓。
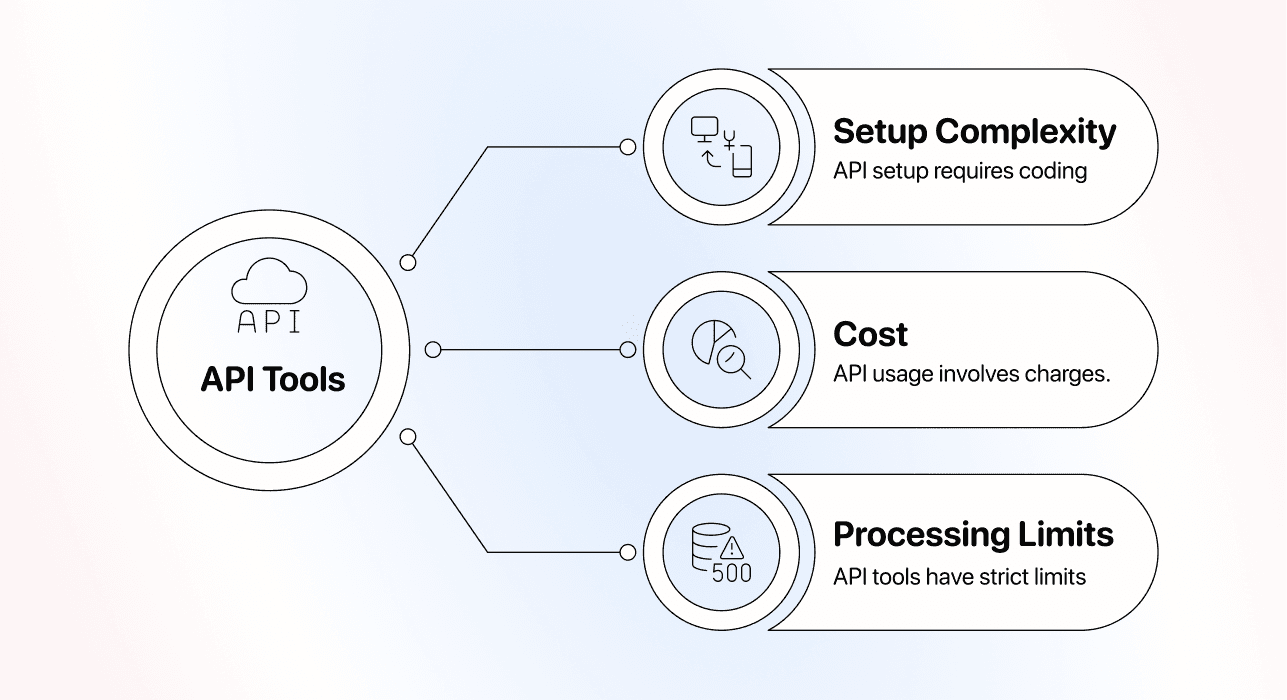
API 与 No-Code 工具的核心区别
在 Datablist 中,只需将一个 collection 属性映射到解析器的 Name 输入,然后在界面中选择输出属性即可。这个 workflow 无需编写 API 调用。
处理限制:不同工具有何区别
当前 action 目录将 Name Parser 标记为 premium enrichment,价格为每处理一个姓名消耗 0.05 credits,且需要付费套餐。处理大型 collection 前,请先运行少量样本,检查输出质量和 credits 用量。
使用 Datablist 根据姓名推测性别的优势
解析器可以将推测结果写入原始姓名旁边,同时返回名、中间名、姓、从输入内容中解析出的称谓,以及可能关联的国家/地区。Processed 标记有助于区分已尝试处理和尚未运行的记录。
**请保留原始姓名并审核结果。**源文本中的 Dr. 等称谓并不能验证性别。如果不知道对方希望如何被称呼,请使用中性称呼。
分 5 步根据姓名推测性别
请先从少量样本开始,以便在处理名单其余部分前检查含义不明确的姓名。
第 1 步:注册并上传数据
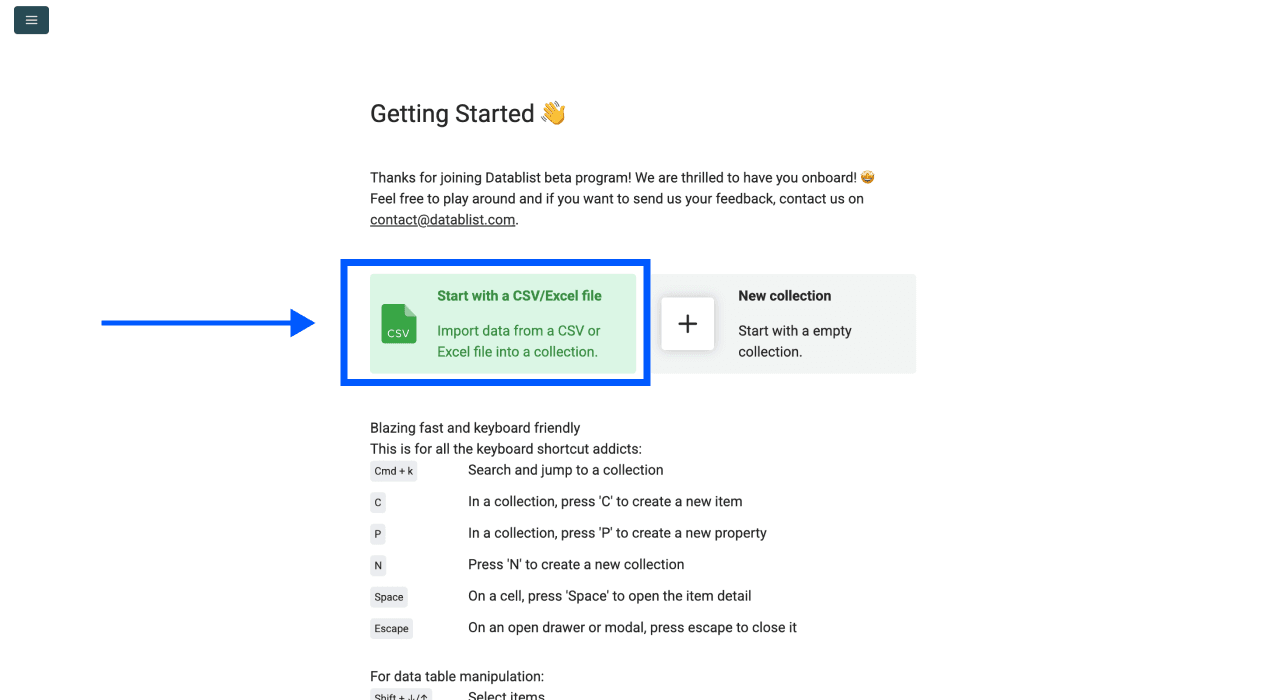
打开 Datablist,导入 CSV 或 Excel 文件。Name Parser 是付费套餐中的 enrichment,因此运行前请检查你的套餐和 credits 余额。
然后使用 Upload 上传包含待分析姓名的 Excel 或 CSV 文件。
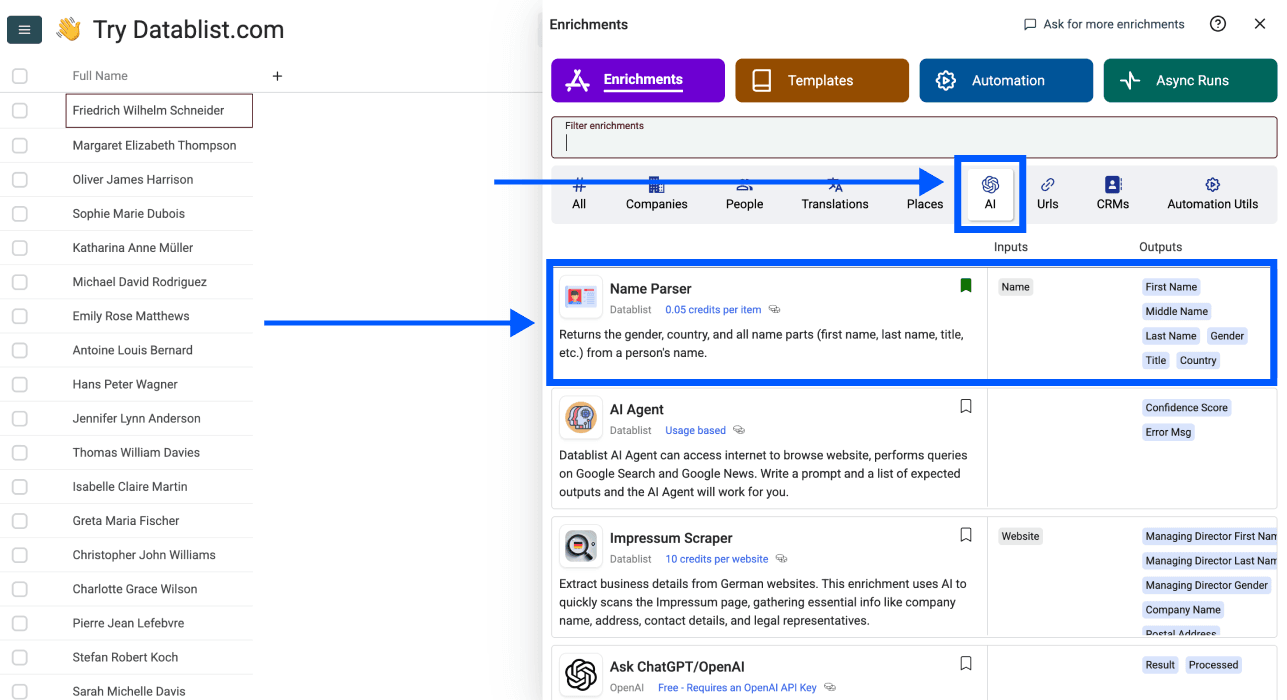
第 2 步:找到 Name Parser
- 点击顶部菜单中的 Enrich
- 前往 AI 分区
- 选择 Name Parser
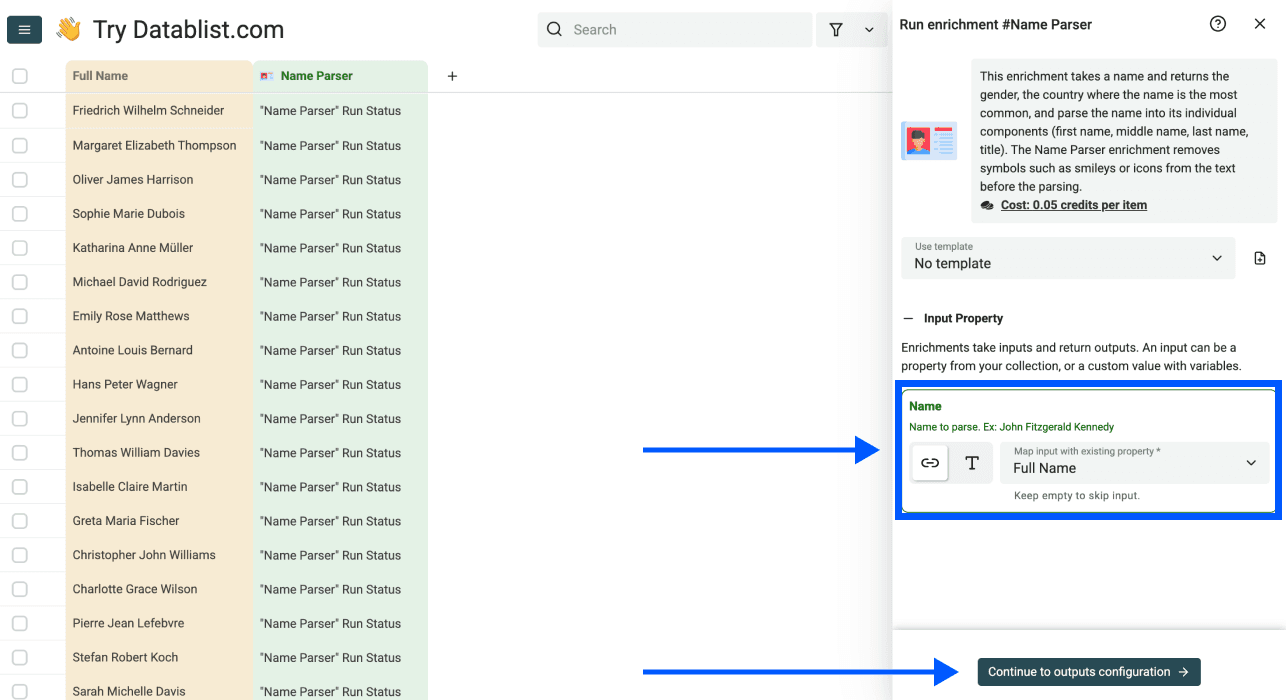
第 3 步:配置输入数据
你会看到一个简洁的界面,要求选择包含姓名的列。
- 将姓名列选为 Input Property
- 点击 Continue to outputs configuration
💡 实用提示
完整姓名可能有助于解析姓名的各个组成部分,但仍无法据此确定个人的性别认同,而且某些姓名不会返回任何性别关联。
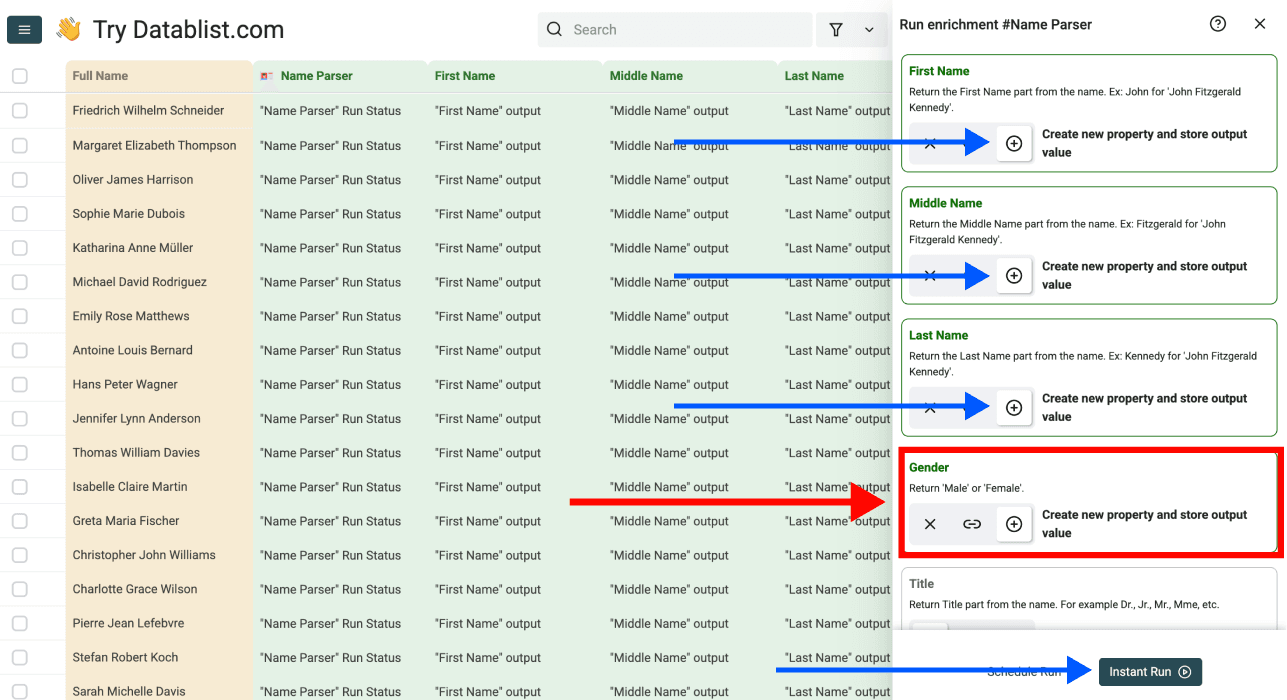
第 4 步:选择输出字段
选择要提取的数据。如果希望根据姓名推测性别,请确保已选择 Gender。
可用输出包括:
- Gender
- First Name
- Last Name
- Middle Name
- Title
- Country
- Country Confidence
- Processed
点击 ⊕ icons,为每项输出在 collection 中新增一列,然后点击 Instant Run。
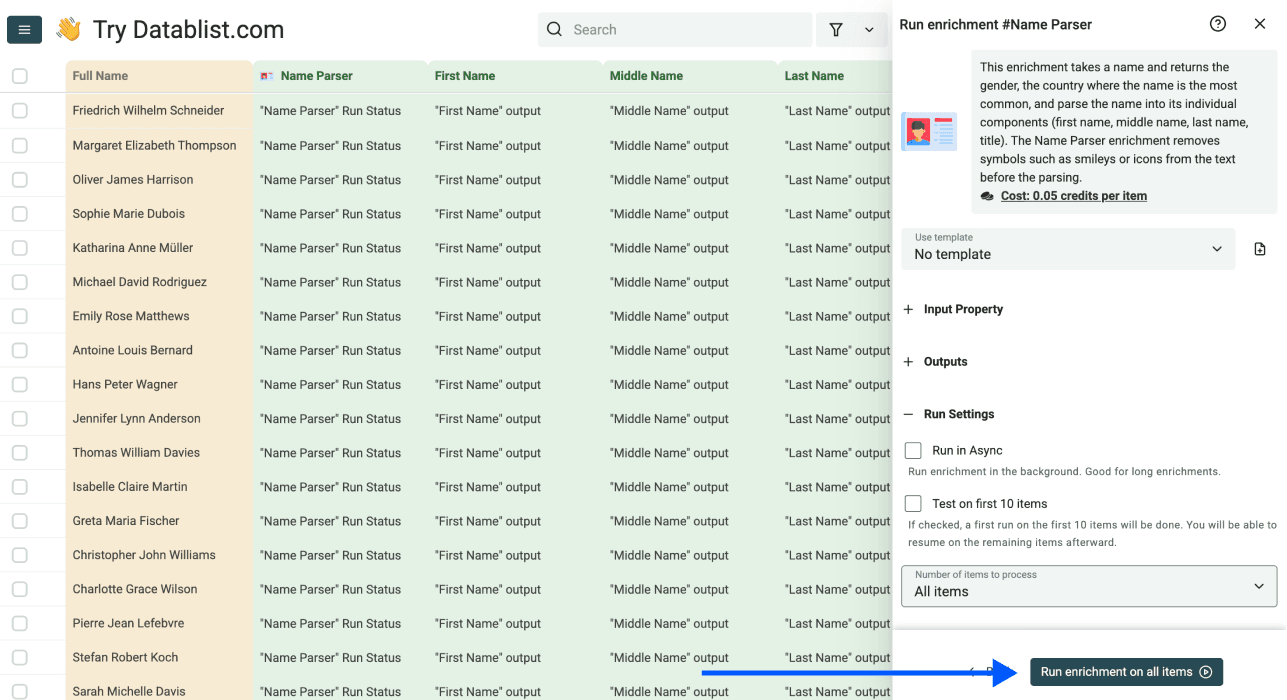
第 5 步:运行 Enrichment
先运行一批样本,并将输出与原始姓名进行比较。如果样本结果适合你的任务,再选择当前 view 中的其余记录。对于空白或不确定的结果,请保持未分类状态。
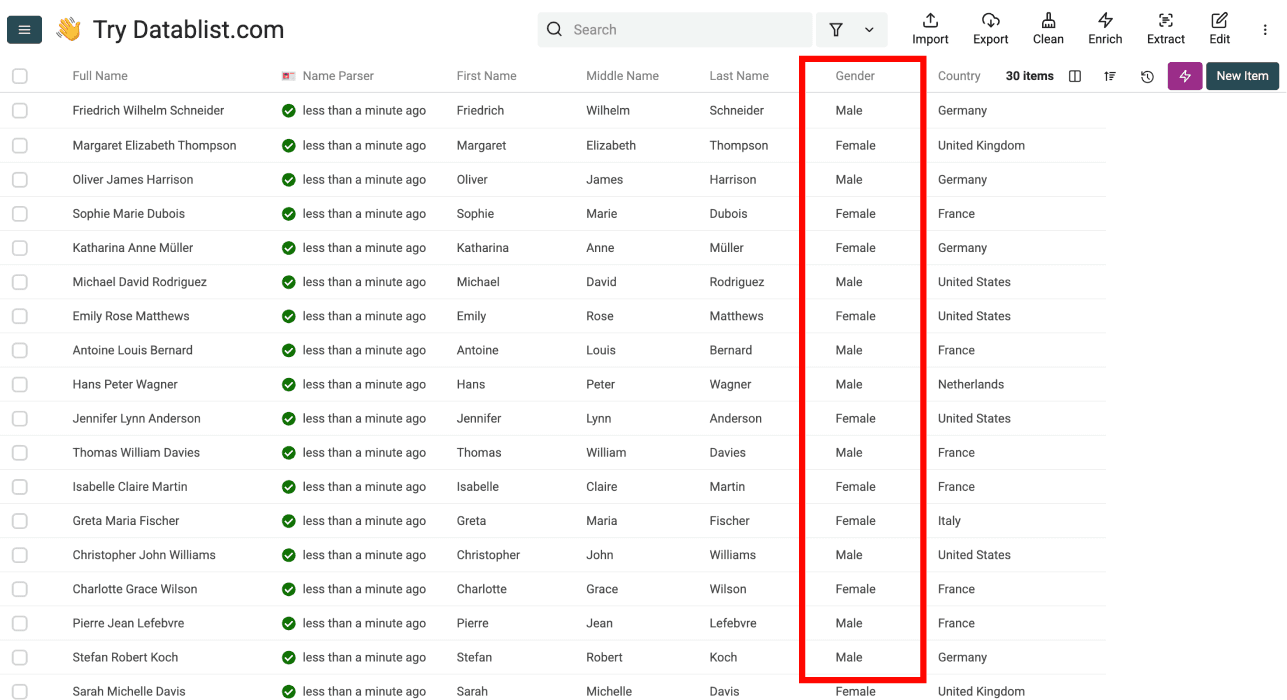
处理完成后,结果将如下所示:
解析器会对已处理的姓名消耗 credits,即使某个姓名没有返回有用结果也是如此。空白输入则会单独处理。
总结
无需编写 API 调用,即可推测姓名通常关联的性别。请将推测结果与已确认的个人信息分开保存。
借助 Datablist 的 Name Parser,你可以:
- 上传电子表格并映射其
Name属性 - 预览解析器可选的性别和姓名组成部分输出
- 审核含义不明确的结果,并在适当情况下使用中性称呼
- 将丰富后的数据导出为 CSV 或 Excel
进行大批量处理前,请查看套餐和 credits。
根据姓名推测性别:常见问题(FAQ)
Datablist 可以处理多少个姓名?
Name Parser 需要付费套餐,目前每处理一个姓名消耗 0.05 credits。可处理的数量取决于你的可用 credits 和 collection 限制。建议先测试少量样本;这项 premium action 并不提供固定的 10,000 个姓名免费额度。
是否有 Rate Limit?
该 action 会分批处理数据,每次运行都需要有足够的 credits。Collection 的导入限制取决于套餐和存储模式;提交大型名单前,请先查看运行费用预估。
如果还需要拆分姓名怎么办?
Name Parser 可以同时完成这两项任务。只需将 "First Name"、"Last Name" 和 "Gender" 选为输出,即可通过一次运行获得这三列数据。更多详细说明,请参阅我们的如何在 Excel 中拆分姓名指南。
能否识别不同语言姓名的性别?
解析器可以处理来自不同地区的姓名,但数据覆盖范围和姓名排列顺序会有所不同。请分别检查文件中每种语言或地区的样本,不要假设所有记录都能获得同等质量的结果。
根据姓名识别性别有多准确?
输出是根据姓名数据集得出的关联,并非经过验证的身份信息,也不是针对你的文件公布的准确率。含义不明确、不常见或过短的姓名可能返回错误或空白结果。请审核结果,不要用它来判定某个人如何认同自己的性别。
API 性别识别工具与 Datablist 有什么区别?
API 需要进行技术集成。在 Datablist 中,你只需导入文件、映射 Name 输入、选择输出字段,然后直接在界面中运行 enrichment。
如何根据名字推测性别?
将名字列或完整姓名列映射到解析器的 Name 输入。任何返回的 Male 或 Female 标签都只能视为姓名关联,使用前务必检查。
如何向 Excel 表格添加性别数据?
将 Excel 文件导入 Datablist,运行 Name Parser,并把 Gender 映射到一个新属性。审核样本后,可根据需要将结果导出为 Excel。
如何判断一个姓名属于男性还是女性?
仅凭姓名无法确定一个人是男性还是女性。解析器可能为某个姓名返回 Male 或 Female 关联,也可能将输出留空。如果对方的性别认同对当前场景很重要,请直接询问本人。
如何从姓名名单中获取性别信息?
导入名单,选择姓名列,再选择解析器的 Gender 输出并运行样本。空白输出应保持为空,同时审核含义不明确的姓名。