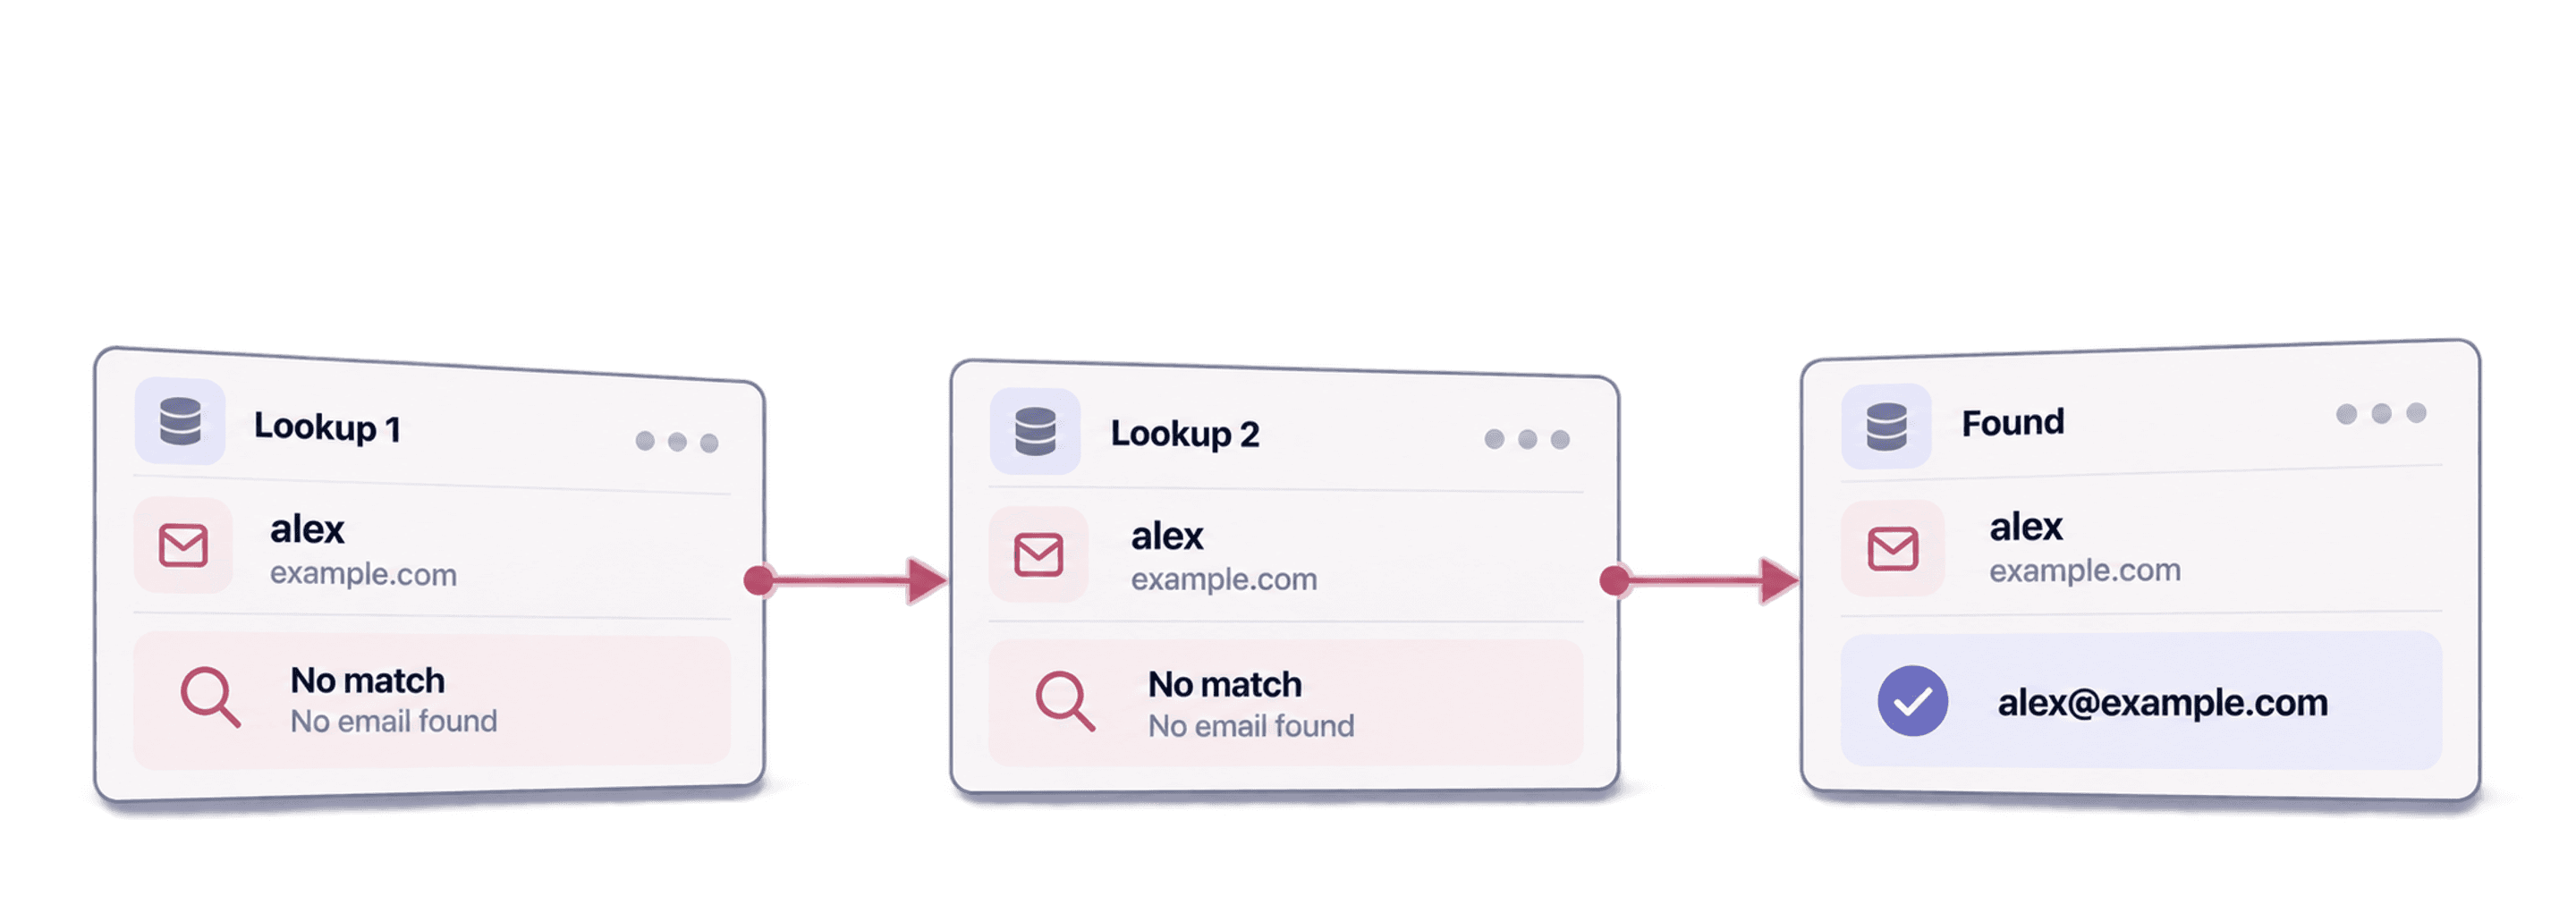
瀑布式数据补全(Waterfall Enrichment)会按顺序查询多个数据源,以补齐缺失信息。如果第一个 Provider 无法返回所需结果,系统就会继续尝试下一个。对于 Lead 列表,这可能意味着根据姓名和公司查找工作邮箱,或通过 LinkedIn 个人资料查找电话号码。
真正值得关注的是:这套查询顺序能为你的 Lead 列表额外找到多少可用联系人。增加 Provider 数量,并不代表一定能达到某个匹配率或带来相应的营收增长。本指南将介绍完整流程、需要准备的输入信息,以及如何判断哪些结果值得保留。
瀑布式数据补全如何运作
首先,你需要有一个可识别的联系人,以及希望获取的字段。Email Finder 用于查找邮箱地址;Email Verifier 则用于评估已有邮箱。两者解决的是不同问题。
一次典型的邮箱查找流程如下:
- 将联系人的身份信息发送给第一个 Provider。
- 如果结果符合本次查找的接受标准,则保留该结果。
- 对仍缺少结果的记录,继续尝试后续 Provider。
- 返回结果及其状态;如果没有找到可用结果,则返回相应说明。
Datablist 的 Waterfall Email Finder 会让尚未获得结果的记录依次经过 Provider 序列。当 Provider 尝试次数或处理限制达到上限时,本次运行也可能结束。没有返回结果,并不代表这个联系人没有邮箱地址。
以下是一个输入示例,并非实际的数据补全测试结果:
| Lead ID | 姓名 | 公司域名 | 现有邮箱 | 任务 |
|---|---|---|---|---|
| L-101 | Alex Rivera | example.com | 空 | 查找工作邮箱 |
| L-102 | Sam Taylor | example.org | sam@example.org | 验证现有邮箱 |
| L-103 | Jordan Lee | 缺失 | 空 | 确认任职公司,或使用已有 LinkedIn 个人资料 |
只有第一行适合直接使用“姓名 + 公司”的邮箱查找流程。如果对这三行执行同一个操作,就会把“输入信息缺失”和“查找失败”混为一谈,还会在已有邮箱的记录上浪费资源。
在 Datablist 中运行瀑布式邮箱查找
1. 准备身份识别字段
将 Lead 导入 Datablist collection。请保留 CRM ID 或来源 ID,并同时保留联系人姓名、公司名称或域名,以及所有已知的联系方式。
确认公司信息对应的是联系人当前所在的企业。同名但任职于不同公司的人,应被视为不同的查找输入。数据补全前先删除明显重复的 Lead,确保每个目标联系人只需审核一份结果。
2. 选择邮箱查找方式
打开 Enrich,选择 Waterfall Email Finder。在 Email Search Method 中选择适合现有数据的方式:
- By Name and Company (default):映射联系人姓名和公司信息。如果有公司域名,建议优先使用。
- By LinkedIn URL:映射联系人的个人资料 URL。公司主页 URL 不等于个人资料 URL。
如果名字和姓氏分别存放在不同字段中,请同时映射这两个字段。如果数据只有一个完整姓名字段,应配置完整姓名输入,不要把整个姓名都填入名字字段。
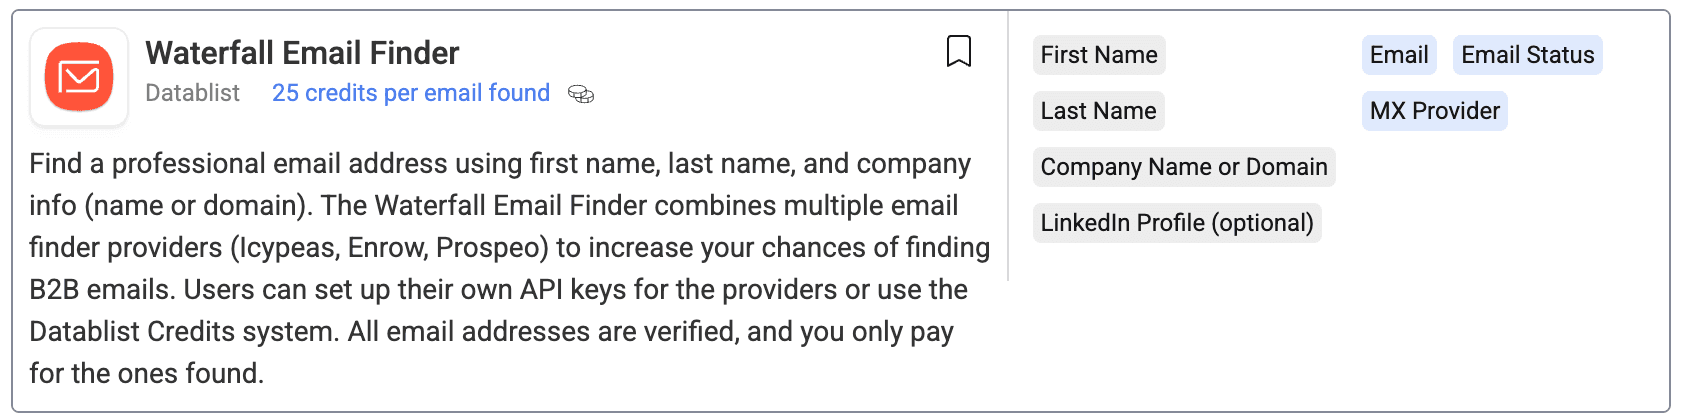
通过 custom waterfall configuration,你可以为“姓名 + 公司”查找方式配置自己的 Provider 顺序和 API keys。设置自定义序列前,请先确认当前选择的查找方式;它并不是适用于所有搜索模式的通用设置。
3. 配置输出并测试小批量样本
将返回的邮箱及其状态保存在不同列中。如果要比较新旧联系方式,请继续保留原有邮箱列。在决定导出哪些数据前,你需要明确哪些值来自本次运行。
建议先建立一个包含代表性记录的小型 collection:包括姓名和域名完整的记录、带 LinkedIn 个人资料的记录,以及缺少某项输入的记录。先审核输出,再扩展到完整列表。
审核结果后,你可能会采取以下处理方式:
| 返回结果 | 需要检查的内容 | 下一步 |
|---|---|---|
| 状态为已验证的邮箱 | 联系人及其任职公司是否与输入一致 | 为后续联系人流程保留邮箱和状态 |
| 状态为未验证的邮箱 | 是否需要进一步验证 | 与已验证结果分开保存 |
| 未找到邮箱 | 输入质量和现有身份标识 | 完善输入信息,或保持字段为空 |
| 输入缺失或无效 | 字段映射和来源记录 | 修正输入后再重试 |
以上只是审核场景,并不意味着每次运行都会返回所有这些状态。请查看所选操作实际生成的状态列。技术故障与正常完成但未匹配到结果,不应被视为同一种情况。
4. 导出时保留数据来源
导出来源 ID、返回的邮箱、状态,以及将结果匹配回原始联系人的必要字段。不要仅仅因为系统返回了新邮箱,就直接覆盖已知邮箱。应先比较联系人身份与结果质量。
瀑布式数据补全的成本与收益
更多可用联系人可以提高 Lead 列表的可触达覆盖率。这属于覆盖率收益;最终能否带来营收,则取决于这些联系人是否相关、能否触达,以及是否有购买意愿。
例如,假设单个 Provider 能从 100 条 Lead 中返回 55 个可用联系人,而瀑布序列能返回 80 个,那么后者额外增加了 25 个联系人。相对于原来的 55 个,联系人数量约增加了 45%。但这并不能证明营收也会增长 45%。这些数字只是说明性假设,并非 Datablist 的基准测试结果。
评估自己的运行结果时,应比较同一批符合条件的 Lead。记录可用结果数、相较第一个 Provider 新增的结果数、未成功的查找数以及消耗的 credits 总量。当额外获取的联系人足以覆盖相应成本和审核工作量时,第二个 Provider 才真正值得使用。
值得采用瀑布式数据补全的五个理由
1. 弥补单个 Provider 的数据覆盖缺口
第二个数据源可能掌握第一个数据源没有的信息。应衡量每个 Provider 带来的新增结果,而不是默认它们都能提供互不重复的数据覆盖。
2. 减少手动重试
瀑布序列会自动对缺少结果的记录执行 fallback 查询。你仍然需要准备输入并检查状态,但不必手动把每条失败记录提交到下一个工具。
3. 根据现有数据选择查找方式
姓名和公司域名适用于一种流程,个人资料 URL 则适用于另一种。应根据实际拥有的身份标识选择方法,而不是靠猜测填补缺失字段。
4. 区分信息查找与邮箱验证
查找邮箱、查找联系人和验证邮箱地址,回答的是三个不同问题。选择正确的操作,可以避免把所有返回字段都误当成已经验证的联系数据。
5. 按目标受众评估覆盖率
整份列表的总体结果可能掩盖不同国家、行业或公司类型之间的差异。将瀑布序列用于新市场前,应先测试具有代表性的细分样本。
根据任务选择 Datablist 瀑布式工具
Waterfall Email Finder
当你知道联系人身份并需要其工作邮箱时,可以使用该工具。准备姓名和公司信息,或个人 LinkedIn URL,选择对应的查找方式,然后审核返回的邮箱及其状态。
如需了解完整的联系人列表处理流程,请参阅批量查找邮箱指南。
Waterfall Phone Finder
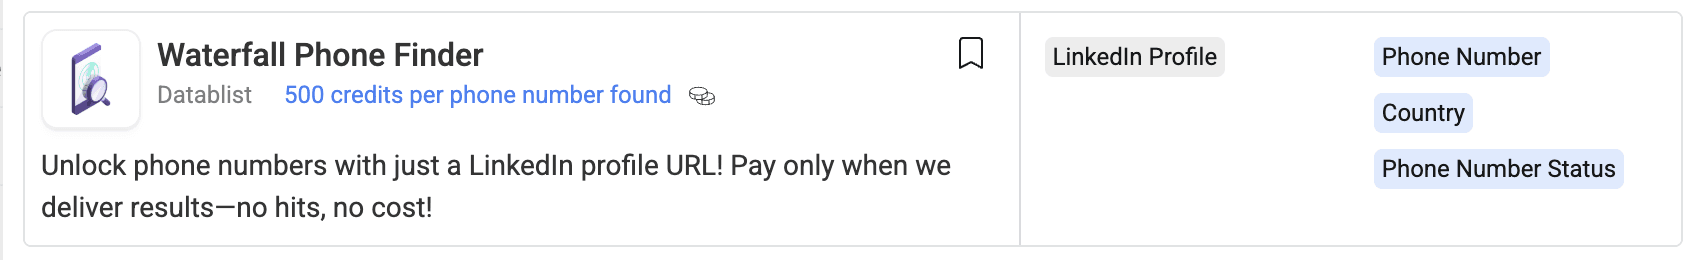
如果你有联系人的 LinkedIn 个人资料,并希望查找电话号码,可以使用 Waterfall Phone Finder。输出内容包括电话号码、国家以及电话号码状态。将号码传输到其他系统时,请保留国际区号。
返回的号码仍需与你的目标联系人相匹配。不要因为工具使用了 Waterfall 标签,就认为结果一定是手机号码,或覆盖所有国家和地区。
Waterfall People Search
如果你知道公司信息,并希望发现该公司的相关人员,可以使用 Waterfall People Search。公司域名是搜索的基础。请在 Waterfall Searches 中配置符合目标画像的职位、部门和职级。
当首次查找没有结果时,fallback 搜索条件可以扩大查询范围。你仍需检查最终找到的联系人是否符合目标要求;fallback 职位并不一定与首选职位等价。
发现新联系人与补全已知联系人的信息,是两种不同的工作流。如需补全已知联系人的资料,可以使用 Waterfall People Enrichment。
Waterfall Advanced Email Address Verification
如果你已经有邮箱地址,可以使用 Waterfall Advanced Email Address Verification。输出包括邮箱状态及其原因,以及该地址是否为角色邮箱等辅助信息。
邮箱验证可以帮助你评估地址质量,但不能保证邮件一定进入收件箱、收件人一定感兴趣,或该地址未来仍可投递。
瀑布式数据补全的应用场景
**CRM 维护:**在不丢失原始记录 ID 的情况下补齐联系信息字段。更新现有联系人前,应检查其任职公司是否发生变化。更完整的流程请参阅我们的 CRM 数据清洗与补全指南。
**Account 调研:**从公司域名开始,通过 People Search 找到相关职位的联系人。如果 fallback 匹配到的职位与首选目标不同,应将这些结果分开保存。
**联系人列表准备:**查找缺失邮箱,并在导出前审核状态。对于已有邮箱,应单独进行验证,而不是对每一行都运行 Email Finder。
瀑布式数据补全常见问题
瀑布式数据补全与普通数据补全相同吗?
数据补全是为现有记录添加信息;Waterfall 则描述一系列依次执行的尝试或 fallback 条件。使用单个 Provider 的查询也属于数据补全,但不属于 Provider 瀑布序列。
瀑布式数据补全能保证 80% 的匹配率吗?
不能。覆盖率取决于目标受众、身份标识、Provider 和结果接受标准。应使用有代表性的样本进行测试,并针对同一批符合条件的输入计算可用匹配率。如果缺少这些背景信息,一个百分比无法有效预测你的列表表现。
所有 Waterfall 操作都只对成功匹配收费吗?
不能用同一套计费规则概括整个工具套件。费用和计费结果取决于所选操作及具体配置。运行大型列表前,请查看该操作当前的用量说明和 Datablist credits 文档。自定义 Provider 序列还可能使用你自己的 Provider 账户。
是否应该重试每一条没有结果的记录?
先检查输入和状态。重试前,应修正缺失的公司信息、过期的任职信息或无效的个人资料 URL。在输入完全不变的情况下重复查找,并不等于改善了查询条件。