
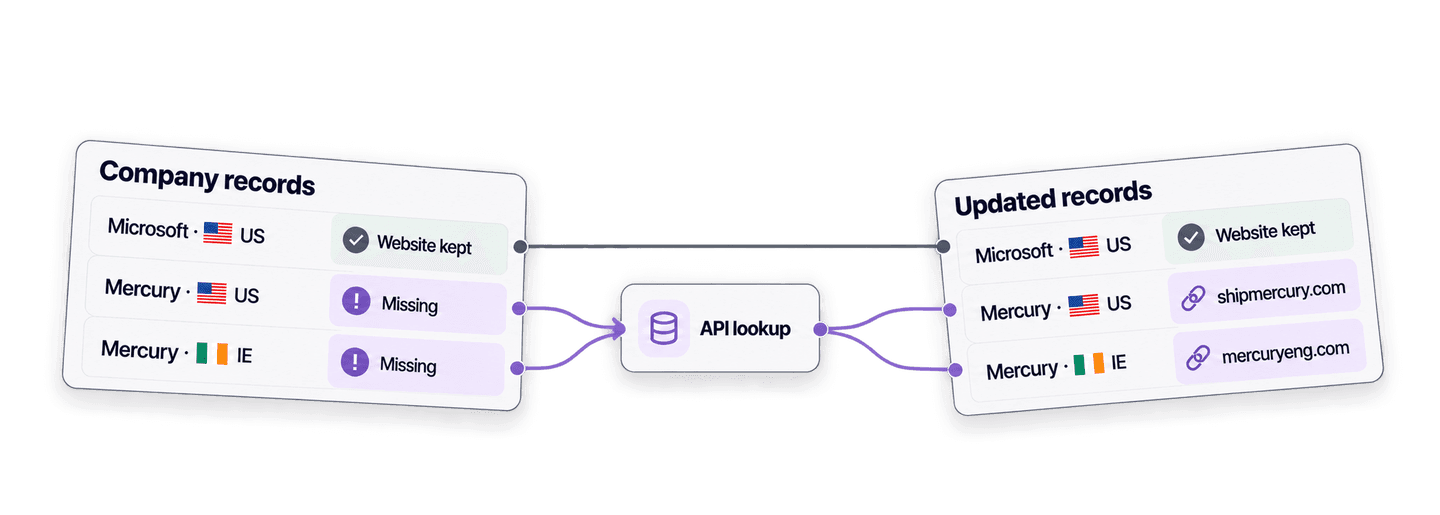
Um die Website eines Unternehmens anhand seines Namens mit Python zu finden, sendest Du den Namen und – sofern vorhanden – das Land an die Company Name to Domain API von Datablist. Die API verarbeitet die Suche im Hintergrund und gibt anschließend die Domain sowie die vollständige Website-URL zurück.
Zuerst zeige ich Dir einen einfachen Python-API-Request. Danach verwenden wir dieselbe Funktion, um in einer Liste von Unternehmensdatensätzen nur die fehlenden Websites zu ergänzen. Bereits vorhandene URLs bleiben dabei erhalten.
Wenn Du lieber mit einer Oberfläche wie in einer Tabellenkalkulation arbeitest, hilft Dir unser Guide zur Bulk-Suche von Unternehmenswebsites weiter.
💡 Kurzfassung für Eilige
Erstelle eine Python-Funktion, die anhand von Unternehmensnamen die passenden Websites findet. Nutze sie anschließend, um Datensätze mit leeren Website-Feldern zu vervollständigen, ohne bekannte URLs zu überschreiben.
- Input: Unternehmensnamen, optional mit Land.
- Output: Domain, vollständige Website-URL, Konfidenz, Ergebnisstatus und verbrauchte Credits.
Python und Deinen Datablist API Key einrichten
Für dieses Beispiel verwende ich das Requests-Paket, um synchrone HTTP-Requests zu senden. Installiere es in einer virtuellen Umgebung:
python3 -m venv .venv
source .venv/bin/activate
python -m pip install requestsDu benötigst außerdem einen Datablist Growth-Tarif, da der Zugriff auf die REST API eine Growth-Funktion ist. Erstelle auf Deiner Datablist API-Kontoseite einen Personal API Key und speichere ihn anschließend in einer Umgebungsvariable:
export DATABLIST_API_KEY="exampleuser-exampleaccount-EXAMPLE_TOKEN_NOT_VALID-2"🔑 Du hast bereits einen API Key? Ältere Keys verwenden das Format
auth0|<userId>:<accountId>:<secret>:1. Sie werden weiterhin unterstützt. Nutze Deinen vorhandenen Key genau so, wie er erstellt wurde – Du musst ihn weder ersetzen noch neu formatieren.
Ersetze den Beispielwert durch den Key aus Deiner Kontoseite. Die Suche nach Unternehmenswebsites verbraucht Credits. Bevor wir das Script skalieren, erkläre ich Dir die Varianten mit 1 beziehungsweise 2,5 Credits. Die aktuellen Tarifwerte findest Du auf der Datablist-Preisseite.
Eine Unternehmenswebsite mit Python finden
Erstelle eine Datei namens find_company_websites.py. Das Script übermittelt die Namen, wartet auf die Verarbeitung des Tasks und ruft die Ergebnisse ab – alles innerhalb einer einzigen Funktion. Jeder Input verwendet Deine dauerhafte Datensatz-ID als inputId. So kannst Du jedes Ergebnis dem richtigen Datensatz zuordnen, selbst wenn sich die Reihenfolge der Response ändert.
import json
import os
import time
import uuid
import requests
API_BASE_URL = "https://api.datablist.com/v1"
def find_domains(companies, api_key):
headers = {
"Accept": "application/json",
"Content-Type": "application/json",
"X-API-Key": api_key,
}
inputs = [
{
"inputId": company["id"],
"data": {
"companyName": company["company_name"],
"targetCountry": company.get("country", ""),
},
}
for company in companies
]
unique_id = f"python-domain-lookup-{uuid.uuid4().hex}"
payload = {
"enrichmentId": "company-name-to-domain",
"uniqueId": unique_id,
"settings": {
"workflow": "dataset_google",
"countryOverwrite": True,
"acceptNonRoot": True,
},
"inputs": inputs,
}
print(f"Task uniqueId: {unique_id}")
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} ended with status {task['status']}: {task.get('error')}"
)
results = []
cursor = None
while True:
params = {"limit": 100}
if cursor is not None:
params["cursor"] = cursor
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}/results",
headers=headers,
params=params,
)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
break
return results
api_key = os.environ["DATABLIST_API_KEY"]
companies = [
{
"id": "direct-microsoft-us",
"company_name": "Microsoft",
"country": "US",
}
]
lookup_results = find_domains(companies, api_key)
for result in lookup_results:
print(json.dumps(result, indent=2))Führe das Script in dem Terminal aus, in dem Du den Key exportiert hast:
python find_company_websites.pySo sieht das Ergebnis für Microsoft aus:
{
  "inputId": "direct-microsoft-us",
  "status": "success",
  "outputs": {
    "companyUrl": "https://microsoft.com",
    "companyDomain": "microsoft.com",
    "domainConfidence": "High"
  },
  "creditsUsed": "1",
  "error": null
}
Mit inputId ordnest Du das Ergebnis dem ursprünglichen Datensatz zu. status kann success, no_result, error oder skipped sein. Ein erfolgreiches Ergebnis kann companyDomain, die vollständige companyUrl und domainConfidence enthalten. creditsUsed zeigt die Kosten für diesen Input, während error einen Fehler auf Datensatzebene erläutert.
Die Funktion führt nacheinander drei Arten von API-Calls aus.
Zuerst übermittelt sie die Suchanfrage. Der Payload enthält die Einstellungen und Unternehmensdatensätze. Der POST-Request gibt 202 Accepted zurück. @id ist die Task-ID, die für die folgenden Requests benötigt wird:
response = requests.post(
f"{API_BASE_URL}/enrichments/tasks",
headers=headers,
json=payload,
)
response.raise_for_status()
task_id = response.json()["@id"]Wenn DATABLIST_API_KEY nicht gesetzt ist, löst Python beim Auslesen der Umgebungsvariable einen KeyError aus, noch bevor ein HTTP-Request gesendet wird. Exportiere die Variable und starte das Script erneut. Enthält sie einen ungültigen Key, erreicht der POST-Request die API und gibt HTTP 401 zurück. Kopiere einen aktuellen Personal API Key von Deiner Kontoseite und ersetze damit den ungültigen Wert.
Danach fragt sie den Task-Status ab. Da der POST-Request die Verarbeitung im Hintergrund startet, ruft das Script den Task alle drei Sekunden ab, bis er den Status completed, failed oder stopped erreicht:
while True:
response = requests.get(
f"{API_BASE_URL}/enrichments/tasks/{task_id}",
headers=headers,
)
response.raise_for_status()
task = response.json()
if task["status"] in {"completed", "failed", "stopped"}:
break
time.sleep(3)Schlägt der Task wegen fehlender Credits fehl, enthält der Fehler den Grund credits_error. Füge Credits hinzu oder warte, bis Deine monatlichen Credits erneuert werden. Prüfe bereits zurückgegebene Ergebnisse und übermittle anschließend nur die noch nicht verarbeiteten Inputs in einem neuen Task.
Zum Schluss ruft sie alle Ergebnisseiten ab. Jede Response ergänzt die Ergebnisliste und liefert den Cursor für den nächsten Request:
results.extend(page["results"])
cursor = page.get("nextCursor")
if cursor is None:
breakDie Funktion ruft so lange weitere Seiten ab, bis nextCursor den Wert null hat.
Vor dem POST-Request gibt das Script die generierte uniqueId aus. Falls die Verbindung abbricht, bevor Du die Response zur Task-Erstellung erhältst, solltest Du zunächst Deine Tasks auflisten und ihren Status prüfen, bevor Du einen weiteren Task erstellst:
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-name-to-domain"Suche nach dem Task, dessen uniqueId mit dem vom Script generierten Wert übereinstimmt, und kopiere seine @id. Der Listen-Endpunkt kann nach enrichmentId, aber nicht nach uniqueId filtern. Verwende die @id mit denselben Status- und Ergebnis-URLs wie im Script. Ist der Task noch aktiv, frage seinen Status weiter ab. Wurde er gestoppt oder ist er fehlgeschlagen, prüfe zunächst, ob Teilergebnisse vorliegen, bevor Du die Inputs erneut übermittelst.
Dataset-Matching und länderspezifischen Fallback verstehen
Das Script verwendet dataset_google, die empfohlene Standardeinstellung. Datablist durchsucht zuerst seine Unternehmensdatensätze. Fehlt ein Match oder sind die Ergebnisse widersprüchlich, kann Google als Fallback verwendet werden. Mögliche Treffer werden geprüft, bevor die API einen Konfidenzwert zurückgibt.
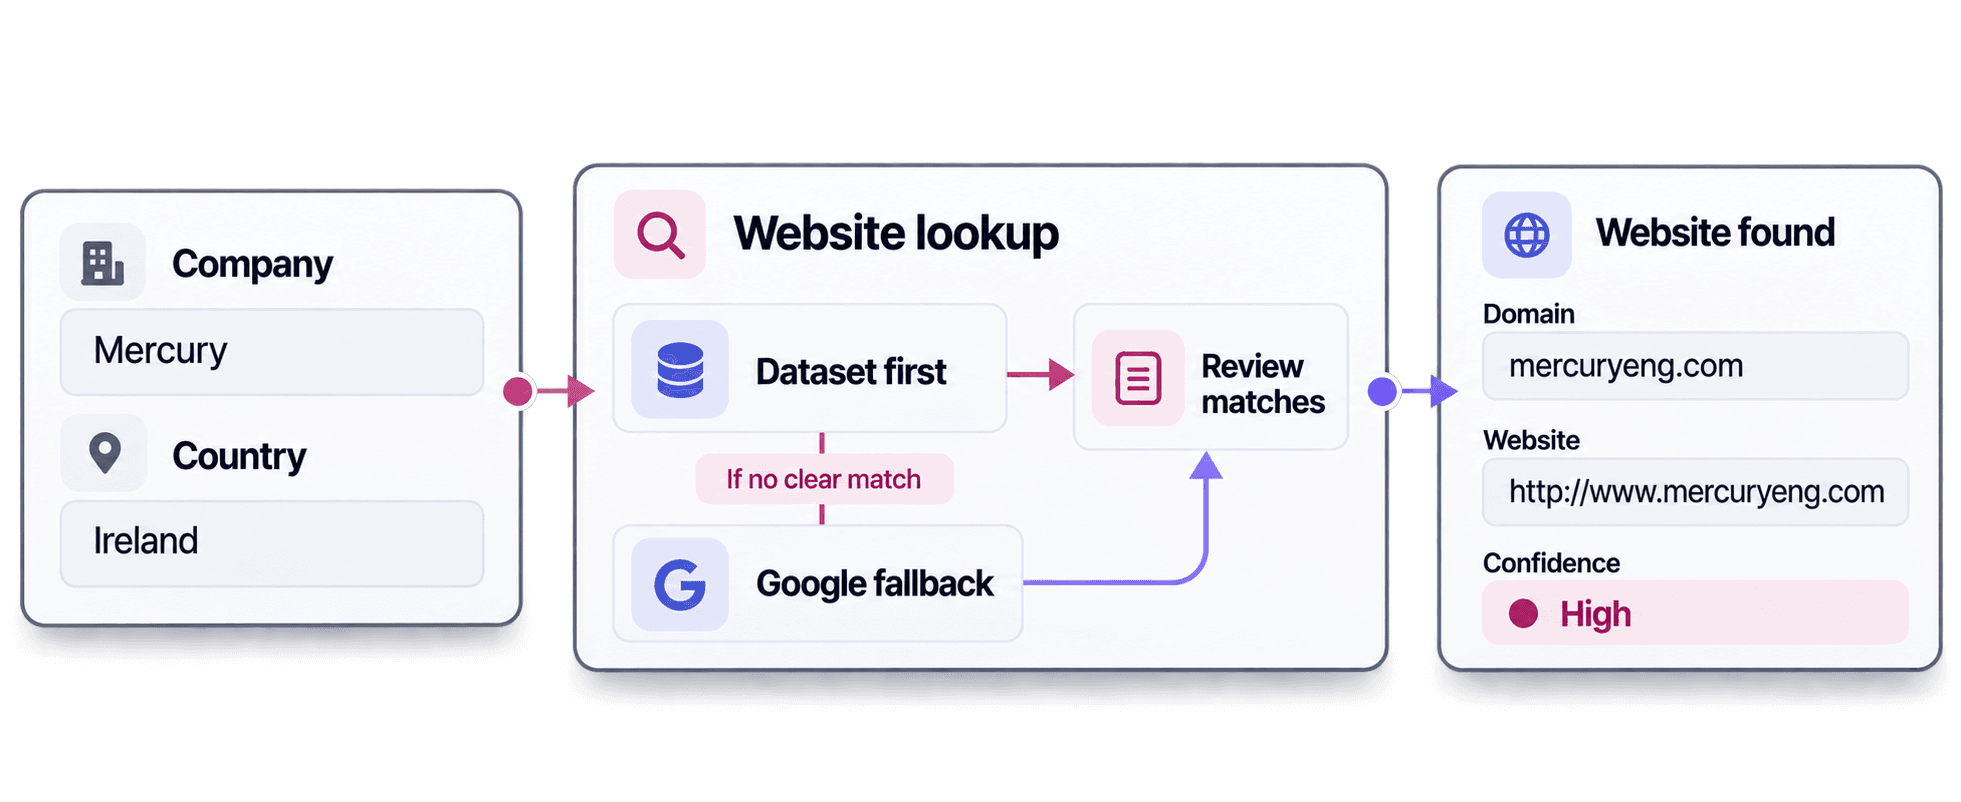
Das Land hilft bei mehrdeutigen Namen. In diesem Beispiel führte derselbe Unternehmensname zu unterschiedlichen Ergebnissen:
MercurymitUSergabshipmercury.comundhttps://www.shipmercury.com/.MercurymitIEergabmercuryeng.comundhttp://www.mercuryeng.com.
Beide Treffer hatten die Konfidenz High. Das Land hilft der Suche, zwischen Unternehmen mit demselben Namen zu unterscheiden. Anhand der Konfidenz kannst Du anschließend entscheiden, welche Ergebnisse geprüft werden sollten.
Hängt das Match zusätzlich von Branche, Unternehmensgröße oder anderem geschäftlichen Kontext ab, nutze den AI Agent Research Workflow. Ergänze diese Angaben im Prompt des AI Agent, damit er mit einem umfassenderen Geschäftskontext nach dem richtigen Unternehmen suchen kann.
Nur fehlende Websites in Datensätzen ergänzen
Da find_domains() jetzt anhand eines Unternehmensnamens eine Website findet, kannst Du die Funktion nutzen, um ausschließlich fehlende Websites in Deinen Unternehmensdatensätzen zu ergänzen. Datensätze, die bereits eine Website enthalten, umgehen die API. Ihre Werte bleiben dadurch unverändert und verbrauchen keine Lookup-Credits.
Ersetze in find_company_websites.py alles ab companies = [ bis einschließlich der letzten Print-Schleife durch den folgenden Block. Behalte die darüberstehende Zuweisung von api_key bei. Die Prüfung auf leere Werte berücksichtigt None, einen leeren String und reine Leerzeichen. Sind alle Websites vorhanden, erfolgt kein API-Call.
records = [
{
"id": "crm-001",
"company_name": "Microsoft",
"country": "US",
"website": "https://www.microsoft.com",
},
{
"id": "crm-002",
"company_name": "boulangerie du palais lyon",
"country": "FR",
"website": "",
},
{
"id": "crm-003",
"company_name": "Mercury Engineering",
"country": "IE",
"website": None,
},
{
"id": "crm-004",
"company_name": "Mercury",
"country": "US",
"website": " ",
},
{
"id": "crm-005",
"company_name": "Datablist",
"country": "FR",
"website": "https://www.datablist.com",
},
{
"id": "crm-006",
"company_name": "Mercury",
"country": "IE",
"website": None,
},
]
def website_is_missing(value):
return not isinstance(value, str) or not value.strip()
records_to_lookup = [
record for record in records if website_is_missing(record.get("website"))
]
lookup_results = (
find_domains(records_to_lookup, api_key) if records_to_lookup else []
)
results_by_id = {result["inputId"]: result for result in lookup_results}
for record in records:
if not website_is_missing(record.get("website")):
record["website_lookup"] = {"status": "not_requested"}
continue
result = results_by_id.get(record["id"])
if result is None:
record["website_lookup"] = {
"status": "missing_result",
"domain": None,
"confidence": None,
"credits": None,
"error": {
"code": "missing_result",
"message": "No result was returned for this inputId.",
},
}
continue
outputs = result.get("outputs") or {}
if result["status"] == "success" and outputs.get("companyUrl"):
record["website"] = outputs["companyUrl"]
record["website_lookup"] = {
"status": result["status"],
"domain": outputs.get("companyDomain"),
"confidence": outputs.get("domainConfidence"),
"credits": result.get("creditsUsed"),
"error": result.get("error"),
}
print(json.dumps(records, indent=2))Der Code indexiert die Ergebnisse anhand der inputId und durchläuft danach die ursprünglichen Datensätze in ihrer bestehenden Reihenfolge. Das Objekt website_lookup speichert das Ergebnis und die Angaben für die spätere Prüfung direkt beim jeweiligen Datensatz – auch bei erfolglosen oder fehlenden Ergebnissen.
Für crm-001 gibt website_is_missing() den Wert False zurück, da die Microsoft-URL bereits vorhanden ist. Der Datensatz wird nicht zu records_to_lookup hinzugefügt und daher nie an die API gesendet. Beim Zusammenführen bleibt die Website erhalten; als Status wird not_requested gespeichert.
Bei crm-002 ist das Website-Feld leer. Deshalb wird die Bäckerei mit inputId: crm-002 übermittelt. Die API gibt dieselbe inputId zurück. results_by_id findet damit das richtige Ergebnis, und beim Zusammenführen wird https://boulangerie-du-palais-lyon.eatbu.com in den Datensatz geschrieben – unabhängig von der Reihenfolge der Ergebnisse.
| ID | Unternehmen | Website nach dem Zusammenführen | Status | Domain | Konfidenz | Credits |
|---|---|---|---|---|---|---|
crm-001 | Microsoft · US | https://www.microsoft.com | not_requested | |||
crm-002 | boulangerie du palais lyon · FR | https://boulangerie-du-palais-lyon.eatbu.com | success | boulangerie-du-palais-lyon.eatbu.com | High | 1 |
crm-003 | Mercury Engineering · IE | https://mercuryeng.com | success | mercuryeng.com | High | 1 |
crm-004 | Mercury · US | https://www.shipmercury.com/ | success | shipmercury.com | High | 1 |
crm-005 | Datablist · FR | https://www.datablist.com | not_requested | |||
crm-006 | Mercury · IE | http://www.mercuryeng.com | success | mercuryeng.com | High | 1 |
Die Bäckerei verwendet die geschäftsspezifische Subdomain boulangerie-du-palais-lyon.eatbu.com. Behalte diesen Wert bei, statt ihn auf eatbu.com zu kürzen, und speichere die exakte Adresse aus companyUrl. Mit der Einstellung acceptNonRoot: true sind außerdem gehostete Unternehmensseiten erlaubt, deren Adresse nach dem Hostnamen einen Pfad enthält. Deshalb ist in beiden Fällen die vollständige URL wichtig.
Auch ein abgeschlossener Task kann Einträge mit no_result, error oder skipped enthalten. Das Beispiel ändert website nur, wenn der Status success lautet und companyUrl vorhanden ist. Bei no_result bleibt die Website leer und der Status ist weiterhin in website_lookup sichtbar. Prüfe zuerst den Unternehmensnamen und das Land. Ist einer der Inputs falsch, korrigiere ihn und übermittle den Datensatz in einem neuen Task. Andernfalls lässt Du das Website-Feld für eine manuelle Prüfung sichtbar leer.
Lookup-Credits vor dem Skalieren kalkulieren
Alle fünf Beispielabfragen waren mit der Konfidenz High erfolgreich und haben insgesamt 5 Credits verbraucht.
Ein über das Dataset aufgelöster Lookup kostet 1 Credit. Ein mit Google verarbeiteter Lookup kostet 2,5 Credits. Du bezahlst nur für den tatsächlich genutzten Weg, nicht für beide. Bei 1.000 Inputs sind das 1.000 Credits, wenn alle über das Dataset aufgelöst werden, oder 2.500 Credits, wenn für alle Google verwendet wird. Diese Zahlen dienen der Planung und sind keine Garantie dafür, dass jeder Lookup erfolgreich ist.
Bewege den Regler, um den Credit-Verbrauch für Deine Liste zu vergleichen.
Bei 20 US-Dollar für 20.000 Credits kosten diese Szenarien 1 beziehungsweise 2,50 US-Dollar. Das Growth-Abonnement wird separat abgerechnet und umfasst derzeit 20.000 monatliche Credits, die vor zusätzlich gekauften Credits verbraucht werden. Prüfe die aktuellen Preise, da sich Tarif- und Paketwerte ändern können.
Ein Task akzeptiert bis zu 10.000 Inputs, wobei pro Input ein Limit von 16 KiB und pro Request ein Limit von 10 MiB gilt. Dieses Beispiel verwendet blockierende Requests-Aufrufe, um einen kleinen asynchronen Datablist-Task zu übermitteln, seinen Status abzufragen und die Ergebnisse abzurufen. Das gepflegte Repository enthält außerdem Beispiele für CSV-Batching und nicht blockierende Clients.
Nächste Schritte
Sobald Du geprüft hast, dass eine gefundene Website zum gewünschten Unternehmen gehört, kannst Du das Impressum mit Python auslesen. So ergänzt Du denselben Lieferantendatensatz um rechtliche Unternehmensangaben und die URL der als Quelle verwendeten Impressumsseite. Prüfe den Website-Match unabhängig von der späteren Datenextraktion.
Ersetze die Beispieldatensätze durch einen kleinen Ausschnitt Deiner eigenen Daten. Führe anschließend das Script aus und prüfe die zusammengeführten Datensätze. Verwende dauerhafte IDs und das jeweilige Land. Skaliere erst, wenn das Script bekannte Websites zuverlässig beibehält und die erwarteten Lücken füllt. Wenn Du ein fertiges Script, CSV-Batching oder eine asynchrone Version suchst, kannst Du mit den gepflegten Company Name to Domain API-Beispielen auf GitHub starten.