
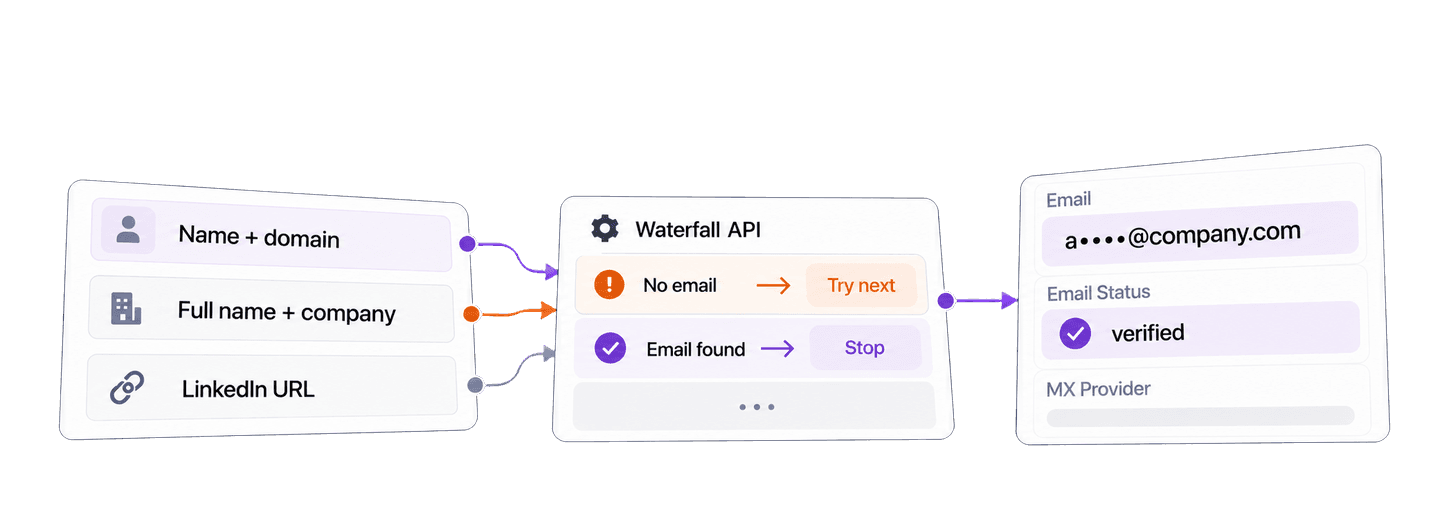
Um geschäftliche E-Mail-Adressen mit Python zu finden, sendest Du den Namen und die Unternehmensdaten einer Person oder die URL eines öffentlichen LinkedIn-Profils mit der Requests-Bibliothek an die Waterfall Email Finder API von Datablist. Die API gibt die gefundene geschäftliche E-Mail-Adresse, ihren Zustellbarkeitsstatus und den Mail-Provider zurück.
Das vollständige Beispiel unten sucht nach Satya Nadella bei microsoft.com und Reid Hoffman bei greylock.com. Es wartet auf den Abschluss des Hintergrund-Tasks und ruft sämtliche Ergebnisseiten ab. Anschließend verwende ich die Ergebnisse, um lokal eine Liste verifizierter Kontakte für die Kampagnenprüfung vorzubereiten.
📌 Kurzfassung für alle, die es eilig haben
Nutze eine einzige Python-Funktion, um bekannte Kontakte an die Waterfall Email Finder API zu senden, auf den Task zu warten und gefundene geschäftliche E-Mail-Adressen abzurufen. Bereite danach verifizierte Kontakte für die Kampagnenprüfung vor, während ungelöste Kontakte in Deiner Ausgangsliste erhalten bleiben.
- Input: Vor- und Nachname mit Unternehmensdomain, vollständiger Name mit Unternehmensname oder URL eines öffentlichen LinkedIn-Profils.
- Output: Eine geschäftliche E-Mail-Adresse mit
emailStatusundmxProvidersowie eine lokale Prüfliste, die nur Kontakte mit E-Mail-Adresse enthält.
💡 Lieber eine No-Code-Lösung? Mit dem Waterfall Email Finder von Datablist findest Du geschäftliche E-Mail-Adressen aus einer Collection, ohne Code schreiben zu müssen.
Python, Requests und API-Key einrichten
Für dieses Python-Beispiel verwende ich das Paket requests. Erstelle eine Datei namens find_work_emails.py und installiere anschließend Requests:
python -m pip install requestsErstelle auf Deiner Datablist API-Kontoseite einen Personal API Key. Für den Zugriff auf die REST API benötigst Du den Growth-Plan. Exportiere den Key in dem Terminal, in dem Du das Skript ausführst:
export DATABLIST_API_KEY="your-api-key"Für erfolgreiche Ergebnisse des Waterfall Email Finders werden ebenfalls Credits berechnet. Im Kostenabschnitt weiter unten trennen wir diese Credits von dem Abonnement, das den API-Zugriff ermöglicht.
Geschäftliche E-Mails mit einer Python-Funktion finden
Füge das folgende vollständige Skript in find_work_emails.py ein:
import json
import os
import time
import uuid
import requests
def find_emails(people, api_key, settings):
"""Send one email-finder task, wait, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-email-finder",
"uniqueId": unique_id,
"settings": settings,
"inputs": people,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
settings = {"sourceKind": "name_company"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"firstName": "Satya",
"lastName": "Nadella",
"companyNameOrDomain": "microsoft.com",
},
},
{
"inputId": "contact-reid-hoffman",
"data": {
"firstName": "Reid",
"lastName": "Hoffman",
"companyNameOrDomain": "greylock.com",
},
},
]
lookup_results = find_emails(people, api_key, settings)
for result in lookup_results:
print(json.dumps(result, indent=2))Führe die Datei im selben Terminal aus:
python find_work_emails.pyDu kannst auch das gepflegte Requests-Beispiel herunterladen. Sobald Du die blockierende Variante verstanden hast, findest Du im Repository außerdem eine asynchrone HTTPX-Alternative.
Die Funktion führt nacheinander drei Arten von API-Aufrufen aus.
Zuerst sendet sie den Task. Jede inputId ist Deine stabile Kontakt-ID. Das verschachtelte data-Objekt enthält die Felder für die Suche. Der POST-Aufruf gibt 202 Accepted und @id zurück – die Task-ID, die für alle weiteren Aufrufe verwendet wird. Der Code gibt die uniqueId vor dem Senden aus, damit Du einen Wert zur Wiederherstellung hast, falls die Response verloren geht.
Danach fragt sie den Task-Status ab. Datablist verarbeitet den Task im Hintergrund. Dieser Requests-Client wartet und prüft den Task alle drei Sekunden, bis er den Status completed, failed oder stopped erreicht. Requests blockiert während der Wartezeit, der API-Task selbst bleibt jedoch asynchron.
Zum Schluss ruft sie die Ergebnisse ab. Ein Task kann mehrere Ergebnisseiten umfassen. Die Schleife lädt so lange weitere Seiten, bis nextCursor den Wert null hat. Ordne jedes Ergebnis über die inputId seinem Ausgangskontakt zu, nicht anhand der Reihenfolge in der Response.
Passenden Input für Deine Kontaktdaten wählen
Ein Task verwendet genau einen Input-Modus. Behalte dieselbe find_emails()-Funktion bei und ersetze die Werte für settings und people durch die Variante, die zu Deinen Ausgangsdaten passt.
Wähle eine inputId, die innerhalb des Tasks eindeutig ist und möglichst bereits zum Ausgangskontakt gehört. Eine CRM-Datensatz-ID oder eine andere dauerhafte Lead-ID eignet sich gut. Datablist gibt diesen Wert zusammen mit dem Ergebnis zurück. So kannst Du Datensätze zuordnen, ohne Namen abzugleichen oder davon auszugehen, dass die Reihenfolge der Response der Input-Reihenfolge entspricht.
Wenn Dir Vor- und Nachname sowie eine Unternehmensdomain vorliegen, verwende sourceKind: "name_company". Eine bekannte Domain ist die eindeutigste Kennung für ein Unternehmen:
settings = {"sourceKind": "name_company"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"firstName": "Satya",
"lastName": "Nadella",
"companyNameOrDomain": "microsoft.com",
},
}
]
lookup_results = find_emails(people, api_key, settings)Wenn Deine Quelldaten ein einziges Namensfeld und einen Unternehmensnamen enthalten, aktiviere useFullName:
settings = {"sourceKind": "name_company", "useFullName": True}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"fullName": "Satya Nadella",
"companyNameOrDomain": "Microsoft",
},
}
]
lookup_results = find_emails(people, api_key, settings)Wenn Du die URL eines öffentlichen Personenprofils hast, nutze die LinkedIn-Variante:
settings = {"sourceKind": "linkedin"}
people = [
{
"inputId": "contact-satya-nadella",
"data": {
"linkedInProfile": "https://www.linkedin.com/in/satyanadella/"
},
}
]
lookup_results = find_emails(people, api_key, settings)Diese Variante akzeptiert eine öffentliche Profil-URL im Format linkedin.com/in/... als Kontext zur Person für die E-Mail-Suche. Profil-URLs aus dem Sales Navigator werden nicht unterstützt.
Wenn Du Provider-Keys und deren Reihenfolge selbst festlegen möchtest, lies den Guide zur individuellen Waterfall. Für die hier verwendete Managed Waterfall ist keine Provider-spezifische Einrichtung nötig.
So findet die Managed Waterfall eine E-Mail-Adresse
Bei einer Anfrage mit Name und Unternehmen verwendet die API eine angegebene Domain direkt. Wenn Du stattdessen einen Unternehmensnamen übermittelst, versucht sie zunächst, daraus eine nutzbare Unternehmensdomain zu ermitteln. Bei einer LinkedIn-Anfrage bereinigt sie die öffentliche Profil-URL und wandelt die verfügbaren Angaben zu Person und Unternehmen in den Kontext um, den geeignete E-Mail-Provider benötigen.
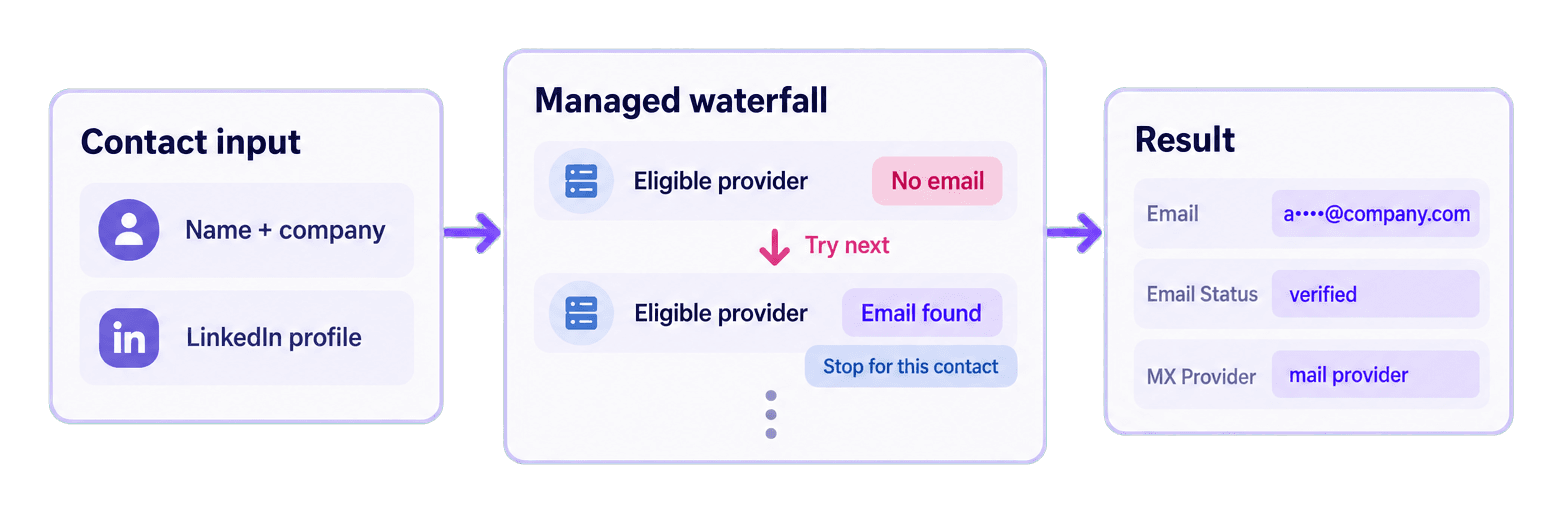
Die Managed Waterfall sendet einen noch ungelösten Kontakt an einen passenden Provider. Kommt keine nutzbare E-Mail-Adresse zurück, kann ein weiterer geeigneter Provider denselben Kontakt prüfen. Sobald eine geschäftliche E-Mail-Adresse akzeptiert wird, endet die Abfolge für diesen Kontakt. In der Standard-Response wird der Finder nicht genannt.
Warum eine Waterfall beim internationalen Outreach hilft
Provider für geschäftliche E-Mail-Adressen greifen auf unterschiedliche Datensätze zurück. Deshalb variiert ihre Abdeckung je nach Land und Markt. Ein Provider liefert für einen Kontakt in einer bestimmten Region möglicherweise kein Ergebnis, während ein anderer über die nötigen Daten verfügt, um die Adresse zu finden.
Für ein Sales- oder Growth-Team gibt die Waterfall jedem ungelösten Kontakt eine weitere Chance, gefunden zu werden, bevor er aus der Outreach-Liste fällt. So lassen sich Kontakte erschließen, die ein Workflow mit nur einem Provider übersehen würde, während der technische Prozess für das Team einheitlich bleibt.
Datablist verwaltet die Reihenfolge der geeigneten Provider hinter einer einzigen API-Integration. Du sendest den Kontakt einmal und erhältst ein einheitliches Ergebnisformat, statt für jeden Provider eine eigene Integration aufzubauen, zu warten und die Responses anschließend selbst zusammenzuführen.
Vollständige Ergebnisse auslesen
Der Beispiel-Task lieferte zwei erfolgreiche Ergebnisse. Die E-Mail-Adressen sind unten maskiert.
{
  "taskId": "2286103ce43748828e27ce71b9cc526b",
  "results": [
    {
      "inputId": "contact-satya-nadella",
      "status": "success",
      "outputs": {
        "gender": null,
        "mxProvider": "microsoft",
        "emailFound": "s*******@microsoft.com",
        "emailStatus": "verified"
      },
      "creditsUsed": "25",
      "error": null
    },
    {
      "inputId": "contact-reid-hoffman",
      "status": "success",
      "outputs": {
        "gender": null,
        "mxProvider": "mimecast",
        "emailFound": "r*******@greylock.com",
        "emailStatus": "verified"
      },
      "creditsUsed": "25",
      "error": null
    }
  ],
  "nextCursor": null
}
emailFound enthält die zurückgegebene geschäftliche E-Mail-Adresse. emailStatus beschreibt ihre Zustellbarkeit zum Zeitpunkt der Suche und mxProvider nennt, sofern verfügbar, den E-Mail-Hosting-Provider. Beide Datensätze haben den Status verified und verbrauchten jeweils 25 Credits.
Der Kampagnen-Code unten legt Ergebnisse mit dem Status verified in campaign_contacts ab und verschiebt andere gefundene Adressen nach needs_verification. Der Wert creditsUsed ist die verbindliche Abrechnung für das jeweilige Ergebnis.
Das standardmäßige Managed-Ergebnis enthält kein finderProvider. Dieses Feld wird nur unter bestimmten Bedingungen bei einem gültigen Name-und-Unternehmen-Workflow mit eigenen Keys ausgegeben. Das Skript sollte es daher nicht aus mxProvider ableiten.
Gefundene E-Mails für die Kampagnenprüfung vorbereiten
Sobald die direkte Suche funktioniert, fügst Du diesen Block am Ende des Skripts ein, nachdem lookup_results zurückgegeben wurde. Er bereitet aus der bereits ausgeführten Suche lokale Kontakte für die Kampagnenprüfung vor.
results_by_id = {result["inputId"]: result for result in lookup_results}
campaign_contacts = []
needs_verification = []
for person in people:
result = results_by_id.get(person["inputId"])
if result is None:
continue
if result["status"] != "success":
continue
if not result["outputs"].get("emailFound"):
continue
contact = person.copy()
contact["result"] = result
if result["outputs"].get("emailStatus") == "verified":
campaign_contacts.append(contact)
else:
needs_verification.append(contact)
print(json.dumps({
"campaign_contacts": campaign_contacts,
"needs_verification": needs_verification,
}, indent=2))Durch results_by_id spielt die Reihenfolge der Response keine Rolle. Für Satya liest die Schleife contact-satya-nadella aus der ursprünglichen people-Liste, findet das Ergebnis mit derselben inputId, kopiert den Ausgangsdatensatz und hängt das vollständige API-Objekt unter result an. Da eine Adresse vorhanden ist und ihr Status verified lautet, landet der Kontakt in campaign_contacts. Reid durchläuft denselben Prozess, selbst wenn sein API-Ergebnis zuerst eintrifft.
Die drei Bedingungen halten die Entscheidungslogik übersichtlich. Die erste überspringt einen Kontakt, wenn kein passendes Ergebnis zurückgegeben wurde. Die zweite überspringt Fehler auf Datensatzebene und andere nicht erfolgreiche Statuswerte. Die dritte verlangt einen tatsächlichen Wert für emailFound. Indem Du das vollständige result-Objekt anhängst, bleiben Status, Outputs, Credit-Verbrauch und Fehlerfeld für eine spätere Prüfung erhalten.
Eine gefundene E-Mail-Adresse mit einem anderen Zustellbarkeitsstatus landet in needs_verification. Ein fehlendes Ergebnis, ein Datensatzfehler oder ein Ergebnis ohne emailFound wird in keine der beiden vorbereiteten Listen aufgenommen. Die ursprüngliche people-Liste bleibt für Korrekturen oder spätere Recherchen verfügbar.
Kosten der Waterfall Email Finder API berechnen
Die standardmäßige Managed Waterfall verbraucht 25 Credits pro gefundener geschäftlicher E-Mail-Adresse. Eine erfolglose Standardsuche kostet 0 Credits. Lies creditsUsed aus jedem Ergebnis aus, statt die Gesamtzahl der übermittelten Kontakte zu multiplizieren.
Auch eine gefundene E-Mail-Adresse mit dem Status unverified verbraucht 25 Credits, obwohl der lokale Kampagnen-Code sie unter needs_verification statt unter campaign_contacts ablegt.
Die beiden gefundenen E-Mail-Adressen in diesem Beispiel haben 50 Credits verbraucht. Zur Planung:
- 100 gefundene geschäftliche E-Mail-Adressen verbrauchen 2.500 Credits.
- 1.000 gefundene geschäftliche E-Mail-Adressen verbrauchen 25.000 Credits.
- Eine größere Input-Liste kann weniger als
Kontakte × 25Credits verbrauchen, da Suchen ohne Ergebnis nicht berechnet werden.
Für den Zugriff auf die REST API benötigst Du den Growth-Plan. Beim aktuellen Top-up-Preis in US-Dollar erhältst Du für 20 $ insgesamt 20.000 Credits, also 0,001 $ pro Credit. Zu diesem Kurs entsprechen 25.000 Credits einem Wert von 25 $. Das Abonnement wird unabhängig von dieser Credit-Berechnung abgerechnet. Aktuelle Informationen zu Plänen und Paketen findest Du auf der Datablist-Preisseite.
Häufige Fehler beheben und Tasks wiederherstellen
Der API-Key fehlt. Das Skript löst vor dem ersten Request den Fehler Set DATABLIST_API_KEY before running this script. aus. Exportiere die Variable im aktuellen Terminal und führe die Datei erneut aus.
Die API gibt einen Authentifizierungsfehler zurück. raise_for_status() meldet den HTTP-Fehler. Kopiere einen aktuellen Personal API Key, prüfe, ob der Header X-API-Key diesen verwendet, und starte das Skript erst erneut, nachdem Du die Zugangsdaten korrigiert hast.
Das Konto hat nicht genügend Credits. Prüfe den Kontostand. Kaufe zusätzliche Credits oder warte auf die nächste Credit-Zuteilung Deines Plans, bevor Du weitere Tasks sendest.
Die Input-Felder passen nicht zum ausgewählten Modus. Verwende separate Namensfelder oder fullName mit name_company. Für linkedin nutzt Du linkedInProfile. Korrigiere den Kontakt und sende ihn in einem einheitlichen Modus erneut.
Der Task hat den Status failed oder stopped. Das Skript löst einen RuntimeError aus, der die Task-ID, den finalen Status und den verfügbaren Task-Fehler enthält. Prüfe diesen Task und alle vorhandenen Ergebnisse, bevor Du entscheidest, für welche Kontakte noch eine Suche nötig ist.
Die POST-Response ist verloren gegangen. Kopiere die vor dem Senden ausgegebene uniqueId. Liste Deine Tasks mit demselben Key auf:
curl "https://api.datablist.com/v1/enrichments/tasks" \
-H "X-API-Key: $DATABLIST_API_KEY"Suche den Task mit der ausgegebenen uniqueId, kopiere seine @id und fahre anschließend mit der URL für den Task-Status oder die Ergebnisse fort. So stellst Du den vorhandenen Task wieder her, statt die Kontakte automatisch erneut zu senden. Die Dokumentation der Task API beschreibt den Lebenszyklus und die Ergebnis-Endpunkte.
Nächste Schritte
Du hast jetzt eine blockierende Python-Requests-Funktion für die drei unterstützten Input-Varianten und einen lokalen Filter, der gefundene, verifizierte E-Mail-Adressen für die Kampagnenprüfung vorbereitet.
Ersetze die beiden Beispielkontakte durch einen kleinen Ausschnitt Deiner recherchierten Kontakte. Wähle die zu Deinen Daten passende Input-Variante, führe die Suche aus und prüfe emailStatus, bevor Du eine Adresse verwendest. Für einen Workflow mit größeren Listen erfährst Du hier, wie Du E-Mail-Adressen in großem Umfang findest. Das gepflegte GitHub-Repository enthält die blockierenden und asynchronen Python-Beispiele zum Herunterladen.