
Un scraper web no-code doit transformer les pages qui vous intéressent en lignes directement exploitables, sans aucun script. Avant de faire votre choix, testez quelques URL représentatives et vérifiez que l’outil récupère bien les champs, la pagination et le format de sortie dont votre workflow a besoin.
Ce classement adopte une approche différente. Un benchmark fixe sur 10 points appliqué à 8 outils de web scraping no-code : Datablist, Browse AI, Octoparse, Apify, Phantombuster, Outscraper, Instant Data Scraper et ParseHub.
Notre benchmark repose sur plusieurs questions : l’outil peut-il scraper n’importe quel site ? Son AI comprend-elle des descriptions de champs en langage naturel ou se contente-t-elle de détecter automatiquement les tableaux ? Permet-il d’enrichir les résultats ou s’arrête-t-il aux données brutes ? Et bien plus encore…
📌 L’essentiel pour les plus pressés
Notre choix : Datablist est le meilleur scraper no-code pour ceux qui recherchent un maximum de puissance sans coder.
Si vous voulez scraper n’importe quel site, extraire des données avec une AI en langage naturel et les enrichir dans une même feuille de calcul, Datablist est le choix le plus évident. Il arrive en tête de notre benchmark axé sur la puissance avec une note de 9,5/10.
Deux agents AI permettent de scraper n’importe quel site web. Des scrapers prêts à l’emploi extraient les données de LinkedIn, les leads de Sales Navigator, les offres d’emploi, ainsi que les données d’Instagram et de Google Maps. Plus de 60 enrichissements vous fournissent ensuite emails, numéros de téléphone et données firmographiques sans changer d’onglet.
Également évalués : Browse AI, Octoparse, Phantombuster, Outscraper, Apify, Instant Data Scraper et ParseHub, avec pour chacun les compromis détaillés plus bas.
En bref : choisissez Datablist pour obtenir un maximum de puissance avec un minimum de friction. Optez pour un outil spécialisé uniquement si votre besoin est très ciblé.
Au programme de ce guide
- Ce que signifie vraiment le scraping no-code et les critères à vérifier
- Tester un scraper sur vos propres pages
- Notre benchmark de puissance sur 10 points
- Les 8 meilleurs scrapers no-code, classés et notés
- Pourquoi les API et outils réservés aux développeurs ne sont pas classés
- Comment choisir le bon scraper selon vos besoins
- Questions fréquentes
Qu’est-ce qu’un scraper no-code ?
Le terme « no-code » ne signifie pas la même chose pour tout le monde. Pour un développeur, cela veut dire qu’aucun script personnalisé n’est nécessaire. Pour un utilisateur non technique, cela implique aussi de ne configurer aucune API, aucun token d’authentification et aucun fichier de configuration.
La définition que la plupart des gens comprennent mal
La plupart des gens définissent le scraping no-code comme du scraping « sans script ». Cette définition est trop restrictive.
Pour une personne non technique, configurer une API revient encore à coder. Il faut rédiger des requêtes, transmettre des clés et gérer les réponses. La friction reste la même ; seule sa forme change.
Un véritable scraper no-code élimine toutes ces étapes. Aucun sélecteur, aucun script et aucune configuration d’API : vous indiquez un site, décrivez les données recherchées et obtenez un résultat structuré.
Critères pour choisir un scraper no-code
Cinq critères distinguent un outil que vous utiliserez encore le mois prochain d’une solution abandonnée au bout d’une semaine :
- Compatibilité avec tous les sites : pouvez-vous saisir n’importe quelle URL ou uniquement utiliser des templates pris en charge ?
- Profondeur de l’extraction AI : pouvez-vous décrire les champs en langage naturel ou l’outil se contente-t-il de détecter les tableaux ?
- Enrichissement intégré : l’outil nettoie-t-il et enrichit-il les données, ou exporte-t-il des données brutes à corriger ailleurs ?
- Friction de mise en place : l’outil fonctionne-t-il instantanément dans le navigateur ou exige-t-il une installation desktop et une console technique ?
- Prévisibilité des tarifs : payez-vous au résultat ou à la minute d’exécution, y compris lorsque le traitement bloque ?
Chaque compromis se fait rapidement sentir. Une compatibilité limitée vous empêche de traiter les sites de niche ; l’absence d’enrichissement vous oblige à assembler trois outils différents.
📘 Ce que ce classement n’inclut pas
Les services reposant exclusivement sur une API ou réservés aux développeurs, comme ScraperAPI, Bright Data et Zyte, sont présentés dans une section finale mais ne figurent pas au classement : ils ne passent pas le test du zéro code.
Les scrapers exclusivement basés sur l’AI font l’objet d’un article dédié. Clay est également exclu, car il enrichit des données sous licence au lieu de scraper des données en direct.
Testez un scraper no-code sur vos propres pages
Aucun classement ne peut garantir qu’un outil fonctionnera sur votre site cible. Utilisez donc le même petit échantillon avec chaque scraper envisagé. Vous pouvez, par exemple, préparer dix URL publiques de produits provenant d’une boutique, dont une fiche sans prix ou avec une mise en page inhabituelle. Demandez Nom du produit, SKU, Prix, Devise et URL du produit dans des champs de sortie distincts.
Lancez le test, puis ouvrez trois pages sources à côté des lignes extraites. Vérifiez que les prix et les devises correspondent, que les valeurs manquantes restent vides et que chaque URL renvoie vers le bon produit. Si votre processus part d’une page de catégorie, vérifiez également que l’outil suit la pagination sans créer de doublons. Exportez enfin l’échantillon en CSV et assurez-vous que les colonnes restent exploitables dans votre feuille de calcul ou votre CRM.
Ce test facilite un choix concret : un sélecteur visuel peut suffire pour un site stable, tandis qu’un scraper AI sera plus adapté si les mises en page varient. Pour les tâches récurrentes, examinez aussi la façon dont les erreurs sont signalées et le coût d’une nouvelle exécution. Une simple liste de fonctionnalités ne permet pas de répondre à ces questions.
Notre benchmark no-code sur 10 points
Comme indiqué précédemment, nous avons défini un benchmark fixe regroupant tous les critères nécessaires pour obtenir un maximum de puissance de scraping sans écrire de code. Nous avons ensuite évalué huit scrapers no-code selon cette grille.
Chaque outil part de zéro. Il peut obtenir jusqu’à 6 points pour sa puissance brute, puis 4 points supplémentaires selon la fluidité d’utilisation et la prévisibilité des coûts. Le total le plus élevé l’emporte.
Benchmark de puissance du scraping sur 6 points
La puissance bénéficie du coefficient le plus élevé, car c’est le critère qui varie réellement d’un outil à l’autre. L’extraction AI pèse davantage que tous les autres.
- Extraction AI en langage naturel (2) : vous décrivez les champs en langage naturel et laissez l’outil les identifier et les structurer. Une extraction entièrement agentique rapporte 2 points ; une assistance AI ou une détection automatique en rapporte 1.
- Compatibilité avec tous les sites (1) : l’outil accepte n’importe quelle URL, pas seulement des templates compatibles.
- Couverture prête à l’emploi (1) : étendue des scrapers disponibles sans aucune configuration.
- JavaScript, contenu dynamique et pagination (1) : capacité à traiter les sites modernes, riches en scripts et paginés.
- Enrichissement et automatisation (1) : nettoyage ou enrichissement intégré, planification et exécutions récurrentes.
Bonus de fluidité et de coût sur 4 points
Ces quatre points récompensent les outils qui offrent de la puissance sans ajouter de travail inutile ni rendre la facture imprévisible.
- Friction de mise en place (1) : une solution web immédiatement accessible surpasse une installation desktop ou une console technique.
- Résultats et courbe d’apprentissage (1) : des données propres et une prise en main rapide valent mieux qu’un lourd travail de nettoyage.
- Prix d’entrée (1) : une offre gratuite ou abordable, autour de 30 $/mois maximum, donnant accès aux fonctions essentielles de scraping.
- Prévisibilité des tarifs (1) : un prix transparent, fixe ou calculé au résultat est préférable à une facturation à l’usage qui fait payer les blocages et les nouvelles tentatives.
Les 8 meilleurs scrapers no-code en un coup d’œil
Voici le classement complet avant d’entrer dans le détail. Vous remarquerez que notre notation axée sur la puissance bouleverse l’ordre habituel où « l’outil le plus simple » arrive systématiquement en tête :
| Outil | Extraction AI | Tous sites | Prêt à l’emploi | JS / dynamique | Enrich. + auto. | Simplicité | Entrée mensuelle | Note |
|---|---|---|---|---|---|---|---|---|
| Datablist | ✅ ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | 25 $/mois | 9,5 |
| Browse AI | ✅ | ✅ | ✅ | ✅ | ⚠️ | ✅ | 48 $/mois | 7,5 |
| Octoparse | ⚠️ | ✅ | ✅ | ✅ | ⚠️ | ⚠️ | 83 $/mois | 7,0 |
| Phantombuster | ⚠️ | ❌ | ✅ | ✅ | ✅ | ✅ | 69 $/mois | 6,0 |
| Outscraper | ⚠️ | ❌ | ✅ | ⚠️ | ✅ | ✅ | À l’usage | 6,0 |
| Apify | ⚠️ | ✅ | ✅ | ✅ | ✅ | ❌ | 19 $/mois | 5,5 |
| Instant Data Scraper | ⚠️ | ✅ | ❌ | ⚠️ | ❌ | ✅ | Gratuit | 5,5 |
| ParseHub | ❌ | ✅ | ❌ | ✅ | ⚠️ | ❌ | Gratuit / 189 $ | 4,5 |
Les tarifs d’entrée payants correspondent à une facturation mensuelle en dollars américains, vérifiée le 30 octobre 2026. Browse AI propose aussi un tarif annuel équivalent à 19 $/mois, soit 228 $ payés d’avance. L’offre Octoparse à 83 $/mois correspond à sa configuration Standard à faible usage ; l’offre Standard classique coûte 119 $/mois. Les offres gratuites et les options à l’usage restent indiquées dans les fiches ci-dessous.[10] [11]
Classement des 8 meilleurs scrapers no-code
Le classement va du scraper no-code le plus complet au plus spécialisé. Chaque note, tarif et fonctionnalité mentionnés ci-dessous provient de tests menés outil par outil.
Datablist : le plus puissant sans coder, 9,5/10
Datablist.com n’est pas qu’un scraper. C’est une feuille de calcul propulsée par l’AI dans laquelle vous pouvez scraper des leads, extraire des données de sites web, les enrichir, les nettoyer et les dédupliquer sans changer d’onglet.
Pourquoi Datablist se démarque comme scraper no-code
Revenons à la définition d’un scraper no-code : aucun code, aucune API et aucune authentification. Avec ces critères, vous comprendrez rapidement pourquoi Datablist remporte ce comparatif.
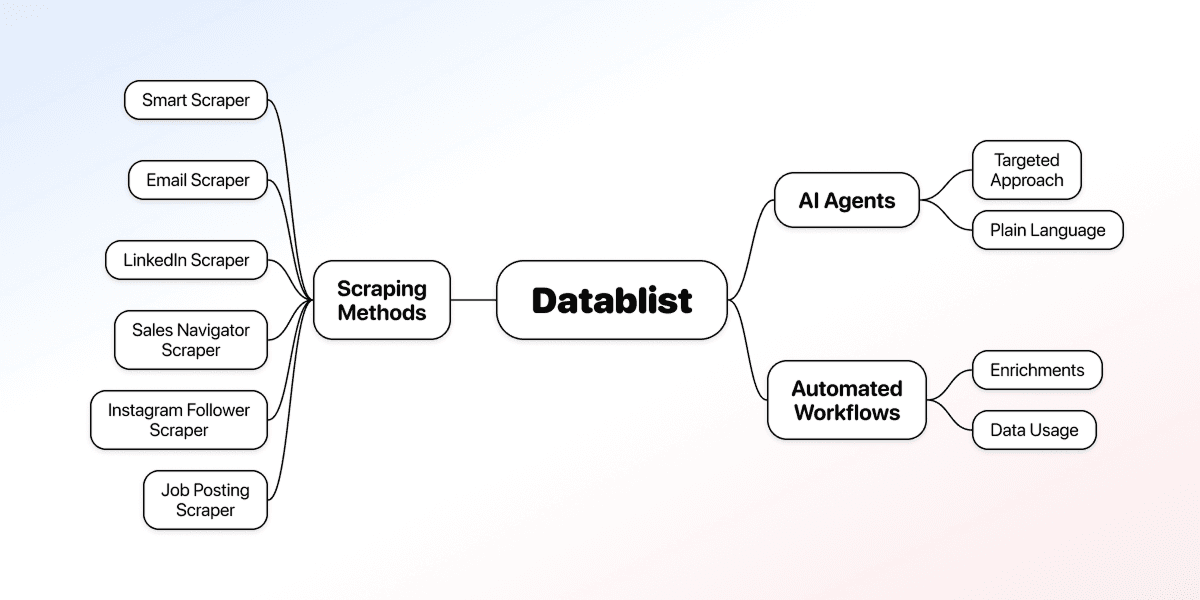
La plateforme propose plusieurs méthodes pour scraper pratiquement n’importe quel site public :
- Smart Scraper extrait rapidement les données d’un site web
- Deux agents AI prennent en charge, en langage naturel, les tâches nécessitant une approche plus ciblée
- Plus de 10 autres scrapers extraient les emails, les données LinkedIn, les leads Sales Navigator, les abonnés Instagram, les offres d’emploi et bien plus encore.
Datablist vous permet également de créer des workflows automatisés et de les associer à des enrichissements afin d’exploiter facilement vos données.
Les outils de web scraping no-code de Datablist
- Smart Scraper : extrait les emails, liens et textes de n’importe quelle page web. Idéal pour alimenter une AI chargée de qualifier vos comptes
- AI Scraping Agent : extrait une liste complète depuis une page — produits d’un site e-commerce, entrées d’un annuaire, études de cas d’un site, etc. — à partir d’instructions en langage naturel.
- AI Research Agent : extrait des champs précis depuis une liste de sites et vous aide à déployer la recherche AI à grande échelle sur des milliers de lignes.
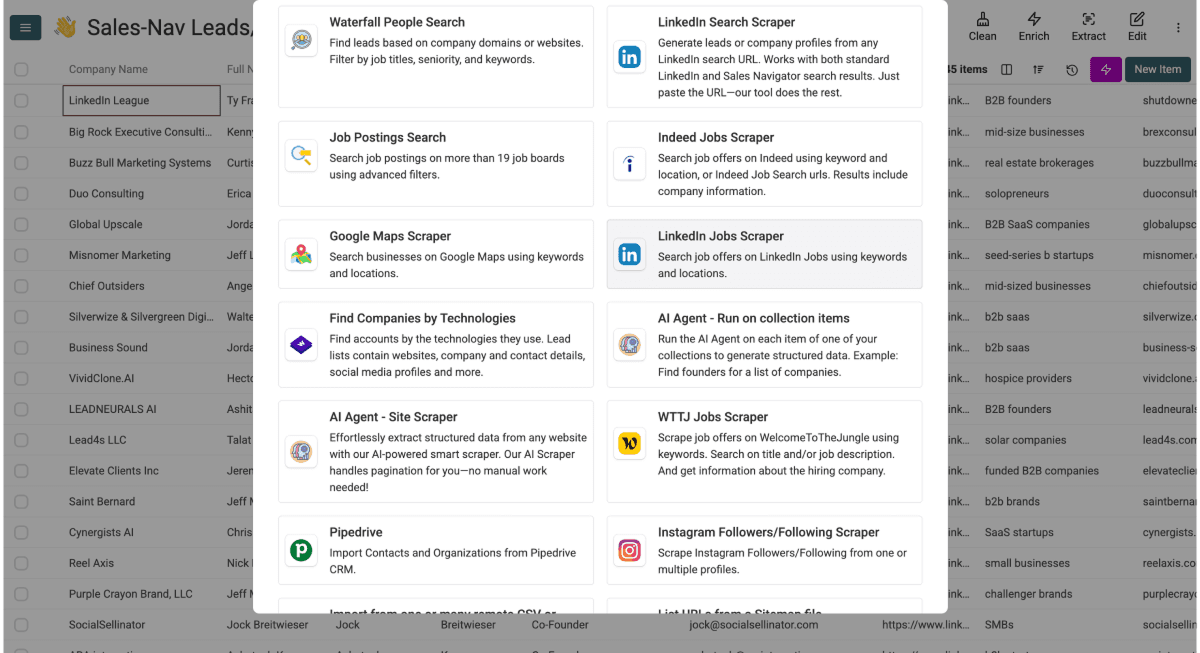
En complément de ses agents AI, Datablist.com propose une bibliothèque de scrapers et d’enrichissements prêts à l’emploi pour traiter sans configuration les tâches de lead generation les plus courantes.
Les scrapers prêts à l’emploi de Datablist
Ces scrapers couvrent les plateformes les plus utilisées par les équipes Growth et recrutement :
- Sales Navigator Scraper : exportez des leads depuis Sales Navigator sans exposer votre compte aux risques habituels.
- LinkedIn Jobs Scraper : récupérez directement depuis LinkedIn Jobs les offres d’emploi actives, les intitulés de poste et les entreprises qui recrutent.
- Job Board Scraper : collectez en une seule exécution les offres publiées sur plusieurs job boards.
- Instagram et Google Maps : récupérez des profils sociaux et des fiches d’entreprises locales pour votre prospection.
Les enrichissements de Datablist
Les enrichissements de Datablist transforment les données scrapées en une liste de leads complète :
- Domain Finder : associez les noms d’entreprises à leurs sites web à grande échelle.
- Email and Personal Email Finder : trouvez des adresses professionnelles ou personnelles.
- Waterfall Phone Finder : enchaînez plusieurs fournisseurs pour augmenter le taux de numéros de téléphone trouvés.
- LinkedIn Profile Finder : retrouvez le bon profil à partir d’un simple nom.
- Company and Technology Enrichment : ajoutez des données firmographiques et détectez la stack technologique d’un site.
Vient ensuite ce que la plupart des scrapers négligent : plus de 60 enrichissements, la déduplication et le nettoyage, ainsi que des exécutions récurrentes dans les offres supérieures. Vous terminez tout le travail au même endroit au lieu d’exporter vos données vers trois outils.
L’avantage de Datablist : vous bénéficiez d’une puissance de scraping maximale sans coder, sur n’importe quel site, avec une extraction AI en langage naturel et des enrichissements. Une offre gratuite est disponible et les scrapers prêts à l’emploi suivent une tarification prévisible par tâche.[1]
🆚 Note du scraper no-code de Datablist
- Note : 9,5/10
- Tarifs : Starter à 25 $/mois pour 5 000 crédits mensuels ; Growth à 50 $/mois pour 20 000 crédits (les crédits supplémentaires n’expirent jamais)
- Mode d’accès : feuille de calcul dans le navigateur, avec une API pour ceux qui en ont besoin.
- Idéal pour : tous ceux qui veulent scraper n’importe quel site, utiliser l’AI en langage naturel et enrichir leurs données au même endroit
- À éviter si : difficile de trouver une raison si vous cherchez un bon scraper no-code
Browse AI : idéal pour le monitoring planifié, 7,5/10
Browse AI utilise des « robots » cloud configurés en point-and-click. Ils enregistrent une extraction sur presque n’importe quel site, puis surveillent les changements selon une fréquence définie.
Vous enregistrez un robot une fois, puis il se relance automatiquement. L’extraction assistée par AI et les robots préconfigurés interprètent correctement la structure des pages. Vous pouvez aussi indiquer les champs recherchés, mais l’approche reste plus proche d’un enregistrement assisté que d’une véritable extraction agentique.
L’outil gère les pages dynamiques, le défilement et la pagination. Il propose également une bibliothèque de robots prêts à l’emploi et des milliers d’intégrations.[2] Son vrai point fort reste le suivi des changements.
Ses limites concernent l’enrichissement et le nettoyage : aucun module intégré ne permet de trouver les emails, numéros de téléphone ou données firmographiques nécessaires à l’exploitation des résultats, qui demandent donc un nettoyage préalable.
🆚 Note du scraper no-code de Browse AI
- Note : 7,5/10
- Tarifs : 50 crédits/mois gratuits ; Personal à 48 $/mois ou 19 $/mois avec facturation annuelle (228 $ payés d’avance) ; Professional à partir de 69 $/mois avec facturation annuelle
- Mode d’accès : application web, API et intégrations
- Idéal pour : le monitoring planifié et l’extraction récurrente de pages précises.
- À éviter si : vous avez besoin d’un enrichissement intégré ou de données immédiatement propres
Octoparse : meilleur scraper no-code desktop, 7/10
Octoparse est un scraper visuel no-code pour desktop et cloud. Il propose la détection automatique par AI, une vaste bibliothèque de templates, la planification, la rotation des IP et la résolution des CAPTCHA.[3]
Son éditeur point-and-click fonctionne sur presque tous les sites publics. La détection automatique par AI analyse une page et crée un template d’extraction en un clic. Il s’agit d’une assistance AI, pas d’une extraction en langage naturel : vous ne pouvez pas décrire librement les champs recherchés.
Octoparse gère efficacement JavaScript, le défilement infini, la pagination, les listes déroulantes et les formulaires. Sa bibliothèque de templates pour les sites populaires est vaste, tandis que la planification cloud et les exécutions simultanées sont solides.
Octoparse présente cependant les mêmes limites que de nombreux outils de web scraping no-code : aucun enrichissement, des résultats bruts à nettoyer et une extraction cloud qui nécessite une installation desktop ainsi qu’une offre de milieu de gamme.
🆚 Note du scraper no-code d’Octoparse
- Note : 7/10
- Tarifs : offre gratuite limitée aux exécutions locales ; Standard à faible usage à 83 $/mois ou Standard classique à 119 $/mois ; facturation annuelle également disponible
- Mode d’accès : application desktop, cloud et API
- Idéal pour : les extractions planifiées à partir d’annuaires, de cartes et du web en général
- À éviter si : vous voulez un outil fonctionnant uniquement dans le navigateur ou un enrichissement intégré
Phantombuster : difficile à recommander, 6/10
Phantombuster est une bibliothèque de « Phantoms » prêts à l’emploi : des workflows fixes compatibles avec une liste définie de plateformes, dont LinkedIn, Instagram, Twitter et Google Maps.
Son catalogue couvre des sources précises. La planification, l’enchaînement via Flows et le nettoyage des données assisté par AI fonctionnent bien, tant que votre source figure dans la liste compatible.
L’outil est efficace dans les limites de son catalogue. Dès que vous en sortez, trois compromis apparaissent :
- Pas de compatibilité avec tous les sites : Phantombuster exécute uniquement des Phantoms préconfigurés. Vous ne pouvez donc pas lui transmettre une URL arbitraire. Il ne propose pas non plus d’extraction en langage naturel, seulement quelques workflows fixes.
- Risque pour les comptes : l’accès aux plateformes sociales repose sur la connexion de cookies de session aux Phantoms, ce qui augmente le risque de détection — certains utilisateurs ont déjà été bannis.
- Facturation imprévisible : avec un prix calculé selon le temps d’exécution, les blocages coûtent autant que les traitements réussis, ce qui complique fortement les prévisions budgétaires.
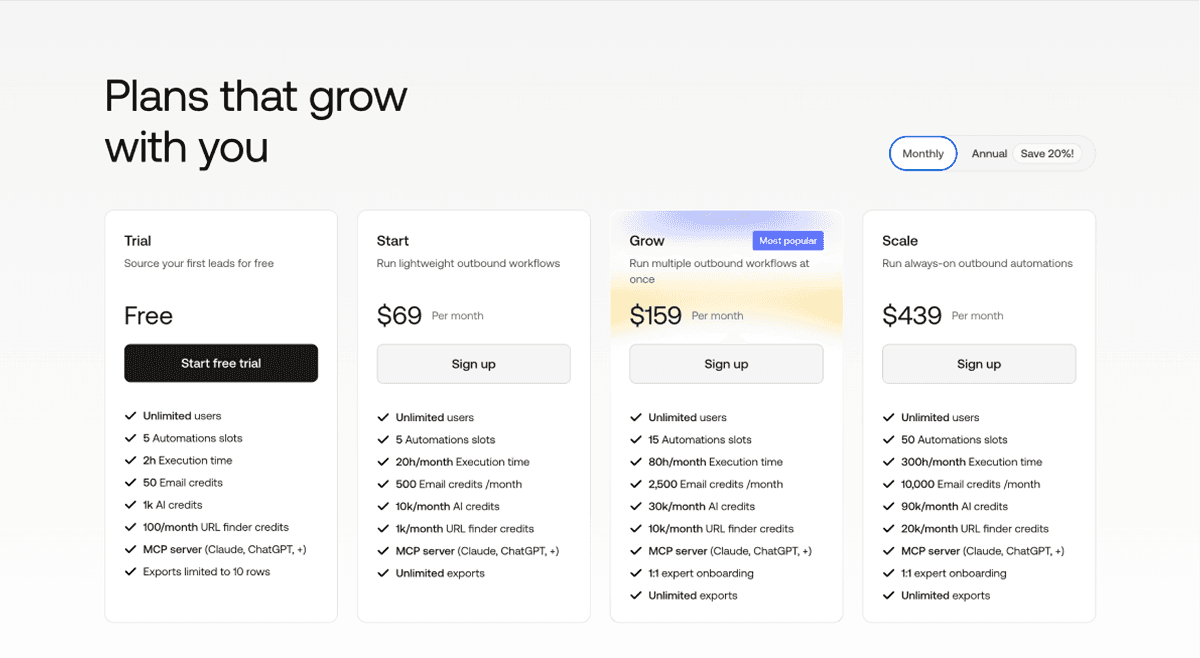
Phantombuster propose un essai gratuit, mais uniquement pour un test rapide : les exports sont limités à 10 lignes et les 2 heures d’exécution accordées une seule fois ne sont pas renouvelées chaque mois.[4]
🆚 Note du scraper no-code de Phantombuster
- Note : 6/10
- Tarifs : essai gratuit uniquement (exports limités à 10 lignes et 2 heures d’exécution non renouvelables) ; offre Start payante à partir d’environ 69 $/mois, ou 56 $/mois avec facturation annuelle
- Mode d’accès : application web, API et intégrations (Make, Zapier, n8n)
- Idéal pour : difficile à recommander. Datablist et d’autres solutions couvrent les mêmes besoins à un meilleur tarif et avec moins de contraintes
- À éviter si : vous devez scraper des sites web génériques et arbitraires
Outscraper : idéal pour Google Maps à petit prix, 6/10
Outscraper propose un catalogue de scrapers — Google Maps, données d’entreprises, avis, etc. — complété par des enrichissements, une tarification à l’usage et une API.[5]
Vous choisissez un service et le lancez sans rien installer. Un service Universal AI Scraper ajoute une extraction pilotée par AI, mais l’essentiel de la plateforme repose sur des services fixes et préconfigurés, plutôt que sur une extraction libre.
La couverture est suffisamment large et les résultats sont propres et structurés. La plateforme propose quelques enrichissements de contacts, ainsi que la planification et l’automatisation par API. Elle reste toutefois principalement centrée sur Google Maps.
🆚 Note du scraper no-code d’Outscraper
- Note : 6/10
- Tarifs : offre gratuite ; paiement à l’usage à partir d’environ 3 $ pour 1 000 fiches de base, ou approximativement 9 à 14 $ avec toutes les coordonnées
- Mode d’accès : interface utilisateur, API et serveur MCP
- Idéal pour : les équipes disposant d’un très petit budget et recherchant uniquement des données simples
- À éviter si : vous devez scraper un site précis qui ne figure pas dans le catalogue
Apify : idéal pour la variété et le volume, 5,5/10
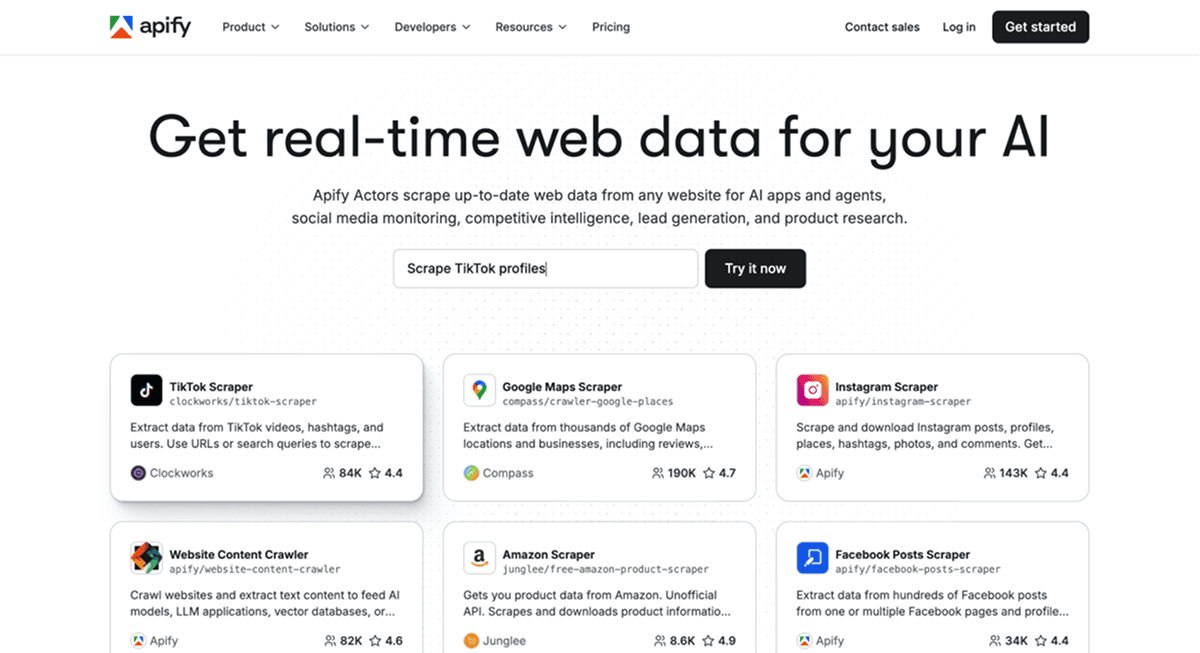
Apify est une marketplace réunissant plus de 43 000 actors prêts à l’emploi[6], ainsi qu’un moteur de navigateur headless complet conçu pour scraper presque n’importe quelle source à grande échelle.
En matière de flexibilité brute, aucun autre outil de ce classement ne le surpasse. Le SDK et les actors personnalisés peuvent atteindre tous les sites, le catalogue préconfiguré est le plus vaste de cette sélection, et le rendu JavaScript, le défilement infini ainsi que la rotation des proxies sont parfaitement pris en charge.
Le problème vient du critère zéro code. La console est technique, les besoins personnalisés exigent du code et la qualité comme la disponibilité des actors maintenus par la communauté varient. Il n’existe pas de couche propriétaire d’extraction en langage naturel.
La facturation dépend de l’Actor. Certains Actors facturés à l’usage font payer le calcul, les proxies et le stockage ; d’autres utilisent une tarification par événement ou combinent les deux modèles. Vérifiez les tarifs et la limite de dépenses de l’Actor sélectionné avant d’estimer votre coût par lead.[7]
🆚 Note du scraper no-code d’Apify
- Note : 5,5/10
- Tarifs : 5 $ de crédits gratuits par mois ; Starter à 19 $/mois avec 19 $ d’usage prépayé, puis paiement à l’usage selon le modèle tarifaire de l’Actor choisi
- Mode d’accès : interface d’exécution des tâches, API et SDK (JS/Python)
- Idéal pour : les utilisateurs techniques qui recherchent une flexibilité maximale et le catalogue prêt à l’emploi le plus étendu
- À éviter si : vous voulez un véritable outil no-code, accessible aux débutants et aux coûts prévisibles
Instant Data Scraper : meilleur outil gratuit ponctuel, 5,5/10
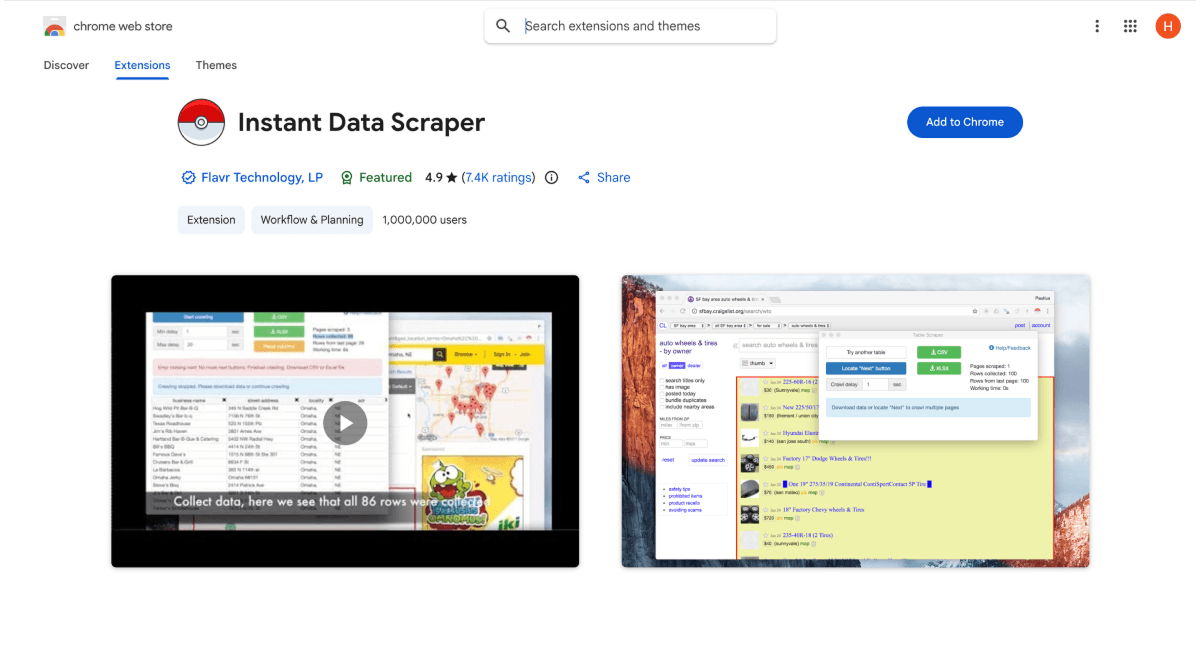
Instant Data Scraper est une extension Chrome gratuite qui détecte de façon heuristique les tableaux présents sur une page et les exporte, sans exiger la création d’un compte.[8]
Pour une extraction rapide, il est difficile de faire mieux : un clic suffit, le résultat est immédiat et l’outil est entièrement gratuit. Il fonctionne sur de nombreuses pages contenant des listes ou des tableaux et gère le défilement infini ainsi qu’une pagination simple.
Ses limites apparaissent au-delà de ces usages élémentaires. Il n’existe ni bibliothèque de templates, ni planification, ni enrichissement. L’outil peine aussi sur les sites dynamiques complexes, et les résultats demandent généralement une phase de nettoyage.
🆚 Note du scraper no-code d’Instant Data Scraper
- Note : 5,5/10
- Tarifs : 100 % gratuit, sans compte ni offre payante
- Mode d’accès : extension Chrome uniquement
- Idéal pour : extraire rapidement et gratuitement un tableau de façon ponctuelle
- À éviter si : vous avez besoin de tâches récurrentes, d’enrichissements ou de données structurées et propres.
ParseHub : difficile à recommander, 4,5/10
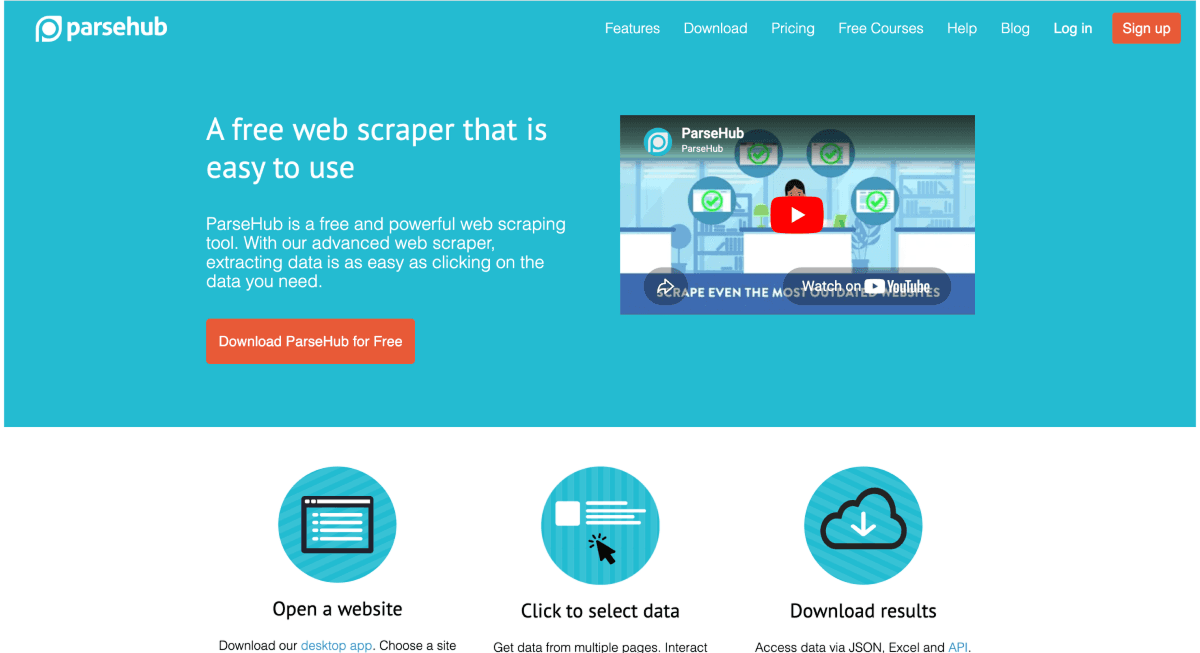
ParseHub est un scraper visuel desktop qui gère JavaScript, AJAX et la pagination, avec une fonction de planification dans les offres payantes.
La sélection visuelle fonctionne sur la plupart des sites publics. L’outil traite correctement les listes déroulantes, AJAX et la pagination. Son offre gratuite, limitée à 200 pages par exécution,[9] facilite les tests à petit budget.
Les inconvénients s’accumulent néanmoins : aucune AI ni extraction en langage naturel, pas de véritable bibliothèque de templates, aucun enrichissement, une interface qui semble dater de 2012 et une courbe d’apprentissage raide.
Les offres payantes commencent à 189 $/mois[9], un tarif très élevé par rapport aux autres outils.
🆚 Note du scraper no-code de ParseHub
- Note : 4,5/10
- Tarifs : offre gratuite limitée à 200 pages par exécution ; Standard à environ 189 $/mois
- Mode d’accès : application desktop et API
- Idéal pour : difficile à recommander.
- À éviter si : vous recherchez une extraction AI ou un outil moderne et fluide
Choisir le bon scraper no-code selon vos besoins
Le meilleur scraper no-code dépend avant tout de votre situation. Voici comment faire votre choix :
- Un seul site ou plusieurs ? Pour scraper n’importe quel site, privilégiez Datablist, Apify ou Octoparse. Pour des sources fixes, choisissez plutôt Outscraper.
- Web généraliste ou réseaux sociaux ? Datablist est particulièrement adapté au scraping des réseaux sociaux et à la lead generation.
- Besoin ponctuel ou récurrent ? Instant Data Scraper convient aux extractions rapides ; Browse AI au monitoring planifié ; Datablist aux tâches répétées.
- Données brutes ou enrichies ? Si vous voulez centraliser emails, numéros de téléphone et données firmographiques, Datablist est la seule solution full-stack du classement.
- Quel budget ? Instant Data Scraper et les offres gratuites sont adaptés aux tests sans frais. Pour maîtriser vos dépenses à mesure que vos volumes augmentent, privilégiez une tarification au résultat plutôt qu’une facturation par unité de calcul ou temps d’exécution.
Verdict : Datablist offre le plus de puissance sans code
Si vous recherchez une puissance de scraping maximale sans écrire de code, Datablist.com s’impose nettement. C’est le seul scraper no-code à atteindre 9,5/10 dans notre benchmark axé sur la puissance. Il associe une compatibilité avec tous les sites et une extraction AI en langage naturel à des enrichissements que les autres outils ne proposent tout simplement pas.
L’écart est encore plus marqué pour les réseaux sociaux et le scraping de leads. Vous pouvez exporter des leads Sales Navigator sans exposer votre compte, scraper les offres LinkedIn Jobs, les profils Instagram et les fiches Google Maps, puis laisser l’AI Research Agent renseigner n’importe quel champ personnalisé sur des milliers de lignes.
Les enrichissements de Datablist pour les emails, les numéros de téléphone et les entreprises transforment ensuite ces données scrapées en une liste de leads prête à contacter, toujours dans la même feuille de calcul. Pour couvrir les besoins les plus larges avec un minimum de friction, aucune autre solution ne fait mieux.
FAQ sur les scrapers no-code
Quel est le meilleur scraper web no-code ?
Datablist arrive en tête de ce benchmark avec une note de 9,5/10. Il associe le scraping de n’importe quel site, l’extraction AI en langage naturel grâce à deux agents AI, ainsi que le nettoyage et l’enrichissement intégrés. Il couvre donc l’essentiel des besoins auxquels doit répondre un scraper no-code.
Quel scraper no-code choisir sans compétences techniques ?
Datablist est le choix le plus solide pour les utilisateurs non techniques, car il reprend l’interface familière d’une feuille de calcul et permet de décrire les champs en langage naturel. Browse AI et Octoparse restent accessibles, mais reposent davantage sur un enregistrement point-and-click que sur une extraction AI.
Un scraper no-code peut-il scraper tous les sites ?
Certains le peuvent. Datablist, Apify, Octoparse et ParseHub atteignent pratiquement toutes les URL publiques. D’autres, comme Outscraper et Phantombuster, exécutent uniquement des scrapers prêts à l’emploi sur un ensemble limité de sources ; vous ne pouvez donc pas les diriger vers un site arbitraire.
Quel scraper no-code offre les tarifs les plus prévisibles ?
Les prix fixes et la facturation au résultat sont les modèles les plus prévisibles. Les scrapers prêts à l’emploi de Datablist facturent un prix fixe par tâche, tandis qu’Octoparse propose des forfaits fixes. Apify et Phantombuster s’appuient davantage sur une facturation à l’usage ou au temps d’exécution, qui fait également payer les blocages et les nouvelles tentatives.
Peut-on extraire des données en langage naturel ?
Oui, les meilleurs outils le permettent. L’AI Scraping Agent de Datablist vous laisse décrire en langage naturel les champs recherchés. La plupart des autres outils proposent seulement une assistance AI ou une détection automatique, capable d’interpréter la structure d’une page mais pas de suivre des instructions libres.
Quel est le scraper web no-code le moins cher ?
Instant Data Scraper est gratuit. Datablist, ParseHub et Browse AI proposent également des offres gratuites pour un usage limité. Pour une utilisation régulière et payante, Datablist commence à 25 $/mois avec des crédits utilisables pour les enrichissements[1], ce qui revient moins cher que de payer séparément des outils de scraping, de nettoyage et d’enrichissement.
Qu’est-ce qu’un scraper no-code ?
Un scraper no-code extrait les données de sites web sans script ni API. Vous utilisez un éditeur visuel, un scraper prêt à l’emploi ou un agent AI à la place de sélecteurs écrits à la main. Tout le monde peut ainsi extraire des données web sans savoir coder.
Comment fonctionnent les outils de web scraping no-code ?
Les outils point-and-click enregistrent les éléments que vous sélectionnez, les scrapers prêts à l’emploi ciblent des sources connues et les scrapers AI lisent une page comme une personne pour renvoyer les champs décrits, le tout sans code.
Peut-on scraper un site web sans coder ?
Oui. Les scrapers no-code prennent en charge tout le processus, de l’accès à la page jusqu’à la structuration des données. Avec un scraper AI comme Datablist, il suffit de coller une URL, de décrire en langage naturel les informations recherchées, puis de laisser l’outil les extraire et les structurer.
Les scrapers no-code gèrent-ils les sites riches en JavaScript ?
La plupart des outils modernes le font. Datablist, Apify, Octoparse, Browse AI et ParseHub rendent tous le JavaScript et traitent les pages dynamiques et paginées. Les extensions légères comme Instant Data Scraper peuvent en revanche rencontrer des difficultés sur les sites dynamiques complexes.
Quelle différence entre scraper no-code et scraper API ?
Un scraper no-code s’utilise depuis une interface sans programmation. Un scraper API, comme ScraperAPI ou Zyte, renvoie les données au moyen du code que vous écrivez. Les outils API sont puissants, mais ne répondent pas au critère zéro code ; c’est pourquoi ils ne figurent pas dans ce classement.
Les scrapers no-code sont-ils sûrs pour vos comptes ?
Les outils comme Datablist, qui scrapent depuis leur propre infrastructure, ne font pas intervenir vos comptes. Les solutions comme Phantombuster, qui injectent un cookie de connexion dans une automatisation cloud utilisant des IP partagées, présentent davantage de risques de détection.
Quel scraper no-code choisir pour les réseaux sociaux ?
Datablist peut scraper les données LinkedIn, les leads Sales Navigator, les abonnés Instagram et les profils Instagram sans connexion à vos comptes sociaux. Il scrape également Google Maps, LinkedIn Jobs, Indeed et de nombreuses autres sources.