
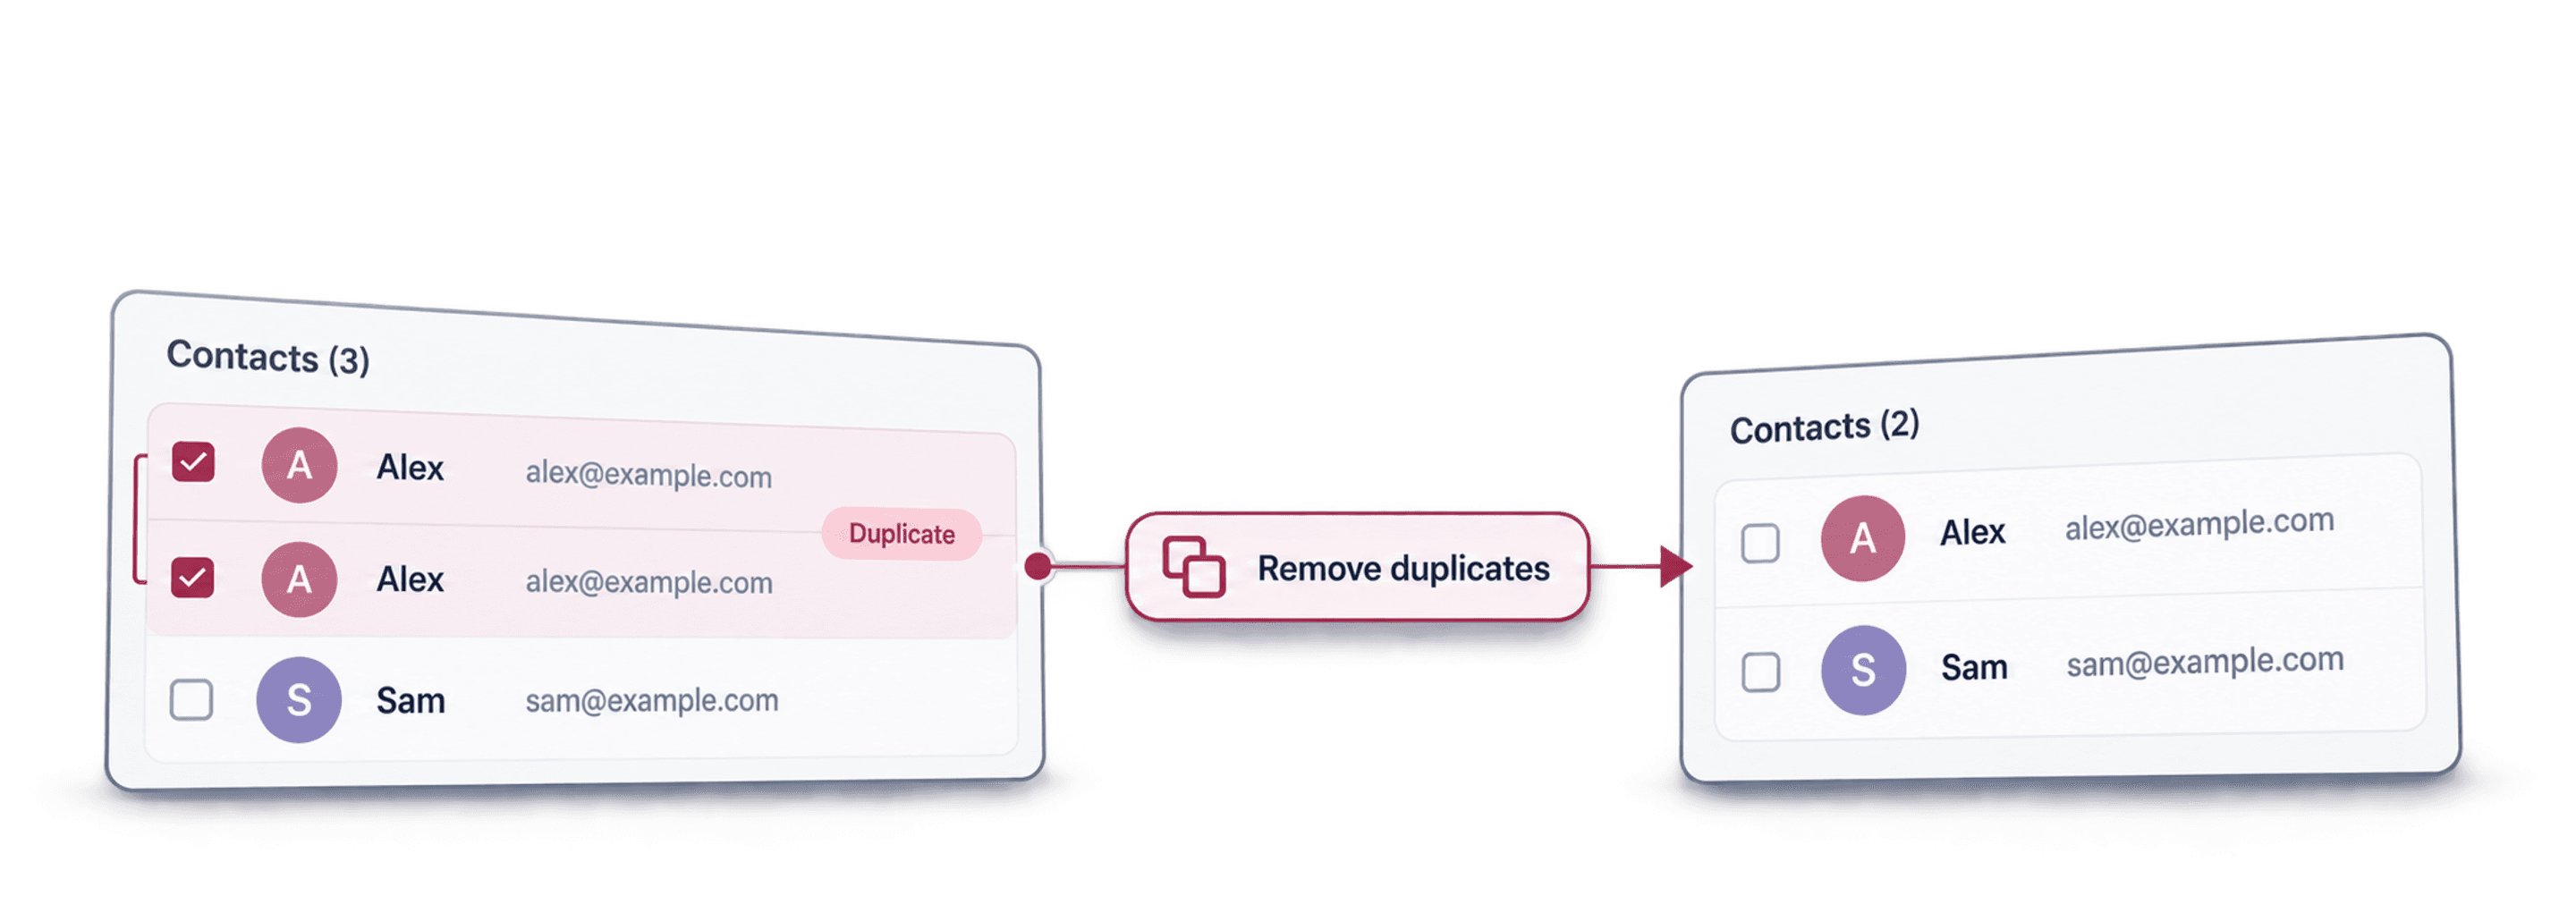
온라인에서 리스트의 중복을 제거하려면 먼저 사람, 회사 또는 제품을 식별하는 필드를 정해야 합니다. 엄격한 matching을 먼저 실행하고, 제안된 중복 그룹을 검토한 다음, 유용한 값은 병합하고 의미 없는 행은 삭제하세요. 이렇게 하면 비슷한 값을 모두 동일한 레코드로 잘못 판단하지 않으면서 빠르게 데이터를 정리할 수 있습니다.
Datablist에서는 이 모든 작업을 브라우저에서 한 번에 처리할 수 있습니다. CSV 또는 Excel 파일을 가져와 matching 속성을 선택하고, 행을 비교하고, 결과를 검토한 뒤 정리된 리스트를 내보내면 됩니다. 중복 검사는 Remove, Merge 또는 custom processing을 실행하기 전까지 원본을 변경하지 않습니다.
이 가이드에서는 완전히 동일한 복사본, 이메일 alias, 회사명 변형, URL 차이, 기본적인 전화번호 형식 차이, 오탈자, 충돌하는 값, 상호 보완적인 레코드가 포함된 1,000행 샘플을 사용합니다.
🔑 안전한 중복 제거 원칙
신뢰할 수 있는 최소 식별자로 matching하되, 무엇을 남길지는 전체 행을 보고 결정하세요.
단순 값 리스트의 중복 제거
리스트가 한 줄에 하나의 값으로 구성되어 있다면 Email, Domain 또는 Value 같은 헤더가 있는 단일 열 CSV로 저장하세요. Datablist로 가져온 뒤 해당 열에서 Clean > Remove duplicates를 열고 Exact를 실행합니다. 그룹을 검토하고 유지할 레코드를 선택한 다음 중복 행을 처리하고 남은 값을 내보내세요.
예를 들어 alpha.example, beta.example, alpha.example이 들어 있는 리스트라면 반복된 행을 삭제한 후 alpha 값 하나와 beta 값 하나만 남아야 합니다. 이는 입력과 출력의 이해를 돕기 위한 예시이며, 다운로드 샘플에서 추가로 측정한 결과는 아닙니다.
식별자만 있는 리스트라면 이 방법을 권합니다. 파일에 여러 열이 있다면 중복 레코드를 정리해야 합니다. 행을 삭제하면 그 행의 다른 값도 함께 사라집니다. 동일한 이메일이 있는 두 번째 행에 유용한 전화번호나 메모가 있다면 아래의 merge workflow를 사용하세요.
식별자가 비어 있는 행은 별도로 처리하세요. 기본 selected-property 비교에서는 텍스트 식별자가 없으면 match가 성립하지 않습니다. 빈 행을 삭제해야 한다면 중복 제거 기능이 그 의미를 판단해 줄 것으로 기대하지 말고 별도의 정리 작업을 수행하세요.
레코드를 고유하게 만드는 기준 선택
matching 알고리즘부터 선택하지 마세요. 먼저 entity가 무엇인지 정의해야 합니다.
연락처, 회사, 제품, 거래에는 서로 다른 식별자가 필요합니다.
| 리스트 | 우선 사용할 강력한 식별자 | 유용한 2차 검사 |
|---|---|---|
| 연락처 | 이메일, 전화번호, LinkedIn URL | 이름과 회사명 |
| 회사 | 웹사이트 도메인, 회사 ID | 정규화된 회사명 |
| 제품 | SKU, EAN, GTIN, 제품 URL | 제품명과 브랜드 |
| CRM Lead | 이메일, 전화번호, CRM ID | 이름과 회사 도메인 |
| 주문 | 주문 ID | 고객 ID와 주문일 |
한 번의 검사로 모든 중복을 찾기는 어렵습니다. 어떤 연락처는 두 행의 이메일이 같지만, 다른 연락처는 이메일을 변경했어도 전화번호는 동일할 수 있습니다. 모든 속성을 하나의 규칙에 넣기보다 식별자별로 검사를 나눠 실행하세요.
예를 들면 다음과 같습니다.
- 이메일을 기준으로 연락처를 matching합니다.
- 검토한 그룹을 처리합니다.
- 전화번호를 정규화한 뒤 정리된 속성에 Exact 검사를 실행합니다.
- 이름과 회사명을 조합해 신중하게 fuzzy 검사를 실행합니다.
여러 필드를 한 검사에 추가하기 전에 빈 값 규칙을 선택하세요. Value required에서는 식별자가 없을 경우 유효한 후보가 제외될 수 있습니다.
Match on empty value에서는 함께 비어 있는 속성이 100%로 계산되어 평균 점수를 높일 수 있습니다. 이메일이 일치하고 성이 둘 다 비어 있으면 점수는 87.5%이며, 양쪽 모두 비어 있는 속성을 세 개 더 추가하면 95%가 됩니다. 열이 많을수록 근거가 강해진다고 판단하기 전에 빈 값 점수 계산 예시를 확인하세요.
식별자별 정규화가 필요하다면 다음 전용 가이드를 참고하세요.
1,000행 예제 리스트 다운로드
중복 제거 데모 CSV를 다운로드하세요. 이 파일은 의도적으로 설계된 800개 entity를 나타내는 1,000개 행으로 구성되어 있습니다.
파일에는 다음과 같은 테스트 케이스가 섞여 있습니다.
| 설계된 케이스 | 중복 그룹 | matching 검사 |
|---|---|---|
| 전체 행이 동일한 복사본 | 5 | All Properties와 Exact |
| 이메일 alias와 wrapper | 100 | Email, Smart 및 Email processor |
| 회사명과 URL 변형 | 50 | Company Name 또는 URL processing |
| 기본적인 미국 전화번호 형식 차이 | 25 | Phone과 Smart, 형식만 비교 |
| 의도적으로 만든 이름 오탈자 | 15 | Jaro-Winkler 또는 Levenshtein |
| 발음이 비슷한 이름 변형 | 5 | Metaphone |
| 의도된 중복이 없는 레코드 | 600 | 각각 별도로 유지되어야 함 |
이는 설계 단계에서 정한 정답 수치이며, 모든 fuzzy threshold에서 동일한 결과가 나온다는 의미는 아닙니다. threshold가 낮으면 Distance matching에 추가 후보가 포함될 수 있으므로 처리 전에 그룹을 검토하세요.
파일에 포함된 세 가지 쌍은 다음과 같습니다.
| 사용 사례 | 첫 번째 저장 값 | 두 번째 저장 값 |
|---|---|---|
| 이메일 alias | felix.patel.605@company-0605.example | felix.patel.605+newsletter@company-0605.example |
| 회사명과 URL | Redwood 0727, Inc.https://www.redwood-0727.example/ | Redwood 0727 Group LLChttp://redwood-0727.example/about?utm_source=event |
| 기본 전화번호 형식 | +1 (202) 555-0768 | 1 202 555 0768 |
행마다 직함, 담당자, 상태, 매출, 소스, 태그, 메모 등의 값도 서로 다릅니다. 이러한 충돌 덕분에 master record와 field survivorship 규칙을 테스트하기 좋습니다.
Datablist로 리스트 가져오기
Datablist를 열고 CSV 또는 Excel 파일을 collection으로 가져오세요. collection은 구조화된 스프레드시트처럼 작동하며, 행은 item, 열은 property에 해당합니다.
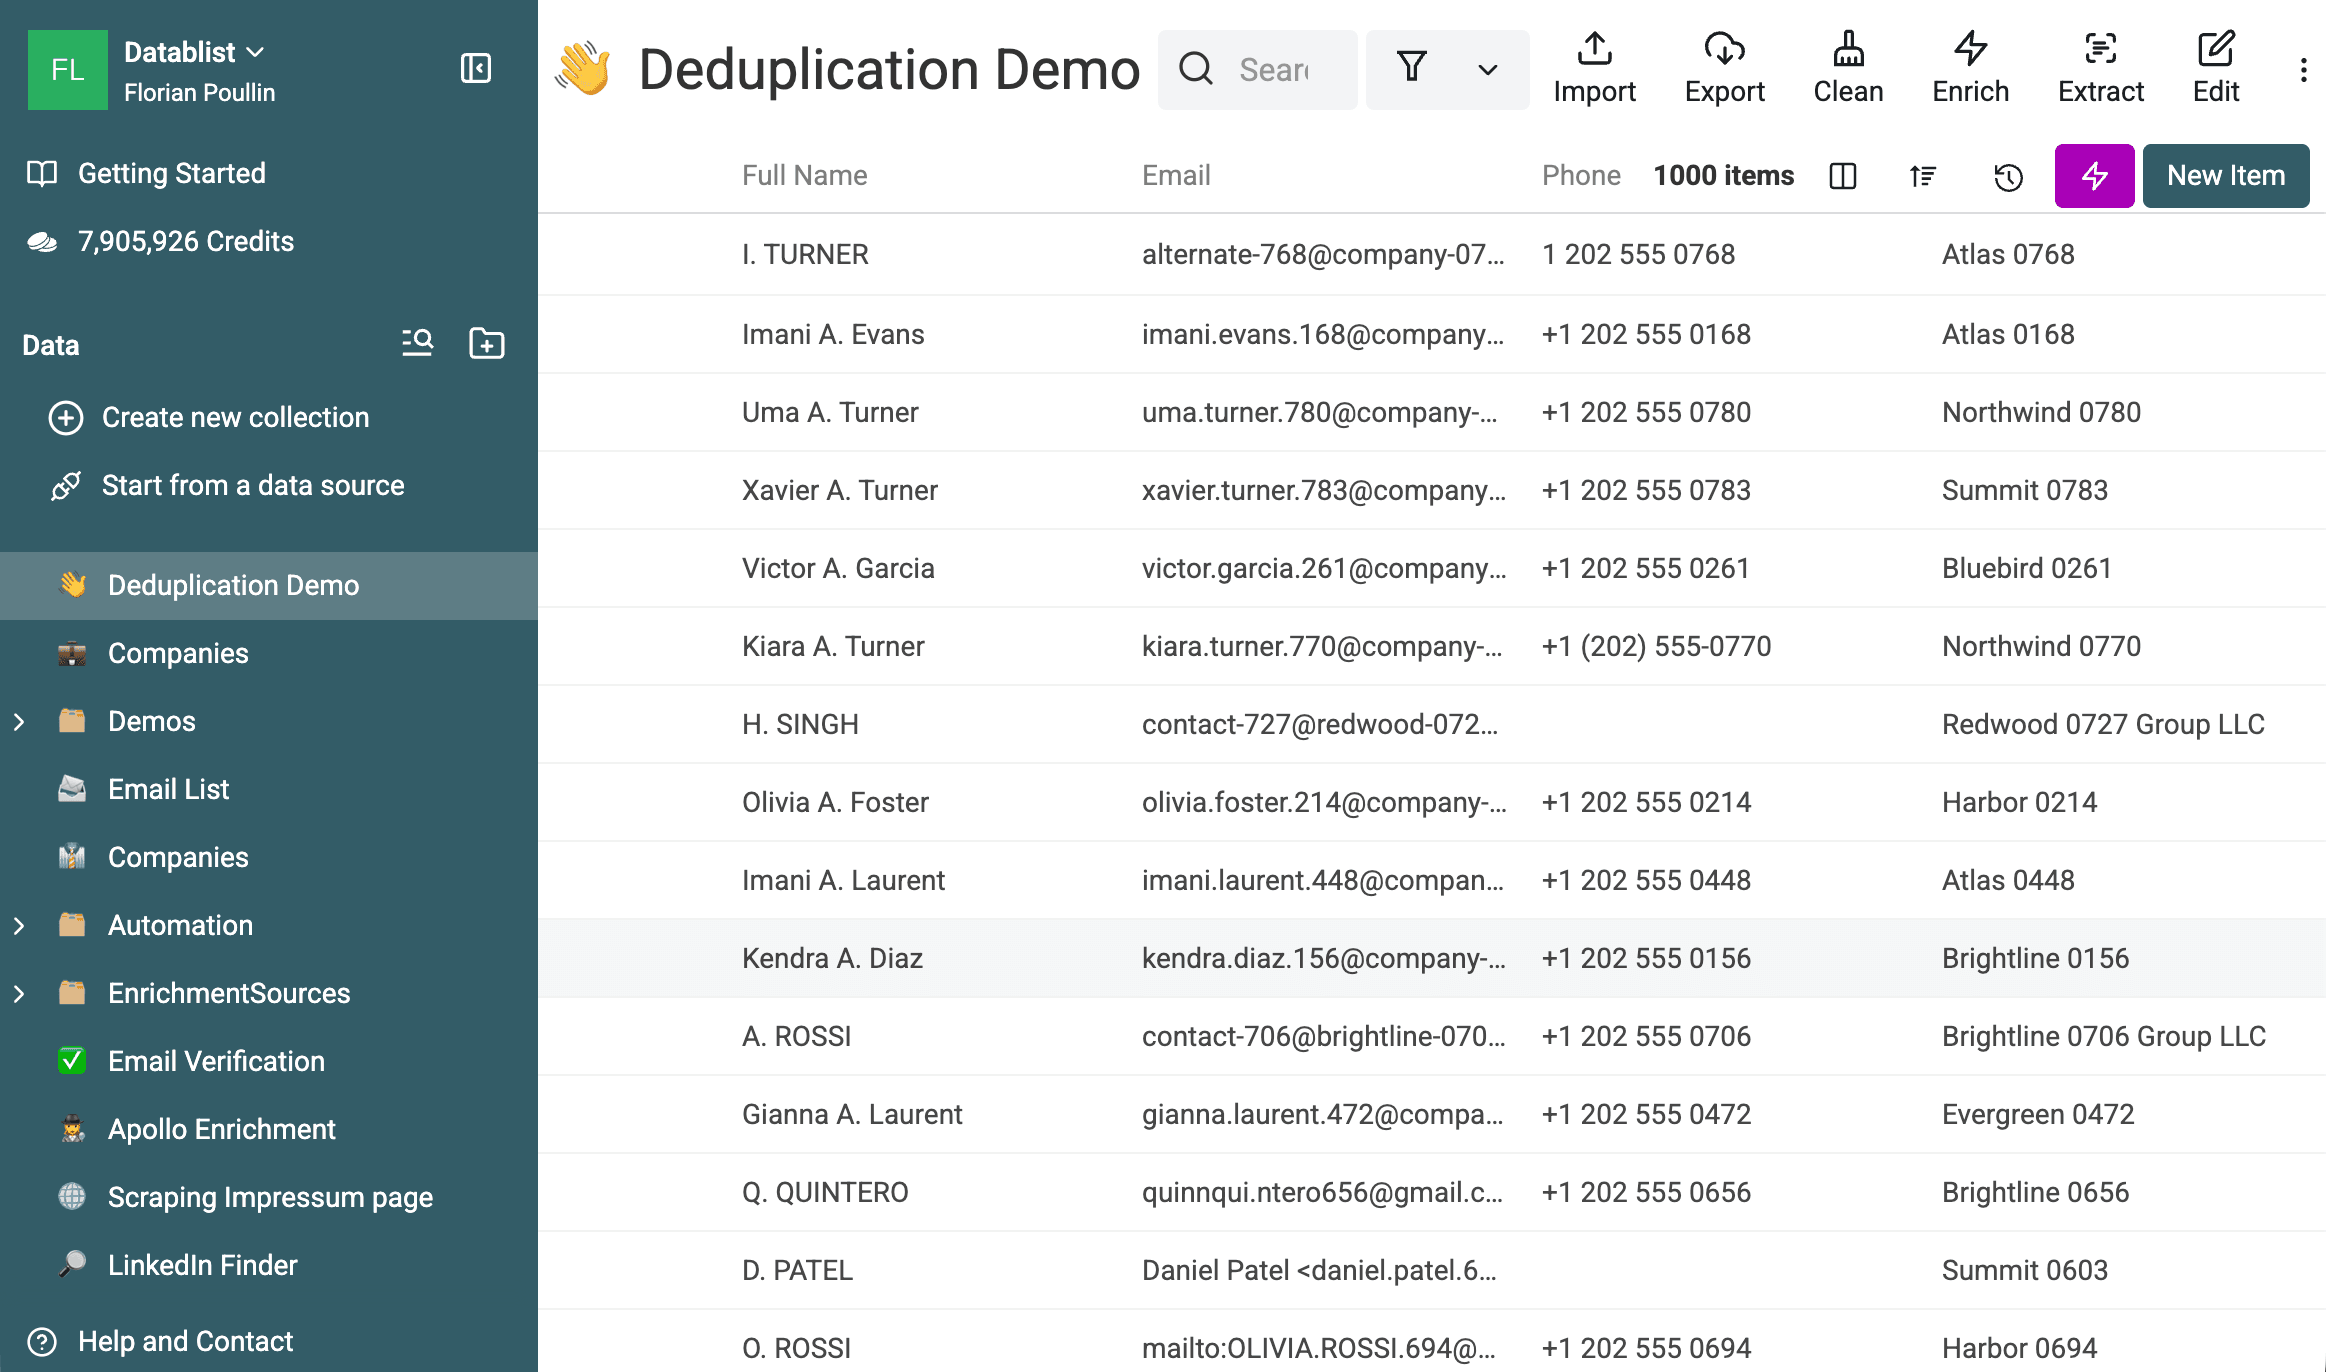
가져오기 과정에서 감지된 property type을 확인하세요.
- 이메일 열은 Email type을 사용해야 합니다.
- 웹사이트 열은 URL을 사용해야 합니다.
- 전화번호 열은 Phone을 사용해야 합니다.
- 매출이나 수량 열은 Number를 사용해야 합니다.
- 활동일과 생성일은 DateTime을 사용해야 합니다.
ID, 소스, 담당자, 메모, 상태 열도 collection에 유지하세요. 올바른 레코드를 선택하고 merge에서 보존되는 값을 확인하는 데 도움이 됩니다.
Exact, Smart, fuzzy matching 실행
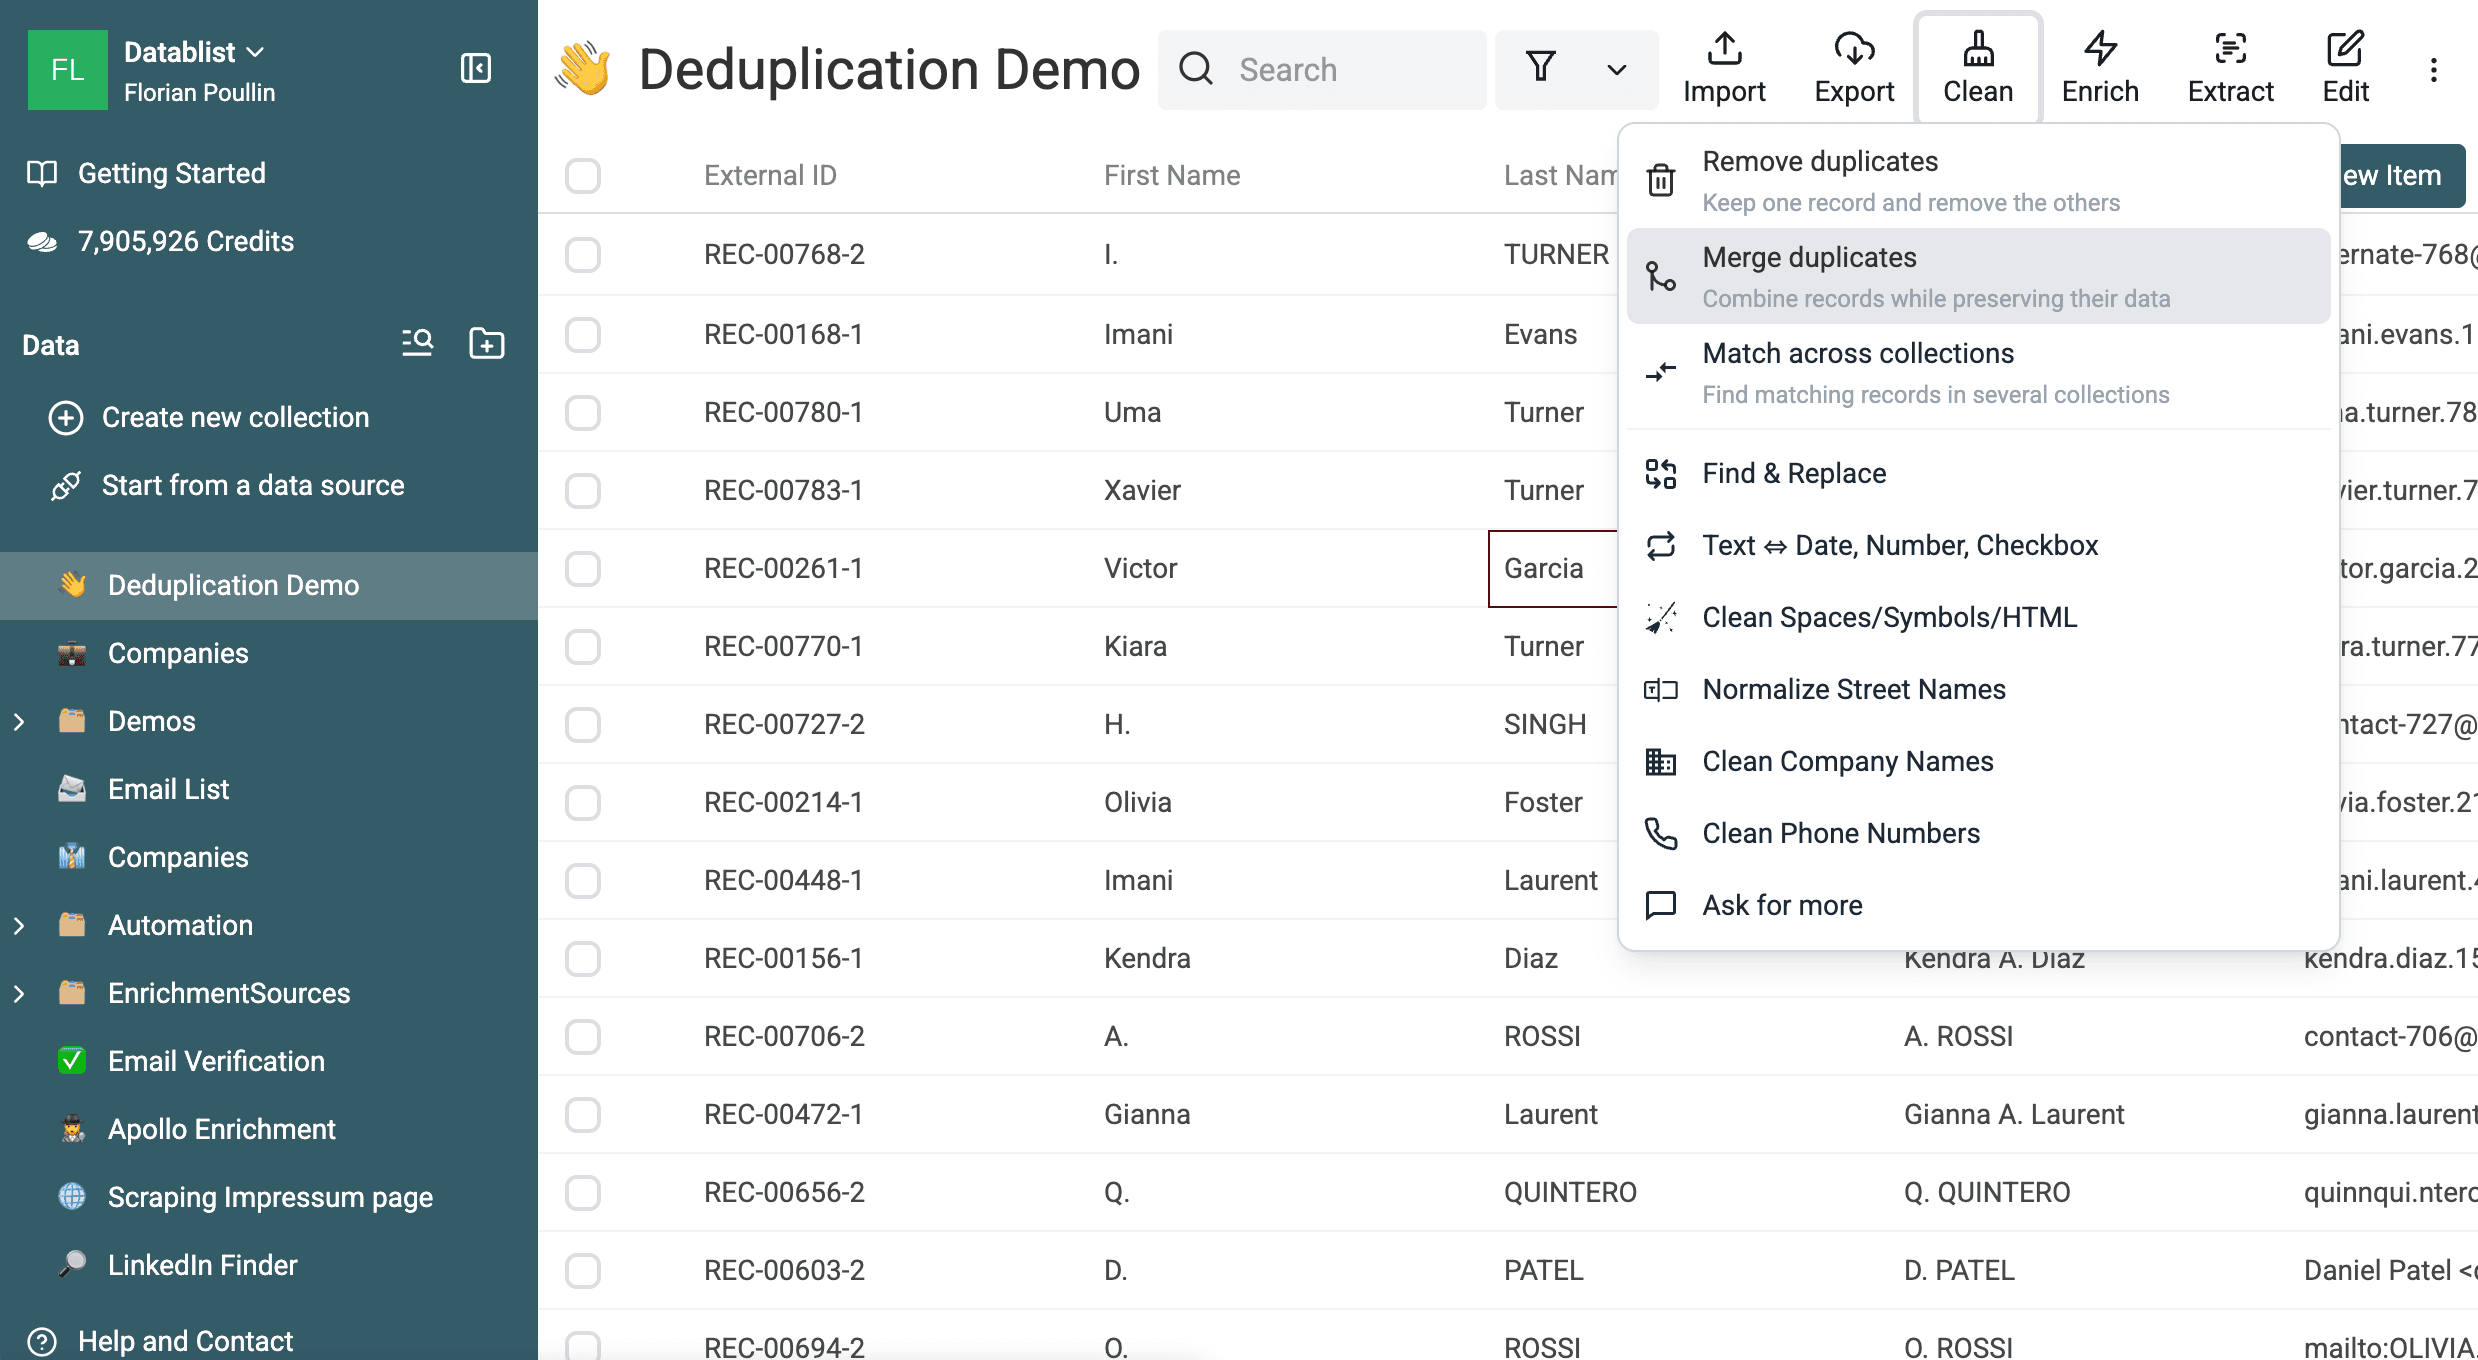
Clean을 열고 목적에 맞는 action을 선택하세요.
- 보조 행을 버려도 된다면 Remove duplicates를 선택합니다.
- 행마다 보존할 정보가 있다면 Merge duplicates를 선택합니다.
- 레코드가 서로 다른 collection에 있다면 Match across collections를 선택합니다.
앞의 두 action은 동일한 detection engine을 사용합니다. 결과 workspace를 열 때 선택되는 processing mode만 다릅니다.
Exact matching부터 시작하기
변경 없이 두 번 복사된 행을 찾으려면 All Properties와 Exact를 사용하세요. 외부 ID처럼 특정 필드가 반드시 같아야 한다면 Selected Properties를 사용합니다.
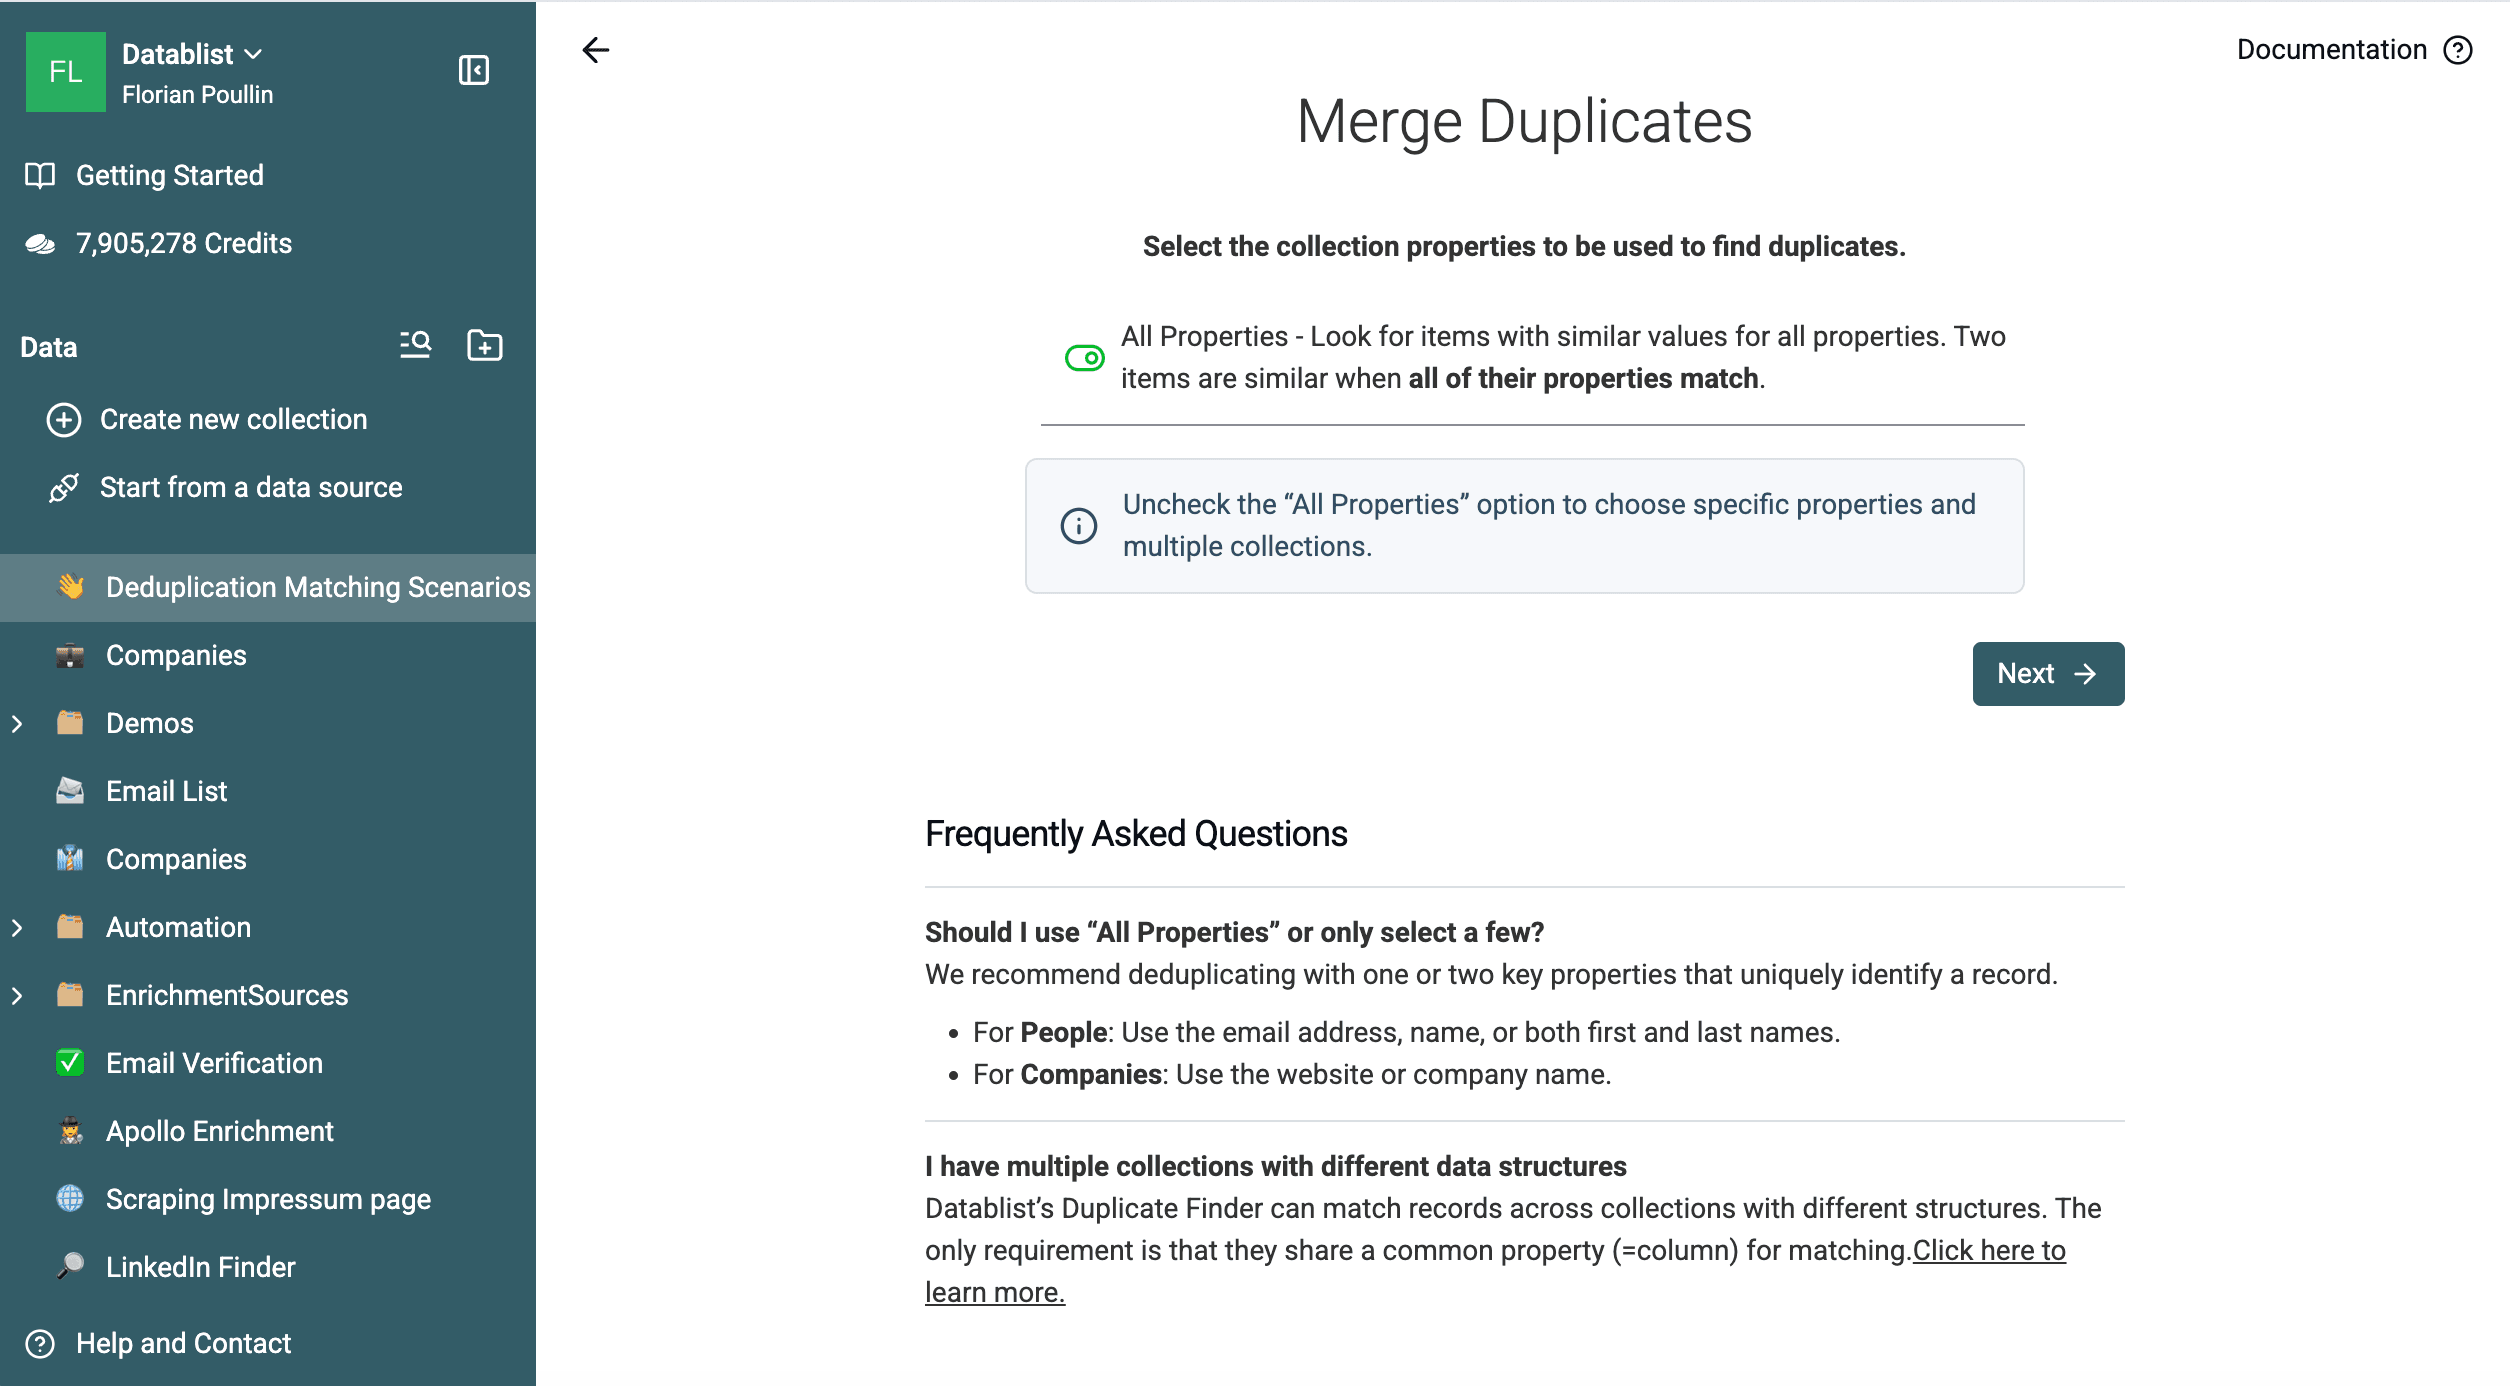
1,000행 샘플에서 이 검사는 중복 그룹 5개를 반환합니다. 각 그룹에는 모든 속성값이 동일한 행이 두 개씩 들어 있습니다.
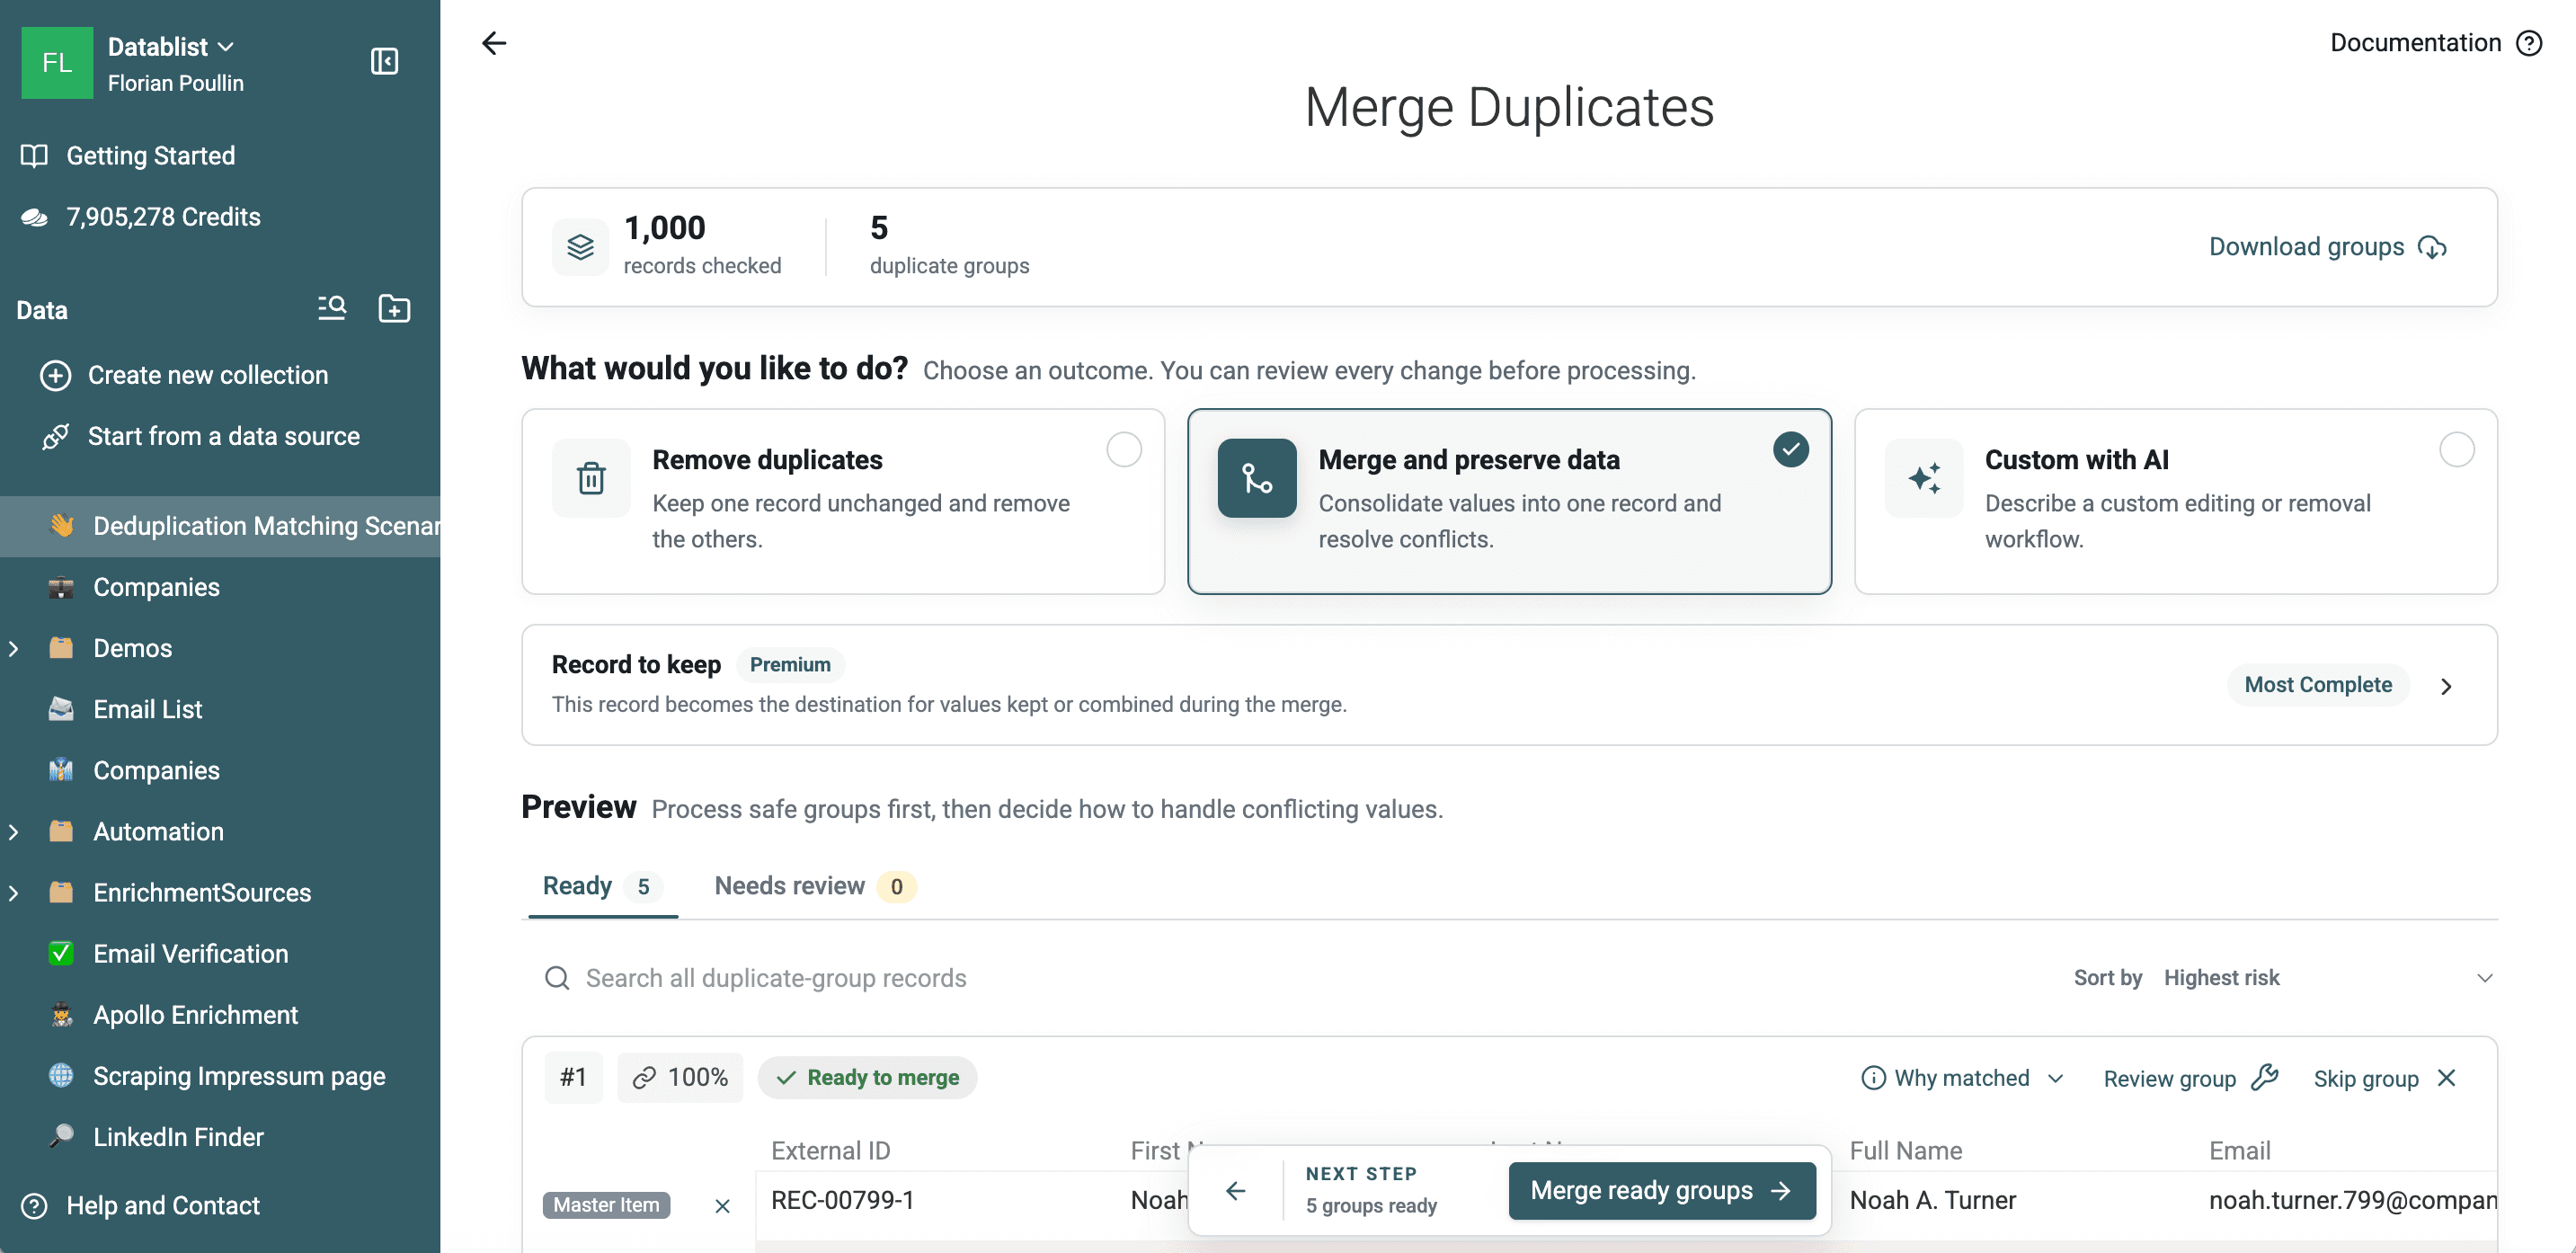
Exact는 모든 match가 엄격한 비교 조건을 충족하므로 가장 안전한 첫 단계입니다. 저장된 값이 다르면 Acme Inc.와 Acme, 형식이 다른 전화번호 또는 이메일 alias를 찾지 못합니다.
비로그인 사용자도 Exact 중복 검사를 실행할 수 있습니다. 무료 계정을 만들면 Smart 비교와 기타 Free plan 기능을 사용할 수 있습니다.
비즈니스 데이터에 Smart matching 사용
Smart matching은 저장된 셀을 변경하지 않고 비교할 값만 표준화합니다. property에 맞는 processor를 선택하세요.
- Email은 대소문자, 앞뒤 공백, plus alias, Gmail 점,
googlemail.com, display-name wrapper 및mailto:값을 처리합니다. - URL은 protocol과 마지막 slash를 무시할 수 있으며, subdomain, path, query parameter도 선택적으로 제어할 수 있습니다.
- Phone은 형식 문자를 무시합니다. 번호를 검증하거나 Country property를 사용하거나 누락된 국가 코드를 추론하지는 않습니다.
- Company Name은 일반적인 법인, 비즈니스, 지역 관련 용어를 제거합니다.
- Text는 악센트, 공백, 문장부호, 기호, 대소문자 및 단어 순서를 무시합니다.
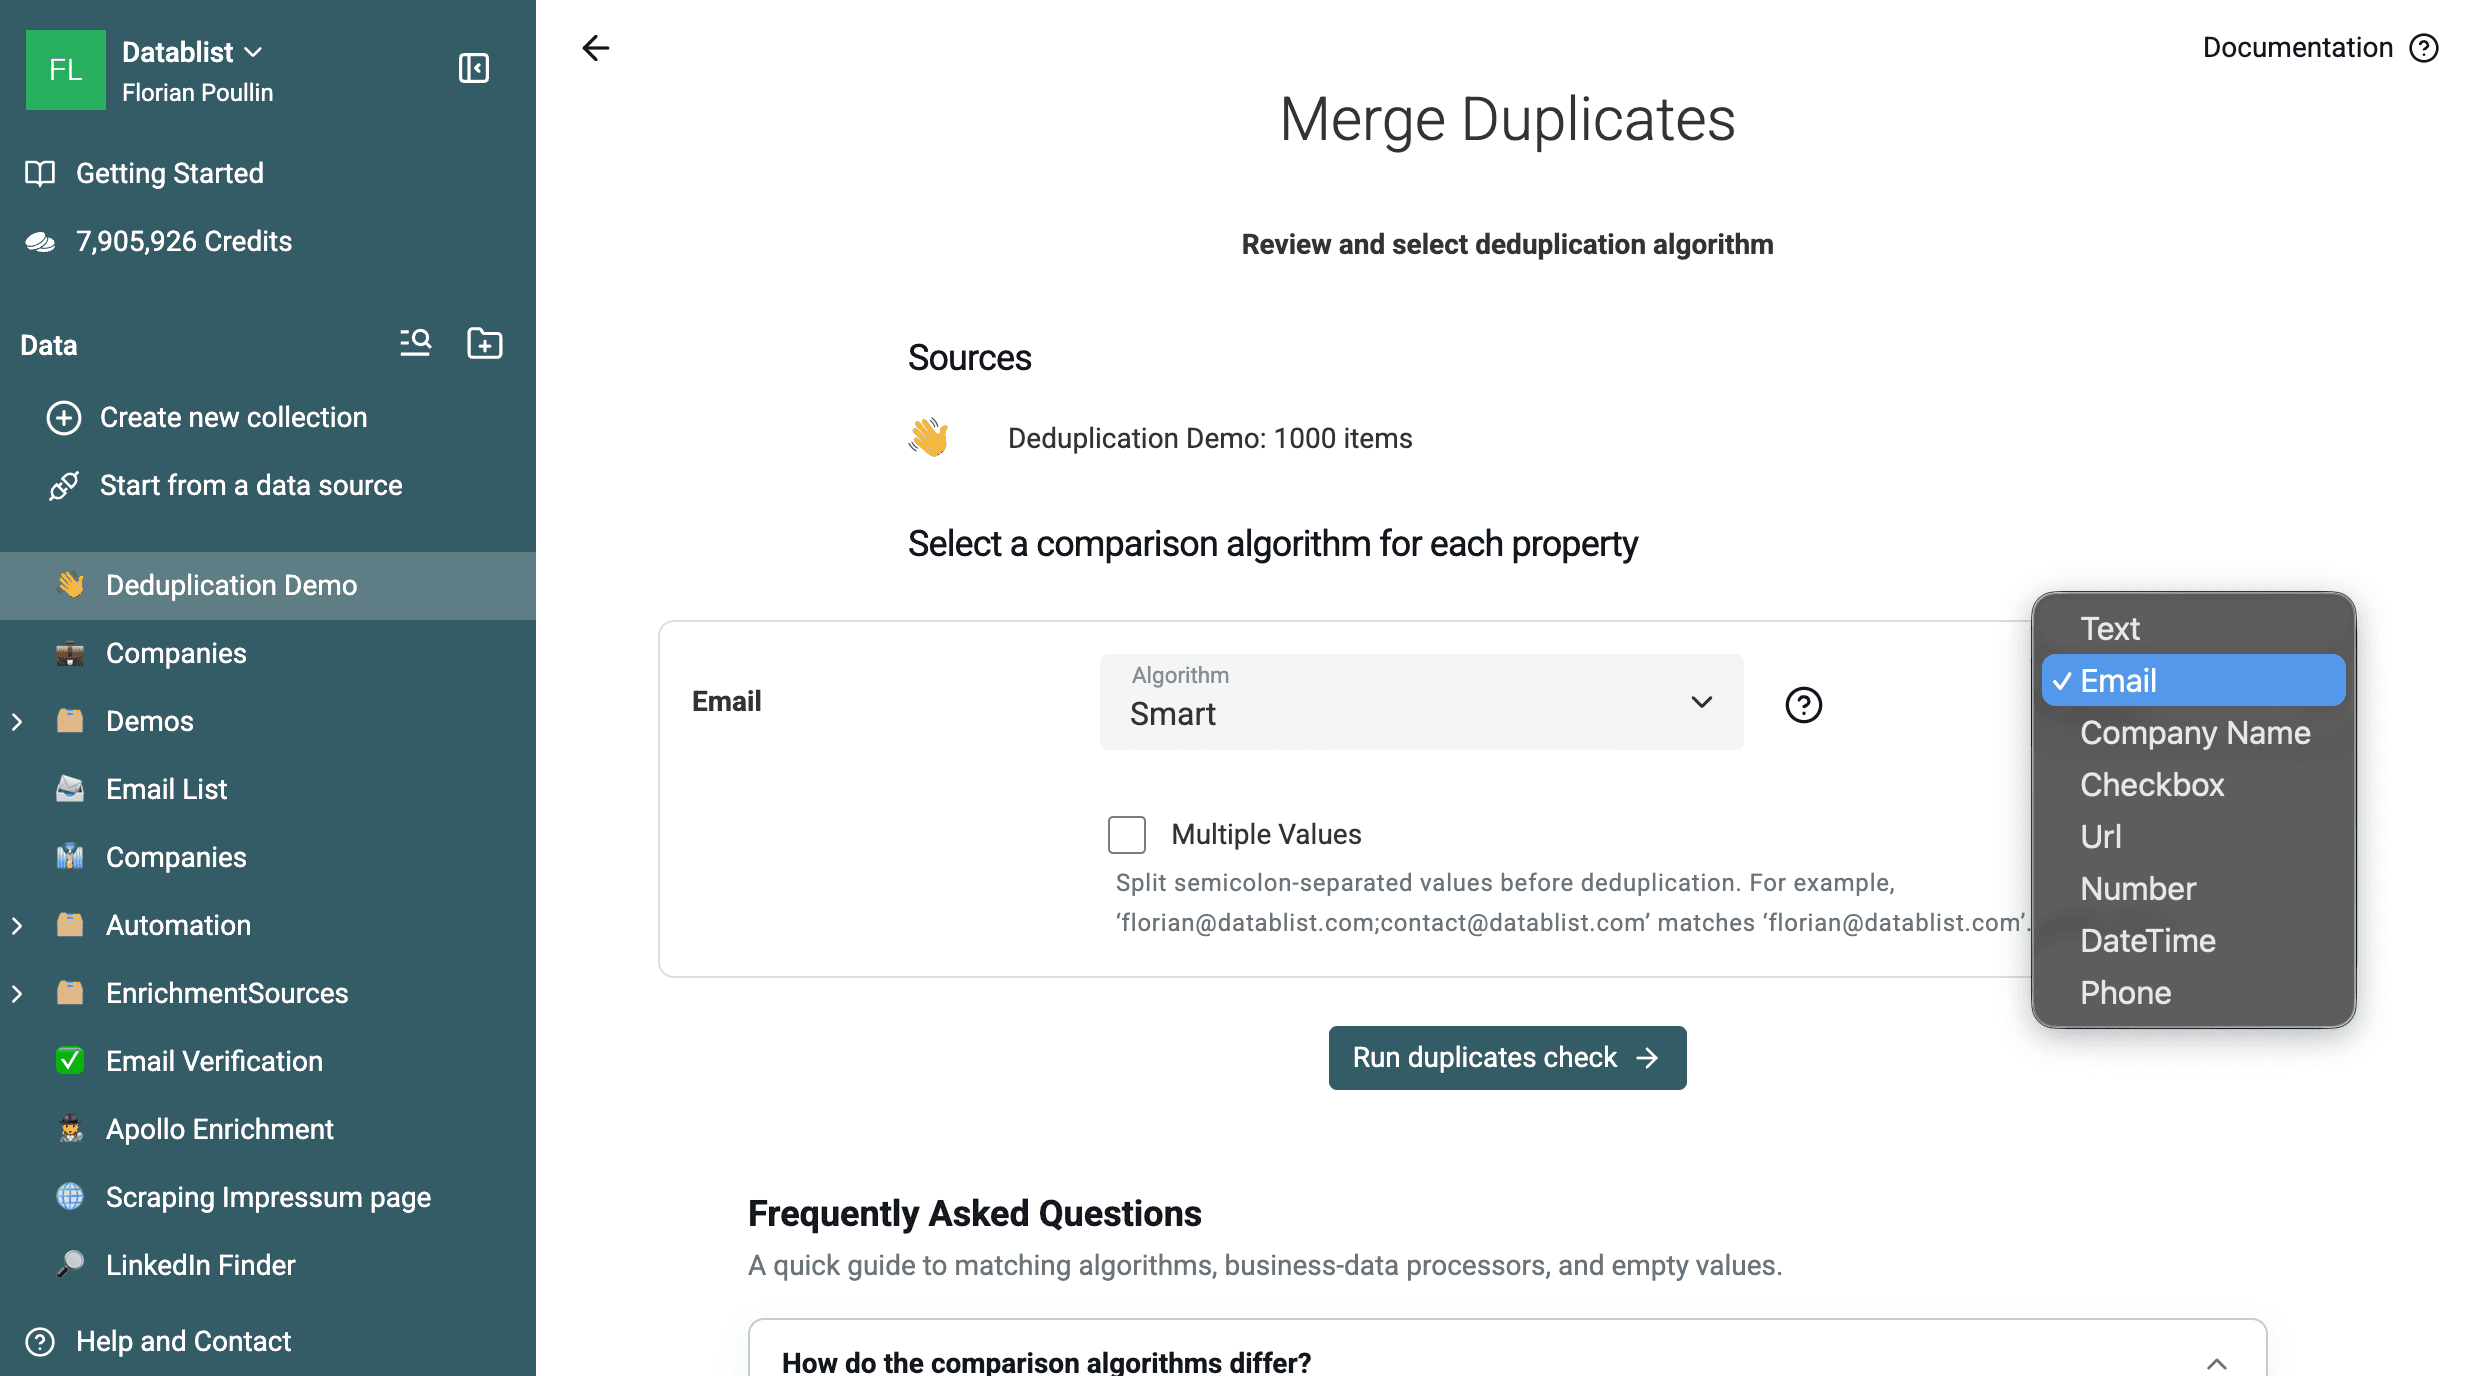
Company Name processor, multi-value matching 및 고급 알고리즘은 유료 plan에서 제공됩니다. 단일 collection matching에서는 Exact와 Smart를 Free plan으로 사용할 수 있지만 Smart에는 무료 계정이 필요합니다.
한 셀에 세미콜론으로 구분된 식별자가 여러 개 있다면 Multiple Values를 활성화하세요. Datablist가 각 값을 비교하여 하나 이상의 쌍이 일치하면 해당 property를 match로 판단합니다. 예를 들어 primary@example.com;shared@example.com이 있는 셀은 shared@example.com이 있는 다른 셀과 match될 수 있습니다.
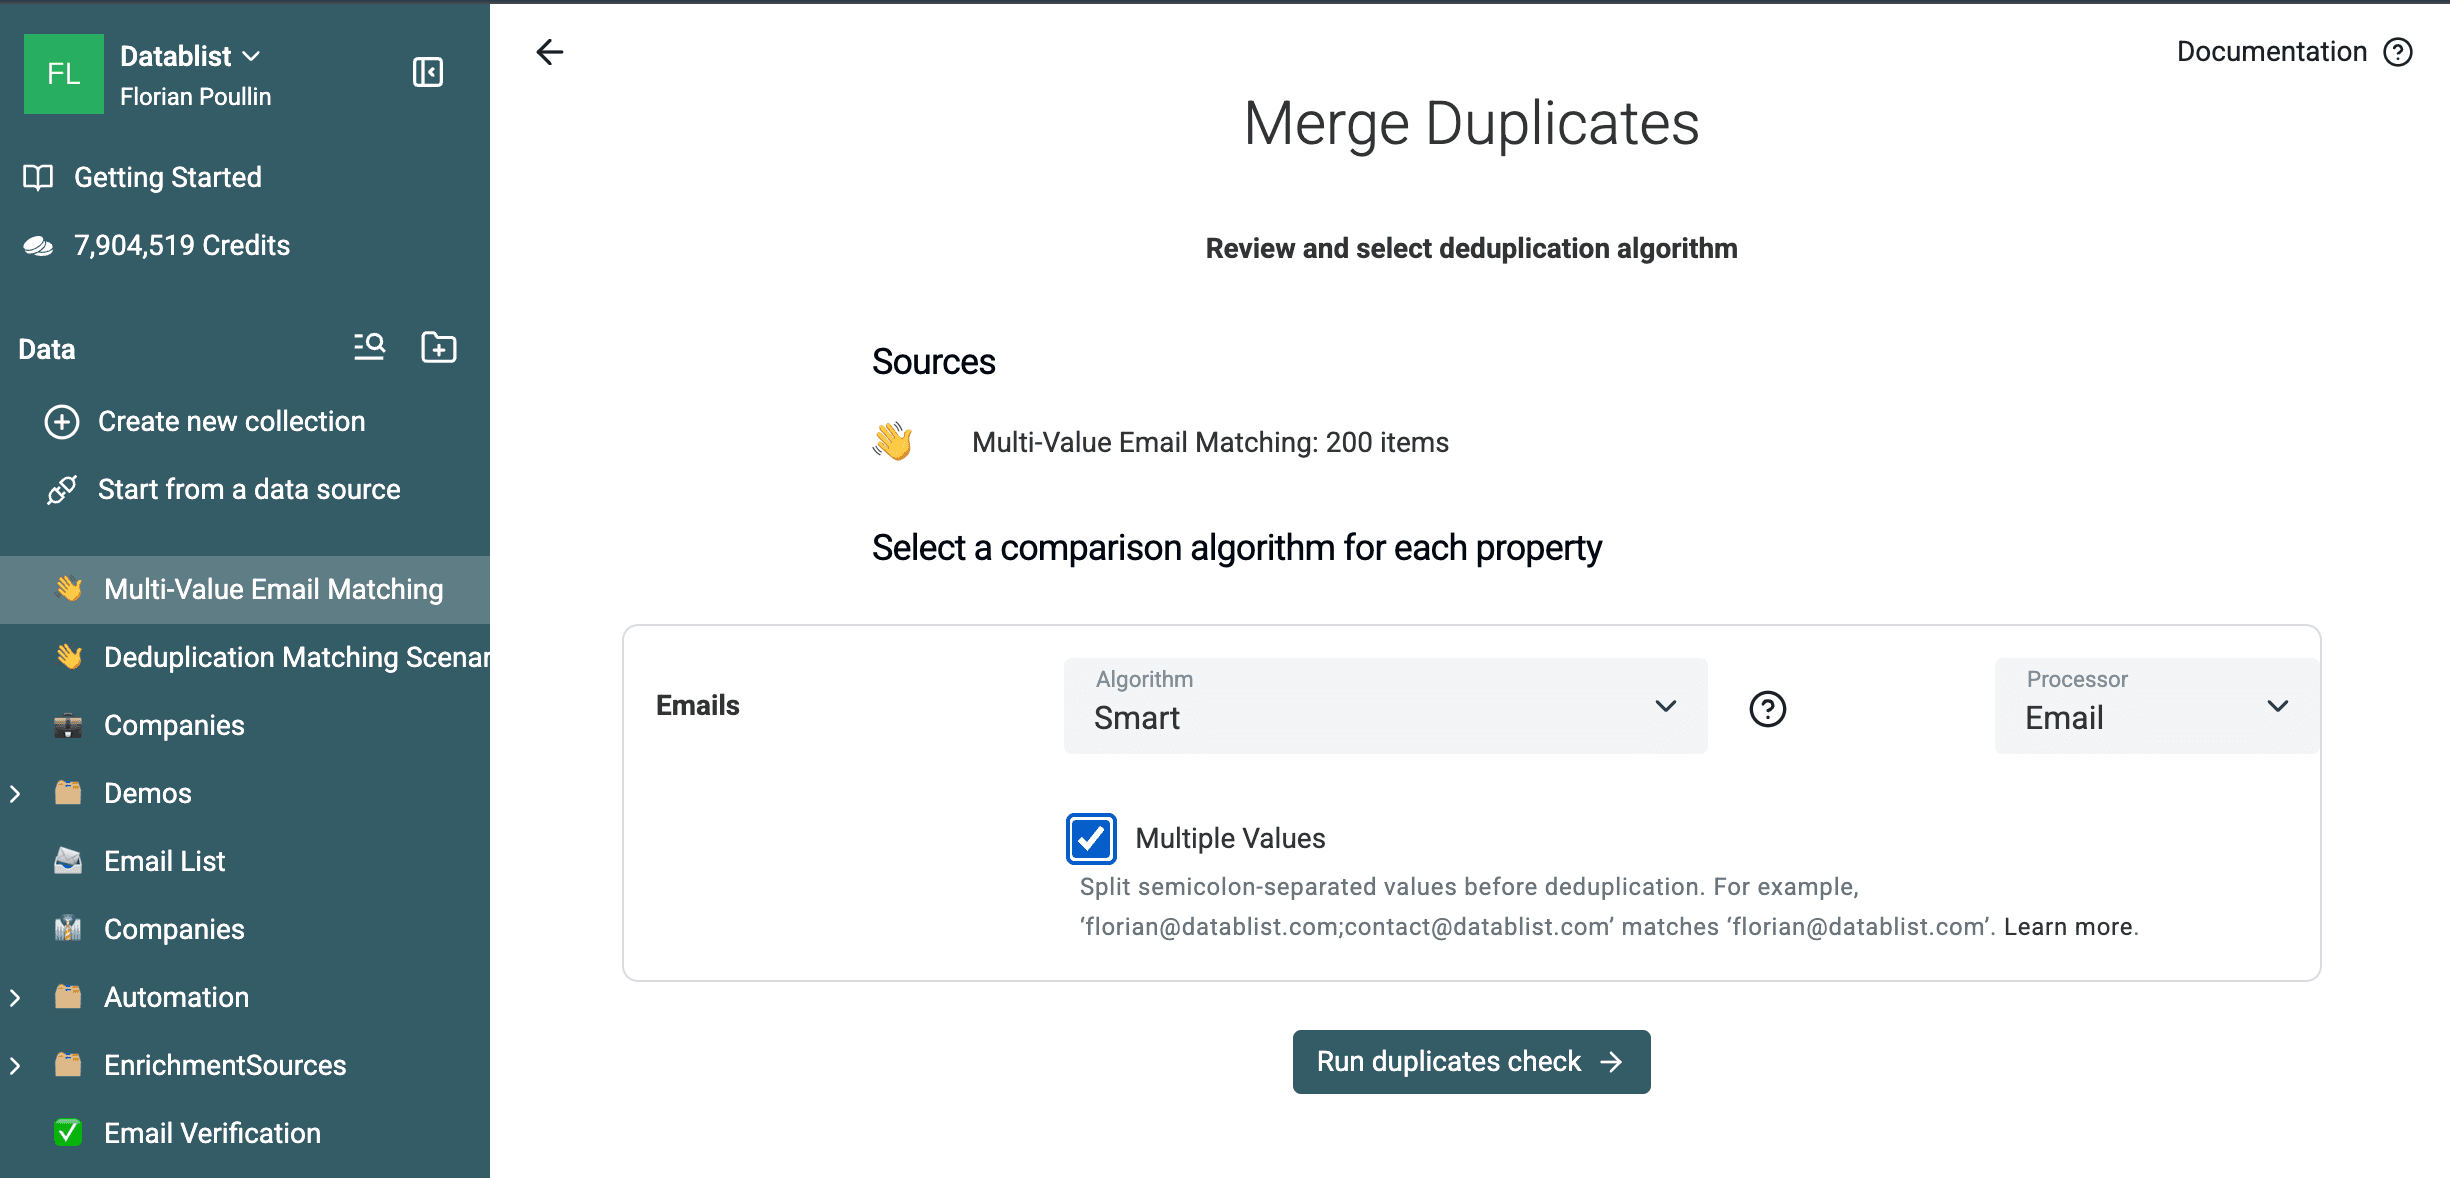
전용 200행 샘플에서는 이 설정으로 두 행짜리 그룹 60개가 반환되었습니다. 정답 검증 결과, 설계된 60개 쌍을 모두 찾았고 control 80개는 모두 제외했습니다. 샘플 파일, 결과 CSV 및 merge 결정 방법은 multi-value 필드 중복 제거 workflow를 참고하세요.
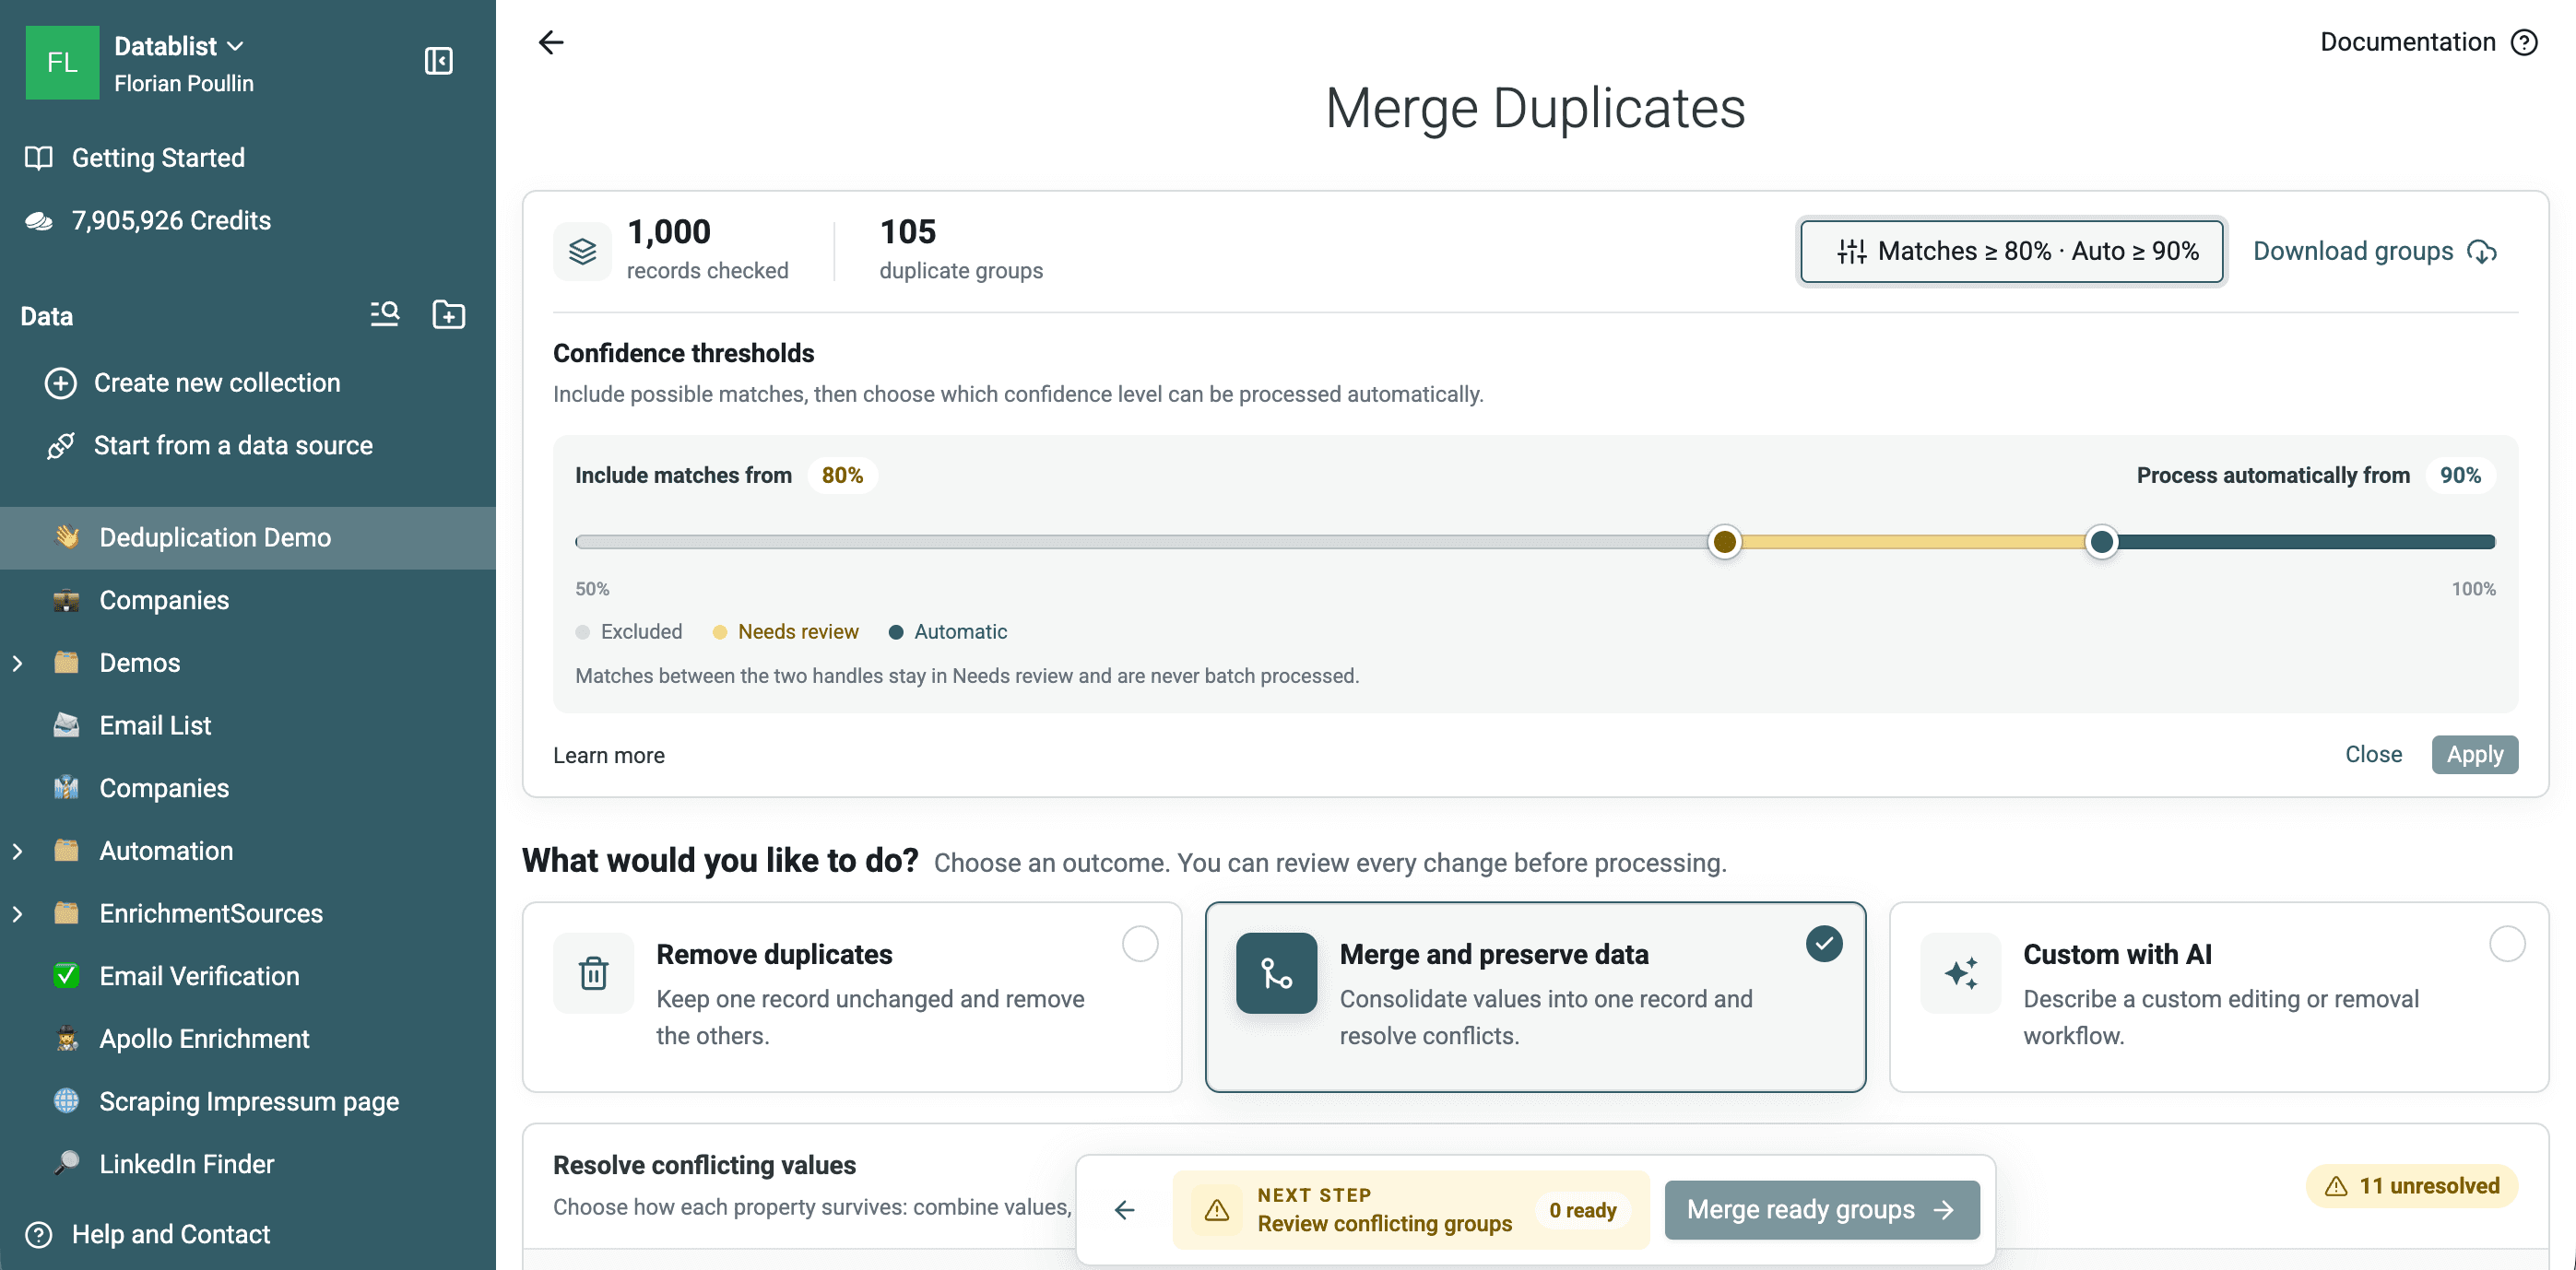
이 이메일 검사는 두 행짜리 그룹 105개를 반환했습니다. 설계된 이메일 정규화 쌍 100개와 동일한 이메일을 공유하는 완전 복사본 5개입니다.
matching 전 전화번호 정규화
Smart Phone processor는 숫자는 같지만 공백, 괄호, 대시 또는 기호가 다른 경우에 유용합니다. (415) 555-0123과 4155550123을 match할 수 있습니다.
하지만 국내 번호와 국제 번호가 같은 번호인지는 판단할 수 없습니다. 예를 들어 06 12 34 50 08과 +33 6 12 34 50 08을 비교하려면 먼저 국가 정보가 필요합니다.
전화번호 기반 중복 제거 전에 Phone Number Cleaner를 사용하세요.
- 원본
Phoneproperty를 mapping합니다. - 한 국가의 리스트라면 Local Phone Countries에서 국가를 선택합니다. 여러 국가가 섞인 리스트라면 Define country per item을 활성화하고
Countryproperty를 mapping합니다. - 원본 값을 덮어쓰지 말고 enrichment 결과를
Clean Phone Number에 저장합니다. - 실패하거나 비어 있는 출력을 검토합니다. 이 값들은 전화번호 matching에 포함하면 안 됩니다.
Clean Phone Number에서 Exact로 Duplicates Finder를 실행합니다.
전용 200행 전화번호 샘플을 다운로드하세요. 미국, 프랑스, 영국, 독일, 스페인의 국내·국제 번호 50쌍과 일치하지 않는 control 100개가 들어 있습니다. 실제 cleaner logic으로 검증한 결과 200개 행 모두에서 정규화된 전화번호가 생성되었습니다. 설계된 50개 쌍은 동일한 국제 번호 50개로 수렴했고 control은 고유한 값으로 남았습니다.
이 전처리 단계에서는 전화번호 형식도 검증합니다. merge 전에 레코드를 확인할 수 있도록 원본 Phone 및 Country property를 정리된 출력 옆에 유지하세요. 국가 코드와 국제 번호의 역할은 전화번호 정규화의 의미에서 확인할 수 있습니다.
회사 레코드는 Website에서 별도의 검사를 실행하세요. URL processor와 함께 Smart를 선택합니다. URL 구성 요소가 다른 회사나 지점을 나타내지 않을 때만 Ignore Subdomain, Ignore Path 및 Ignore Query Params를 활성화하세요.
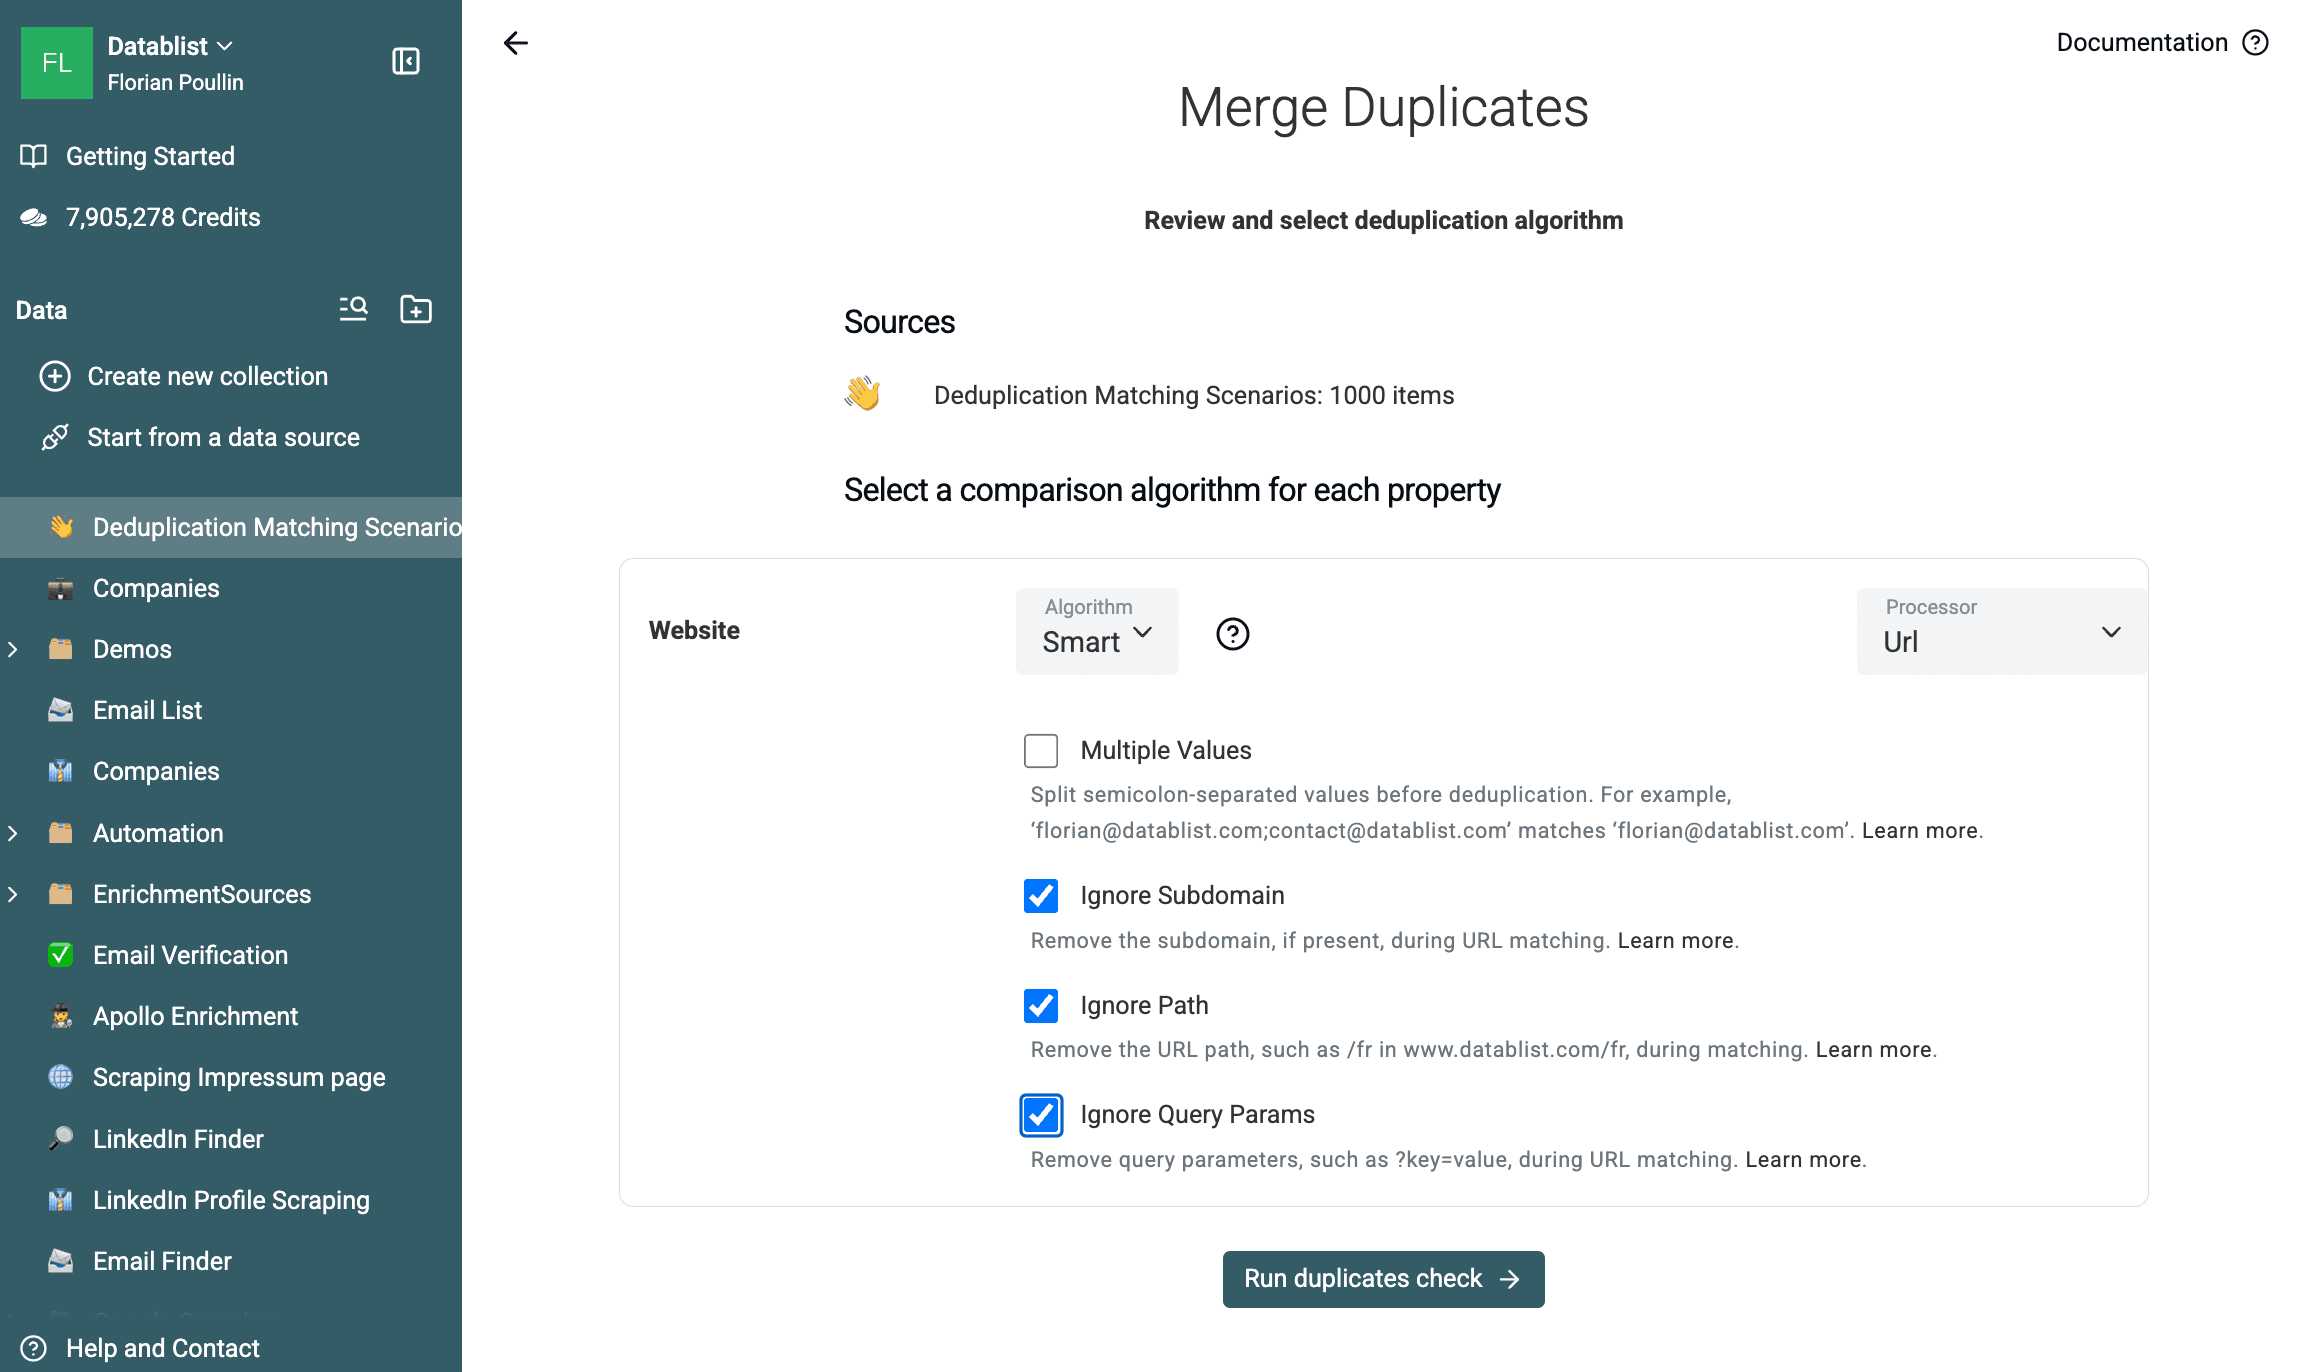
동일한 1,000행 샘플에서 이 설정은 두 행짜리 그룹 200개를 반환했습니다. 50개 쌍에는 의도적으로 만든 URL 변형이 있고, 150개 쌍은 이미 동일한 웹사이트를 공유합니다. 이 테스트에서 내보낸 모든 쌍은 같은 정규화 host로 변환되었습니다.
Website 중복 그룹 200개를 다운로드하거나 회사 중복 제거 workflow에서 도메인 우선 matching 전략을 확인하세요.
fuzzy와 phonetic matching을 검토 단계로 사용
Metaphone은 텍스트의 발음을 비교합니다. Jaro-Winkler와 Levenshtein은 유사도 점수를 계산하므로 Uma Turner와 Uman Turner 같은 철자 차이를 찾는 데 유용합니다.
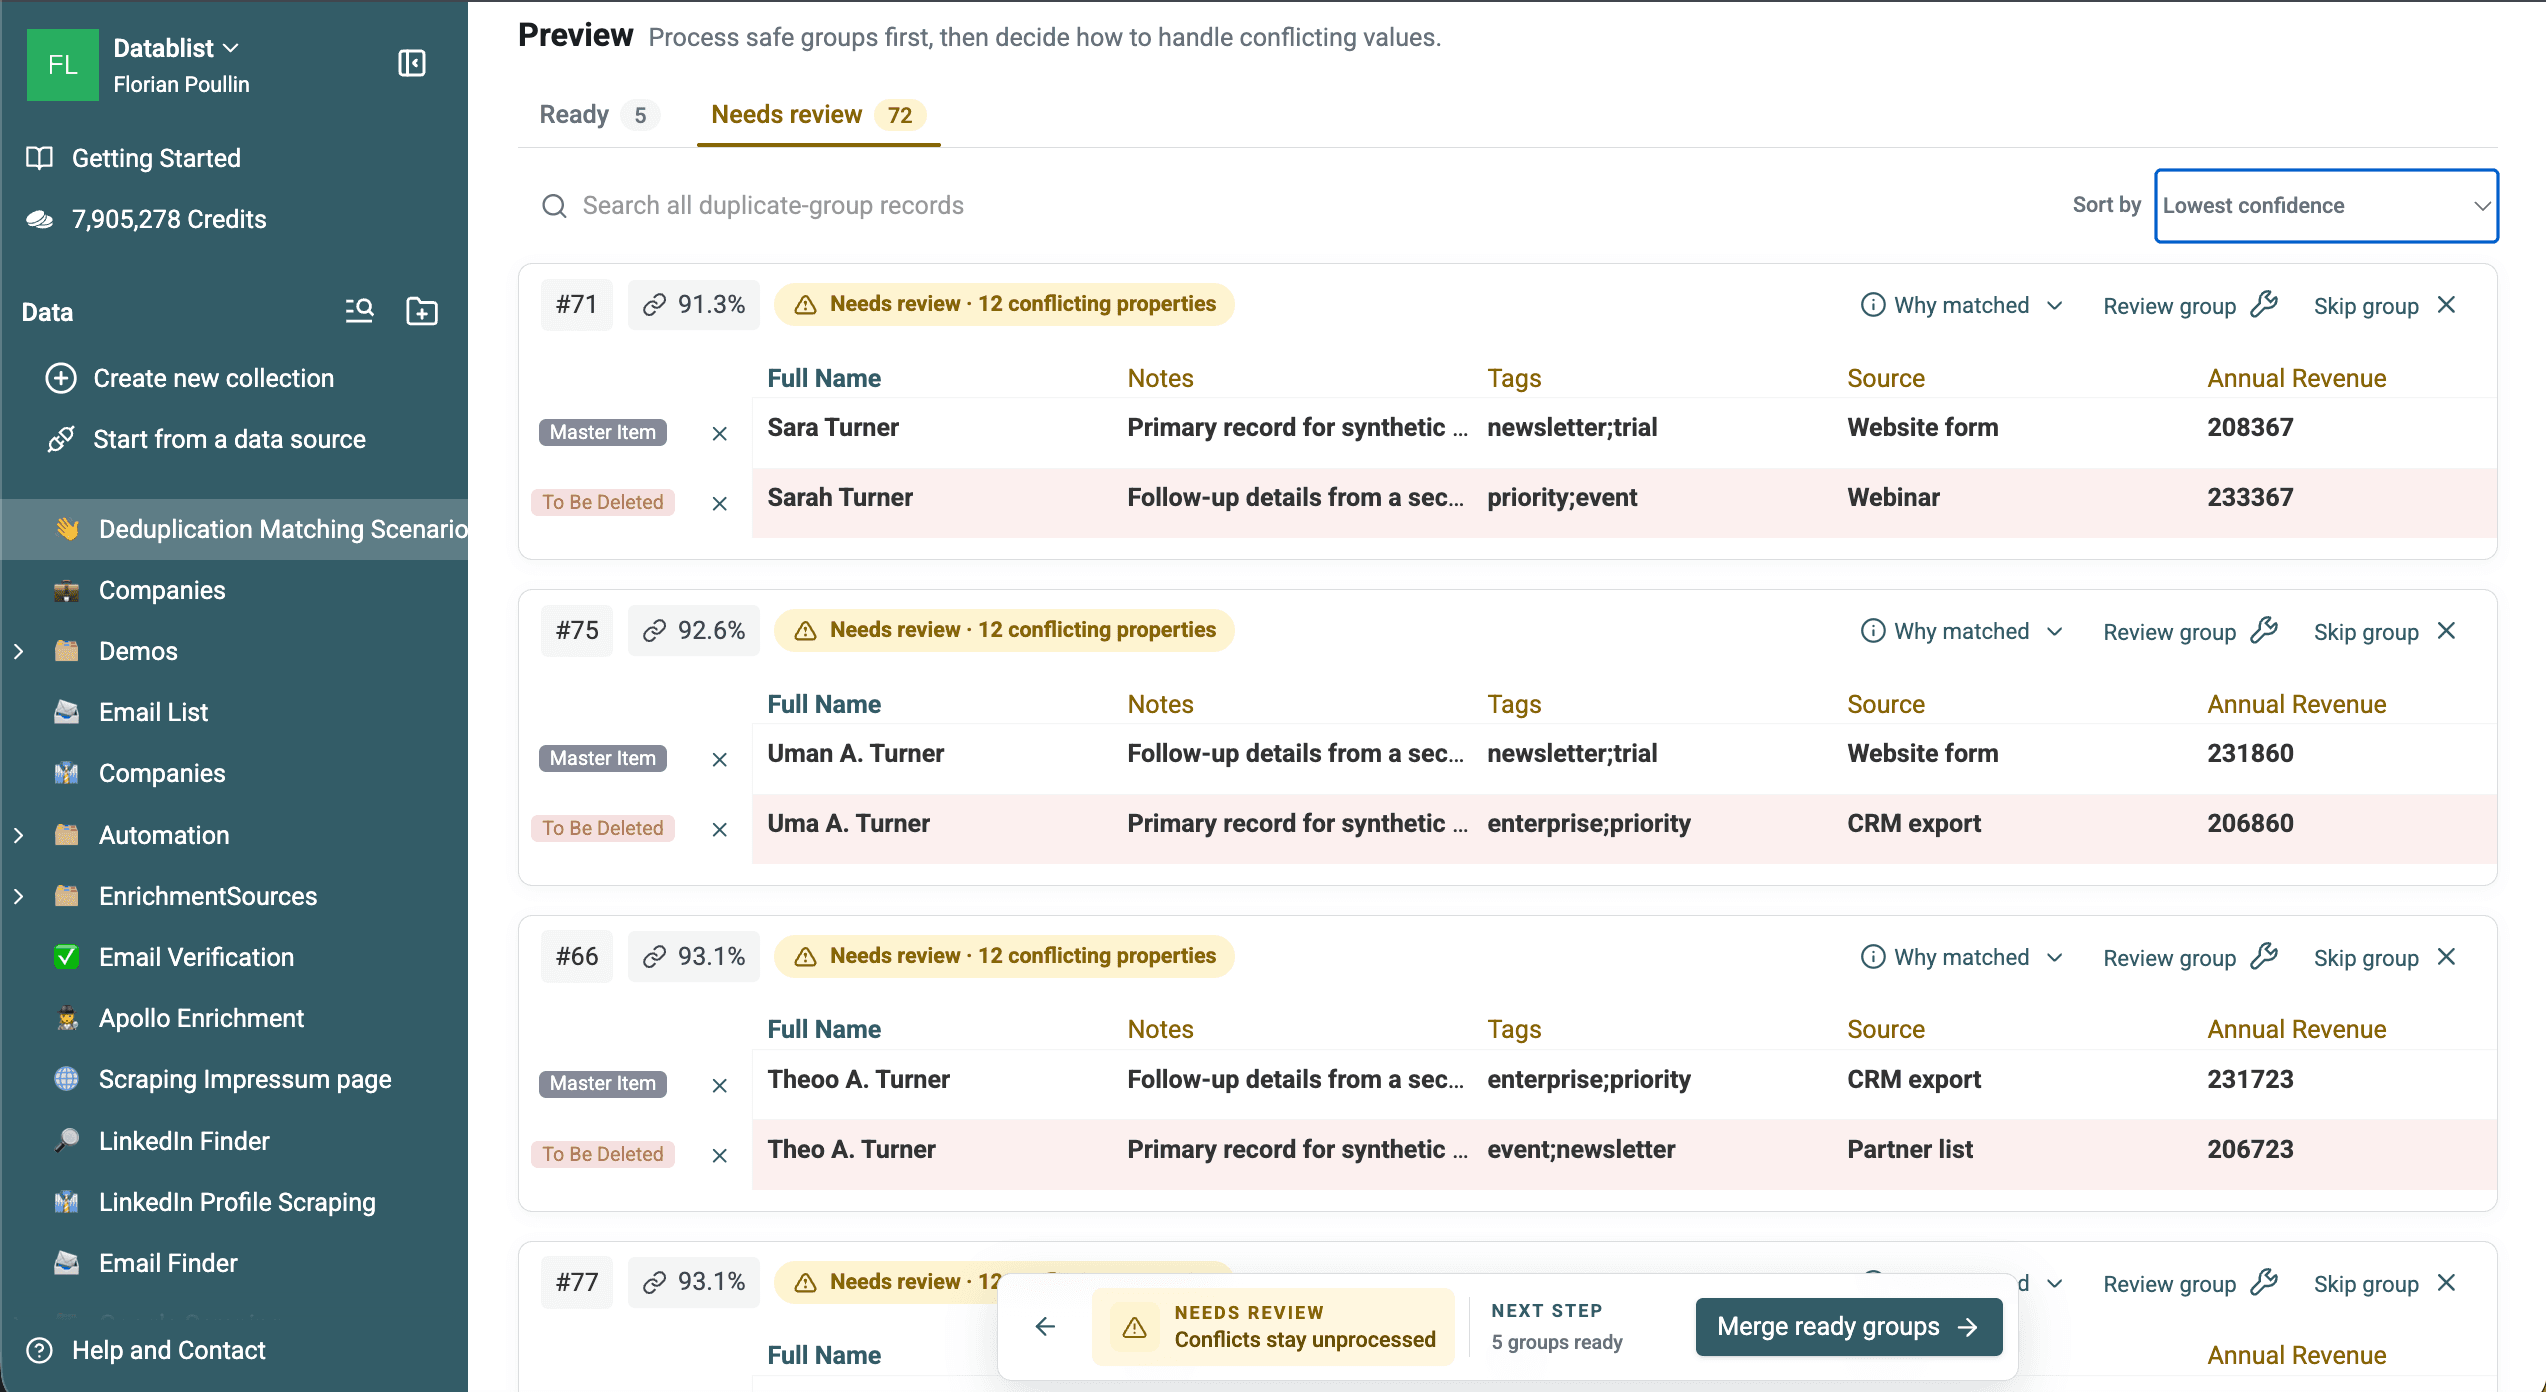
Fuzzy match는 확정된 중복이 아니라 후보입니다. 높은 threshold로 시작해 점수가 가장 낮은 그룹을 확인하고, 검토 결과가 충분히 정확할 때만 threshold를 낮추세요.
측정 가능한 fuzzy 검사를 실행하려면 Full Name을 선택하고 Levenshtein을 사용하는 Distance와 Text processor를 설정한 뒤 threshold를 90%로 지정하세요.
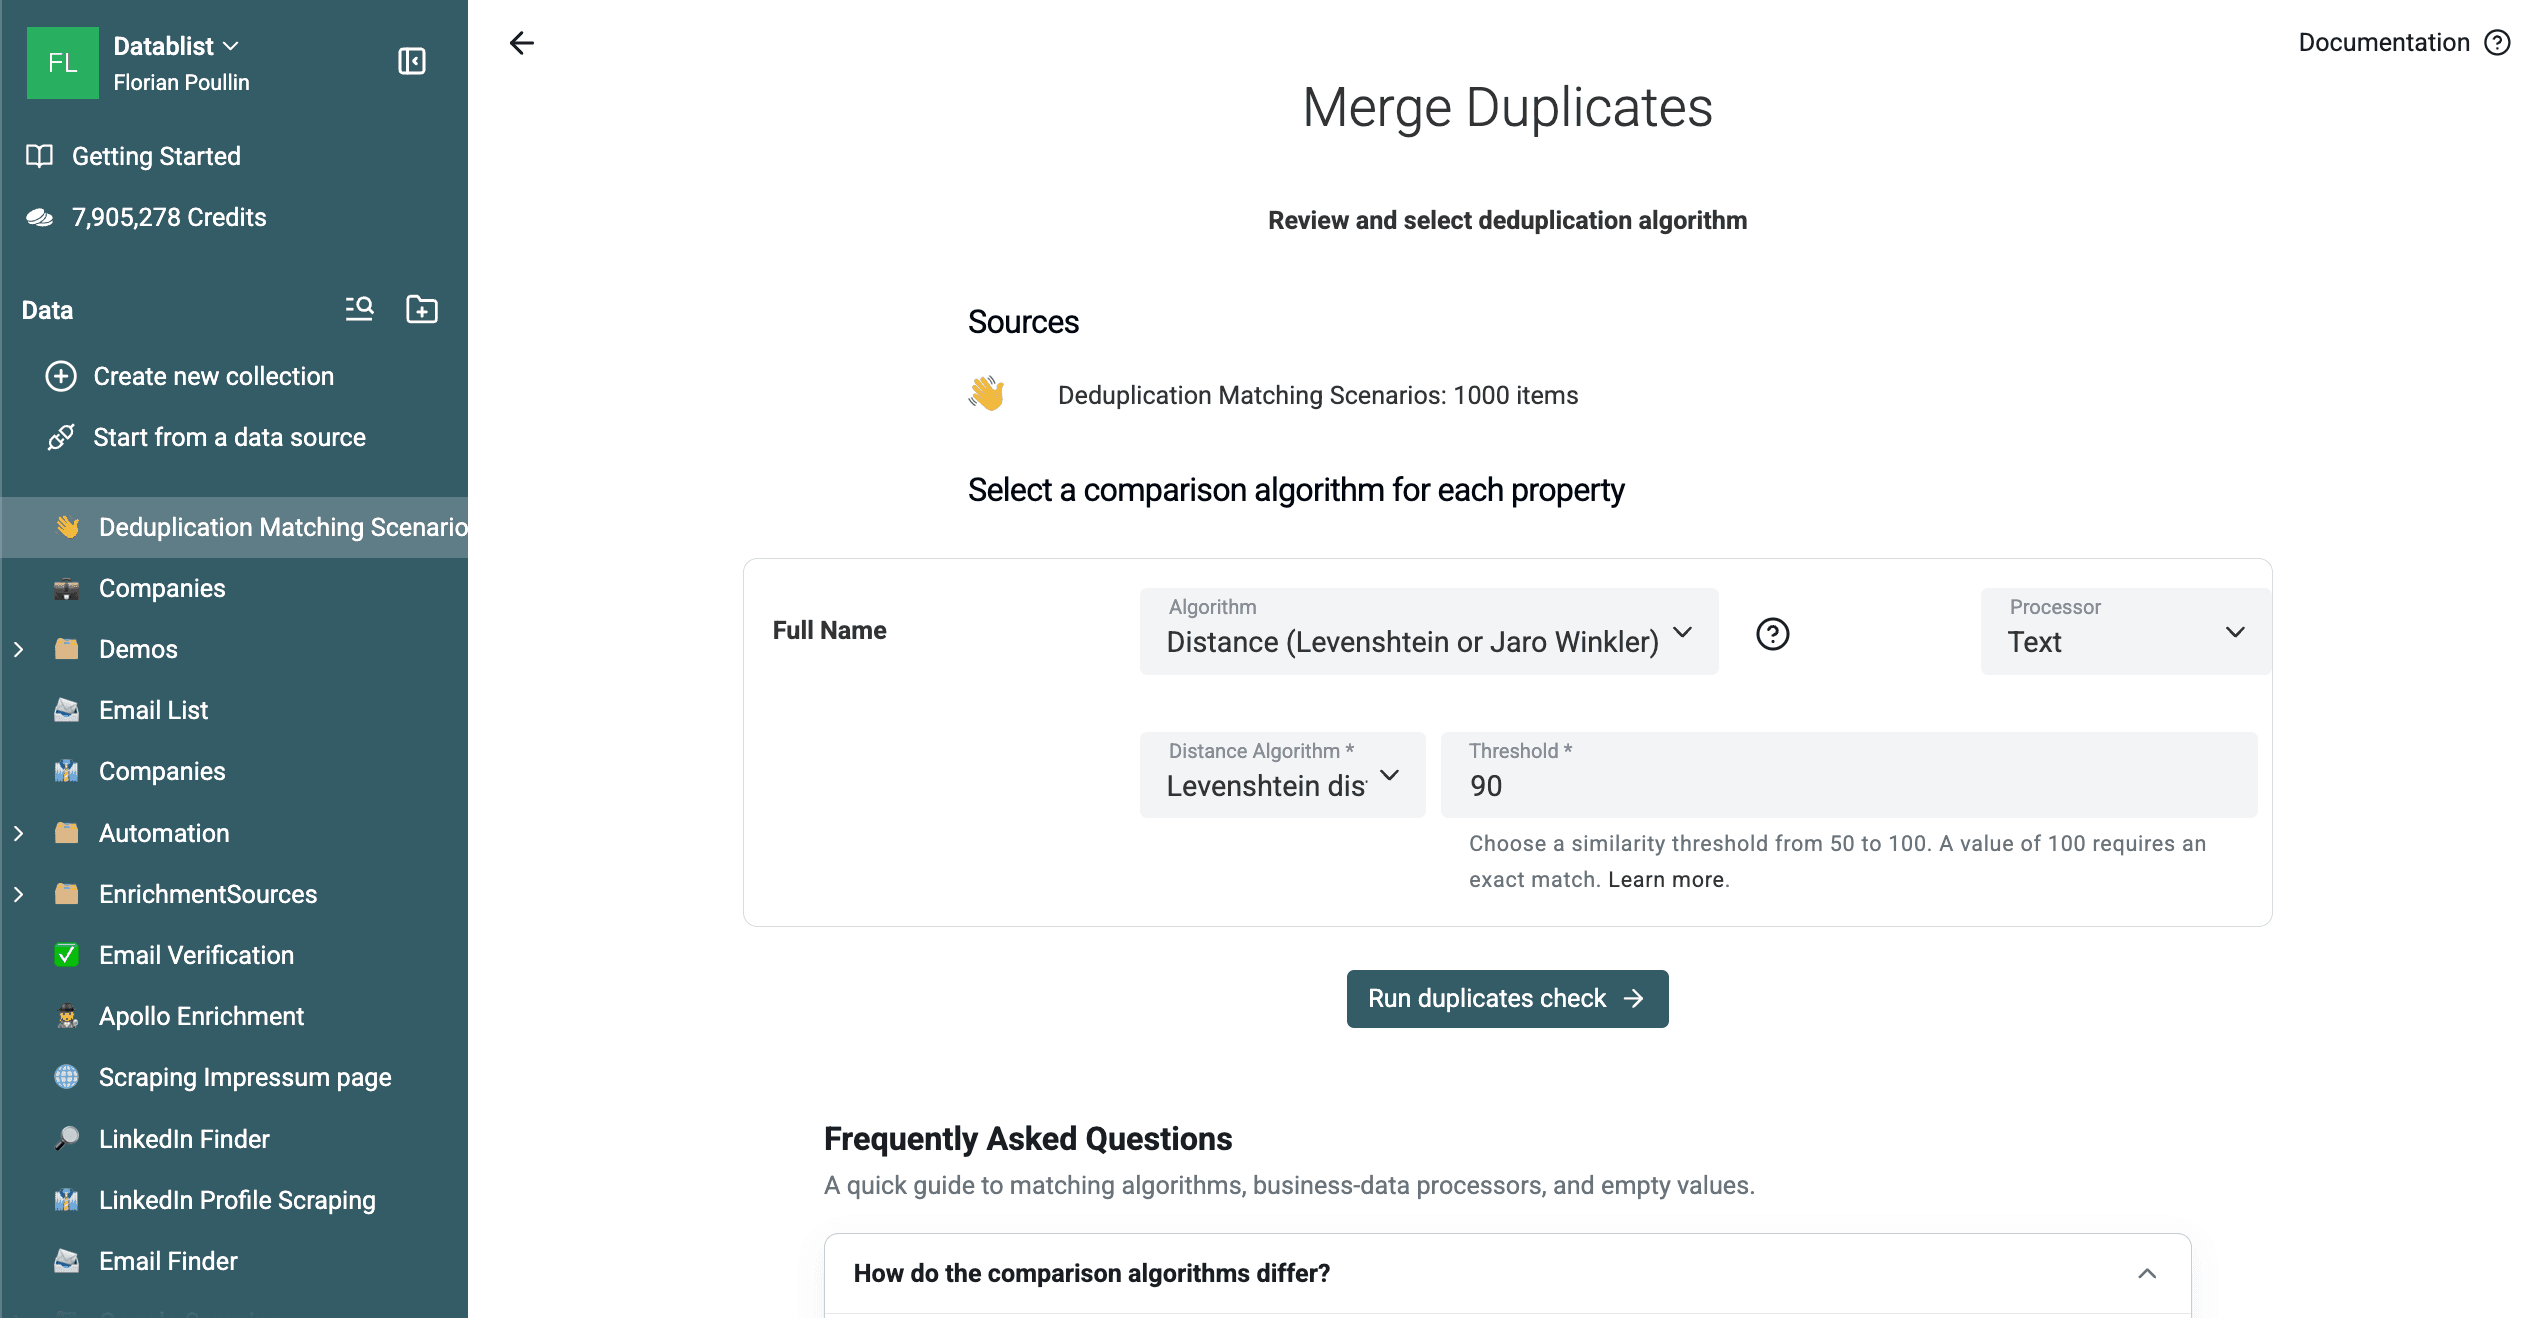
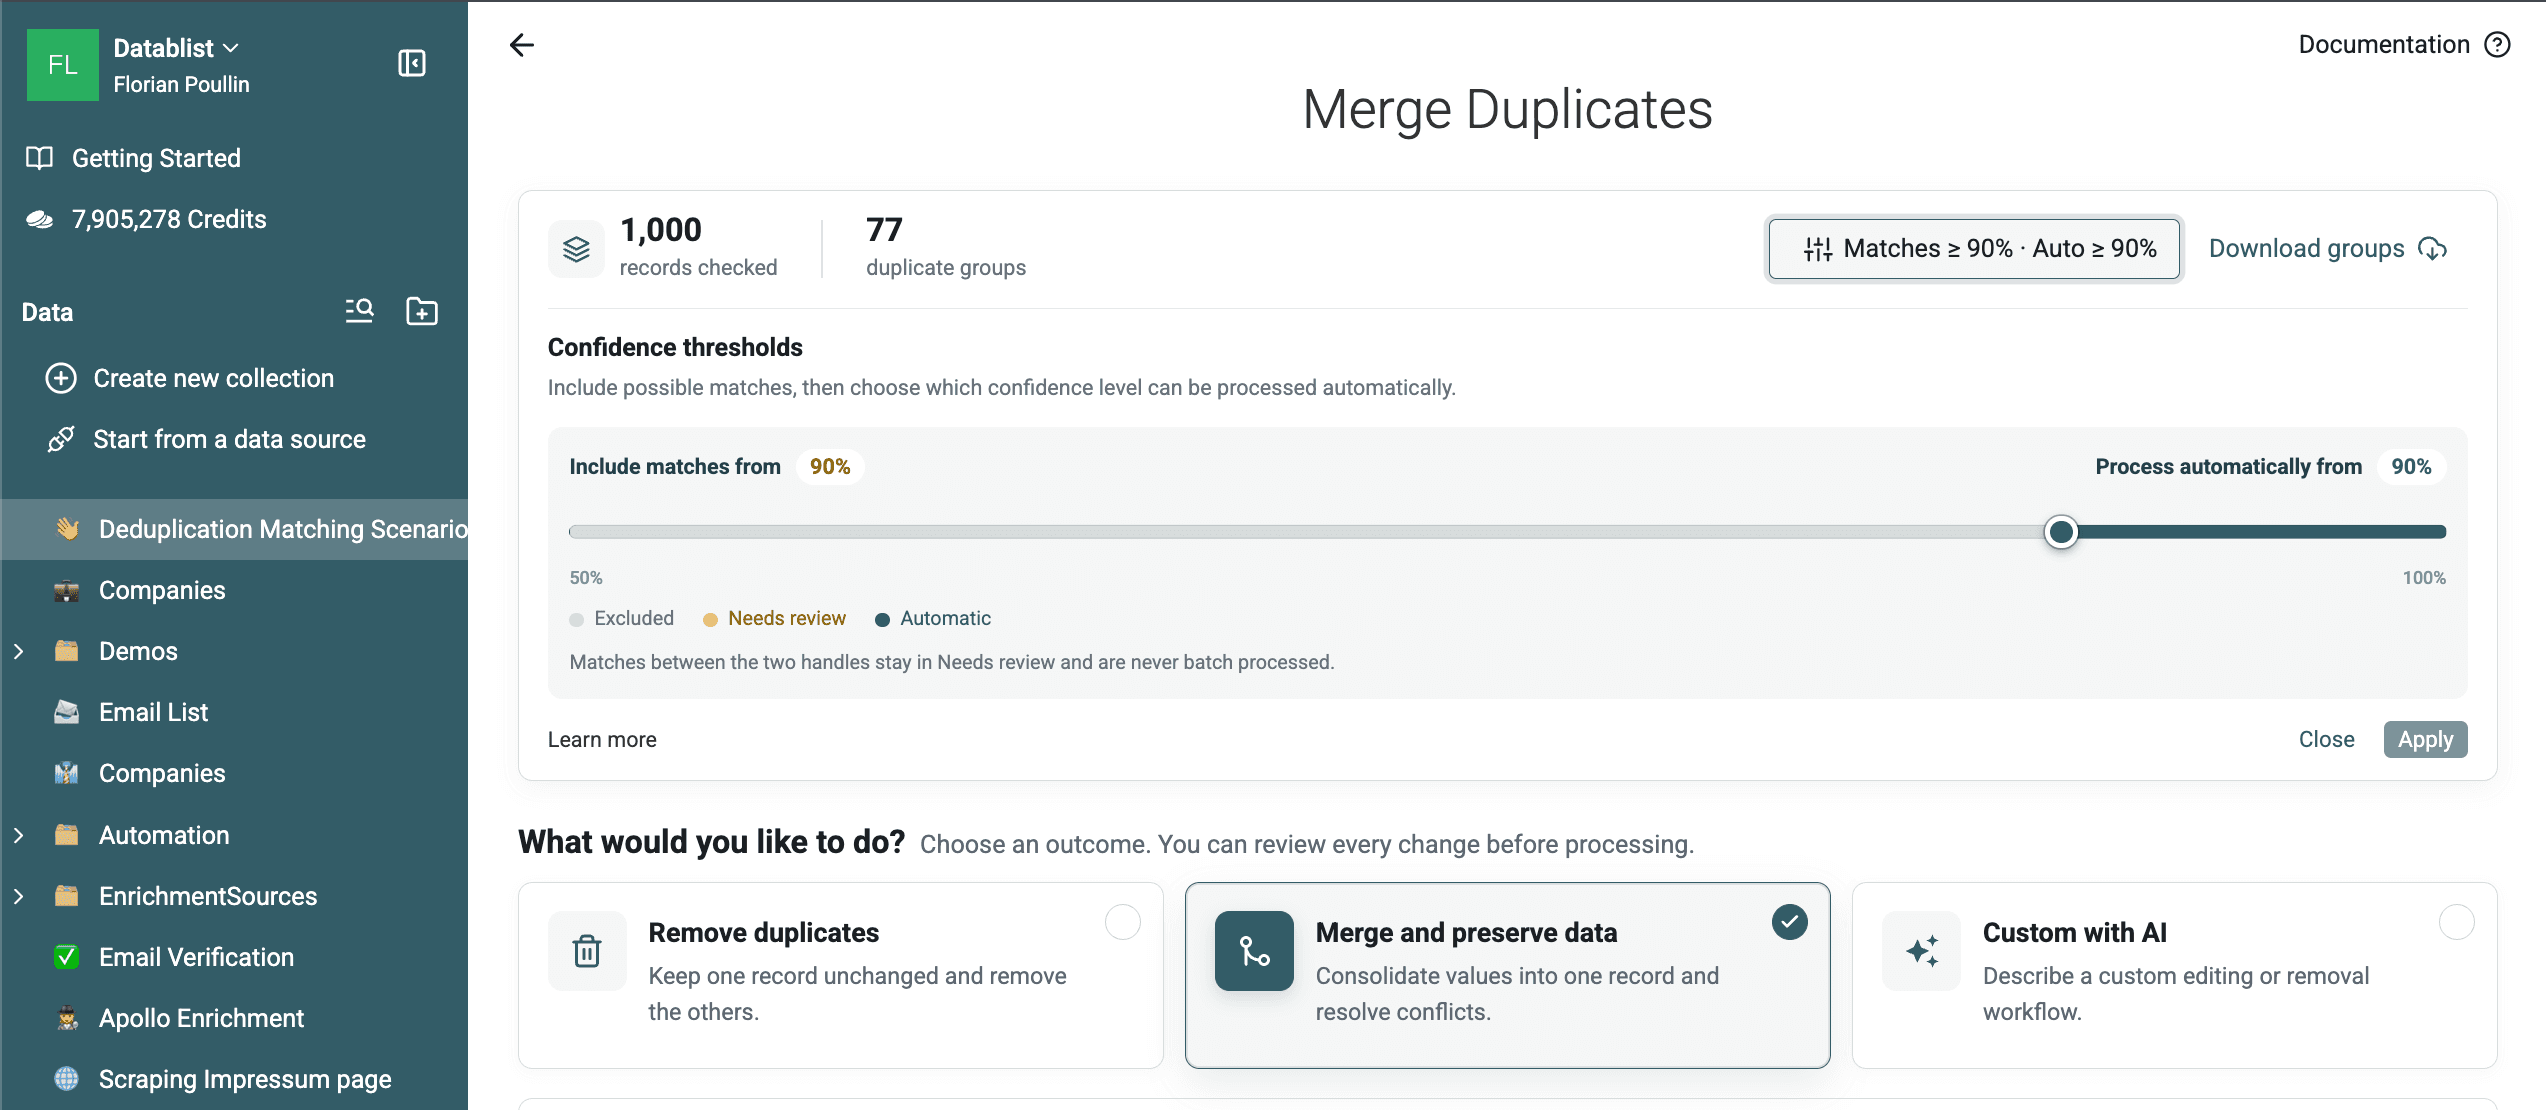
이 검사는 1,000행 샘플에서 두 행짜리 그룹 77개를 반환했습니다. 정답 검증 결과 21개 그룹은 동일한 entity를 연결했고, 56개 그룹은 서로 다른 entity를 연결했습니다. false positive 대부분은 G. Rossi처럼 축약된 이름으로, Full Name만으로는 두 사람을 구분할 수 없었습니다.
이 검사는 Uma A. Turner와 Uman A. Turner 같은 의도된 철자 변형을 찾지만, 이름만 사용한 fuzzy match에 검토가 필요한 이유도 보여 줍니다.
유용한 match와 false positive를 모두 살펴보려면 내보낸 Levenshtein 그룹 77개를 다운로드하세요.
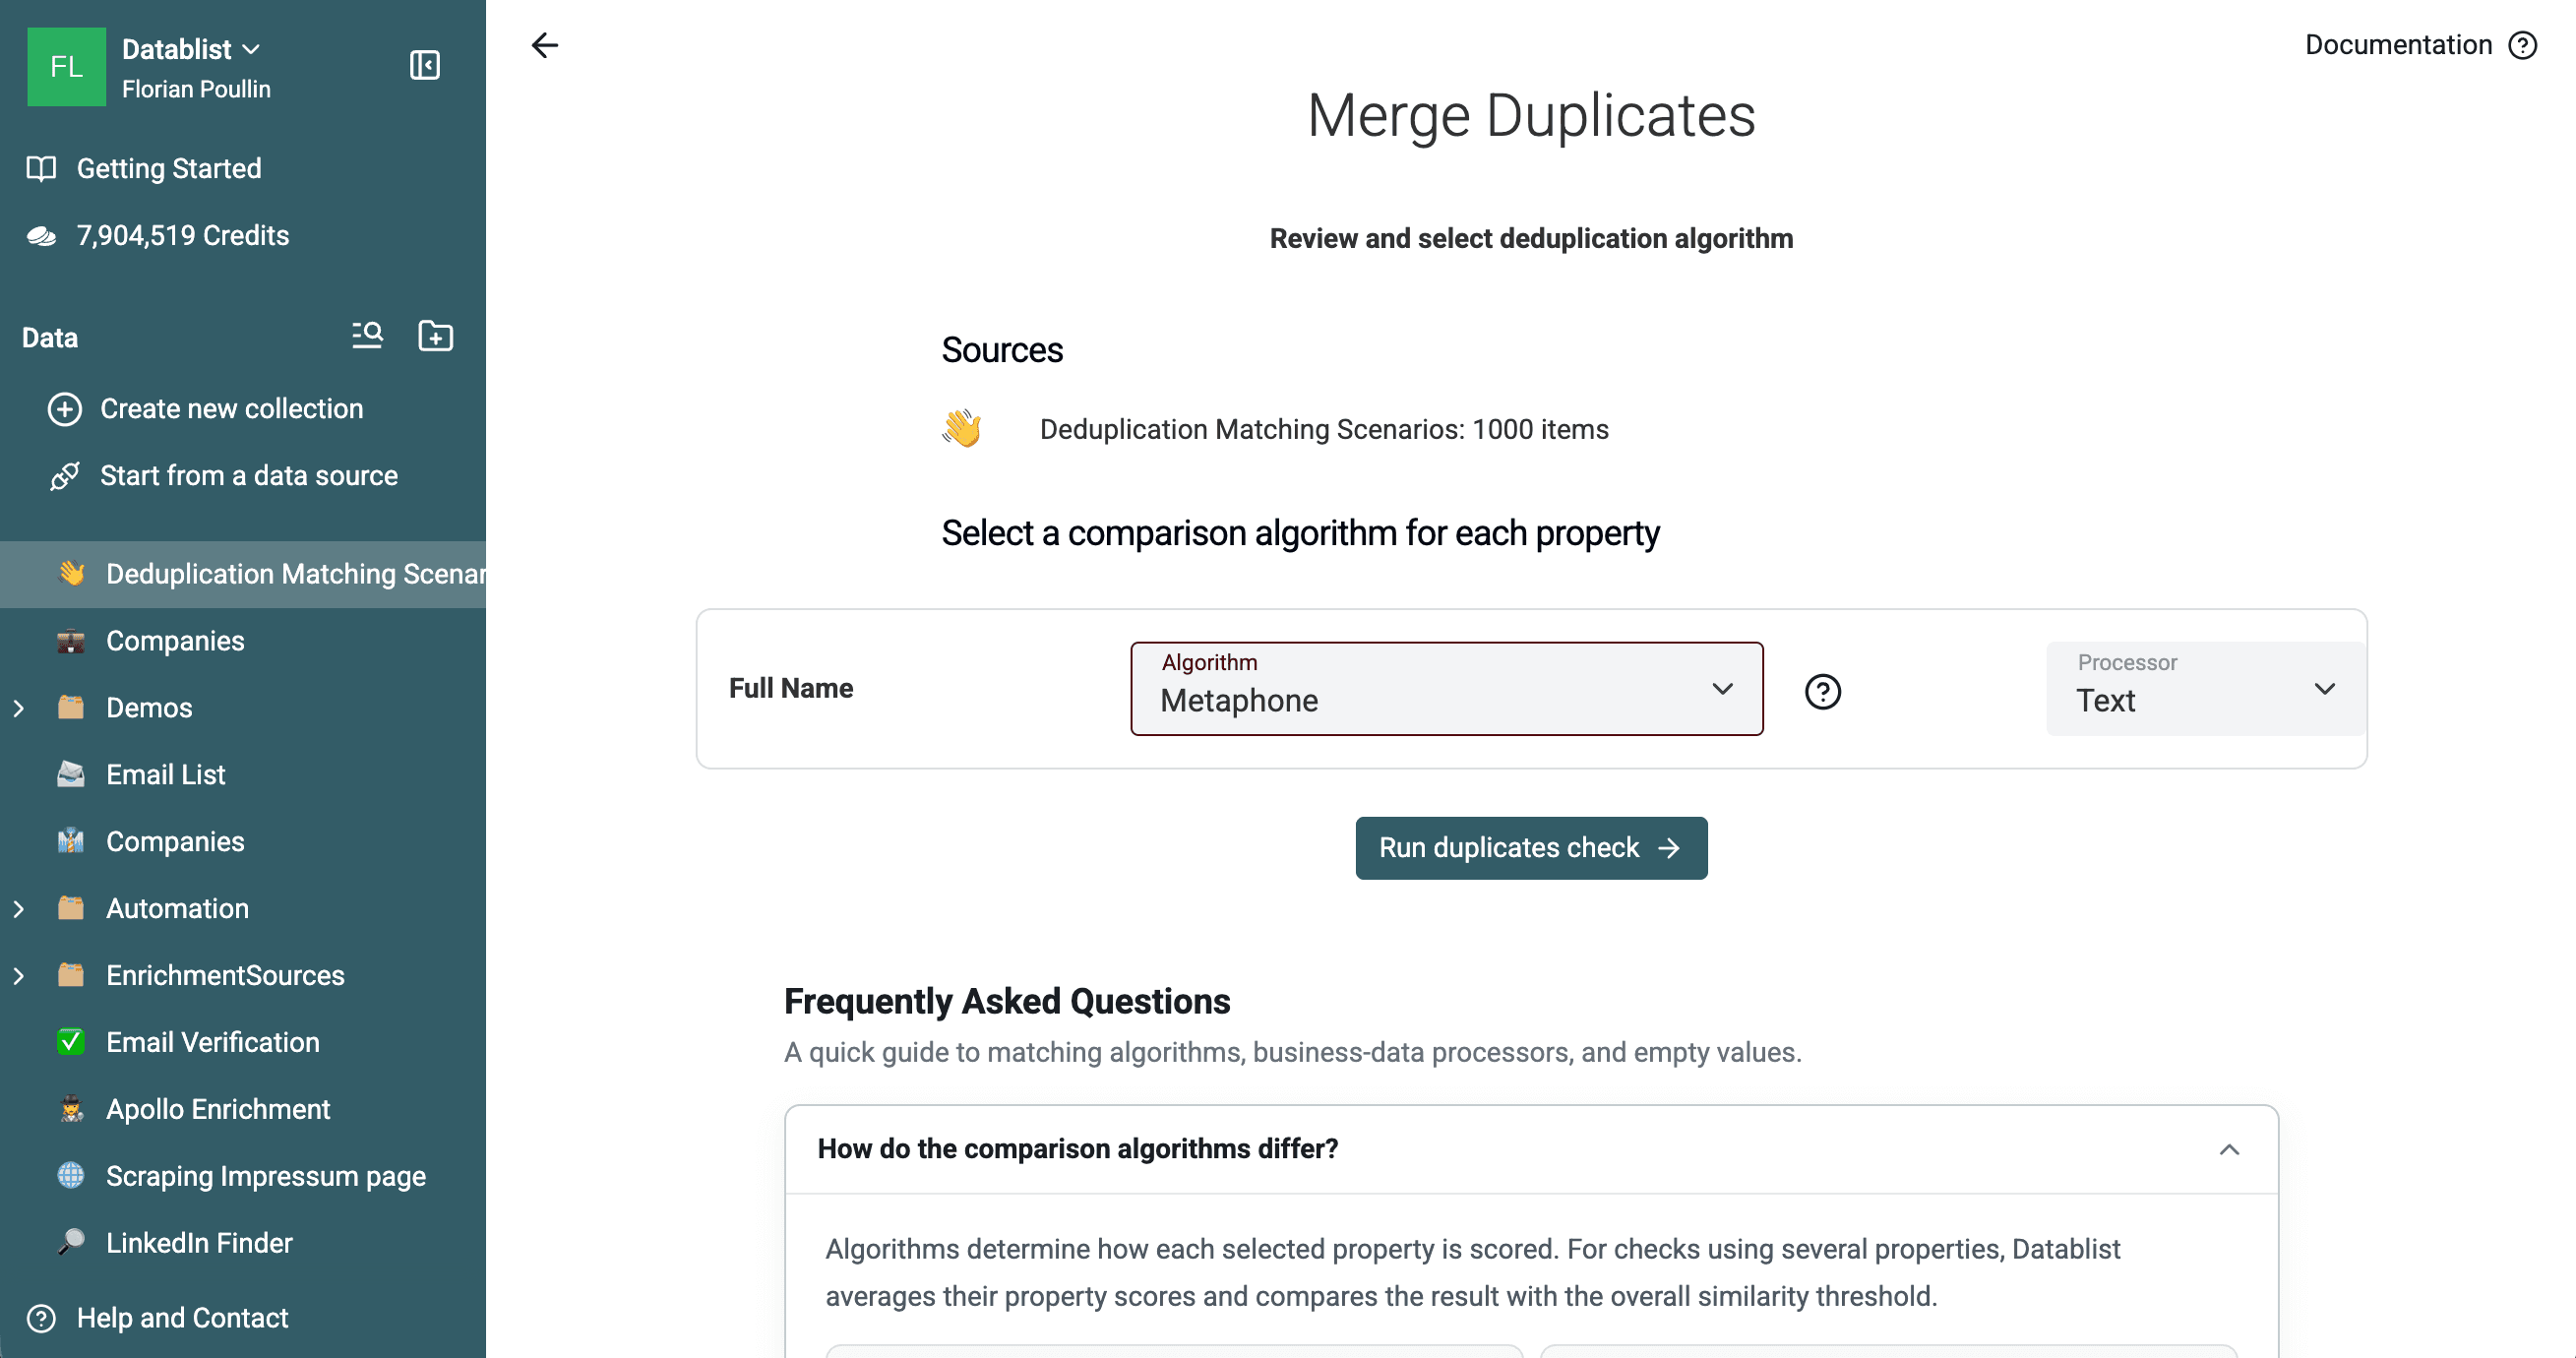
phonetic matching에는 Full Name, Metaphone 및 Text processor를 선택하세요.
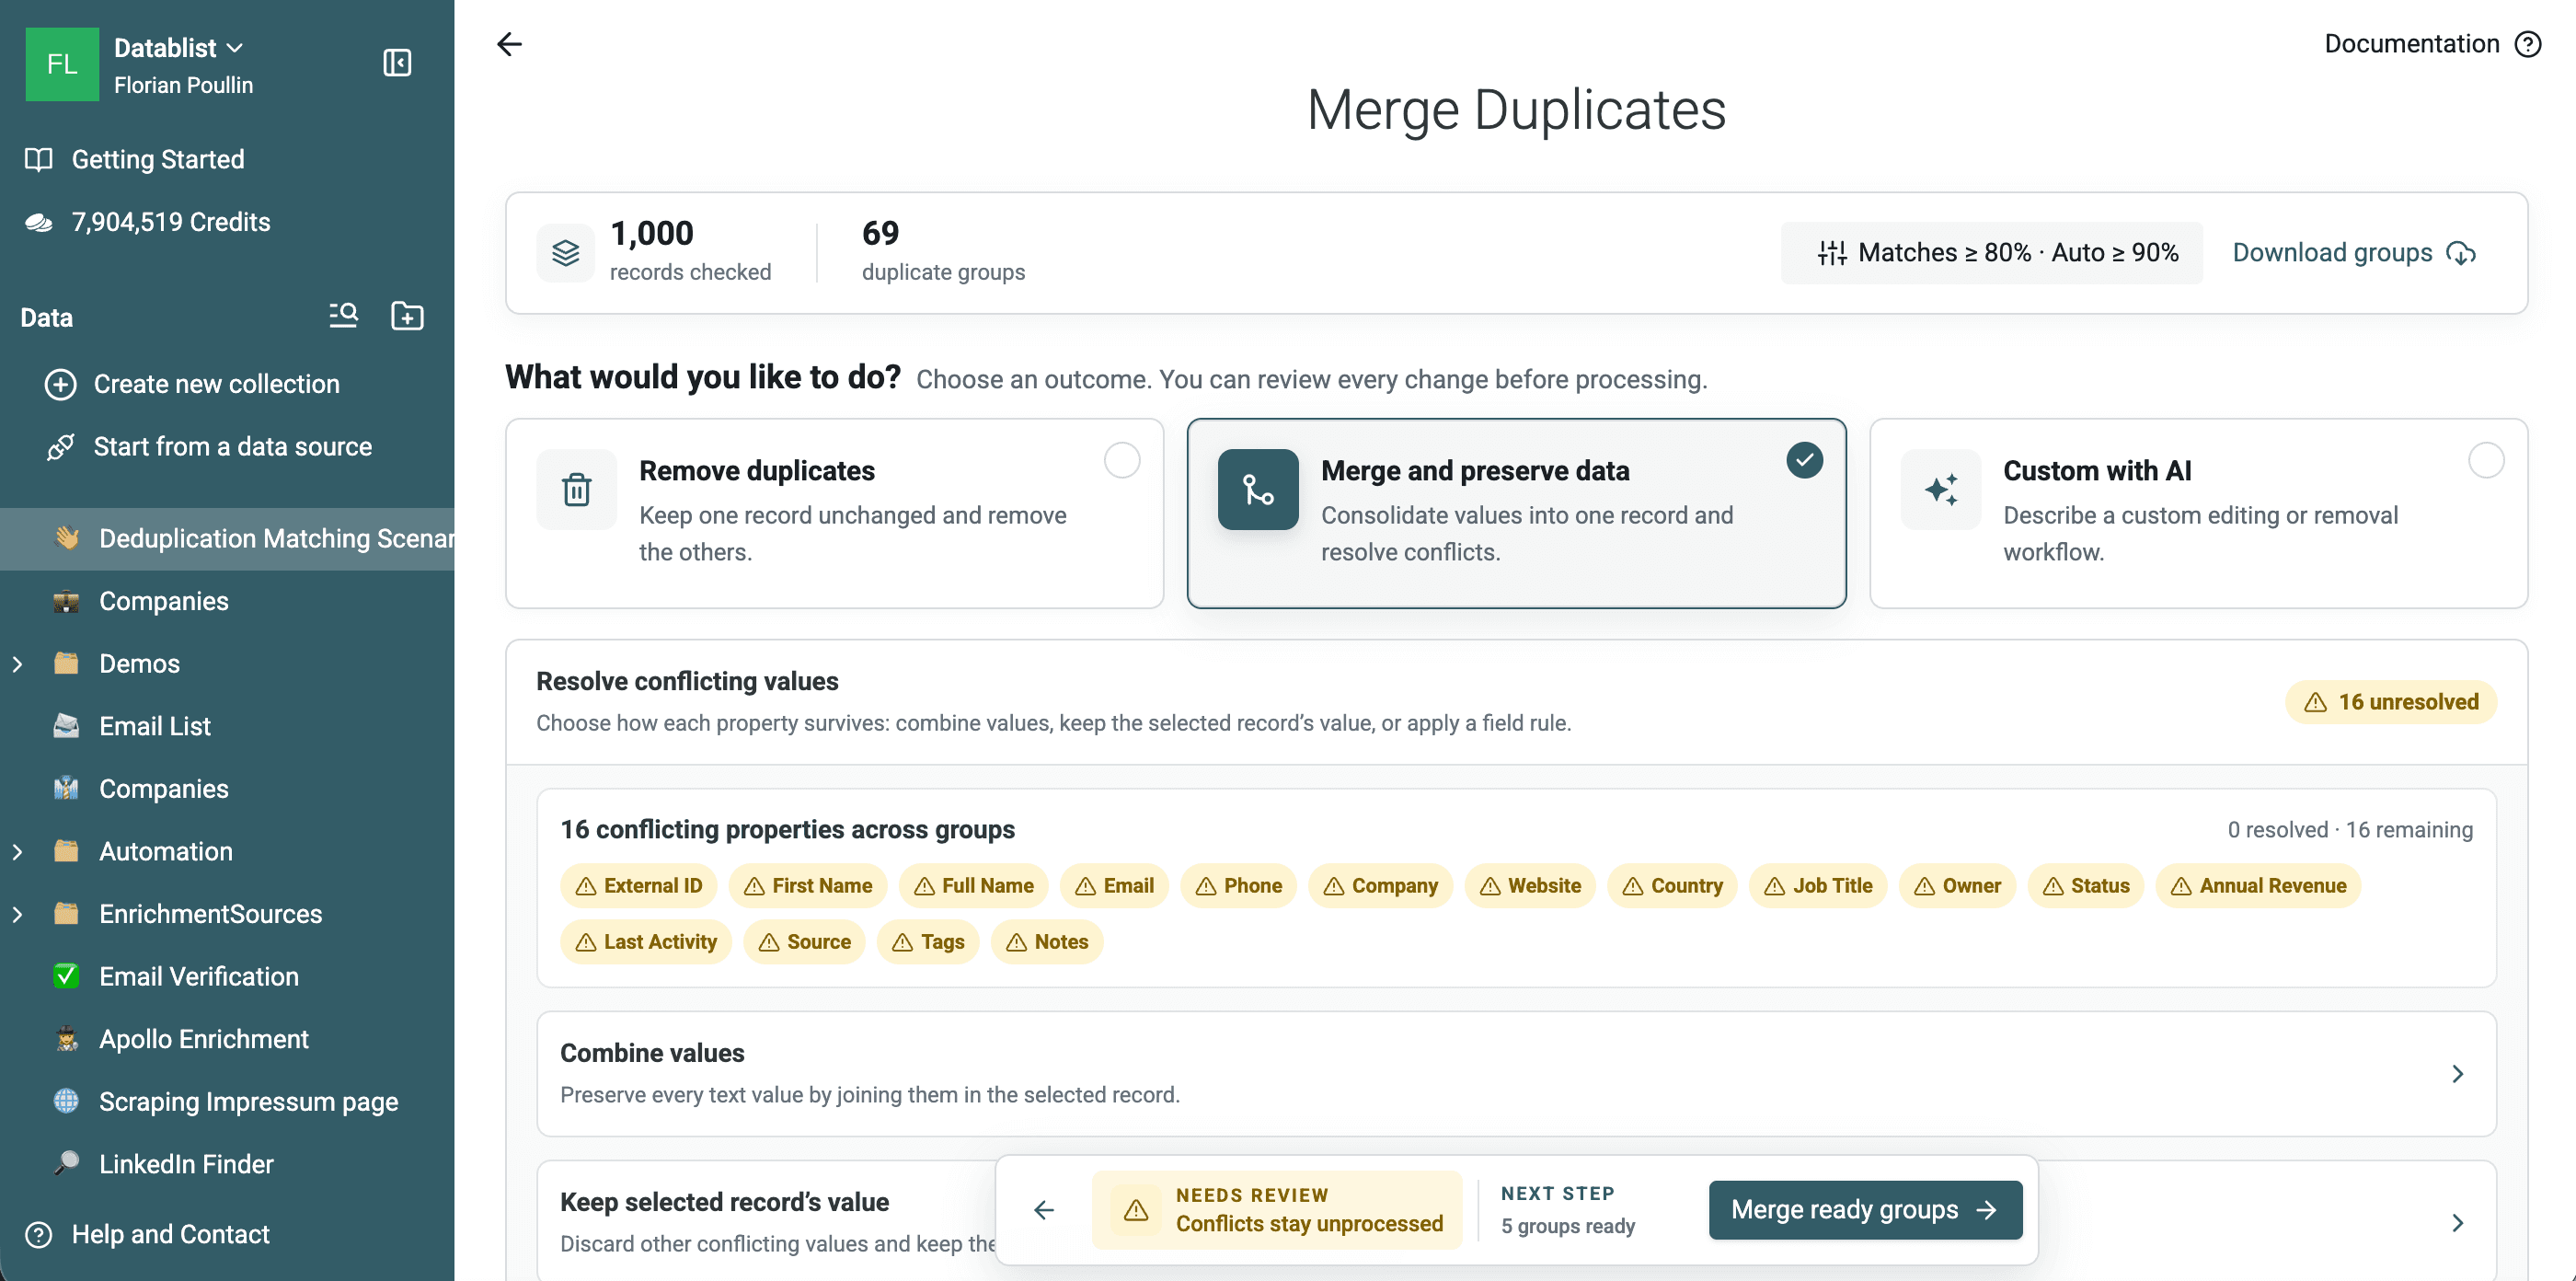
이 검사는 69개 그룹을 표시했습니다. 5개는 Ready, 64개는 Needs review였습니다. 내보낸 그룹에는 188개 행이 포함되어 있습니다. 샘플의 알려진 entity와 대조한 결과, 19개는 동일한 entity만 있는 그룹이었고 50개는 서로 다른 사람이 섞인 그룹이었습니다. 그룹 크기는 2~7개 행입니다.
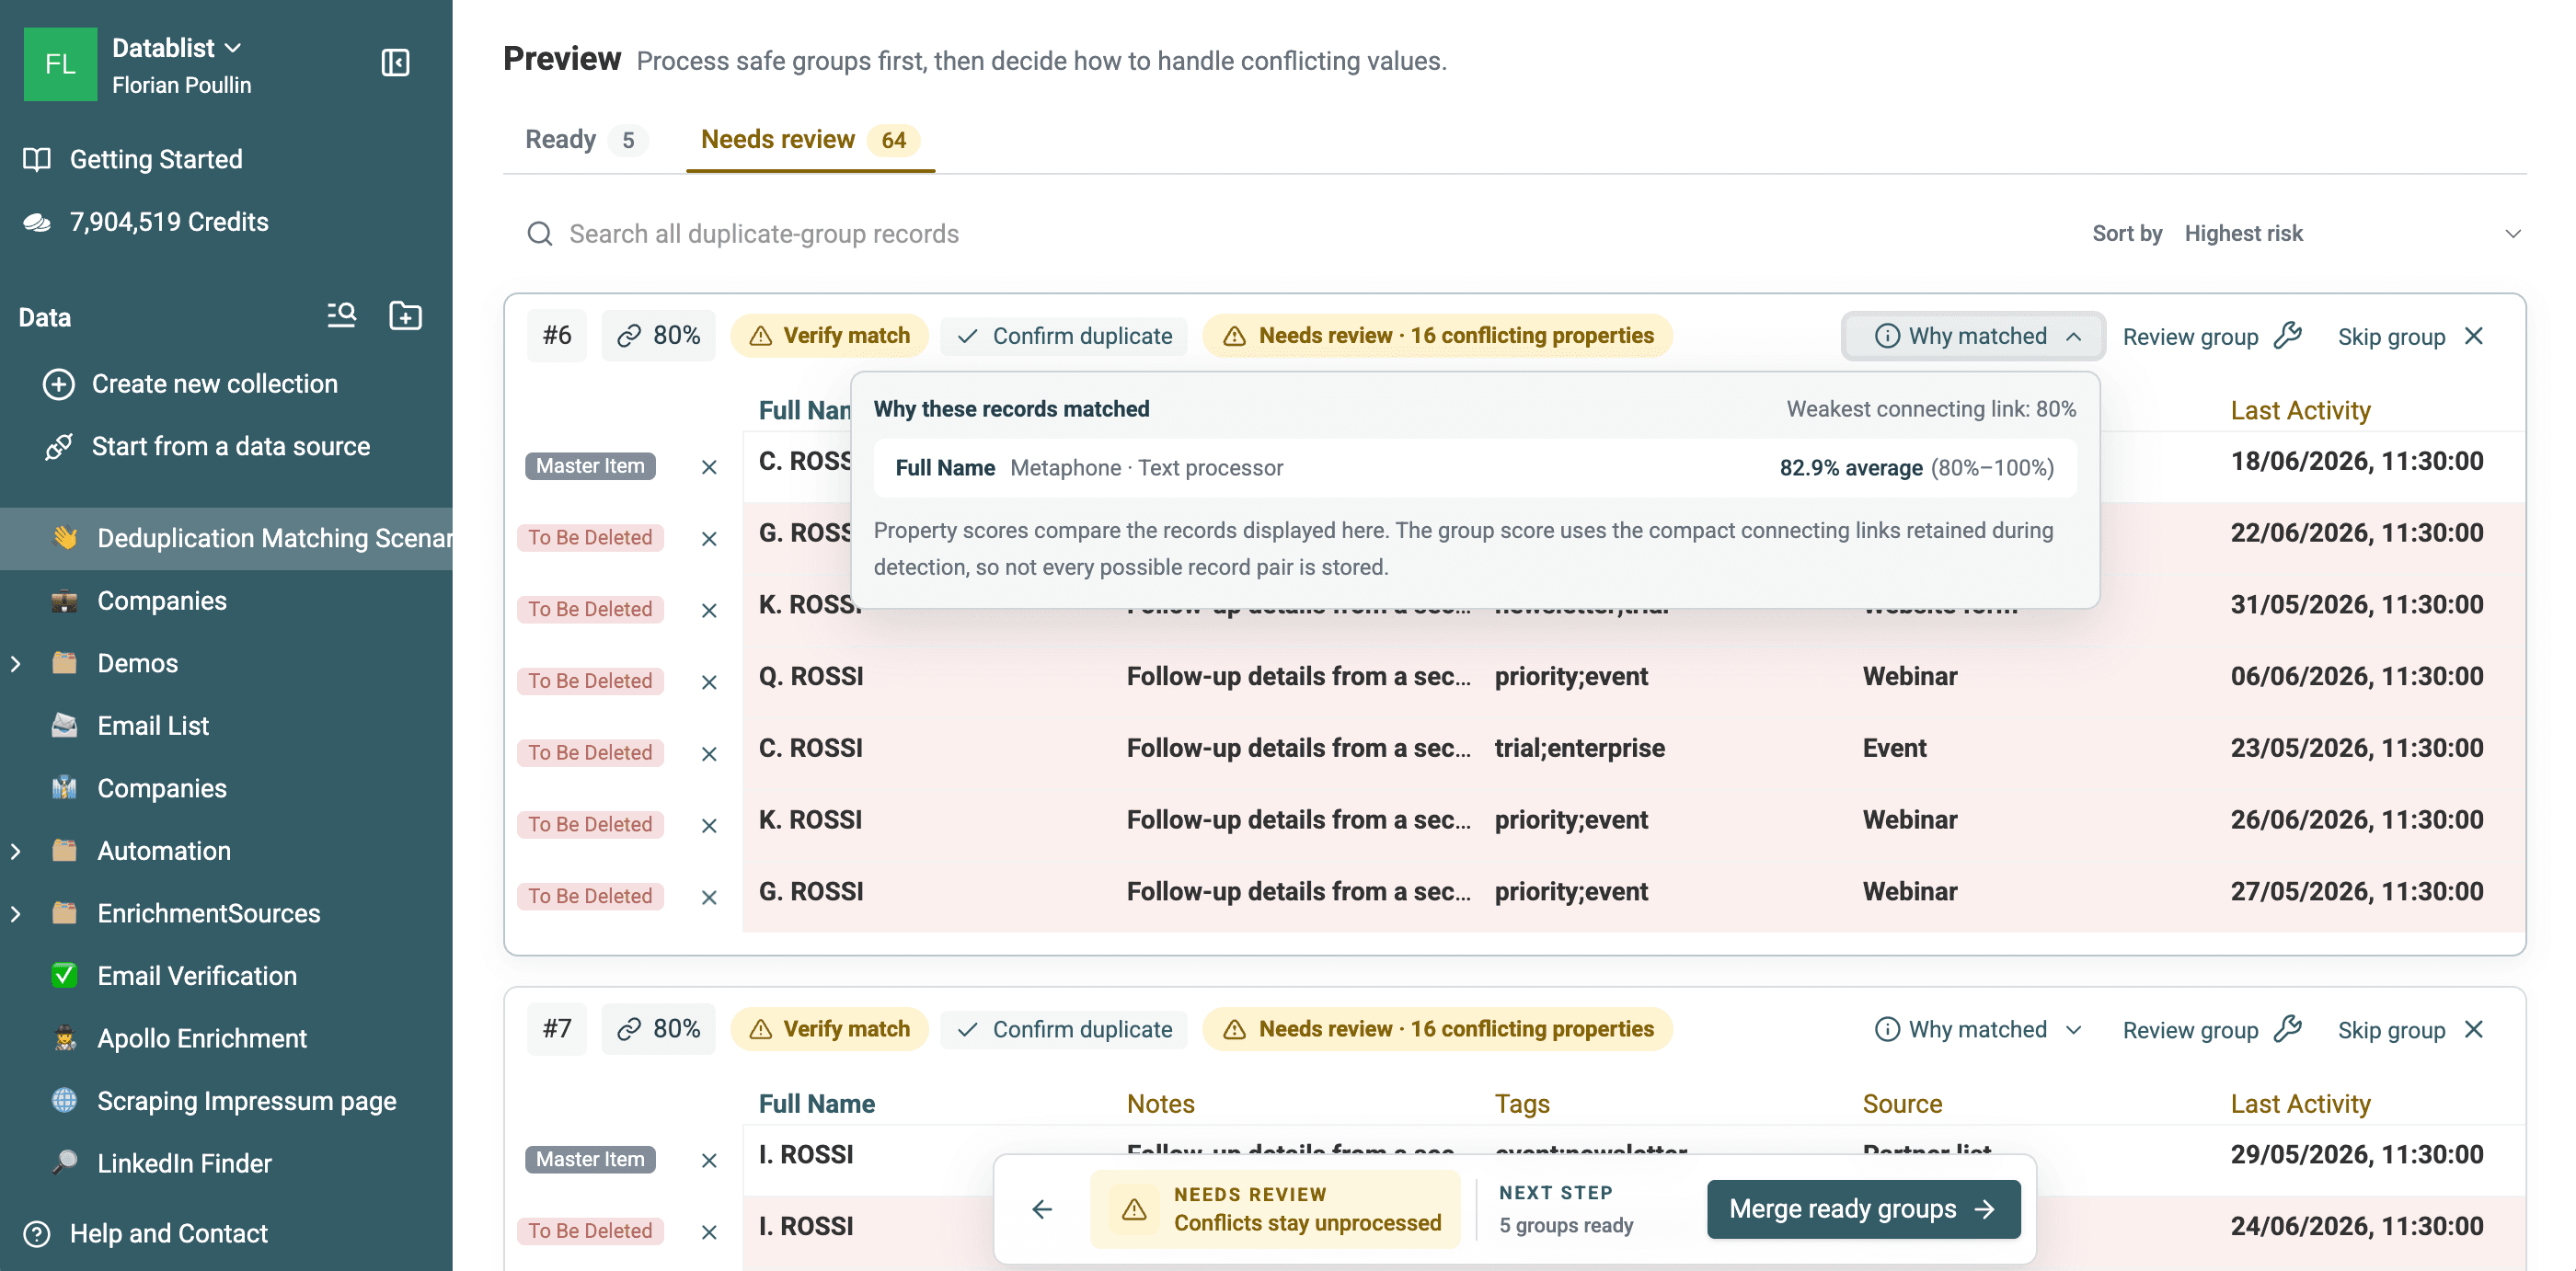
Why matched에서는 Full Name property, Metaphone 알고리즘, Text processor 및 그룹 점수를 확인할 수 있습니다. 이 정보는 비교를 감사하는 데 사용해야 하며 신원 확인을 대신할 수는 없습니다.
유용한 phonetic match와 false positive를 검토하려면 내보낸 Metaphone 그룹 69개를 다운로드하세요. 큰 false-positive 그룹에는 여러 개의 축약된 Rossi 이름처럼 이니셜과 흔한 성의 조합이 자주 포함됩니다. phonetic code는 겹치지만 이름만으로 자동 merge할 만큼 충분한 신원 근거는 제공하지 않습니다.
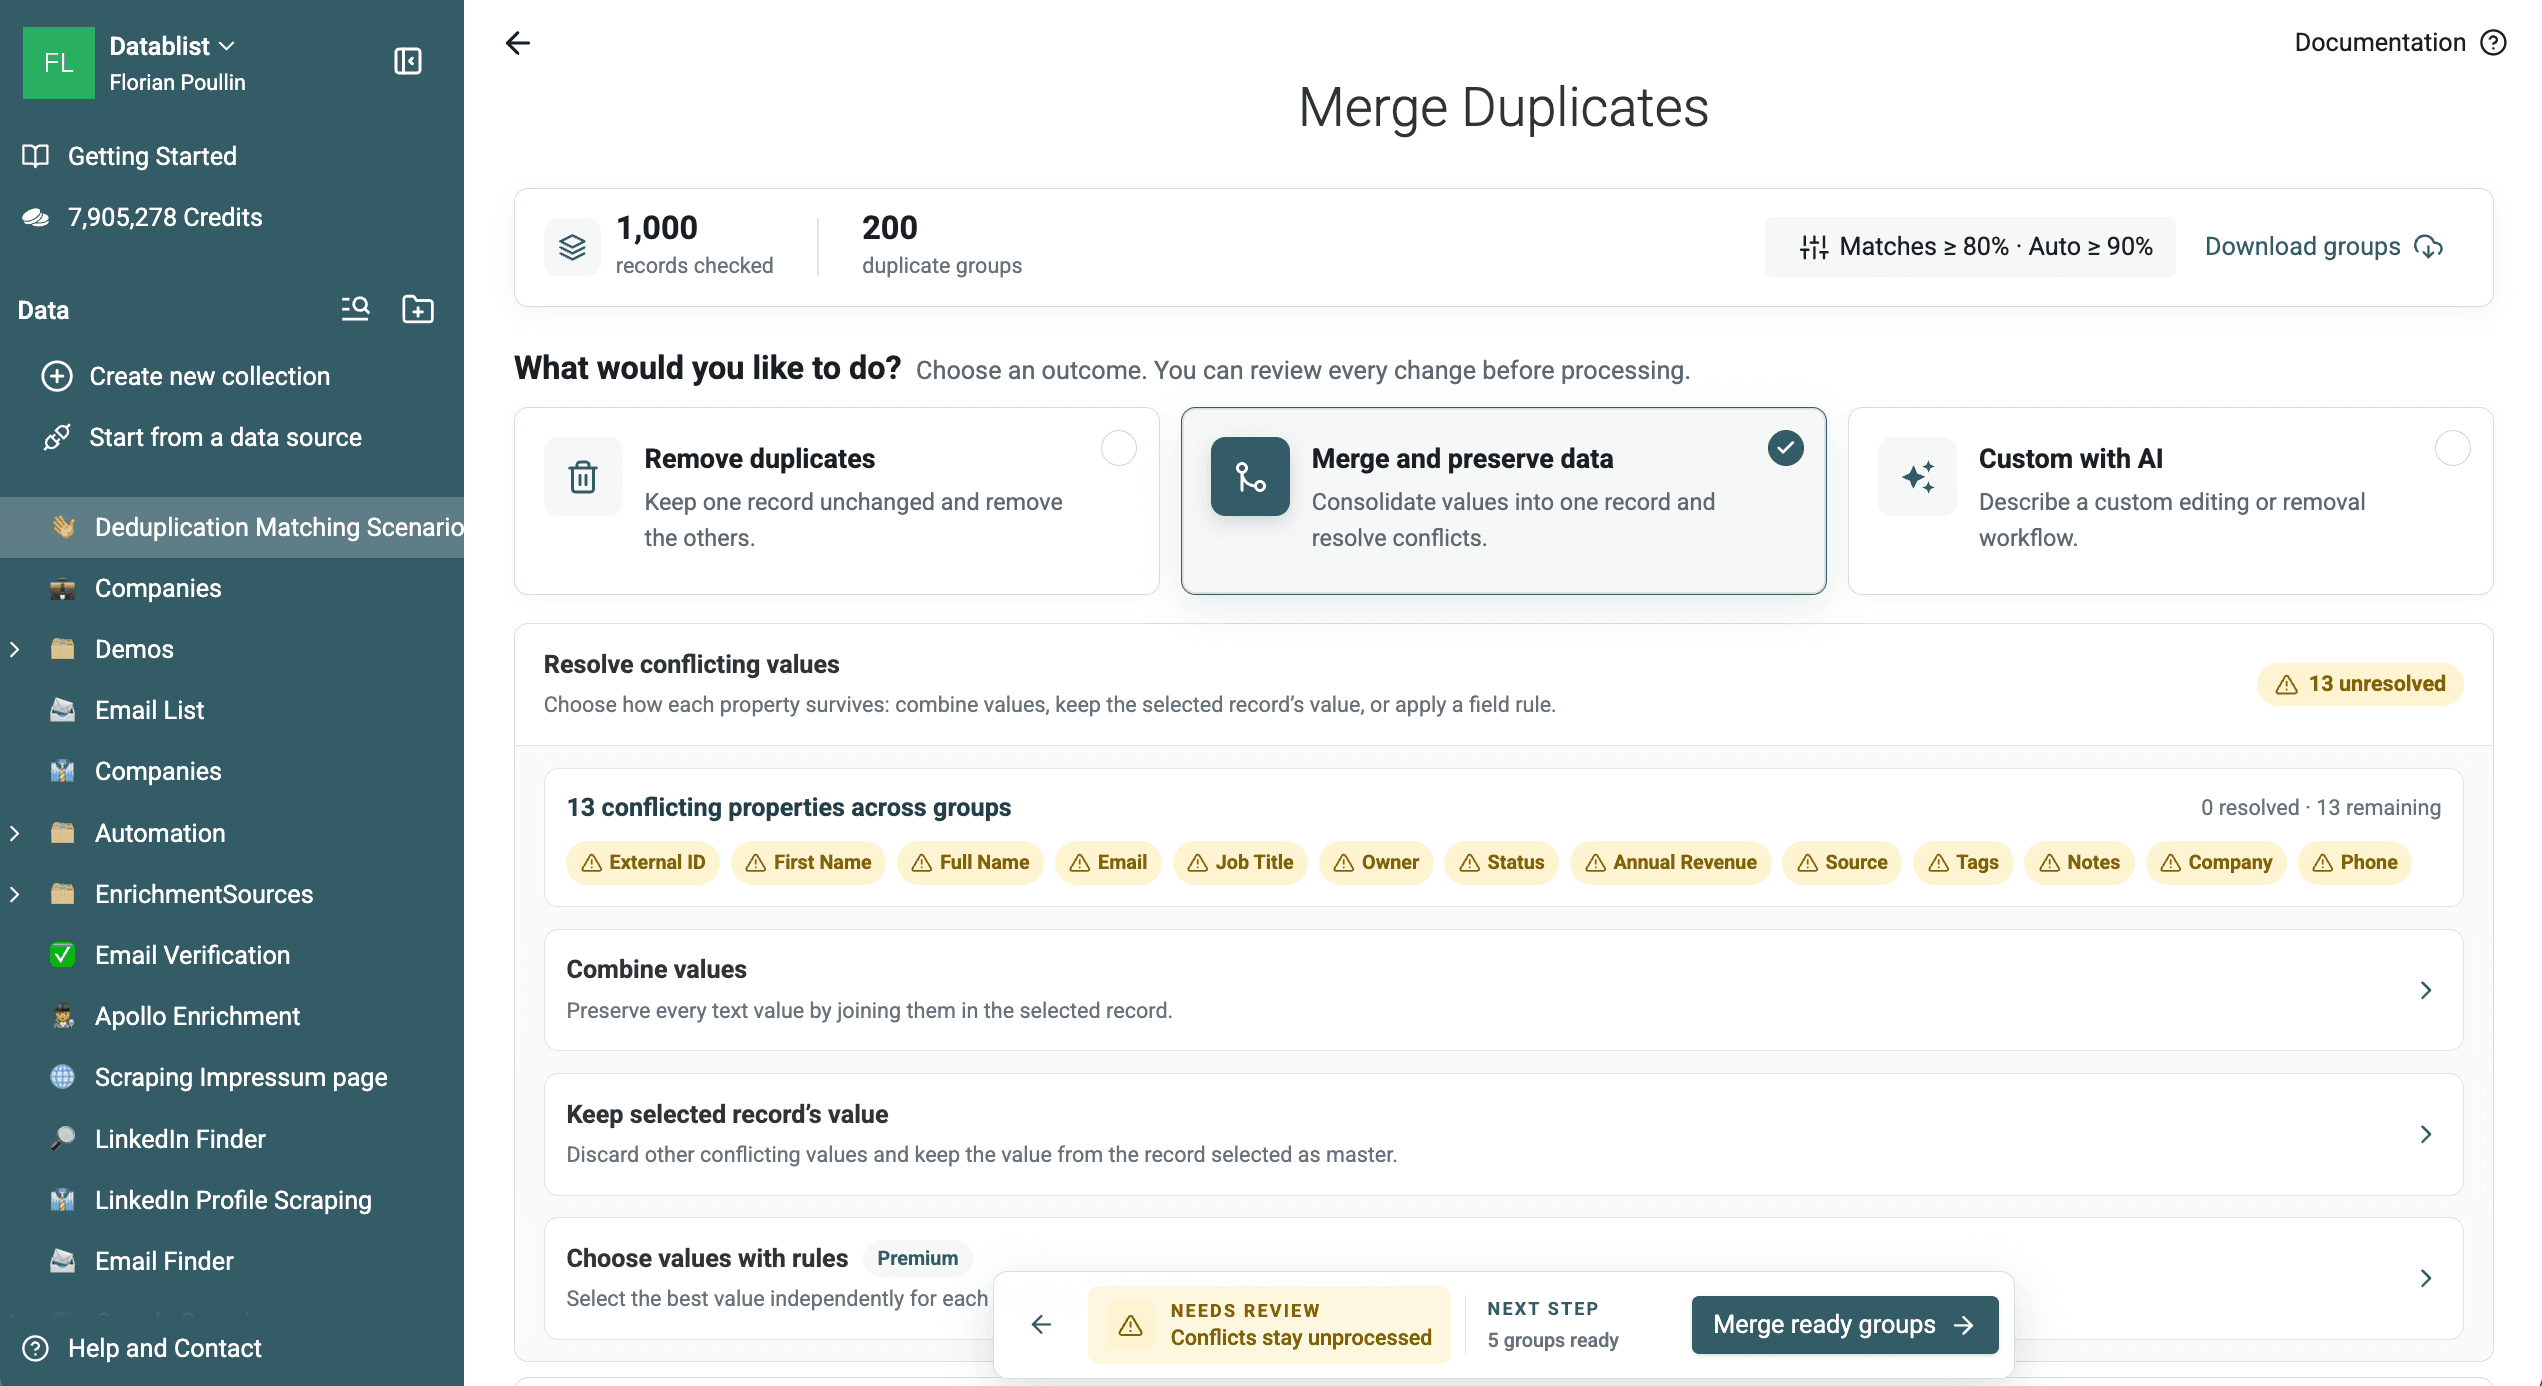
결과 페이지에는 두 가지 control이 있습니다.
- Include matches from은 표시할 그룹을 결정합니다.
- Process automatically from은 신뢰도가 낮은 그룹을 Needs review에 남기고 batch processing에서 제외합니다.
두 설정을 분리하면 폭넓은 후보를 검토하면서 모든 그룹에 같은 자동화 규칙을 적용하지 않을 수 있습니다.
중복 그룹 검토
결과 workspace에서는 중복 그룹을 Ready와 Needs review로 구분합니다.
- Ready 그룹에는 구체적인 처리 결과가 있으며 자동 처리 confidence threshold를 충족합니다.
- Needs-review 그룹은 신뢰도가 낮거나 merge 충돌이 해결되지 않았거나, 레코드 선택 규칙에 맞는 항목이 없거나, custom 규칙에 의해 건너뛴 그룹입니다.
불확실한 그룹마다 다음을 확인하세요.
- 모든 행이 동일한 사람, 회사 또는 제품을 나타내나요?
- 어떤 식별자가 match를 만들었나요?
- 서로 보완하는 값이 있나요?
- 신뢰할 수 있는 소스는 무엇인가요?
- 행을 삭제하면 전화번호, ID, 상태, 날짜 또는 메모가 사라지나요?
- 신뢰도가 낮은 세 번째 레코드를 통해 그룹이 연결된 것은 아닌가요?
Why matched에서 matching property, 알고리즘, processor 및 점수 범위를 확인하세요. fuzzy 검사에서 그룹 유사도는 그룹을 연결하는 데 필요한 유지된 연결 중 가장 낮은 점수입니다.
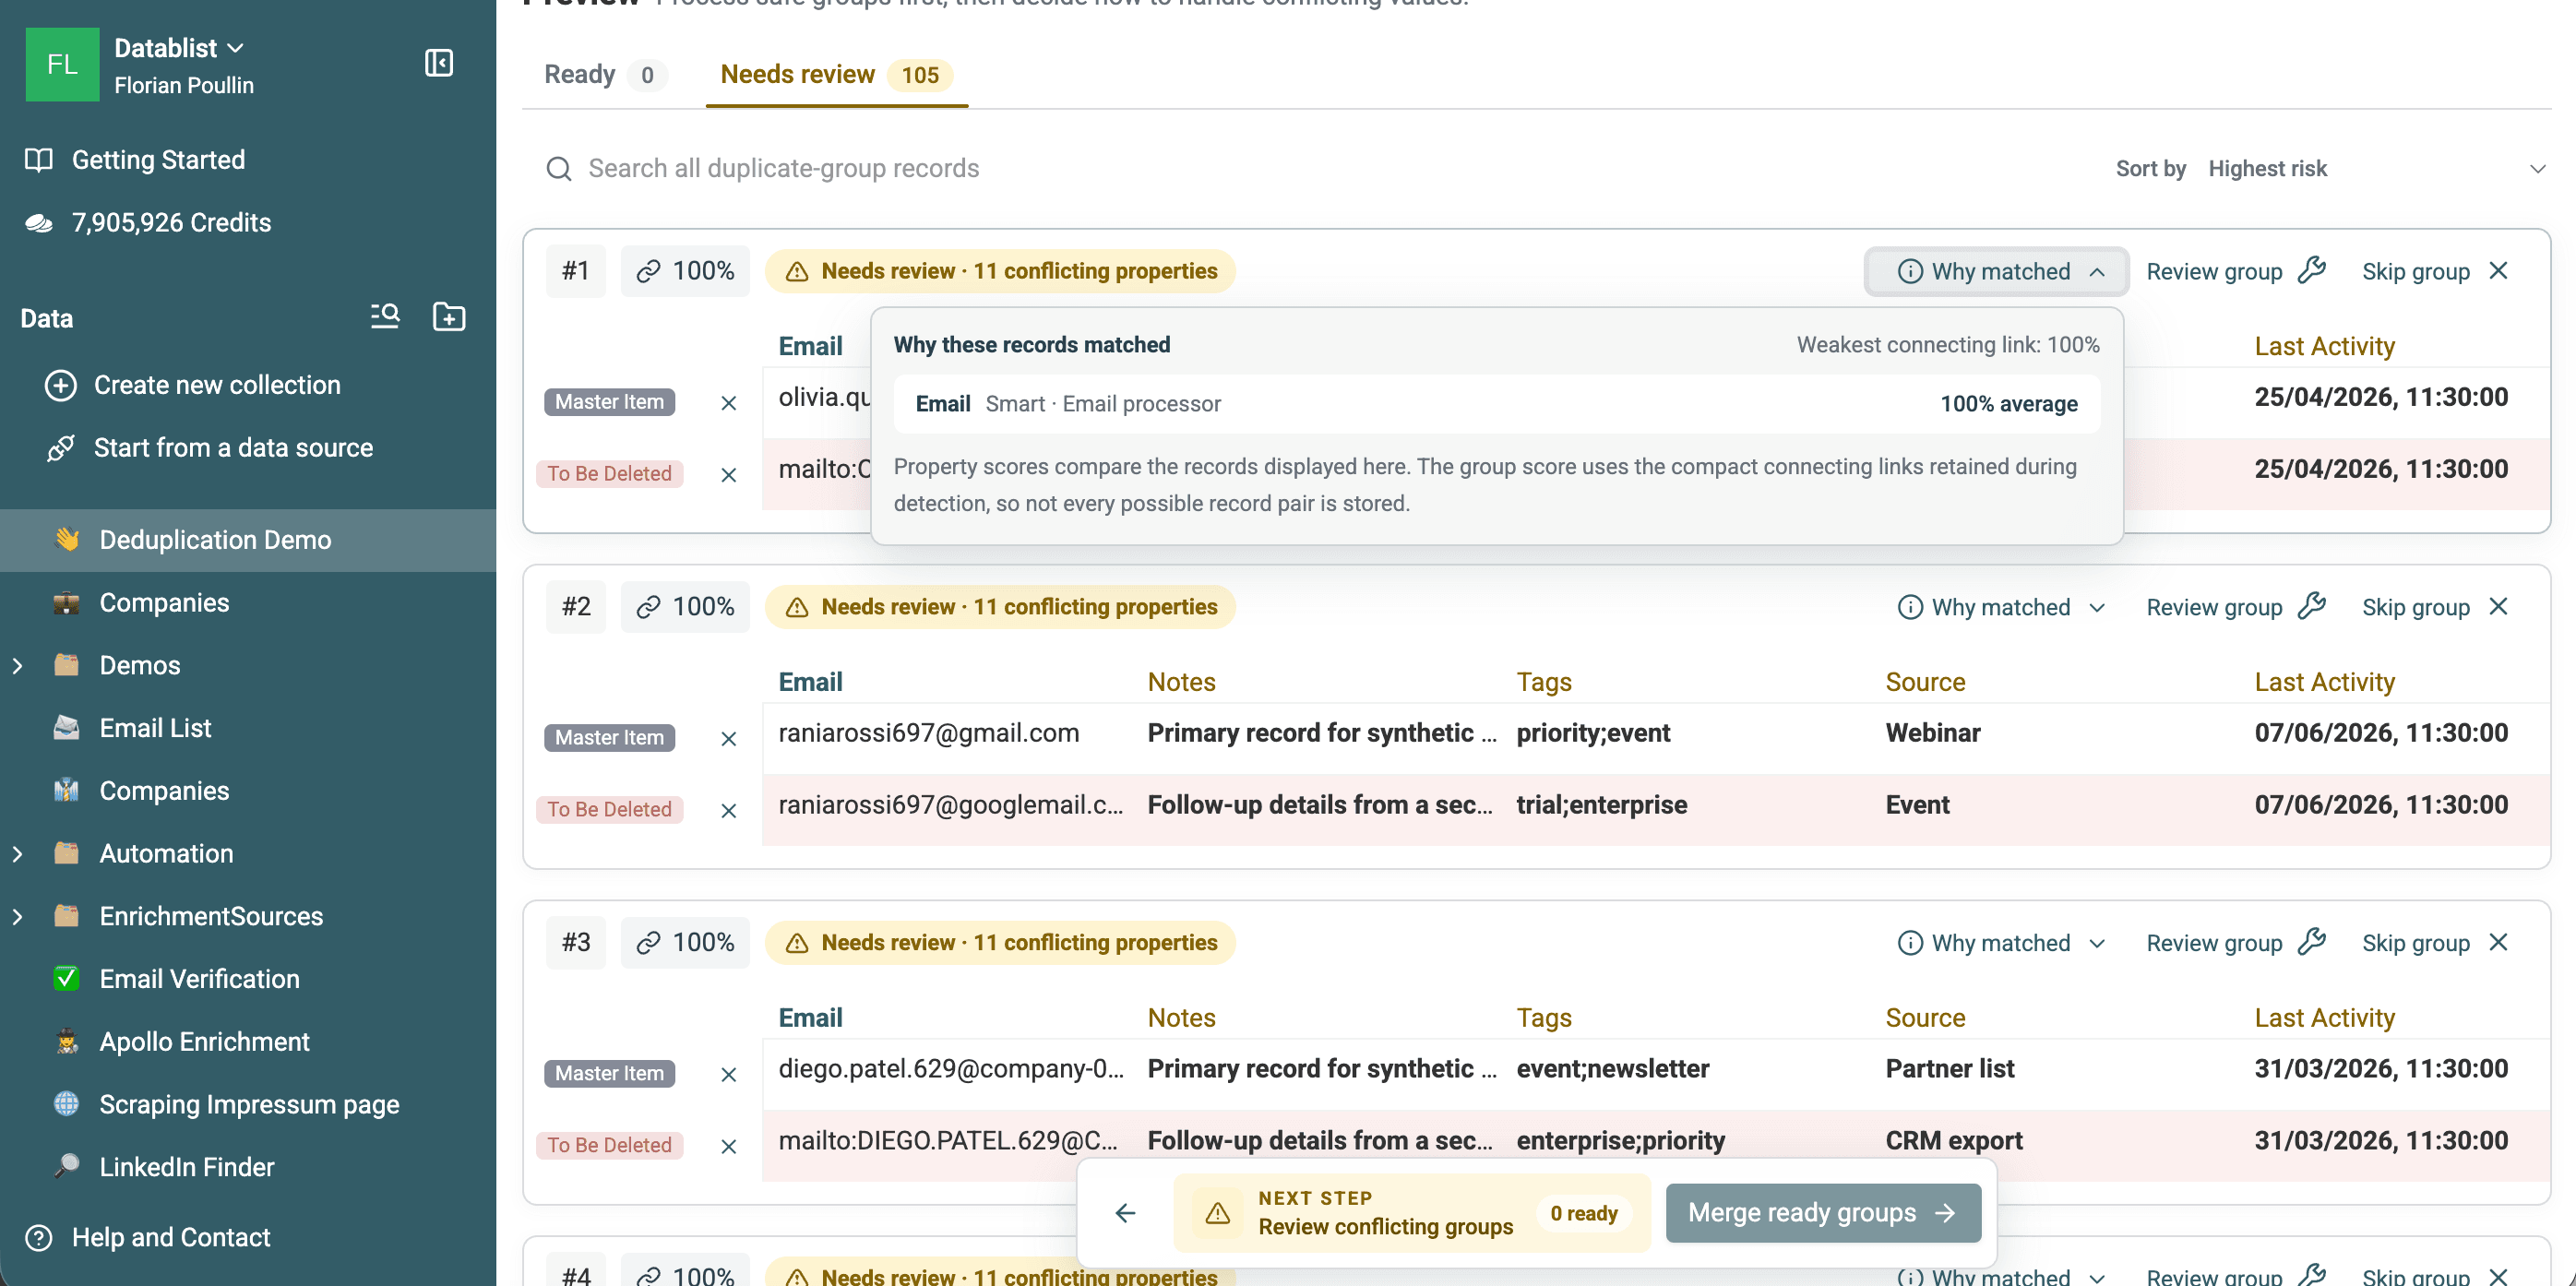
다음 작업도 할 수 있습니다.
- 신뢰도가 낮은 match를 확인합니다.
- 레코드를 삭제하지 않고 그룹에서 제외합니다.
- 그룹을 건너뜁니다.
- 레코드를 열어 수정합니다.
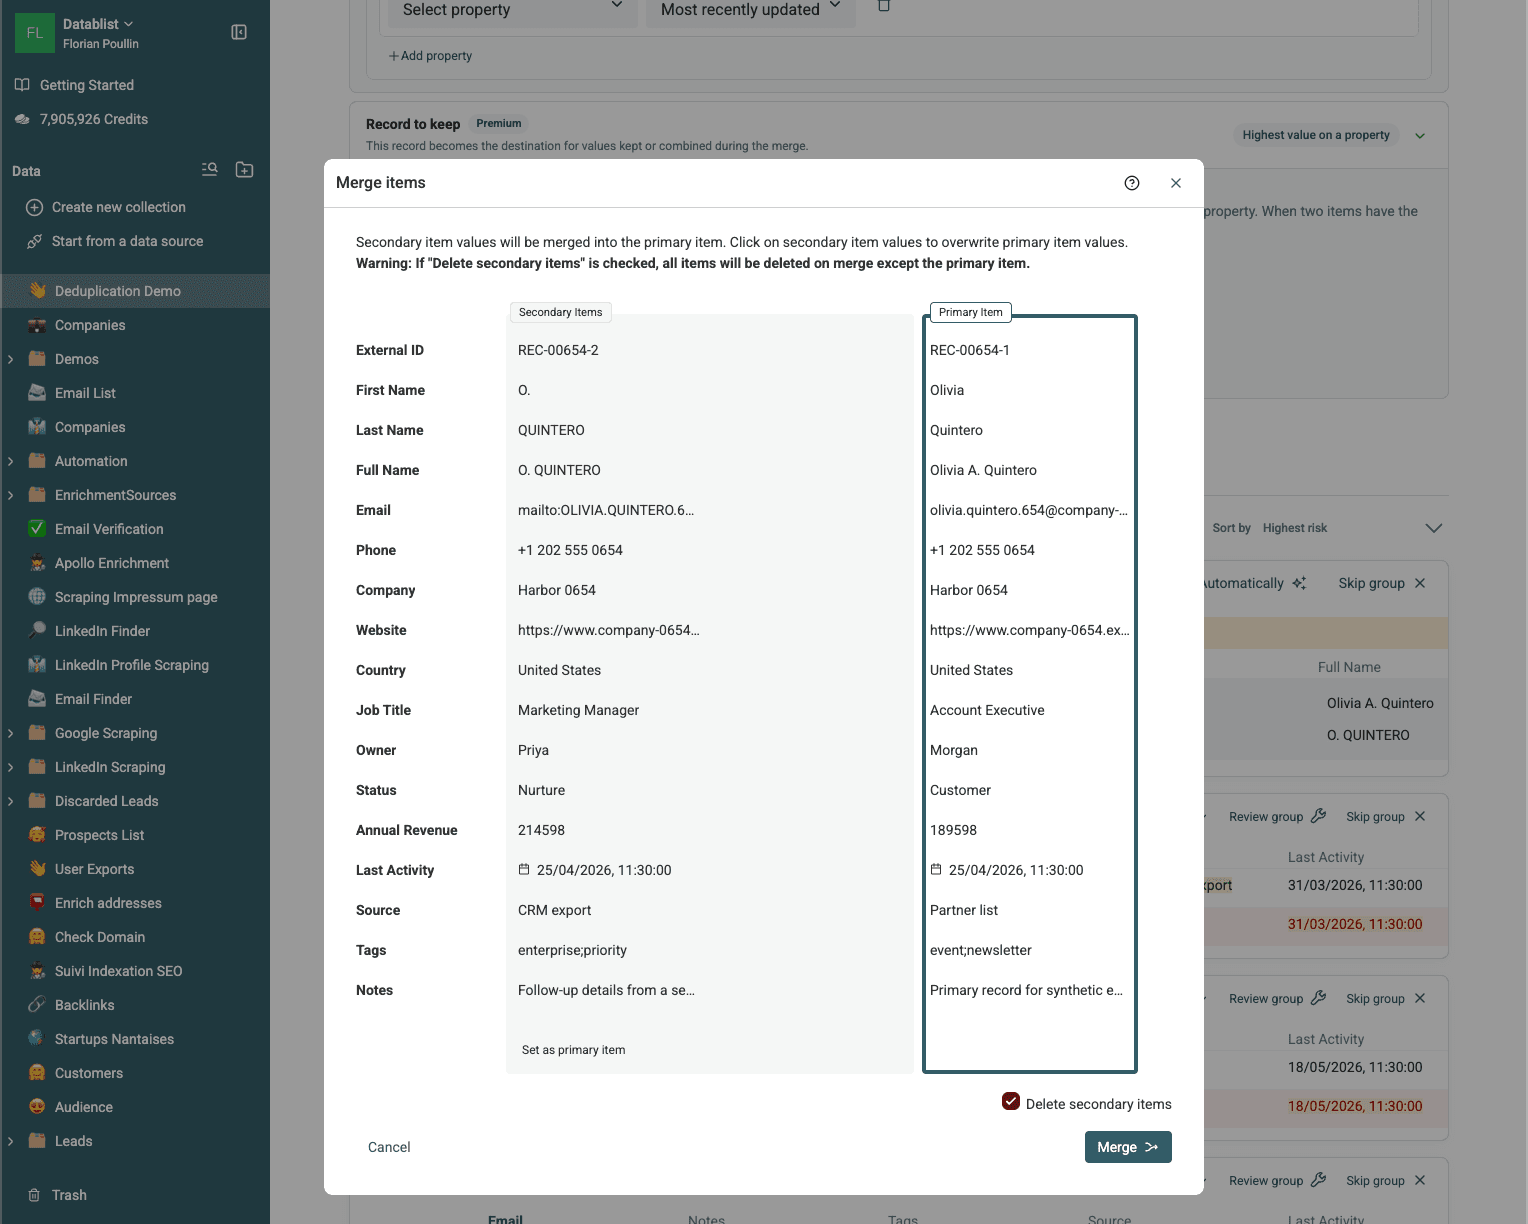
- Merging Assistant에서 그룹을 검토합니다.
- 남은 모든 그룹을 검색하고 위험도가 높은 후보부터 정렬합니다.
⚠️ fuzzy 그룹을 점수만 보고 처리하지 마세요
비슷한 이름이 서로 다른 사람을 가리킬 수 있습니다. 그룹을 확정하기 전에 식별자와 주변 필드를 검토하세요.
merge 전 공유 식별자와 누락 식별자 확인
info@company.example 같은 공용 inbox는 여러 연락처가 사용할 수 있습니다. 해당 주소를 사용하는 두 사람이 Email로 match되더라도 서로 다른 사람일 수 있습니다. 마찬가지로 회사 도메인은 하나의 기업을 식별하지만 여러 직원 레코드에 나타날 수 있습니다.
다른 식별자가 match를 뒷받침할 때까지 이런 그룹은 사람 단위 자동 merge에서 제외하는 것이 좋습니다. 반대로 회사당 한 행이 목적이라면 공유 도메인이 적절한 grouping key일 수 있습니다. 결과를 해석하기 전에 entity를 정의하세요.
빈 값 규칙도 selected-property 비교 결과를 바꿉니다. Exact가 아닌 여러 property 비교에서는 고급 Empty Value Rule 설정으로 Value required (default) 또는 Match on empty value를 선택할 수 있습니다. 기본 설정은 텍스트 식별자가 있어야 하며, 빈 값 match를 허용하면 이 조건이 완화됩니다. 다른 matching 필드가 충분한 신원 근거를 제공할 때만 사용하세요. 이메일이 둘 다 없다는 사실은 두 사람이 같다는 근거가 아닙니다.
예를 들어 Email이 비어 있고 Full Name이 서로 다른 두 행을 단순히 행 수를 줄이기 위해 merge해서는 안 됩니다. 이메일이 없는 행도 유지하거나 나중에 enrich해야 할 연락처일 수 있습니다.
중복 제거, merge 또는 custom processing
중복을 찾는 것과 해결하는 것은 별개의 결정입니다. 보조 행에 어떤 정보가 있는지 검토한 후 processing mode를 선택하세요.
하나의 행이 기준이라면 중복 제거
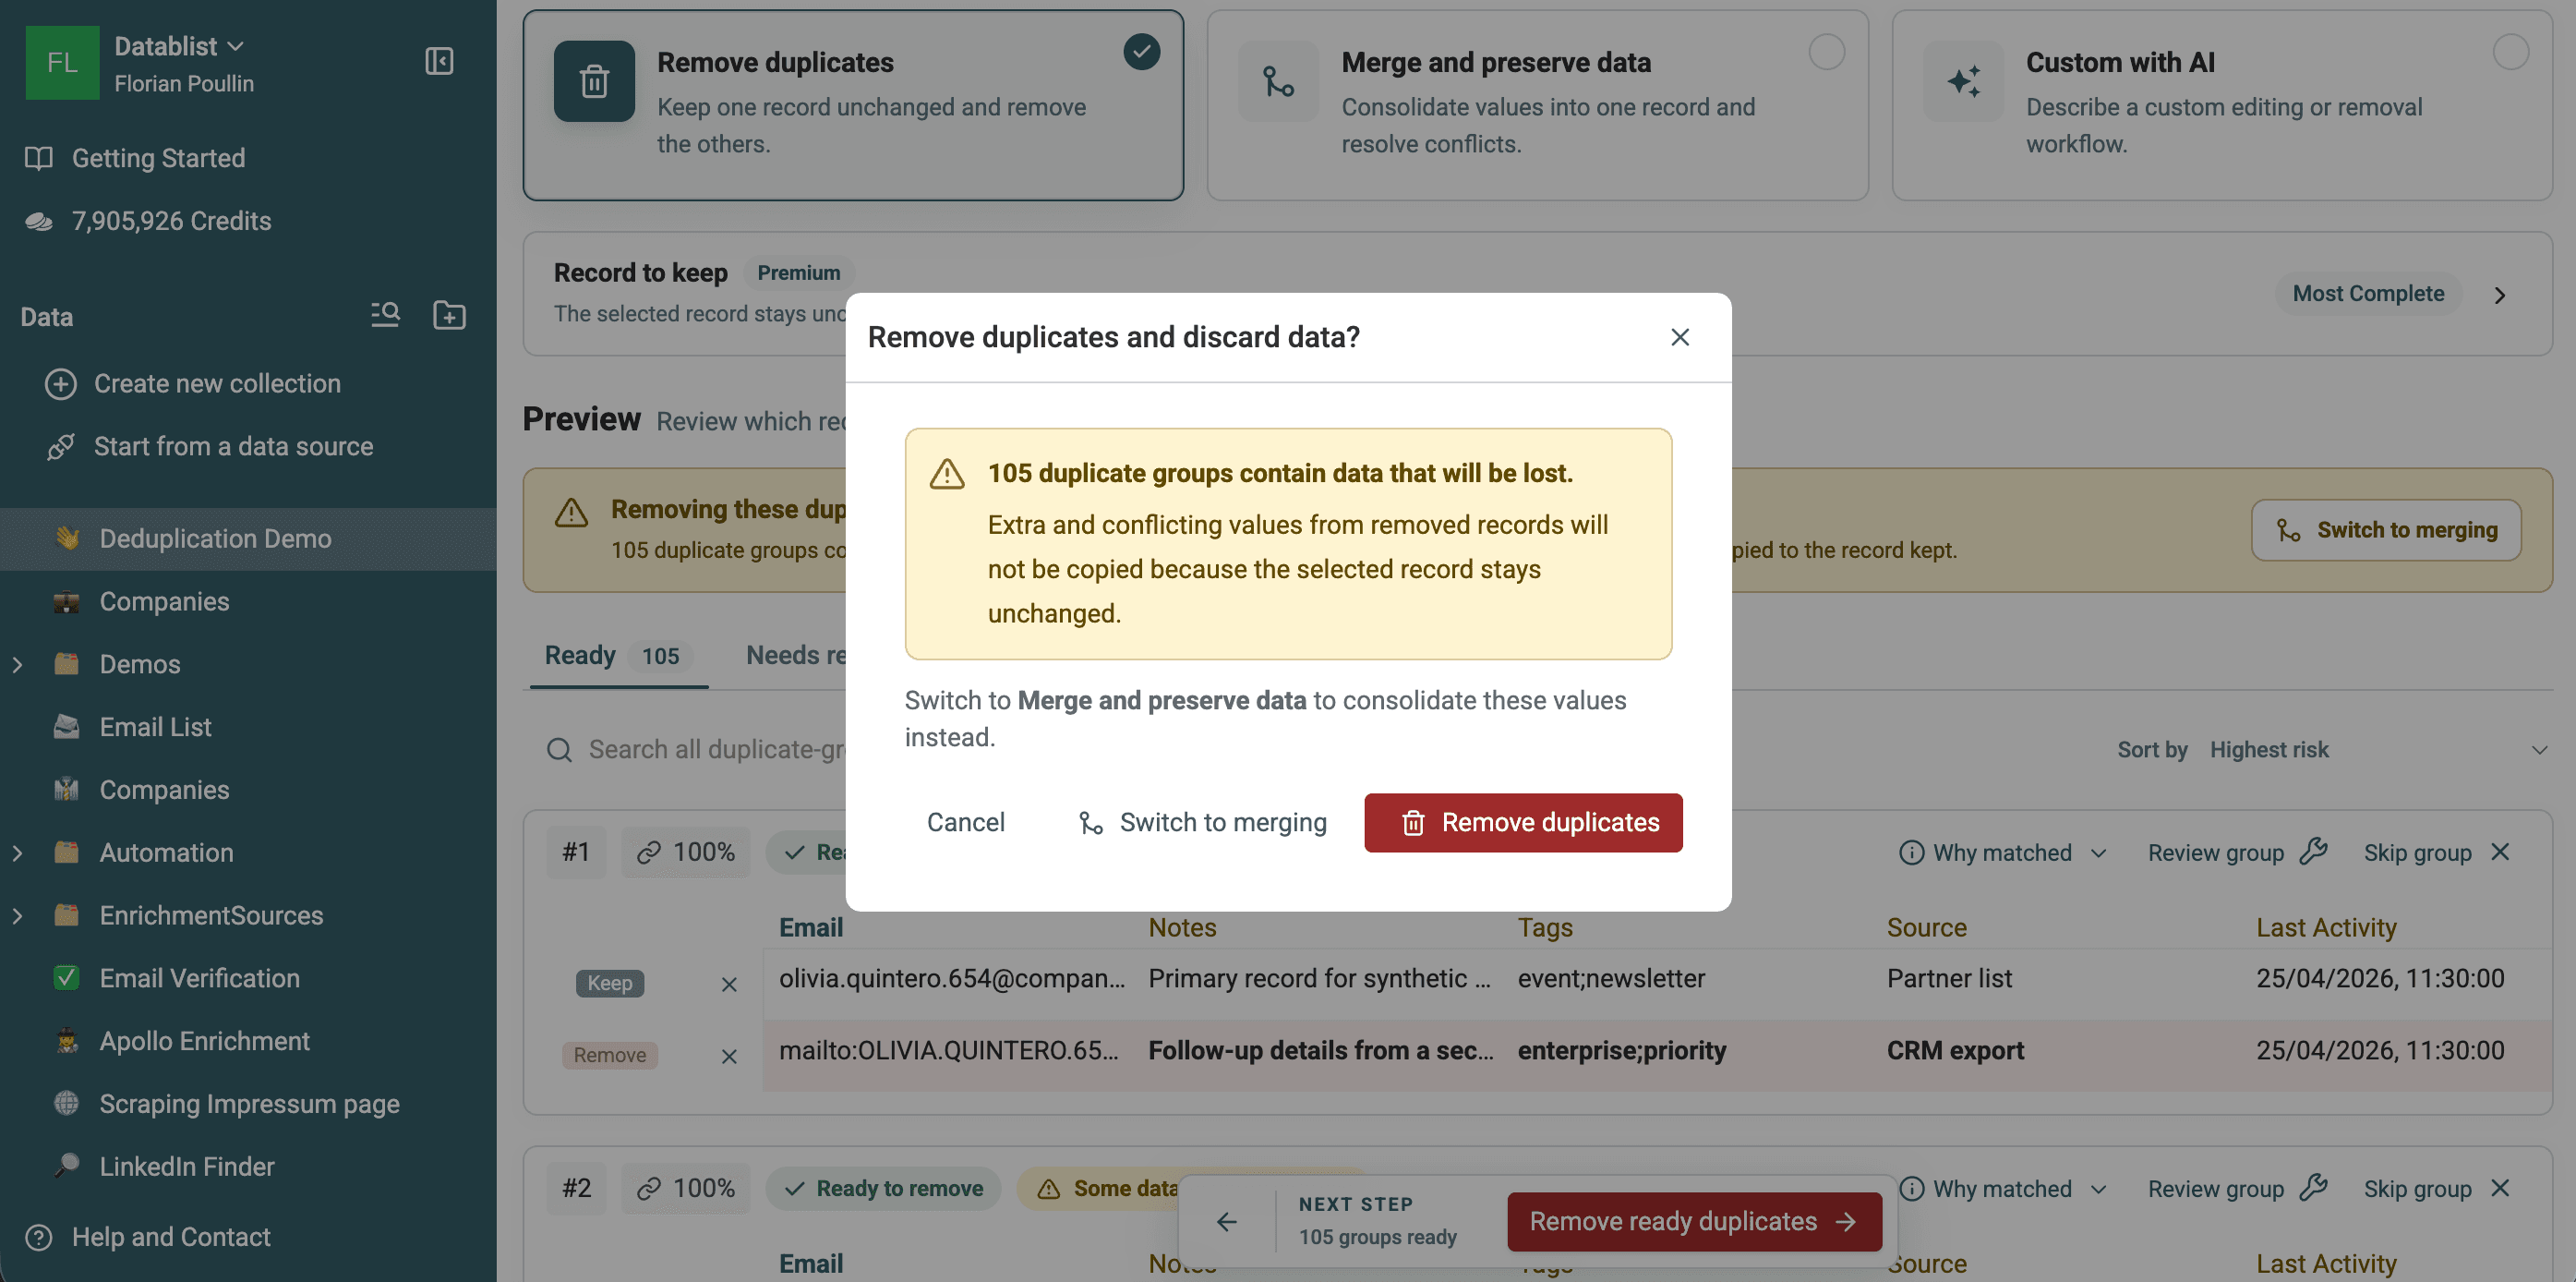
Remove duplicates는 선택한 레코드 하나를 변경하지 않고 유지하며, 각 Ready 그룹의 나머지 행을 삭제합니다.
복사된 행, 임시 가져오기 데이터 또는 보조 값을 버려도 되는 레코드에 사용하세요. 삭제할 레코드에 추가 정보나 충돌하는 정보가 있으면 preview에 경고가 표시됩니다. 해당 값은 유지되는 행으로 복사되지 않습니다.
행에 유용한 데이터가 있다면 merge
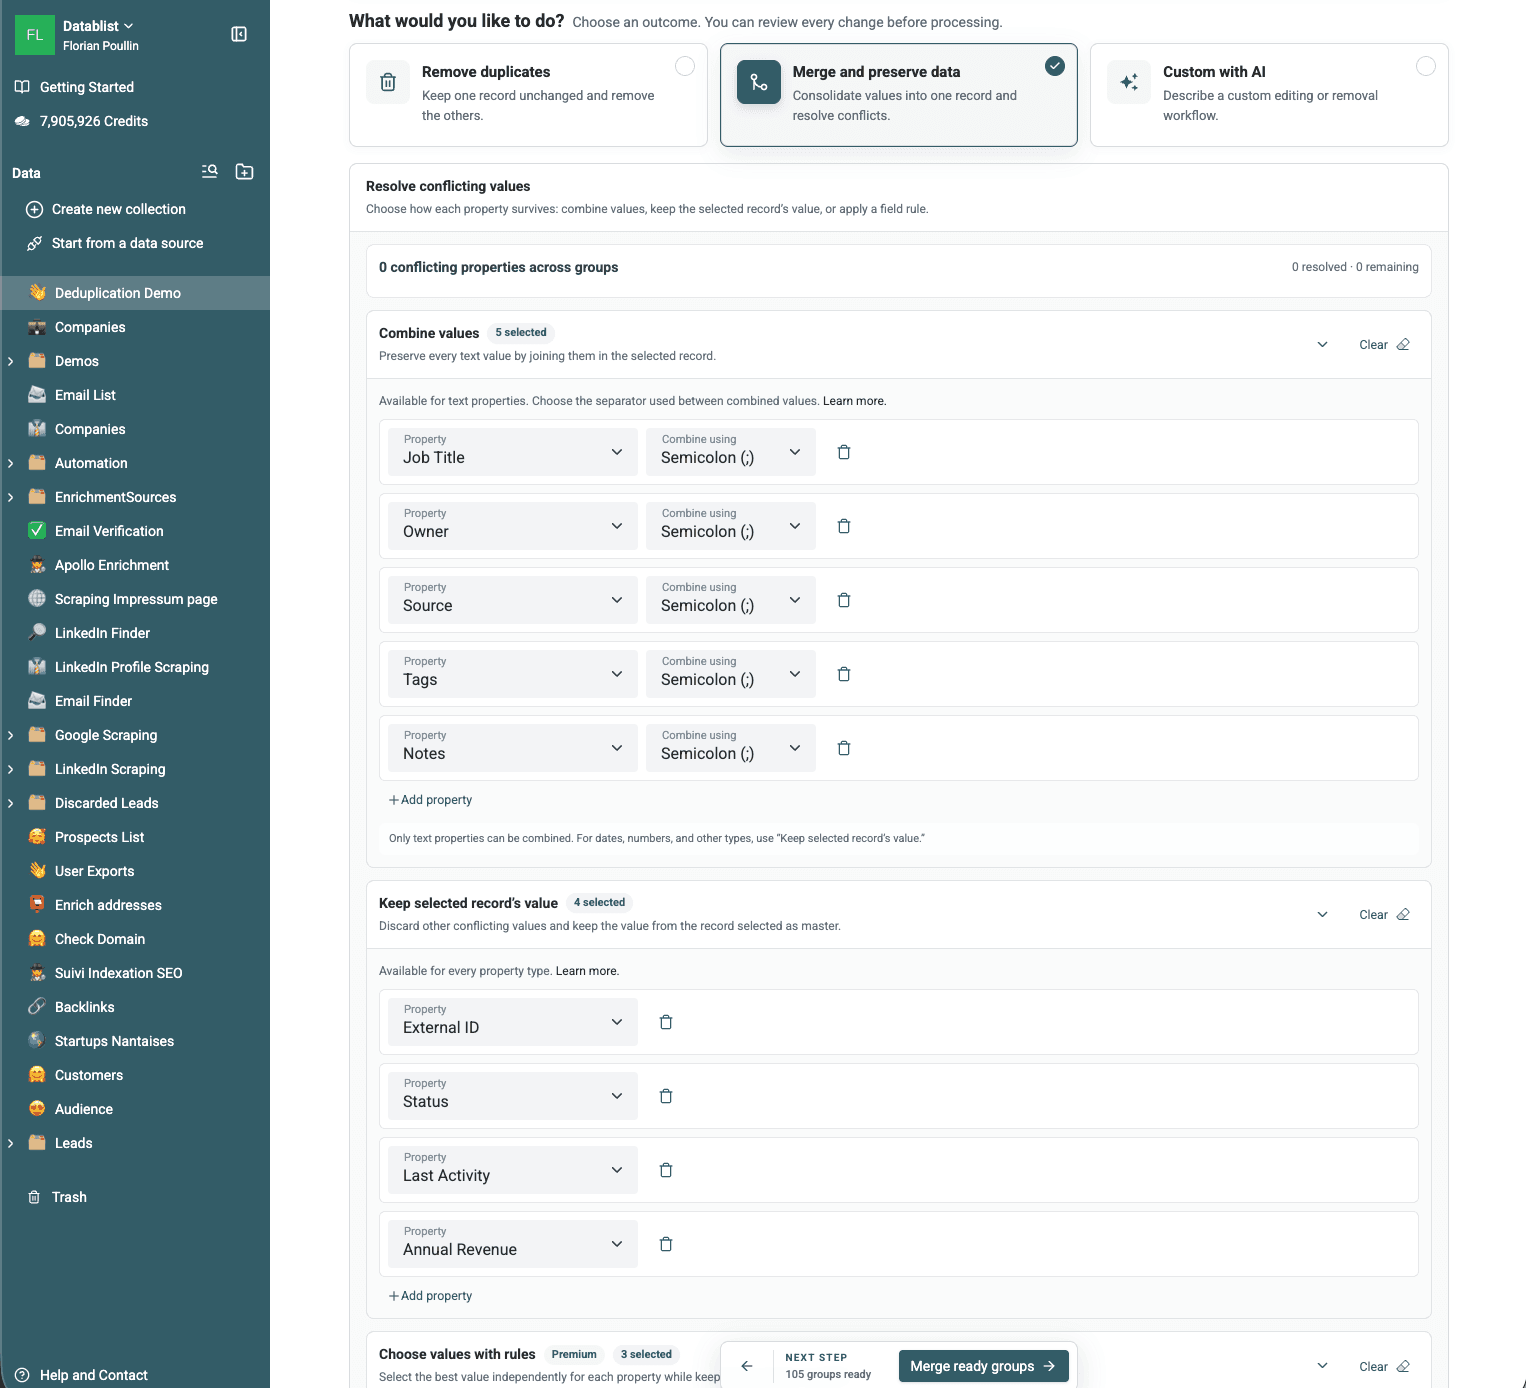
Merge and preserve data는 선택한 레코드의 빈 property를 채우고 설정된 충돌을 해결한 뒤 보조 행을 삭제합니다.
먼저 Record to keep 규칙을 선택하세요. 기본값은 Most Complete입니다. 유료 plan에서는 생성 시간, 업데이트 시간, 가장 높거나 낮은 property 값 또는 필수 property 값을 기준으로 선택할 수 있습니다.
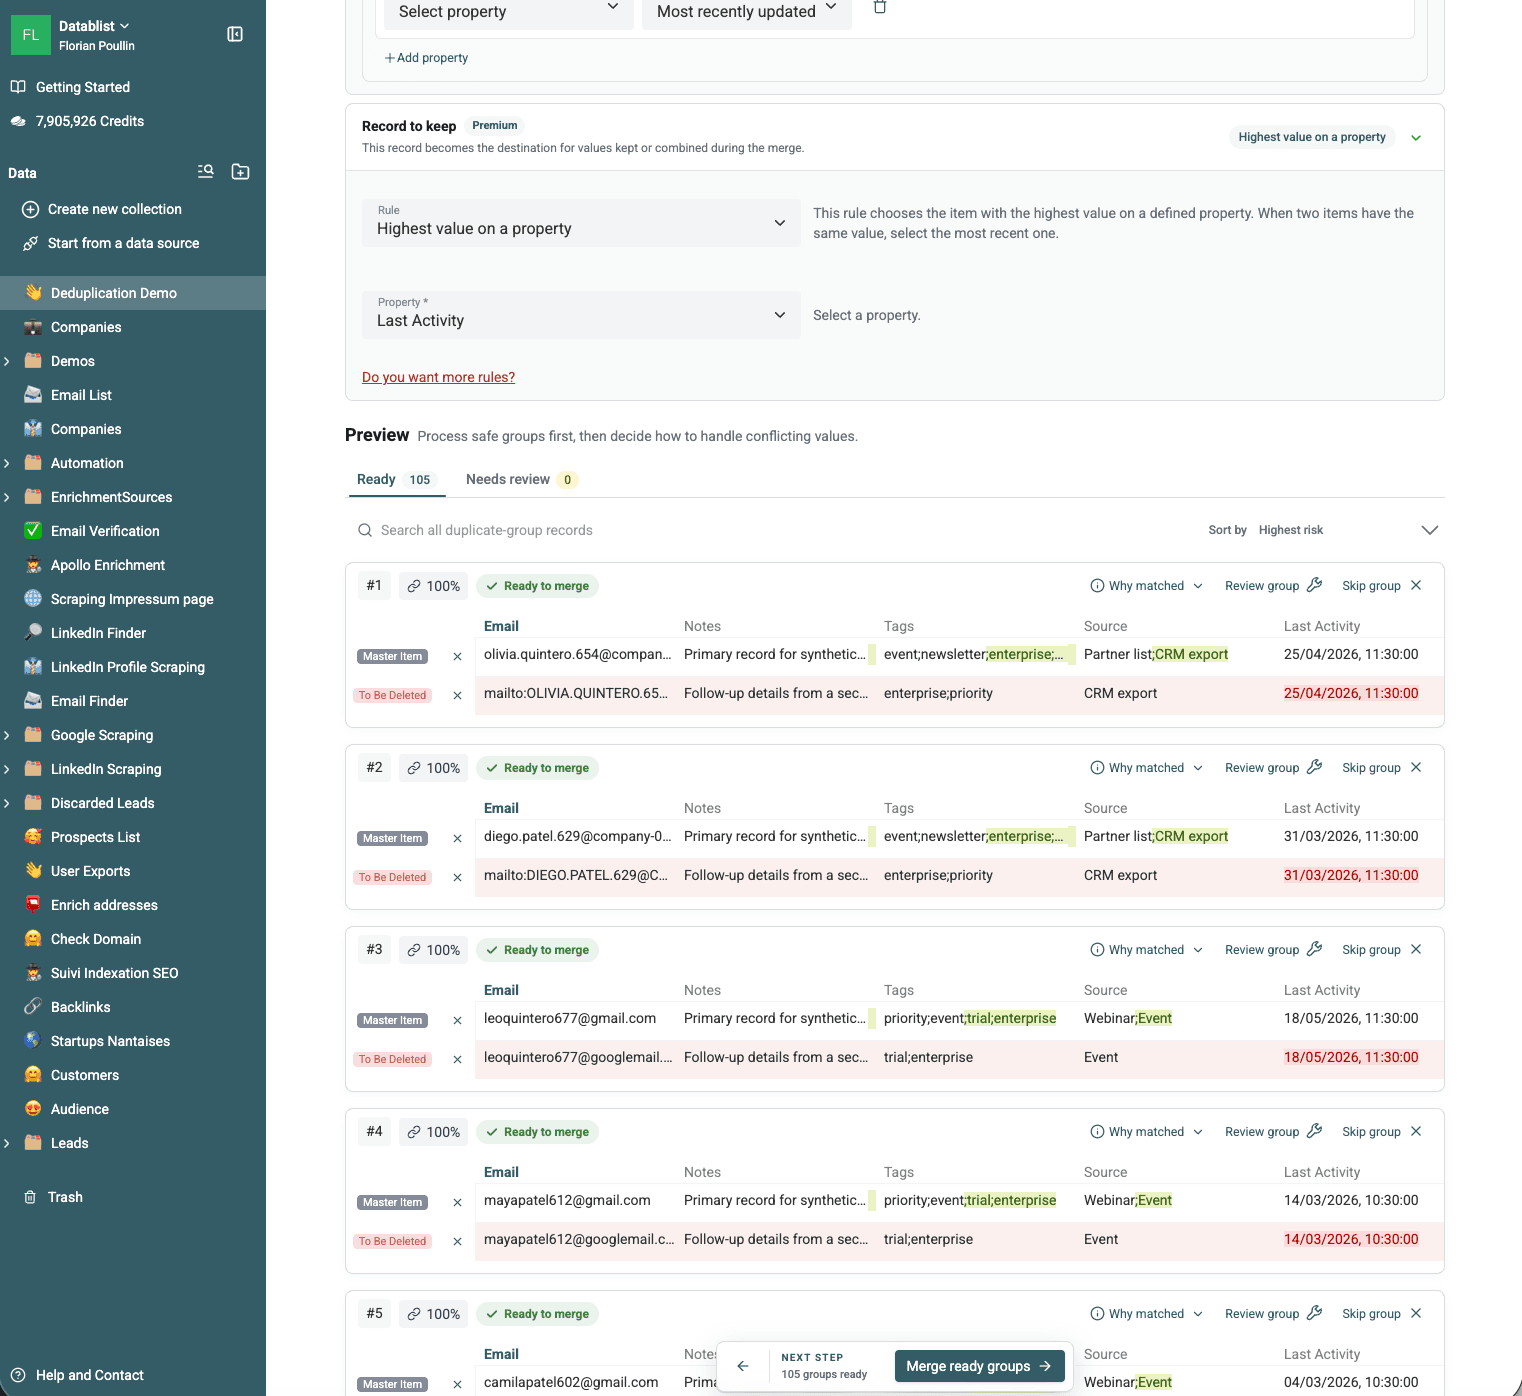
그런 다음 충돌하는 각 property에서 어떤 값을 남길지 결정하세요.
- 서로 다른 텍스트 값을 delimiter로 결합합니다.
- 선택한 레코드의 값을 유지합니다.
- 유료 plan에서는 최신, 가장 오래된 값, 가장 긴 값, 가장 짧은 값, 최댓값, 최솟값 또는 최빈값 등의 규칙으로 각 값을 따로 선택할 수 있습니다.
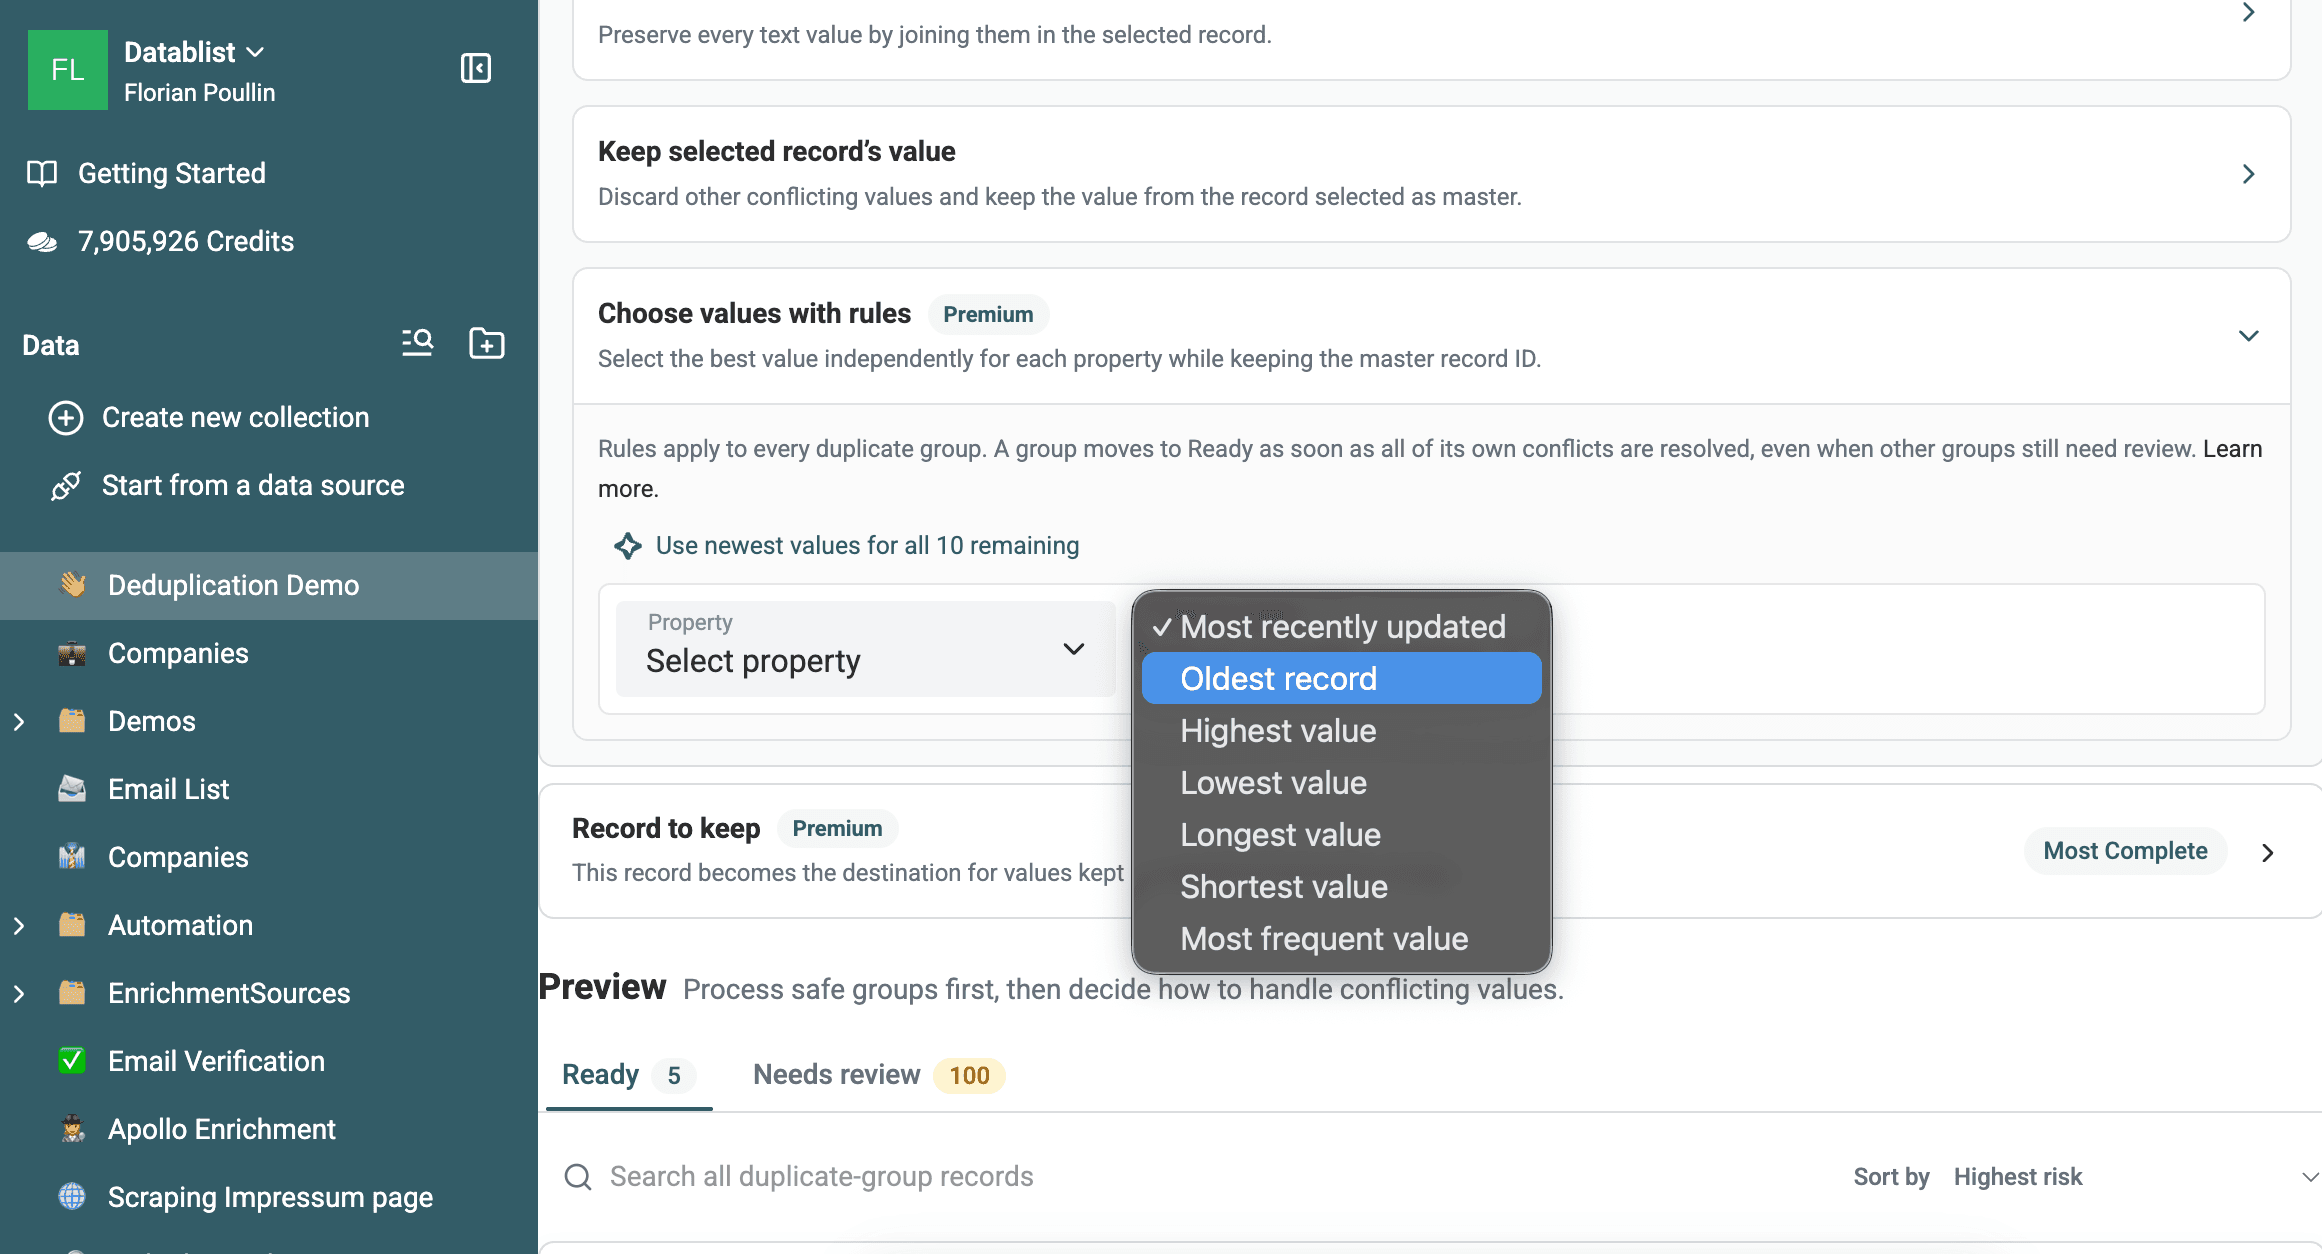
어느 한 행에도 모든 property의 최적값이 모여 있지 않다면 field-level 규칙을 사용하세요. 선택한 레코드의 ID는 유지하면서 다른 행에서 더 최신인 직함, 더 긴 회사명, 가장 자주 나타나는 상태를 가져올 수 있습니다.
threshold, workflow, 그룹 구성, 충돌 설정 또는 레코드 선택 규칙을 변경한 후에는 preview를 새로고침하세요.
Custom with AI로 그룹별 logic 적용
Custom with AI는 자연어 지시문을 바탕으로 그룹 processing workflow를 생성합니다. 레코드 선택, 값 복사 또는 정규화, 상태 property 추가, 그룹 합계 계산, 보조 행 삭제, 조건에 맞지 않는 그룹 건너뛰기 등을 수행할 수 있습니다.
예를 들면 다음과 같습니다.
Source가 CRM export인 레코드를 유지하세요. 가장 최근 레코드에서 Job Title을 복사하고, 서로 다른 Notes를 줄바꿈으로 결합하고, Duplicate Reviewed checkbox를 추가한 다음 보조 레코드를 삭제하세요.
collection property는 /Property 또는 {{Property}}로 참조하세요. workflow를 실행하기 전에 생성하고 preview로 확인해야 합니다. Custom with AI는 유료 plan의 로그인 사용자에게 제공됩니다.
개별 예외는 batch 규칙을 복잡하게 만들지 말고 Review group을 열어 Merging Assistant에서 처리하세요.
정리된 리스트 검증 및 내보내기
Ready 그룹을 처리하기 전에 다음을 확인하세요.
- preview가 현재 설정을 반영하나요?
- 신뢰도가 낮거나 식별자를 공유하는 그룹을 검토했나요?
- 선택한 레코드에 보존해야 할 ID가 있나요?
- 고유한 전화번호, 소스, 메모, 상태 값이 유지되나요?
- 하나의 값만 허용되는 필드가 연결되지 않나요?
- 표시된 Ready 수가 처리하려는 범위와 일치하나요?
처리 후에는 행 수를 대조하세요.
시작 행 수 - 삭제된 보조 행 수 = 최종 행 수
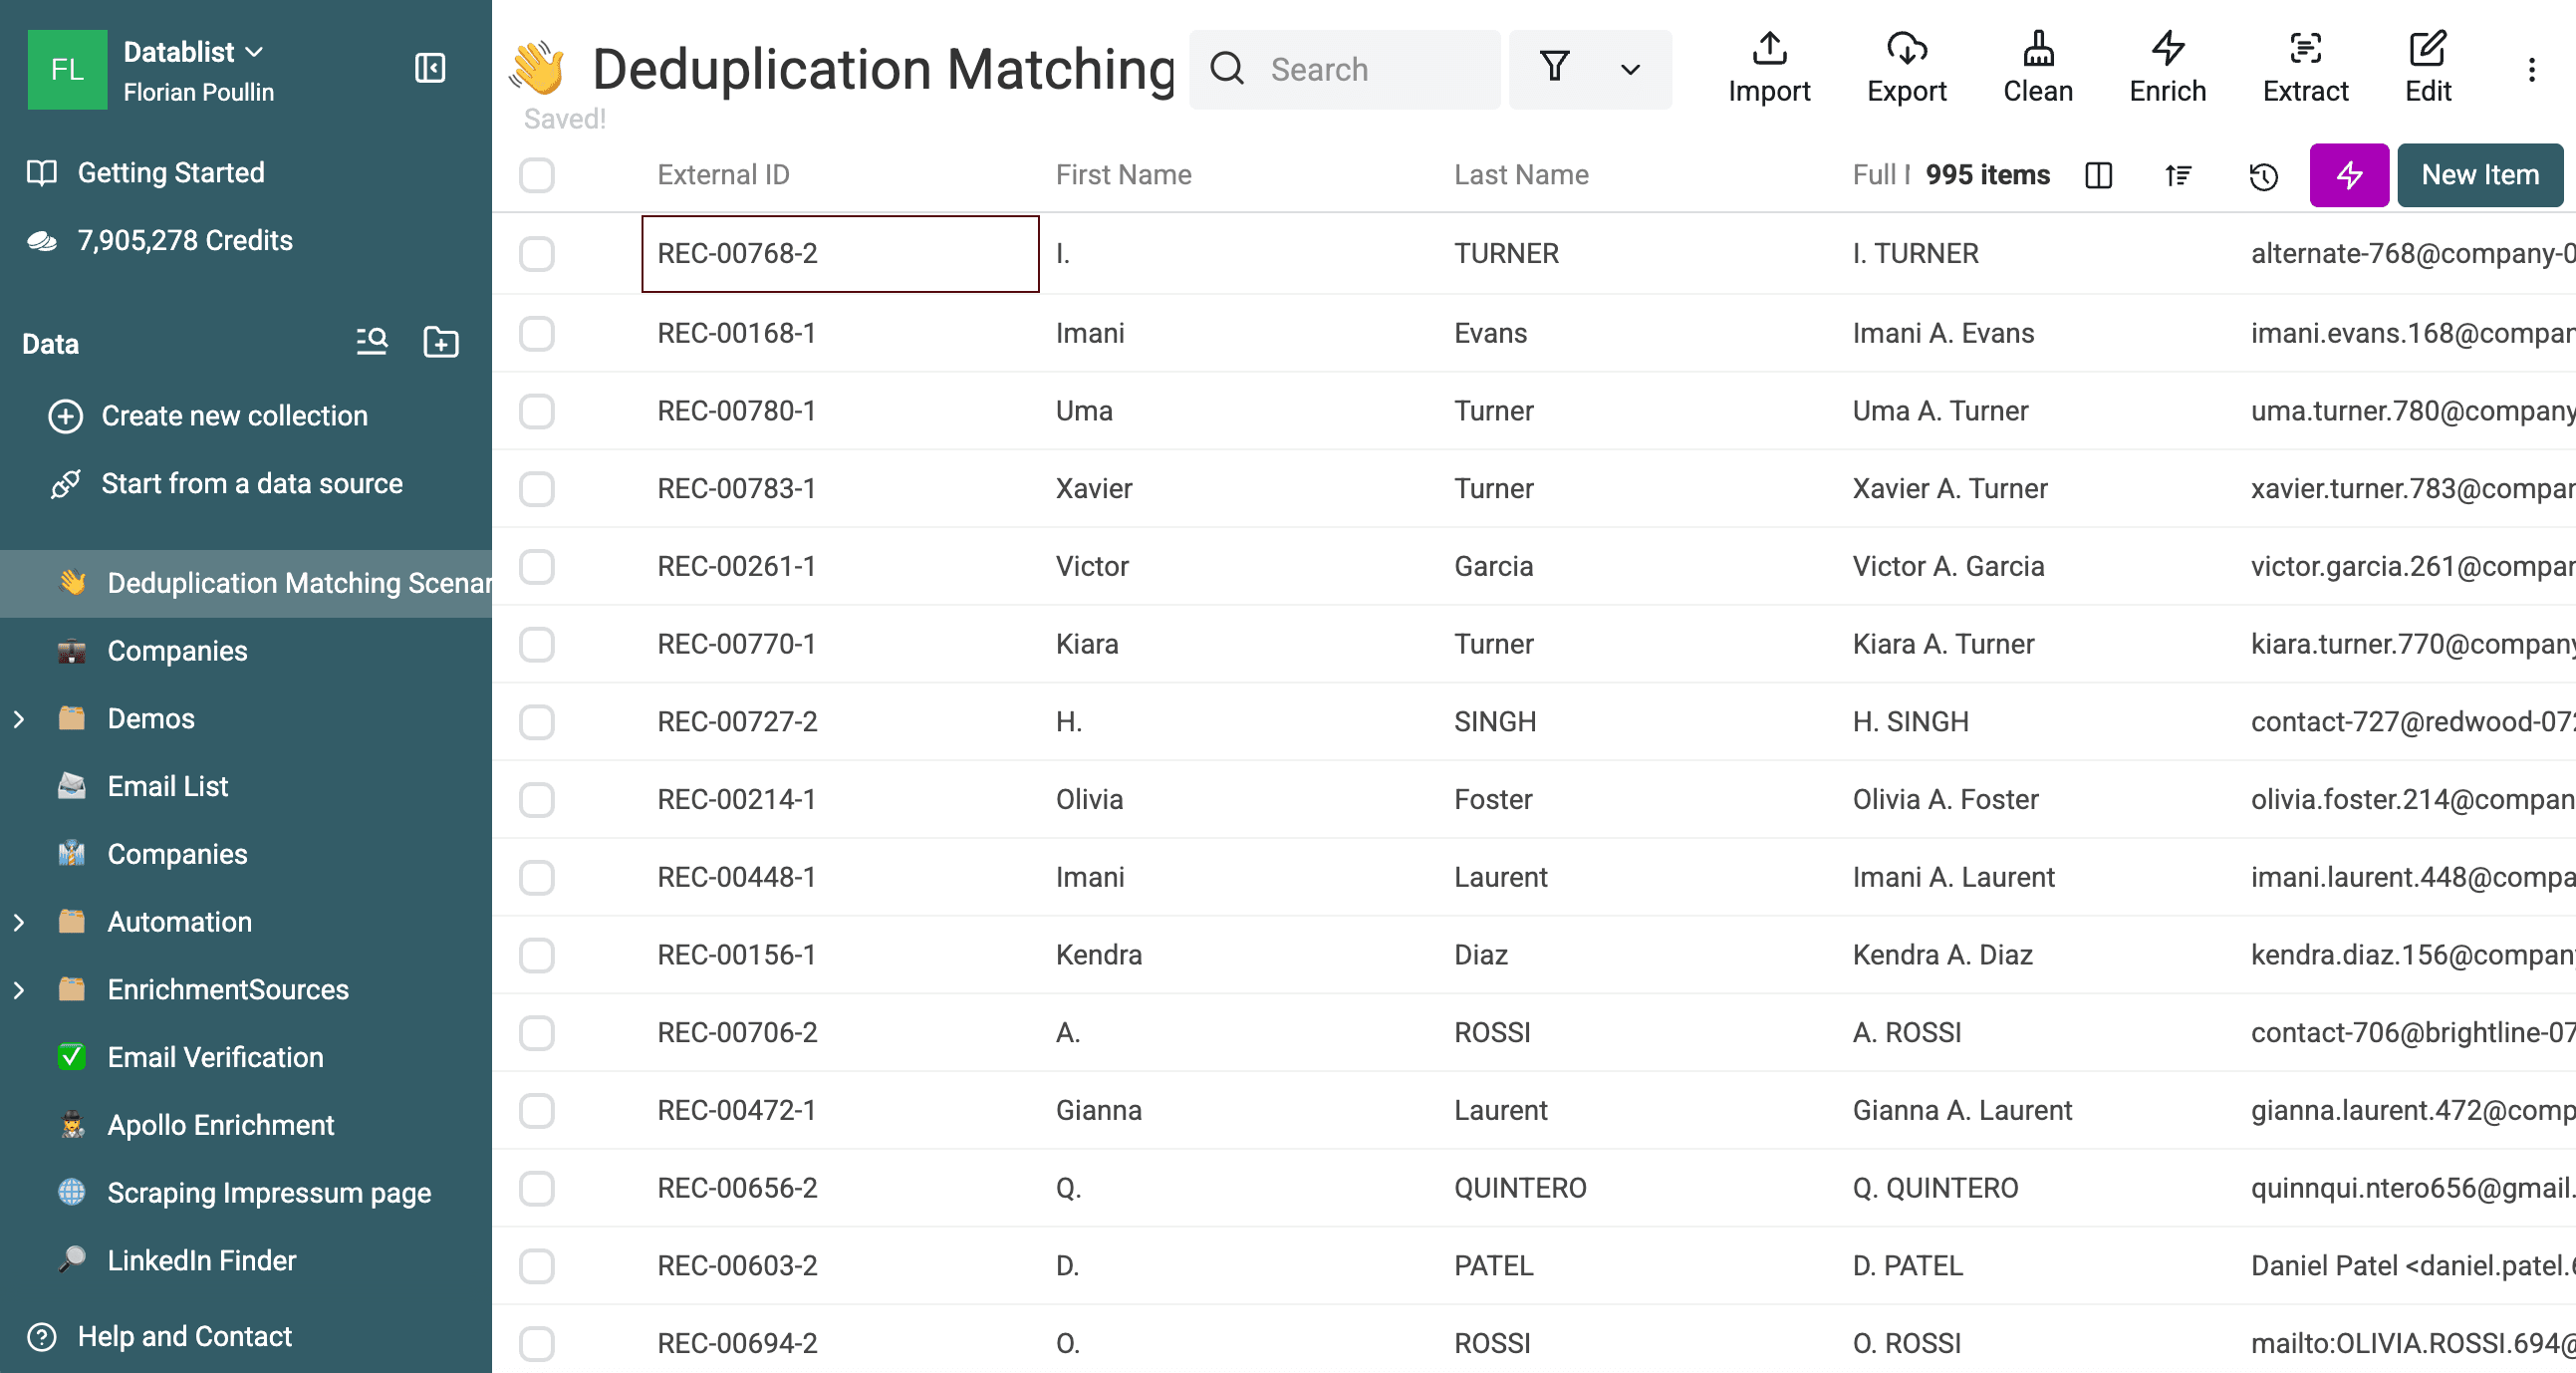
이 가이드의 Exact 검사에서 Datablist는 두 행짜리 그룹 5개를 merge했습니다. 따라서 collection의 item 수는 1,000개에서 995개로 줄었습니다.
외부 검토용 파일이 필요하다면 처리 전에 중복 그룹을 다운로드하세요. 유료 plan에는 활용 가능한 중복 그룹 ID와 처리 후 change log가 포함됩니다. change log에는 삭제되거나 업데이트된 Datablist ID와 이전 값 및 대상 값이 기록됩니다.
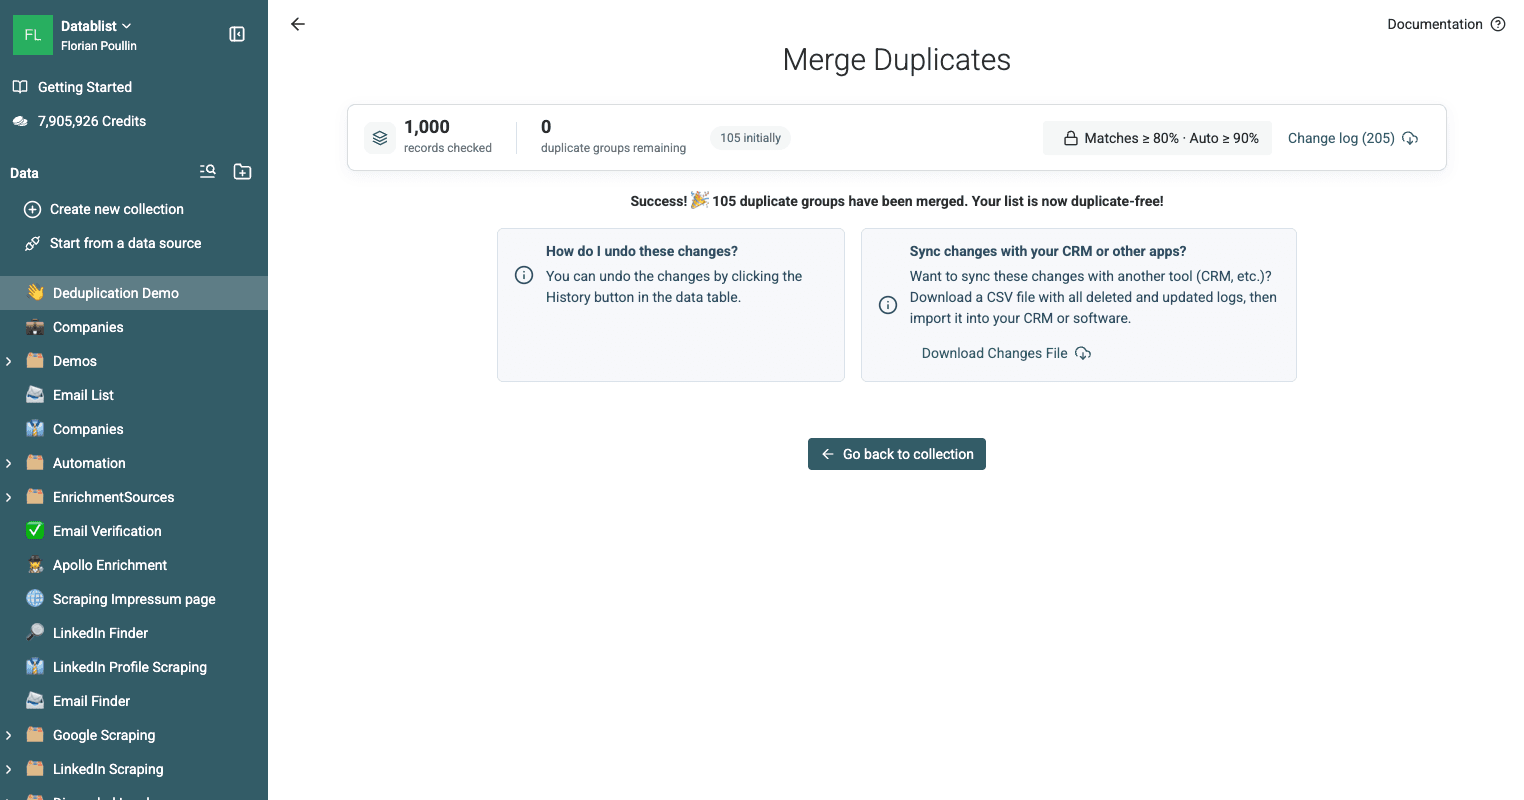
자동 제거 및 merge 작업은 collection History에도 표시되며 여기에서 실행 취소할 수 있습니다.
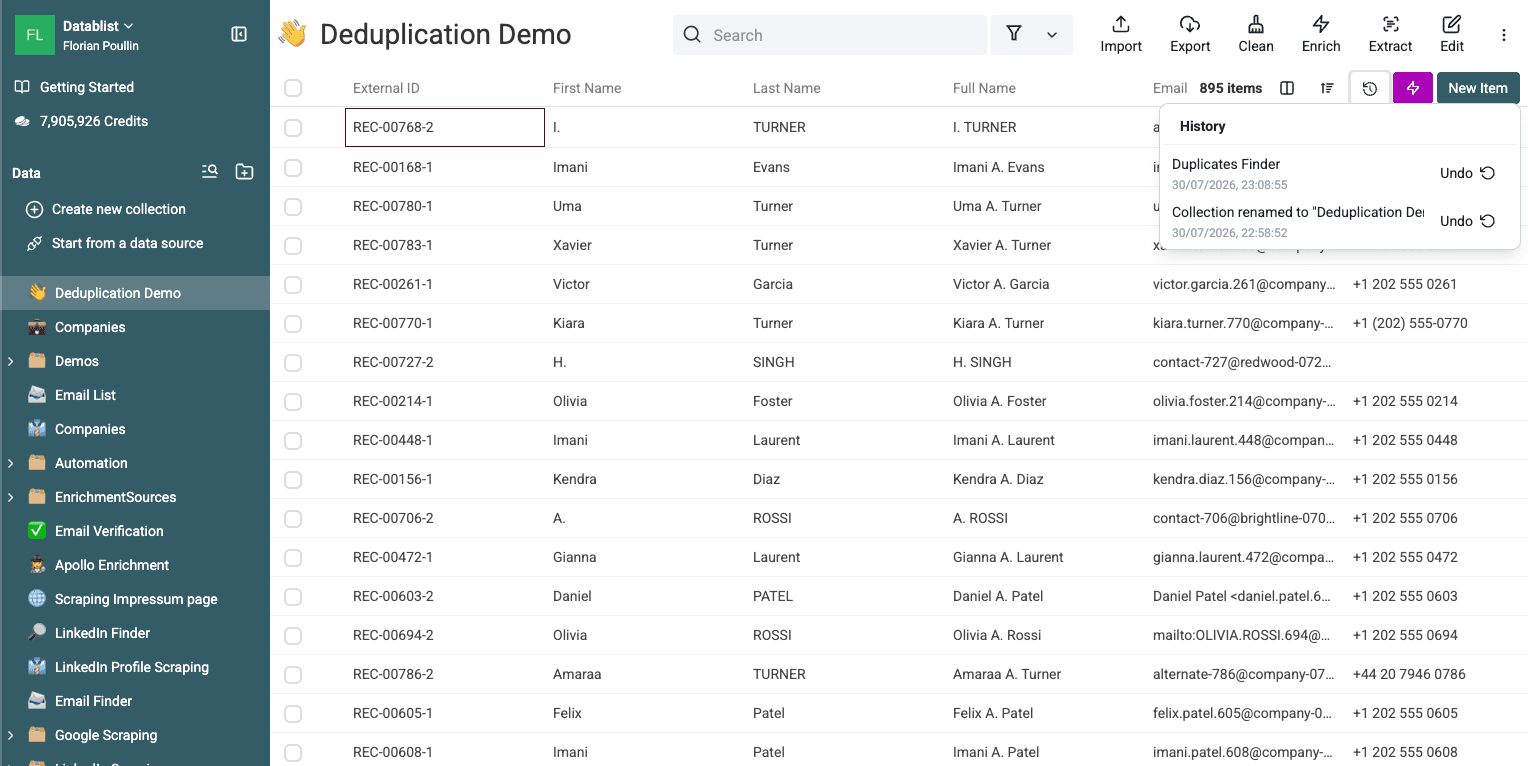
collection으로 돌아가 Export를 열고 정리된 CSV 또는 Excel 파일을 다운로드하세요.
여러 리스트 중복 제거
새로운 Lead 파일을 CRM export와 비교해야 한다면 cross-collection matching을 사용하세요. CRM을 기준 리스트로 삼고, 가져오기 전에 신규 리스트에서 CRM과 일치하는 항목을 제거합니다.
이 workflow를 테스트하려면 데모 CRM 파일과 데모 이벤트 파일을 다운로드하세요. 두 파일은 서로 다른 헤더를 사용하며 의도적으로 설계된 이메일 중복 100개를 포함합니다. 각 파일은 250행으로 시작합니다.
각 파일을 별도의 collection으로 가져온 다음 Clean > Match across collections를 여세요. 두 collection을 추가하고 Email과 Attendee Email처럼 서로 대응하는 property를 mapping합니다.
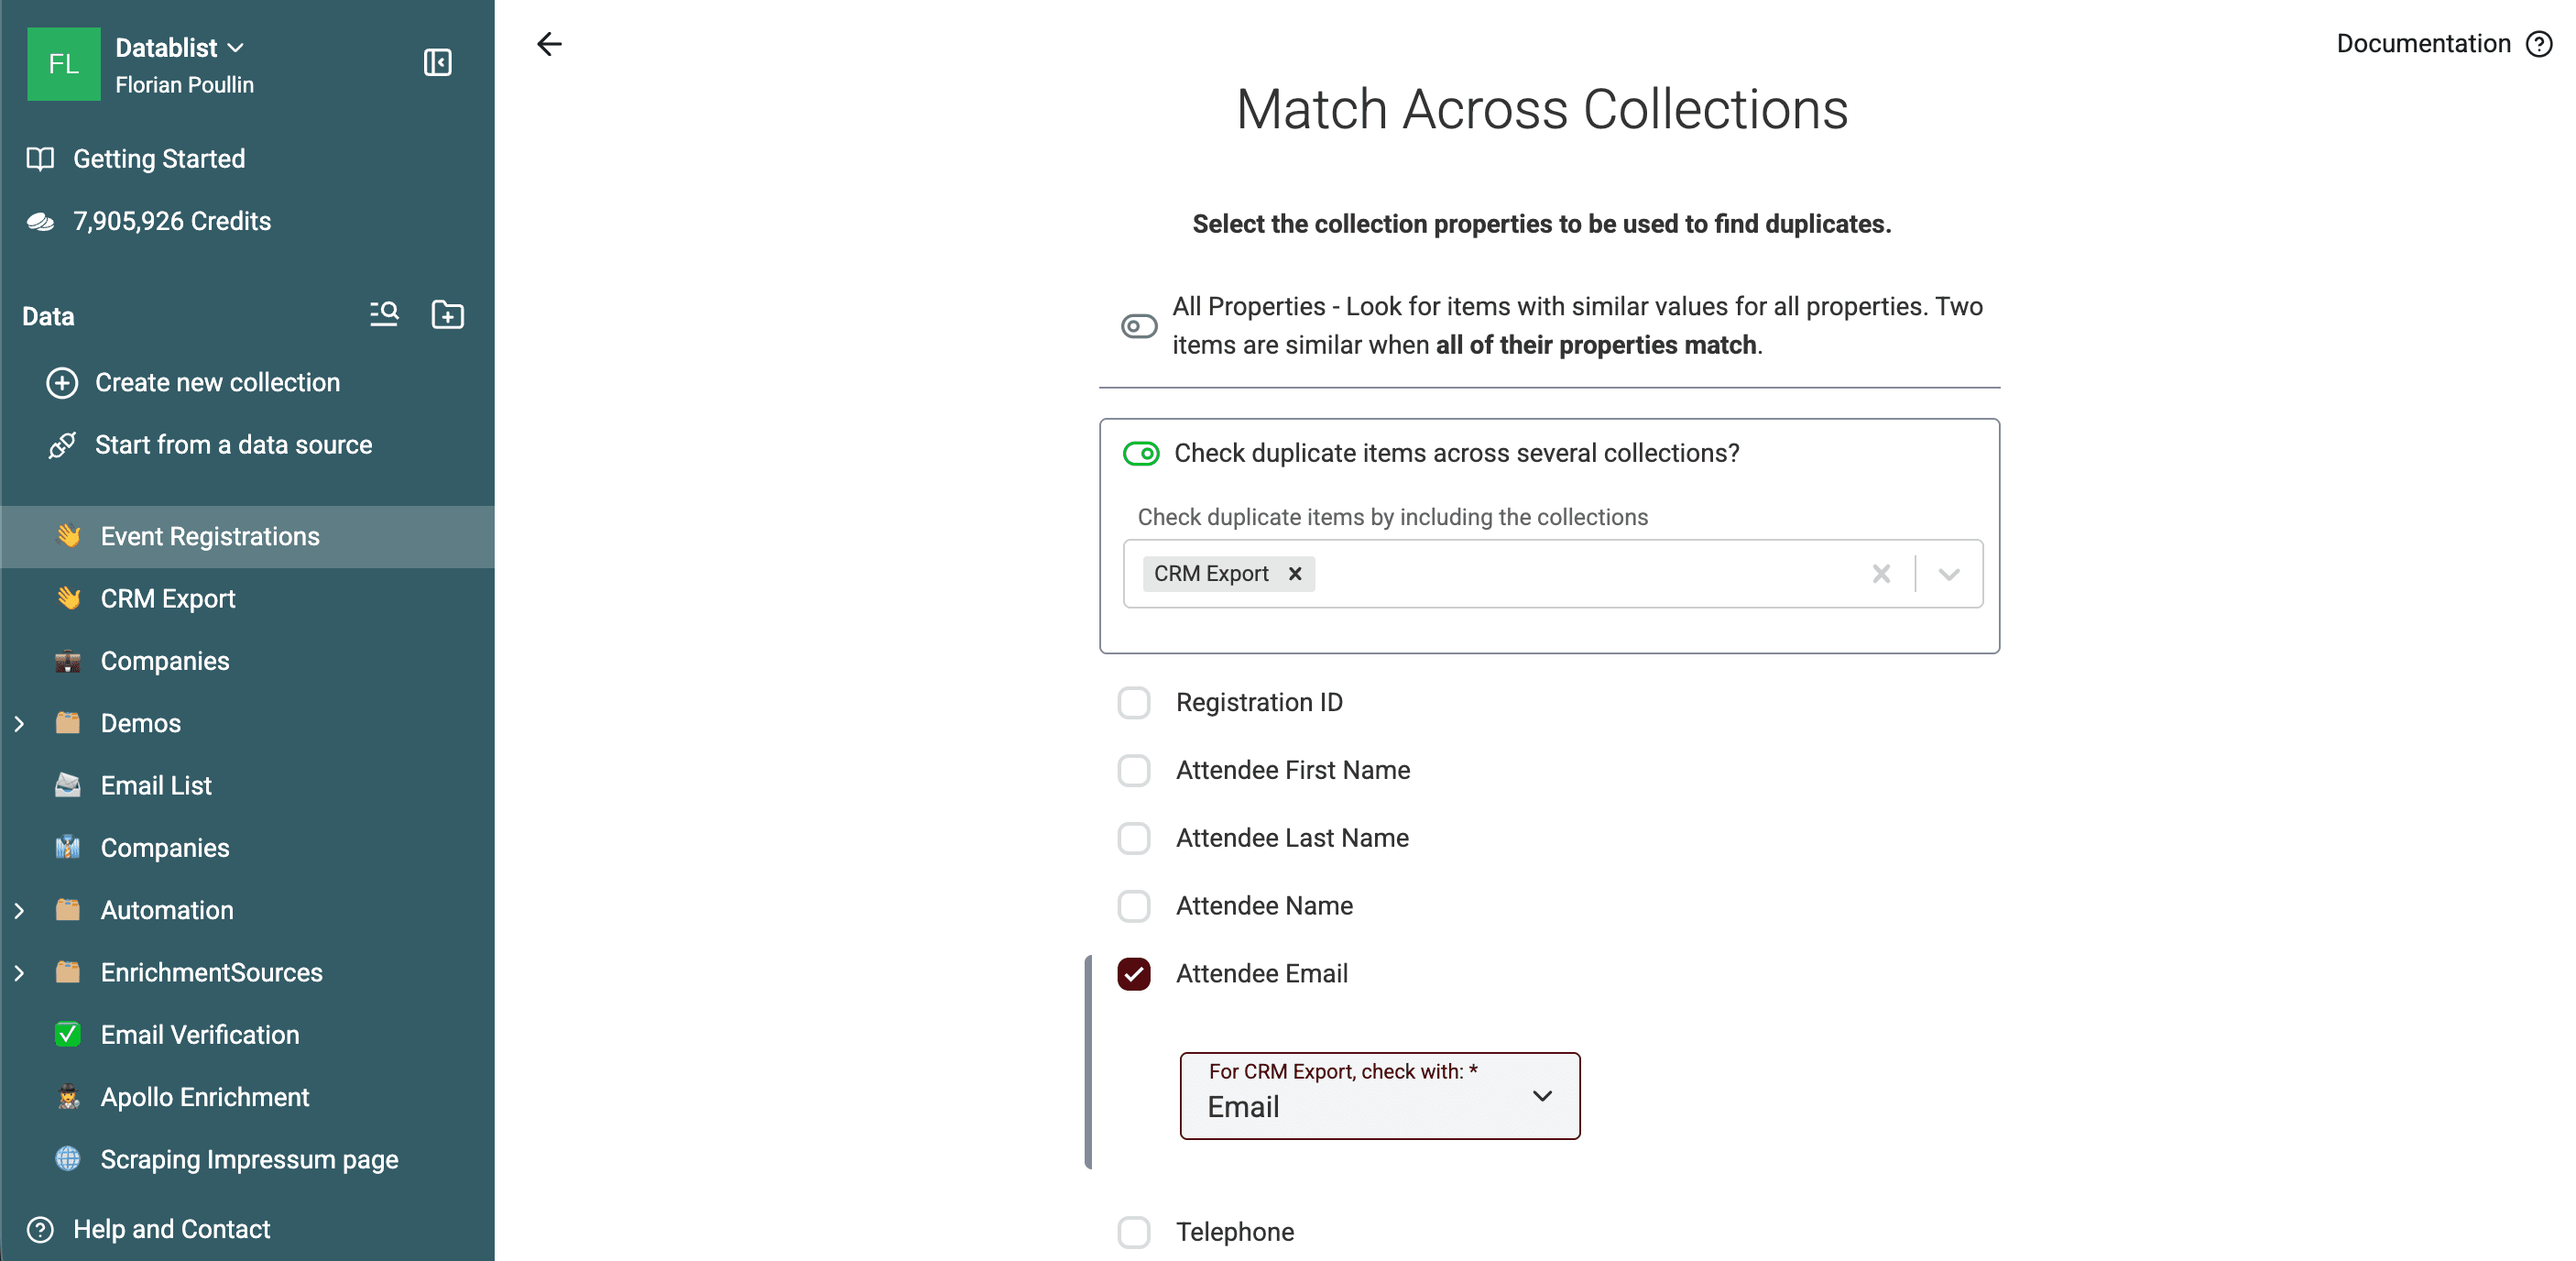
이 테스트에서는 Email processor를 사용한 Smart matching이 검사한 레코드 500개에서 cross-collection 그룹 100개를 반환했습니다. CRM은 변경하지 않고 이벤트 리스트에서 일치 항목을 제외하려면 ***Remove duplicate items from collection {X}***에서 Event Registrations를 선택하세요.
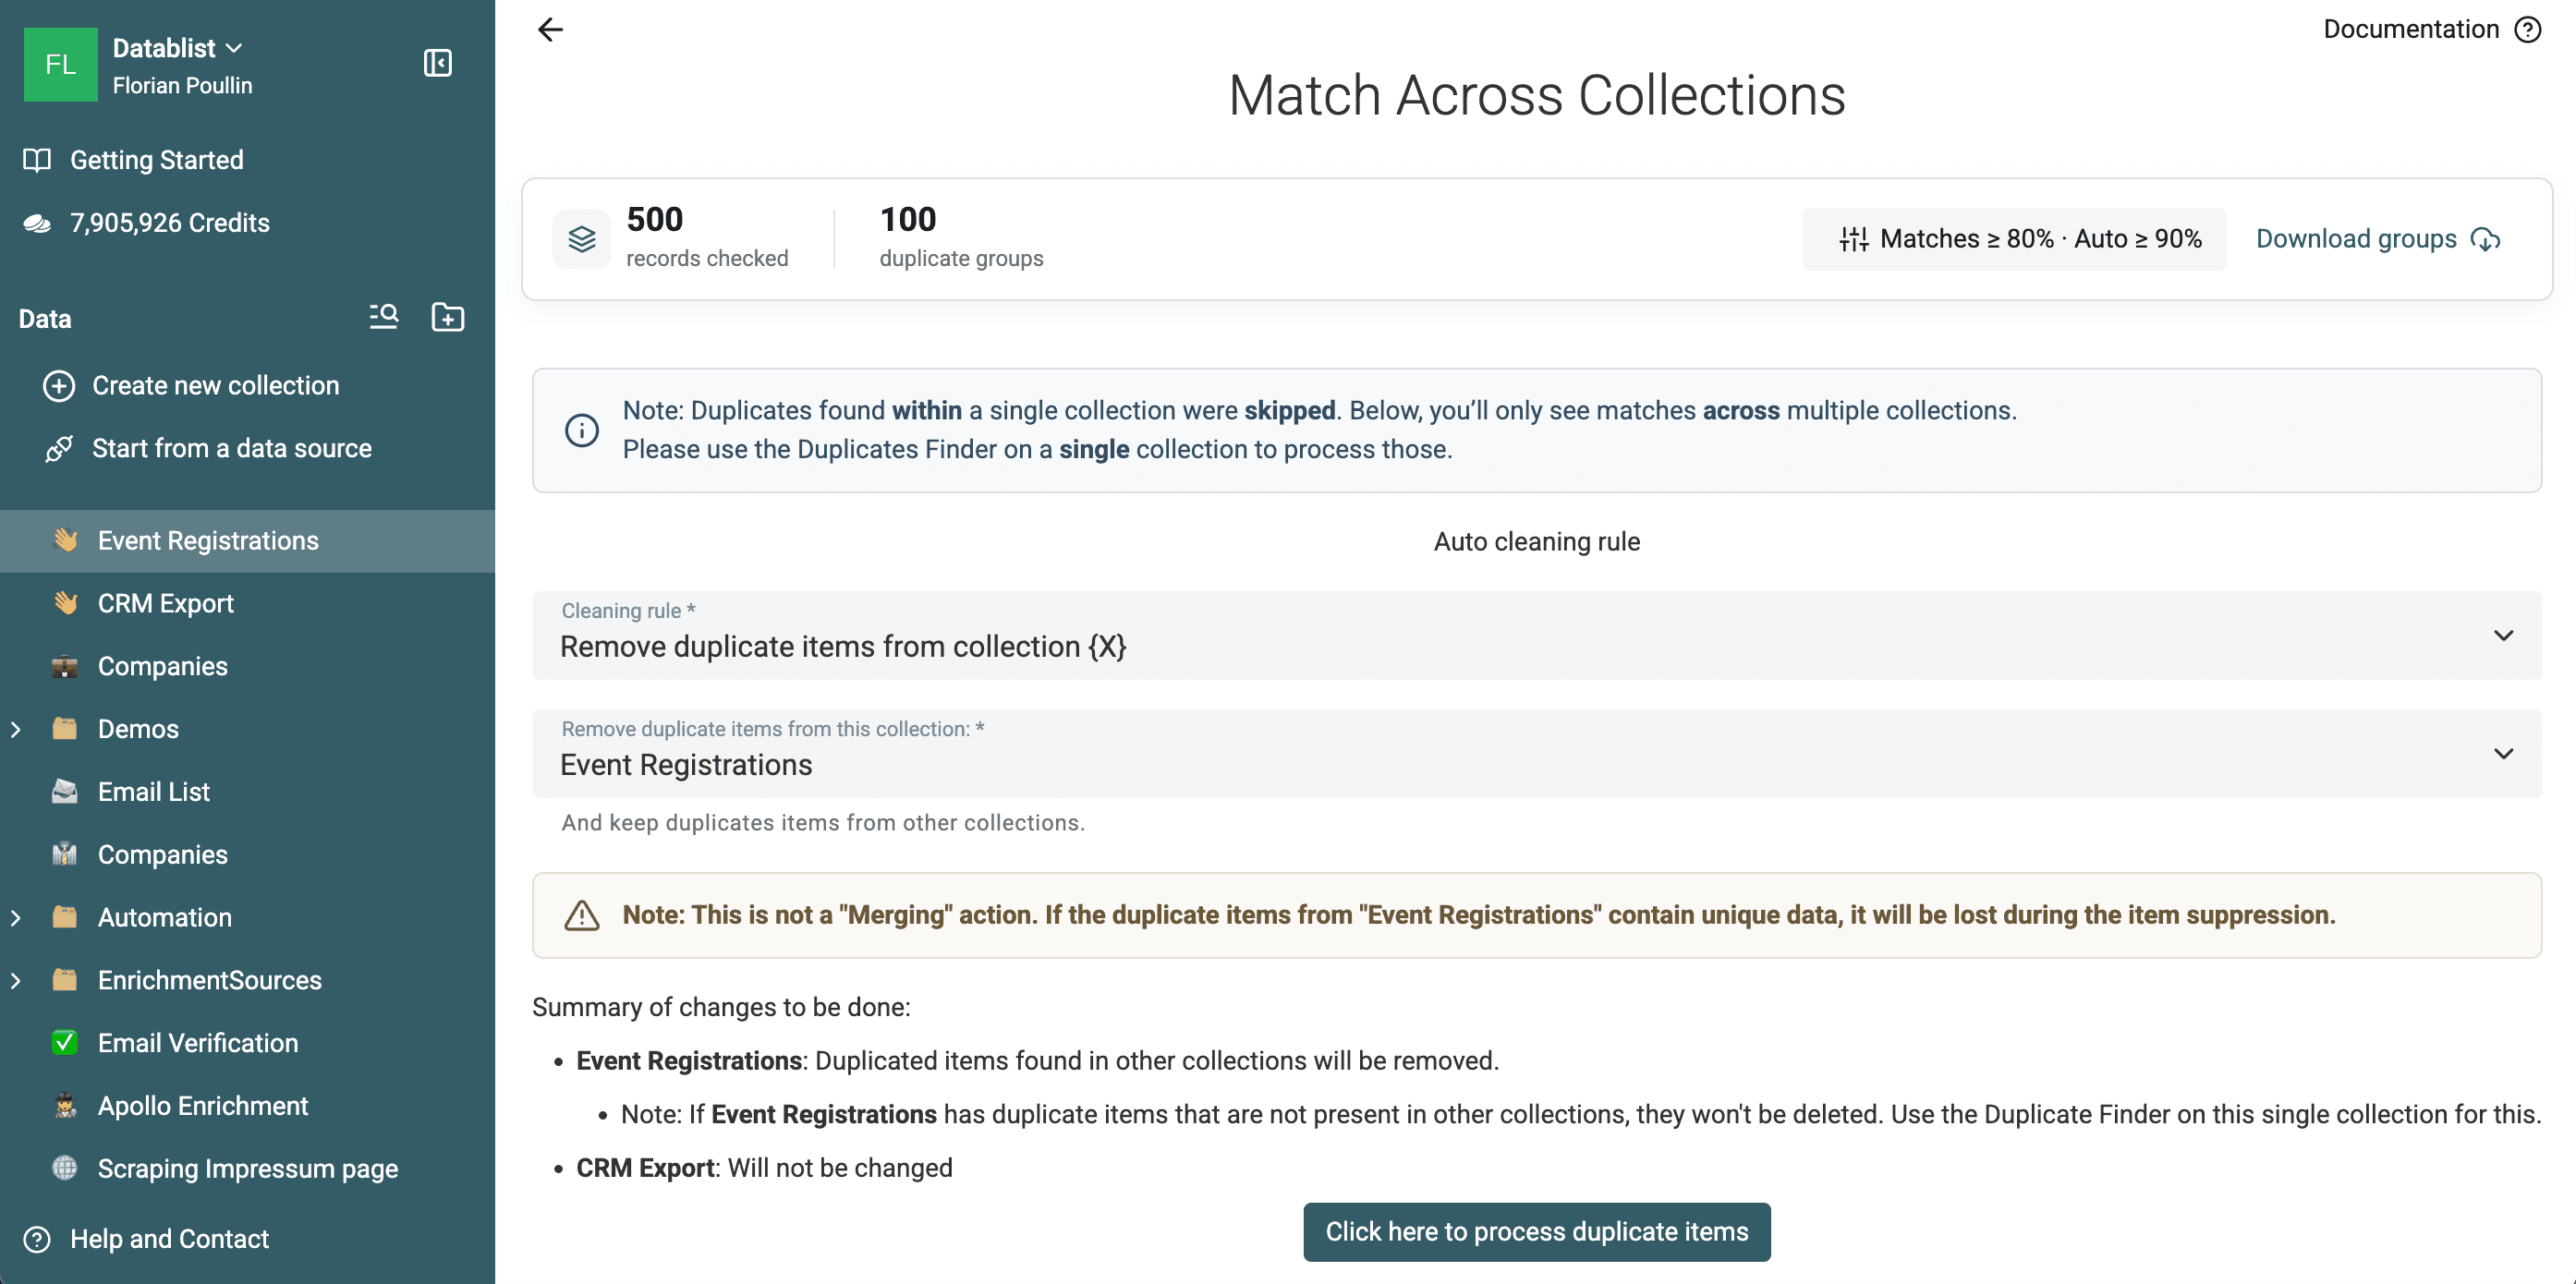
자동 cross-collection cleaning은 행을 삭제합니다. 이벤트의 고유 값을 CRM에 merge하지는 않습니다. 신규 레코드에 보존할 정보가 있다면 먼저 그룹을 내보내거나 검토하세요.
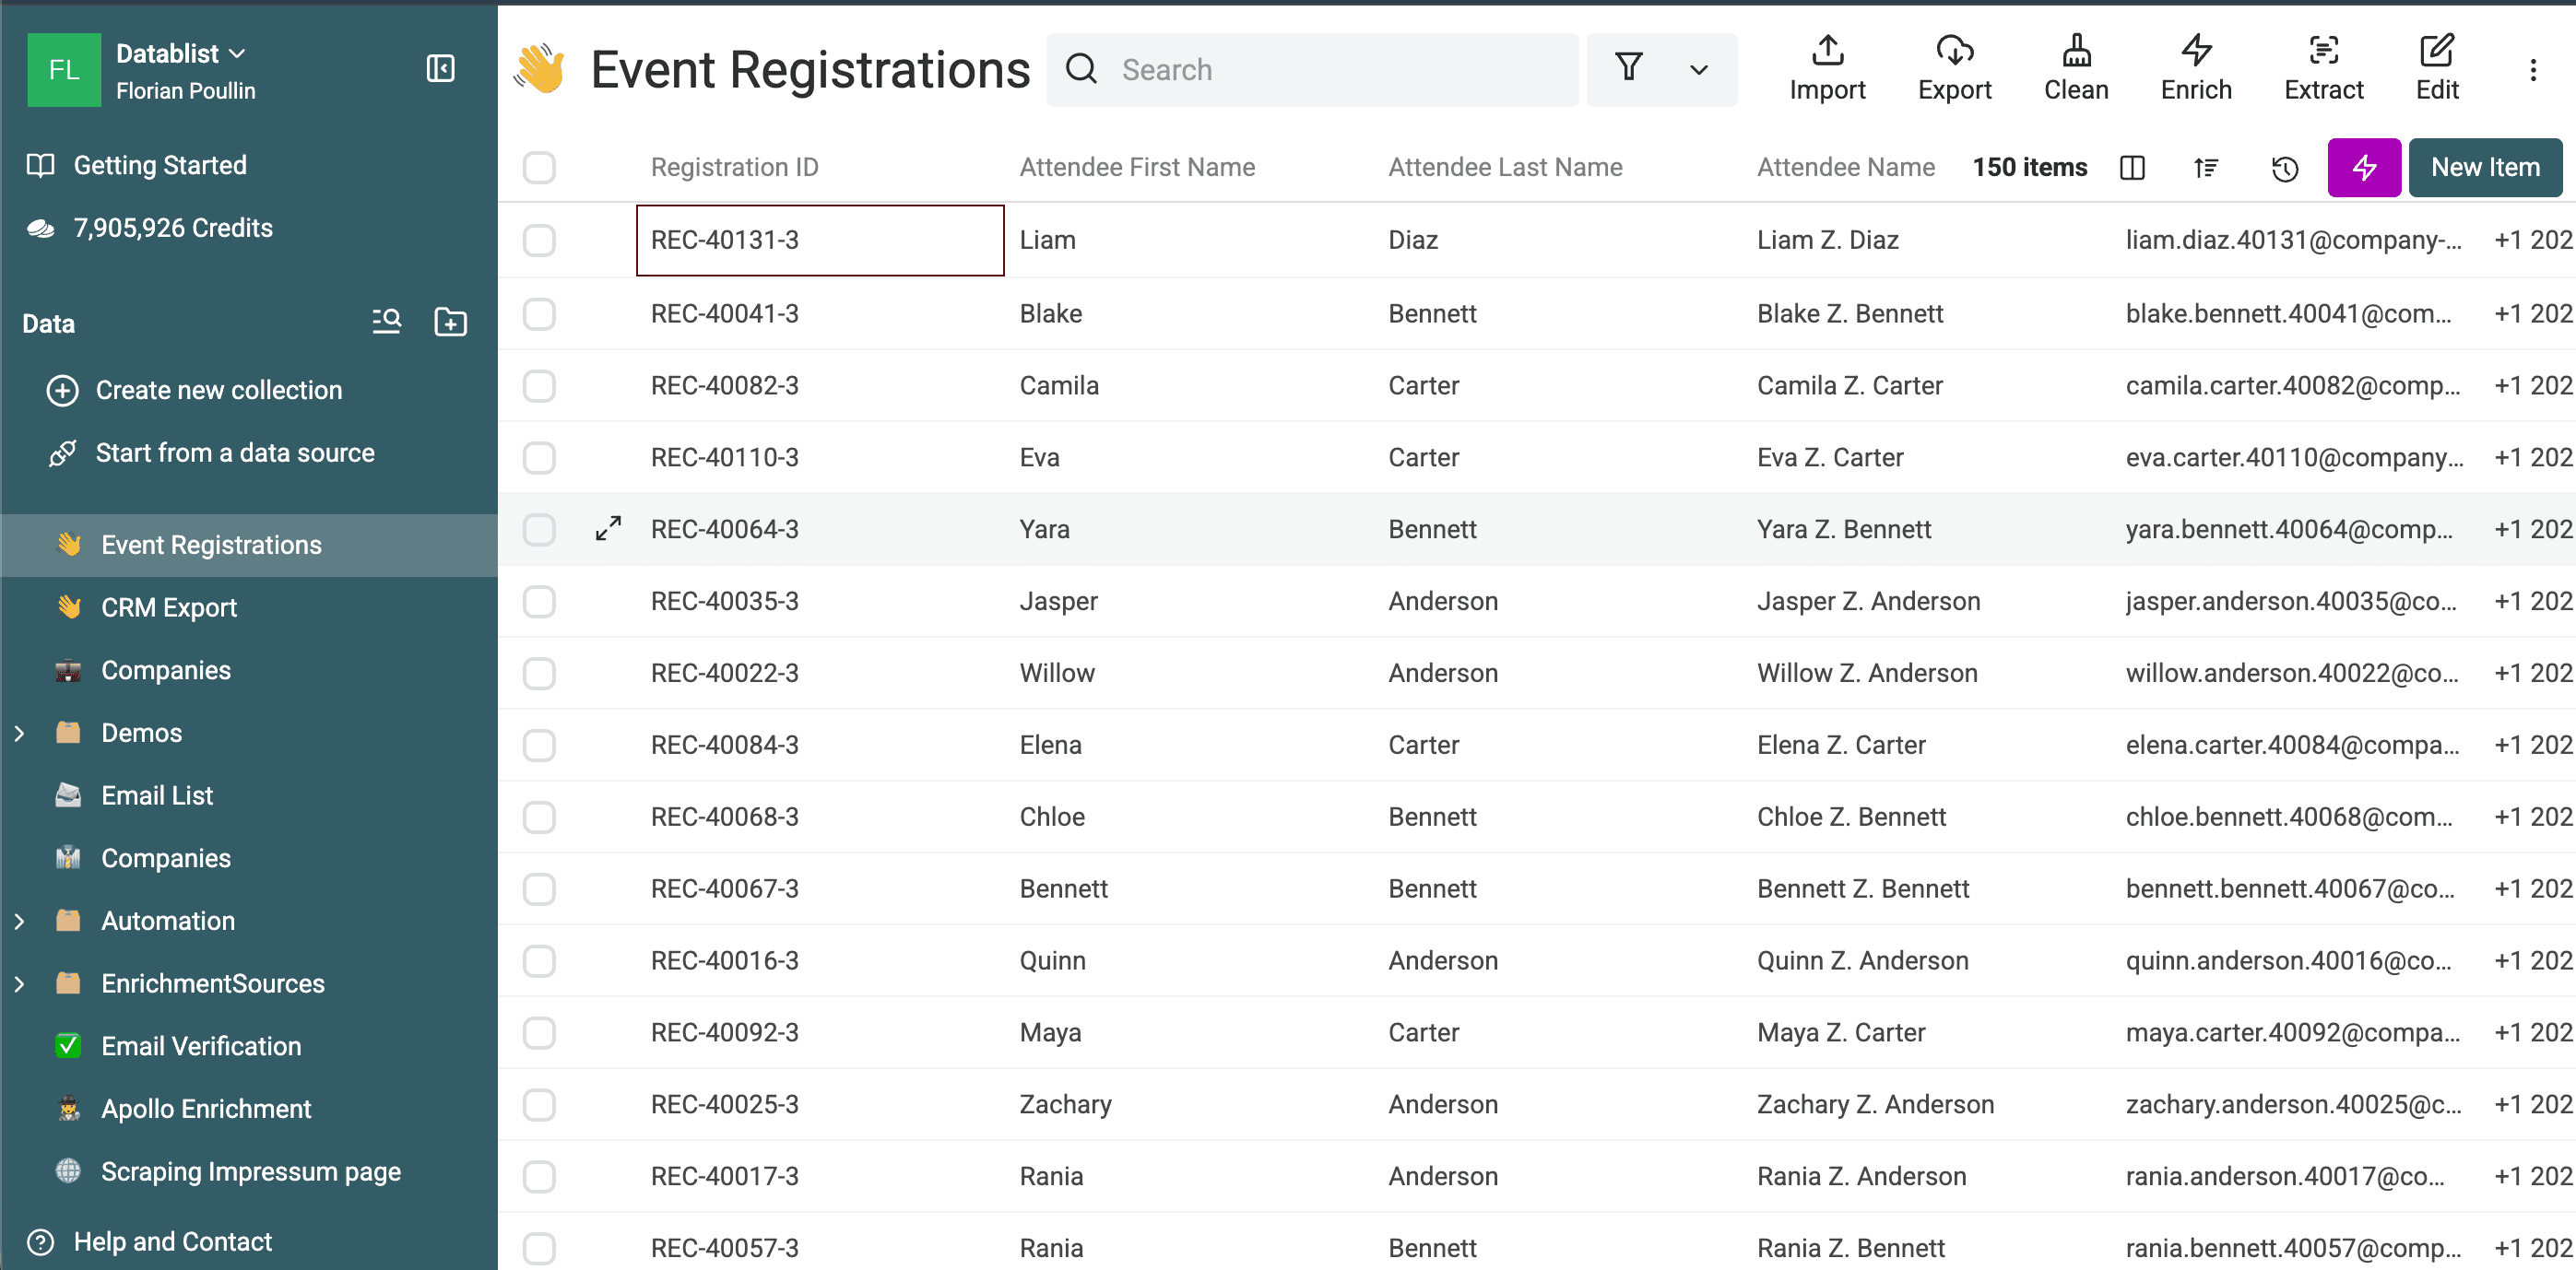
중복 100개를 처리하면 Event Registrations에는 순수 신규 연락처 150개가 남습니다.
Cross-collection matching은 Premium 기능입니다. collection mapping 및 processing option은 여러 CSV 또는 Excel 파일의 중복 제거 상세 가이드를 참고하세요.
FAQ
온라인에서 리스트 중복을 무료로 제거할 수 있나요?
네. 비로그인 사용자도 Exact 검사를 실행할 수 있습니다. 무료 계정을 만들면 Smart matching과 기타 Free-plan 단일 collection 기능을 사용할 수 있습니다. fuzzy 및 phonetic 알고리즘, 고급 processor, cross-collection matching, configurable survivorship, Custom with AI에는 유료 plan이 필요합니다.
중복 행을 삭제해야 하나요, merge해야 하나요?
하나의 레코드가 기준이며 다른 행에 필요한 정보가 없다면 삭제하세요. 보조 행에 유용한 값이 있다면 merge하세요. Remove preview는 데이터가 삭제될 경우 경고를 표시합니다.
Datablist로 오탈자가 있는 중복도 찾을 수 있나요?
네. Jaro-Winkler와 Levenshtein은 텍스트 유사도를 비교하고 Metaphone은 발음을 비교합니다. 이러한 고급 알고리즘에는 유료 plan이 필요하며, 발견된 match는 반드시 검토해야 합니다.
데이터 손실 없이 중복 행을 merge할 수 있나요?
Datablist는 빈 필드를 채우고, 텍스트 값을 결합하고, 선택한 레코드의 값을 유지하거나 field-level survivorship 규칙을 적용할 수 있습니다. 버리도록 선택한 값은 merge된 레코드에 나타나지 않으므로 preview를 검토하세요.
리스트는 얼마나 클 수 있나요?
Free plan은 브라우저 저장소에서 collection당 최대 100만 item을 지원합니다. 유료 plan에서는 collection당 최대 200만 item을 가져올 수 있습니다. 대규모 local operation의 성능은 브라우저와 기기에 따라 달라집니다.
리스트를 변경하지 않고 중복만 검토할 수 있나요?
네. detection은 원본을 변경하지 않습니다. processing action을 실행하기 전에 그룹을 확인하고, threshold를 조정하고, Why matched를 사용하고, 결과를 검색·정렬하고, 중복 행을 다운로드할 수 있습니다.
모든 설정과 제한 사항은 전체 Duplicate Finder documentation에서 확인하세요.