
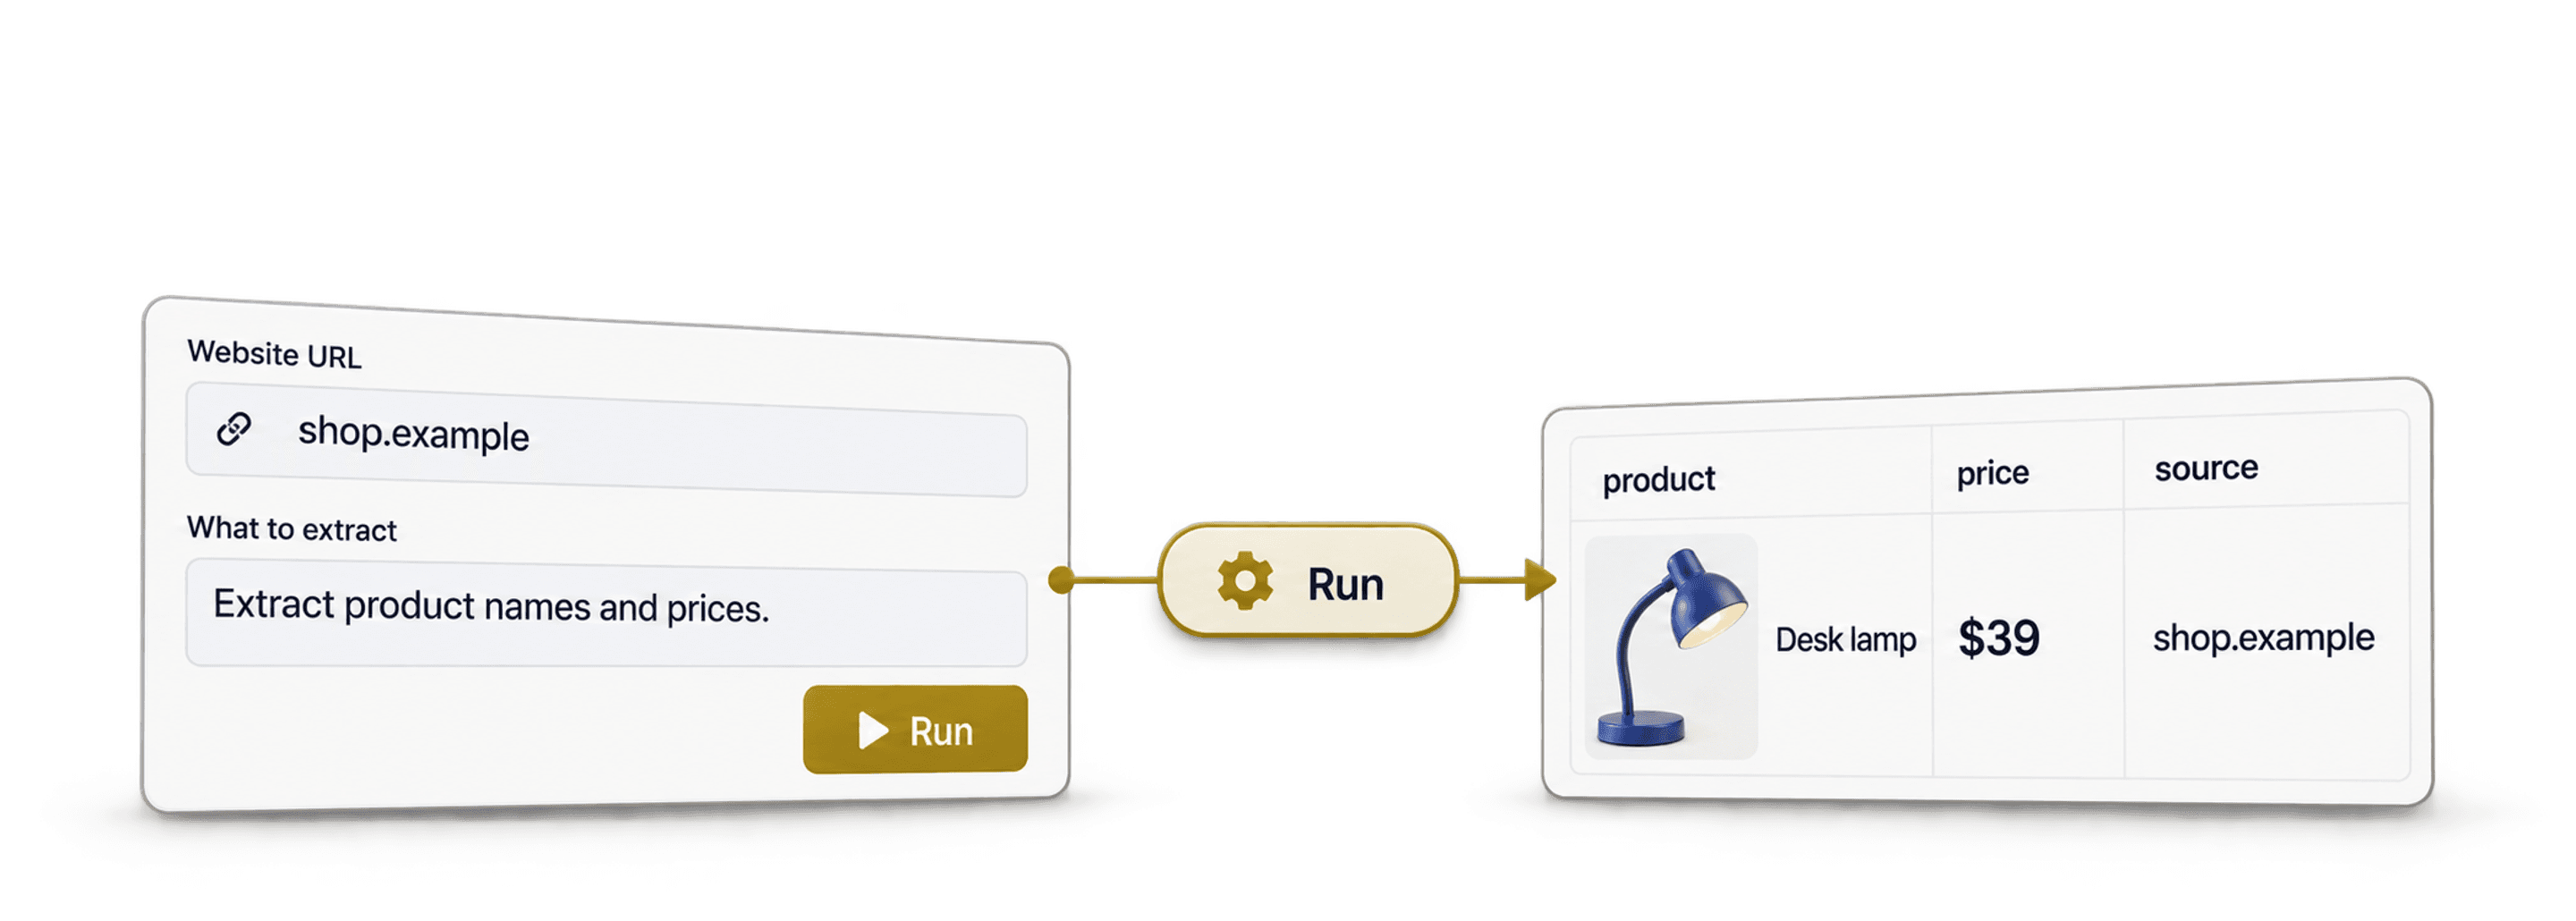
몇 달 전, 저희는 이토록 강력할 것이라고 예상하지 못했던 기능 하나를 출시했습니다.
지금 이 기능은 no-code 웹 스크래핑 업계를 뒤흔들고 있습니다.
바로 Datablist의 “AI Agent - Site Scraper” 소스입니다. 사용자가 입력한 지시에 따라 접근 가능한 웹사이트 콘텐츠에서 구조화된 행을 추출하는 기능입니다.
그리고 몇 달이 지난 지금, 저는 세 가지 사실을 깨달았습니다.
- no-code 스크래핑 업계 전체가 거대한 거짓말이라는 것
- 저희도 모르는 사이 최고의 no-code 스크래퍼를 만들었다는 것
- AI 스크래핑 Agent가 기존의 어떤 no-code 스크래핑 도구보다 강력하고, 사용하기 쉽고, 빠르다는 것
📌 바쁜 분을 위한 요약
이 글에서는 진정한 no-code 스크래핑에 필요한 모든 것을 설명합니다. API나 CSS selector, 기술 지식이 필요하지 않다는 사실도 보여드립니다. 시간이 없다면 아래 내용만 확인하세요.
문제: 이른바 “no-code” 스크래핑 도구도 여전히 기술 지식을 요구합니다. 웹사이트 구조를 이해하고, 튜토리얼을 보고, 설정에 몇 시간을 써야 하며, 웹사이트가 조금만 바뀌어도 모든 것이 작동을 멈춥니다.
왜 문제인가: 웹사이트에서 데이터를 추출하려고 API와 CSS selector를 배우거나 몇 시간짜리 튜토리얼을 볼 필요는 없어야 합니다. 그래야 “no-code”라는 이름에 걸맞습니다.
해결책: 자연어 지시를 활용하는 Datablist의 AI 기반 스크래핑입니다. 원하는 내용을 설명하면 나머지는 AI가 처리합니다.
이 글에서 배울 내용: no-code 스크래핑 업계의 허상을 살펴보고, 진정한 no-code 스크래핑이 어떤 모습인지 알아봅니다. 바로 활용할 수 있는 사례와 프롬프트 작성 팁도 제공합니다.
No-Code 스크래핑에 Datablist를 사용해야 하는 세 가지 이유
- 진정한 no-code 방식으로, 원하는 내용을 자연어로 설명하기만 하면 됩니다
- JavaScript, pagination, 동적 콘텐츠가 적용된 복잡한 웹사이트도 처리합니다
- 깨지기 쉬운 CSS selector 기반 스크래퍼와 달리 웹사이트 변경에 대응합니다
이 글에서 다룰 내용
No-Code 스크래핑 업계와 그 거짓말
이 섹션에서는 no-code 스크래핑 업계가 만들어 낸 오해와 눈속임을 짚어봅니다. 사실 대부분의 “no-code” 도구는 진정한 no-code가 아닙니다. 기술적 복잡성을 조금 다른 형태로 포장했을 뿐입니다.
애초에 코드는 문제가 아니었습니다
잠시 생각해 보세요. 코드는 애초에 문제가 아니었습니다. 코딩할 줄 안다면 코드로 직접 스크래핑했을 테고, 처음부터 no-code 솔루션을 찾지도 않았을 것입니다.
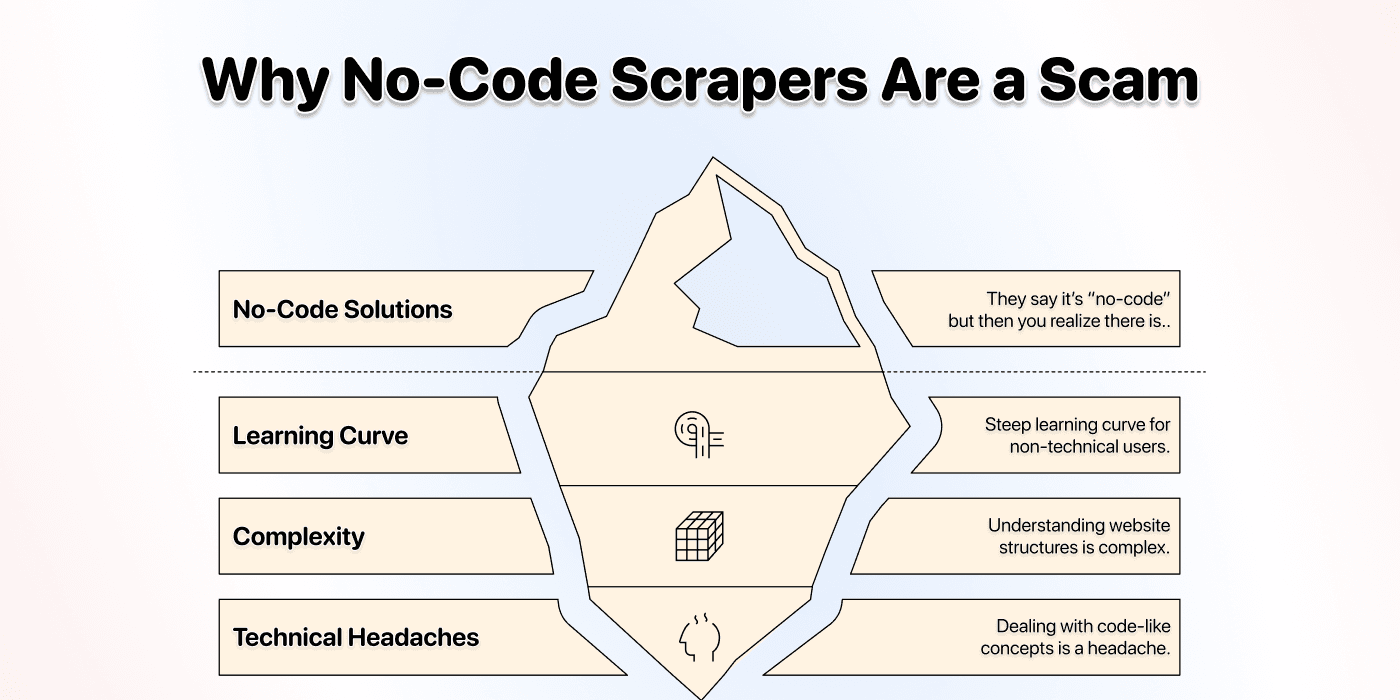
웹사이트 하나를 스크래핑하려고 코딩까지 배우고 싶지 않기 때문에 no-code 솔루션을 찾는 것입니다. 하지만 영리한 판매자들은 반쪽짜리 솔루션을 내놓았습니다. 여전히 다음과 같은 일을 해야 하는 솔루션입니다.
- 가파른 학습 곡선 감당하기
- 여러 튜토리얼 시청하기
- 웹사이트 구조 이해하기
때로는 CSS selector처럼 코드와 유사한 개념까지 다뤄야 합니다.
진짜 문제는 code냐 no-code냐가 아니었습니다.
진짜 문제는 늘 학습 부담과 복잡성, 기술적인 골칫거리였습니다.
업계가 판매하려 했던 것
아래 세 가지 방식도 맞춤형 스크래핑을 구성할 때 설정 작업이 필요할 수 있습니다. 미리 제작된 template과 자동 데이터 감지 기능을 사용하면 일부 작업을 줄일 수 있으므로, 필요한 필드와 pagination을 지원하는지 확인하세요.
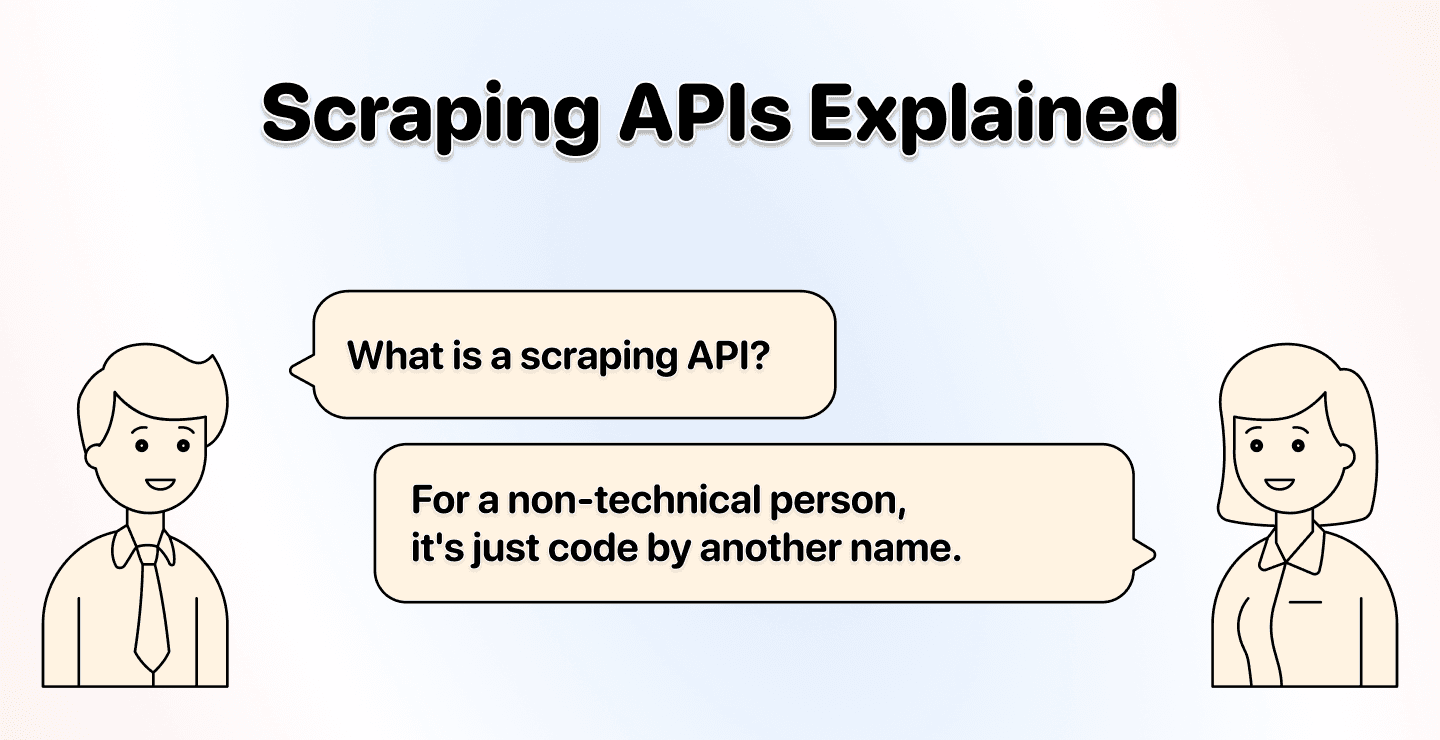
API 기반 스크래퍼
이런 도구는 Python이나 JavaScript를 작성하지 않는다는 이유로 “no-code”를 내세웁니다. 하지만 알려 주지 않는 사실이 있습니다.
여전히 다음 요소를 다뤄야 합니다.
- 웹사이트 DOM 구조
- CSS selector
- HTML tag
엄밀히 말하면 코딩은 아니지만, 그에 못지않게 기술적인 작업입니다. 사람이 원하는 바를 기계가 읽을 수 있는 selector로 바꾸는 일이므로, 사실상 단계만 더 늘어난 프로그래밍과 다르지 않습니다.
Click-and-Point 도구
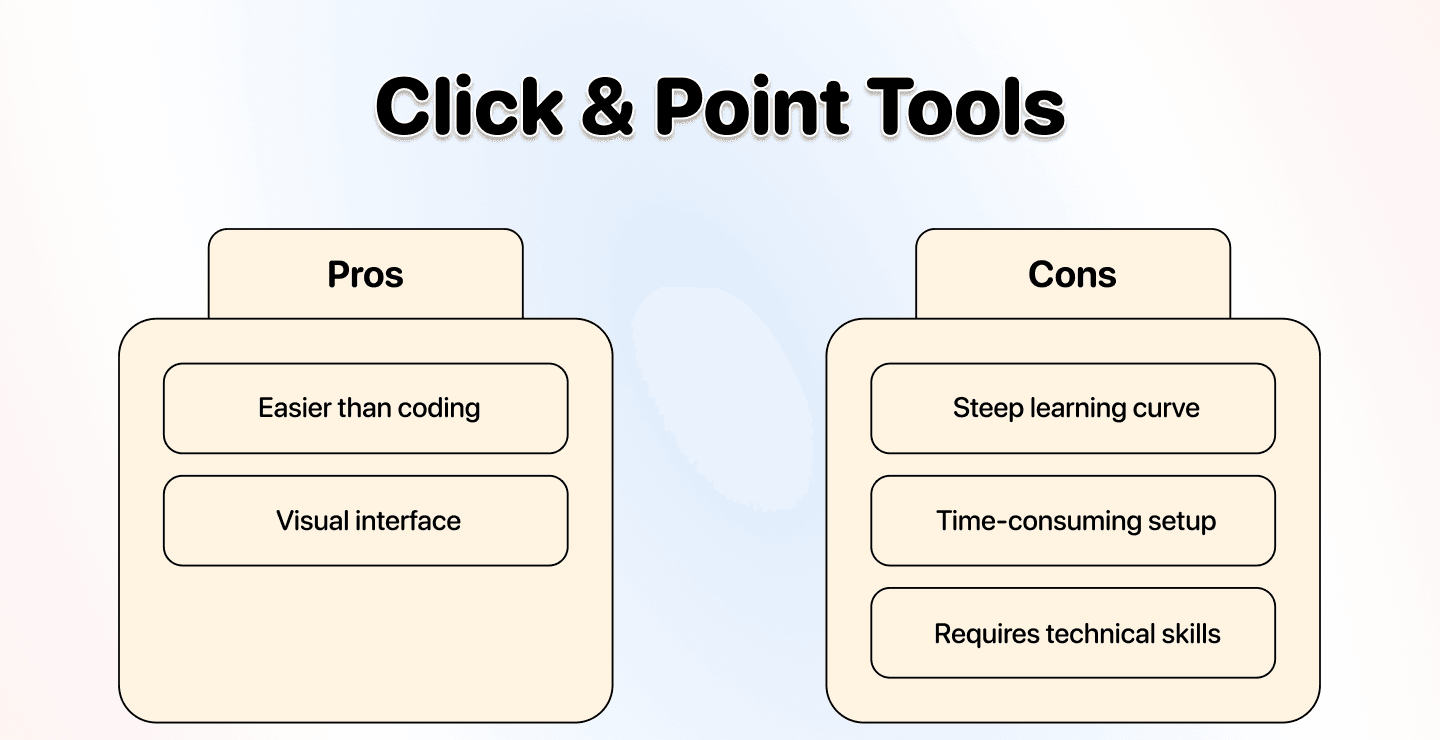
이 방식은 조금 더 쉽지만, 여전히 웹사이트가 어떻게 구성되어 있는지 이해해야 합니다. 요소를 직접 클릭할 수 있어 조금 편할 뿐, 골칫거리까지 사라지는 것은 아닙니다.
가장 큰 문제는 무엇일까요? 웹사이트 구조가 바뀌면 모든 설정을 처음부터 다시 해야 한다는 점입니다. 다시 말해 다음 과정을 반복해야 합니다.
- 튜토리얼 다시 보기
- 모든 selector 재설정하기
- 이번에는 제대로 작동하기를 바라기
브라우저 확장 프로그램
전용 앱 대신 브라우저에서 작동하는 click-and-point 도구라고 보면 됩니다. Instant Data Scraper처럼 무료로 제공되는 제품도 많습니다.
이런 도구의 주요 문제는 다음과 같습니다.
- 웹사이트가 한 번만 바뀌어도 모든 작업을 처음부터 다시 해야 함
- 기능과 확장성의 한계
- IP가 차단될 가능성
📘 여기서 주목해야 할 패턴
일반적인 작업이라면 이미 만들어진 template으로 해결할 수도 있습니다. Octoparse의 template 문서에서는 추출 workflow를 직접 만들지 않고 URL이나 keyword를 입력하는 방법을 설명합니다. 자동 감지 가이드에서는 필드와 다음 페이지 control을 감지하는 방법도 안내합니다.
Preview 결과가 필요한 필드와 일치하는지 확인하세요. 적절한 template이 없는 맞춤형 페이지라면 Datablist의 AI Agent - Site Scraper에서 필요한 필드를 자연어로 설명할 수 있습니다. 설정 방식은 달라지지만, 반환된 행과 페이지 범위를 검토하는 과정은 여전히 필요합니다.
실제로 원하는 것
솔직히 말해 여러분이 정말 원하는 것은 no-code 스크래핑이 아니라 골치 아프지 않은 스크래핑입니다. 실제로 이는 다음을 의미합니다.
골칫거리 없음
- CSS selector를 이해하도록 강요하지 않을 것
- 3시간짜리 튜토리얼을 보게 하지 않을 것
- 웹사이트 디자인이 바뀌어도 작동을 멈추지 않을 것
학습 부담 없음
- 바로 시작할 수 있을 것
- 새로운 기술을 배울 필요가 없을 것
결국 원하는 목표를 자연어로 설명하고 결과를 받기만 하면 됩니다. 나머지는 업계가 당연한 것으로 만들어 버린 불필요한 마찰일 뿐입니다.
No-Code 대신 AI 스크래핑을 선택해야 하는 이유
No-code 스크래핑 문제의 해답은 더 나은 click-and-point interface나 더 깔끔한 API가 아닙니다. 기술 계층을 완전히 없애고 자연어를 사용하는 것이 해답입니다.
AI 스크래핑이 진정한 No-Code인 이유
이름 그대로 AI 스크래핑에서는 사용자가 아닌 AI가 웹사이트를 스크래핑합니다. 사용자는 기술 담당자가 아니라 관리자가 됩니다.
AI 기반 no-code 스크래핑에서는 시스템에 무엇을, 어떻게, 언제 해야 하는지만 알려 주면 됩니다. 뒤에 숨은 모든 기술적 복잡성은 AI가 처리합니다.
다음 내용을 이해할 필요가 없습니다.
- CSS selector 또는 HTML 구조
- 웹사이트 DOM architecture
- API endpoint 또는 기술 문서
자연어로 지시하기만 하면 AI 스크래핑 Agent가 나머지를 알아서 처리합니다. No-code 스크래핑은 처음부터 이렇게 쉬웠어야 합니다.
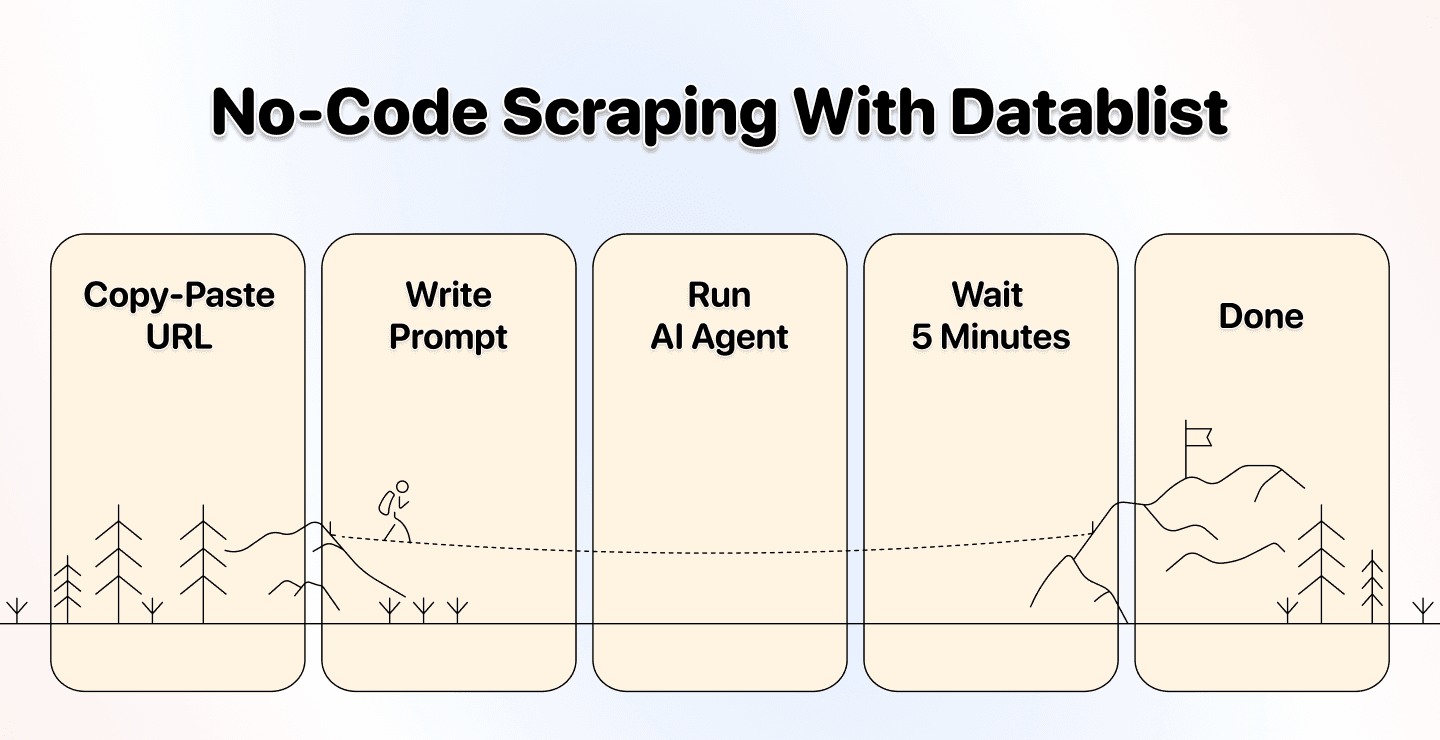
해결책을 제공하는 기업: Datablist.com
처음에 말씀드렸듯 저희가 no-code 업계 전체를 뒤흔들려고 계획했던 것은 아닙니다. 한 사용자가 웹사이트 스크래핑 기능을 필요로 했고, 그 해결책을 만들다 보니 우연히 그렇게 되었습니다.
저희가 만든 AI Agent는 다음과 같은 일을 할 수 있습니다.
- 자연어 지시 이해
- 복잡한 웹사이트 자동 탐색
- JavaScript 비중이 높은 페이지 처리
- 페이지로 나뉜 콘텐츠 처리
- 지능적인 데이터 추출
- …
진정한 혁신은 더 나은 스크래퍼를 만든 데 있지 않았습니다.
기술 지식 자체가 필요 없도록 만든 데 있었습니다.
AI에 원하는 것을 말하면, AI가 데이터를 가져올 방법을 찾아냅니다.
CSS selector도, DOM 검사도, 튜토리얼도 필요 없습니다.
Datablist란?
Datablist는 영업, 마케팅, 채용 담당자와 같은 비개발자를 위해 만들어진 Lead Generation 자동화, 데이터 enrichment, 데이터 cleaning workflow 플랫폼입니다.
스크래핑 소스로 행을 생성하고 collection에서 검토한 다음, 결과를 clean하고 export할 수 있습니다. 다음 단계에 필요할 때만 추가 enrichment를 선택하세요.
Datablist를 선택해야 하는 이유
Datablist의 no-code 스크래핑 방식은 시중의 다른 제품과 다릅니다. 저희는 기술적인 골칫거리를 보기 좋게 포장해 판매한 것이 아니라 AI 스크래핑을 선택했습니다.
사용자에게는 다음과 같은 이점이 있습니다.
진정한 No-Code 솔루션
- 기술 지식이 전혀 필요 없음
- HTML이나 CSS를 이해할 필요 없음
- 웹사이트가 바뀌면 추출 품질을 검토할 수 있음
프롬프트만 작성하면 끝
- 원하는 내용을 자연어로 작성
- AI가 맥락과 의도를 이해
다양한 스크래퍼 Template
- 일반적인 활용 사례를 위한 사전 제작 프롬프트
- 디렉터리 스크래핑 template
- 이커머스 스크래핑 template
- 고객 사례 추출 template
디렉터리 스크래핑을 위한 가장 쉬운 솔루션
- Yellow Pages, Yelp, TripAdvisor, Alibaba에서 작동
- Pagination 자동 처리
10가지 도구를 오가며 Export-Import할 필요 없음
- 데이터가 spreadsheet interface로 바로 이동
- 한곳에서 데이터 edit, filter, enrich 가능
- 완전한 Lead Generation ecosystem 이용 가능
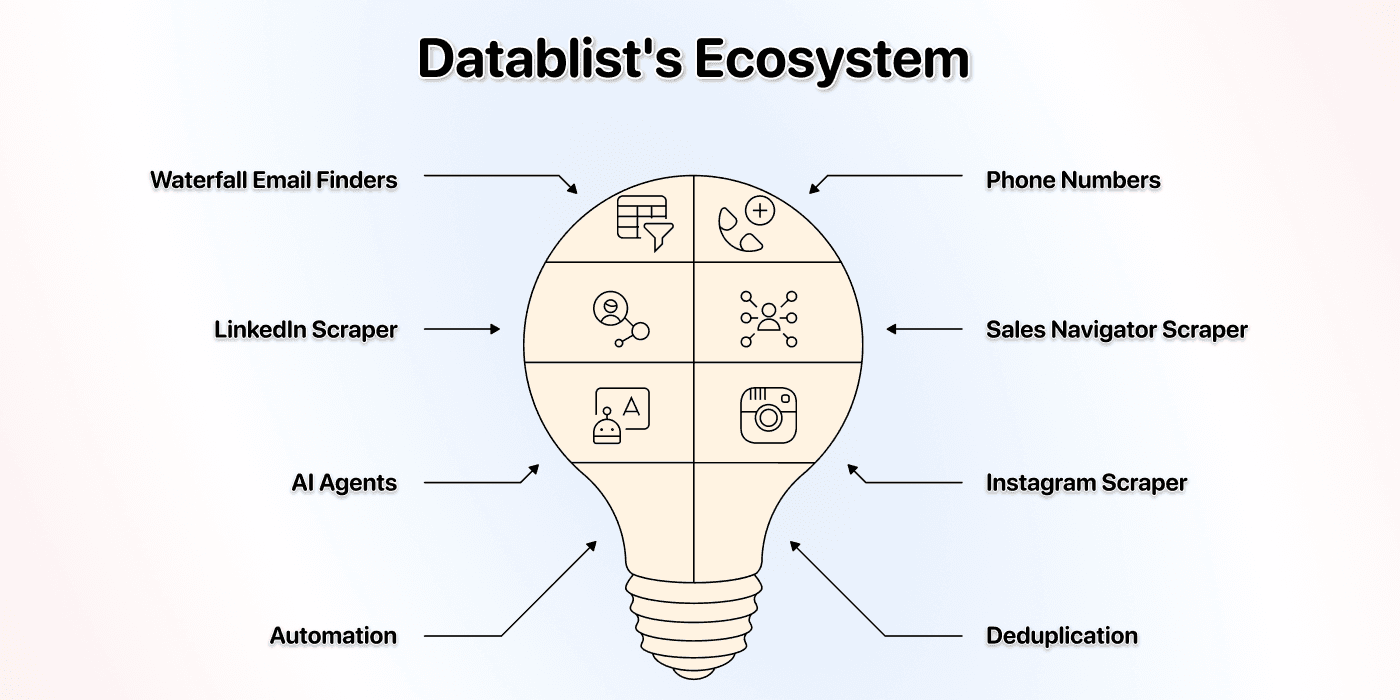
활용 사례와 사용 팁
Datablist를 이용한 웹사이트 및 디렉터리 스크래핑은 물론, 대규모 AI 검색도 어렵지 않습니다. 방법은 단순하고 언제나 같습니다. 원하는 내용을 최대한 구체적으로 설명하세요.
프롬프트 작성 기초
AI 스크래핑 Agent의 다양한 활용 사례를 살펴보기 전에, 지시를 내리는 방법이 얼마나 간단한지 먼저 알아보겠습니다.
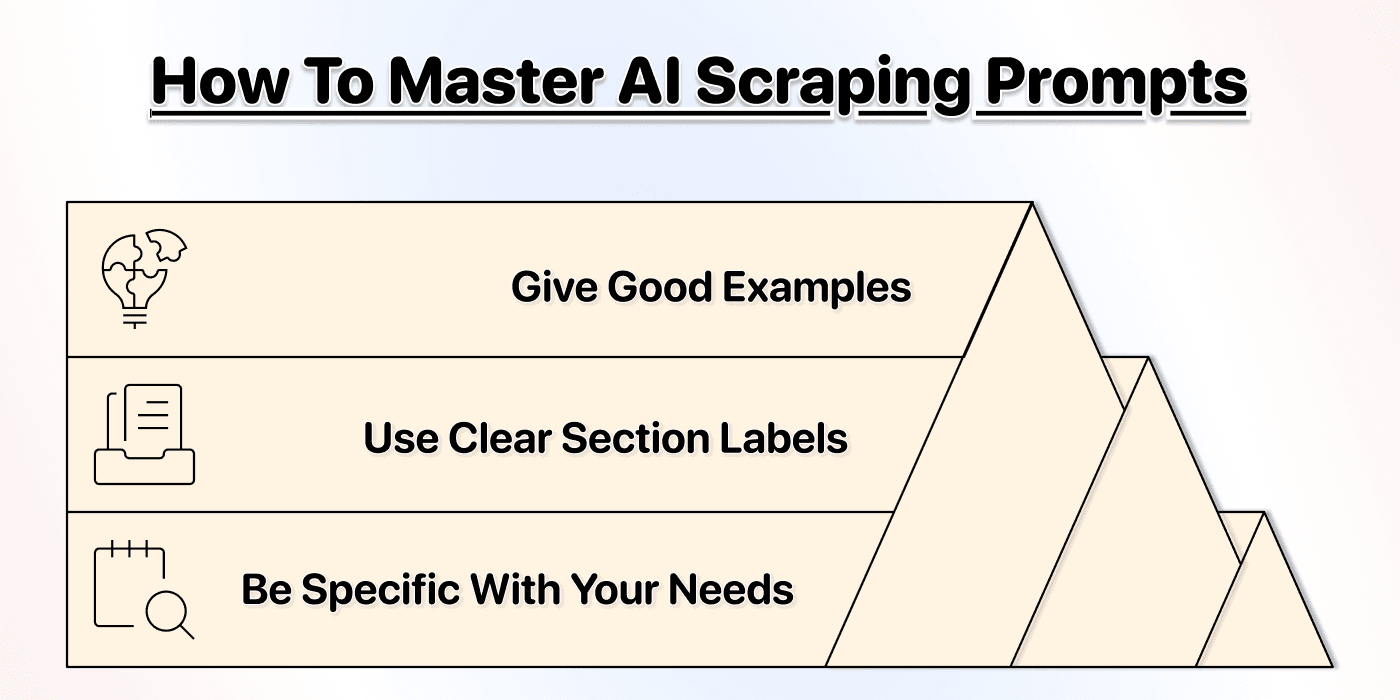
프롬프트 작성 원칙
좋은 프롬프트는 단순합니다. 전문가일 필요도 없습니다. 원하는 바를 명확히 표현하기만 하면 됩니다. 더 나은 프롬프트를 작성하는 데 도움이 되는 몇 가지 팁을 소개합니다.
구체적으로 작성하세요
- “제품 정보를 가져와 줘”라고 쓰지 마세요
- “제품명, 가격, 재고 상태를 가져와 줘”라고 작성하세요
- 가능하면 예시를 포함하세요
이렇게 하면 AI Agent가 잘못 해석할 가능성을 줄이고 원하는 데이터를 얻을 수 있습니다.
섹션 Label을 사용하세요
- 프롬프트를 명확한 섹션으로 구성하세요
- 목표: 무엇을 달성하려는가
- 데이터 항목: 어떤 구체적인 정보가 필요한가
- 형식: 데이터를 어떤 구조로 받을 것인가
- 제약 조건: 무엇을 제외하거나 포함할 것인가
섹션 label을 사용하면 AI Agent가 요청을 더 정확히 이해할 수 있습니다. 필수 사항은 아니지만, 저희가 테스트한 결과 정확도가 크게 향상되었습니다.
예시를 제공하세요
AI Agent가 모든 것을 아는 것은 아닙니다. 일부 웹사이트는 매우 복잡합니다. 예시를 제공하면 false positive를 줄이고 정확도를 높이는 동시에 비용도 낮출 수 있습니다.
AI Agent 프롬프트 작성법을 자세히 설명한 가이드를 확인해 보세요 👈🏽
💡 Pro Tip: Pagination 처리
Datablist의 AI Agent는 페이지로 나뉜 콘텐츠를 자동으로 처리할 수 있습니다. 설정에서 pagination을 활성화하고 최대 페이지 수를 지정하면 됩니다. 결과가 있고 설정된 페이지 한도에 도달하지 않은 동안 Agent가 접근 가능한 다음 페이지 링크를 따라갑니다.
===
필요한 데이터 항목:- 제품명(예: "Classic T-Shirt")
- 가격(예: "$29.99")
- 제품 URL(전체 링크)
- 재고 상태(In Stock / Out of Stock)
===
형식:- 제품마다 한 행씩 반환
- 데이터가 없으면 "N/A" 사용
===
제약 조건:- 프로모션 배너 제외
- 카테고리 페이지가 아닌 실제 제품만 수집
No-Code 스크래핑 활용 사례
No-code 스크래핑의 활용 가능성은 사실상 무궁무진합니다. 지금까지 확인한 가장 인기 있고 효과적인 AI 스크래핑 활용 사례를 소개합니다.
디렉터리
-
Yelp 음식점 데이터 스크래핑
-
TripAdvisor 호텔 정보 스크래핑
-
Alibaba 공급업체 카탈로그 스크래핑
이커머스 웹사이트
기타
- 웹사이트의 모든 고객 사례 스크래핑
- 박람회 웹사이트에서 참가업체 추출
📘 여러 웹사이트를 스크래핑하는 방법
구조가 비슷한 여러 웹사이트를 스크래핑해야 한다면 Datablist's AI Research Agent를 이용해 웹사이트 목록을 한꺼번에 처리할 수도 있습니다. 이 Agent에는 대규모 AI 검색을 실행할 수 있는 추가 기능도 있습니다.
결론: No-Code 스크래핑에는 새 이름이 필요합니다
No-code 스크래핑은 **“기술 걱정 없는 스크래핑”**으로 이름을 바꿔야 합니다. 사람들이 실제로 원하는 것이 바로 그것이기 때문입니다. 코딩을 못해서 no-code 스크래핑을 찾는 것이 아니라, 데이터를 추출하려고 기술을 새로 배우고 싶지 않아서 찾는 것입니다.
따라서 스크래핑이 핵심 수익 활동이 아니라면 여기에 몇 시간씩 낭비하도록 요구해서는 안 됩니다. 더 나은 API나 더 깔끔한 click-and-point interface가 해답도 아닙니다.
해답은 기술 계층을 완전히 없애는 것, 즉 AI 스크래핑입니다.
Datablist를 사용하면 바로 그렇게 할 수 있으며, 다음과 같은 이점도 얻을 수 있습니다.
- 몇 시간이 아닌 몇 분 안에 결과 확보
- 웹사이트 하나에서 수천 개까지 확장
- 원하는 내용을 자연어로 설명
- 웹사이트 변경에 자동 대응
No-code 스크래핑 문제는 마침내 해결되었습니다. 그것도 우연히 말입니다.
No-Code 스크래핑 FAQ
Datablist로 디렉터리를 스크래핑할 수 있나요?
네. Datablist의 AI Scraping Agent는 디렉터리를 효율적으로 스크래핑하고 pagination도 자동으로 처리하므로, 수동 설정 없이 수천 개의 listing을 추출할 수 있습니다.
실제로 다음과 같은 서비스에서 데이터를 성공적으로 스크래핑했습니다.
- TripAdvisor의 리뷰, 호텔, 음식점 등
- Yellow Pages 비즈니스 listing
- Airbnb 숙소 카탈로그
- Alibaba 공급업체 데이터베이스
- Yelp 비즈니스 정보
- … 그 외 다수
여러 페이지의 데이터를 자동으로 스크래핑할 수 있나요?
네. Datablist의 AI Scraping Agent는 자동 pagination을 지원합니다. 설정에서 최대 페이지 수를 지정하면 Agent가 해당 한도 안에서 접근 가능한 다음 페이지 링크를 따라갑니다. 작업이 끝나면 수집 범위를 확인하세요.
다음과 같은 용도로 활용할 수 있습니다.
- 이커머스 제품 카탈로그
- 여러 페이지로 구성된 디렉터리 listing
- Pagination이 있는 검색 결과
- 블로그 archive
- …
Datablist Scraping Agent의 이용 요금은 얼마인가요?
Datablist AI Agent의 요금은 사용량 기반이며 스크래핑 작업의 복잡도에 따라 달라집니다. Yellow Pages 같은 디렉터리는 비용이 훨씬 낮으며, 처리할 페이지 수와 필요한 작업량에 따라 달라집니다. 대규모 batch의 비용을 추산하기 전에 소규모로 먼저 실행해 보세요.
No-Code 스크래핑이란 무엇인가요?
No-code 스크래핑은 코드를 작성하거나 기술 지식을 사용하지 않고 웹사이트에서 데이터를 추출하는 과정입니다. 진정한 no-code 스크래핑이라면 HTML, CSS selector, API를 몰라도 원하는 내용을 자연어로 설명하고 결과를 받을 수 있어야 합니다.
Datablist는 JavaScript 기반 웹사이트도 처리하나요?
네. Datablist의 AI Agent는 JavaScript 비중이 높은 웹사이트도 스크래핑할 수 있습니다. 고급 설정에서 “Render HTML” option을 활성화하면 JavaScript가 로드될 때까지 기다린 후 데이터를 추출합니다.
초기 페이지 로드 후 콘텐츠를 동적으로 불러오는 React, Vue, Angular 기반의 최신 웹사이트에서는 꼭 필요한 설정입니다.
No-Code 스크래핑과 기존 웹 스크래핑의 차이는 무엇인가요?
기존 웹 스크래핑에는 코딩 지식(Python, JavaScript)이나 기술 역량(CSS selector, XPath)이 필요합니다. No-code 스크래핑은 visual interface를 제공하거나, Datablist처럼 자연어를 이해해 이러한 요건을 없앱니다.
AI 스크래핑은 CSS Selector 방식과 어떻게 다른가요?
CSS selector 기반 스크래퍼는 웹사이트 HTML의 정확한 구조에 의존합니다. 웹사이트 layout이 바뀌면 스크래퍼가 작동하지 않습니다.
AI 스크래핑은 콘텐츠의 위치뿐 아니라 의미를 이해합니다. HTML class 이름이 달라져도 “이것이 제품 가격이다”라고 식별할 수 있습니다. 따라서 일부 layout 변경은 견딜 수 있지만, 사이트가 변경되면 추출 품질을 여전히 검토해야 합니다.
No-Code 스크래핑은 합법인가요?
무엇을 수집하고 어떻게 사용하며 어떤 법률이 적용되는지에 따라 달라집니다. No-code 도구를 사용한다고 해서 관련 규정이 달라지는 것은 아닙니다. 개인정보의 경우 공개되어 있다는 이유만으로 개인정보 보호 의무가 사라지지 않습니다. 프랑스 시장을 대상으로 한다면 인터넷 데이터 재사용에 관한 CNIL 지침에서 이러한 차이를 확인할 수 있습니다. 한국에서는 개인정보보호법과 관련 규정도 함께 검토해야 합니다.
- robots.txt와 기타 접근 제한을 준수하세요.
- 로그인해야 접근할 수 있는 영역은 스크래핑하지 마세요.
- 꼭 필요한 필드만 수집하고 적용되는 개인정보 보호 규정을 준수하세요.
- 원본 웹사이트에 부담을 주는 과도한 요청을 피하세요.
고정 규칙 대신 AI 추출을 선택하기 전에 AI 웹 스크래핑 비교 및 정확도 검증 가이드를 읽어 보세요. 어느 한쪽이 모든 layout 변경을 처리할 것이라고 가정하지 말고, 대표 페이지에서 두 방식을 모두 테스트하세요.
No-Code 스크래핑 설정 및 결과 확인
공개 listing 페이지에서 시작하세요. AI Agent - Site Scraper에 페이지 URL을 입력하고, 출력할 한 행의 형태와 필요한 필드를 설명합니다. 제품 목록이라면 제품명, 표시 가격, 통화, 제품 URL 등을 지정할 수 있습니다. 누락된 값은 빈칸으로 유지하고, 사이트의 콘텐츠는 지시가 아닌 데이터로 취급하도록 요청하세요.
스크래핑 범위를 넓히기 전에 소규모 테스트를 실행하세요. 첫 번째와 마지막 행을 실제 페이지와 대조하고, 가격이 의도한 제품 variant를 나타내는지 확인하세요. 결과에 카테고리 URL이 아닌 제품 URL이 포함되어 있는지도 점검해야 합니다.
Listing에 다음 페이지 링크가 있을 때만 pagination을 활성화하세요. 이 소스는 현재 페이지에서 해당 링크를 추출한 후, 결과가 있고 설정된 최대 페이지 수가 남아 있는 동안 작업을 계속합니다. 최대 페이지 수는 상한선일 뿐, 모든 페이지를 방문한다는 보장이 아닙니다. 추출 결과가 비어 있거나 다음 페이지에 접근할 수 없으면 더 일찍 중단될 수 있습니다.
초기 HTML에 콘텐츠가 없을 때는 JavaScript rendering이 도움이 될 수 있습니다. 다만 로그인, CAPTCHA, 차단된 요청, interactive “load more” control을 반드시 통과할 수 있는 것은 아닙니다. 테스트에서 필수 콘텐츠가 누락된다면 실행 규모를 키우면 해결될 것이라고 가정하지 마세요. 대신 이용 가능한 export 기능이나 승인된 API를 사용해야 합니다. 겹치는 검색을 반복할 때는 제품 URL을 기준으로 중복을 제거하세요.
유용한 no-code 도구는 설정 작업을 줄여 줍니다. 그래도 어떤 데이터를 수집할지 결정하고, 접근 가능 여부를 확인하고, 결과를 검토하며, 원본이 바뀌면 workflow를 유지·관리하는 일은 사용자의 몫입니다.