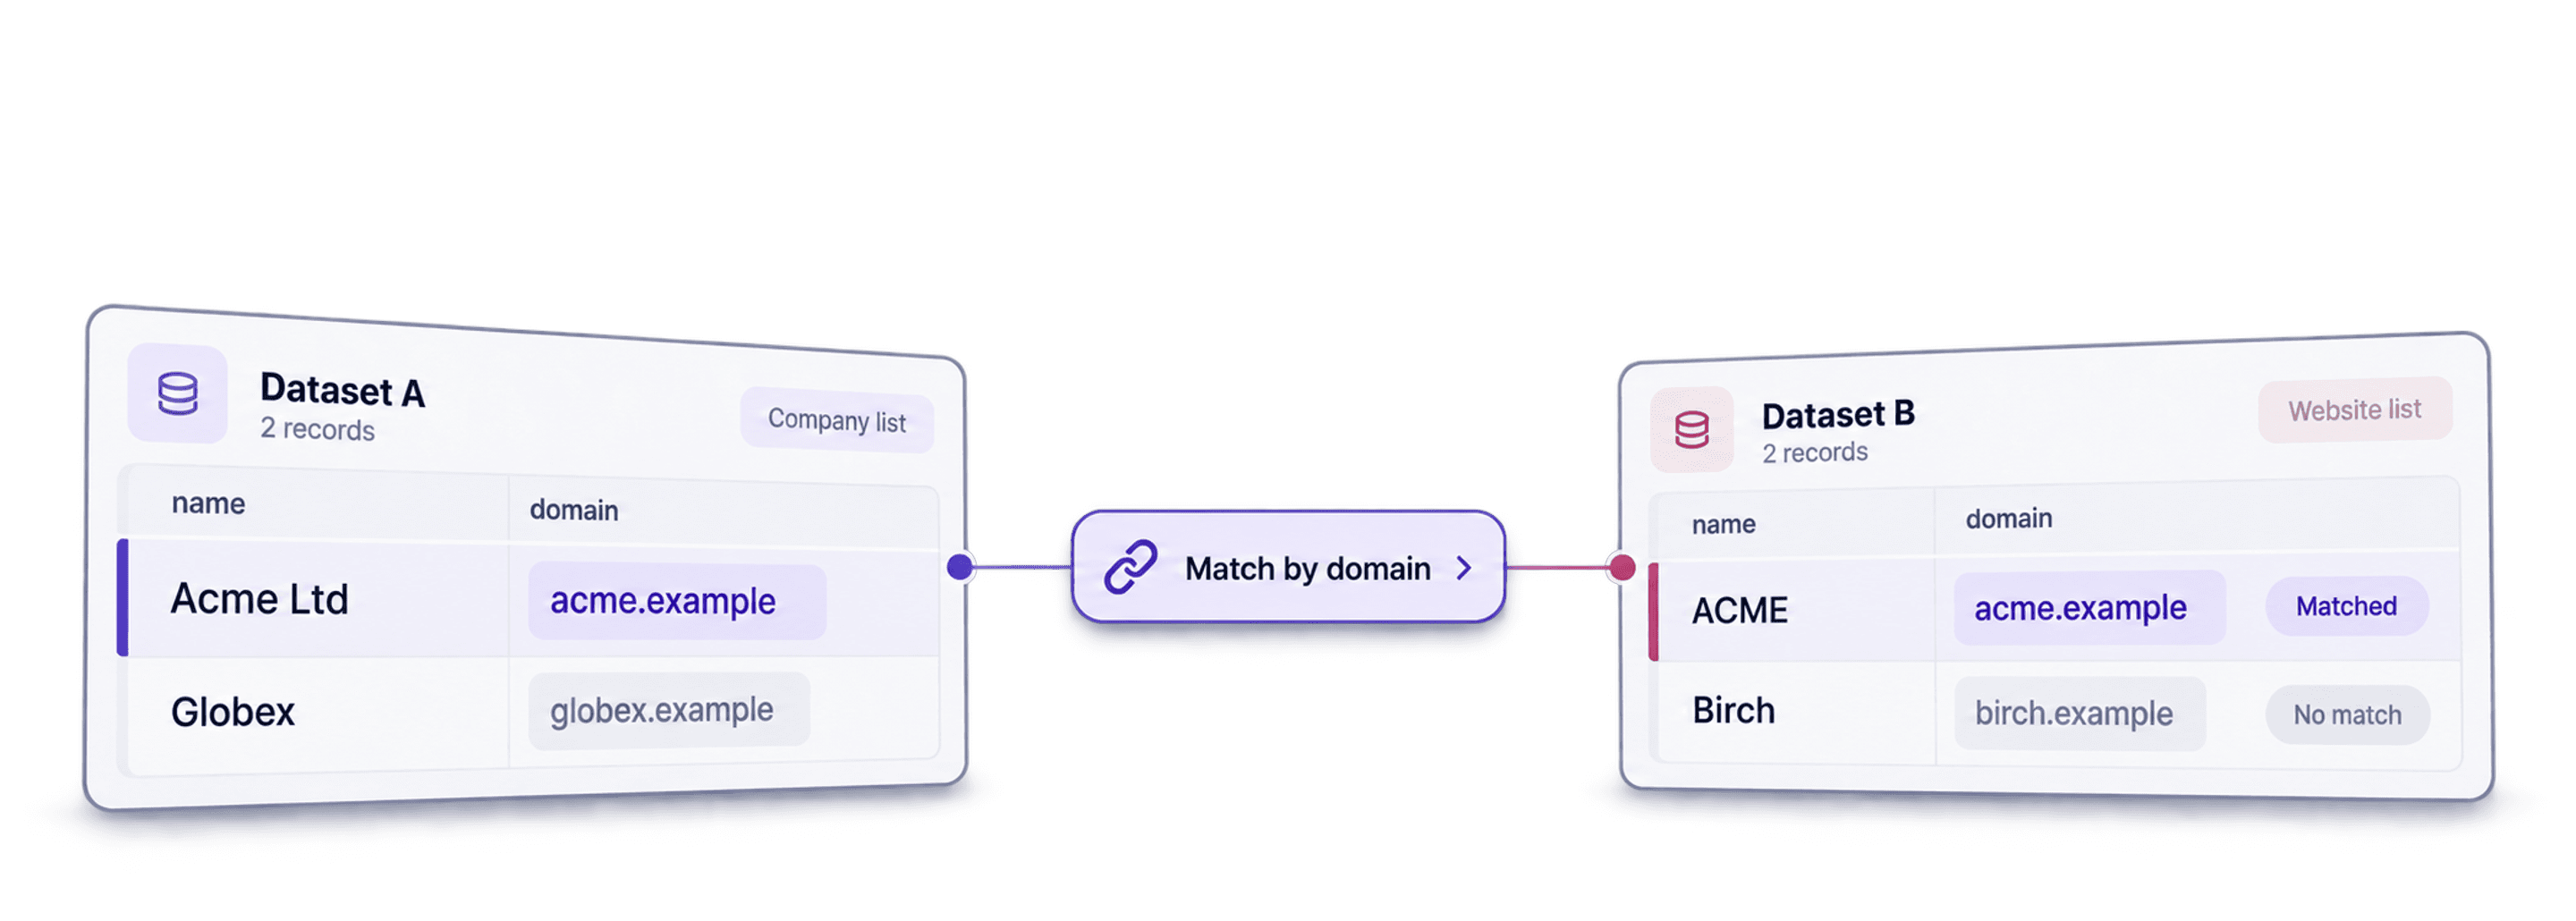
Use una herramienta de data matching cuando dos listas puedan contener las mismas personas o empresas con nombres ligeramente distintos. En Datablist, importe las listas en colecciones, asigne las columnas que quiera comparar, elija un algoritmo de matching y revise los grupos candidatos antes de fusionarlos o exportarlos. Empiece con un identificador exacto, como una dirección de email o el dominio de una empresa. Recurra al fuzzy matching de nombres solo cuando no disponga de un identificador estable y contraste los resultados con un segundo campo.
Por ejemplo, una lista de Leads puede incluir Acme Ltd en acme.com, mientras que otra contiene ACME con el mismo dominio. La coincidencia del dominio ofrece un motivo más sólido para vincular estas filas que la mera similitud entre los nombres. Duplicates Finder de Datablist puede comparar registros dentro de una colección o entre varias colecciones y, después, mostrar los grupos para que usted los revise. Los algoritmos avanzados de matching fonético y fuzzy matching están disponibles en los planes de pago.
Este es un resumen de los aspectos de Data Matching que encontrará en el artículo:
- Cargar sus datasets
- Preparar, limpiar y normalizar los datos
- Cruzar registros dentro de una o varias colecciones
- Deduplicar: eliminar o fusionar grupos coincidentes
Revise las coincidencias antes de fusionar. Dos nombres similares pueden corresponder a personas o empresas distintas, especialmente si son cortos o están abreviados.
Paso 1: Cargar sus datasets
El primer paso consiste en cargar sus datasets en Datablist. Datablist es una herramienta online para gestionar listas. Le permite ver y editar archivos CSV y archivos de Excel. Es la herramienta ideal para gestionar su lista de Leads, limpiar datos de clientes o limpiar datos extraídos mediante scraping.
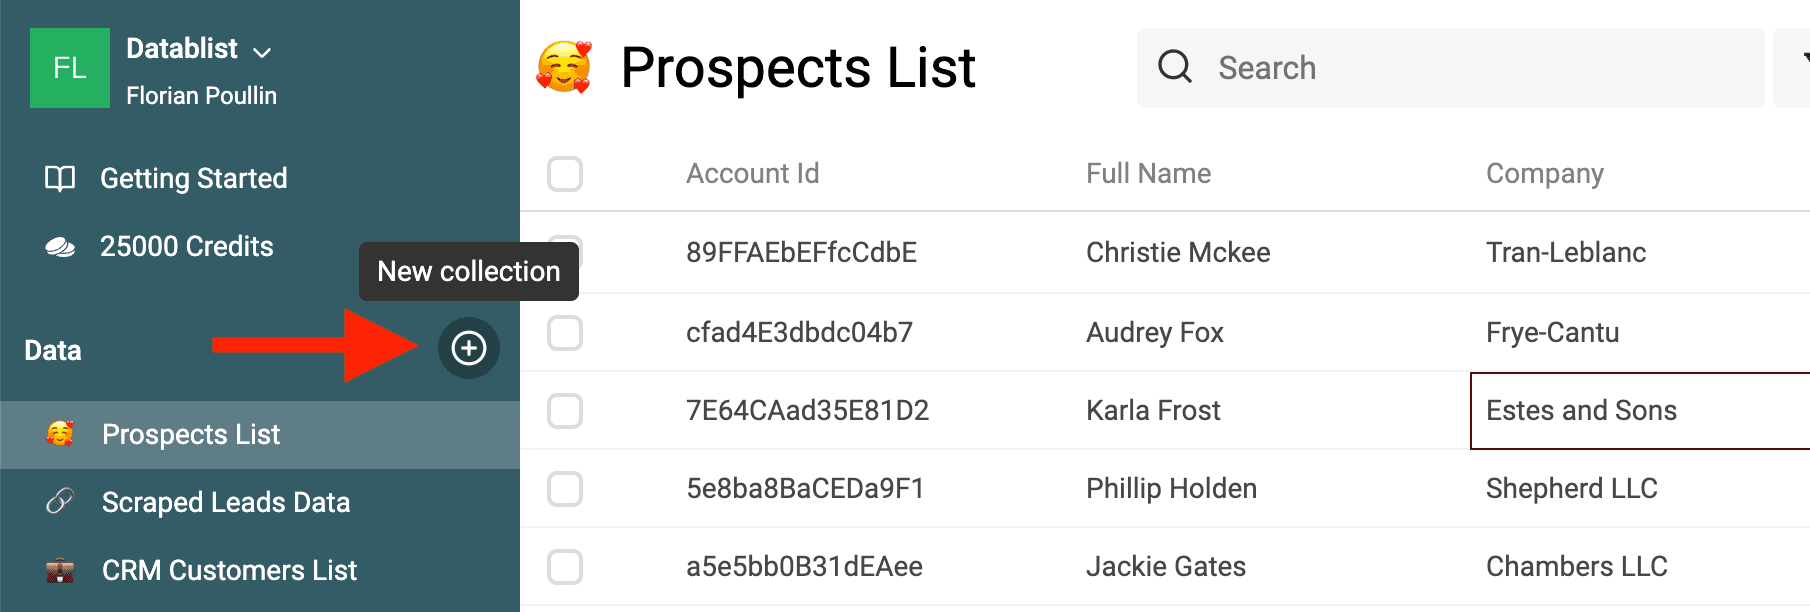
Para empezar, cree una colección donde cargar su primer dataset.
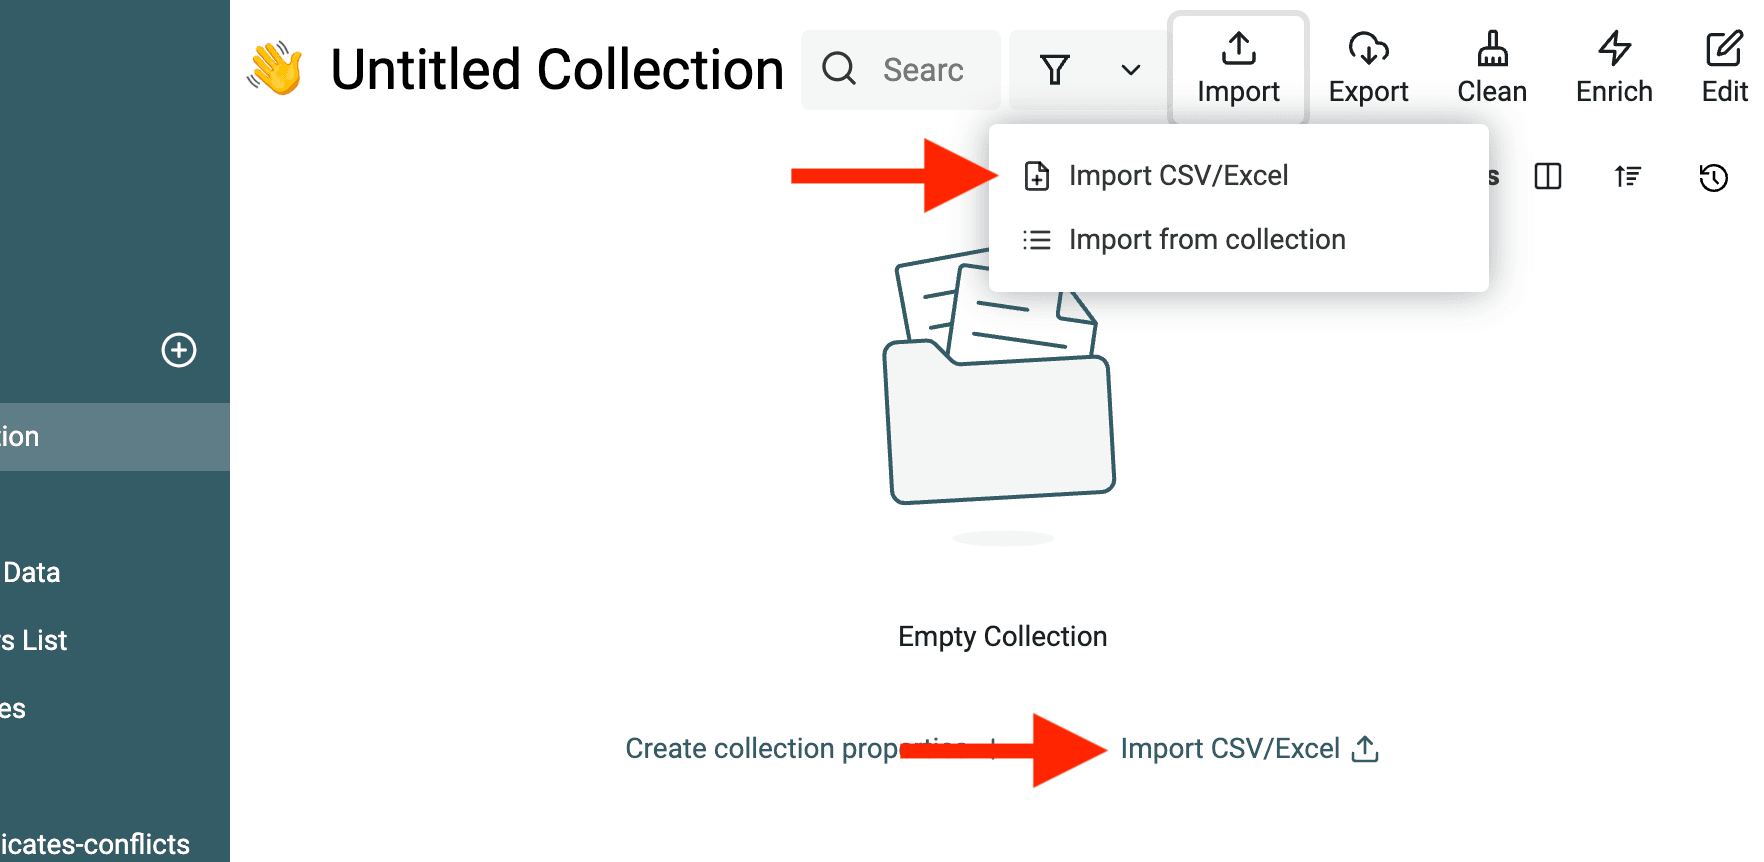
Después, haga clic en el botón Import.
Una vez importado el primer dataset, puede:
- Importar en la misma colección otros datasets con estructuras de datos comunes.
- Importar datasets con estructuras diferentes en colecciones nuevas.
Duplicates Finder de Datablist encuentra registros coincidentes dentro de una única colección o entre colecciones con estructuras de datos diferentes.
Paso 2: Limpiar los datos si es necesario
El segundo paso es la limpieza de datos. Limpiar los datos es un requisito esencial para realizar un data matching fiable, ya que garantiza la precisión y la calidad del proceso. Los datos sucios o sin depurar pueden generar coincidencias incorrectas y resultados poco fiables. En definitiva, la limpieza de datos sienta las bases para que el data matching funcione correctamente.
Cuando aparecen en nombres de personas o empresas, ciertos elementos no aportan información, pero pueden impedir que el algoritmo de deduplicación detecte duplicados.
Datablist incluye varias herramientas de limpieza de datos:
- Eliminar símbolos y signos de puntuación - Los textos obtenidos mediante scraping pueden contener emoticonos, símbolos ASCII o nombres con signos de puntuación. El algoritmo de matching de Datablist los ignora al cruzar los datos, pero pueden impedir la fusión automática durante el proceso de deduplicación.
- Eliminar espacios sobrantes - Basta un espacio adicional entre dos palabras para que dos cadenas se consideren distintas. Los algoritmos de matching de Datablist preprocesan los textos para eliminar estos espacios, aunque también pueden impedir la fusión automática durante el proceso de deduplicación.
- Extraer direcciones de email, URL, etc. de los textos - Si sus datos incluyen texto no estructurado con direcciones de email, URL, menciones, etiquetas u otros elementos, use nuestro Data Extractor para extraer esas entidades y estructurar los datos. El proceso de Data Matching será más sencillo si dispone de entidades estructuradas que comparar.
- Eliminar etiquetas HTML - Otra función de limpieza permite convertir cadenas con etiquetas HTML en texto plano. Así podrá cruzar listas obtenidas mediante scraping que contengan HTML con sus demás datasets.
- Convertir texto a DateTime, Number, Boolean, etc. - Datablist ofrece una estructura de datos real con formatos nativos como DateTime, Number y Boolean. Un paso importante de la limpieza consiste en convertir el texto sin procesar a su formato nativo. Los valores nativos de DateTime, Number, etc. son fundamentales para crear reglas avanzadas de fusión cuando se necesita elegir un registro principal comparando valores, por ejemplo, la fecha más reciente.
- Cambiar mayúsculas y minúsculas para un formato coherente - Unificar el uso de mayúsculas y minúsculas es un paso sencillo pero necesario. Datablist incluye varios algoritmos para transformar el uso de mayúsculas y minúsculas).
- Dividir o fusionar propiedades - Esta función es perfecta para trabajar con datos que contienen varios valores. Si una propiedad incluye varias direcciones de email separadas por comas, punto y coma o espacios, la herramienta Split Property de Datablist creará varias propiedades con una sola dirección en cada una.
- Eliminar o sustituir valores vacíos - Use las funciones de filtrado de Datablist para filtrar valores o filas vacíos.
Consulte nuestra guía de limpieza de datos para ver más ejemplos e instrucciones.
Normalizar nombres de personas
Trabajar con datasets de personas es habitual en la deduplicación de datos. Las listas de clientes, Leads y prospectos son buenos ejemplos. En el mejor de los casos, el data matching de personas se basa en identificadores únicos, como direcciones de email o números de identidad. Si no dispone de estos identificadores, o si quiere cruzar personas entre varios datasets, tendrá que utilizar sus nombres en el proceso.
Preprocesar los nombres de las personas permite que todos sigan un formato uniforme y reduce los errores durante la deduplicación.
Eliminar elementos innecesarios de los nombres
Los nombres de personas pueden presentar muchas variaciones. Es habitual encontrar apodos, abreviaturas, grafías alternativas y caracteres especiales.
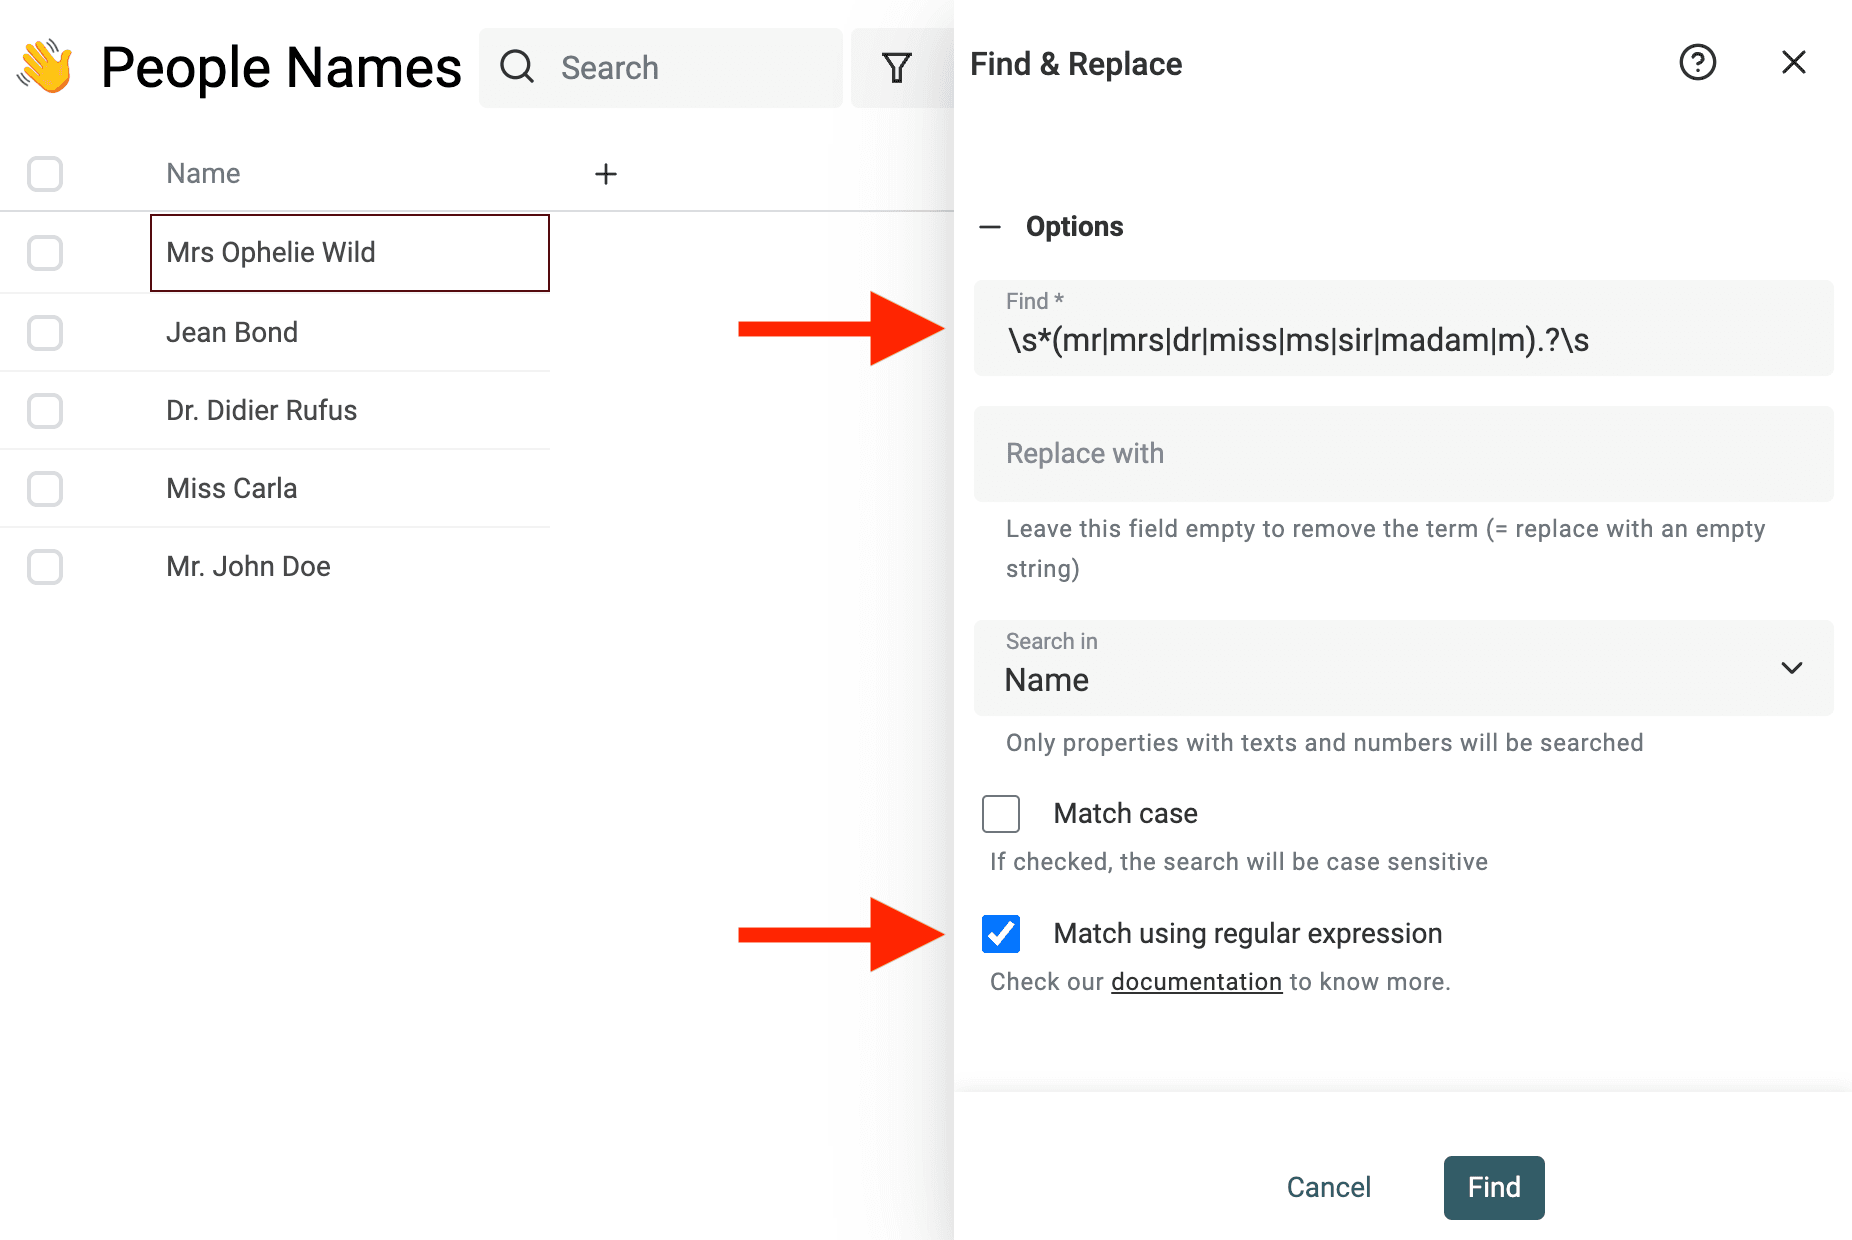
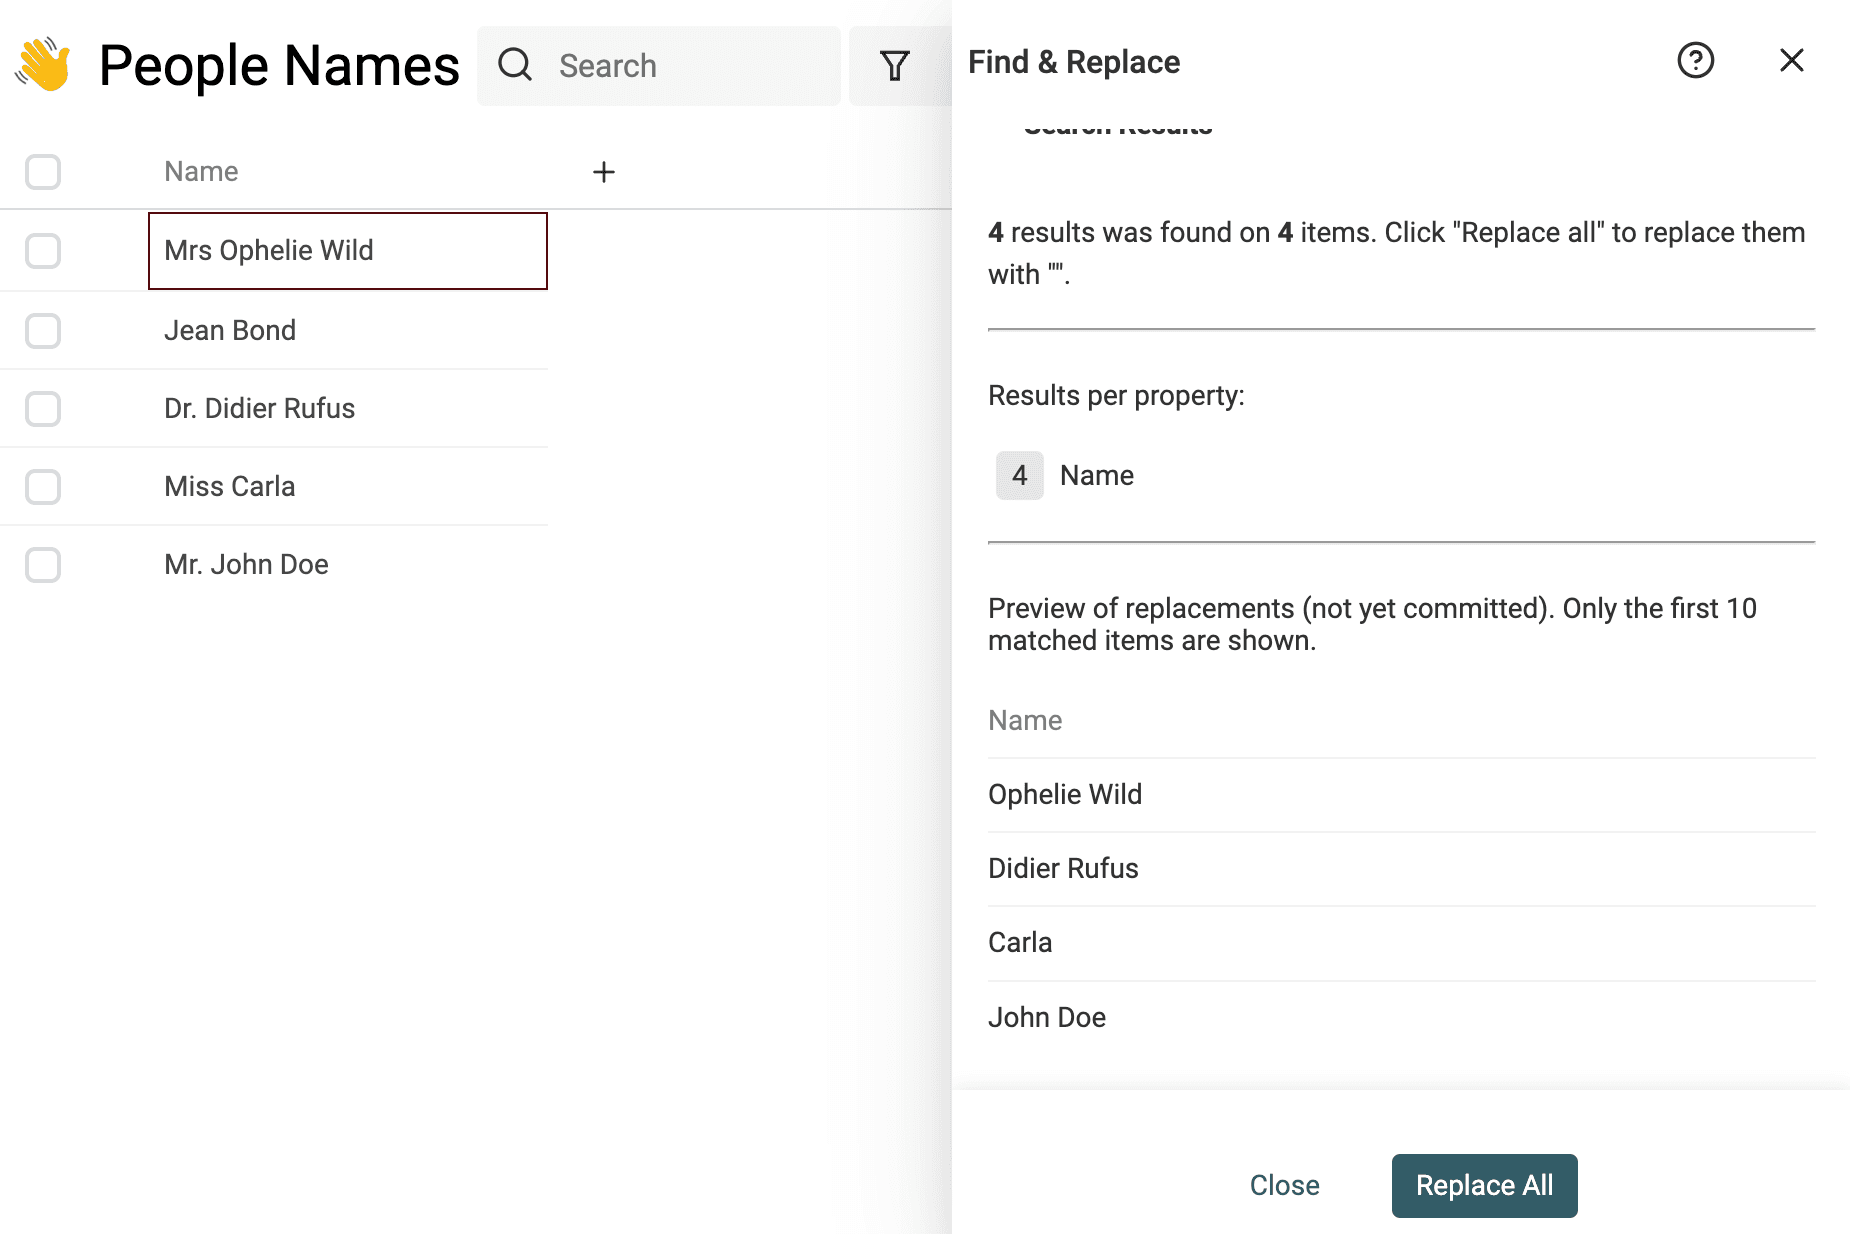
Use la potente herramienta Find & Replace para eliminar prefijos, sufijos, stop words, complementos regionales y otras palabras innecesarias.
Por ejemplo, puede eliminar los tratamientos personales con esta expresión regular:
^\s*(mr|mrs|dr|miss|ms|sir|madam|m).?\s
Y sustituirlos por una cadena vacía.
Notas Si no está familiarizado con las expresiones regulares, solo tiene que contactarnos y le ayudaremos a limpiar sus datos.
Separar un nombre completo en sus partes
Datablist es más que una herramienta de limpieza: también permite enriquecer datos. Algunos ejemplos son el enriquecimiento de Leads y la traducción de archivos CSV con DeepL.
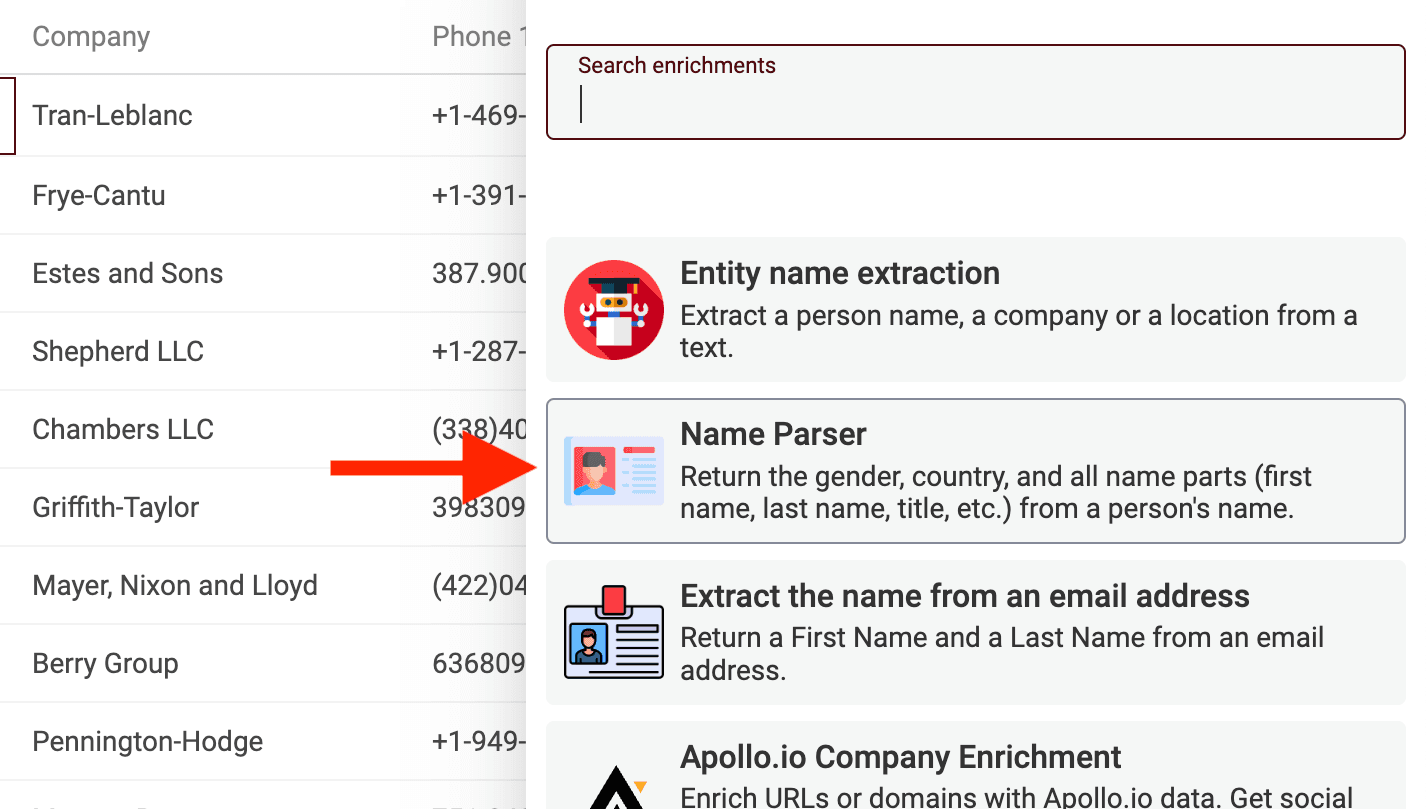
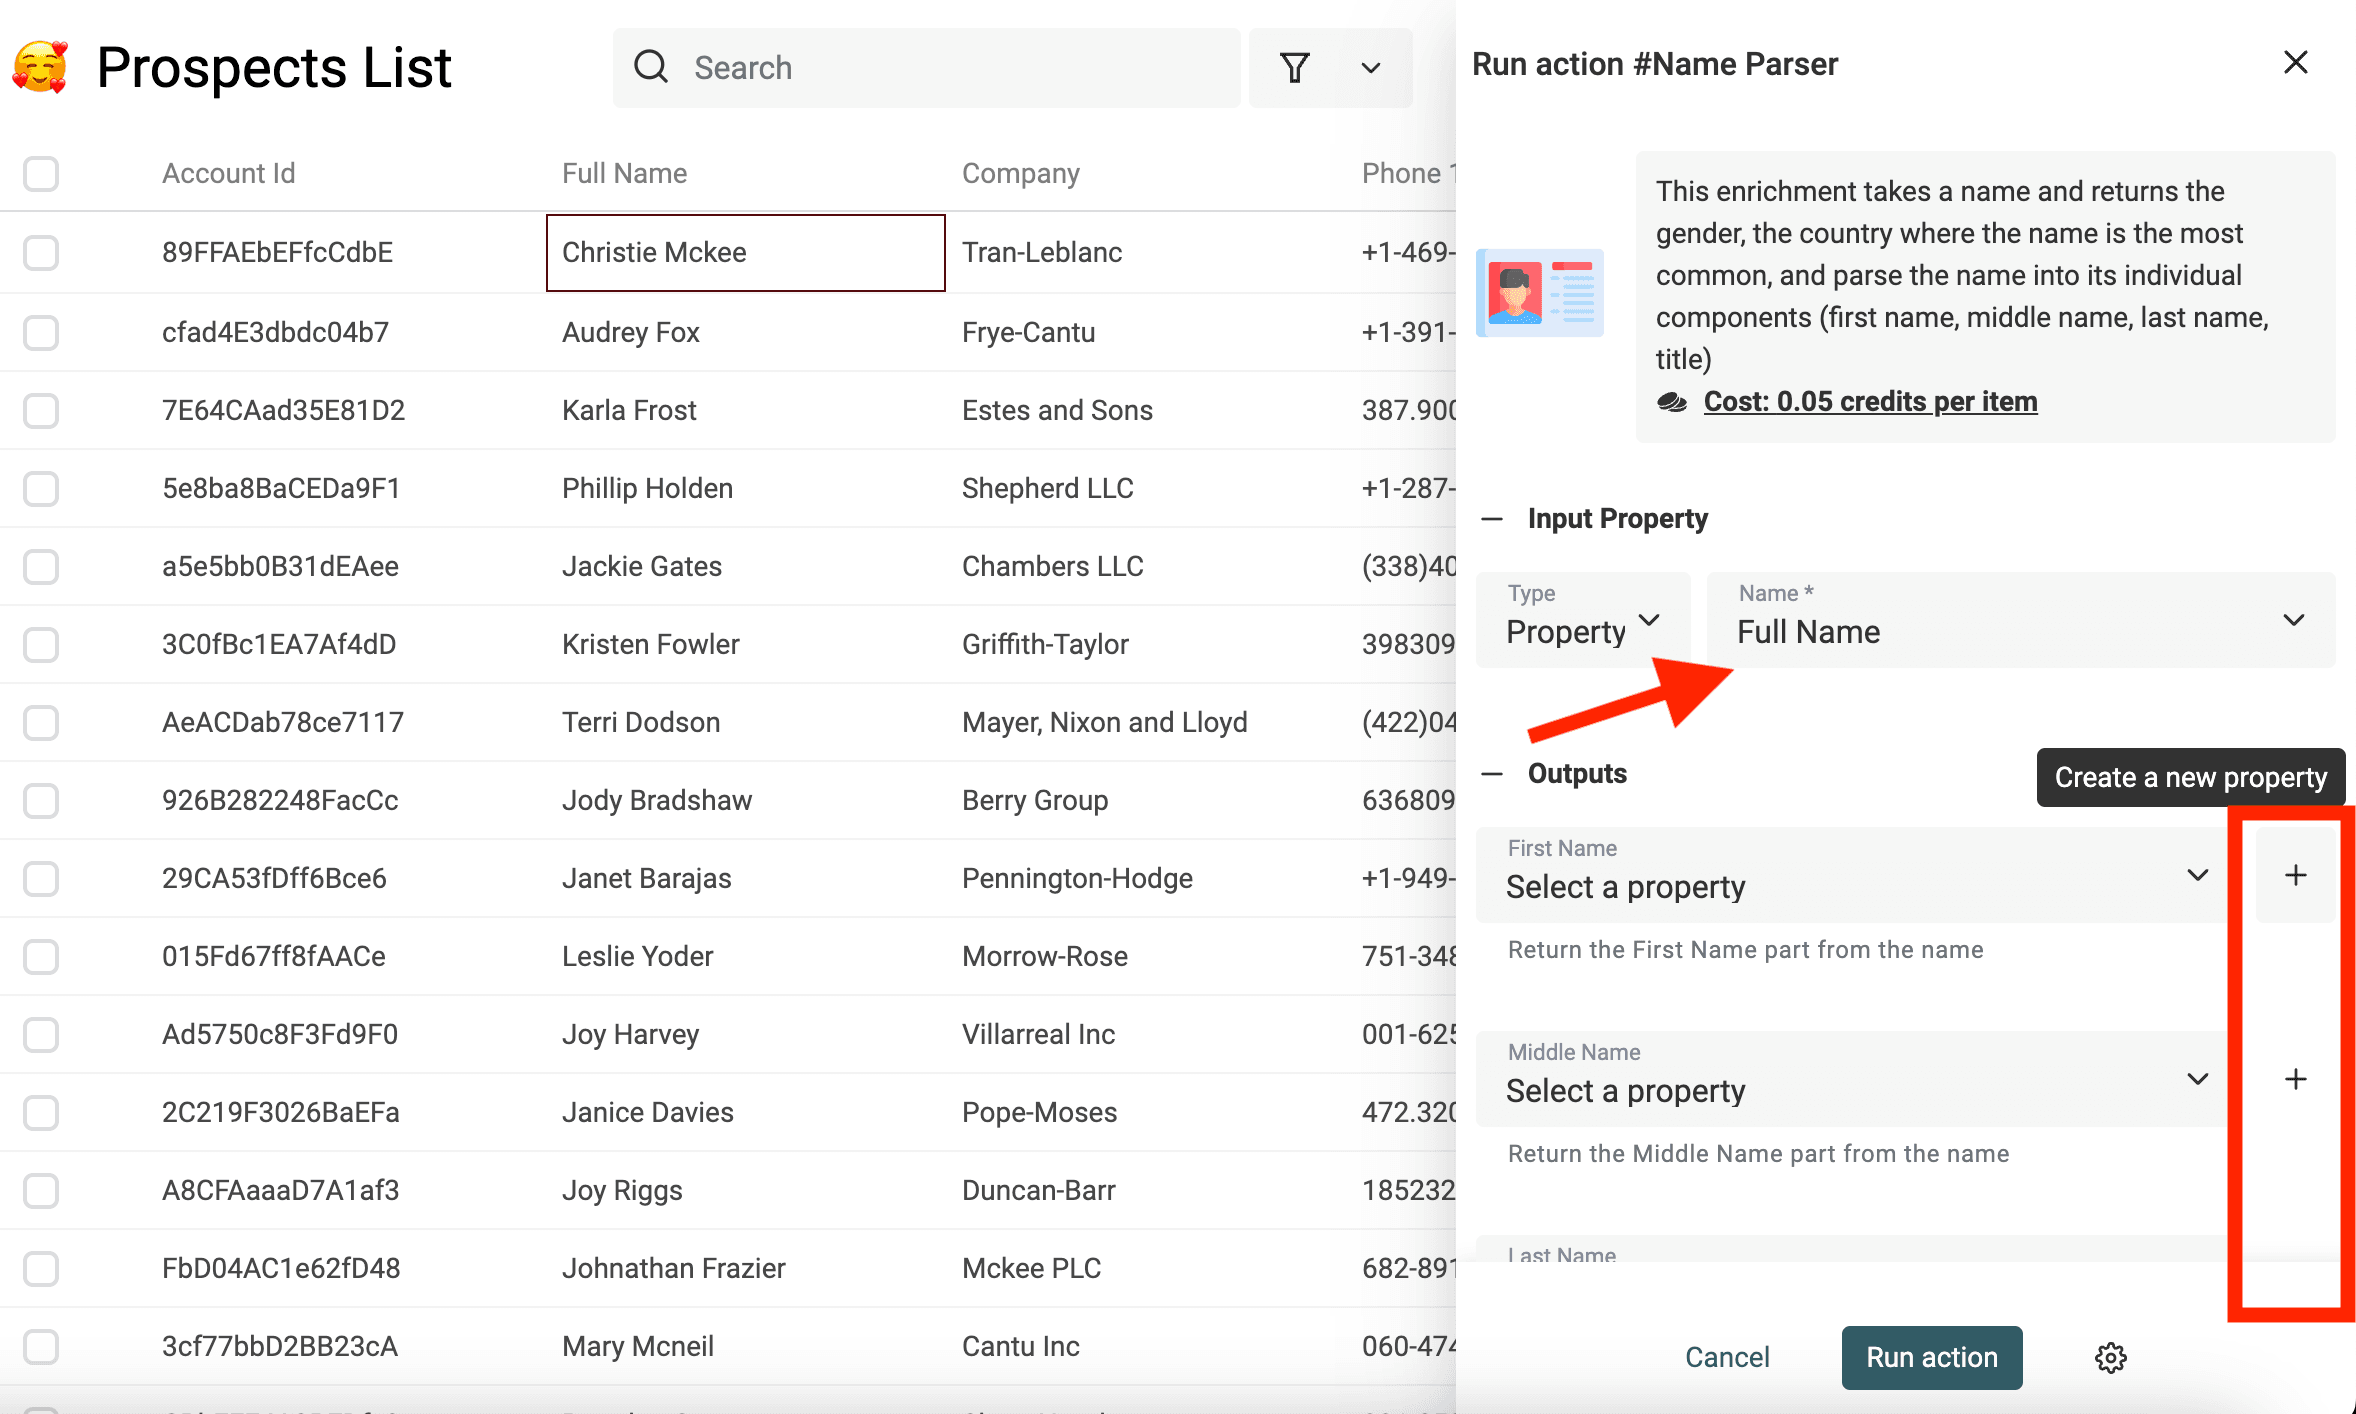
Name Parser es un enrichment ideal para limpiar nombres de personas. A partir de un nombre completo, devuelve sus componentes: nombre, segundo nombre y apellidos. También indica el género y el país más habituales para ese nombre.
Utiliza datos estadísticos para separar los nombres completos.
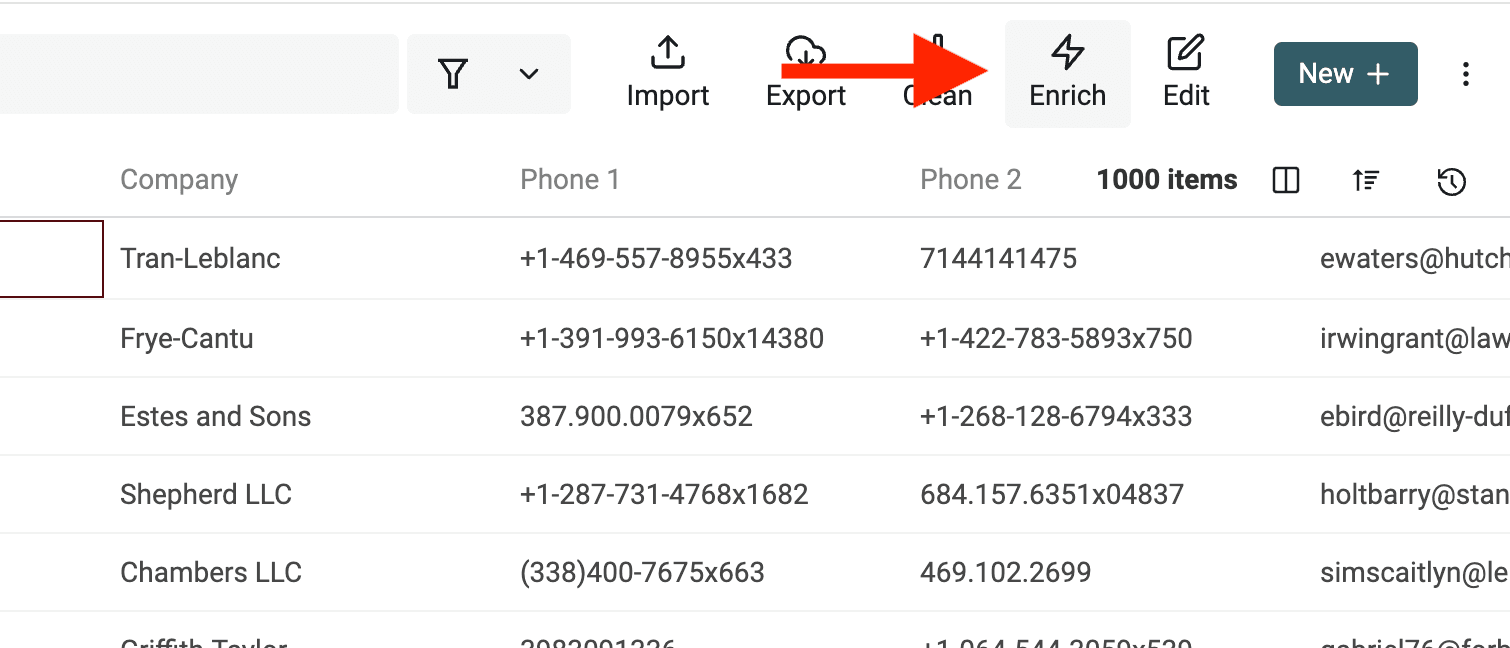
Para usarlo, abra "Enrich Menu" desde los botones superiores.
Después, seleccione "Name Parser".
A continuación, seleccione la propiedad que contiene los nombres y asigne o cree propiedades nuevas para guardar los resultados. La propiedad con el nombre completo no se modificará; solo se actualizarán con los resultados las propiedades de salida.
Normalizar nombres de empresas
También puede eliminar elementos innecesarios de los nombres de empresas, como prefijos, sufijos, stop words, complementos regionales u otros términos que dificulten el matching.
Un ejemplo de limpieza consiste en eliminar sufijos societarios como "Inc." o "GmbH".
Use esta expresión regular en la herramienta Find & Replace:
,?\s(llc|inc|incorporated|corporation|corp|co|gmbh|ltd).?$
Y sustitúyala por una cadena vacía.
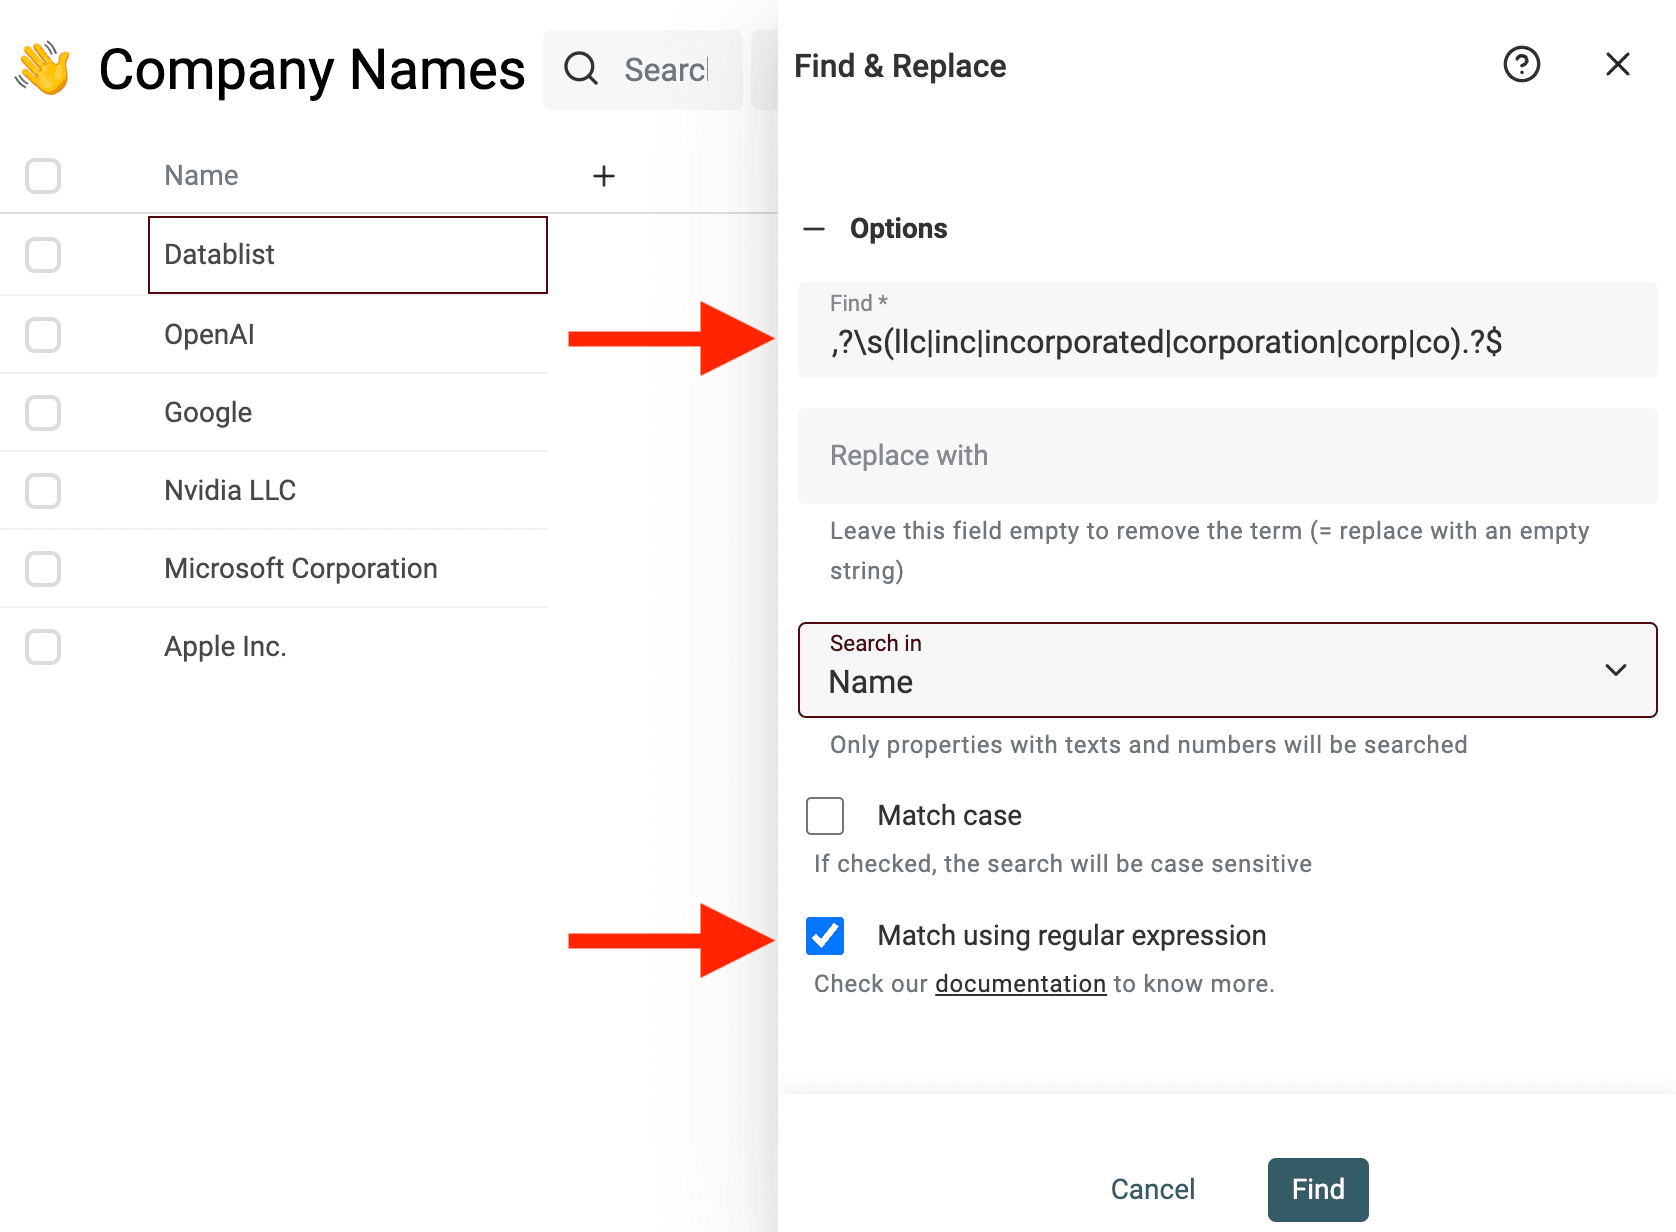
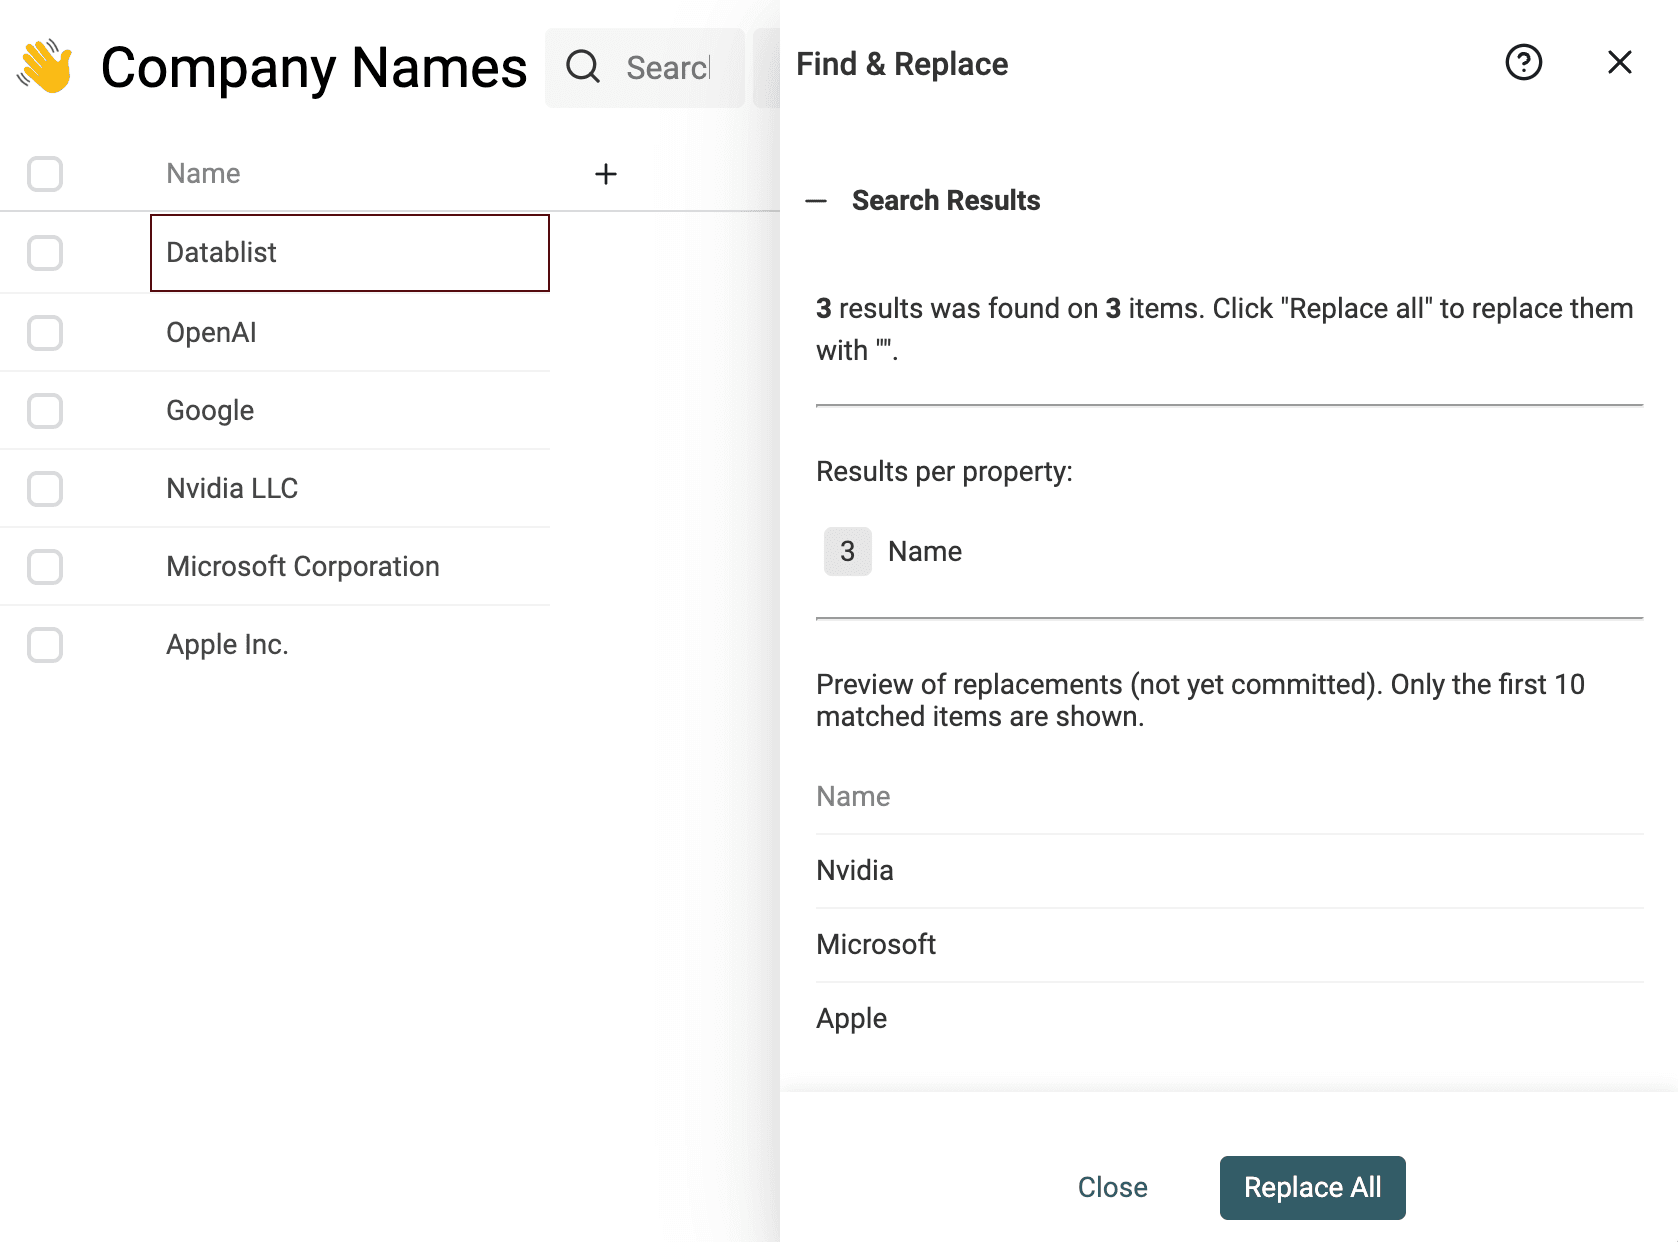
Es importante normalizar los nombres y las direcciones de empresas en todos los datasets para llevarlos a un formato estándar.
Normalizar nombres de calles
Si realiza Data Matching con direcciones postales, normalizar los nombres de las calles es fundamental. Las direcciones pueden incluir abreviaturas, prefijos de orientación o sufijos numéricos. Sin normalización, una misma calle puede aparecer representada de distintas formas, lo que complica el cruce de datos.
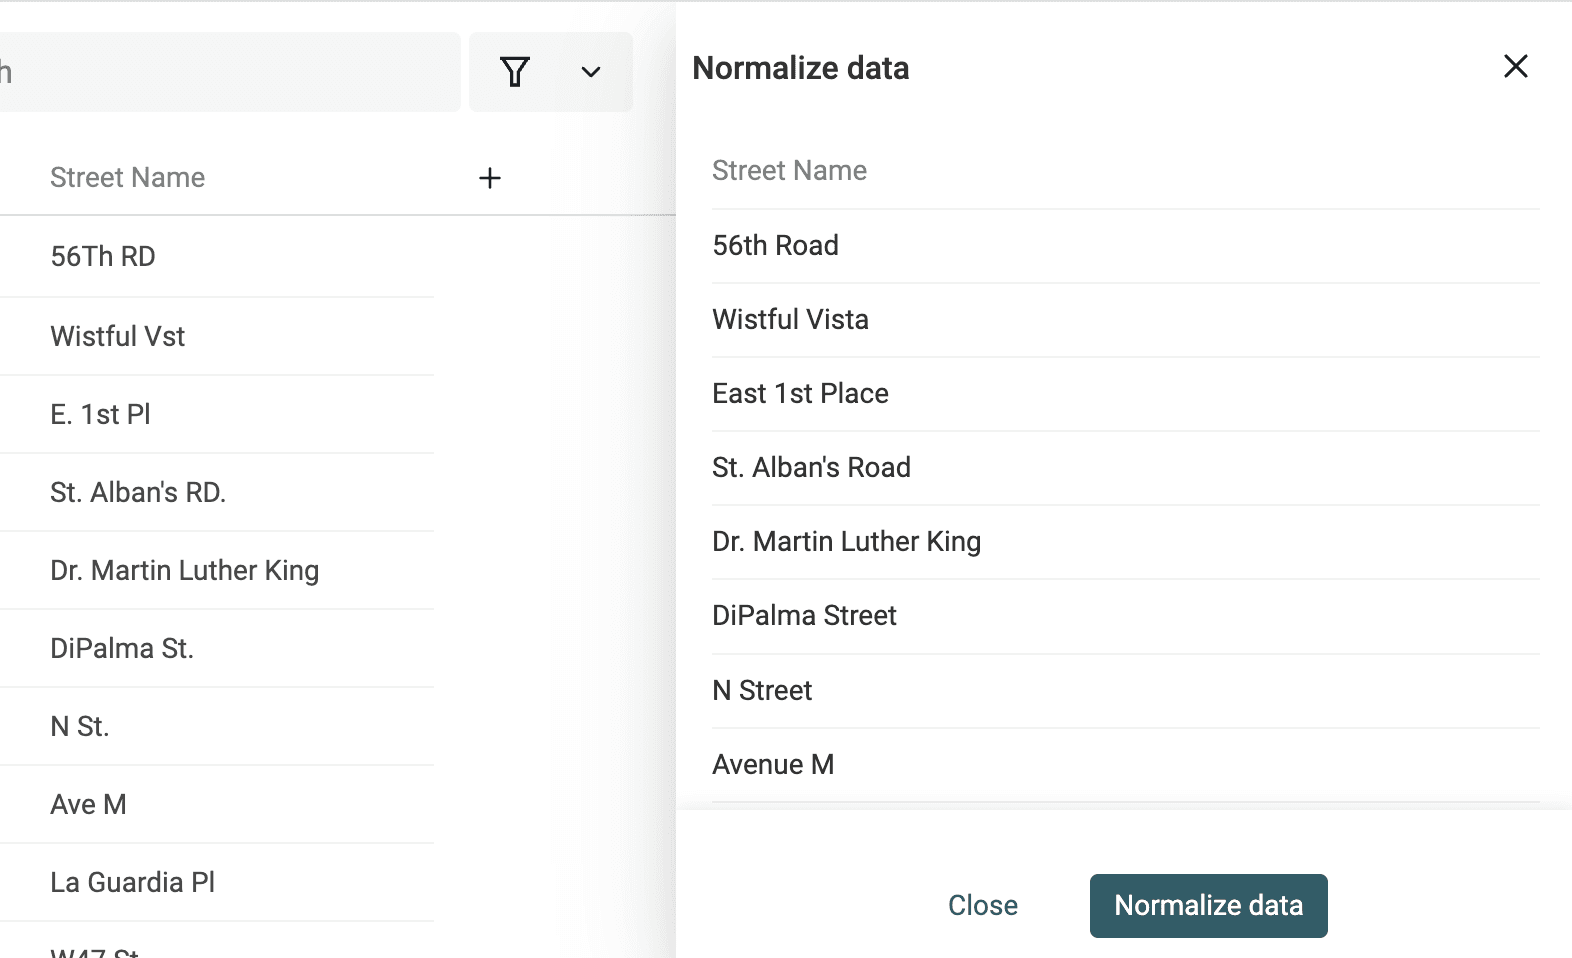
Por ejemplo, Main 9 St, Main 9TH St. y Main 9th Street hacen referencia a la misma calle. Lo mismo ocurre con Washington Blvd y Washington Boulevard.
Utilizar algoritmos fuzzy para resolver estas diferencias resulta poco eficiente. Entre Washington Blvd y Washington Boulevard hay que modificar varias letras, por lo que la distancia de similitud calculada con algoritmos de fuzzy matching sería elevada.
Una opción más eficaz es normalizar los nombres de las calles. Aplicar un formato uniforme garantiza la coherencia de los datos.
Datablist permite normalizar nombres de calles escritos conforme a los formatos ingleses. Normaliza abreviaturas, números de calle y otros elementos.
Notas
La normalización funciona con direcciones separadas en propiedades. El nombre de la calle debe estar en una propiedad independiente. No funcionará con direcciones completas.
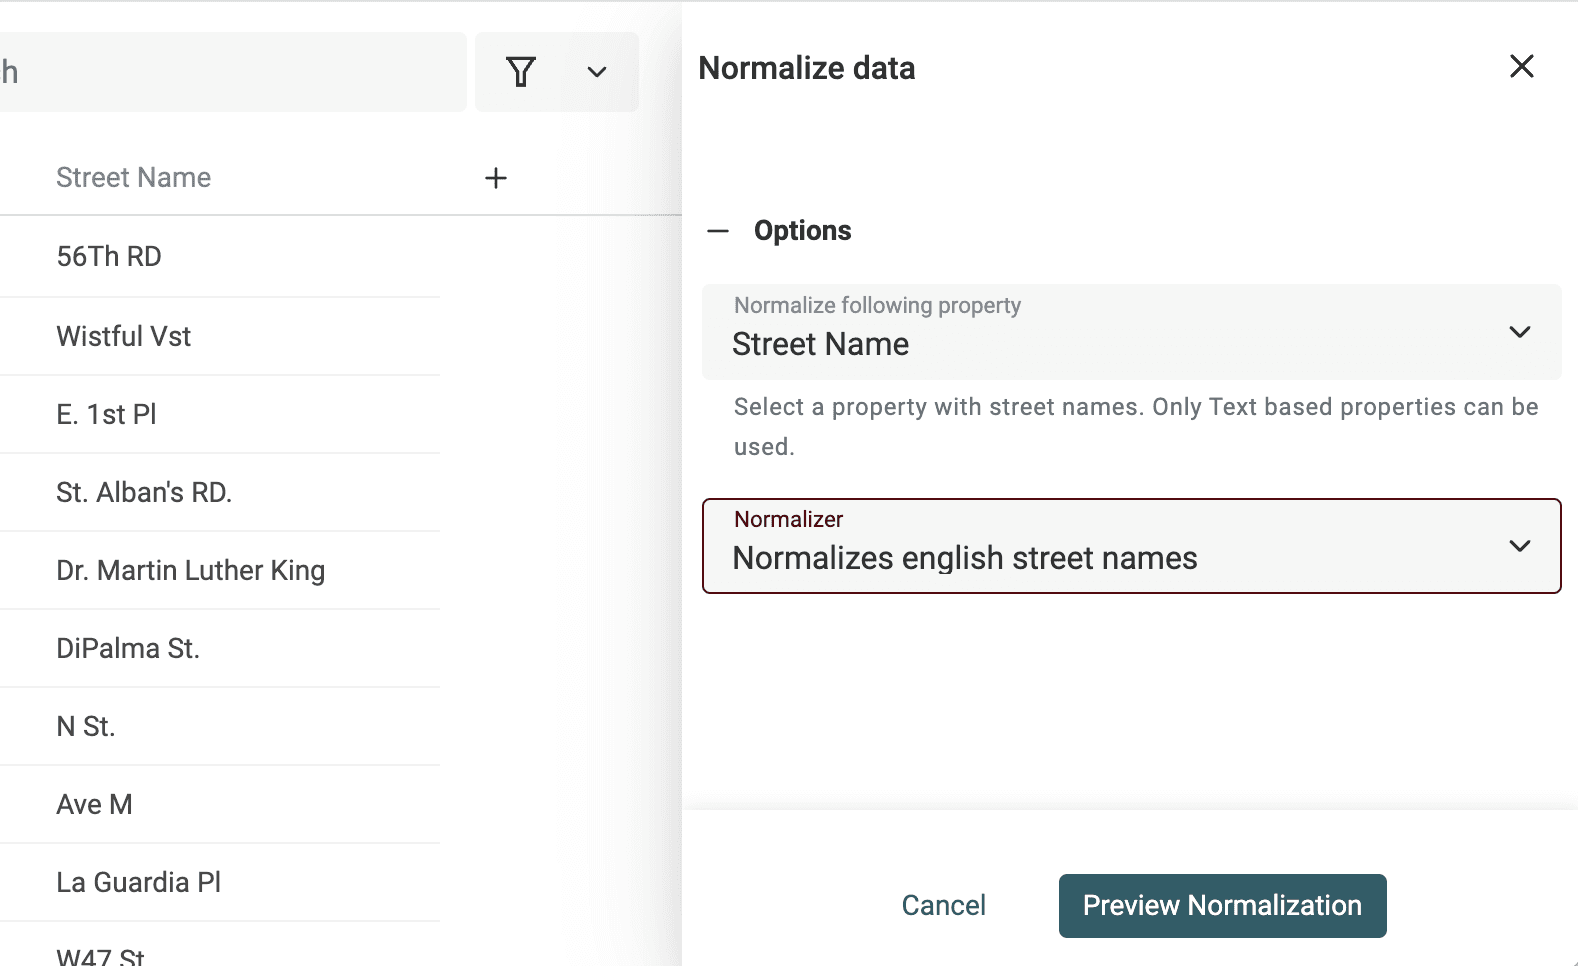
Haga clic en "Normalize Street Names" dentro del menú "Clean".
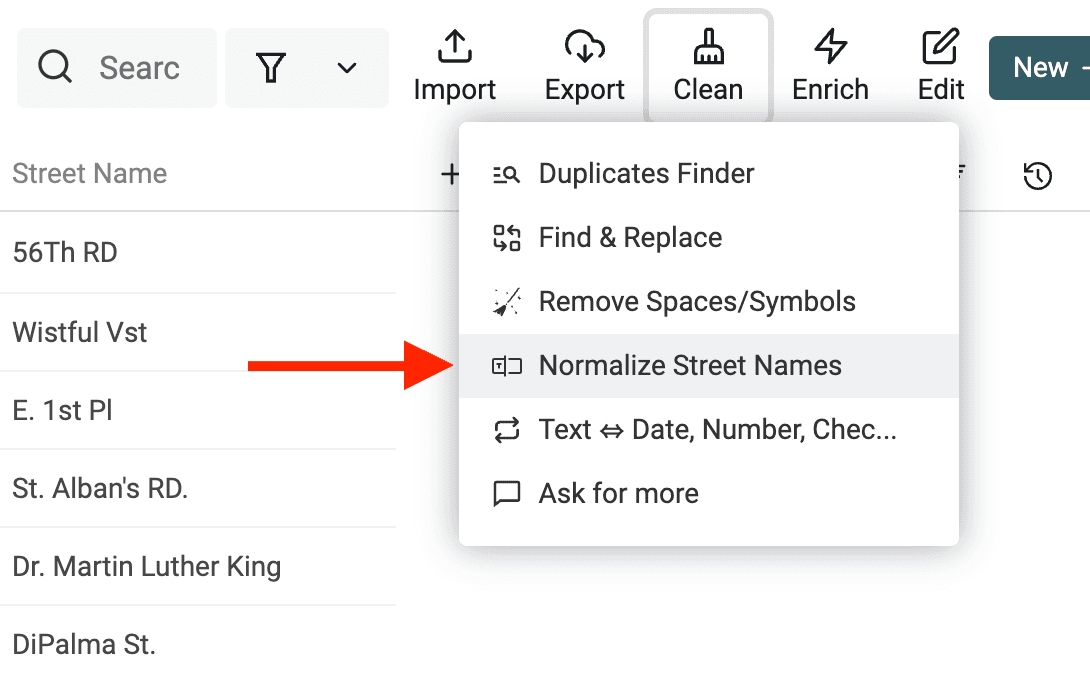
Después, seleccione la propiedad que contiene los nombres de las calles y elija "Normalize english street names".
Revise los cambios en la vista previa y haga clic en "Run".
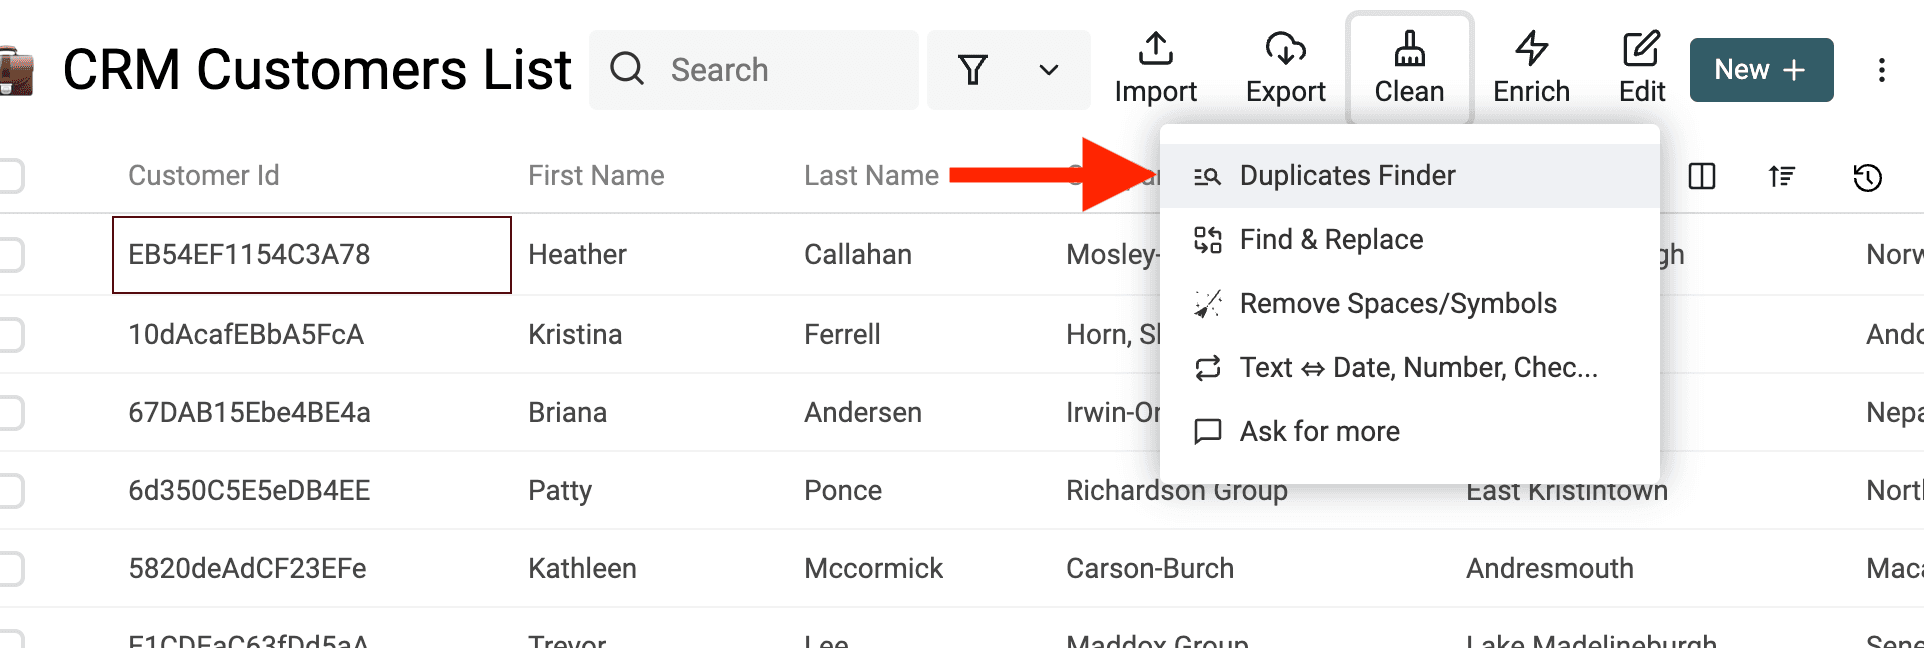
Paso 3: Cruzar registros en una o varias colecciones
Ahora que sus datos están limpios y normalizados, puede pasar al data matching. En este paso se agrupan los registros similares.
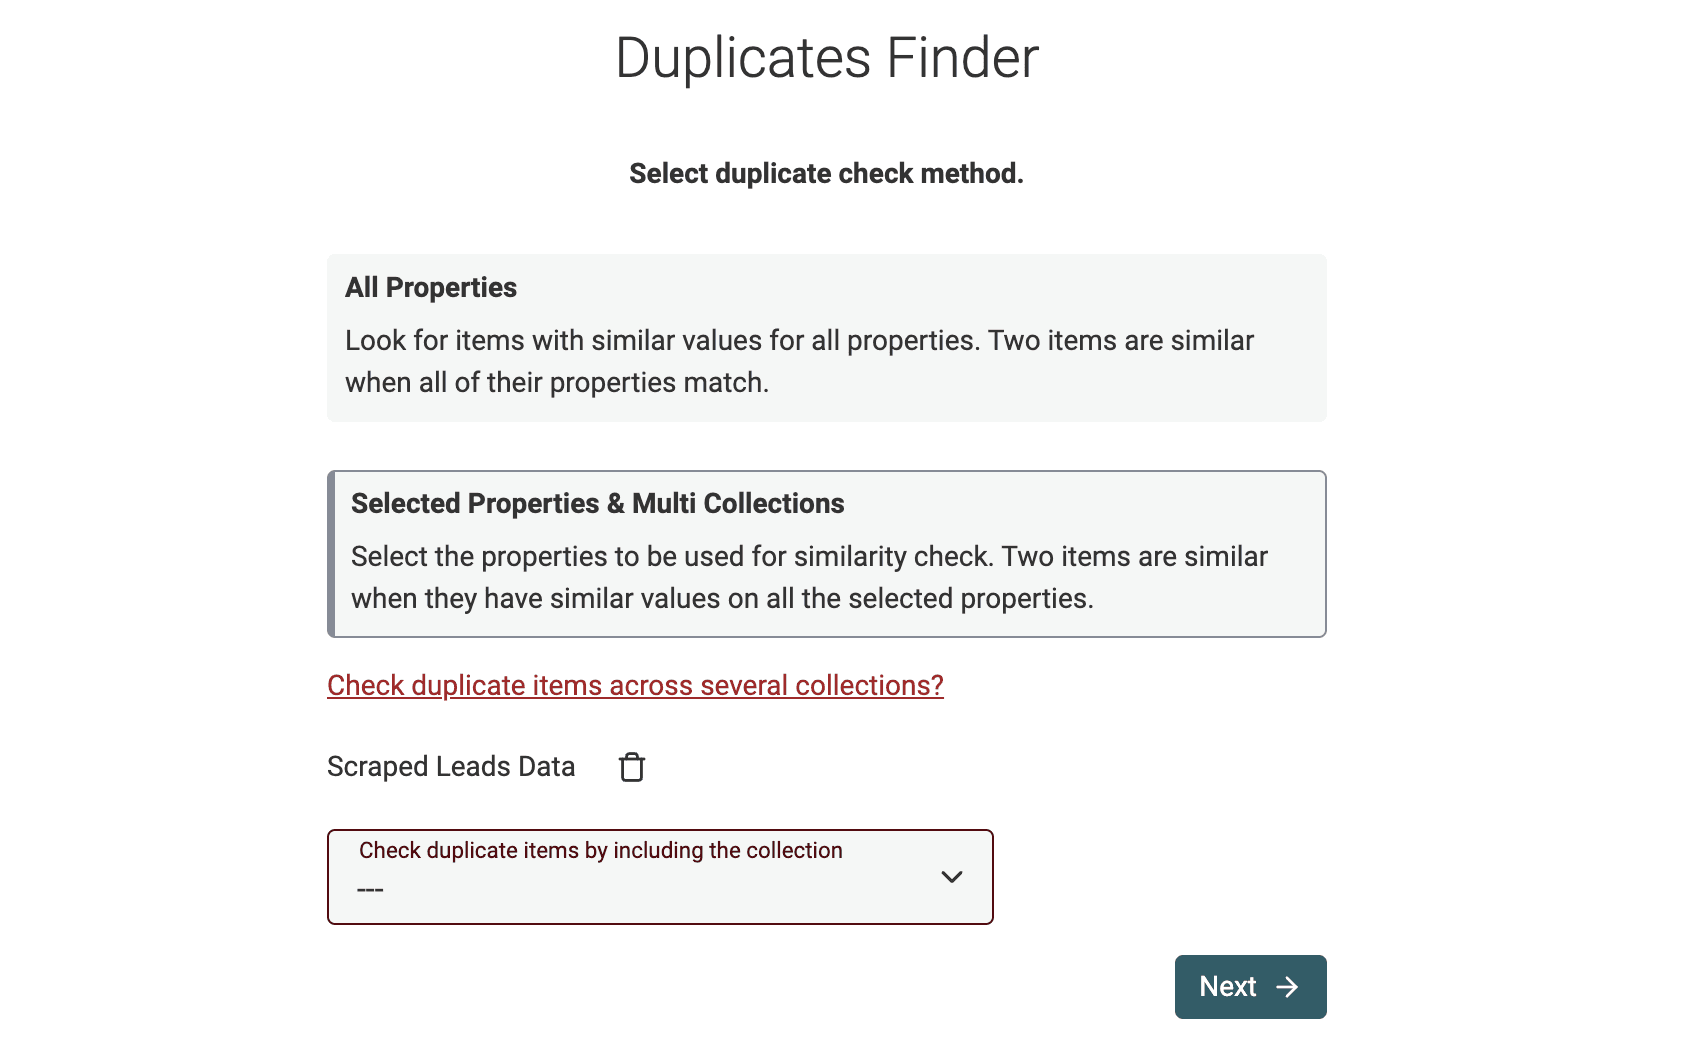
Datablist ofrece tres modos de inicio:
- Selected Properties compara los campos que usted elija dentro de una colección.
- All Properties compara registros completos dentro de una colección.
- Match across collections asigna y compara propiedades de varias colecciones.
Si tiene dos archivos de Leads con las propiedades Email y Company, asigne primero las propiedades de email. Si no dispone de direcciones de email, compare los nombres de las empresas y añada, cuando sea posible, un campo de sitio web o ubicación. El resultado será un conjunto de posibles grupos coincidentes, no una lista limpia garantizada. Abra algunos grupos y compruebe los valores de origen antes de fusionar los registros.
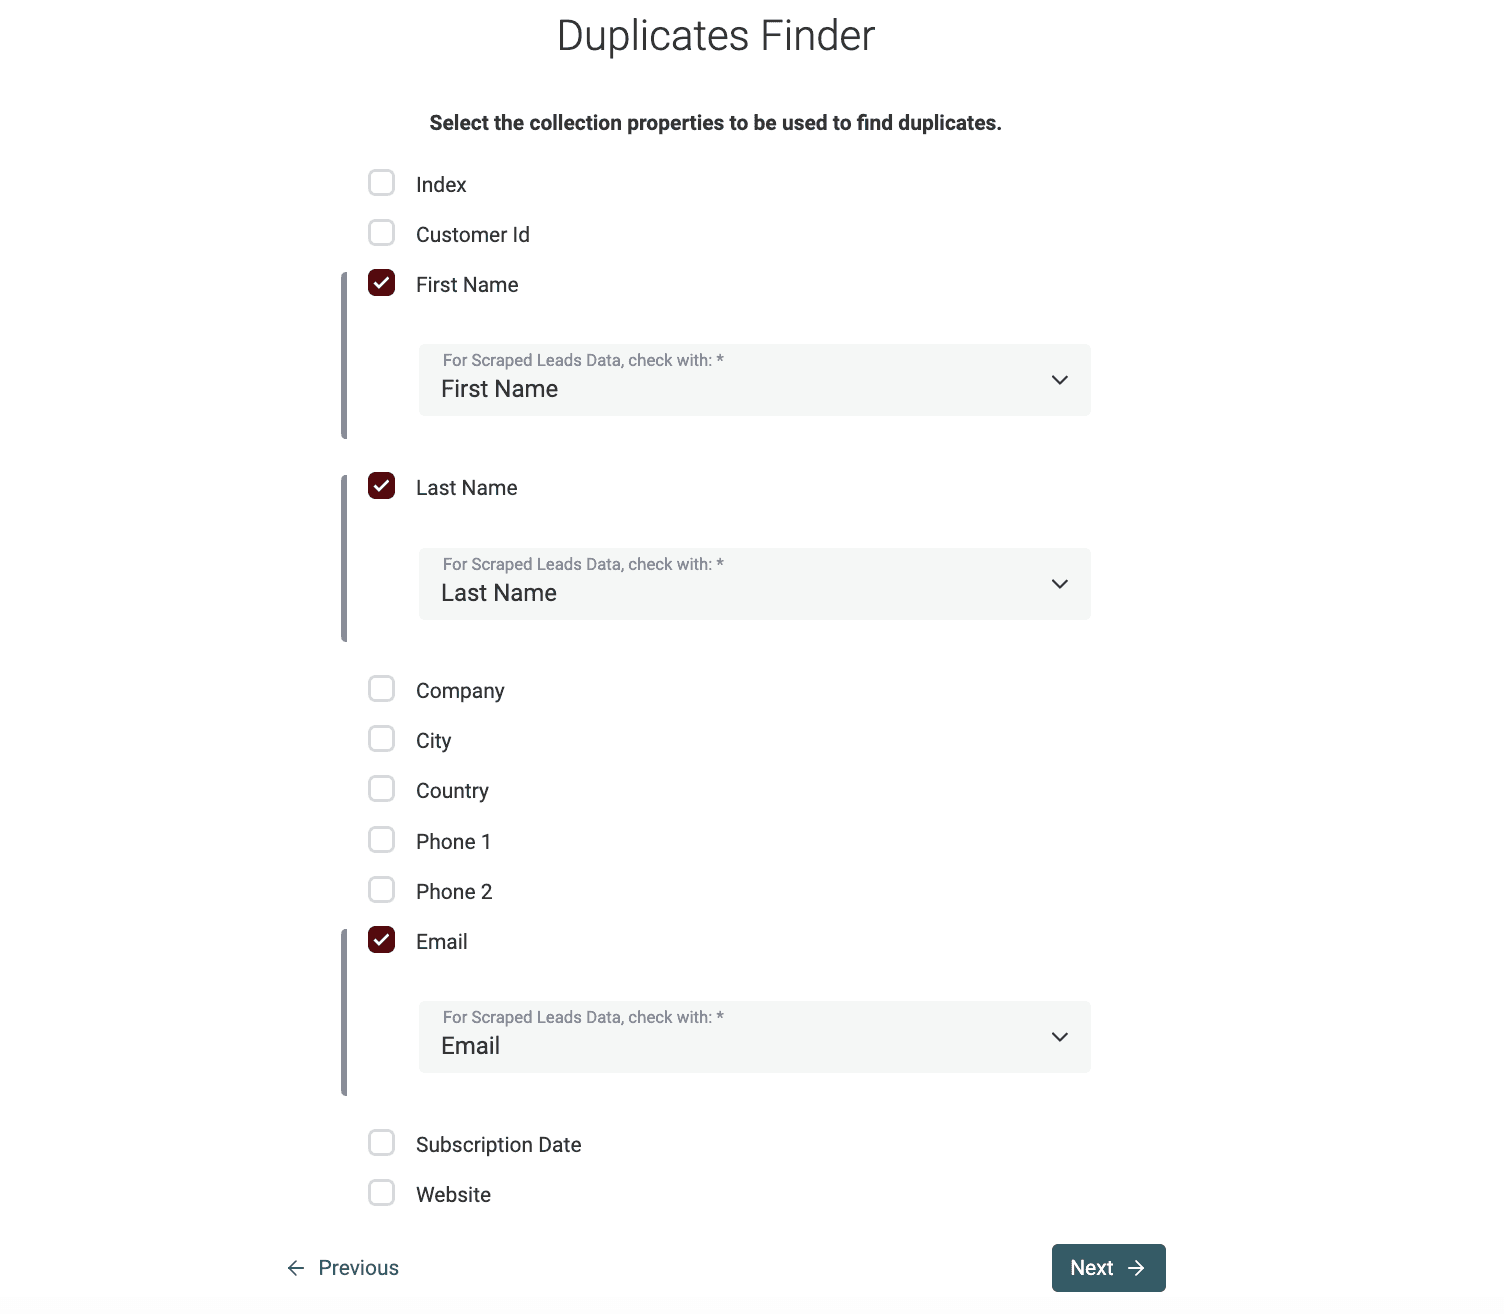
Seleccionar las propiedades que se compararán
Para el resto de esta guía, use Match across collections.
El siguiente paso consiste en seleccionar las propiedades que se utilizarán en el data matching. Si en el paso anterior eligió varias colecciones, tendrá que seleccionar una propiedad correspondiente en cada una de ellas.
Notas
Datablist intentará asignar automáticamente las propiedades de las distintas colecciones a partir de sus nombres.
Seleccionar el algoritmo de matching
En el siguiente paso verá las propiedades seleccionadas y deberá configurar los algoritmos de comparación.
Datablist incluye los siguientes algoritmos de matching:
-
Exact - Exact es el algoritmo recomendado para propiedades que no sean de texto, como DateTime, Number o Boolean. Cuando se utiliza con propiedades de texto, una opción permite decidir si la comparación debe distinguir entre mayúsculas y minúsculas. El algoritmo Exact elimina los espacios situados al principio y al final del texto.
-
Smart - Smart preprocesa los registros para encontrar datos con pequeñas variaciones. Puede comparar URL con protocolos distintos y también gestiona el orden de las palabras y la puntuación. "John-Doe" y "Doe John" se considerarán coincidentes.
-
Phonetic with Double Metaphone algorithm - Datablist implementa el algoritmo Double Metaphone para realizar matching fonético. Este algoritmo convierte las palabras en códigos que representan su pronunciación. Dos palabras que suenen de forma similar obtendrán el mismo código Double Metaphone.
-
Fuzzy matching with distance algorithms - Datablist también permite hacer fuzzy matching con las distancias de Jaro-Winkler y Levenshtein. Al seleccionarlo, deberá establecer un umbral de similitud. Cuanto más alto sea, menos variaciones se admitirán.
Consulte nuestra documentación para obtener más información sobre los algoritmos de matching.
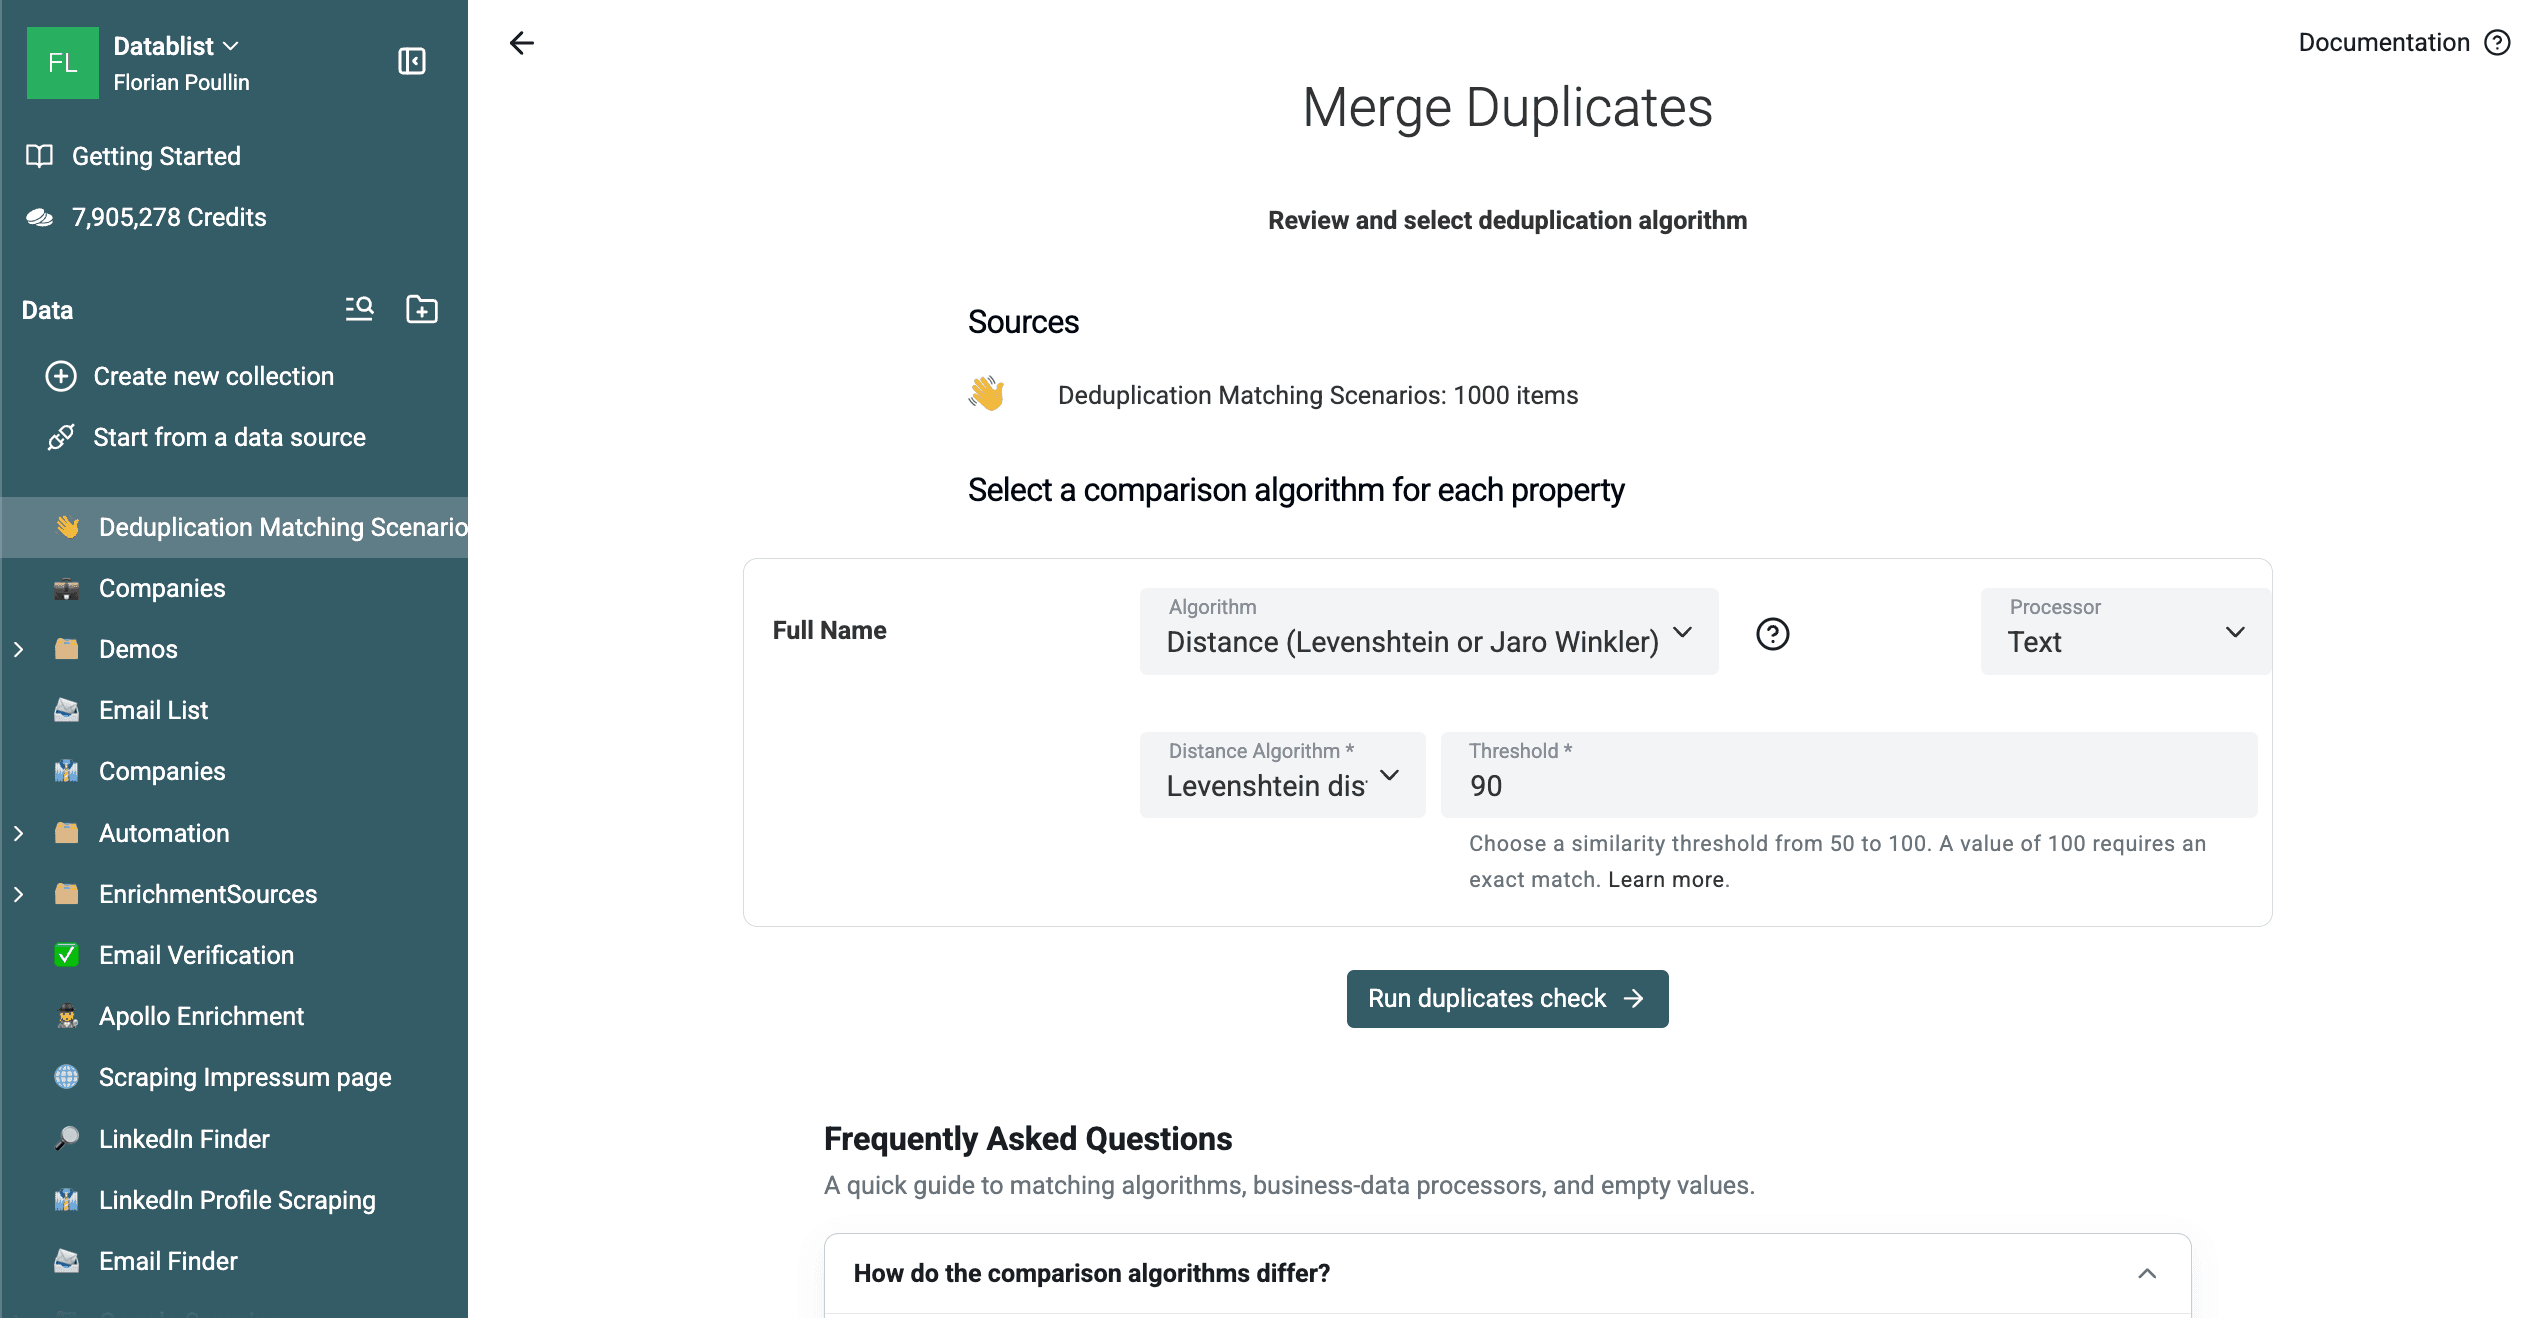
En la muestra de deduplicación de 1.000 filas, esta configuración de Full Name devolvió
77 grupos de dos filas. La validación con datos de referencia detectó 21 grupos correspondientes a la misma
entidad prevista y 56 grupos que vinculaban entidades diferentes. La mayoría de los falsos positivos
eran abreviaturas cortas e idénticas, como G. Rossi.
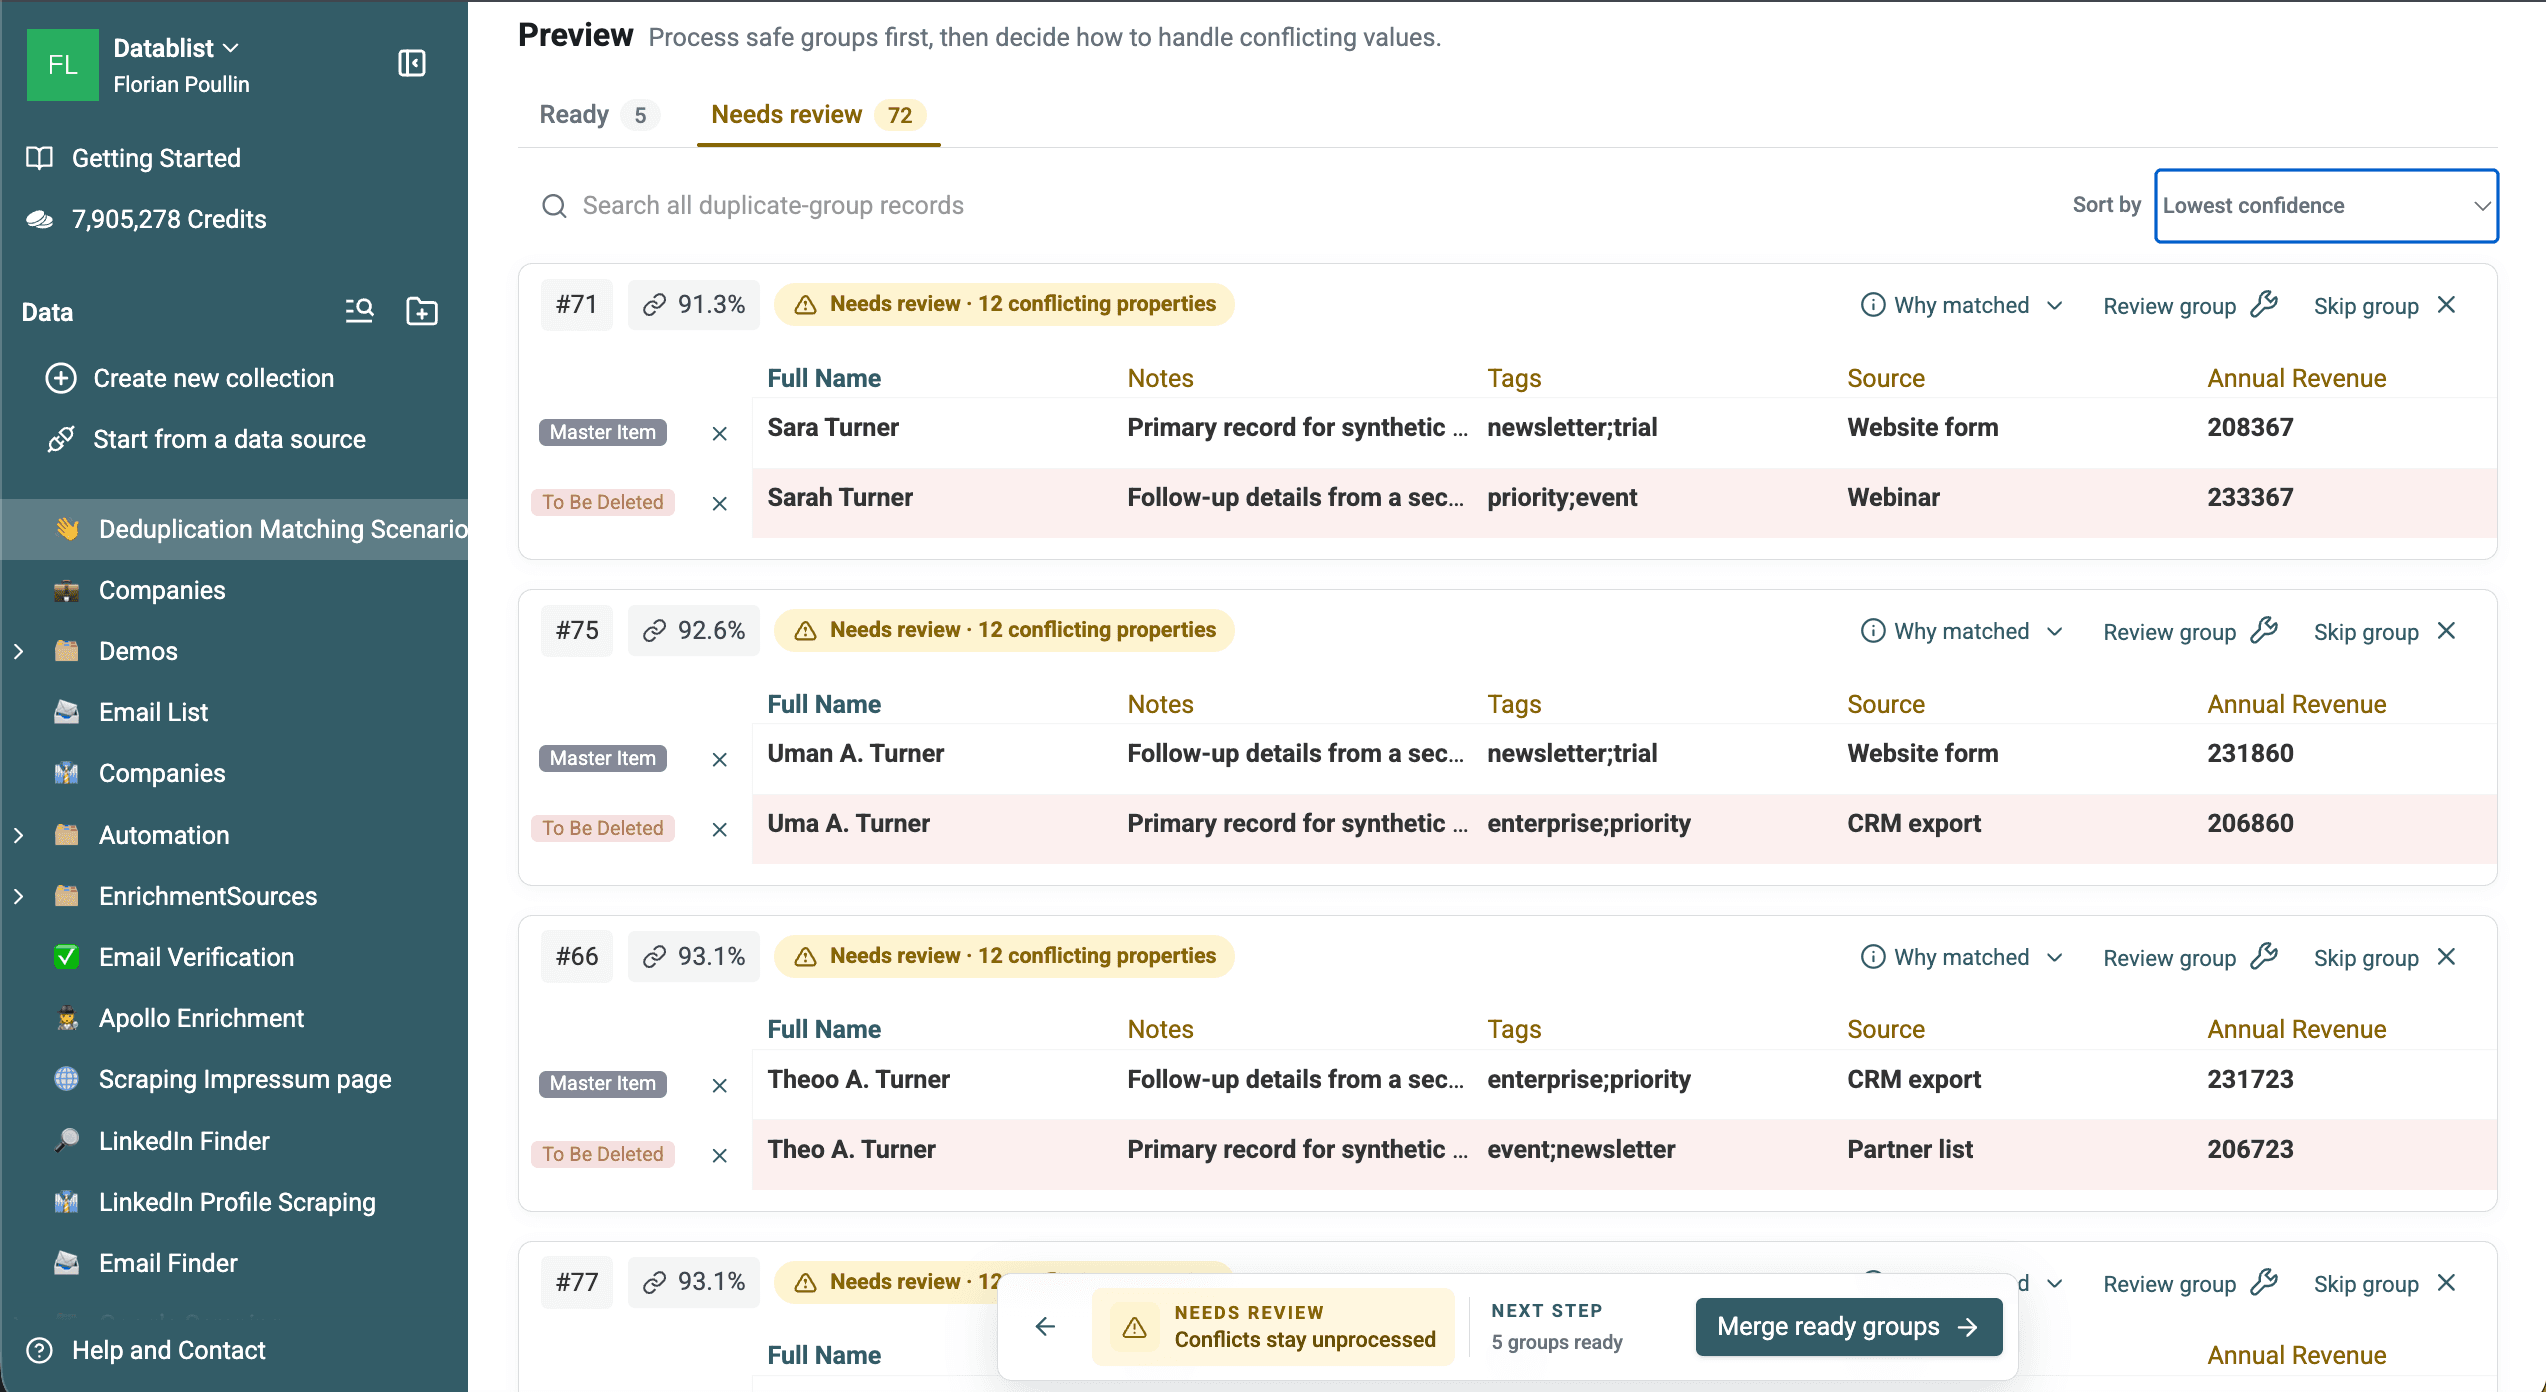
Use un segundo identificador, como el email, el teléfono, la empresa o el sitio web, antes de procesar coincidencias ambiguas entre nombres. Descargue los 77 grupos exportados para examinar el resultado.
La misma muestra devolvió 69 grupos y 188 filas agrupadas cuando Full Name utilizó
Metaphone con el procesador Text. La validación con datos de referencia encontró 19
grupos puros correspondientes a la misma entidad y 50 grupos que mezclaban personas diferentes.
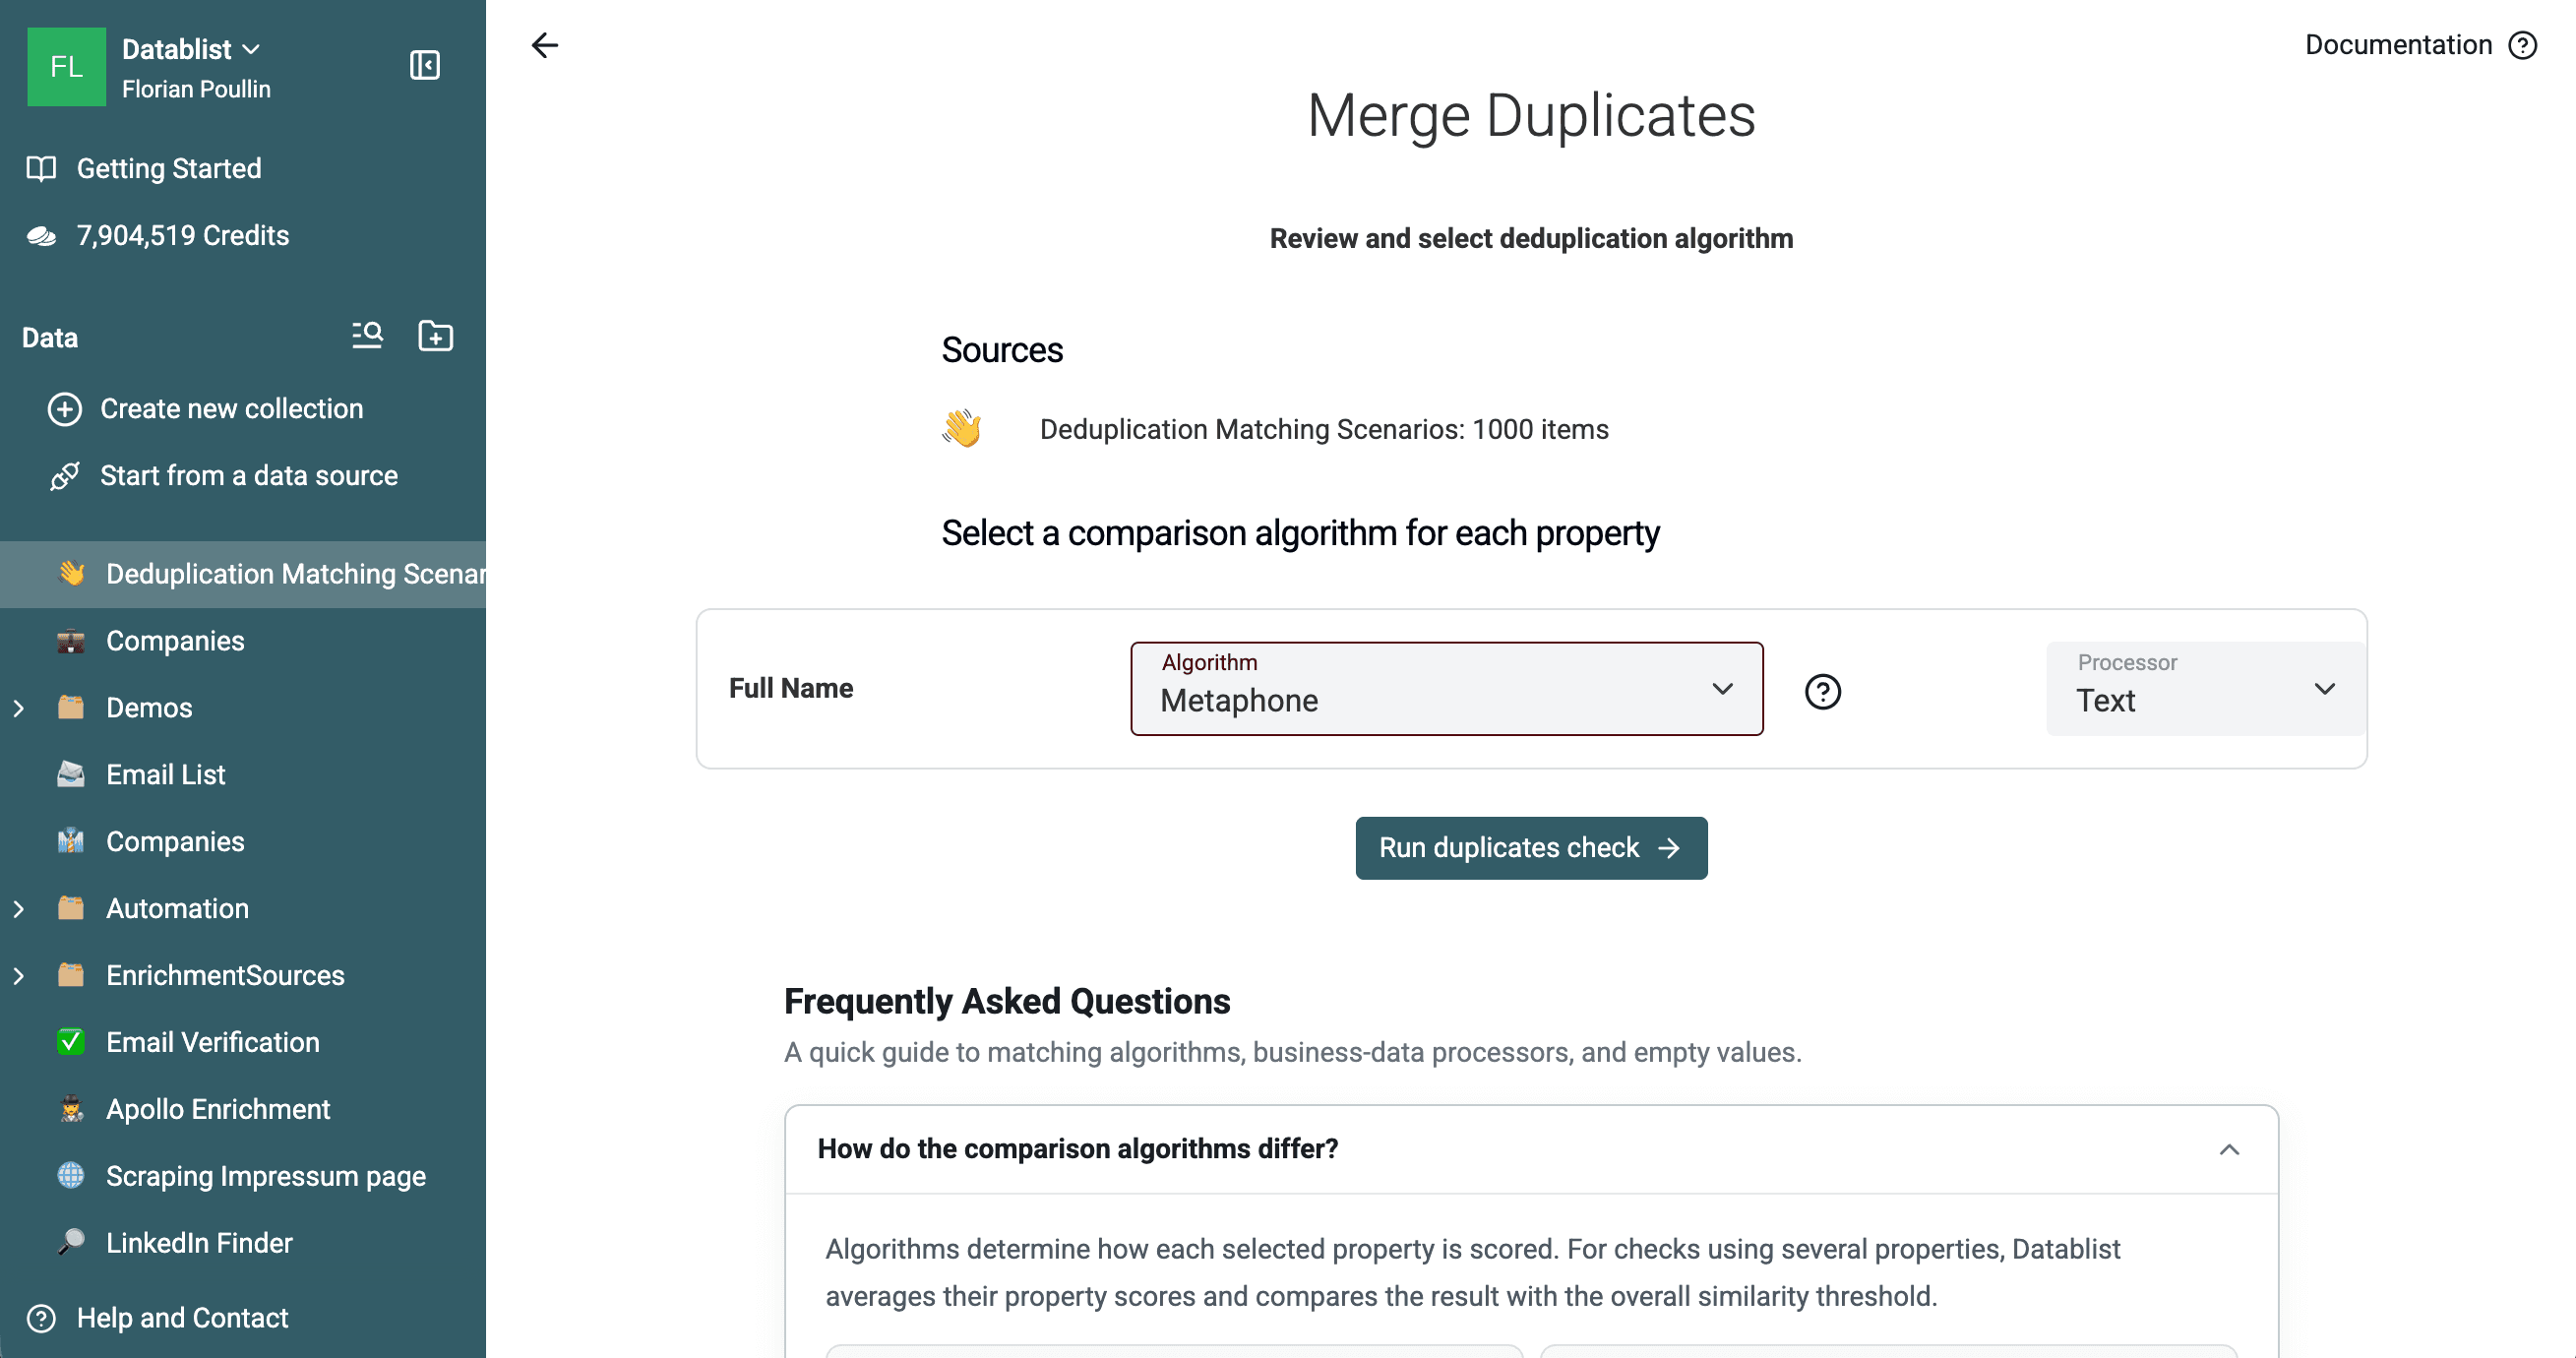
El resultado incluyó grupos grandes de nombres abreviados con el mismo apellido. La similitud fonética sirve para encontrar posibles coincidencias, pero no demuestra que dos filas pertenezcan a la misma persona.
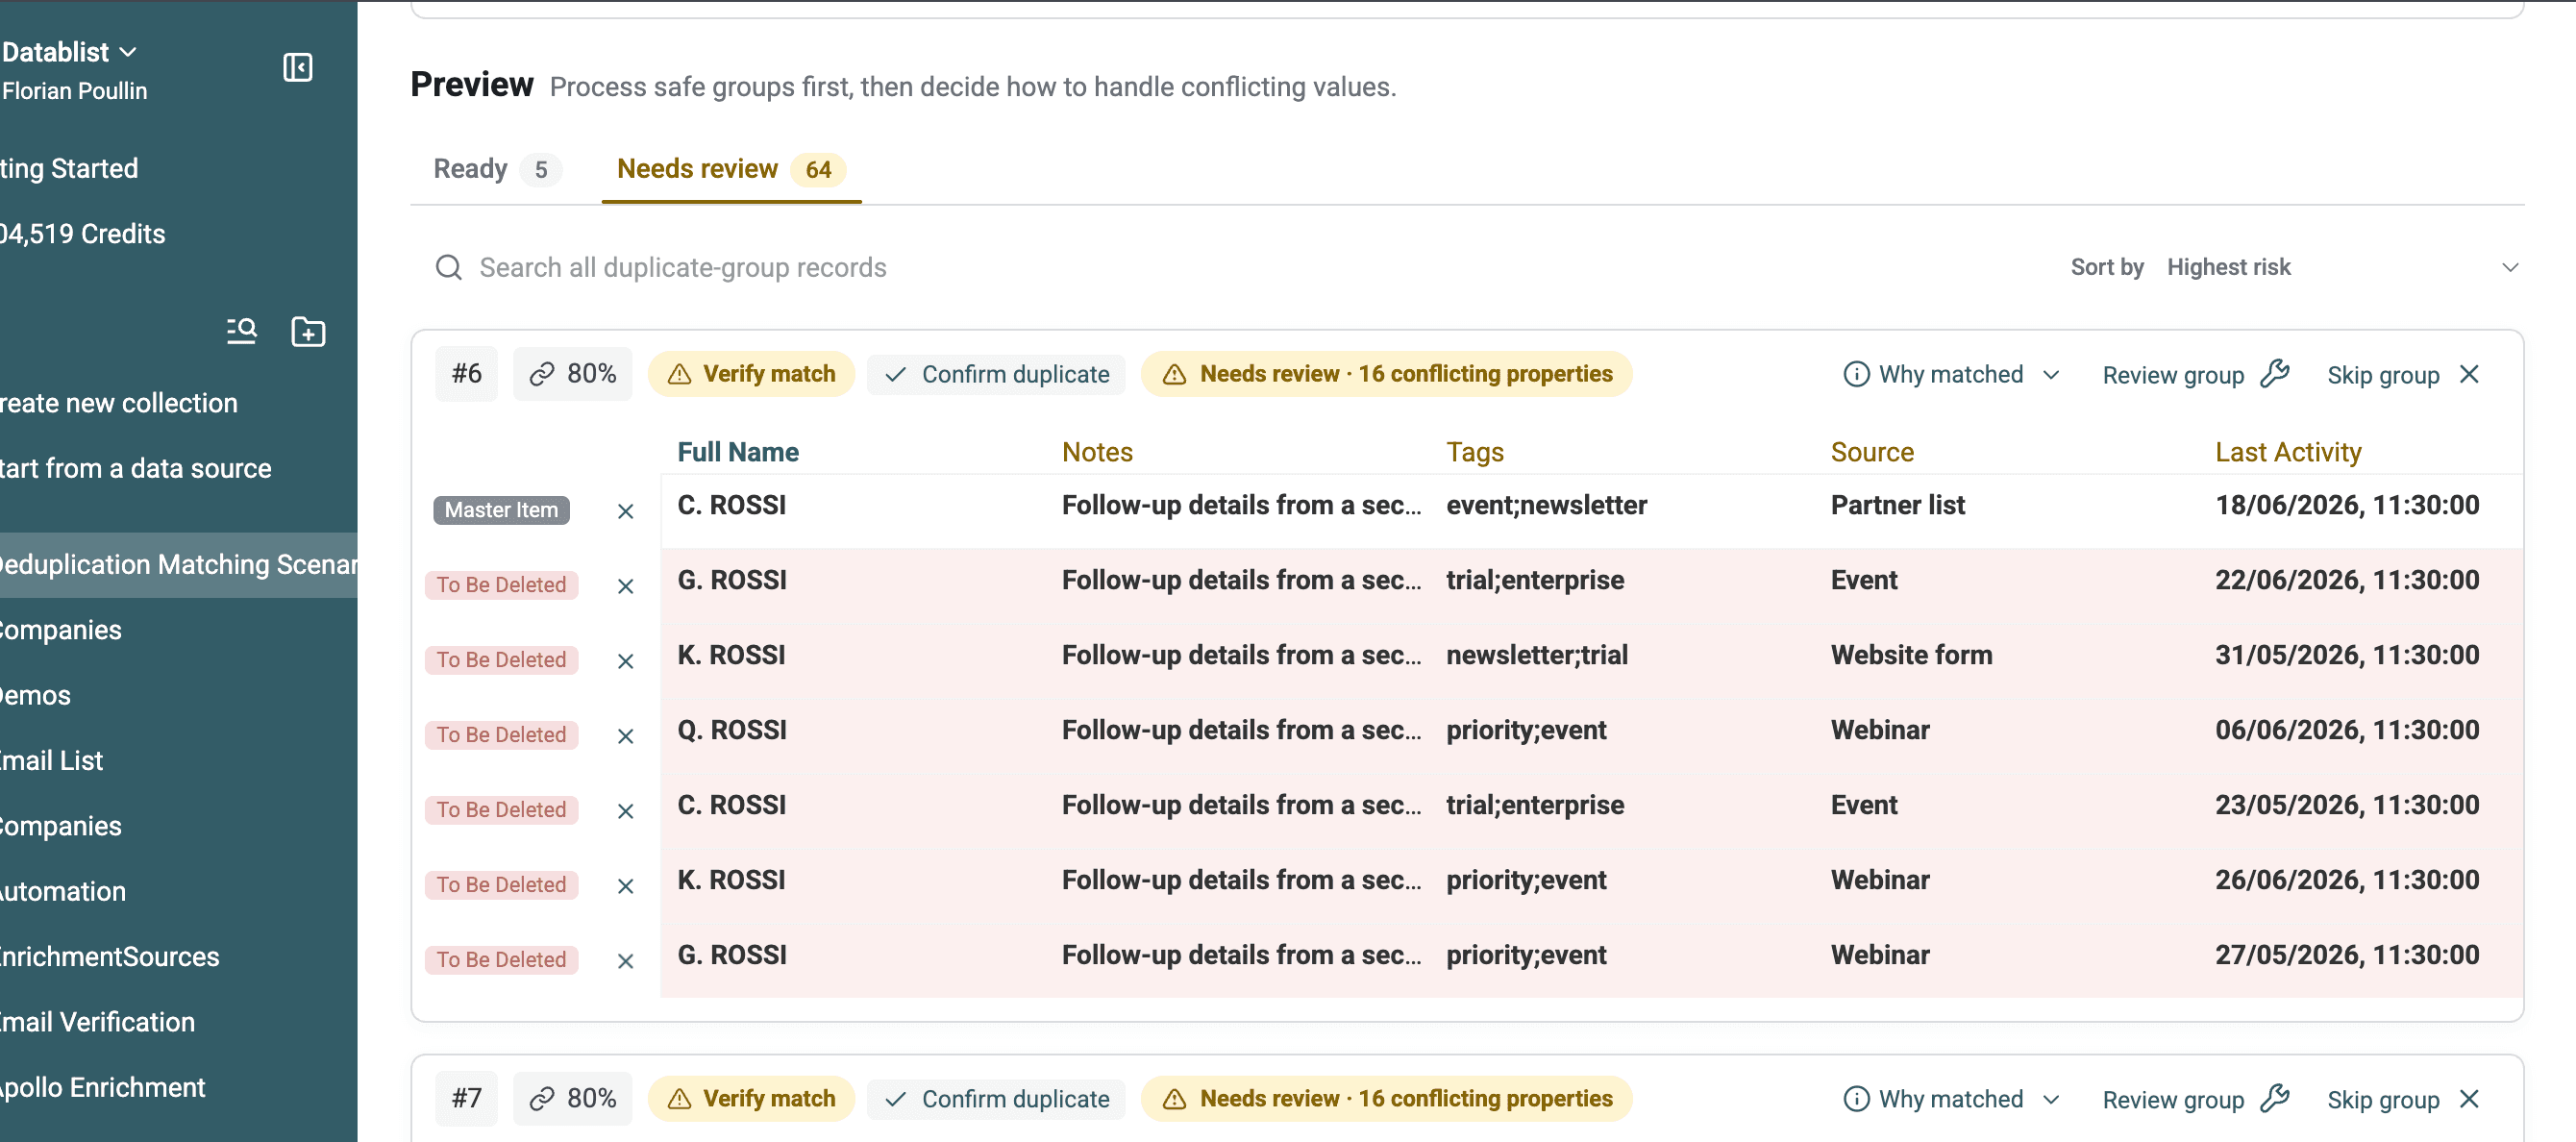
Descargue los 69 grupos de Metaphone exportados para revisar los grupos de entre dos y siete filas y comparar las coincidencias útiles con los falsos positivos.
Notas
- Los algoritmos Smart, Phonetic y fuzzy solo se aplican a propiedades de texto, incluidas Email, Text y LongText.
- Las propiedades URL solo son compatibles con los algoritmos Exact y Smart.
Paso 4: Eliminar o fusionar grupos coincidentes
Duplicates Finder de Datablist devuelve grupos coincidentes para que usted los revise. La página de resultados explica por qué se han agrupado las filas y separa los grupos Ready de los candidatos que requieren revisión.
Fusión automática al deduplicar una colección
En una única colección, seleccione Merge and preserve data. Datablist completa las propiedades vacías y aplica sus reglas de conflictos y Record to keep.
Notas:
Tenga en cuenta que esta función solo está disponible al deduplicar una única colección. En la deduplicación de varias colecciones, estas pueden tener estructuras de datos diferentes.
Fusión automática sin conflictos de datos
Datablist marca un grupo como Ready cuando la fusión produce un resultado concreto y no queda ningún requisito por resolver.
El proceso funciona así:
- Si todos los elementos duplicados tienen los mismos valores en sus propiedades, solo se conservará uno y se eliminarán los demás.
- Si los elementos duplicados son complementarios, se elegirá como principal el que contenga más información y sus propiedades se completarán con los valores de los otros elementos. Después, se eliminarán todos salvo el elemento principal.
- Si hay valores en conflicto, configure una regla o deje el grupo en Needs review.
Fusión automática con resolución de conflictos
Al ejecutar el algoritmo de fusión automática, Duplicates Finder de Datablist detecta automáticamente las propiedades en conflicto. Existe un conflicto cuando dos elementos tienen valores distintos para una misma propiedad. Para poder fusionarlos, deberá elegir entre estas opciones:
- Combine concatena valores de texto distintos mediante el separador seleccionado.
- Keep the selected record's value descarta los demás valores.
- Las reglas de pago para conservar valores de campos pueden elegir, en cada propiedad, el valor más reciente, más antiguo, más largo, más corto, más alto, más bajo o más frecuente.
Reglas de limpieza para cruzar varias colecciones
Cuando ejecute la herramienta Data Matching de Datablist con varios datasets, la fusión automática no estará disponible. Sus colecciones podrían tener estructuras y propiedades diferentes.
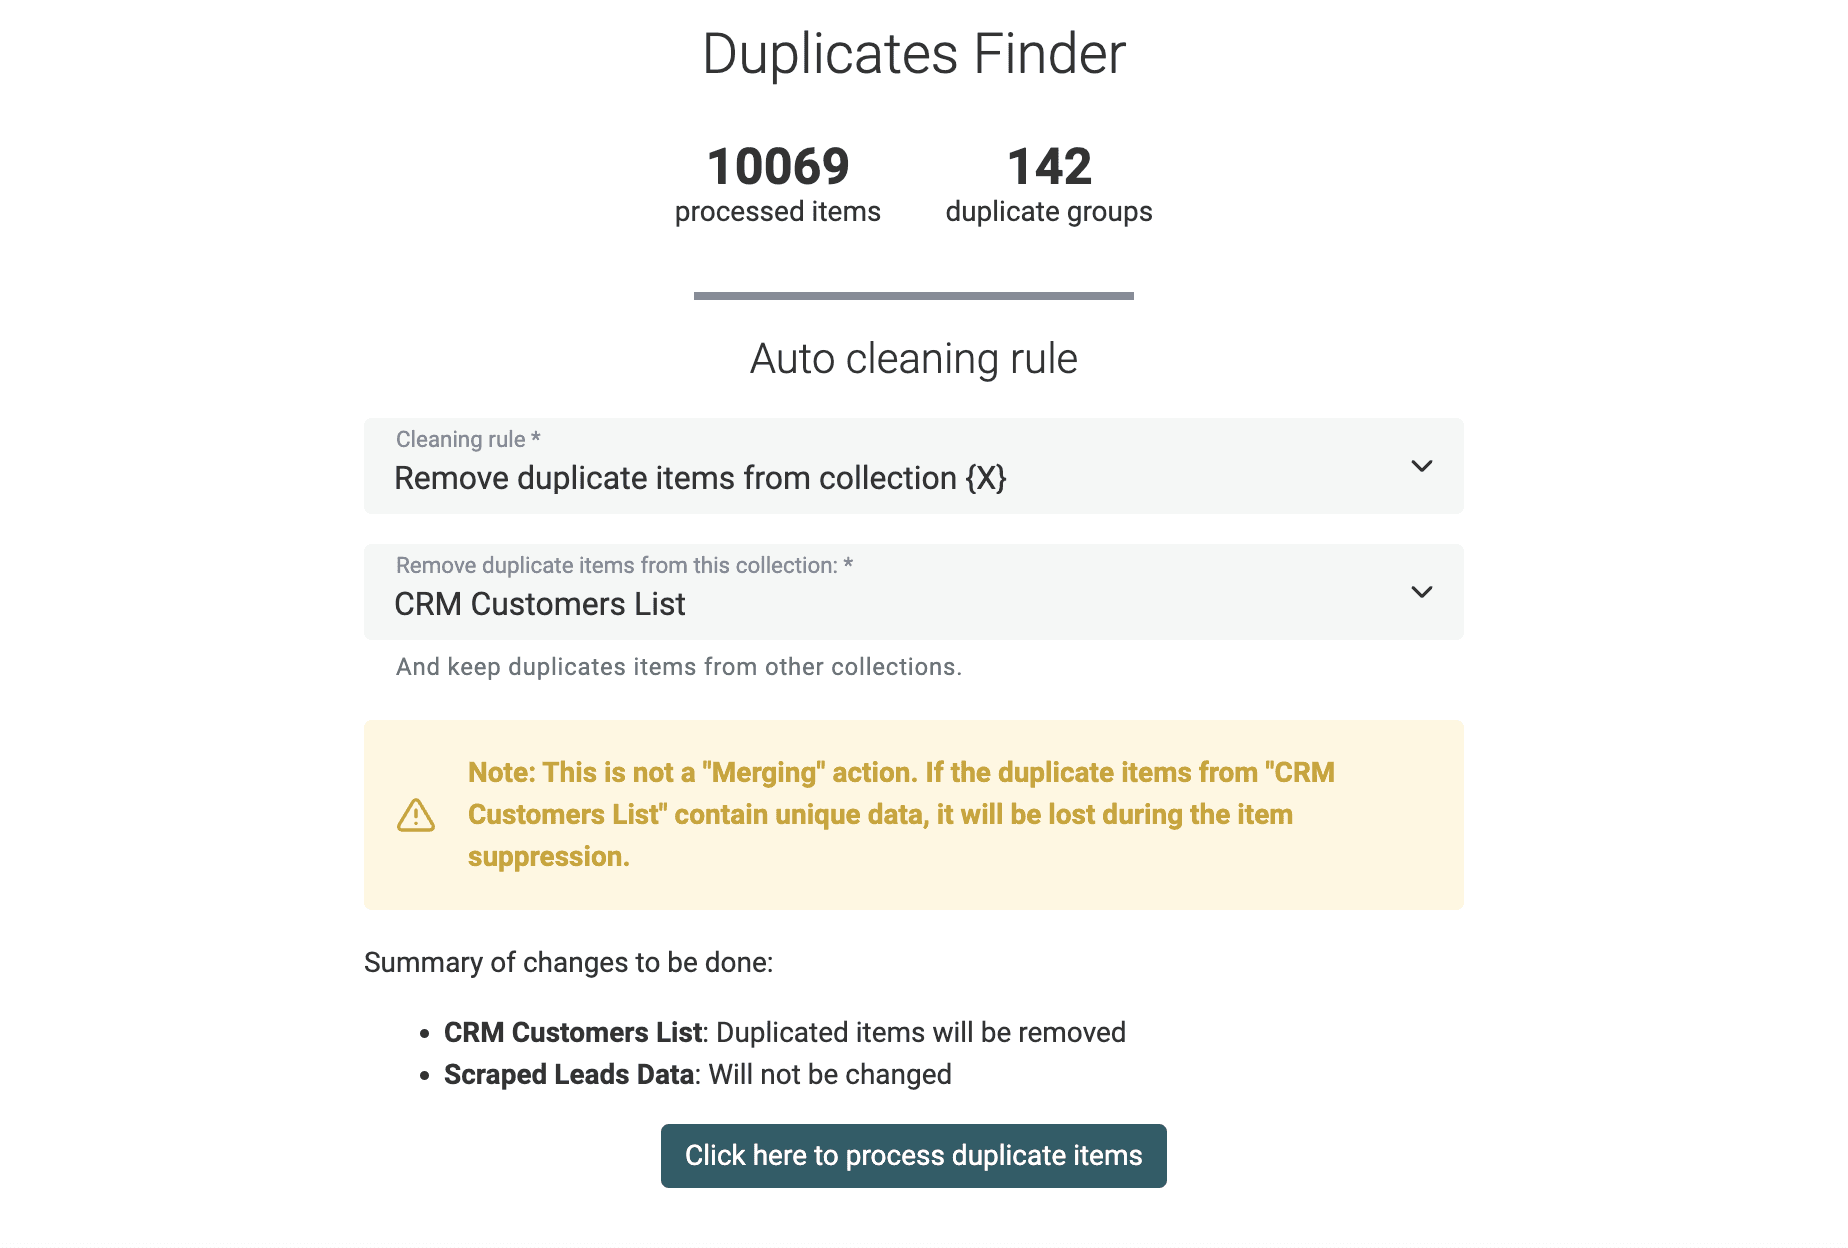
En su lugar, Datablist ofrece una función de limpieza que elimina los elementos duplicados de todas las colecciones excepto una. Use esta herramienta para garantizar que cada elemento sea único en el conjunto de sus datasets.
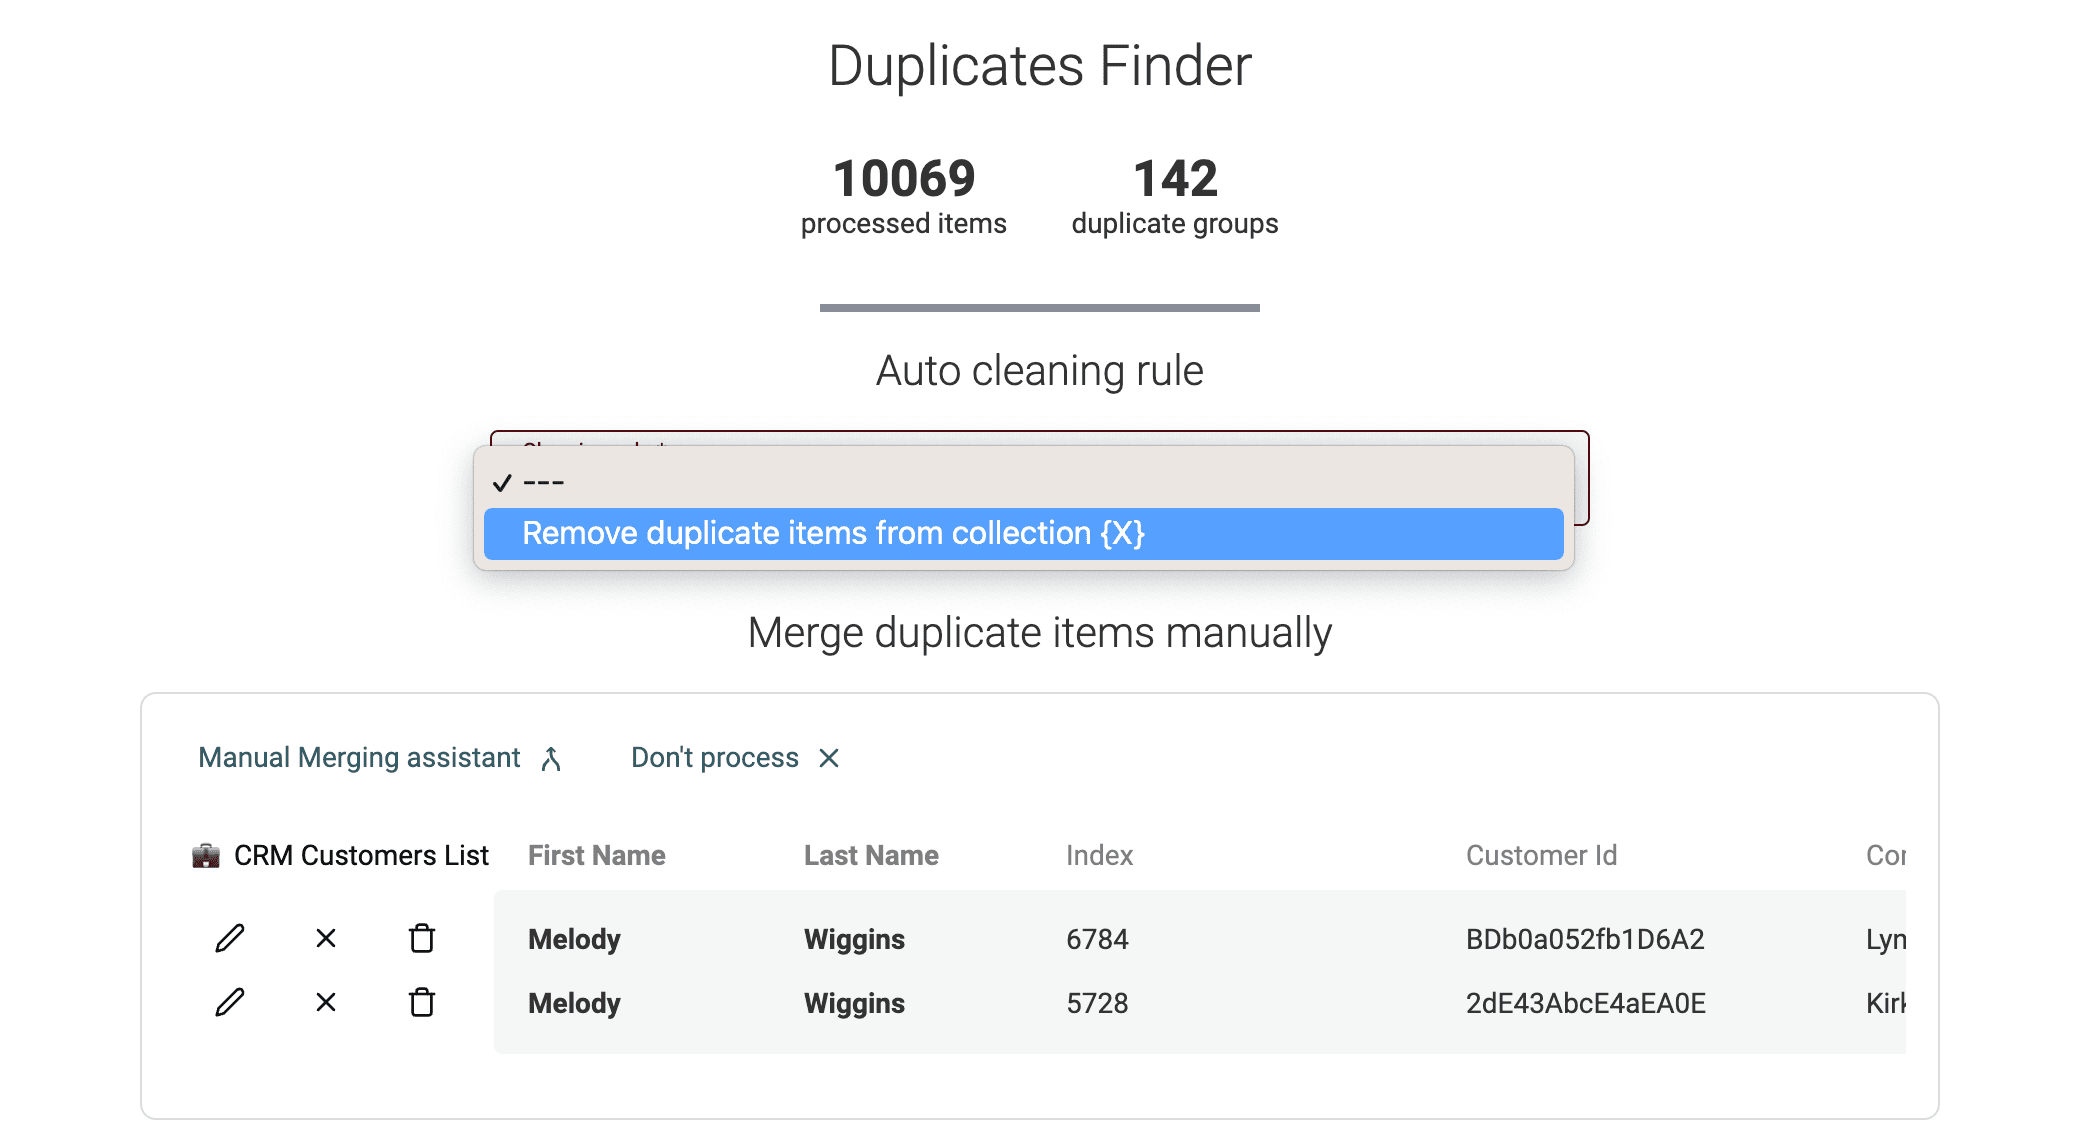
Antes de ejecutar el algoritmo de limpieza se muestra una vista previa de los cambios que se aplicarán.
Fusión manual con Merging Assistant
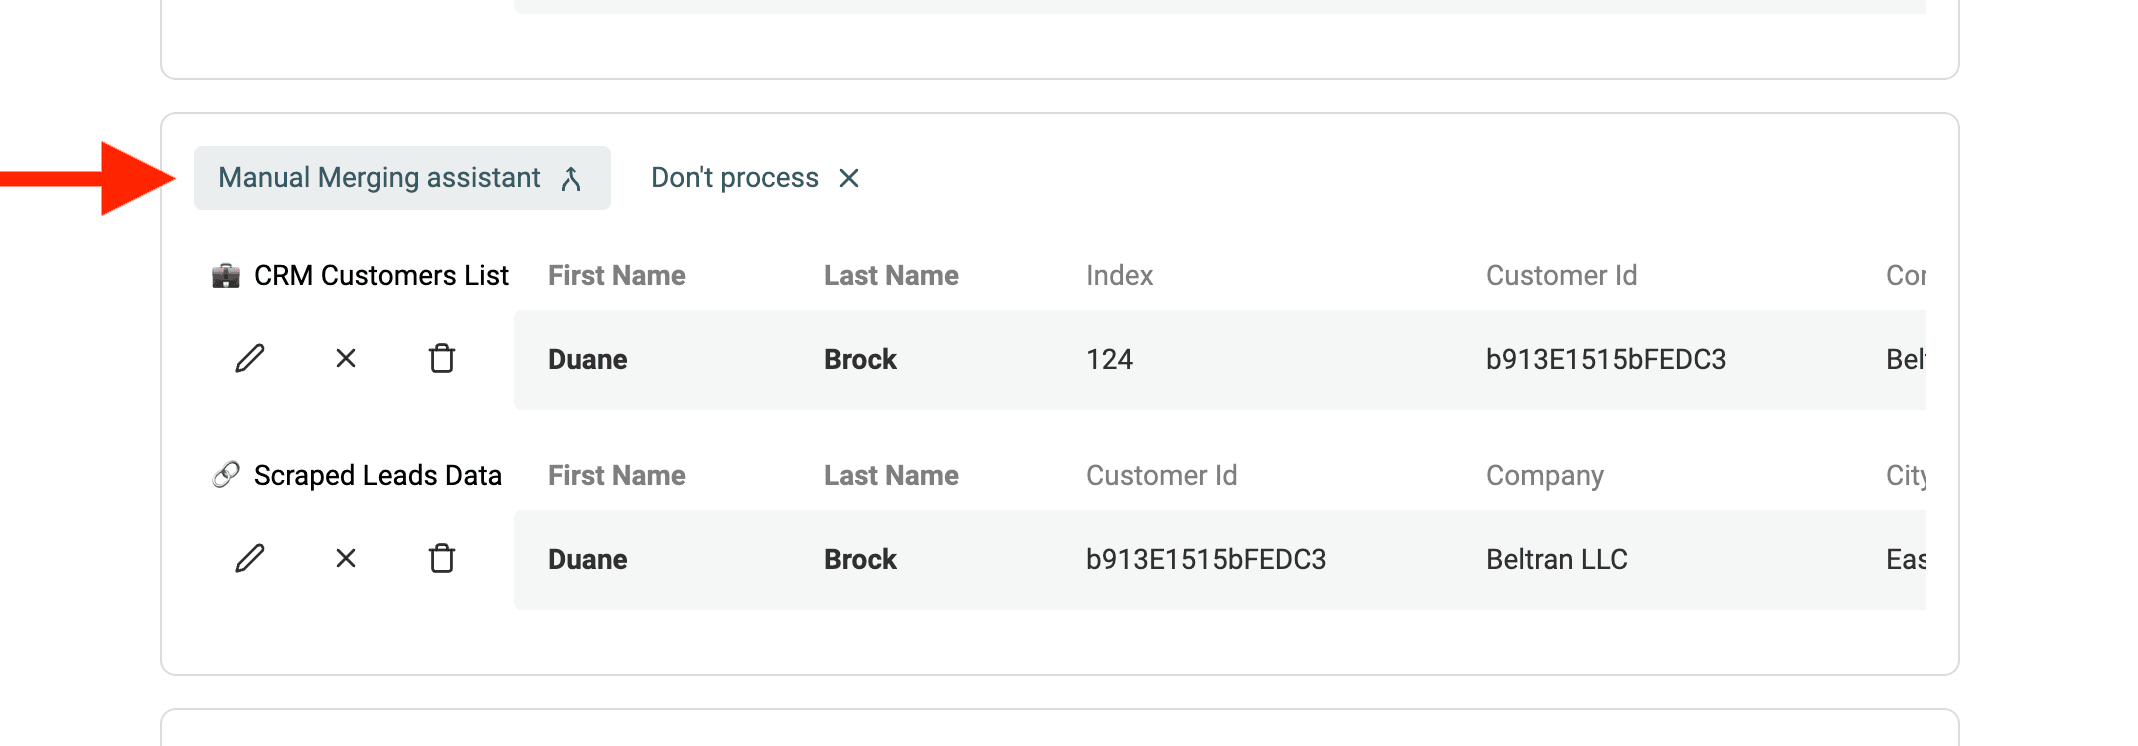
Para los registros duplicados restantes, dispone de un asistente de fusión manual.
Haga clic en Review group y abra Manual Merging Assistant.
Se abrirá la herramienta de fusión. A la derecha aparece un "Primary Item" y, a la izquierda, los demás elementos duplicados, denominados "Secondary Items". Datablist elige como "Primary Item" el elemento que contiene más datos.
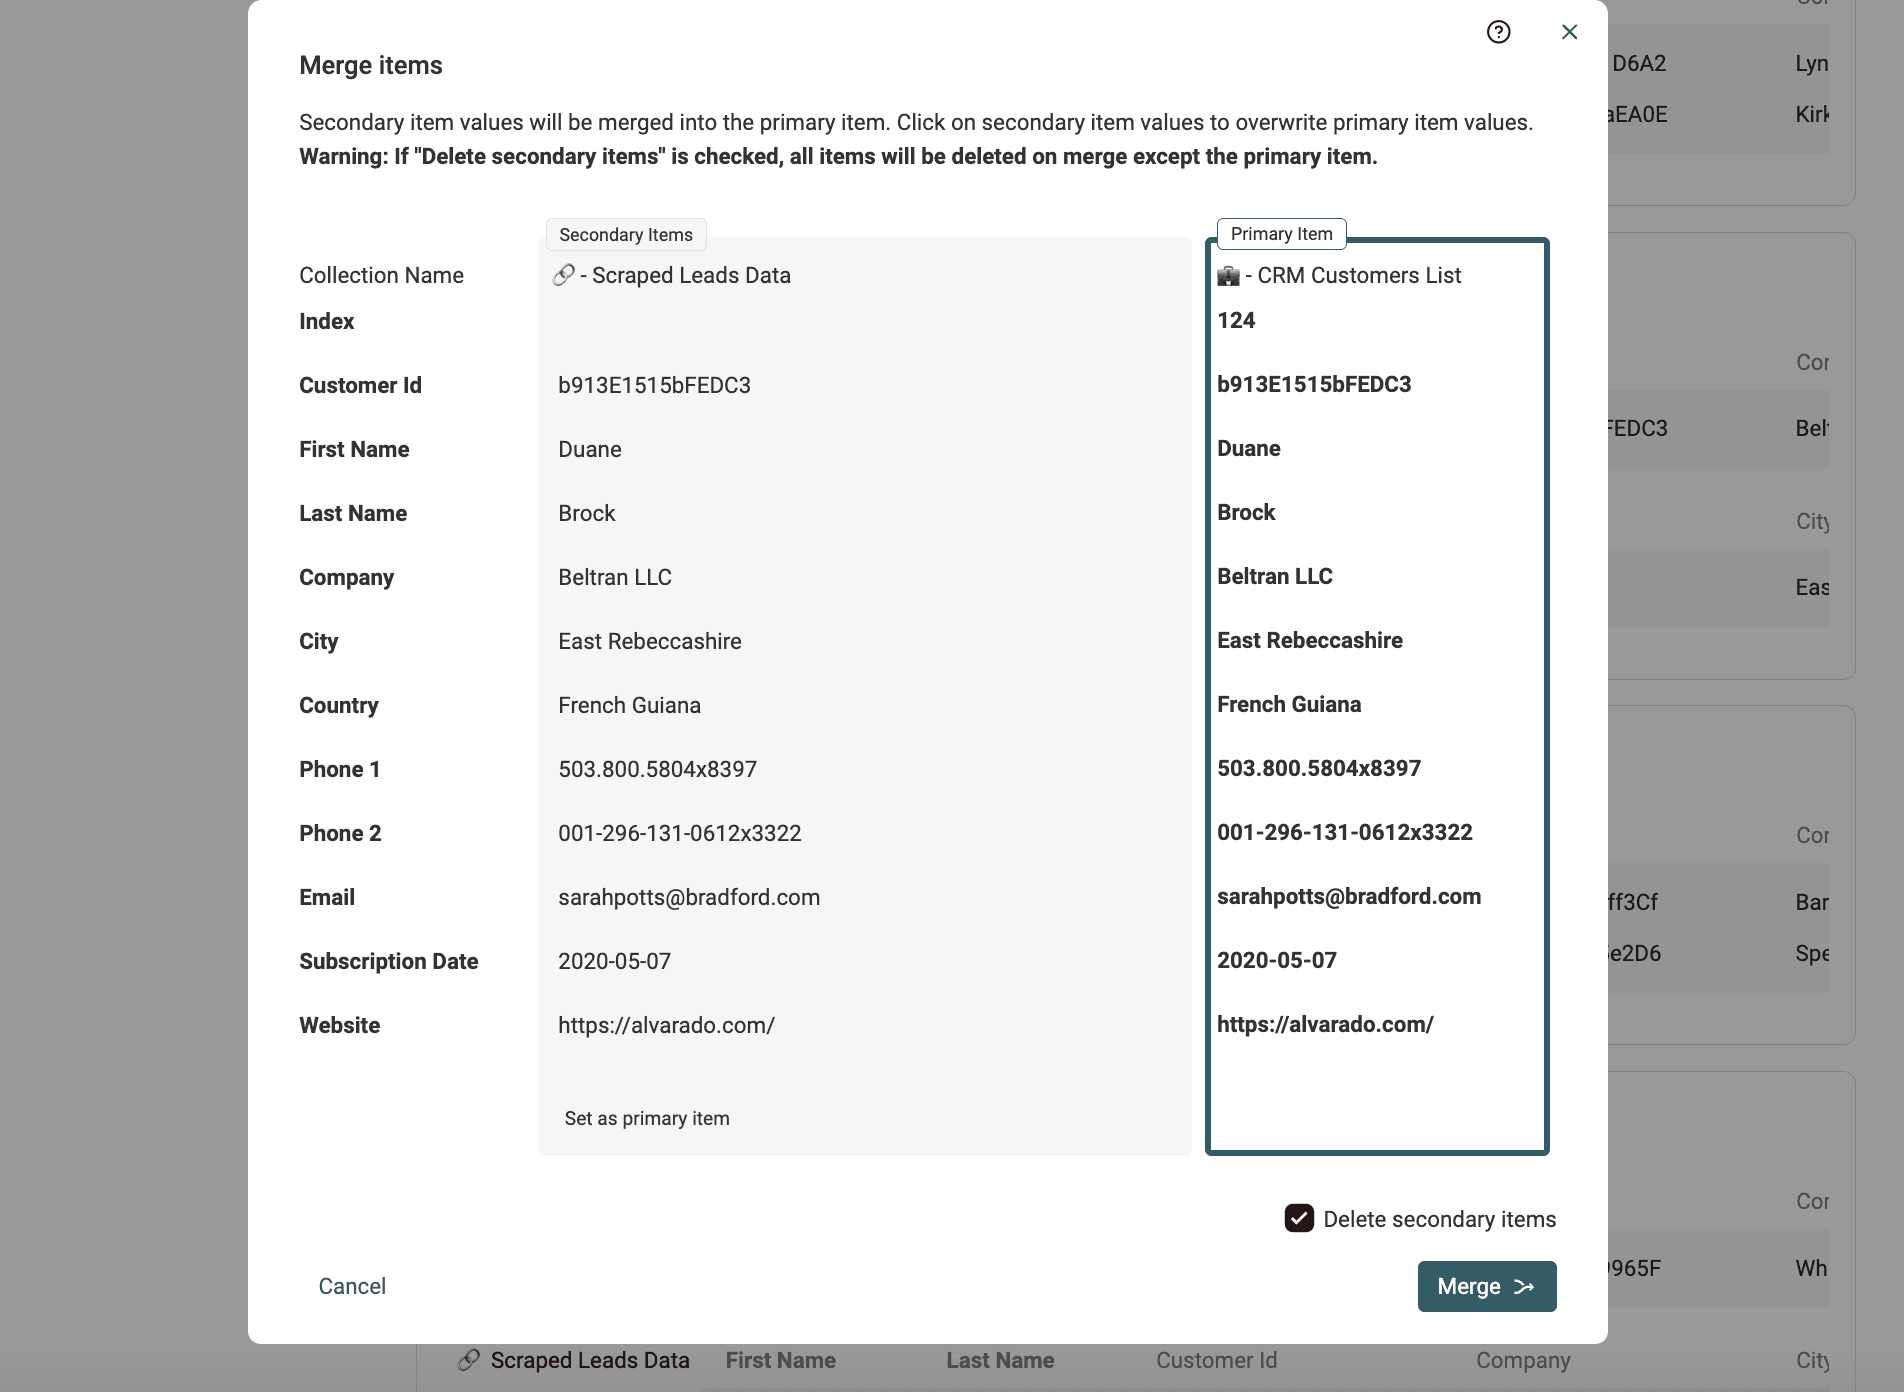
Cuando es posible, los valores de las propiedades de los elementos secundarios se seleccionan automáticamente para incorporarlos al elemento principal. Si hay varios valores en conflicto, deberá decidir cuál conservar.
Si el "Primary Item" resultante es correcto, haga clic en el botón Merge para confirmar la fusión. Todos los elementos secundarios se eliminarán y solo se conservará el elemento combinado.
Notas Manual Merging Assistant está disponible al deduplicar varias colecciones si estas tienen una estructura de datos similar, es decir, las mismas propiedades.
Descargar grupos duplicados para fusionarlos con otra herramienta
Por último, la herramienta Data Matching de Datablist permite exportar los grupos duplicados detectados. Puede generar un archivo CSV o Excel en el que todos los elementos duplicados aparecen de forma consecutiva.
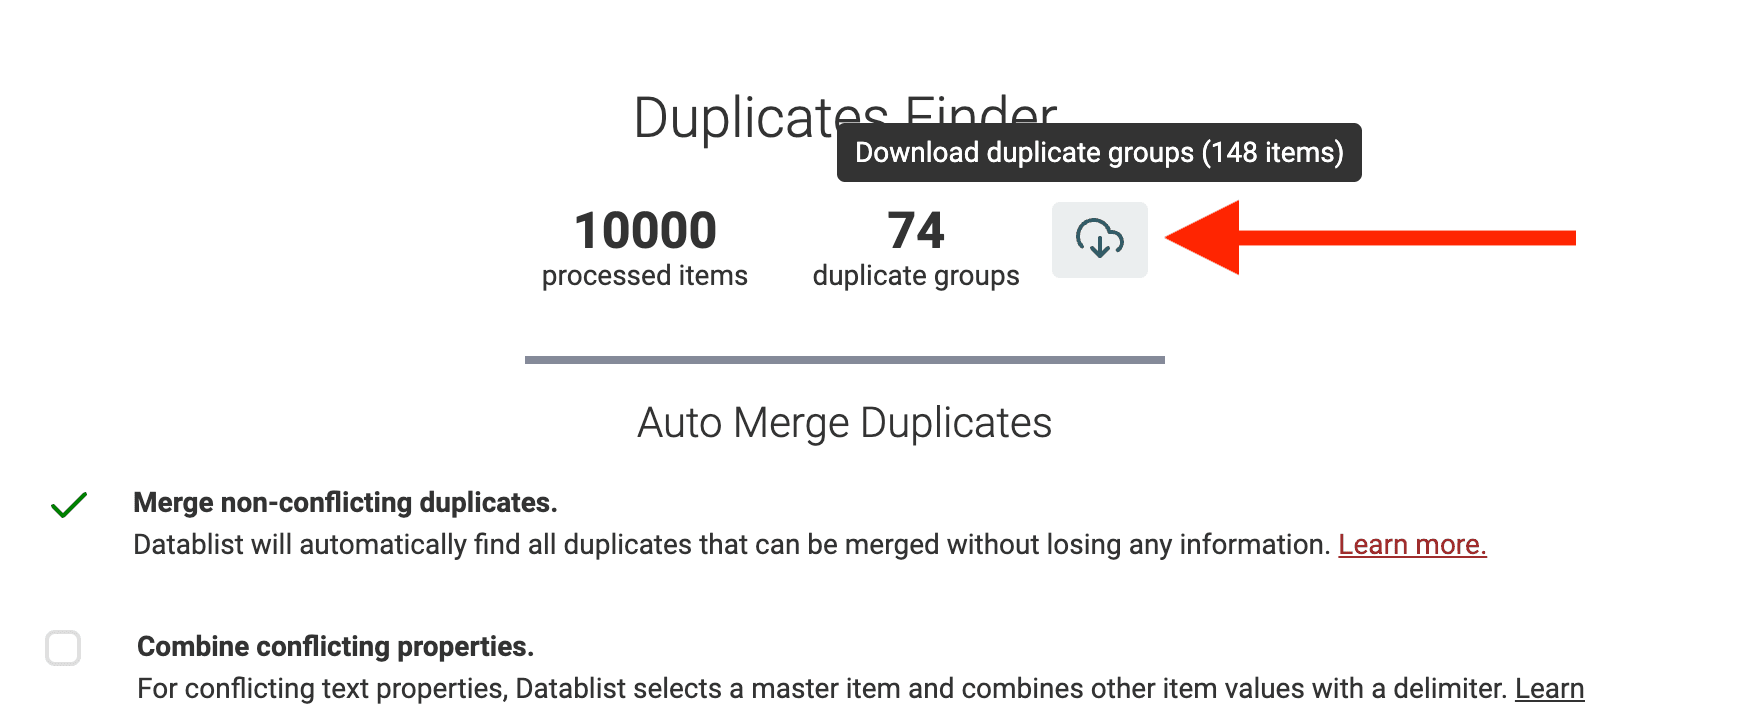
Use el archivo exportado para limpiar sus registros con otra herramienta, por ejemplo, una hoja de cálculo, o para realizar análisis más complejos.
FAQ
¿Qué es el data matching?
El data matching, también conocido como vinculación de registros o deduplicación, es el proceso de identificar y relacionar registros asociados dentro de uno o varios datasets. Su principal objetivo es mejorar la calidad, la precisión y la coherencia de los datos mediante la detección y consolidación de entradas duplicadas o similares que representan las mismas entidades, personas u objetos.
Este proceso resulta útil para limpiar datasets que van acumulando registros duplicados con el tiempo o para combinar varios datasets con campos similares o solapados.
El data matching puede utilizar campos discriminantes, como una dirección de email, la URL de un sitio web o cadenas y números de identificación. También puede combinar atributos no únicos, como el nombre, la fecha de nacimiento, la empresa o la ubicación, para generar una puntuación de similitud entre registros.
¿Qué velocidad ofrece el data matching de Datablist?
La herramienta Data Matching de Datablist carga sus datasets en memoria para efectuar el análisis. Está indicada para datasets de menos de un millón de registros y completa la mayoría de los análisis de matching en pocos minutos.
¿Necesito conocimientos técnicos para hacer Data Matching?
No. Datablist es una solución no-code pensada para cualquier perfil, desde analistas de datos hasta profesionales de marketing o ventas.
¿Cuándo conviene usar data matching?
El data matching se utiliza en ámbitos muy diversos, como las finanzas, la sanidad, el marketing y la gestión de clientes, donde disponer de datos fiables es esencial para tomar decisiones fundamentadas o integrar información con otras herramientas.
Este proceso facilita tareas como la detección de fraude, la consolidación de perfiles de usuario y el enriquecimiento de datos a partir de varias fuentes.
¿Cuál es el siguiente paso?
Si le interesa la limpieza de datos, le recomendamos estas guías: