
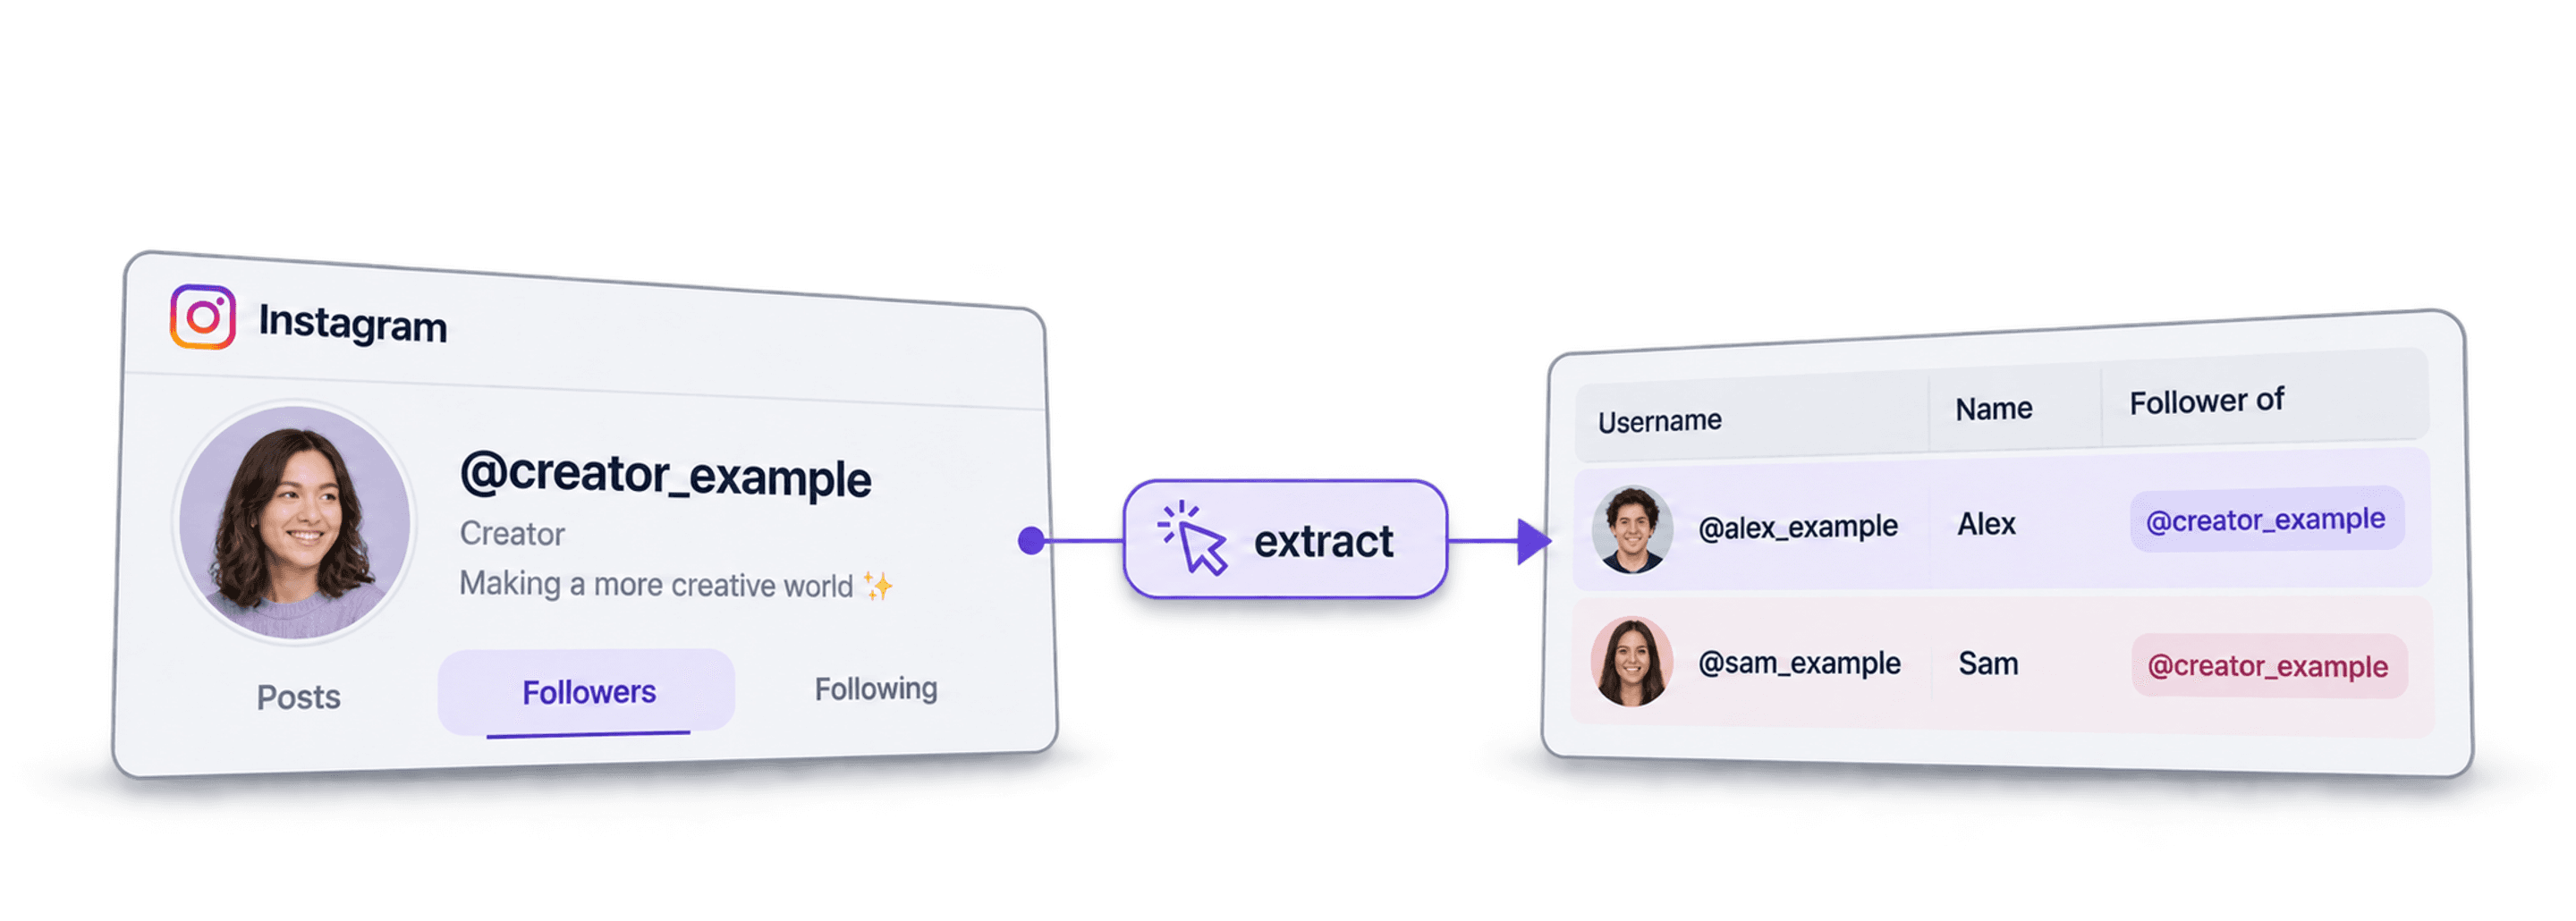
Datablist에서 Instagram 팔로워를 스크래핑하려면 Instagram Followers/Following Scraper 소스를 열고, 공개 프로필 URL이나 username 또는 user ID를 입력하세요. 그런 다음 프로필별 수집 한도를 설정하고 반환된 팔로워 행을 검토한 뒤 내보내면 됩니다.
처음에는 프로필 하나와 적은 한도로 테스트하는 것이 좋습니다. 반환된 목록은 제공업체가 조회할 수 있었던 계정의 스냅샷일 뿐, 해당 프로필의 실시간 전체 팔로워 목록을 보장하지 않습니다. 또한 특정 분야의 인플루언서를 팔로우한다는 사실만으로 그 사람의 직업, 위치 또는 구매 의향을 판단할 수는 없습니다.
이 가이드에서는 소스 설정, 관계 데이터 출력, 검토 및 중복 제거, 대규모 스크래핑 재개 방법과 프로필 상세 정보용 별도 enrichment를 설명합니다. Instagram 로그인 정보는 필요하지 않습니다.
📌 빠른 작업 순서
Collection을 만들고 See all sources를 연 다음 Instagram Followers/Following Scraper를 선택하세요. Instagram Profiles에 프로필을 한 줄에 하나씩 입력하고, Scrape followers or following에서는 ***Followers (default)***를 유지한 뒤 Scraping Limit Per Profile을 설정합니다. 팔로워 식별자와 소스 프로필 출력 필드를 추가하고 샘플을 실행한 다음, 결과를 검토하여 내보내세요.
Instagram 팔로워 스크래핑 비용은 얼마인가요?
팔로워 목록 추출 비용은 반환된 팔로워 1명당 0.01크레딧입니다. 소스 프로필의 식별자가 캐시에 없으면 프로필 확인에 1크레딧이 추가될 수 있습니다. 프로필 상세 정보 enrichment 비용은 별도입니다.
하나의 소스 프로필에서 정확히 1,000개의 팔로워 행이 반환된다고 가정해 보겠습니다.
- 팔로워 목록: 1,000 × 0.01 = 10크레딧에 캐시되지 않은 소스 조회 비용 1크레딧을 더해 11크레딧입니다.
- 선택한 팔로워 100명의 상세 정보: 반환된 User Id를 사용하면 표준 프로필 조회 비용은 1명당 2크레딧이므로 200크레딧입니다. 공개된 이메일과 전화번호가 있으면 반환될 수 있지만, 두 정보 모두 제공된다는 보장은 없습니다.
- 합계: 팔로워 목록과 100건의 프로필 조회에 총 211크레딧이 듭니다. About 데이터를 추가하거나 다른 scraping type을 선택하면 enrichment 비용이 달라집니다.
USD 월간 결제 기준으로 Starter 요금제는 $25이며 5,000크레딧이 포함됩니다. 크레딧을 아직 사용하지 않았다면 이 예시에서는 추가 충전이 필요 없으며 4,789크레딧이 남습니다. 실제 결제 금액은 구독료 $25이고, 이 workflow에서 사용되는 양은 211크레딧입니다. 크레딧의 달러 환산 가치는 요금제와 추가 충전 패키지에 따라 달라집니다.
이 프로필 enrichment 예시에서는 반환된 User Id를 사용하세요. username이나 URL을 사용하면 식별자 조회가 한 번 더 필요할 수 있습니다. 샘플 실행 후 실제 반환된 행과 크레딧 사용량을 확인하세요. 제공업체 페이지에서 요청한 소량의 한도를 초과해 결과가 반환될 수 있으며, 팔로워 행이 하나도 반환되지 않아도 프로필 조회 과정에서 크레딧이 사용될 수 있습니다. 따라서 요청 한도가 정확한 지출 상한선은 아닙니다.
Datablist란? 핵심 기능 살펴보기
Datablist는 Lead Generation workflow를 위한 스프레드시트형 workspace입니다. AI Agents, Email Finders, AI processors, Technology enrichments 등 다양한 enrichments를 활용해 데이터를 수집하고 검토하며 보강한 뒤 내보낼 수 있습니다.
또한 Datablist에서는 정해진 일정이나 필요할 때 실행되는 자동화 workflow를 설정할 수 있습니다. Datablist 사용자들이 자주 활용하는 사례는 다음과 같습니다.
Instagram 팔로워를 저렴하게 스크래핑하는 방법
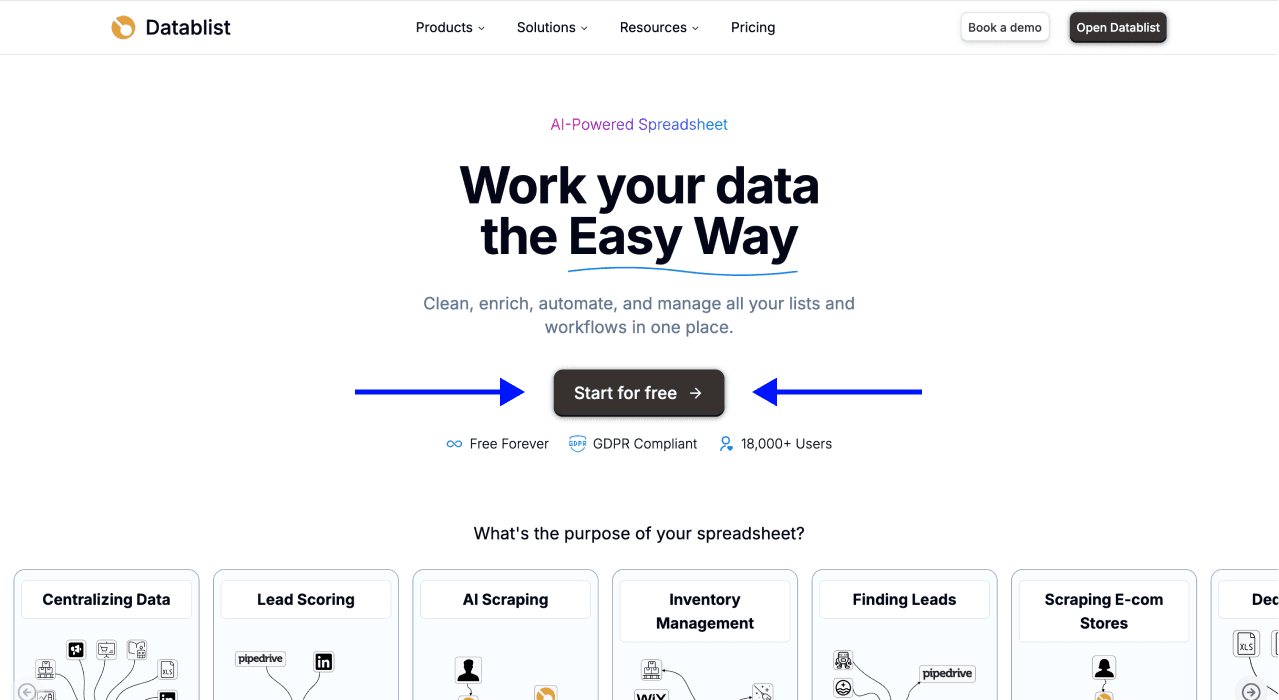
이제 직접 시작해 보겠습니다. 먼저 Datablist에 접속해 스크래핑할 대상을 설정해야 합니다. 팔로워를 수집하려는 인플루언서의 프로필 URL이나 username을 붙여 넣으면 됩니다.
먼저 샘플을 설정하고 소스 프로필과 반환 필드를 확인한 다음 범위를 넓히세요. 이 workflow에는 브라우저 확장 프로그램이나 별도의 제공업체 API key가 필요하지 않습니다.
📘 중요: 비공개 프로필
이 workflow로는 비공개 프로필의 팔로워 목록을 가져올 수 없습니다. 팔로워 행이 반환되지 않더라도 프로필을 확인하는 과정에서 크레딧이 사용될 수 있습니다. 프로필 상세 정보 enrichment는 별도의 조회 작업이며, 비공개 게시물이나 팔로워 목록에 대한 접근 권한을 제공하지 않습니다.
1단계: Datablist.com 회원가입
Datablist.com에서 계정을 만드세요. 계정 설정 절차를 완료하면 workspace를 열 수 있습니다.
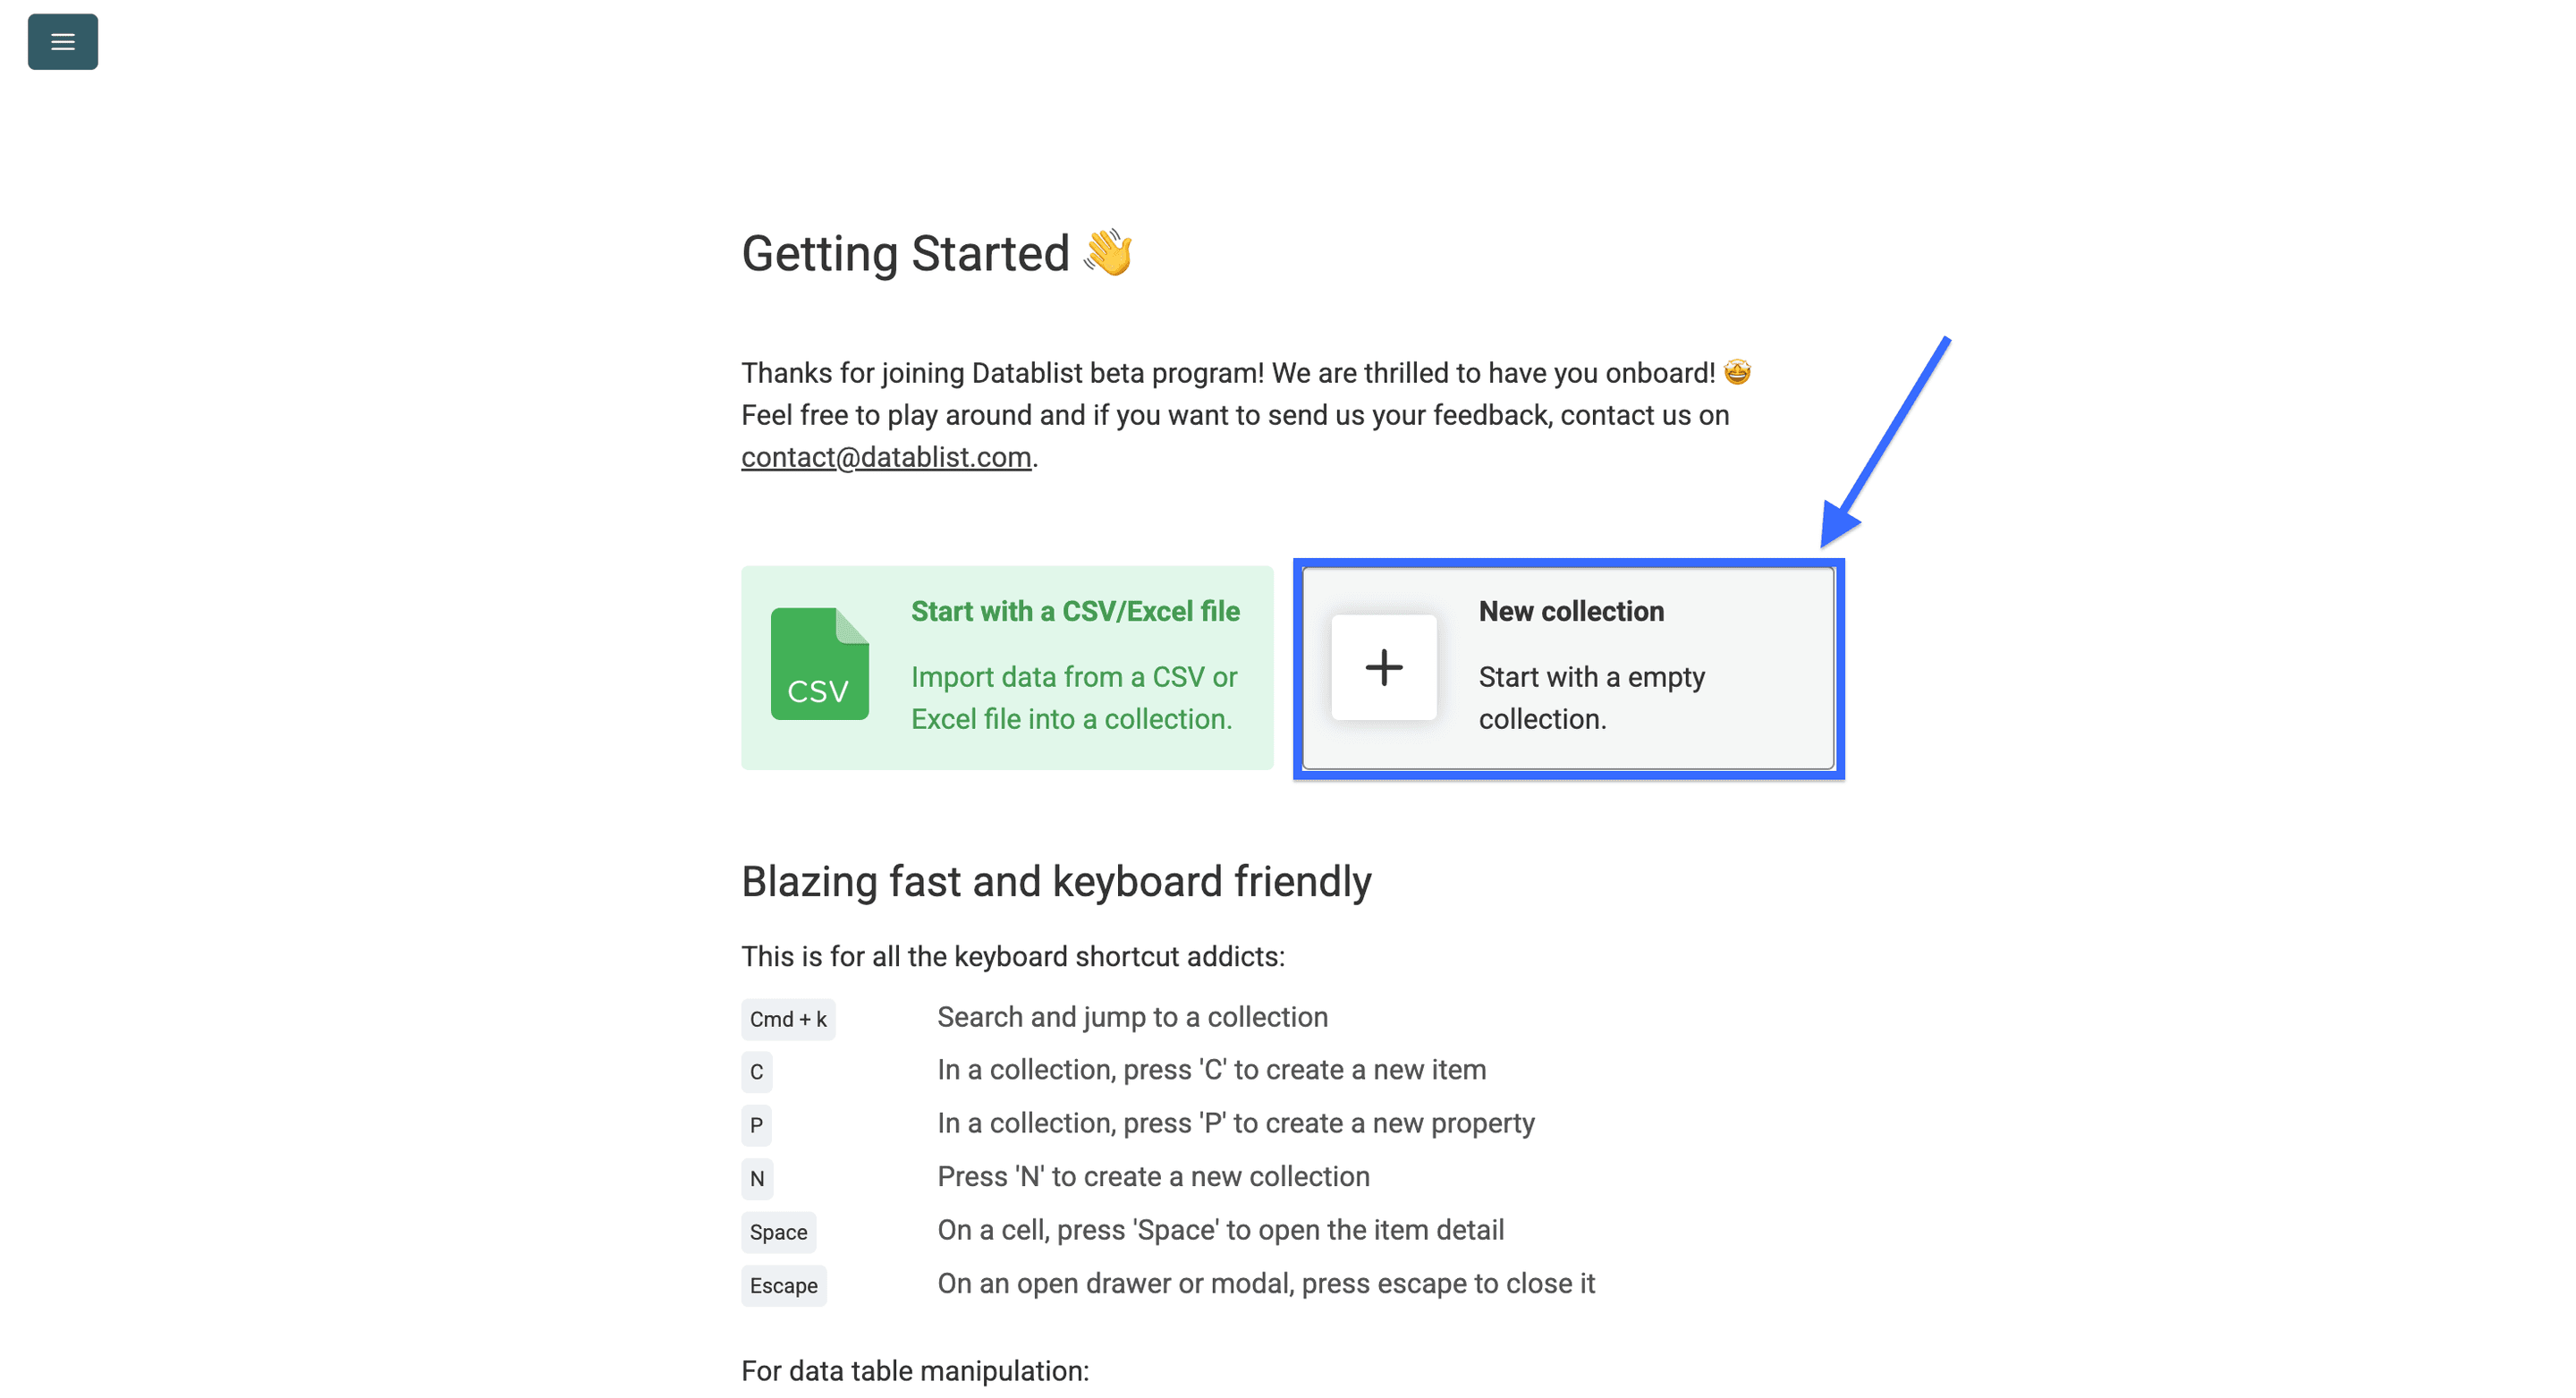
2단계: 새 Collection 만들기
로그인한 뒤 New Collection을 클릭하세요.
3단계: Instagram Followers/Following Scraper 열기
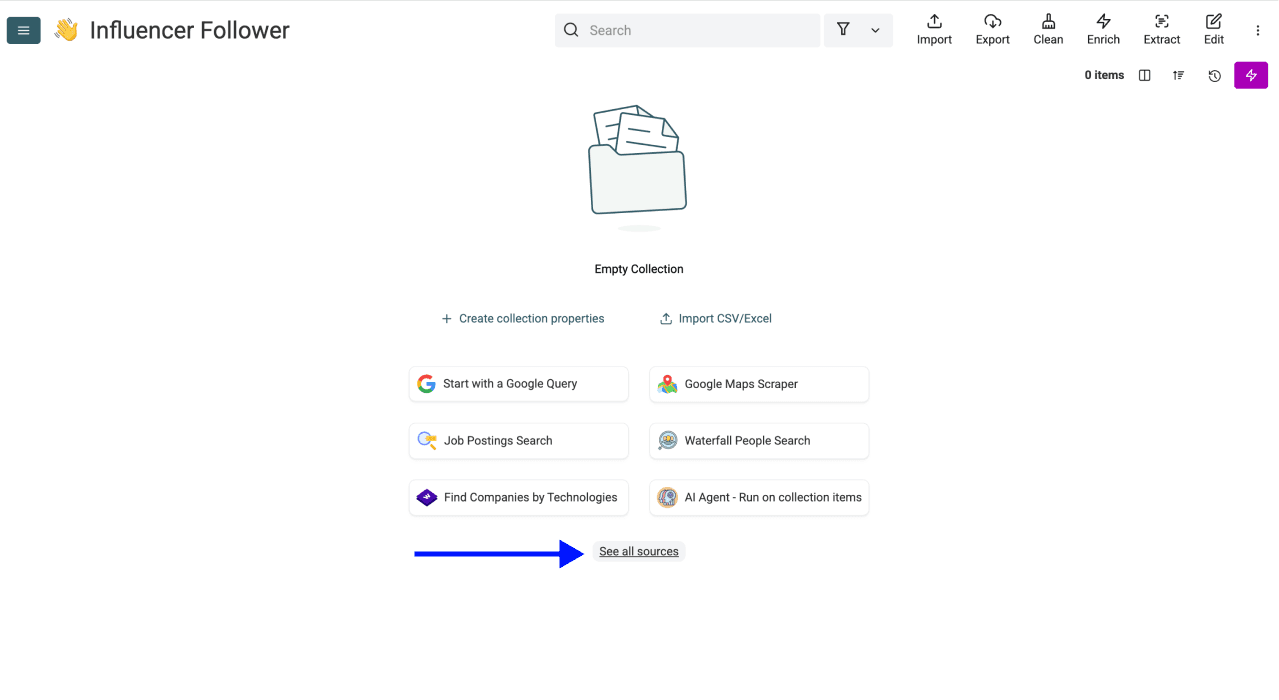
See all sources를 클릭하세요.
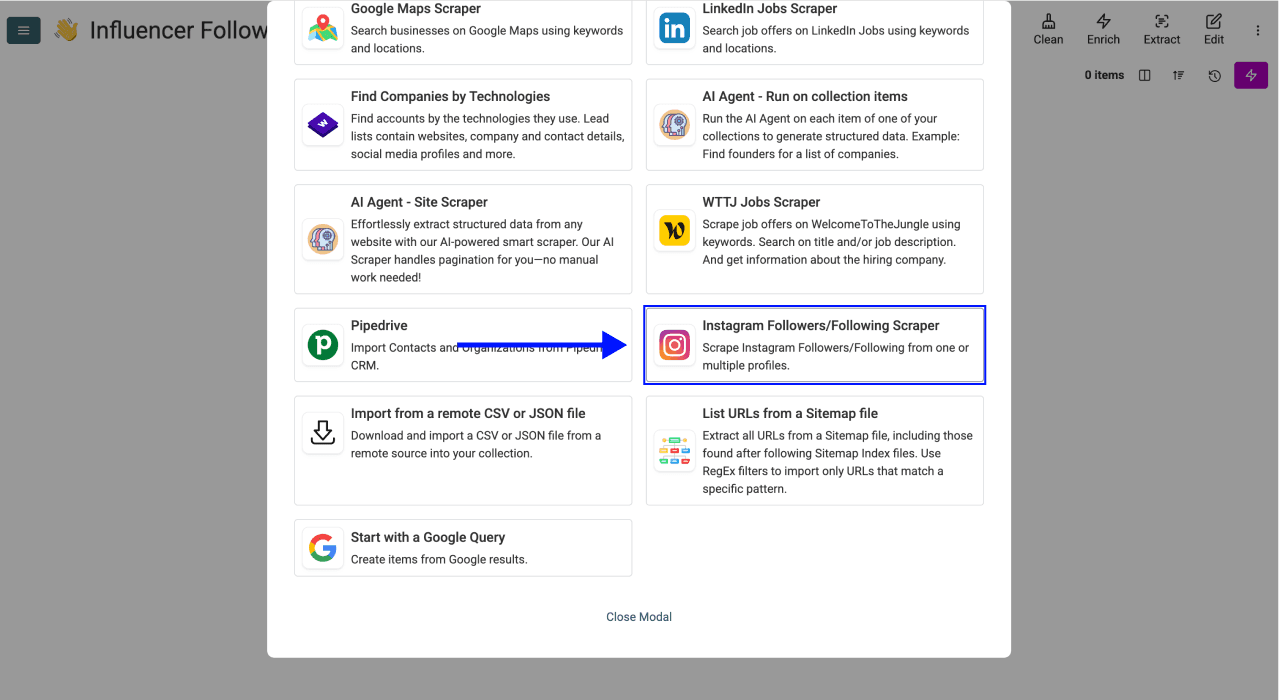
아래로 스크롤한 뒤 목록에서 Instagram Followers/Following Scraper를 선택하세요.
4단계: 스크래핑 설정 구성하기
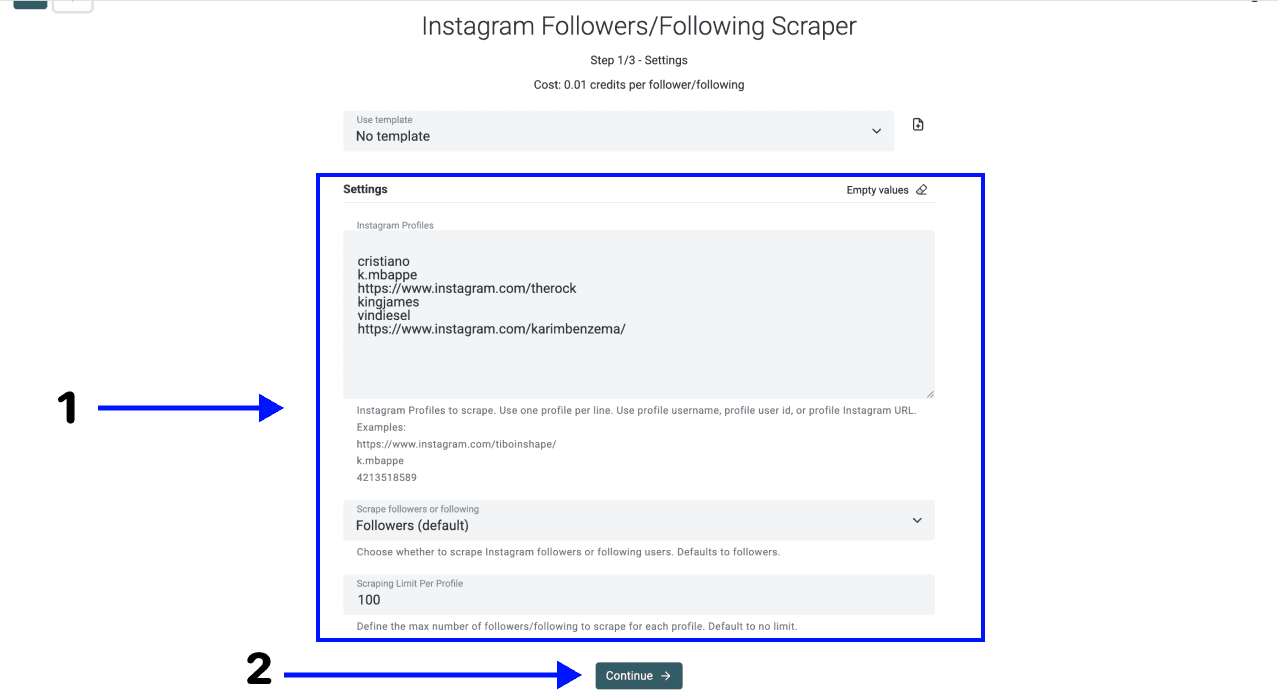
간단한 설정 화면이 표시됩니다. 원하는 결과를 얻으려면 다음과 같이 진행하세요.
- Instagram Profiles에 공개 프로필 URL, username 또는 user ID를 한 줄에 하나씩 입력합니다. 각 식별자가 원하는 계정을 가리키는지 확인하세요.
- Scrape followers or following에서 ***Followers (default)***를 선택합니다. 입력한 프로필이 팔로우하는 계정을 수집하려는 경우에만 Following을 선택하세요.
- 전체 실행으로 확대하기 전에 Scraping Limit Per Profile을 적은 샘플 수로 설정하세요. 이 한도는 전체 목록 수집을 보장하지 않습니다.
- Continue를 클릭하고 출력 열을 설정합니다.
5단계: 출력 필드 선택하기
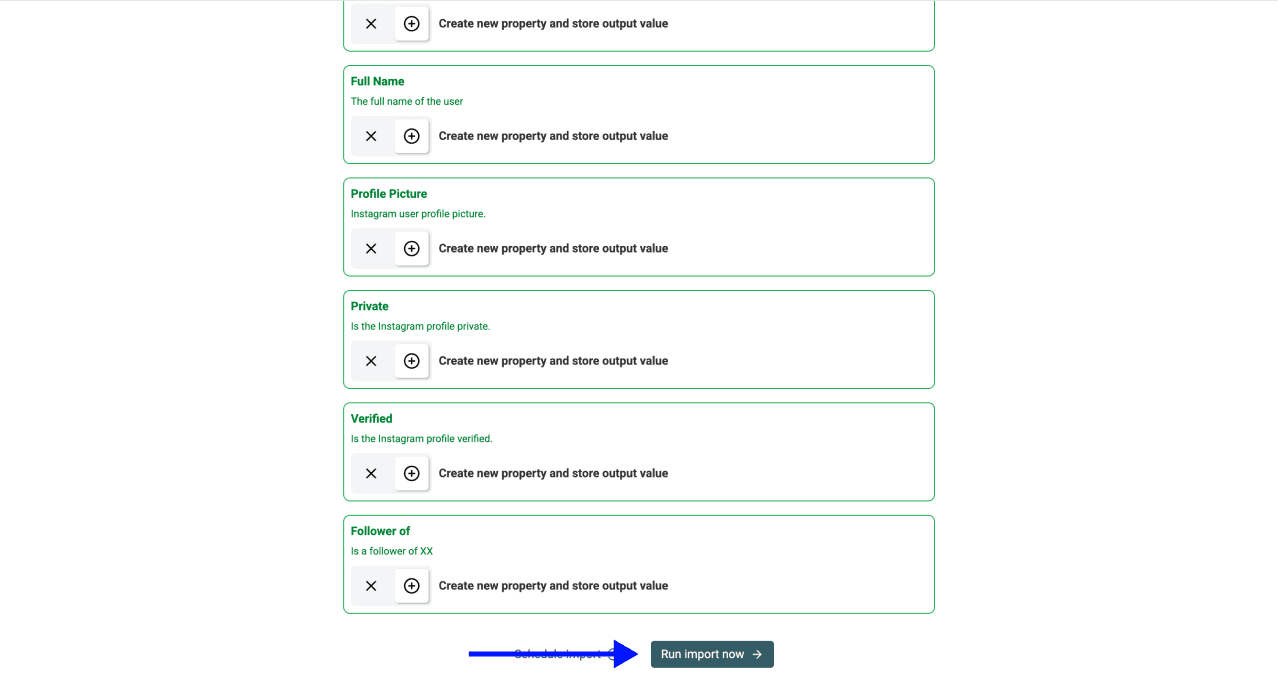
Datablist에 사용 가능한 출력 필드가 표시됩니다. 팔로워의 User Id, User Username, User Profile URL과 소스 프로필 필드를 유지하세요. 이 필드를 사용하면 각 행이 누구를 나타내는지, 어떤 입력 프로필에서 생성되었는지 확인할 수 있습니다.
필요하지 않은 항목은 ✕ 아이콘을 클릭해 제거한 다음 Run import now를 클릭하세요.
6단계: 스크래핑 결과 확인하기
소스 실행이 완료되면 반환된 행 수를 요청한 한도와 비교하고 실행 상태를 확인하세요. 소요 시간은 제공업체의 응답, pagination, 프로필 및 실행 규모에 따라 달라집니다. 반환된 행이 적다고 해서 해당 프로필에 다른 팔로워가 없다고 단정해서는 안 됩니다.
참고: 결과에는 전체 이름도 포함됩니다. 아래 이미지에서는 개인정보 보호를 위해 이름을 가렸습니다.
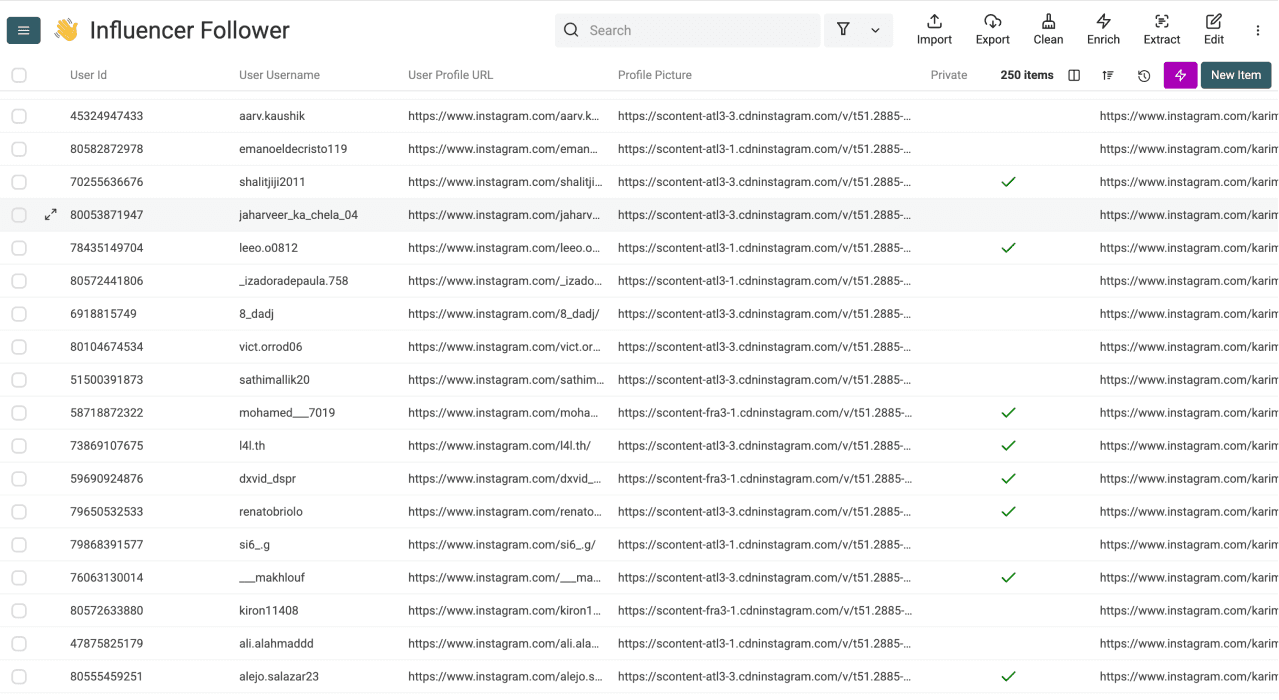
여러 입력 프로필을 처리할 때는 Follower of (UserId), Follower of (Username) 또는 ***Follower of (ProfileUrl)***을 유지하세요. 열 위치에 의존하지 말고 이 필드로 소스 계정별 관계를 필터링할 수 있습니다.
💡 알아두기: 대규모 스크래핑
소스 실행에는 자체 pagination과 행 제한이 있습니다. 이는 Collection 저장 공간 및 cloud synchronization과는 별개의 제한입니다. 더 가져올 결과가 남은 상태에서 실행이 중단되면, 나머지 팔로워가 같은 실행에 모두 들어갈 것이라고 가정하지 말고 아래의 재개 옵션을 사용하세요.
7단계: 팔로워 프로필 상세 정보 Enrichment
팔로워 목록을 확보하는 것은 시작에 불과합니다. 이 username을 실제로 활용할 수 있는 Lead로 전환하려면 상대가 누구인지 파악해야 합니다. Instagram Profile Scraper를 사용하면 공개 이메일 주소, bio, engagement 지표 등의 데이터를 목록에 추가할 수 있습니다.
Lead list 구축에서는 프로필 상세 정보를 세그먼트 판단의 근거로 활용하세요. 팔로워 관계만으로는 신뢰할 수 있는 Lead 선별 기준이 되지 않습니다.
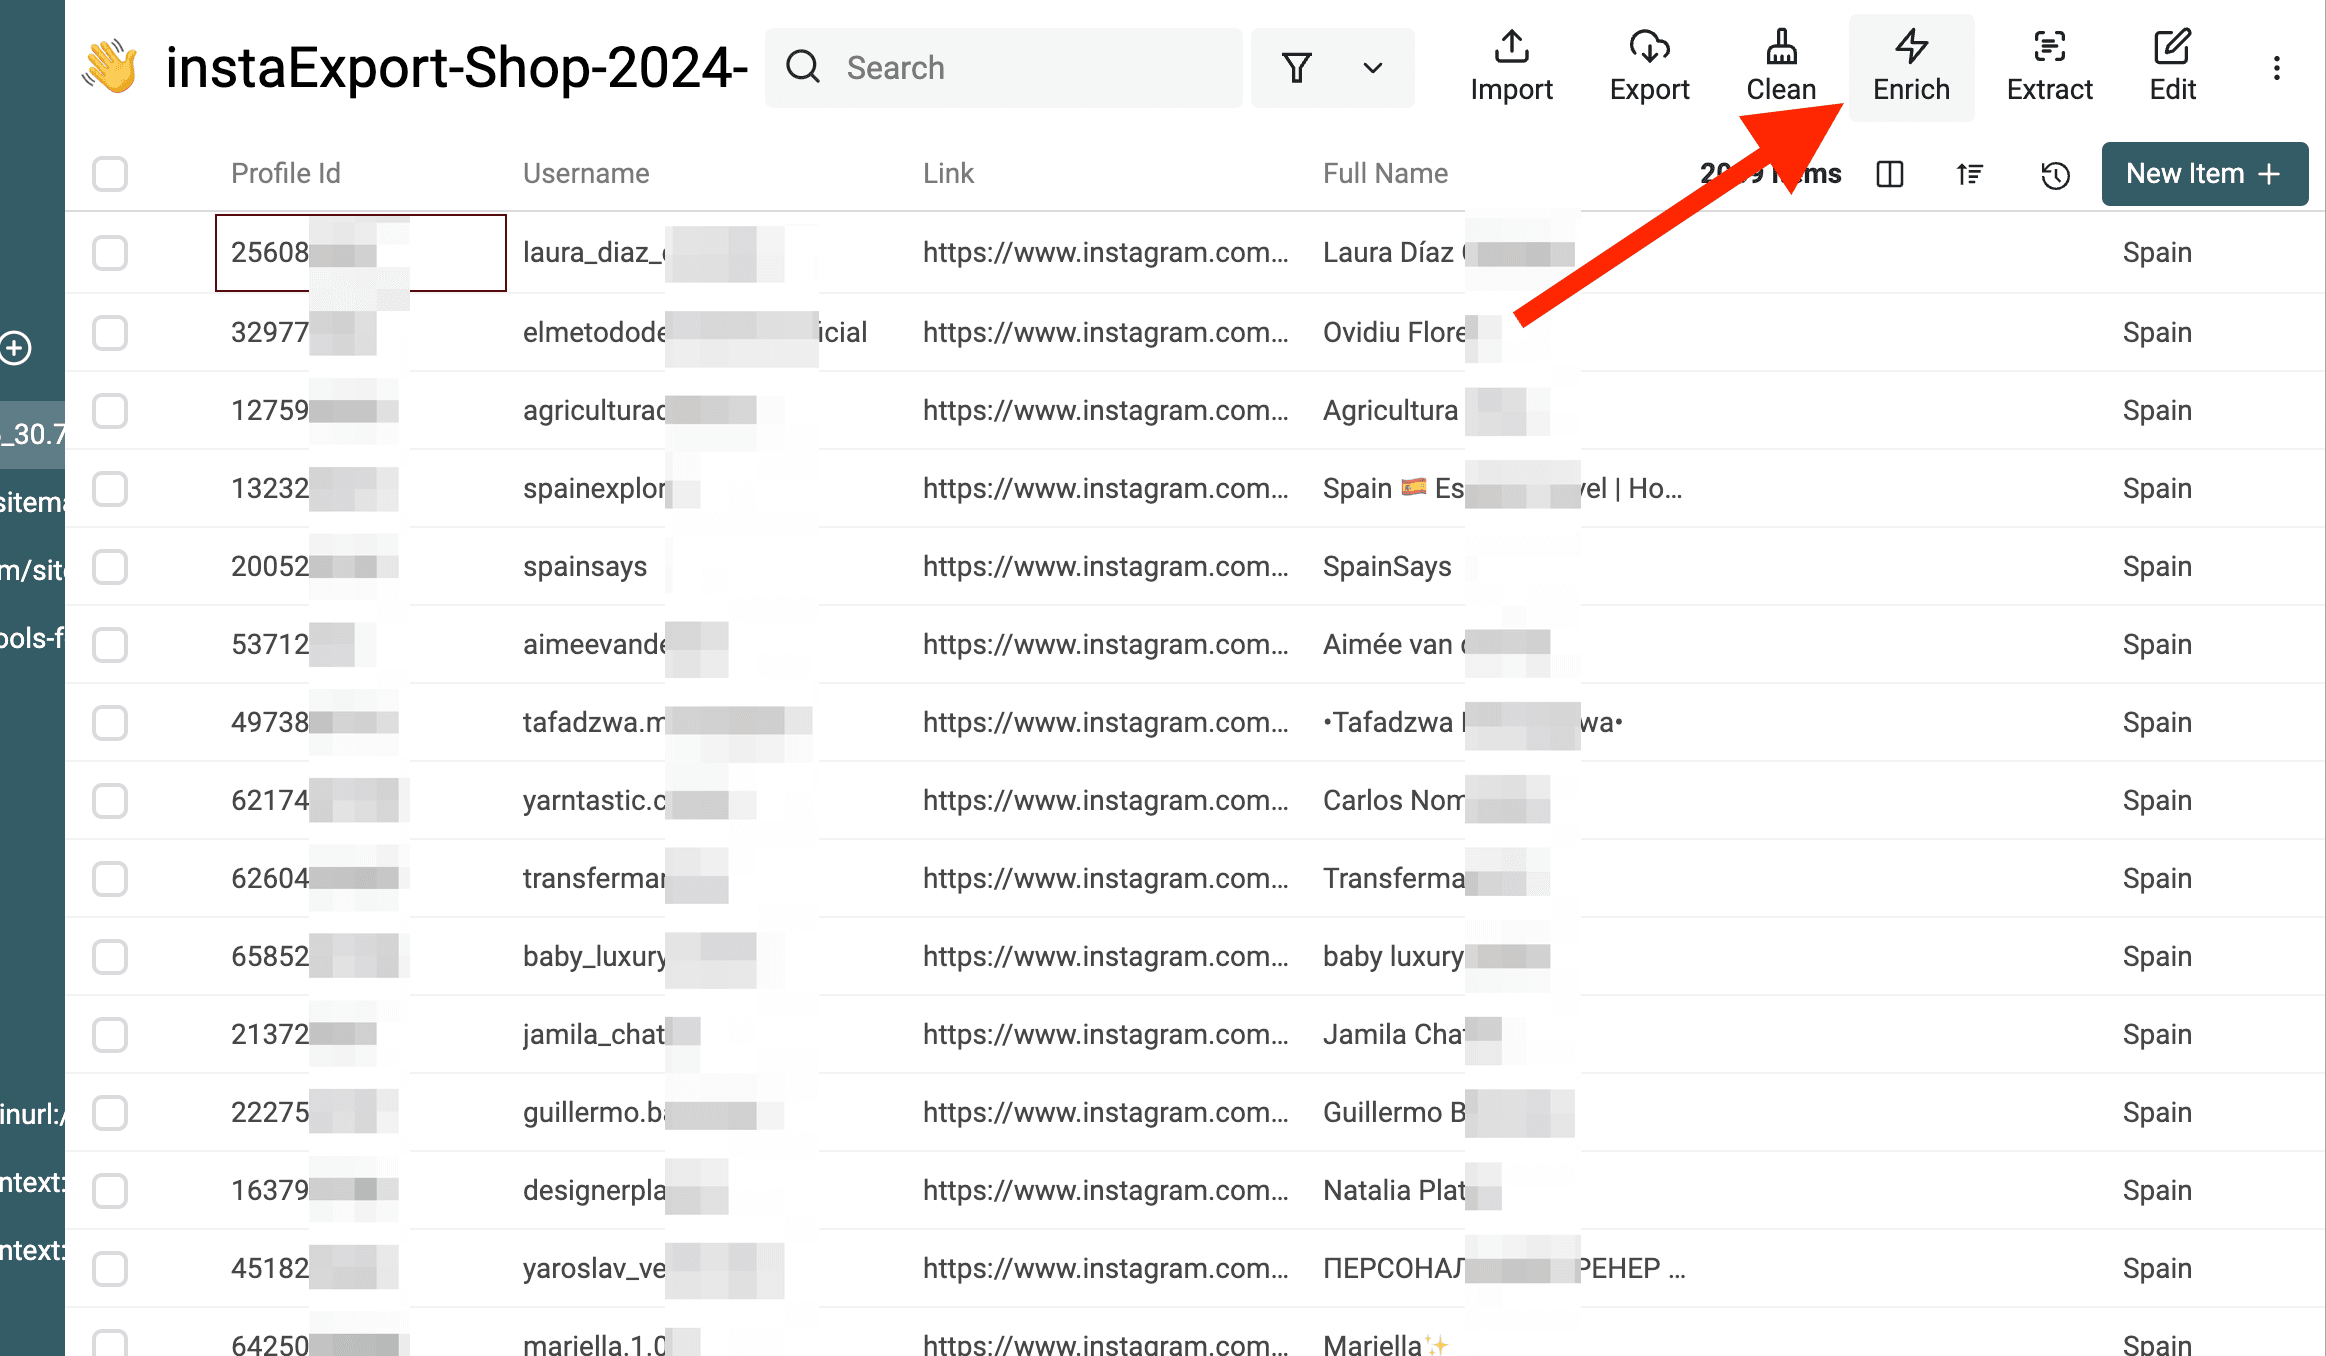
1. Enrichment 메뉴 열기 스크래핑한 팔로워가 담긴 Collection에서 대시보드 상단의 Enrich를 클릭하세요.
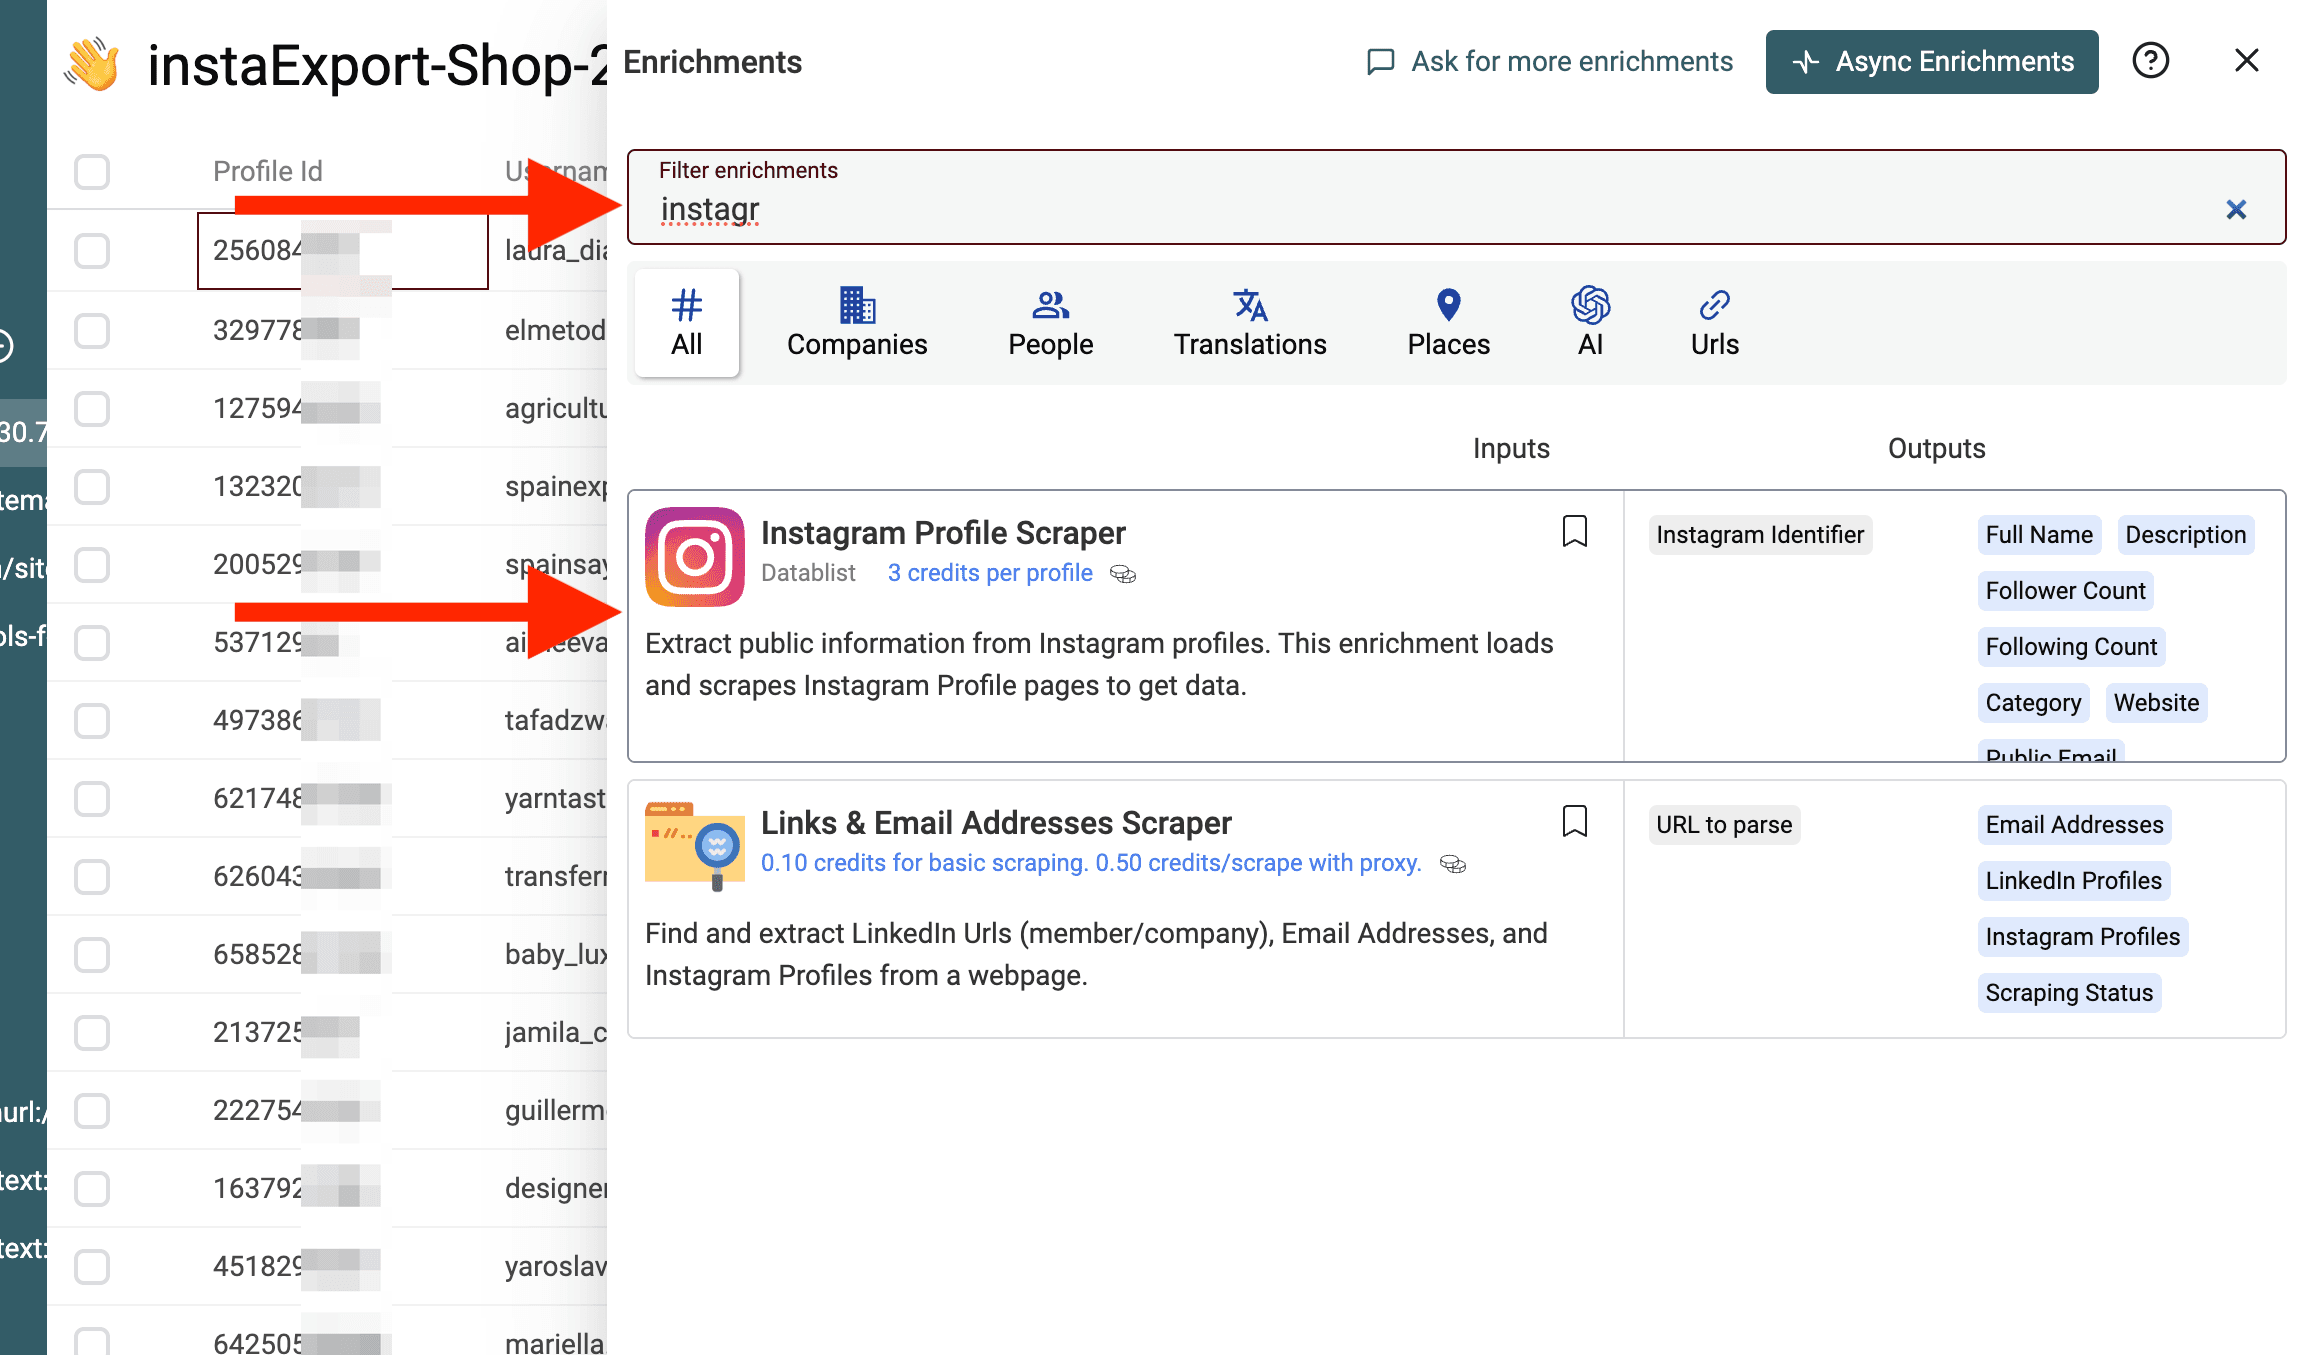
2. Instagram Profile Scraper 선택하기 Instagram Profile Scraper를 검색해 선택하세요. 이 enrichment는 소스 결과의 프로필 식별자를 사용해 추가 프로필 필드를 요청합니다. 선택한 scraping type과 제공업체가 반환할 수 있는 데이터에 따라 이용 가능한 필드가 달라집니다.
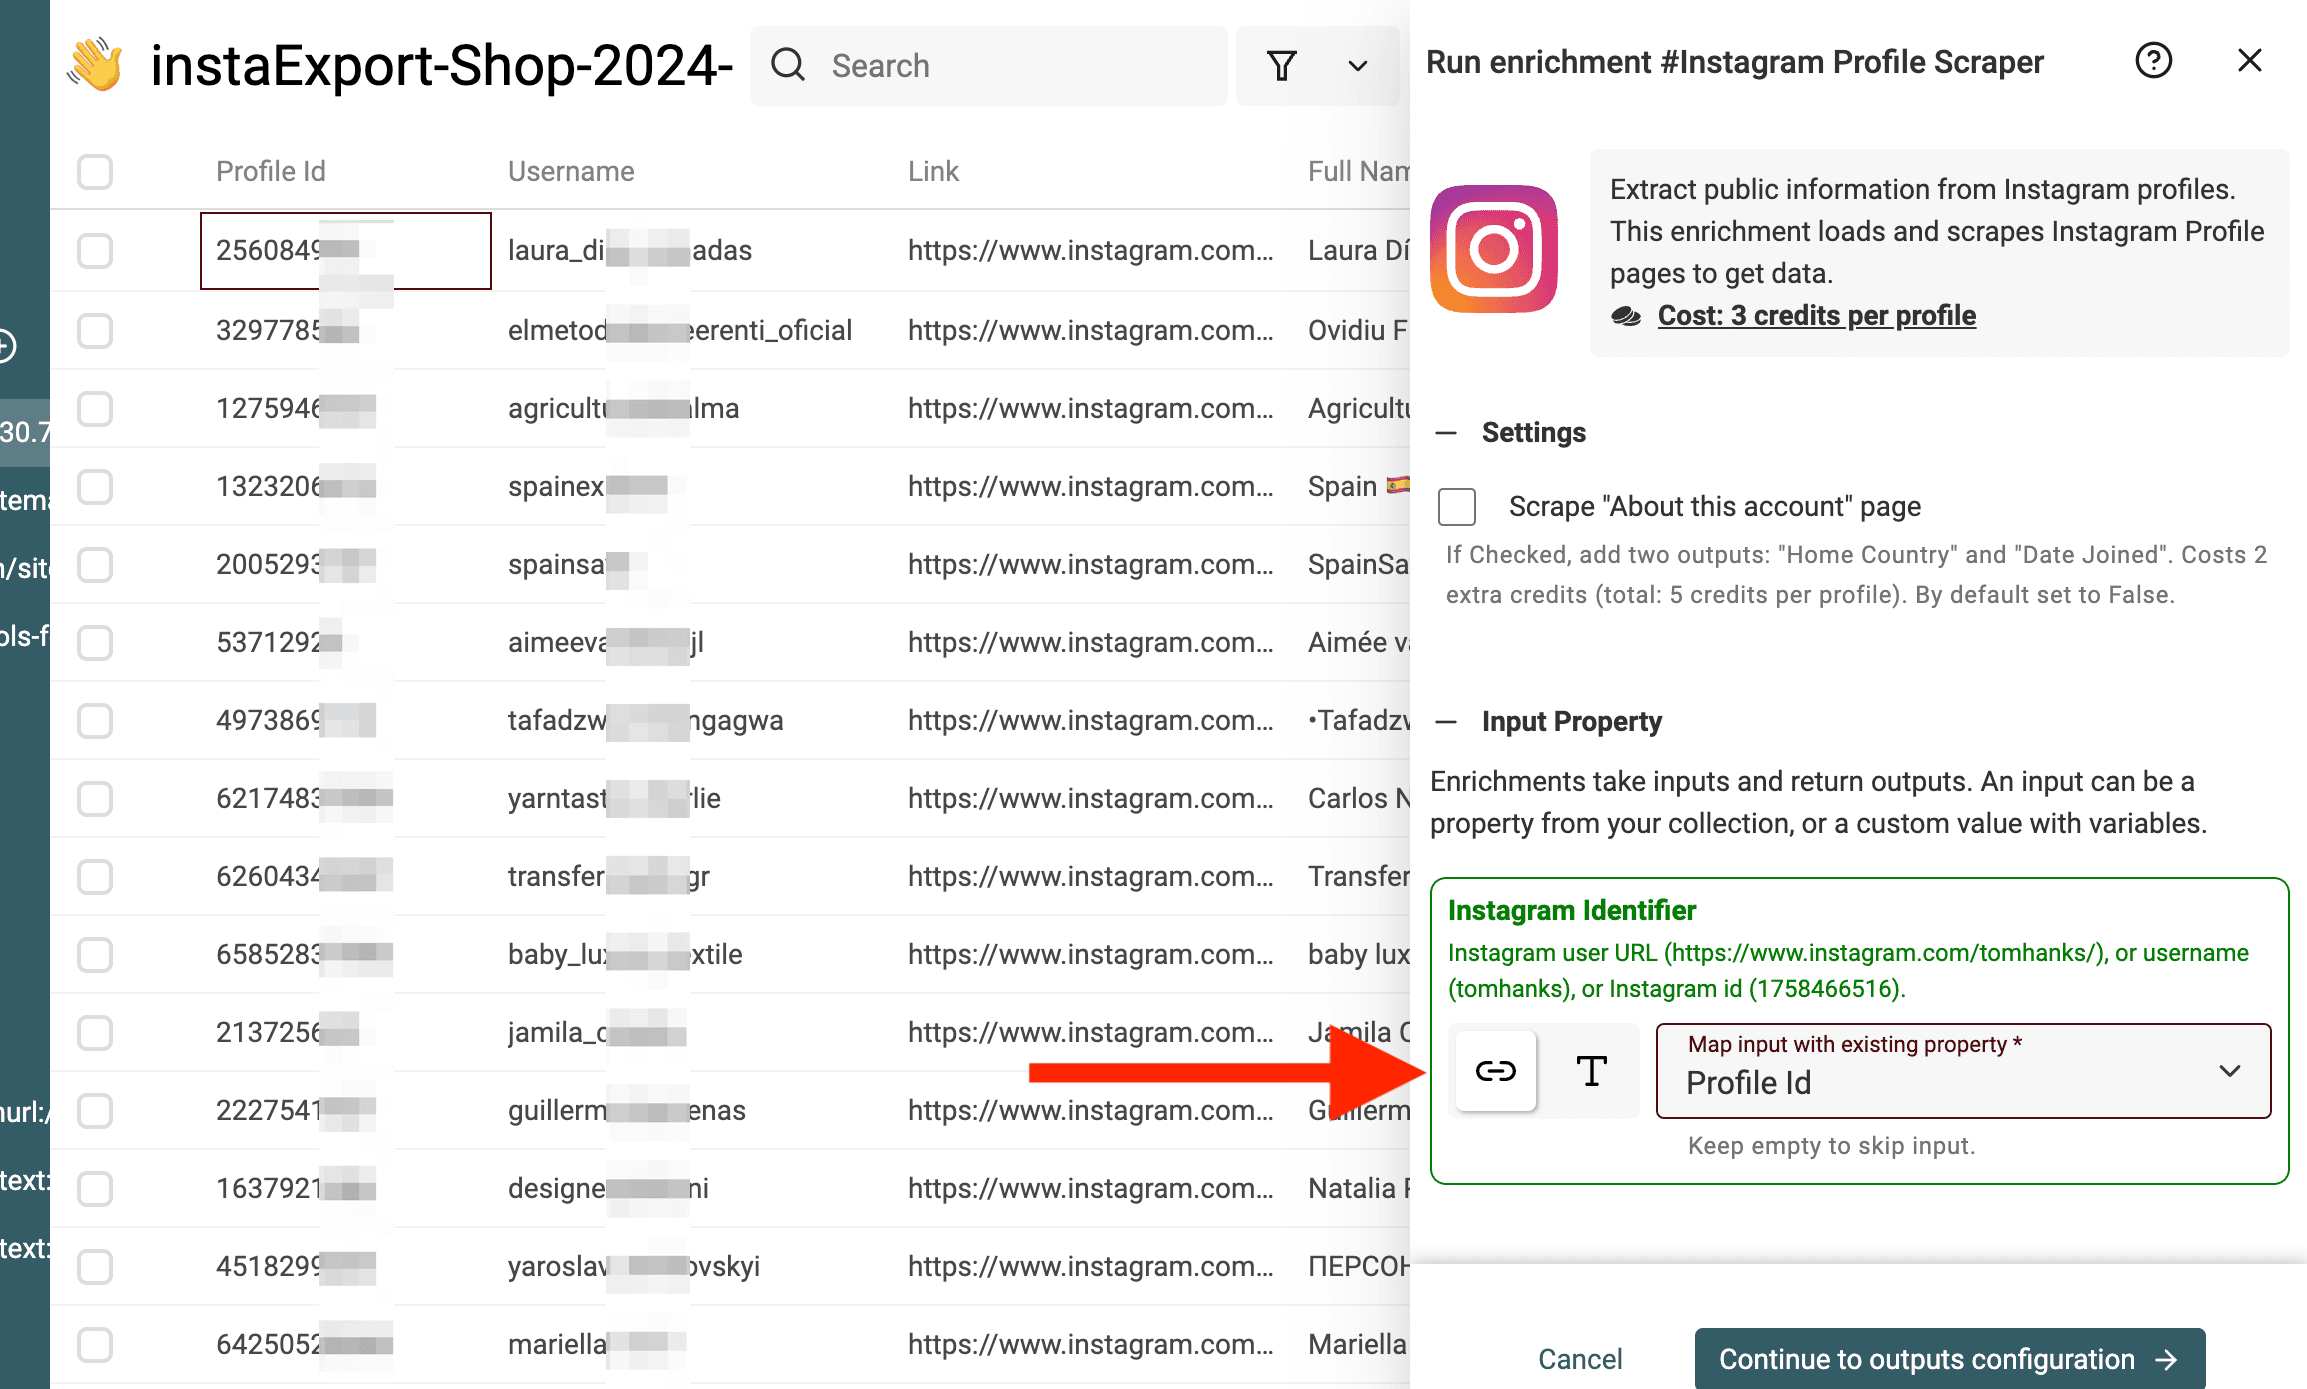
3. 데이터 열 매핑하기 어떤 열에 handle이 들어 있는지 Datablist에 지정하세요. 6단계에서 생성된 Instagram Username 또는 Profile URL 열을 scraper의 입력 필드에 매핑하면 됩니다.
4. 출력 필드 선택하기 Collection에 추가할 데이터 항목을 선택하세요.
필요한 출력 필드를 새 열에 매핑해 기존 팔로워 식별자가 그대로 남도록 하세요.
가져올 수 있는 출력 항목은 다음과 같습니다.
- Public Email: 비즈니스 프로필에 공개된 이메일을 직접 추출합니다.
- Description: 특정 직책이나 관심사를 기준으로 데이터를 필터링할 때 활용합니다.
- Follower Count: "Micro-influencers"와 일반 사용자를 구분해 필터링합니다.
- Website: bio에 있는 링크를 가져와 추가 기업 리서치에 활용합니다.
5. Enrichment 실행하기
필요한 필드를 반환하는 Scraping Type을 선택한 뒤 샘플을 실행하세요. 공개 프로필 전용 옵션에는 이메일이나 전화번호 출력이 포함되지 않습니다. 프로필 옵션은 사용자가 공개한 이메일이나 전화번호가 있으면 반환할 수 있지만, 해당 필드가 비어 있을 수도 있습니다. 나머지 데이터를 처리하기 전에 사용 가능한 설정과 예상 크레딧을 확인하세요.
Enrichment가 완료되면 Enrichment Status와 누락된 필드를 검토하세요. 공개 이메일이 없다면 해당 필드는 빈 상태로 두어야 합니다. 이것이 그 사람에게 이메일 주소가 없다는 의미는 아닙니다. 공식 이메일 필드가 아니라 bio 텍스트 안에 이메일이 포함되어 있다면 Data Extractor를 사용할 수 있습니다.
중복 관계 검토와 대규모 스크래핑 재개
다음 두 데이터셋의 차이를 구분해야 합니다.
- 팔로워 관계: 팔로워와 소스 프로필의 조합마다 하나의 행이 생성됩니다. 한 사람이 두 개의 입력 계정을 팔로우하면 같은 사람이 두 번 나타나는 것이 정상입니다.
- 고유 프로필: 각 사람을 한 번만 enrichment하려면 User Id당 하나의 행을 사용합니다. 중복 프로필을 제거하기 전에 각 소스와의 관계를 별도로 보존하세요.
예를 들어 User Id 101이 Account A와 Account B를 모두 팔로우한다면 관계는 두 개지만 프로필은 하나입니다. 이 관계 정보를 먼저 통합하지 않고 User Id만 기준으로 중복을 제거하면 소스 관계 하나가 사라집니다.
Enrichment 전에 누락된 ID, 중복된 소스와 팔로워 조합, 예상보다 적은 결과를 검토하는 것이 좋습니다. 대표성 있는 프로필 샘플을 선택해 Description, Website와 반환된 이메일 필드를 확인하세요. 피트니스 계정을 팔로우한다는 이유만으로 모든 팔로워를 피트니스 전문가로 분류해서는 안 됩니다.
이전 실행에 저장된 continuation이 있다면 소스 설정을 열고 Continue a previous scrape를 사용하세요. 이용 가능한 항목은 현재 workspace에 한정되며 7일 동안 보관됩니다. 선택한 항목에는 기존 소스 프로필과 scrape type이 그대로 적용되므로 새 프로필을 입력해 교체할 필요가 없습니다.
소스가 Collection의 한계에 도달하면 설정의 안내에 따라 같은 workspace의 다른 Collection에서 작업을 재개하세요. Continuation을 사용할 수 없다면 처음부터 다시 시작하기 전에 소스 실행 상태를 확인하세요. 새로 시작한 스크래핑 결과는 이전 스냅샷과 겹칠 수 있으므로 식별자를 비교하고 소스 및 Collection 정보를 보존해야 합니다.
각 batch에 Checked At 날짜를 저장하고, 검토가 끝난 결과를 CSV 또는 Excel로 내보내세요. 팔로워 수가 달라졌다는 사실만으로 추출이 완료되었다고 판단할 수는 없습니다. 페이지를 넘기거나 실행하는 사이에도 팔로워가 바뀔 수 있습니다.
마무리
공개 프로필과 적은 한도로 시작하고, 팔로워 및 소스 식별자를 유지한 채 반환된 관계를 검토한 후 enrichment하거나 내보내세요. 대규모 소스 실행에서는 저장된 continuation을 사용할 수 있다면 이를 활용하세요.
프로젝트와 관련된 프로필로 같은 workflow를 테스트하려면 Datablist를 열어보세요.
Instagram 팔로워 스크래핑 FAQ
Instagram 팔로워 스크래핑은 합법인가요?
정보가 공개되어 있다는 사실만으로 자동 수집이나 재사용이 허용되는 것은 아닙니다. 팔로워 데이터를 수집하기 전에 Instagram의 최신 이용 약관과 사용 목적에 적용되는 요건을 확인하세요.
여러 인플루언서의 팔로워를 동시에 수집할 수 있나요?
네. Instagram Profiles에 식별자를 한 줄에 하나씩 입력하세요. 소스는 입력된 계정을 처리하고, 반환된 행에 소스 프로필과의 관계 필드를 포함합니다. 실행 시간과 완료 여부는 계정마다 다를 수 있습니다.
비공개 Instagram 프로필의 팔로워도 수집할 수 있나요?
아니요. 이 workflow로는 비공개 프로필의 팔로워 목록을 가져올 수 없습니다. 프로필 상세 정보 조회는 별도의 enrichment이며, 제한된 팔로워 데이터에 접근하는 수단이 아닙니다.
Instagram 팔로워 스크래핑 속도는 얼마나 빠른가요?
모든 프로필에 동일하게 적용되는 고정 완료 시간은 없습니다. 범위를 확대하기 전에 적은 샘플을 실행해 실제 소요 시간, 반환된 행 수와 크레딧 사용량을 확인하세요.
팔로워를 10만 명 넘게 스크래핑하면 어떻게 되나요?
소스 실행 한도와 Collection 저장 용량은 별개의 제약으로 봐야 합니다. 프로필의 전체 목록을 가져오기 전에 소스가 중단될 수 있습니다. 안내가 표시되면 다른 Collection에서 이용 가능한 continuation을 사용하고, 완료된 batch마다 내보내세요. Collection의 import 용량이 소스의 추출 가능 용량과 같다고 가정해서는 안 됩니다.
Instagram 팔로워 스크래핑으로 어떤 데이터를 얻나요?
각 팔로워에 대해 다음과 같은 다양한 프로필 데이터 필드를 선택할 수 있습니다.
- User Id: Instagram 내부 사용자 식별자
- User Username: 팔로워의 Instagram handle
- User Profile URL: 해당 Instagram 프로필로 연결되는 직접 링크
- Full Name: 프로필에 표시되는 이름
- Profile Picture: 프로필 이미지 URL
- Private: 계정의 공개 또는 비공개 여부
- Verified: 파란색 인증 배지 상태
- Follower of (UserId), Follower of (Username), Follower of (ProfileUrl): 관계 확인에 사용하는 소스 계정 식별자
한 번에 몇 명의 Instagram 팔로워를 수집할 수 있나요?
소스 실행의 Scraping Limit Per Profile을 설정하고 진행 상황과 continuation 설정을 확인하세요. 실제 결과는 접근 가능한 팔로워 페이지, 제공업체 응답, 실행 한도와 사용 가능한 크레딧에 따라 달라집니다. Import 용량이 크다고 해서 팔로워 소스가 한 번의 실행으로 같은 수의 결과를 반환하는 것은 아닙니다.
Instagram 팔로워 스크래핑에 확장 프로그램이 필요한가요?
아니요. Datablist는 전적으로 web app에서 실행됩니다. 확장 프로그램, 다운로드 또는 설치가 필요하지 않습니다.
Instagram 팔로워를 가장 저렴하게 수집하는 방법은?
적은 한도를 요청하고 예상 크레딧을 확인한 뒤, 프로필 상세 정보 enrichment를 실행하기 전에 반환된 행을 검토하세요. 반환된 모든 팔로워를 적합한 잠재 고객이라고 가정하지 말고, 검토를 마쳐 실제로 활용할 수 있는 프로필당 비용을 비교해야 합니다.
계정 정지 없이 Instagram 팔로워를 수집하려면?
Datablist는 이 workflow에서 Instagram 로그인 정보나 session cookie를 요구하지 않습니다. 그렇다고 해서 위험이 전혀 없는 스크래핑 방식이거나 데이터 수집 권한이 보장되는 것은 아닙니다. 접근 가능한 소스 데이터만 사용하고 사이트의 요건을 검토하며, 요청한 목록을 이용할 수 없다면 작업을 중단하세요.
Followers와 Following 스크래핑의 차이는 무엇인가요?
Followers는 해당 프로필을 팔로우하는 사람들의 목록입니다. Following은 해당 프로필이 팔로우하는 계정 목록입니다. 이 가이드는 팔로워 스크래핑을 중심으로 설명하지만 Datablist에서는 두 옵션을 모두 제공합니다.
Instagram 비즈니스 계정의 팔로워도 수집할 수 있나요?
네. 비즈니스 계정이 공개 상태라면 가능합니다. 개인, creator 및 비즈니스 계정 모두 같은 방식으로 scraper를 사용할 수 있습니다.
Instagram 팔로워 목록을 다운로드하는 방법은?
Datablist에 가입하고 Collection을 만든 다음 Instagram Followers/Following Scraper를 선택하세요. 프로필을 붙여 넣고 실행하면 됩니다. 완료된 결과는 CSV 또는 Excel로 내보낼 수 있습니다.
Instagram 팔로워를 수집할 수 있는 도구는 무엇인가요?
브라우저 확장 프로그램, Python script, Datablist 같은 플랫폼 등 여러 옵션이 있습니다. 필요한 계정 접근 권한, 반환되는 필드, continuation 지원 여부, 샘플 실행 시간과 유용한 결과당 비용을 비교하세요. Datablist의 이 workflow에는 Instagram 로그인 정보가 필요하지 않습니다.