
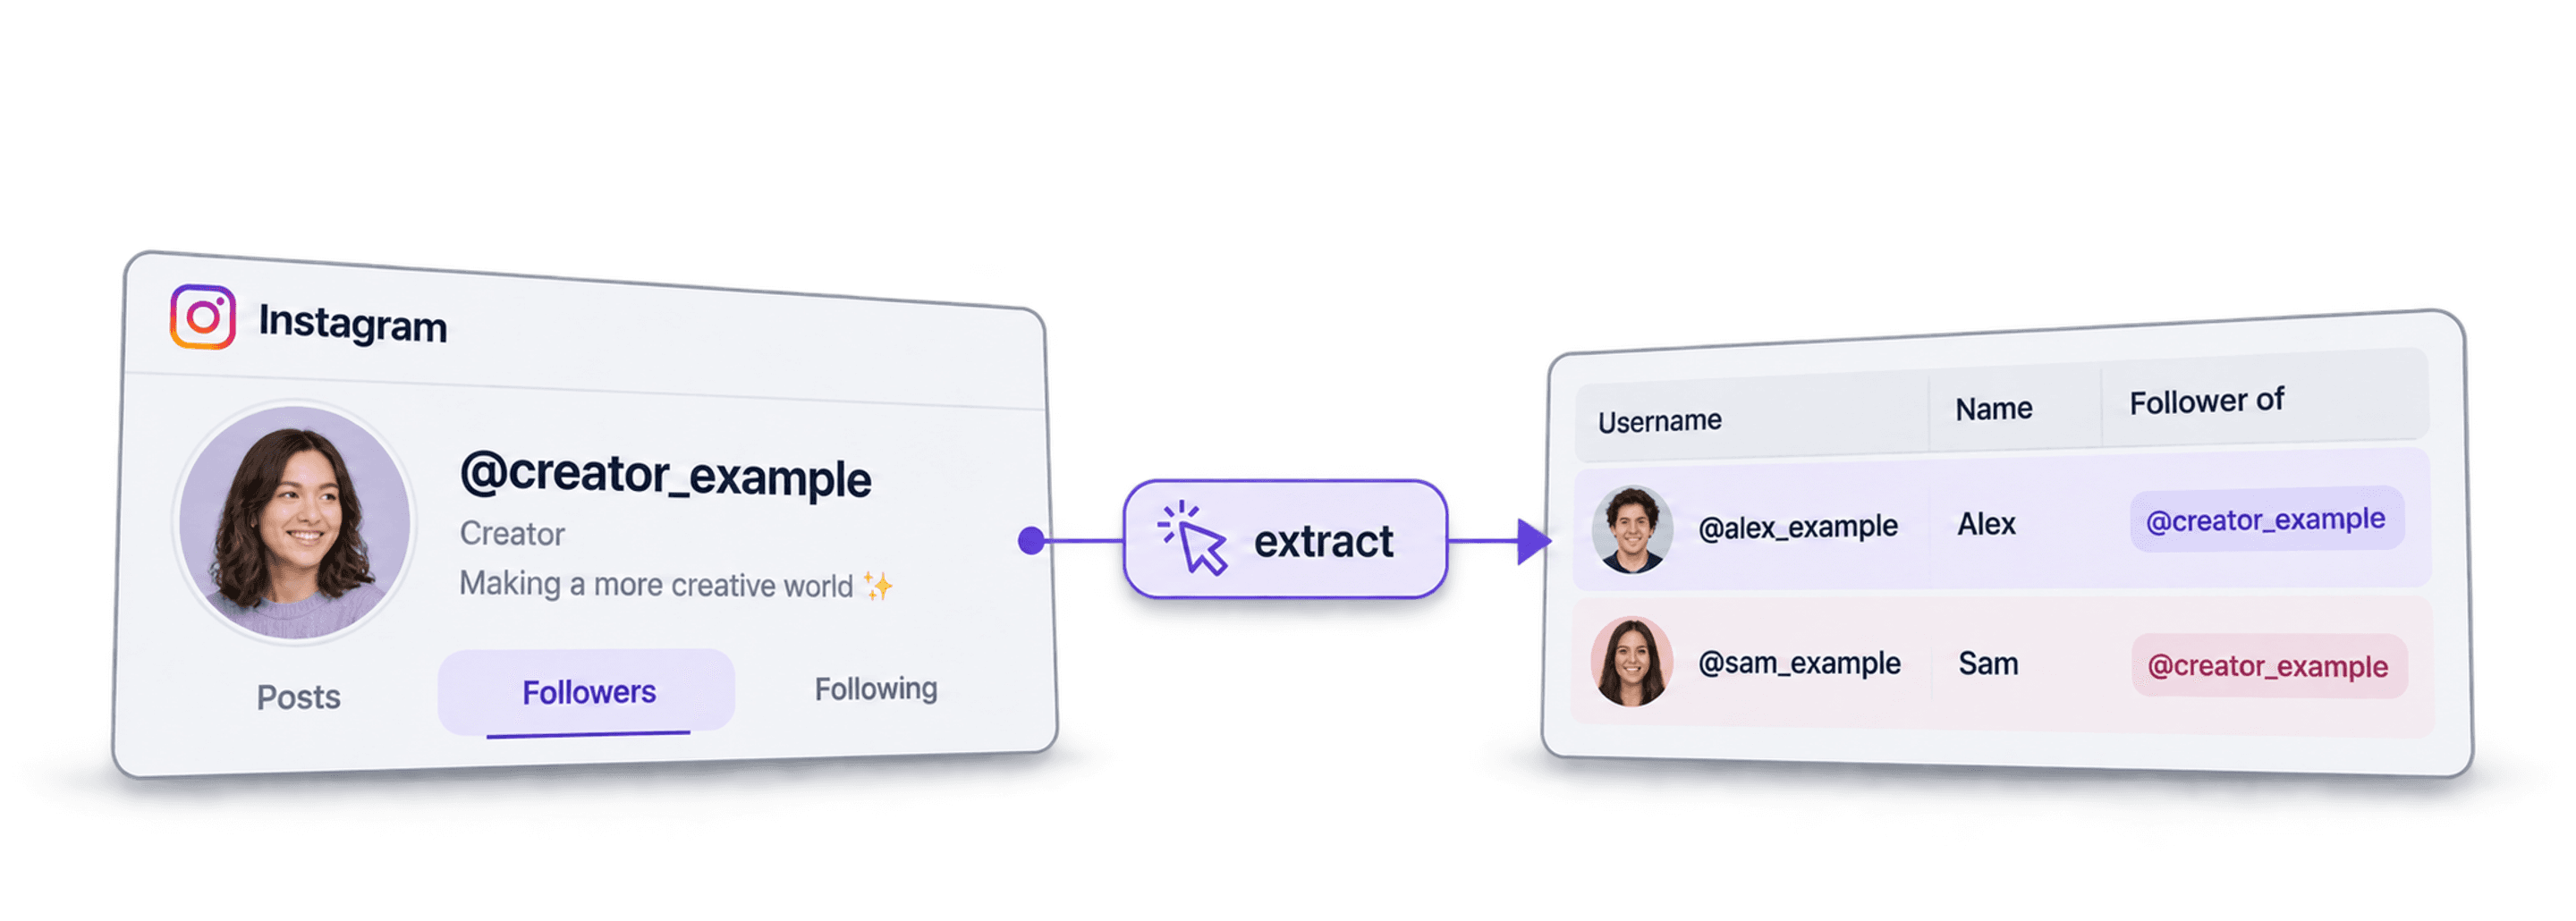
要在 Datablist 中抓取 Instagram 粉丝,请打开 Instagram Followers/Following Scraper 数据源,输入公开主页的 URL、用户名或 User ID,设置每个主页的抓取上限,并在导出前检查返回的粉丝数据行。
建议先用一个主页和较小的抓取上限进行测试。返回的名单只是服务商当时能够获取的账号快照,并不保证包含该主页当前的全部粉丝。此外,关注某位垂直领域的 Influencer,并不能证明一个人的职业、所在地或购买意愿。
本指南将介绍数据源设置、关注关系输出字段、数据检查与去重、续跑大规模抓取任务,以及单独执行的主页详情 enrichment。整个流程无需提供 Instagram 登录凭据。
📌 快速操作流程
创建一个 collection,打开 See all sources,然后选择 Instagram Followers/Following Scraper。在 Instagram Profiles 下每行输入一个主页,在 Scrape followers or following 中保留默认选项 Followers (default),并设置 Scraping Limit Per Profile。添加粉丝标识符和来源主页输出字段,运行一个小样本,检查结果后再导出。
抓取 Instagram 粉丝需要多少费用?
**提取粉丝名单时,每返回一名粉丝收取 0.01 credits。**如果来源主页的标识符尚未缓存,解析该主页可能额外消耗 1 credit。主页详情 enrichment 需另行计费。
以下是一个具体示例:假设某个来源主页正好返回 1,000 行粉丝数据:
- **粉丝名单:**1,000 × 0.01 = 10 credits;如果来源主页未缓存,再加 1 credit,共计 11 credits。
- **补充 100 名选定粉丝的详情:**使用返回的 User Id 执行标准主页查询,每人消耗 2 credits,共计 200 credits。如果公开信息中存在邮箱和电话号码,此选项可能返回这些字段,但不保证一定能够获取。
- **总计:**粉丝名单加上 100 次主页查询,共需 211 credits。如果添加 About 数据或选择其他 Scraping Type,enrichment 费用也会变化。
按月使用美元结算时,Starter 套餐价格为 25 美元,包含 5,000 credits。假设这些额度尚未使用,本例无需额外充值,完成后还剩 4,789 credits。25 美元是订阅的实际付款金额,211 credits 则是此次工作流的用量。不同套餐及充值包中的 credit 并没有统一固定的美元价值。
在这个主页 enrichment 示例中,请优先使用返回的 User Id;如果使用用户名或 URL,可能还需要额外查询标识符。运行样本后,应检查实际返回的数据行和 credit 用量。服务商返回的数据页可能超过你设置的较小上限,而且即使没有返回任何粉丝数据,主页查询仍可能消耗 credits,因此请求上限并不等于精确的费用上限。
Datablist 是什么?快速了解
Datablist 是一个采用电子表格式界面的工作空间,适用于Lead 生成工作流。你可以通过各种 enrichments 收集、检查、补充并导出数据,包括 AI Agents、Email Finders、AI processors、Technology enrichments 等。
此外,Datablist 还支持设置按计划或按需运行的自动化工作流。以下是 Datablist 用户经常使用的几个实际场景:
如何低成本抓取 Instagram 粉丝:完整步骤
**下面开始实际操作。**首先进入 Datablist,并配置要抓取的内容,也就是粘贴目标 Influencer 的主页 URL 或用户名,以获取他们的粉丝。
建议先运行一个样本,确认来源主页和返回字段无误后再扩大规模。此工作流不需要浏览器扩展,也不需要你提供服务商的 API key。
📘 重要提示:私密账号
此工作流无法获取私密账号的粉丝名单。即使最终没有返回粉丝数据,系统在解析主页时仍可能消耗 credits。主页详情 enrichment 属于另一项独立查询,也无法用于访问私密帖子或粉丝名单。
第 1 步:注册 Datablist.com
前往 Datablist.com 创建账号。按照账号设置流程进入你的工作空间。
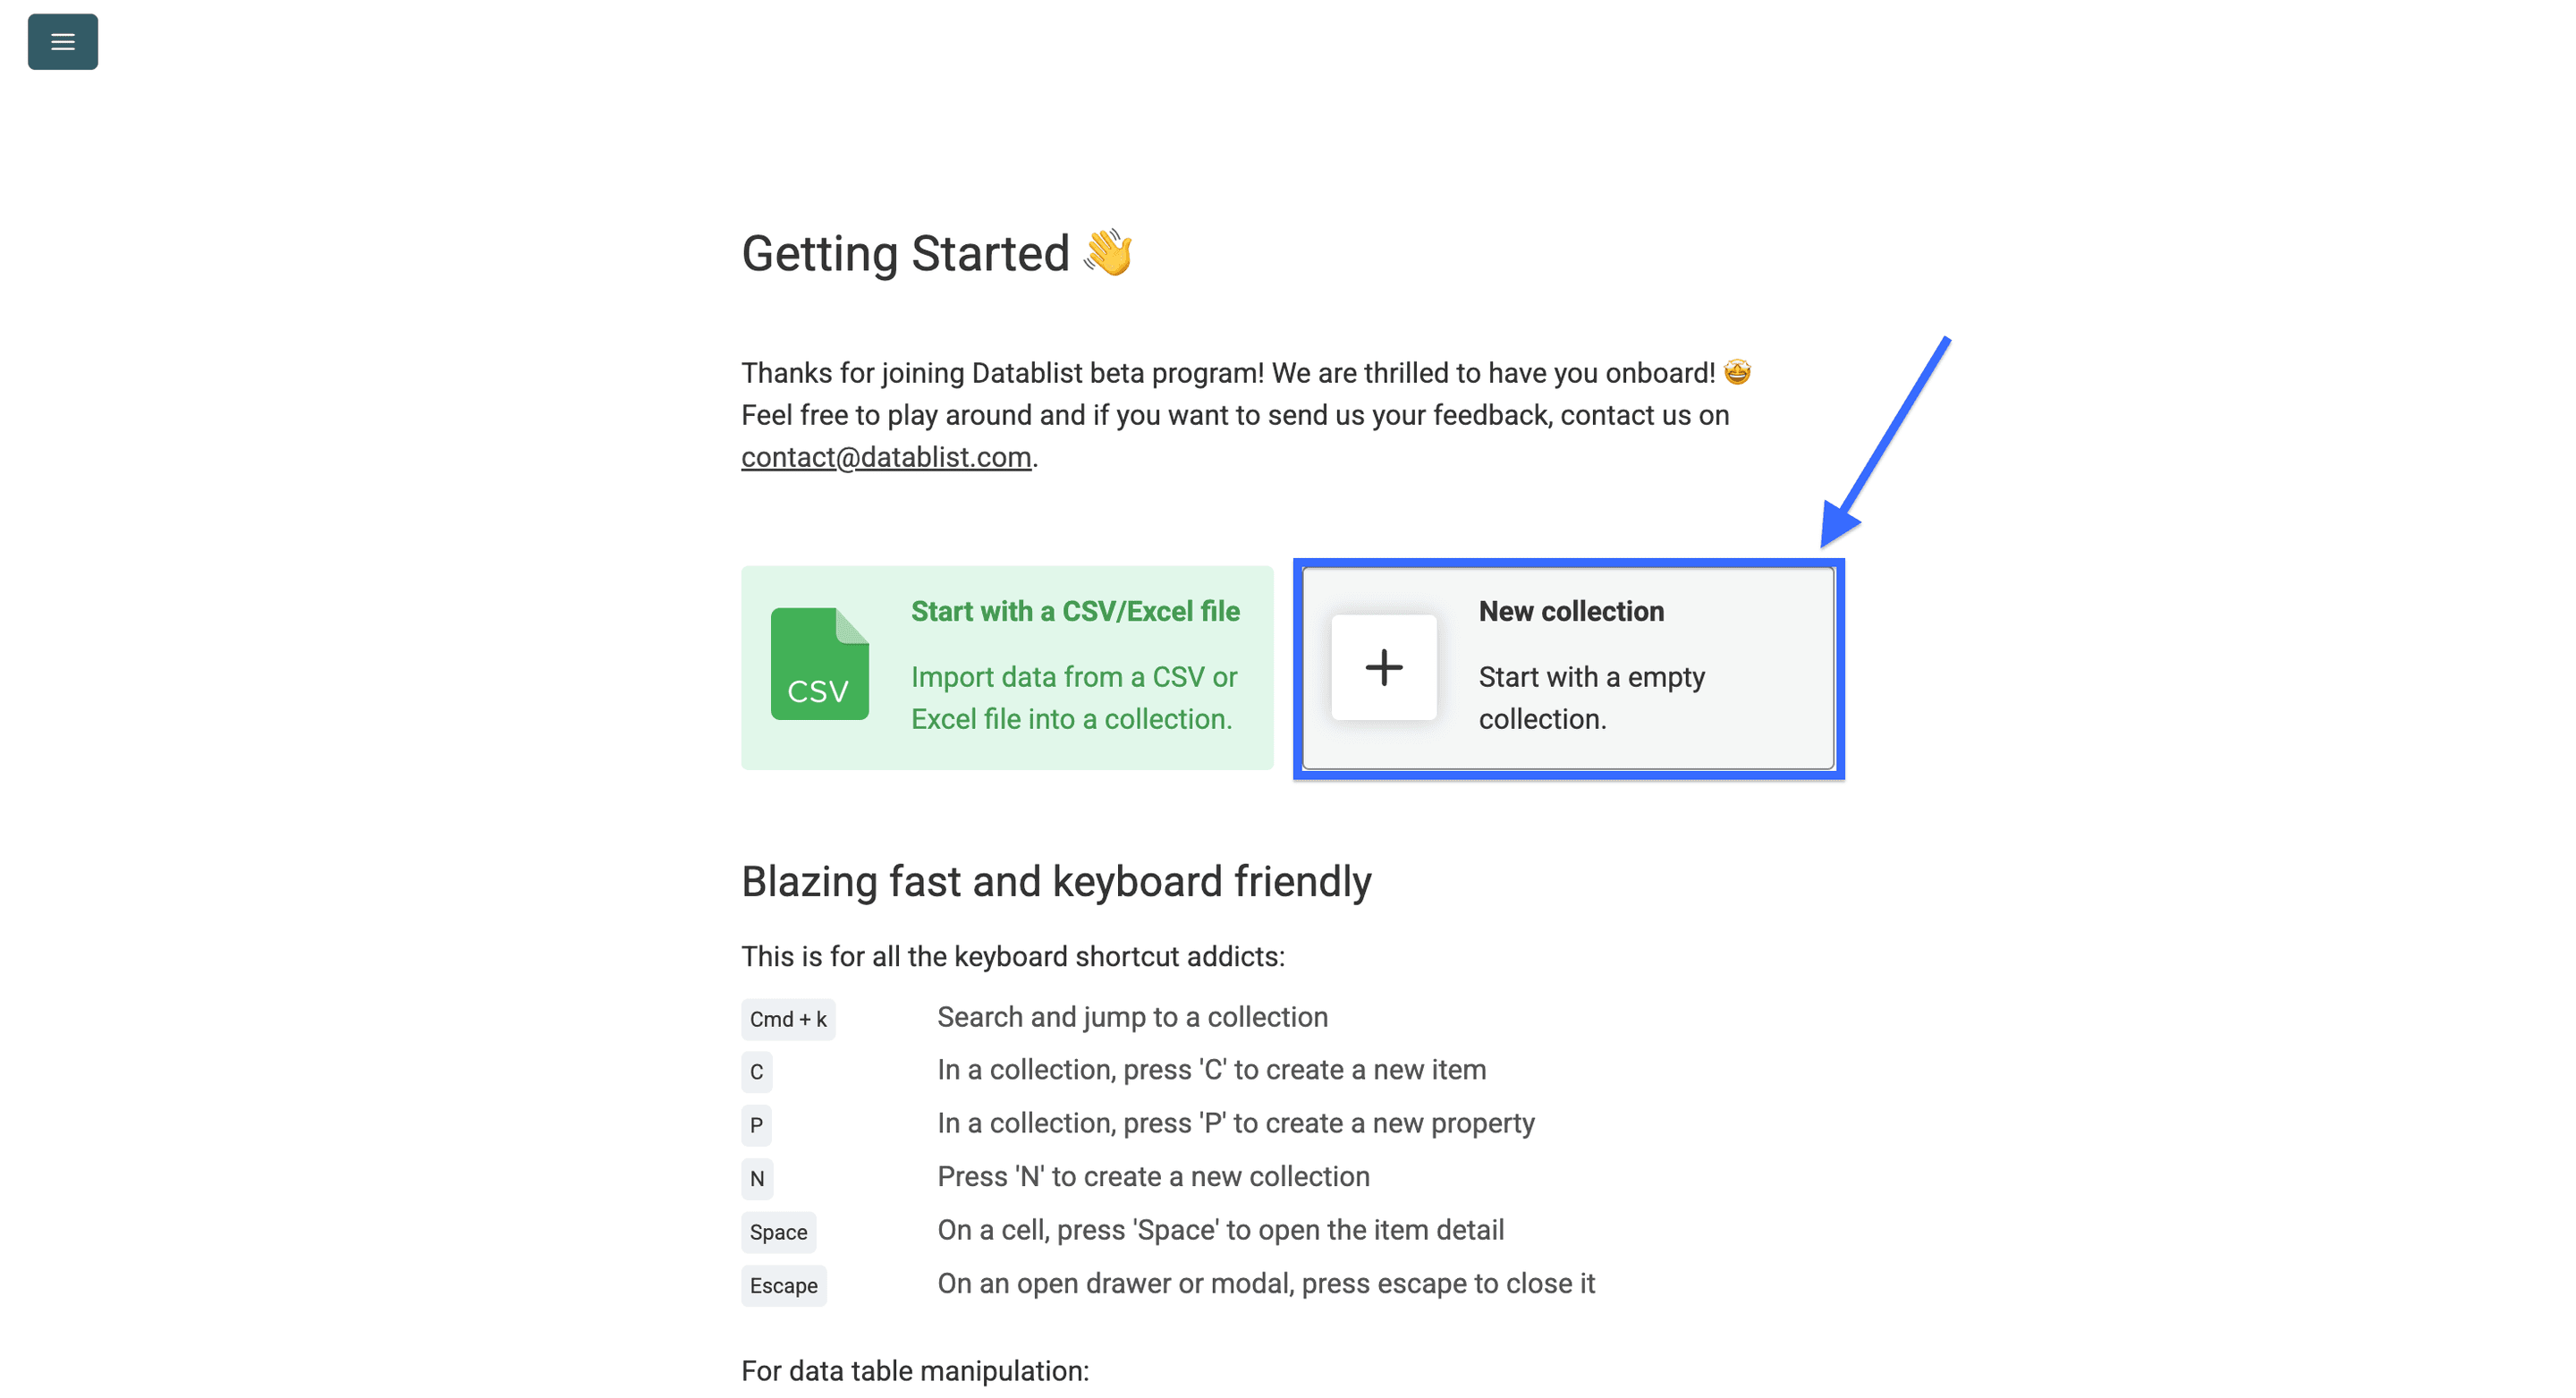
第 2 步:创建新的 Collection
进入后,点击 New Collection。
第 3 步:打开 Instagram Followers/Following Scraper
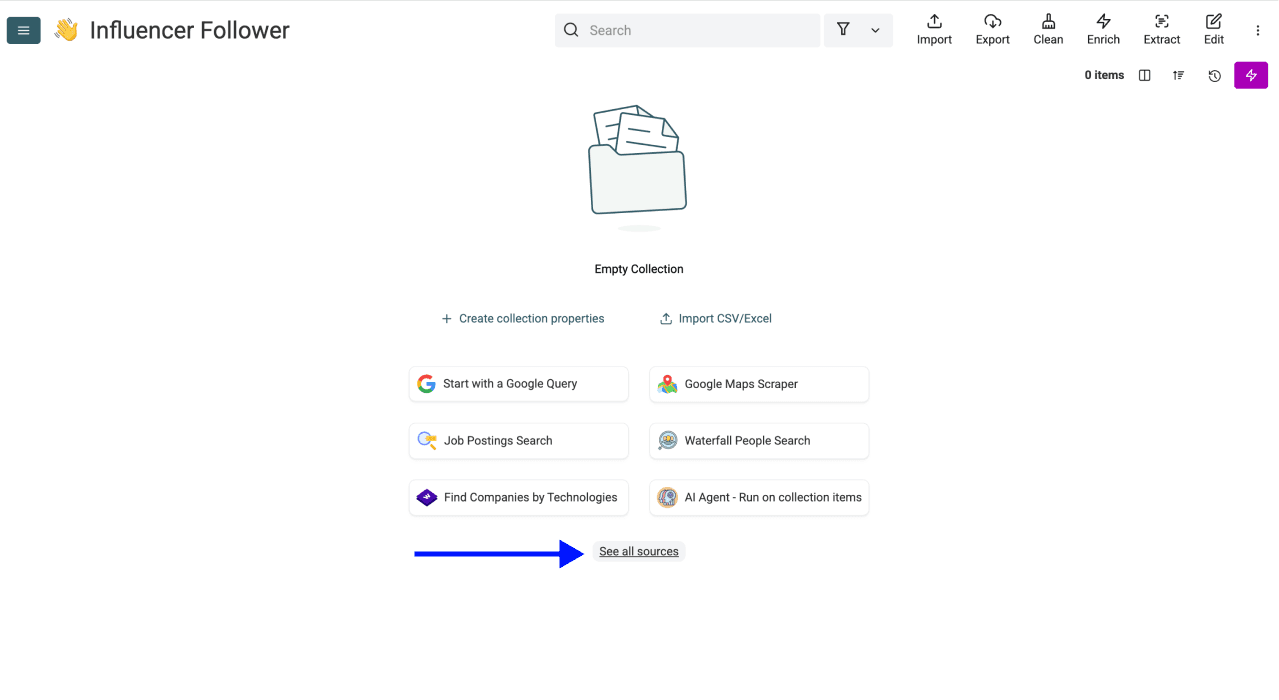
点击 See all sources。
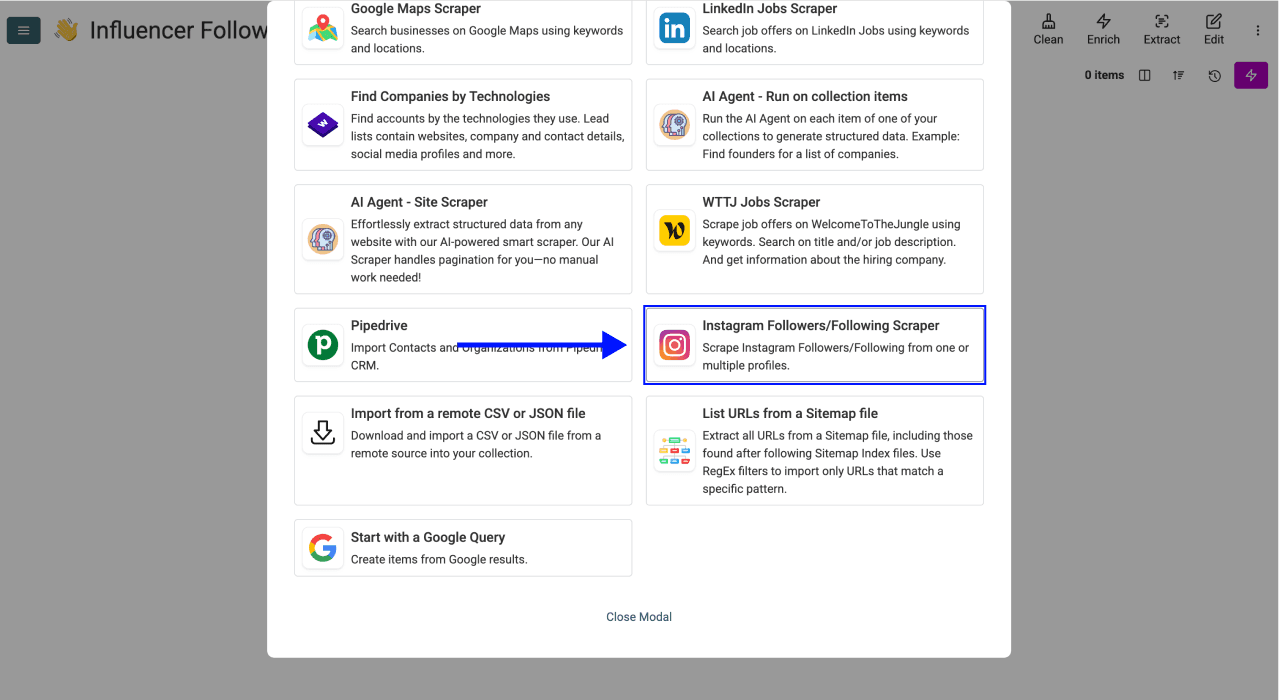
向下滚动,然后从列表中选择 Instagram Followers/Following Scraper。
第 4 步:配置抓取设置
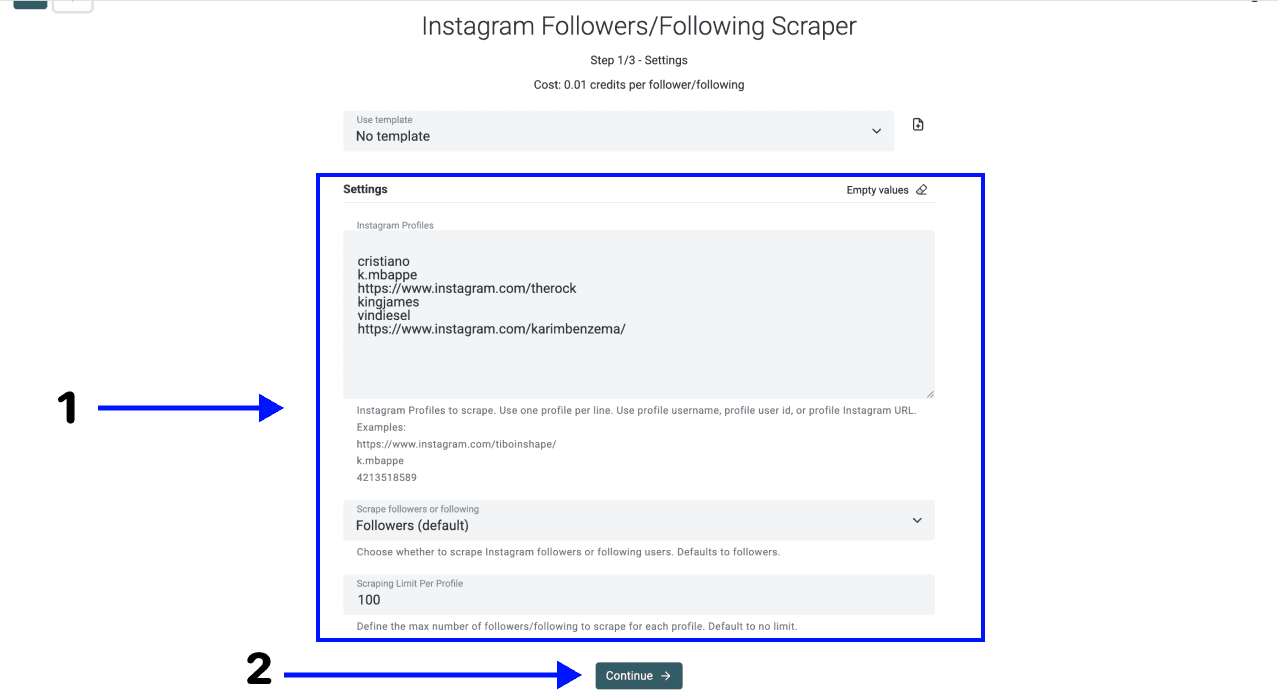
你会看到一个简洁的配置页面。按以下方式设置,可以获得更可靠的结果:
- 在 Instagram Profiles 下,每行输入一个公开主页 URL、用户名或 User ID。确认每个标识符都对应正确的目标账号。
- 在 Scrape followers or following 下选择 Followers (default)。只有当你想获取目标主页所关注的账号时,才选择 Following。
- 先将 Scraping Limit Per Profile 设为较小的样本数量,确认无误后再扩大任务。设置上限并不代表一定能够完整获取相应数量的数据。
- 点击 Continue,然后配置输出列。
第 5 步:选择输出字段
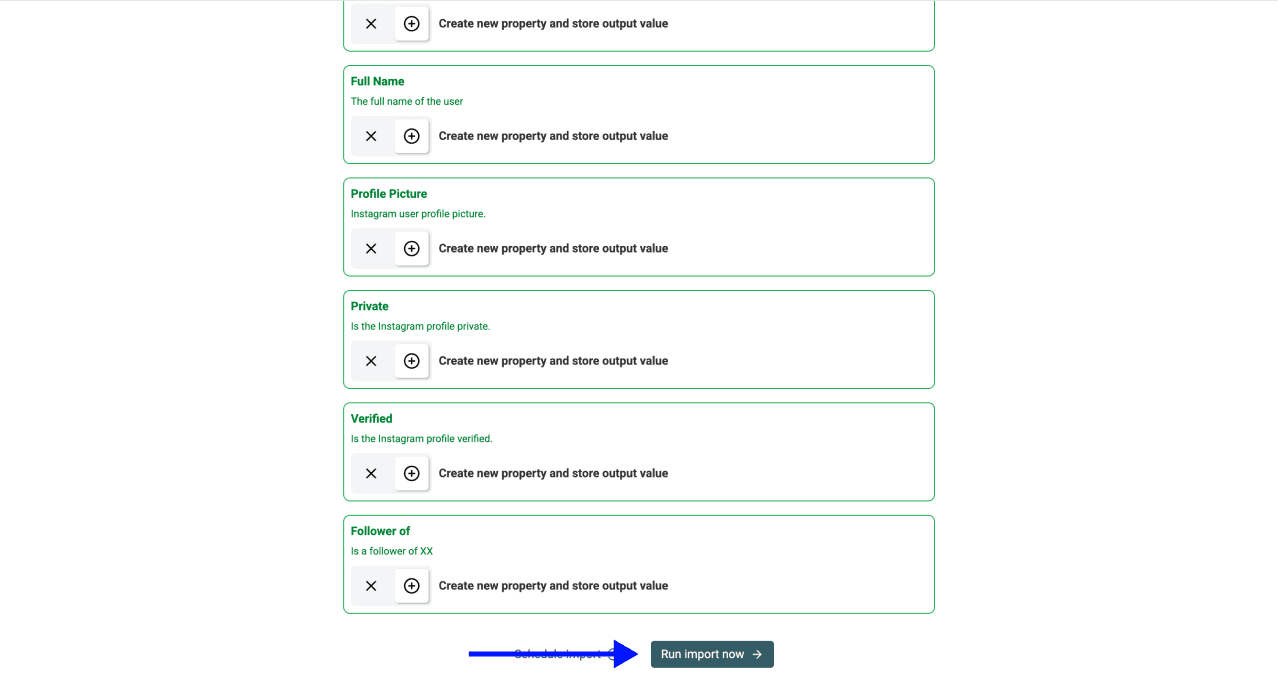
Datablist 会显示所有可用的输出字段。建议保留粉丝的 User Id、User Username 和 User Profile URL,以及来源主页字段。借助这些信息,你可以确认每行数据代表哪个账号,以及它来自哪个输入主页。
点击 ✕ 图标移除不需要的字段,然后点击 Run import now。
第 6 步:获取抓取结果
数据源任务完成后,将返回行数与请求上限进行比较,并检查任务状态。运行时长取决于服务商响应、分页情况、主页本身和任务规模。返回行数较少,并不代表该主页没有其他粉丝。
**注意:**结果中还会包含完整姓名。为保护个人隐私,我们在下图中隐藏了这些信息。
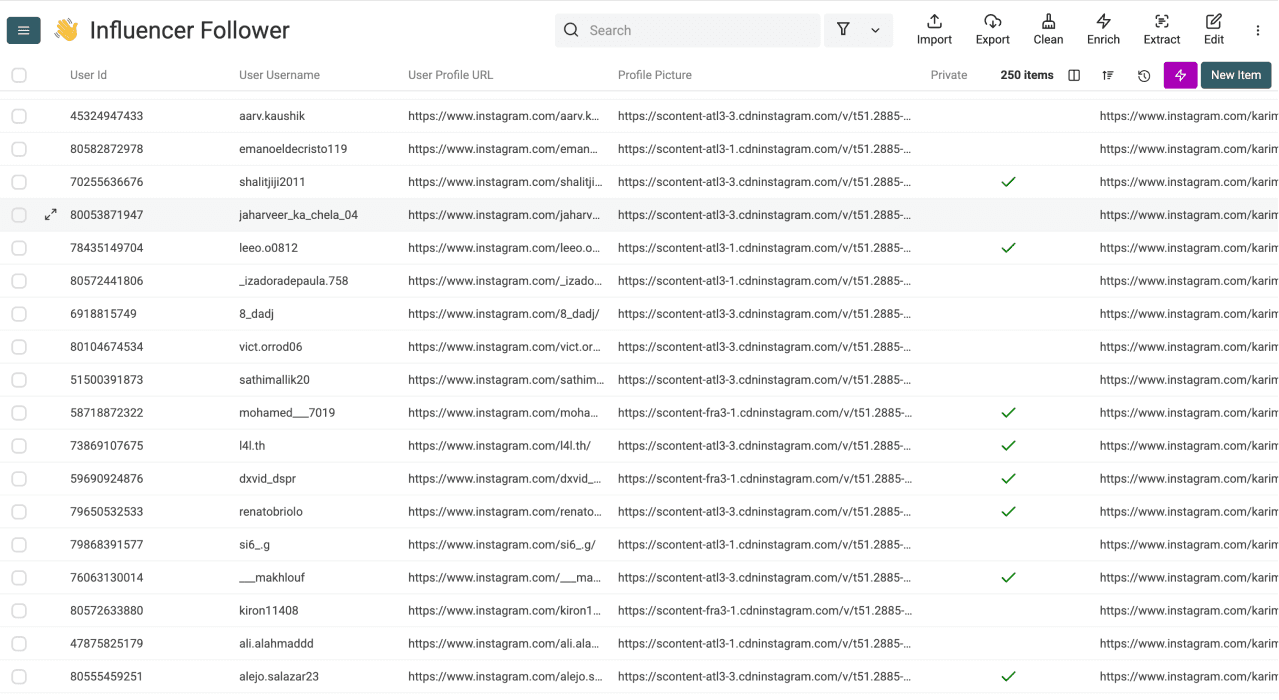
如果输入了多个主页,请保留 Follower of (UserId)、Follower of (Username) 或 Follower of (ProfileUrl)。你可以通过这些字段按来源账号筛选关注关系,无需依赖列的位置来判断。
💡 实用提示:大规模抓取
数据源任务有自己的分页和数据行上限,这些限制与 collection 存储空间及云端同步相互独立。如果任务停止时仍有更多结果可用,请使用下文介绍的续跑功能,不要默认剩余粉丝可以在同一次任务中全部获取。
第 7 步:补充粉丝主页详情
获取粉丝名单只是第一步。要把这些用户名转化为可执行的 Leads,你还需要了解他们是谁。通过 Instagram Profile Scraper,你可以为名单补充公开数据,例如邮箱、个人简介和互动指标。
在构建 Lead 名单时,应将主页详情作为划分人群的依据。仅凭关注关系,并不能可靠地判断一个 Lead 是否符合条件。
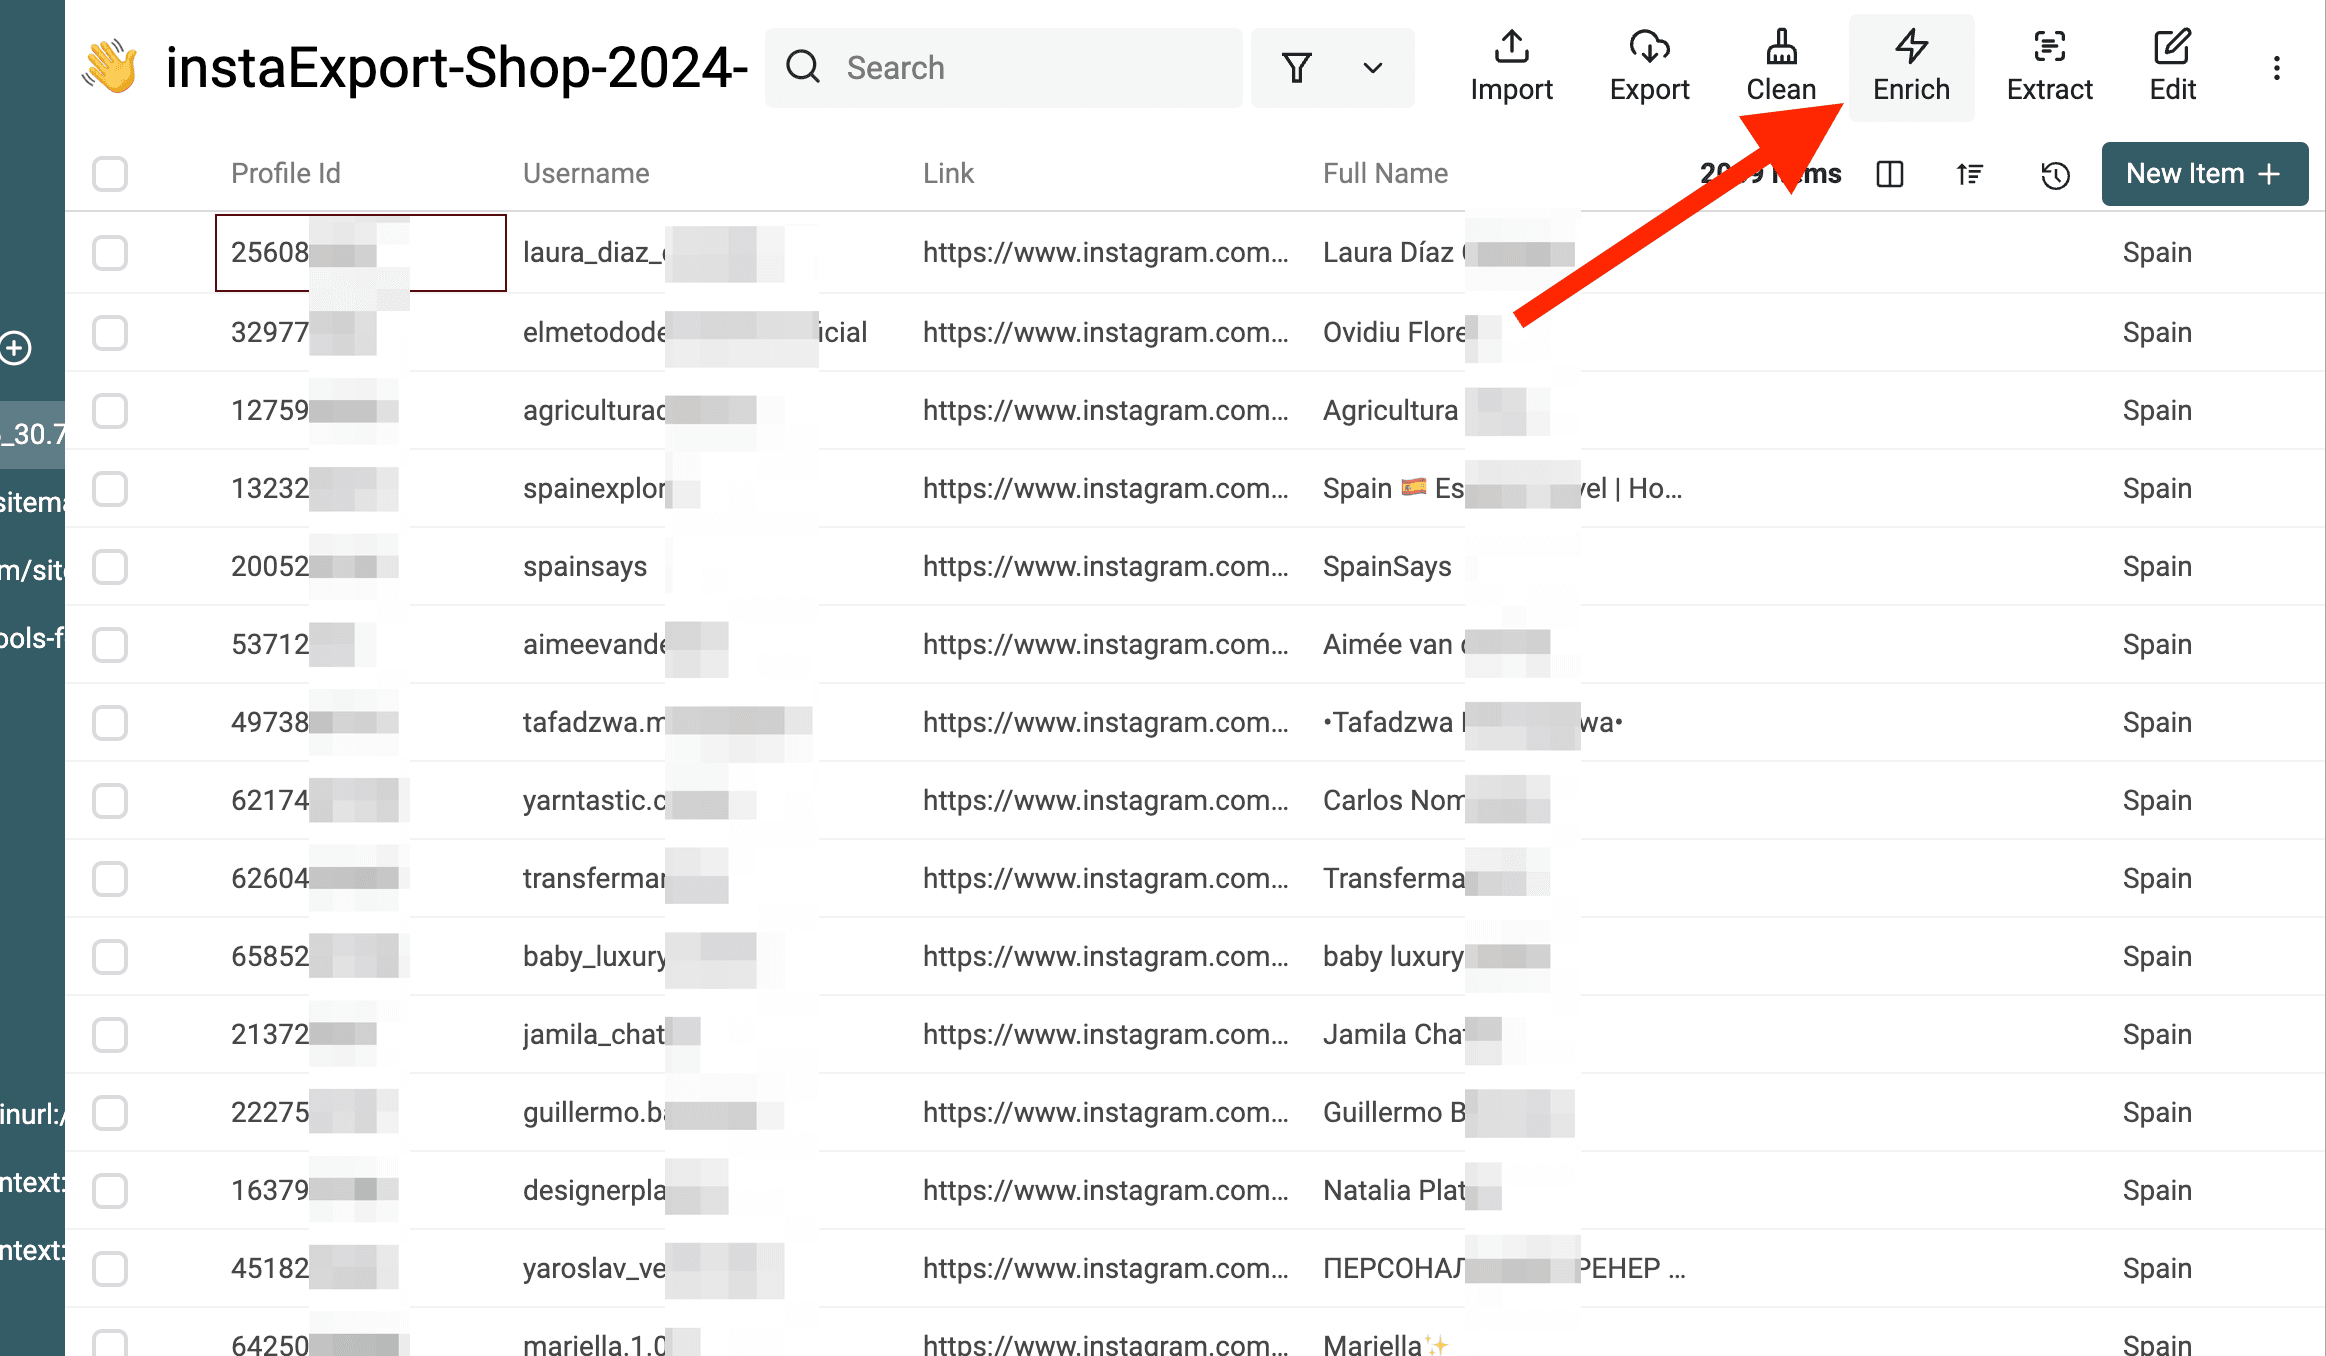
1. 打开 Enrichment 菜单 在包含已抓取粉丝的 collection 中,点击控制面板顶部的 Enrich。
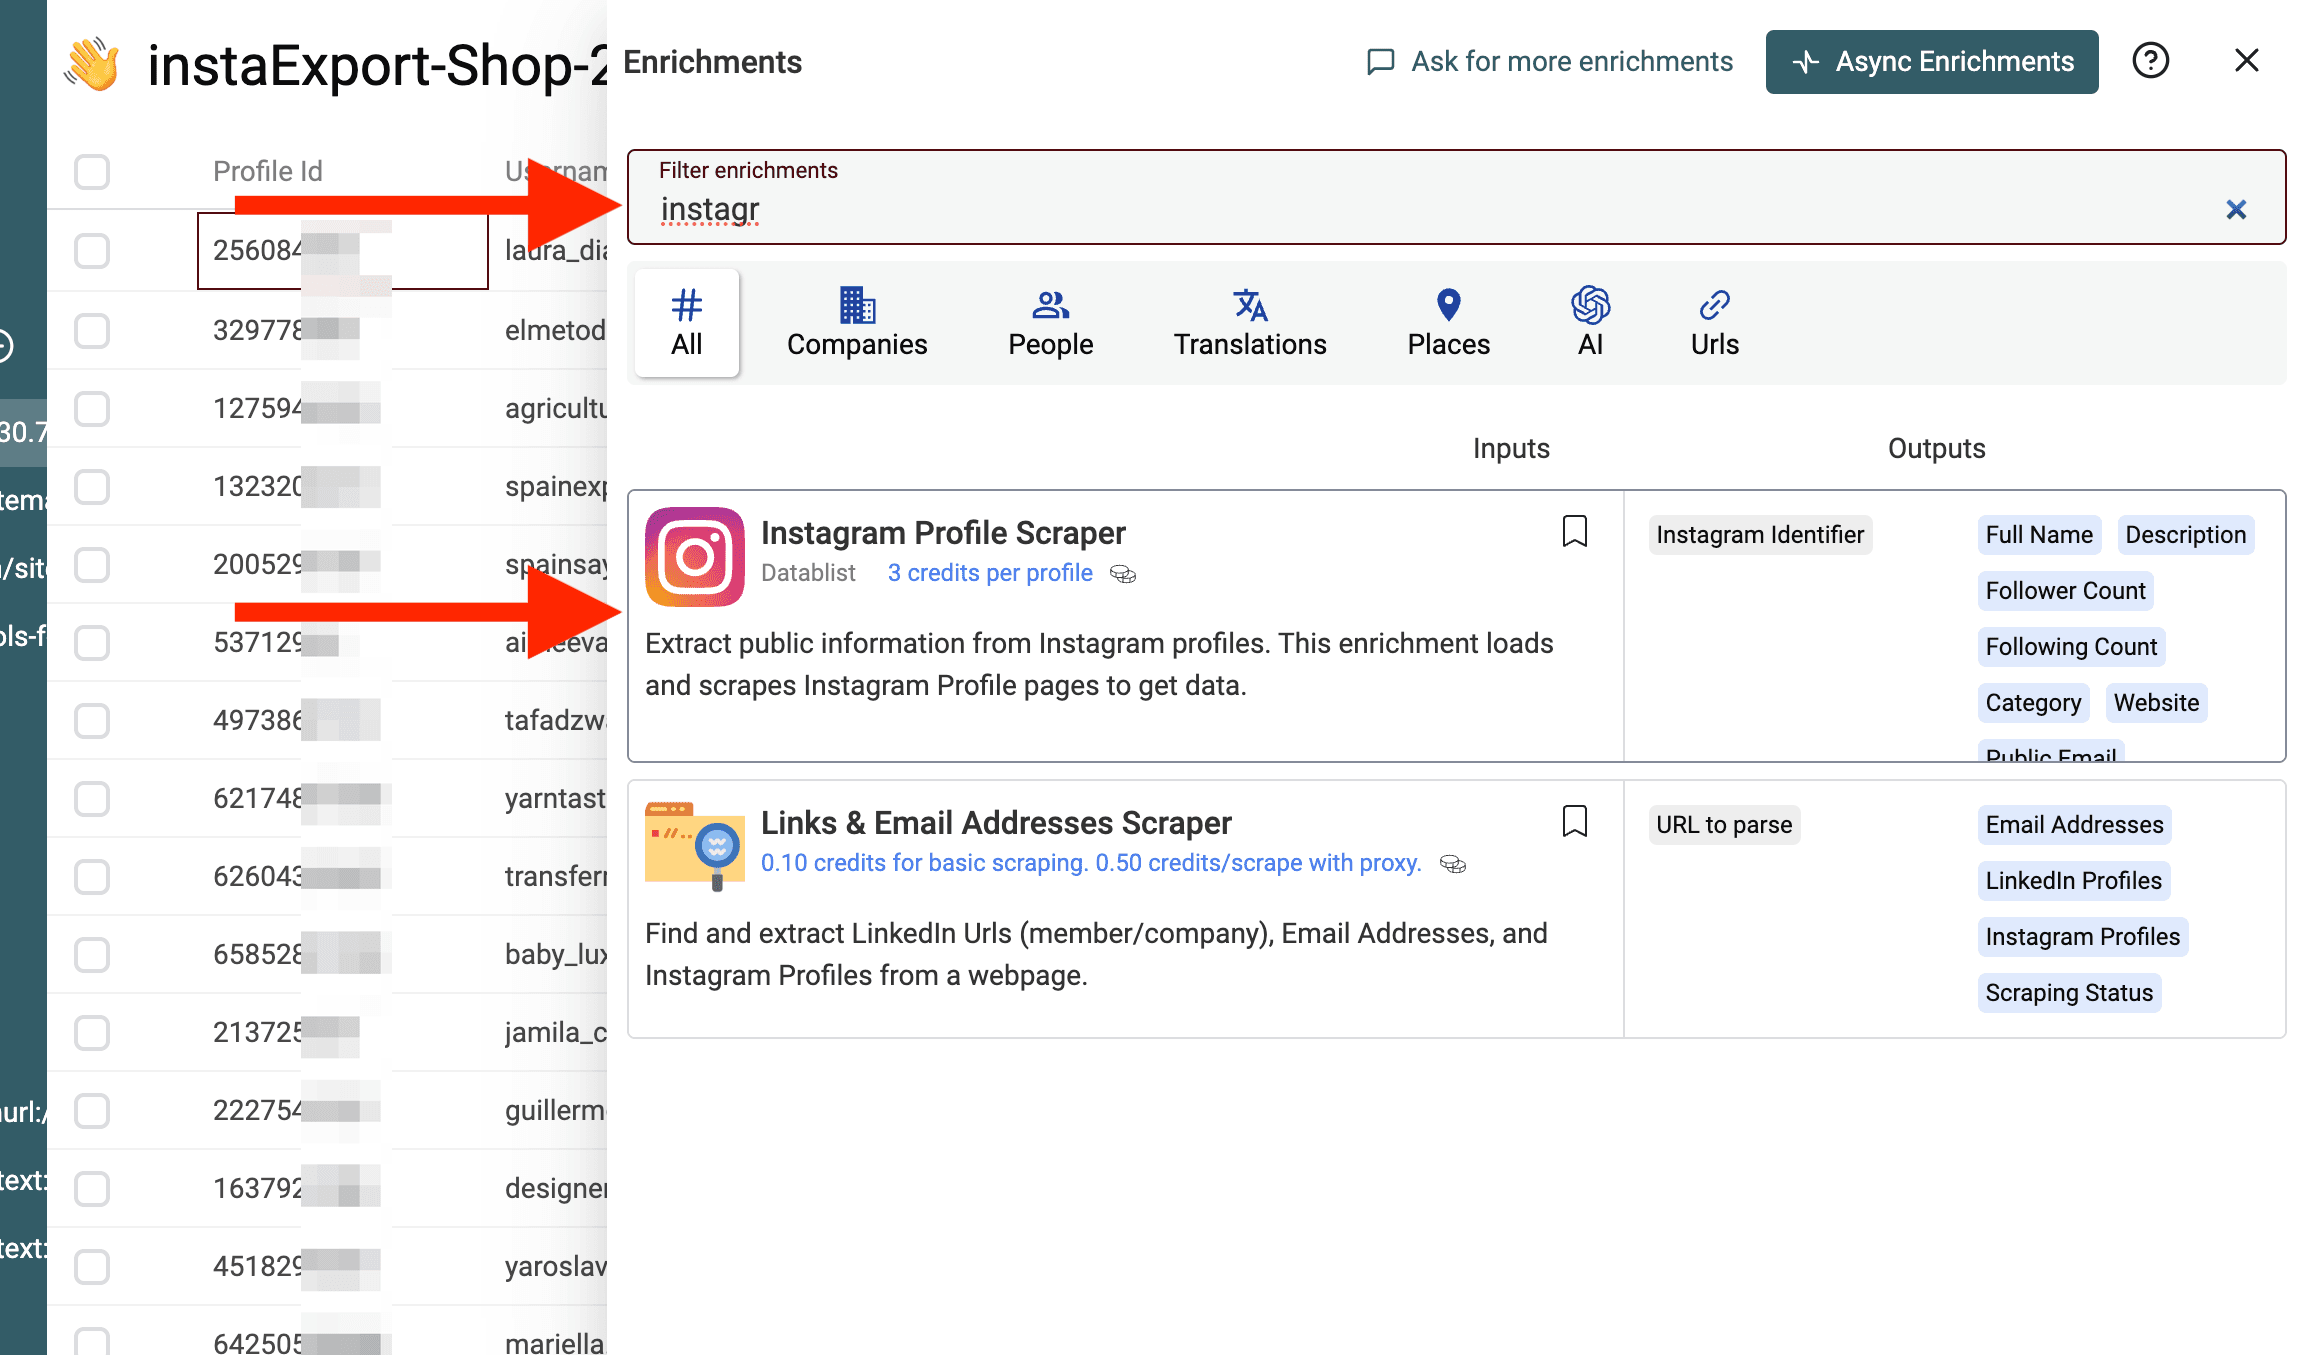
2. 选择 Instagram Profile Scraper 搜索并选择 Instagram Profile Scraper。这项 enrichment 会使用数据源结果中的主页标识符,请求额外的主页字段。具体可用数据取决于所选 Scraping Type,以及服务商能够返回的信息。
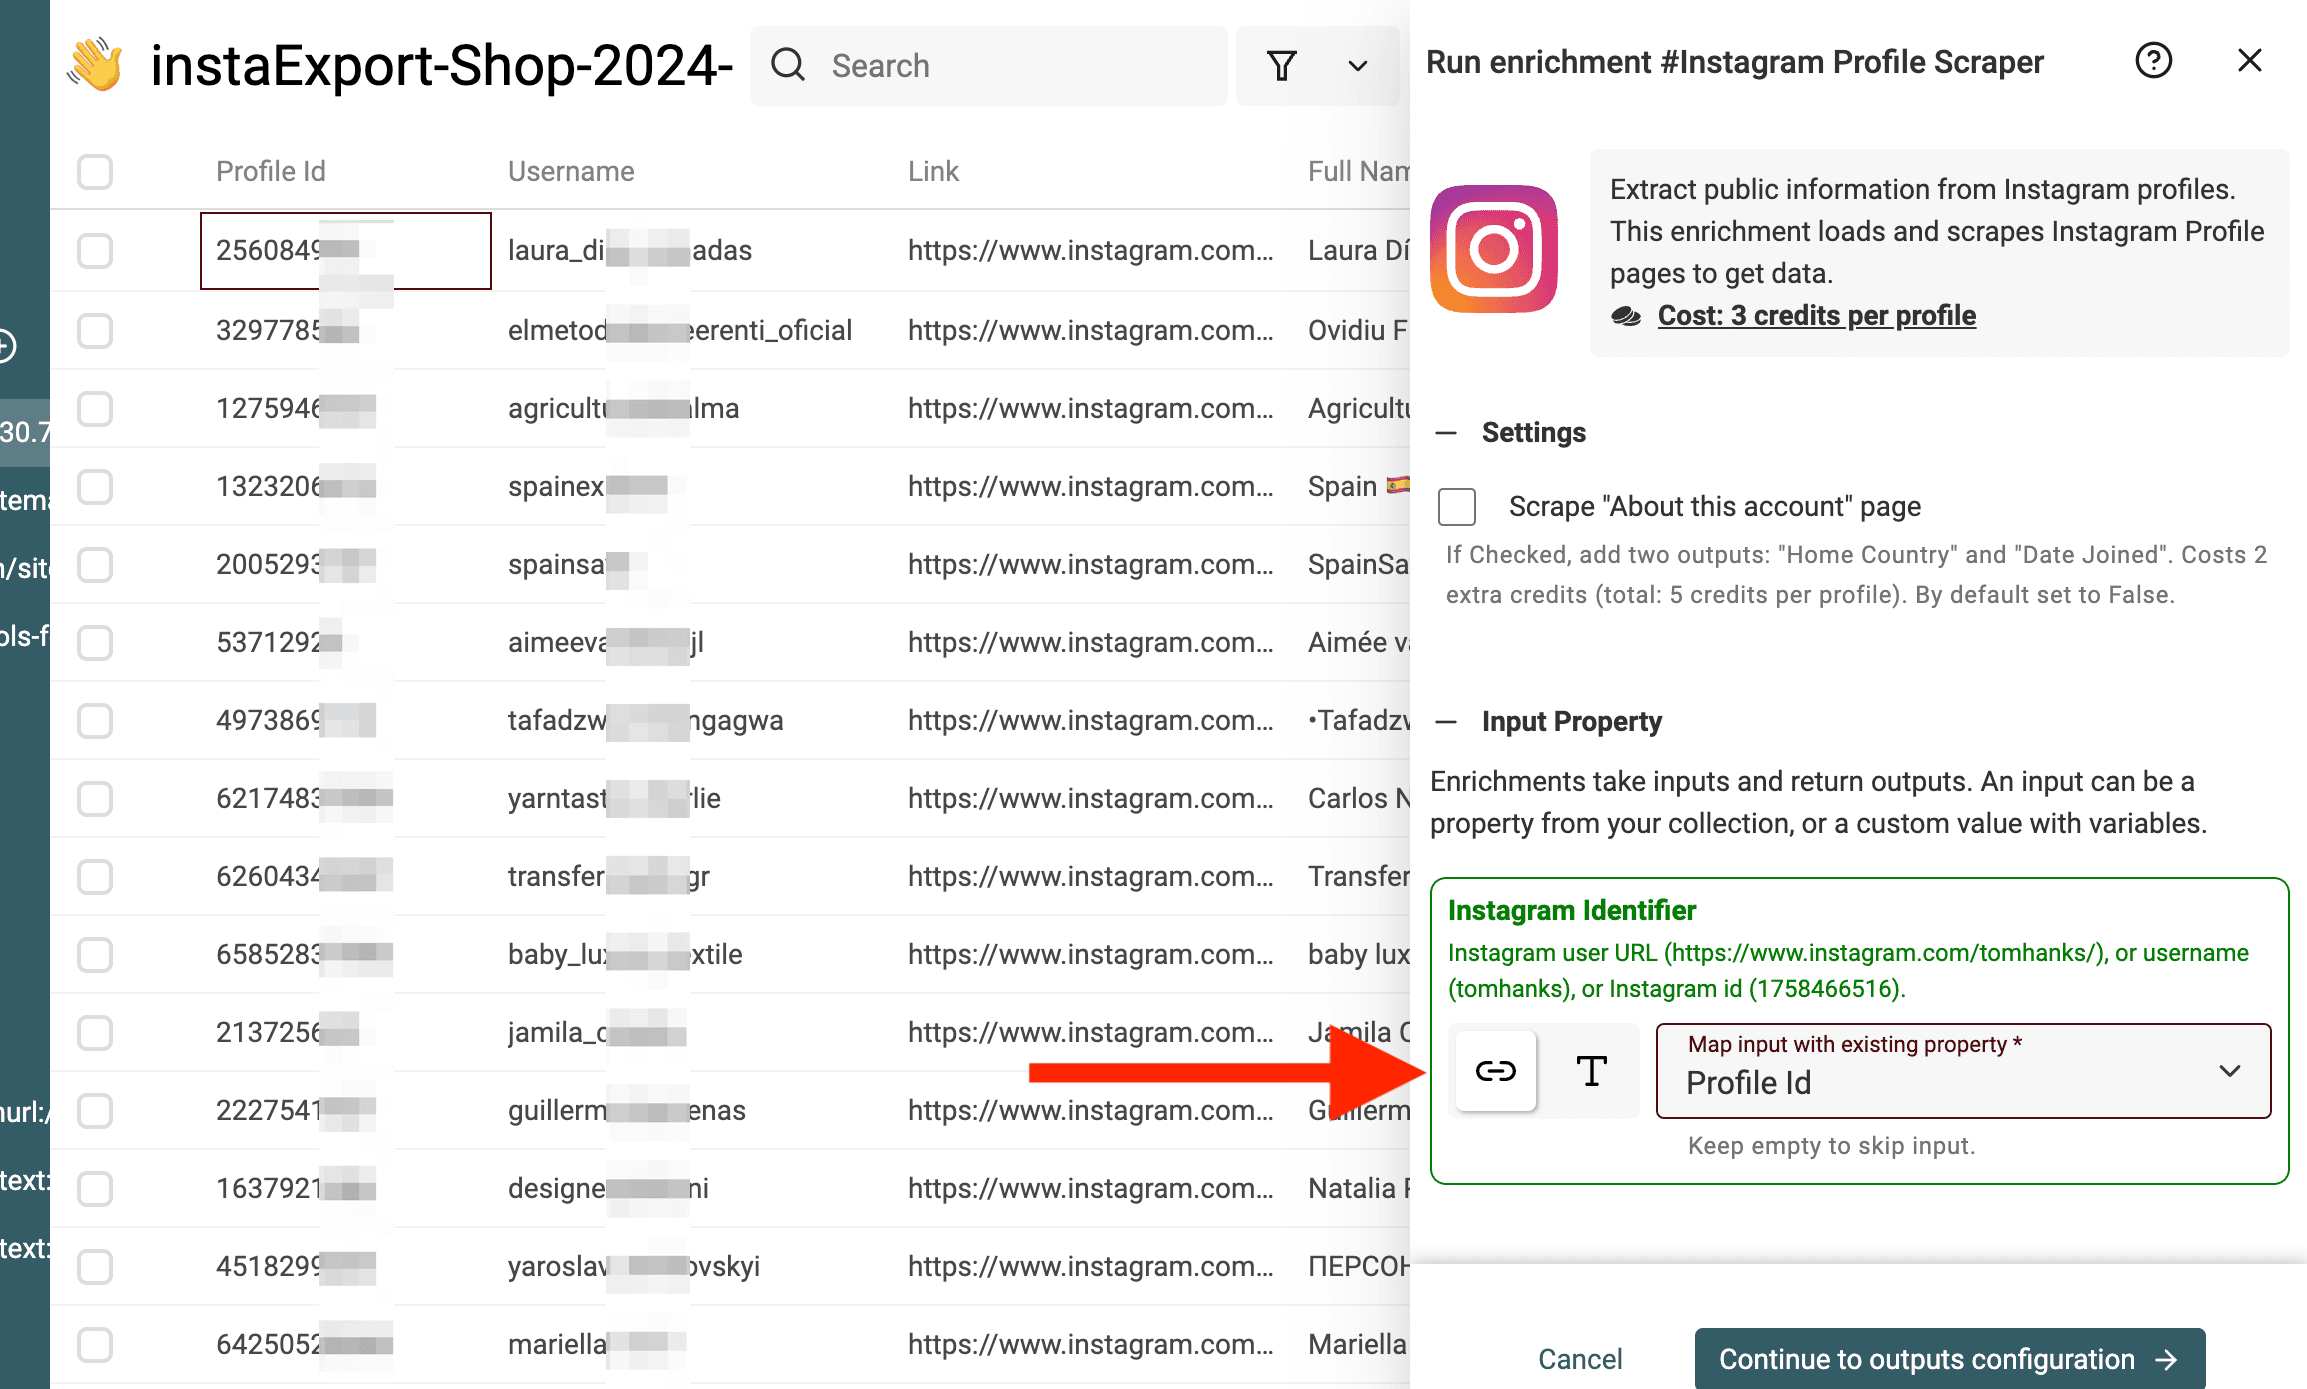
3. 映射数据列 告诉 Datablist 哪一列包含 Instagram handle。你应将第 6 步中的 Instagram Username 或 Profile URL 列映射到 scraper 的输入字段。
4. 选择输出字段 选择要添加到 collection 的具体数据字段。
将需要的输出字段映射到新列,以便保留原始粉丝标识符。
可获得的输出字段包括:
- **Public Email:**直接从商业主页中提取邮箱。
- **Description:**用于按特定职位或兴趣筛选数据。
- **Follower Count:**区分“Micro-influencers”和普通用户。
- **Website:**获取个人简介中的网站链接,以便进一步开展公司调研。
5. 运行 Enrichment
选择能够返回所需字段的 Scraping Type,然后先运行一个样本。仅获取公开主页信息的选项不包含邮箱或电话字段。Profile 选项可能返回用户公开提供的邮箱或电话号码,但这些字段仍可能为空。在处理剩余数据前,请检查可用设置和 credit 预估。
Enrichment 完成后,检查 Enrichment Status 和缺失字段。如果未找到公开邮箱,该字段应保持为空;这并不代表对方没有邮箱。如果邮箱隐藏在个人简介文本中,而不是官方邮箱字段里,你可以继续使用 Data Extractor 提取。
检查重复数据并续跑大规模抓取任务
需要区分以下两类数据集:
- **粉丝关系:**每个粉丝与来源主页的组合占一行。同一个人同时关注两个输入账号时,合理情况下会出现两次。
- **唯一主页:**如果只想对每个人执行一次 enrichment,则每个 User Id 只保留一行。在删除重复主页前,应单独保留其来源归属信息。
以一个示例批次来说,User Id 101 同时关注 Account A 和 Account B,代表两条关注关系,但只对应一个主页。如果仅按 User Id 去重,又没有先整合来源信息,就会丢失其中一条关注关系。
建议在 enrichment 前检查缺失的 ID、重复的来源与粉丝组合,以及异常偏少的结果。选择有代表性的主页样本,查看 Description、Website 和所有已返回的邮箱字段。不要因为某人关注健身账号,就将其直接归类为健身行业从业者。
如果之前的任务保存了续跑进度,请打开数据源设置并使用 Continue a previous scrape。可选记录仅适用于当前工作空间,并会保留七天。选中记录后,系统会沿用原来的来源主页和 Scrape Type,无需重新输入新的主页。
当数据源达到 collection 边界时,请按照设置提示,在同一工作空间的另一个 collection 中续跑。如果找不到续跑记录,请先检查原数据源任务,再决定是否重新开始。重新抓取可能与之前的快照产生重叠,因此应比较标识符,并保留来源和 collection 上下文。
为每个批次保存 Checked At 日期,并将检查后的结果导出为 CSV 或 Excel。粉丝数量会不断变化,因此不能将数量变化当作证明抓取完整性的检查清单;在不同分页或任务之间,粉丝可能已经发生变化。
总结
从公开主页和较小的抓取上限开始,保留粉丝及来源标识符,并在 enrichment 或导出前检查返回的关注关系。如果要运行更大规模的数据源任务,请优先使用仍然有效的续跑记录。
打开 Datablist,使用与你项目相关的主页体验同一套工作流。
Instagram 粉丝抓取常见问题(FAQ)
抓取 Instagram 粉丝合法吗?
数据公开可见,并不代表你已获得自动收集或重复使用这些数据的许可。收集粉丝数据前,请查看 Instagram 当前的使用条款,并确认你的预期用途符合相关要求。
可以同时抓取多个 Influencer 的粉丝吗?
可以。在 Instagram Profiles 下每行输入一个标识符。数据源会处理所提供的账号,并在返回的数据行中加入来源主页关系字段。不同账号的运行时长和完成情况可能不同。
可以抓取 Instagram 私密账号的粉丝吗?
不可以。此工作流无法提供私密账号的粉丝名单。主页详情查询是另一项独立 enrichment,不能用于解锁受限的粉丝数据。
抓取 Instagram 粉丝需要多长时间?
不同主页没有统一固定的完成时间。扩大任务前,请先运行一个小样本,检查实际用时、返回行数和 credit 消耗。
抓取超过 10 万名粉丝会怎样?
应将数据源任务上限和 collection 存储空间视为两项独立限制。数据源可能在完整获取某个主页的粉丝名单前停止。系统提示时,请在另一个 collection 中使用可用的续跑记录,并导出每个已完成的批次。不要将 collection 的导入容量误认为数据源的单次提取能力。
抓取 Instagram 粉丝可以获得哪些数据?
你可以为每名粉丝选择多种主页数据字段,包括:
- **User Id:**Instagram 内部用户标识符
- **User Username:**粉丝的 Instagram handle
- **User Profile URL:**其 Instagram 主页的直接链接
- **Full Name:**主页上显示的姓名
- **Profile Picture:**主页头像的 URL
- **Private:**账号是私密还是公开
- **Verified:**蓝色认证标记状态
- **Follower of (UserId)、Follower of (Username) 和 Follower of (ProfileUrl):**用于核对关注关系的来源账号标识符
一次可以抓取多少 Instagram 粉丝?
为数据源任务设置 Scraping Limit Per Profile,并检查任务进度和续跑设置。实际结果取决于可访问的粉丝页面、服务商响应、任务限制和可用 credits。导入容量并不代表粉丝数据源能够在一次任务中返回相同数量的数据。
抓取 Instagram 粉丝需要浏览器扩展吗?
不需要。Datablist 完全以 Web App 形式运行,无需扩展、下载或安装任何软件。
抓取 Instagram 粉丝最省钱的方法是什么?
先设置较小的请求上限,查看 credit 预估,并在运行主页详情 enrichment 前检查返回的数据行。应比较每个经过审核且真正有用的主页成本,而不是默认每个返回的粉丝都是合格联系人。
如何抓取 Instagram 粉丝而不被封号?
在此工作流中,Datablist 不会要求提供 Instagram 登录凭据或 session cookies。但这并不代表抓取完全没有风险,也不表示你已获得收集数据的许可。请仅使用可访问的来源数据,查看网站的相关要求,并在请求的名单不可用时停止操作。
抓取 Followers 和 Following 有什么区别?
Followers 是关注某个主页的人;Following 则是该主页正在关注的账号列表。本指南专门介绍粉丝抓取,但 Datablist 同时提供这两种选项。
可以抓取 Instagram 商业账号的粉丝吗?
可以,前提是该商业账号为公开账号。无论是个人账号、Creator 账号还是商业账号,scraper 的工作方式都相同。
如何下载 Instagram 粉丝名单?
注册 Datablist、创建一个 collection、选择 Instagram Followers/Following Scraper、粘贴主页信息,然后点击运行。任务完成后,将结果导出为 CSV 或 Excel。
哪些工具可以抓取 Instagram 粉丝?
可选方案包括浏览器扩展、Python 脚本和 Datablist 等平台。比较时应关注所需的账号访问权限、返回字段、续跑支持、样本运行时间,以及每条有效结果的成本。使用此工作流时,Datablist 不需要你的 Instagram 登录凭据。