
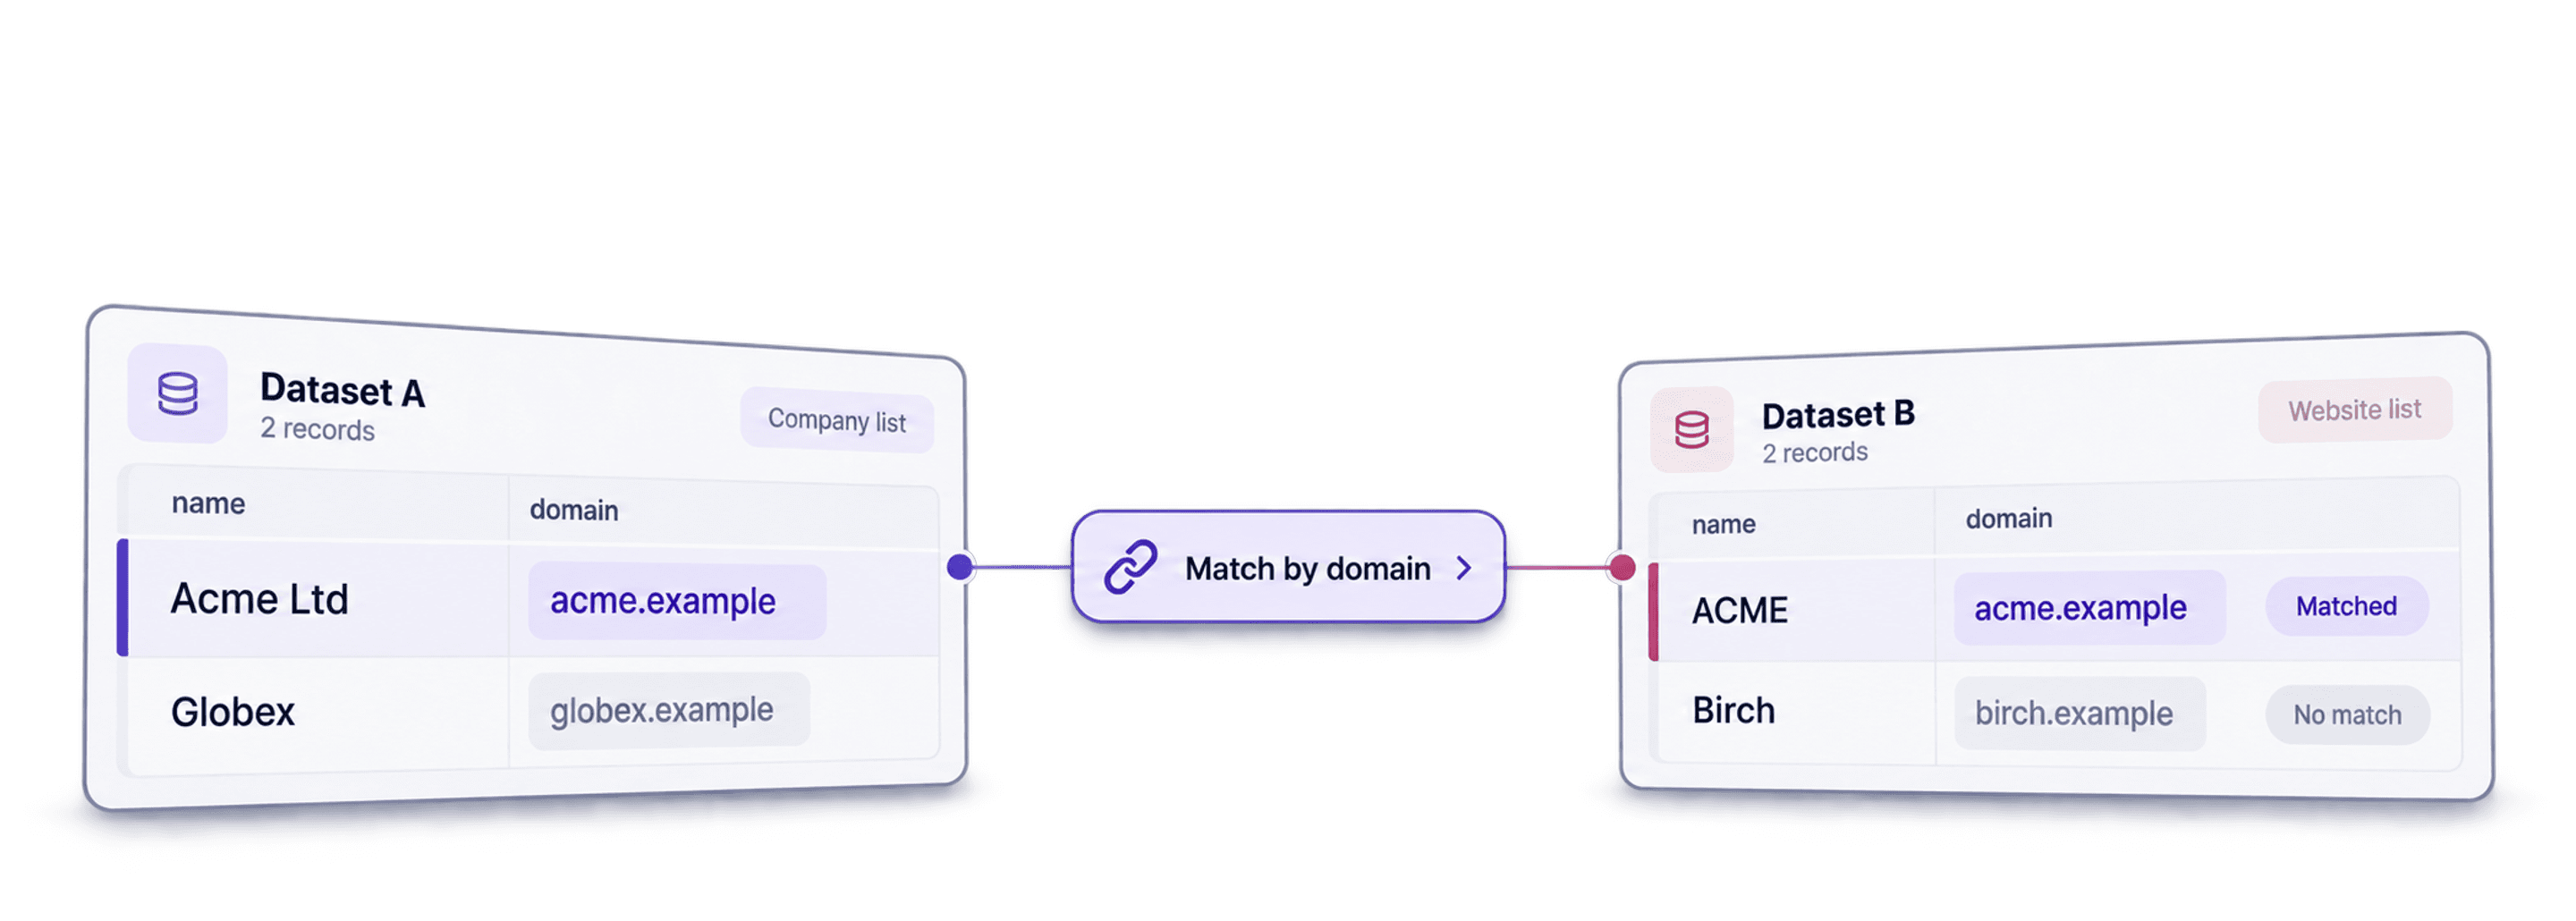
当两个名单中可能包含同一批人员或公司,但名称写法略有不同时,就可以使用数据匹配工具。在 Datablist 中,先将名单导入不同的 collection,映射需要比较的列,选择匹配算法,再审核候选分组,然后合并或导出。建议先用邮箱地址、公司域名等精确标识符进行匹配。只有在缺少稳定标识符时,才使用名称模糊匹配,并结合第二个字段核验结果。
例如,一份 Lead 名单中的公司可能写作 Acme Ltd,域名为 acme.com;另一份名单则写作 ACME,但域名相同。相比名称相似,仅凭相同域名就有更充分的理由将这两条记录关联起来。Datablist 的 Duplicates Finder 既能比较单个 collection 内的记录,也能跨 collection 比较,并生成分组供你审核。高级语音匹配和模糊匹配算法仅在付费方案中提供。
以下是本文将介绍的数据匹配要点:
合并前务必审核匹配结果。 相似的名称可能对应不同的个人或公司,名称较短或使用缩写时尤其如此。
第 1 步:导入数据集
第一步是将数据集导入 Datablist。Datablist 是一款在线名单管理工具,可用于查看和编辑 CSV 文件及 Excel 文件。它非常适合管理 Lead 名单、清洗客户数据或清洗网页抓取数据。
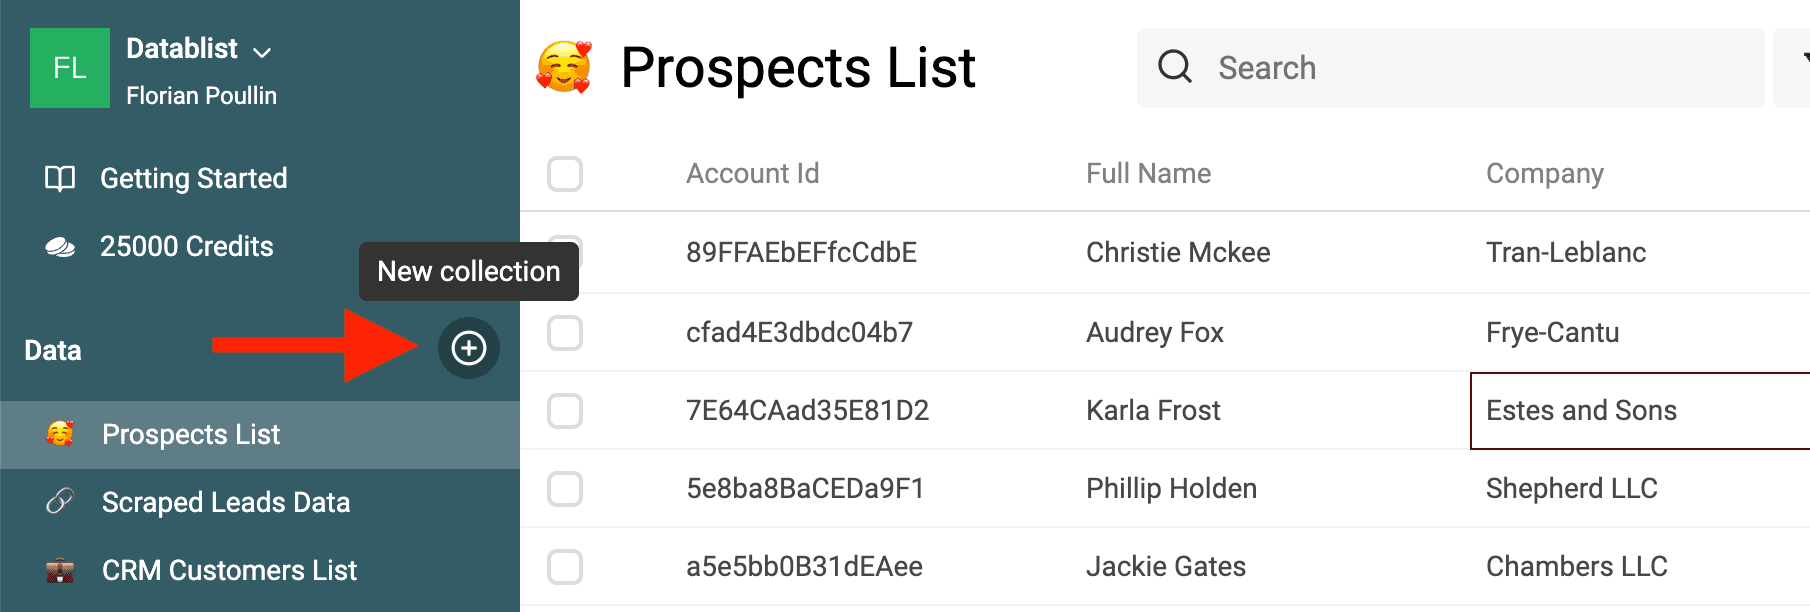
首先,新建一个 collection,用来导入你的第一个数据集。
然后点击 Import 按钮。
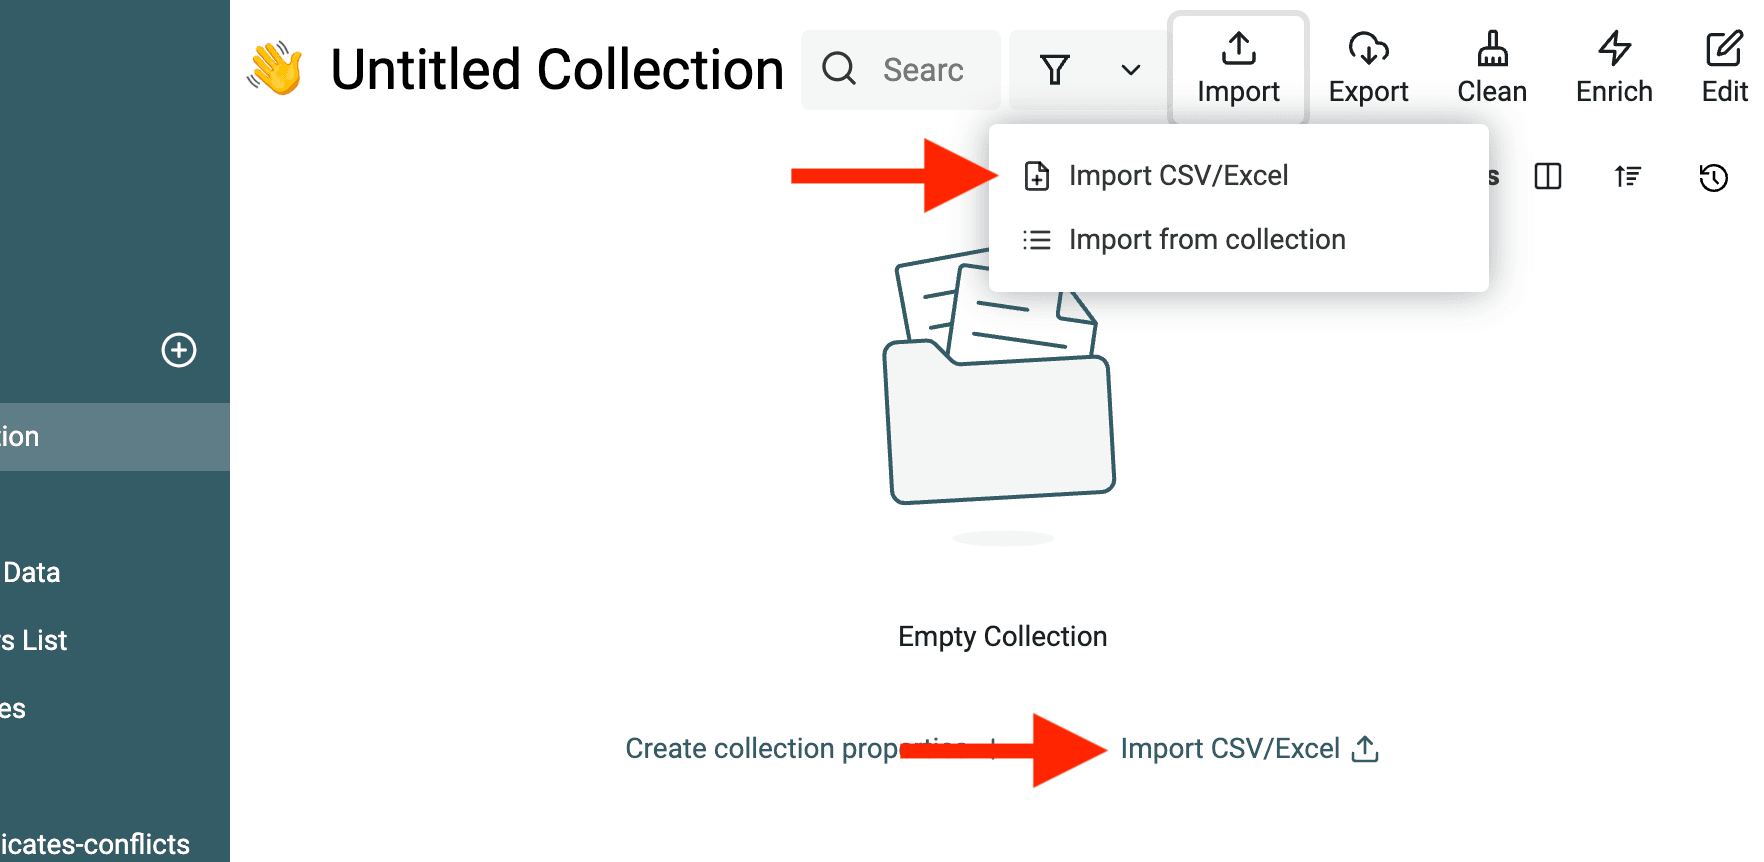
第一个数据集导入后,你可以:
- 将数据结构相同的其他数据集导入同一个 collection。
- 将数据结构不同的数据集导入新的 collection。
Datablist 的 Duplicates Finder 可以查找单个 collection 内的匹配记录,也可以跨不同数据结构的 collection 进行匹配。
第 2 步:按需清洗数据
第二步是进行数据清洗。数据清洗是数据匹配的重要前提,能够提升匹配过程的准确性和可靠性。脏数据或未经清洗的数据容易造成错误匹配,让结果失去可信度。简单来说,做好数据清洗,才能为准确的数据匹配打好基础。
姓名或公司名称中可能包含一些没有实际意义的内容。这些内容虽然不提供有效信息,却可能妨碍去重算法识别重复项。
Datablist 内置了多种数据清洗工具:
- 删除符号和标点 - 抓取的文本可能包含表情符号、ASCII 符号,名称中也可能带有标点。Datablist 的匹配算法会在数据匹配时忽略它们,但这些字符仍可能阻碍去重流程中的自动合并。
- 删除多余空格 - 单词之间多一个空格,就足以让两个字符串被视为不同内容。Datablist 的匹配算法会预处理文本并删除多余空格,但这些空格仍会妨碍去重流程中的自动合并。
- 从文本中提取邮箱地址、URL 等信息 - 如果数据包含邮箱地址、URL、成员提及、标签等非结构化文本,可使用 Data Extractor 提取这些实体并将数据结构化。拥有可匹配的结构化实体后,Data Matching 流程会更顺畅。
- 删除 HTML 标签 - 该清洗功能可以将包含 HTML 标签的字符串转换为纯文本,从而将带 HTML 标签的抓取名单与其他数据集进行匹配。
- 将文本转换为 DateTime、Number、Boolean 等类型 - Datablist 提供原生的 DateTime、Number、Boolean 等数据格式。数据清洗中的一个重要步骤,就是将原始文本转换为原生格式。当你需要通过比较值来选择主记录时,例如选择日期最新的记录,原生 DateTime、Number 等类型是实现高级合并规则的关键。
- 统一文本大小写格式 - 转换文本大小写看似简单,却是必不可少的一步。Datablist 内置了多种大小写转换算法。
- 拆分或合并属性 - 该功能非常适合处理多值数据。如果某个属性包含多个以逗号、分号或空格分隔的邮箱地址,Datablist 的 Split Property 工具会创建多个属性,每个属性仅保留一个邮箱地址。
- 删除或替换空值 - 使用 Datablist Filtering 功能筛选空值或空行。
如需更多示例和操作说明,请查看我们的数据清洗指南。
标准化人员姓名
处理人员数据集是数据去重中的常见场景。客户、Lead 和潜在客户数据集都是典型的人员名单。理想情况下,人员数据匹配应基于邮箱地址或身份号码等唯一标识符。如果缺少这类标识符,或需要跨数据集匹配同一个人,就必须在匹配过程中使用姓名。
对姓名进行预处理,可以让所有姓名采用统一格式,减少去重时的错误。
清除姓名中的干扰信息
姓名的写法可能有很大差异,昵称、缩写、不同拼写以及特殊字符都很常见。
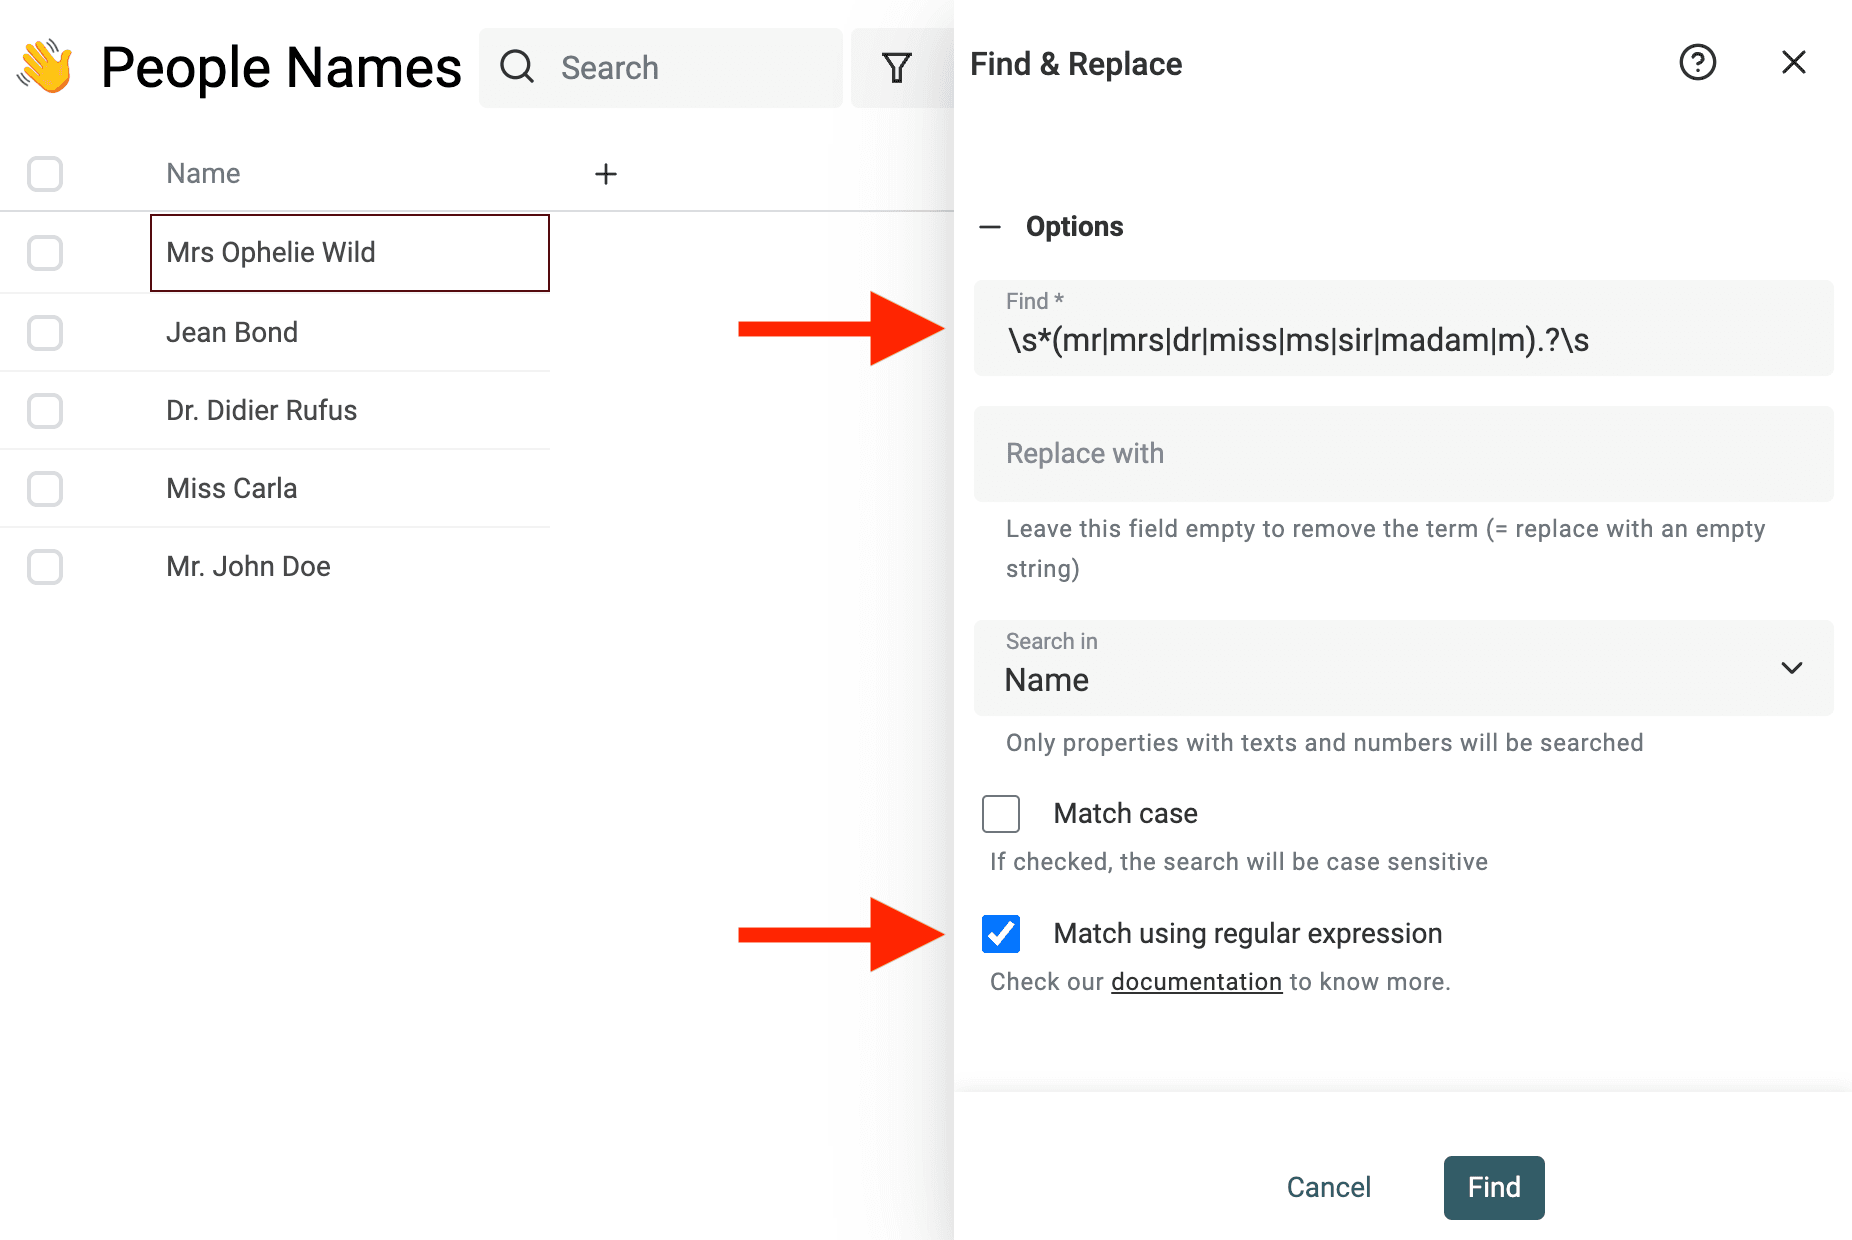
使用功能强大的 Find & Replace tool,可以删除称谓、后缀、停用词、地区附加信息及其他无用内容。
例如,要删除英文姓名中的称谓,可以使用以下正则表达式:
^\s*(mr|mrs|dr|miss|ms|sir|madam|m).?\s
并将其替换为空字符串。
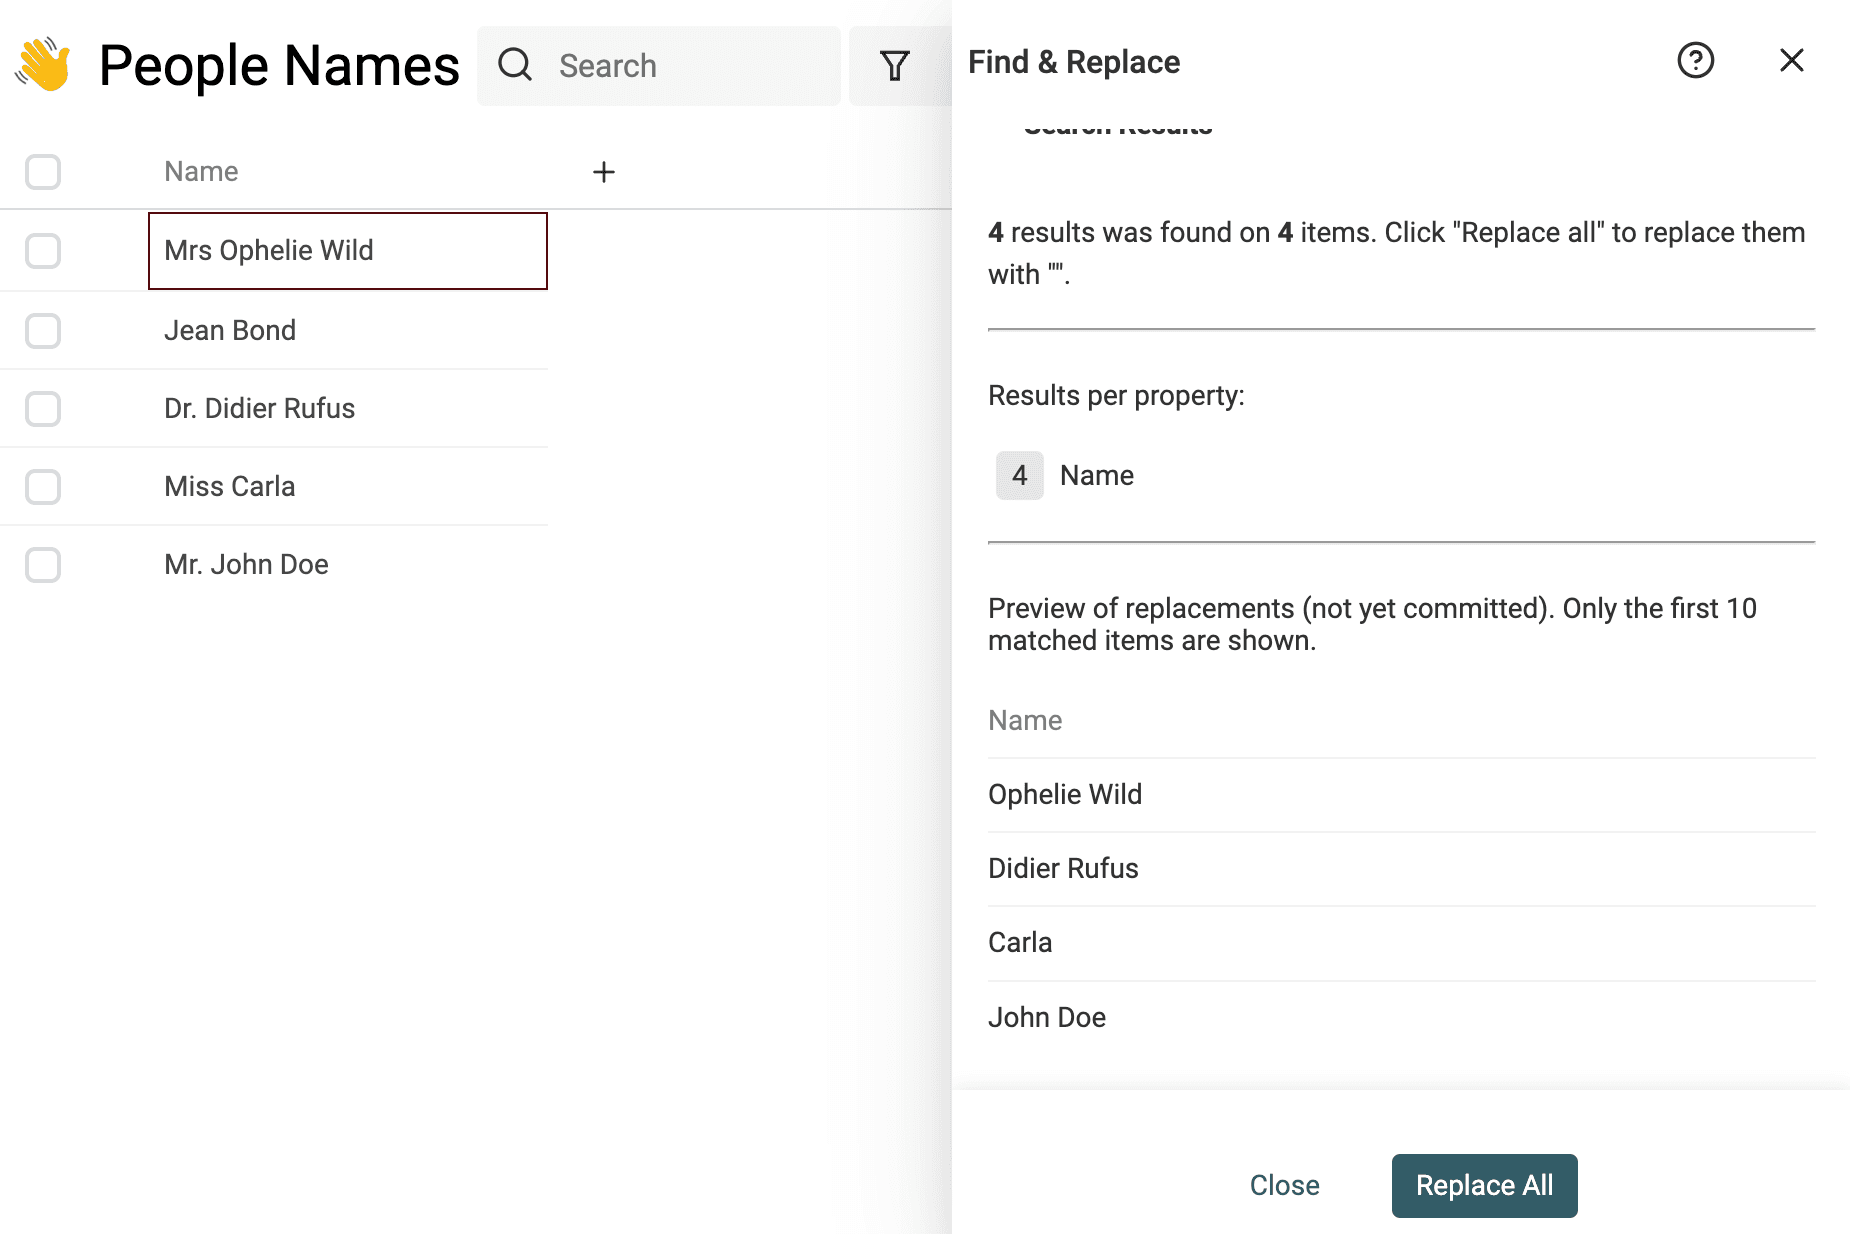
说明 如果你不熟悉正则表达式,可以直接联系我们,我们会协助你清洗数据。
将完整姓名拆分为多个部分
Datablist 不只是一款数据清洗工具,还提供数据 enrichment 功能,例如 Lead enrichment,以及使用 Deepl 翻译 CSV。
Name Parser 是一项非常适合清洗姓名的 enrichment。它接收完整姓名后,可拆分出 first name、middle name 和 last name,并返回该姓名最常见的性别与国家/地区。
它会利用统计数据拆分完整姓名。
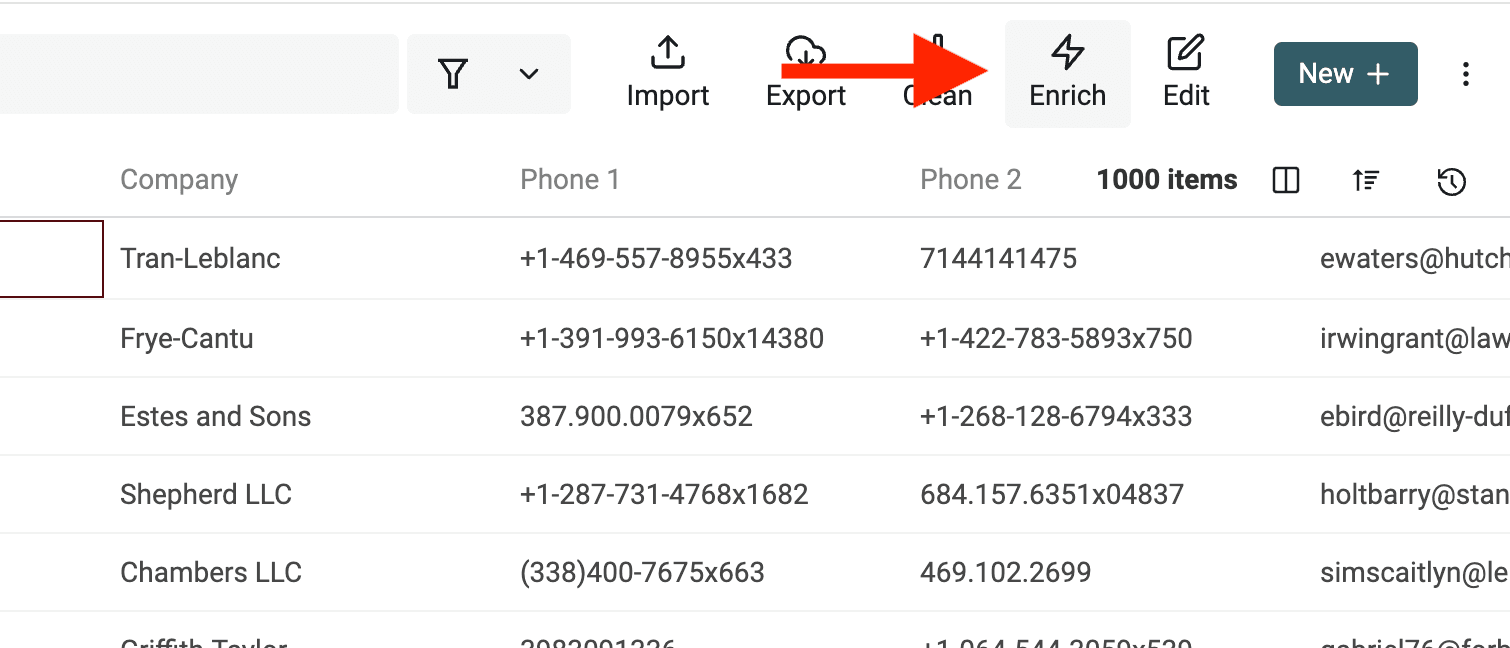
要使用此功能,请点击顶部按钮中的 “Enrich Menu”。
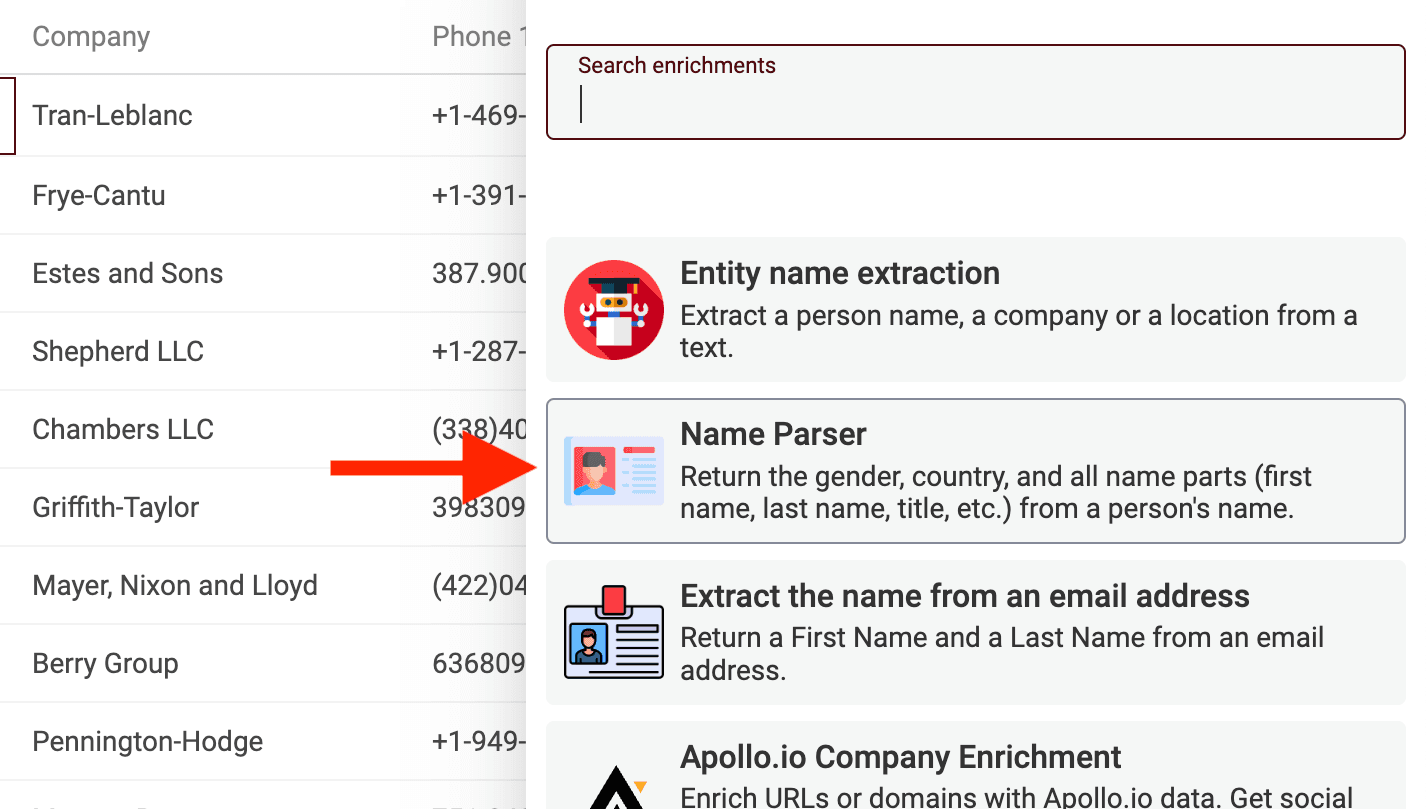
然后选择 “Name Parser”。
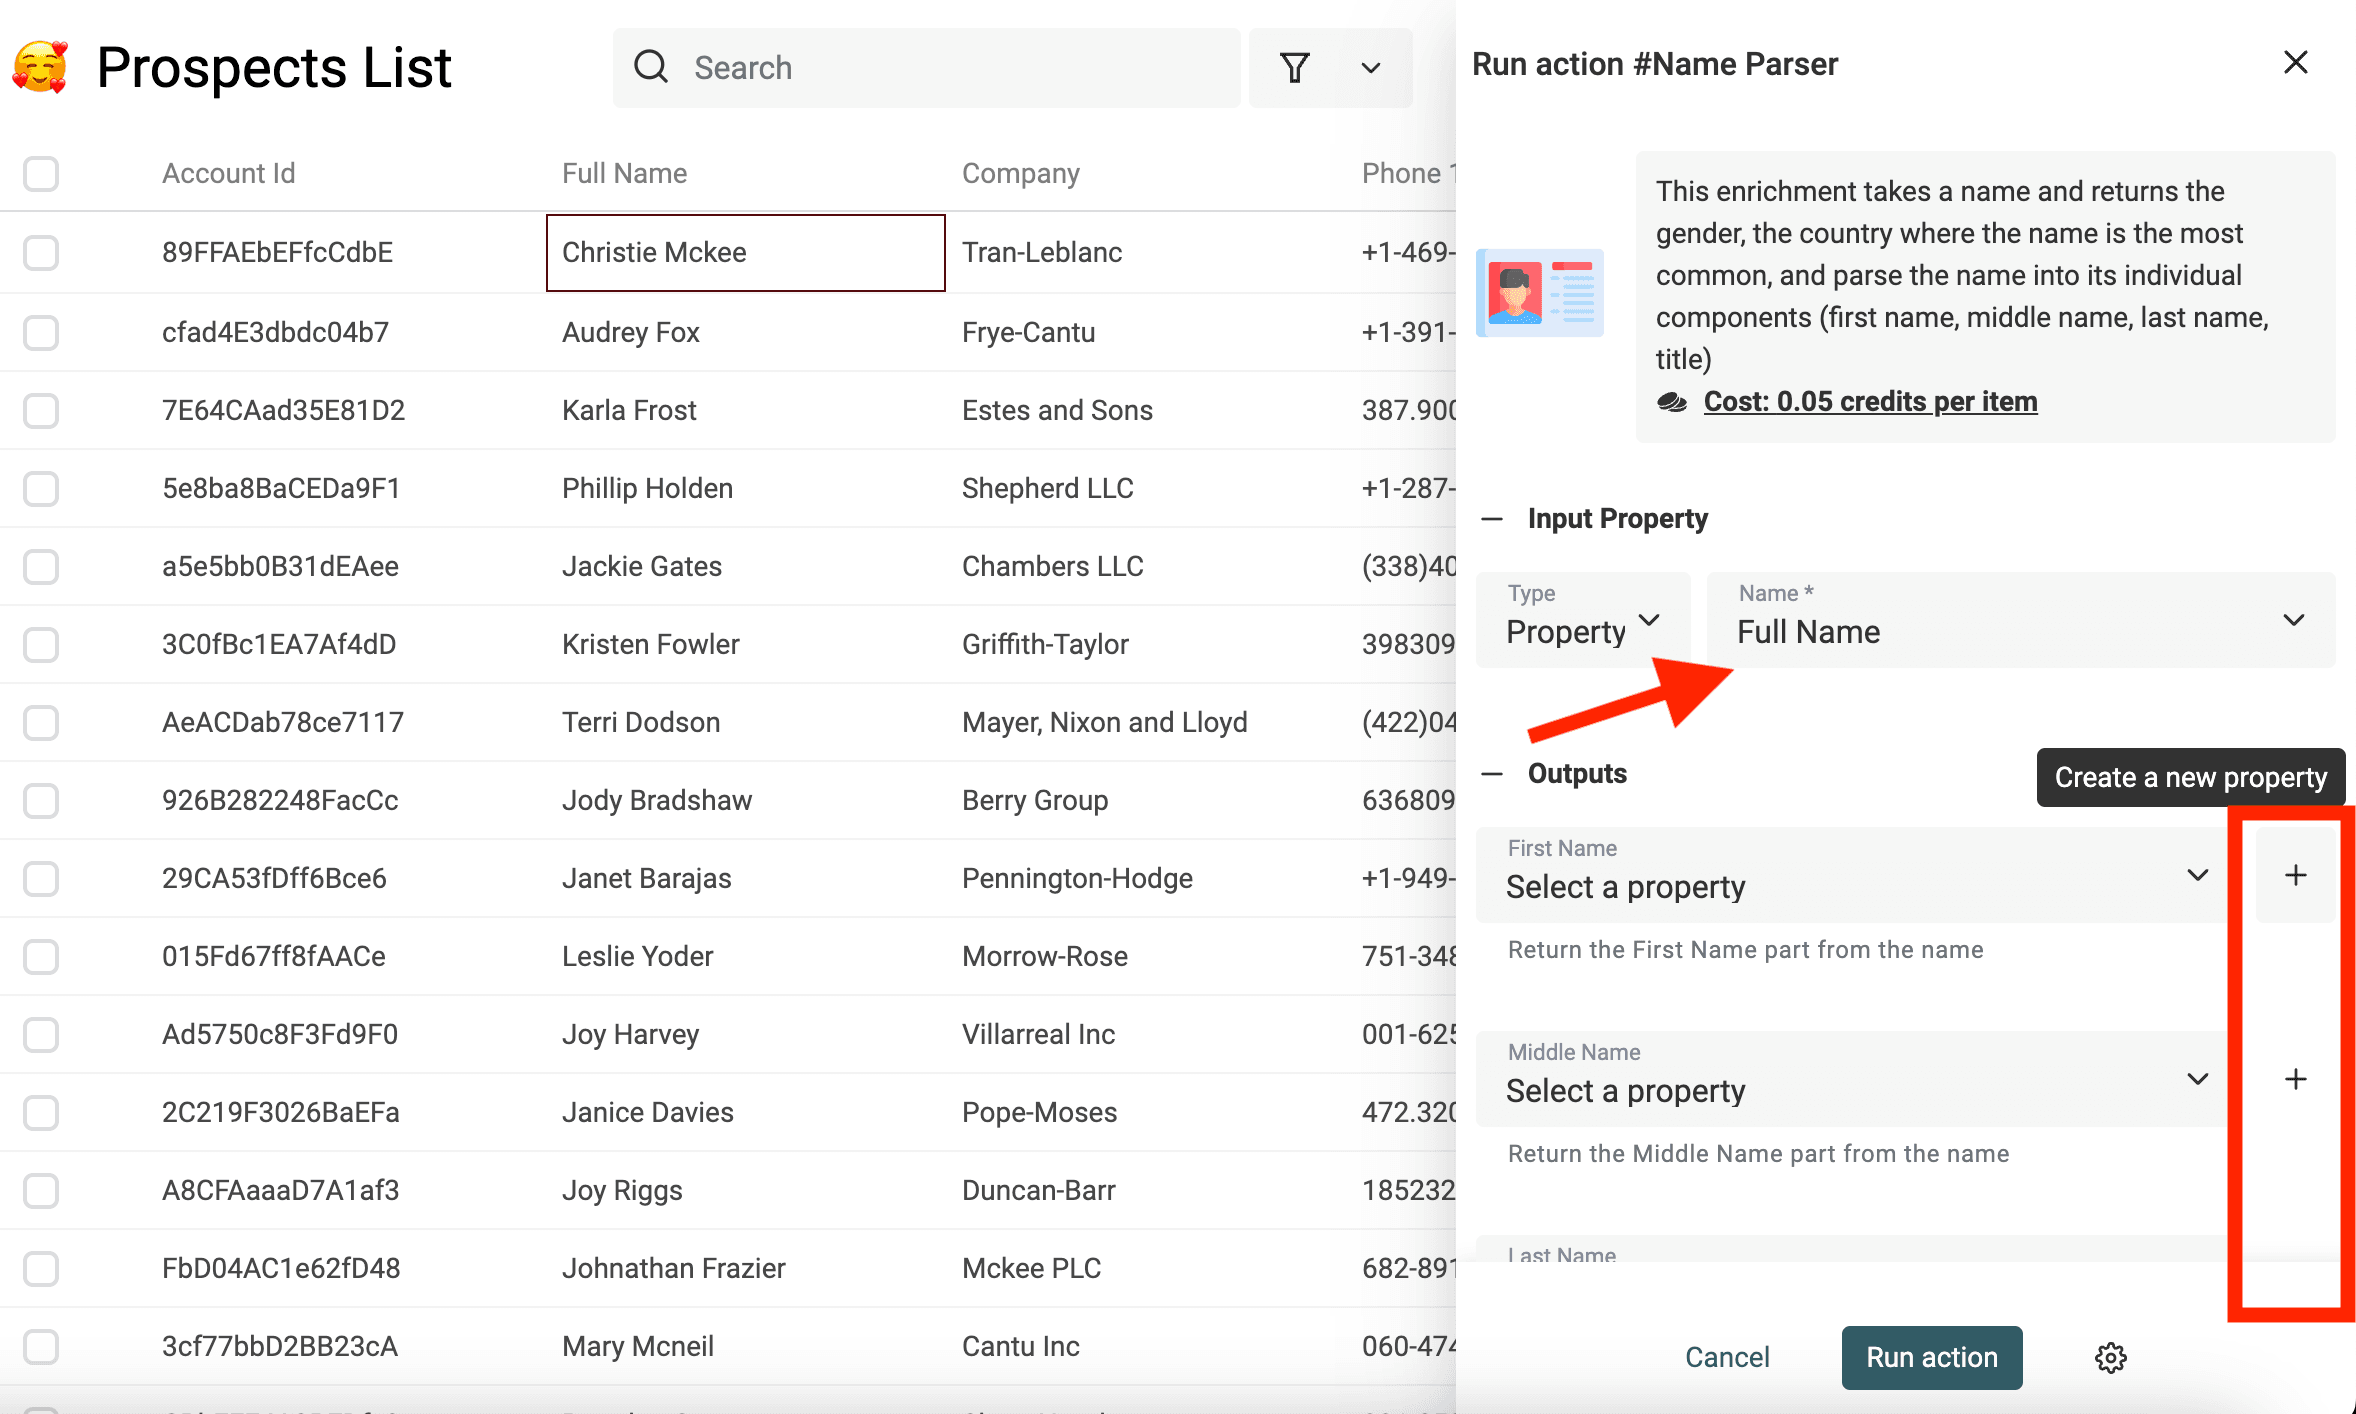
接着选择包含姓名值的属性,并映射或新建属性来保存解析结果。完整姓名属性不会被修改,只有输出属性会写入解析结果。
标准化公司名称
公司名称同样可以清除干扰信息。如果名称中含有前缀、后缀、停用词、地区附加信息或其他影响匹配的内容,都可以先进行清洗。
一个常见的清洗示例,是删除 “Inc.” 或 “GmbH” 等公司名称后缀。
在 Find & Replace 工具中使用以下正则表达式:
,?\s(llc|inc|incorporated|corporation|corp|co|gmbh|ltd).?$
并将其替换为空字符串。
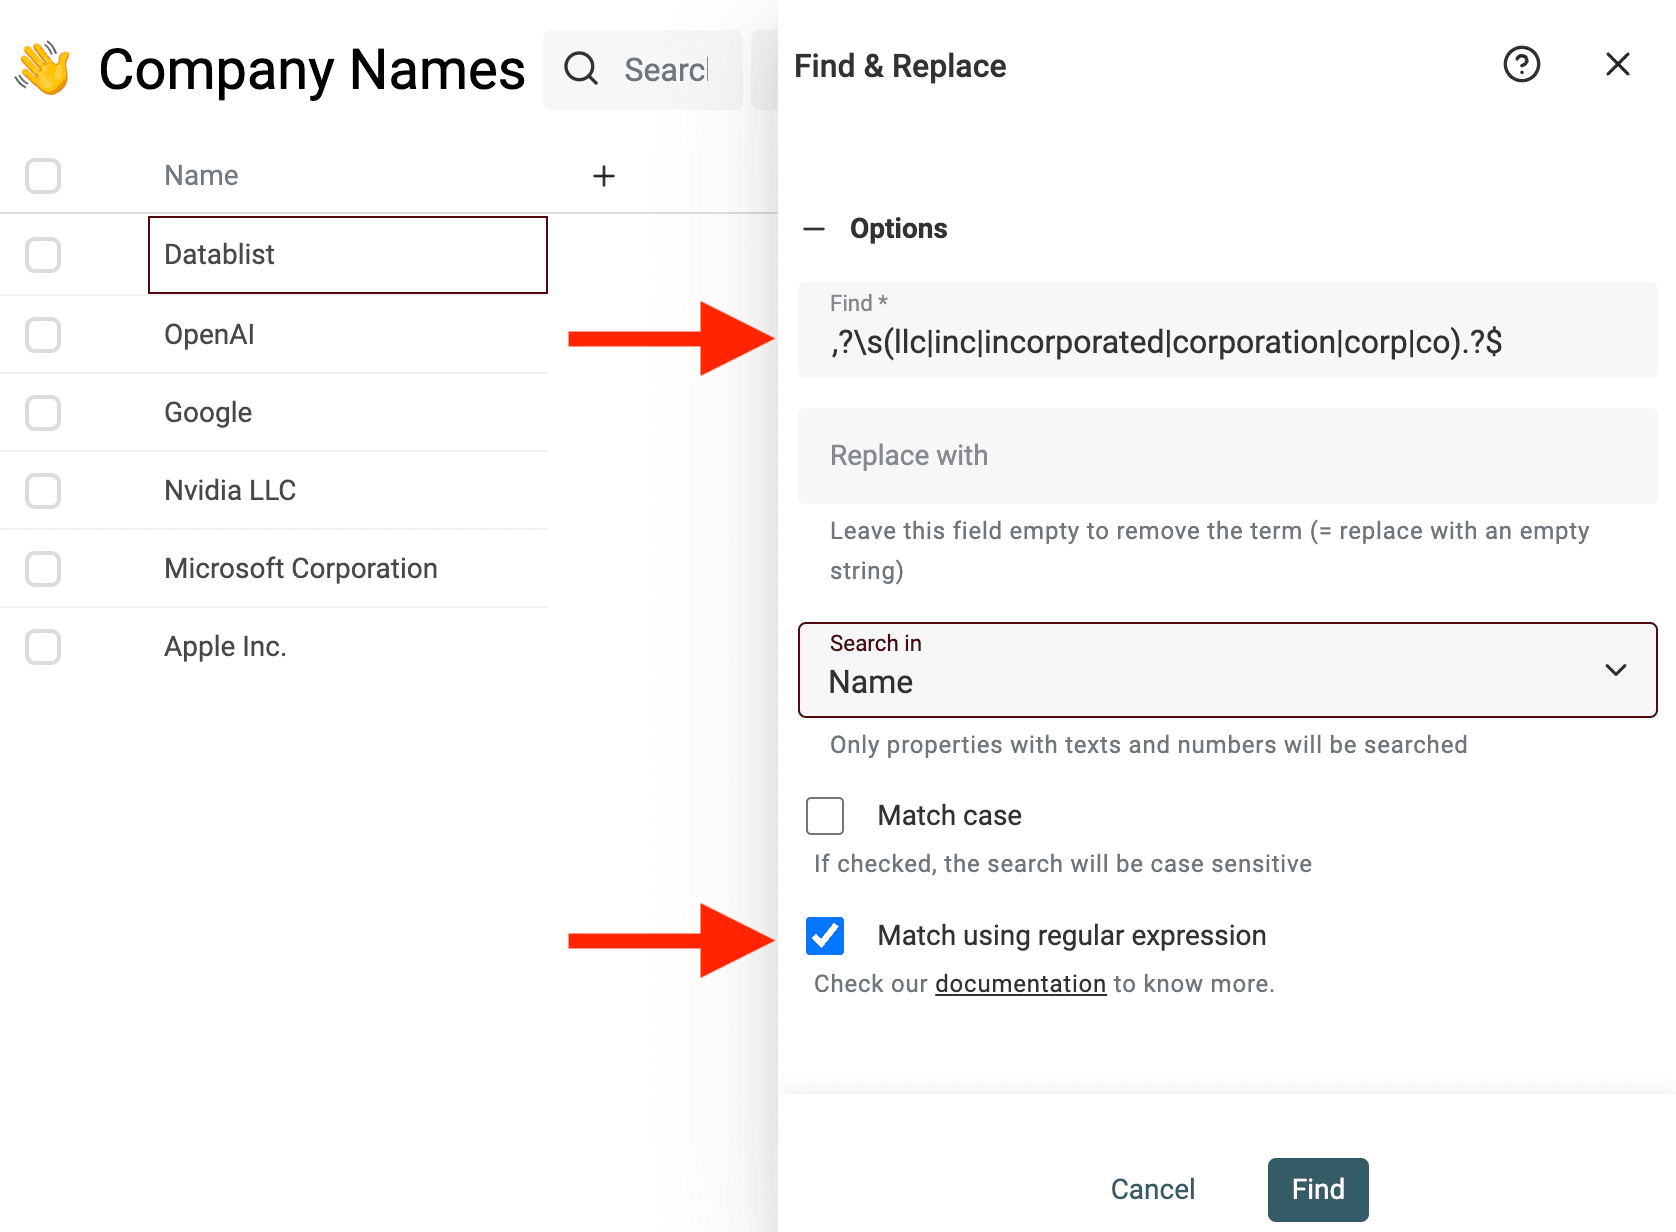
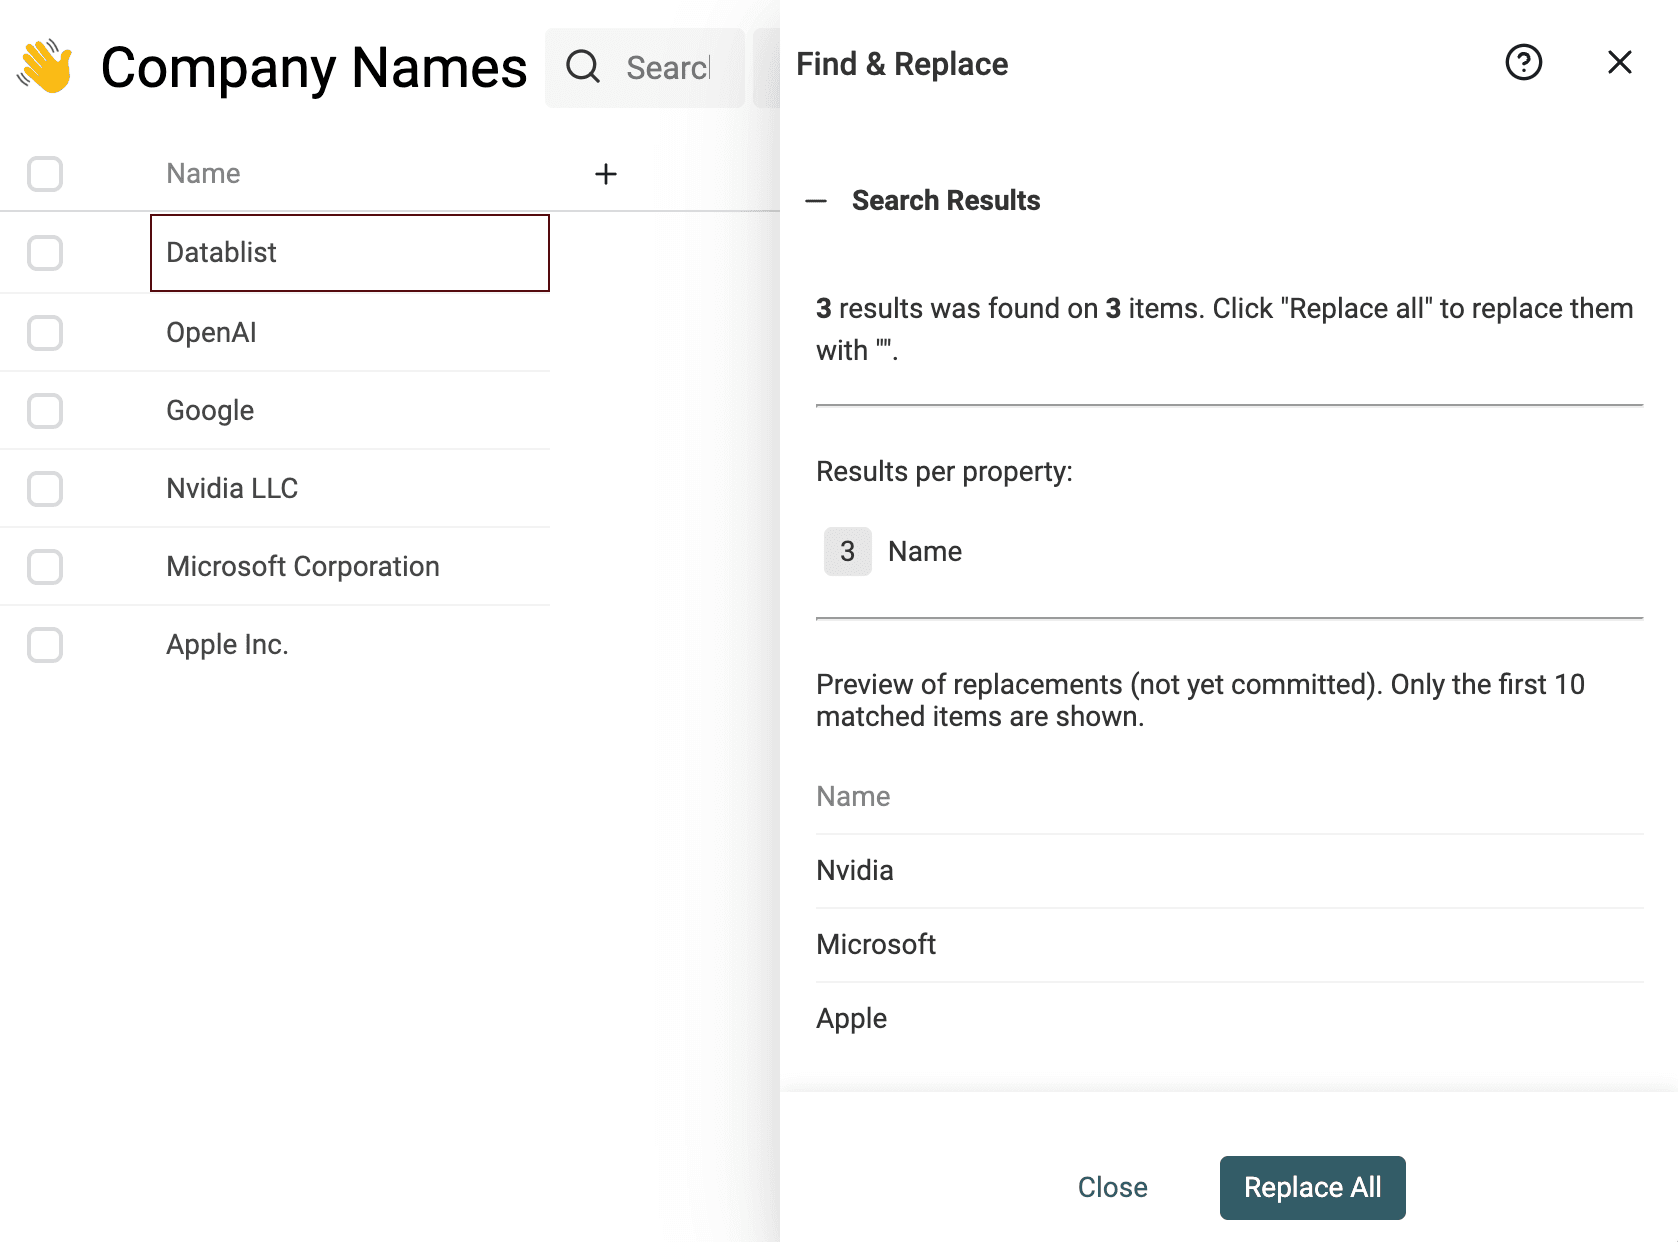
对所有数据集中的公司名称和地址进行标准化,可以将它们统一为一致的格式,这对准确匹配非常重要。
标准化街道名称
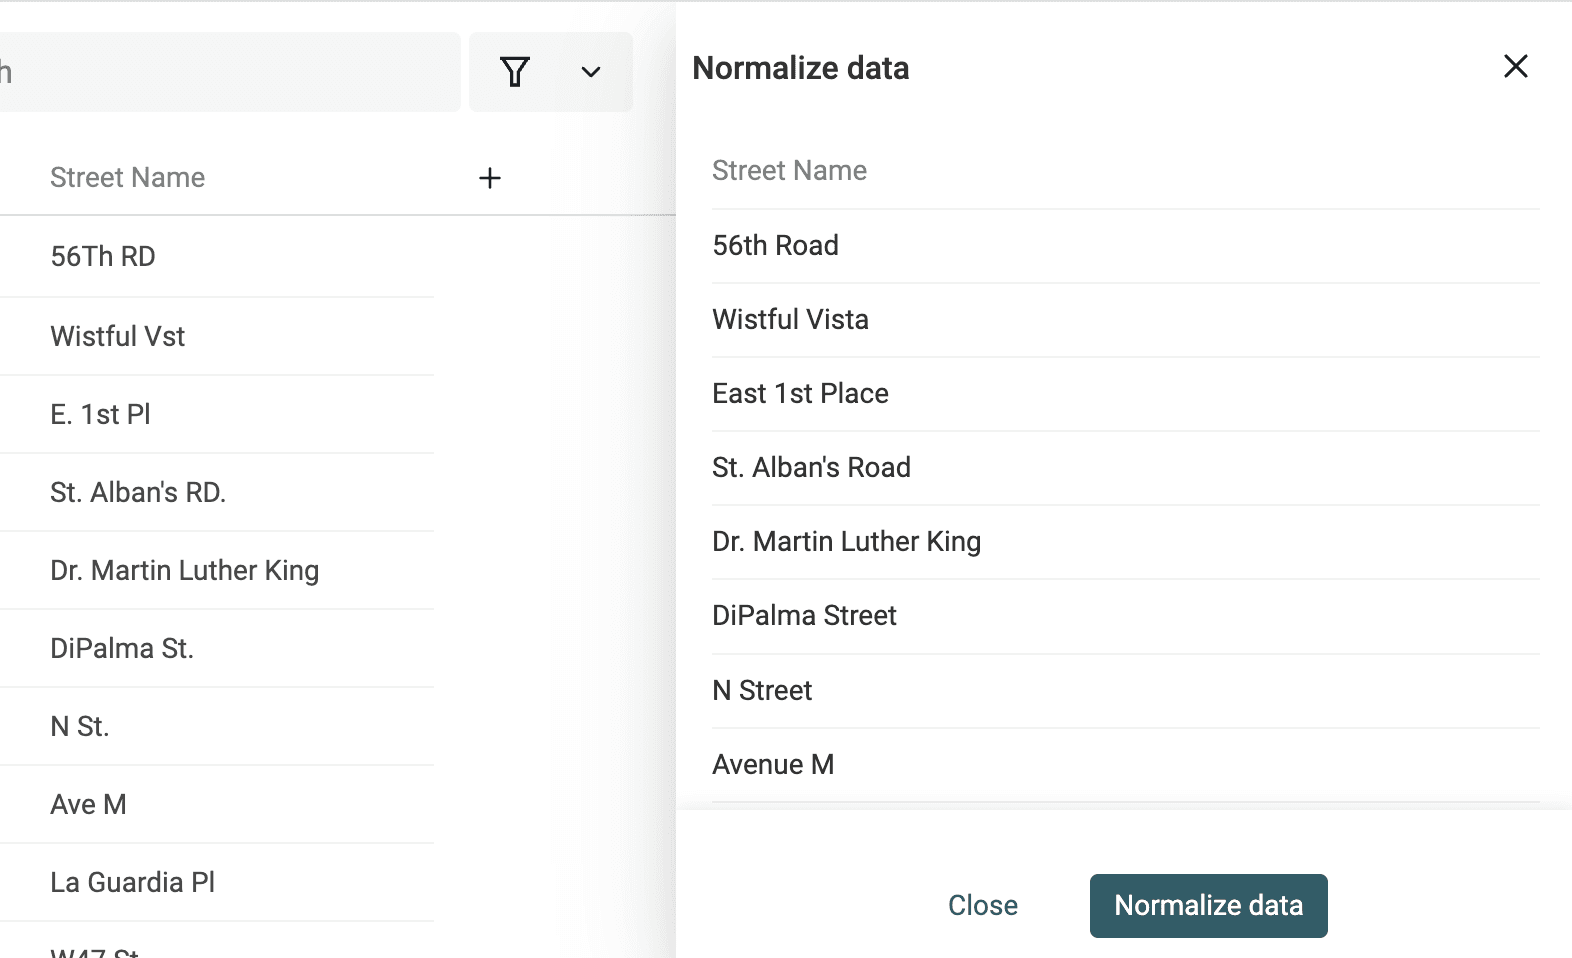
如果要根据邮寄地址进行 Data Matching,街道名称标准化至关重要。地址可能使用缩写、方向前缀或数字序数后缀。若不进行标准化,同一条街道可能以多种写法重复出现,显著增加数据匹配难度。
例如,Main 9 St、Main 9TH St. 和 Main 9th Street 指的是同一条街道,Washington Blvd 与 Washington Boulevard 也是如此。
用模糊算法处理这些差异并不高效。Washington Blvd 和 Washington Boulevard 之间需要改动多个字母,因此通过模糊匹配算法计算出的距离也会较大。
更合适的做法是标准化街道名称,通过统一格式确保数据一致性。
Datablist 支持英文街道名称格式的标准化,可统一处理缩写、街道编号等内容。
说明
街道名称标准化仅适用于已拆分的地址。街道名称必须存放在独立属性中。 完整地址值无法直接使用此功能。
在 “Clean” 菜单中点击 “Normalize Street Names”。
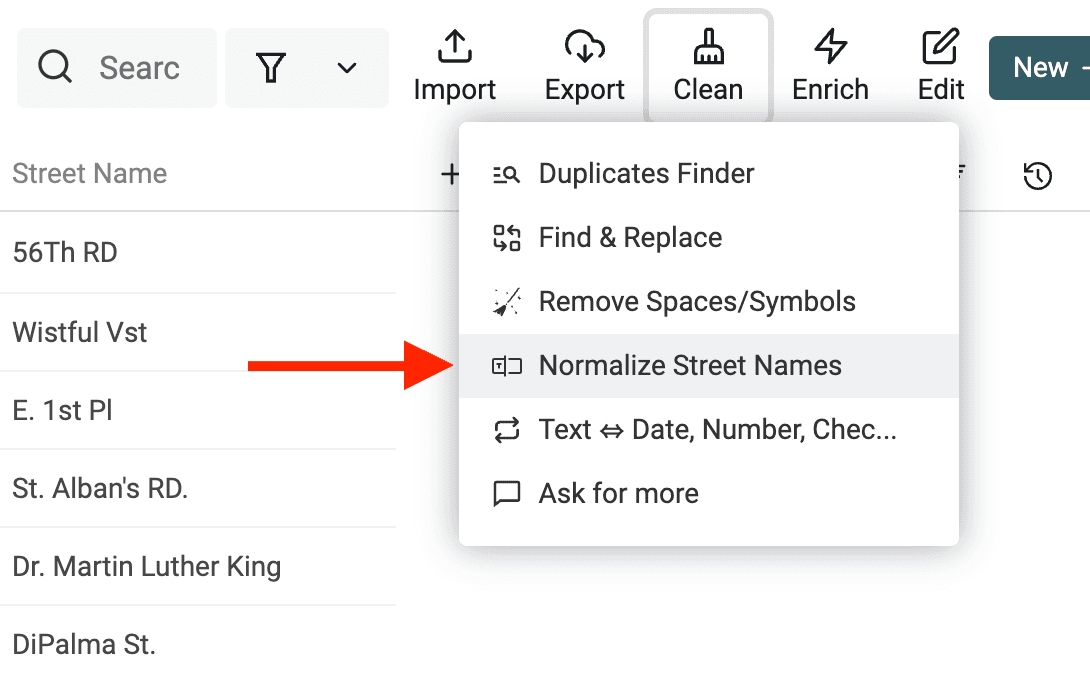
然后选择包含街道名称的属性,并点击 “Normalize english street names”。
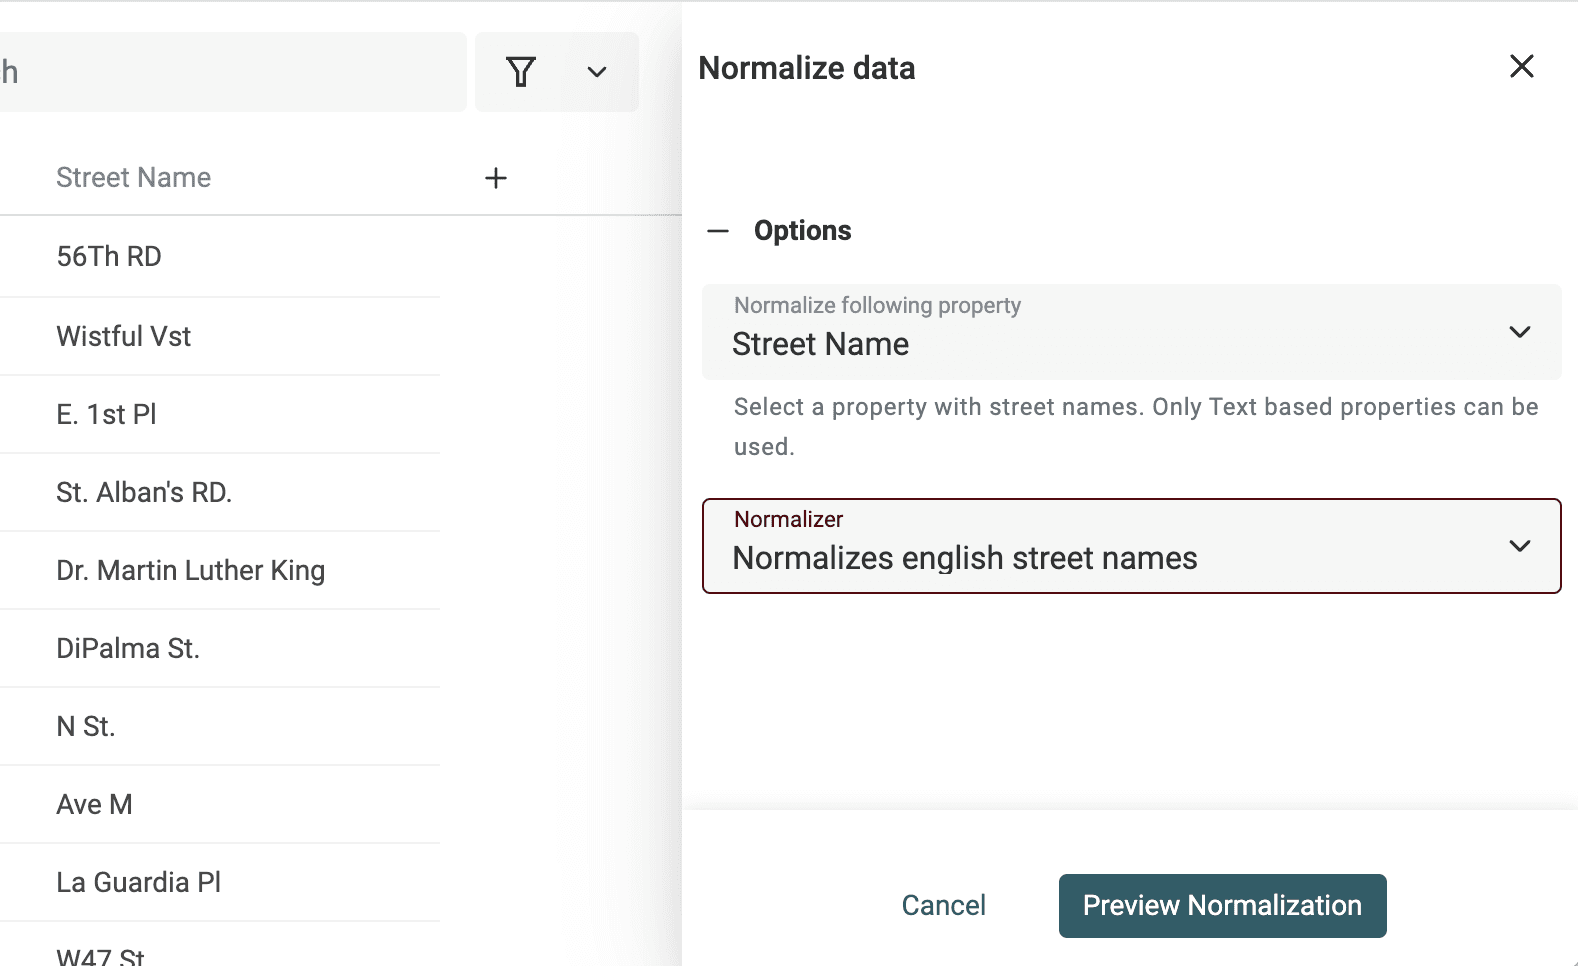
检查变更预览,然后点击 “Run”。
第 3 步:在单个或多个数据集中匹配记录
数据完成清洗和标准化后,就可以进入数据匹配阶段。这一步的目标是将相似记录归入同一组。
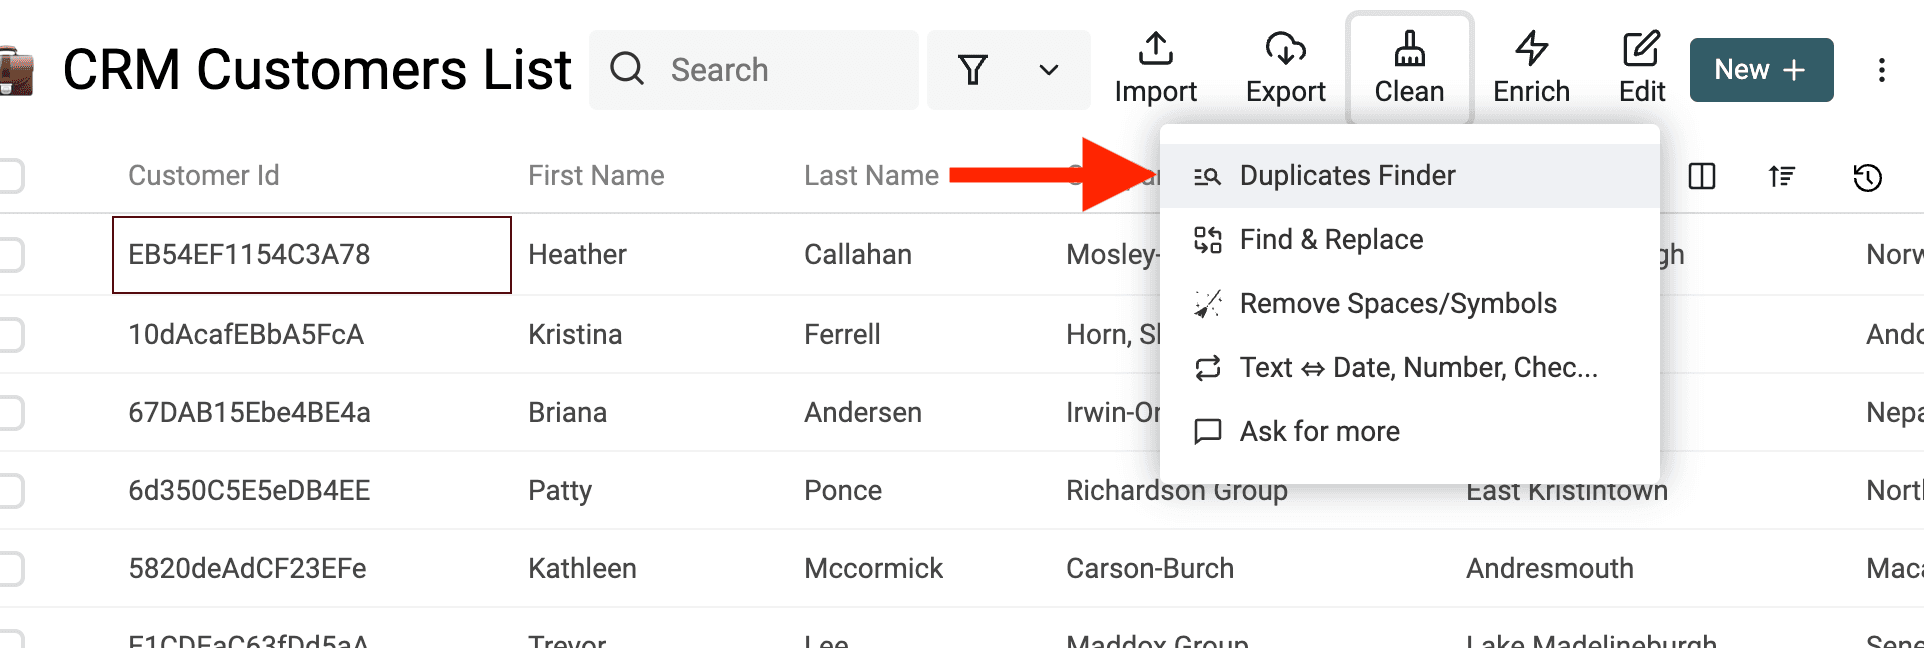
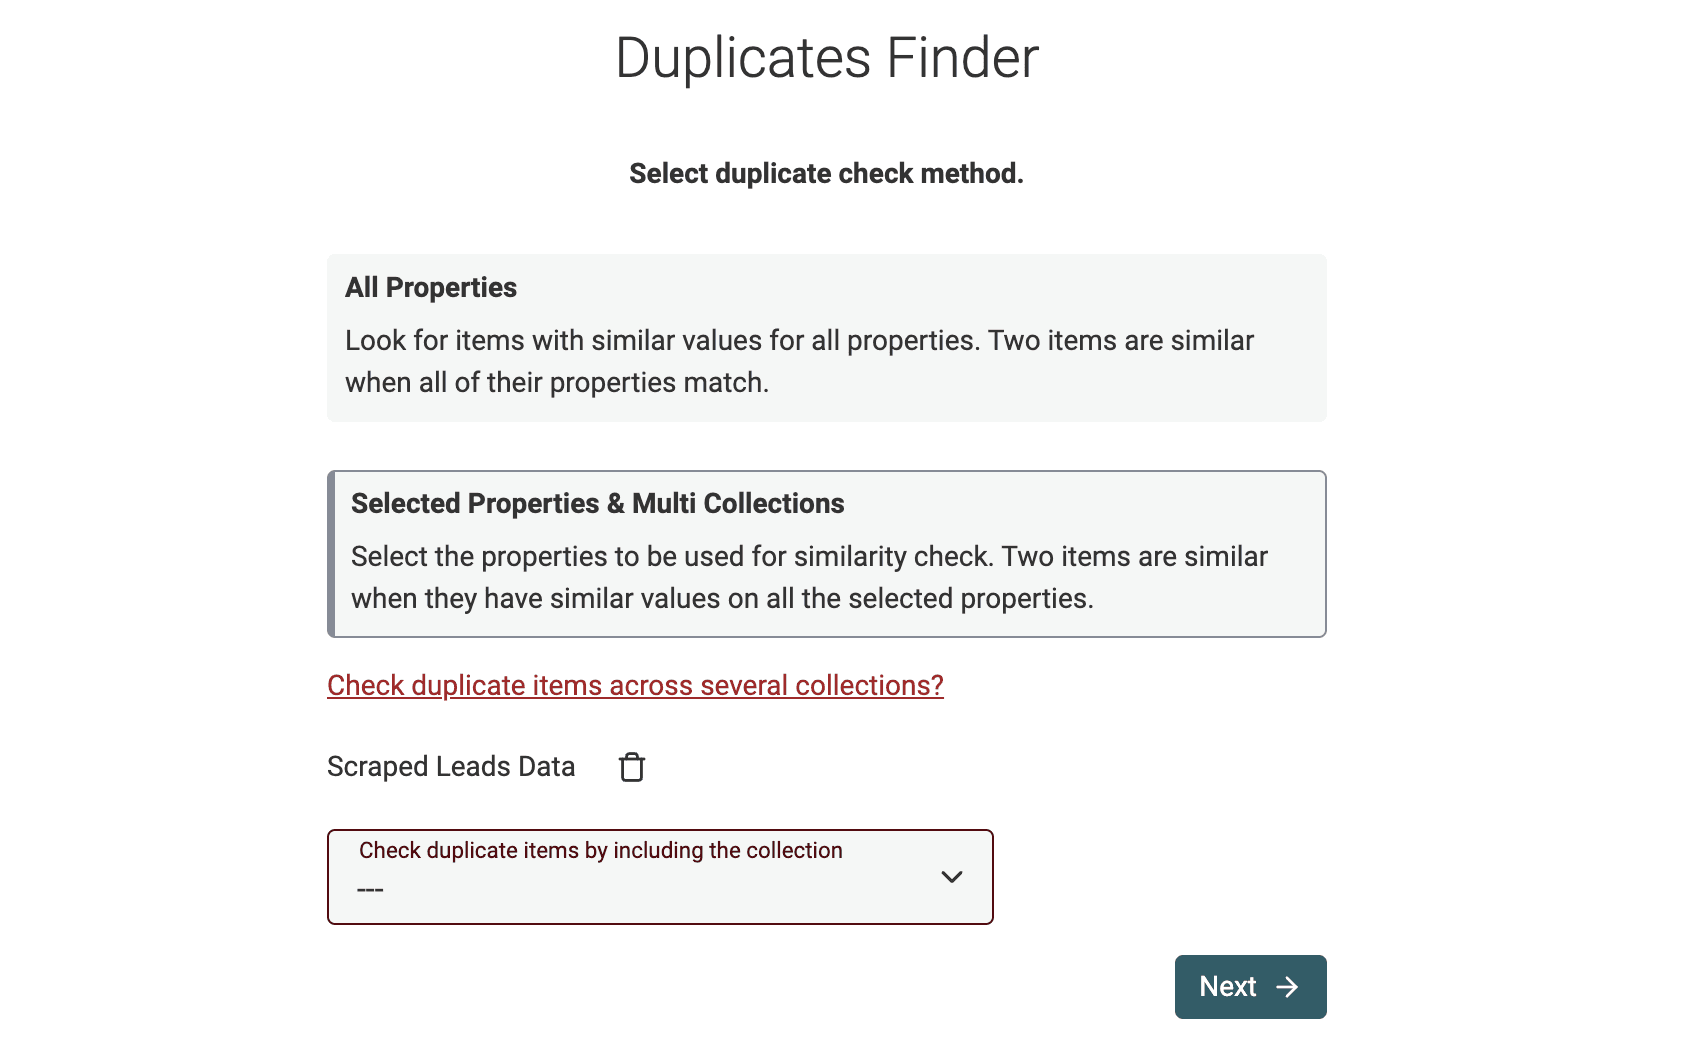
Datablist 提供三种起始模式:
- Selected Properties:比较一个 collection 中由你选择的字段。
- All Properties:比较一个 collection 中的完整记录。
- Match across collections:映射并比较多个 collection 中的属性。
如果两份 Lead 文件都包含 Email 和 Company,应优先映射邮箱属性。如果缺少邮箱,则比较公司名称,并尽可能增加网站或所在地字段。输出结果是一组候选匹配分组,并不代表名单已经完成可靠清洗。合并记录前,请打开几个分组并核对来源值。
选择用于匹配的属性
在本指南接下来的步骤中,我们使用 Match across collections。
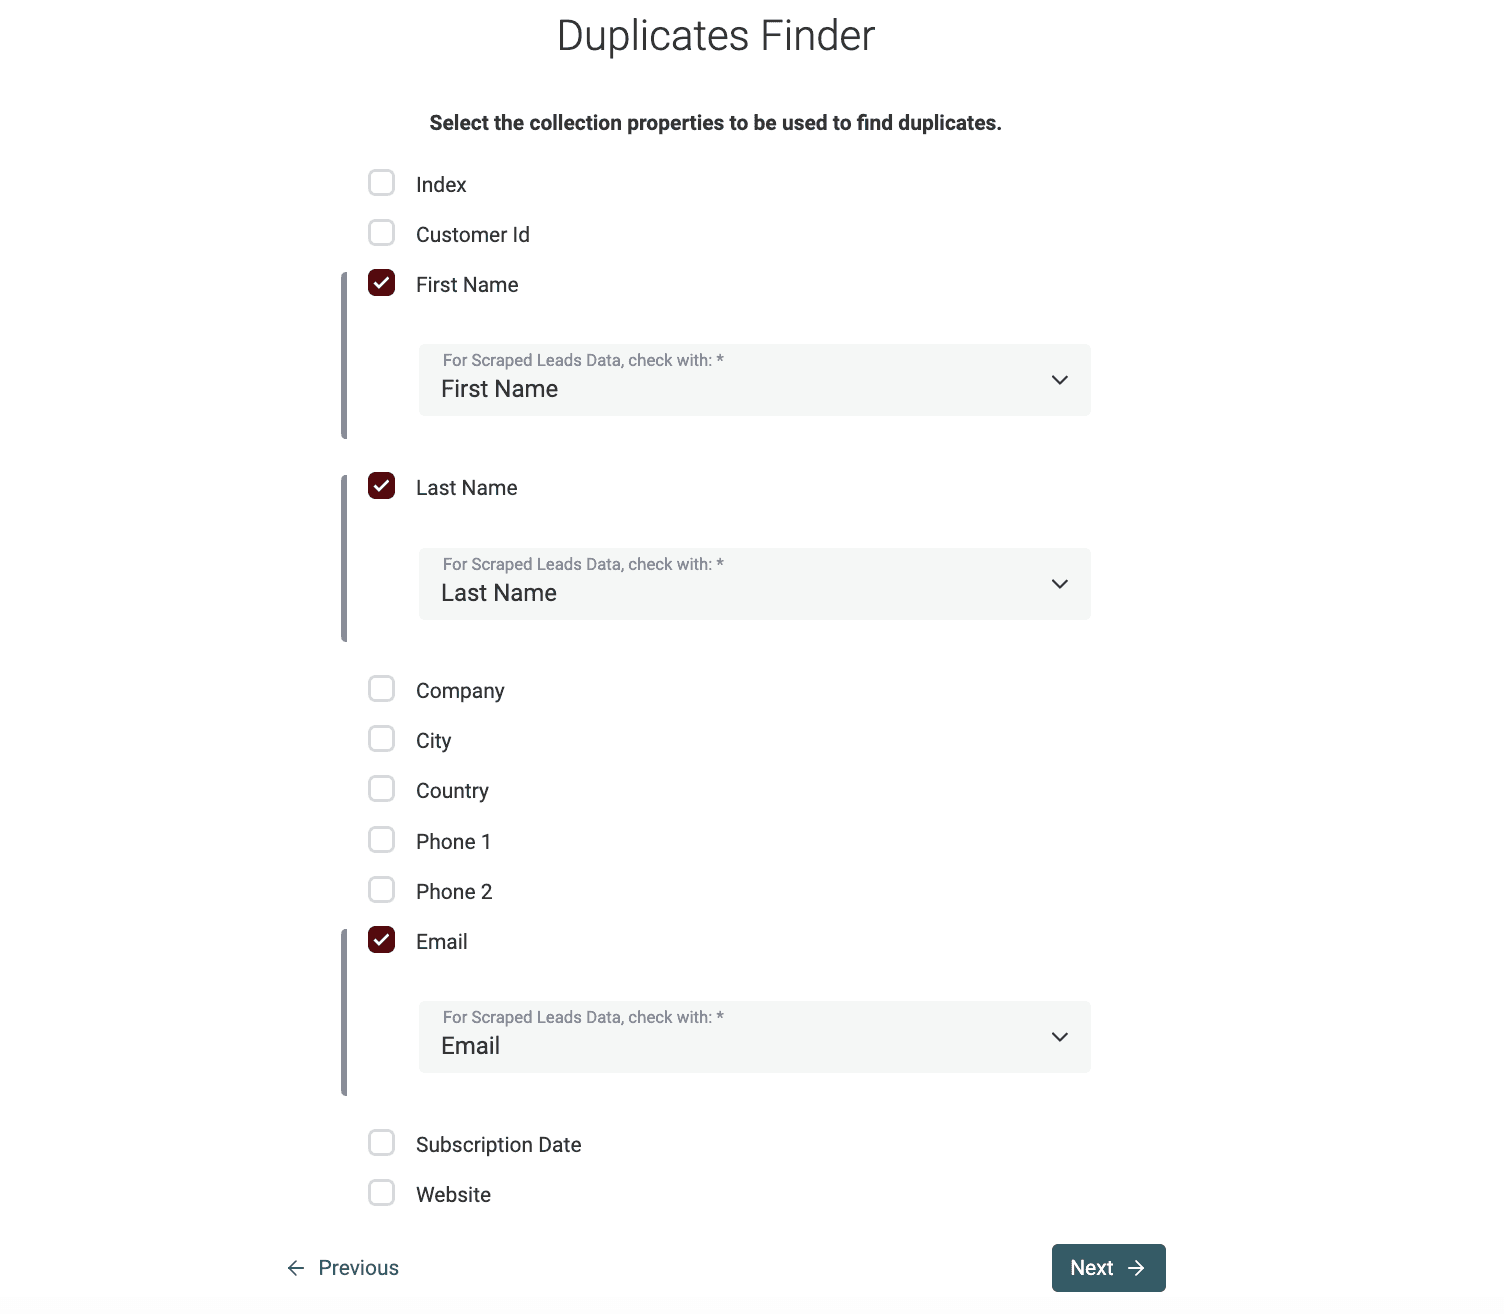
下一步是选择数据匹配所使用的属性。如果上一步选择了多个 collection,系统会要求你为每个 collection 选择一个对应的映射属性。
说明
Datablist 会尝试根据属性名称,在不同 collection 之间自动完成映射。
选择匹配算法
下一步会列出所选属性,你需要为它们配置比较算法。
Datablist 提供以下匹配算法:
-
Exact - 对于 DateTime、Number、Boolean 等非文本属性,建议使用 Exact 算法。应用于文本属性时,你可以选择比较是否区分大小写。Exact 算法还会删除文本首尾的空格。
-
Smart - Smart 算法会预处理数据项,以匹配存在细微差异的数据。它能匹配使用不同协议的 URL,也能处理词序和标点差异。例如,“John-Doe” 和 “Doe John” 可以成功匹配。
-
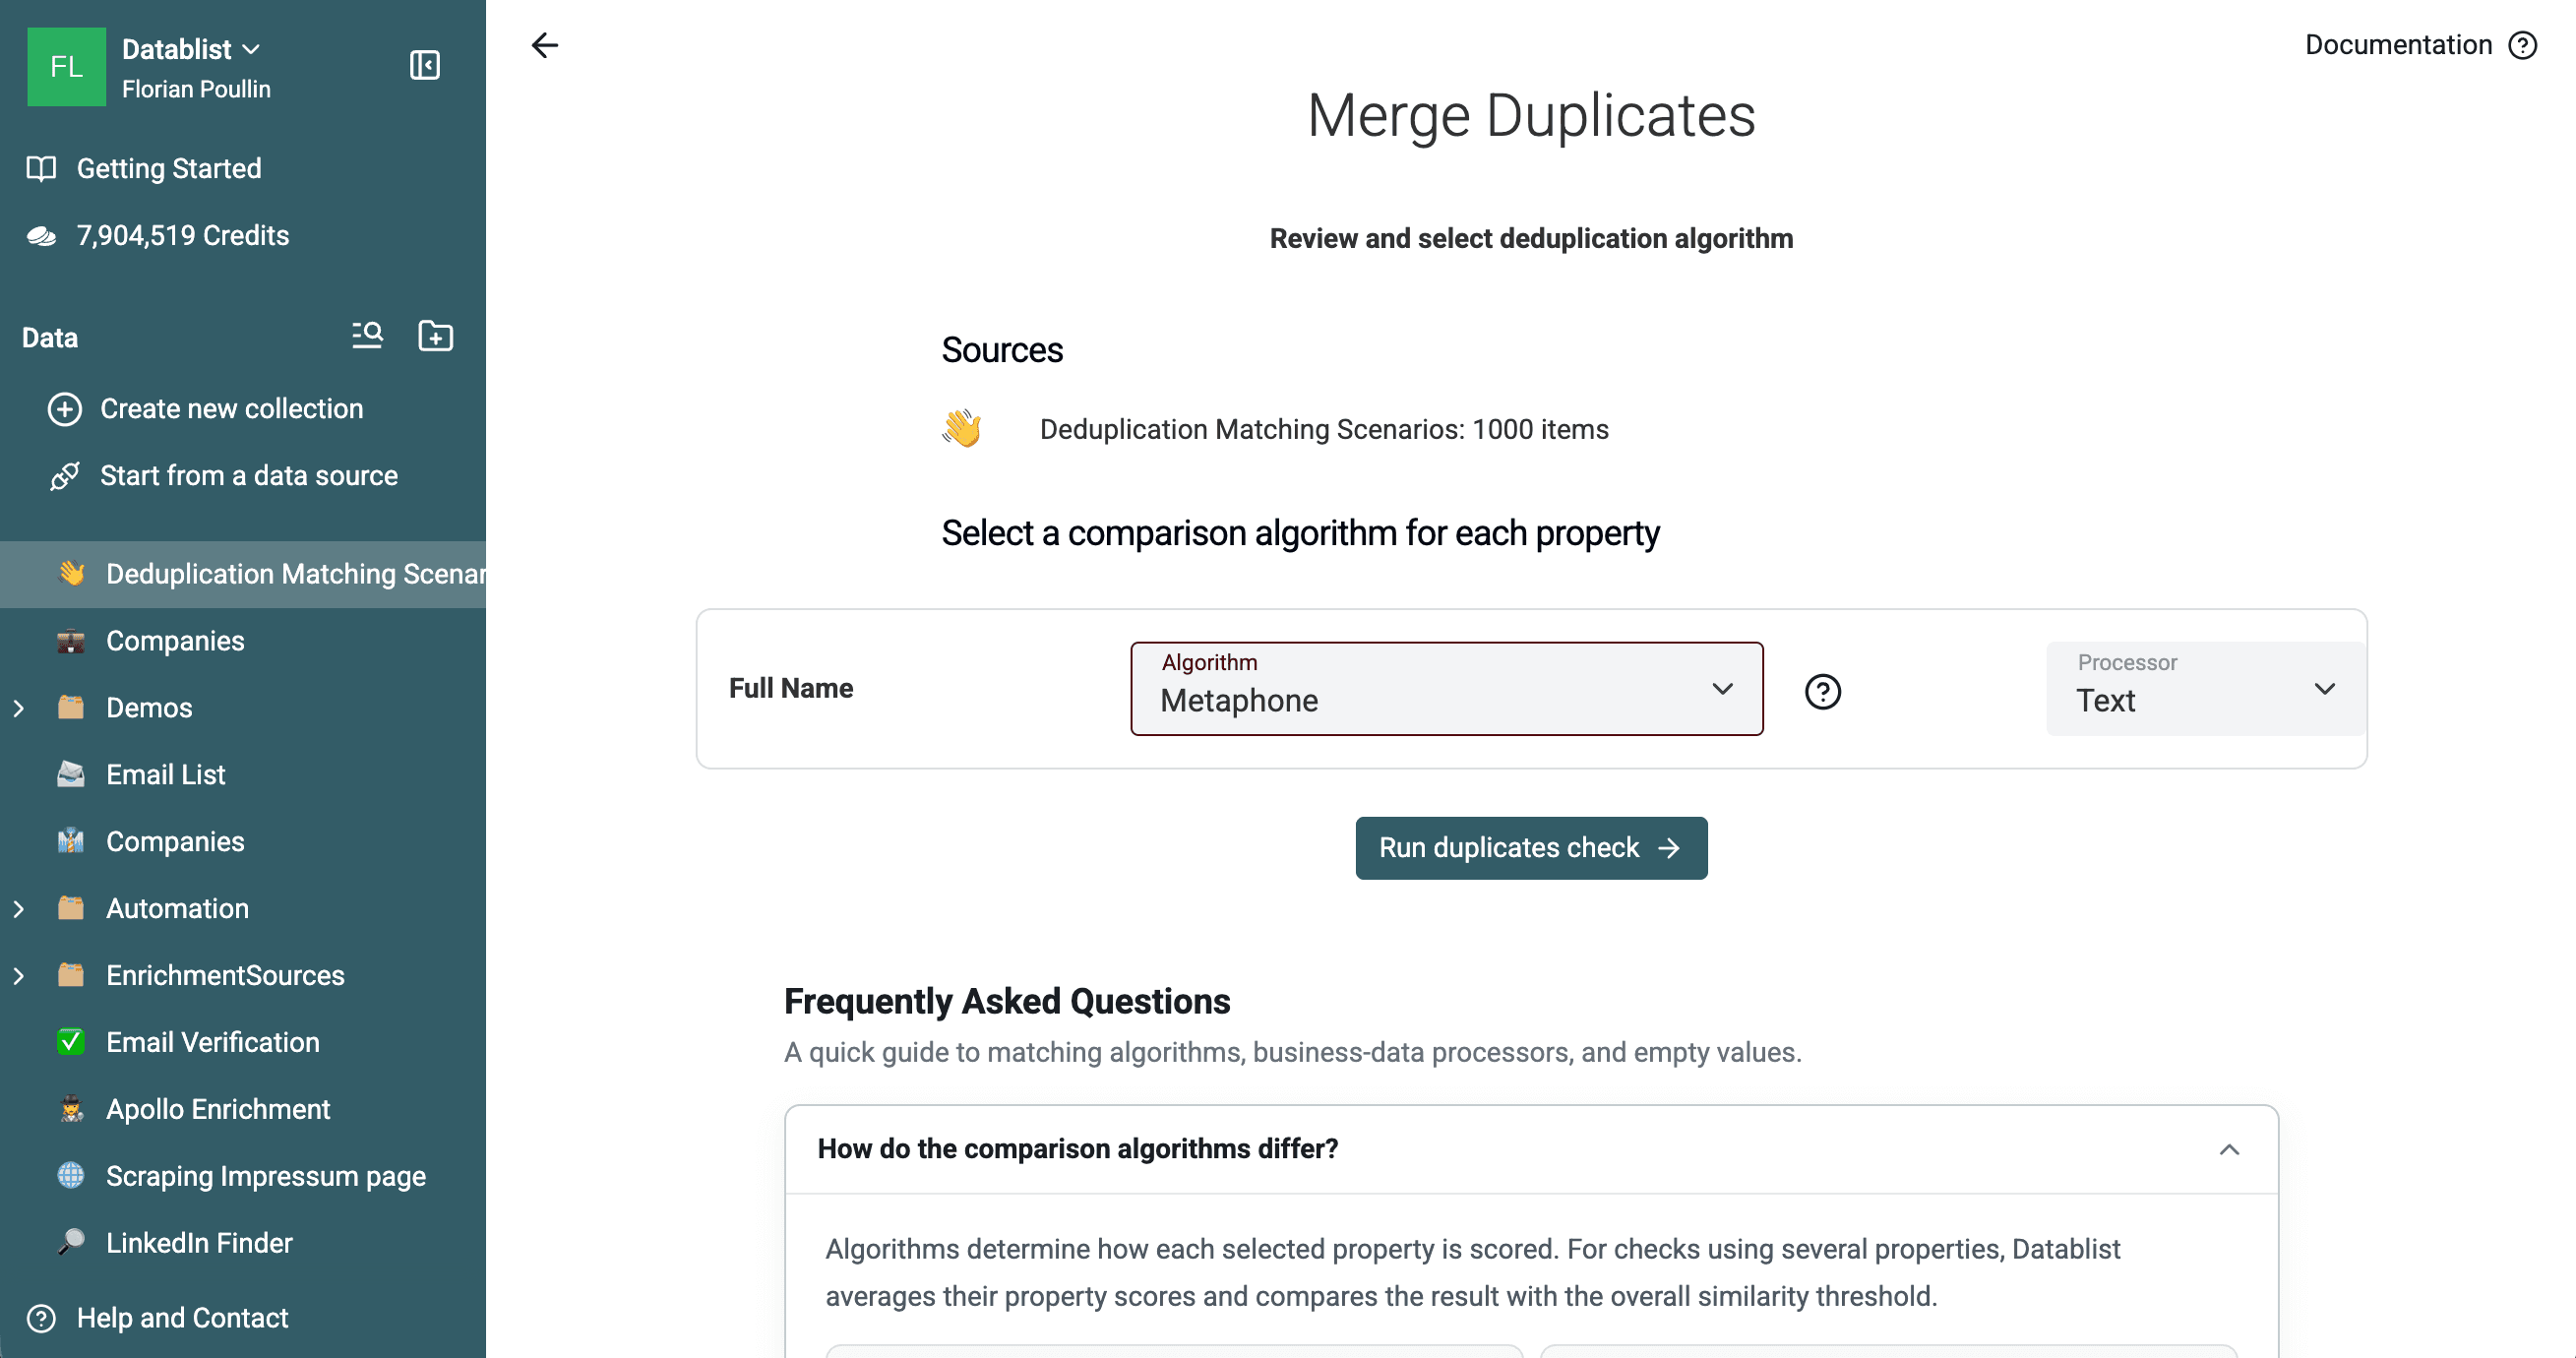
使用 Double Metaphone 算法进行语音匹配 - Datablist 使用 Double Metaphone 算法实现语音匹配。该算法会将单词转换成代表其发音的代码,发音相近的两个单词将获得相同的 Double Metaphone 代码。
-
使用距离算法进行模糊匹配 - Datablist 还支持基于 Jaro-Winkler 和 Levenshtein 距离的模糊匹配。选择后必须设置相似度阈值。阈值越高,允许的差异越小。
如需进一步了解匹配算法,请查看我们的文档。
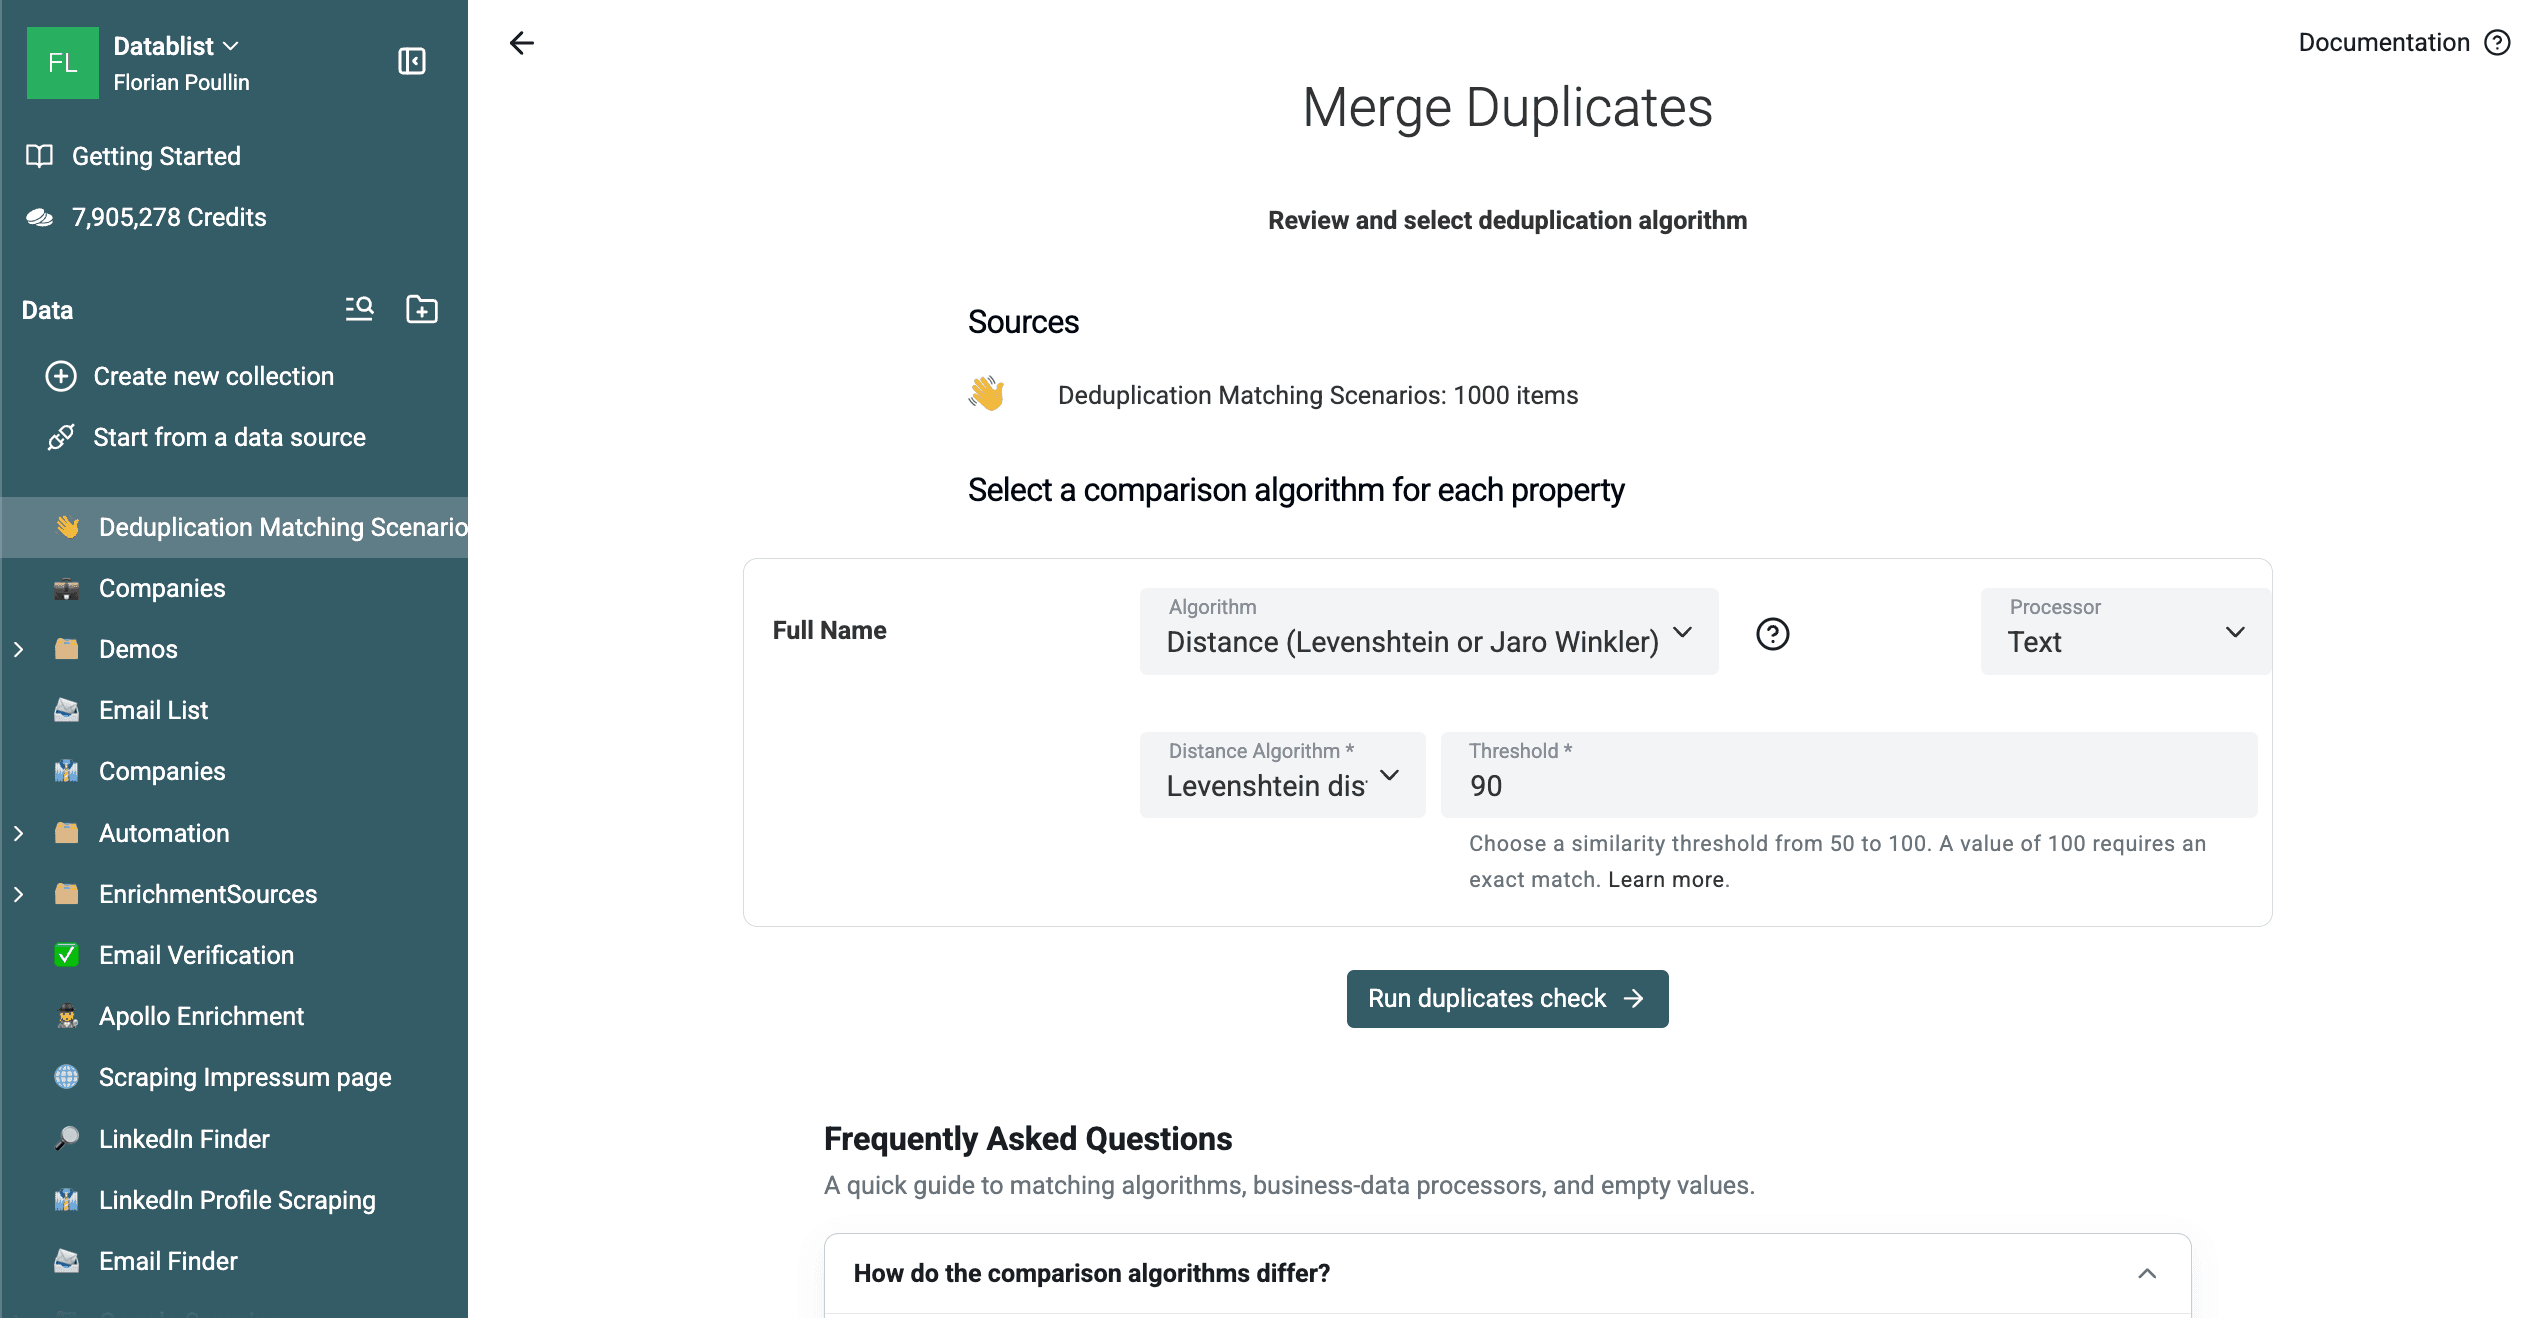
在包含 1,000 行的去重样本中,这套 Full Name 配置生成了 77 个双记录分组。与基准真值核验后发现,其中 21 组属于同一预设实体,另外 56 组则错误关联了不同实体。大多数误报来自简短且完全相同的缩写,例如 G. Rossi。
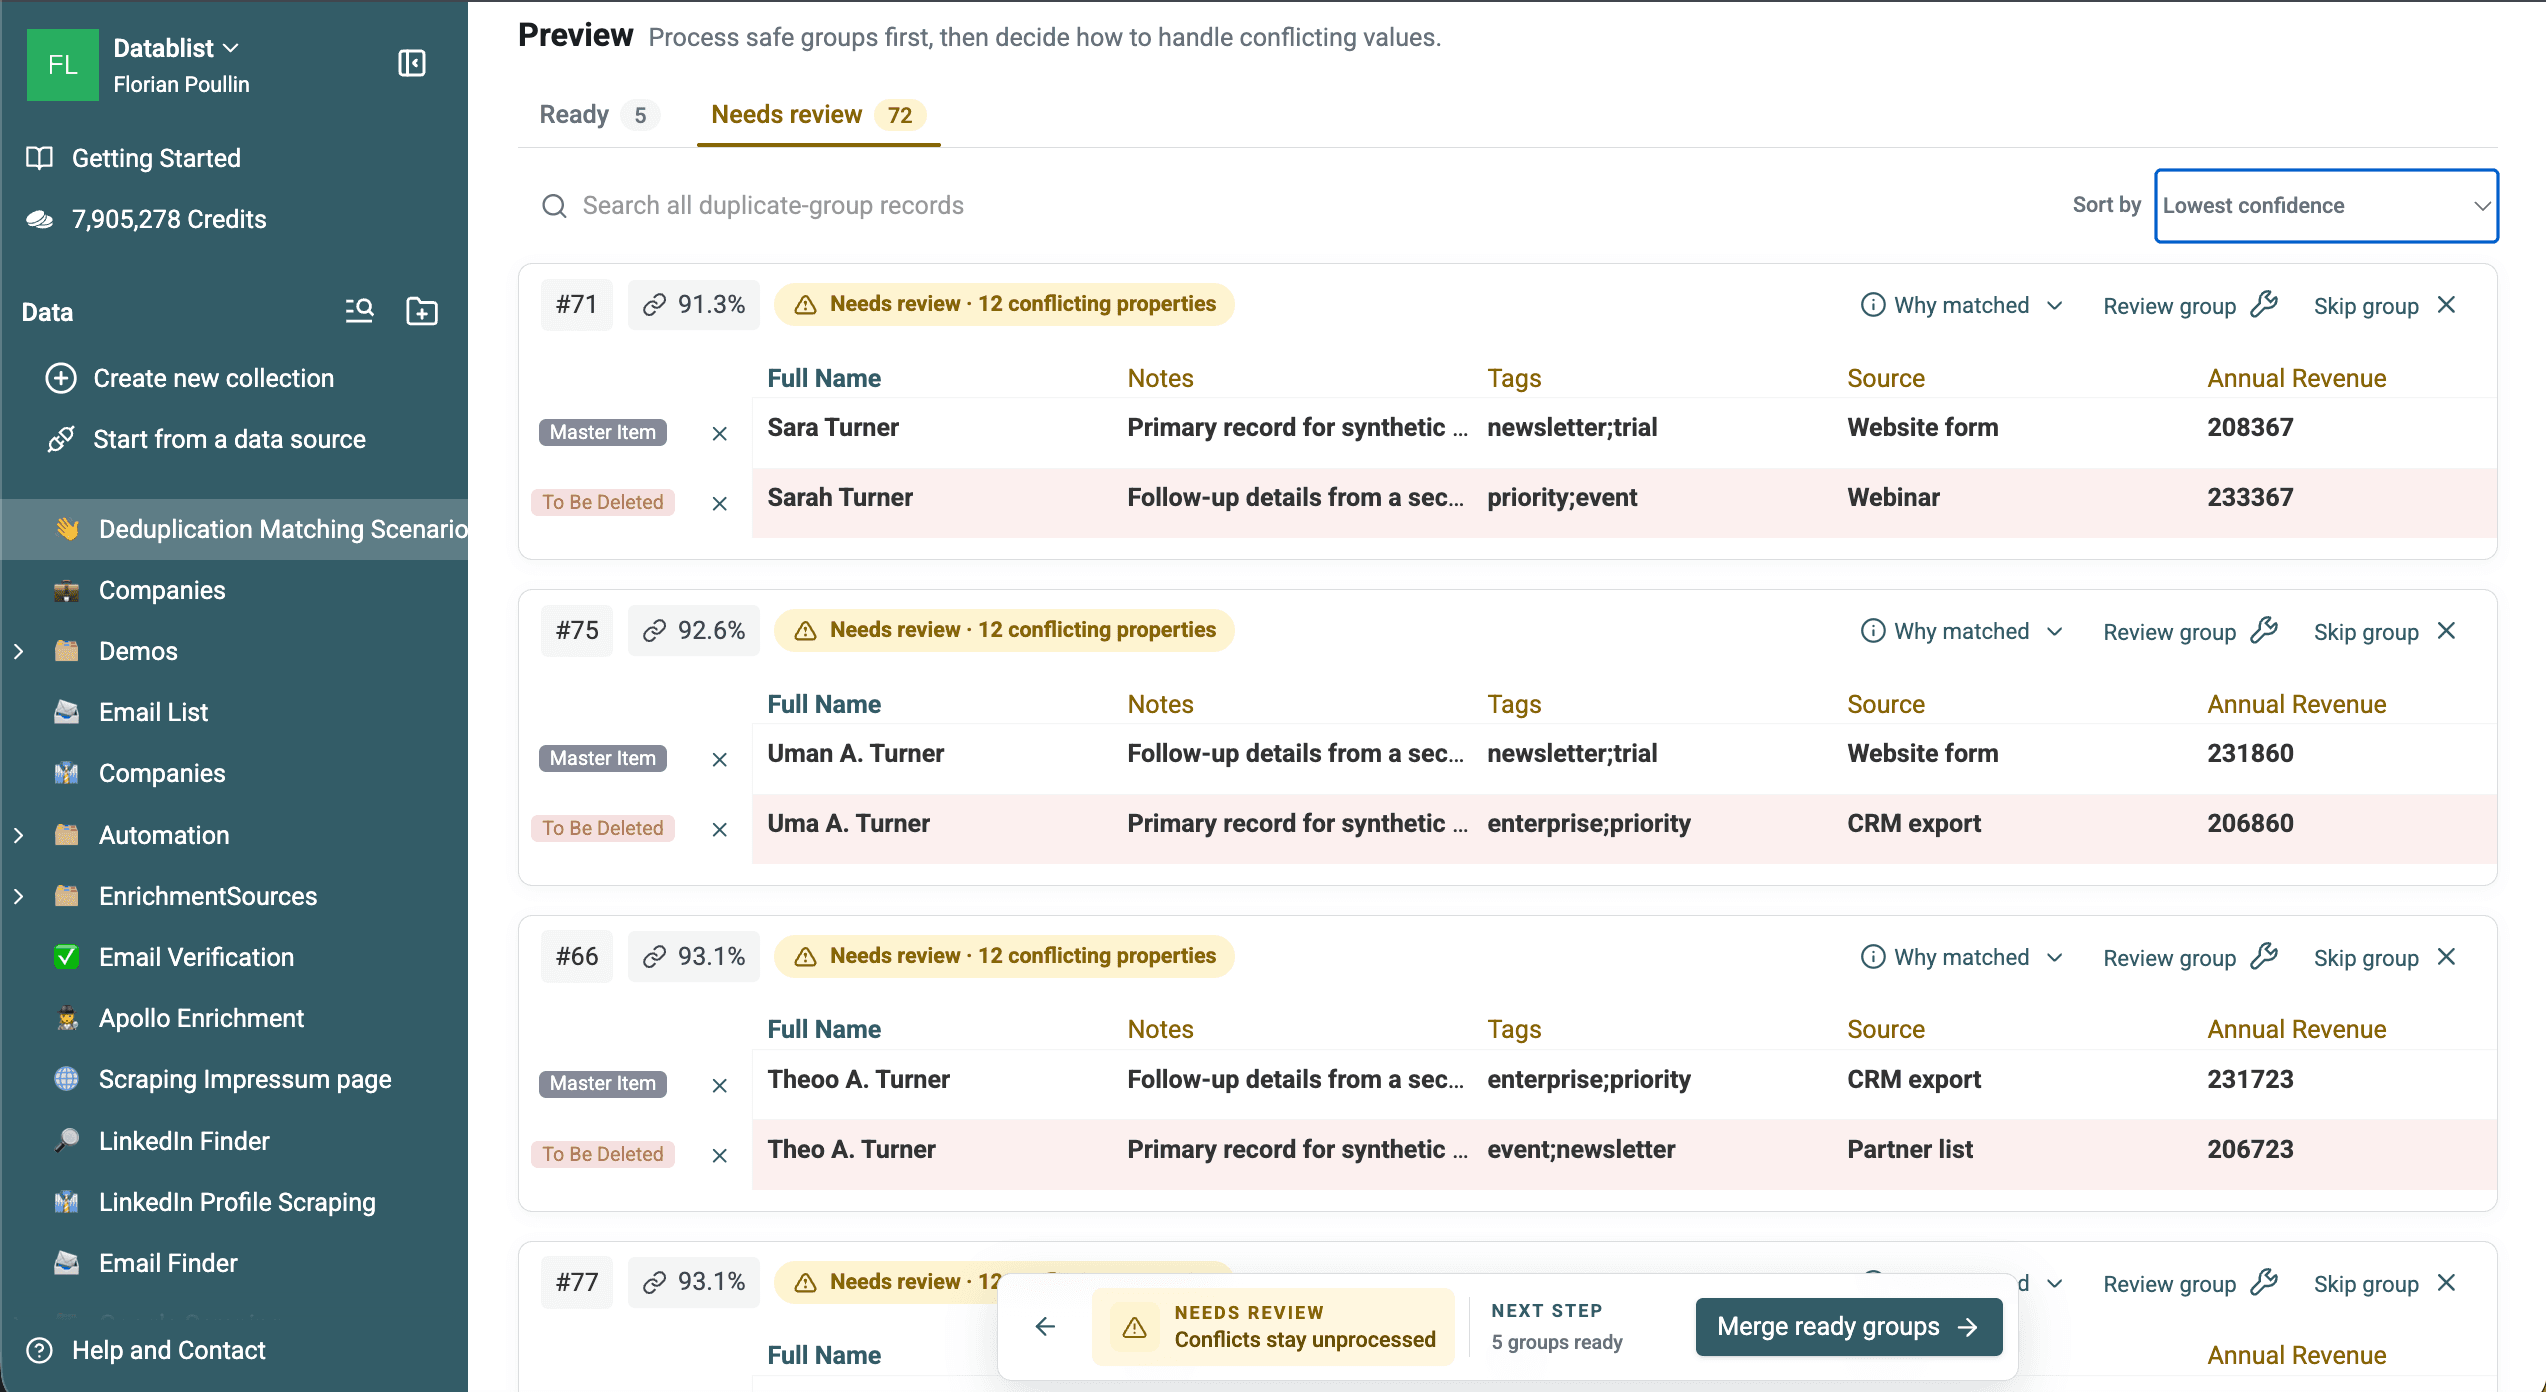
处理含义不明确的姓名匹配前,请使用邮箱、电话号码、公司或网站等第二标识符进行核验。你可以下载导出的 77 个分组并检查结果。
在同一个样本中,当 Full Name 使用 Metaphone 和 Text processor 时,共返回 69 个分组,涉及 188 行记录。与基准真值核验后发现,只有 19 个分组完全由同一实体组成,另有 50 个分组混入了不同人员。
结果中出现了多个姓氏相同、名字使用缩写的大型分组。语音相似度适合用来发现候选项,但并不能证明两行记录属于同一个人。
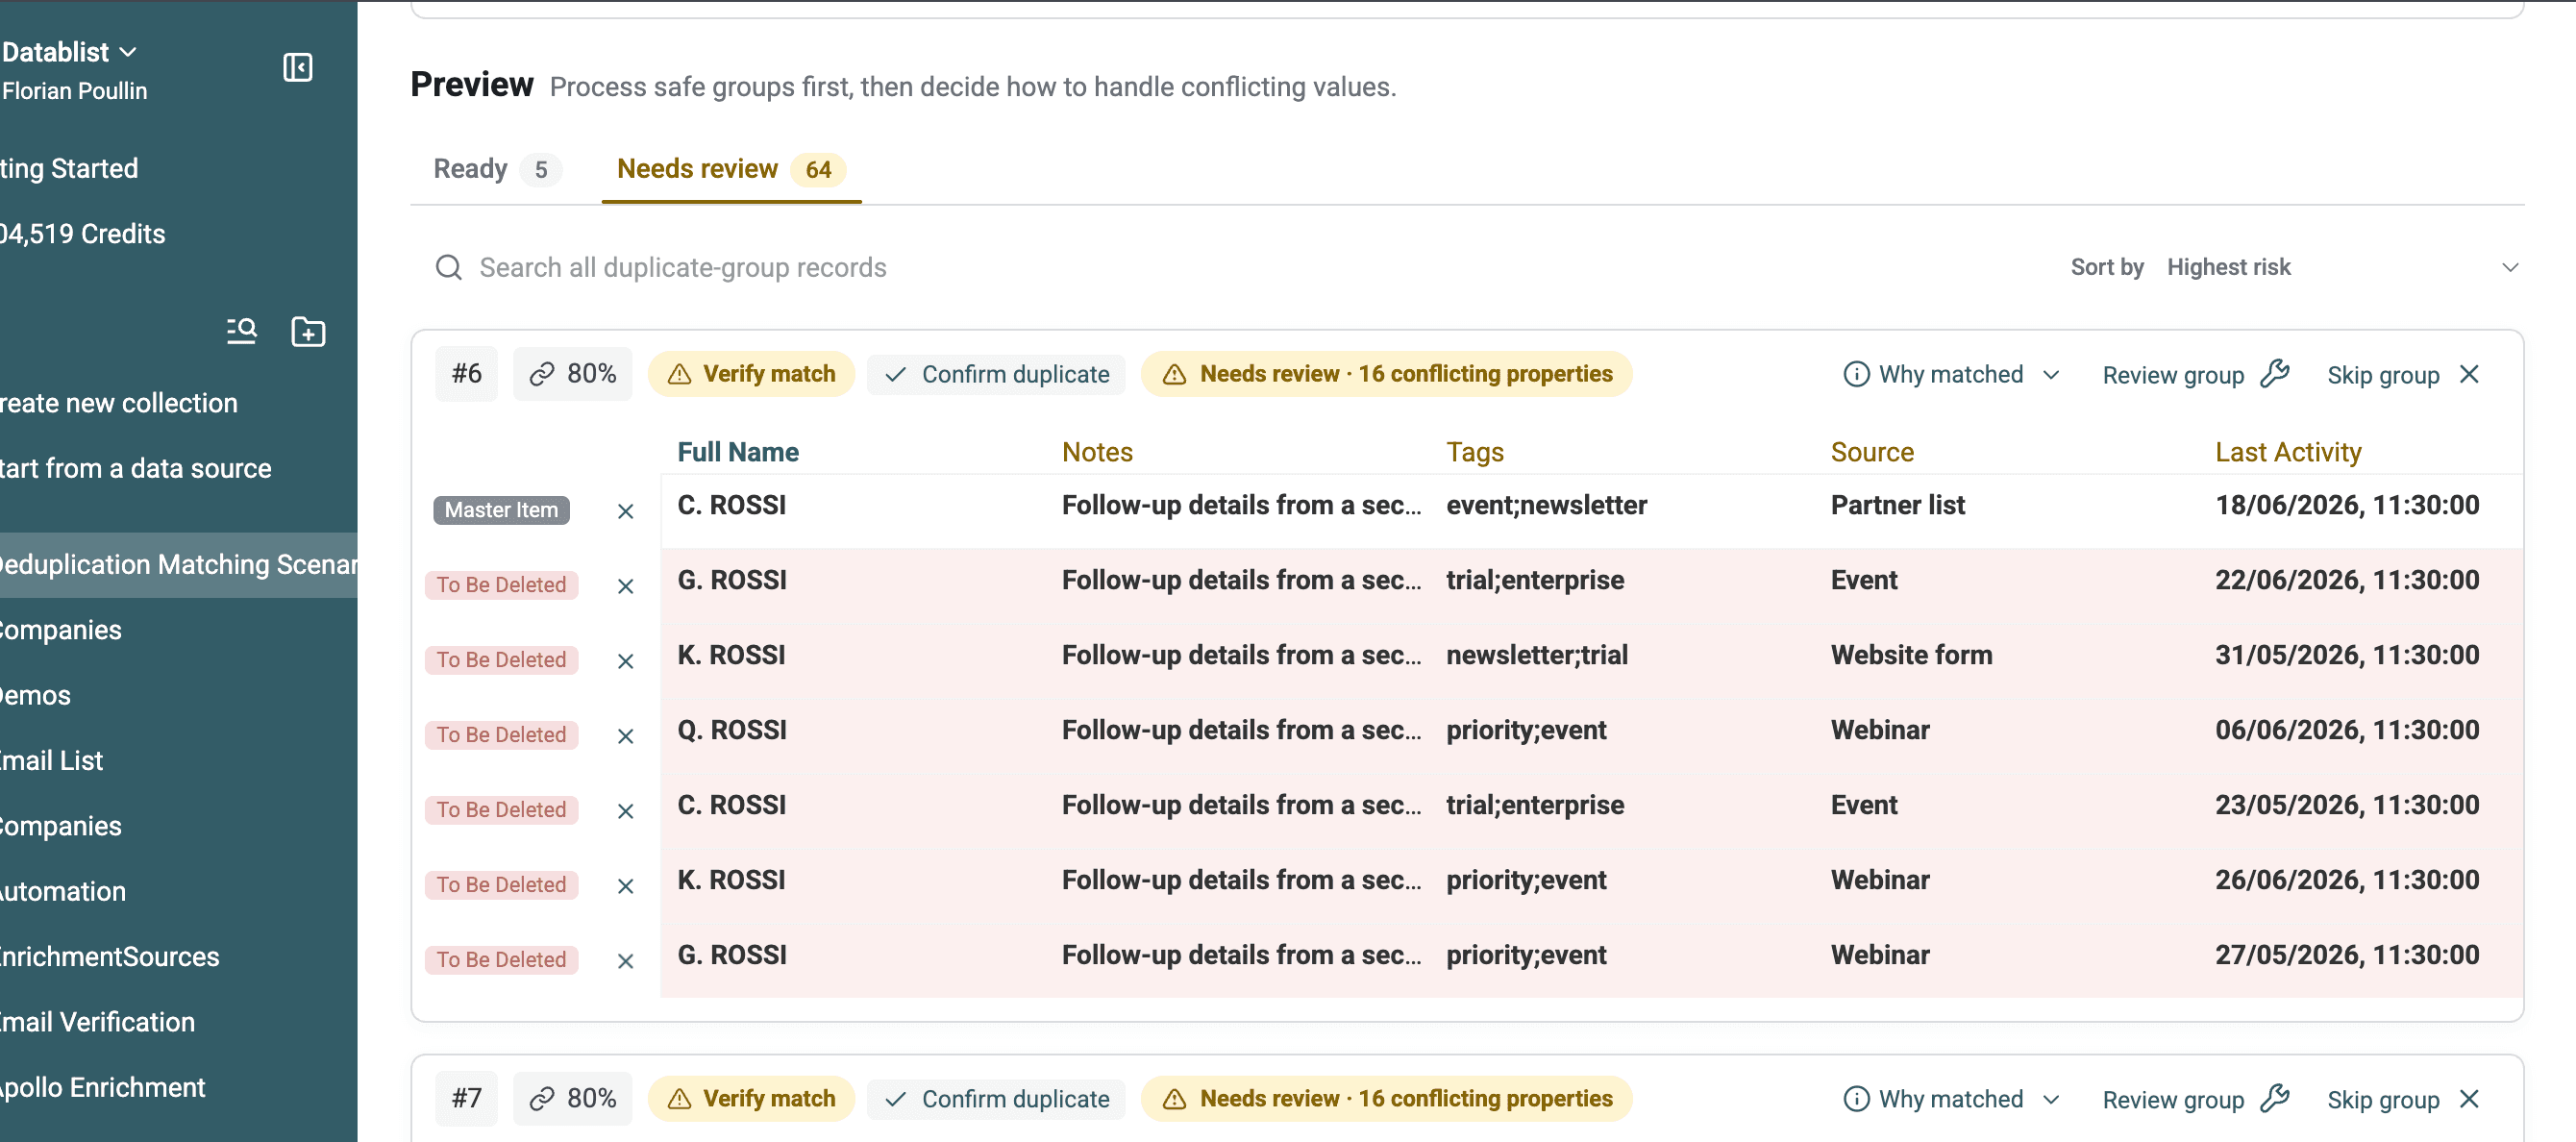
下载导出的 69 个 Metaphone 分组,即可审核每组包含 2 至 7 行的记录,并对比有效匹配和误报。
说明
- Smart、Phonetic 和 fuzzy 算法仅适用于文本类属性,包括 Email、Text、LongText。
- URL 属性仅兼容 Exact 和 Smart 算法。
第 4 步:数据去重,删除或合并匹配分组
Datablist 的 Duplicates Finder 会返回匹配分组供你审核。结果页面会说明每组记录匹配的原因,并将 Ready 分组与需要人工审核的候选分组分开显示。
单个 collection 去重时自动合并
对于单个 collection,请选择 Merge and preserve data。Datablist 会填充空属性,并应用你设置的冲突处理规则和 Record to keep 规则。
说明:
请注意,此功能仅适用于单个 collection 的去重。在多个 collection 之间去重时,各 collection 的数据结构可能不同。
无数据冲突时自动合并
当合并结果明确且不存在未解决的要求时,Datablist 会将该分组标记为 Ready。
具体规则如下:
- 如果所有重复项的属性值都相同,则只保留一条记录,删除其余记录。
- 如果重复项的数据可以互补,系统会选择信息最完整的记录作为主记录,并使用其他记录的属性值补全它,然后删除主记录以外的所有记录。
- 如果值存在冲突,请配置处理规则,或将该分组保留在 Needs review 状态。
解决数据冲突后自动合并
运行 Auto-Merging 算法时,Datablist 的 Duplicates Finder 会自动检测存在冲突的属性。如果两条记录在同一个属性上具有不同值,即视为冲突。要合并这些记录,你需要选择以下处理方式:
- Combine:使用选定的分隔符拼接不同的文本值。
- Keep the selected record's value:保留所选记录的值,并舍弃其他值。
- 付费版的字段保留规则可针对每个属性选择最新、最早、最长、最短、最高、最低或出现频率最高的值。
多 collection 数据匹配的清洗规则
使用 Datablist Data Matching 工具处理多个数据集时,无法使用自动合并功能,因为各 collection 可能包含不同的属性和数据结构。
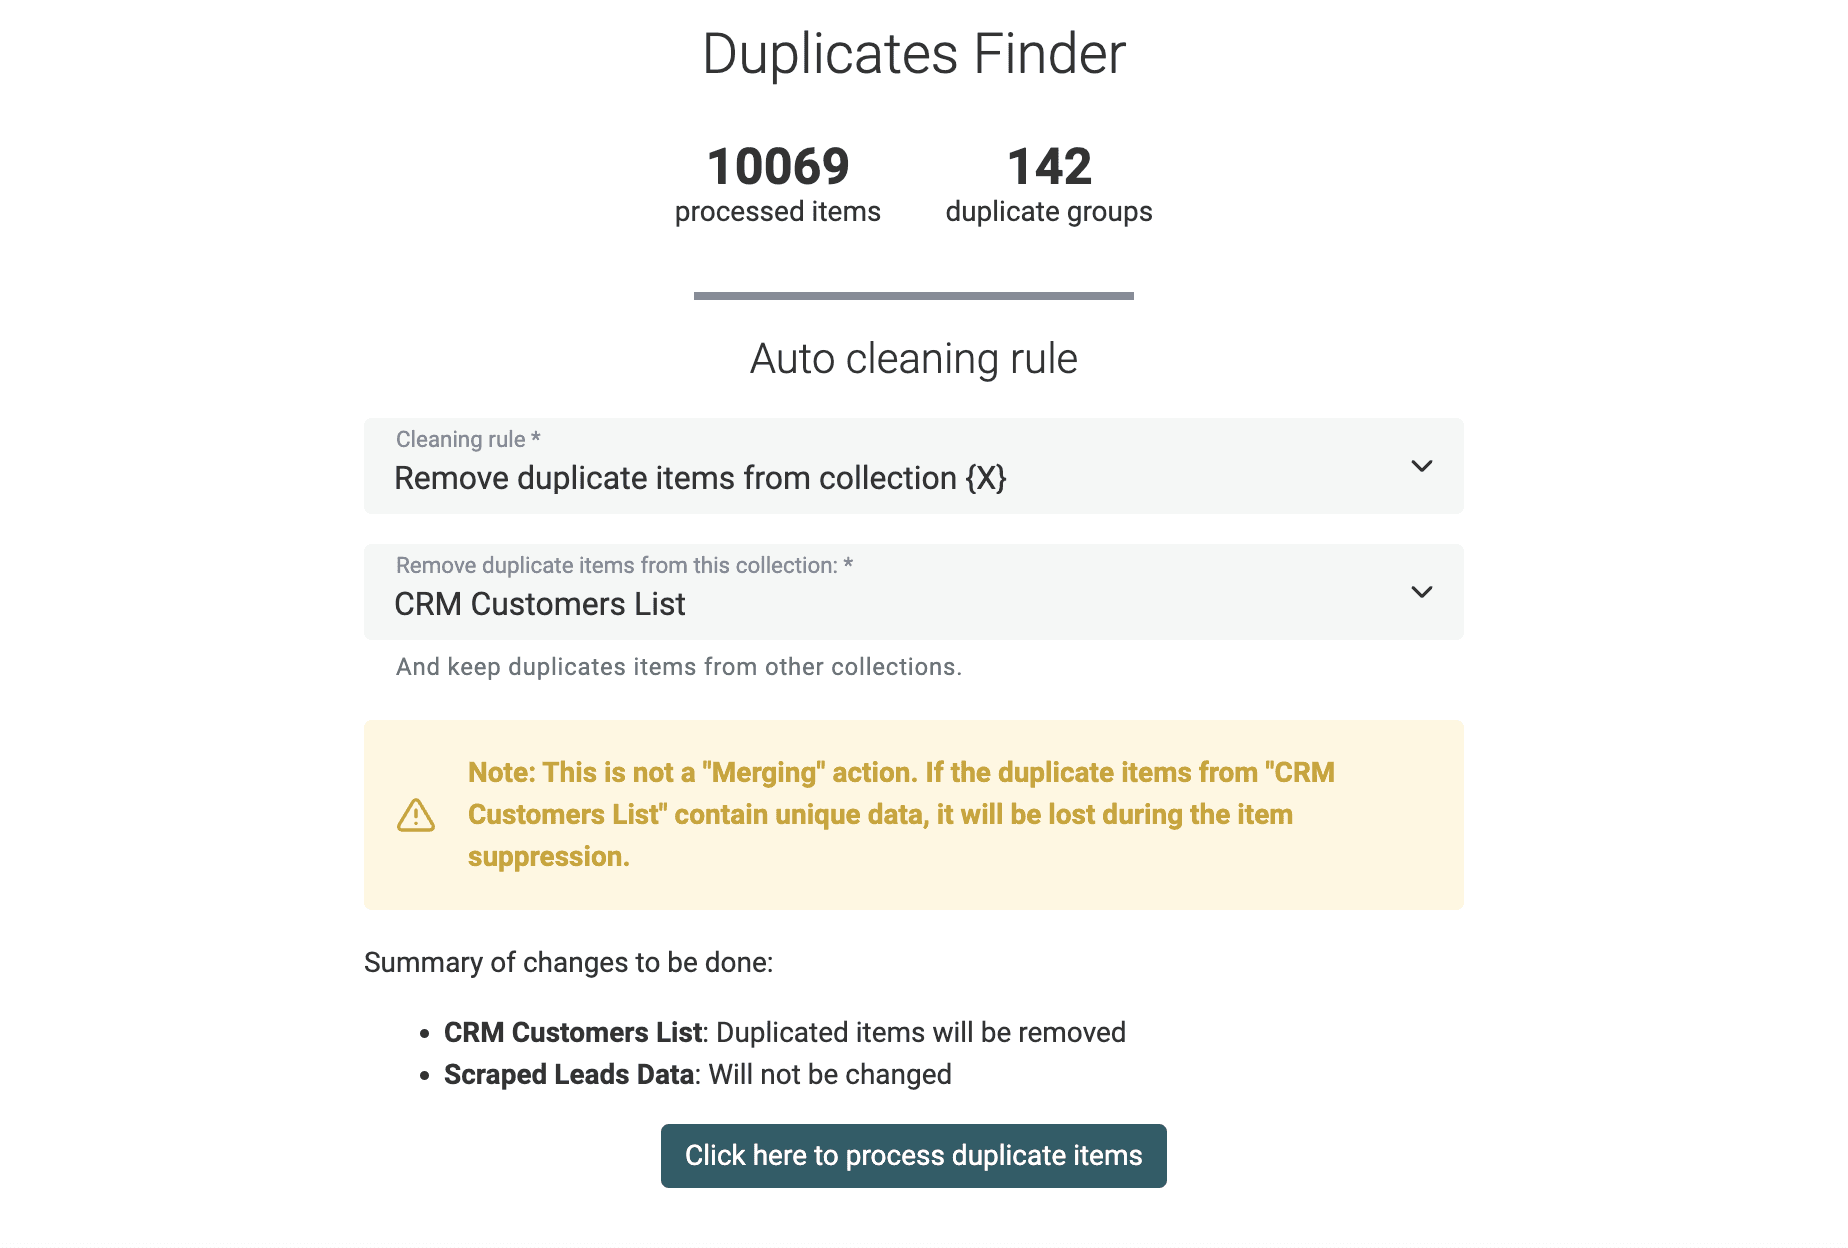
Datablist 会改为提供一项清洗功能:只在一个 collection 中保留重复项,并从其他所有 collection 中删除这些重复记录。你可以利用这项工具确保不同数据集之间的记录具有唯一性。
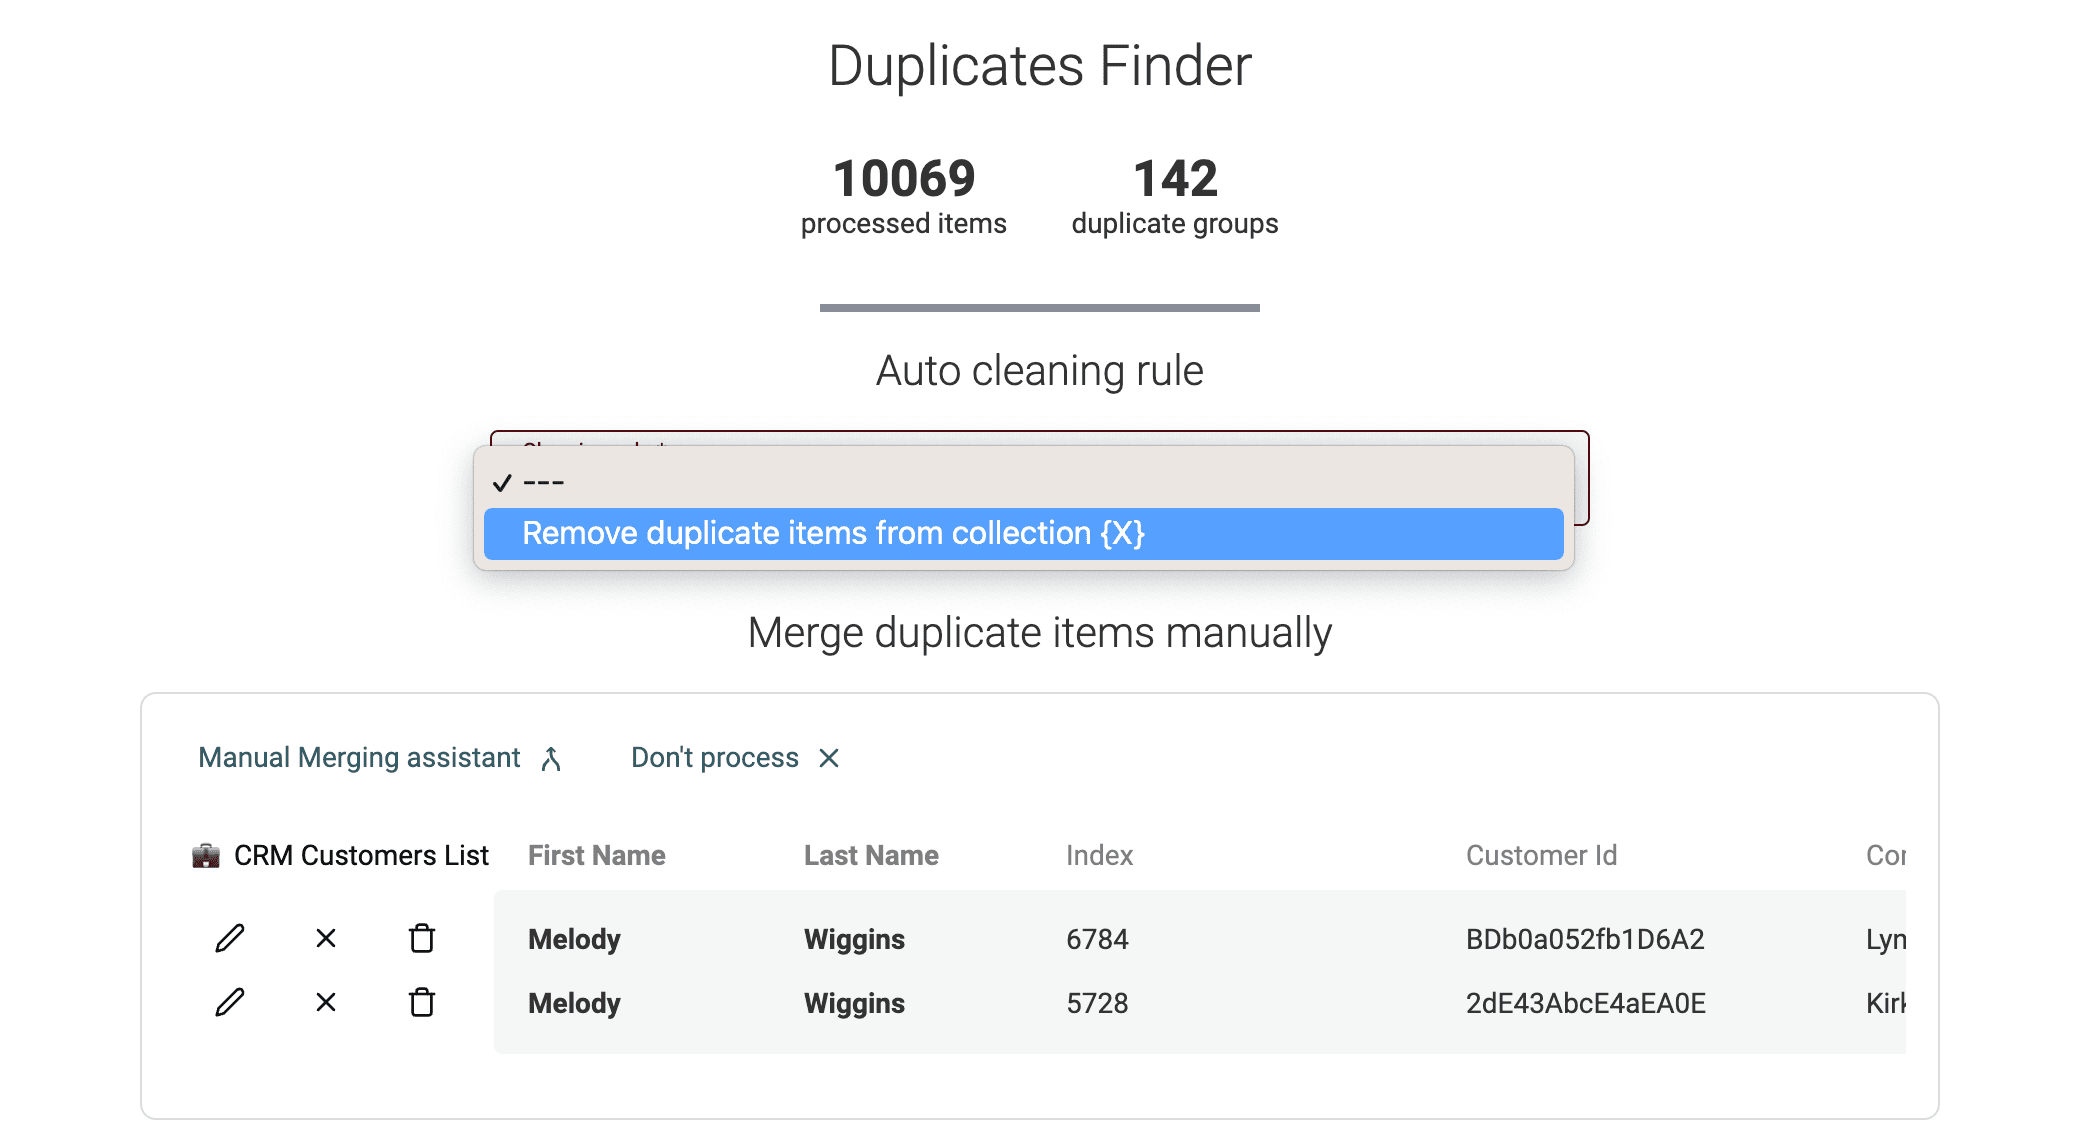
运行清洗算法前,系统会显示待执行变更的预览。
使用 Merging Assistant 手动合并
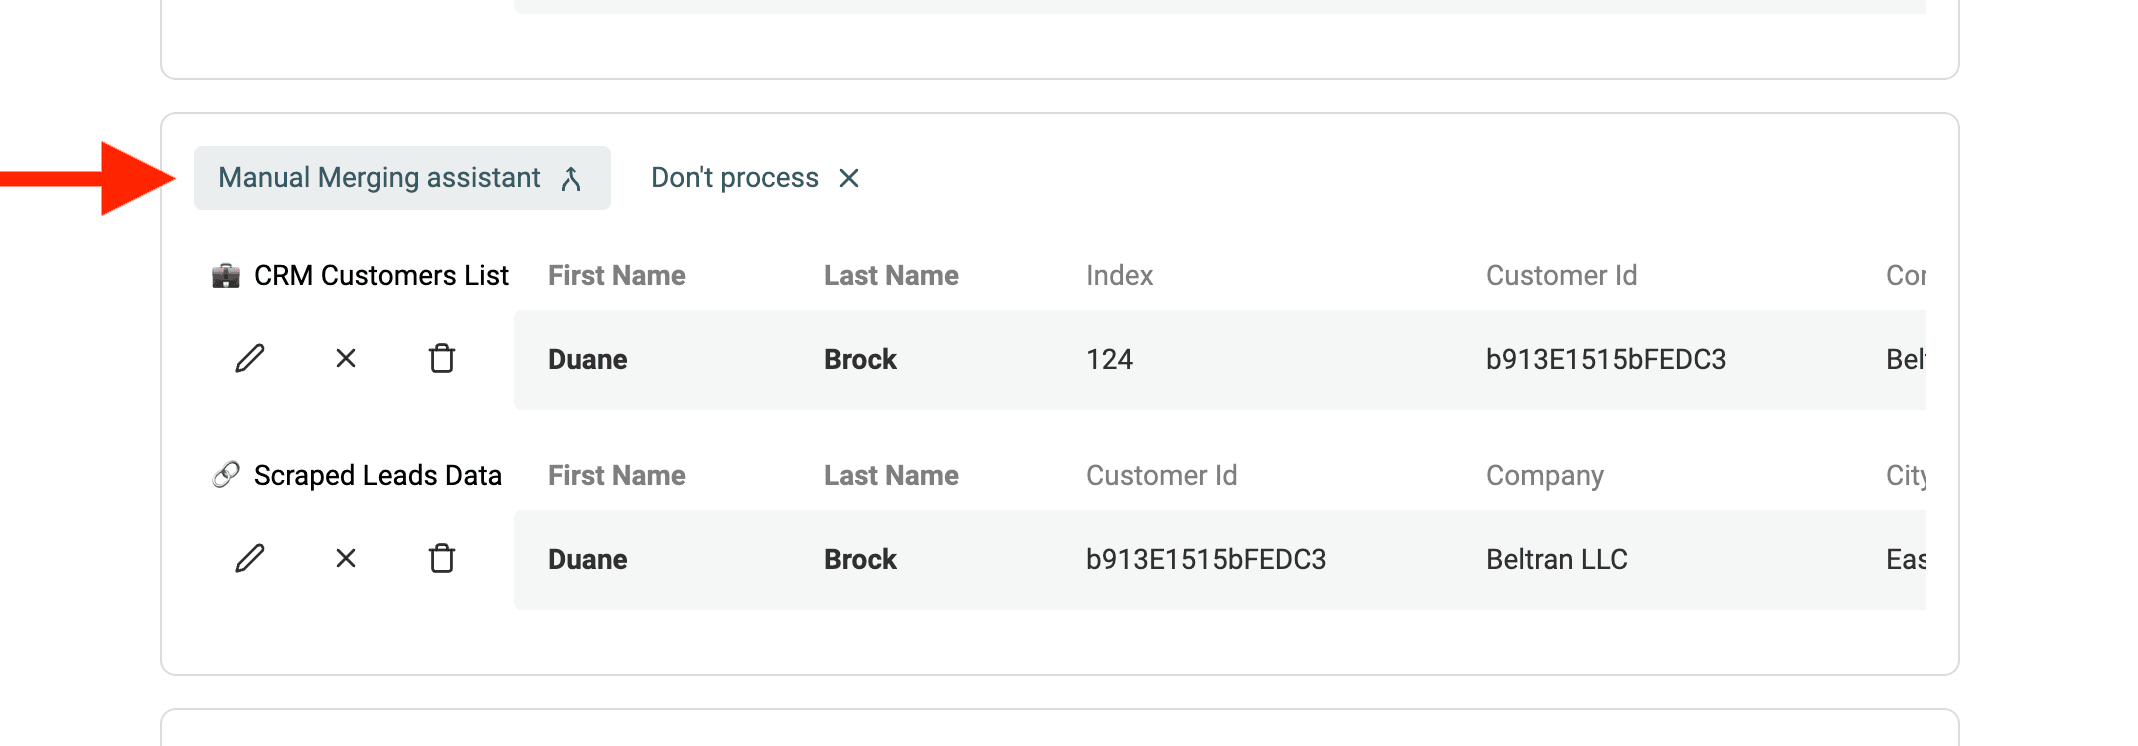
对于剩余的重复记录,可以使用手动合并助手。
点击 Review group,然后打开 Manual Merging Assistant。
系统会打开合并工具。右侧显示 “Primary Item”,左侧其余重复项则称为 “Secondary Items”。 Datablist 会选择数据最完整的记录作为 “Primary Item”。
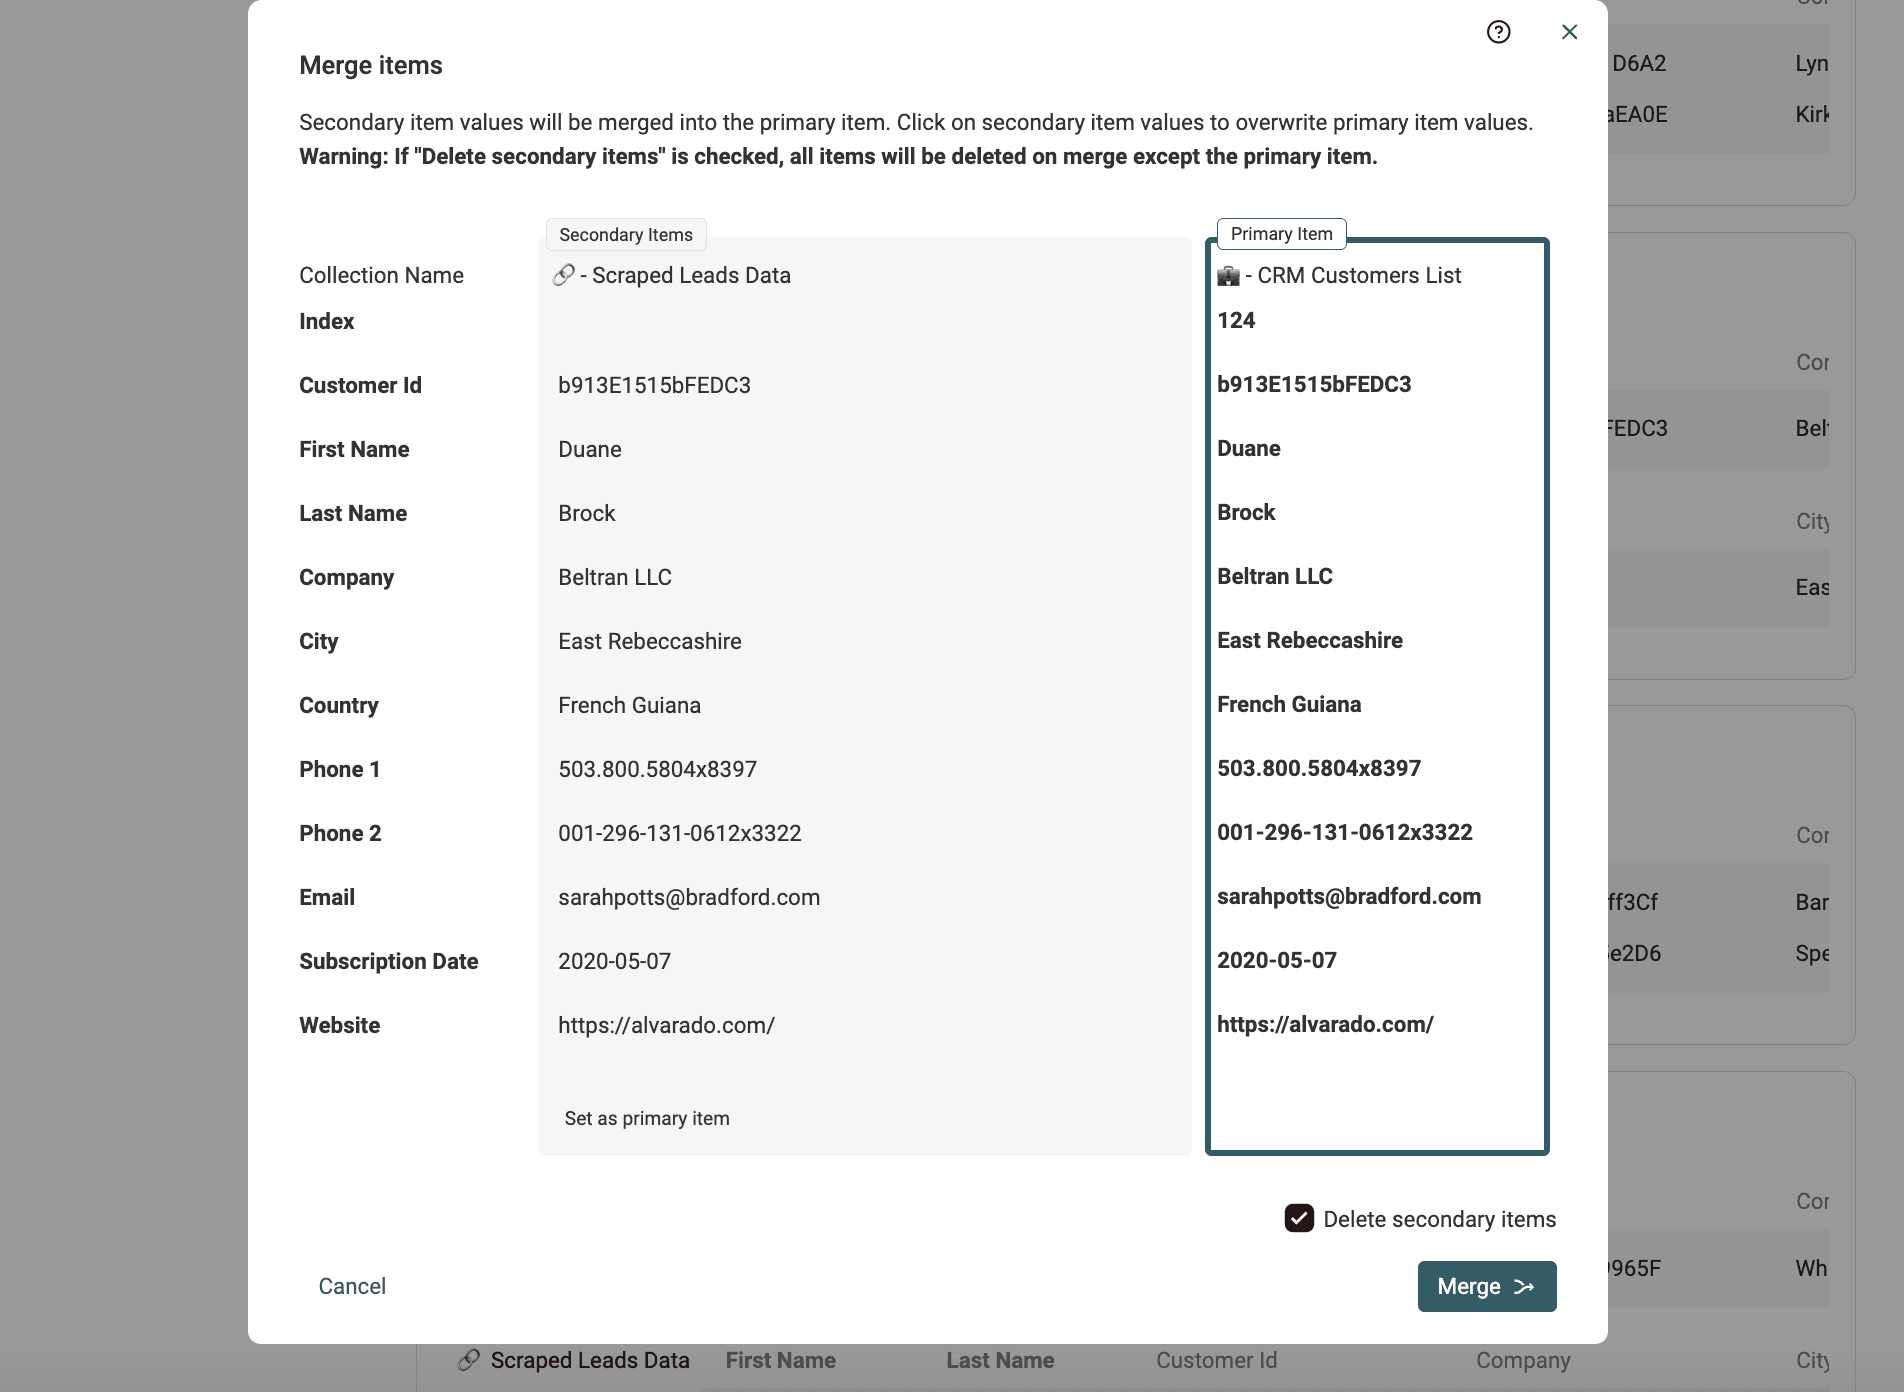
在条件允许时,系统会自动选择 Secondary Items 中的属性值,并将其合并到 Primary Item。如果多个值存在冲突,则需要由你决定保留哪个值。
如果合并后的 “Primary Item” 符合要求,请点击 Merge 按钮确认。系统会删除所有 Secondary Items,仅保留一条合并后的记录。
说明 当多个 collection 具有相似的数据结构,即包含相同属性时,也可以在跨 collection 去重过程中使用 Manual Merging Assistant。
下载重复分组并使用外部工具合并
最后,Datablist Data Matching 工具还支持导出检测到的重复分组。你可以导出 CSV 或 Excel 文件,其中同一组内的所有重复项会连续排列。
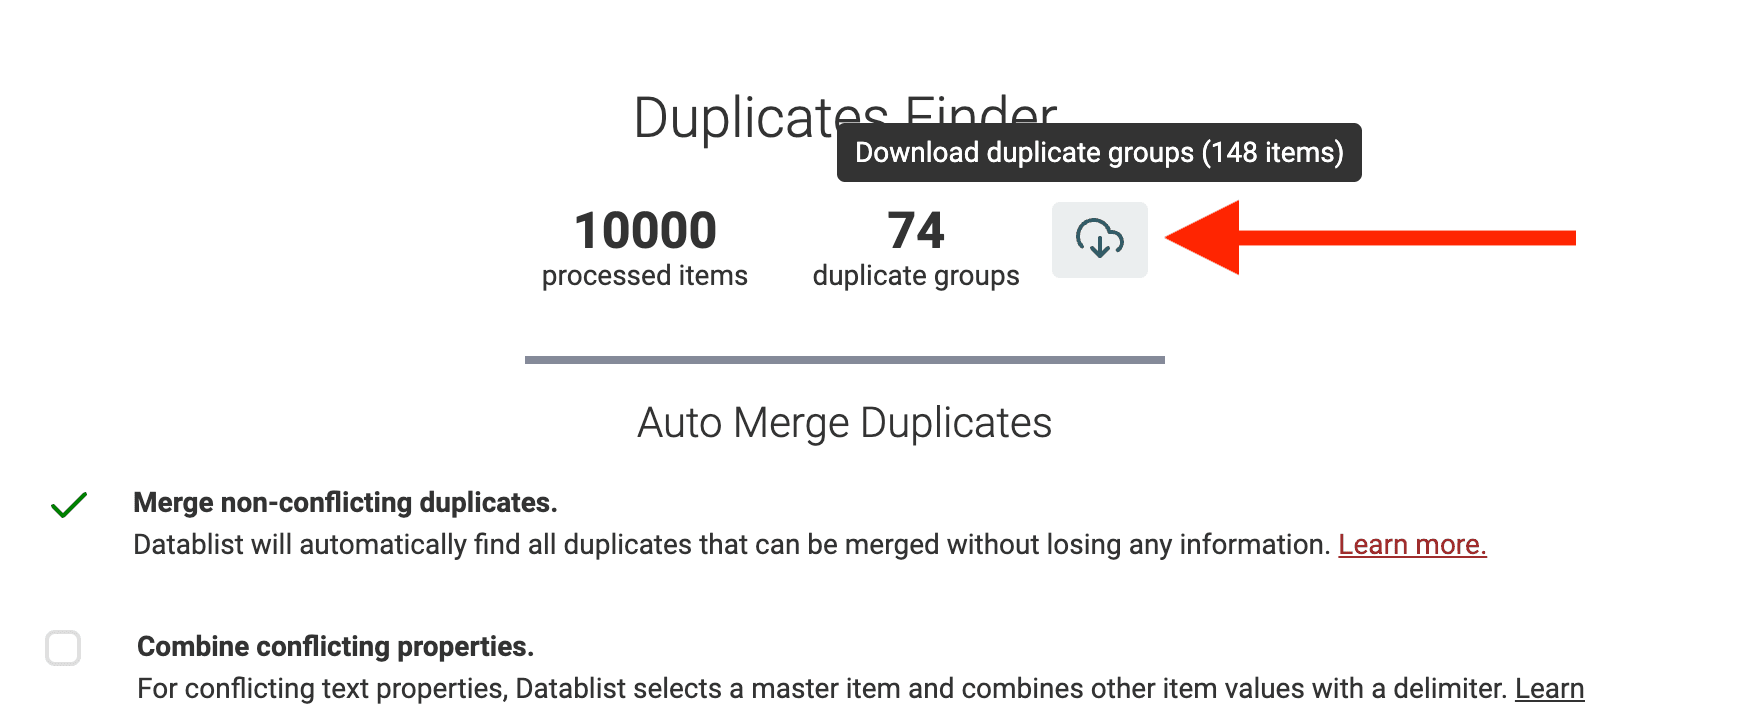
你可以使用导出文件,通过其他工具(例如电子表格工具)清洗记录,或开展更复杂的分析。
常见问题
什么是数据匹配?
数据匹配也称为记录关联或数据去重,是识别并关联单个或多个数据集内相关记录的过程。其主要目标是识别并整合代表同一实体、个人或对象的重复或相似条目,从而提高数据质量、准确性和一致性。
这一过程既适合清理由于长期积累而出现重复记录的数据集,也适合合并字段相似或存在重叠的多个数据集。
数据匹配可以使用邮箱地址、网站 URL、身份标识字符串或编号等区分度较高的字段,也可以组合姓名、出生日期、公司名称或所在地等非唯一属性,为记录计算相似度得分。
Datablist 数据匹配工具有多快?
Datablist Data Matching 工具会将数据集载入内存并执行匹配分析,适合处理少于 100 万条记录的数据集。大多数数据匹配分析可在几分钟内完成。
进行数据匹配需要技术基础吗?
不需要。Datablist 是面向所有人的 no-code 解决方案,无论是数据分析师,还是市场与销售人员,都可以直接使用。
什么时候应该使用数据匹配?
数据匹配广泛应用于金融、医疗、市场营销和客户管理等领域。在这些场景中,可靠的数据是科学决策或与其他工具集成数据的重要基础。
它可以帮助完成欺诈检测、用户档案整合,以及基于多个来源的数据 enrichment 等任务。
下一步做什么?
如果你对数据清洗感兴趣,还可以阅读以下指南: