
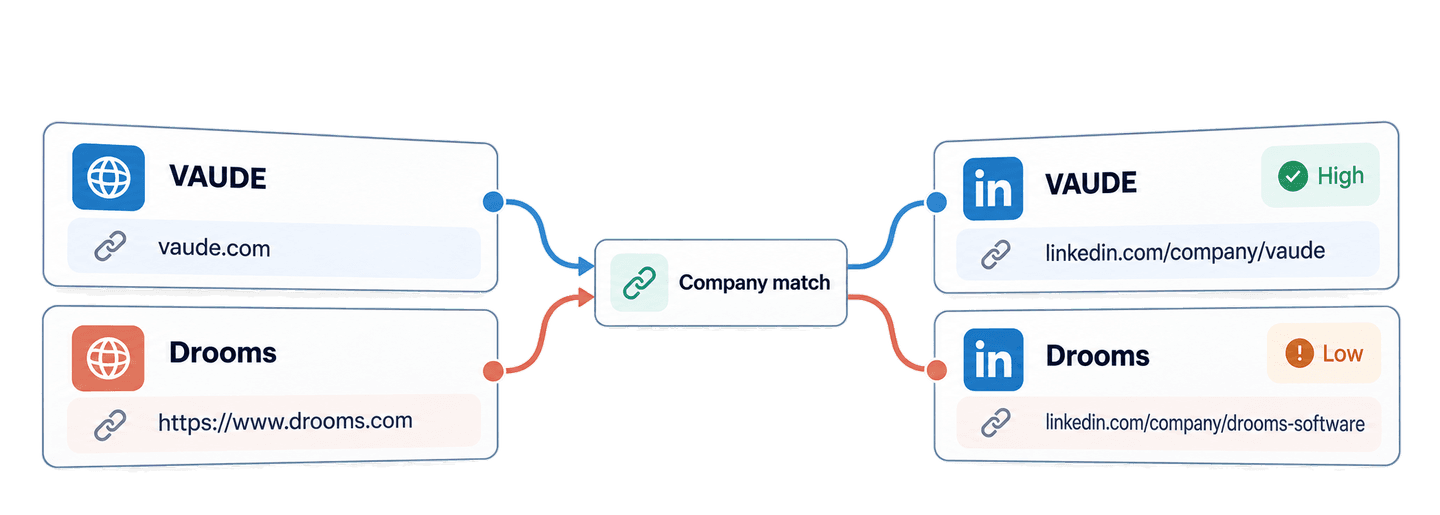
Mit der Company to LinkedIn API von Datablist findest Du per Python die LinkedIn-Unternehmensseite zu einer Website. Du kannst eine reine Domain oder eine vollständige Website-URL senden, auf den Abschluss des Matching-Tasks warten und erhältst den Unternehmensnamen, die Website, die LinkedIn-Unternehmens-URL sowie eine Konfidenzbewertung.
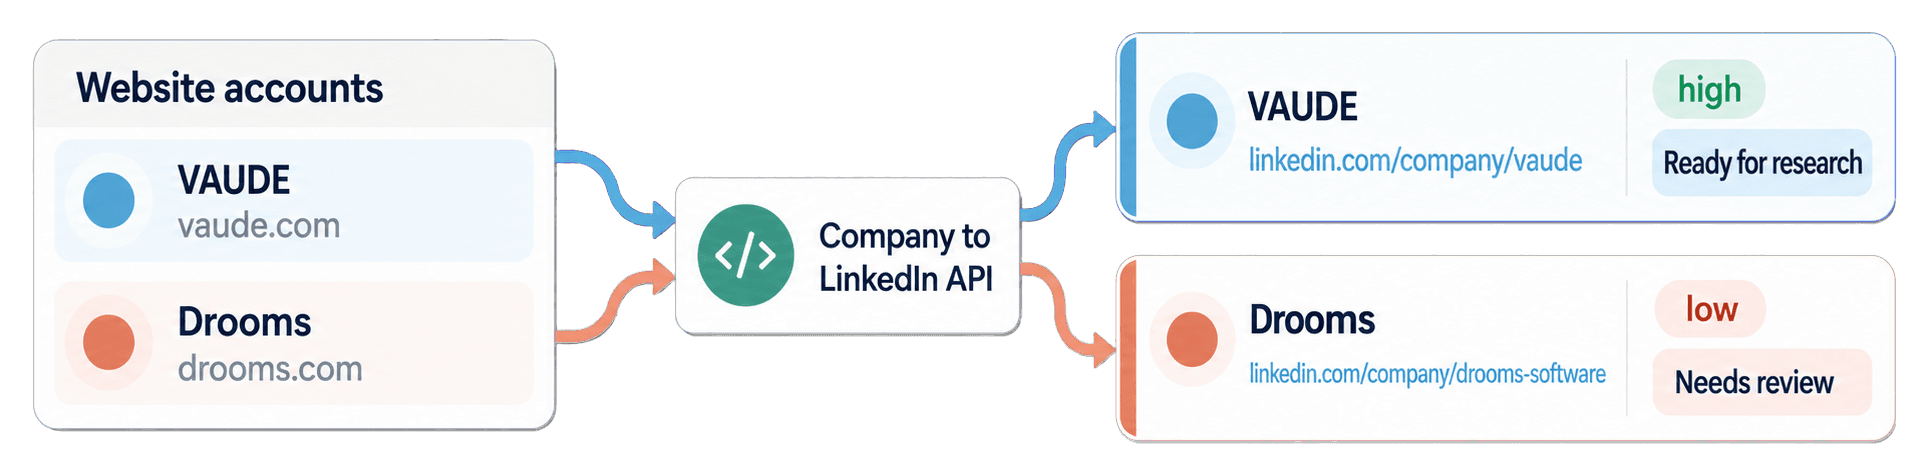
In diesem Guide gleiche ich mit Python und der Requests-Bibliothek fünf Unternehmenswebsites ab. Die Liste enthält bekannte Softwareunternehmen sowie VAUDE, einen Hersteller von Outdoor-Ausrüstung, und Drooms, einen Anbieter virtueller Datenräume. Anschließend teile ich die Ergebnisse in zwei lokale Queues auf: Matches, die für die Unternehmensrecherche bereit sind, und Matches, die manuell geprüft werden müssen.
🔑 Kurzfassung für Eilige
Sende die Websites aus Deiner Account-Liste an die Company to LinkedIn API von Datablist. Die API liefert URLs von LinkedIn-Unternehmensseiten und Konfidenzbewertungen. So kannst Du entscheiden, welche Zuordnungen Du direkt verwenden kannst und welche Du prüfen solltest.
- Input: reine Domains und vollständige URLs von Unternehmenswebsites.
- Output: Unternehmensnamen, zugeordnete Websites, URLs der LinkedIn-Unternehmensseiten sowie eine
high- oderlow-Konfidenz, aufgeteilt in die QueuesReady for researchundNeeds review.
💡 Du bevorzugst eine No-Code-Lösung? Mit Datablists LinkedIn Company Pages & Domain Lookup kannst Du Unternehmenswebsites und LinkedIn-Seiten ohne Programmierung abgleichen.
Python und Deinen Datablist API-Key einrichten
Für dieses Beispiel verwende ich das Paket requests. Die API selbst funktioniert über HTTP. Du kannst dieselbe Abfolge von Requests später also auch in einer anderen Programmiersprache umsetzen.
Du brauchst einen Datablist-Account mit REST-API-Zugriff, der im Growth-Tarif enthalten ist. Erfolgreiche Lookups verbrauchen außerdem Enrichment Credits. Die genaue Berechnung erkläre ich weiter unten im Guide.
Erstelle ein Arbeitsverzeichnis und eine Datei namens find_linkedin_company_pages.py. Richte danach eine virtuelle Umgebung ein und installiere Requests:
mkdir company-linkedin-matcher
cd company-linkedin-matcher
python -m venv .venv
source .venv/bin/activate
python -m pip install requests
touch find_linkedin_company_pages.pyErstelle in Deinem Datablist-Account einen Personal API Key und exportiere ihn als Umgebungsvariable:
export DATABLIST_API_KEY="your-api-key"Das Skript liest diesen Wert aus und sendet ihn im Header X-API-Key.
LinkedIn-Unternehmensseiten mit einer Python-Funktion finden
Das Beispiel verwendet diese fünf Quell-Accounts:
account-datablist:datablist.comaccount-posthog:posthog.comaccount-n8n:https://n8n.ioaccount-vaude:vaude.comaccount-drooms:https://www.drooms.com
Jede account_id wird zum API-Feld inputId. Das ist wichtig, weil die Ergebnisse nicht unbedingt in derselben Reihenfolge wie die Inputs zurückkommen. Mit einer stabilen ID kannst Du jedes Ergebnis zuverlässig dem richtigen Quell-Account zuordnen.
Füge das folgende vollständige Skript in find_linkedin_company_pages.py ein:
import json
import os
import time
import uuid
import requests
def match_companies(accounts, api_key, matching_direction):
"""Submit one matching task, wait for it, and return every result."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": account["account_id"],
"data": {"sourceUrl": account["source_url"]},
}
for account in accounts
]
unique_id = str(uuid.uuid4())
print(f"Task uniqueId: {unique_id}", flush=True)
payload = {
"enrichmentId": "company-to-linkedin",
"uniqueId": unique_id,
"settings": {"matchingDirection": matching_direction},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(
f"Task {task_id} {task['status']}: {task.get('error')}"
)
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "datablist.com",
},
{
"account_id": "account-posthog",
"company_name": "PostHog",
"source_url": "posthog.com",
},
{
"account_id": "account-n8n",
"company_name": "n8n",
"source_url": "https://n8n.io",
},
{
"account_id": "account-vaude",
"company_name": "VAUDE",
"source_url": "vaude.com",
},
{
"account_id": "account-drooms",
"company_name": "Drooms",
"source_url": "https://www.drooms.com",
},
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Set DATABLIST_API_KEY before running this script.")
match_results = match_companies(
accounts, api_key, matching_direction="domain_to_linkedin"
)
print(json.dumps(match_results, indent=2))Führe es so aus:
python find_linkedin_company_pages.pyDie Funktion führt nacheinander drei Arten von API-Calls aus.
Zuerst sendet der POST die fünf Websites mit dem Wert domain_to_linkedin für matchingDirection. Die API antwortet mit 202 Accepted und einer Task-ID, weil das Matching als Hintergrund-Task ausgeführt wird. Das Requests-Skript läuft für Dich trotzdem sequenziell, da es wartet, bevor es zum nächsten Schritt übergeht.
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]Anschließend prüft der Status-Request den Task so lange, bis sein Status completed, failed oder stopped lautet. Die Pause von drei Sekunden verhindert, dass das Skript ununterbrochen Status-Requests sendet.
Zum Schluss liest der Ergebnis-Request Seiten mit jeweils bis zu 100 Ergebnissen ein. Enthält nextCursor einen Wert, übergibt die Schleife ihn beim nächsten Request als cursor. Sie endet erst, wenn nextCursor den Wert null hat.
Matches auswerten und Prüffälle erkennen
Hier ist die vollständige Ergebnisliste für die fünf Inputs:
[
  {
    "inputId": "account-datablist",
    "status": "success",
    "outputs": {
      "companyWebsite": "datablist.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/datablist",
      "companyName": "datablist"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-posthog",
    "status": "success",
    "outputs": {
      "companyWebsite": "posthog.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/posthog",
      "companyName": "PostHog"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-n8n",
    "status": "success",
    "outputs": {
      "companyWebsite": "n8n.io",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/n8n",
      "companyName": "n8n"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-vaude",
    "status": "success",
    "outputs": {
      "companyWebsite": "vaude.com",
      "confidence": "high",
      "companyLinkedInUrl": "https://www.linkedin.com/company/vaude",
      "companyName": "vaude"
    },
    "creditsUsed": "1.5",
    "error": null
  },
  {
    "inputId": "account-drooms",
    "status": "success",
    "outputs": {
      "companyWebsite": "drooms.com",
      "confidence": "low",
      "companyLinkedInUrl": "https://www.linkedin.com/company/drooms-software",
      "companyName": "Drooms"
    },
    "creditsUsed": "1.5",
    "error": null
  }
]
Werte status und confidence getrennt aus. Die API liefert für jeden Input ein Ergebnisobjekt zurück – auch für nicht erfolgreiche Inputs. Der Status success bedeutet, dass ein Kandidat für die Unternehmensseite gefunden wurde. Der Wert outputs.confidence zeigt Dir, ob die Zuordnung zur Website validiert werden konnte. Über inputId wird das Objekt mit Deinem Quell-Account verknüpft. creditsUsed dokumentiert die Kosten der jeweiligen Zeile, während error bei einem Fehler strukturierte Informationen enthält.
Speichere in Deiner Anwendung das vollständige outputs-Objekt, auch wenn Du auf dem ersten Screen nur die LinkedIn-URL und die Konfidenz brauchst. companyName und companyWebsite beschleunigen die manuelle Prüfung – besonders dann, wenn sich die Groß- und Kleinschreibung des zurückgegebenen Unternehmensnamens unterscheidet oder als Input eine vollständige URL verwendet wurde. Außerdem erhältst Du damit hilfreichen Kontext, ohne einen weiteren API-Call auszuführen.
Der Matching-Prozess normalisiert zunächst die übermittelte Website und sucht in Unternehmensdatensätzen nach einer bekannten Verknüpfung zwischen Website und LinkedIn. Danach vergleicht er die Input-Domain mit der Website, die auf der gefundenen LinkedIn-Unternehmensseite angegeben ist. Stimmen die registrierten Domains überein, lautet die Konfidenz high.
Wenn die Datensätze keine LinkedIn-URL enthalten, kann der Lookup eine gezielte Google-Suche nach möglichen Unternehmensseiten ausführen. Lässt sich ein Kandidat nicht anhand einer veröffentlichten Website validieren, kann er mit der Konfidenz low zurückgegeben werden. Ein Kandidat mit einer nachweislich abweichenden Website wird nicht akzeptiert.
Betrachte die Konfidenz als konkrete Prüfanweisung. Für VAUDE wurde https://www.linkedin.com/company/vaude mit der Konfidenz high gefunden. Der Eintrag kann daher direkt in die Recherche-Queue übernommen werden. Für Drooms kam https://www.linkedin.com/company/drooms-software mit low zurück. Öffne die Drooms-Website und die LinkedIn-Seite, bevor Du Dich auf diese Zuordnung verlässt.
Auch Datablist, PostHog und n8n lieferten Matches mit hoher Konfidenz. Diese API ermittelt die Beziehung zwischen einer Website und einer Unternehmensseite. Wenn Du nach der Prüfung der URL noch Unternehmensgröße, Branche oder andere Seitendaten brauchst, kannst Du als nächsten Schritt den Guide zur LinkedIn Company Scraper API verwenden.
Recherche-Queue aus den Ergebnissen erstellen
Verwende nun match_results, um eine lokale Queue für die manuelle Unternehmensrecherche anzulegen. Dieser Block ruft die API nicht erneut auf. Er indexiert die Ergebnisse anhand von inputId und durchläuft danach die ursprüngliche Account-Liste. So bleibt jeder Quell-Account sichtbar, selbst wenn künftig einmal ein Ergebnis fehlen sollte.
results_by_id = {result["inputId"]: result for result in match_results}
ready_for_research = []
needs_review = []
for account in accounts:
result = results_by_id.get(account["account_id"])
if result is not None:
outputs = result.get("outputs", {})
else:
outputs = {}
research_record = {
**account,
"companyLinkedInUrl": outputs.get("companyLinkedInUrl"),
"confidence": outputs.get("confidence"),
"api_result": result,
}
is_ready = (
result is not None
and result["status"] == "success"
and outputs.get("companyLinkedInUrl")
and outputs.get("confidence") == "high"
)
if is_ready:
ready_for_research.append(research_record)
else:
needs_review.append(research_record)
print("Ready for research:")
print(json.dumps(ready_for_research, indent=2))
print("Needs review:")
print(json.dumps(needs_review, indent=2))Das Ergebnis-Dictionary macht die Verknüpfung unabhängig von der Reihenfolge der API-Antwort. account-vaude verbindet den ursprünglichen Datensatz für vaude.com mit der gefundenen VAUDE-Seite und landet in ready_for_research. Bei account-drooms bleiben die vollständige Input-URL und das komplette API-Ergebnis erhalten. Der Eintrag landet jedoch in needs_review, weil die Konfidenz trotz des Ergebnisstatus success niedrig ist.
Mit derselben Logik bleiben auch fehlende Ergebnisse sowie Zeilen mit no_result oder einem Fehler in der Prüf-Queue. Die beiden ausgegebenen Listen bieten dem Team einen klaren Ausgangspunkt für die manuelle Unternehmensrecherche.
Du kannst außerdem das gepflegte synchrone Requests-Beispiel herunterladen. Das Repository enthält auch ein asynchrones HTTPX-Beispiel für Anwendungen, die nicht blockierende HTTP-Requests benötigen. Für die erste Integration ist die oben gezeigte blockierende Version jedoch leichter nachzuvollziehen.
Von der LinkedIn-Unternehmensseite zur Website suchen
Dieselbe Funktion akzeptiert auch LinkedIn-Unternehmensseiten, wenn Du die Matching-Richtung änderst. Das ist hilfreich, wenn Deine Quellliste URLs von Unternehmensseiten enthält und Du vor einem kompatiblen Company- oder Work-Email-Enrichment die zugehörigen Websites brauchst.
linkedin_accounts = [
{
"account_id": "account-datablist",
"company_name": "Datablist",
"source_url": "https://www.linkedin.com/company/datablist",
}
]
website_results = match_companies(
linkedin_accounts,
api_key,
matching_direction="linkedin_to_domain",
)Ein regulärer Lookup einer LinkedIn-Unternehmensseite wird zum normalen Matching-Tarif abgerechnet. Numerische Unternehmens-IDs und Sales-Navigator-Unternehmens-URLs können 10 Credits verbrauchen, da sie einen anderen Reverse-Lookup-Prozess nutzen. Eine No-Code-Version für diese Richtung findest Du im Guide Website-URLs aus LinkedIn-Unternehmensseiten ermitteln.
Credits für Website-zu-LinkedIn-Lookups berechnen
Ein erfolgreicher regulärer Website-zu-LinkedIn-Lookup verbraucht 1,5 Credits. Die fünf gezeigten Matches haben somit insgesamt 7,5 Credits benötigt. Beim gleichen Tarif kosten 1.000 erfolgreiche Matches 1.500 Credits. Ungültige Inputs und Zeilen ohne Ergebnis können null Credits verbrauchen. Prüfe deshalb den Wert creditsUsed jedes Ergebnisses, um den tatsächlichen Verbrauch zu ermitteln.
Der REST-API-Zugriff ist im Growth-Tarif enthalten. Das monatliche Abonnement und zusätzliche Top-up Credits werden separat abgerechnet. Für 20 $ erhältst Du 20.000 Credits, ein Credit kostet also 0,001 $. Bei 1,5 Credits pro erfolgreichem Match kosten 1.000 Matches insgesamt 1.500 Credits beziehungsweise 1,50 $. Aktuelle Tarife und Pakete findest Du auf der Seite Datablist Preise.
Häufige Probleme mit Inputs, Tasks und Ergebnissen lösen
DATABLIST_API_KEYfehlt: Das Skript wird beendet, bevor es einen Request sendet. Exportiere die Umgebungsvariable und führe den Befehl erneut aus.- Die API lehnt den Key ab: Prüfe, ob Du einen Personal API Key kopiert hast und der Request ihn ausschließlich im Header
X-API-Keysendet. - Der Input wird nicht unterstützt: Verwende für
domain_to_linkedineine Unternehmenswebsite oder Domain. Nutze für die umgekehrte Richtung die URL einer unterstützten Unternehmensseite – kein persönliches Profil und keinen leeren Wert. - Die Credits reichen nicht aus: Prüfe Dein Guthaben. Verwende anschließend enthaltene Credits oder kaufe ein Top-up, bevor Du einen weiteren Task erstellst.
- Der Task hat den Status
failedoderstopped: Prüfe den Task-Status, den Fehler, vorhandene Ergebnisse und den Credit-Verbrauch, bevor Du entscheidest, ob Du ihn erneut sendest. - Ein Ergebnis hat eine niedrige Konfidenz,
no_resultoder einen Fehler: Behalte die Quell-Website und das vollständige Ergebnis inneeds_review. Öffne den Kandidaten, falls einer vorhanden ist, und spekuliere nicht über die Ursache eines fehlenden Ergebnisses.
Falls die Verbindung beim Erstellen des Tasks abbricht, verwende die vor dem POST ausgegebene uniqueId. Rufe Deine Tasks ab und suche nach diesem Wert, bevor Du einen neuen Task erstellst:
curl --get "https://api.datablist.com/v1/enrichments/tasks" \
--header "X-API-Key: $DATABLIST_API_KEY" \
--data-urlencode "enrichmentId=company-to-linkedin" \
--data-urlencode "limit=100"Die Task-Liste lässt sich nicht nach uniqueId filtern. Prüfe deshalb jeden zurückgegebenen Task und folge bei Bedarf nextCursor. Sobald Du den passenden Wert gefunden hast, verwendest Du dessen @id mit denselben Status- und Ergebnis-URLs wie im Skript.
Ein Task kann bis zu 10.000 Inputs enthalten. Alle Limits für Requests, die Aufbewahrung von Tasks und die Pagination findest Du in der Dokumentation zur Company to LinkedIn API.
Nächste Schritte
Du hast jetzt eine wiederverwendbare Python-Requests-Funktion, die Unternehmenswebsites in Kandidaten für LinkedIn-Unternehmensseiten umwandelt. In der lokalen Queue stehen Matches mit hoher Konfidenz direkt für die Recherche bereit, während unsichere oder nicht erfolgreiche Datensätze zur Prüfung sichtbar bleiben.
Ersetze die fünf Beispiele durch eine kleine Account-Liste und prüfe jeden Kandidaten mit niedriger Konfidenz. Anschließend kannst Du die bestätigten URLs für die manuelle Unternehmensrecherche oder als Inputs für die LinkedIn Company Scraper API verwenden. Enthält Deine Quellliste Unternehmensnamen statt Websites, beginne mit dem Guide zur Company Website Finder API.