几个月前,我们上线了一项功能,当时完全没想到它会如此强大。
如今,这项功能正在重新定义 no-code 网页抓取行业。
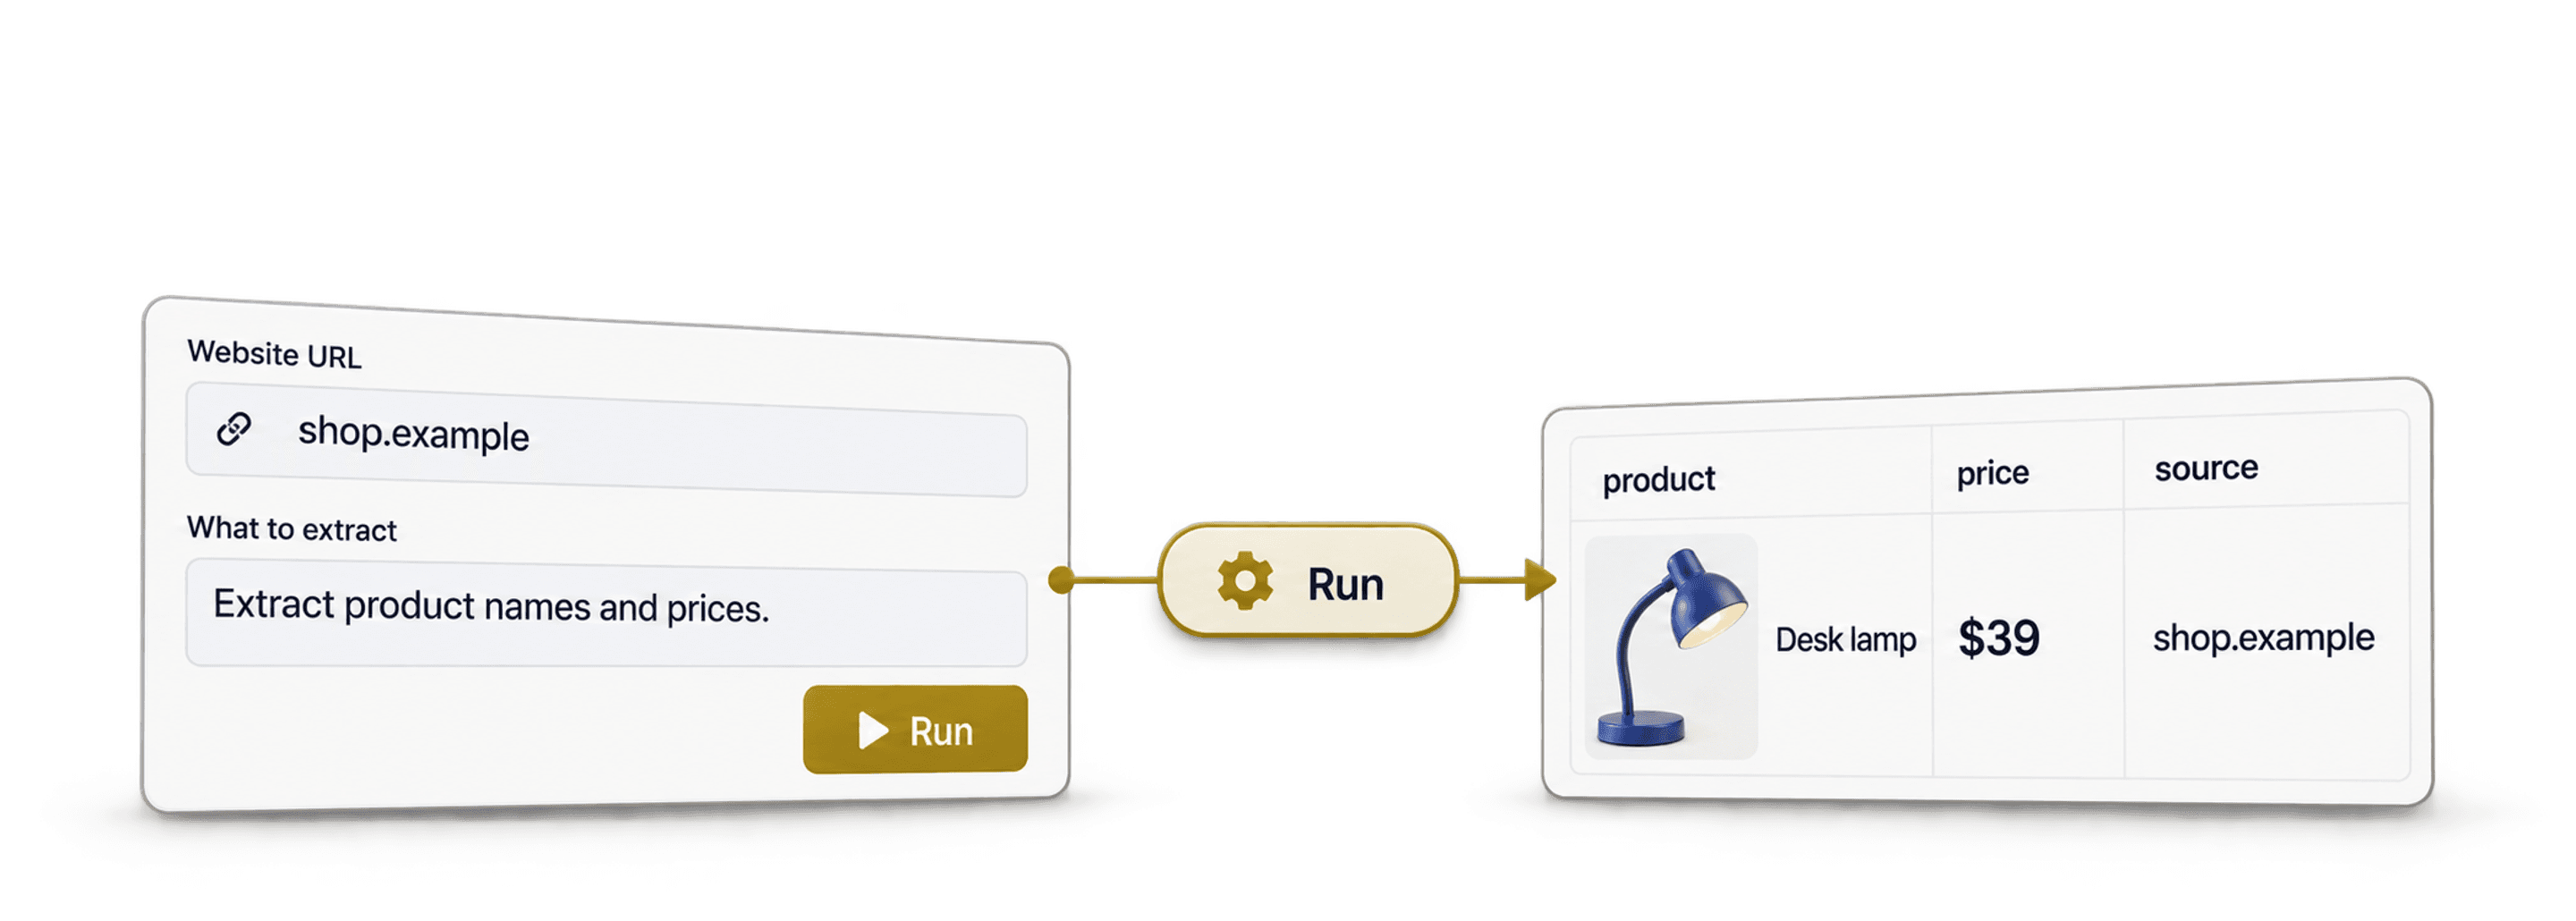
**我说的就是我们的 “AI Agent - Site Scraper” 数据源。**它可以根据你的指令,从可访问的网页内容中提取结构化数据行。
几个月后,我发现了三件事:
- 整个 no-code 抓取行业都建立在一个巨大的谎言之上
- 我们在毫不知情的情况下,做出了最好用的 no-code 抓取工具
- AI 抓取 Agent 比以往任何 no-code 抓取工具都更强大、更易用,也更快
📌 赶时间?先看摘要
本文会讲清楚真正的 no-code 抓取是什么,并说明它不需要 API、CSS 选择器或技术背景。如果你赶时间,可以先看下面的摘要:
**问题:**所谓的“no-code”抓取工具依然要求技术知识:你得理解网站结构、观看教程、花几个小时配置;而网站只要稍微更新一下,一切就可能失效。
**为什么这是个问题:**仅仅为了从网站提取数据,你不应该还得学习 API、CSS 选择器,或看几个小时的教程。否则,“no-code”也就失去了意义。
**解决方案:**使用 Datablist 的 AI 抓取功能,直接用自然语言描述需求。你只需说明想要什么,其余工作交给 AI。
**你将学到什么:**这篇指南会揭开 no-code 抓取行业的真相,展示真正的 no-code 抓取应该是什么样,并提供实用场景和 Prompt 编写技巧。
为什么用 Datablist 做 No-Code 抓取:三个关键理由
- 真正的 no-code:只需用自然语言描述需求
- 能处理包含 JavaScript、分页和动态内容的复杂网站
- 网站变化时可以适应,不像基于 CSS 选择器的抓取工具那么脆弱
本文内容概览
No-Code 抓取行业的谎言
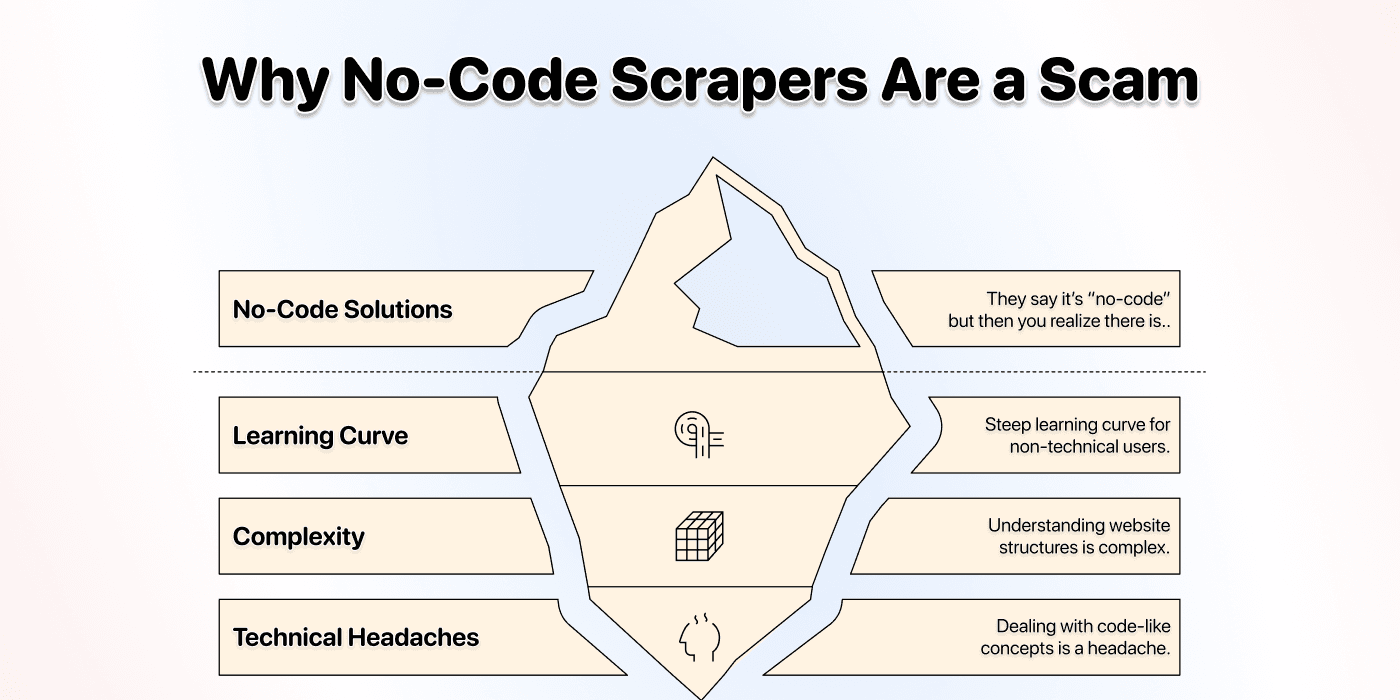
这一部分要拆穿 no-code 抓取行业的迷思和套路。**事实是,大多数“no-code”工具根本不是真正的 no-code。**它们只是换了一种包装,把技术复杂性重新卖给你。
问题从来都不是代码
仔细想想:**代码从来都不是问题。**如果你会编程,一开始就会直接写代码抓取数据,根本不会寻找 no-code 方案。
你寻找 no-code 方案,是因为不想为了抓取一个网站专门学习编程。但**商家很聪明,于是卖给你一种勉强可用的方案;**而这种方案依然意味着:
- 陡峭的学习曲线
- 观看大量教程
- 理解网站结构
有时甚至还要接触 CSS 选择器这类近似编程的概念。
真正的问题从来不是 code 与 no-code 之争。
真正的问题一直都是学习成本、复杂性和技术负担。
他们试图卖给你的方案
使用下面三类方案进行自定义抓取时,通常仍然少不了配置工作。预制模板和自动数据识别可以省去其中一部分操作,但你需要确认它们是否覆盖目标网站中的字段和分页方式。
基于 API 的抓取工具
这些工具声称自己是“no-code”,因为你不需要编写 Python 或 JavaScript。不过,有些事情它们不会告诉你。
你仍然需要处理:
- 网站 DOM 结构
- CSS 选择器
- HTML 标签
严格来说,你确实没有写代码,但做的事情同样很技术化。**你仍然要把人的需求翻译成机器可以读取的选择器,**本质上只是多绕了几步的编程。
点击式抓取工具
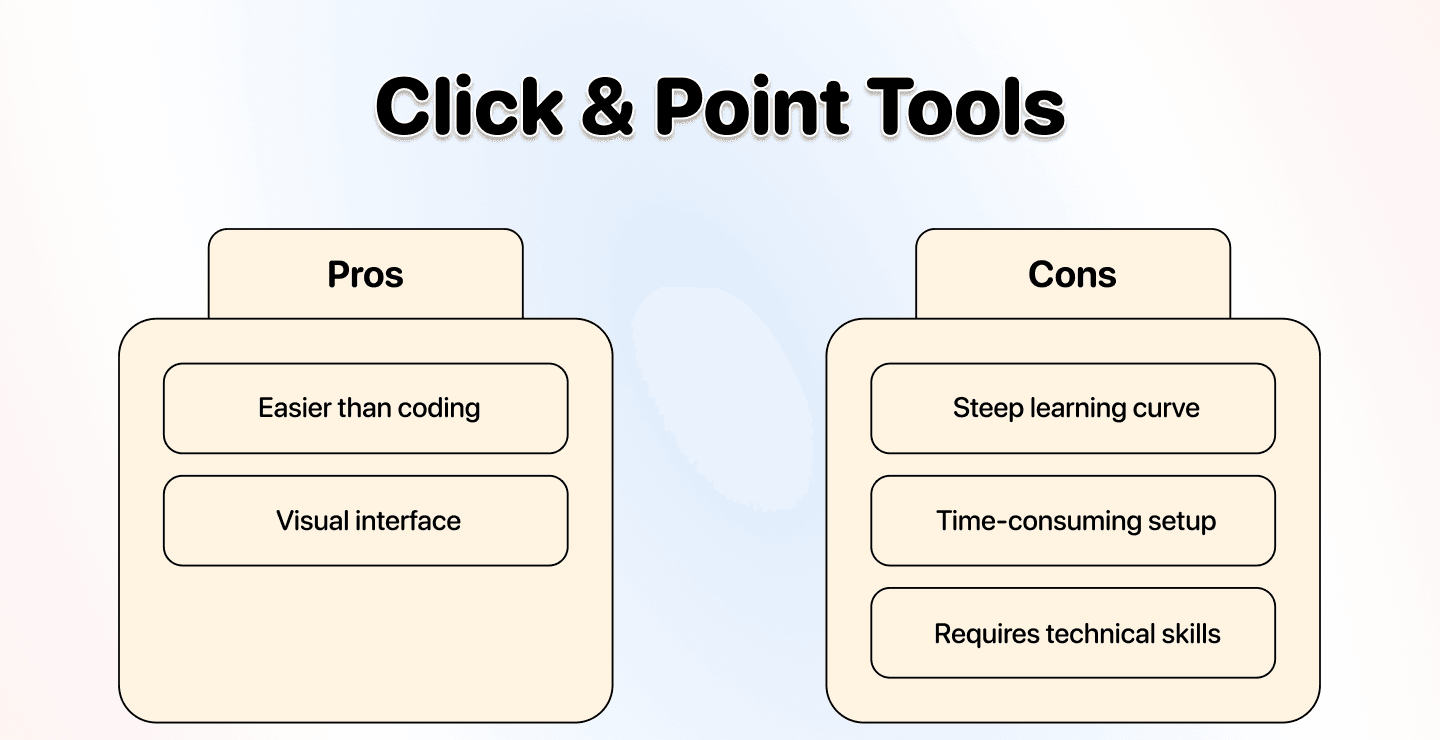
这种方式更简单一些,但你仍然需要理解网站是如何构建的。它们允许你直接点击网页元素,确实降低了一点难度,但整个过程依然谈不上省心。
最大的问题是什么?**一旦网站结构发生变化,你就得从头重新配置所有内容。**这意味着:
- 再看一遍教程
- 重新配置所有选择器
- 然后祈祷这次能正常工作
浏览器扩展
这类工具本质上也是点击式抓取工具,只不过直接在浏览器中运行,而不是使用独立应用。其中不少工具可以免费使用,例如 Instant Data Scraper。
这类工具的主要问题包括:
- 网站一改版,就得从头再来
- 功能和处理规模有限
- 可能导致你的 IP 被封锁
📘 你应该注意到的规律
对于标准化任务,现成模板可能已经足够。Octoparse 的模板文档介绍了如何直接输入 URL 或关键词,无需自行搭建提取流程。其自动识别指南还说明了如何识别字段和“下一页”控件。
请对照实际需要的字段检查预览结果。如果自定义页面没有合适的模板,Datablist 的 AI Agent - Site Scraper 可让你直接用自然语言描述需要提取的字段。配置方式虽然变了,但检查返回的数据行和页面覆盖范围仍然是必不可少的工作。
你真正想要的是什么
坦白说,你真正需要的**不是 no-code 抓取,而是“不折腾”的抓取。**真正省心的抓取应该做到:
没有技术负担
- 不要强迫我理解 CSS 选择器
- 不要让我看三个小时的教程
- 不要因为网站更新设计就完全失效
没有学习门槛
- 我应该可以立即上手
- 我不应该还要学习一项新的技术技能
归根结底,你只想用自然语言描述目标,然后直接获得结果。其他步骤都只是行业长期以来习以为常、但本可避免的阻力。
用 AI 抓取取代 No-Code 抓取
解决 no-code 抓取问题的办法,不是做一个更好用的点击界面,也不是提供一个更简洁的 API。真正的解决方案,是彻底移除技术操作层,改用自然语言。
AI 如何实现真正的 No-Code 抓取
顾名思义,AI 抓取是让 AI 去抓取网站,而不是让你亲自操作。你的角色是管理者,不再是技术执行人员。
使用 AI 驱动的 no-code 抓取时,你只需告诉系统要做什么、怎么做以及何时做。所有技术复杂性都由 AI 在后台处理。
你不需要理解:
- CSS 选择器或 HTML 结构
- 网站的 DOM 架构
- API Endpoint 或技术文档
只需用自然语言下达指令,AI 抓取 Agent 就会自行完成其余工作。No-code 抓取从一开始就应该这么简单。
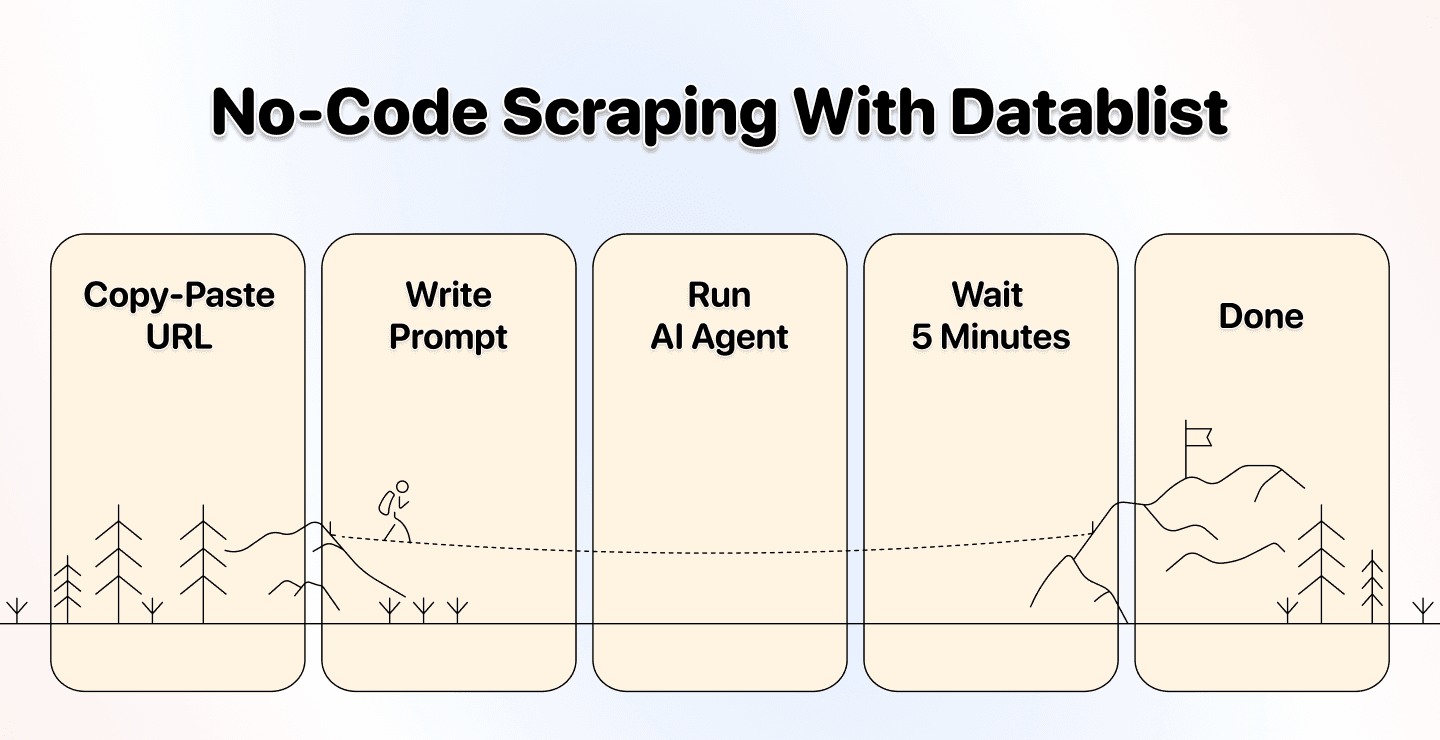
提供解决方案的平台:Datablist.com
正如开头提到的,我们本来没打算颠覆整个 no-code 行业。事情纯属偶然:一位用户需要抓取某个网站,于是我们为他做了一个解决方案。
我们构建了一个 AI Agent,它可以:
- 理解自然语言指令
- 自动浏览复杂网站
- 处理大量使用 JavaScript 的页面
- 处理分页内容
- 智能提取数据
- ……
真正的突破并不是做出了一个更好的抓取工具。
而是彻底消除了对技术知识的要求。
你告诉 AI 想要什么,它会自己判断如何获取。
不需要 CSS 选择器,不需要检查 DOM,也不需要看教程。
Datablist 是什么
Datablist 是一个面向非技术用户的平台,可用于自动化 Lead Generation、Data Enrichment 和数据清洗工作流,特别适合销售、市场营销和招聘团队。
你可以使用抓取数据源创建数据行,在 Collection 中检查结果,然后进行清洗并导出。只有后续步骤确实需要时,再选择额外的 Enrichment。
为什么选择 Datablist
Datablist 的 no-code 抓取方式与市面上的其他产品不同,因为**我们没有把技术负担包装得更漂亮再卖给你;**我们选择了 AI 抓取。
这对你意味着:
真正的 No-Code 方案
- 不需要任何技术知识
- 不需要理解 HTML 或 CSS
- 网站变化后,可检查数据提取质量
只需编写 Prompt
- 用自然语言写下你的需求
- AI 能够理解上下文和意图
适用于多种抓取任务的模板
- 常见场景的预制 Prompt
- 目录网站抓取模板
- 电商网站抓取模板
- 客户案例提取模板
抓取目录网站的简单方案
- 支持 Yellow Pages、Yelp、TripAdvisor 和 Alibaba
- 自动处理分页
不必在十个工具之间反复导入导出
- 数据直接进入 Spreadsheet 界面
- 在一个平台内编辑、筛选和 Enrich 数据
- 接入完整的 Lead Generation 生态系统
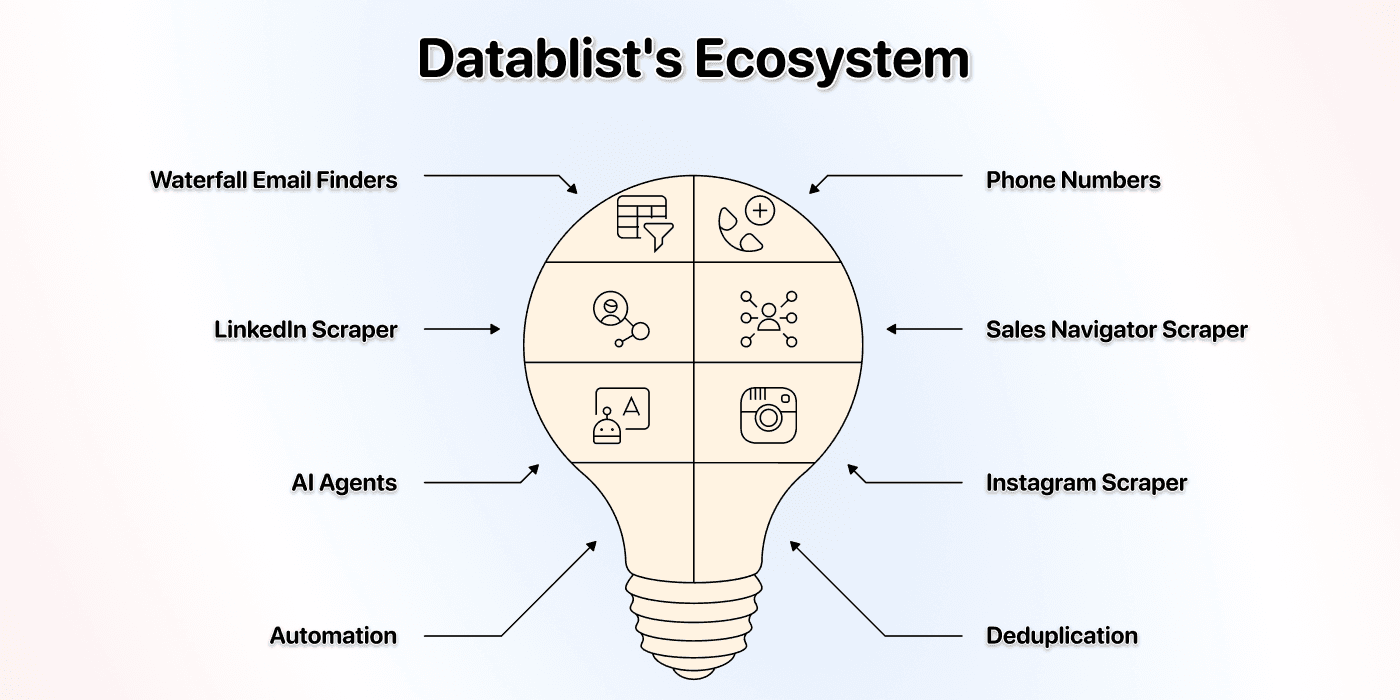
应用场景与使用技巧
使用 Datablist 抓取网站、目录,甚至规模化执行 AI Search 都很简单。方法始终如一:尽可能准确地描述你想要什么。
Prompt 快速入门
在介绍 AI 抓取 Agent 的各种应用场景之前,先来看看给它下达指令有多简单。
Prompt 编写规则
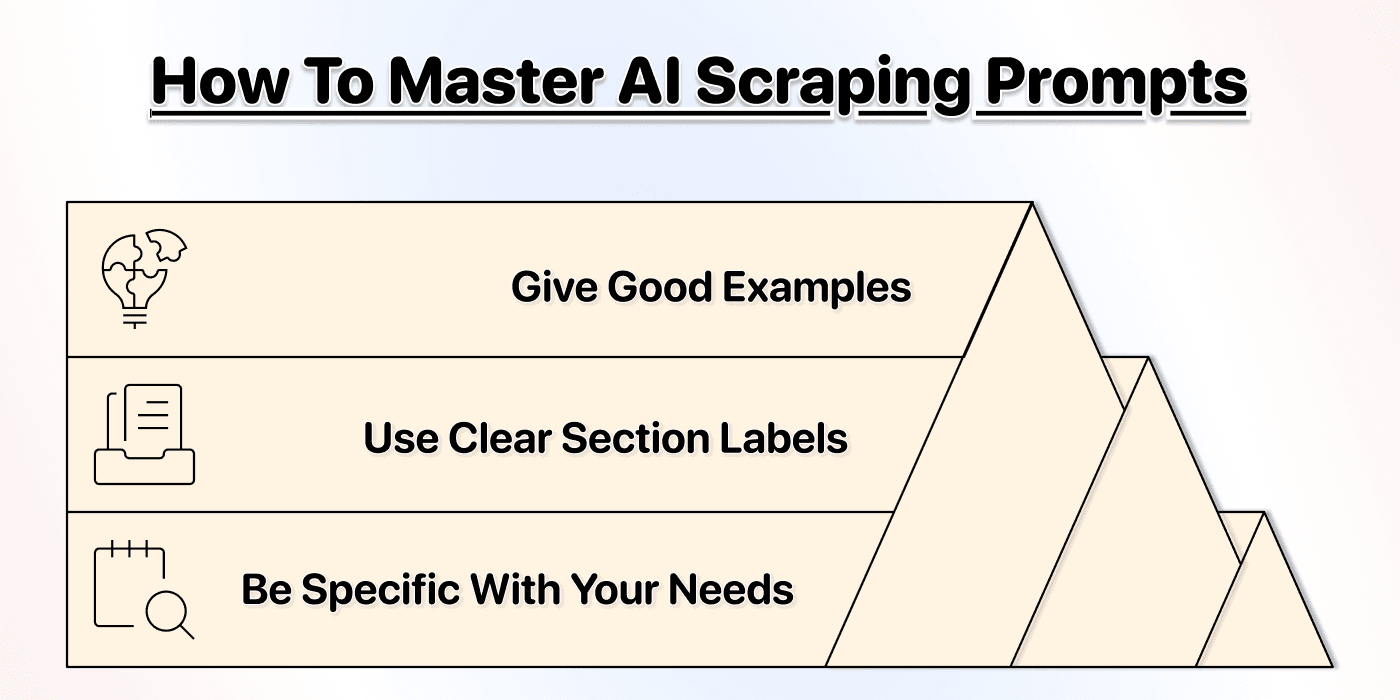
**写好 Prompt 并不复杂。**你不需要成为专家,只需要清楚表达自己的需求。以下技巧可以帮你写出更有效的 Prompt:
明确具体
- 不要只说“获取产品信息”
- 应该说“获取产品名称、价格和库存状态”
- 尽可能提供示例
这样可以降低 AI Agent 误解需求的可能性,确保你拿到真正想要的数据。
使用分区标签
- 用清晰的分区组织 Prompt
- Goal:你想完成什么
- Data Points:具体需要哪些信息
- Format:希望数据采用什么结构
- Constraints:需要排除或包含什么
分区标签有助于 AI Agent 理解你的要求。这不是硬性规定,但根据我们的测试,它能大幅提高准确率。
提供示例
AI Agent 并非无所不知,有些网站的结构非常复杂。提供示例可以减少误判、提高准确率并降低成本。
这里有一份如何为 AI Agent 编写 Prompt 的详细指南与示例 👈🏽
💡 专业建议:处理分页
Datablist 的 AI Agent 可以自动处理分页内容。你只需在设置中启用分页,并设置最大页数。只要仍有结果、尚未达到设定的页数上限,Agent 就会继续访问可访问的“下一页”链接。
===
我需要的数据:- 产品名称(示例:“经典款 T 恤”)
- 价格(示例:“$29.99”)
- 产品 URL(完整链接)
- 库存状态(有货 / 缺货)
===
格式:- 每个产品返回一行
- 数据缺失时使用“N/A”
===
限制条件:- 跳过促销横幅
- 只提取实际产品,不要提取分类页面
No-Code 抓取的应用场景
No-code 抓取几乎有无限种用途。以下是我们目前看到的热门且有效的 AI 抓取场景:
目录网站
-
抓取 Yelp 餐厅数据
-
抓取 TripAdvisor 酒店信息
-
抓取 Alibaba 供应商目录
电商网站
其他场景
- 抓取网站上的所有客户案例
- 从展会网站提取参展商信息
📘 如何抓取多个网站
如果需要抓取许多结构相似的网站,也可以使用 Datablist 的 AI Research Agent 批量抓取网站列表。这个 Agent 还提供额外能力,可帮助你规模化运行 AI Search。
结论:No-Code 抓取应该换个名字
No-code 抓取应该改名为**“无技术负担抓取”**,因为这才是用户真正想要的。你搜索 no-code 抓取,并不是因为你不会写代码,而是不想仅仅为了提取数据就专门学习技术技能。
因此,如果抓取数据并不是你的核心盈利业务,**你就不应该被迫在这件事上浪费几个小时。**解决方案也不是更好用的 API,或更简洁的点击式界面。
**真正的解决方案,是彻底移除技术操作层,**也就是使用 AI 抓取。
通过 Datablist,你不仅可以做到这一点,还可以:
- 几分钟内获得结果,而不是等上几个小时
- 从抓取一个网站扩展到数千个网站
- 用自然语言描述需求
- 自动适应网站变化
**No-code 抓取问题终于得到了解决。**而且,我们纯属意外地解决了它。