
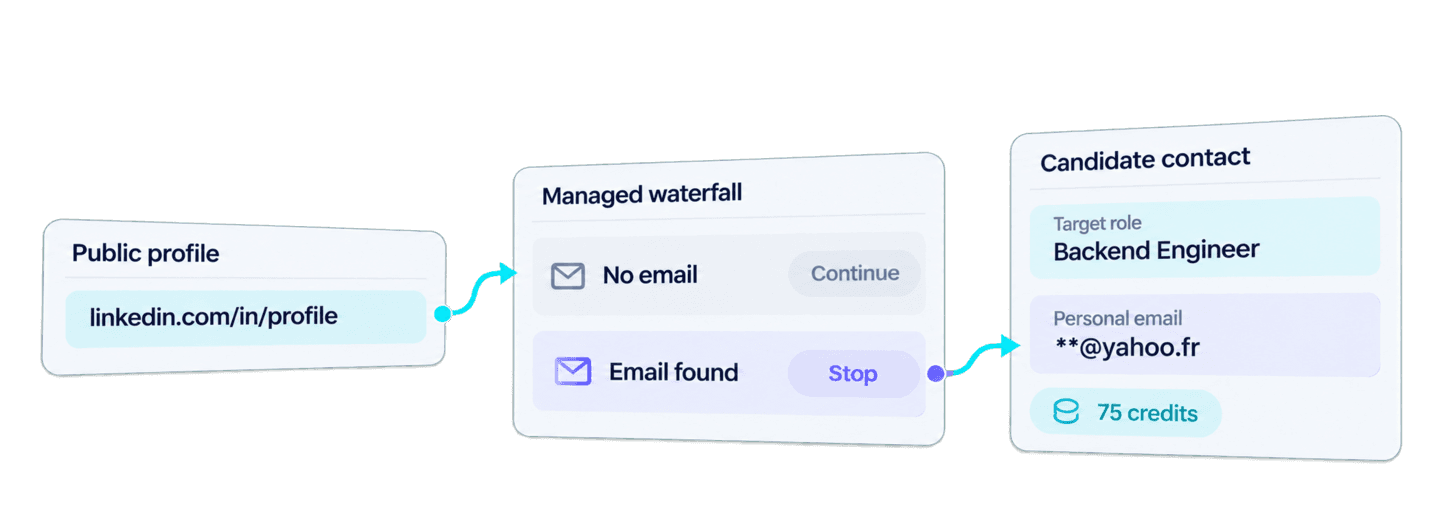
Du kannst private E-Mail-Adressen aus LinkedIn-Profilen mit Python finden, indem du öffentliche Profil-URLs im Format linkedin.com/in/... an die Waterfall Personal Email Finder API von Datablist sendest. Die API führt eine verwaltete Abfolge geeigneter E-Mail-Anbieter aus und gibt eine private Adresse zurück, sobald einer von ihnen ein Ergebnis findet.
Das vollständige Requests-Beispiel unten startet einen Hintergrund-Task, wartet auf dessen Abschluss und ruft alle Ergebnisseiten ab. Sobald die Suche funktioniert, verwendest du die zurückgegebenen Objekte, um Kontaktdatensätze fürs Recruiting zu erstellen. So bleiben Name, LinkedIn-URL und Zielposition jedes Kandidaten direkt mit der gefundenen E-Mail-Adresse verknüpft.
Dieser Workflow sucht nach einer privaten E-Mail-Adresse, die unabhängig vom aktuellen Arbeitgeber des Kandidaten ist. Benötigst du stattdessen eine geschäftliche Adresse, folge der separaten Anleitung zum Finden einer geschäftlichen E-Mail-Adresse über ein LinkedIn-Profil.
🔑 Kurzfassung für Eilige
Gib die Namen der Kandidaten, öffentliche LinkedIn-Profil-URLs und Zielpositionen an. Der Python-Workflow findet verfügbare private E-Mail-Adressen und verknüpft jede Adresse mit den ursprünglichen Recruiting-Daten.
- Input: Namen der Kandidaten, öffentliche Profil-URLs im Format
linkedin.com/in/...und Zielpositionen.- Output: Gefundene private E-Mail-Adressen zusammen mit den passenden Kandidatendaten.
💡 Lieber eine No-Code-Lösung? Mit dem Waterfall Personal Email Finder von Datablist findest du private E-Mail-Adressen ganz ohne Programmieren.
Enthält deine Quelle Namen, aber keine Profil-URLs, solltest du zuerst öffentliche LinkedIn-Profile mit Python finden und die gefundenen URLs anschließend an diese API übergeben.
Python, Requests und Datablist API-Key einrichten
Für dieses Beispiel verwende ich Python mit dem Paket requests. Erstelle eine Datei namens find_personal_emails.py und installiere anschließend Requests:
python -m pip install requestsErstelle in deinem Datablist-Konto einen Personal API Key und exportiere ihn als Umgebungsvariable:
export DATABLIST_API_KEY='your-api-key'Der Zugriff auf die REST API ist im Growth-Tarif verfügbar. Für jedes erfolgreiche Ergebnis der Suche nach einer privaten E-Mail-Adresse werden außerdem Credits verbraucht. Die Kosten berechne ich weiter unten im entsprechenden Abschnitt.
Private E-Mail mit einer Python-Funktion finden
Die bearbeitbare Liste candidates in diesem Skript enthält einen Recruiting-Datensatz. target_role ist ein beispielhafter Ausgangswert, der lokal im Recruiting-Workflow bleibt. Nur candidate_id und linkedin_url werden an die API übermittelt.
import json
import os
import time
import uuid
import requests
def find_personal_emails(candidates, api_key):
"""Einen Task starten, auf den Abschluss warten und alle Ergebnisse zurückgeben."""
tasks_url = "https://api.datablist.com/v1/enrichments/tasks"
headers = {"X-API-Key": api_key}
inputs = [
{
"inputId": candidate["candidate_id"],
"data": {"profileUrl": candidate["linkedin_url"]},
}
for candidate in candidates
]
unique_id = str(uuid.uuid4())
print(f"UniqueId zur Wiederherstellung: {unique_id}", flush=True)
payload = {
"enrichmentId": "waterfall-personal-email-finder",
"uniqueId": unique_id,
"settings": {},
"inputs": inputs,
}
response = requests.post(tasks_url, headers=headers, json=payload)
response.raise_for_status()
task = response.json()
task_id = task["@id"]
task_url = f"{tasks_url}/{task_id}"
while task["status"] not in ("completed", "failed", "stopped"):
time.sleep(3)
response = requests.get(task_url, headers=headers)
response.raise_for_status()
task = response.json()
if task["status"] != "completed":
raise RuntimeError(f"Task {task_id} {task['status']}: {task.get('error')}")
results = []
results_url = f"{task_url}/results"
params = {"limit": 100}
while True:
response = requests.get(results_url, headers=headers, params=params)
response.raise_for_status()
page = response.json()
results.extend(page["results"])
next_cursor = page["nextCursor"]
if next_cursor is None:
break
params["cursor"] = next_cursor
return results
if __name__ == "__main__":
candidates = [
{
"candidate_id": "candidate-florian-poullin",
"name": "Florian Poullin",
"linkedin_url": "https://www.linkedin.com/in/florianpoullin/",
"target_role": "Backend Engineer",
}
]
api_key = os.environ.get("DATABLIST_API_KEY")
if not api_key:
raise RuntimeError("Lege DATABLIST_API_KEY fest, bevor du das Skript ausführst.")
personal_email_results = find_personal_emails(candidates, api_key)
for result in personal_email_results:
print(json.dumps(result, indent=2))Führe die Datei im selben Terminal aus:
python find_personal_emails.pyDu kannst auch das gepflegte synchrone Requests-Beispiel herunterladen. Das obige Skript verwendet dieselbe Abfolge aus Absenden, Statusabfrage und Paginierung und nutzt dabei die Kandidaten-IDs aus den Quelldatensätzen.
Suchanfrage absenden
Die Funktion wandelt jeden Kandidaten in einen API-Input um. inputId erhält die stabile Kandidaten-ID und data.profileUrl die öffentliche URL des persönlichen LinkedIn-Profils. Erforderlich ist eine normale URL im Format linkedin.com/in/.... Sales-Navigator-URLs, Unternehmensseiten, leere Werte und Namen ohne Profil-URL sind für dieses Enrichment keine gültigen Inputs.
Die Anfrage verwendet waterfall-personal-email-finder als enrichmentId und ein leeres settings-Objekt, wie in der Dokumentation zur Waterfall Personal Email Finder API gezeigt. Vor dem Absenden gibt das Skript die generierte uniqueId aus. Bewahre diesen Wert auf: Damit kannst du einen vorhandenen Task identifizieren, falls die Verbindung abbricht, nachdem die API deine Anfrage angenommen hat.
Hier siehst du den vollständigen Request Body für das Beispiel mit einem Profil:
{
  "enrichmentId": "waterfall-personal-email-finder",
  "uniqueId": "55001d29-4fb9-4fe2-9497-80f4b346eed7",
  "settings": {},
  "inputs": [
    {
      "inputId": "candidate-florian-poullin",
      "data": {
        "profileUrl": "https://www.linkedin.com/in/florianpoullin/"
      }
    }
  ]
}
Bei erfolgreicher Übermittlung erhältst du HTTP 202 Accepted und die Task-ID im Feld @id. Die Verarbeitung läuft nach dieser Antwort auf den Servern von Datablist weiter.
Auf den Hintergrund-Task warten
Das Requests-Skript blockiert die lokale Ausführung, während der Server den Hintergrund-Task verarbeitet. Es prüft den Task alle drei Sekunden und wartet weiter, solange der Status queued oder running lautet. Bei einem Task mit dem Status completed beginnt der Abruf der Ergebnisse. Ein Task mit failed oder stopped löst einen Fehler aus, der die Task-ID und die verfügbare Fehlermeldung enthält.
Alle Ergebnisseiten abrufen
Der Ergebnis-Endpunkt gibt für jede Zeile die Quell-ID, den Status, die Outputs, die Credits und mögliche Fehler zurück. Die erste Anfrage ruft bis zu 100 Ergebnisse ab. Anschließend lädt sie weitere Seiten, bis nextCursor den Wert null hat.
Die Task-Ergebnisse behalten die Reihenfolge der Inputs bei. Über inputId bleibt jedes Ergebnis außerdem eindeutig mit seinem Kandidatendatensatz verknüpft – auch über mehrere Ergebnisseiten hinweg.
Wenn du das Beispiel für mehr Datensätze anpasst, sollte jede candidate_id aus dem Quellsystem unverändert bleiben. So lässt sich die Verknüpfung auch dann zuverlässig herstellen, wenn ein Task mehrere Ergebnisseiten umfasst.
So findet die Personal-Email-Waterfall ein Ergebnis
Datablist bereinigt die übermittelte öffentliche LinkedIn-Profil-URL und leitet das noch nicht aufgelöste Profil nacheinander an die aktuell verfügbaren Anbieter für private E-Mail-Adressen weiter. Liefert ein Anbieter keine brauchbare Adresse, kann das Profil an den nächsten geeigneten Anbieter übergeben werden. Sobald ein Anbieter eine verwendbare E-Mail-Adresse findet, endet die Abfolge für dieses Profil und die Adresse wird als outputs.emailFound zurückgegeben.
Datablist verwaltet die verfügbaren Anbieter. Deine Integration benötigt daher weder anbieterspezifische Anfragen noch eigenen Fallback-Code. Das öffentliche Ergebnis zeigt das Resultat der E-Mail-Suche, aber keine feste Reihenfolge der Anbieter oder Historie einzelner Suchversuche.
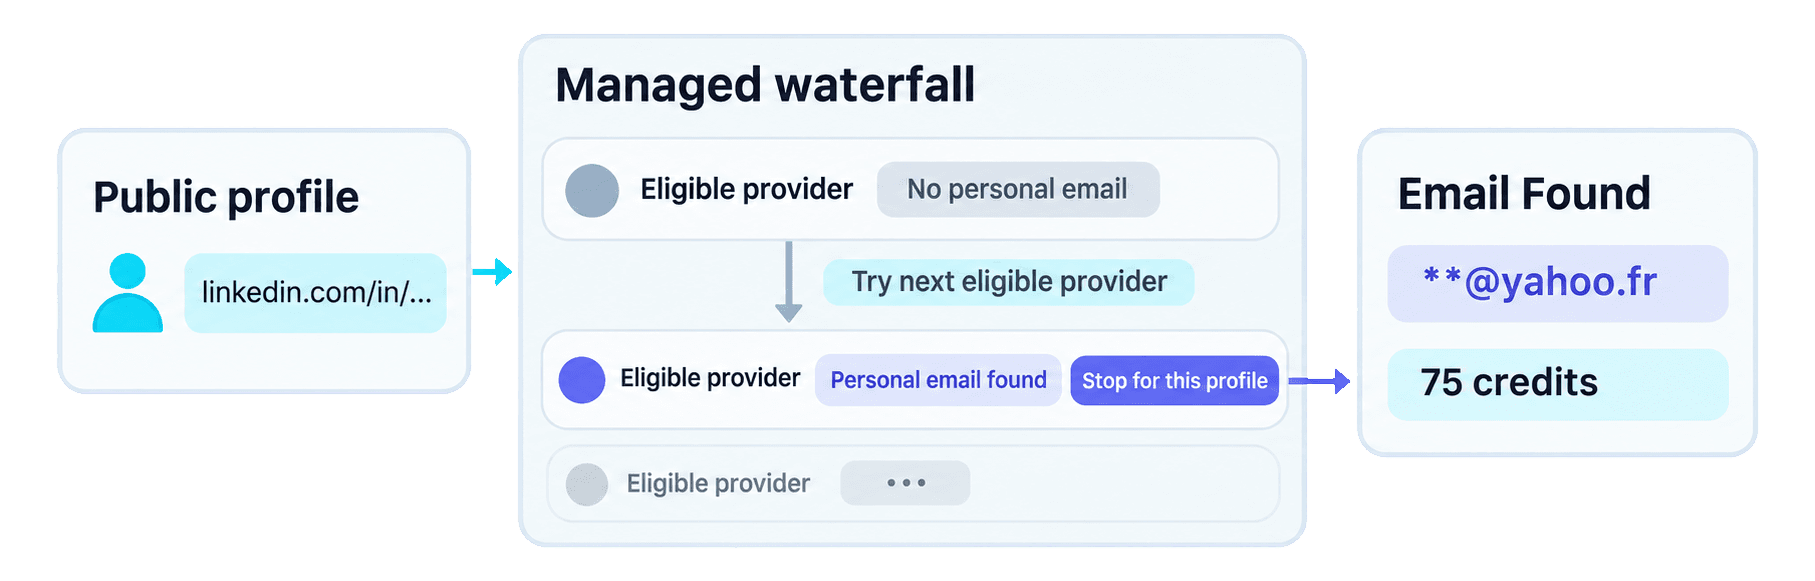
Die Waterfall ist die Suchmethode. Das Polling erfüllt einen anderen Zweck: Es lässt den Python-Client warten, bis die Verarbeitung im Hintergrund abgeschlossen ist.
Vorteile der Waterfall für internationale Recruiting-Teams
Anbieter privater E-Mail-Adressen greifen auf unterschiedliche Datenbestände zurück. Ihre Stärken unterscheiden sich deshalb je nach Land und Markt. Findet der erste Anbieter keine E-Mail-Adresse für einen Kandidaten, kann ein anderer Anbieter in der Waterfall erfolgreich sein.
Recruiting-Teams, die in mehreren Ländern aktiv sind, erhalten über eine einzige API-Integration eine breitere Anbieterabdeckung. Datablist verwaltet die Abfolge. So kann das Team Kontakte finden, die bei der Suche mit nur einem Anbieter möglicherweise unentdeckt blieben, ohne mehrere Anbieter-APIs anbinden und pflegen zu müssen.
Vollständiges Ergebnis auslesen
📘 Maskierte E-Mail-Adresse: Der lokale Teil der Adresse wird unten durch
**ersetzt. Dein API-Ergebnis enthält den vollständigen Wert.
Hier siehst du die vollständige Ergebnisseite für den Kandidaten-Input:
{
  "taskId": "b5de73ffaa3f4f349c125d7c85125bb4",
  "results": [
    {
      "inputId": "candidate-florian-poullin",
      "status": "success",
      "outputs": {
        "emailFound": "**@yahoo.fr"
      },
      "creditsUsed": "75",
      "error": null
    }
  ],
  "nextCursor": null
}
Die inputId ist der Join-Key zum ursprünglichen Kandidatendatensatz. outputs.emailFound enthält die private Adresse. creditsUsed zeigt die verbindlich abgerechneten Credits für diese Zeile, und error: null bedeutet, dass die API keinen Fehler auf Zeilenebene zurückgegeben hat. Der Cursor mit dem Wert null bestätigt, dass keine weitere Ergebnisseite vorhanden ist.
Betrachte die Adresse als Kontaktmöglichkeit, die mit dem übermittelten Profil verknüpft ist, und prüfe sie, bevor du sie im Recruiting einsetzt.
Kandidatenkontakte für Recruiter vorbereiten
Sobald die Suche abgeschlossen ist, kannst du ohne weitere API-Anfrage eine lokale Liste zur Prüfung durch Recruiter erstellen. Der folgende Block verwendet die vorhandenen Variablen candidates und personal_email_results erneut:
results_by_id = {
result["inputId"]: result for result in personal_email_results
}
prepared_contacts = []
for candidate in candidates:
result = results_by_id.get(candidate["candidate_id"])
if not result or result.get("status") != "success":
continue
email_found = result.get("outputs", {}).get("emailFound")
if not email_found:
continue
prepared_contact = candidate.copy()
prepared_contact["result"] = result
prepared_contacts.append(prepared_contact)
print(json.dumps(prepared_contacts, indent=2))Für candidate-florian-poullin findet die Dictionary-Abfrage das Ergebnis mit derselben inputId. Der kopierte Datensatz behält den Namen Florian Poullin, die LinkedIn-URL und die beispielhafte Zielposition Backend Engineer. Anschließend wird das vollständige API-Objekt unter result angehängt. Dort kann der Recruiter die Adresse über result.outputs.emailFound auslesen.
Die Schleife beginnt mit der ursprünglichen Kandidatenliste. Ein späterer Datensatz ohne Treffer, mit einem Zeilenfehler, einem fehlenden Ergebnis oder einem leeren emailFound verändert diese Quellliste nicht und wird nicht in prepared_contacts aufgenommen.
Mehr über einen umfassenderen Prüfprozess und weitere Kontaktkanäle erfährst du in der Anleitung zum Finden der E-Mail-Adresse eines Kandidaten als Recruiter.
Kosten der Personal Email Finder API berechnen
Jede gefundene private E-Mail-Adresse kostet 75 Credits. Eine Suche ohne Ergebnis kostet 0 Credits. Um die tatsächlichen Kosten zu ermitteln, solltest du creditsUsed für jedes Ergebnis auslesen, statt die Gesamtzahl der übermittelten Profile zu multiplizieren.
Die Formel für deine Planung lautet:
gefundene private E-Mail-Adressen × 75 Credits
Wenn du beispielsweise 100 Profile übermittelst und für 20 davon eine private E-Mail-Adresse gefunden wird, verbraucht der Task 20 × 75 = 1.500 Credits. Diese Rechnung dient nur der Planung und stellt keine erwartete Trefferquote dar. Bei größeren Volumen kosten 100 gefundene E-Mail-Adressen 7.500 Credits und 1.000 gefundene E-Mail-Adressen 75.000 Credits.
Beim aktuellen Basispreis für das Aufladen in US-Dollar gilt: $20 / 20.000 Credits = $0,001 pro Credit. Eine gefundene E-Mail-Adresse verbraucht damit Credits im Wert von $0,075, 100 gefundene Adressen entsprechen $7,50. Diese Schätzung bewertet nur die verbrauchten Credits. Das für den REST-API-Zugriff erforderliche Growth-Abo wird separat berechnet. Aktuelle Tarife und Credit-Pakete findest du auf der Seite Datablist Preise.
Häufige Fehler beheben und Tasks wiederherstellen
Die meisten Probleme treten vor dem Absenden, bei der HTTP-Anfrage oder in einem einzelnen Ergebnis auf. Wo der Fehler auftritt, bestimmt deinen nächsten Schritt:
DATABLIST_API_KEYfehlt: Das Skript stoppt lokal, bevor es eine Anfrage sendet. Exportiere die Umgebungsvariable und führe die Datei erneut aus.- HTTP-Authentifizierung fehlgeschlagen: Prüfe den Personal API Key in
DATABLIST_API_KEY. Die Funktion sendet ihn im HeaderX-API-Key. Korrigiere die Zugangsdaten, bevor du eine neue Anfrage übermittelst. - Nicht unterstützte Profil-URL: Ersetze eine Sales-Navigator-URL, Unternehmensseite, einen leeren Wert oder eine fehlerhafte URL durch ein öffentliches persönliches Profil im Format
linkedin.com/in/.... - Nicht genügend Credits: Prüfe deinen Kontostand und die verfügbaren Credits, bevor du weitere Tasks startest.
- Task hat den Status
failedoderstopped: Prüfe den Task-Fehler, die verfügbaren Ergebnisse und den Credit-Verbrauch, bevor du entscheidest, was erneut ausgeführt werden muss. - Eine Zeile enthält kein Ergebnis oder einen Fehler: Behalte den ursprünglichen Kandidatendatensatz zur Prüfung oder für einen anderen Kontaktkanal. Eine erfolglose Suche verrät nicht, warum keine Adresse verfügbar war.
Falls die Antwort auf den POST-Request verloren geht, solltest du deine Tasks auflisten, bevor du einen neuen erstellst. Suche in der Antwort nach der vom Skript ausgegebenen uniqueId und kopiere anschließend die @id des passenden Tasks:
curl "https://api.datablist.com/v1/enrichments/tasks?enrichmentId=waterfall-personal-email-finder&limit=100" \
--header "X-API-Key: $DATABLIST_API_KEY"
TASK_ID='paste-matching-task-id'
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID" \
--header "X-API-Key: $DATABLIST_API_KEY"
curl "https://api.datablist.com/v1/enrichments/tasks/$TASK_ID/results" \
--header "X-API-Key: $DATABLIST_API_KEY"Wenn der passende Task nicht in der ersten Antwort des Task-Verlaufs erscheint, folge dem zurückgegebenen Pagination-Cursor und prüfe die nächste Seite. Frage den wiederhergestellten Task weiter ab oder rufe seine verfügbaren Ergebnisse ab, anstatt automatisch einen weiteren kostenpflichtigen Task zu erstellen. Die Task-Dokumentation erklärt den Lebenszyklus, die Paginierung und die Aufbewahrung von Ergebnissen.
Nächste Schritte
Du hast jetzt eine wiederverwendbare Python-Requests-Funktion für öffentliche LinkedIn-Profil-URLs sowie eine Zusammenführung über stabile IDs, die gefundene private E-Mail-Adressen mit dem jeweiligen Kontext aus dem Kandidatendatensatz verknüpft.
Ersetze die Beispielliste durch eine kleine Auswahl deiner eigenen Kandidatendatensätze und behalte für jeden Datensatz eine stabile ID sowie die Zielposition bei. Prüfe anschließend jeden vorbereiteten Kontakt, bevor du ihn in deinem Recruiting-Prozess verwendest. Benötigt deine Anwendung nicht blockierende Parallelität, ist das gepflegte async HTTPX-Beispiel der passende nächste Implementierungsschritt.