
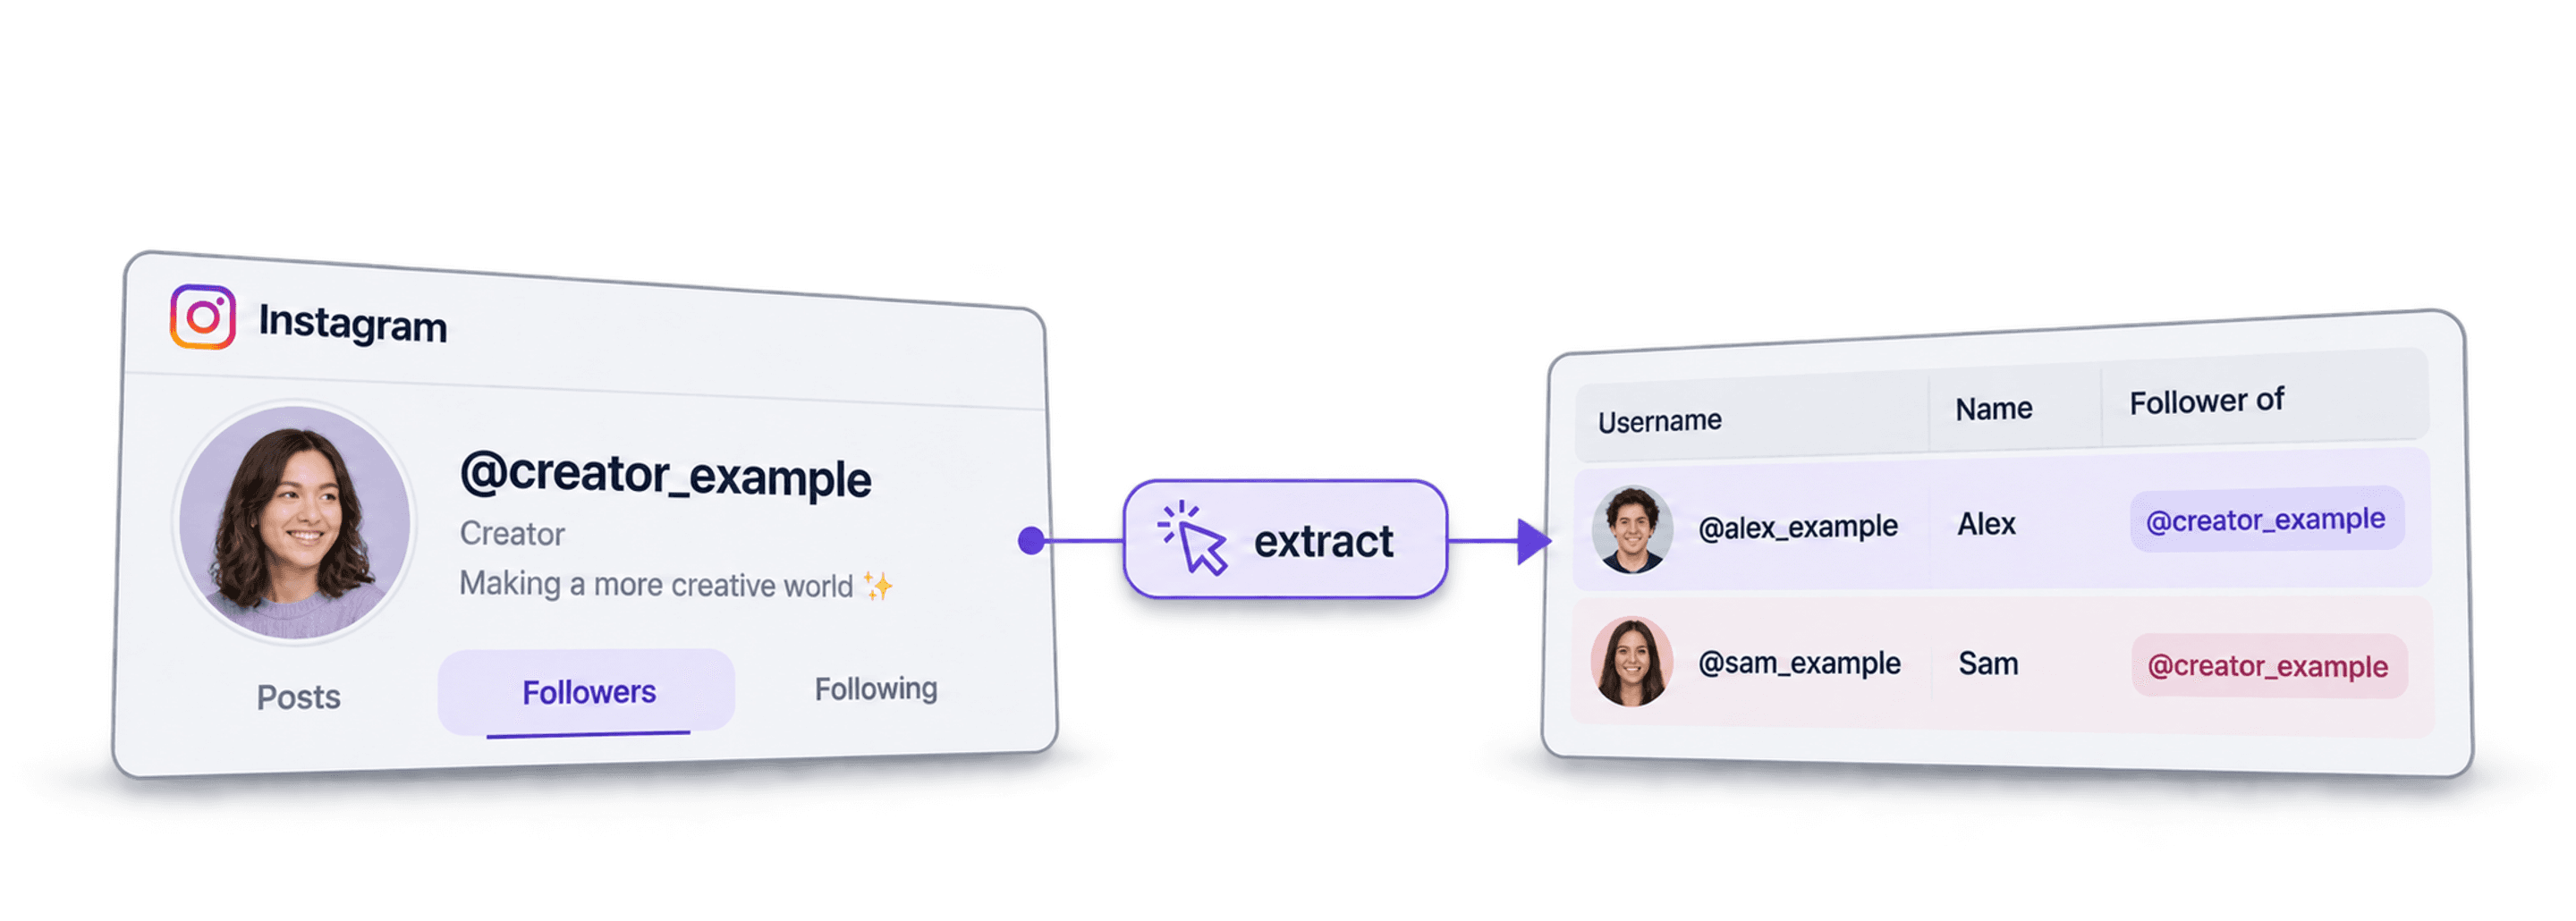
Um Instagram-Follower zu scrapen, öffnest Du in Datablist die Quelle Instagram Followers/Following Scraper. Gib eine öffentliche Profil-URL, einen Benutzernamen oder eine User ID ein, lege ein Limit pro Profil fest und prüfe die ausgegebenen Follower-Zeilen, bevor Du sie exportierst.
Ich würde mit einem Profil und einem kleinen Limit starten. Die ausgegebene Liste ist eine Momentaufnahme der Accounts, die der Anbieter abrufen konnte – keine Garantie für eine vollständige, aktuelle Follower-Liste des Profils. Dass jemand einem Nischen-Influencer folgt, sagt außerdem nichts Verlässliches über Beruf, Standort oder Kaufbereitschaft aus.
Dieser Guide erklärt die Einstellungen der Quelle, die Beziehungsfelder in der Ausgabe, die Prüfung und Deduplizierung, das Fortsetzen eines größeren Scrapes sowie die separate Anreicherung mit Profildetails. Deine Instagram-Zugangsdaten brauchst Du dafür nicht.
📌 Schneller Workflow
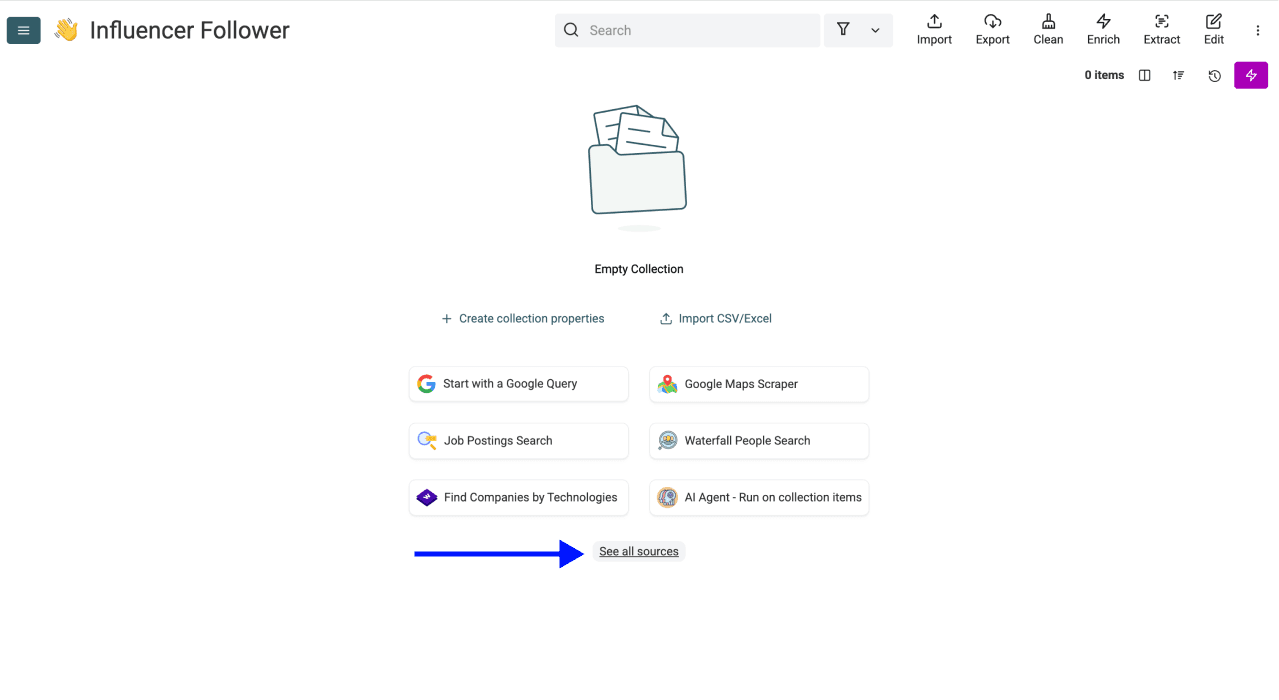
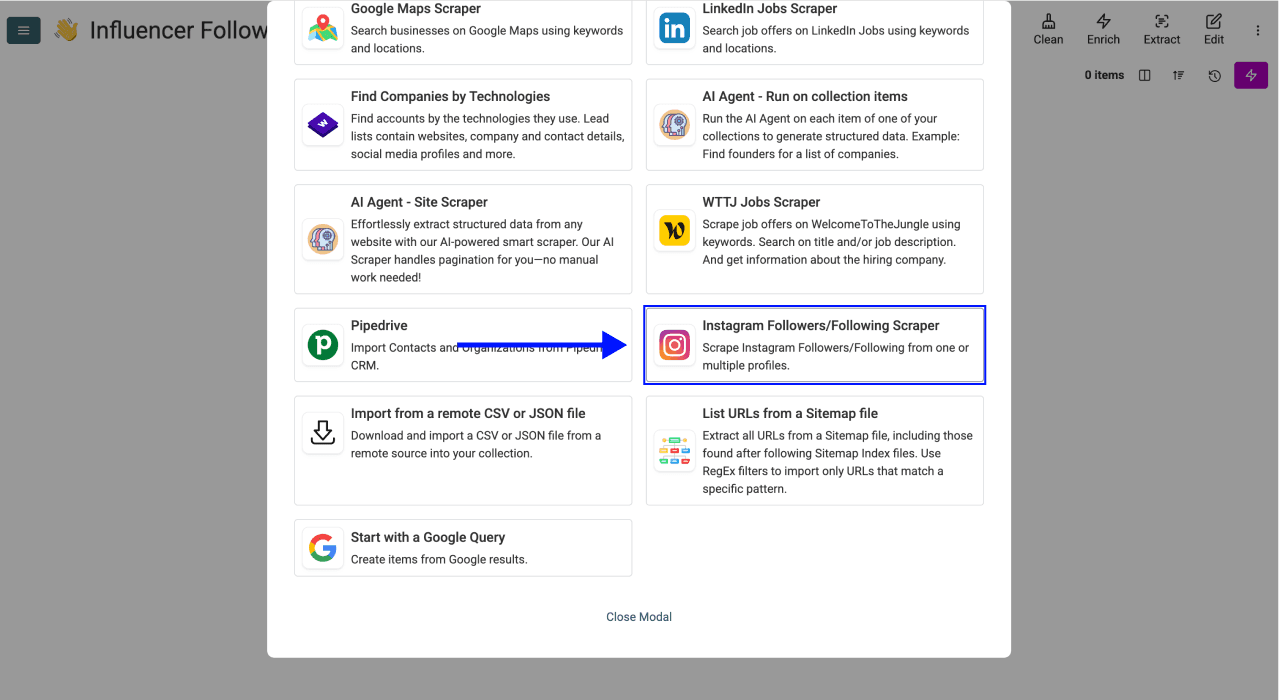
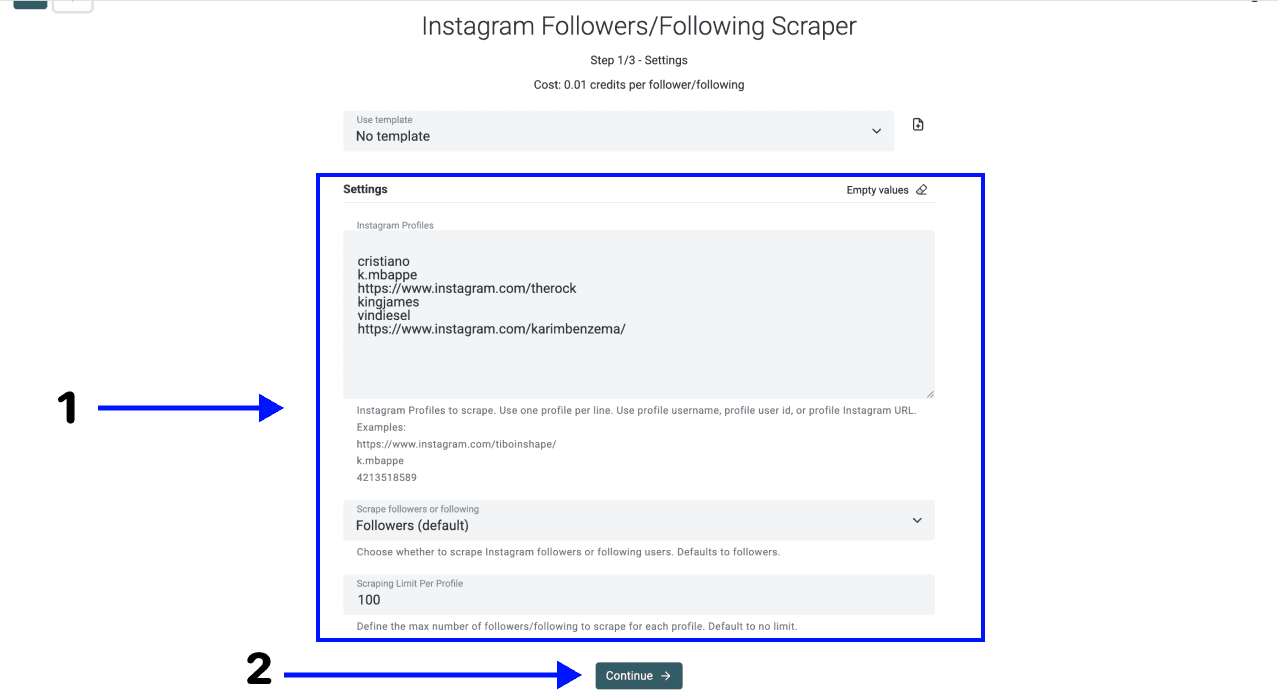
Erstelle eine Collection, öffne See all sources und wähle Instagram Followers/Following Scraper. Trage unter Instagram Profiles ein Profil pro Zeile ein, behalte unter Scrape followers or following die Option Followers (default) bei und lege das Scraping Limit Per Profile fest. Füge Follower-Kennungen und Ausgabefelder des Quellprofils hinzu, führe einen Testlauf durch und prüfe und exportiere anschließend das Ergebnis.
Was kostet das Scrapen von Instagram-Followern?
Das Extrahieren der Follower-Liste kostet 0,01 Credits pro ausgegebenem Follower. Das Auflösen des Quellprofils kann zusätzlich 1 Credit kosten, wenn dessen Kennung nicht im Cache liegt. Die Anreicherung mit Profildetails wird separat berechnet.
Nehmen wir als Beispiel an, dass ein Quellprofil genau 1.000 Follower-Zeilen ausgibt:
- Follower-Liste: 1.000 × 0,01 = 10 Credits, plus 1 Credit für die nicht zwischengespeicherte Suche nach dem Quellprofil: 11 Credits.
- Details für 100 ausgewählte Follower: Mit den ausgegebenen User-Id-Werten kostet die Standardsuche nach Profildaten jeweils 2 Credits: 200 Credits. Diese Option kann öffentliche E-Mail-Adressen und Telefonnummern ausgeben, sofern vorhanden; beides ist jedoch nicht garantiert.
- Gesamt: 211 Credits für die Liste und die 100 Profilabfragen. Wenn Du About-Daten hinzufügst oder einen anderen Scraping Type auswählst, ändern sich die Kosten der Anreicherung.
Bei monatlicher Abrechnung in USD kostet Starter 25 $ und umfasst 5.000 Credits. Wenn dieses Kontingent noch ungenutzt ist, brauchst Du für das Beispiel kein Top-up und hast danach noch 4.789 Credits. Die 25 $ sind der Zahlbetrag für das Abo; 211 Credits entsprechen der Nutzung durch den Workflow. Credits haben nicht in allen Tarifen und Top-up-Paketen denselben festen Dollarwert.
Verwende für diese Profilanreicherung die ausgegebene User Id. Ein Benutzername oder eine URL kann eine weitere Abfrage der Kennung erfordern. Prüfe nach dem Testlauf die tatsächlich ausgegebenen Zeilen und den Credit-Verbrauch. Anbieterseiten können ein kleines angefordertes Limit überschreiten, und eine Profilabfrage kann Credits verbrauchen, selbst wenn keine Follower-Zeilen ausgegeben werden. Das angeforderte Limit ist daher keine exakte Kostenobergrenze.
Datablist im kurzen Überblick
Datablist ist ein Workspace im Tabellenformat für Lead-Generation-Workflows. Du kannst Zeilen mithilfe von Enrichments erfassen, prüfen, anreichern und exportieren – von AI Agents und Email Finders über AI processors bis hin zu Technology enrichments und mehr.
Außerdem kannst Du mit Datablist automatisierte Workflows einrichten, die nach Zeitplan oder bei Bedarf ausgeführt werden. Diese praktischen Anwendungsfälle sind bei Datablist-Nutzern besonders beliebt:
- Lead-Listen erstellen
- E-Mails mit AI personalisieren
- CRMs bereinigen und deduplizieren
- Stellenanzeigen scrapen
- Leads aus dem Sales Navigator scrapen
Instagram-Follower günstig scrapen: Schritt für Schritt
Legen wir los. Öffne zunächst Datablist und konfiguriere, was Du scrapen möchtest. Füge also die Profil-URLs oder Benutzernamen der Influencer ein, deren Follower Du erfassen willst.
Richte zuerst einen Testlauf ein. Vergrößere ihn erst, nachdem Du das Quellprofil und die ausgegebenen Felder geprüft hast. Für diesen Workflow brauchst Du weder eine Browser-Erweiterung noch einen eigenen API-Key des Anbieters.
📘 Wichtig: private Profile
Die Follower-Liste eines privaten Profils ist über diesen Workflow nicht verfügbar. Beim Auflösen eines Profils kann ein Lauf Credits verbrauchen, auch wenn keine Follower-Zeilen ausgegeben werden. Die Anreicherung mit Profildetails ist eine separate Abfrage und gewährt keinen Zugriff auf private Posts oder Follower-Listen.
Schritt 1: Bei Datablist.com registrieren
Gehe zu Datablist.com und erstelle einen Account. Folge der Kontoeinrichtung, um Deinen Workspace zu öffnen.
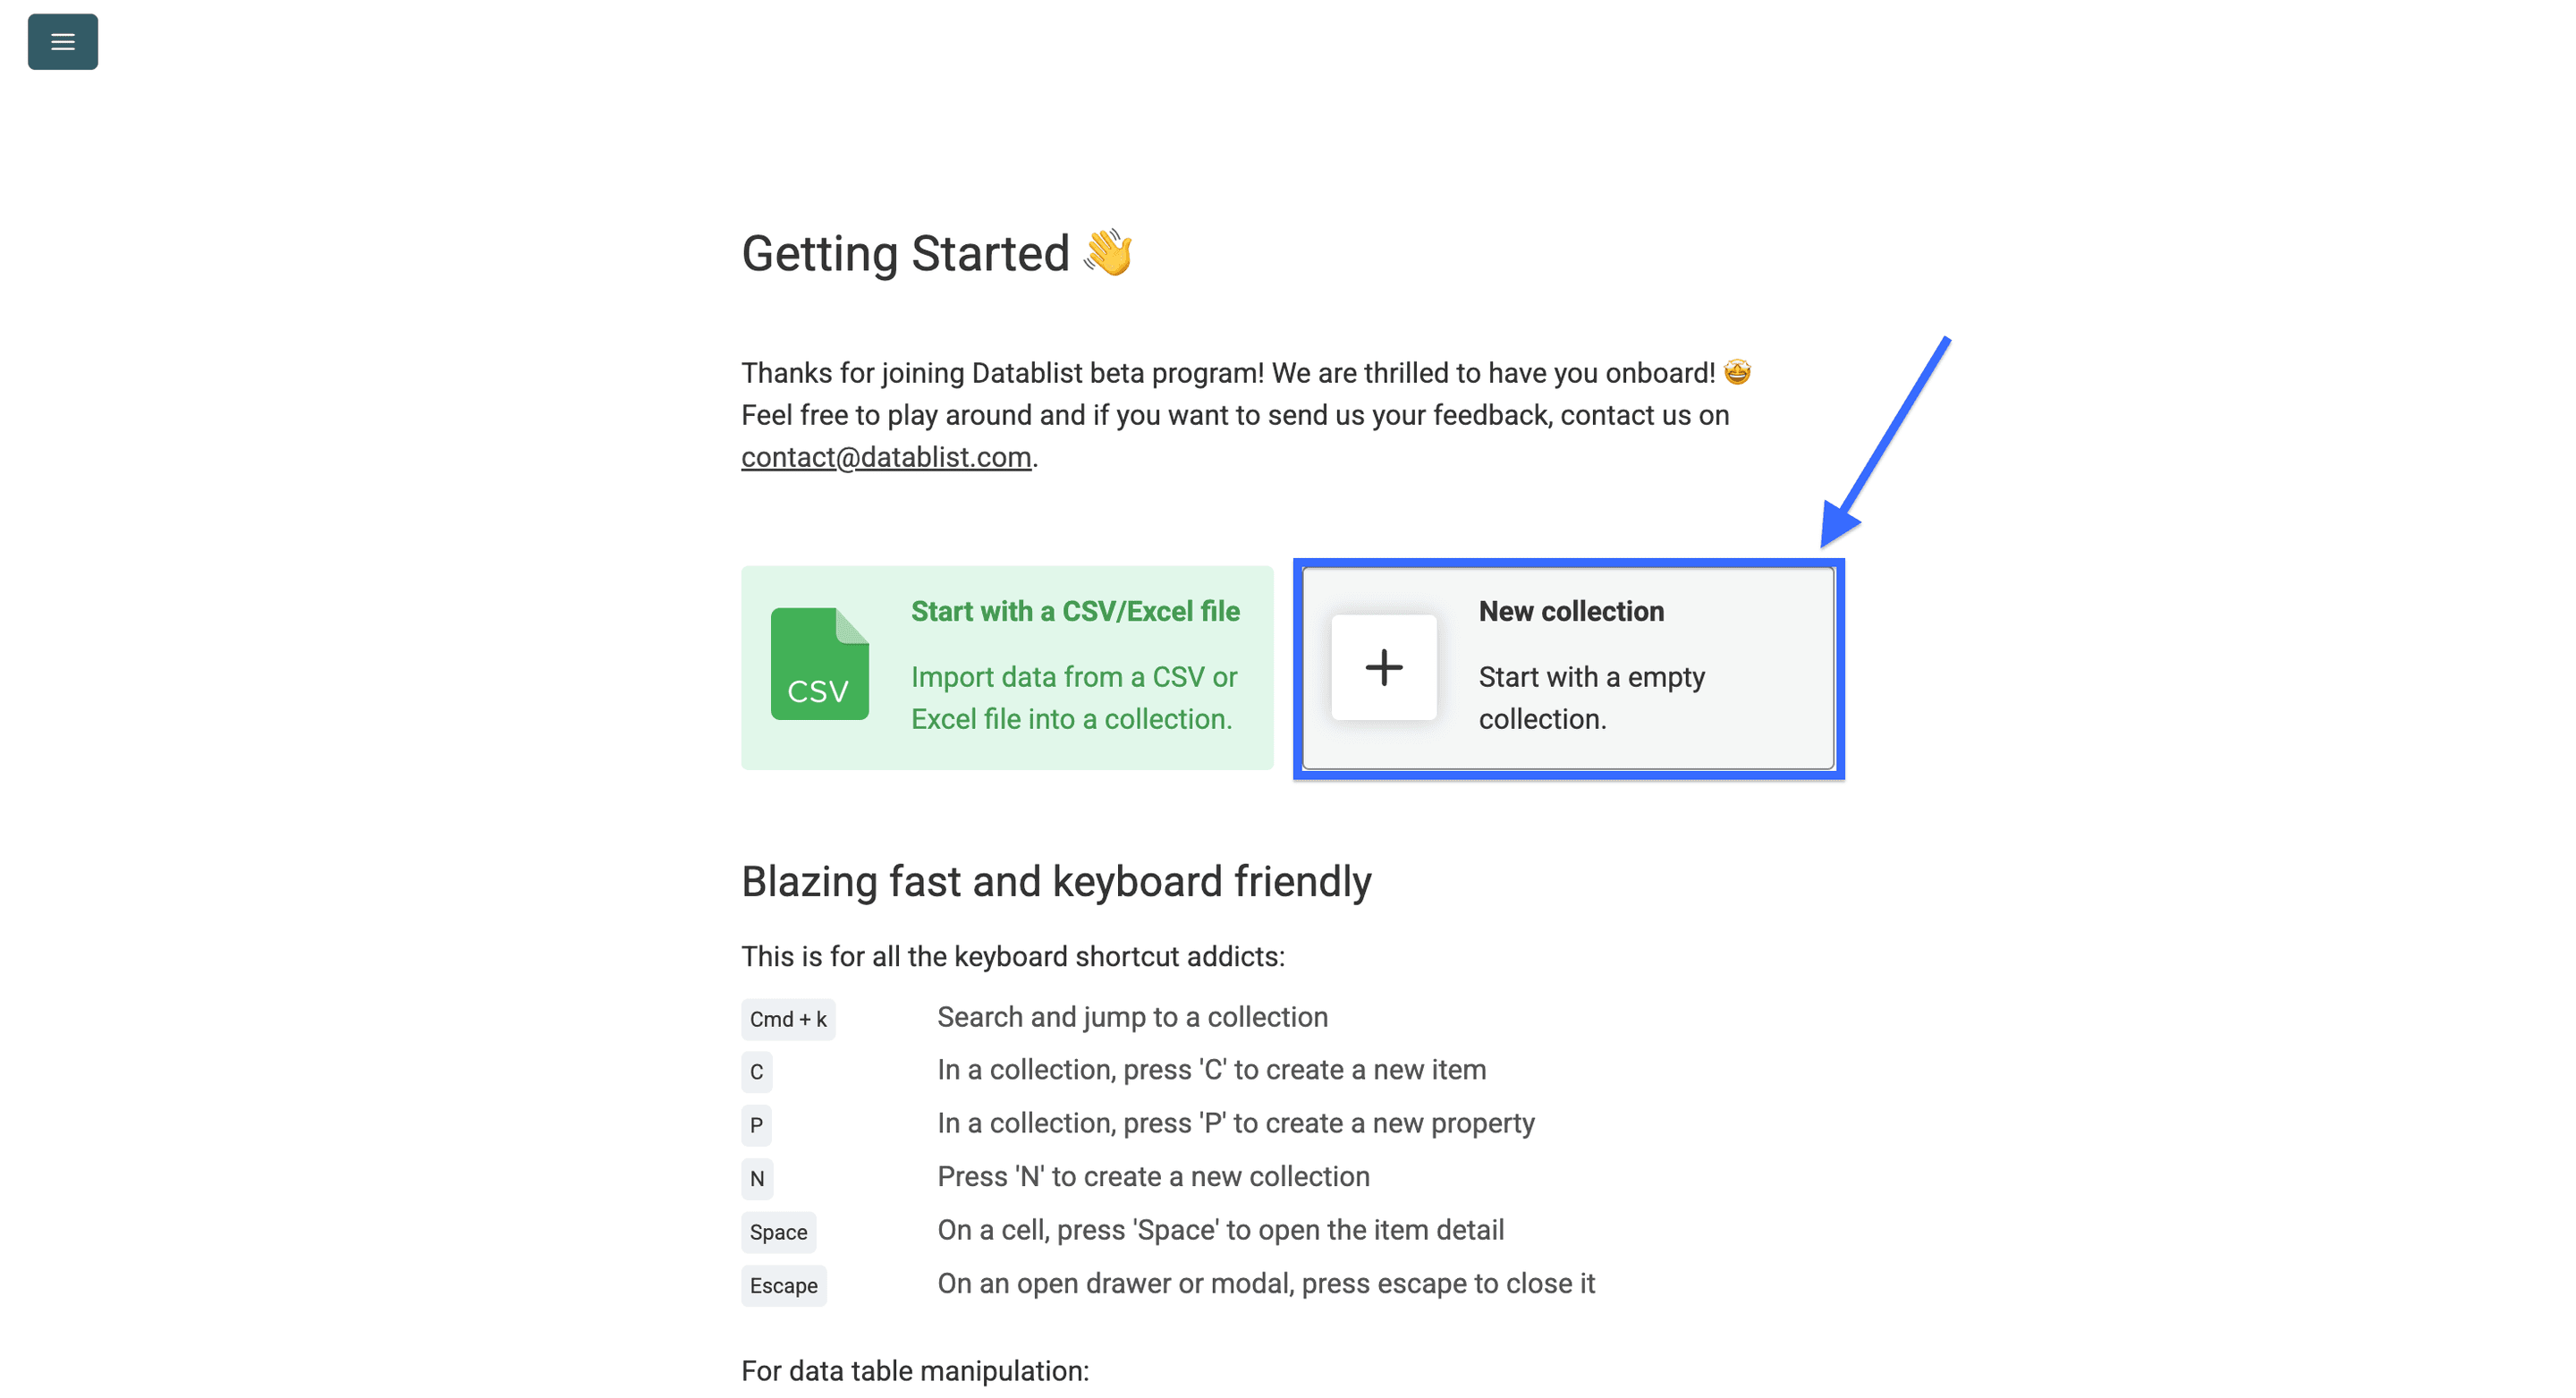
Schritt 2: Eine neue Collection erstellen
Sobald Du angemeldet bist, klickst Du auf New Collection.
Schritt 3: Instagram Followers/Following Scraper öffnen
Klicke auf See all sources.
Scrolle nach unten und wähle Instagram Followers/Following Scraper aus der Liste aus.
Schritt 4: Einstellungen konfigurieren
Jetzt siehst Du eine übersichtliche Konfigurationsseite. So erzielst Du die besten Ergebnisse:
- Trage unter Instagram Profiles pro Zeile eine öffentliche Profil-URL, einen Benutzernamen oder eine User ID ein. Prüfe, ob jede Kennung zum gewünschten Account gehört.
- Wähle unter Scrape followers or following die Option Followers (default). Nutze Following nur, wenn Du die Accounts erfassen möchtest, denen das eingegebene Profil folgt.
- Stelle für Scraping Limit Per Profile zunächst eine kleine Stichprobe ein, bevor Du den Lauf erweiterst. Ein Limit garantiert keine vollständige Liste.
- Klicke auf Continue und konfiguriere die Ausgabespalten.
Schritt 5: Ausgabefelder auswählen
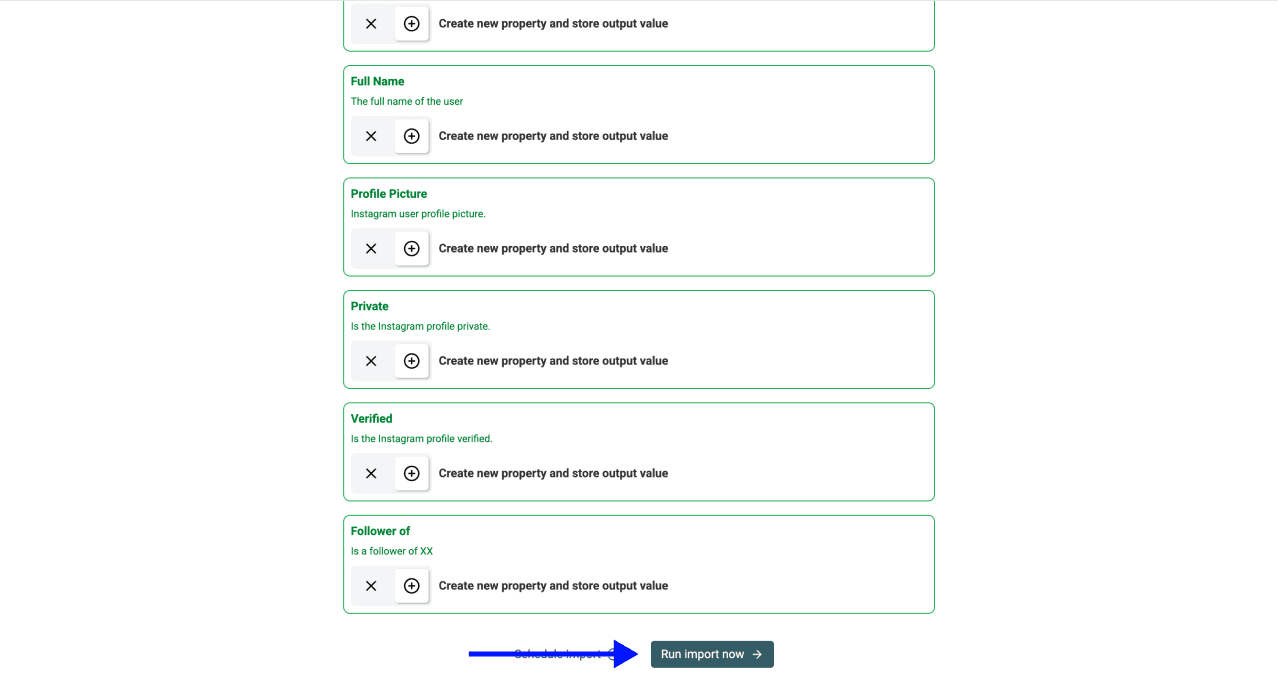
Datablist zeigt Dir die verfügbaren Ausgabefelder. Behalte die Felder User Id, User Username und User Profile URL des Followers sowie die Felder des Quellprofils. So kannst Du prüfen, für wen eine Zeile steht und aus welchem Eingabeprofil sie stammt.
Klicke auf die ✕-Symbole, um nicht benötigte Felder zu entfernen. Klicke danach auf Run import now.
Schritt 6: Ergebnisse abrufen
Vergleiche nach Abschluss des Quelllaufs die ausgegebenen Zeilen mit Deinem angeforderten Limit und kontrolliere den Status. Die Dauer hängt von den Antworten des Anbieters, der Paginierung, dem Profil und dem Umfang des Laufs ab. Eine geringe Zeilenzahl bedeutet nicht automatisch, dass das Profil keine weiteren Follower hat.
Hinweis: Die Ergebnisse enthalten auch die vollständigen Namen. Zum Schutz der Privatsphäre haben wir sie im folgenden Bild ausgeblendet.
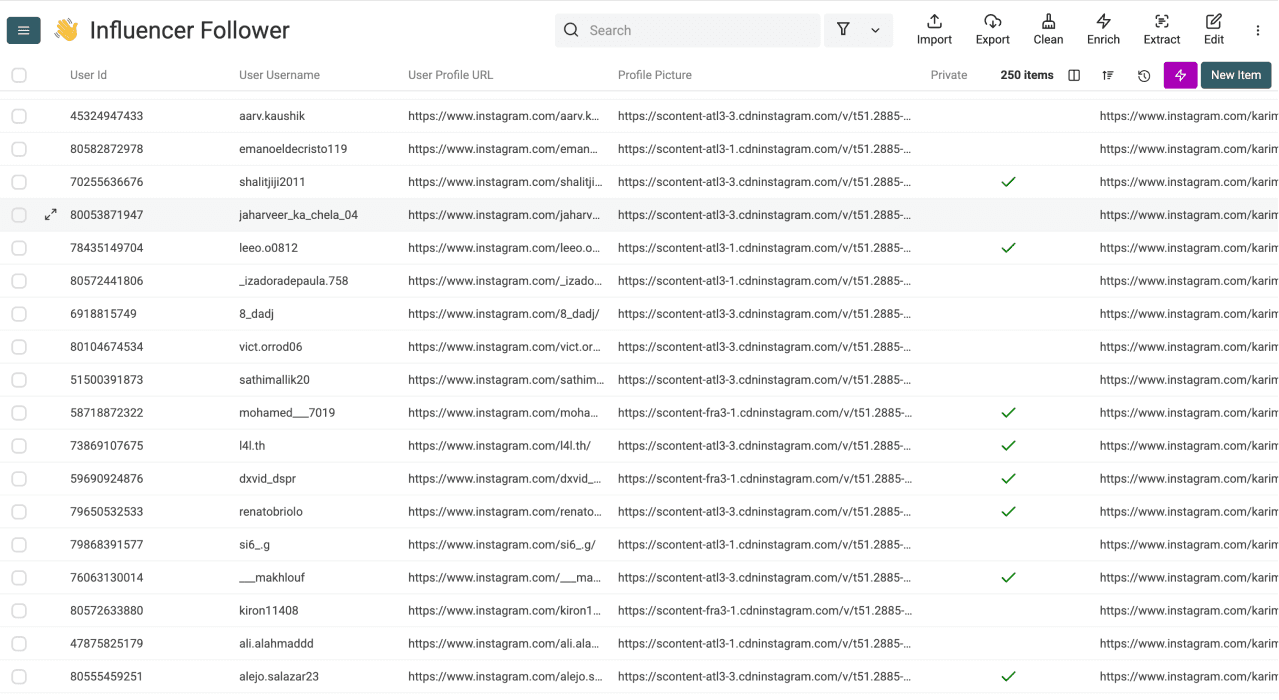
Behalte bei mehreren Eingabeprofilen Follower of (UserId), Follower of (Username) oder Follower of (ProfileUrl). Nutze diese Felder, um Beziehungen nach Quell-Account zu filtern, statt Dich auf die Position der Spalten zu verlassen.
💡 Gut zu wissen: große Scrapes
Der Quelllauf hat eigene Paginierungs- und Zeilenlimits. Diese sind von der Speicherkapazität der Collection und der Cloud-Synchronisierung unabhängig. Wenn ein Lauf endet, obwohl weitere Ergebnisse verfügbar sind, nutze die unten beschriebene Fortsetzungsoption. Gehe nicht davon aus, dass alle übrigen Follower in denselben Lauf passen.
Schritt 7: Follower mit Profildetails anreichern
Eine Follower-Liste ist erst der Anfang. Um aus den Benutzernamen verwertbare Leads zu machen, musst Du wissen, wer dahintersteckt. Mit dem Instagram Profile Scraper kannst Du Deine Liste um öffentliche Daten wie E-Mail-Adressen, Bios und Engagement-Kennzahlen ergänzen.
Beim Aufbau von Lead-Listen solltest Du Profildetails als Beleg für die Segmentierung verwenden. Eine Follower-Beziehung allein ist kein verlässliches Qualifizierungskriterium.
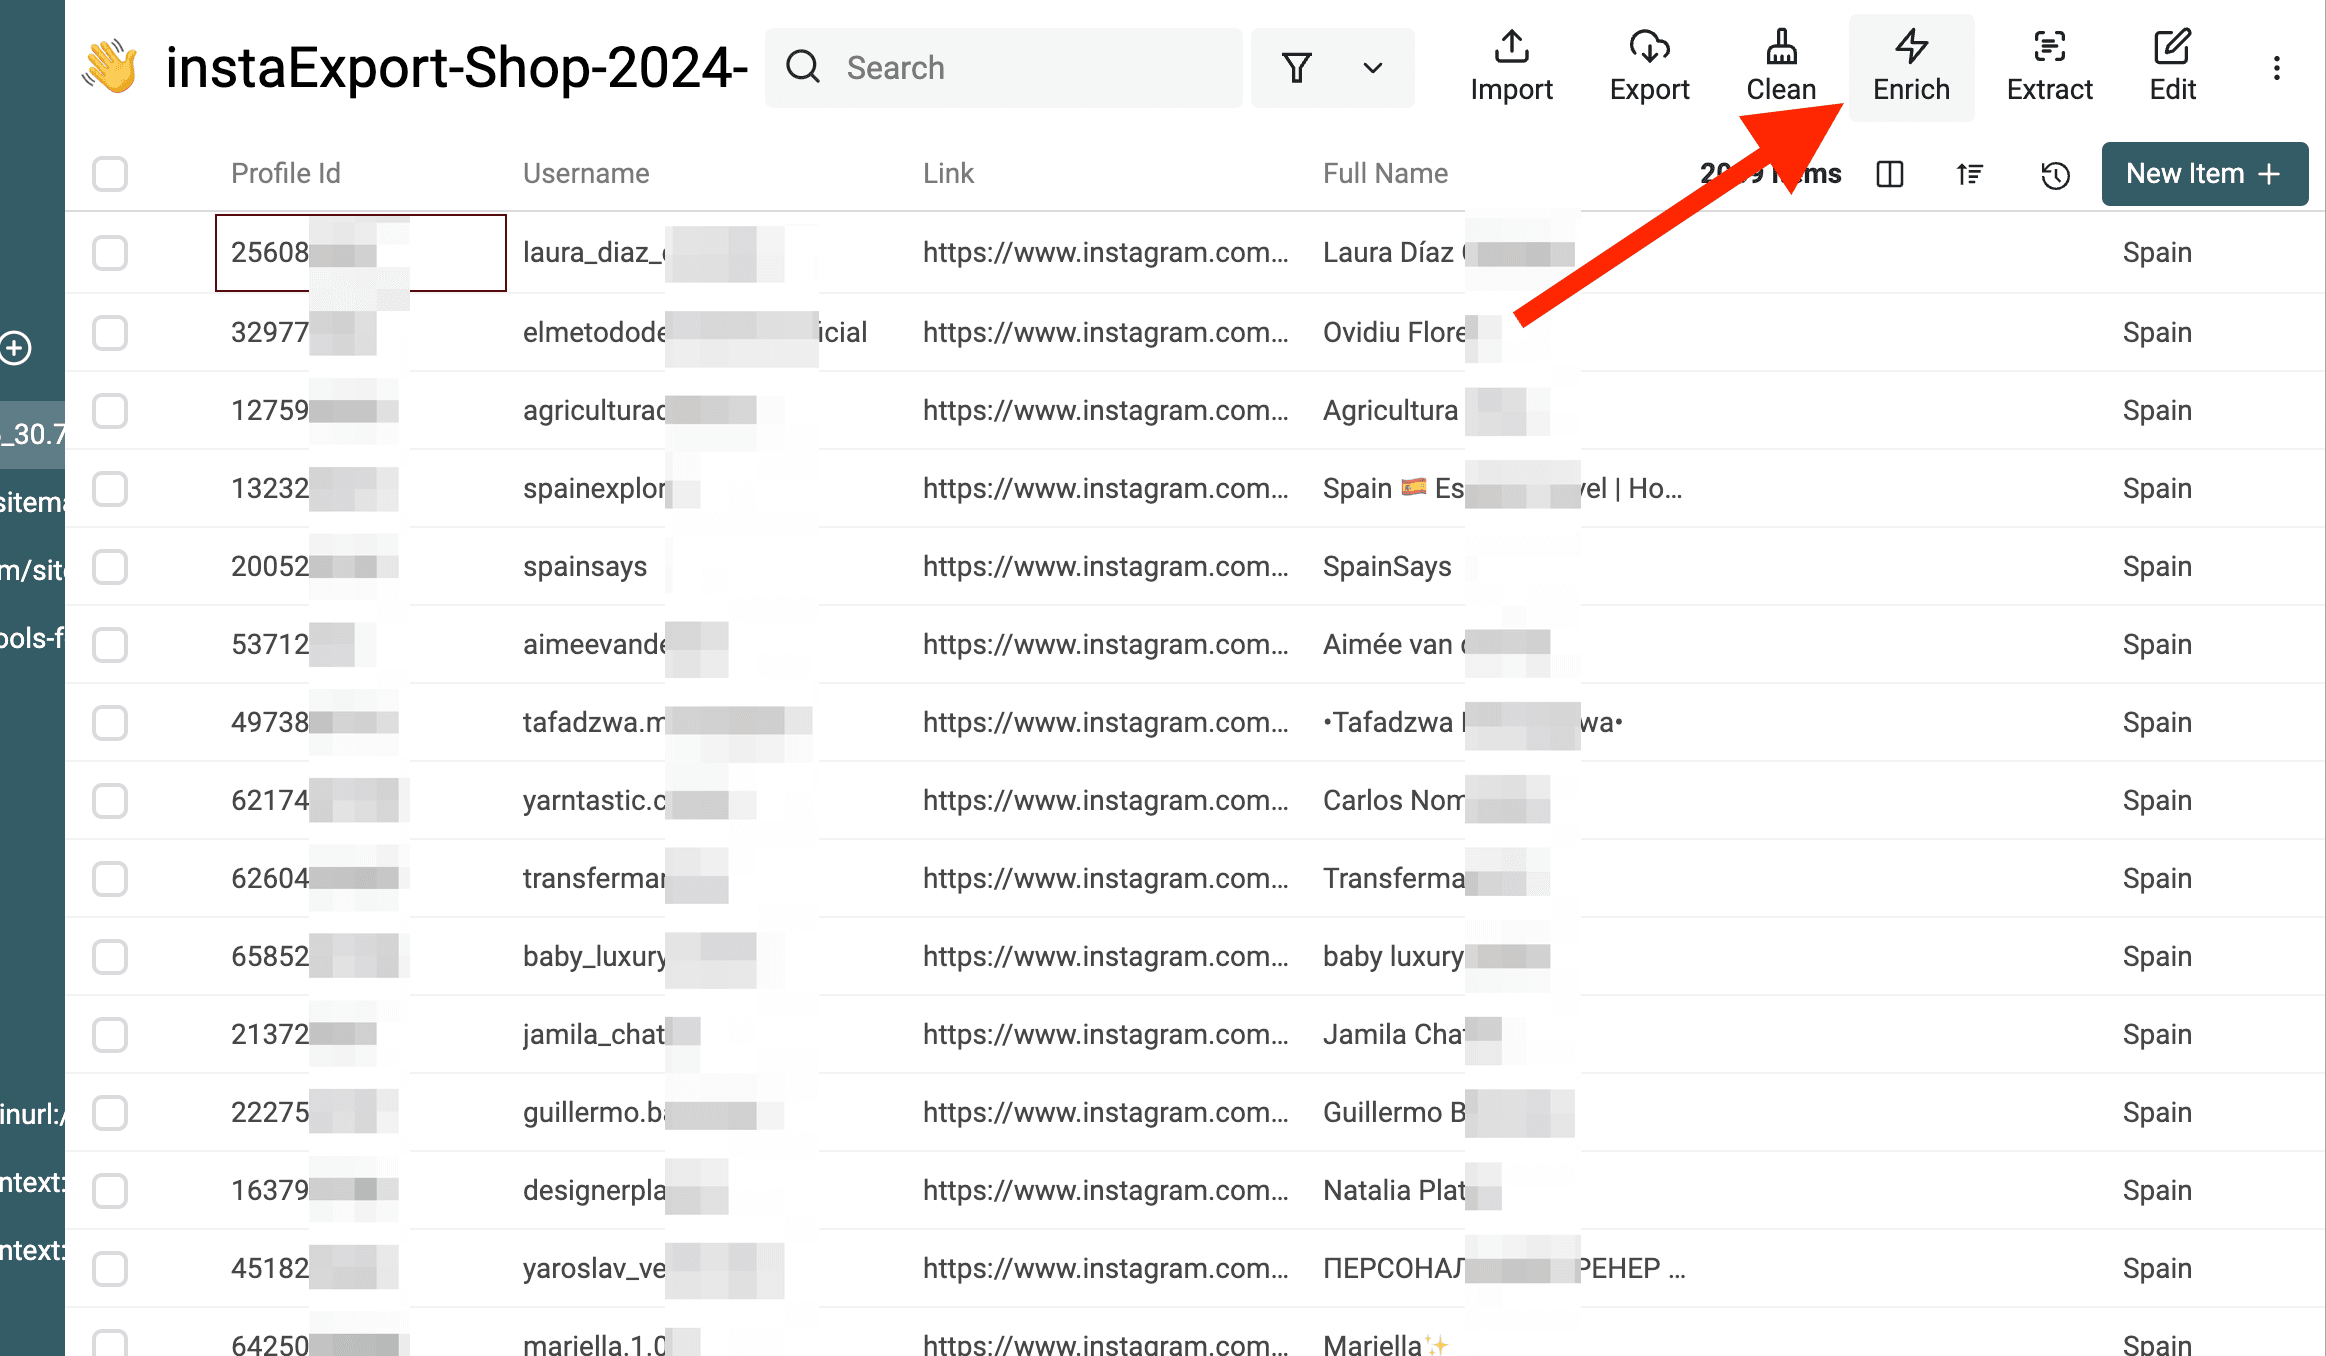
1. Enrichment-Menü öffnen Klicke in Deiner Collection mit den gescrapten Followern oben im Dashboard auf Enrich.
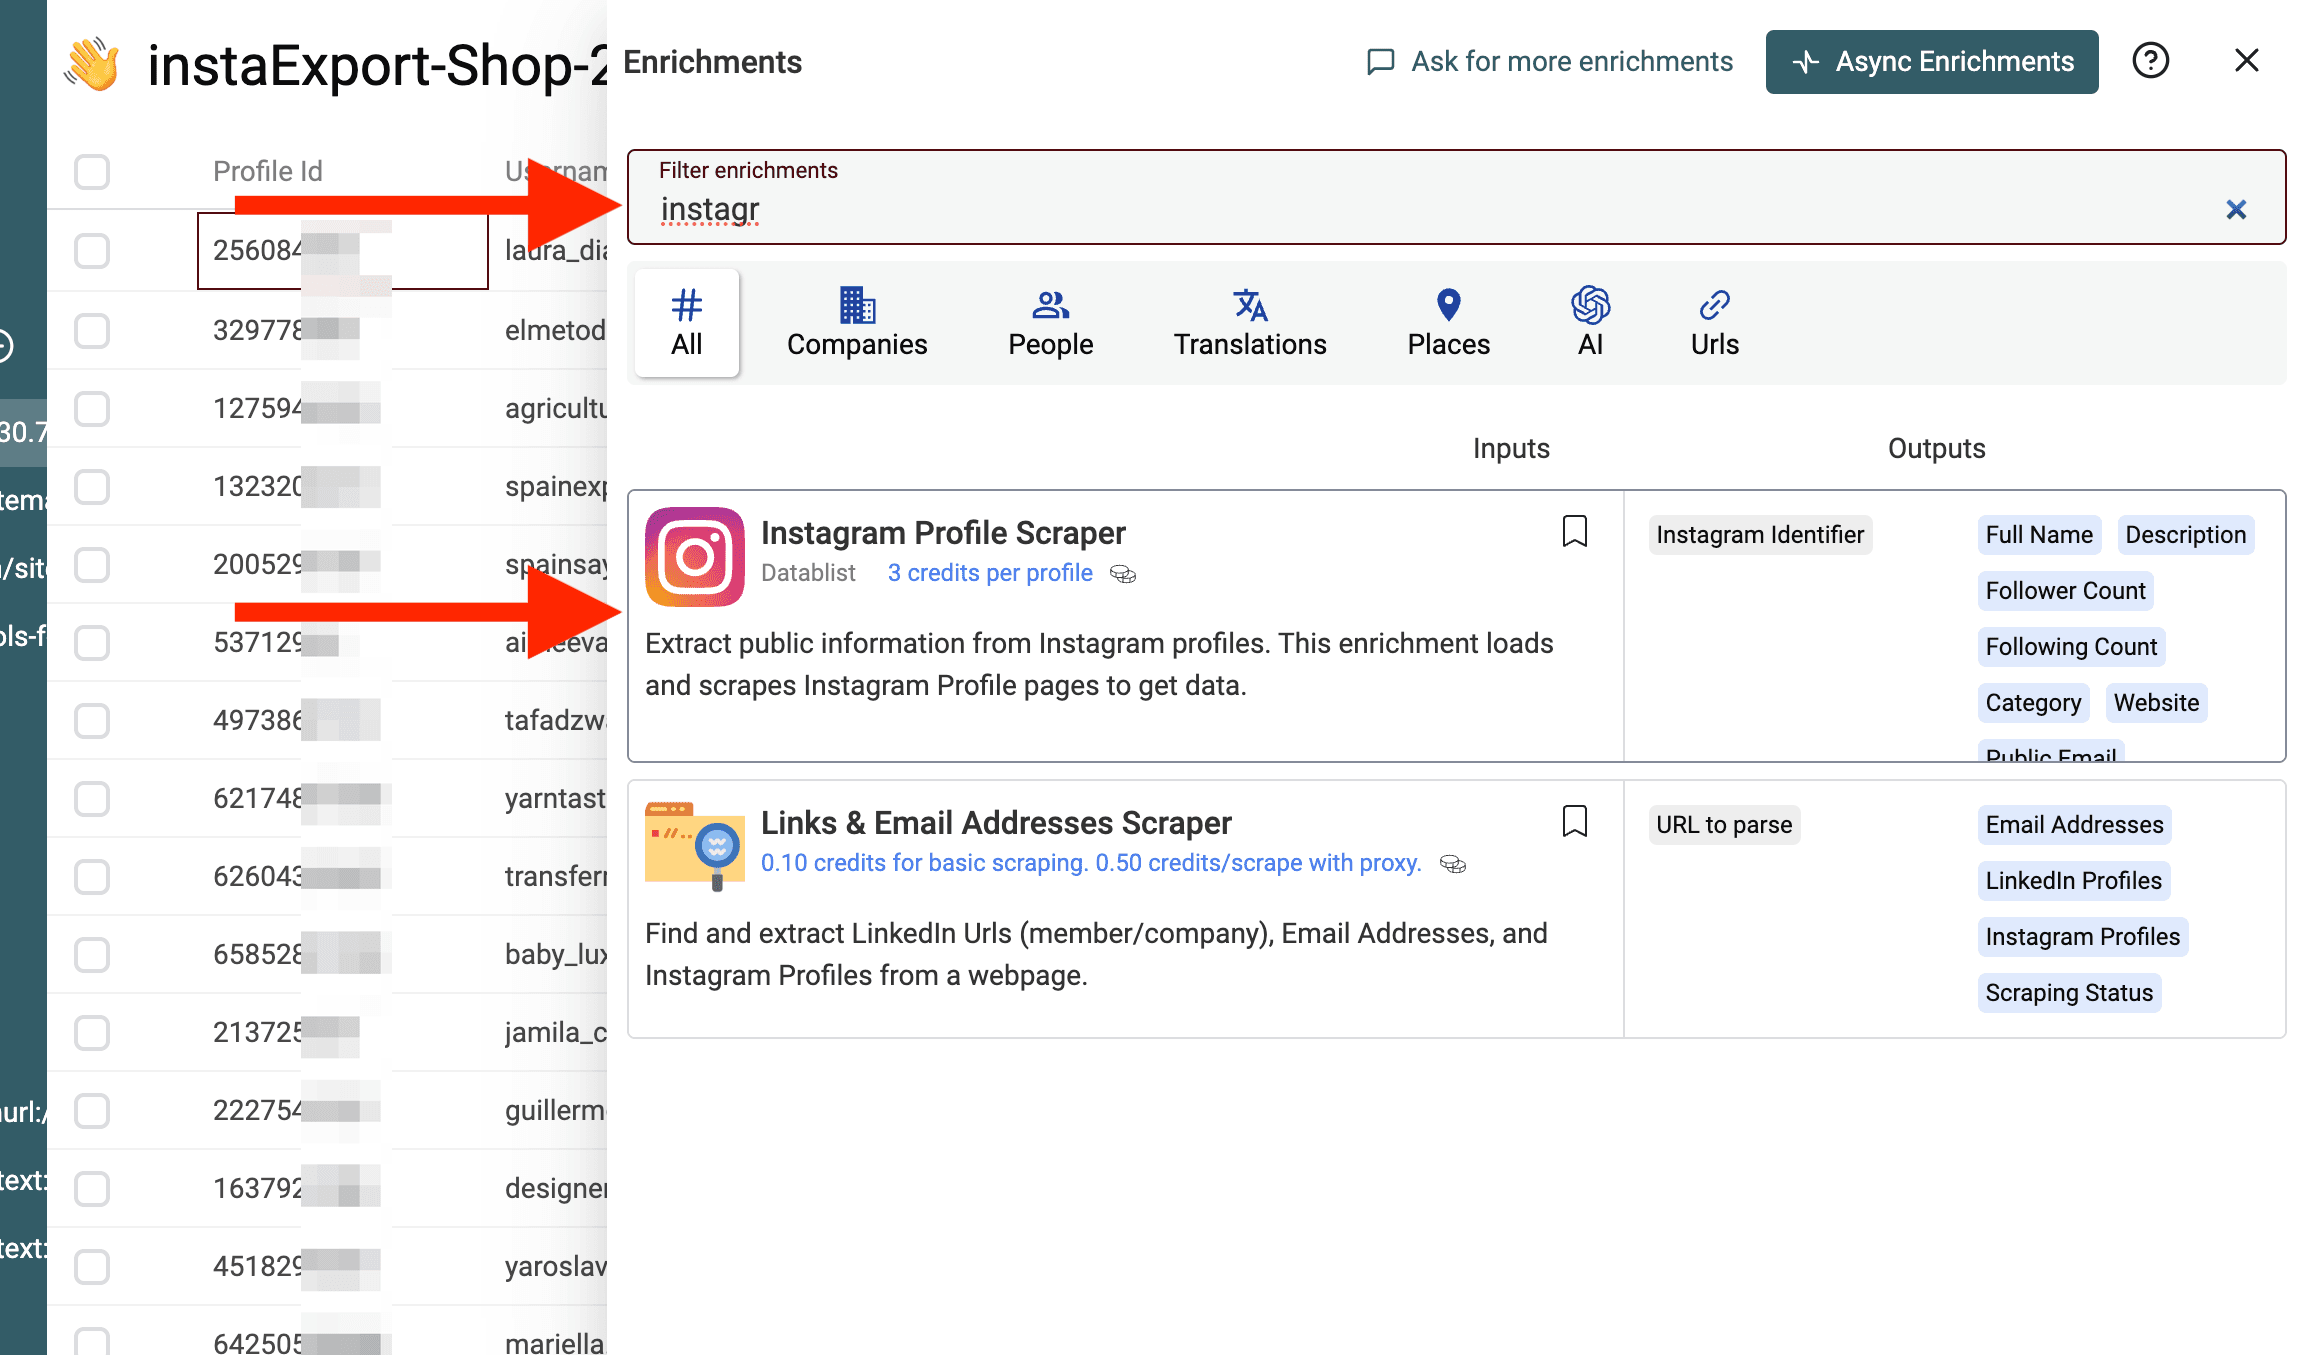
2. Instagram Profile Scraper auswählen Suche nach Instagram Profile Scraper und wähle ihn aus. Dieses Enrichment nutzt die Profilkennungen aus den Ergebnissen Deiner Quelle, um zusätzliche Profilfelder abzurufen. Welche Daten verfügbar sind, hängt vom gewählten Scraping Type und den Daten ab, die der Anbieter ausgeben kann.
3. Datenspalten zuordnen Lege fest, welche Spalte die Handles enthält. Ordne dafür die Spalte Instagram Username oder Profile URL aus Schritt 6 dem Eingabefeld des Scrapers zu.
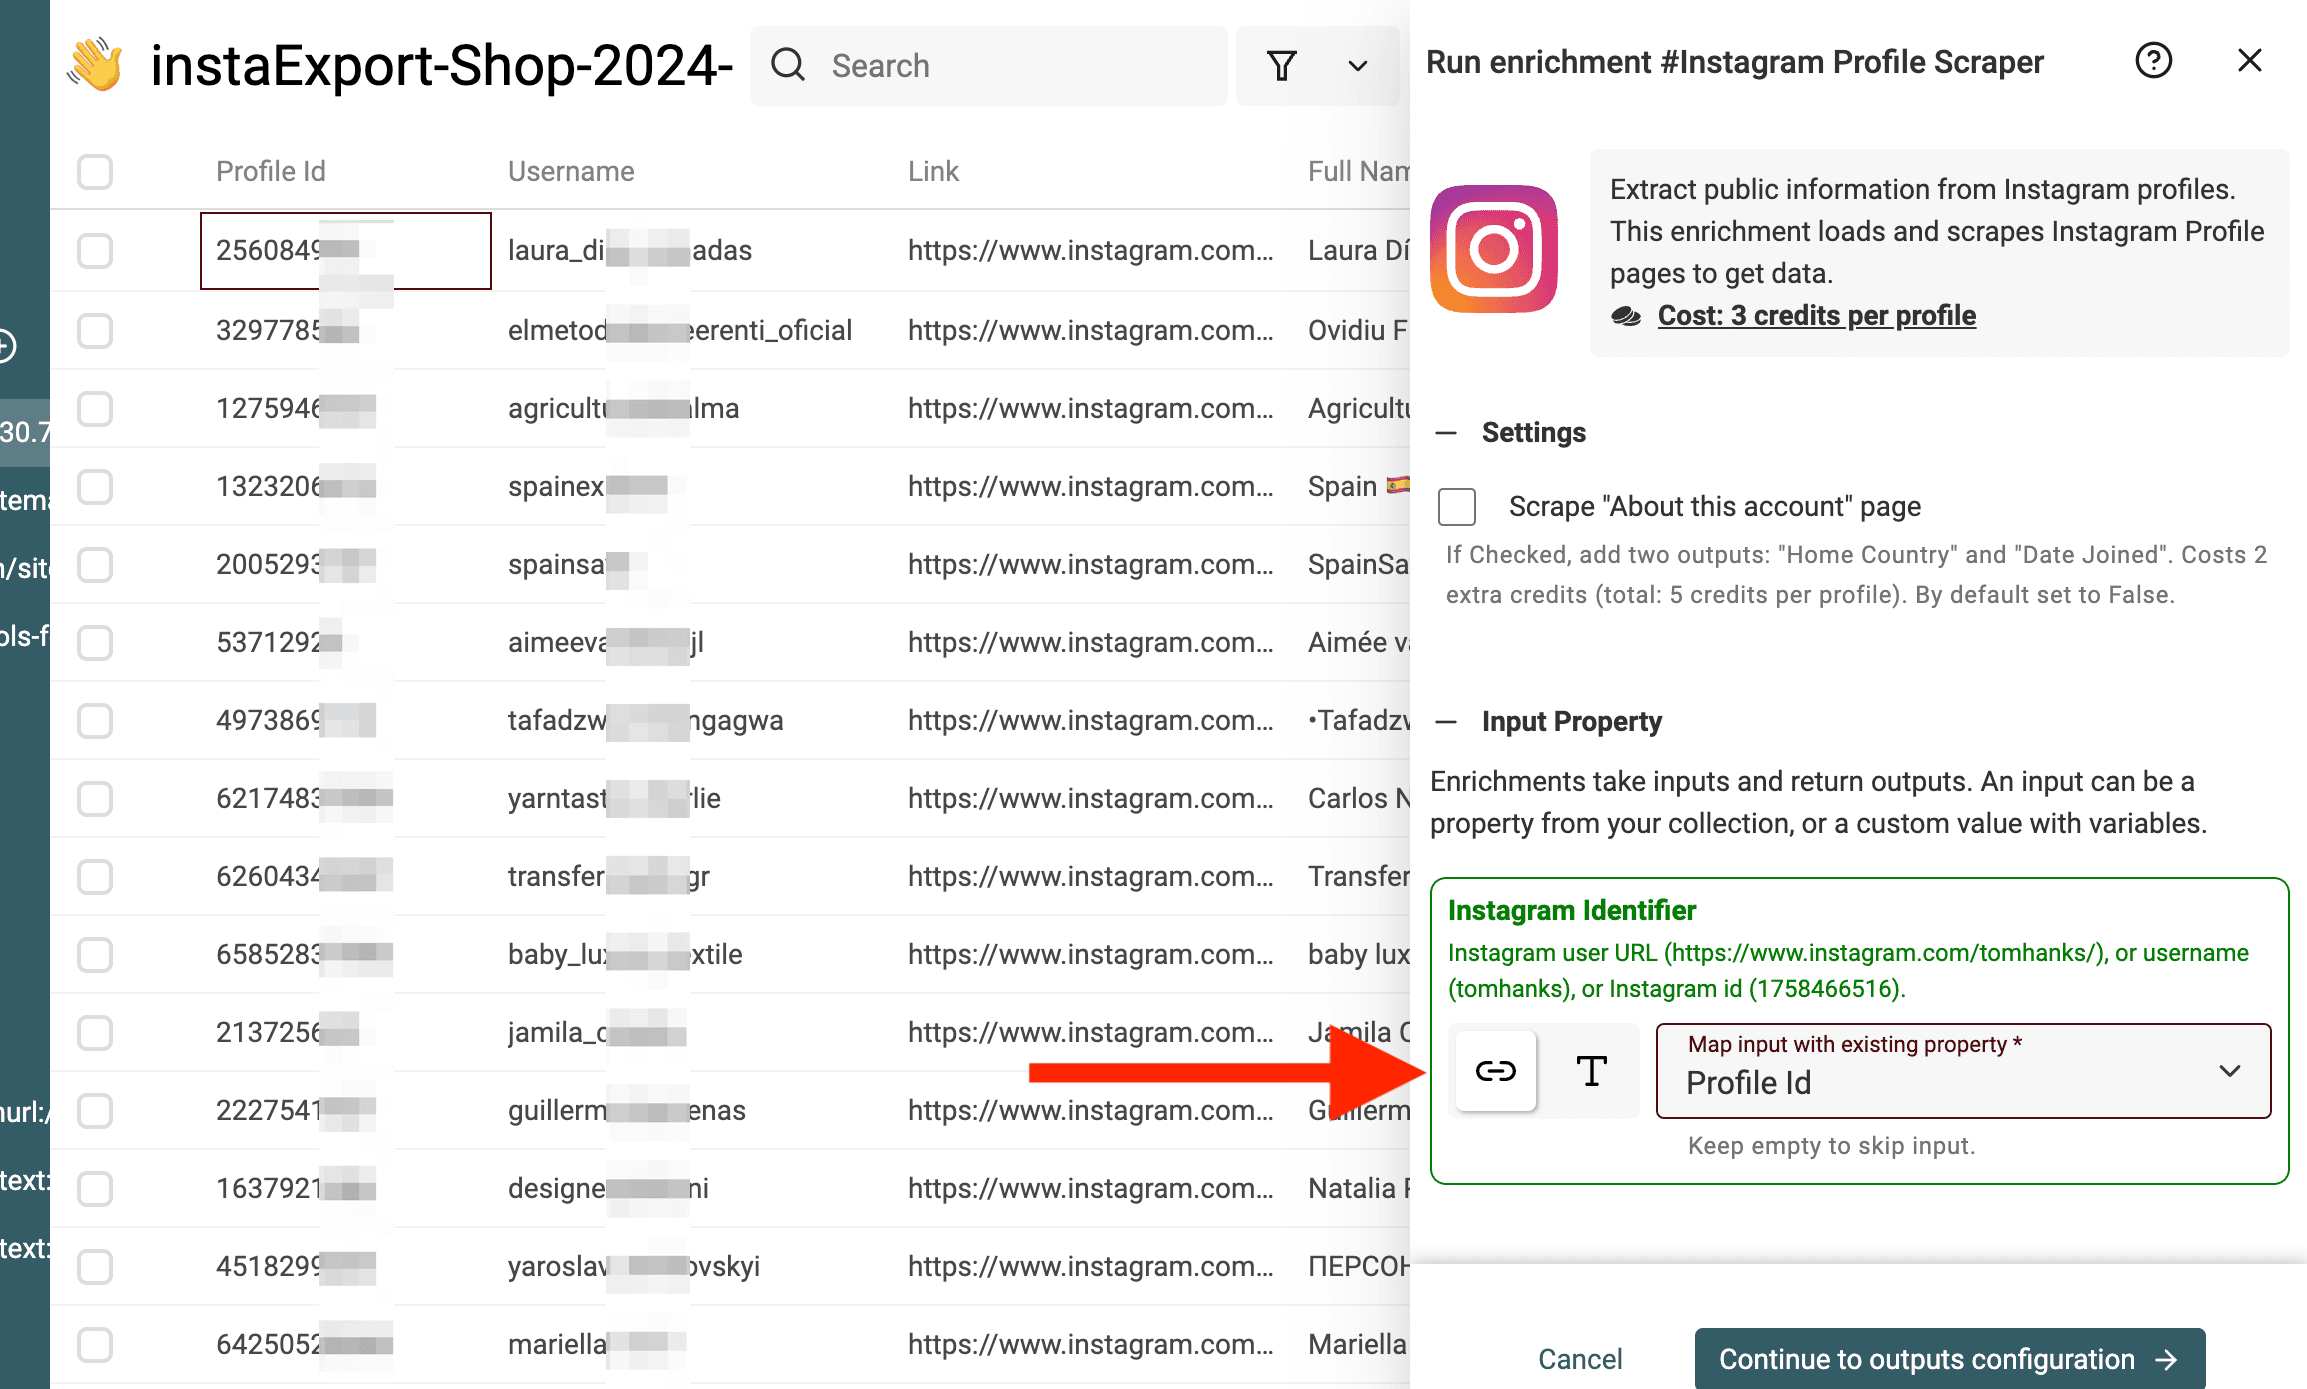
4. Ausgabefelder auswählen Wähle die Datenpunkte aus, die Du Deiner Collection hinzufügen möchtest.
Ordne die benötigten Ausgabefelder neuen Spalten zu, damit die ursprünglichen Follower-Kennungen erhalten bleiben.
Zu den möglichen Ausgaben gehören:
- Public Email: E-Mail-Adressen direkt aus Business-Profilen extrahieren.
- Description: Nutze dieses Feld, um Deine Daten nach bestimmten Jobtiteln oder Interessen zu filtern.
- Follower Count: Unterscheide „Micro-Influencer“ von regulären Nutzern.
- Website: Erfasse den Link in der Bio für eine weiterführende Unternehmensrecherche.
5. Enrichment ausführen
Wähle den Scraping Type, der die benötigten Felder ausgibt, und starte einen Testlauf. Die Option ausschließlich für öffentliche Profile enthält keine E-Mail- oder Telefonnummernfelder. Die Profiloption kann eine öffentliche E-Mail-Adresse oder Telefonnummer ausgeben, wenn der Nutzer sie hinterlegt hat; diese Felder können dennoch leer bleiben. Prüfe die verfügbaren Einstellungen und die Credit-Schätzung, bevor Du die restlichen Datensätze verarbeitest.
Prüfe nach Abschluss des Enrichments den Enrichment Status und fehlende Felder. Eine fehlende öffentliche E-Mail-Adresse sollte leer bleiben; sie beweist nicht, dass die Person keine E-Mail-Adresse besitzt. Anschließend kannst Du den Data Extractor verwenden, falls E-Mail-Adressen im Bio-Text statt im offiziellen E-Mail-Feld enthalten sind.
Überschneidungen prüfen und große Scrapes fortsetzen
Behalte zwei unterschiedliche Datensätze im Blick:
- Follower-Beziehungen: eine Zeile pro Paar aus Follower und Quellprofil. Folgt eine Person zwei eingegebenen Accounts, kann sie berechtigterweise zweimal erscheinen.
- Eindeutige Profile: eine Zeile pro User Id, wenn Du jede Person nur einmal anreichern möchtest. Sichere die Zugehörigkeit zu den Quellprofilen separat, bevor Du wiederholte Profile entfernst.
In einem einfachen Beispiel steht die User Id 101, die sowohl Account A als auch Account B folgt, für zwei Beziehungen, aber nur ein Profil. Wenn Du ausschließlich nach User Id deduplizierst, geht eine Quellbeziehung verloren, sofern Du diesen Kontext nicht vorher zusammenführst.
Ich würde vor dem Enrichment nach fehlenden IDs, wiederholten Paaren aus Quelle und Follower sowie unerwartet kleinen Ergebnissen suchen. Wähle eine repräsentative Stichprobe von Profilen und prüfe Description, Website und alle ausgegebenen E-Mail-Felder. Ordne nicht jeden Follower eines Fitness-Accounts automatisch der Fitnessbranche zu.
Wenn für einen früheren Lauf eine Fortsetzung gespeichert wurde, öffne die Einstellungen der Quelle und nutze Continue a previous scrape. Verfügbare Einträge gelten nur für den aktuellen Workspace und werden sieben Tage lang gespeichert. Der ausgewählte Eintrag verwendet das ursprüngliche Quellprofil und den Scrape Type erneut; Du musst sie nicht durch eine neue Profileingabe ersetzen.
Wenn die Quelle eine Grenze der Collection erreicht, setze den Lauf entsprechend der angezeigten Anweisung in einer anderen Collection desselben Workspaces fort. Ist die Fortsetzung nicht verfügbar, prüfe den Quelllauf, bevor Du neu beginnst. Ein neu gestarteter Scrape kann sich mit einer früheren Momentaufnahme überschneiden. Vergleiche deshalb die Kennungen und bewahre den Kontext von Quelle und Collection auf.
Speichere zu jedem Batch ein Checked-At-Datum und exportiere die geprüften Ergebnisse als CSV oder Excel. Eine veränderte Follower-Zahl ist kein Beleg dafür, dass Dein Export vollständig ist; Follower können sich zwischen einzelnen Seiten oder Läufen ändern.
Fazit
Starte mit einem öffentlichen Profil und einem kleinen Limit, behalte die Kennungen des Followers und des Quellprofils und prüfe die ausgegebenen Beziehungen, bevor Du sie anreicherst oder exportierst. Nutze für einen größeren Quelllauf eine gespeicherte Fortsetzung, sofern sie verfügbar ist.
Öffne Datablist, um denselben Workflow mit einem Profil zu testen, das für Dein Projekt relevant ist.
Häufige Fragen zum Scrapen von Instagram-Followern
Ist das Scrapen von Instagram-Followern legal?
Die öffentliche Sichtbarkeit bedeutet nicht automatisch, dass eine automatisierte Erfassung oder Weiterverwendung erlaubt ist. Prüfe vor der Datenerfassung die aktuellen Nutzungsbedingungen von Instagram und die Anforderungen für Deinen konkreten Verwendungszweck.
Kann ich Follower mehrerer Influencer gleichzeitig scrapen?
Ja. Trage unter Instagram Profiles eine Kennung pro Zeile ein. Die Quelle verarbeitet die angegebenen Accounts und ergänzt die ausgegebenen Zeilen um Beziehungsfelder des jeweiligen Quellprofils. Laufzeit und Vollständigkeit können je nach Account variieren.
Kann ich Follower privater Instagram-Profile scrapen?
Nein. Dieser Workflow stellt die Follower-Liste eines privaten Profils nicht bereit. Die Abfrage von Profildetails ist ein separates Enrichment und kann keine geschützten Follower-Daten freischalten.
Wie schnell kann ich Instagram-Follower scrapen?
Es gibt keine feste Laufzeit, die für jedes Profil gilt. Führe eine kleine Stichprobe aus und prüfe die tatsächliche Dauer, die ausgegebenen Zeilen und den Credit-Verbrauch, bevor Du den Lauf erweiterst.
Was passiert bei mehr als 100.000 Followern?
Behandle das Limit des Quelllaufs und den Speicherplatz der Collection als getrennte Einschränkungen. Eine Quelle kann stoppen, bevor die gesamte Liste eines Profils abgerufen wurde. Nutze eine verfügbare Fortsetzung in einer anderen Collection, wenn Du dazu aufgefordert wirst, und exportiere jeden abgeschlossenen Batch. Gehe nicht davon aus, dass die Importkapazität der Collection der Extraktionskapazität der Quelle entspricht.
Welche Daten erhalte ich beim Scrapen von Instagram-Followern?
Für jeden Follower kannst Du verschiedene Profildaten auswählen, darunter:
- User Id: interne Benutzerkennung von Instagram
- User Username: Instagram-Handle des Followers
- User Profile URL: direkter Link zum Instagram-Profil
- Full Name: Anzeigename im Profil
- Profile Picture: URL des Profilbilds
- Private: zeigt, ob der Account privat oder öffentlich ist
- Verified: Verifizierungsstatus mit blauem Haken
- Follower of (UserId), Follower of (Username) und Follower of (ProfileUrl): Kennungen des Quell-Accounts zur Überprüfung der Beziehung
Wie viele Instagram-Follower kann ich auf einmal scrapen?
Lege für den Quelllauf das Scraping Limit Per Profile fest und prüfe den Fortschritt sowie die Einstellungen für Fortsetzungen. Die tatsächlichen Ergebnisse hängen von den zugänglichen Follower-Seiten, den Antworten des Anbieters, den Lauflimits und den verfügbaren Credits ab. Die Importkapazität ist keine Zusage, dass eine Follower-Quelle dieselbe Anzahl in einem einzigen Lauf ausgeben kann.
Brauche ich eine Browser-Erweiterung?
Nein. Datablist läuft vollständig als Web-App. Du brauchst weder Erweiterungen noch Downloads oder Installationen.
Wie scrape ich Instagram-Follower am günstigsten?
Fordere zunächst ein kleines Limit an, prüfe die Credit-Schätzung und kontrolliere die ausgegebenen Zeilen, bevor Du das Enrichment mit Profildetails startest. Vergleiche die Kosten pro brauchbarem und geprüftem Profil, statt anzunehmen, dass jeder ausgegebene Follower ein qualifizierter Kontakt ist.
Wie scrape ich Instagram-Follower ohne Sperre?
Datablist verlangt in diesem Workflow weder Deine Instagram-Zugangsdaten noch Session-Cookies. Das bedeutet jedoch nicht, dass Scraping risikofrei oder die Datenerfassung automatisch erlaubt ist. Nutze zugängliche Quelldaten, prüfe die Vorgaben der Plattform und brich ab, wenn die gewünschte Liste nicht verfügbar ist.
Was unterscheidet Followers und Following?
Followers sind Personen, die einem Profil folgen. Following bezeichnet die Accounts, denen das Profil selbst folgt. Dieser Guide behandelt speziell das Scrapen von Followern, Datablist bietet aber beide Optionen an.
Kann ich Follower eines Instagram-Business-Accounts scrapen?
Ja, sofern der Business-Account öffentlich ist. Der Scraper funktioniert bei persönlichen Accounts, Creator-Accounts und Business-Accounts auf dieselbe Weise.
Wie lade ich eine Instagram-Follower-Liste herunter?
Registriere Dich bei Datablist, erstelle eine Collection, wähle den Instagram Followers/Following Scraper aus, füge das Profil ein und starte den Lauf. Anschließend kannst Du die Ergebnisse als CSV oder Excel exportieren.
Welche Tools können Instagram-Follower scrapen?
Es gibt verschiedene Möglichkeiten, darunter Browser-Erweiterungen, Python-Skripte und Plattformen wie Datablist. Vergleiche den erforderlichen Account-Zugriff, die ausgegebenen Felder, die Unterstützung für Fortsetzungen, die Dauer eines Testlaufs und die Kosten pro brauchbarem Ergebnis. Für diesen Workflow benötigt Datablist keine Instagram-Zugangsdaten.