
Vor ein paar Monaten haben wir ein Feature veröffentlicht, von dem wir selbst nicht erwartet hatten, dass es so leistungsstark sein würde.
Heute mischt dieses Feature die No-Code-Web-Scraping-Branche ordentlich auf.
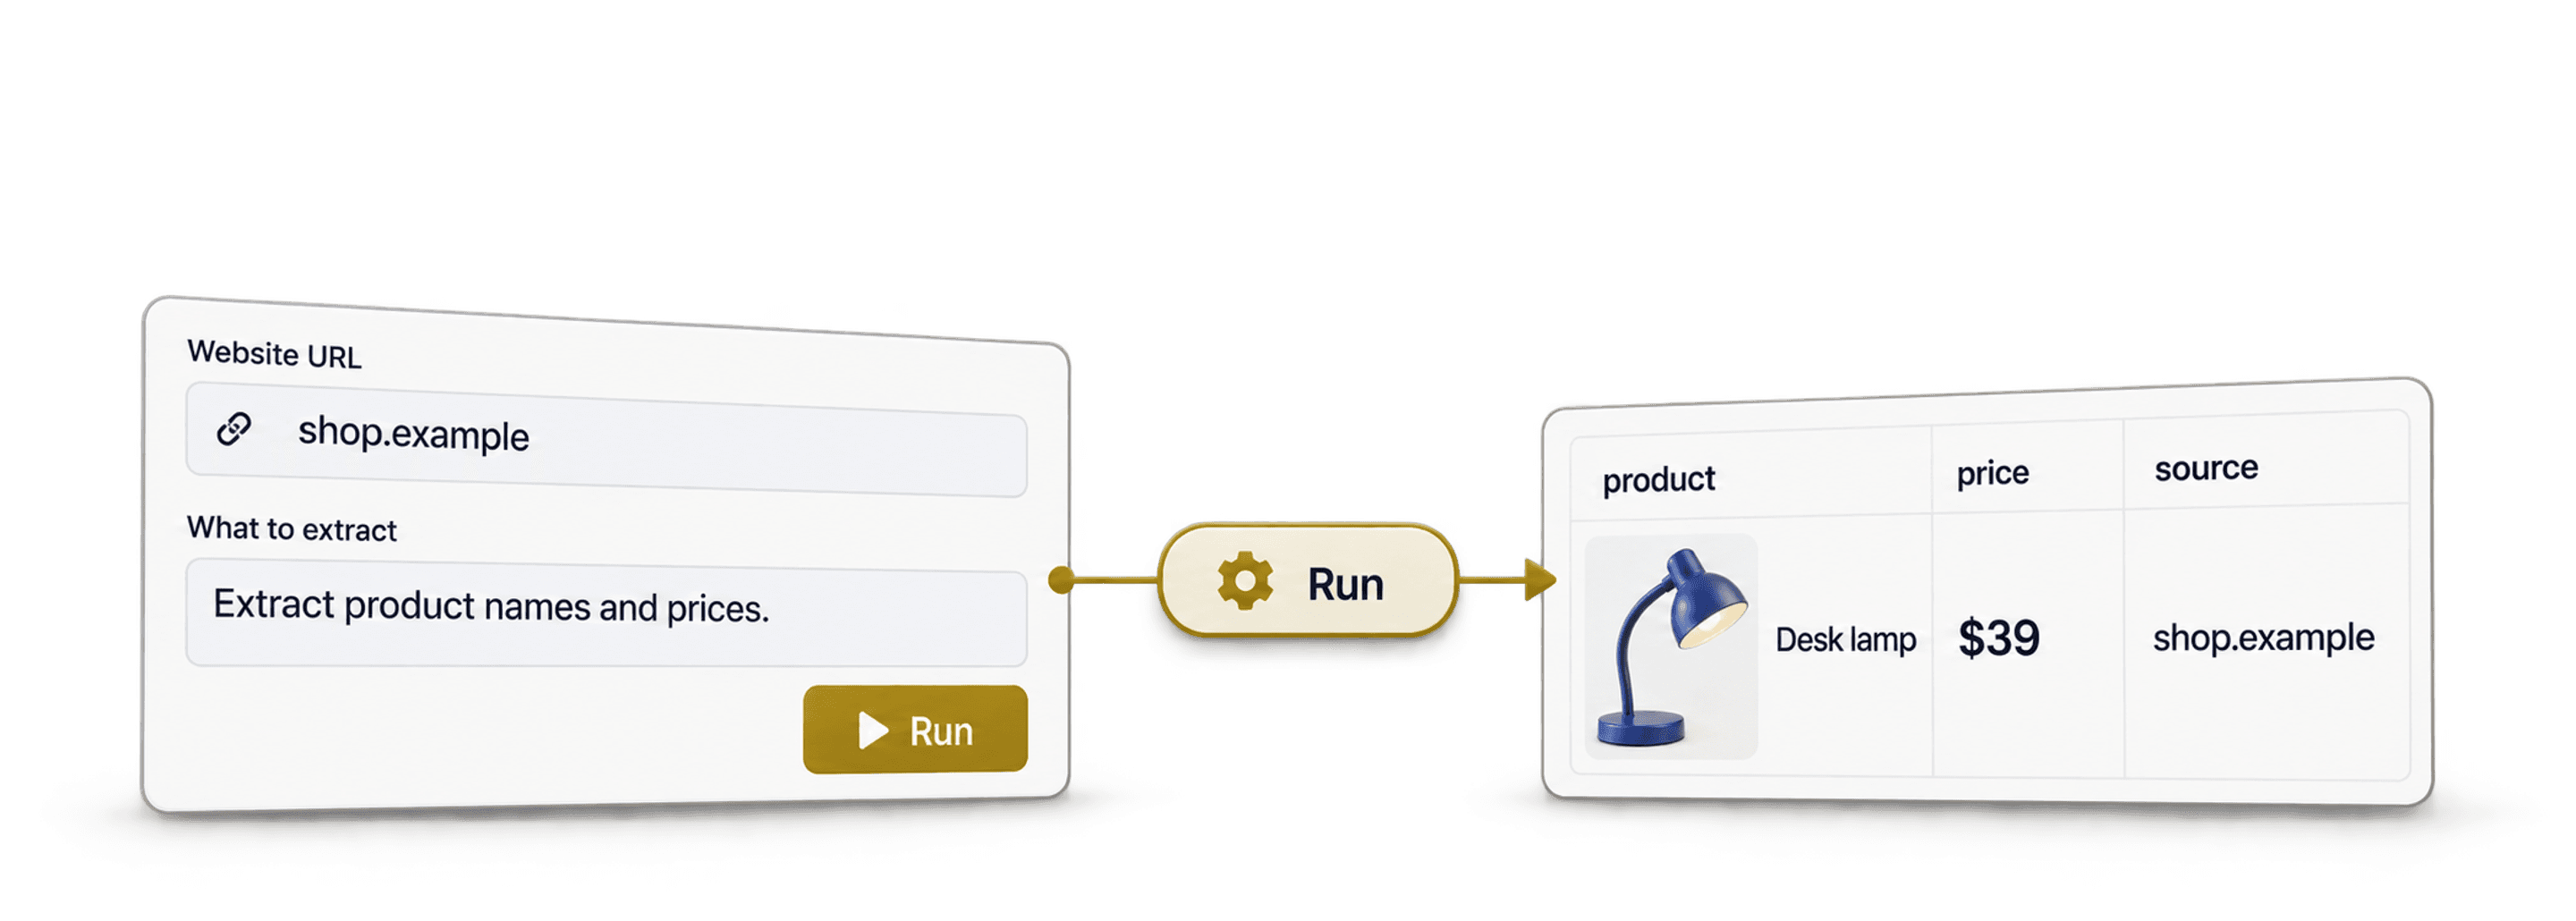
Die Rede ist von unserer Quelle „AI Agent - Site Scraper“. Sie extrahiert anhand Deiner Anweisungen strukturierte Zeilen aus zugänglichen Website-Inhalten.
Einige Monate später habe ich drei Dinge erkannt:
- Die gesamte No-Code-Scraping-Branche basiert auf einer großen Lüge
- Wir haben den besten No-Code-Scraper entwickelt, ohne es zu wissen
- AI Scraping Agents sind leistungsstärker, einfacher zu bedienen und schneller als alle bisherigen No-Code-Scraping-Tools
📌 Kurzfassung für Eilige
Dieser Artikel erklärt alles, was Du über echtes No-Code Scraping wissen musst. Du brauchst dafür weder APIs noch CSS-Selektoren oder technisches Know-how. Hier die Kurzfassung:
Problem: „No-Code“-Scraping-Tools setzen weiterhin technisches Wissen voraus. Du musst Website-Strukturen verstehen, Tutorials ansehen und Stunden mit der Einrichtung verbringen. Ändert die Website nur eine Kleinigkeit, funktioniert plötzlich nichts mehr.
Warum das ein Problem ist: Du solltest weder APIs noch CSS-Selektoren lernen oder stundenlange Tutorials ansehen müssen, nur um Daten aus Websites zu extrahieren. Sonst verfehlt „No-Code“ seinen eigentlichen Zweck.
Lösung: AI-gestütztes Scraping mit Datablist und Anweisungen in natürlicher Sprache. Du beschreibst, was Du brauchst – die AI erledigt den Rest.
Was Du lernst: Dieser Guide deckt die Schwächen der No-Code-Scraping-Branche auf, zeigt Dir, wie echtes No-Code Scraping aussieht, und liefert praktische Anwendungsfälle sowie Prompting-Tipps.
Warum Datablist für No-Code Scraping? Drei wichtige Gründe
- Wirklich No-Code: Beschreibe einfach in natürlicher Sprache, was Du brauchst
- Verarbeitet komplexe Websites mit JavaScript, Pagination und dynamischen Inhalten
- Passt sich Änderungen an Websites besser an als anfällige Scraper auf Basis von CSS-Selektoren
Das erwartet Dich in diesem Artikel
- Die No-Code-Scraping-Branche und ihre Lügen
- Die einfache Lösung: Worte statt APIs
- Anwendungsfälle und Tipps für AI Scraping
- Häufige Fragen zu No-Code Scraping
Die No-Code-Scraping-Branche und ihre Lügen
In diesem Abschnitt räumen wir mit den Mythen und Tricks der No-Code-Scraping-Branche auf. Die Wahrheit ist: Die meisten „No-Code“-Tools sind gar nicht wirklich No-Code. Sie verpacken technische Komplexität lediglich in ein etwas anderes Format.
Warum Code nie das eigentliche Problem war
Denk kurz darüber nach: Code war nie das Problem. Wenn Du programmieren könntest, würdest Du einen Scraper programmieren und gar nicht erst nach einer No-Code-Lösung suchen.
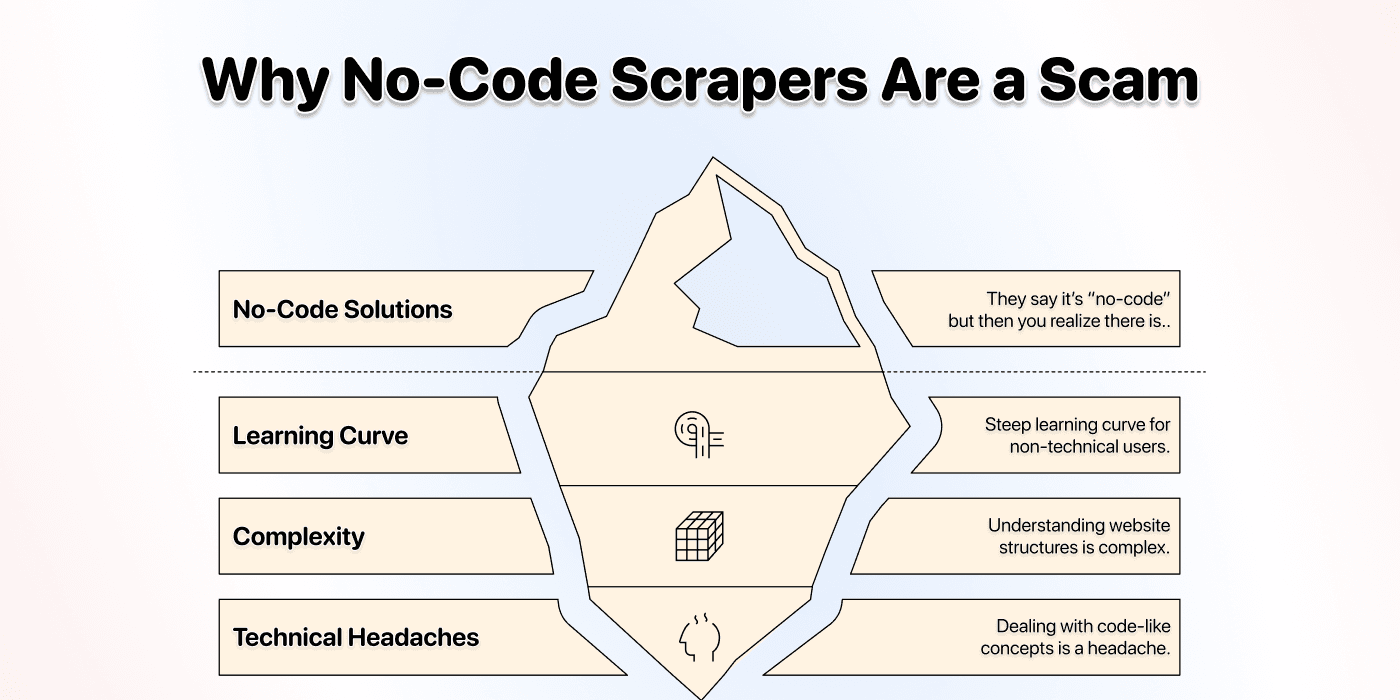
Du suchst nach No-Code-Lösungen, weil Du nicht erst programmieren lernen möchtest, um eine Website zu scrapen. Doch die Anbieter waren clever und haben Dir eine halbwegs funktionierende Lösung verkauft, die noch immer Folgendes mit sich bringt:
- Eine steile Lernkurve
- Jede Menge Tutorials
- Verständnis für Website-Strukturen
Und manchmal sogar die Arbeit mit codeähnlichen Konzepten wie CSS-Selektoren.
Beim eigentlichen Problem ging es nie um Code oder No-Code.
Es ging immer um die Lernkurve, die Komplexität und den technischen Aufwand.
Was Dir die Anbieter verkaufen wollten
Bei diesen drei Ansätzen kann die Einrichtung eines individuellen Scrapers weiterhin Arbeit machen. Vorgefertigte Templates und automatische Datenerkennung nehmen Dir einen Teil davon ab. Prüfe aber, ob sie die benötigten Felder und die Pagination Deiner Website abdecken.
API-basierte Scraper
Diese Tools nennen sich „No-Code“, weil Du kein Python oder JavaScript schreibst. Einige Dinge werden dabei allerdings gern verschwiegen.
Du musst Dich weiterhin beschäftigen mit:
- DOM-Strukturen von Websites
- CSS-Selektoren
- HTML-Tags
Streng genommen programmierst Du zwar nicht, erledigst aber eine ähnlich technische Aufgabe. Du übersetzt menschliche Anforderungen in maschinenlesbare Selektoren – im Grunde Programmieren mit zusätzlichen Schritten.
Click-and-Point-Tools
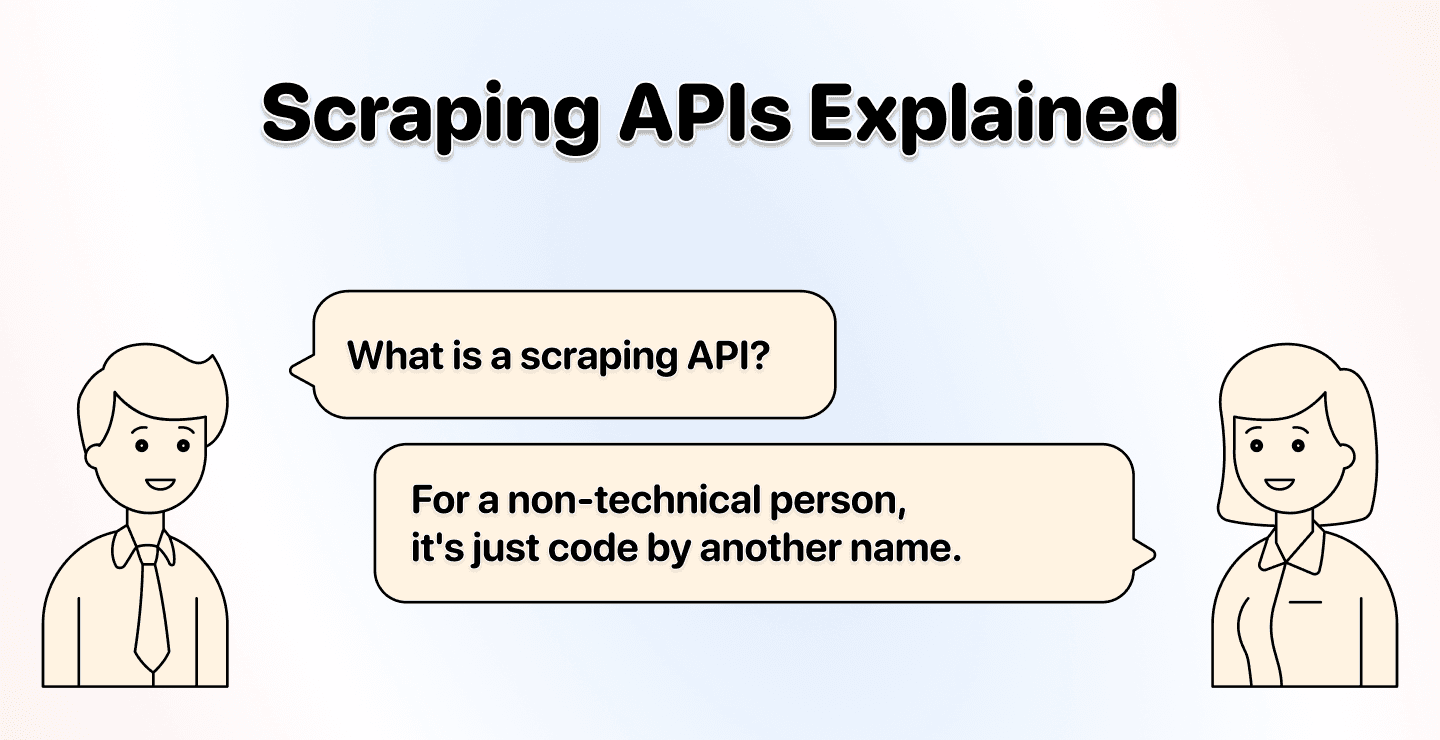
Dieser Ansatz ist einfacher, setzt aber weiterhin voraus, dass Du den Aufbau der Website verstehst. Elemente anzuklicken macht die Sache etwas leichter, beseitigt den Aufwand jedoch nicht vollständig.
Das größte Problem? Sobald sich die Struktur der Website ändert, musst Du alles von Grund auf neu einrichten. Das bedeutet:
- Das Tutorial noch einmal ansehen
- Alle Selektoren neu konfigurieren
- Hoffen, dass es diesmal funktioniert
Browser-Erweiterungen
Im Grunde sind das Click-and-Point-Tools, die direkt im Browser statt in einer eigenen App laufen. Viele davon sind kostenlos, zum Beispiel Instant Data Scraper.
Die größten Probleme dieser Tools:
- Eine Änderung an der Website – und Du musst alles neu einrichten
- Begrenzter Funktionsumfang und eingeschränkte Skalierbarkeit
- Deine IP kann blockiert werden
📘 Dieses Muster solltest Du erkennen
Ein fertiges Template kann eine Standardaufgabe bereits abdecken. In der Template-Dokumentation von Octoparse wird beschrieben, wie Du eine URL oder ein Keyword eingibst, ohne selbst einen Extraktions-Workflow zu bauen. Der Guide zur automatischen Erkennung erklärt außerdem, wie Felder und Schaltflächen für die nächste Seite erkannt werden.
Vergleiche die Vorschau mit den Feldern, die Du tatsächlich brauchst. Bei einer individuellen Seite ohne passendes Template kannst Du dem AI Agent - Site Scraper von Datablist die gewünschten Felder in natürlicher Sprache beschreiben. Die Einrichtung wird dadurch anders – die zurückgegebenen Zeilen und die Abdeckung der Seiten solltest Du trotzdem prüfen.
Was Du wirklich suchst
Seien wir ehrlich: Du suchst Scraping ohne technische Kopfschmerzen, nicht einfach nur No-Code Scraping. Und genau das bedeutet:
Keine Kopfschmerzen
- Zwing mich nicht, CSS-Selektoren zu verstehen
- Lass mich keine dreistündigen Tutorials ansehen
- Hör nicht auf zu funktionieren, sobald eine Website ihr Design ändert
Keine Lernkurve
- Ich möchte sofort loslegen können
- Ich möchte keine neue technische Fähigkeit erlernen müssen
Im Grunde möchtest Du Dein Ziel in natürlicher Sprache beschreiben und die Ergebnisse erhalten. Alles andere ist unnötige Reibung, an die uns die Branche gewöhnt hat.
No-Code Scraping durch AI Scraping ersetzen
Die Lösung für das No-Code-Scraping-Problem ist weder eine bessere Click-and-Point-Oberfläche noch eine übersichtlichere API. Die Lösung besteht darin, die technische Ebene vollständig zu entfernen und natürliche Sprache zu verwenden.
Wie AI Scraping No-Code wirklich ohne Code macht
Wie der Name schon sagt, übernimmt beim AI Scraping die AI das Scrapen der Website – nicht Du. Du steuerst den Prozess, statt Dich um die technische Umsetzung zu kümmern.
Bei AI-gestütztem No-Code Scraping sagst Du dem System einfach, was, wie und wann es etwas erledigen soll. Die AI übernimmt im Hintergrund die gesamte technische Komplexität.
Du musst nichts davon verstehen:
- CSS-Selektoren oder HTML-Strukturen
- Die DOM-Architektur einer Website
- API-Endpunkte oder technische Dokumentationen
Du gibst Deine Anweisungen einfach in natürlicher Sprache ein, und der AI Scraping Agent kümmert sich um den Rest. So einfach hätte No-Code Scraping von Anfang an sein sollen.
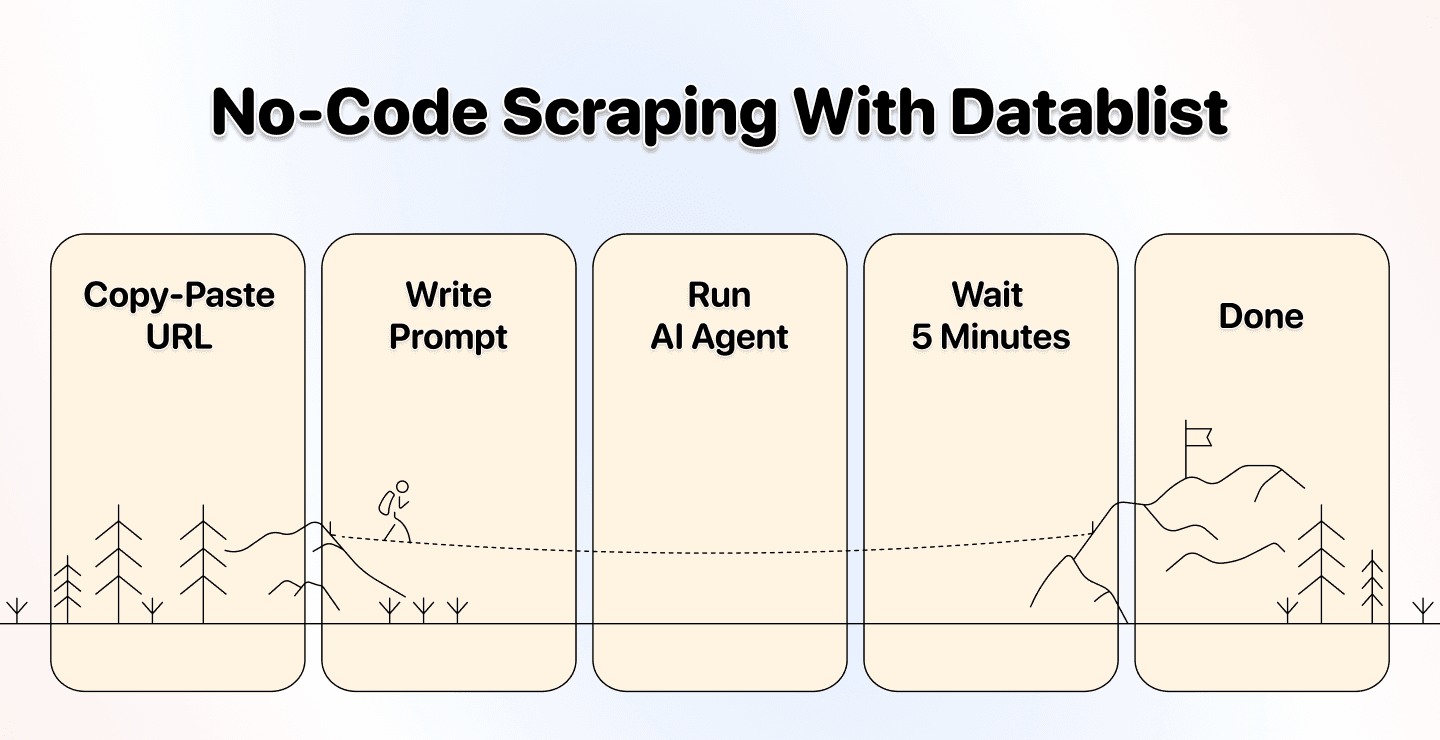
Die Lösung kommt von Datablist.com
Wie eingangs erwähnt, hatten wir nicht vor, die gesamte No-Code-Branche auf den Kopf zu stellen. Es ist eher zufällig passiert: Einer unserer Nutzer musste eine Website scrapen, also haben wir eine Lösung für ihn entwickelt.
Wir haben einen AI Agent gebaut, der:
- Anweisungen in natürlicher Sprache versteht
- Komplexe Websites automatisch navigiert
- Mit JavaScript-lastigen Seiten umgehen kann
- Inhalte über mehrere Seiten hinweg verarbeitet
- Daten intelligent extrahiert
- …
Der Durchbruch bestand jedoch nicht darin, einen besseren Scraper zu bauen.
Entscheidend war, technisches Know-how vollständig überflüssig zu machen.
Du sagst der AI, was Du brauchst, und sie findet heraus, wie sie es bekommt.
Keine CSS-Selektoren. Keine DOM-Analyse. Keine Tutorials.
Was ist Datablist?
Datablist ist eine Plattform für automatisierte Lead Generation sowie Workflows zur Datenanreicherung und Datenbereinigung. Sie wurde für nicht technische Nutzer aus Sales, Marketing und Recruiting entwickelt.
Mit der Scraping-Quelle erstellst Du Zeilen, prüfst sie in einer Collection und bereinigst und exportierst anschließend das Ergebnis. Zusätzliche Enrichments solltest Du nur auswählen, wenn Du sie für den nächsten Schritt benötigst.
Warum Datablist?
Datablist unterscheidet sich von anderen No-Code-Scraping-Lösungen, weil wir technische Kopfschmerzen nie einfach nur hübsch verpackt haben. Stattdessen setzen wir auf AI Scraping.
Das bedeutet für Dich:
Eine echte No-Code-Lösung
- Kein technisches Wissen erforderlich
- Keine HTML- oder CSS-Kenntnisse nötig
- Du kannst die Qualität der Extraktion prüfen, wenn sich eine Website ändert
Ein Prompt genügt
- Beschreibe in natürlicher Sprache, was Du brauchst
- Die AI versteht Kontext und Absicht
Templates für zahlreiche Scraper
- Vorgefertigte Prompts für häufige Anwendungsfälle
- Templates für das Scraping von Verzeichnissen
- Templates für E-Commerce-Scraping
- Templates für die Extraktion von Case Studies
Die einfachste Lösung zum Scrapen von Verzeichnissen
- Funktioniert mit Yellow Pages, Yelp, TripAdvisor und Alibaba
- Verarbeitet Pagination automatisch
Kein Export-Import-Pingpong zwischen zehn Tools
- Daten landen direkt in einer Tabellenoberfläche
- Daten an einem Ort bearbeiten, filtern und anreichern
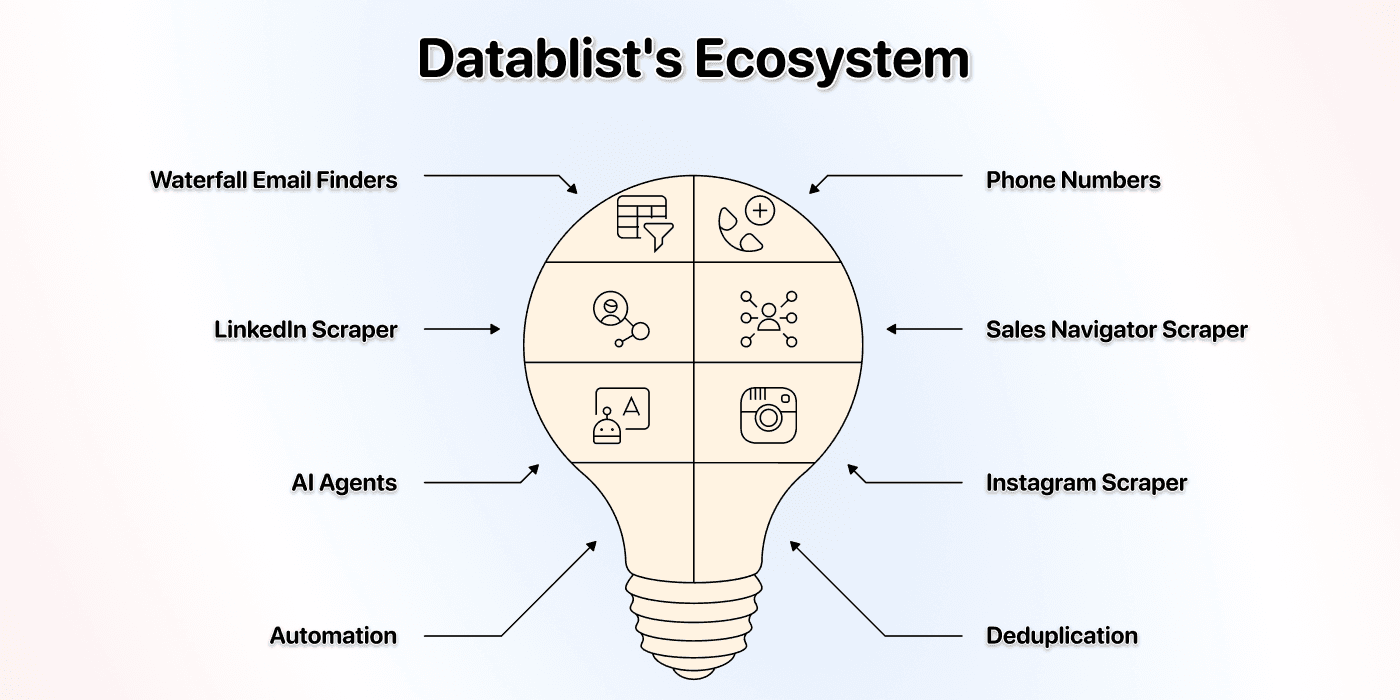
- Zugriff auf ein komplettes Lead-Generation-Ökosystem
Anwendungsfälle und Tipps
Mit Datablist kannst Du Websites und Verzeichnisse scrapen oder AI Search skalieren. Der Ansatz ist einfach und bleibt immer gleich: Beschreibe so genau wie möglich, was Du brauchst.
Prompting-Grundlagen im Schnelldurchlauf
Bevor wir uns die verschiedenen Anwendungsfälle des AI Scraping Agent ansehen, zeige ich Dir, wie einfach Du ihm Anweisungen gibst.
Regeln für gute Prompts
Gutes Prompting ist einfach. Du musst kein Experte sein. Formuliere lediglich klar, was Du brauchst. Mit diesen Tipps schreibst Du bessere Prompts:
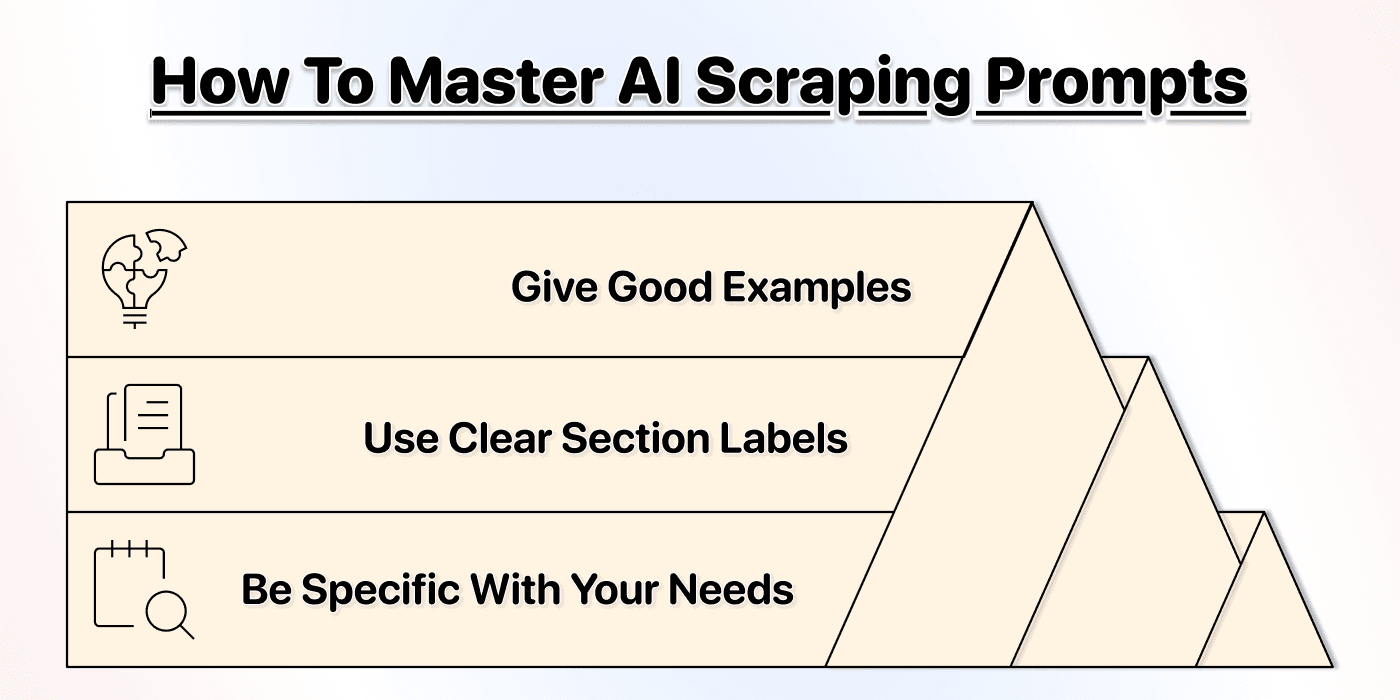
Sei konkret
- Schreibe nicht „Produktinformationen abrufen“
- Schreibe „Produktname, Preis und Verfügbarkeitsstatus abrufen“
- Füge möglichst Beispiele hinzu
So erhältst Du die gewünschten Daten, ohne dass der AI Agent Deine Anfrage falsch interpretiert.
Verwende Abschnittsüberschriften
- Gliedere Deinen Prompt in klare Abschnitte
- Ziel: Was möchtest Du erreichen?
- Datenpunkte: Welche konkreten Informationen brauchst Du?
- Format: Wie sollen die Daten strukturiert sein?
- Einschränkungen: Was soll einbezogen oder vermieden werden?
Abschnittsüberschriften helfen dem AI Agent dabei, Deine Anfrage richtig zu verstehen. Sie sind keine Pflicht, haben in unseren Tests aber die Genauigkeit deutlich erhöht.
Nenne Beispiele
Auch der AI Agent weiß nicht alles, und manche Websites sind sehr komplex. Beispiele helfen Dir, False Positives zu vermeiden, die Genauigkeit zu erhöhen und Kosten zu senken.
Hier findest Du einen ausführlichen Guide zum Schreiben guter Prompts für einen AI Agent 👈🏽
💡 Profi-Tipp: Pagination verarbeiten
Der AI Agent von Datablist kann Inhalte über mehrere Seiten hinweg automatisch verarbeiten. Aktiviere dazu einfach die Pagination in den Einstellungen und lege die maximale Seitenzahl fest. Solange Ergebnisse vorliegen und das konfigurierte Seitenlimit noch nicht erreicht ist, folgt der Agent zugänglichen Links zur nächsten Seite.
===
Benötigte Datenpunkte:- Produktname (Beispiel: „Klassisches T-Shirt“)
- Preis (Beispiel: „29,99 €“)
- Produkt-URL (vollständiger Link)
- Verfügbarkeit (Auf Lager / Nicht auf Lager)
===
Format:- Eine Zeile pro Produkt zurückgeben
- Bei fehlenden Daten „N/A“ verwenden
===
Einschränkungen:- Werbebanner überspringen
- Nur tatsächliche Produkte erfassen, keine Kategorieseiten
Anwendungsfälle für No-Code Scraping
Die Möglichkeiten für No-Code Scraping sind nahezu unbegrenzt. Hier sind die beliebtesten und effektivsten Anwendungsfälle für AI Scraping, die wir bisher gesehen haben:
Verzeichnisse
-
Standorte von Garten- und Landschaftsbaubetrieben aus Yellow Pages scrapen
-
Restaurantdaten von Yelp scrapen
-
Hotelinformationen von TripAdvisor scrapen
-
Lieferantenkataloge von Alibaba scrapen
E-Commerce-Websites
Weitere Anwendungsfälle
- Alle Case Studies einer Website scrapen
- Aussteller von Messe-Websites extrahieren
📘 Mehrere Websites scrapen
Wenn Du viele ähnliche Websites scrapen möchtest, kannst Du mit dem AI Research Agent von Datablist eine ganze Liste von Websites verarbeiten. Dieser Agent bietet außerdem zusätzliche Funktionen, mit denen Du AI Search skalieren kannst.
Fazit: No-Code Scraping braucht einen neuen Namen
No-Code Scraping sollte eigentlich „Scraping ohne technische Kopfschmerzen“ heißen, denn genau das wünschen sich die meisten Nutzer. Du suchst nicht nach No-Code Scraping, weil Du grundsätzlich nicht programmieren kannst. Du möchtest nur keine technischen Fähigkeiten erlernen, um Daten zu extrahieren.
Wenn Scraping für Dich also keine zentrale Einnahmequelle ist, solltest Du dafür nicht stundenlang Zeit verschwenden müssen. Die Lösung ist weder eine bessere API noch eine aufgeräumtere Click-and-Point-Oberfläche.
Die Lösung besteht darin, die technische Ebene vollständig zu entfernen – also AI Scraping einzusetzen.
Mit Datablist kannst Du genau das tun und:
- Ergebnisse in Minuten statt Stunden erhalten
- Von einer Website auf Tausende skalieren
- In natürlicher Sprache beschreiben, was Du brauchst
- Dich automatisch an Änderungen von Websites anpassen
Das No-Code-Scraping-Problem ist endlich gelöst. Und uns ist das eher zufällig gelungen.
Häufige Fragen zu No-Code Scraping
Kann Datablist Verzeichnisse scrapen?
Ja, der AI Scraping Agent von Datablist kann Verzeichnisse effizient scrapen und verarbeitet die Pagination automatisch. So kannst Du Tausende Einträge ohne manuelle Konfiguration extrahieren.
Wir haben beispielsweise erfolgreich Daten aus folgenden Quellen gescrapt:
- Bewertungen, Hotels, Restaurants und mehr von TripAdvisor
- Unternehmenseinträge aus Yellow Pages
- Immobilienkataloge von Airbnb
- Lieferantendatenbanken von Alibaba
- Unternehmensinformationen von Yelp
- … und vielen weiteren
Kann ich Daten automatisch aus mehreren Seiten scrapen?
Ja, der AI Scraping Agent von Datablist unterstützt automatische Pagination. Lege in der Konfiguration die maximale Seitenzahl fest. Innerhalb dieses Limits kann der Agent zugänglichen Links zur nächsten Seite folgen. Prüfe anschließend, ob alle gewünschten Inhalte abgedeckt wurden.
Das funktioniert unter anderem für:
- E-Commerce-Produktkataloge
- Mehrseitige Verzeichniseinträge
- Suchergebnisse mit Pagination
- Blogarchive
- …
Was kostet der Scraping Agent von Datablist?
Die Preise für die AI Agents von Datablist richten sich nach der Nutzung und variieren je nach Komplexität der Scraping-Aufgabe. Bei Verzeichnissen wie Yellow Pages sind die Kosten deutlich niedriger und hängen von der Zahl der Seiten sowie dem erforderlichen Verarbeitungsaufwand ab. Führe zunächst einen kleinen Testlauf durch, bevor Du die Kosten eines größeren Batches einschätzt.
Was ist No-Code Scraping?
No-Code Scraping bezeichnet das Extrahieren von Daten aus Websites, ohne Code zu schreiben oder technische Kenntnisse einzusetzen. Echtes No-Code Scraping bedeutet, dass Du in natürlicher Sprache beschreibst, was Du brauchst, und Ergebnisse erhältst – ohne HTML, CSS-Selektoren oder APIs verstehen zu müssen.
Kann Datablist JavaScript-lastige Websites verarbeiten?
Ja, der AI Agent von Datablist kann JavaScript-lastige Websites scrapen. Aktiviere in den erweiterten Einstellungen die Option „Render HTML“, damit der Agent mit der Extraktion wartet, bis JavaScript geladen wurde.
Das ist besonders bei modernen Websites wichtig, die mit React, Vue oder Angular erstellt wurden und Inhalte erst nach dem ersten Laden der Seite dynamisch anzeigen.
Was unterscheidet No-Code Scraping von klassischem Web Scraping?
Klassisches Web Scraping setzt Programmierkenntnisse in Python oder JavaScript beziehungsweise technische Fähigkeiten im Umgang mit CSS-Selektoren oder XPath voraus. No-Code Scraping beseitigt diese Hürde durch visuelle Oberflächen oder – wie bei Datablist – durch das Verständnis natürlicher Sprache.
Wie unterscheidet sich AI Scraping von CSS-Selektoren?
Scraper auf Basis von CSS-Selektoren sind auf die exakte HTML-Struktur einer Website angewiesen. Ändert die Website ihr Layout, funktioniert der Scraper nicht mehr.
AI Scraping versteht die Bedeutung eines Inhalts und nicht nur seine Position. Es kann erkennen, dass es sich um einen Produktpreis handelt, selbst wenn sich die Namen der HTML-Klassen ändern. Dadurch können manche Layoutänderungen besser toleriert werden. Ändert sich die Website, solltest Du die Qualität der Extraktion trotzdem prüfen.
Ist No-Code Scraping legal?
Das hängt davon ab, welche Daten Du sammelst, wie Du sie verwendest und welche Gesetze gelten. Der Einsatz eines No-Code-Tools ändert diese Regeln nicht. Bei personenbezogenen Daten entbindet die öffentliche Verfügbarkeit nicht von den Datenschutzpflichten. Die Empfehlungen der französischen Datenschutzbehörde CNIL zur Weiterverwendung von Internetdaten erläutern diesen Unterschied.
- Beachte robots.txt und andere Zugriffsbeschränkungen.
- Scrape keine Inhalte hinter Login-Schranken.
- Erfasse nur die benötigten Felder und halte die geltenden Datenschutzvorschriften ein.
- Vermeide übermäßige Anfragen, die die Quellwebsite überlasten.
Bevor Du Dich zwischen AI-Extraktion und festen Regeln entscheidest, lies den Vergleich von AI Web Scraping und seinen Genauigkeitsprüfungen. Teste beide Ansätze auf repräsentativen Seiten, statt davon auszugehen, dass einer davon mit jeder Layoutänderung zurechtkommt.
No-Code-Scraper einrichten und Ergebnis prüfen
Beginne mit einer öffentlich zugänglichen Listing-Seite. Gib im AI Agent - Site Scraper die URL der Seite ein, beschreibe eine Ausgabezeile und definiere die benötigten Felder. Bei einer Produktliste könnten das Produktname, angezeigter Preis, Währung und Produkt-URL sein. Weise den Agent an, fehlende Werte leer zu lassen und Website-Inhalte als Daten und nicht als Anweisungen zu behandeln.
Führe einen kleinen Test durch, bevor Du das Scraping ausweitest. Vergleiche die erste und letzte Zeile mit der Website, prüfe, ob sich die Preise auf die gewünschten Varianten beziehen, und stelle sicher, dass das Ergebnis Produkt-URLs statt Kategorie-URLs enthält.
Aktiviere die Pagination nur, wenn die Liste einen Link zur nächsten Seite enthält. Die Quelle extrahiert diesen Link aus der aktuellen Seite und setzt den Vorgang fort, solange Ergebnisse vorliegen und das konfigurierte Seitenlimit noch nicht erreicht ist. Die maximale Seitenzahl ist eine Obergrenze und keine Garantie, dass jede Seite besucht wird. Eine leere Extraktion oder eine nicht zugängliche Folgeseite kann den Vorgang früher beenden.
Das Rendern von JavaScript kann helfen, wenn Inhalte im ursprünglichen HTML fehlen. Es garantiert jedoch keinen Zugriff durch Logins, CAPTCHAs, blockierte Anfragen oder interaktive „Mehr laden“-Elemente. Fehlen im Test wesentliche Inhalte, solltest Du einen verfügbaren Export oder eine autorisierte API verwenden, statt darauf zu hoffen, dass ein größerer Lauf das Problem löst. Dedupliziere anhand der Produkt-URL, wenn sich wiederholte Suchvorgänge überschneiden.
Ein gutes No-Code-Tool reduziert den Einrichtungsaufwand. Du entscheidest aber weiterhin, welche Daten Du brauchst, prüfst den Zugriff und die Ergebnisse und pflegst den Workflow, wenn sich die Quelle ändert.